手机能做人声分离吗?浏览器算力与系统沙盒的六大限制及自救方案
你把手机浏览器打开,找了个在线人声分离工具,上传一首歌,等了三分钟——页面卡死了。或者进度条走完,下载下来的文件只有 30 秒,后半段直接静音。同样这首 MP3 在电脑上跑,十几秒就出结果。
很多人以为"网页端工具手机也能用",这个认知需要修正。浏览器的确能跑,但跑得好不好,取决于手机厂商砍了什么、浏览器封了什么、操作系统把什么藏起来了。
六大限制:从硬件到权限的层层夹击
限制一:Web Audio API 的 AudioContext 内存上限
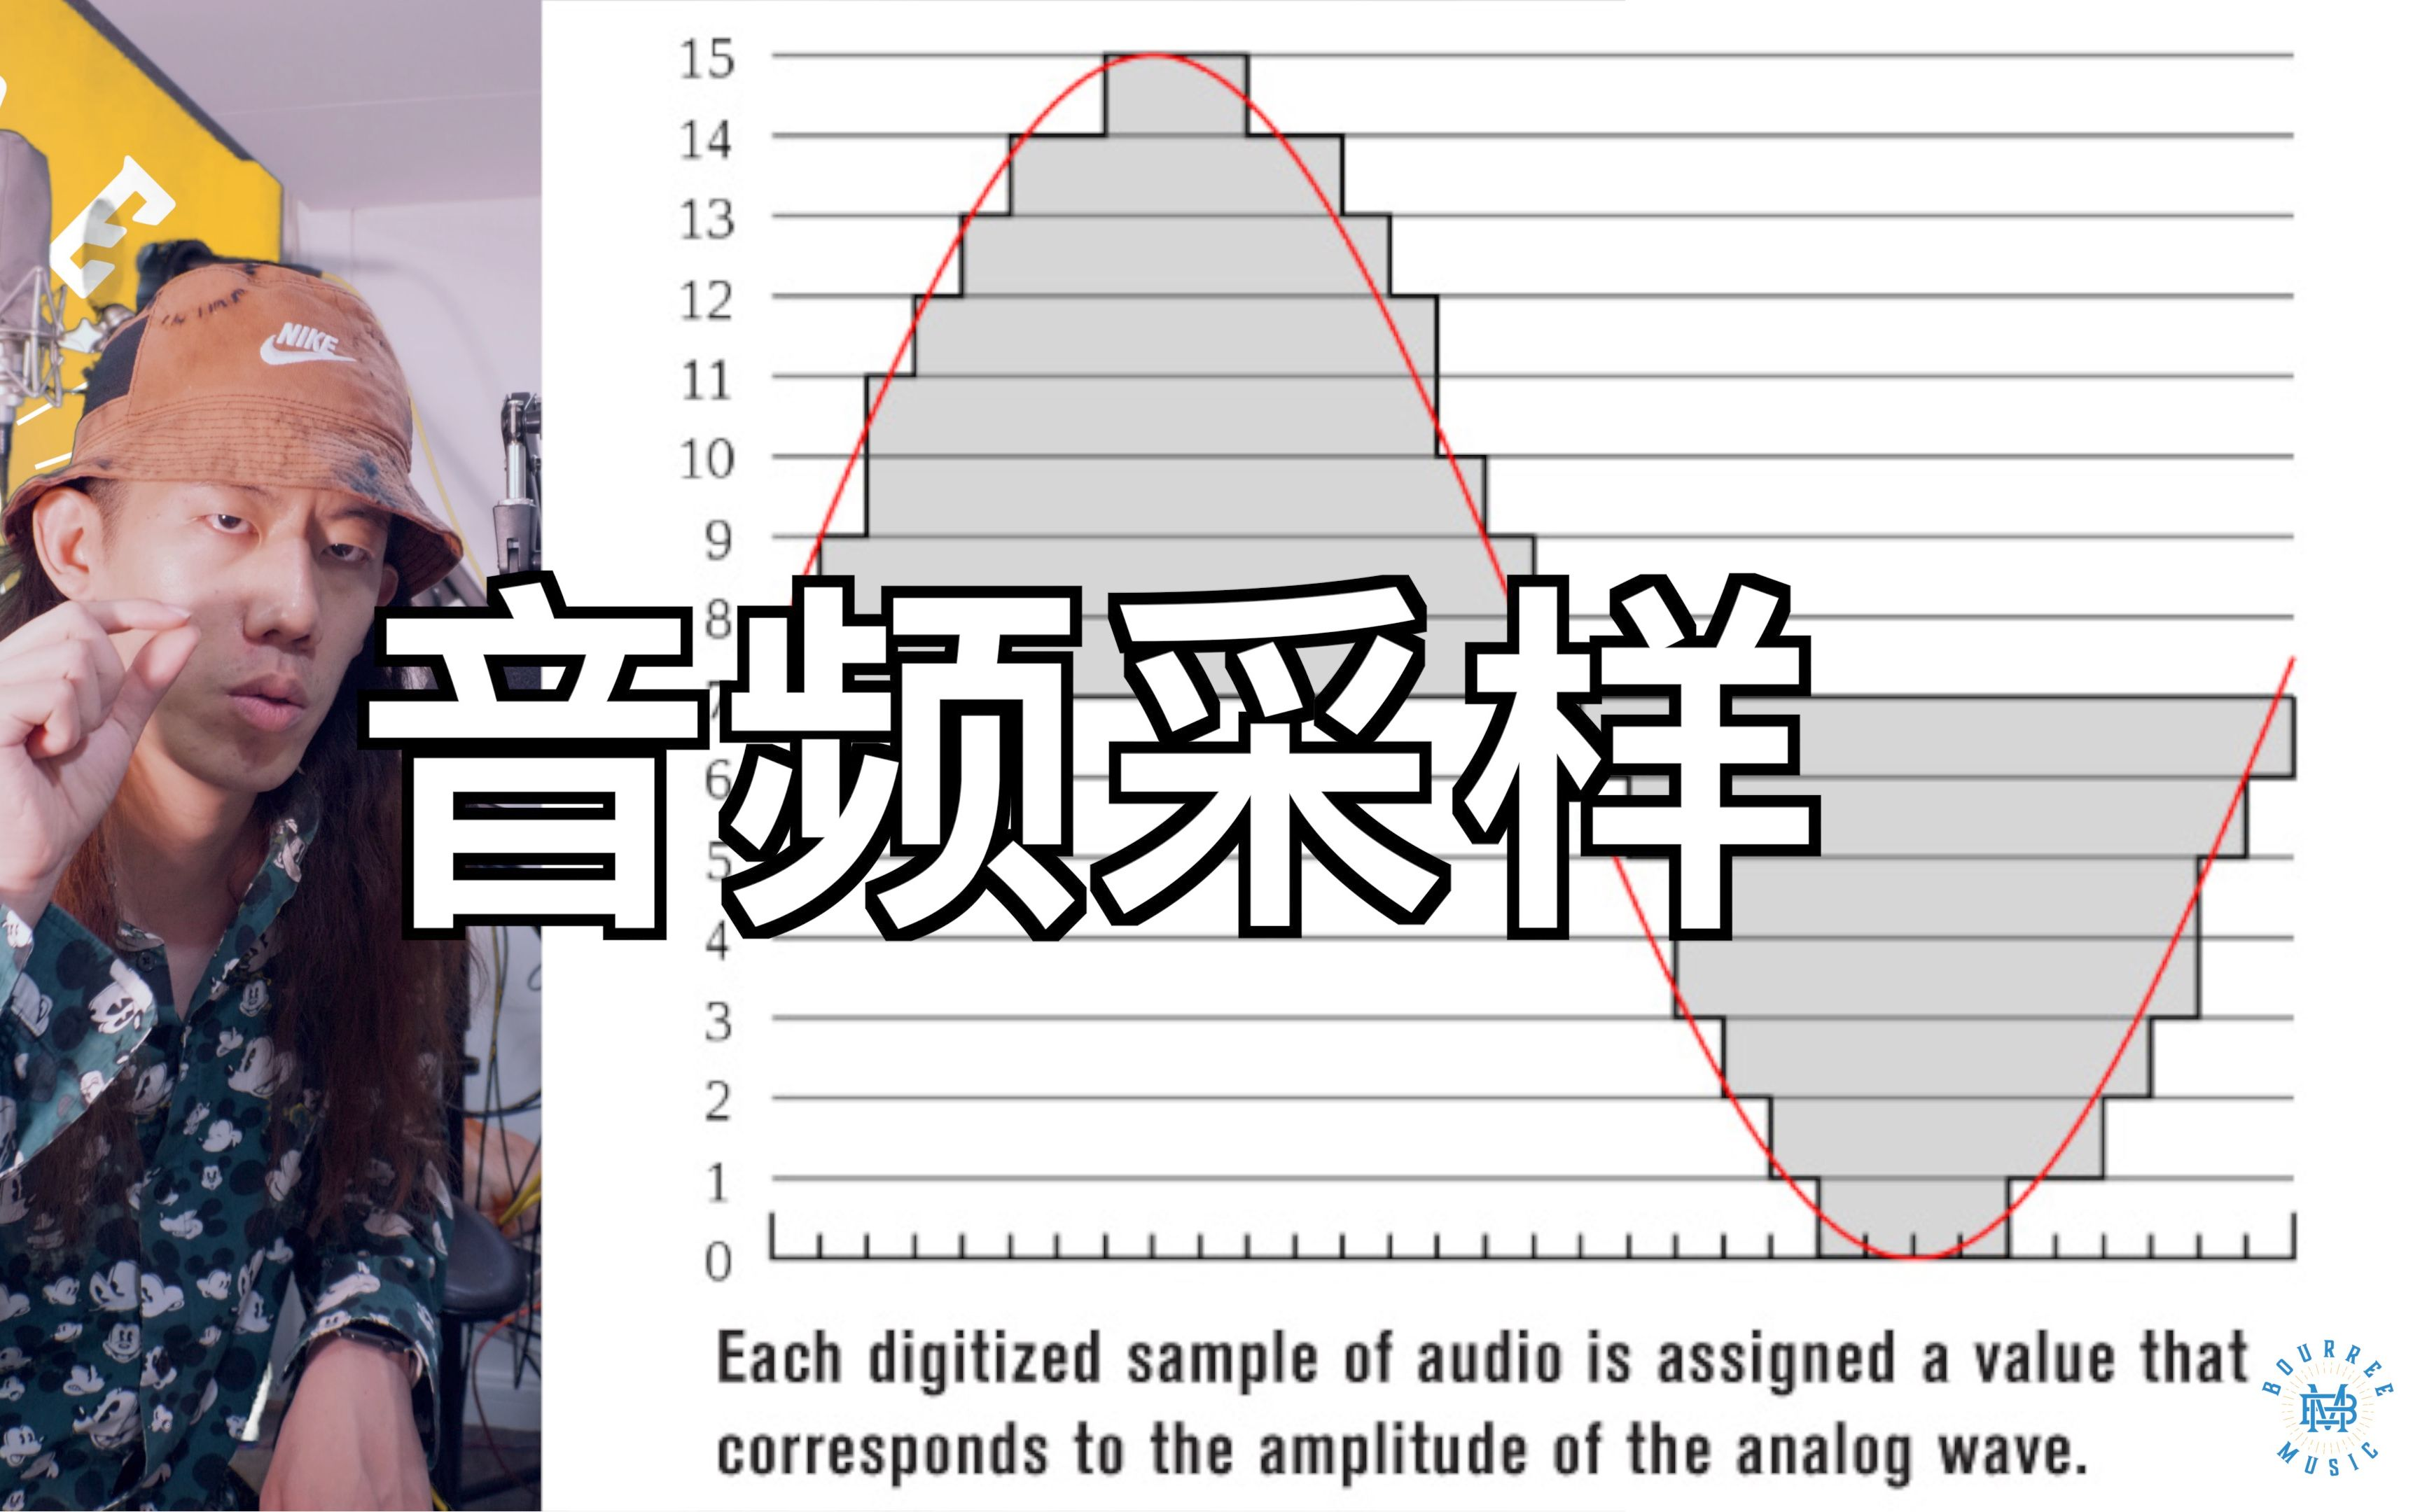
浏览器处理音频的入口是 Web Audio API,它通过 `AudioContext` 管理解码后的音频数据。问题在于,`AudioContext` 会把整段音频解码为 PCM 浮点缓冲区——一首 44.1kHz/16bit 立体声的 4 分钟歌曲,解码后占用约 44.1kHz × 2 声道 × 2 字节 × 240 秒 ≈ 42MB。这个数字看起来不大,但手机浏览器的 AudioContext 可用堆内存通常只有 128-256MB,而且要和 DOM 渲染、JS 引擎、图片解码共享。
实际的限制在 Chromium 内核层:`AudioBuffer` 的最大长度受 `OfflineAudioContext` 的 `maxChannelCount` 和系统剩余内存双重约束。iOS Safari 更激进,WkWebView 对单个 AudioBuffer 的硬限制约为 4 通道 × 300 秒,超出直接抛 `NotSupportedError`。
限制二:Web Worker 与 WASM 得不到完整 CPU 配额
人声分离模型(如 Open-Unmix、Demucs)的核心计算是 STFT 变换和矩阵乘法,在桌面端通过 WebAssembly 编译到接近原生 70-80% 的性能。但手机端不同:Android 的 Chrome 对后台 Web Worker 做了 CPU 配额限制,前台页面也受到 DVFS(动态电压频率调节)的实时降频影响——手机一发热,大核直接掉到小核频率,WASM 算力骤降 50% 以上。
iOS 更特殊:Safari 的 Web Worker 不支持 `SharedArrayBuffer`(除非开启跨域隔离但很多站点不会配),这意味着模型权重无法在主线程和 Worker 之间零拷贝共享,每次推理都要走 `postMessage` 序列化,4MB 的模型权重传一次就要几十毫秒。
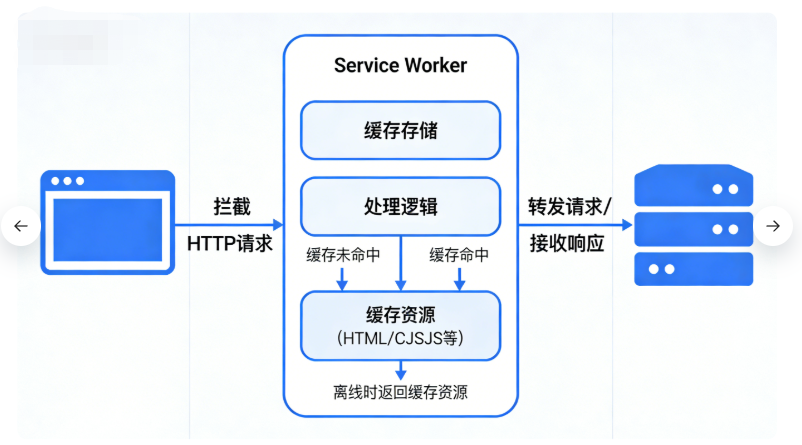
限制三:模型文件加载被 Service Worker 缓存策略拖慢
在线分离工具的模型文件通常 10-50MB,第一次加载需要下载到本地。桌面端可以走浏览器的磁盘缓存,二次访问秒开。手机端不同:iOS Safari 的磁盘缓存上限是 50MB(有争议,实测约 50-80MB),超出后 LRU 淘汰;Android Chrome 虽然上限更高,但 ROM 剩余空间不足时系统会主动清理应用缓存。
更隐蔽的问题是 Service Worker 的 Cache API 在手机上的行为——Chromium 内核在低存储空间下会静默拒绝缓存写入,不报错,`cache.put()` 返回的 Promise 正常 resolve,但数据没写进去。下次访问还要重新下载。
限制四:AudioContext 的采样率被系统重采样绑架
桌面浏览器的 `AudioContext.sampleRate` 通常是声卡原生采样率(44.1kHz 或 48kHz)。手机端不同:Android 的 AudioFlinger 混音器强制所有音频流走 48kHz 重采样,iOS 的 Core Audio 也是 48kHz。这意味着你上传 44.1kHz 的 MP3,浏览器解码后必须经过一次系统级重采样才能喂给 AudioContext,而重采样引入的相位偏移(尤其是低通滤波器截止频率附近的纹波)会直接影响分离模型的输入质量。
更坑的是,`OfflineAudioContext` 的采样率可以指定,但指定后引擎内部还是走 48kHz 再转回来——等于在 44.1→48→44.1 的路径上白白损失两次精度。
限制五:文件系统隔离让"上传-处理-下载"链路断裂
桌面端拖拽文件到浏览器,浏览器可以保持对文件的引用,用 `FileReader` 分块读取,不占内存。手机端不同:iOS 的文件选择器返回的是沙盒化副本,原文件路径不可见;Android 的 Storage Access Framework 也类似。这意味着整个音频文件必须先完整加载到内存中的 `ArrayBuffer`,再解码为 `AudioBuffer`——两倍内存占用,直接吃掉 80-100MB。
更糟糕的是处理结果的下载:iOS Safari 不支持 `Blob` URL 的持久化下载,`URL.createObjectURL` 创建的链接在页面刷新后即失效。如果处理过程中页面被杀后台(iOS 的 Jetsam 机制在内存压力下会优先杀浏览器标签页),结果文件直接丢失。
限制六:深度学习推理的浮点精度被移动 GPU 阉割
桌面端 WASM 可以用 Float32 做推理。手机端 GPU 的 WebGL 2.0 计算着色器(Compute Shader)支持有限,很多手机只支持到 Float16 精度。Float16 的尾数只有 10 位,做矩阵乘法时累积误差在 1024 维向量上可达 0.01 量级——对于音频分离这种需要精确频域处理的场景,累积误差会导致输出出现可闻的量化噪声。
更底层的问题是:移动 GPU 的 WebGL 实现通常不支持 `OES_texture_float` 扩展的线性过滤,只能用最近邻采样,这对频域特征的插值精度是灾难性的。
落地方案:手机端分离的正确姿势
如果你的场景必须用手机,有一条务实路径:
第一步,把长音频在手机上用系统自带裁剪工具切成 30-60 秒的片段。分段处理不仅绕开内存限制,还能让你对每段单独调整参数——比如前奏段用普通分离,副歌段上深度分离。
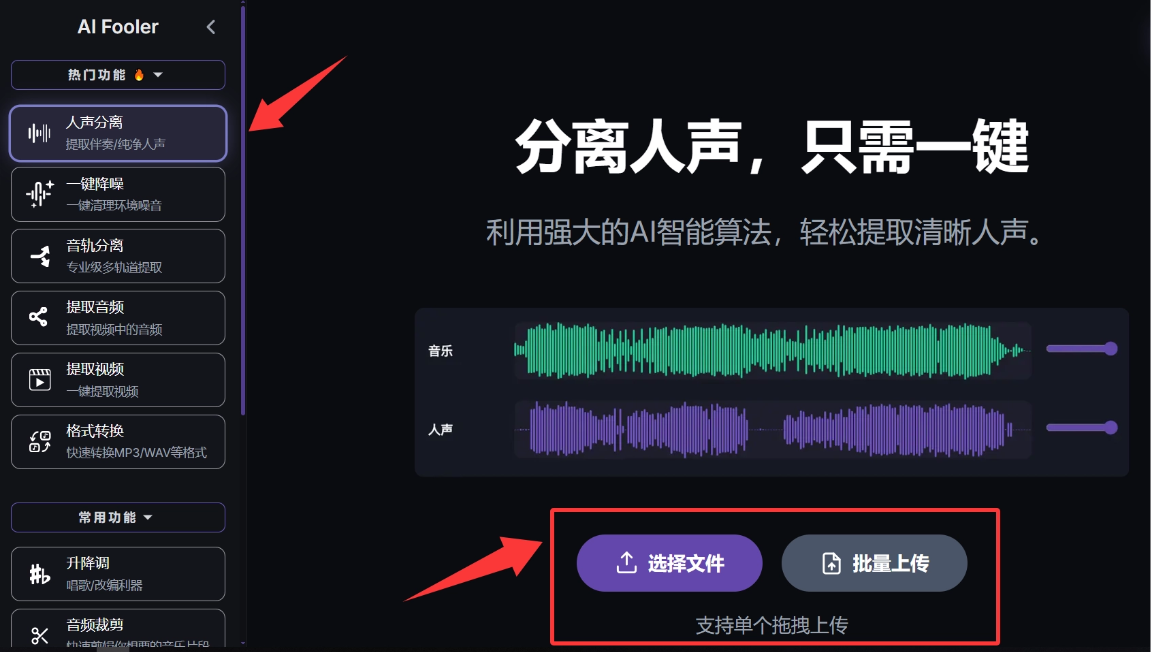
第二步,用网页端的人声分离工具处理这些片段。网页端直用意味着不需要安装 App、不用注册账号、没有次数限制。处理完一段就下载,清空浏览器缓存再处理下一段,避免累积内存占用。上传的音频文件 24 小时后自动删除,隐私方面也不必担心。
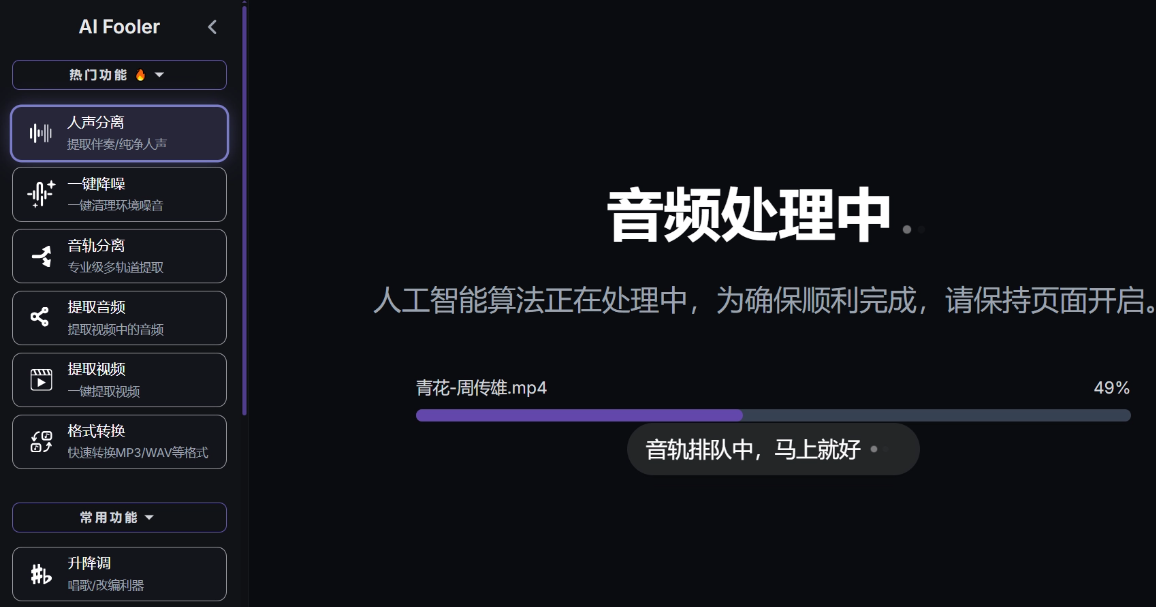
你可以在 在线音频处理平台 上完成这个流程。对于需要更精细操作的场景,比如想单独提取鼓轨或贝斯轨,可以用 AI人声提取工具 做多轨分离——但这一步建议回到桌面端操作,手机端处理多轨分离的时间和内存开销不划算。
第三步,把分段结果在手机端用音频拼接工具合并。拼接时注意咬合点选在静音段,避免相位跳变。
这条路径本质上是用"分治"策略绕开手机浏览器六大限制中的内存和 CPU 两大瓶颈。你把一个大问题拆成多个小问题,每个小问题都落在手机能处理的范围内。
认知收尾
手机的浏览器不是不能用,而是它的每一层——从操作系统内核到浏览器引擎再到 Web API——都在为了功耗和稳定性做减法。理解这些减法在哪里砍了你的音频处理精度,比找"手机上最好用的分离工具"更有价值。知道什么能做、什么做不了,比盲目尝试少踩坑。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 13
 0
- 0


 已为社区贡献1条内容

所有评论(0)