901-004_系统分析师基础知识-计算机系统
| 模块 | 必须掌握的内容 | 常见题型 |
|---|---|---|
| 计算机系统概述 | 层次结构、冯·诺依曼结构、硬件/软件/固件 | 概念判断、结构识图 |
| 存储器系统 | RAM/ROM、DRAM/SRAM、磁盘、RAID、Cache、NAS/SAN、虚拟存储 | 对比题、容量/平均访问时间计算 |
| 输入输出系统 | 程序查询、中断、DMA、通道、总线、接口、端口编址 | 机制比较、带宽计算 |
| 指令系统 | 指令类型、特权指令、CISC/RISC、流水线和性能公式 | 对比题、性能分析 |
| 多处理机系统 | SIMD/MIMD、SMP/MPP、UMA/NUMA/COMA、互连网络 | 体系结构辨析、互连函数 |
| 操作系统 | OS 功能、进程/PV、死锁、存储管理、页面置换、设备/文件管理、作业调度 | 综合题、算法题、公式题 |
1 计算机系统概述
1.1 计算机系统层次结构
计算机系统由硬件系统和软件系统组成,按照抽象程度通常分为硬件层、系统层和应用层。上层通过下层提供的接口使用下层功能,从而屏蔽实现细节。
计算机系统通常划分为三级层次结构:
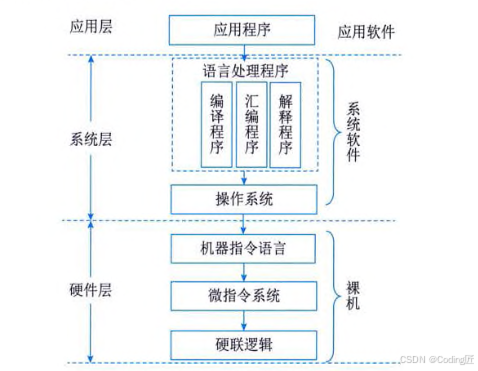
| 层次 | 细分 | 说明 |
|---|---|---|
| 硬件层(裸机) | 硬联逻辑级 | 计算机的内核,由门电路、触发器等逻辑电路组成 |
| 微程序级 | 机器语言是微指令集 | |
| 传统机器级 | 机器语言是该机的指令集 | |
| 系统层(系统软件) | 操作系统级 | 管理计算机系统中的软硬件资源 |
| 语言处理程序级 | 将高级语言或汇编语言编写的程序翻译成机器语言程序(编译程序、汇编程序、解释程序) | |
| 应用层(应用软件) | 应用程序 | 面向实际用户的各种应用软件 |
⭐ 常考点:层次结构从下到上的顺序:硬联逻辑 → 微程序 → 传统机器 → 操作系统 → 语言处理程序 → 应用程序
易考辨析:编译程序、解释程序、汇编程序区别
- 编译程序把源程序整体翻译成目标程序后再执行;
- 解释程序通常逐条翻译、边解释边执行;
- 汇编程序把汇编语言翻译为机器语言。
1.2 计算机系统硬件
- 冯·诺依曼体系结构(1946年至今的基础架构):程序和数据以二进制形式存放在存储器中,CPU 按地址取指令、取数据并执行;指令和数据原则上统一存储、统一寻址。这种体系称为冯·诺依曼体系结构。
- 五大基本组成部件:
输入设备 ──> 主存储器 <──> CPU(运算器 + 控制器) ──> 输出设备
                 ^
                 └── 辅助存储器(外存,长期保存)
- 运算器:完成算术运算和逻辑运算。
- 控制器:取指令、分析指令并产生控制信号,协调各部件工作。
- ** CPU **:运算器、控制器以及相关寄存器等部件的集合,是硬件系统的核心,负责数据加工和控制。
- 存储器:是计算机系统中的记忆设备,分为内部存储器和外部存储器。
- “主存储器(内存)”:速度较高、容量相对较小,CPU 可直接随机读写;运行时保存程序、数据和中间结果。
- ”辅助存储器(外存)“:容量大、速度较慢,用于持久保存程序和数据;CPU 通常不能直接执行其中内容,需先调入主存。
- 输入设备:用于输入原始数据及各种命令。
- 输出设备:用于输出计算机运行的结果。
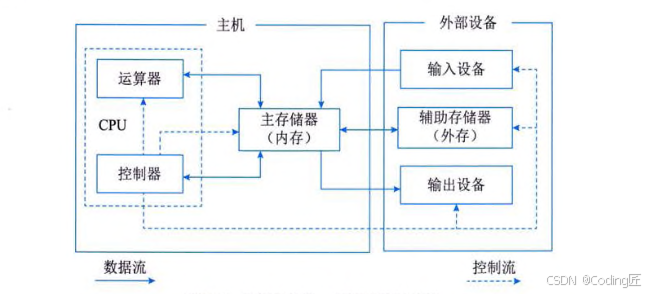
⭐ 重点概念:
- 运算器 + 控制器 = CPU(中央处理单元),是硬件系统的核心
- 存储器分为内存储器(速度快、容量小、临时存放)和外存储器(容量大、速度慢、长期保存)
- 输入设备 + 输出设备 = 外部设备(外设)
- 基于存储程序的原理
1.3 计算机软件系统
按照功能,计算机系统中的软件可以分为系统软件和应用软件两大类。
| 分类 | 说明 | 举例 |
|---|---|---|
| 系统软件 | 实现计算机系统的管理、调度、监视和服务等功能 | 操作系统、语言处理程序、服务性程序、数据库管理系统、计算机网络软件 |
| 应用软件 | 为解决某种应用问题而编制的程序 | 财务管理软件、项目管理软件等 |
⭐ 重要概念——固件:
- 存储在能永久保存信息的器件(EPROM或EEPROM)中的程序
- 是具有软件功能的硬件
- 性能指标介于硬件与软件之间:执行速度快于软件,灵活性优于硬件
2 存储器系统
存储器用于保存程序和数据,是实现“存储程序控制”的基础。传统存储层次如下:
速度快、容量小、成本高
        Cache(高速缓冲)
        主存储器(内存)
        辅助存储器(外存)
速度慢、容量大、成本低
数据常用的存取方式:
| 存取方式 | :完整定义 | 典型设备 |
|---|---|---|
| 顺序存取 | 必须按记录先后顺序访问,目标位置越远,等待时间通常越长 | 磁带 |
| 直接存取 | 可以直接定位到所需物理块,访问时间与块的先后顺序基本无关 | 硬盘 |
| 随机存取 | 对任意存储单元的访问时间基本相同 | RAM |
| 相联存取 | 按存储内容的一部分(标记)进行匹配查找,而不是按地址查找 | 相联存储器、全相联 Cache |
四个主要性能指标:
- 存取时间:从发出读/写命令到完成该操作所需的时间。
- 存储器带宽:单位时间内存储器能够传输的数据量。
- 存储器周期:连续两次独立存取操作之间允许的最小时间间隔,通常不小于存取时间。
- 数据传输率:实际数据传输速度,通常用
B/s表示。
2.1 主存储器:RAM、ROM、DRAM 和 SRAM
主存储器(Main Memory) 简称主存或内存,是计算机硬件的重要部件,其作用是存放计算机运行时的程序和数据,并能由CPU直接随机地进行读/写。
主存由 CPU 直接随机读写,按工艺分为随机存取存储器(Random Access Memory,RAM)和只读存储器(Read Only Memory,ROM)。
| 类型 | 完整定义及断电特性 | 典型用途 |
|---|---|---|
| RAM | 可读可写的随机存取存储器;通常断电后信息丢失 | 暂存运行中的程序和数据 |
| DRAM | 存储电荷会随时间泄漏,必须周期性刷新;容量大、成本低 | 计算机主内存 |
| SRAM | 只要持续供电即可保持信息,无需刷新;速度快、成本高、容量小 | Cache |
| ROM | 内容可随机读出,通常不能改写;断电后信息仍保留 | BIOS、专用子程序、控制存储器 |
易错:DRAM 的“动态”是指需要刷新,不是指断电后才丢失;SRAM 的“静态”也不表示断电不丢失,而是表示供电期间不需要刷新;RAM/ROM 的“随机”描述寻址方式,不等于掉电特性。
2.2 辅助存储器与磁盘容量
辅助存储器 简称辅存,用于存放需持久性存储的信息。其特点是存储器容量大、可靠性高、价格低。常用的辅存有磁带存储器、硬盘存储器、磁盘阵列和光盘存储器等。
- 磁带:顺序存取,容量大、便携、价格低,但访问速度慢。
- 硬盘存储器:简称硬盘,属于直接存取设备,即存取磁盘上任一物理块的时间不依赖于该物理块所处的位置。硬盘分为三类:机械硬盘(HDD)、固态硬盘(SSD)和混合硬盘(SSHD)。
- 机械硬盘(HDD):由盘片、驱动系统、读写系统和控制系统组成,属于直接存取设备。物理层次为记录面、圆柱面、磁道和扇区;地址可由驱动器号、柱面号、磁头号、扇区号组成。
- 固态硬盘(SSD):由闪存芯片阵列、主控和缓存组成,没有机械寻道,读取速度快,但价格较高、写入寿命需要关注。
- 混合硬盘(SSHD):HDD 与 SSD 的组合,用小容量闪存缓存常用数据,降低平均寻道时间。
机械硬盘常考公式:
格式化容量 C = n × t × s × b
	n:总记录面数;t:每面的磁道数;
	s:每道扇区数;b:每扇区字节数。
- 标称容量通常是格式化容量,约为非格式化容量的 60%–70%。
- 道密度:半径方向单位长度上的磁道数。
- 位密度:沿磁道方向单位长度记录的二进制位数。
- 平均存取时间由平均寻道时间、平均旋转等待时间和读写传输时间组成。若
T_s为平均寻道时间,T_r为磁盘旋转一周的时间,T_t为读写传输时间,则:T_a = T_s + T_r/2 + T_t。传输时间较小时,教材常近似为T_a ≈ T_s + T_r/2;这里的平均旋转等待时间是T_r/2,不是整圈时间T_r。 - 硬盘缓存用于缓解盘内介质与接口之间的速度不匹配。
光盘类型:
| 类型 | 定义 |
|---|---|
| CD-ROM | 厂商预写,用户只能读取,不能修改 |
| CD-R | WORM(Write Once Read Many),可写一次、可读多次,写后不可修改 |
| CD-RW | 可写、擦除和重写,可重复读写 |
| DVD-ROM | 原理类似 CD-ROM,但容量更大,可有单/双面、单/双层结构 |
- RAID 磁盘阵列
RAID(独立磁盘冗余阵列)用多个较小磁盘分布存储数据,支持并行 I/O,以提高性能、容量利用率和可靠性。主要技术包括分块、交叉和校验/重构;选择级别时要综合考虑冗余、性能和成本。
| 级别 | 核心机制 | 主要特点 |
|---|---|---|
| RAID 0 | 数据分块,无冗余、无校验 | 性能和空间利用率最高,但任一磁盘故障都可能导致数据丢失 |
| RAID 1 | 磁盘镜像 | 可靠性高,可从镜像恢复;空间利用率约 50% |
| RAID 2 | 海明码纠错 | 可单错纠正、双错检测;访问涉及全部磁盘,实际少用 |
| RAID 3 | 位交叉加独立奇偶校验盘 | 适合大块顺序传输;校验盘可能成为瓶颈 |
| RAID 4 | 块交叉加独立奇偶校验盘 | 支持独立存取和并行 I/O;校验盘写入压力大 |
| RAID 5 | 块交叉,校验信息分布在所有磁盘 | 无独立校验盘,避免单一校验盘瓶颈,可并行处理请求 |
| RAID 6 | 双重分布式校验 | 可容忍更高程度的磁盘故障,但校验开销和成本更高 |
| RAID 7 | 面向异步高 I/O 速率的改进级别 | 性能高、成本高,属于高档阵列 |
| RAID 10 | RAID 0 与 RAID 1 组合 | 兼顾条带化性能和镜像可靠性 |
速记:
0=只追求速度,1=镜像安全,5=分布式校验,10=性能+镜像。教材有时将 RAID 10 写为 RAID 0+1;工程上还要区分 RAID 10(1+0)与 RAID 0+1 的嵌套顺序。
2.3 高速缓冲存储器 Cache
Cache 位于 CPU 与主存之间,用少量高速存储器缓解两者速度差异。其有效性建立在程序局部性原理上:
- 时间局部性:某存储单元刚被访问,近期再次访问它的可能性较大,例如循环中的指令。
- 空间局部性:某存储单元被访问后,其邻近单元近期被访问的可能性较大,例如顺序执行的指令。
CPU 访问流程:先查 Cache;命中则直接取数;未命中则从主存取数,并把数据同时送入 CPU 和 Cache。
若 Cache 命中率为h,Cache 周期为t_c,主存周期为t_m,教材采用的平均存储周期为:
t_avg = h × t_c + (1 − h) × t_m
例:Cache 为 10 ns,主存为 100 ns,取指命中率 98%,取数命中率 95%,约五分之一指令还要取操作数,则每条指令平均访存时间为:
(2% × 100 + 98% × 10) + 1/5 × (5% × 100 + 95% × 10) = 14.7 ns
2.3.1 Cache 地址映射
主存和 Cache 被划分为大小相同的块。
| 映射方式 | 完整定义 | 优点 | 缺点 |
|---|---|---|---|
| 直接映射 | 每个主存块只能放入 Cache 的一个固定块,K = I mod C(I 为主存块号,C 为 Cache 块数) | 电路简单、成本低、速度快 | 多个主存块竞争同一位置,冲突多 |
| 全相联映射 | 任一主存块可放入 Cache 任一块,需要逐项比较标记 | 灵活、冲突少 | 比较器复杂、成本高,适合小容量 Cache |
| 组相联映射 | 先用直接映射确定组,再在组内用全相联选择块 | 灵活性与成本折中,工程中常用 | 设计和替换策略较复杂 |
组相联计算中,若 Cache 被分为 Q 组,主存块号为 I,则组号为 J = I mod Q;确定组后,在该组内按全相联方式选择 Cache 块。
2.3.2 替换算法与写策略
- 随机:实现简单,但命中率不稳定。
- FIFO:淘汰最早进入 Cache 的块。
- LRU:淘汰近期最少使用的块,通常命中率较好。
- 写直达(Write Through):写 Cache 的同时写主存,主存始终较新,但写主存次数多。
- 写回(Write Back):只更新 Cache,块被淘汰时才写回主存,速度快但需要 dirty/修改标志。
- 有效位:数据装入时置 1;有效位为 0 时不能使用该 Cache 块,必须访问主存。
2.4 网络存储技术
| 技术 | 定义与访问粒度 | 优点 | 局限/场景 |
|---|---|---|---|
| DAS (直接附加存储) | 通过 SCSI 等电缆直接连接服务器,通常依赖服务器完成管理;多为块级访问 | 结构简单,适合必须直接连接应用服务器的场景 | 距离、连接数和带宽受限,扩展困难;服务器故障会影响数据 |
| NAS (网络附加存储) | 类似专用文件服务器,经网络提供文件级访问,常用 NFS/CIFS | 与服务器分离、即插即用、管理方便、成本低,适合文件共享 | 受网络和文件协议影响,难以获得高端块级 I/O 性能 |
| SAN (存储区域网络) | 用专用高速网络连接服务器和磁盘阵列,采用块级存储 | 高性能、高可用、集中管理、可扩展,并与业务网络分离 | 架构复杂,建设和运维成本高 |
SAN 常见协议:
- FC SAN:基于光纤通道,带宽高、距离远、设备多,但需要专用适配器、交换机和布线,成本最高。
- IP SAN(iSCSI):在 TCP/IP 上封装 SCSI 命令,可使用普通以太网,部署成本较低;协议封装会占用带宽并增加主机负担。
- IB SAN:基于 InfiniBand 交换结构,支持高带宽、虚信道、远程 DMA、容错和热插拔。
2.5 虚拟存储
定义:把多个物理存储模块(硬盘、RAID 等)集中管理为统一存储池,将物理实体与逻辑表示分离。应用服务器只与分配给它的逻辑卷交互,不必知道数据落在哪个物理设备。
| 分类维度 | 类型 | 含义 |
|---|---|---|
| 拓扑结构 | 对称式 | 虚拟存储控制设备与存储软件、交换设备集成,并位于数据传输路径中 |
| 拓扑结构 | 非对称式 | 虚拟存储控制设备位于数据传输路径之外 |
| 实现原理 | 数据块虚拟 | 以块为单位,通过多端口并行减少冲突和延时,强调带宽 |
| 实现原理 | 虚拟文件系统 | 以文件共享为重点,通过站点访问权限保障安全 |
实现层级:主机级虚拟化由服务器卷管理软件完成,成本低;存储设备级虚拟化由存储控制器完成,常结合 RAID、缓存和复制;网络级虚拟化由 SAN 专用设备完成,可统一管理异构设备。主要收益是集中管理、负载均衡、兼容异构设备、支持镜像和快照,并解耦应用与物理存储。
3 输入输出系统
3.1 I/O 工作方式
I/O 系统由 I/O 设备、I/O 接口(控制器)和 I/O 控制管理软件组成。输入把外部信息送入计算机加工,输出把内部处理结果送到外部设备。
| 方式 | 工作机制 | CPU 占用与并行性 | 高频辨析 |
|---|---|---|---|
| 程序控制 | CPU 执行 I/O 程序,通过无条件传送或循环查询设备状态 | CPU 占用高,效率低 | 查询方式会忙等,硬件简单 |
| 程序中断 | 设备提出请求,CPU 保存现场,执行中断服务程序后返回 | CPU 不必持续等待,存在中断响应开销 | 请求、判优、响应、处理、返回五阶段 |
| DMA | DMA 控制器取得总线,直接在主存和外设之间成块传送 | 速度高,CPU 与外设可并行 | 暂停、共享、周期窃取三种总线获取方式 |
| 通道 | 专用 I/O 控制部件执行通道程序,CPU 负责启动、停止和状态管理 | CPU 介入更少,并行度更高 | 字节多路、选择、数组多路通道 |
| I/O 处理机 | 独立外围处理机执行 I/O,具有丰富指令和中断系统 | CPU 负担最低 | 还可做码制转换、校验、故障处理和诊断 |
CPU 参与程度大致为:程序查询 > 中断 > DMA > 通道 > I/O 处理机。
中断:当前程序执行中发生需要及时处理的请求,CPU 暂停当前程序并保护现场,转去执行服务程序,完成后恢复现场并返回原程序。多中断源可采用多中断线、软件查询、菊花链、总线仲裁和中断向量表等方法。
DMA:DMA 控制器(DMAC)与 CPU 共享系统总线并能独立访问主存。传送时 CPU 让出总线,DMAC 自动产生地址和读写控制信号,完成地址递增和计数,适合高速、批量数据交换。
三种总线获取方式:暂停方式是传送期间 CPU 暂停访问主存;共享/分时方式是 CPU 与 DMAC 分时使用总线;周期窃取方式是 DMAC 每次窃取一个存储周期传送数据,随后 CPU 继续运行。I/O 处理机还可与 CPU 共享主存,或使用独立局部存储器并异步工作。
通道类型:字节多路通道以字节交叉方式服务多台低速设备;选择通道一次选择一台设备并在一段时间内独占通道;数组多路通道兼有多路分时和成组高速传送能力。
3.2 总线
总线是一组供多个部件分时共享的公共信息传送线路。同一时刻只能有一个部件向总线发送,多个部件可以同时接收;多个发送者同时发送会产生冲突。
| 分类维度 | 类型 |
|---|---|
| 相对 CPU/芯片位置 | 内部总线、外部总线 |
| 传送功能 | 地址总线、数据总线、控制总线 |
| 微机系统位置 | 机内总线、机外总线 |
| 功用 | 局部总线、系统总线、通信总线 |
| 数据线数量 | 并行总线、串行总线 |
- 地址总线传送地址,数据总线传送数据,控制总线传送控制信号。
- 并行总线一次传送一个数据的多位,速率高但线缆多、距离受限;串行总线逐位传送,适合远距离和高速差分通信。
- 总线标准规定机械、功能、电气和时间规范,正式标准可由 IEEE 等组织确定,事实标准通常由厂商提出后被广泛采用。
主要性能指标:总线宽度、总线带宽、总线负载、分时复用和猝发传输。
同步总线带宽 = 每周期传输的字节数 × 总线频率
(宽度以 bit 表示时,先除以 8)
例:每个总线周期传送 4 B,占 2 个时钟周期,时钟频率为 10 MHz,则总线周期为 0.2 μs,带宽为 4 / 0.2 μs = 20 MB/s。
即插即用、热插拔、多主控、错误检测和对特定 CPU 的依赖性,也常作为评价总线的指标。
3.3 I/O 接口、串行通信与端口
I/O 接口(I/O 控制器)是主机与外设之间的界面,用于屏蔽双方在速度、时序和信息格式上的差异。五项核心功能为:
- 通信联络控制:协调主机与外设的时序。
- 地址译码与设备选择:把 CPU 发来的设备地址译码为选择信号。
- 数据缓冲:暂存数据,防止速度不同导致丢失。
- 数据格式变换:如并/串转换、数/模转换。
- 控制命令与状态传递:命令寄存器发启动命令,状态寄存器返回“准备好”等状态,并传递中断/DMA 请求和响应。
| 串行通信方式 | 同步机制 | 特点 |
|---|---|---|
| 异步通信 | 每个字符增加开始位和停止位 | 字符间隔可任意,设备简单便宜,效率较低 |
| 同步通信 | 收发双方同频同相,报文前附同步字符 | 建立同步后连续传输,效率较高 |
常见接口识别:IDE/EIDE、ATA 是传统并行磁盘接口;SATA 是串行硬盘接口并支持热插拔;SCSI 可视为多设备共享总线;IEEE-1394 支持菊花链或树状连接;USB 是可热插拔的串行总线,最多可连接 127 个设备。
端口是接口电路中 CPU 可直接访问的寄存器,通常有数据端口、命令端口和状态端口。端口编址有两种:
- 独立编址(I/O 映射):端口地址空间与主存地址空间分开,使用专门的 I/O 指令;不占用主存地址空间,但指令种类增加。
- 统一编址(存储器映射):端口与主存单元统一编址,把端口当作存储单元,用普通数据传送指令访问;指令统一,但占用主存地址空间。
4 指令系统
4.1 定义、实现选择与设计要求
指令是指示计算机执行某种操作的命令;一台计算机的全部指令集合称为指令系统(指令集)。指令系统是软件和硬件的主要分界面,目标程序最终由机器指令组成,通常由软硬件设计人员共同确定。
| 实现方式 | 速度 | 成本 | 灵活性 |
|---|---|---|---|
| 硬件指令 | 快 | 高 | 差 |
| 软件子程序/微程序 | 慢 | 低 | 好 |
设计要求:
- 完整性:具备通用计算机完成基本任务所需的各种基本指令类型。
- 规整性:包括对称性和均匀性。相关寄存器、操作码和数据类型应遵循一致规则。若有 5 种数据表示、4 种字长和 8 种有效存储设备组合,两地址加法指令可有
5 × 4 × 8 = 160种形式。 - 高效率:高频指令应执行快;低频且复杂的功能可用微程序实现,降低硬件复杂度。
- 兼容性:新系统尽量兼容既有系统软件和应用软件,保证可继承性。
4.2 五类基本指令 [高频]
| 类型 | 完整定义与作用 | 常见内容 |
|---|---|---|
| 数据传送 | 在寄存器与寄存器、寄存器与主存、主存单元之间传送数据 | 一般传送、堆栈操作、数据交换 |
| 运算 | 对数据进行算术、逻辑和移位处理 | 算术移位、逻辑移位、循环移位 |
| 程序控制 | 控制程序执行顺序,使程序能够测试、判断和循环 | 无条件/有条件转移、调用与返回、循环控制 |
| I/O | 传送 I/O 数据、发控制命令、读取设备状态 | 多用户环境下通常属于特权指令 |
| 处理机控制与调试 | 设置处理机状态,管理系统资源和进程,支持程序调试 | 管态可执行特权指令,用户态只能执行一般指令 |
4.3 CISC 与 RISC [高频、难点]
**CISC(复杂指令系统计算机)**把许多原本由软件完成的复杂功能直接设计成硬件指令,以增强单条指令的功能。典型特点是指令多、寻址方式多、指令长度可变、可直接处理主存数据、控制器多采用微程序控制。
“80–20 规律”指约 20% 的简单高频指令占约 80% 的执行时间。对目标程序进行统计和优化,可以把高频指令串合并成一条新指令,以减少时间和空间开销。
**RISC(精简指令系统计算机)**不是简单删除指令,而是用少量、规整、高频指令换取更简单的硬件结构、更少的平均周期和更容易实现的流水线。
| 对比项 | CISC | RISC |
|---|---|---|
| 指令 | 多、功能复杂 | 少、选择高频简单操作 |
| 访存 | 许多指令可直接访问主存 | Load/Store:只有 LOAD、STORE 访问主存,其余运算在寄存器间完成 |
| 寻址方式 | 多,约 5–20 种 | 少,常见寄存器、立即数、相对寻址 |
| 指令格式 | 变长、种类多 | 定长、格式少且规整,易译码 |
| 控制器 | 微程序控制为主 | 硬布线控制为主,固件为辅 |
| 执行和流水线 | 多周期,流水线较难 | 多数指令可单周期,便于流水线 |
| 寄存器与编译器 | 寄存器相对少,硬件承担功能较多 | 通用寄存器多,依赖优化编译器 |
程序执行时间公式:
P = I × CPI × T
P:程序执行总时间;I:动态执行的指令条数;
CPI:平均每条指令的周期数;T:一个时钟周期时间。
RISC 可能使 I 增加,但通过降低 CPI、缩短周期时间 T 和便于流水线来获得整体性能优势。
RISC 关键技术包括延迟转移、指令取消、重叠寄存器窗口和指令流调整。延迟转移在转移指令后填入有效指令;指令取消用于无法安排有效指令时清除错误预取;重叠寄存器窗口减少过程调用时的参数搬移;指令流调整由编译器重排指令、消除数据相关以保持流水线充满。
5 多处理机系统
5.1 多处理机与 SIMD/MIMD
多处理机含两个或更多处理机,共享 I/O 子系统,在操作系统统一控制下,通过共享主存或高速通信网络通信并协同完成任务。多处理机典型属于 MIMD;并行处理机典型属于 SIMD。
| 比较维度 | SIMD 并行处理机 | MIMD 多处理机 |
|---|---|---|
| 结构 | 处理单元固定,适合数组/向量算法 | 通用性强,互连和资源管理更复杂 |
| 并行层次 | 操作级/数据级并行 | 任务级/程序段并行 |
| 任务派生 | 指令本身驱动多个处理单元 | 需专门机制表达并发关系、派生任务 |
| 同步 | 同一控制器发指令,天然同步 | 各处理机进度不同,需显式同步 |
| 调度资源 | 处理单元数固定 | 资源和任务需求动态变化,需要操作系统调度 |
5.2 共享存储、分布式存储与 MPP
| 模型 | 完整定义 | 优点 | 局限 |
|---|---|---|---|
| 共享存储(SM) | 处理机通过互连网络访问公共共享存储器,可另带局部存储器或 Cache | 统一地址空间,编程和资源管理简单,适合细粒度并行 | 共享资源争用,处理机数扩展有限;SMP 属于此类 |
| 分布式存储(LM) | 每个处理机拥有本地存储器,通过网络和消息交换数据 | 松耦合、结构灵活、易扩展,适合粗粒度并行;MPP 属于此类 | 不能直接访问远程存储器,通信和数据划分复杂 |
**MPP(海量并行处理)**通常指拥有数百或数千个处理机、采用分布式存储的大规模并行系统。SVM/DSM 把物理上分散的本地存储器在逻辑上统一编址,形成可由任一处理机访问的虚拟共享地址空间。
SVM/DSM 可由硬件、操作系统/库或编译器实现:硬件方案速度快但增加专用部件;操作系统/库方案利用虚拟存储实现共享和一致性;编译器方案灵活但对程序员和编译器要求高。
5.3 SMP 存储模型和 S2MP
| 模型 | 完整定义 | 访问特性 |
|---|---|---|
| UMA | 所有处理机均匀共享物理存储器 | 访问任一存储位置的时间基本相同 |
| NUMA | 共享地址空间分布在各结点的局部存储器上 | 访问本地存储器快,访问远程存储器慢 |
| COMA | NUMA 的特例,用分布式 Cache 取代分布式主存,所有 Cache 构成全局地址空间 | 远程访问依赖目录,结点没有传统主存层次 |
**S2MP(可扩展共享存储多处理机)**用硬件 Cache 缓存共享数据和私有数据,保持共享编程模型并提高扩展能力。本质上是 NUMA:每个结点由处理机和邻近存储器组成,处理机数增加时存储带宽也可扩展,适合细粒度应用。
5.4 互连网络 [难点]
互连网络连接处理部件、存储模块和外设,使各部件在软件控制下通信。主要指标是连接度、延时性、带宽、可靠性和成本。
| 互连函数 | 定义 | 4 位地址 1011 的例子 |
|---|---|---|
| 恒等 | 输入端与同编号输出端连接,地址不变 | 1011 -> 1011(11) |
| 交换 | 翻转最低位 bit 0 | 1011 -> 1010(10) |
方体 Cube_k | 翻转第 k 位;教材例 Cube_3 翻转最高位 | 1011 -> 0011(3) |
| 均匀洗牌 | 二进制地址循环左移一位 | 1011 -> 0111(7) |
| 蝶式 | 交换最高位和最低位 | 1011 -> 1110(14) |
| 位序颠倒 | 将所有二进制位次序反转 | 1011 -> 1101(13) |
互连方式的权衡:总线最简单但争用最严重;交叉开关争用最低但连接复杂度最高;开关枢纽由仲裁单元处理冲突、开关单元完成连接;多端口存储器把仲裁逻辑移到存储器;多级互连网络是总线和交叉开关的折中,模块化扩展性好但延时随级数增加。
6 操作系统
6.1 定义、特征、功能与类型
**操作系统(OS)**是有效组织和管理软硬件资源、组织计算机工作流程、控制程序执行,并向用户提供工作环境和友好接口的一组系统软件;其本质是计算机系统的资源管理者。
两个作用:通过资源管理提高系统效率;改善人机界面,提供友好工作环境。
四个基本特征:
- 并发性:多个程序在同一时间间隔内推进;单处理机上通常是交替执行,多处理机上可以真正同时执行。
- 共享性:多个并发进程共同使用系统资源,包括互斥共享和同时访问。
- 虚拟性:利用技术把物理实体变成逻辑上更多、更快或更方便的资源,例如虚拟存储和 SPOOLing。
- 不确定性:进程执行顺序、资源分配和运行时间受并发事件影响,不能简单预先确定。
五项核心功能:处理机/进程管理、存储器管理、设备管理、文件管理和用户接口。设备管理还包括设备分配、传输控制和设备独立性;文件管理包括空间分配回收、目录、文件操作和保护。
| 类型 | 定义与重点 |
|---|---|
| 批处理 OS | 将多个作业成批提交并自动处理,用户交互性较弱 |
| 分时 OS | 把 CPU 划分为短时间片轮流服务多个终端,具有多路性、独立性、交互性和及时性 |
| 实时 OS | 对随机外部事件在被控对象允许的时间内及时响应;分为实时控制和实时信息处理 |
| 网络 OS | 通过软件和协议共享网络资源,提供通信、文件、打印、邮件、安全和互操作服务;有集中式、客户机/服务器、对等模式 |
| 分布式 OS | 管理多个无主从之分、可通信协作的计算机,进行资源动态分配、任务划分和并行协调,强调透明性、可靠性和高性能 |
| 嵌入式 OS | 运行在嵌入式芯片中,统一控制芯片及其部件;具有微型化、可定制、实时性、可靠性和易移植性,常用 HAL/BSP |
分时与实时的区别:分时系统是多用户通用系统,交互能力强,以用户可接受的等待时间为设计依据;实时系统多为专用系统,交互性较弱,以被控对象允许的延迟上限为依据,对响应时间更敏感。
互联网环境下的 OS 还应支持自主配置与自适应协调、跨网络互连互通协作、异构资源共享管理、功能/性能/可信性动态演化,以及私密性、防卫性、可靠性、安全性和可用性。
6.2 进程管理、PV 与死锁
6.2.1 程序顺序执行与并发执行
前驱图是有向无环图,结点表示程序段,有向边 P_i -> P_j 表示 P_i 完成后 P_j 才能执行。程序顺序执行具有顺序性、封闭性和可再现性;并发执行会失去封闭性,程序与机器执行活动不再一一对应,并发程序间存在相互制约。
进程是程序的一次执行,通常由 PCB、程序和数据组成:
- **PCB(进程控制块)**记录进程状态、资源和调度等信息,是进程存在的唯一标志。
- 程序描述进程要完成的功能;可被多个进程共享时应使用不可修改的可再入纯代码。
- 数据包括运行所需数据和工作区,通常是进程独占且可修改的部分。
6.2.2 进程状态
                 被调度
       +--------------------------+
       |                          v
   就绪 ----------------------> 运行 -----> 终止
     ^       时间片到             | 结束/等待 I/O 或事件
     |                            v
     +--------- 事件发生 -------- 阻塞
- 运行:正在占用处理机;单处理机同一时刻最多一个运行进程。
- 就绪:除处理机外的资源都已获得,得到 CPU 即可运行。
- 阻塞:等待 I/O 或其他事件,即使获得 CPU 也不能运行。
- 五态模型在三态模型基础上增加新建和终止。
6.2.3 信号量与 PV
信号量是不可分割执行的整型同步原语。公用信号量主要用于互斥,初值通常为 1 或资源数;私用信号量主要用于同步,初值通常为 0 或正整数。
P(S):S = S - 1;若 S < 0,则阻塞当前进程并进入等待队列
V(S):S = S + 1;若 S <= 0,则唤醒一个等待进程并使其进入就绪队列
互斥模板:
P(mutex)
临界区
V(mutex)
生产者–消费者问题(缓冲区容量为 n):
初值:mutex = 1,empty = n,full = 0
生产者:生产 -> P(empty) -> P(mutex) -> 放入缓冲区 -> V(mutex) -> V(full)
消费者:         P(full)  -> P(mutex) -> 取出缓冲区 -> V(mutex) -> V(empty) -> 消费
先申请 empty/full,再申请 mutex,可以避免占有互斥锁后等待空槽或产品。PV 操作属于低级通信原语;高级进程通信还包括共享存储、消息传递和管道。
6.2.4 死锁 [高频、难点]
死锁是两个或多个进程互相等待对方已经占有的资源,导致所有相关进程都无法继续运行的状态。四个必要条件必须同时满足:
- 互斥:资源一次只能由一个进程使用。
- 不剥夺:进程已占用的资源不能被强制收回。
- 请求与保持:进程持有已有资源的同时继续请求其他资源。
- 环路等待:存在进程–资源的循环等待链。
| 处理策略 | 核心做法 | 特点 |
|---|---|---|
| 鸵鸟策略 | 忽略死锁 | 实现最简单,适合死锁极少且处理成本高的场景 |
| 预防 | 静态限制资源请求,破坏至少一个必要条件 | 降低并发度和资源利用率;一次性申请全部资源破坏请求与保持,按序申请破坏环路等待 |
| 避免 | 每次分配前检查是否仍存在安全序列,典型是银行家算法 | 需要预知最大需求;不安全状态不等于已经死锁 |
| 检测与解除 | 允许死锁发生,周期检测,发生后剥夺资源或撤销进程 | 可能先发生死锁,再付出恢复代价 |
银行家算法要点:只有在分配后系统仍存在一个能让所有进程依次完成的安全序列时,才批准请求。安全状态表示存在安全序列;不安全状态表示不能保证避免死锁,但不一定已经发生死锁。
6.2.5 线程
线程是进程内的轻量级执行实体,是独立调度和分配的基本单位;进程是资源拥有和保护的基本单位。线程只拥有程序计数器、寄存器和栈等少量运行资源,与同一进程的其他线程共享代码、数据和文件等资源。用户级线程由线程库管理,内核级线程由内核管理;线程同样具有就绪、运行和阻塞状态。
6.3 存储器管理
存储器管理负责内存分配、回收、保护和扩充。主要方案包括分区、分页、分段、段页式和虚拟存储。
| 方案 | 定义 | 主要问题 |
|---|---|---|
| 固定分区 | 静态把内存划成若干分区,每个分区装一个作业 | 实现简单,容易产生内部碎片 |
| 可变分区 | 按作业需要动态划分分区 | 容易产生外部碎片 |
| 可重定位分区 | 移动已分配分区、合并空闲区 | 可减少外部碎片,但需要地址重定位 |
| 分页 | 把逻辑空间划为固定大小的页,把物理空间划为同样大小的块,页可离散装入 | 对用户透明,页表开销和内部碎片需关注 |
| 分段 | 按程序逻辑划分为长度可变的段,每段在内存中连续 | 逻辑性好,但外部碎片和段表管理较复杂 |
| 段页式 | 先按逻辑分段,再把每段划成固定大小的页 | 兼顾逻辑组织和离散分配,但需多级表查找 |
分页地址变换:逻辑地址为 (页号 P, 页内地址 W),页表记录 P -> 物理块号 b。检查 P 是否越过页表长度;合法时物理地址为 b 与 W 的拼接,即 b × 页大小 + W。
分段地址变换:逻辑地址为 (段号 S, 段内位移 d),段表项含基址 base 和段长 limit。先检查段号,再检查 d < limit;合法时物理地址为 base + d。
段页式地址变换:逻辑地址为 (段号 S, 页号 P, 页内地址 W),先由段表找到该段页表,再由页表找到物理块,最后将物理块号和页内地址拼接。
| 项目 | 分页 | 分段 | 段页式 |
|---|---|---|---|
| 划分依据 | 固定大小的页 | 程序逻辑段,长度可变 | 先分段,再分页 |
| 地址表 | 页表给物理块号 | 段表给基址和段长 | 段表指向页表,页表给物理块号 |
| 物理地址 | 块号 + 页内地址 | 基址 + 段内地址 | 块号 + 页内地址 |
虚拟存储:只把进程当前需要的部分装入主存,其余留在外存,按需调入并置换,从逻辑上扩充主存容量。其逻辑容量受主存容量、外存容量和 CPU 可寻址范围共同限制,运行速度接近主存但低于纯内存访问。实现形式有请求分页、请求分段和请求段页式。
工作集 w(t, Δ) 是进程在时间窗口 Δ 内实际访问的页面集合。分配给进程的物理块过少会导致频繁换入换出,CPU 大量时间用于页面置换,形成抖动/颠簸(Thrashing)。
页面置换算法:
| 算法 | 完整定义 | 性质与陷阱 |
|---|---|---|
| OPT | 淘汰未来最长时间不再访问或永不访问的页 | 性能最好,但不能预知未来,只用于评价其他算法 |
| FIFO | 淘汰进入主存最早、驻留时间最长的页 | 简单但性能通常较差,存在 Belady 异常 |
| LRU | 淘汰最近最久未访问的页 | 通常性能较好,需要访问时间、寄存器或栈等支持 |
| NUR | 用访问位近似 LRU;优先淘汰访问位为 0 的页,遇 1 则清零后跳过 | 实现开销较小,但精度低于 LRU |
Belady 异常:对 FIFO 等算法,增加分配的页框数后,缺页次数有时反而增加。OPT 理想但不可实现;LRU 关注最近使用时间;FIFO 只关注进入主存的先后。
6.4 设备管理与磁盘调度
设备管理目标是提高设备利用率和 CPU/I/O 并行程度。I/O 软件通常分为四层:用户级软件、与设备无关的系统软件、设备驱动程序、中断处理程序。
SPOOLing(外围设备联机操作):在磁盘上设置输入井和输出井,由预输入程序、缓输出程序和井管理程序协同,把慢速或独占物理设备模拟成多个虚拟设备。作业先进入输入井,运行时从输入井取数据,把结果写入输出井,设备空闲时由缓输出程序完成输出。
磁盘调度主要先减少磁头移动距离,再考虑旋转等待:
| 算法 | 规则 | 优缺点 |
|---|---|---|
| FCFS | 按请求到达先后服务 | 公平、简单、无饥饿,但平均寻道时间可能较长 |
| SSTF | 选择距当前磁头最近的请求 | 单次寻道短,但远端请求可能长期等待,存在饥饿 |
| SCAN | 沿当前方向服务请求,到端部后反向,类似电梯 | 等待较均匀,可避免长期饥饿 |
| CSCAN | 只沿一个方向服务,到端部后快速回到起点再继续 | 等待时间更均匀,减少双向扫描造成的差异 |
6.5 文件管理
文件系统是统一管理和存取文件信息的软件及数据集合,提供按名存取、统一接口、空间分配、并发控制、安全保护和差错恢复。
- 逻辑结构:记录式文件由一个或多个逻辑记录组成;流式文件是连续字符流。
- 物理结构:连续结构、链接结构和索引结构。UNIX inode 采用直接、一级间接、二级间接和三级间接索引。
- FCB(文件控制块):至少包含文件名和物理地址;FCB 的有序集合构成文件目录。多级目录通过路径名定位,绝对路径从根目录开始。
外存空闲空间管理:
| 方法 | 定义与适用 |
|---|---|
| 位示图 | 每一位对应一个物理块,0/1 表示空闲/占用;描述能力强,适合各种物理结构 |
| 空闲区表 | 每项记录连续空闲区的首块号、块数和状态;适合连续文件 |
| 空闲块链 | 每个空闲块含下一个空闲块指针,头指针位于管理块;节省分配表空间 |
| 成组链接 | 空闲块分组,组首记录下一组位置和数量;UNIX 常用 |
文件共享:硬链接让多个目录项指向同一索引结点;符号链接建立保存原路径映射的新文件。硬链接通常不能跨文件系统;符号链接可跨文件系统或网络,但原路径失效时可能成为悬空链接。
文件保护:存取控制矩阵按“用户 × 文件”记录 R/W/X 权限,概念清晰但规模大;存取控制表按文件记录相关用户;用户权限表按用户记录可访问文件;密码方式在存盘时加密,读取时解密。文件安全管理层次包括系统级、用户级、目录级和文件级。
文件系统可靠性是抵抗和预防物理性、人为性破坏的能力,常用措施包括转储与恢复、日志文件以及一致性检查(块一致性检查和文件一致性检查)。
6.6 作业调度与用户界面
作业是系统为完成一次用户计算任务或事务处理所做工作的总和,由程序、数据和作业说明书组成。编译、连接、装入和执行等步骤可称为作业步。脱机控制使用 JCL 编写作业说明书;联机控制通过终端命令提交意图。
作业状态:提交(输入设备向外存输入)、后备/收容(已在磁盘等待调度)、执行(已分配资源并建立进程)、完成(正常结束或异常终止,等待善后和输出)。**JCB(作业控制块)**记录用户名、作业名、状态等,是作业存在的唯一标志;若干 JCB 组成作业后备队列。
常见作业调度算法有 FCFS、短作业优先、优先级调度和响应比高优先。HRRN(最高响应比优先)每次调度都重新计算后备作业的响应比并选择最大者:
R = 响应时间 / 执行时间
  = (等待时间 + 执行时间) / 执行时间
  = 1 + 等待时间 / 执行时间
作业 J_i 的提交时间为 t_i,完成时间为 c_i,执行时间为 s_i:
周转时间 T_i = c_i - t_i
带权周转时间 W_i = T_i / s_i
平均周转时间 = ΣT_i / n
平均带权周转时间 = ΣW_i / n
计算题通常要求画甘特图,求各作业等待时间、完成时间,再代入上述公式。HRRN 兼顾短作业和等待时间,但每次重新计算会增加系统开销。
用户界面是实现用户与计算机通信的软硬件总称。操作系统通常提供命令接口、程序接口(如系统调用)和图形界面;命令/图形接口主要面向用户和管理者,程序接口面向开发人员。演进阶段为控制面板式、字符式、图形界面和新一代自然交互界面。新一代界面强调用户中心、多媒体、多通道和智能化,支持语音、自然语言、手势、表情、视线等交互。
6.7 国产操作系统(识记)
教材列举的国产操作系统主要以开源 Linux 为基础进行二次开发,包括银河麒麟 KylinOS、深度 deepin、统信 UOS、中标麒麟、红旗 Linux、安超 OS 2020、中科方德和 StartOS。
| 系统 | 教材识记点 |
|---|---|
| 银河麒麟 KylinOS | 面向自主知识产权服务器系统,分实时版、安全版、服务器版 |
| 深度 deepin | 基于 Linux 内核,以桌面应用为主,含 DDE 桌面环境 |
| 统信 UOS | 由统信软件研发,基于 deepin 深度开发 |
| 中标麒麟 | 强化 Linux 内核,面向桌面等应用,含桌面版、通用版、高级版、安全版 |
| 红旗 Linux | 包括桌面、工作站、数据中心服务器、HA 集群和嵌入式版本 |
| 安超 OS 2020 | 面向服务器架构的通用型云操作系统,强调软硬件解耦和混合负载 |
| 中科方德 | 基于核高基桌面操作系统,适配国产兆芯处理器,易安装和配置 |
| StartOS | 从 Linux 底层构建,具有自主核心配置、包管理和桌面界面 |
7 小结
7.1 公式汇总
硬盘格式化容量:C = n × t × s × b
Cache 平均存储周期:t_avg = h × t_c + (1 − h) × t_m
程序执行时间:P = I × CPI × T
总线带宽:带宽 = 每周期传输字节数 × 总线频率
响应比:R = 1 + 等待时间 / 执行时间
周转时间:T_i = 完成时间 − 提交时间
带权周转时间:W_i = 周转时间 / 执行时间
平均周转时间:ΣT_i / n
平均带权周转时间:ΣW_i / n
7.2 对比表速查
| 对比 | 结论 |
|---|---|
| RAM / ROM | RAM 可读写但通常易失;ROM 通常只读且非易失 |
| DRAM / SRAM | DRAM 需刷新、容量大且便宜;SRAM 不需刷新、速度快但昂贵,常用于 Cache |
| DAS / NAS / SAN | DAS 直接挂服务器;NAS 文件级、走普通网络;SAN 块级、专用高速网络 |
| 程序查询 / 中断 / DMA / 通道 | CPU 介入逐步减少,并行性逐步提高 |
| CISC / RISC | CISC 指令多且复杂、变长、微程序;RISC Load/Store、定长、硬布线、易流水线 |
| SIMD / MIMD | SIMD 同指令处理多数据;MIMD 多处理机可执行不同指令和任务 |
| SMP / MPP | SMP 共享统一内存、编程简单但扩展受限;MPP 分布内存、消息通信、扩展性强 |
| UMA / NUMA / COMA | UMA 访问时间均匀;NUMA 本地快远程慢;COMA 用分布式 Cache 构成全局地址空间 |
| 就绪 / 阻塞 | 就绪只缺 CPU;阻塞在等事件,给 CPU 也不能运行 |
| 预防 / 避免死锁 | 预防静态破坏必要条件;避免动态检查安全状态;不安全不等于已死锁 |
| FIFO / LRU / OPT | FIFO 看进入先后且可能 Belady 异常;LRU 看最近使用;OPT 看未来,理想不可实现 |
| SCAN / CSCAN | SCAN 双向电梯;CSCAN 单向服务后回到起点,等待更均匀 |
| 硬链接 / 符号链接 | 硬链接共享 inode;符号链接保存路径,可跨文件系统但可能悬空 |
7.3 一页速记
- 系统层次:硬件层(裸机)→系统层(OS/语言处理)→应用层;CPU = 运算器 + 控制器。
- 存储层次:Cache → 主存 → 外存;越靠近 CPU,速度越快、容量越小、成本越高。
- RAID:
0无冗余,1镜像,5分布式校验,10性能与镜像组合。 - I/O:程序查询 → 中断 → DMA → 通道 → I/O 处理机,CPU 参与越来越少。
- 指令系统:CISC 复杂但指令丰富;RISC 规整、Load/Store、适合流水线。
- 多处理机:SMP/共享内存易编程;MPP/分布内存易扩展;NUMA 本地访问更快。
- 进程:PCB 是唯一标志;就绪只等 CPU,阻塞等事件;PV 是不可分割的同步原语。
- 死锁:互斥、不剥夺、请求与保持、环路等待四条件同时满足才可能发生。
- 虚存:分页固定大小、分段按逻辑;OPT 最优但不可实现,FIFO 有 Belady 异常,LRU 需支持。
- 调度:HRRN =
1 + 等待时间/执行时间;周转 = 完成 - 提交;带权周转 = 周转/执行。
7.4 计算题切入点
- Cache 题:先确认命中率是取指、取数还是综合命中率,再按访问次数加权。
- 磁盘容量题:统一单位后代入
n × t × s × b,注意记录面数不是盘片数。 - 总线带宽题:先算一个总线周期,再用“每周期字节数 ÷ 周期时间”或“字节数 × 频率”。
- 地址变换题:分页查页表并拼接页内地址;分段检查段长后做“基址 + 位移”;段页式要查两级表。
- 页面置换题:按访问序列逐次记录页框,区分“缺页”与“命中”,最后统计缺页率;特别检查 FIFO 的 Belady 异常。
- 作业调度题:先画甘特图,确定每个作业的开始/完成时间,再计算等待、周转和带权周转。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 5
 0
- 0


 已为社区贡献2条内容

所有评论(0)