二、JVM相关
二、JVM相关
2.1 JVM介绍
- 定义:Java虚拟机(JVM)是一个可以执行Java字节码的虚拟机进程,它运行在操作系统之上的,与硬件没有直接的交互。
- JVM属于JRE,JRE属于JDK,同时JDK包含了其他的命令(20:17)
- 功能:JVM能够根据
.class字节码文件,编译成特定机器上的机器码
这也是为什么Java语言是平台无关的
- 种类:
- HotSpot JVM:Hotspot JVM是Oracle官方自带的Java虚拟机,其采用了惰性评估(Lazy Evaluation)的做法,根据二八定律,消耗大部分系统资源的只有那一小部分的代码(热点代码),而这也就是 JIT 所需要编译的部分。JVM 会根据代
码每次被执行的情况收集信息并相应地做出⼀些优化,因此执行的次数越多,它的速度就越快 - JRockit VM:是OpenJDK对应的Java虚拟机
以下介绍的JVM未作说明默认HotSpot JVM
- JIT:
- 定义:JIT是热点代码优化器,它可以将热点字节码编译成机器语言并缓存起来。
- 编译成机器语言的目的:机器语言相比于其他语言,被底层机器识别效率最高。
2.2 JDK1.8之前的JVM内存模型
2.2.1 介绍
- 定义:JVM内存模型可以分为线程共享区域(堆、方法区)和线程私有区域(程序计数器、虚拟机栈以及本地方法区)以及直接内存三大块,其中线程共享区域和线程私有区域又被称作运行时数据区域(Runtime Data Area)
- 示意图:


- JVM内存模型和Java内存模型(JMM)的区别:
**扩展:**与操作系统相对于硬件类似,操作系统需要抽象出内存模型,那么 Java语言也需要抽象出相对于操作系统的内存模型,这就是Java内存模型(JMM)。
- Java 内存模型(Java Memory Model,JMM)用于屏蔽各种硬件和操作系统的内存访问差异,以实现让 Java 程序在各种平台都能达到一致的内存访问效果
- JMM定义程序中各个变量的访问规则,即在虚拟机中将变量存储到内存和从内存中取出变量这样的底层细节。
这里说的变量包括了实例字段、静态字段和构成数组对象的元素,但不包括局部变量与方法参数。因为后者是线程私有的,不会被共享,自然就不会存在竞争问题
- JMM定义了线程和主内存之间的抽象关系,即JMM 定义了JVM在计算机内存(RAM)中的工作方式,是我们了解Java并发编程的基础。
- 而JVM内存模型是指JVM运行时将数据分区域存储,强调对内存空间的划分。
- 如何查看JVM内存模型:
- 启动一个可以循环读取控制台字符的程序InputHolder:
List<Character> tl = new ArrayList<>();
for (;;) {
	char c = (char) System.in.read();
	tl.add(c);
}
- 工具:阿里提供的
arthas-boot.jar - 使用
java -jar arthas-boot.jar命令 启动arthas-boot.jar,可以看到当前正在运行的java进程:

- 选择进程编号前的序号,例如我们这里选择刚刚写的InputHolder,输入进程编号8848前面的1,打印如下日志后说明arthas接入监控了InputHolder所在进程:

- 接着我们在命令提示符输入
dashboard,将展示进程运行的各项参数:
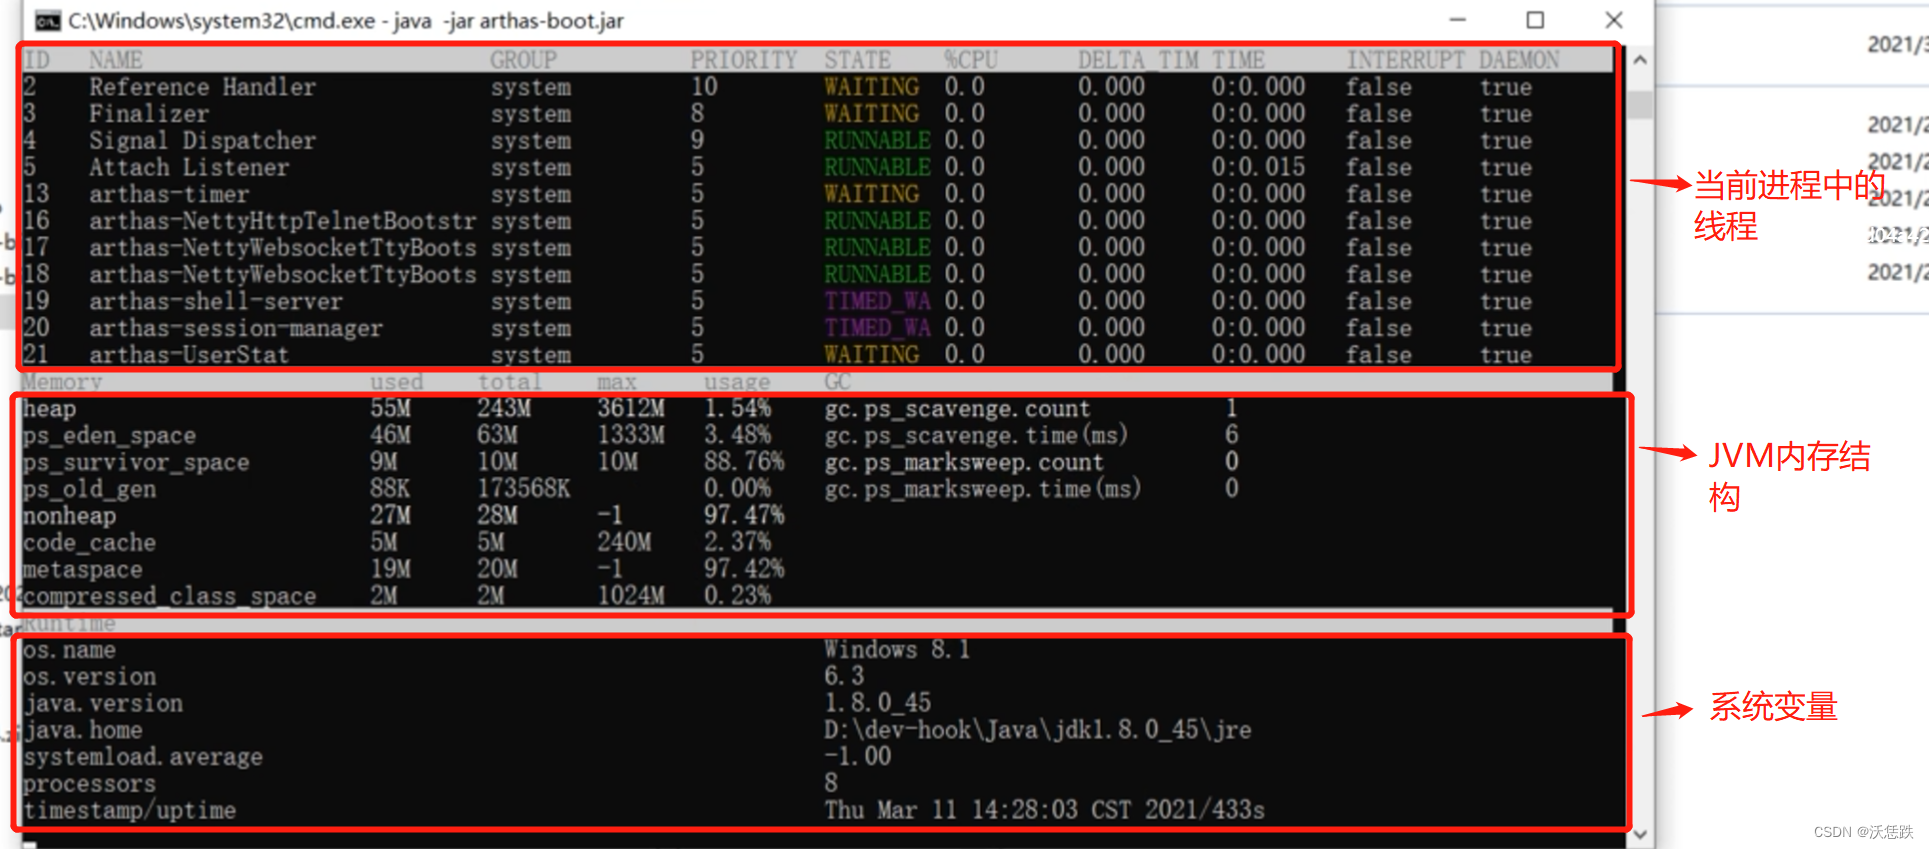
其中第二栏Memory就是JVM内存模型了,可以清晰的看到JVM对内存的划分
heap:JVM内存模型中的堆区ps_eden_space:堆中新生代的Eden区ps_survivor_space:堆中新生代的两个Survivor(S1、S2)空间ps_old_gen:堆中老年代nonheap:非堆区,即直接内存区域(DirectBuffer)的方法区(JDK1.8之前是永久代,JDK1.8之后是元空间)code_cache:对应本地方法栈(native stack)中方法编译后的空间metaspace:元数据区compressed_class:压缩的类空间,存储类的类型信息
-
通用参数设置:
java ‐Xms2048M ‐Xmx2048M ‐Xmn1024M ‐Xss512K ‐XX:MetaspaceSize=256M ‐XX:MaxMetaspaceSize=256M ‐jar microservice‐eurek a‐server.jar元空间默认大小
‐XX:MetaspaceSize必须设置!原因见下文。
2.2.2 堆(heap)
- 定义:是Java 虚拟机所管理的内存中最大的一块,是所有线程共享的一块内存区域,在虚拟机启动时创建。
- 功能:
- 存放对象实例:几乎所有的对象实例以及数组都在这里分配内存
- 是垃圾收集器管理的主要区域,因此也被称作GC堆(Garbage Collected Heap)
扩展:为什么要强调【几乎】?除了堆,对象还可以在什么地方分配内存?
1)随着JIT编译期的发展与逃逸分析技术逐渐成熟,栈
上分配、标量替换优化技术将会导致一些微妙的变化,所有的对象都分配到堆上也渐渐变得不那么“绝对”了。
2)从jdk 1.7开始已经默认开启逃逸分析,如果某些方法中的对象引用没有被返回或者未被外面使用(也就是未逃逸出去),那么对象可以直接在栈上分配内存。
- 结构:
-
从垃圾回收的角度(使用分代垃圾收集算法的角度):分为新生代、老年代、持久代。其中新生代和老年代在堆中默认配比是1:2。
-
新生代(Young Generation):又可细分为Eden区和Survivor区。
-
Eden区:
1)对象绝大多数时间都分配在Eden区(不绝对)
2)Eden区对象存储满时,JVM的字节码执行引擎会开启一个垃圾回收线程(Minor GC)进行垃圾回收(GC), 目的是将新生代中的无用对象进行回收。
-
Survivor区:分为S0区和S1区,两者在进行Minor GC时,可能将存有对象的Survivor区(最初是S0,此处作区分叫SurvivorFrom区)中的非垃圾对象搬到空Survivor区(最初是S1,此处作区分叫SurvivorTo区)
新生代中Eden区:S0:S1比例默认8:1:1
另外注意,Minor GC中不光迁移SurvivorFrom区的非垃圾对象到SurvivorTo区,还有可能迁移Eden区的非垃圾对象到SurvivorTo区!
-
-
老年代(Old Generation):对应Eden空间的话,又叫tentired空间
扩展:Web应用中哪些对象会最终转移到老年代?
1)静态变量、对象池、缓存对象、Spring容器引用的对象
- 持久代(Permanent Generation、PermGen、永生代):是对方法区的具体实现。JDK1.7之前,持久代会存储已被虚拟机加载的类信息、字段信息、方法信息、运行时常量池(包括字符串常量池)、静态变量、即时编译器编译后的代码缓存等数据。JDK1.7时,将字符串常量池和静态变量从永生代移到了堆内存中。
-

进一步划分的目的是更好地回收内存,或者更快地分配内存
- 从内存分配的角度:线程共享的 Java 堆中可以划分出多个线程私有的分配缓冲区(Thread Local Allocation Buffer,TLAB)以及线程共有的共享区域
-
内存参数设置:
-Xms // 表示堆的初始大小 -Xmx // 表示堆的最大大小 新生代: -Xmn // 表示新生代的初始大小 ‐XX:SurvivorRatio=8 //表示Eden区和S0、S1的比例为8:1:1,此处8的单位是0.1,默认值为8 -XX:+UseAdaptiveSizePolicy // 开启Eden区动态扩容,JVM默认开启,生产上也建议开启 -
对象在堆中的分配规则:
- 大部分情况,对象都会首先在 Eden 区域分配,在一次新生代垃圾回收后,如果对象还存活,原本在Eden区的则会进入S0,原本在S0空间的则进入S1,并且对象的年龄还会加1(Eden区→Survivor区后对象的初始年龄变为1)
- 当S1区的对象分代年龄增加到对象动态年龄阈值(默认晋升年龄并不都是15,这个是要区分垃圾收集器的,CMS就默认是6),就会被晋升到老年代中。对象晋升到老年代的年龄阈值,可以通过参数
-XX:MaxTenuringThreshold来设置
扩展:年龄阈值算法逻辑:
1)“HotSpot JVM遍历所有对象时,按照年龄从小到大对其所占用的大小进行累积;
2)当累积的某个年龄个数大小超过了S1区的一半时,取这个年龄和MaxTenuringThreshold中更小的一个值,作为新的晋升年龄阈值
3)C++相关算法源码如下:
uint ageTable::compute_tenuring_threshold(size_t survivor_capacity) {
	// survivor_capacity是survivor空间的大小
	size_t desired_survivor_size = (size_t)((((double) survivor_capacity)*TargetSurvivorRatio)/100);
	size_t total = 0;
	uint age = 1;
	while (age < table_size) {
		// sizes数组是每个年龄段对象大小
		total += sizes[age];
		if (total > desired_survivor_size) break;
		age++;
	}
	uint result = age < MaxTenuringThreshold ? age : MaxTenuringThreshold;
	...
}
- 大对象:
-
定义:首先对象大小直接超过Eden区大小的对象肯定是大对象,其次开启大对象判断后超过界限的对象为大对象
-
大对象直接分配到堆中老年代。
-
人为开启大对象判断:大小界限的单位为字节(byte),同时需启用一种年轻代垃圾收集器(Serial或ParlNew都行):
-XX:PretenureSizeThreshold=1000000 // 超过1000000字节的对象为大对象
-XX:+UseSerialGC // 启用Serial垃圾收集器,此处也可以启用ParNew:-XX:+UseParNewGC
G1垃圾收集器有自己的大对象判断,不用
-XX:PretenureSizeThreshold参数设置界限!
- 哪些对象将进入老年代:
- 大对象
- 长期存活对象:当对象分代年龄达到对象动态年龄阈值时进入老年代(并非默认15岁,具体垃圾收集器要求不同,像CMS就默认6岁)
- 如何判断对象是否需要尽早进老年代:
- 大对象占年轻代内存空间,可设置大小界限让超过的直接进老年代
- 能够推测出程序中的对象大多数在哪个年龄就被干掉,比方说80%差不多3次Minor GC就能干掉了,那么就适当降低对象动态年龄阈值(例如降到5),从而让对象尽早进入老年代,给年轻代腾出空间
- 指定Survivor区对象大小阈值:值为权重,默认为50%,需配合对象动态年龄判断机制使用
-XX:TargetSurvivorRatio=50
- 关于字符串常量池:
- 定义:指的就是StringTable以及StringTable管理的一片String对象实例
- 底层实现:HotSpot 虚拟机中字符串常量池的实现是
src/hotspot/share/classfile/stringTable.cpp,即java中的StringTable
StringTable可以简单理解为一个固定大小的HashTable ,容量为 StringTableSize(可以通过
-XX:StringTableSize参数来设置),保存的是字符串(key)和 字符串对象的引用(value)的映射关系,字符串对象的引用指向堆中的字符串对象。更多相关知识详见前文Java技术栈 1-1 Java基础
2.2.3 方法区(Method Area)
- 定义:由《Java虚拟机规范》提出,规定了方法区属于是 JVM 运行时数据区域的一块逻辑区域,是各个线程共享的内存区域,又被称为非堆区。
- 功能:当虚拟机要使用一个类时,它需要读取并解析Class文件获取相关信息,再将信息存入到方法区中。
- 存储内容:存储已被虚拟机加载的类信息、字段信息、方法信息、运行时常量池、静态变量、即时编译器编译后的代码缓存等数据(注意JDK1.7开始字符串常量池、静态变量不再在方法区,而是转移到了堆内存中)
重点:字符串常量池是运行时常量池中的一部分,JDK1.7对字符串常量池的迁移并未影响到运行时常量池中的其他内容
- 内存参数设置:
-XX:PermSize=N //方法区 (永久代) 初始大小
-XX:MaxPermSize=N //方法区 (永久代) 最大大小,超过这个值将会抛出 OutOfMemoryError 异常:java.lang.OutOfMemoryError: PermGen
- 方法区和永久代以及元空间的关系:可以理解成接口和类的关系
- JDK1.8以前,方法区是对永生代的抽象,永生代是HotSpot JVM对方法区的具体实现
- JDK1.8以后,方法区是对元空间的抽象,元空间是HotSpot JVM对方法区的具体实现
- 关于常量池表(Constant Pool Table):
- 定义:Class 文件中除了有类的版本、字段、方法、接口等描述信息外,还有用于存放编译期生成的各种字面量(Literal)和符号引用(Symbolic Reference)的常量池表
- 关于字面量:是源代码中的固定值的表示法(即通过字面我们就能知道其值的含义)。字面量包括整数、浮点数和字符串字面量。
- 关于符号引用:常见的符号引用包括类符号引用、字段符号引用、方法符号引用、接口方法符号
- 关于运行时常量池:
- 初始化时机:常量池表会在类加载后存放到方法区的运行时常量池中
- 功能:类似于传统编程语言的符号表,尽管它包含了比典型符号表更广泛的数据
既然运行时常量池是方法区的一部分,自然受到方法区内存的限制,当常量池无法再申请到内存时会抛出OutOfMemoryError异常
2.2.4 栈(Stack)
1)介绍
- 定义:
- 是方法运行时的基础数据结构。
- 与程序计数器一样,Java 虚拟机栈(后文简称栈)也是线程私有的,它的生命周期和线程相同,随着线程的创建而创建,随着线程的死亡而死亡。
- 每执行一个java方法,就会在栈中生成一个栈帧,在执行引擎运行时,所有指令都只能针对当前栈帧进行操作。栈帧中包括局部变量、动态链接、操作数栈、方法出口(返回地址)等等信息
-
内存参数设置:默认一个线程中(线程私有的分配缓冲区(Thread Local Allocation Buffer,TLAB))栈空间大小是1M
-Xss // 表示一个线程中栈空间的最大大小,超过则报StackOverFlowError异常理论上,在同一个物理内存下,
-Xss设置的越小,栈帧的数量越少,JVM能开启的线程数就越多注意,无法直接控制JVM最多能开启的栈数量!!
-
种类:栈区又分为虚拟机栈(JVM Stack)和本地方法栈(Native Stack),虚拟机栈主要存放java方法的栈帧,而本地方法栈自然存放的是native方法的栈帧了
在HotSpot虚拟机中,本地方法栈和虚拟机栈合二为一了
- 功能:方法调用的数据需要通过栈进行传递,每一次方法调用都会有一个对应的栈帧被压入栈中,每一个方法调用结束后,都会有一个栈帧被弹出
上述功能又被称为Java方法执行的内存模型
- 示意图:

- 栈常见的两种异常:
StackOverFlowError:若栈的内存大小不允许动态扩展,那么当线程请求栈的深度超过当前 Java 虚拟机栈的最大深度的时候,就抛出StackOverFlowError异常OutOfMemoryError:如果栈的内存大小可以动态扩展, 但虚拟机在动态扩展栈时无法申请到足够的内存空间,则抛出OutOfMemoryError异常(OOM)
- 堆和栈的区别:
| 维度 | 栈 | 堆 |
|---|---|---|
| 数据结构 | 栈是运行时单位,代表着逻辑,内含基本数据类型和堆中对象引用,所在区域连续,没有碎片 | 堆是存储单位,代表着数据,可被多个栈共享(包括成员中基本数据类型、引用和引用对象),所在区域不连续,会有碎片 |
| 功能 | 存储局部变量和方法调用 | 存储Java中的对象 |
| 共享性 | 栈内存是线程私有的 | 堆内存是所有线程共有的 |
| 异常 | 栈空间不足:java.lang.StackOverFlowError | 堆空间不足:java.lang.OutOfMemoryError |
此外,栈的空间大小远远小于堆
2)局部变量表
-
功能:存放方法参数和局部变量的区域
-
存储数据类型:主要存放了编译期可知的各种数据类型boolean、byte、char、short、int、float、long、double、对象引用(reference)
关于对象引用(reference):它不同于对象本身,可能是一个指向对象起始地址的引用指针,也可能是指向一个代表对象的句柄或其他与此对象相关的位置
-
对应硬件位置:一般在内存中
-
初始化过程:
- 没有准备阶段, 必须显式初始化
- 对于非静态方法,则在
index[0]位置上存储方法所属对象的实例引用(一个引用变量占 4 个字节) - 随后存储的是参数和局部变量
扩展:字节码指令中的
STORE指令就是将操作数栈中计算完成的局部变量写回局部变量表的存储空间内
3)操作数栈
- 数据结构:是个初始状态为空的桶式结构栈,一般在寄存器中
节码指令集的定义都是基于栈类型的,栈的深度在方法元信息的
stack属性中
- 功能:
- 主要作为方法调用的中转站使用,用于存放方法执行过程中产生的中间计算结果。
- 另外,计算过程中产生的临时变量也会放在操作数栈中。
扩展1:从JVM角度看i++和++i的区别:接下来对两者在底层的操作进行分析:
1)i++:从局部变量表取出i并压入操作栈(load memory),然后对局部变量表中的i自增1(add&store memory),将操作栈栈顶值取出使用,如此线程从操作栈读到的是自增之前的值。
2)++i:先对局部变量表的i自增1(load memory&add&store memory),然后取出并压入操作栈(load memory),再将操作栈栈顶值取出使用,线程从操作栈读到的是自增之后的值。
扩展2:为什么使用
volatile无法保证i++和++i的线程安全?
1)是因为无论i++和++i在JVM中的三步都是非原子性的,都有可能受到别的线程影响导致数据覆盖问题
4)动态链接
-
定义:是常量池中对当前方法的引用:
-
Class文件的常量池里保存有大量的符号引用(比如方法引用的符号引用)。
-
当一个方法要调用其他方法,需要将常量池中指向方法的符号引用转化为其在内存地址中的直接引用。
-
动态链接的作用就是为了将符号引用转换为调用方法的直接引用,这个过程也被称为动态链接 。

5)返回地址
-
定义:又叫方法出口:
-
方法执行时的两种退出条件:
- 正常退出,即正常执行到任何方法的返回字节码指令,如
RETURN、IRETURN、ARETURN等 - 抛出异常推出。
无论何种退出情况,都将返回至方法当前被调用的位置。方法退出的过程相当于弹出当前栈帧。
栈帧随着方法调用而创建,随着方法结束而销毁。无论方法正常完成还是异常完成都算作方法结束。
- 方法退出的3种方式:
- 返回值压入上层调用栈帧
- 异常信息抛给能够处理的栈帧
- PC计数器指向方法调用后的下一条指令
2.2.5 程序计数器
- 定义:
- 程序计数器又叫PC寄存器,是一块较小的内存空间,可以看作是当前线程所执行的字节码的行号指示器。字节码解释器工作时通过改变这个计数器的值来选取下一条需要执行的字节码指令,分支、循环、跳转、异常处理、线程恢复等功能都需要依赖这个计数器来完成。
- 另外,为了线程切换后能恢复到正确的执行位置,每条线程都需要有一个独立的程序计数器,各线程之间计数器互不影响,独立存储,我们称这类内存区域为线程私有的内存。
- 功能:
- 每个线程都有一个程序计数器用来记录当前栈帧的执行位置(程序计数器使用一个指针指向当前虚拟机栈帧或native栈帧),从而在CPU调度等线程来回切换时能知道线程上次运行到哪儿了。
- 字节码解释器通过改变程序计数器来依次读取指令,从而实现代码的流程控制,如:顺序执行、选择、循环、异常处理。
注意程序计数器指向native栈帧时,其计数为空
2.2.6 直接内存(DirectBuffer)
- 定义:
- 直接内存是一种特殊的内存缓冲区,并不在 Java 堆或方法区中分配,而是通过JNI 的方式在本地内存上分配的。
- 直接内存并不是虚拟机运行时数据区的一部分,也不是《Java虚拟机规范》中定义的内存区域,但是这部分内存也被频繁地使用,而且也可能导致OutOfMemoryError异常出现。
JDK1.4 中新加入的 NIO(Non-Blocking I/O,也被称为 New I/O),引入了一种基于通道(Channel)与缓存区(Buffer)的 I/O 方式(零拷贝),它可以直接使用 Native 函数库直接分配堆外内存,然后通过一个存储在 Java 堆中的 DirectByteBuffer 对象作为这块内存的引用进行操作。这样就能在一些场景中显著提高性能,因为避免了在Java 堆和 堆外内存之间来回复制数据。
- 直接内存的分配不会受到 Java 堆的限制,但是,既然是内存就会受到本机总内存大小以及处理器寻址空间的限制。
2.3 JDK1.8之后(含1.8)的JVM内存模型
2.3.1 介绍
- 最大区别:JDK 8 版本之后 PermGen(永久代) 已被 Metaspace(元空间) 取代,元空间使用的是本地内存
- 示意图:

2.3.2 元空间(Metaspace)与动态水平伸缩机制
- JDK1.8后永久代被移出 HotSpot JVM 的原因:
- 由于JVM 本身设置固定大小上限,无法进行调整,因此PermGen 内存经常会溢出,引发恼人的
java.lang.OutOfMemoryError: PermGen。JVM 的开发者希望这一块内存可以更灵活地被管理,不要再经常出现这样的OOM - 移除 PermGen 可以促进 HotSpot JVM 与 JRockit VM 的融合,因为 JRockit 没有永久代。
- 内存参数设置:
-XX:MetaspaceSize // 表示元空间初始大小,是触发动态水平伸缩机制的阈值
-XX:MaxMetaspaceSize // 表示元空间最大大小,超过该大小则报错
MaxMetaspaceSize若不手动设置,则默认值为unlimited,这意味着它只受系统内存的限制。建议‐XX:MetaspaceSize和‐XX:MaxMetaspaceSize相同
- 元空间直接使用的物理内存(直接内存),若未设置初始元空间(
‐XX:MetaspaceSize)大小或元空间最大大小(-XX:MaxMetaspaceSize),则元空间使用默认的配置:初始大小21MB,最大值无限(取决于物理内存大小) - 动态水平伸缩机制:又叫方法区容量大小自动伸缩机制
- 若未手动设置元空间初始大小,则元空间默认初始值21MB。当Web应用加载了很多类信息到元空间,且元空间大小达到初始大小(此处假设还是默认21MB),则会触发Full GC来回收堆和方法区,将元空间中的无用信息进行回收。
- 若某次回收后方法区中仅剩很少的信息(如1MB),则JVM会将元空间初始大小缩小(例如从21MB→15MB);
- 若回收后方法区信息大小没啥大变化(如20MB),则在不超过元空间最大值的情况下,适当扩容元空间初始大小(例如从21MB→30MB)
无论是否手动设置元空间初始大小,都可能触发动态水平伸缩机制
- 未手动设置元空间初始大小所带来的问题:
- 例如大型Spring单体应用达到5G,在程序启动过程中,元空间由于使用默认大小21MB就很容易触发动态水平伸缩机制来扩容,进而触发Full GC。
- 由于不断加载类,扩容并非一蹴而就,而是不断调整的过程,这就导致了频繁Full GC。我们后文将会提到Full GC是存在STW机制的,频繁的Full GC进一步导致STW时间过长,从而使得程序启动时间延长(几分钟十几分钟都有,,),用户的体验、程序性能大大降低。
2.4 Java类文件结构解析
2.4.1 JVM字节码指令集
1)介绍
- 定义:JVM用来控制CPU执行的一套程序指令集
- 使用字节码的意义:
- Java 语言通过字节码的方式,在一定程度上解决了传统解释型语言执行效率低的问题,同时又保留了解释型语言可移植的特点。
- 所以 Java 程序运行时比较高效,而且,由于字节码并不针对一种特定的机器,因此,Java 程序无须重新编译便可在多种不同操作系统的计算机上运行,做到了平台无关性
2)如何查看字节码指令?
- 使用
javap -v xxx.class命令:在当前.class文件的目录,打开控制台输入该命令,即可看到翻译后的汇编代码(包括:字节码指令、行号、局部变量表、常量池等信息):
- 源代码:
public class StringTest {
    public StringTest() {
    }

    public static void main(String[] args) {
        String a = "1";
    }
}
- 反汇编后的结果:
  Last modified 2022-7-20; size 422 bytes
  MD5 checksum 49327255721de2f988d8838e6161276c
  Compiled from "StringTest.java"
public class StringTest
  minor version: 0
  major version: 49
  flags: ACC_PUBLIC, ACC_SUPER
Constant pool:
   #1 = Methodref          #4.#20         // java/lang/Object."<init>":()V
   #2 = String             #21            // 1
   #3 = Class              #22            // StringTest
   #4 = Class              #23            // java/lang/Object
   #5 = Utf8               <init>
   #6 = Utf8               ()V
   #7 = Utf8               Code
   #8 = Utf8               LineNumberTable
   #9 = Utf8               LocalVariableTable
  #10 = Utf8               this
  #11 = Utf8               LStringTest;
  #12 = Utf8               main
  #13 = Utf8               ([Ljava/lang/String;)V
  #14 = Utf8               args
  #15 = Utf8               [Ljava/lang/String;
  #16 = Utf8               a
  #17 = Utf8               Ljava/lang/String;
  #18 = Utf8               SourceFile
  #19 = Utf8               StringTest.java
  #20 = NameAndType        #5:#6          // "<init>":()V
  #21 = Utf8               1
  #22 = Utf8               StringTest
  #23 = Utf8               java/lang/Object
{
  public StringTest();
    descriptor: ()V
    flags: ACC_PUBLIC
    Code:
      stack=1, locals=1, args_size=1
         0: aload_0
         1: invokespecial #1                  // Method java/lang/Object."<init>":()V
         4: return
      LineNumberTable:
        line 1: 0
      LocalVariableTable:
        Start  Length  Slot  Name   Signature
            0       5     0  this   LStringTest;

  public static void main(java.lang.String[]);
    descriptor: ([Ljava/lang/String;)V
    flags: ACC_PUBLIC, ACC_STATIC
    Code:
      stack=1, locals=2, args_size=1
         0: ldc           #2                  // String 1
         2: astore_1
         3: return
      LineNumberTable:
        line 3: 0
        line 15: 3
      LocalVariableTable:
        Start  Length  Slot  Name   Signature
            0       4     0  args   [Ljava/lang/String;
            3       1     1     a   Ljava/lang/String;
}
SourceFile: "StringTest.java"
通常我们只关注指定方法的字节码指令步骤,比方说这边的main()方法的String实例a构造过程,对应的指令如下:
0: ldc #2 // String 1
2: astore_1
3: return
- 使用idea插件Jclasslib bytecode viewer:
- File→Settings打开设置页面,选择Plugins,在搜索框内输入jclasslib
- 选择安装,之后重启idea
- Build→Build Project,然后打开编译后的
.class文件,选择 View→Show Bytecode With jclasslib,即可打开反汇编视图。
3)常见字节码指令及释义
本笔记只略做说明,详细学习之后再说吧,,
1. new
- 功能:在java堆上为特定类型的对象分配内存空间,并创建一个instanceOopDesc(Java对象)实例,最后将Java对象实例的地址(引用)压入操作数栈的栈顶。
- 典型应用:
new一个对象
2. ldc
- 功能:分为两大类:
- 将
int、float、或者一个类、方法类型或方法句柄的符号引用压入操作数栈的栈顶 - 将指定字符串常量的String对象实例(String常量)的引用从常量池中压入操作数栈栈顶。
- 典型应用:String对象内存分配
3. astore
- 功能:弹出操作数栈的栈顶元素,赋值给指定索引(
index)的局部变量。
index对应的变量必须位于局部变量表中;astore指令只能操作栈顶的returnAddress类型或reference类型的数据
- 典型应用:任何以对象实例赋值的场景
4. dup
- 功能:复制操作数栈顶值,并将其压入栈顶,此时操作数栈上有连续相同的两个对象地址
- 典型应用:
new一个对象
5. invokespecial、invokevirtual
- 功能:
- 依次从操作数栈的栈顶取出待执行方法的各项参数(
args)、对象引用(objectref),并调用对象引用所指实例的该方法。 - 执行完方法后,除非该方法无返回值(构造方法和返回
void的方法),否则将返回值压入操作数栈的栈顶(因为Java是值传递,所以压入栈的只能是数值或引用)
1.1 注意事项
1)执行这两个指令前需确保 对象引用、要执行的方法的各项参数(左先右后)已经被其他指令依次压入操作数栈中。
2)invokespecial通常用来执行实例方法,尤其是实例的初始化方法(<init>:()V);而invokevirtual则是用来执行特定非私有的实例方法
更多指令使用请参考:www.cnblogs.com/mongotea/p/11980087.html
- 典型应用:
invokespecial:new一个对象、调用私有方法、调用父类方法invokevirtual:调用实例的公共方法
6. aload
- 功能:将指定索引(
index)的局部变量压入操作数栈的栈顶。 - 典型应用:
new一个对象
2.4.2 Class文件结构
通过上一节如何查看字节码指令,我们已经通过反汇编初步看出了类文件的结构,以下进行详细分析
1)介绍
- 数据结构:根据《Java虚拟机规范》,Class 文件通过
ClassFile定义,有点类似C语言的结构体:
ClassFile {
    u4             magic; //Class 文件的标志
    u2             minor_version;//Class 的小版本号
    u2             major_version;//Class 的大版本号
    u2             constant_pool_count;//常量池的数量
    cp_info        constant_pool[constant_pool_count-1];//常量池
    u2             access_flags;//Class 的访问标记
    u2             this_class;//当前类
    u2             super_class;//父类
    u2             interfaces_count;//接口数量
    u2             interfaces[interfaces_count];//一个类可以实现多个接口
    u2             fields_count;//字段数量
    field_info     fields[fields_count];//一个类可以有多个字段
    u2             methods_count;//方法数量
    method_info    methods[methods_count];//一个类可以有个多个方法
    u2             attributes_count;//此类的属性表中的属性数
    attribute_info attributes[attributes_count];//属性表集合
}
- 示意图:

扩展:Java的.class文件如何判断是否符合规范?
1)使用UE的十六进制打开后,开头必须是CA FE BA BE:

- 查看方式:上文提到了,可以使用IDEA插件jclasslib查看,抑或是使用
javap -v xxx.class命令。

不光可以直观地查看某个类对应的字节码文件,还可以查看类的基本信息、常量池、接口、属性、函数等信息
接下来详细介绍一下Class文件结构涉及到的一些组件
2)Magic Number(魔数)
- 定义:每个文件的头4 个字节称为魔数(Magic Number)
u4 magic; //Class 文件的标志
- 作用:用来校验这个文件是否符合JVM接收的Class文件的格式
- 数据结构:《Java虚拟机规范》规定Class文件的魔数为固定值:
0xCAFEBABE
如果读取的文件不是以这个魔数开头,Java 虚拟机将拒绝加载它
- 功能:主要用来预防文件类型伪造
-
通过post上传文件时,文件后缀名和 Content-Type 都可以伪造
-
而不管你怎么改文件后缀名和Content-Type,文件的魔数都是不变的,检测魔数更可靠
-
方法:
-
项目引入Tika,调用以下方法获取文件类型
String contentType = tika.detect(inputStream, fileName); -
同时在
.yml文件中配置好文件类型白名单:以下表示只允许post上传.txt、.pdf、.docx、.doc这四种# application.yml app: resume: allowed-types: - application/pdf - application/msword - application/vnd.openxmlformats-officedocument.wordprocessingml.document - text/plain
-
3)Minor&Major Version(主次版本号)
- 定义:魔数后的四个字节存储的是Class文件的主次版本号。
- 第5和第6个字节是次版本号
- 第7和第8个字节是主版本号
    u2             minor_version;//Class的小版本号
    u2             major_version;//Class的大版本号
- 特性:
- 每当Java发布大版本(比如 Java 8、Java9)的时候,主版本号都会加1
- 高版本的Java 虚拟机可以执行低版本编译器生成的 Class 文件,但是低版本的Java 虚拟机不能执行高版本编译器生成的 Class 文件。
所以在实际开发的时候要确保开发的的DK 版本和生产环境的JDK 版本保持一致。
4)Constant Pool(常量池)
- 定义:紧接着主次版本号之后的是常量池
constant_pool[constant_pool_count-1]
    u2             constant_pool_count;//常量池的数量
    cp_info        constant_pool[constant_pool_count-1];//常量池
- 大小:常量池的大小是
constant_pool_count-1
扩展:大小是
constant_pool_count-1的原因:
1)常量池计数器是从1开始计数的,将索引为0(constant_pool[0])的位置空出来是有特殊考虑的,索引值为0代表不引用任何一个常量池项
- 数据结构:存放字面量和符号引用
- 字面量:类似于Java语言层面的的常量概念,如文本字符串、声明为
final的常量值等 - 符号引用:属于编译原理方面的概念,包括下面三种常量:
- 类和接口的全限定名
- 字段的名称和描述符
- 方法的名称和描述符
- 常量的种类:常量池中一共有14中常量,每一种常量都是一个表,开始的第一位是一个u1类型的标志位,接着用
-tag来标识常量的类型:
| 类型 | 对应tag | 描述 |
|---|---|---|
| CONSTANT_utf8_info | 1 | UTF-8 编码的字符串 |
| CONSTANT_Integer_info | 3 | 整形字面量 |
| CONSTANT_Float_info | 4 | 浮点型字面量 |
| CONSTANT_Long_info | 5 | 长整型字面量 |
| CONSTANT_Double_info | 6 | 双精度浮点型字面量 |
| CONSTANT_Class_info | 7 | 类或接口的符号引用 |
| CONSTANT_String_info | 8 | 字符串类型字面量 |
| CONSTANT_FieldRef_info | 9 | 字段的符号引用 |
| CONSTANT_MethodRef_info | 10 | 类中方法的符号引用 |
| CONSTANT_InterfaceMethodRef_info | 11 | 接口中方法的符号引用 |
| CONSTANT_NameAndType_info | 12 | 字段或方法的符号引用 |
| CONSTANT_MethodHandle_info | 15 | 表示方法句柄 |
| CONSTANT_MethodType_info | 16 | 标志方法类型 |
| CONSTANT_InvokeDynamic_info | 18 | 表示一个动态方法调用点 |
5)Access Flags(访问标志)
- 定义:常量池后的两个字节代表访问标志
u2 access_flags;//Class 的访问标记
- 作用:用于识别一些类或者接口层次的访问信息,包括:
- 这个Class是类还是接口
- 是否为
public或者abstract类型 - 如果是类的话是否声明为
final等等
- 各种
access_flags的取值及含义:
| 访问标志 | 值 | 含义 |
|---|---|---|
| ACC_PUBLIC | 0x0001 | 声明为public |
| ACC_FINAL | 0x0010 | 声明为final,不允许有子类 |
| ACC_SUPER | 0x0020 | 声明为最上层类(超类),当子类invokespecial指令调用时,需特别处理该超类方法 |
| ACC_INTERFACE | 0x0200 | 声明为接口 |
| ACC_ABSTRACT | 0x0400 | 声明为抽象类,不可实例化 |
| ACC_SYNTHETIC | 0x1000 | 声明为合成类,源码中不可见 |
| ACC_ANNOTATION | 0x2000 | 声明为注解 |
| ACC_ENUM | 0x4000 | 声明为枚举 |
- 应用示例:定义了一个Employee类,并通过
javap -v Employee指令查看该类的访问标志:

6)This Class、Super Class、Interfaces
- 定义:紧跟着访问标志的是
This Class、Super Class、Interfaces,分别表示当前类索引、父类索引以及接口索引数组
    u2             this_class;//当前类
    u2             super_class;//父类
    u2             interfaces_count;//接口数量
    u2             interfaces[interfaces_count];//一个类可以实现多个接口
注意接口索引数组大小就是
interfaces_count,无需减一!
- 作用:
This Class:类索引用于确定这个类的全限定名
Super Class:父类索引用于确定这个类的父类的全限定名
重点:由于Java 语言的单继承,所以父类索引只有一个,除了 java.lang.Object之外,所有的Java 类都有父类,因此除了 java.lang.Object外,所有Java类的父类索引都不为0。
Interfaces:接口索引数组用来描述这个 类实现/接口继承 了那些接口,这些被实现的接口将按implements(如果这个类本身是接口的话则是extends) 后的接口顺序从左到右排列在接口索引数组中
7)Fields(字段表数组)
- 定义:紧跟着接口索引数组后的就是字段表数组
fields,它用于描述接口或类中声明的变量。
注意,此处
fields中包括类级变量以及实例变量,但不包括在方法内部声明的局部变量!
    u2             fields_count;//变量数量
    field_info     fields[fields_count];//一个类中的所有变量数组(不包括方法中局部变量)
field_info数据结构:字段表数组中每一个字段信息用field_info封装,具体结构如下:
field_info {
	u2				access_flags;
	u2				name_index;
	u2				descriptor_index;
	u2				attributes_count;
	attribute_info	attributes[attributes_count];
}
access_flags:字段访问标志,标识当前字段的作用域(public、private、protected修饰符)、是实例变量还是类变量(static修饰符)、可否被序列化(transient修饰符)、可变性(final修饰符)、可见性(volatile修饰符)等:
| 字段访问标志 | 值 | 含义 |
|---|---|---|
| ACC_PUBLIC | 0x0001 | 声明为公共变量 |
| ACC_PRIVATE | 0x0002 | 声明为私有变量 |
| ACC_PROTECTED | 0x0004 | 声明为保护变量 |
| ACC_STATIC | 0x0008 | 声明为类变量 |
| ACC_FINAL | 0x0010 | 声明为静态变量 |
| ACC_VOLATILE | 0x0040 | 声明为可见变量 |
| ACC_TRANSIENT | 0x0080 | 声明为不可被序列化的变量 |
| ACC_SYNTHETIC | 0x1000 | 声明为合成变量,源码中不可见 |
| ACC_ENUM | 0x4000 | 声明为枚举类型的变量 |
注意字段的访问标志和类/接口层面的访问标志不等同!!
name_index:对常量池的引用,表示字段的名称descriptor_index:对常量池的引用,表示字段和方法的描述符(可以理解成数据类型)attributes_count:表示当前字段额外属性的个数attributes[attributes_count]:存放额外属性的数组
扩展:为什么
name_index和descriptor_index要进行引用,而非直接给出描述?→为了节省空间
1)字段的修饰符都是布尔值,要么有某个修饰符,要么没有,很适合使用标志位来表示
2)而字段叫什么名字、字段被定义为什么数据类型这些都是无法固定的,恰好常量池中已包含了该部分信息,直接引用常量池中常量来描述能够更好的节省空间
8)Methods(方法表数组)
- 定义:紧跟着字段表数组的就是方法表数组
methods,用于描述接口或类中声明的方法。
    u2             methods_count;//方法数量
    method_info    methods[methods_count];//一个类中所有方法的数组
method_info数据结构:方法表数组中每一个方法信息用method_info封装,其结构和字段表一样,依次包括了访问标志、名称索引、描述符索引、属性表数组几项:
method_info {
	u2				access_flags;
	u2				name_index;
	u2				descriptor_index;
	u2				attributes_count;
	attribute_info	attributes[attributes_count];
}
access_flags:方法访问标志,各种标志的值及含义如下:
| 方法访问标志 | 值 | 含义 |
|---|---|---|
| ACC_PUBLIC | 0x0001 | 声明为公共方法 |
| ACC_PRIVATE | 0x0002 | 声明为私有方法 |
| ACC_PROTECTED | 0x0004 | 声明为保护方法 |
| ACC_STATIC | 0x0008 | 声明为类方法 |
| ACC_FINAL | 0x0010 | 声明为静态方法 |
| ACC_SYNCHRONIZED | 0x0020 | 声明为同步方法 |
| ACC_BRIDGE | 0x0040 | 声明为桥接方法 |
| ACC_VARARGS | 0x0080 | 声明为桥接方法 |
| ACC_NATIVE | 0x0100 | 声明为本地方法 |
| ACC_ABSTRACT | 0x0400 | 声明为抽象方法 |
| ACC_STRICT | 0x0800 | 声明为strict方法(具体含义不是很懂) |
| ACC_SYNTHETIC | 0x1000 | 声明为合成方法,源码中不可见 |
方法访问标志和字段访问标志的区别:
1)因为volatile修饰符和transient修饰符不可以修饰方法,所以方法表的访问标志中没有这两个对应的标志。
2)但是增加了synchronized、native、abstract等关键字修饰方法,所以也就多了这些关键字对应的标志
9)Attributes(额外属性数组)
- 定义:在Class文件,字段表、方法表中都可以携带自己的额外属性数组,以用于描述某些场景专有的信息。
- 特性:
- 与 Class 文件中其它的数据项目要求的顺序、长度和内容不同,额外属性数组的限制稍微宽松一些,不再要求各个属性表具有严格的顺序。
- 并且只要不与已有的属性名重复,任何人实现的编译器都可以向属性表中写入自己定义的属性信息,Java虚拟机运行时会忽略掉它不认识的属性。
2.5 Java类生命周期解析
前言:
1)Java类生命过程又叫类的加载过程,具体可以分为:加载(Loading)→验证(Verification)→准备(Preparation)→解析(Resolution)→初始化(Initialization)→使用(Using)→卸载(Unloading)
2)其中验证→准备→解析这三个阶段可以统称为连接(Linking)
重点:需要注意的是,一般我们会将加载→连接→初始化这三个阶段称为广义上的类加载过程
2.5.1 加载(Loading)
1)介绍
1. **类加载阶段主要做了三件事情**:
《Java虚拟机规范》已有明确规定:
- 通过全类名获取定义此类的二进制字节流
- 将字节流所代表的静态存储结构转换为方法区的运行时数据结构
- 在内存中生成一个代表该类的Class对象,作为方法区这些数据的访问入口
- 如何完成?
- 通过类加载器(ClassLoader)
- 加载阶段与连接阶段的部分动作(如一部分字节码文件格式验证动作)是交叉进行的,加载阶段尚未结束,连接阶段可能就已经开始了。
2)类加载器(ClassLoader)
前言:
1)类加载器从JDK 1.0就出现了,最初只是为了满足Java Applet(已经被淘汰)的需要。后来,慢慢成为 Java 程序中的一个重要组成部分,赋予了Java类可以被动态加载到JVM中并执行的能力。
- 定义:类加载器(ClassLoader)是一个负责加载类的对象,用于实现类加载过程中的加载这一步。
- 功能:
- ClassLoader 是一个抽象类,通过给定类的二进制名称,类加载器尝试定位或生成构成类定义的数据。说人话就是:加载 Java 类的字节码文件
.class到 JVM中,并在内存中生成一个代表该类的Class对象 - 加载Java应用所需的资源如文本、图像、配置文件、视频等等文件资源
本节只看其核心功能:加载类
- 类加载器加载规则:
- 将名称转换为文件名,然后从文件系统中读取该名称的类文件
- JVM 启动的时候,并不会一次性加载所有的类,而是根据需要去动态加载。→大部分类在具体用到的时候才会去加载,这样对内存更加友好
- 采用缓存机制:对于已经加载的类会被放在ClassLoader缓存中。在类加载的时候,系统会首先判断当前类是否被加载过。已经被加载的类会直接返回,否则才会尝试加载。→对于一个类加载器来说,相同二进制名称的类只会被加载一次
public abstract class ClassLoader {
  ...
  private final ClassLoader parent;
  // 类加载器Class缓存
  private final Vector<Class<?>> classes = new Vector<>();
  // 由JVM调用,用此类加载器记录每个已加载类。
  void addClass(Class<?> c) {
        classes.addElement(c);
   }
  ...
}
扩展:JVM如何判断两个Java类是否相同?
1)JVM 不仅要看类的全名是否相同,还要看加载此类的类加载器是否一样。只有两者都相同的情况,才认为两个类是相同的。
2)即使两个类来源于同一个 Class 文件,被同一个虚拟机加载,只要加载它们的类加载器不同,那这两个类就必定不相同。
- java类与类加载器的关系:每个Java 类都有一个引用指向加载它的ClassLoader
- 数组的类加载器:
数组类不是通过 ClassLoader 创建的,而是JVM在需要的时候自动创建的,数组类通过getClassLoader()方法获取ClassLoader的时候和该数组的元素类型的ClassLoader是一致的
疑问:String[] a = new String[10]这样的数组?
- 场景示例:获取各种类型的类对应类加载器
public class ClassLoaderTest {
    public static void main(String[] args) throws ClassNotFoundException {
        ClassLoader cl1 = ClassLoaderTest.class.getClassLoader();
        // 类加载器的调用关系:AppClassLoader → ExtClassLoader → BootStrap ClassLoader
        System.out.println("cl1:" + cl1);// cl1:sun.misc.Launcher$AppClassLoader@18b4aac2,说明是AppClassLoader
        System.out.println("parent of cl1:" + cl1.getParent());// parent of cl1:sun.misc.Launcher$ExtClassLoader@355da254

        // 这里很特殊,结果为null是因为BootStrap ClassLoader是由C++开发的,是JVM的一部分,本身不是Jqva类
        System.out.println("grandfather of cl1:" + cl1.getParent().getParent());// grandfather of cl1:null

        // 上述论点可以通过Java原生引用类型String和集合类List来证明:获取的类加载器都返回null
        ClassLoader stringClassLoader = String.class.getClassLoader();
        System.out.println("String类加载器:" + stringClassLoader);// String类加载器:null
        System.out.println("List类加载器:" + cl1.loadClass("java.util.List").getClass().getClassLoader());// List类加载器:null
    }
}
- Java类的加载器:一共有3种自带的类加载器:
- BootstrapClassLoader:表示启动类加载器,又叫引导类加载器,最顶层的加载类,由C++实现,因此
getClassLoader()时结果为null,并且没有父级(parent),主要用来加JDK内部的核心类库以及被-Xbootclasspath参数指定的路径下的所有类。
扩展:核心类库包括
%JAVA_HOME%/lib目录下的rt.jar、resources.jar、charsets.jar等jar包和类
重点:Java原生的引用类型,如String、List等,在JVM启动时就提供了BootStrap ClassLoader加载器进行加载,只不过BootStrap ClassLoader是用C++实现的,因此直接获取时只能获取到null
- ExtClassLoader:表示扩展类加载器,也就是常说的Extention ClassLoader,主要负责加载
%JRE_HOME%/lib/ext目录下的jar包和类以及被java.ext.dirs系统变量所指定的路径下的所有类。 - AppClassLoader:表示应用程序类加载器,面向用户自定义的类,负责加载当前应用classpath下的所有jar包和类(就
/target下的)
- 层级关系:AppClassLoader → ExtClassLoader → BootStrap ClassLoader,箭头所指即各自上层父加载器
ExtClassLoader也就是常说的Extention ClassLoader
注意这三个类加载器并非父子类关系,它们只是通过
parent属性相关联,并使用组合关系来复用父加载器的代码:
public abstract class ClassLoader {
  ...
  // 组合
  private final ClassLoader parent;
  protected ClassLoader(ClassLoader parent) {
       this(checkCreateClassLoader(), parent);
  }
  ...
}
- 继承关系:
- AppClassLoader、ExtClassLoader都继承于URLClassLoader,而URLClassLoader又继承于SecureClassLoader,而SecureClassLoader继承于ClassLoader
- 验证各类加载器的加载路径:
public class ClassLoaderDirTest {
    public static void main(String[] args) {
        System.out.println("BootStrap ClassLoader加载目录:" + System.getProperty("sun.boot.class.path"));// BootStrap ClassLoader加载目录:C:\Program Files\Java\jdk1.8.0_191\jre\lib\resources.jar;C:\Program Files\Java\jdk1.8.0_191\jre\lib\rt.jar;C:\Program Files\Java\jdk1.8.0_191\jre\lib\sunrsasign.jar;C:\Program Files\Java\jdk1.8.0_191\jre\lib\jsse.jar;C:\Program Files\Java\jdk1.8.0_191\jre\lib\jce.jar;C:\Program Files\Java\jdk1.8.0_191\jre\lib\charsets.jar;C:\Program Files\Java\jdk1.8.0_191\jre\lib\jfr.jar;C:\Program Files\Java\jdk1.8.0_191\jre\classes
        System.out.println("Extention ClassLoader加载目录:" + System.getProperty("java.ext.dirs"));// Extention ClassLoader加载目录:C:\Program Files\Java\jdk1.8.0_191\jre\lib\ext;C:\WINDOWS\Sun\Java\lib\ext
        System.out.println("AppClassLoader加载目录:" + System.getProperty("java.class.path"));//
    }
}
3)从loadClass()方法看双亲委派机制(PDM)
- 定义:Java类加载的机制:向上委托查找,向下委托加载
- 双亲委派机制其实就是加载类的时候优先从当前类对应类加载器自身缓存获取,没有就从其父类加载器缓存获取,并以此循环到最高层次的BootStrap ClassLoader
- 还是没有就尝试先让BootStrap ClassLoader加载类,不行依次往下尝试加载。
- 示意图:

- 双亲委派机制的作用:
- 保护Java底层类不被用户覆盖
例如用户自己在项目中定义了
java.lang.String类,在获取该类的类加载器后,调用loadClass()方法并不会直接用用户自定义的String类,而是优先用Java原生的String类(被BootStrap ClassLoader给找到加载了),避免了用户对Java底层的类进行覆盖
- 避免类的重复加载
- 相关源码:
- 我们从测试类进入到ClassLoader类的
loadClass()方法中:核心就是调用loadClass()重载方法

public Class<?> loadClass(String name) throws ClassNotFoundException {
    return loadClass(name, false);
}
- 接着进入
loadClass()重载方法:synchronized锁部分一直到resolveClass()方法之前就是双亲委派机制的核心逻辑:

注意
loadClass()方法是protected修饰的,说明用户自定义ClassLoader子类可以重写该方法!
- 首先调用
findLoadedClass()方法,尝试获取加载过的class:

这也说明每个类加载器对它加载过的类,都是有缓存的
- 进入
findLoadedClass()方法:核心就是调用findLoadedClass0()这个native方法(由于是C++实现的,此处看不到了):

- 然后若缓存中没有当前class,则先判断当前类加载器的属性parent是否不为空,不为空说明存在父加载器,调用其
loadClass()方法来加载类;否则直接调用findBootstrapClassOrNull()方法,使用BootStrap ClassLoader来加载类:
 - 若依旧没加载到类,则自己调用
findClass()方法获取类:

4)Tomcat自定义类加载器来打破双亲委派机制
前言:一个非数组类的加载阶段(具体说是加载阶段获取类的二进制字节流的动作)是可控性最强的阶段,除了上述三种类加载器之外,用户还可以在该阶段加入自定义的类加载器来进行拓展,以满足自己的特殊需求。就比如说,我们可以对Java 类的字节码文件
.class进行加密,加载时再利用自定义的类加载器对其解密。
- 如何自定义类加载器:定义ClassLoader的子类,并重写
loadClass()方法或/和findClass()方法 - 如何打破双亲委托机制:重写
loadClass()方法
扩展:若是不想打破双亲委派机制呢?
1)重写ClassLoader 类中的findClass()方法即可,无法被父加载器加载的类最终会通过这个方法被加载
- Tomcat下web应用的类实现隔离的原理:
- Tomcat 服务器为了能够优先加载Web应用目录下的类,然后再加载其他目录下的类,就自定义了类加载器WebAppClassLoader来打破双亲委托机制
- Tomcat类加载器的层次结构:

- Tomcat自定义的类加载器:
- CommonClassLoader:作为CatalinaClassLoader和 SharedClassLoader的父加载器,CommonClassLoader能加载的类都可以被CatalinaClassLoader和SharedClassLoader使用。因此,CommonClassLoader是为了实现公共类库的共享和隔离。其加载目录为
<Tomcat>/common/*
此处公共类库指的是可以被所有Web应用和Tomcat内部组件使用的类库
- CatalinaClassLoader:用于加载Tomcat 自身的类,并隔离Tomcat本身的类和Web 应用的类。其加载目录为
<Tomcat >/server/* - SharedClassLoader:作为WebAppClassLoader的父加载器,专门来加载Web应用之间共享的类比如Spring、Mybatis框架的类。其加载目录为
<Tomcat >/shared/*
注意,CatalinaClassLoader和SharedClassLoader能加载的类则与对方相互隔离
- WebAppClassloader:每个 Web应用都会创建一个单独的 WebAppClassLoader,并在启动Web应用的线程里设置线程上下文类加载器(ThreadContextClassLoader)为WebAppClassLoader。其加载目录为
<Tomcat >/webapps/<app>/WEB-INF/*
单独设置WebAppClassLoader的好处:各个WebAppClassLoader 实例之间相互隔离,进而实现Web应用之间的类隔离。
关于线程上下文类加载器ThreadContextClassLoader的功能详见下文
5)线程上下文类加载器(ThreadContextClassLoader)
- 单独使用自定义类加载器的局限性:无法支持【高层的类加载器需要加载低层的加载器才能加载的类】的场景
吹逼废话,理解即可:
1)比如在SPI 中,SPI的接口(如java.sql.Driver)是由Java核心库提供的,从上文可知,其由BootstrapClassLoader加载。而SPI的具体实现(如com.mysql.cj.jdbc.Driver)是由第三方供应商提供的,它们是由应用程序类加载器或者自定义类加载器来加载的。默认情况下,一个类及其依赖类应该由同一个类加载器加载,按照这个思路,加载SPI的接口的类加载器BootstrapClassLoader也会用来加载SPI的实现。现实却是,按照双亲委派模型,BootstrapClassLoader是无法找到SPI的实现类的,因为它无法委托给子类加载器去尝试加载。
2)再比如,假设我们的项目中有Spring的jar包,由于其是Web应用之间共享的(假设Web服务器是Tomcat),因此会由SharedClassLoader加载。我们项目中有一些用到了Spring的业务类(比如实现了Spring提供的接口、用到了 Spring 提供的注解),通常我们希望加载Spring的类加载器SharedClassLoader也能加载这些业务类。但是业务类在Web应用目录下,不在 SharedClassLoader 的加载路径下,所以SharedClassLoader无法找到业务类,也就无法加载它们。
- 定义:线程上下文类加载器是线程的一个属性,用来打破双亲委托机制,加载其他层次类加载器才能加载的类(并不局限低层次)。
- 相关API:
Java.lang.Thread中的getContextClassLoader()方法和setContextClassLoader(ClassLoader cl)方法分别用来获取和设置线程的线程上下文类加载器。
如果没有通过
setContextClassLoader(ClassLoader cl)方法进行设置的话,线程将继承其父线程的线程上下文类加载器。
扩展:Spring应用获取线程上下文类加载器:
ClassLoader cl = Thread.currentThread().getContextClassLoader();
- 原理:将一个类加载器保存在线程私有数据里,跟线程绑定,然后在需要的时候取出来使用。
这个类加载器通常是由应用程序或者容器(如Tomcat)设置的。
- Tomcat中的应用:
- 当Spring需要加载业务类的时候,它不是用自己的类加载器,而是用当前线程的上下文类加载器。
- 在Tomcat容器中,每个Web应用都会创建一个单独的 WebAppClassLoader,并在启动Web 应用的线程里设置线程上下文类加载器为WebAppClassLoader。
- 这样就可以让高层的类加载器SharedClassLoader借助子类加载器 WebAppClassLoader来加载业务类,从而破坏了双亲委托机制,让应用逆向使用类加载器。
2.5.2 连接(Linking)
- 连接阶段对应源码:接上文源码解析,进行完双亲委派的操作后,就是执行
resolveClass()方法进行连接:

- 核心便是调用Java native方法
resolveClass0():
- 连接阶段分为三个小阶段:
- 验证:检查加载到的字节信息是否符合JVM规范。
- 准备:在JVM堆中创建类或接口的静态变量,并赋予初始值→对应半初始化状态
- 解析:把常量池中的符号引用替换成直接引用→在JVM中的体现就是让栈中的指针指向堆中的对象
1)验证(Verification)
注意,验证阶段与解析阶段的部分动作(例如符号引用验证动作)是交叉进行的,验证阶段尚未结束,解析阶段可能就已经开始了。
- 功能:检查加载到的字节信息是否符合JVM规范
- 确保字节码文件
.class的字节流中包含的信息符合《Java虚拟机规范》的全部约束要求,保证这些信息被当作代码运行后不会危害虚拟机自身的安全。
- 组成:主要由四个检验阶段组成,按照执行顺序如下:
- 文件格式验证:即字节码文件
.class格式检查。- 内容:验证字节流是否符合字节码文件
.class格式的规范,例如:①是否以0xCAFEBABE开头;②主次版本号是否在当前虚拟机的处理范围之内;③常量池中的常量是否有不被支持的类型等 - 目标:文件格式验证这一阶段是基于该类的二进制字节流进行的,主要目的是保证输入的字节流能正确地解析并存储于方法区之内,格式上符合描述一个Java类型信息的要求。
- 内容:验证字节流是否符合字节码文件
注意,除了这一阶段之外,其余三个验证阶段都是基于方法区的存储结构上进行的,不会再直接读取、操作字节流了。
- 元数据验证:主要是字节码语义检查,以保证其描述的信息符合《Java语言规范》的要求。例如:①该类是否有父类(除Object之外的类都有父类);②该类是否继承了不允许继承的类(比如被
final修饰的类)等。 - 字节码验证:主要是程序语义检查(通过数据流分析和控制流分析,确定程序语义是否合法、是否符合逻辑)。例如:①方法的参数类型是否正确;②对象类型转换是否合理(类似父类对象直接赋值给子类对象就报错)等。
- 符号引用验证:即类正确性检查:
- 内容:主要是类的正确性检查。例如:①该类依赖的其他类、方法、字段是否存在;②该类对依赖的资源是否拥有正确的访问权限等。
- 目标:确保解析阶段能正常执行,如果无法通过符号引用验证,JVM会抛出异常,例如:
java.lang.IllegalAccessError:当类试图访问或修改它没有权限访问的字段,或调用它没有权限访问的方法时,抛出该异常java.lang.NoSuchFieldError:当类试图访问或修改一个指定的对象字段,而该对象不再包含该字段时,抛出该异常java.lang.NoSuchMethodError:当类试图访问一个指定的方法,而该方法不存在时,抛出该异常
符号引用验证发生在类加载过程中的解析阶段,具体点说是 JVM将符号引用转化为直接引用的时候
关于符号引用和直接引用的概念详见解析阶段
- 必要性:尽管验证阶段耗费的资源相对较多,但很有必要,可以有效防止恶意代码的执行。
任何时候,程序安全都是第一位!
- 跳过验证阶段的方法:
-Xverify:none
- 验证阶段并非必须执行,如果程序运行的全部代码(包括自己编写的、第三方包中的、从外部加载的、动态生成的等所有代码)都已经被反复使用和验证过,在生产环境的实施阶段就可以考虑使用
-Xverify:none参数来关闭大部分的类验证措施,以缩短虚拟机类加载的时间
2)准备(Preparation)
- 功能:准备阶段是正式为类变量分配内存并设置类变量 零值的阶段,这些内存JDK1.7之前在方法区中分配,JDK1.7之后则是在Java堆中分配。
- 目标:仅包括类变量,而不包括实例变量。
- 类变量(Class Variables):即静态变量,被 static 关键字修饰的变量,只与类相关
- 实例变量:只在对象实例化时随着对象一块分配在Java堆中
关于类变量的存储位置:
1)从JVM规范上来讲,类变量所使用的内存都应当在方法区中进行分配。
2)JDK1.7之前,HotSpot 使用永久代来实现方法区的时候,实现是完全符合这种逻辑概念的。 而在 JDK1.7及之后,HotSpot 已经把原本放在永久代的字符串常量池、静态变量等移动到堆中,这个时候类变量则会随着Class对象一起存放在Java堆中
- 零值:零值是数据类型的默认值,它不等同于声明的类变量以及成员变量的初始值。在准备阶段通常情况下给类变量赋值零值,除非该变量使用final修饰时才赋值初始值。
- 例如一个类中定义类变量
public static int value = 111;,该变量value在准备阶段只会赋零值(为0),而不是初始值111(111需等到初始化阶段才赋值) - 若给
value加final修饰,则准备阶段value就赋值111了
- 基本数据类型的零值:
| 数据类型 | 零值 |
|---|---|
| int | 0 |
| long | 0L |
| short | (short)0 |
| char | ‘\u0000’ |
| byte | (byte)0 |
| boolean | false |
| float | 0.0f |
| double | 0.0d |
| reference | null |
3)解析(Resolution)
- 定义:虚拟机将常量池内的符号引用替换为直接引用的过程,也就是得到类或者字段、方法在内存中的指针或者偏移量。
在该阶段会交叉进行符号引用验证。
- 目标:解析动作主要针对类或接口、字段、类方法、接口方法、方法类型、方法句柄和调用限定符7类符号引用进行。
- 符号引用:
- 符号引用以一组符号来描述所引用的目标。
- 符号可以是任何形式的字面量,只要使用时能无歧义地定位到目标即可。
- 符号引用与JVM实现的内存布局无关,引用的内容不一定是已经加载到JVM中的内容。
扩展:
1)《Java虚拟机规范》规定,各种JVM实现的内存布局可以不同,但是它们能接受的符号引用必须是一致的!
2)符号引用的字面量形式定义在了《Java虚拟机规范》的Class文件格式中!
- 直接引用:
- 直接引用是可以直接指向目标的指针、相对偏移量或者是一个能间接定位到目标的句柄。
- 直接引用和符号引用不同,它和JVM实现的内存布局直接相关。
- 同一个符号引用在不同JVM实例上翻译出来的直接引用一般不会相同
- 如果已经有直接引用了,那么其引用的目标一定已经在JVM的内存中了!
- 原理:
- 在程序执行方法时,系统需要明确知道这个方法所在的位置。
- JVM为每个类都准备了一张方法表数组(Methods)来存放类中所有的方法。
- 当需要调用一个类的方法的时候,只要知道这个方法在方法表数组中的偏移量就可以直接调用该方法了。
- 通过解析、操作 符号引用就可以直接转变为目标方法在类中方法表数组的位置,从而使得方法可以被调用。
2.5.3 初始化(Initialization)
- 定义:初始化阶段是执行初始化方法
<clinit>()方法的过程,是广义上类加载过程的最后一步。
这一步JVM才开始真正执行字节码
- 关于
<clinit>()方法:
- 是编译之后自动生成的。
- 因为
<clinit>()方法带锁,从而保证了JVM在多线程环境中对该方法调用时的线程安全性。同时多线程初始化也可能会引起多个线程阻塞,并且这种阻塞很难被发现。
- 类初始化时机:包含6种情况,一句话概括就是只有主动去使用类才会初始化类:
- 当JVM遇到
new、getstatic、putstatic或invokestatic这4条字节码指令时,比如new一个类,读取一个静态字段(未被final修饰)、或调用一个类的静态方法时:new指令:创建一个类的实例对象。getstatic指令:访问类的静态变量(不是静态常量,常量会被加载到运行时常量池)。putstatic指令:给类的静态变量赋值。invokestatic指令:调用类的静态方法。
- 使用
java.lang.reflect包的方法对类进行反射调用时,如Class.forname("...")、newInstance()等等,如果类没初始化,需要触发其初始化。 - 如果待初始化的类的父类还未初始化,则先触发该父类的初始化
- 当虚拟机启动时,用户需要定义一个要执行的主类(包含
main()方法的类),虚拟机会先初始化这个类 MethodHandle和VarHandle可以看作是轻量级的反射调用机制,而要想使用这2个调用,就必须先使用findStaticVarHandle来初始化要调用的类。- 当一个接口中定义了JDK1.8新加入的默认方法(被
default关键字修饰的接口方法)时,如果该接口的实现类待初始化,那该接口要在其之前先被初始化。
2.5.4 使用(Using)
- 涉及到使用类的场景:
- 获取类类型或其类加载器:详见加载阶段说明
- Java对象创建:详见后文Java对象创建过程
- Java对象垃圾回收:详见后文Java对象回收
2.5.5 类卸载(Unloading)
- 功能:将类的Class对象进行垃圾回收(GC)
- 条件:也是判断一个类是否是无用的类的条件:
-
该类的所有的实例对象都已被GC:也就是说堆不存在该类的实例对象。
意味着没有对象头指向该类的类元信息了!
-
该类没有在其他任何地方被引用,无法在任何地方通过反射访问该类的方法。
-
该类的类加载器的实例已被GC:
- JVM自带的类加载器BootstrapClassLoader、ExtClassLoader、AppClassLoader的实例肯定不能GC,因此类加载器对应的类是不会被卸载的,进而其加载的类也不能被卸载。
- 而我们自定义的类加载器的实例是可以被回收的,所以由我们自定义的类加载器加载的类是可以被卸载的。
2.6 Java对象的创建
说白了就是对象创建到销毁的过程,对应Java类生命周期的使用阶段
2.6.1 Java对象内存布局(OOP)
1)OOP-Klass对象模型
HotSpot JVM 并没有根据Java实例对象直接通过虚拟机映射到新建的
C++对象,而是设计了一个OOP-Klass模型。
- 定义:
OOP-Klass对象模型是HotSpot JVM实现的、用来描述Java对象和C++对象间关系的模型。 - 设计理念:no virtual functions allowed 虚函数禁止:
- HotSopt JVM的设计者不想让每个对象中都含有一个
vtable(虚函数表),所以就把对象模型拆成Klass和OOP。 - 其中
OOP中不含有任何虚函数,而Klass就含有虚函数表,可以进行方法派遣(method dispatch)。
该模型参照了Strongtalk VM底层的对象模型
所谓方法派遣method dispatch,指的就是当某个方法被调用时,JVM知道如何选择将要执行的字节码指令
2)OOP(Ordinary Object Pointer)
- 定义:普通对象指针,它用来表示对象的实例信息。
- 创建时机:是在
new的时候创建的。 - 组成:

| 对象信息(OOP,32位版) | ||||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 对象头信息 | 实例数据 Instance Data | 对齐填充 Padding | ||||||||||||||
| Mark World | Klass Pointer | 数组长度(只在数组时才有) | ||||||||||||||
| 锁状态 | 25bit | 4bit | 1bit | 2bit | ||||||||||||
| 23bit | 2bit | 是否偏向锁 | 锁标志位 | |||||||||||||
| 无锁状态 | 对象的hashCode | 分代年龄 | 0 | 01 | ||||||||||||
| 轻量级锁 | 指向栈中锁记录的指针 | 00 | ||||||||||||||
| 重量级锁 | 指向互斥量(重量级锁)的指针 | 10 | ||||||||||||||
| GC标记 | 空 | 11 | ||||||||||||||
| 偏向锁 | 线程ID | Epoch | 分代年龄 | 1 | 01 | |||||||||||
-
对象头:包含Mark Word标记字段和Klasss Pointer类型的元数据指针以及数组长度信息(仅当是数组时):
-
Mark Word:32位占4字节,64位占8字节,主要存储对象运行时数据:如hashCode、GC分代年龄、锁状态标志(偏向锁、轻量级锁、重量级锁)、线程持有的锁、偏向线程ID、偏向时间戳等。注意,标记字段中记录的数据是随着对象的锁状态而不断变化的:
1)无锁状态下会用前25bit记录对象的hashCode, 之后4bit记录对象的分代年龄,再用1bit记录是否偏向锁(明显不是。。),最后使用2bit表示当前的锁状态标志为01-无锁;
2)到了偏向锁时,前25bit中的前23bit改为记录偏向线程ID了,后2bit改为记录时间戳
-
metadata:元数据指针,是Klasss Pointer类型,它指向方法区的instanceKlass实例(Klass对象)。虚拟机通过这个指针来确定这个对象是哪个类的实例。元数据指针长度:开启压缩占4字节,关闭压缩占8字节
-
数组长度:4字节,只有当对象是数组对象时才有
-
-
对象字段数据:
field data:实例数据,又叫实例数据(Instance Data),存储Java源代码中定义的各种类型字段内容,具体包括父类继承以及子类定义的对象字段。
-
对齐补充:
padding:对齐补充,非必须,用来保证对象大小是8字节的整数倍,这是对象寻址效率最高的一种方式。
扩展:对齐补充padding存在的意义:
1)HotSpot JVM要求对象大小必须是8字节(64 bit)的整数倍(也就是对象起始地址必须是8字节的整数倍),而对象头部分是8字节的整数倍(1倍或2倍)
2)因此,当对象实例数据部分没有对齐时,就需要通过对齐填充来补全。
- 底层C++源码:
- oopDesc类:是各种oop类的共同基类:
class oopDesc
{
  friend class VMStructs;
  private:
      volatile markOop  _mark; // 对象头
      union _metadata
      {
        wideKlassOop    _klass;//普通指针
        narrowOop       _compressed_klass;//压缩类指针
      }
      _metadata;

  private:
      // field addresses in oop
      void*     field_base(int offset)        const;

      jbyte*    byte_field_addr(int offset)   const;
      jchar*    char_field_addr(int offset)   const;
      jboolean* bool_field_addr(int offset)   const;
      jint*     int_field_addr(int offset)    const;
      jshort*   short_field_addr(int offset)  const;
      jlong*    long_field_addr(int offset)   const;
      jfloat*   float_field_addr(int offset)  const;
      jdouble*  double_field_addr(int offset) const;
      address*  address_field_addr(int offset) const;
}
- instanceOopDesc类:是oopDesc的一个子类,表示堆中一个具体的Java对象实例:
class instanceOopDesc : public oopDesc {
	public:
	static int header_size()
	{
		return sizeof(instanceOopDesc)/HeapWordSize;
	}

	static int base_offset_in_bytes()
	{
		return UseCompressOops ? klass_gap_offset_in_bytes(): sizeof(instanceOopDesc);
	}

	static bool contains_field_offset(int offset, int nonstatic_field_size)
	{
		int base_in_bytes = base_offset_in_bytes();
		return (offset >= base_in_bytes && (offset-base_in_bytes) < nonstatic_field_size * heapOopSize);
	}
};
3)Klass对象和Class对象的关系
- Klass对象:即
instanceKlass实例,是Java类在HotSpot JVM中的C++对等体,用来描述Java类,代表一个类的元数据。
- 一般JVM在加载
.class文件时,会在方法区创建instanceKlass实例,表示其元数据,包括常量池、字段、方法等。 instanceKlass实例是HotSpot JVM内部用的,JVM并不把instanceKlass实例暴露给 Java层(开发者)使用。
- Class对象:是HotSpot VM内部用的Klass对象的“镜像”(
Java mirror):JVM把InstanceKlass实例包装了一层来暴露给Java层(开发者)使用。
- 主要用途:提供反射访问
- 完成创建时机:加载->连接->初始化的加载阶段
- 内存位置:在堆内存中
- 包含内容:
ClassLoader(类加载器类)
4)OOP(Java对象)和Klass对象、Class对象的关系
- 图示:

- 每个Java对象的对象头里,
_klass字段会指向一个JVM内部用来记录类的元数据用的InstanceKlass实例。 - klass与mirror之间的双向引用:
1)
insanceKlass里_java_mirror字段指向该类所对应的Class对象(Java mirror);
2)HotSpot VM会给Class对象注入一个隐藏字段klass(注意不是_klass字段!!),用于指回到其对应的InstanceKlass实例
- 静态变量内存位置的变化:
- JDK1.7之前,HotSpot VM把静态变量存在
InstanceKlass实例的末尾; - JDK1.7之后,为了配合PermGen(永久代)移除的工作,静态变量被挪到Class对象(
Java mirror)的末尾了。
5)使用new 类名()创建对象的底层加工过程
- 以类A为例,执行
new A()前(执行invokespecial A::),如果这个类没有被加载过,JVM会先进行类的加载,并在方法区创建一个instanceKlass实例表示这个类的运行时元数据。 - 同时,在堆内存中会自动构造一个镜像的Class对象提供反射访问(它和
instanceKlass实例持有着双向引用) - 加载完类后,JVM就会在堆分配内存,创建一个
instanceOopDesc对象表示A的实例,并调用构造函数初始化A的实例
3.1 初始化实例包括以下动作:
1)进行Mark Word的填充;
2)将元数据指针(KlassPointer)指向instanceKlass实例
3)填充实例变量、执行构造方法
- 返回该实例的指针到栈空间对应线程。
6)Java对象复制
- Java对象复制的方式:将一个对象的引用复制给另外一个对象,一共有三种方式:直接赋值、浅拷贝、深拷贝。
- 直接赋值:
A a1 = a2;
直接赋值实际上复制的是引用,也就是说
a1和a2指向的是同一个对象。因此,当a1变化的时候,a2里面的成员变量也会跟
着变化。
- 浅拷贝:在拷贝一个对象时,对对象的基本数据类型的成员变量进行拷贝,但对引用类型的成员变量只进行引用的传递,并没有创建一个新的对象,当对引用类型的内容修改会影响被拷贝的对象。
- 实现方式:Java中的
clone()方法是一个浅拷贝,其拷贝出的对象实例内部引用类型成员依然在引用传递。 - 代码示例:
class Person implements Cloneable {
	private int age;// 整形
	private String name;// 引用类型
	public Object clone() {
		try {
			// 仅仅拷贝了Person对象实例,内部的String类型成员依旧是之前的引用,未重新创建String成员实例
			return (Person) super.clone();
		} catch (Exception e) {
			e.printStackTrace();
			return null;
		}
	}
}
- 深拷贝:在拷贝一个对象时,除了对基本数据类型的成员变量进行拷贝,对引用类型的成员变量进行拷贝时,创建一个新的对象实例来保存引用类型的成员变量。
- 实现方式1:序列化该对象,然后反序列化回来,就能得到一个新的对象了。
- 实现方式2:继续利用
clone()方法,对该对象的引用类型成员再实现一次clone()方法:
class Person implements Cloneable {
	private int age;// 整形
	private String name;// 引用类型
	public Object clone() {
		Person p = null;
		try {
			// 先拷贝了Person对象实例
			p = (Person) super.clone();
			// 再拷贝内部的String引用类型成员
			p.name = (String) name.clone();
		} catch (Exception e) {
			e.printStackTrace();
			return null;
		}
	}
}
注意区分零拷贝!!详见并发编程篇章
7)对象的访问方式
建立对象就是为了使用对象,Java程序通过栈上的reference数据来操作堆上的具体对象。
对象的访问方式由虚拟机实现而定,目前主流的访问方式有使用句柄和直接指针这两种:
- 使用句柄: 如果使用句柄的话,那么Java堆中将会划分出一块内存来作为句柄池,reference中存储的就是对象的句柄地址,而句柄中包含了对象实例数据与类型数据各自的具体地址信息:

- 优势:使用句柄访问的最大好处就是对象引用中存储的是稳定的句柄地址,在对象被移动(比如垃圾回收时,整理内存空间,会移动对象的存储位置)时只会改变句柄中示例数据的指针,而对象引用本身不需要修改。
- 使用直接指针:如果使用直接指针访问,那么Java堆对象的布局中就必须考虑如何放置访问类型数据的相关信息,而reference中存储的直接就是对象的地址:

- 优势:使用直接指针访问的方式,类似于C++ 中的虚表(虚表就是指向对象类型数据的指针),其最大好处就是速度更快,节省了一次内存寻址的时间开销。
8)其他内容
- 创建Java对象用什么关键字?
new关键字,new创建对象实例。
- 对象引用和对象实例的区别:
1)对象实例在堆内存中,对象引用存放在栈内存中。
2)一个对象引用可以指向0个或1个对象实例,一个对象实例可以有n个引用指向它。
- 创建对象的4种方式:
- new创建新对象
- 通过反射机制:详见反射章节
- 采用clone机制
- 通过序列化机制
- 对象的上转型对象(父类引用指向子类对象实例):
- 不能访问子类相比父类新增出的成员
- 不能访问子类相比父类新增出的方法【重载方法包含在内】
- 能被强制转换为子类对象(下转型对象)
- 对象的相等与指向他们的引用相等,两者有什么不同?:
- 对象的相等:比的是内存中存放的内容是否相等。
- 引用相等:比的是他们指向的内存地址是否相等。
通常不特别指明的话,提到的对象就是指对象实例,而不需要考虑对象引用。
2.6.2 Java对象创建过程
分为类加载过程检查→分配内存→初始化零值→设置对象头→执行
init()方法这5个步骤
1)类加载过程检查
- 虚拟机遇到一条
new指令时,首先将去检查这个指令的参数是否能在常量池中定位到这个类的符号引用。 - 然后检查这个符号引用代表的类是否已被加载、解析和初始化过。如果没有,那必须先执行相应的类加载过程。
2)分配内存
- 操作:在类加载过程检查通过后,接下来虚拟机将为新生对象分配内存。
对象所需的内存大小在类加载完成后便可确定,为对象分配空间的任务等同于把一块确定大小的内存从Java堆中划分出来。
- Java对象内存分配流程:
-
new一个对象,先判断当前对象能否在栈帧上分配?
栈帧上分配涉及到对象的逃逸分析
-
若未开启逃逸分析或开启了但在栈上分配失败,则向堆中分配内存
-
若当前对象是大对象,则直接分配到老年代(Old);若不是大对象,则优先在TLAB中分配内存,分配失败则在外部Eden区分配
- 内存分配的方式:为新生对象分配内存有两种方式有指针碰撞和空闲列表两种方式:
| 分配方式 | 适用场合 | 原理 | 对应GC收集器 |
|---|---|---|---|
| 指针碰撞 | 堆内存规整(即没有内存碎片)的情况下 | 用过的内存全部整合到一边,没有用过的内存放在另一边,中间有一个分界值指针。在分配内存时,只需要向没用过的内存方向 将该指针移动对象内存大小位置即可 | Serial、ParNew |
| 空闲列表 | 堆内存不规整的情况下(已使用内存和空闲内存交错) | JVM会维护一个列表,空闲内存块,从而在分配内存时找到足够大的空间分配给对象实例,最后更新列表记录 | CMS |
- 内存分配方式的使用策略:
- JVM默认使用指针碰撞进行内存分配
- 选择那种分配方式由Java 堆是否规整决定,而Java堆是否规整又由所采用的垃圾收集器是否带有压缩整理功能决定(即取决于垃圾收集器算法是标记-清除,还是标记-整理(标记-压缩):
- 后续讲GC算法会说明,标记整理算法和标记复制算法处理后的内存是规整的,适合指针碰撞的方式分配内存;
- 而标记清除算法处理后会有大量的内存碎片,则适合使用空闲列表
- JVM如何保证内存分配的线程安全:并发下多个线程可能对同一片内存进行争抢,需解决并发问题,常见两种方式如下:
-
本地线程分配缓冲(Thread Local Allocation Buffer,TLAB):
-
定义:为了避免线程争抢,预先在JVM堆(具体是Eden空间)中划分出当前线程专属的空间,之后JVM在给线程中的对象分配内存时,首先在TLAB(Java堆中的线程私有缓冲区)分配,当对象大于TLAB中的剩余内存或TLAB的内存已用尽时,再采用CAS+失败重试的方式进行内存分配
-
开启/关闭TLAB:JVM默认开启TLAB:
# 开启TLAB: -XX:+UseTLAB # 关闭TLAB: -XX:-UseTLAB -
指定TLAB大小:默认大小为Eden区的1%,不推荐人工指定
-XX:TLABSize
-
-
CAS+失败重试:都去抢,失败则重试(抢下一个空间),从而保证更新操作的原子性
CAS是乐观锁的一种实现方式。所谓乐观锁就是,每次不加锁而是假设没有冲突而去完成某项操作,如果因为冲突失败就重试,直到成功为止。
3)初始化零值
- 操作:内存分配完成后,虚拟机需要将分配到的内存空间中的对象字段数据(
field data)赋予零值
注意不包括对象头以及对齐补充部分!!具体数据类型的零值见上文
- 意义:保证了对象的实例字段在Java 代码中可以不赋初始值就直接使用,程序能访问到这些字段的数据类型所对应的零值
4)设置对象头
- 操作:初始化零值完成之后,虚拟机要对对象头进行必要的设置:
- 这个对象是哪个类的实例
- 如何才能找到类的元数据信息、对象的哈希码、对象的 GC 分代年龄等信息
- 根据虚拟机当前运行状态的不同,是否启用偏向锁等
5)执行init()方法
在上面工作都完成之后,从虚拟机的视角来看,一个新的对象已经产生了,但从Java 程序的视角来看,对象创建才刚开始,
<init>()方法还没有执行,所有的字段都还为零。
- 前提:执行完
new指令 - 操作:执行
<init>()方法,把对象按照程序员的意愿进行字段初始化:
- 对成员变量使用用户声明的值进行赋值
- 执行构造方法
这样一个真正可用的对象才算完全产生出来。
2.6.3 Java对象指针压缩
1)查看Java对象大小
- 对象大小可以通过jolcore包查看,引入依赖如下:
<dependency>
	<groupId>org.openjdk.jol</groupId>
	<artifactId>jol‐core</artifactId>
	<version>0.9</version>
</dependency>
2)Java对象指针压缩及原理
- 定义:JDK1.6开始,在64位操作系统中,JVM支持指针压缩。开启后可以让指针中的地址压缩到4个字节,从而减小对象大小,方便主内存和缓存间移动数据。同时,相同内存下,能存放的对象越多,GC频率越低。(一句话,开启指针压缩就是为了节约内存空间!)
- 开启方式:JDK1.6之后JVM默认开启,开启后对象头以及实例数据中的指针都会被压缩:
-XX:+UseCompressedOops
- 关闭方式:禁止指针压缩:
-XX:-UseCompressedOops
- 压缩对象头里的类型指针:若禁止指针压缩(
-XX:-UseCompressedOops),仅开启对象头类型指针压缩(-XX:+UseCompressedClassPointers),仅会压缩对象头中的类型指针,不会去压缩实例数据中的寻址指针:
-XX:+UseCompressedClassPointers
- Java对象指针压缩的原理:
- 32位系统,最大支持内存为 232 =4G,而64位系统自然最大支持内存是264,是个相当大的数值。
- 当前市面上流行8G、16G、32G内存,对应地址(指针)位数分别为33、34、35。很显然只能使用64位系统来进行管理。
- 而指针压缩就是将原本33、34、35位的地址(指针)通过一定算法,压缩到32位存储到内存中,等CPU寄存器取出该地址时再解码成33、34、35位的地址(CPU运算时就是原本的33、34、35位)
- Java对象指针压缩的使用策略:与JVM堆内存有关
- 堆内存小于4G时,无需开启指针压缩,JVM会直接去除高32位地址(即使用低虚拟机地址)
- 堆内存不要超过32G!大于32G时,压缩指针会直接失效,堆中强制使用64位(即8字节)来存储地址,这就造成指针过大、对象过大、主内存和缓存间移动数据占用较大带宽,且相同内存下GC频次也会变高。
2.7 Java对象回收(JVM垃圾回收)
2.7.1 Minor GC与Full GC
1)Minor GC
-
定义:Eden区对象存储满时,JVM的字节码执行引擎会开启一个垃圾回收线程(Minor GC)进行垃圾回收(GC), 目的是将新生代中的无用对象进行回收。
-
Minor GC回收过程:
- 从方法区、栈中寻找GC Roots根节点:线程栈的本地变量、静态变量、本地方法栈的变量等(1:38:40)
- 从GC Roots出发,寻找所有引用的对象,在该链上的对象都视作非垃圾对象。
- 针对Eden区处理:
- 若Eden区即将添加的对象存储空间不够,则将非垃圾对象从Eden区搬到空的Survivor区(最初是S0,此处作区分叫SurvivorTo区),同时将这批对象的分代年龄(位于对象头)置为1。
- 若搬到SurvivorTo区过程中发现SurvivorTo区空间不够(达到Survivor区对象大小阈值),则直接转移到老年代。
- 迁移完成后,Eden区中剩余的对象就被视作垃圾对象,直接干掉(GC)
- 针对Survivor区处理:
- 分代年龄<对象动态年龄阈值(比方说15):将存有对象的Survivor区(最初是S0,此处作区分叫SurvivorFrom区)中的非垃圾对象搬到空Survivor区(最初是S1,此处作区分叫SurvivorTo区),同时将这批对象的分代年龄+1(1:41:20)。
- 若搬到SurvivorTo区过程中发现SurvivorTo区空间不够(达到Survivor区对象大小阈值),则直接转移到老年代。
- 分代年龄≥对象动态年龄阈值:将存有对象的Survivor区中的非垃圾对象搬到老年代。
- 迁移完成后,SurvivorFrom区中剩余的对象被视作垃圾对象,直接干掉(GC)。
- 当某次向老年代搬运对象发现老年代存储不够时,会先触发Full GC(会对整个堆和方法区进行回收);Full GC完毕后若发现老年代存储依旧不够,JVM才会报OOM异常。
- Minor GC不一定比Full GC快:
- 当堆内存足够大,新生代达到40个G左右时,CMS及之前的GC收集器Minor GC的时间开销远大于后续的Full GC,因为遍历新生代太耗时了。
2)Full GC
- 定义:Full GC和Major GC都是一个意思,它会对整个堆和方法区进行回收
3)如何打印GC日志
-XX:+PrintGC
2.7.2 STW机制
- 定义:STW机制又叫Stop The World。无论Minor GC、Full GC,都有可能触发STW,它表示停止整个事件,对于JVM来说就是停止掉所有用户线程(指用户发起的线程)。
- 危害:若STW时间较长,对用户的感知就是操作有卡顿,对体验和性能有影响
- Minor GC和Full GC中STW时间的区别:
- JVM调优的目的就是为了减少GC(无论Minor GC、Full GC),当然主要是 Full GC,因为其回收范围最大,时间最长,其STW时间也最长。
- 至于Minor GC,尽管频率高,但其操作时间较短,STW时间对用户来说几乎无感
- JVM为什么设置STW机制?
- JVM在GC过程中需要先遍历GC Roots链,当某一条链遍历完后,若此时没有引入STW机制,则链上的相应对象所在方法就能继续执行。
- 方法执行完毕,按理来说此时原本方法中的局部变量已经变成垃圾对象,而由于GC Roots遍历完了该链,就没处理到该对象,JVM认为该对象还是非垃圾对象,这就使得GC失去了意义。
2.7.3 对象逃逸分析
- 定义:一个对象在方法中创建后并返回,则该对象视作逃逸了。而一个对象在方法中创建直到方法执行结束都没有返回,则该对象视作未逃逸。
- 开启逃逸分析的好处:针对未逃逸的对象,因为随着方法执行完毕就可以确定是垃圾对象了,可以尝试在当前线程的栈帧中分配内存,从而在方法执行完毕后跟栈帧一起销毁,减少GC压力。
- 开启方式:JDK1.7后默认开启。JVM开启后可以优化对象内存分配位置,使其通过标量替换优先分配在栈上:
-XX:+DoEscapeAnalysis
开启逃逸分析并不代表该对象一定在栈帧中分配内存!这取决于栈帧中是否存在足够空间进行内存分配(无论是否开启标量替换)!
- 关闭方式:
-XX:-DoEscapeAnalysis
2.7.4 标量替换
- 定义:
- JVM通过逃逸分析确定对象不会逃逸后,则会判断对象大小是否超过栈帧空闲大小,未超过则尝试在栈帧中分配内存空间
- 通常栈帧中内存块并非连续的,当栈帧中不存在足够大的、连续的内存块进行对象分配时,JVM不会创建该对象,而是将该对象拆分出一个个标量(通常就是成员变量),依次在栈帧(或寄存器)中空闲内存块进行分配
- 开启标量替换:JDK1.7之后默认开启:
-XX:+EliminateAllocations
- 标量替换开启并起作用的前提:开启逃逸分析并确定该对象是未逃逸对象:
- 因为标量替换是对象在栈帧中分配内存的处理方式,没有开启逃逸分析,或开启了但发现对象逃逸了,就不会在栈帧中分配内存。
- 标量与聚合量:
- 标量:不可被进一步分解的量。Java基本数据类型(
int、long、reference等)就是标量。 - 聚合量:可被进一步分解的量。典型的就是Java对象
2.7.5 对象动态年龄阈值
- 定义:是指对象晋升老年代的分代年龄最大值
- 人工指定阈值:默认晋升年龄并不都是15,这个是要区分垃圾收集器的,CMS就默认是6
-XX:MaxTenuringThreshold=15 // 指定对象动态年龄阈值为15岁
- 对象动态年龄判断机制:即对象动态年龄阈值算法,适用于JDK1.8开始
- 定义:
- 如果一批非垃圾对象在开启Minor GC时,尝试从Eden区或SurvivorFrom区迁移到空的SurvivorTo区,按照分代年龄从小到大进行汇总累加
- 当这批对象的总大小累积到大于等于SurvivorTo区的Survivor区对象大小阈值(默认为SurvivorTo区内存大小的50%)时,假设此时最大对象分代年龄到
n了,取n和MaxTenuringThreshold中更小的一个值,作为新的对象动态年龄阈值 - 把年龄大于等于对象动态年龄阈值的对象都放入老年代中
- 触发条件:通常在Minor GC过程中
- 意义:希望那些可能长期存活的对象能尽早进入老年代
- 相关C++源码:
uint ageTable::compute_tenuring_threshold(size_t survivor_capacity) {
	// survivor_capacity是survivor空间的大小
	size_t desired_survivor_size = (size_t)((((double) survivor_capacity)*TargetSurvivorRatio)/100);
	size_t total = 0;
	uint age = 1;
	while (age < table_size) {
		// sizes数组是每个年龄段对象大小
		total += sizes[age];
		if (total > desired_survivor_size) break;
		age++;
	}
	uint result = age < MaxTenuringThreshold ? age : MaxTenuringThreshold;
	...
}
2.7.6 老年代空间分配担保机制
了解之前先看下亿级流量电商系统JVM参数设置优化(一)
-
实际JVM在Eden区满后,并非直接进行Minor GC,而是先判断当前老年代中剩余可用空间大小是否大于等于年轻代里当前所有对象大小,如果是,说明即便全不回收也放的下,则直接进行Minor GC;如果不是则接着往下判断:
-
判断JVM是否开启了分配担保机制(通过参数
-XX:-HandlePromotionFailure开启,注意是-而非+),若没开启,就直接进行Full GC;若开启了接着往下判断: -
判断老年代中剩余可用空间大小是否大于等于历史每次Minor GC进入老年代的平均对象大小,如果是,说明大概率Minor GC后放的下,则进行Minor GC;如果不是,则直接进行Full GC,Full GC做完后再进行Minor GC
Full GC操作内存不局限于老年代,而是堆和方法区!!这边Full GC做完后再进行Minor GC感觉有点多此一举了,JVM的GC策略有问题的。。。
平均对象大小:例如第一次Minor GC后50MB对象进入老年代,第五次Minor GC后40MB对象进入老年代,第十次Minor GC后30MB对象进入老年代,那么平均对象大小为40MB。注意次数是进入老年代的次数,也就是3次,而非Minor GC的次数!!
2.7.7 引用计数法与可达性分析法
- 引用计数法:每个对象有一个引用计数属性,新增一个引用时计数加1,引用释放时计数减1,计数为0时回收
- 优势:效率高
- 缺陷:可能出现循环引用的情况:A引用了B的同时B又引用了A。这样即使他们都不再使用了,但因为相互引用,引用计数器始终为1,永远无法被回收→从而造成内存泄露
- 使用该算法的语言:phyphon、go
- 可达性分析法:JVM采用的是该方法。从GC Roots开始向下搜索,搜索所走过的路程称为引用链,其上的引用处于可达状态(reachable)。当一个对象到GC Roots没有任何引用链相连时,则证明此对象是不可用的,那么虚拟机就判断是可回收对象(无用对象)
- GC Roots的对象有:
- 虚拟机栈(栈帧中的本地变量表)中引用的对象;
- 方法区中类静态属性(
static变量)引用的对象; - 方法区中常量引用的对象;
- 本地方法栈中JNI(Java Native方法)引用的对象
- 可达性分析法下不可达对象的回收过程:
- 不可达对象并非立即死亡,对象拥有一次自我拯救的机会(在
finalize()方法中) - 对象被JVM宣告死亡至少要经历两次标记过程:第一次是可达性分析发现其没有与GC Roots相连接的引用链;第二次是在由JVM自动建立的Finalizer队列中判断其是否需要执行
finalize()方法,关于第二次的过程具体如下:- 当对象变成GC Roots不可达时,GC会判断该对象是否覆盖了
finalize()方法。 - 若未覆盖,则直接将其回收。若覆盖,则判断对象是否尚未执行
finalize()方法。尚未执行的话就将其放入F-Queue队列,由一级优先级线程执行该队列中对象的finalize()方法。 finalize()方法中只要让该对象重新与GC Roots引用链上的任意对象建立关联(例如把自己赋值给某个类变量或成员变量),那么该对象就会被移出F-Queue队列。如果finalize()方法没做当前对象的引用关联,那基本后续就要被回收了。
- 当对象变成GC Roots不可达时,GC会判断该对象是否覆盖了
- 执行完
finalize()方法后,GC会再次判断对象是否可达,若不可达则进行回收,否则对象复活
扩展:关于
finalize()方法:
1)finalize()方法主要用来进行对象的销毁前置操作。每个对象最多只能触发一次finalize()方法;
2)由于finalize()方法运行代价高昂,不确定性大,无法保证各个对象的调用顺序,因此不推荐使用。
2.7.8 常见引用类型
1)介绍
- 不同JDK版本中对于对象引用的使用规范:
- 在JDK 1.2以前的版本中,若一个对象不被任何变量引用,那么程序就无法再使用这个对象。也就是说,只有对象处于可达状态(reachable),程序才能使用它。
- 从JDK 1.2版本开始,对象的引用被划分为4种级别,从而使程序能更加灵活地控制对象的生命周期。这4种级别由高到低依次为:强引用、软引用、弱引用和虚引用
- 常见引用类型及特性:
| 引用类型 | 引用对象回收时机 | 应用 | 仅有该引用的对应对象生存时间 |
|---|---|---|---|
| 强引用 | 不被回收 | 表示对象状态 | 超过对象的生命周期时 |
| 软引用 | 内存不足时 | 高速缓存 | ①超过对象的生命周期时②内存不足时 |
| 弱引用 | GC线程扫描到时 | 不希望干预原本对象的生命周期 | gc运行后若未将对象存入引用队列则终止 |
| 虚引用 | GC线程扫描到时 | 不希望干预原本对象的生命周期,且希望对象被销毁前做些前置工作 | gc运行后终止 |
2)强引用(StrongReference)
- 定义:强引用是使用最普遍的引用(即默认声明模式下),强引用在程序内存不足报OutOfMemoryError错误(OOM),使程序异常终止的时候也不会被回收,使用方式如下:
Object o = new Object();// o便是强引用
- 强引用对应对象的回收:如果想要回收强引用对应对象,有两种方式:
- 显式赋值null来弱化引用:
o=null; - 让引用的对象超出生命周期范围:在一个方法的内部有一个强引用,这个引用保存在栈中,而真正的引用内容(对象Object)保存在堆中。当这个方法运行完成后就会退出方法栈,则对象的引用不存在,这个对象会被回收:
public void test(){
    Object o = new Object();
    // 省略其他操作
}
上述两种方式都可以让gc认为该对象不存在引用,这时就可以回收对象了,具体什么时候收集这要取决于gc的算法
- 强引用对象回收的应用:
- 数组类容器的数据清理:在ArrayList类中定义了一个私有的变量
elementData数组,在调用clear()方法清空数组时可以看到为每个数组内容elementData[i]赋值为null,而不是直接elementData=null。这样做一是能够很好的清理内存,二是让强引用仍然存在,避免在后续调用add()等方法添加元素时进行重新的内存分配:
private transient Object[] elementData;

public void clear() {
    modCount++;
    // Let gc do its work
    for (int i = 0; i < size; i++)
        elementData[i] = null;
    size = 0;
}
3)软引用(SoftReference)
- 定义:将对象用SoftReference类型包裹,得到的被包裹对象的引用。这种引用对应的对象正常情况不会被回收,如果GC做完后发现空间不够存放新对象,且被包裹对象的引用只存在软引用,则将被包裹的对象进行回收。
- 语法:
T为泛型,该语法表示对SoftReference类型包裹的对象进行软引用;
// 直接创建一个软引用,注意sr本身不是软引用,它是一个SoftReference类型的强引用(软引用引用的是`某个对象`,只不过这个软引用没显式声明出来罢了)
SoftReference<T> sr = new SoftReference<T>(某个对象);
// 关联ReferenceQueue实例是为了将软引用的对象被回收后存入该引用队列
SoftReference<T> sr = new SoftReference<T>(某个对象, ReferenceQueue实例);
- 应用示例:
// 注意:wrf这个引用也是强引用,它是指向SoftReference这个对象的,
// 这里的软引用指的是指向new String("str")的引用,也就是SoftReference类中T
SoftReference<String> wrf = new SoftReference<String>(new String("str"));
// 强引用str
String str=new String("abc");
// 声明一个abc字符串常量的软引用
SoftReference<String> softRef=new SoftReference<String>(str);
// 将str弱化,这样后续才能在GC时将软引用对应的对象abc给回收了
str=null;
- 特性:
-
如果一个对象只具有软引用,当GC做完后内存空间足够存放新对象,垃圾回收器就不会回收它;
一个对象被软引用,不代表内存紧张时就能被GC,因为有可能该对象还有强引用!!
-
如果GC做完后内存空间不足以存放新对象,JVM就会回收这些对象的内存(如果关联了ReferenceQueue则在回收后会将该对象存入引用队列)。
当内存不足时,软引用等价于:
If(JVM.内存不足()) {
   str = null;  // 转换为软引用
   System.gc(); // 垃圾回收器进行回收
}
- 应用场景:
- 用来实现内存敏感的高速缓存:创建缓存的时候,创建的对象放进缓存中,当内存不足时,JVM就会回收早先创建的对象
- 浏览器网页缓存:内存吃紧的时候回收,内存不紧张的时候则缓存:
Browser prev = new Browser();               // 获取页面进行浏览
SoftReference sr = new SoftReference(prev); // 浏览完毕后置为软引用
if(sr.get()!=null){
    rev = (Browser) sr.get();           // 还没有被回收器回收,直接获取
}else{
    prev = new Browser();               // 由于内存吃紧,所以对软引用的对象回收了
    sr = new SoftReference(prev);       // 重新构建
}
- 和引用队列(ReferenceQueue)联合使用:
- 在创建SoftReference实例时关联一个ReferenceQueue对象,则软引用所引用的对象被垃圾回收器回收后,JVM就会把这个软引用引用的对象加入到与之关联的引用队列中:
ReferenceQueue<String> referenceQueue = new ReferenceQueue<>();
String str = new String("abc");
SoftReference<String> softReference = new SoftReference<>(str, referenceQueue);
System.out.println(softReference.get());// abc

// 将唯一强引用str弱化
str = null;
// Notify GC
System.gc();

try {// 下面休息几分钟,让上面的垃圾回收线程运行完成
    Thread.currentThread().sleep(6000);
} catch (InterruptedException e) {
    e.printStackTrace();
}

System.out.println(softReference.get());// null

Reference<? extends String> reference = referenceQueue.poll();
System.out.println(reference);// abc
4)弱引用(WeakReference)
- 定义:将对象用WeakReference类型包裹,得到的被包裹对象的引用。
- 语法:类似SoftReference
WeakReference<T> wr = new WeakReference<T>(某个对象);
WeakReference<T> wr = new WeakReference<T>(某个对象, ReferenceQueue实例);
- 特性:
- 弱引用与软引用的区别在于:只具有弱引用的对象拥有更短暂的生命周期。在垃圾回收器线程扫描它所管辖的内存区域的过程中,一旦发现了只具有弱引用的对象,不管当前内存空间足够与否,都会回收它的内存(如果关联了ReferenceQueue则在回收后会将该对象存入引用队列)。
不过,由于垃圾回收器是一个优先级很低的线程,因此不一定会很快发现那些只具有弱引用的对象
-
如何让弱引用的对象变成强引用:
String abc = wr.get(); -
应用场景:当你想引用一个对象,但是这个对象有自己的生命周期,你不想介入这个对象的生命周期,这时候你就用弱引用。
-
和引用队列(ReferenceQueue)联合使用:
- 在创建WeakReference实例时关联一个ReferenceQueue对象,则弱引用所引用的对象被垃圾回收器回收后,JVM就会把这个弱引用引用的对象加入到与之关联的引用队列中:
public class ReferenceTest {

    private static ReferenceQueue<VeryBig> rq = new ReferenceQueue<VeryBig>();

    public static void checkQueue() {
        Reference<? extends VeryBig> ref = null;
        while ((ref = rq.poll()) != null) {
            if (ref != null) {
                System.out.println("In queue: "    + ((VeryBigWeakReference) (ref)).id);
            }
        }
    }

    public static void main(String args[]) {
        int size = 3;
        LinkedList<WeakReference<VeryBig>> weakList = new LinkedList<WeakReference<VeryBig>>();
        for (int i = 0; i < size; i++) {
            weakList.add(new VeryBigWeakReference(new VeryBig("Weak " + i), rq));
            System.out.println("Just created weak: " + weakList.getLast());

        }

        System.gc();
        try {// 下面休息几分钟,让上面的垃圾回收线程运行完成
            Thread.currentThread().sleep(6000);
        } catch (InterruptedException e) {
            e.printStackTrace();
        }
        checkQueue();
    }
}

class VeryBig {
    public String id;
    // 占用空间,让线程进行回收
    byte[] b = new byte[2 * 1024];

    public VeryBig(String id) {
        this.id = id;
    }

    protected void finalize() {
        System.out.println("Finalizing VeryBig " + id);
    }
}

class VeryBigWeakReference extends WeakReference<VeryBig> {
    public String id;

    public VeryBigWeakReference(VeryBig big, ReferenceQueue<VeryBig> rq) {
        super(big, rq);
        this.id = big.id;
    }

    protected void finalize() {
        System.out.println("Finalizing VeryBigWeakReference " + id);
    }
}
/**
最终输出结果:
Just created weak: com.javabase.reference.VeryBigWeakReference@1641c0
Just created weak: com.javabase.reference.VeryBigWeakReference@136ab79
Just created weak: com.javabase.reference.VeryBigWeakReference@33c1aa
Finalizing VeryBig Weak 2
Finalizing VeryBig Weak 1
Finalizing VeryBig Weak 0
In queue: Weak 1
In queue: Weak 2
In queue: Weak 0
**/
5)虚引用(PhantomReference)
- 定义:将对象用PhantomReference类型包裹,得到的被包裹对象的引用。
- 语法:必须配合ReferenceQueue引用队列使用
PhantomReference<T> wr = new PhantomReference<T>(某个对象, ReferenceQueue实例);
- 特性:只具有虚引用的对象拥有更短暂的生命周期。在垃圾回收器线程扫描它所管辖的内存区域的过程中,一旦发现了只具有虚引用的对象,不管当前内存空间足够与否,都会回收它的内存。
回收机制和弱引用很像,但并不完全一致
- 虚引用与软引用和弱引用的区别:
- 虚引用必须和引用队列 (ReferenceQueue)联合使用,且在回收前先将引用的对象存入引用队列中;
- 软引用和弱引用是在回收对象后才将引用的对象存入引用队列中。
- 应用场景:虚引用主要用来进行对象销毁前的一些操作,比如说资源释放等。
finalize()方法虽然也可以做这类动作,但是既不安全又低效,不推荐使用!
2.8 垃圾收集算法与垃圾收集器
2.8.1 垃圾收集算法与相关数据结构
1)分代收集理论
- 定义:根据堆中年轻代和老年代的特点,选择对应的垃圾收集算法。
- 比如在新生代中,每次收集都会有大量对象(近99%)死去,所以可以选择复制算法,只需要付出少量对象的复制成本就可以完成每次垃圾收集。
- 而老年代的对象存活几率是比较高的,而且没有额外的空间对它进行分配担保,所以我们必须选择“标记-清除”或“标记-整理”算法进行垃圾收集。注意,“标记-清除”或“标记-整理”算法会比复制算法慢10倍以上
除了这三种基础的GC算法外,还有三色标记算法用来解决并发标记过程中存在的漏标问题
此外记忆集与卡表这类数据结构也很好的解决了跨代引用效率低下的问题
2)标记-复制算法
- 定义:将内存空间对半分,每次使用其中一边。当一边内存使用完后,就通过可达性分析算法,将还存活的对象复制到另一边去(复制完后一般会整理碎片),然后再把使用过的这边内存一次性清理掉,确保每次内存回收都是对一半内存进行回收
- 图示:

-
存在的问题:空间利用率太低,一半空间直接浪费了。
这个问题年轻代使用可能还不明显,老年代根本不能用这个算法,因为大部分都是存活的
3)标记-清除算法
- 定义:属于最基础的收集算法,相对简单,包含标记和清除两个阶段:
- 标记:标记存活的对象
- 清除:然后统一回收所有没被标记的对象
扩展:正常使用上述策略,还有一种就是标记反过来的,即标记所有需要回收的对象,标记完成后再统一回收所有被标记的对象
- 图示:

- 存在的问题:
- 效率问题:如果需要标记的对象太多,效率不高(这个取决于内存大小,内存越大效率越低)
- 空间问题:标记-清除后会产生大量不连续的碎片。
- 碎片的危害:如果一个对象需要连续的内存块,而尽管空闲内存空间足够,但却找不到合适大小的连续内存块,对象在没有做标量替换的情况下依旧无法在内存中进行分配
4)标记-整理算法
- 定义:根据老年代的特点所提出的算法,可以理解成是对标记-清除算法的升级,包含标记、整理和清除三个阶段:
-
标记:标记存活的对象
-
整理:标记完成后,将标记的对象统一向内存一端移动(即压缩整理,期间会通过写屏障机制同步修改内存地址),如果其上已经有垃圾对象了则覆盖,最终目标是使其连续
压缩整理这个阶段一般要开启STW
-
清除:统一回收剩余没有被标记的对象
- 图示:

- 好处:标记整理完成后内存规整,避免了碎片的产生
5)三色标记算法
学习该算法需结合CMS收集器相关知识来进行
- 定义:基于JDK1.8,在GC过程中,把GC Roots引用链上的对象,按照是否访问过来标记成以下三种颜色:
- 黑色:该对象已经被GC线程访问到,且这个对象的所有引用(仅局限当前对象内,引用对应的对象其内部引用不管)都已经扫描过,则标记该对象为黑色。
- GC时不可删除黑色对象。
- 黑色标记的对象是可用对象,如果有其他对象引用指向了黑色对象,无需重新从该黑色对象开始再扫描一遍。
- 灰色:该对象已经被GC线程访问到,但这个对象上至少存在一个引用还没有被扫描到(是一个进行中的状态)。
- GC时不可删除灰色对象
- 白色:该对象尚未被GC线程访问到。可达性分析开始阶段所有对象都是白色的,若在可达性分析结束还是白色,就表示该对象不可达,GC时可以删除白色对象
- 用途:用来解决并发标记过程存在的问题:以CMS收集器为例,在并发标记过程中,用户线程和GC线程并行执行,对象间的引用可能发生变化,从而出现多标或漏标的情况:
-
多标:原本方法中的局部变量还是可用状态,因此CMS会根据根据可达性分析算法,通过GC Roots引用链将其引用的对象标记为可用对象。但是若方法先于标记结束,其结束后本身以及引用的对象也应该是垃圾对象,这些对象不应该再标记为可用对象,从而出现多标的情况。
多标没关系,当作浮动垃圾由下次GC时清理掉即可
-
漏标:分为两种情况:
- 并发标记期间新增的对象,其最开始可能不在初始标记阶段的GC Roots上,CMS从初始标记的标记对象出发,根据引用链遍历时无法发现这些对象。等该链遍历结束时引用更新(新增引用等)才关联上GC Roots的话就可能漏标记这些对象。这批对象就会被当作垃圾对象给误删。
- 并发标记期间原本就有的对象,其原本在初始标记阶段的GC Roots上,但是在并发标记过程中,因为用户线程并行执行导致其脱离GC Roots(引用删除等引用更新),恰好此时GC线程扫描到了原本引用该对象的对象,则扫描时无法发现该脱离的对象。等该链遍历结束时引用更新(新增引用等)才关联上GC Roots的话就可能漏标记这些对象。这批对象就会被当作垃圾对象给误删。
漏标属于非常严重的bug,必须要解决
- 漏标过程代码示例:
// 情况1
public class ThreeColorRemark {

    public static void main(String[] args) {
    	// 1.假设用户线程执行new方法这一步触发Full GC,开始做初始标记

        // 2.开始做并发标记,假设开始执行对象A的构造语句,那么在扫描A对象的过程中,根据三色标记算法,引用关系如下:
    	// A(黑色)→B(灰色),假设B对象尚在扫描中,因此B对象灰色
        // A(黑色)→null,A.d引用删除了
        // A对象扫描完成,开始扫描其引用的B对象
    	// B(灰色)→C(黑色):C对象已经扫描完毕,标识为黑色
    	// B(灰色)→D(白色),假设还没扫描到B.d这个引用,此时A构造方法还没置B.d = null
        // D(白色),D对象尚未被访问
        A a = new A();

        // 4.用户线程并行执行
        D d = new D();// 【关键】新构造了一个对象D2,初始为白色对象,尽管在GC Roots上,但是因为CMS是从初始标记的对象开始沿着GC Roots遍历的,根本遍历不到d
        // 新增引用:A(黑色)→D2(白色)
        a.d = d; // 给A的成员d赋值D2,属于新增的引用,但是A对象已经扫描完成了,因此对象D2漏标

        // 5. 开始做重新标记,开启STW
        // 6. 开始做并发清理,此时用户线程并行创建了对象E,直接被标记为黑色对象
        E e = new E();// E创建出来就黑色
    }
}

class A {
    // 注意此处d赋值为null也是一种引用删除的情况!!不要漏咯
    D d = null;
    B b = new B();
    // 3.引用删除:用户线程把B.d引用置为空,此时恰好最后扫描到B对象的B.d,则:B(黑色)→null
    b.d = null;
}

class B {
    C c = new C();
    D d = new D();
}

class C {
}

class D {
}
// 情况2
public class ThreeColorRemark {

    public static void main(String[] args) {
        // 1.假设用户线程执行new方法这一步触发Full GC,开始做初始标记
        A a = new A();
        // 2.开始做并发标记,假设开始执行对象A的构造语句,那么在扫描A对象的过程中,根据三色标记算法,引用关系如下:
        // A(黑色)→B(灰色),假设B对象尚在扫描中,因此B对象灰色
        // A(黑色)→null,A.d引用删除了
        // A对象扫描完成,开始扫描其引用的B对象
    	// B(灰色)→C(黑色):C对象已经扫描完毕,标识为黑色
    	// B(灰色)→D(白色),假设还没扫描到B.d这个引用
        // D(白色),D对象尚未被访问

        // 先备份B对象的d引用的D对象
        D d = a.b.d;
        // 3.用户线程置B对象的d引用为空,此时若GC线程恰好开始扫描B的d引用,会发现其为空,D对象获取不到
        a.b.d = null;
        // 4.用户线程给A对象的d引用指向之前的D对象,由于GC线程已经扫描了A对象,因此不会再给D对象标记,从而出现漏标
        a.d = d;

        // 5. 开始做重新标记,开启STW
    }
}

class A {
    B b = new B();
    D d = null;
}

class B {
    C c = new C();
    D d = new D();
}

class C {
}

class D {
}
- 通用漏标的解决方案:例如CMS会利用CPU的读写屏障,来实现如下解决方案:
-
增量更新(Incremental Update):在并发标记期间,CMS会开启一个异步线程,将引用更新后的引用(例如新增的引用)使用集合存储起来(拷贝)。等到后续重新标记阶段,CMS会遍历集合中的引用,将引用涉及到的源头对象(例如A)无论黑灰,都先标记为灰色,然后重新去扫描这些对象内部的引用。如果这些引用确实可达(B对象存在),则将引用的对象(目标对象)标识为灰色,继续沿着引用链进行遍历(深度扫描)。
开启异步线程:源码证明详见视频2:21:34,此处略
引用更新后的引用 :是指对象原本的引用因赋值发生变化后的引用
注意,重新标记阶段因为开启STW,集合中的引用不会发生变化(也就是说对象的状态不会发生变化),引用变化只会发生在并发标记阶段
-
原始快照(Snapshot At The Beginning,SATB):针对并发标记期间出现的引用更新前的引用(赋值为null)的情况,G1会开启一个异步线程(注意此处是G1不是CMS了),将原本的引用关系使用集合存储起来(拷贝)。等到后续重新标记阶段,G1会遍历集合中的引用,从源头对象出发进行扫描,对于当前引用如果可达(目标对象存在,但可能不再是引用删除前的原本目标对象了),则将引用的对象直接标记为黑色,不再对其进行深度扫描。
这样该目标对象本轮GC就能存活下来(可能是浮动垃圾),需留到下一轮GC来判断是否需要清理
原始快照在遍历到目标对象后就不再深度扫描了,这点和增量更新不同!
开启异步线程+集合存储的目的:无论原始快照还是增量更新,都是赋值操作前后的操作,需要异步进行,以防止对已有的写操作造成影响,从而提升性能
- 增量更新和SATB实现原理:根据CPU写屏障实现的
- 写屏障:
-
无论是新增引用还是删除引用,都是通过赋值操作,而在赋值操作前、后加入的一些操作被称作写屏障
类似Spring中的AOP,但与并发编程中的内存执行屏障不是一回事!
-
赋值操作C++代码:
/**
* @param field 某对象的成员变量,如a.b.d,在C++中就是一个指针对象,在Java中表示引用关系
* @param new_value 新值,如null
*/
void oop_field_store(oop* field, oop new_value) {
    *field = new_value;// 赋值操作
}
- 伪代码描述写屏障:类似适配器模式、AOP那样在目标方法前后加前后操作
/**
* @param field 某对象的成员变量,如a.b.d,在C++中就是一个对象指针,在Java中表示引用关系
* @param new_value 新值,如null
*/
void oop_field_store(oop* field, oop new_value) {
    pre_write_barrier(field);// 写屏障-写前操作
    *field = new_value;// 赋值操作,*field这个对象指针指向了new_value
    post_write_barrier(field, new_value);// 写屏障-写后操作
}
- 写屏障源码:在
oop.inline.hpp文件中:
template <class T> inline void oop_store(volatile T* p, oop v) {
	update_barrier_set_pre((T*)p, v);// 写前操作
	oopDesc::release_encode_store_heap_oop(p, v);// 赋值操作
	update_barrier_set((void*)p, v);// 写后操作
}
- 写屏障实现SATB:当出现引用更新时,可以利用写屏障保存原本的成员变量引用:
void pre_write_barrier(oop* field) {
    oop old_value = *field;// 取出对象指针的值(是个指针),赋值给old_value,它代表了原本的成员变量的引用关系
    remark_set.add(old_value);// 记录原来的引用关系
}
- 写屏障实现增量更新:当出现引用更新时,可以利用写屏障保存修改后的成员变量引用:
void post_write_barrier(oop* field, oop new_value) {
    remark_set.add(field);// 记录新的引用
}
- 不同垃圾处理器对漏标的具体处理方案:
- CMS:写屏障+增量更新
- G1、Shenandoah:写屏障+SATB
- ZGC:读屏障
- 为什么G1用SATB,而CMS用增量更新?
- SATB尽管会产生更多的浮动垃圾,但相对增量更新效率会更高:SATB不需要在重新标记阶段对旧引用的对象(目标对象)做深度扫描,而CMS会从源头对象开始就深度扫描,目标对象自然也要被深度扫描
- G1因为对象分配在一个个region中,且相邻region的角色可能不同,做不到像CMS那样让堆在物理层面有明确的分代界限。因此深度扫描对象的话G1存在大量跨代引用的情况,即便每个Eden region有卡表的支持其代价也比CMS要高(每个区的卡表也要扫描的,而CMS就一个卡表),只能选择使用SATB来减少扫描次数。
- 同时G1收集器对于堆内存要求是大内存(8G以上,100G以下),恰好能够满足SATB在用户线程高并发下产生大量浮动垃圾的场景。
- CMS收集器对应的堆内存通常在4G~6G,深度扫描造成的STW停顿时间不长;且内存不高CMS更需要节约内存的使用,需尽量避免浮动垃圾的产生,因此选择增量更新的解决方案。
6)记忆集与卡表
- 记忆集:是JVM分配在新生代中的数据结构,记录了非当前GC区到GC区的指针集合(引用集合)。
- 记忆集的使用背景:
-
Minor GC通过可达性分析算法,根据GC Roots在给新生代做扫描时,针对跨代引用(老年代对象引用新生代对象),如果又要去老年代扫描的话效率就太低了,因此JVM在新生代中引入了记忆集(Remember Set)的数据结构来解决跨代引用效率低下的问题。
为什么遇到跨代引用不建议去老年代进行扫描:跨代引用在JVM中发生的很少,因此全局扫描老年代太不划算了
除了老年代对新生代的这种跨代引用,实际上所有涉及部分区域收集行为(Partial GC)的垃圾收集器(例如G1、ZGC和Shenandoah),都会存在跨代引用的问题。
-
使用记忆集的好处:引入记忆集后,GC线程只需要扫描记忆集就能判断出某一块非GC区是否存在指向当前GC区的指针,不需要了解跨代引用的全部细节
-
卡表(Card Table):位于新生代中,是HotSpot VM对记忆集的具体实现(类似Map和HashMap的关系)。
注意,即便是G1收集器在物理层面上已经没有一整个大的Eden、S0、S1区了,但是在每个Eden region、Survivor region中依旧维护了卡表,记录了Old region对新生代region的跨代引用。
-
卡表底层数据结构:为字节数组
CARD_TABLE[],每个元素包含两个要素:一是跨代引用标识位(1bit),还有一个是指向其标识的内存区域(一般是非当前GC区,例如老年代)里一块特定大小的内存块(512字节)的起始地址,其中这个内存块称作卡页(Card Page):
| Card Table数据结构 | ||||
|---|---|---|---|---|
| 索引 | CardTable[0] | CardTable[1] | ... | CardTable[n] |
| 跨代引用标识(1bit) | 0 | 1 | ... | 1 |
| 卡页起始地址(7bit) | 0x0100 | 0x0200 | ... | 0x1000 |
- 卡页:通常是GC过程中非当前GC区(例如老年代)的一个内存块(页内存),在HotSpot中卡页大小是29=512字节,其中会存放n个对象。
- 跨代引用标识:只要卡页中有一个对象跨代引用了当前GC区域的对象(肯定要有赋值操作),那么就表示这个卡页脏了(Dirty),HotSpot VM需通过写屏障将卡表索引位置的元素跨代引用标识置1,否则为0。
- 卡表的功能:GC时会扫描卡表,将其中跨代引用标识为1的元素对应的卡页中的对象加入到GC Roots里
2.8.2 垃圾收集器
1)介绍
-
定义:C++实现的使用垃圾收集算法的类。垃圾收集算法是理论,垃圾收集器就是具体实现
-
种类:市面上目前有8种垃圾收集器:Serial、Parellel、ParNew、CMS、G1、ZGC、Shenandoah、Epslion。

扩展:为什么需要这么多的垃圾收集器?
1)之所以有这么多的垃圾收集器,是因为没有哪个垃圾收集器是完美的,敢说自己在任何场景下都适用的
2)例如G1适用于8g到几百G内存;ZGC适用于4T及以上内存,且停顿控制在10ms内
2)Serial垃圾收集器
- 定义:Serial(串行)收集器是最基本、历史最悠久的垃圾收集器,它是单线程的。
- 特点:
- 该收集器只会使用一条GC线程来完成GC工作
- GC时会触发STW:Serial收集器在进行GC时必须暂停其他所有用户线程,直到其工作结束
- 工作流程:

- 种类:包含两个版本:Serial、Serial Old:
-
Serial垃圾收集器:采用标记-复制算法,只能处理年轻代,对应Minor GC;
-
Serial Old垃圾收集器:采用标记-整理算法,可以处理老年代,对应Full GC
重点:Serial Old不代表不可以处理年轻代!只是老年代更适合
-
开启方式:
-XX:+UseSerialGC // 开启使用Serial收集器 -XX:+UseSerialOldGC // 开启使用Serial Old收集器 -
优势:
- 简单,没有复杂的调优参数
- 单核下GC过程相比并行垃圾收集器要快
- 缺陷:单线程下效率太低
3)Parallel Scavenge收集器(Parallel收集器)
- 定义:Parallel收集器是Serial收集器的多线程版本,其控制参数、收集算法、回收策略等和Serial收集器类似。
- 特点:
- GC过程中一样会触发STW:多GC线程并发执行,其他所有用户线程暂停执行,直到所有GC线程执行结束
- 工作流程:

-
种类:同样包含Parallel、Parallel Old两个版本,分别负责年轻代(标记-复制算法)和老年代(标记-整理算法)的GC。
-
线程数设置:Parallel收集器开启的GC线程数默认和CPU核数相同,可以使用如下参数修改:
-XX:ParallelGCThreads=4 // 开启4个GC线程注意,该参数不推荐修改!原因如下:
1)因为人工指定线程数多余核数,多出的那些线程会争抢CPU调度,成为伪并行,效率可能不高反低;
2)而少于CPU核数又会无法释放性能
-
开启方式:
-XX:UseParallelGC // 开启使用Parallel收集器 -XX:UseParallelOldGC // 开启使用Parallel Old收集器 -
应用:JDK1.8版本,JVM默认使用Parallel和Parallel Old来分别处理年轻代、老年代的GC,适合2~3GB的堆内存来使用
-
优点:多核下能更好的释放CPU性能,GC效率相比于串行收集器更高
-
缺陷:在内存较大时,GC过程中STW时长较长,性能依旧有影响
4)ParNew收集器
-
定义:ParNew收集器GC过程跟Parallel收集器类似,只不过Parallel收集器由于早期JDK的实现,无法跟CMS收集器配合运行,因此JVM推出了配合CMS收集器的ParNew收集器
-
特点:CMS收集器重点清理老年代,因此ParNew收集器负责年轻代的GC
-
工作流程:GC过程和Parallel收集器类似:

-
开启方式:
-XX:+UseParNewGC
5)CMS收集器
-
定义:CMS收集器(Concurrent Mark Sweep 并发标记清除)是一种以获取最短STW停顿时间为目标的收集器。它是HotSpot VM第一款真正意义的并发收集器,首次实现了GC线程与用户线程的并发执行
严格来说只能叫基本并发。。
-
特点:CMS收集器的GC过程属于Full GC,因此处理范围在堆和方法区(元空间),只不过重点清理老年代罢了。
-
工作流程:CMS采用标记清除算法,其GC处理过程如下:

-
初始标记:开启STW(暂停所有其他线程),并使用可达性分析算法,从GC Roots出发,标记所有GC Roots直接能引用的对象。这一步速度很快。
开启STW的原因:不STW,不断有局部变量引用新对象,这个初始标记阶段做不完了。。
-
并发标记:用户线程和GC线程并行执行,过程耗时长(一般CMS的GC耗时80%都在并发标记阶段),期间不开启STW:
-
GC线程从初始标记标记的对象出发,沿着GC Roots引用链遍历所有对象并进行标记
-
存在的问题:用户线程正常运行,可能导致已标记的对象状态发生改变
状态发生改变主要是指漏标的情况:
1)例如并发标记阶段,原本GC Roots上某个对象的某个成员变量被GC线程扫描时还是null,没做引用,等到该对象都被GC扫描完成后,用户线程执行又给它的这个成员变量重新赋值了,那这个赋值的对象由于没被GC线程在并发标记阶段扫描到,从而出现了漏标
不开启STW的原因:
1)堆内存稍微大些(几个G有几百万、几千万对象时),完整遍历GC Roots引用链耗时很长,如果STW的话对用户体验和性能影响很大
-
-
重新标记:该阶段主要修复 并发标记时 那些由于用户线程运行 而导致状态发生改变(主要是漏标的情况) 的已标记对象。
漏标的概念详见上文以及下文三色标记算法
- 该阶段需要开启STW,不过STW停顿时间相比初始标记阶段稍长,比并发标记阶段短很多
- 使用的算法:CMS使用的三色标记里的增量更新算法,G1使用的三色标记里的SATB算法
-
并发清理:用户线程继续和GC线程并行执行,GC线程对未标记的对象进行清理
- CMS针对当前阶段新增的对象,会使用三色标记算法将其标记为黑色,从而排除出去不作处理(可能产生浮动垃圾)
-
并发重置:用户线程和GC线程并行执行,GC线程重置本次GC过程中的标记数据
-
优点:CMS收集器的关注点是提升吞吐量,更高效的利用CPU,提升用户体验
吞吐量:CPU中用于运行用户代码的时间 与 CPU总消耗时间的比值
-
缺陷:
-
与Parallel、ParNew收集器相比,会出现用户线程跟GC线程争抢CPU资源的情况
-
无法处理浮动垃圾,只能等下次GC再清理
浮动垃圾:CMS在并发标记和并发清理阶段,可能存在刚创建没多久的对象变成无用对象的情况,这类对象无法被此次GC清理,因此叫做浮动垃圾
-
CMS使用的标记-清除算法,在GC结束后会出现大量空间碎片
补救方式:可以通过
-XX:+UseCMSCompactAtFullCollection参数让CMS在Full GC结束后再做压缩整理,注意压缩整理时会STW,通过写屏障来更新内存地址,这对性能肯定有影响。剩的内存越少,停顿时间越短,通常来说停顿时间还能接受) -
可能出现Concurrent Mode Failure(并发模式失败)问题:触发Full GC是因为老年代没空间存新对象了,而CMS又允许在并发标记、并发清理阶段用户线程并行执行,这就可能导致期间新增的对象(例如大对象)又存不进老年代,继而再次触发Full GC。这种情况下表明并发已经失败了,JVM会强制STW,并使用Serial Old收集器进行GC,效率会非常低。
补救方式:Concurrent Mode Failure问题可以通过
-XX:CMSInitiatingOccupancyFraction=80参数来解决,该参数表示在老年代使用率达到80%时就触发Full GC(CMS默认为92%),通过调低该比例从而为老年代预留空间,避免并发标记和并发清理阶段的新对象无法存入老年代!
- CMS核心参数总结:
| 参数 | 描述 |
|---|---|
| -XX:+UseConcMarkSweepGC | 启用cms |
| -XX:ConcGCThreads=4 | 设置并发GC线程数为4(默认CPU核心数,不推荐设置,原因见Parallel) |
| -XX:+UseCMSCompactAtFullCollection | 让CMS在Full GC结束后做压缩整理,以减少碎片(注意这个过程也会开启STW,因此对性能肯定有影响,只不过时间很短罢了) |
| -XX:CMSFullGCsBeforeCompaction=2 | 控制CMS压缩整理的频率(此处2次Full GC后才做压缩整理):默认为0,表示每次Full GC结束后都会压缩一次(和1相同),需配合-XX:+UseCMSCompactAtFullCollection参数使用 |
| -XX:CMSInitiatingOccupancyFraction=92 | 指定回收阈值,也就是老年代触发Full GC的使用比例(单位为百分比,默认92%),该参数可以很好解决Concurrent Mode Failure问题,具体比例要结合实际来调整 |
| -XX:+UseCMSInitiatingOccupancyOnly | 开启后JVM只会使用指定的回收阈值(-XX:CMSInitiatingOccupancyFraction参数值)来触发Full GC。不开启的话,JVM仅在第一次使用回收阈值,后续会自动调整(JVM触发Full GC的回收阈值是一个动态调整的过程,类似元空间的动态水平伸缩机制) |
| -XX:+CMSScavengeBeforeRemark | 开启后会在触发Full GC前启动一次Minor GC,目的是为了减少老年代对年轻代的跨代引用,降低并发标记阶段开销 |
| -XX:+CMSParallellnitialMarkEnabled | 开启后初始标记阶段不再STW,而是让用户线程并发执行,从而缩短STW时间(默认开启) |
| -XX:+CMSParallelRemarkEnabled | 开启后重新标记阶段不再STW,而是让用户线程并发执行,从而缩短STW时间(默认开启) |
扩展:Java命令中,X越多代表该命令的使用越不稳定,越容易被高版本的JDK废除
跨代引用:指的是老年代中的对象中存在指针指向新生代的对象(这个指针可能是成员变量之类)
-
开启方式:
-XX:+UseConcMarkSweepGC -
CMS和Parallel、ParNew收集器的区别:
-
CMS收集器重点负责处理老年代GC;ParNew重点处理年轻代GC;Parallel因为有专门的Parallel Old收集器,因此既可以处理年轻代,又可以处理老年代
-
相比于Parallel和ParNew收集器GC所需花费的时间,CMS在完成一个完整的GC过程不一定比它们短(因为并发阶段允许用户线程并发执行,其会对GC线程造成影响),但是在STW停顿时间这块,则缩短很多(只在初始标记和重新标记阶段有STW),且因为多次间隔执行STW,用户几乎感知不到停顿,对性能的影响大大降低
例如Parallel总的GC时间是1s,其STW时间也是1s,那么换做CMS进行GC处理,由于时间大头都在并发标记阶段,且该阶段不会出现STW,因此STW时间总和可能就只有0.3s(初始标记0.1s、重新标记0.2s这样),用户体验就好很多了
- 应用:JDK1.8下建议使用ParNew+CMS的组合,其性能比G1好很多
6)G1收集器
JDK1.7版本初次出现G1收集器,大于8个G才考虑用G1,但此时G1算法还不完善,直到JDK1.9版本G1才算完善成为JVM默认垃圾收集器
JDK1.8默认垃圾收集器:Parallel + Parallel Old,JDK1.9默认垃圾收集器:G1
-
定义:G1(Garbage-First)收集器依旧是分代收集器,它主要面向于生产环境下多核大容量内存的服务器,其STW停顿时间相对较短、吞吐量相对较高。
因此前文讲的所有分代的理论包括晋升老年代、动态年龄判断、老年代担保、三色标记、漏标的解决方案、跨代引用、卡表等依旧适用于G1
-
G1不像其他收集器只重点处理年轻代或老年代的内存,而是对整个堆内存进行管理,这是由其堆内存结构决定的。
-
堆内存结构:堆内存在物理层面上不再像之前JVM内存模型中Eden区、Survivor区、老年代有明显的分代概念,而是将堆内存划分成一个个独立的内存块,叫做区(region),每个区专门存放Eden或Survivor或Old或Humongous(巨型)区的对象,它们不再像之前一样分代规整连续。
逻辑上还是区分了新生代、老年代以及巨型代的
- 结构图示:

-
G1通常将堆内存划分为2048个区(最多2048,不一定就固定2048),例如4G堆内存则每个区2MB,也可以使用如下参数人工指定区大小:注意值必须是2的n次方
-XX:G1HeapRegionSize=2M推荐使用默认的区分配方式而非人工指定
-
region的种类:E(Eden)、S(Survivor)、O(Old)、H(Humongous)、空白区(未被使用的region)
G1的堆在初始的时候除了年轻代区外就是空白区。
-
region的角色是动态变化的:一个区之前可能是老年代,在做完GC后可能就变成Eden区了(因为G1采用的标记-复制算法)
-
堆中年轻代初始占比默认5%,可通过如下参数手动设置年轻代初始占比:值配置为整数
-XX:G1NewSizePercent=5 // 年轻代初始化占比5% -
系统运行过程中,JVM会不断给年轻代分配更多的region(取决于G1评估下来何时达到STW最大停顿时间),但最多也不会超过60%,可通过如下参数手动设置年轻代最大占比:值配置为整数
-XX:G1MaxNewSizePercent=55 // 年轻代最大占比55% -
年轻代Eden:S0:S1的region比例默认还是8:1:1:假设年轻代一共1000个region,即Eden区有800个region,则S0有100个region,S1有100个region
-
Humongous(巨型代)是G1新提出的分代类型,对应的region专门用来存储大对象。
-
之前我们说过的大对象阈值设置参数(
‐XX:PretenureSizeThreshold=1M)对G1是不生效的; -
在G1中,当一个新增对象大小大于等于region区大小的50%时,它会将该对象视作大对象,不再存储进Eden区的region中,改为存进Humongous区中。
注意,若大对象大小超过单个region大小时,需分配连续的Humongous区给该对象:例如单一region区大小2M,大对象6M,那么就分配3个连续的Humongous区给该对象
-
Humongous区中的对象在GC时会进行清理
-
- 工作流程:和CMS类似,一共四个阶段:

-
初始标记(initial mark):同CMS的初始标记阶段,一样开启STW,并标记GC Roots能直接引用的对象,速度很快。
-
并发标记(Concurrent Marking):同CMS的并发标记阶段
-
最终标记(Remark):同CMS的重新标记阶段,开启STW
-
筛选回收(Cleanup):
-
该阶段会开启STW。G1收集器在该阶段会先对当前各个region的回收价值和成本进行排序,将其信息存入回收集合(Collection Set)中。接着根据期望的STW最大停顿时间来确认此次回收集合的回收范围,对回收范围内的region进行回收。
-
筛选回收阶段GC线程进行处理时,并非一次性处理完回收范围内的对象,而是根据筛选回收子阶段个数平均分配剩余的STW停顿时间,采取筛选回收子阶段和用户线程交替执行的工作模式(开启STW执行GC线程(筛选回收子阶段)→暂停GC线程,继续执行用户线程→开启STW执行GC线程→…),直到GC处理完毕。
-
具体来说,例如用户设置的STW最大停顿时间为300ms,当前阶段剩余STW停顿时间200ms,那么GC线程会根据筛选回收子阶段执行次数(假如是10),分配每个筛选回收子阶段的STW时间为20ms,则可能会先开启STW运行个20ms,再暂停执行用户线程,一直循环10次直到这200ms停顿时间用完。
-
筛选回收子阶段:指筛选回收阶段一次开启STW执行GC线程的过程。用户可以通过如下参数设置筛选回收子阶段执行次数:默认8次
-XX:G1MixedGCCountTarget=10 // 指定筛选回收子阶段执行次数为10次 -
采取筛选回收子阶段和用户线程交替执行的意义:进一步降低单次STW停顿时间,提升用户体验
- STW最大停顿时间:
-
-
-
定义:是指G1一次GC过程中所有阶段STW的停顿时间总和的最大值,默认200ms。
-
设置STW最大停顿时间:
-XX:MaxGCPauseMillis=300 // STW停顿时间最多300ms-
STW最大停顿时间不能乱设置:
- 停顿时间过少,例如只设置10ms,那么一次清理的垃圾就非常少,垃圾对象更容易积累从而触发一个大范围的Full GC,并使最大停顿时间失效掉
- 停顿时间过大,用户体检就变差了
比方说当前老年代有1000个region待GC,用户设置的STW最大停顿时间为300ms,当前阶段剩余STW停顿时间200ms,而G1评估下来回收回收集合中前800个region恰好需要200ms,那么G1会将定位到这800个region进行回收,而剩余200个region则留待下次GC进行回收。
因此筛选回收阶段不一定能将堆中所有待回收的region都回收!而是根据STW最大停顿时间来选择性的回收。
-
根据STW最大停顿时间来进行回收的目的:提升用户体验
哪怕堆内存达到几个T,ZGC收集器的STW停顿时间甚至可以控制在10ms!但相应的ZGC一次GC过程的持续时间可能会很久。
-
- 回收集合(Collection Set):
-
是G1收集器维护的一个优先级列表,其根据region的回收价值和成本(回收效益比)排序将region信息依次存入其中。
-
回收效益比 = region中总对象大小 / 回收复制时间 = 存活对象大小 / region中总对象大小,值越大优先级越高。G1采用的标记-复制算法进行GC,通常region中需复制的对象(也就是可用对象)越多,其回收时间越长。
-
每次回收时优先选择回收价值最大的region,这就是G1收集器Garbage-First名字的又来
例如一个region评估下来需花1ms来回收2M垃圾,而另一个region仅需花0.1ms就能回收1M垃圾,那么G1优先选择后者进行回收
再例如一批region大小10M需要20ms来回收,而另一批region同样大小只需5ms进行回收,那么G1优先选择后一批进行回收
- G1收集器使用的GC算法:标记复制算法
从region层面来看使用的是标记-复制算法,从堆层面来看相当于使用的标记-整理算法(因为没有碎片产生,这个效果和整理算法是一样的),当然问的时候还是老老实实答标记-复制算法。。
-
以某个老年代的region GC过程为例,G1会将其中的可用对象复制到最近的空白region,并标识为老年代region;然后将当前老年代的region直接清空掉,并标识为空白region。
-
同CMS的标记-清除算法的区别:G1的复制算法使得GC后不会有碎片产生
所谓没有碎片是指region内部没有碎片,从堆的角度来看不连续的region、跨region的对象间其实还是有碎片,只不过G1对于region能够很好的处理,哪怕是大对象的复制也是以region为维度分配连续的region进行存储的,对于没有用到的region其还是空白region,可以留给其他小对象正常使用。
- G1收集器特性总结:
- 并行与并发:G1在GC过程中允许并发标记阶段让用户线程并行执行。
- 分代收集:G1不像其他收集器有明显的分代处理偏好,它对整个堆负责;同时堆中依旧保留了分代的概念,只不过分代更加碎片化,并不像之前的收集器管理时那么规整有明显界限。
- 空间整合:使用标记-复制算法对region中的对象进行GC,不会产生碎片,从而达到类似标记-整理算法的效果
- 可预测的STW停顿:G1根据STW最大停顿时间来回收垃圾,提高了用户体验
-
G1收集器的三种GC线程(三种垃圾收集方式):
注意不是三种垃圾收集器!和Serial 、Serial Old以及Parallel、Parallel Old是不同的概念!!
-
YoungGC:对应Minor GC,即整个堆中Eden区放满后就会触发。
- 需要注意的是,此处G1对Eden区放满的判断和之前的收集器不同,不是达到默认占比5%或是人为指定的年轻代最大占比才进行收集,而是在每次存放对象前都会预估下当前所有Eden区对象进行GC所需时间,将其和STW最大停顿时间比较后来决定后续处理方式。
- 若GC时间远小于STW最大停顿时间,只要不超过年轻代最大占比就继续将新对象存放Eden区
- 若GC时间接近STW最大停顿时间,则会立即触发Young GC,GC完成后再存放新对象
这也是G1 GC性能高的原因,同样的算法也就更复杂了,对于小内存GC并没有优势(甚至可能不如CMS),只能处理大内存GC。
同时G1的GC算法直到JDK1.9 才真正完善,这也是为啥JDK 1.8版本大家普遍使用ParNew+CMS的组合而不用G1的原因
-
MixedGC(混合GC):首先明确它不是前文概念中的Full GC,它是在老年代region在堆中占比达到老年代最大占比时才会触发。MixedGC处理**所有的年轻代region(Eden、Survivor)**以及 部分老年代region、部分大对象(Humongous)region
-
老年代最大占比:是指老年代的region在整个堆中的最大占比,若达到该占比则触发MixedGC。设置老年代最大占比:默认为45%,值配置为整数
-XX:InitiatingHeapOccupancyPercent=45 // 老年代region占整个堆中比最多45% -
只处理部分老年代区而非全部老年代区的原因:G1会根据STW停顿时间,结合回收集合来确定老年代region、Humongous region的回收范围,无法保证会处理全部老年代region以及大对象region。
-
G1在MixedGC过程中,会判断当前region中存活对象大小占比是否大于等于 存活对象占比阈值,若是则不对该region进行GC处理。
-
存活对象占比阈值:是指一个region中可用对象大小占整个region大小的比值,默认为85%,值配置整数。可通过如下参数设置:
-XX:G1MixedGCLiveThresholdPercent=85 // 指定region中存活对象占比阈值为85%
为什么超过存活对象占比阈值就不处理:存活对象太多,垃圾对象过少,处理意义不大
-
-
G1在MixedGC过程中,一旦因为复制算法而清空 得到的空region数量 达到销毁region占比阈值时,会立即停止MixedGC的处理(此次GC结束)。
-
销毁region占比阈值:因为复制算法清空的region数量占堆内存的最大占比,默认为5%。可通过如下参数设置:
-XX:G1HeapWastePercent=10 // 指定销毁region占比阈值为10%
-
-
-
Full GC:类似Serial收集器的GC方式,在达到触发条件后,直接开启STW,使用单线程对整个堆和方法区进行标记、清除、压缩整理,从而空闲出一批region供下次MixedGC/YoungGC使用
-
触发时机:通常G1会在触发MixedGC条件/YoungGC条件后先做MixedGC/YoungGC,使用标记-复制算法将回收范围内的region中的可用对象拷贝到最近的空region中。拷贝过程中若发现没有足够的空region用来存放拷贝对象,就会触发Full GC
-
由于单线程,通常G1的Full GC是非常耗时的,应尽可能避免出现Full GC
Shenandoah收集器是G1的升级版本,它将Full GC优化成多线程收集
-
- G1核心参数设置:
| 参数 | 描述 |
|---|---|
| -XX:+UseG1GC | 开启使用G1收集器 |
| -XX:ParallelGCThreads=8 | 指定GC线程数为8,默认为CPU核数,不建议人为指定 |
| -XX:G1HeapRegionSize=4m | 指定region大小为4mb,默认为堆内存/2048,指定的值必须是2的n次方,否则报错;不建议人为指定 |
| -XX:MaxGCPauseMillis=300ms | 指定STW最大停顿时间为300ms |
| -XX:G1NewSizePercent=5 | 指定年轻代region数在堆内存中的初始占比为5%,值配置为整数,默认为5% |
| -XX:G1MaxNewSizePercent=55 | 指定年轻代region数在堆内存中的最大占比为55%,值配置为整数,默认为60%且不得超过 |
| -XX:TargetSurvivorRatio=50 | 指定Survivor区对象大小阈值为50% |
| -XX:MaxTenuringThreshold=5 | 指定对象动态年龄阈值为5岁,默认15岁 |
| -XX:InitiatingHeapOccupancyPercent=45 | 指定老年代region数在堆内存中的最大占比为45%,默认为45%,值配置为整数 |
| -XX:G1MixedGCLiveThresholdPercent=85 | 指定region中存活对象大小占比阈值为85%,仅当存活对象低于这个值时G1才会对其进行MixedGC处理,默认为85% |
| -XX:G1MixedGCCountTarget=10 | 指定筛选回收子阶段执行次数为10次 |
| -XX:G1HeapWastePercent=10 | 指定销毁region占比阈值为10%,MixedGC过程中一旦因为复制算法清空的region数和堆内存的比值大于等于该值时,直接停止MixedGC处理。 |
- G1收集器优化建议:上文提到过,STW最大停顿时间不能太短。太小回收效率太低,可能出现GC拷贝的对象没有空region存放的情况,进而触发Full GC,影响性能。
- G1收集器的适用场景:
- 50%以上的堆内存被可用对象占用
- 对象分配和晋升的速度变化非常大
- GC时间特别长(例如超过1s)
- 8GB以上,100G以下的堆内存
- STW停顿时间要求控制在500ms以内。
7)ZGC、Shenandoah、Epsilon收集器
- ZGC:
-
参考文档:https://wiki.openjdk.java.net/display/zgc/Main http://cr.openjdk.java.net/~pliden/slides/ZGC-Jfokus-2018.pdf
-
开启方式:
-XX:+UseZGC -
适用场景:ZGC适用于JDK11,目前国内几乎没适用的场景,不作了解了,后续有机会再学吧
- 读屏障:ZGC在GC过程中用到的技术,不作了解了,后续有机会再学吧。
- 安全点与安全区域:
-
安全点:是指代码中的一些特定位置。当线程运行到这些位置时其状态时确定的,此时JVM就可以安全的进行线程调度,执行GC线程等。
因此GC不是想做就立即做的,需要等到用户线程运行到安全点后才能触发
- 安全点的位置:
- 方法返回之前
- 调用某个方法之后
- 抛出异常的位置
- 循环的末尾
- JVM实现在安全点进行用户线程和GC线程的切换:
- 当垃圾收集器需要中断用户线程开启GC线程时,不直接对用户线程操作,而是简单的设置一个中断标志位。
- 每个线程执行过程中都会不停地主动轮询查询这个标志,一旦发现中断标志为真时就自己在最近的安全点上主动中断挂起。
- 安全点的位置:
-
安全区域:是指一段代码片段中,引用关系不会发生变化。在这个区域内的任意地方开启GC都是线程安全的。
- 引入安全区域的原因:
- 安全点是针对正在执行的线程设定的,如果一个线程已经处于睡眠或中断状态,那么它就响应不了JVM的中断请求,自然也运行不到安全点上。
- 而联系前文漏标的解决方案我们直到,通常开启GC线程只要引用关系不发生变化,GC都是线程安全的,因此有必要增加线程调度的判断粒度,扩大至代码片段,哪怕当前线程达不到安全点也能够让GC线程启动。
- 引入安全区域的原因:
- Shenandoah:是G1的升级版本,由RedHat基于Open JDK开发,但不被Oracle官方认可
- Epsilon:由RedHat基于Open JDK开发,但不被Oracle官方认可。与其他垃圾收集器不同,其实现非常简单,适用于一次性收集的过程,应用场景太少几乎见不到使用。
2.9 JVM Profiling及调优
2.9.1 Profiling介绍
-
定义:指性能分析,它不只是一类工具,而是一种工程思维,是【数据驱动优化】这项能力的具体体现
此处工程思维是指:坚持3不原则,具体来说:
1)不猜测→用数据说话,
2)不盲改→精准优化,
3)不局部看→全链路分析
-
好处:避免凭经验导致的错误优化,提升优化效率,量化优化效果更有说服力
-
常见的优化错误方式:上来就优化代码、过度优化非关键路径、只看平均值、只在本地测
-
常见profiling工具:
- Linux系统:命令行
perf、top、htop - Java:
- 命令行:
jps、jinfo、jstat、jstack、jmap - 图形界面:jvisualvm、jconsole
- 第三方:Arthas、MAT
- 命令行:
- 分布式:Jaegar(链路追踪)、Zipkin、OpenTelemetry
- profiling分析的角度:
-
CPU Profiling:哪些函数占用 CPU 最多、是否存在死循环或低效算法
-
Memory Profiling:内存使用增长情况、是否存在内存泄漏、热点对象
热点对象:持续使用或频繁分配内存的对象
-
Latency / Time Profiling(延迟/耗时分析):每个函数执行时间、API 响应时间分布、请求链路耗时
-
I/O Profiling:网络请求耗时、磁盘读写延迟、阻塞等待时间
-
Call Graph(调用关系):谁调用了谁、哪一层有瓶颈、服务间调用路径
- profiling流程五步走:
- 发现问题:用户反馈、监控报警、指标异常(latency(延迟)/cpu)
- 运行profiling:选择合适工具,在真实或接近真实的环境中采样
- 分析结果:找出热点函数、识别瓶颈类型(CPU/IO/memory)
- 针对性优化:算法优化、并发优化、缓存策略、系统架构调整
- 验证优化效果:再次profiling,对比前后性能差异,需要给出量化的优化效果(改前耗时1000ms,改完耗时300ms)
- 应用:
- AI 推理系统:模型耗时分析
- 大规模微服务架构:链路追踪
- 后端高并发:延迟敏感
- 边缘计算:资源受限环境优化
2.9.2 前言
- 如何选择垃圾收集器:
- 如果内存小于100M,使用串行(Serial)收集器
- 如果是单核且没有STW停顿时间要求,使用Serial或JVM默认选择
- 如果允许STW停顿时间超过1,选择Parallel+Parallel Old或JVM默认选择
- 如果追求用户体验,STW停顿时间不超过1s,使用并发类收集器,例如CMS、G1、ZGC
- 堆内存4G以下可以用Parallel+Parallel Old,4G~8G可以用ParNew+CMS,8G以上100G以下可以用G1,100G以上用ZGC。
- JDK1.8版本并且内存不是很大,尽量避免用G1,因为G1算法不完善。
- JVM调优的目的:为了减少GC(无论Minor GC、Full GC),当然主要是 Full GC,因为其回收范围最大,时间最长,其STW时间也最长。
- JVM Profiling涉及工具:
-
命令行:
-
jps:查看java进程号,jps | grep xxx -
jinfo:查看JVM配置信息、进程启动参数、JVM参数信息,用法:jinfo 进程号【重点】注意,JVM参数和Java进程启动参数是两回事!
1)若想要设置a.jar启动时的jvm堆最小最大都是1g,应当:
java -Xms1g -Xmx1g -jar a.jar2)若只是想要设置a.jar的启动参数,则应当:
java -jar -Xms1g -Xmx1g a.jar -
jstat:监控JVM各项性能指标,包括YGC和FGC的频率。用法:jstat -gcutil会5s输出一次GC和内存占用信息
其中,S0 表示 Survivor0 区占用百分比,S1 表示 Survivor1 区占用百分比,E 表示 Eden 区占用百分比,O 表示老年代占用百分比,M 表示元数据区占用百分比,YGC 表 示年轻代回收次数,YGCT 表示年轻代回收耗时,FGC 表示老年代回收次数,FGCT 表 示老年代回收耗时
-
jstack:打印JVM进程的线程栈和锁情况,用法:jstack 进程名可以配合在线分析工具fastthread来分析线程栈
-
jmap:JVM内存分析、打印对象直方图、类加载统计、做堆转储操作 -
jcmd:用于向JVM进程发送调试命令,例如观察细粒度内存使用情况的指令:jcmd 进程号 VM.native_memory summary、jcmd 进程号 VM.native_memory detail想要进行JVM调试,首先需要开启JVM的**NMT(NativeMemoryTracking)**功能
-
-
图形界面:
- jvisualvm:图形界面,综合的JVM监控工具,做JVM堆栈、内存、CPU profiling
- jconsole:以曲线形式监控MBean(年代Bean)中的属性值
-
第三方:Arthas、MAT
1)jvisualvm
-
开启指令:
jvisualvm -
面板介绍:
- 左侧:当前运行中Java进程
- 右侧:包含7个标签页,分别是概述、监视、线程、抽样器、Profiler、MBeans、JConsole Plugins,其中【概述】可以看到JVM启动参数;【线程】标签页下方右侧【线程Dump】按钮用来查看线程瞬时的线程栈
2)jcmd
-
使用前提:开启JVM的**NMT(NativeMemoryTracking)**功能:
-XX:NativeMemoryTracking=detail注意是JVM的参数哈!不是java进程启动参数!
-
常用用法:
为了展示jcmd的使用过程,我们可以先设置JVM的单一线程栈大小固定256kb:
-XX:ThreadStackSize=256k注意上述指令不是真设置的256kb,此处只是做问题排查演示错误做法哈!
-
观察细粒度内存使用情况:
-
看总览:
jcmd 进程号 VM.native_memory summary# 进程号 24404: Native Memory Tracking: Total: reserved=6635310KB, committed=5337110KB - Java Heap (reserved=1048576KB, committed=1048576KB) (mmap: reserved=1048576KB, committed=1048576KB) - Class (reserved=1066233KB, committed=15097KB) (classes #902) (malloc=9465KB #908) (mmap: reserved=1056768KB, committed=5632KB) - Thread (reserved=4209797KB, committed=4209797KB) # 表示当前进程有32个线程 (thread #32) # 表示当前进程的线程栈总共预留了4G内存 (stack: reserved=4209664KB, committed=4209664KB) (malloc=96KB #165) (arena=37KB #59) - Code (reserved=249823KB, committed=2759KB) (malloc=223KB #730) (mmap: reserved=249600KB, committed=2536KB) - GC (reserved=48700KB, committed=48700KB) (malloc=10384KB #135) (mmap: reserved=38316KB, committed=38316KB) - Compiler (reserved=186KB, committed=186KB) (malloc=56KB #105) (arena=131KB #7) - Internal (reserved=9693KB, committed=9693KB) (malloc=9661KB #2585) (mmap: reserved=32KB, committed=32KB) - Symbol (reserved=2021KB, committed=2021KB) (malloc=1182KB #334) (arena=839KB #1) - Native Memory Tracking (reserved=85KB, committed=85KB) (malloc=5KB #53) (tracking overhead=80KB) - Arena Chunk (reserved=196KB, committed=196KB) (malloc=196KB)问题来了,根据打印的(stack: reserved=4209664KB, committed=4209664KB),我们了解到线程栈当前总供预留了4G内存,而32个线程每个我们设置256kb怎么也到不了这么多,问题出在哪里?
-
看明细:
jcmd 进程号 VM.native_memory detail,配合关键字262144KB for Thread Stack from我们得到如下结果:可以查出32个线程中有16个线程预留了256MB的内存,因此猜测是线程栈大小参数设置错了!
原因:其实,ThreadStackSize 参数的单位是 KB,所以我们如果要设置线程栈 256KB,那么应该设置 256 而不是 256k,即
-XX:ThreadStackSize=256。修改后再次使用jcmd 进程号 VM.native_memory detail验证:可以看到没问题了
-
查看JVM堆信息:先使用
jcmd 进程号 help GC.heap_info指令来查看Javahelp指令关于GC.heap_info的用法
-
2.9.2 案例实践
1)亿级流量电商系统JVM参数设置优化(一)
此处默认使用的是Parallel和Parallel Old垃圾收集器,不懂得话可以暂时不管
- 假设存在一个电商系统,每日点击上亿次,日活500万左右,付费转化率在10%左右,也就是日均50万的订单
- 这些订单平常时候都是在一天的固定时段(例如早晚上下班)产生,跨度在3~4个小时,那么每秒几十单左右,对系统压力还好
- 但如果这些订单遇到618、双11这样的大促,就会在几分钟内集中产生,平均每秒就达到1000多单了,对系统压力就大了(因为单笔订单处理逻辑相对复杂)。
- 若现在系统分布式部署在了3台4C8G的服务器上,每个服务器平均每秒要300单
要点:不能直接根据物理机内存分配堆、元空间大小!应该根据系统承受的压力来分配空间
- 假设现在不考虑逃逸分析(不能考虑,本身就是要留有余量的!),每秒300单对应了至少每秒300个订单对象生成到堆中。假设一个对象是1kb(对象),那么每秒就有300kb的对象分配到堆中的Eden区
对象大小的估算要看对象字段的多少,平均一个字段40字节的话,20个字段差不多就有800b了
-
假设下单过程还涉及到其他对象创建(例如库存、优惠券、积分等),我们假设还有19个对象要创建,且大小也是1kb,把么对于一台服务器平均每秒就会生成300kb*20=6MB的对象
-
完整的订单下单过程肯定除了下单还有订单查询、支付扣款等环节,我们假设还有9个环节,那么一台服务器平均每秒就会生成60MB对象,而这60MB对象1s后就会变为垃圾对象(因为下单操作完成后,那么涉及到的局部变量对应GC Roots消失了)
-
假设我们使用如下参数设置:其中堆内存分配了3GB,新生代分配了1GB(符合新生代:老年代 = 1:2),而默认Eden:S0:S1=8:1:1,因此Eden区800MB,两个Survivor区(S0、S1)各100MB:
java ‐Xms3072M ‐Xmx3072M ‐Xmn1024M ‐Xss1M ‐XX:MetaspaceSize=256M ‐XX:MaxMetaspaceSize=256M ‐jar microservice‐eurek a‐server.jar
JVM默认Eden:S0:S1=8:1:1的比例是合适的,但不是绝对的!比例在开启Eden区动态调节后会尽可能使Eden区够大,Survivor区够用即可。
开启Eden区动态扩容:
-XX:+UseAdaptiveSizePolicy,该参数JVM默认开启,生产上也建议开启。开启后当JVM发现Eden区不够时会调整Eden区和Survivor区的比例;若不想有变化则-XX:-UseAdaptiveSizePolicy
-
对象优先在Eden区分配,这样推算下来差不多运行到14s的时候Eden区就满了,从而触发Minor GC。此时要注意,前13s的对象因为1s操作就完成,变成垃圾对象了,因此会被GC掉,但是第14s的这批对象尚在订单操作过程中,因为触发Minor GC进而触发STW机制,此时14s的这批对象还在被GC Roots引用着,那么在Minor GC结束后第14s的这批对象会尝试从Eden区转移到SurvivorTo区(S0或S1)
-
关键点来了,前文说过在Minor GC后,JVM会进行对象动态年龄判断,此时第14s的这批分代年龄为0的对象就已经超过Survivor区大小一半了(Survivor区才100MB),那么第14s的这批对象(60MB)全部会迁移到老年代中。
-
也就是说,每过14s就有60MB的对象放入老年代,那么2G的老年代差不多2048/60≈35次,也就是35*14=490s≈8分钟左右老年代就塞满了。老年代一旦塞满就触发Full GC了,而老年代中的这些对象早就是垃圾对象了,肯定会被回收掉,同时Full GC时会触发STW机制,其时间较长,对性能影响太大了,几分钟就来次Full GC明显不合适
通常半小时、半天这样做下Full GC才差不多)
如何优化呢?两个方向:①调大年轻代②单独调大Survivor区大小,从而尽可能避免频繁迁移到老年代导致的频繁GC
-
我们尝试修改参数为
‐Xmn2048M,这样新生代内存变为2G,Eden区变为1600MB,Survivor区内存变为200MB,此时第25s时Eden区才会占满,并触发Minor GC。前24s和之前一样,都是垃圾对象会直接回收,第25s这批对象由于STW机制,还被GC Roots引用着,因此会尝试从Eden区转移到SurvivorTo区。根据对象动态年龄判断,60MB尚未达到SurvivorTo区的一半,因此正常转移到SurvivorTo区。 -
后续再到下一个25s时,Eden区再次占满触发GC,此时Eden区连同SurvivorFrom区(旧SurvivorTo区)中的对象都已经是垃圾对象,直接回收,第50s的这批对象因为STW机制加上对象动态年龄判断,会转移到另一个空的SurvivorTo区,从而保证了非长期对象的及时清理。

- 上述参数修改后,还需进行测试验证、完善,不能直接拍脑袋
2)亿级流量电商系统JVM参数设置优化(二)
结合ParNew和CMS收集器,我们针对上节的场景进行进一步优化

- 结合之前的电商案例,我们最终设置:
- 对象动态年龄阈值是5:希望长期使用的对象尽早去老年代,避免对新生代的占用
- 大对象大小阈值为1M:很少有超过1M的对象,这类大对象通常是系统初始化的缓存对象,例如List缓存、Map缓存
- 同时需开启使用ParNew、CMS收集器。相关参数如下:
‐XX:MaxTenuringThreshold=5 ‐XX:PretenureSizeThreshold=1M ‐XX:+UseParNewGC ‐XX:+UseConcMarkSweepGC
- 即便如此也不能完全杜绝Full GC,原因如下:
- 目前我们解决了每秒300笔左右订单的情况,但是没考虑峰值的情况(暂时不考虑限流),有可能隔个6、7分钟突然峰值访问导致1、2分钟内出现每秒600笔订单,相应每秒产生的对象也就加倍变成100多MB了,根据Survivor区对象动态年龄判断(默认50%)的要求触发Minor GC时还在处理的那批对象肯定是直接迁移到老年代了。
- 此外一台服务器有一个最佳性能阈值,假如原本300笔订单时可以正常1s处理完,但是当600笔订单过来时,系统压力突增,各方面性能指标(磁盘、IO、带宽)都会变吃紧的情况下,每笔订单的处理时间可能就要2s了,那么联系前文,每次Minor GC迁移对象就不是最后那1s,而是可能最后2s,2s的对象足以达到Survivor区对象动态年龄判断(默认50%)的要求了,会直接迁移到老年代,这是高并发系统非常棘手的问题。
- 当然时上述情况发生后,老年代也差不多要20分钟左右进行一次Full GC,这在电商系统中还算能接受,因为并非每时每刻都有峰值访问
- 综上,更多需要考虑的还是年轻代,年轻代参数设置合理,老年代CMS处理时基本都能用默认值,最终设置参数如下:
 ‐Xms3072M	// 堆初始大小3G
 ‐Xmx3072M	// 堆最大大小3G
 ‐Xmn2048M	// 新生代初始大小2G
 ‐Xss1M	// 每个线程对应栈最大大小1M
 ‐XX:MetaspaceSize=256M // 元空间初始化大小256M
 ‐XX:MaxMetaspaceSize=256M // 元空间最大大小256M
 ‐XX:SurvivorRatio=8 // Eden区:S0:S1=8:1:1
 ‐XX:MaxTenuringThreshold=5	// 对象动态年龄阈值为5岁
 ‐XX:PretenureSizeThreshold=1M // 大对象阈值为1M
 ‐XX:+UseParNewGC // 开启使用ParNew收集器
 ‐XX:+UseConcMarkSweepGC // 开启使用CMS收集器
 ‐XX:CMSInitiatingOccupancyFraction=92 // CMS触发Full GC的回收阈值为92%,为了预防Concurrent Mode Failure问题也可以降到80%
 ‐XX:+UseCMSCompactAtFullCollection // 开启CMS在Full GC结束后压缩整理碎片
 ‐XX:CMSFullGCsBeforeCompaction=0 // 压缩周期:CMS每次Full GC结束后都会进行压缩整理,能这么配的原因在于当前场景下Full GC频率很低
3)每秒几十万并发的系统该如何优化?
- 通常4C8G的服务器,分配3G内存给堆,其中2G新生代,1G老年代,遇到每秒几十万并发(通过Rocket MQ、Kafka等消息中间件转发),假设一个对象1kb,1s单就一类对象就达到100MB。以订单系统为例,假设类似对象有20种,那么1s中对象就将近2G,2s就直接触发Minor GC并由于老年代空间不够直接Full GC了。且由于服务器资源紧张,带宽不够等问题往往1笔订单1s都不一定处理的完,Full GC回收不了可用对象,直接报OOM异常导致JVM崩掉。
- 针对这种情况,肯定要用大内存了,通常生产服务器内存应≥64G,也就是说可以给年轻代30~50G的空间用来支持高并发处理,从而让这些朝生夕死的对象尽早在年轻代就被回收掉。
- 如此大内存的年轻代,CMS以及之前的GC收集器在做Minor GC时遍历太耗时了,效率高不到哪去,STW停顿时间也会很长,对用户的体验和性能都不好。
- 但是换做G1的话,假设Eden区分配40G,两个Survivor区各分配5个G,老年代14G,同时用户可以设置STW最大停顿时间,比方说300ms,且300ms够处理24G的对象。那么按照每秒2G对象的话,结合STW最大停顿时间的影响,隔12s才触发一次YoungGC呢。同时由于服务器内存资源充足,基本一个对象存活1s就到头了,一次回收掉24G垃圾对象新生代基本就空了,不可能出现Rocket MQ使用上的性能瓶颈(消息发送超时的场景)
- 且因为用户可以设置筛选回收子阶段执行次数,设置个10次,每个筛选回收子阶段仅停顿30ms,对于用户体验来说几乎无感,可以边处理业务边GC。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 6
 0
- 0


 已为社区贡献1条内容

所有评论(0)