LoopThread与LoopThreadPool的设计与实现
目录
前言:
在上一篇文章中,我们完成了 Acceptor 模块的设计与实现。从监听套接字的创建,到 Channel 的事件注册,再到新连接的接收与回调分发,我们解决了服务器“如何接收一个新连接”的问题。Acceptor 作为服务器的“入口”,负责将客户端连接从操作系统交付到网络库上层;而 Connection 则负责连接建立之后的数据收发与生命周期管理。至此,我们已经初步串起了从 IO 事件产生,到新连接建立,再到连接数据处理 的完整链路。
然而,随着服务器并发连接数量的增加,一个新的问题也随之出现:这些连接应该由哪个线程负责处理?
如果整个服务器只有一个 EventLoop,那么所有的 accept、客户端连接的读写事件以及对应的回调处理都将在同一个线程中完成。对于简单的网络程序来说,这种单线程 Reactor 模型已经足够,但当连接数量不断增加时,单个线程需要承担的事件处理任务也会越来越多。此时,我们就需要引入多个工作线程,让不同的 EventLoop 分担客户端连接的事件处理工作。
但这里又产生了一个新的问题:EventLoop 本身并不会自动创建线程,那么如何让每一个 EventLoop 运行在一个独立的线程中?又如何统一管理多个这样的线程和 EventLoop?
这正是本节 LoopThread 与 LoopThreadPool 要解决的问题。
LoopThread 负责解决的是一个更加基础的问题:如何建立“一个线程 + 一个 EventLoop”的对应关系。它创建一个独立的工作线程,并在线程内部实例化 EventLoop,随后启动事件循环。同时,由于 EventLoop 是在线程内部创建的,外部线程还需要一种安全的方式获取这个 EventLoop 的指针,因此 LoopThread 还需要借助互斥锁与条件变量完成线程之间的同步,确保在 EventLoop 真正创建完成之前,其他线程不会提前访问一个尚未初始化的对象。
而当我们需要创建多个工作线程时,仅仅依靠一个 LoopThread 显然是不够的。于是,在 LoopThread 之上,我们进一步设计了 LoopThreadPool。它负责统一创建和管理多个 LoopThread,保存每个工作线程对应的 EventLoop,并通过轮询(Round Robin)的方式选择下一个工作 EventLoop,从而将新建立的客户端连接分散到不同的线程中。
因此,这两个模块虽然代码量并不大,却承担着整个网络库中非常重要的多线程 Reactor 基础设施:
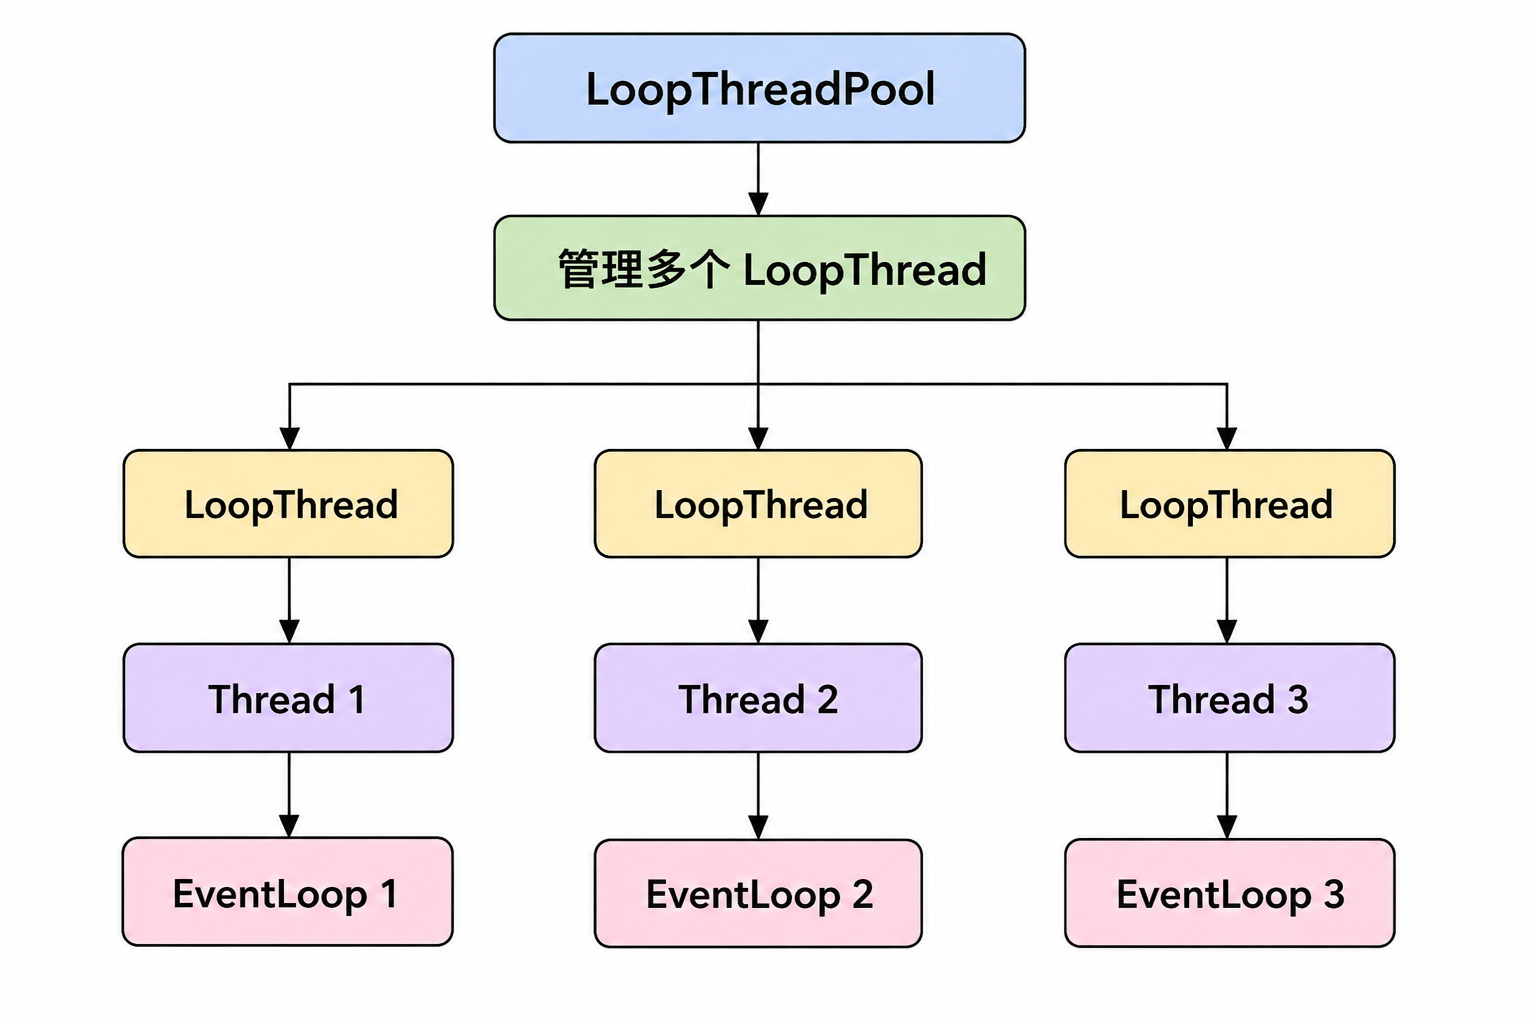
从整体架构来看,EventLoop 是真正负责 IO 事件循环的核心,而 LoopThread 解决的是 “让一个 EventLoop 在独立线程中运行”,LoopThreadPool 则进一步解决 “如何管理多个 EventLoop 并将连接分配给它们”。三者共同构成了网络库从单线程 Reactor 向多线程 Reactor 扩展的重要基础。
同时,这一设计也保留了单线程模式的灵活性。当 LoopThreadPool 中的工作线程数量被设置为 0 时,服务器无需创建额外的工作线程,直接使用主线程中的 EventLoop;而当工作线程数量大于 0 时,则可以由主线程负责接收新连接,再通过线程池将连接分配给不同的工作 EventLoop。因此,同一套网络库既可以运行在简单的单线程模式下,也可以自然地扩展到多线程 Reactor 模式。
LoopThread的设计
在前面的文章中,我们已经介绍了 EventLoop 的基本作用。EventLoop 是整个 Reactor 网络库的核心,它负责不断调用 epoll_wait() 等待 IO 事件,并在事件发生之后分发给对应的 Channel,最终执行具体的事件回调。
但是,到这里我们会遇到一个非常现实的问题:
一个 **EventLoop** 应该运行在哪个线程中?
如果整个服务器只有一个 EventLoop,那么事情非常简单。我们可以直接在主线程中创建:
EventLoop loop;
loop.Start();
此时主线程既负责事件循环,又负责处理所有客户端连接。
但是,当服务器需要同时处理大量客户端连接时,让一个线程承担所有 IO 事件显然不够理想。我们希望能够创建多个工作线程,并让每个工作线程拥有一个独立的 EventLoop:
Thread 1  →  EventLoop 1
Thread 2  →  EventLoop 2
Thread 3  →  EventLoop 3
这样,不同客户端连接就可以分配到不同的 EventLoop 中,由不同线程分别处理。
问题也随之产生:
如何保证一个
EventLoop一定是在它所属的工作线程中创建并运行的?
这就是 LoopThread 存在的意义。
LoopThread 并不是一个新的事件循环,它本身也不负责处理网络 IO。它真正做的事情是:
封装一个线程,并在线程内部创建和运行一个
**EventLoop**。
EventLoop 模块与一个线程一一对应,其实例化的一个对象,在构造的时候就会初始化 _thread_id,而后面当运行一个操作的时候,需要判断当前 EventLoop 是否运行在对应的线程上时,我们就用 _thread_id 与线程 id 进行一个比对,相同就表示在同一个线程。
如果我们先创建多个EventLoop对象,再创建多个线程,将多个线程的id交给EventLoop设置,这样就会出现一个问题:
在构造EventLoop对象,到设置新的thread_id期间将是不可控的。
因此我们必须先创建线程,然后在线程的入口函数中,去实例化 EventLoop 对象。
class LoopThread
{
private:
    EventLoop *_loop;    // 这里是故意定义一个指针,防止一开始就实例化
    std::thread _thread; // EventLoop对应的线程
private:
    /*实例化EventLoop 对象,并且开始运行EventLoop模块的功能*/
    void ThreadEntry();

public:
    LoopThread();
    /*返回当前线程关联的EventLoop对象指针*/
    EventLoop *GetLoop();
};
我们的子线程将会在LoopThread对象实例化的时候,将_thread初始化,这样我们就创建了一个子线程。
而 ThreadEntry 线程就是我们这个新子线程的入口函数,至于 GetLoop 接口,就是提供给上层,让其知道这个 LoopThread 对应的 EventLoop 是谁。
那么这个EventLoop在哪里创造呢?
答案是 ThreadEntry 入口函数中,我们会在这个子线程中创建一个 EventLoop 对象,并让 _loop 指针指向这个对象。
这样我们上层调用 GetLoop 接口就可以找到这个 EventLoop 对象。
但是这样就会引发一个问题!
如果在我上层调用GetLoop的时候,你的_loop还没被设置,那岂不是要返回给我一个空值??
为了避免这个情况,我们需要对这个两个函数使用锁与条件变量。
class LoopThread
{
private:
    EventLoop *_loop;    // 这里是故意定义一个指针,防止一开始就实例化
    std::thread _thread; // EventLoop对应的线程

    /*用于实现_loop获取的同步关系,避免线程创建了,但是_loop还没有实例化之前去获取_loop*/
    std::mutex _mutex;             // 互斥锁
    std::condition_variable _cond; // 条件变量
private:
    /*实例化EventLoop 对象,并且开始运行EventLoop模块的功能*/
    void ThreadEntry();

public:
    LoopThread();
    /*返回当前线程关联的EventLoop对象指针*/
    EventLoop *GetLoop();
};
LoopThread的实现
我们先从构造函数来开始依次实现。
根据这个类的成员参数,我们会发现其实并没有什么要从外界传入的参数,所以就是写一个无参的默认构造函数:
LoopThread() : _loop(NULL), _thread(std::thread(&LoopThread::ThreadEntry, this)) {}
对于GetLoop,我们需要明确这一定是外界的主线程调用的,来获取我们的_loop对应的EventLoop。
由于之前说了,必须要保证_loop被设置了,所以我们的目的就是先给他上把锁,条件变量设置为当_loop不为空时就满足不阻塞条件。
我们是传递一个地址回去,所以可以用个临时变量,并用{}限定锁的生命周期,直观明了。
    EventLoop *GetLoop()
    {
        EventLoop *loop = NULL;
        {
            std::unique_lock<std::mutex> lock(_mutex); // 上锁
            _cond.wait(lock, [&]()
                       { return _loop != NULL; });//loop为NULL就一直阻塞
            loop=_loop;
        }
        return loop;
    }
最后就是ThreadEntry,这是我们子线程入口函数,我们需要先创建一个EventLoop。
为什么会在这个函数里面创建一个EventLoop对象呢??
主要还是因为我们想把这个EventLoop对象的生命周期限定在这个入口函数中,并且这个子线程的生命周期也是跟这个入口函数一样的,所以就相当于EventLoop与子线程生命周期一样了。
class LoopThread
{
private:
    EventLoop *_loop;    // 这里是故意定义一个指针,防止一开始就实例化
    std::thread _thread; // EventLoop对应的线程

    /*用于实现_loop获取的同步关系,避免线程创建了,但是_loop还没有实例化之前去获取_loop*/
    std::mutex _mutex;             // 互斥锁
    std::condition_variable _cond; // 条件变量
private:
    /*实例化EventLoop 对象,并且开始运行EventLoop模块的功能*/
    void ThreadEntry()
    {
        EventLoop loop;
        {
            std::unique_lock<std::mutex> lock(_mutex); // 上锁,两个线程都涉及到_loop,所以需要上锁
            _loop = &loop;
            _cond.notify_all();
        }
        loop.Start(); // 这个start一定是个循环
    }

public:
    LoopThread() : _loop(NULL), _thread(std::thread(&LoopThread::ThreadEntry, this)) {}
    /*返回当前线程关联的EventLoop对象指针*/
    EventLoop *GetLoop()
    {
        EventLoop *loop = NULL;
        {
            std::unique_lock<std::mutex> lock(_mutex); // 上锁
            _cond.wait(lock, [&]()
                       { return _loop != NULL; }); // loop为NULL就一直阻塞
            loop = _loop;
        }
        return loop;
    }
};
这里我们必须理解锁与条件变量各自的作用。
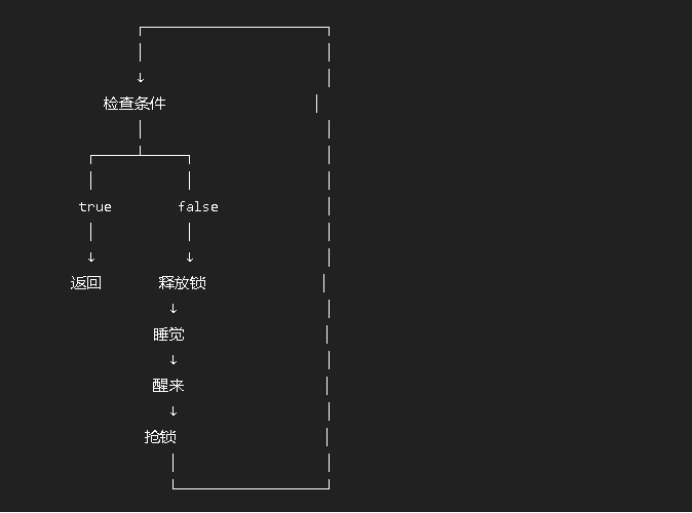
锁 mutex 被两个线程申请,如果是主线程先申请到,此时子线程就会阻塞在上锁的代码。
随后主线程执行条件变量的 wait,根据传入的 Lambda 判断条件是否满足,发现此时 _loop 还没有被设置(因为此时子线程被阻塞住了,或者子线程压根还没运行)。
主线程这里就会进入 wait,如果条件不满足,wait 会自动释放当前持有的锁,并让主线程进入休眠状态,也就是阻塞等待。
当子线程终于运行到上锁这里时,如果此时主线程已经因为 wait 释放了锁,那么一直在等待这把锁的子线程就可以获得锁,接下来继续运行代码,执行 _loop = &loop,然后通过 notify_all() 通知所有正在这个条件变量上等待的线程:条件可能已经满足了。
被唤醒的主线程不会立即继续执行,因为它还需要重新获得 _mutex。所以此时子线程需要先离开锁的作用域,释放 _mutex。锁空闲后,被唤醒的主线程重新竞争并获得这把锁。
主线程获得锁以后,wait 会再次检查 Lambda 条件:
_loop != nullptr
此时 _loop 已经被子线程设置成了 &loop,所以条件满足,wait 返回,主线程继续执行:
loop = _loop;
然后离开锁的作用域,释放 _mutex,最后:
return loop;
返回刚才保存下来的 EventLoop*。
需要特别注意:notify_all() 只是唤醒等待线程,并不会直接把锁交给它。被唤醒的线程还必须重新竞争 _mutex,获得锁以后再重新检查条件。
LoopThreadPool的设计
解决了“一个线程如何运行一个 EventLoop”之后,我们又会遇到第二个问题:
如果服务器需要多个工作线程怎么办?
一个 LoopThread 只能管理一个工作线程和一个 EventLoop。
如果服务器需要三个工作线程:
LoopThread 1 → Thread 1 → EventLoop 1
LoopThread 2 → Thread 2 → EventLoop 2
LoopThread 3 → Thread 3 → EventLoop 3
我们当然可以手动创建三个 LoopThread,但随着线程数量增加,这种方式显然不够方便。
因此,我们进一步设计 LoopThreadPool。
它的职责就是:
统一创建、管理多个
**LoopThread**,同时保存这些工作线程对应的**EventLoop**,并负责选择一个合适的**EventLoop**。
LoopThreadPool所拥有的线程数量是可配置的,一般是0个或多个。
在服务器中,主从Reactor模型是主线程只负责新连接获取,从属线程负责新连接的事件监控及处理因此当前的线程池。所以有可能从属线程会数量为0,这样就是实现单Reactor服务器,一个线程及负责获取连接,也负责连接的处理。
当主线程获取了一个新连接,我们就需要将新连接挂到从属线程上进行事件监控及处理。
假设有0个从属线程,则直接分配给主线程的EventLoop,进行处理。
假设有多个从属线程,则采用RR轮转思想,进行线程的分配(将对应线程的EventLoop获取到,并设置给对应的Connection)
所以我们可以设计出他的类成员变量就应该至少有一个EventLoop*一直指向主线程,有一个变量记载所拥有的线程数量,两个数组功能的变量,分别保存LoopThread*与EventLoop*。
一般来说,我们要保存LoopThread *是因为这个是由我们主线程创建的LoopThread对象,而我们要求LoopThreadPool必须对创建出来的线程对象进行管理。
而保存EventLoop *是因为方便我们分配连接。
class LoopThreadPool
{
private:
    int _thread_count;                  // 配置的线程个数
    int _next_idx;                      // 下一个需要分配连接的EventLoop的下标
    EventLoop *_baseloop;               // 主EventLoop,运行在主线程,子线程数量为0时,所有连接都由baseloop处理
    std::vector<LoopThread *> _threads; // 保存并管理LoopThread
    std::vector<EventLoop *> _loops;    // 保存每个LoopThread对应的EventLoop,方便后续分配连接

public:
    LoopThreadPool();
    void SetThreadCount(); // 设置子线程的数量
    void Create();         // 根据配置数量创建对应数量的LoopThread,并获取其对应的EventLoop
    EventLoop *NextLoop(); // 返回下一个分配连接的EventLoop
};
LoopThreadPool的实现
接下来来实现一下,首先从构造函数开始,我们只有主EventLoop是需要从外界传入的,所以构造函数就应该这样写:
LoopThreadPool(EventLoop * baseloop):_thread_count(0),_next_idx(0),_baseloop(baseloop){}
而两个数组应该放在Create中根据设置好的_thread_count来初始化与构造对应对象。
// 设置子线程的数量
    void SetThreadCount(int count)
    {
        _thread_count = count;
    }

    // 根据配置数量创建对应数量的LoopThread,并获取其对应的EventLoop
    void Create()
    {
        if (_thread_count > 0)
        {
            _threads.resize(_thread_count);
            _loops.resize(_thread_count);
            for (int i = 0; i < _thread_count; ++i)
            {
                _threads[i] = new LoopThread();
                _loops[i] = _threads[i]->GetLoop();
            }
        }
        return;
    }
    // 返回下一个分配连接的EventLoop
    EventLoop *NextLoop()
    {
        if (_thread_count == 0)
        {
            return _baseloop;
        }
        _next_idx = (_next_idx + 1) % _thread_count;
        return _loops[_next_idx];
    }
这两个类型就完成了,只看代码的话,都是十分简单的代码:
class LoopThread
{
private:
    EventLoop *_loop;    // 这里是故意定义一个指针,防止一开始就实例化
    std::thread _thread; // EventLoop对应的线程

    /*用于实现_loop获取的同步关系,避免线程创建了,但是_loop还没有实例化之前去获取_loop*/
    std::mutex _mutex;             // 互斥锁
    std::condition_variable _cond; // 条件变量
private:
    /*实例化EventLoop 对象,并且开始运行EventLoop模块的功能*/
    void ThreadEntry()
    {
        EventLoop loop;
        {
            std::unique_lock<std::mutex> lock(_mutex); // 上锁,两个线程都涉及到_loop,所以需要上锁
            _loop = &loop;
            _cond.notify_all();
        }
        loop.Start(); // 这个start一定是个循环
    }

public:
    LoopThread() : _loop(NULL), _thread(std::thread(&LoopThread::ThreadEntry, this)) {}
    /*返回当前线程关联的EventLoop对象指针*/
    EventLoop *GetLoop()
    {
        EventLoop *loop = NULL;
        {
            std::unique_lock<std::mutex> lock(_mutex); // 上锁
            _cond.wait(lock, [&]()
                       { return _loop != NULL; }); // loop为NULL就一直阻塞
            loop = _loop;
        }
        return loop;
    }
};
class LoopThreadPool
{
private:
    int _thread_count;                  // 配置的线程个数
    int _next_idx;                      // 下一个需要分配连接的EventLoop的下标
    EventLoop *_baseloop;               // 主EventLoop,运行在主线程,子线程数量为0时,所有连接都由baseloop处理
    std::vector<LoopThread *> _threads; // 保存并管理LoopThread
    std::vector<EventLoop *> _loops;    // 保存每个LoopThread对应的EventLoop,方便后续分配连接

public:
    LoopThreadPool(EventLoop *baseloop) : _thread_count(0), _next_idx(0), _baseloop(baseloop) {}
    // 设置子线程的数量
    void SetThreadCount(int count)
    {
        _thread_count = count;
    }

    // 根据配置数量创建对应数量的LoopThread,并获取其对应的EventLoop
    void Create()
    {
        if (_thread_count > 0)
        {
            _threads.resize(_thread_count);
            _loops.resize(_thread_count);
            for (int i = 0; i < _thread_count; ++i)
            {
                _threads[i] = new LoopThread();
                _loops[i] = _threads[i]->GetLoop();
            }
        }
        return;
    }
    // 返回下一个分配连接的EventLoop
    EventLoop *NextLoop()
    {
        if (_thread_count == 0)
        {
            return _baseloop;
        }
        _next_idx = (_next_idx + 1) % _thread_count;
        return _loops[_next_idx];
    }
};
但最重要的是理解所用到的知识,理解每一步的步骤。
结语
至此,我们完成了 LoopThread 与 LoopThreadPool 两个模块的完整设计与实现。让我们回顾一下这两个模块在整个网络库中的定位与价值。
LoopThread 与 LoopThreadPool 虽然代码量并不多,但它们解决了网络库从单线程 Reactor 向多线程 Reactor 扩展过程中非常关键的问题。LoopThread 负责建立“一个线程 + 一个 EventLoop”的对应关系,而 LoopThreadPool 则负责统一管理多个这样的工作线程,并将新连接分配给不同的 EventLoop。
回顾 LoopThread 与 LoopThreadPool 的设计,有几个关键点值得我们再次品味:
第一,关于 EventLoop 的创建位置。 EventLoop 必须在线程内部创建,而不能先在主线程中创建后再交给子线程运行。因为 EventLoop 本身具有明确的线程归属关系,在构造时会记录当前线程的线程 ID。因此,让工作线程自己创建并运行 EventLoop,才能保证二者始终处于正确的对应关系中。
第二,关于互斥锁与条件变量的使用。 LoopThread 创建线程之后,EventLoop 并不是立即存在的,因此主线程调用 GetLoop() 时必须等待子线程完成 EventLoop 的创建。我们通过 mutex 保证 _loop 的访问安全,通过 condition_variable 实现线程之间的同步,从而保证 GetLoop() 返回时,_loop 一定已经完成初始化。
第三,关于 LoopThread 与 EventLoop 的关系。 LoopThread 本身并不负责 IO 事件处理,它真正负责的是创建一个工作线程,并让这个线程拥有自己的 EventLoop。因此,一个 LoopThread 对应一个工作线程,也对应一个 EventLoop;而 EventLoop 才是真正负责事件监控与事件分发的核心模块。
第四,关于 LoopThreadPool 的设计。 LoopThreadPool 在 LoopThread 之上进一步完成了多个工作线程的统一管理。_threads 用于保存和管理创建出来的 LoopThread,而 _loops 保存这些工作线程对应的 EventLoop,方便服务器后续进行连接分配。通过这种方式,上层模块不需要关心具体线程的创建过程,只需要向线程池获取一个合适的 EventLoop 即可。
第五,关于 Round Robin 连接分配策略。 当存在多个工作线程时,LoopThreadPool 通过 _next_idx 对不同的 EventLoop 进行轮询,让新连接依次分配给不同的工作线程,从而避免所有连接集中到同一个线程中。虽然这种方式并没有考虑线程当前的实际负载,但实现简单,非常适合作为基础 Reactor 网络库中的连接分配策略。
第六,关于单线程与多线程模式的兼容。 当 _thread_count == 0 时,LoopThreadPool 不创建任何工作线程,而是直接返回主线程的 _baseloop,此时服务器退化为单线程 Reactor;当线程数量大于 0 时,则由主线程负责接收连接,再通过 LoopThreadPool 将连接分配给不同工作线程中的 EventLoop。这样,同一套网络库便可以同时支持单线程和多线程两种运行模式。
至此,我们已经完成了从 EventLoop 事件驱动核心,到 Connection 连接管理,再到 Acceptor 连接接收,以及 LoopThread、LoopThreadPool 多线程管理的完整构建

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐


 86
 0
- 0


 已为社区贡献3条内容

所有评论(0)