知识库是死的,流程是活的:从 Obsidian 到 Ontology,我让企业地图每天自己更新一次
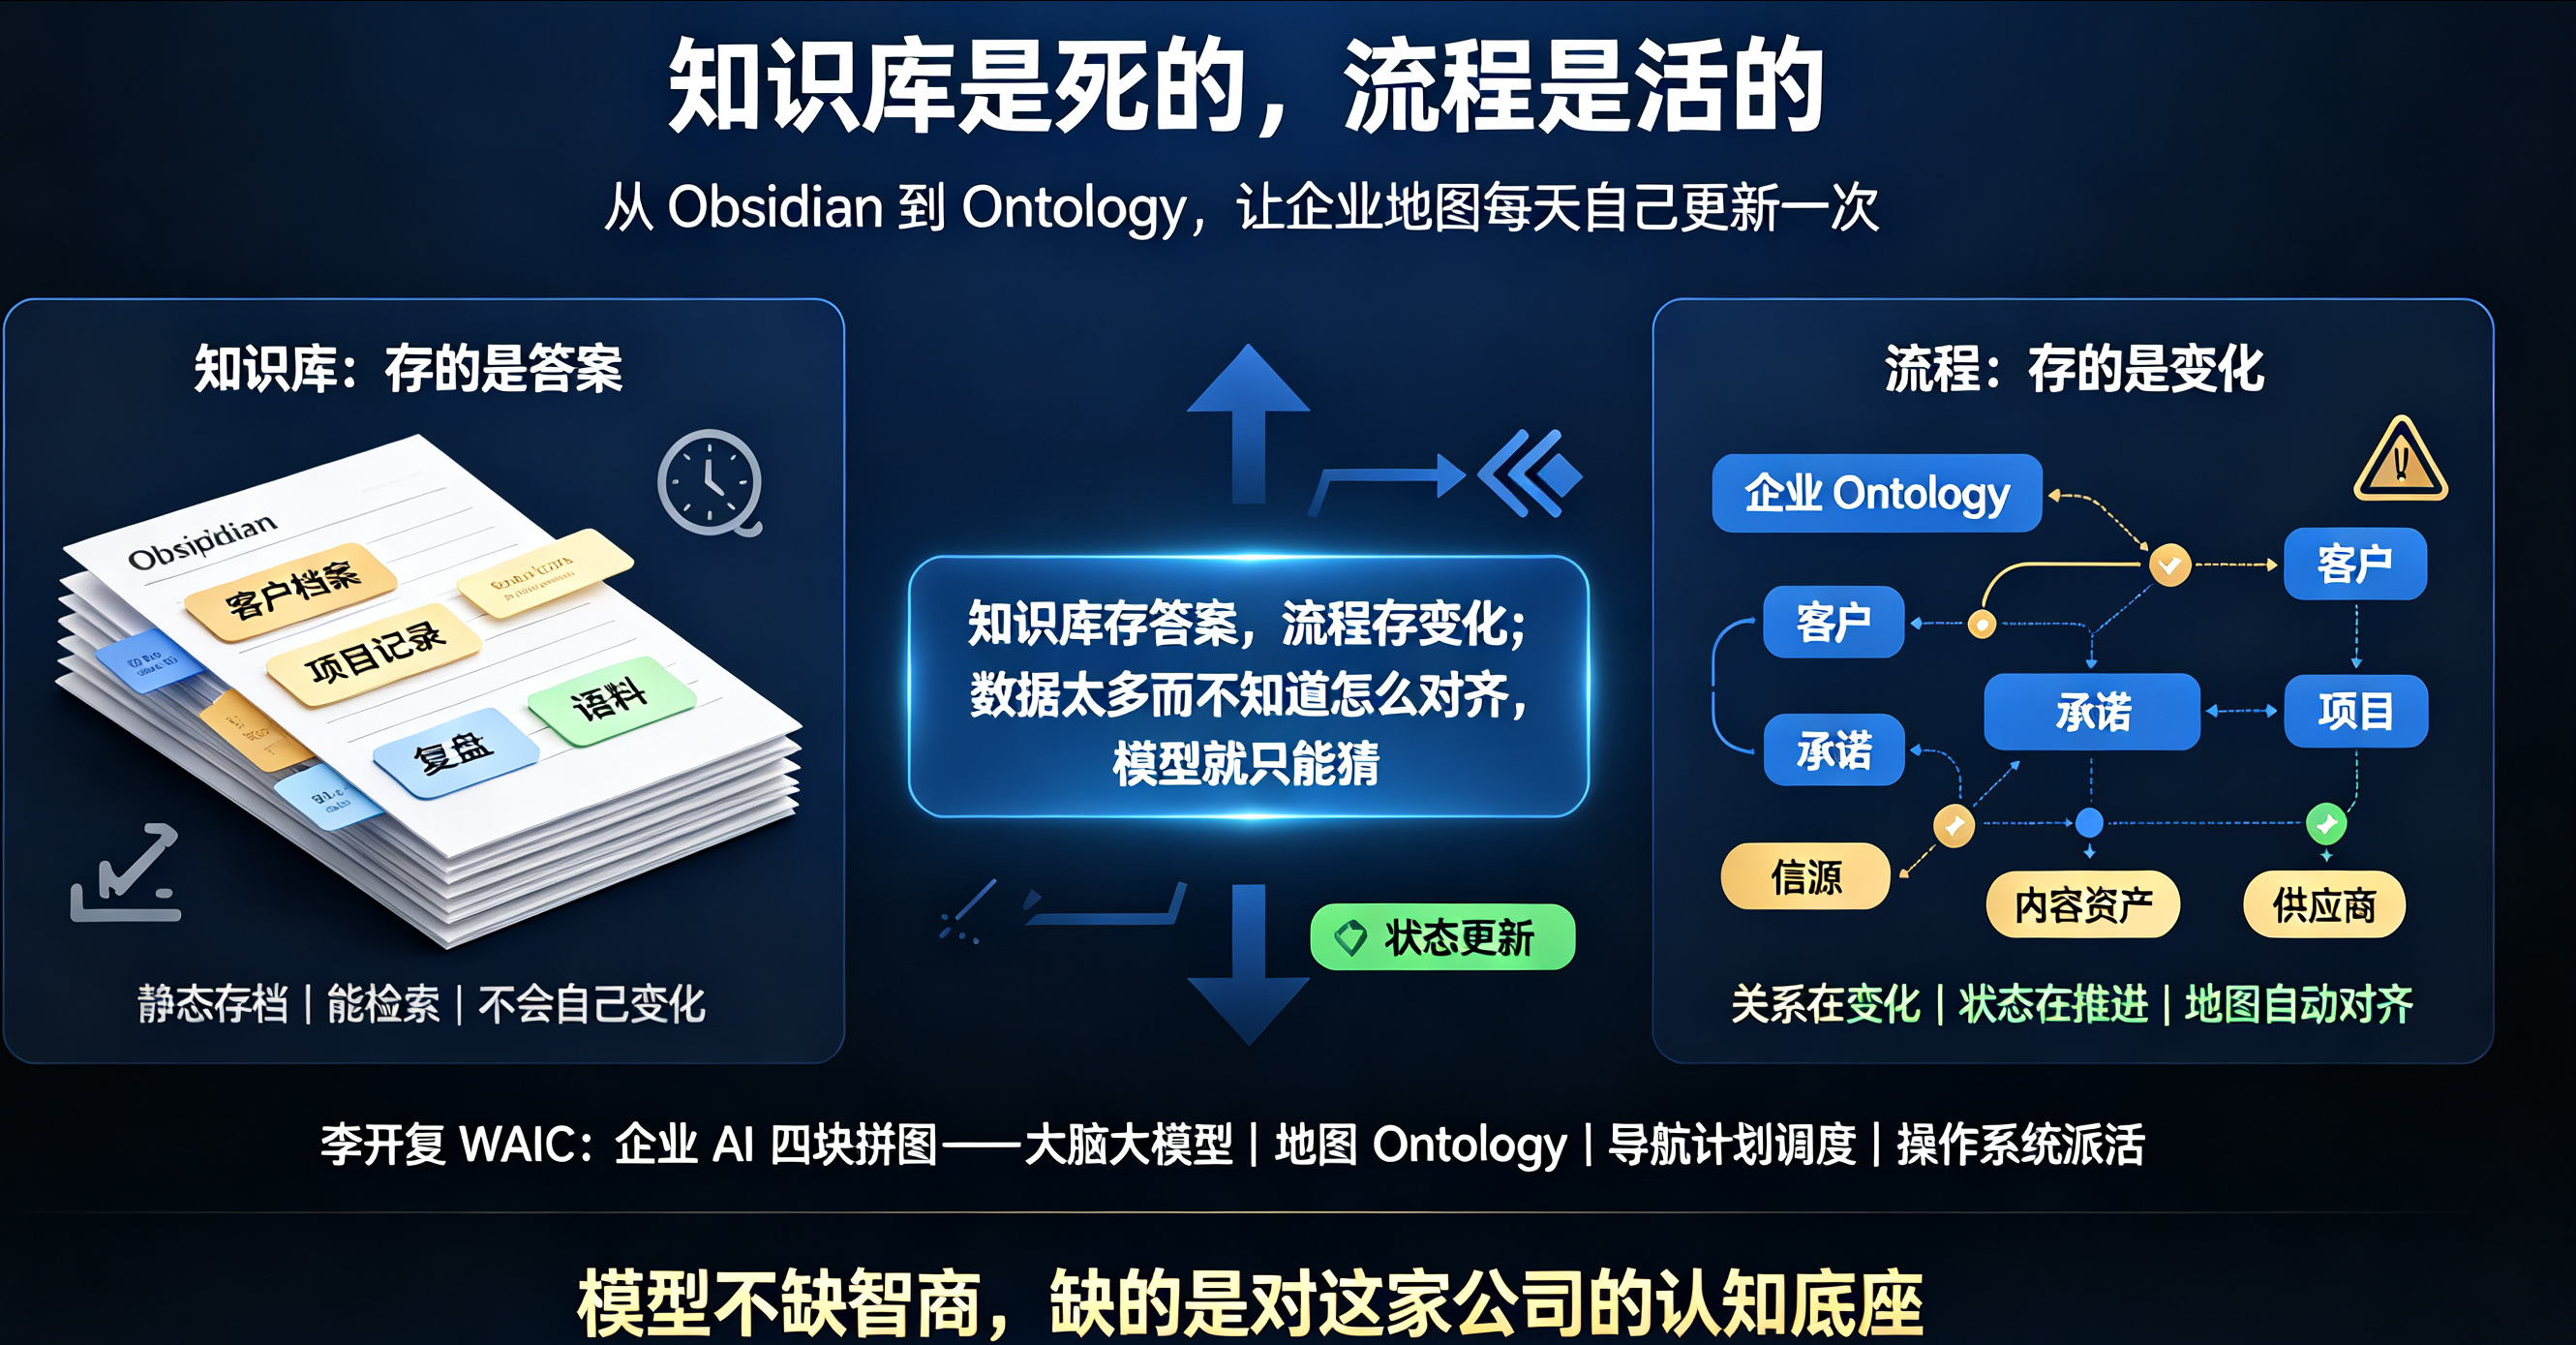
先说结论:知识库存的是答案,流程存的是变化
先引一段李开复在 WAIC 上讲企业 AI 落地时的原话:把决策中枢拆成了四块拼图:第二大脑是大模型,负责推理和指挥;地图是 Ontology,用语义定义业务世界和流程;导航是计划与调度;企业操作系统负责把任务和活派出去。他强调这四块拼图里最重要的是地图。
李开复在另一个场合打过一个比方,我觉得比任何定义准确:一个顶尖毕业生,如果不经过任何训练和师傅带领就扔进公司,其实什么都做不来。模型是一样的道理——它缺的不是智商,是对这家公司的认知底座和经验摸底。
我踩的坑正好卡在这儿。Obsidian 里虽然攒了几千张卡片,如客户档案、项目记录、复盘、语料全在,检索也能搜到。可 AI 回答"这个客户现在该不该跟"这类问题时,依然在猜,因为没有第二大脑帮它兜底,所以我的企业系统也不知道怎么干活,虽然有了知识库和大脑但是没有流转,就是没有“活起来”。
后来我想明白了一件事:问题从来不是数据太少,因为AI的数据人无法有他全面,而是数据太多但不知道怎么对齐。李开复也这么讲——数据多到不知道怎么对齐,模型就只能猜,猜出来就是幻觉。
于是我就有了那次重构。回头看,我改的不是"存东西的地方",是三处代码。
差的那一层,叫"关系"
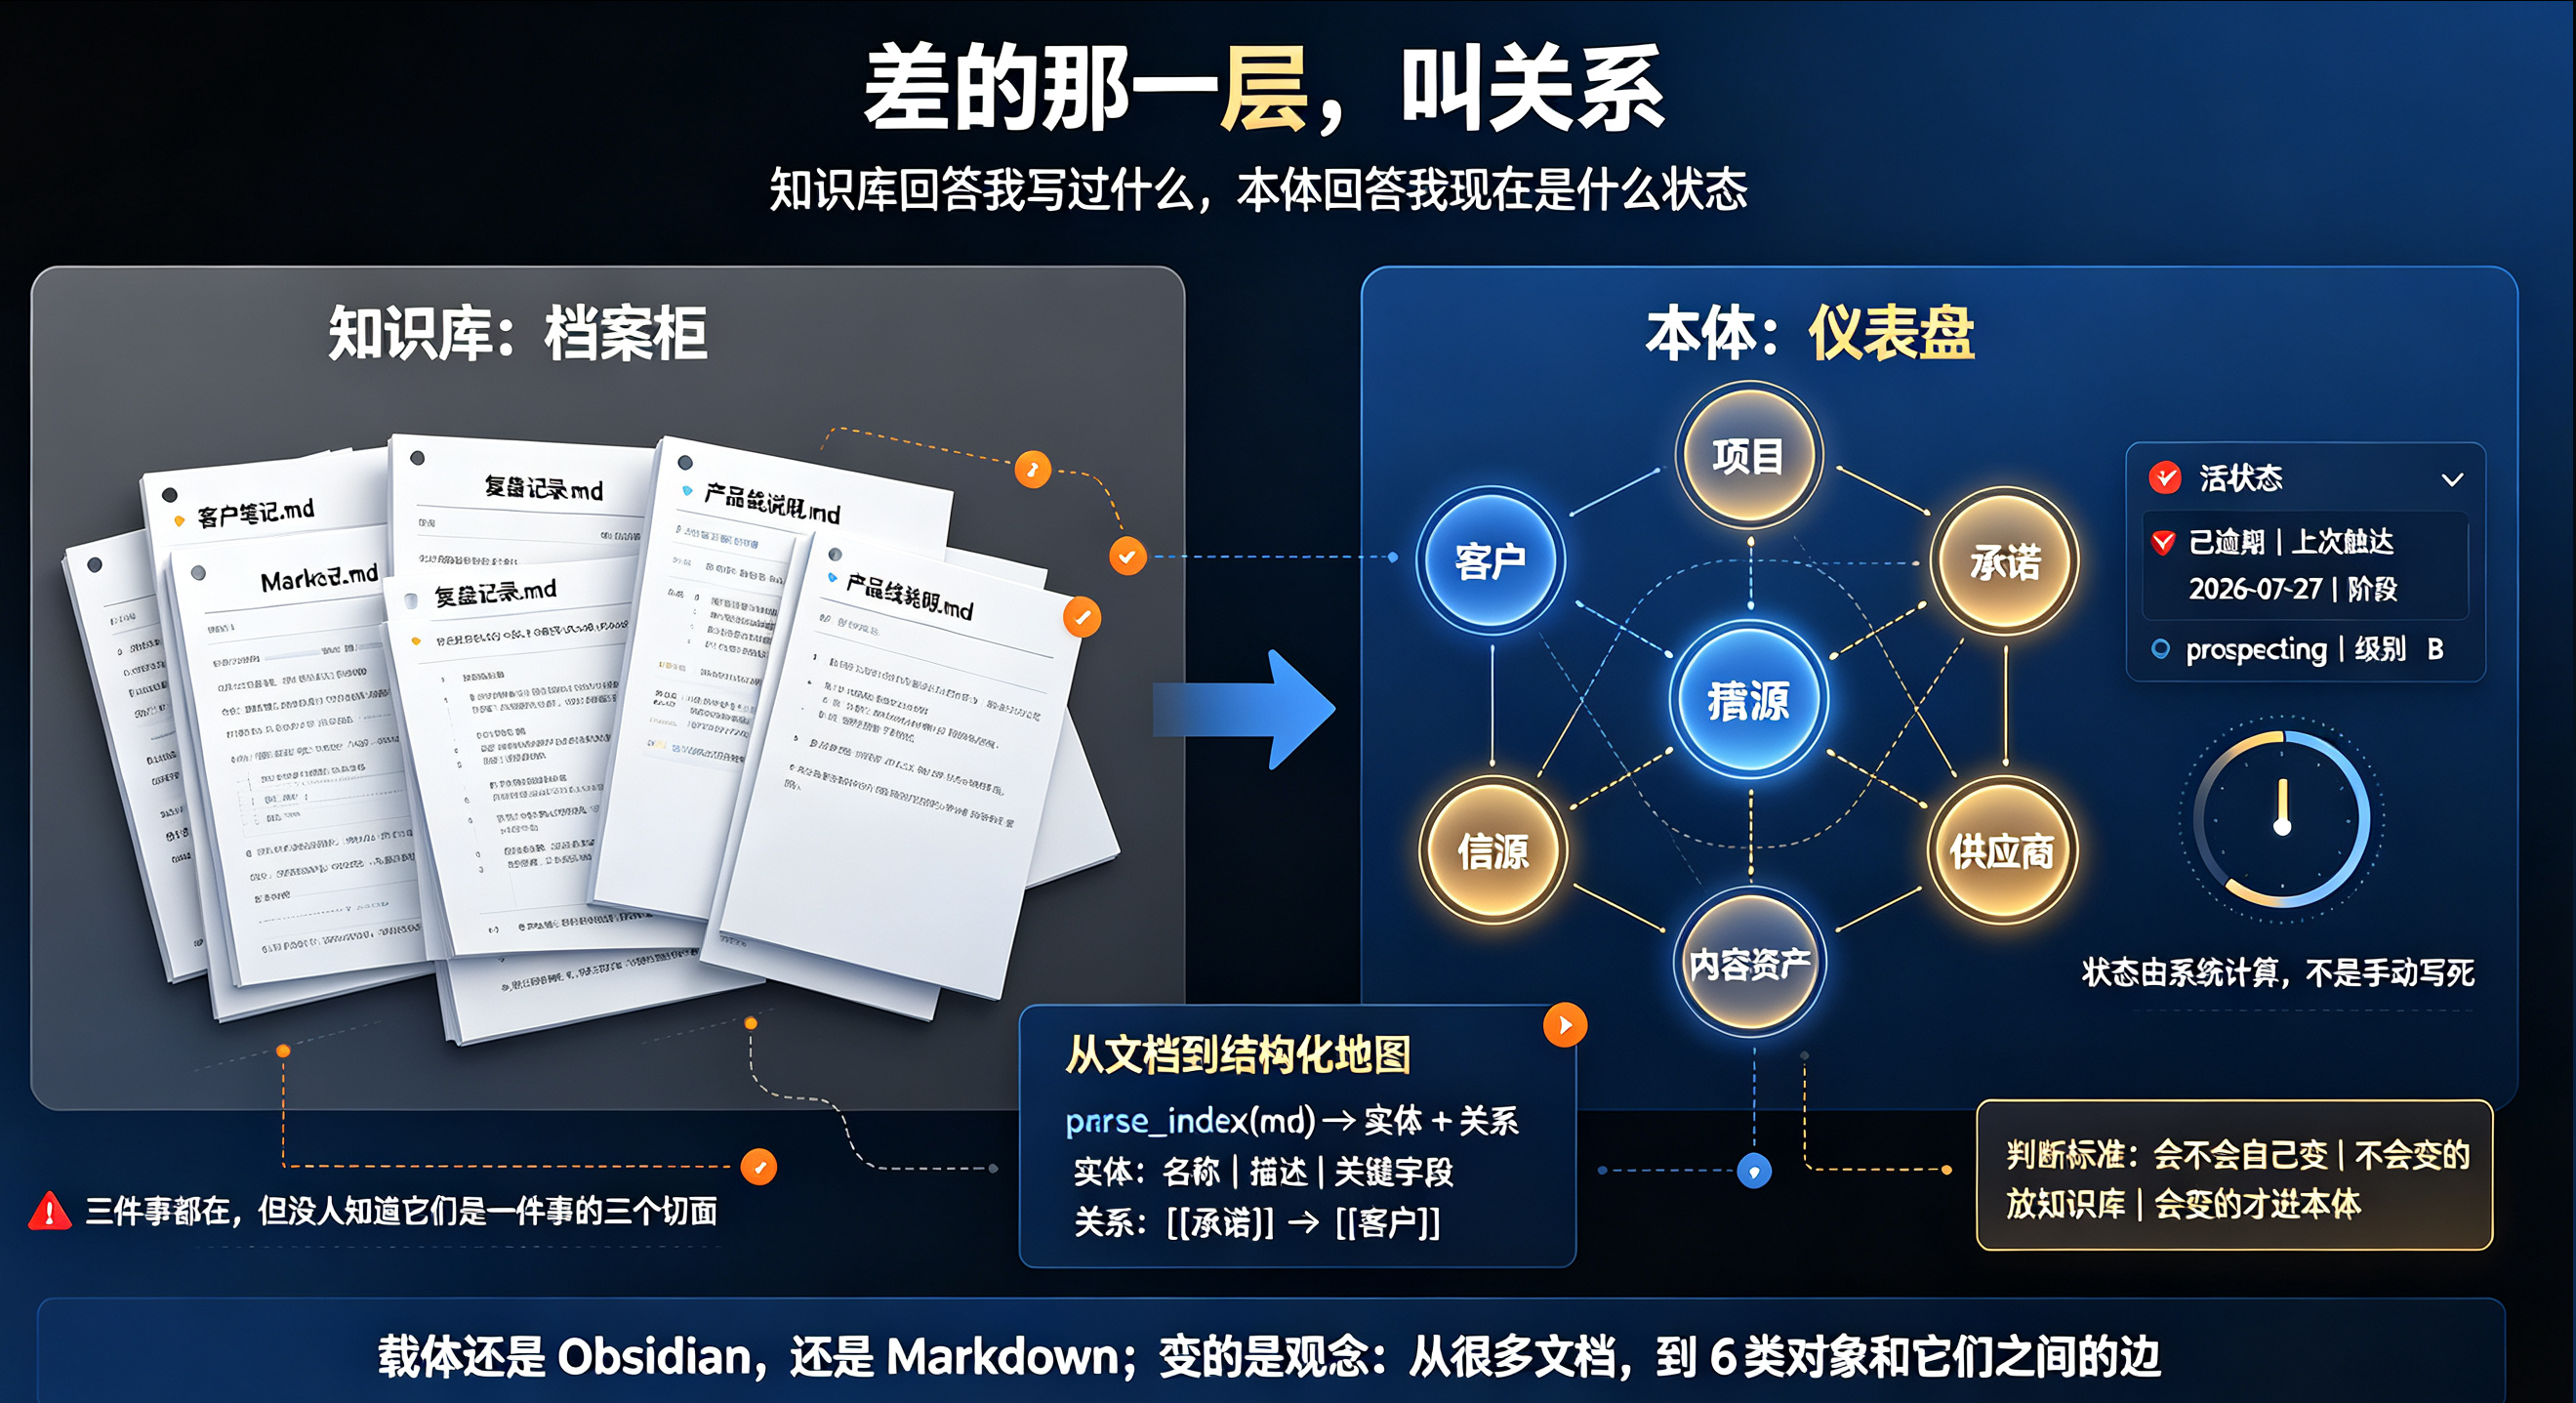
知识库和本体,看起来都是一堆 Markdown,区别只在一层:实体之间有没有被显式声明的关系,以及实体自己带不带状态。
我的知识库时代是这样的:客户叫张三,写在 客户笔记.md 里;答应过他下周给方案,写在某次复盘里;方案对应的产品线,写在另一个文件里。三件事都知道,但没人知道它们是一件事情的三个切面。
本体版本长这样——我按业务抽象出 6 类实体:客户、项目、承诺、信源、内容资产、供应商。每类一个索引文件,结构上就两块:
## 实体          →  名称 | 描述 | 关键字段
## 关系          →  [[承诺/XX·跟进承诺]] ↔ [[客户/XX]]
关键在于关键字段那一列是活的。比如承诺实体,字段里直接写着"🔴 已逾期,上次触达 2026-07-27,阶段 prospecting,级别 B"。这不是我写的,是系统算出来的。
所以这两者的差别可以一句话说清:知识库回答"我写过什么",本体回答"我现在是什么状态"。前者是档案柜,后者是仪表盘。
要把文档变成结构化地图,第一步就是把 md 表解析成实体和关系:
def parse_index(md):
    class="tok-str">""class="tok-str">"把本体索引 md 解析成实体 + 关系:文档 → 结构化地图。"class="tok-str">""
    ents, rels, mode = [], [], None
    for line in md.split(class="tok-str">"\n"):
        t = line.strip()
        if t.startswith(class="tok-str">"## 实体"): mode = class="tok-str">"e"; continue
        if t.startswith(class="tok-str">"## 关系"): mode = class="tok-str">"r"; continue
        if mode == class="tok-str">"e" and t.startswith(class="tok-str">"|") and class="tok-str">"名称" not in t:
            if set(t) <= set(class="tok-str">"|- "): continue          # 跳过 | --- | 表格分隔行
            c = [x.strip() for x in t.strip(class="tok-str">"|").split(class="tok-str">"|")]
            if c[0]: ents.append({class="tok-str">"名称": c[0].strip(class="tok-str">"*"), class="tok-str">"描述": c[1], class="tok-str">"字段": c[2]})
        if mode == class="tok-str">"r" and t.startswith(class="tok-str">"-"):
            rels.append(t[1:].strip())
    return ents, rels
这段代码本身没什么技术含量,真正的转变在观念:从"我有很多文档"到"我有 6 类对象,它们之间有边"。载体我一个都没换,还是 Obsidian,还是 Markdown。
有个细节值得说一下:这 6 类实体不是一次定下来的。最早我列了十几类,做完发现维护成本根本压不住——每加一类,就意味着多一个需要被流程喂养的入口。后来我给自己定了条标准:会不会自己变,是判断该不该成为实体的唯一标准。不会变的(公司愿景、方法论沉淀)放在知识库里就够了;会变的(承诺状态、客户阶段、信源覆盖度)才值得进本体。那些删掉的类别,大多是因为它们一年都不会动一次。
代码改的第一处:检索不再比相关度,地图强制置顶
以前我小舍科技公司的 RAG 是标准做法:把查询丢进去,对所有卡片打分,按分数倒序返回前 N 条。
问题出在这儿的隐含假设——它假设"最相关的片段"拼起来就是答案。但实际上,命中的是碎片,AI 得自己推断碎片之间的关系,而推断就是猜。
改法很朴素:检索时先读那 6 个实体索引,拼成一段"地图上下文",然后不参与排序,直接插到结果最前面。
def retrieve(query, cards, onto_dir):
    class="tok-str">""class="tok-str">"检索:先看地图,再找碎片。地图不参与打分,直接置顶。"class="tok-str">""
    hits = [(c, score(c, query)) for c in cards if score(c, query) > 0]
    hits.sort(key=lambda x: -x[1])
    snippets = [{class="tok-str">"title": c.title, class="tok-str">"snippet": snippet(c, query), class="tok-str">"score": s}
                for c, s in hits[:8]]
    map_ctx = load_map(onto_dir)          # 6 个实体索引拼成的地图上下文
    if map_ctx:
        snippets.insert(0, {class="tok-str">"title": class="tok-str">"Ontology · 企业地图(优先注入)",
                            class="tok-str">"snippet": map_ctx[:600], class="tok-str">"score": 10})
    return snippets
注意那个 score: 10 和 insert(0, ...)——这是刻意的。地图不该和相关度竞争,它是前提,不是候选答案。
我给这个改动起了个名字叫"先看地图,再找门牌号"。效果上的差别是:以前 AI 拿到一堆碎片去拼关系,现在它先看到"这是一家有 6 个客户、3 条逾期承诺的公司",再去定位具体那一条。幻觉的来源被砍掉了一大半。
这一处改动,代码量不到十行,但它把系统的性质从"文档检索"变成了"地图导航"。
代码改的第二处:地图不再由人写,由流程来养
这一处才是"活"的本质,也是我最想分享的部分。
前面那个"🔴 已逾期"的状态,如果靠我手动去改,那这个本体三天就烂了——因为人会忘。所以必须让业务流程自动写回它。
我的企业AI系统的做法是:每天 09:00 跑一个跟进调度,扫描 CRM 的客户档案,读出约定好的下次联系时间,判定状态,生成跟进话术,最后把结果同步回本体的承诺索引。
def sync_commitments(custs, today, vault):
    class="tok-str">""class="tok-str">"流程养地图:CRM 状态 → 判定承诺时点 → 自动写回本体索引。"class="tok-str">""
    rows = []
    for company, fm in custs:
        nc, lc = fm.get(class="tok-str">"followup.nextContact", class="tok-str">""), fm.get(class="tok-str">"followup.lastContact", class="tok-str">"")
        if nc:
            st = class="tok-str">"已逾期" if nc < today else (class="tok-str">"今日到期" if nc == today else class="tok-str">"待兑现")
            rows.append(fclass="tok-str">"| **{company}** | 跟进承诺({nc}) | {st},上次触达 {lc} |")
    write_text(vault / class="tok-str">"Ontology/承诺-index.md", render(rows, today))
    return len(rows)
写进去的文件头会自动带上这么一行:
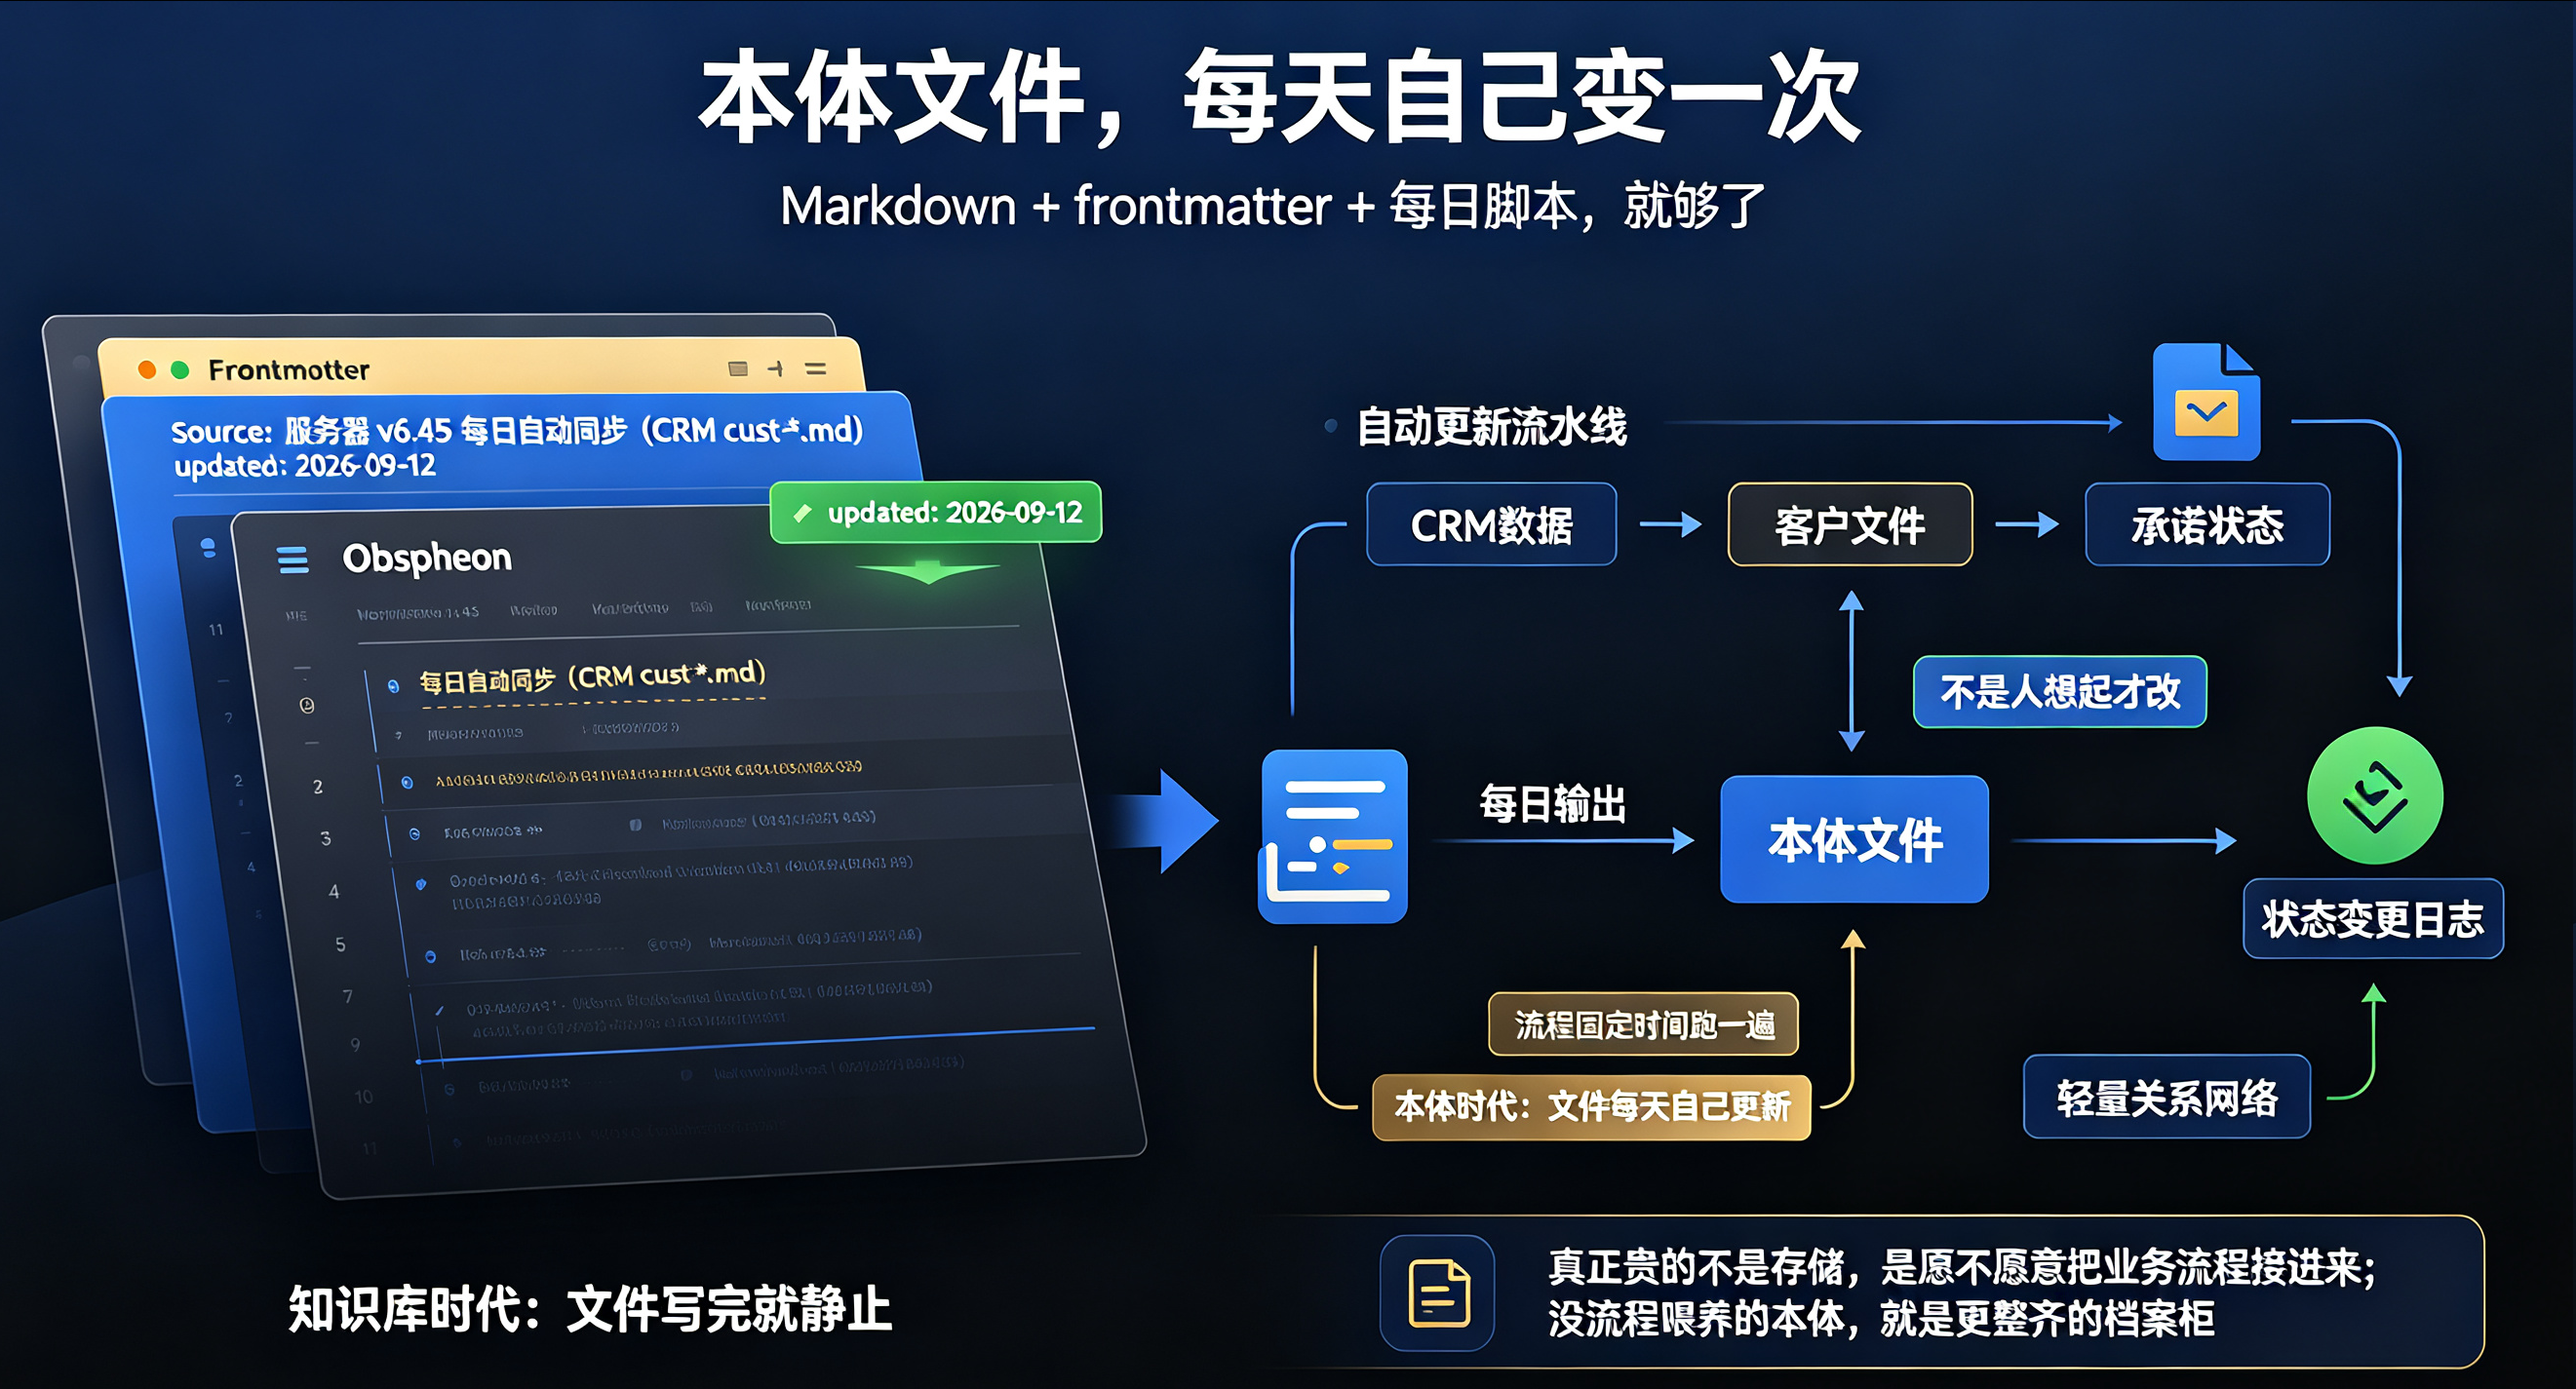
source: 服务器 v6.45 每日自动同步(CRM cust-*.md)
updated: 2026-09-12
这一行就是"活"的证据。它意味着这个本体文件最后一次更新不是某个人想起来了才去改,而是流程在固定时间跑了一遍。
我第一次看到这个效果时挺感慨的:同样是 Markdown,同样是 Obsidian,知识库时代文件写完就静止了;本体时代文件每天自己变一次。载体没变,变的是谁来写它。
这里有个认知要掰一下——很多人以为上本体就是上图数据库、上 Neo4j。我实际做下来,Markdown + frontmatter + 一个每天跑的脚本就够了。真正贵的不是存储,是你愿不愿意把业务流程接进来。没流程喂养的本体,就是个更整齐的档案柜。
怎么判断你的系统活没活
给三个自检问题,都是我这轮重构里真正卡住过的:
第一,你的实体有没有"状态"字段? 如果实体只有名称和描述,没有"已逾期/待兑现/进行中"这类会随时间变化的值,那你做的还是文档,不是本体。
第二,上次更新本体的是人还是调度? 打开索引文件看 updated 时间和来源。如果是人手改的,它迟早会烂掉。
第三,AI 回答时先读地图,还是先撞碎片? 如果你的 RAG 还是纯相关度排序,那关系就还是靠模型猜——模型越强,猜得越像真的,也就越危险。
还有一条经验值得记下来:不要一开始就追求把全公司建模完。我是从"承诺"这一类实体切进去的,因为它最能体现"活"——承诺会逾期,逾期会触发动作,动作会改写状态,一个完整的环。这个环跑通之后,再往外扩到客户、项目、供应商,阻力小得多。
回到开头那四块拼图。大脑会越来越便宜,模型谁都能买到,这已经是共识。真正拉开差距的是那张地图,以及每天喂它数据、让它自己更新的流程。知识库是死的,流程是活的,企业系统的价值从来不在存了多少,在于有多少东西在自动流转。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 1
 0
- 0


 已为社区贡献3条内容

所有评论(0)