从一次 LLM 调用到完整 Harness:Agent 外面的那层「操作系统」是怎么长出来的
摘要导读
当 Agent 开始写文件、调 API、跑长任务时,失败往往不在模型不够聪明,而在模型外面缺少一层可恢复、可约束、可审计的运行时。腾讯技术工程近期长文系统梳理了从单次 LLM 调用到工业级 Harness 的六段演进,并对比 Pi、OpenCode、Codex、Hermes 四条路线。本文在其基础上做结构化精读,供做 Agent 落地的工程师与产品负责人快速建立地图。
正文
一、为什么 Agent 越来越像「小型操作系统」?
很多团队的第一版 Agent,本质上是:
answer = LLM(question)
这足够做 Demo,但不足以做生产。模型不会记住上一轮对话,不知道自己的输出有没有被执行,更无法在真实副作用下连续决策。
复杂性不是一次设计出来的。 业界过去六年的补全路径,可以概括成一条边界驱动的链:
- 记不住 → 上下文装配(Working Memory)
- 碰不到世界 → ReAct 循环(Agent Runtime)
- 命令易漂移 → 结构化 Tool Calling(及 MCP)
- 历史装不下 → 分层 Memory 与反思
- 副作用失控 → Harness(会话、权限、沙箱、子 Agent)
- 重复踩坑 → 跨会话自进化(Hermes 路线)
文章给了一句值得写进设计文档的断言:
Agent 决定下一步做什么;Harness 决定这一步在什么上下文、权限、生命周期与持久化规则下发生。
二、六阶段演进:每一层解决上一层的「撞墙」
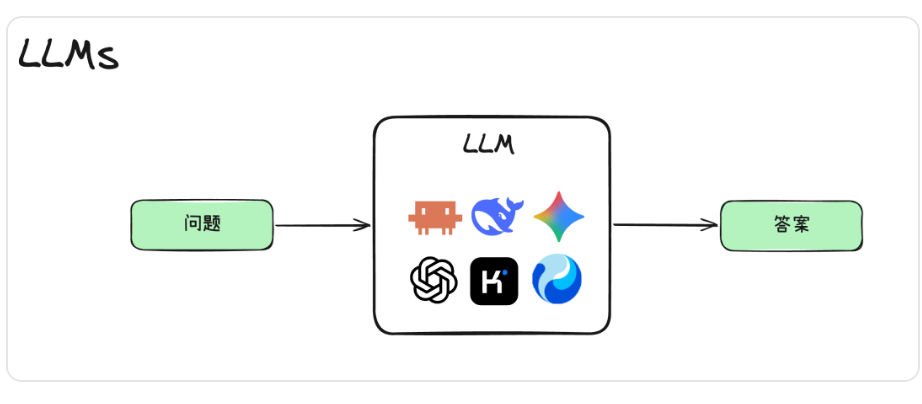
1. LLM(2020 前后):无状态函数
输入 token,输出 token。世界知识在参数里,会话状态不在模型里。应用只负责送入问题、展示答案。
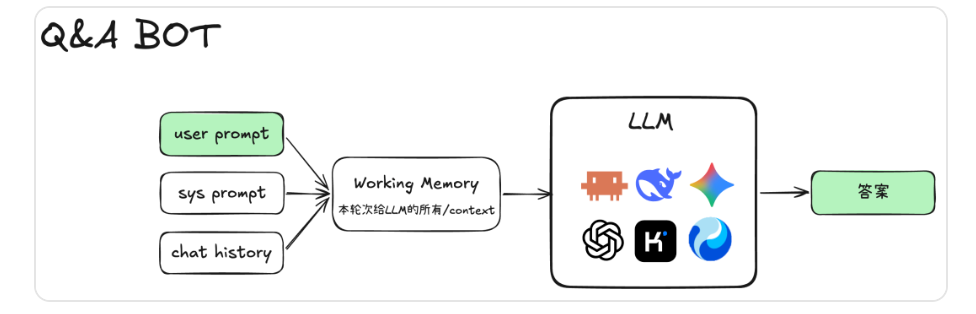
2. Q&A Bot(2022.11,ChatGPT 时代):上下文装配
working_context = [system_prompt, recent_chat_history, user_prompt]answer = LLM(working_context)
Working Memory 不是长期存储,而是本轮提交给模型的全部上下文。Harness 的第一原则在此确立:模型看见的一切,都是运行时系统构造出来的。
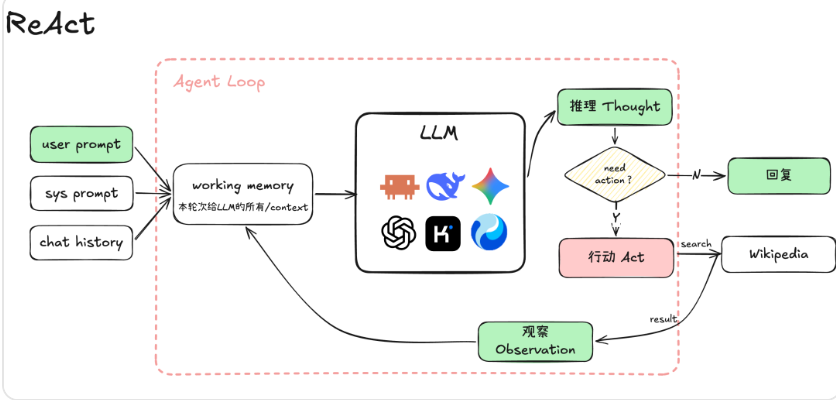
3. ReAct(2022.10 / ICLR 2023):行动闭环
Bot 答一次即可;Agent 必须根据环境反馈继续决策。外部程序驱动:
while not finished: response = model(context) if response.has_action: observation = environment.execute(response.action) context.append(response.action, observation) else: return response.answer
分水岭不是「会思考」,而是 模型 → 动作 → 环境 → 观察 → 模型 的闭环。
4. Tool Calling & MCP(2023–2024):动作协议化
早期 Search[Wikipedia] + 正则解析,灵活但脆弱。结构化之后形成三件套:
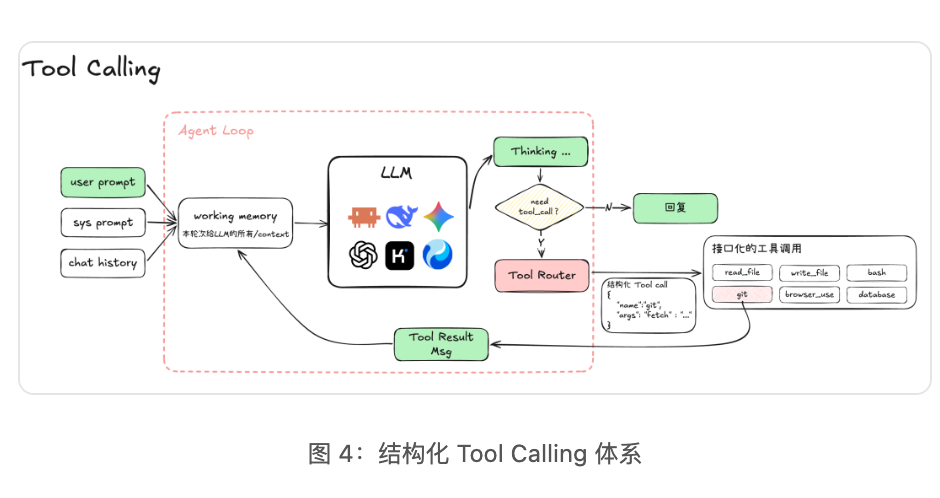
| 组件 | 职责 |
|---|---|
| Tool Schema | 定义动作空间与参数约束 |
| Tool Router | 校验、路由、执行 |
| Tool Result | 带 ID 的结果回写上下文 |
MCP 进一步统一 Agent 与外部工具、数据源的连接方式。
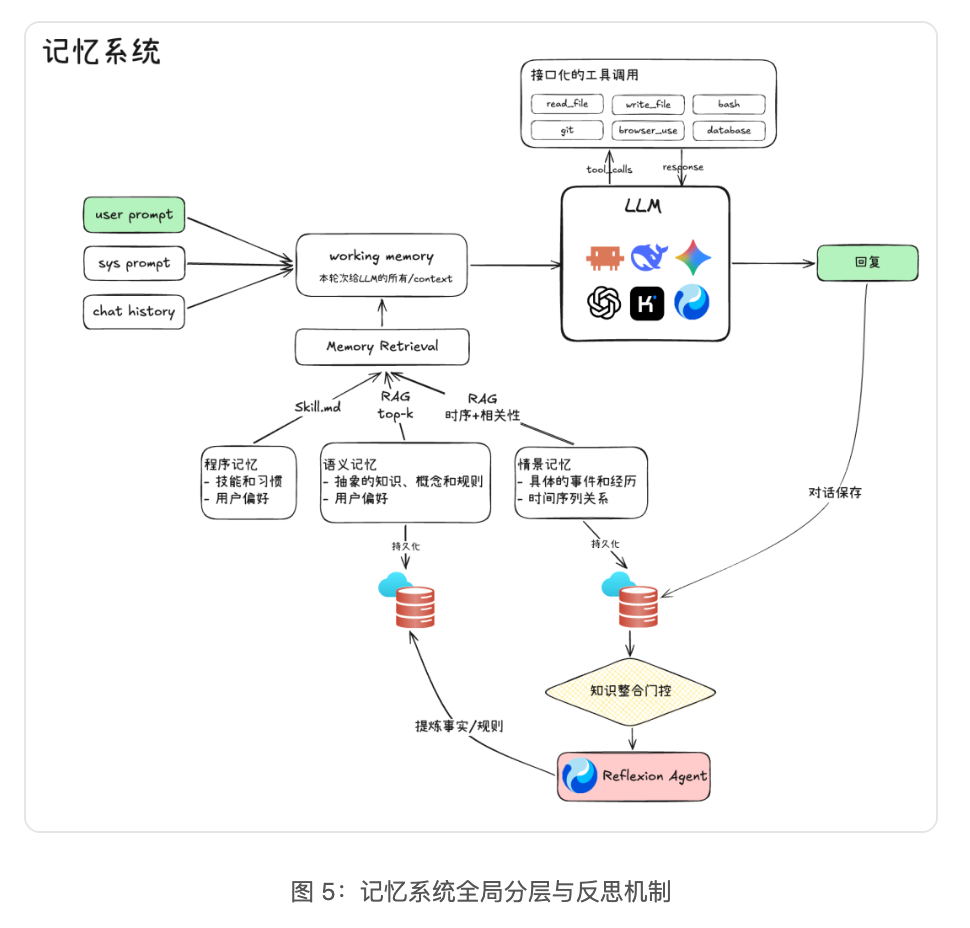
5. Memory(RAG / MemGPT):短期与长期分离
| 类型 | 内容 | 典型载体 |
|---|---|---|
| 程序记忆 | 技能、流程、约定 | SKILL.md |
| 语义记忆 | 事实、偏好、概念 | RAG / 向量检索 |
| 情景记忆 | 单次任务轨迹 | 日志、事件流 |
难点在写入/读取策略与 Reflexion 式反思,而非「有没有向量库」。
6. Harness(2025–2026):工业级运行时
当任务变长、客户端变多、副作用变强,Loop 外围必须回答:崩溃能否恢复?命令能否越权?多端是否同一状态?子 Agent 如何隔离?
Pi、OpenCode、Codex、Hermes 共享 Loop + Tool Calling + Context Assembly,但在成本、审计、安全、自进化上做了不同取舍
四、Harness 时代:Pi / OpenCode / Codex / Hermes · Qoder · Ruflo
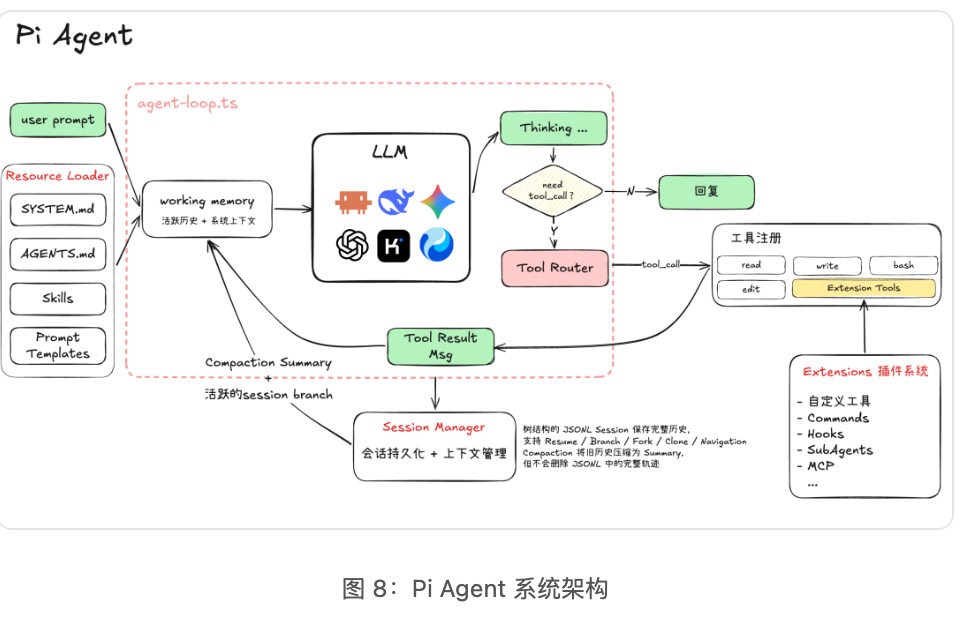
Pi:极简主义,压 Harness Tax
- 默认仅
read/write/edit/bash - Resource Loader + Session Compaction 压紧 Working Memory
- Composio 评测(DeepSeek V4 Flash · 30 任务):通过率 66.7%,中位成本 $0.012
- 代价:无内置强权限隔离,高风险环境需外置沙箱
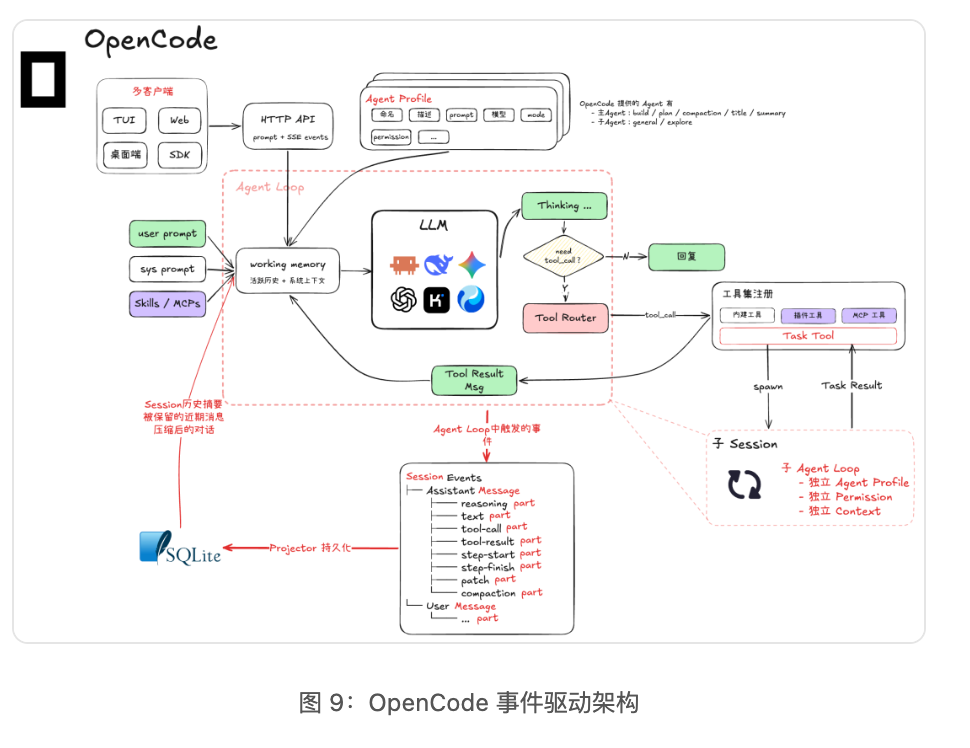
OpenCode:事件驱动,状态可回放
- Assistant Message 拆为 Reasoning、Tool、Patch、Compaction 等 Part
- Agent Profile 区分主 Agent / 子 Agent / 后台 Agent
- Session Events 投影 SQLite,多端共享运行时
- 代价:状态机与投影复杂,额外模型调用
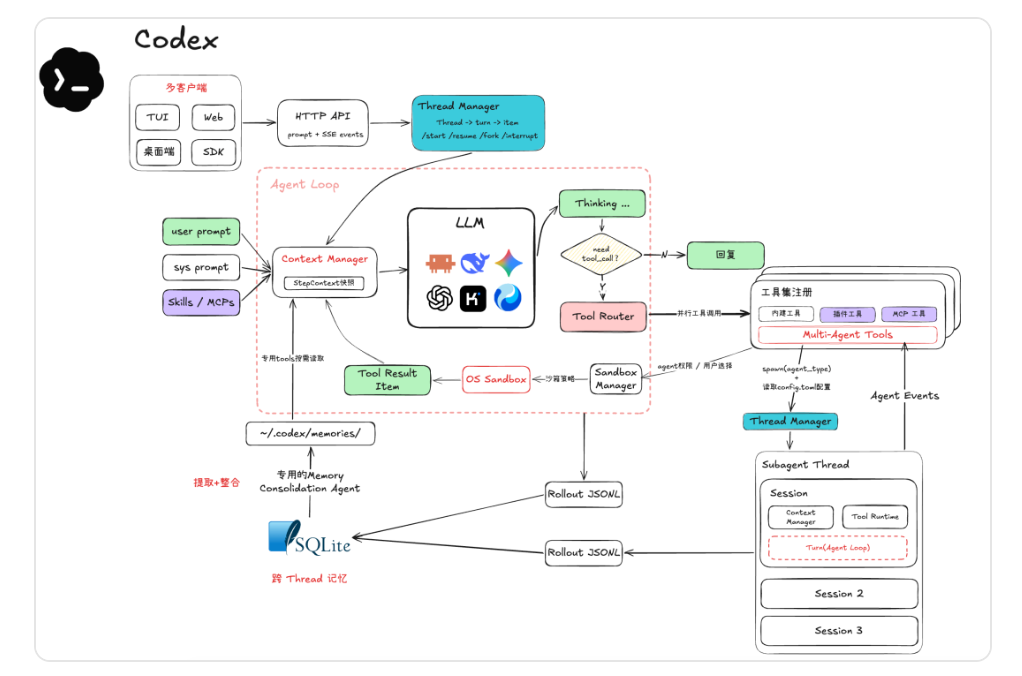
Codex:安全与 Thread 生命周期
- Approval Policy + OS Sandbox Policy 双层边界
- Thread → Turn → Item 协议骨架,支持 fork / resume / interrupt
- OpenBench(gpt-5.6-sol · 42 任务):通过率 73.8%,token 消耗最重一档
- 适合:长任务、真实副作用、需监督与恢复的场景
Hermes:跨会话自进化
- Background Review Agent 提炼 Skill / Memory
- Cronjob 触发,Agent 从「会话进程」变为「长期运行时」
- PAST-Bench:持久化增益 +0.13,机制证据分 0.64
- 适合:长期助手、经验复利
Qoder:产品化编码 Harness(CLI · SDK · Qoderwork)
与 Pi / OpenCode / Codex / Hermes 等「开源/论文路线」并列,Qoder 把 Agentic 闭环做成可交付产品:Qoder CLI 在终端里读仓、改代码、跑命令,写文件/跑命令前按权限设置确认;项目级 AGENTS.md、Memory、MCP、子 Agent(如 /quest),并支持 Headless 输出结构化结果,方便 CI 与脚本编排。QoderWork 把同一套 Agent 能力延伸到文档、表格、研究等非纯编码场景。
- 与 Codex 同层:都是 能碰真实工作区的执行面,适合长任务与真实副作用
- 与 OpenCode 相近:会话可
/resume,上下文可/compact,状态可观察 - Agent SDK(TypeScript / Python):流式响应、工具权限、MCP——可嵌入自研后端,而不是只能人手敲 TUI
- 落地要点:后端若用
child_process拉起 CLI,应像 Codex 哲学一样外包 受控执行器——工作区隔离(如 git worktree)、动作分级审批、沙箱白名单、流式可接管、先写任务账本再执行
Ruflo:Meta-Harness / 控制平面(编码 Agent 外层)
Pi、OpenCode、Codex、Hermes 回答的是「单个 Agent 会话里 Harness 怎么设计」。Qoder / Claude Code / Codex 等则是日常 执行者。当需要跨多个执行者做 Swarm、记忆闭环与策略时,Ruflo(本地整理:20260912-Ruflo项目分析总结.md)提供 控制平面:路由、Swarm、AgentDB、成本与审计——同样 Agent = Model + Harness,但不替 Worker 写每一行代码。
用户 → Ruflo CLI/MCP → Router → Swarm → Agents → Memory → LLM Providers ↑ ↓ └── Learning Loop ┘
- 与 Hermes 相近:ReasoningBank、AgentDB、RAG / 知识图谱等跨会话沉淀
- 与 Codex 相近:Cost Tracker、Policy/MetaHarness、审计与权限
- 与 OpenCode 相近:任务状态、多 Agent Profile 式角色分工
- 关键边界(AGENTS.md):
swarm init、task create等多是 协调账本,不会自动替代 Codex/Claude Code 去写文件、跑测试;Worker 权限与环境须显式配置 - 自研对照六层:模型 → 工具 → 编排 → 记忆 → 治理 → 验证;先单 Agent + 可验证结果,再 Swarm / Federation
选型矩阵(简)
| 框架 | 优势 | 代价 | 场景 |
|---|---|---|---|
| Pi | 成本、速度 | 安全弱 | 短平快代码任务 |
| OpenCode | 可审计、可恢复 | 工程复杂 | 多端协同 |
| Codex | 沙箱、生命周期 | 重 | 企业级工程 |
| Hermes | 越用越聪明 | 后台维护 | 长期助手 |
| Qoder | CLI/Headless + SDK 可嵌入 | 需自建受控执行层 | 终端/CI、业务系统内嵌编码 Agent |
| Ruflo | 多 Agent 编排 + 治理一体 | 配置重、学习曲线陡 | Qoder/Claude Code/Codex 外的控制平面 |
更细的 GOAP、Hooks、Federation 见知识库 站外分享/vibe-coding/20260912-Ruflo项目分析/。
五、给落地者的三个问题
- 你的 Agent 停在第几阶段? 只有 Prompt 和 API,没有 Loop 和 Tool 协议,还不算 Agent 系统。
- Harness Tax 算过没有? 上下文、轮次、审批、持久化都会吃 token 与时间;Pi 的评测说明同一模型换 Harness,成本可差数倍。
- 副作用谁兜底? 审核、运营、Coding Agent 一旦动真实数据,必须有 Approval + Sandbox + 审计账本——Codex 哲学在此。
六、结语
模型还会继续变强,但 Harness 不会因此消失。模型越能行动,外面的运行时越不能含糊。
未来分水岭,未必只是谁的基座更大,也是谁能为同一个模型搭出:更紧的上下文、更稳的循环、更清晰的边界、以及不会在长期使用中越学越乱的记忆。
学AI大模型的正确顺序,千万不要搞错了
🤔2026年AI风口已来!各行各业的AI渗透肉眼可见,超多公司要么转型做AI相关产品,要么高薪挖AI技术人才,机遇直接摆在眼前!
有往AI方向发展,或者本身有后端编程基础的朋友,直接冲AI大模型应用开发转岗超合适!
就算暂时不打算转岗,了解大模型、RAG、Prompt、Agent这些热门概念,能上手做简单项目,也绝对是求职加分王🔋
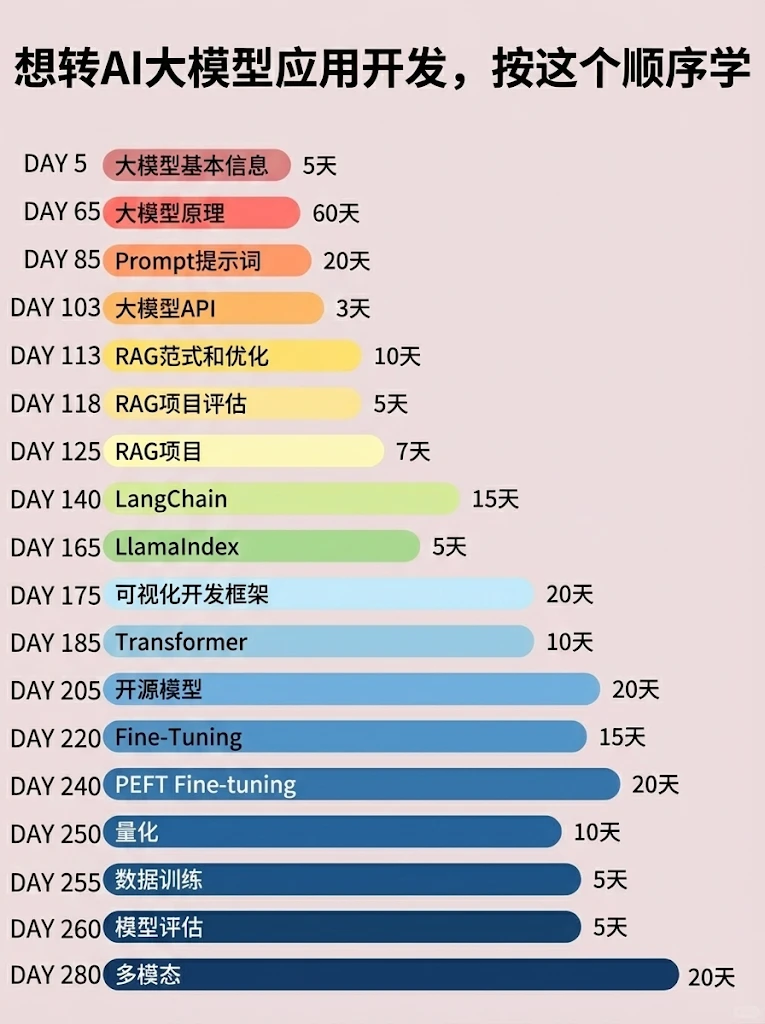
📝给大家整理了超全最新的AI大模型应用开发学习清单和资料,手把手帮你快速入门!👇👇
学习路线:
✅大模型基础认知—大模型核心原理、发展历程、主流模型(GPT、文心一言等)特点解析
✅核心技术模块—RAG检索增强生成、Prompt工程实战、Agent智能体开发逻辑
✅开发基础能力—Python进阶、API接口调用、大模型开发框架(LangChain等)实操
✅应用场景开发—智能问答系统、企业知识库、AIGC内容生成工具、行业定制化大模型应用
✅项目落地流程—需求拆解、技术选型、模型调优、测试上线、运维迭代
✅面试求职冲刺—岗位JD解析、简历AI项目包装、高频面试题汇总、模拟面经
以上6大模块,看似清晰好上手,实则每个部分都有扎实的核心内容需要吃透!
我把大模型的学习全流程已经整理📚好了!抓住AI时代风口,轻松解锁职业新可能,希望大家都能把握机遇,实现薪资/职业跃迁~
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】


openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 3
 0
- 0


 已为社区贡献4条内容

所有评论(0)