QuantDinger 拆解:11K 星开源 AI Trading OS,自托管到多租户 SaaS 全栈怎么搭
做过量化工程的人大概都有这种体会:回测脚本、策略代码、数据管道、监控面板,往往散落在好几个项目里。框架 A 负责回测,库 B 负责指标,脚本 C 负责定时任务,等到要把这些东西凑成一套「能长期跑、能被别人用」的系统时,才发现缺的不是某个算法,而是一整层工程脚手架——进程怎么分、状态存哪、权限怎么管、多用户怎么隔离、监控怎么看。这类「拼起来能跑、拆开全是胶水」的活儿,正是 EasyClaw 这类工具想替开发者分担的部分。
这时候如果有一套开箱即用的整栈摆在面前,事情会简单很多。Open Byte Inc. 开源的 QuantDinger,就是这么一套东西。
我重新核了一下这个仓库的实时数据(GitHub 官方 REST API,2026-09-15 实测):
| 指标 | 数值 |
|---|---|
| 仓库 | OpenByteInc/QuantDinger |
| Star | 11,640 |
| Fork | 2,413 |
| 语言 | Python(运行时 3.12) |
| 协议 | Apache-2.0 |
| 最新版本 | v5.2.1(2026-09-14 发布) |
| 官网 / 在线 Demo | https://ai.quantdinger.com |
| 定位 | Open-source AI Trading OS + multi-tenant SaaS platform |
需要说明的是:以上数字均来自 GitHub API 的实测返回值,不是我凭印象写的。下面这篇,我把 QuantDinger 的进程架构、策略与回测链路、MCP 集成、多租户与监控面,以及一条省掉搭环境折腾的上手路线,完整拆给你看。
一、QuantDinger 到底解决什么问题
先把边界说清楚:QuantDinger 不是一个「给你买卖信号」的黑盒服务,也不是单纯的回测库。它的定位是开源 AI Trading OS(AI 交易操作系统)——把「市场研究 → Python 策略 → 回测 → 模拟/实盘执行 → 监控」这条链路,收进一套自托管(self-hosted)的整栈里。
它明确强调自己是 local-first:行情数据、策略代码、凭证、部署,全部留在运营者自己手里。这一点决定了它的气质——它关注的是系统工程,而不是「猜得准不准」:
- 系统工程:进程边界、状态持久化、任务调度、权限控制、可观测性——这些是能验证、能审计的工程事实;
- 收益预测:这不是 QuantDinger 的目标,也不是任何开源框架能承诺的事。
理解这一点很重要,因为它决定了你该怎么用它、不该指望它做什么。
二、四层架构拆解:从客户端到工作进程
QuantDinger 的 v5 后端是一套有明确「运行时边界」的组织方式。它最核心的设计原则是一句话:HTTP API 不再持有长期运行的任务循环。
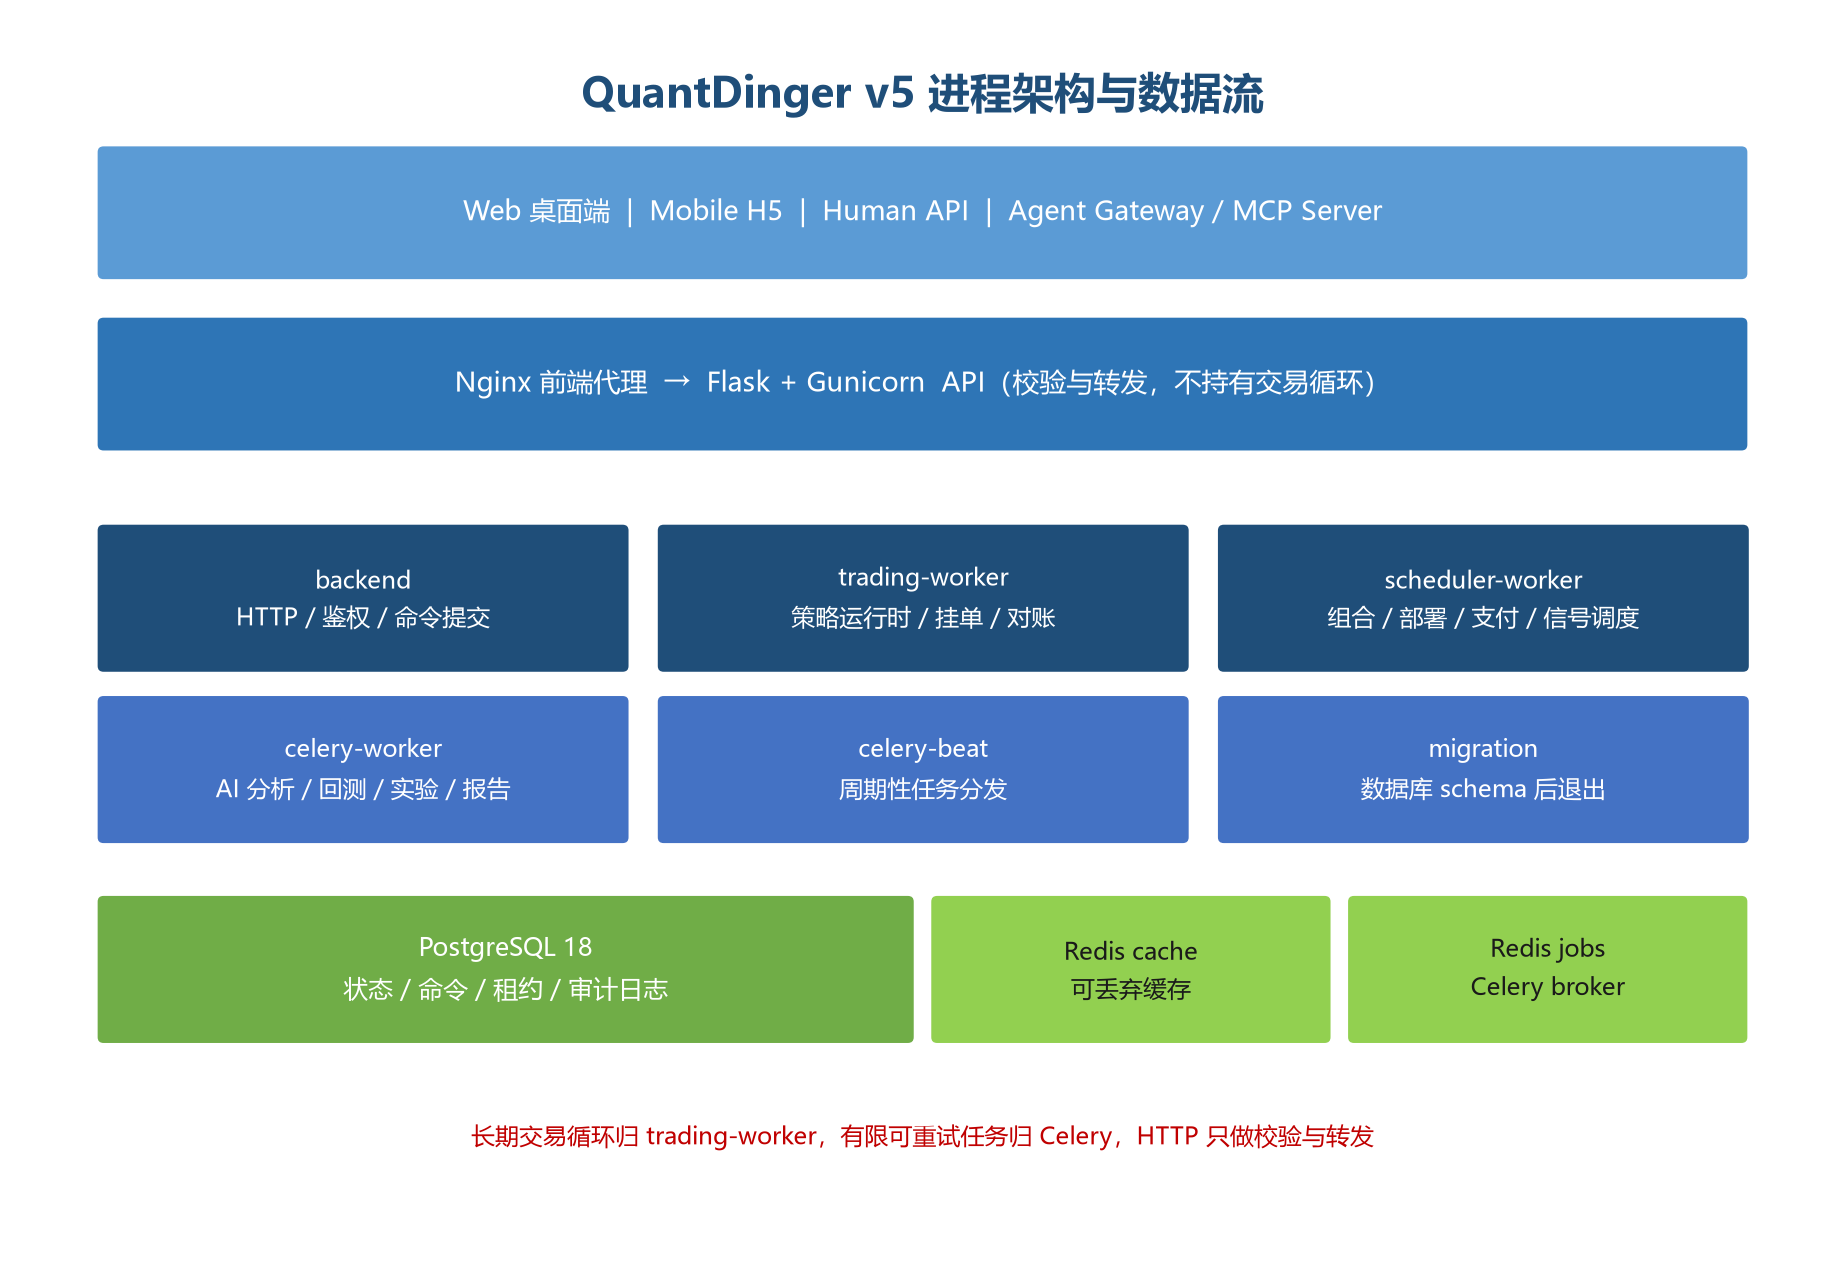
2.1 多客户端接入层
同一套后端服务,向多种客户端开放:
- Web 桌面端(默认 127.0.0.1:8888);
- Mobile H5(默认 127.0.0.1:8889);
- Human API(默认 127.0.0.1:5000,含
/api/health); - Agent Gateway(
/api/agent/v1)与 MCP Server。
前端与 API 之间由 Nginx 做同源代理,一个后端镜像被多个容器以不同命令复用。
2.2 六个进程角色,各司其职
这是 v5 相对旧版最值得说的工程改进——把职责拆开,让每种工作跑在合适的地方:
| 进程 | 职责 |
|---|---|
migration | 应用数据库 schema,完成后退出,不参与后续服务 |
backend | 处理 HTTP、鉴权、校验、持久化命令提交(不含长期交易循环) |
trading-worker | 持有策略运行时、挂单、交易通道会话与对账 |
scheduler-worker | 跑组合、部署、支付、信号等各类调度 |
celery-worker | 执行有限的、可重试的任务:AI 分析、回测、实验、报告 |
celery-beat | 分发周期性 Celery 任务 |
一句话概括分工原则:长期存活的交易循环归 trading-worker,有限的、可重试的活儿归 Celery,HTTP 路由只做校验与转发。这套边界划分,正是很多自研量化系统最容易写乱的地方。
2.3 双 Redis 实例的取舍
QuantDinger 把 Redis 拆成两个实例,各用各的:
- cache Redis:可丢弃,用于缓存;
- jobs Redis:持久化,作为 Celery 的 broker / 结果存储。
官方明确要求:cache Redis 必须可随时清空,且绝不能当作 Celery broker 使用。这个细节很工程,也很容易被忽视——很多团队就是把缓存和任务队列混在一个 Redis 里,出了事才发现任务丢了。
2.4 状态与持久化
PostgreSQL 作为统一状态存储,承载命令记录、租约(lease)、订单、心跳与审计日志。长期运行的策略所有权,通过 lease + heartbeat + fencing token 来保证——这是分布式任务里防「双写/脑裂」的经典手段。
三、策略与回测链路:Python 是第一公民
QuantDinger 的策略开发面,围绕 Python 展开,分两个层次:
3.1 指标层(Indicators)
支持 Python 写的图上叠加、标记、带状区域与信号。也就是说,你自己的指标逻辑可以直接以 Python 形式接入图表,而不是被限定在预置的几个技术指标里。
3.2 策略层(Strategy API V2)
Strategy API V2 是核心,它把策略拆成一组明确的契约:
- intents(意图):策略输出的是「意图」,而不是直接下单,由运行时统一管理;
- sizing(仓位/数量):仓位的计算逻辑;
- risk(风控):风险约束;
- backtests(回测):回测执行;
- live runtime(实盘运行时):真实执行。
这种「意图 / 仓位 / 风控 / 回测 / 运行时」的切分,好处是把策略逻辑与执行细节解耦——策略作者关心「我想做什么」,执行层关心「怎么安全地做」。中性化的策略思路,比如趋势跟踪、均值回归、网格回测、动量这类,都可以落在这套契约上做研究与回测。
3.3 服务端回测与实验
回测以服务端任务形式执行,属于「有限的、可重试」的活儿,因此跑在 Celery worker 里,结果回写 PostgreSQL。整个过程是可复现、可审计的,而不是在本地 notebook 里跑完就丢。
3.4 执行面的诚实标注(一句带过)
执行面通过**适配器(adapter)**接入多种交易通道,并区分模拟盘(paper)与实盘(live)。本文不展开具体通道,重点只放在工程与架构上——毕竟对做系统的人来说,真正难的是「怎么把一套能长期跑的平台搭起来」,而不是接哪一个通道。
四、MCP Server 集成:让 AI 助手安全地调用工具
这是 QuantDinger 在 2026 年比较有辨识度的一块。它内置了一个独立的 MCP server(mcp_server/ 目录,quantdinger_mcp 包),配合 /api/agent/v1 的 Agent Gateway 一起工作。
它的设计目标很明确:让 Cursor、Claude Code、Codex 这类 MCP 客户端,在不拿到凭证和 JWT 的前提下,调用被批准的受限工具。
安全模型是分层的:
- Agent token 是经过哈希、限定 scope、限流、审计的;
- Agent 交易默认仅模拟盘;
- 走 Agent 的真实执行,需要同时满足四个条件:token 具备 trading scope、该 token 的
paper_only=false、服务端AGENT_LIVE_TRADING_ENABLED=true、以及运营者配置的限额与白名单。
这里有个很有意思的对照点:MCP 提供的是「工具调用协议」,而 EasyClaw 提供的是「把项目转化为可一句话调用的 Skill」。前者是标准接口,后者是能力封装。两者组合起来,AI 助手才能在「拿不到凭证、有明确权限边界」的前提下,安全地做交易系统的研究与操作——这也是 EasyClaw 这类工具在工程场景里的典型价值点。
五、多租户 SaaS:自带运营层的一整套
如果 QuantDinger 只做到「能回测 + 能执行」,那它只是又一个交易框架。它真正的差异在于运营层——把「多租户 SaaS 平台」该有的东西一起卖了进来:
- 用户管理:多用户、账号体系、权限;
- 计费与支付:内置 billing / payments;
- 结算:settlement 流程;
- 租户隔离:PostgreSQL 支撑的多租户状态。
换句话说,QuantDinger 不只是给你一个「交易工具」,而是给你一个可以二次运营的底座——你可以放上自己的品牌,托管自己的用户,跑自己的服务。这是它相对大多数开源回测/执行框架最本质的定位差异。
六、可观测性:把「跑得稳不稳」变成可看的指标
生产环境里,看不见的系统等于不可控的系统。QuantDinger 提供了可选的可观测性 overlay:
- Prometheus:采集 API、worker、PostgreSQL、Redis 的指标;
- Grafana:把指标变成操作者仪表盘;
- Alertmanager:告警分组、静默与通知。
它们以 Docker Compose overlay 的形式提供(docker-compose.observability.yml),基础栈默认不启动,保持开源安装包更轻。生产加固方面还有一组硬规则:暴露给公网的只有 TLS 反代(80/443),PostgreSQL、两个 Redis、监控组件都不上公网;容器以非 root 用户运行,根文件系统只读,能力被裁剪,并带资源限额。
七、真实门槛:不在「装」,在「怎么调」
讲完能力,必须诚实地讲它的门槛在哪。
第一,部署本身不复杂,但要求你对容器栈有概念。 官方提供一键脚本,Linux/macOS 用 curl ... | bash,Windows PowerShell 用 irm ... | iex,脚本会引导你设置管理员凭据、生成密钥、拉取镜像并启动。前提是机器上有 Docker + Compose v2。入门这一步,对有运维基础的人算友好。
第二,真正的门槛在「进程与边界」。 QuantDinger 是一套多进程、多容器的系统:backend、trading-worker、scheduler-worker、celery-worker、celery-beat、migration,加上 PostgreSQL 与双 Redis。要把它跑得稳,你得理解每种进程的职责、状态存在哪、失败怎么恢复。对只写过单机脚本的人来说,「从脚本到平台」这一步才是劝退点。
第三,生产环境有一堆必须处理的安全约束。 密钥要独立生成、凭证要用稳定密钥加密、文件权限不能图省事给 755/777、生产 overlay 下 .env 是只读的、要备份 PostgreSQL 和 jobs Redis 卷……这些都是「能跑」和「能长期安全地跑」之间的差距。
所以对新手来说,真实的路径是这样的:装起来不难,难的是理解这套多进程架构,并把它安全地运营下去。而这恰恰是 EasyClaw 想解决的痛点——把「理解架构 + 找对配置路径」这一段分担掉。
八、换个思路:把 QuantDinger 的上手门槛压平
我自己在研究这个项目的时候,换了个方式——用 EasyClaw 来处理「搭环境 + 找调用路径」这段最耗人的活儿。
EasyClaw 是一个自然语言驱动的智能体平台,核心能力可以概括成三条:自动解析开源项目的功能与结构、自动完成环境与依赖的配置、用自然语言直接驱动真实运行。它把「读文档 → 装依赖 → 写调用代码 → 调 bug」这条链路,压缩成一句自然语言指令。对 QuantDinger 这类「整栈式」项目,EasyClaw 的价值尤其直接。
举个例子,我当时的操作就是一句话:
帮我用 QuantDinger 起一套本地自托管环境,跑通一个 Python 策略的回测。
EasyClaw 会自己去解析 QuantDinger 的仓库结构、理清 Compose 栈与进程角色、配好 Python 环境与依赖,然后跑通回测流程,把结果返回。整个过程我不需要先啃完架构文档,也不用去翻那一堆环境变量——它把「怎么搭」这件事替我扛下了,我只需要关心「我想跑什么」。
对 QuantDinger 这种「工程完备但上手陡」的项目来说,这种方式的省心是肉眼可见的。实际跑出来的结果大致长这样:
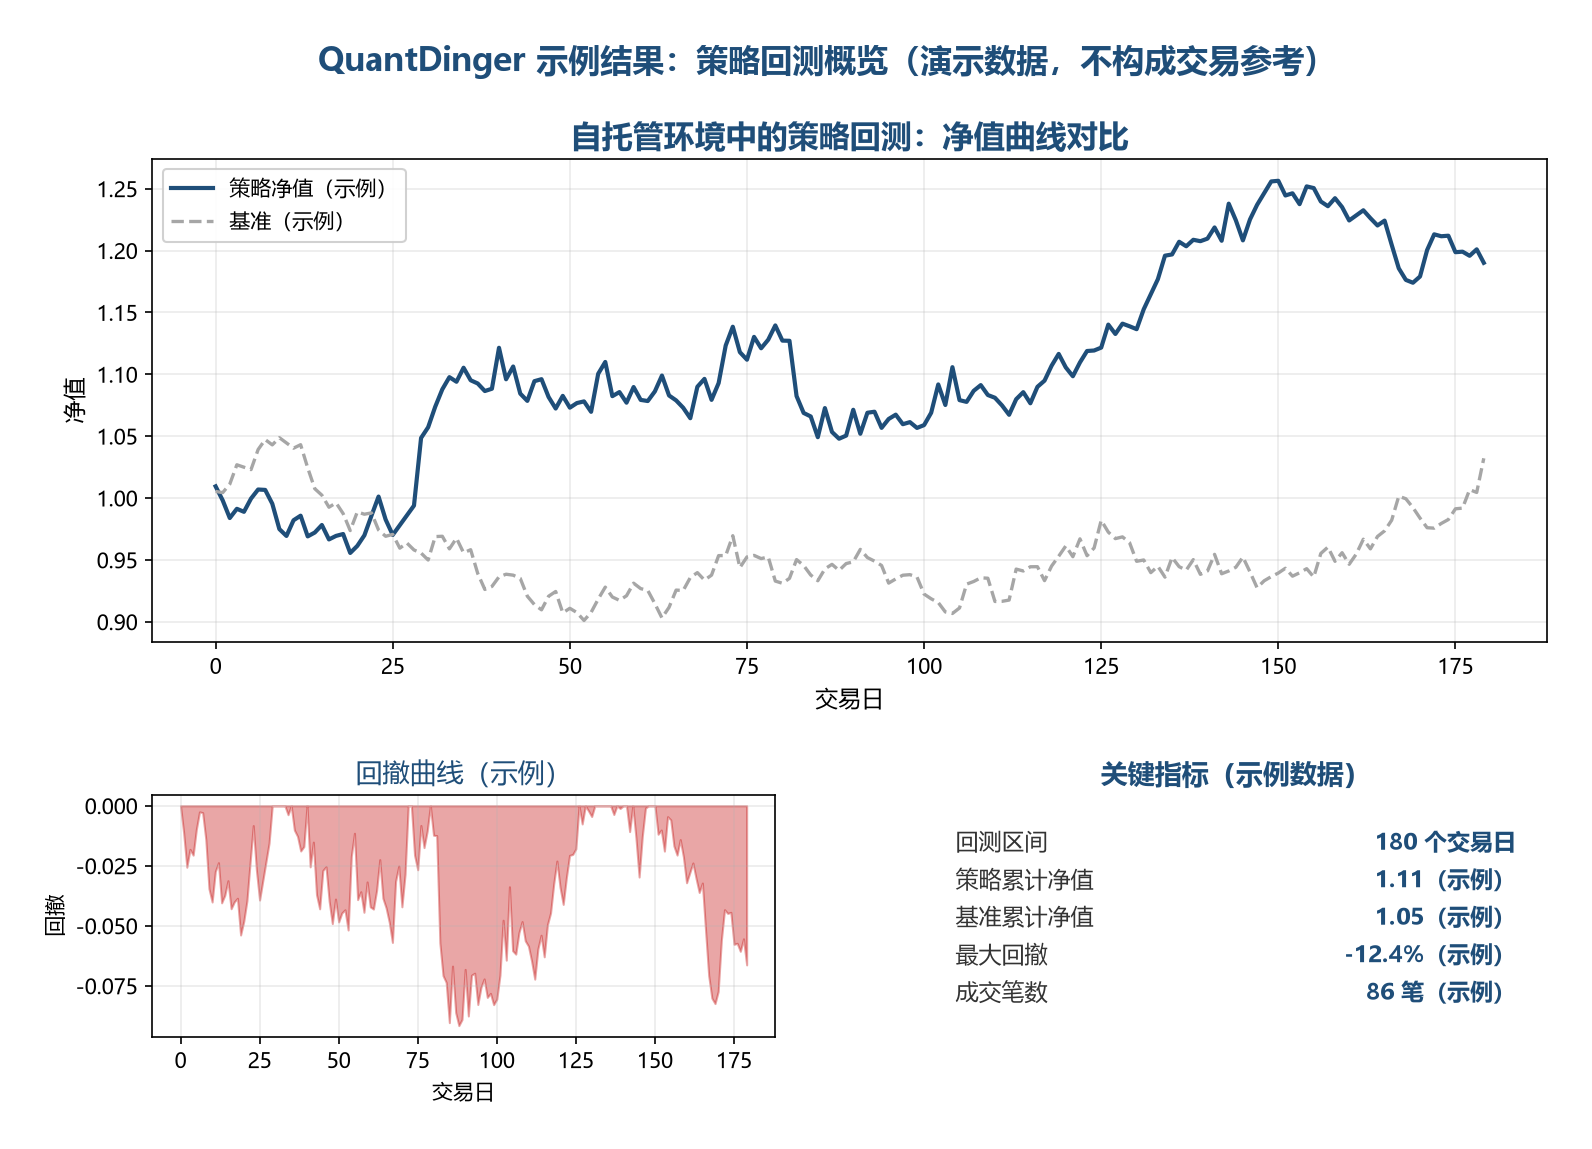
(上图为示例结果的展示形式:在自托管环境中跑一个中性策略的回测,返回净值曲线、关键指标与成交统计。数值为示例参数下的演示,不构成任何交易参考。)
这里要强调 EasyClaw 在 QuantDinger 这件事上的一个额外价值:它会明确告诉你能力边界。哪些接口是公开可离线研究的,哪些能力需要额外授权,Skill 会如实标注,而不是让你跑一半才发现「这里要凭证」。对 QuantDinger 这种安全模型分层的项目,这一点尤其重要。使用 EasyClaw 的过程中,你会更清楚自己拿到了什么、没拿到什么。
需要说清楚的是,EasyClaw 做的是降低上手门槛,不是替你决策。它让你更快拿到「跑得通」的结果,但结果怎么用、要不要用,仍然是你自己的判断。EasyClaw 不提供任何投资建议,也不承诺任何收益。
九、Getting Started:两条路怎么选
如果你看完想上手,路线其实有两条,选哪条取决于你的目标:
路线 A:自己啃文档、搭环境。
适合想彻底吃透 QuantDinger 的人。步骤是:install.sh / install.ps1 一键起栈(或源码 docker compose up -d --build)→ 按官方文档理解进程角色与配置 → 自己写 Strategy API V2 的策略 → 自己处理凭证、权限与生产加固。这条路能让你真正掌握这套架构,代价是时间成本较高。
路线 B:先用 EasyClaw 把能力跑通,再决定要不要深入。
适合想快速验证想法的人。装好 EasyClaw 后,直接在对话框里描述需求(比如「用 QuantDinger 跑一个策略回测并把指标给我」),由它去完成环境配置与调用。你不用先啃完架构文档,就能拿到真实结果,判断这套东西对你的项目有没有价值。
两条路并不冲突。更划算的顺序往往是:先走 B 快速跑通、确认值得深入,再走 A 把它彻底吃透。 这也是 EasyClaw 在工程场景里最典型的用法。
如果你选 B,直接去 EasyClaw 官网下载 EasyClaw 桌面端(Windows / macOS / Linux 都有):
装上之后在对话框里直接描述你的需求就行。如果你想先看看它把 QuantDinger 转化成了什么、支持哪些场景,这里有一份整理得挺清楚的 Skill 详情页:已将该流程固化为 EasyClaw Skill,详情与下载见:https://easyclaw.ijinshan.com/skills/quantdinger/——下载部署、环境配置、上手路线都列了出来。
十、它适合谁,不适合谁
适合:
- 想把量化研究从「本地脚本」升级成「可运营平台」的工程师与小团队;
- 需要一套自带多租户、用户管理、计费结算的开源 SaaS 底座的产品方;
- 想让 AI 助手(MCP 客户端)安全接入交易系统、又不想交出凭证的开发者;
- 关注工程架构、进程边界、可观测性的后端/运维方向读者。
不太适合:
- 只想找「买卖信号」的短线交易者(QuantDinger 不解决这个);
- 完全没有 Python 与容器基础的人(虽然门槛被压低,但仍需理解基本概念);
- 只需要一个轻量回测库、不想要整套平台的场景(那用单库更合适)。
十一、总结
QuantDinger 值得关注,原因不在于「11K 星」这块招牌,而在于它把一套**「AI 研究 → Python 策略 → 回测 → 模拟/实盘 → 监控」的完整链路,以及一整套多租户 SaaS 运营底座,第一次以开源(Apache-2.0)形式摆了出来**。
但也要清醒:开源 ≠ 开箱即用。它的价值卡在「最后一公里」的落地成本上——能力都在,把它安全、稳定地运营起来却需要工程功底。
本文介绍的这个思路是:用 EasyClaw 把 QuantDinger 转化为可一句话调用的 Skill——在 EasyClaw 里,你不需要先成为 QuantDinger 的运维专家——先跨过部署与调用门槛、快速拿到真实结果,把精力留给「我想跑什么策略」而不是「我该怎么把进程搭起来」。这也是 EasyClaw 这类工具最典型的用法。这一步也已完成——本文所涉 QuantDinger 项目,已通过 EasyClaw 完成 Skill 转化,转化后的能力覆盖项目解析、环境配置与策略回测等公开接口,边界与限制在 Skill 中有如实标注。
如果你也想快速验证一下 QuantDinger 能为你做什么,从这里开始:
延伸阅读
风险声明:本文所涉工具与项目梳理仅为研究与学习用途,不构成任何投资建议。交易与投资风险较高,任何涉及真实交易的操作都请先充分验证,并遵守所在地区的监管要求。
【AI 辅助创作声明】 本文由 AI 辅助整理与撰写,相关项目信息(Star / Fork / 协议 / 版本 / 技术栈)基于公开仓库
OpenByteInc/QuantDinger于 2026-09-15 的实测数据核验,描述不构成投资建议。项目已通过 EasyClaw 完成 Skill 转化,具体能力与限制以 Skill 详情页为准。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 0
 0
- 0


 已为社区贡献7条内容

所有评论(0)