【Linux】操作系统之进程介绍(一)
前言:前面我们一直在编译程序、运行程序,但程序运行起来以后,操作系统到底在管理什么?磁盘上的可执行文件和我们经常说的进程,是不是同一个东西?这篇先从计算机的硬件结构和操作系统的作用说起,再看看进程是什么、怎样查看进程,以及如何通过fork创建一个子进程。
1.冯诺依曼体系结构
在说进程之前,我们先来看一下程序运行所依赖的硬件。冯诺依曼体系结构是理解计算机的一种基本模型,它的一个重要思想是存储程序:程序指令和数据都存放在存储器中,由CPU取出指令并执行。
从功能上看,可以把计算机分成五个部分:
| 组成部分 | 作用 |
|---|---|
| 输入设备 | 把外部信息送入计算机,例如键盘、鼠标、扫描仪 |
| 存储器 | 保存程序指令和数据,这里的核心是主存,也就是内存 |
| 运算器 | 完成算术运算、逻辑运算等数据处理 |
| 控制器 | 解释指令并协调各部分完成操作 |
| 输出设备 | 把处理结果输出,例如显示器、打印机 |
运算器和控制器是CPU的重要组成部分。输入、输出也不是给某个设备贴上一个永远不变的标签,比如网卡既能接收数据,也能发送数据;磁盘既能读,也能写。
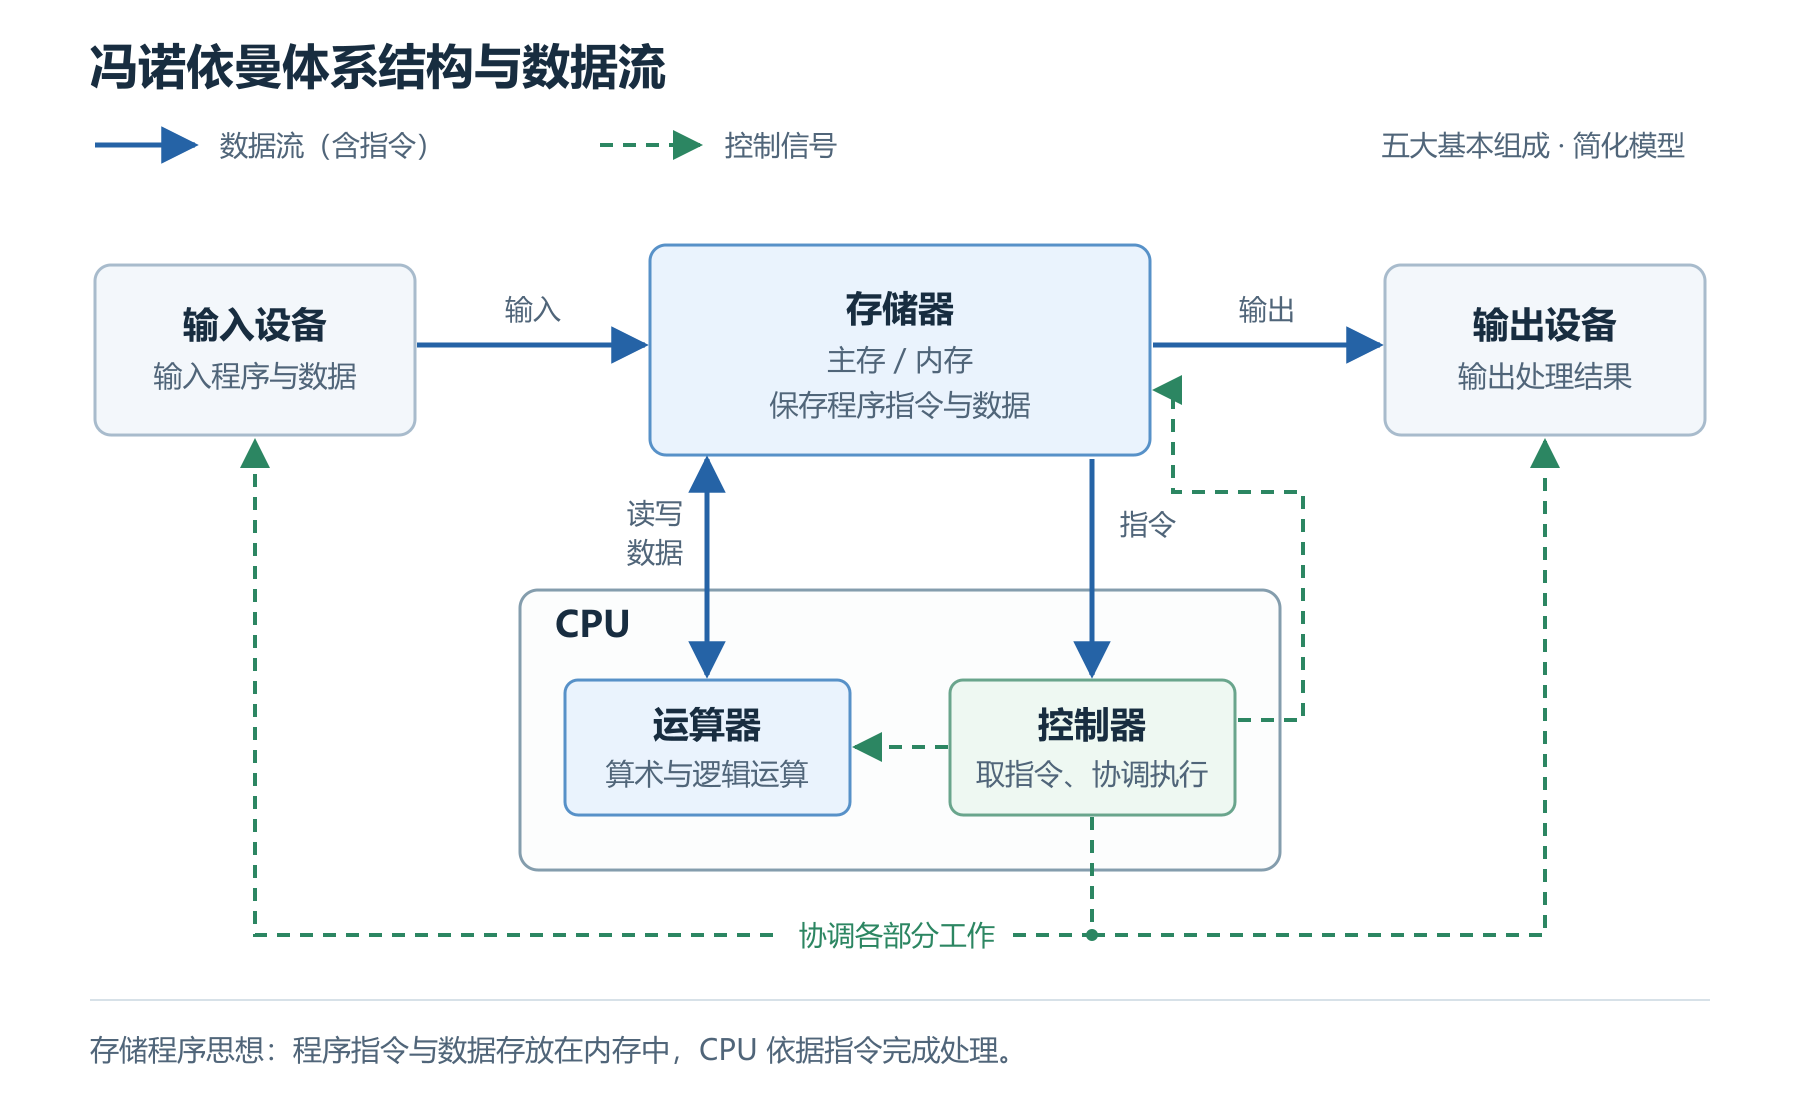
这里比较容易混淆的是内存和磁盘。磁盘主要用于长期保存文件,而内存用于保存程序运行时需要的指令和数据。gcc生成的可执行文件放在磁盘上,并不代表CPU已经在执行它;运行程序时,需要先建立相应的运行环境,让执行所需的内容进入内存,CPU才能取指执行。
为什么要把内存放在中间理解呢?因为CPU处理数据的速度和外部设备提供数据的速度并不一致。内存可以作为程序运行和设备数据传递的重要中间环节,这样的话CPU执行程序时不必把每次处理都理解成直接对磁盘上的文件进行操作。
如果再考虑存储层次,通常是寄存器、各级缓存、内存、磁盘逐层配合。越靠近CPU,通常访问越快、容量越小、单位容量成本越高。整套系统的效率不只取决于CPU,数据供给跟不上,同样会限制程序的运行速度。
图中画的是简化过后的数据流模型,不是在说真实CPU绝对不能访问外设。实际设备访问还涉及设备寄存器和驱动等机制,可以参考Linux的设备访问说明,这里不展开硬件细节。
举个现实里我们发消息的场景里就比较好理解了:
- 键盘输入文字,应用程序在内存中保存和处理这些输入。
- 点击发送后,程序通过操作系统提供的网络功能,把准备好的数据交给网卡发送。
- 对方的网卡收到数据,经过其操作系统和应用程序处理,再把消息显示出来。
如果发送的是文件,数据来源就从键盘输入变成了磁盘上的文件,需要先读取文件内容,再进行后续处理和发送。
2.操作系统的管理
2.1操作系统的作用与位置
有了硬件,还需要一套软件负责协调它们,这就是操作系统,其实操作系统也是个软件,这个软件用来管理计算机的软硬件资源。OS就是Operating System的缩写。
从核心功能来说,操作系统负责进程管理、内存管理、文件管理和设备管理等工作。我们平时说一个完整的Linux系统时,除了内核,还会包含Shell、函数库和其他系统工具;但这些外围程序并不等于内核本身。
操作系统的作用可以从两个方向理解:
- 对下,管理和协调硬件及其他系统资源。
- 对上,向应用程序提供服务,让程序能够在合适的环境中执行。
比如程序要读取文件、申请资源,或者创建新的进程,不应该由每个应用随意操作整个机器的硬件,而是通过操作系统提供的接口完成,就像是我们之前实现 AVL树一样我们是不期望 _root 被访问的,否则用户可能会破坏这棵树。
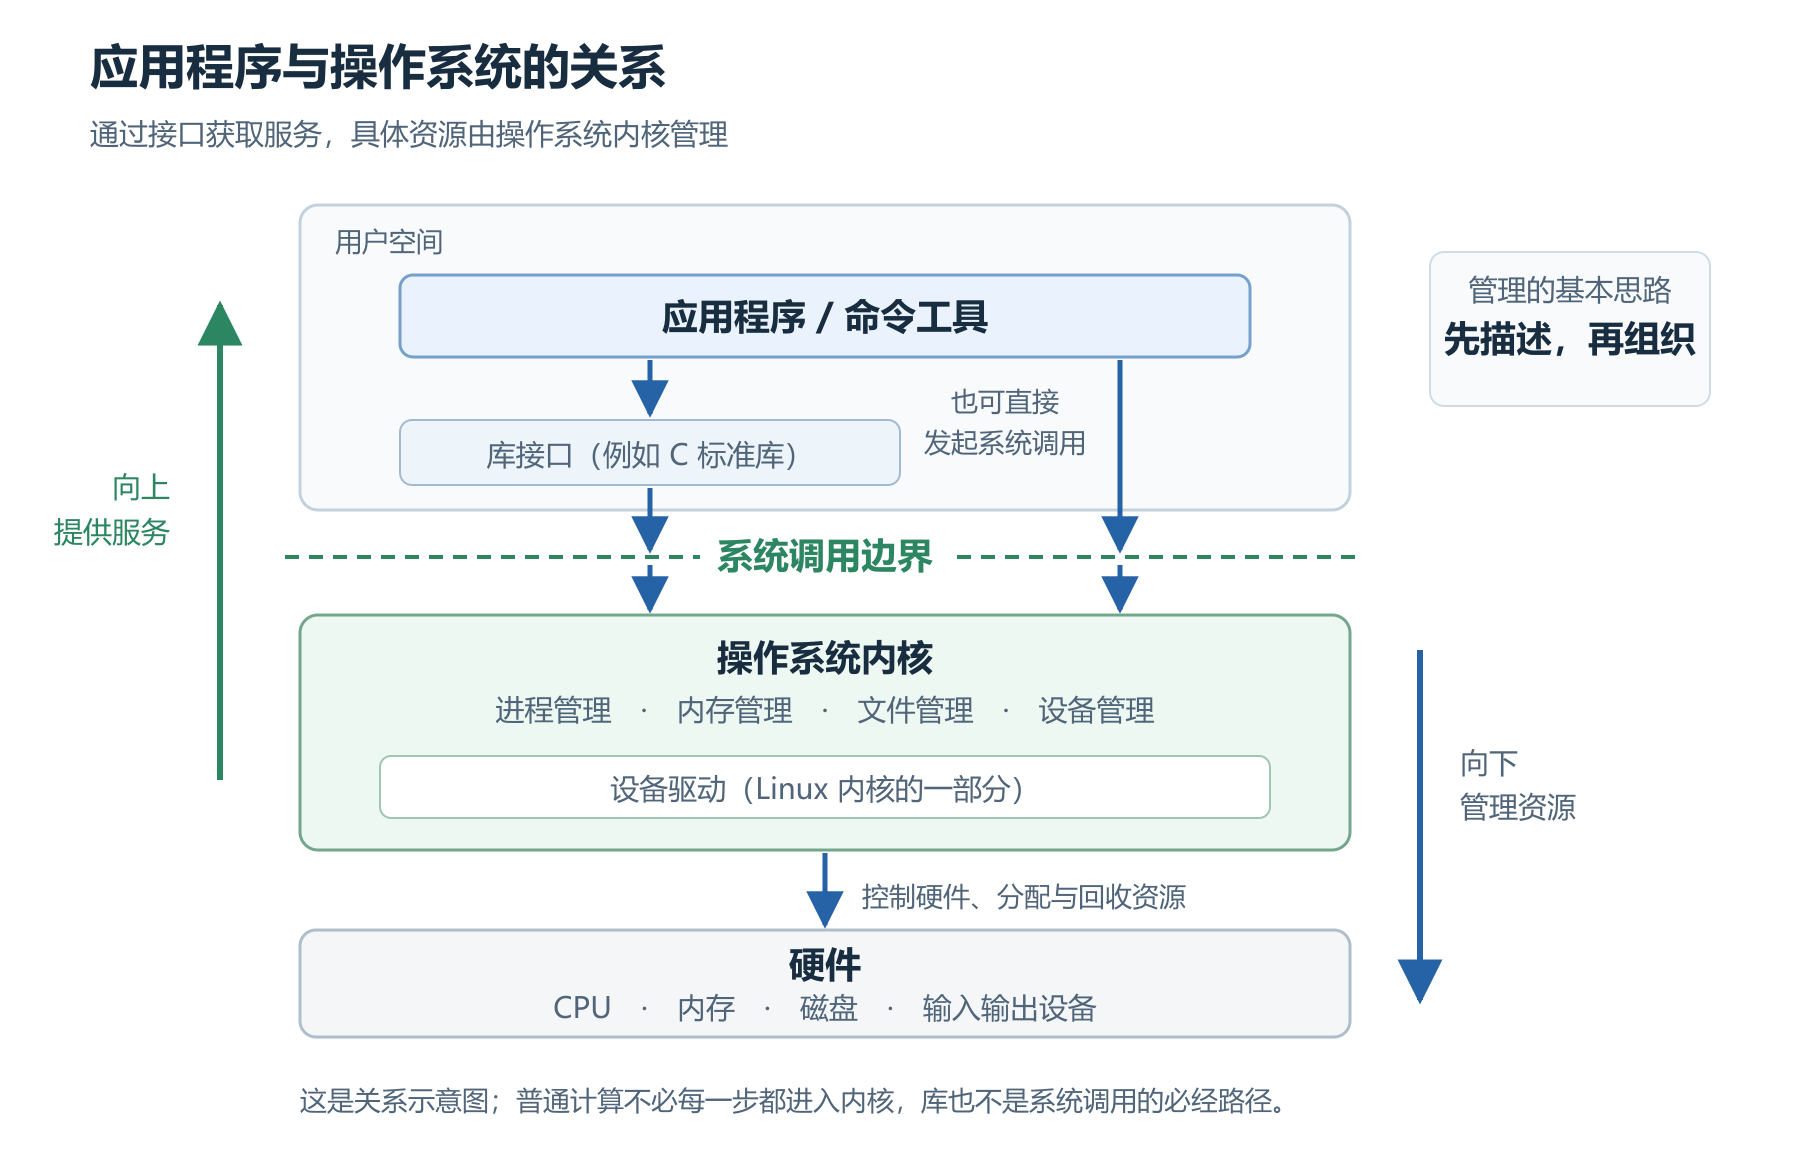
这里的设备驱动也是软件,它负责具体设备的操作细节,在常见的Linux结构中,设备驱动属于内核体系的一部分。应用程序通常不需要知道某个型号的硬盘或网卡应该怎样操作,而是使用上层提供的接口,这里实际上也体现出了封装的工程思想。
因此可以把操作系统理解成一款负责“管理”的软件。管理硬件不是最终目的,让多个程序能够合理使用资源、正常运行,才是这些管理工作的意义。
2.2先描述,再组织
这六个字会贯穿我们学习操作系统的始终
“管理”听起来比较抽象,我们可以换一个熟悉的场景。
一所学校有很多学生,管理者不可能每次处理事情时都把所有学生叫过来,而是先记录学号、姓名、班级、成绩等信息,再把这些信息整理起来。查找某个学生、更新成绩、增加新生记录,本质上都是在操作这套数据。
放到程序里也是一样的:
- 先描述:把被管理对象的属性保存下来,例如用结构体记录相关信息。
- 再组织:把这些记录放到链表、树等数据结构中,方便查找、增加、删除和修改。
所以管理并不一定意味着直接接触被管理对象,而是可以通过描述它的数据来完成。
操作系统同样如此。它要知道有哪些程序在运行、各自使用了哪些资源、接下来应该如何处理,就需要为这些运行中的程序建立相应的管理信息,再把它们组织起来。
这里也能发现,我们前面学过的结构体和数据结构并不只是用来写几道题,它们就是复杂软件组织和管理信息的基础。
2.3系统调用与库函数
操作系统内部的管理信息不能任由应用程序随便修改,所以它会提供一组对外的服务接口,这些接口就叫作系统调用。
可以把它理解成去银行办业务。我们不能直接进入内部修改自己的账户余额,而是通过规定的窗口提交请求,由银行内部检查并完成操作。系统调用也是这样的边界:应用程序提出请求,由内核完成需要它负责的工作。
我们平时写程序时,很多功能又是通过库函数使用的。库可以在系统调用之上进一步封装,处理一些通用的步骤,让上层使用起来更方便。
比如printf是C库函数,它会处理格式化等工作,需要真正向外输出时,再通过底层接口完成相应的操作。
不过,不是所有库函数都一定调用系统调用。有些函数只处理程序自己内存中的数据,不需要内核提供额外服务。反过来,应用也可以通过相应的系统调用接口请求内核服务,并不需要每次都经过某个额外的高级封装层。关于系统调用与C库接口的关系,可以对照Linux系统调用手册。
之前我实现的拿个贪吃蛇其实也是调用的win提供的系统接口。
3.进程的基本概念与查看方式
3.1程序、进程与PCB
简单来说,进程是程序的执行实例。
程序可以是磁盘上的一个可执行文件,里面保存着指令和数据;进程则是这个程序运行起来以后形成的运行实体。除了要执行的代码和使用的数据,它还需要有操作系统保存与管理信息。
可以把它理解成:
进程 = 描述它的内核数据结构 + 运行中的程序代码和数据。
同一个可执行文件可以运行多次,形成不同的进程。它们执行的程序相同,不代表就是同一个进程,也不代表所有运行数据都混在一起。
那么操作系统用什么来描述进程呢?这个结构通常叫作PCB,全称是Process Control Block,也就是进程控制块。
在Linux中,理解这一概念时主要会接触到task_struct。它是内核中描述任务的重要结构体,保存或关联进程管理需要的信息。可以把它看作进程在内核中的一份“档案”,而不是存放在磁盘上的程序文件。
这些信息大致可以分为:
| 信息类别 | 用来说明什么 |
|---|---|
| 标识信息 | 这个进程是谁,如何和其他进程区分 |
| 状态与退出信息 | 当前处于什么情况,结束时留下什么信息 |
| 调度相关信息 | 操作系统安排它执行时需要参考的属性 |
| 执行位置与上下文 | 程序执行到了哪里,需要保存哪些寄存器等信息 |
| 内存相关信息 | 程序代码、数据以及相关内存在哪里 |
| I/O与文件信息 | 使用了哪些文件,涉及哪些输入输出资源 |
| 记账信息 | 已消耗的CPU时间等资源使用情况 |
有了描述,还需要组织。task_struct中有用于组织任务的链表成员,内核可以把相关记录连接起来,再对它们进行管理。实际内核不只使用一条链表,也会根据不同需求使用其他数据结构。感兴趣的话可以在Linux内核的sched.h中看到相应定义。
这样,对进程的管理就不再是一个看不见的概念,而是变成了对内核中这些数据结构的操作。
3.2PID、PPID与ps
操作系统要区分进程,就需要给它们分配编号,这个编号叫作PID。而PPID表示父进程的PID。
在程序内部,可以通过下面两个接口取得这些编号:
getpid():取得当前进程的PID。getppid():取得当前父进程的PID。
可以先查看手册:
man 2 getpid
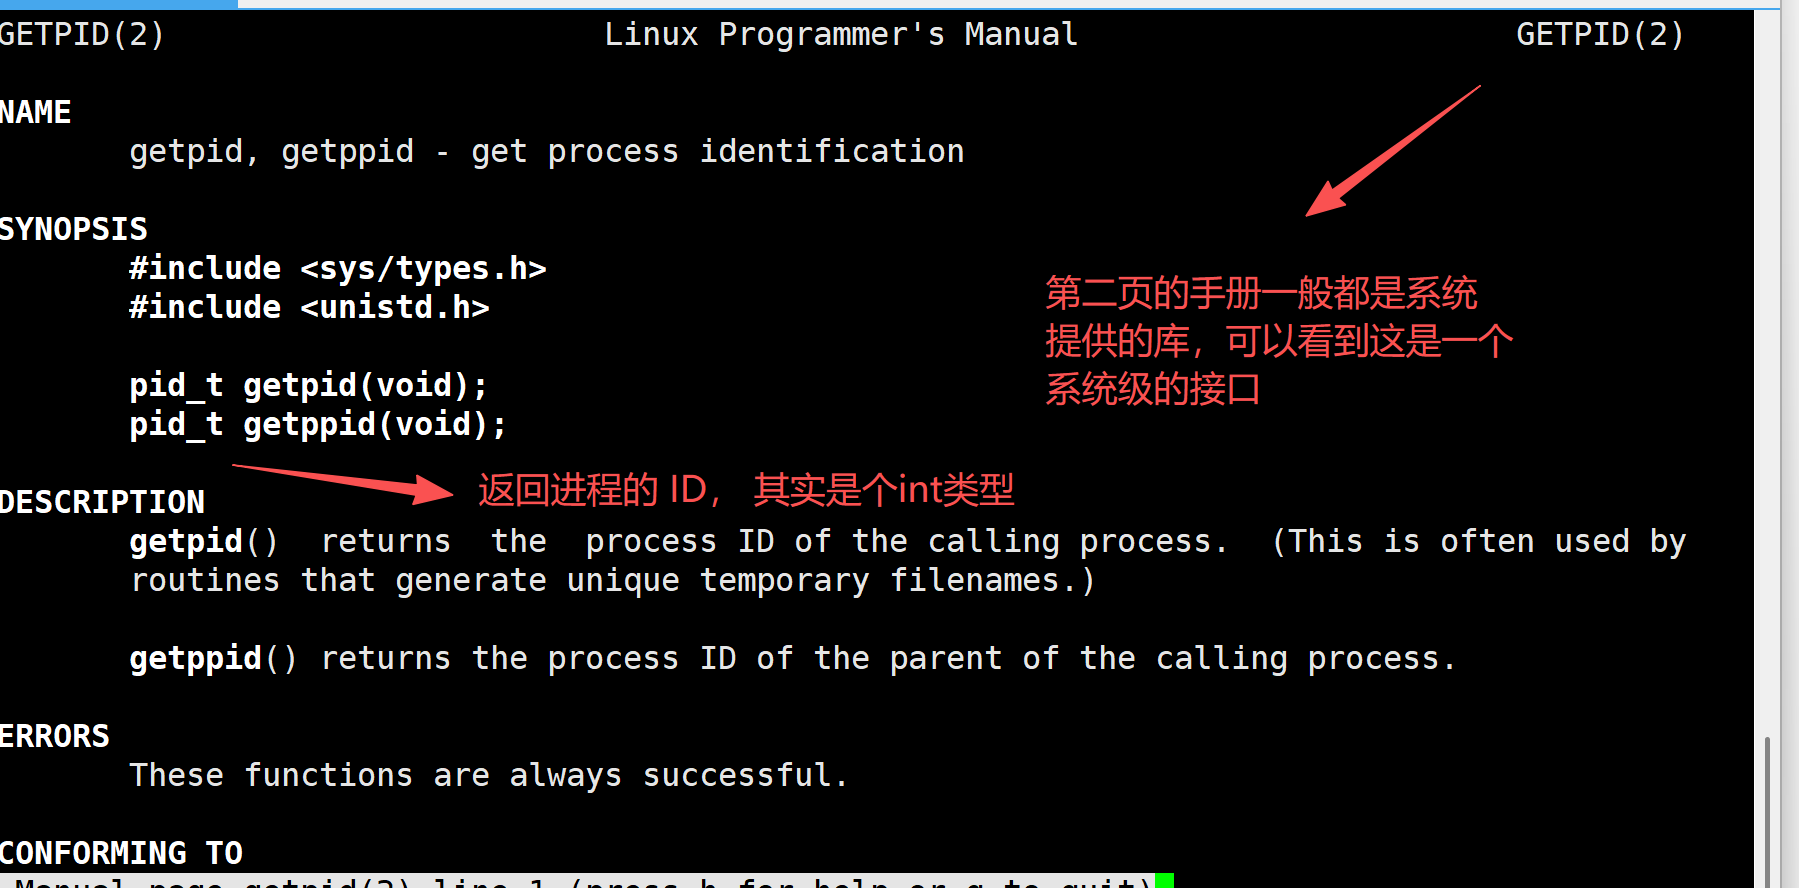
手册标题中的GETPID(2)表示它位于手册的第2节,这一节主要介绍系统调用接口返回类型是pid_t,用来表示进程标识符。
在程序外部,可以使用ps查看进程。例如:
ps axj
它会列出当前可见的进程信息,并使用包含父子关系等字段的输出格式。
如果想找到运行中的Myprocess,可以结合grep过滤:
ps axj | grep Myprocess
这里的Myprocess是要查找的程序名称
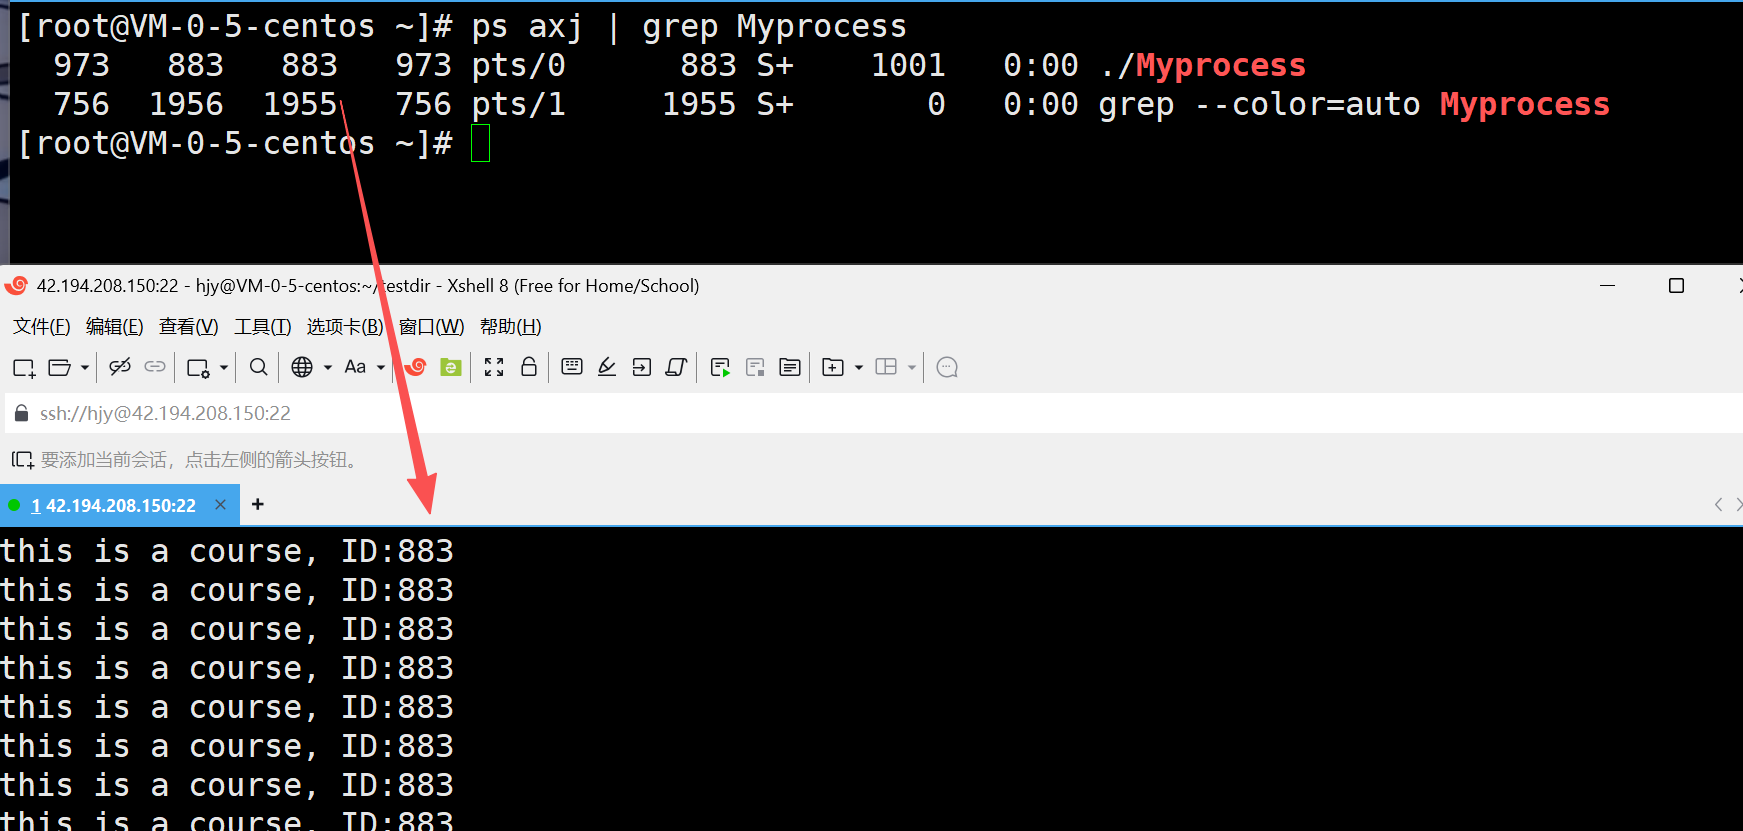
图中程序自己打印的编号是883,ps axj对应行的PID也是883,前面的973才是它的PPID。这样就把程序内部看到的编号和系统工具中的记录对应起来了。
还出现了一行grep,因为查询命令本身也在执行,它的命令行里同样包含Myprocess。如果想把这条查询记录过滤掉,可以使用:
ps axj | grep Myprocess | grep -v grep
再来看多次运行同一个程序的现象:
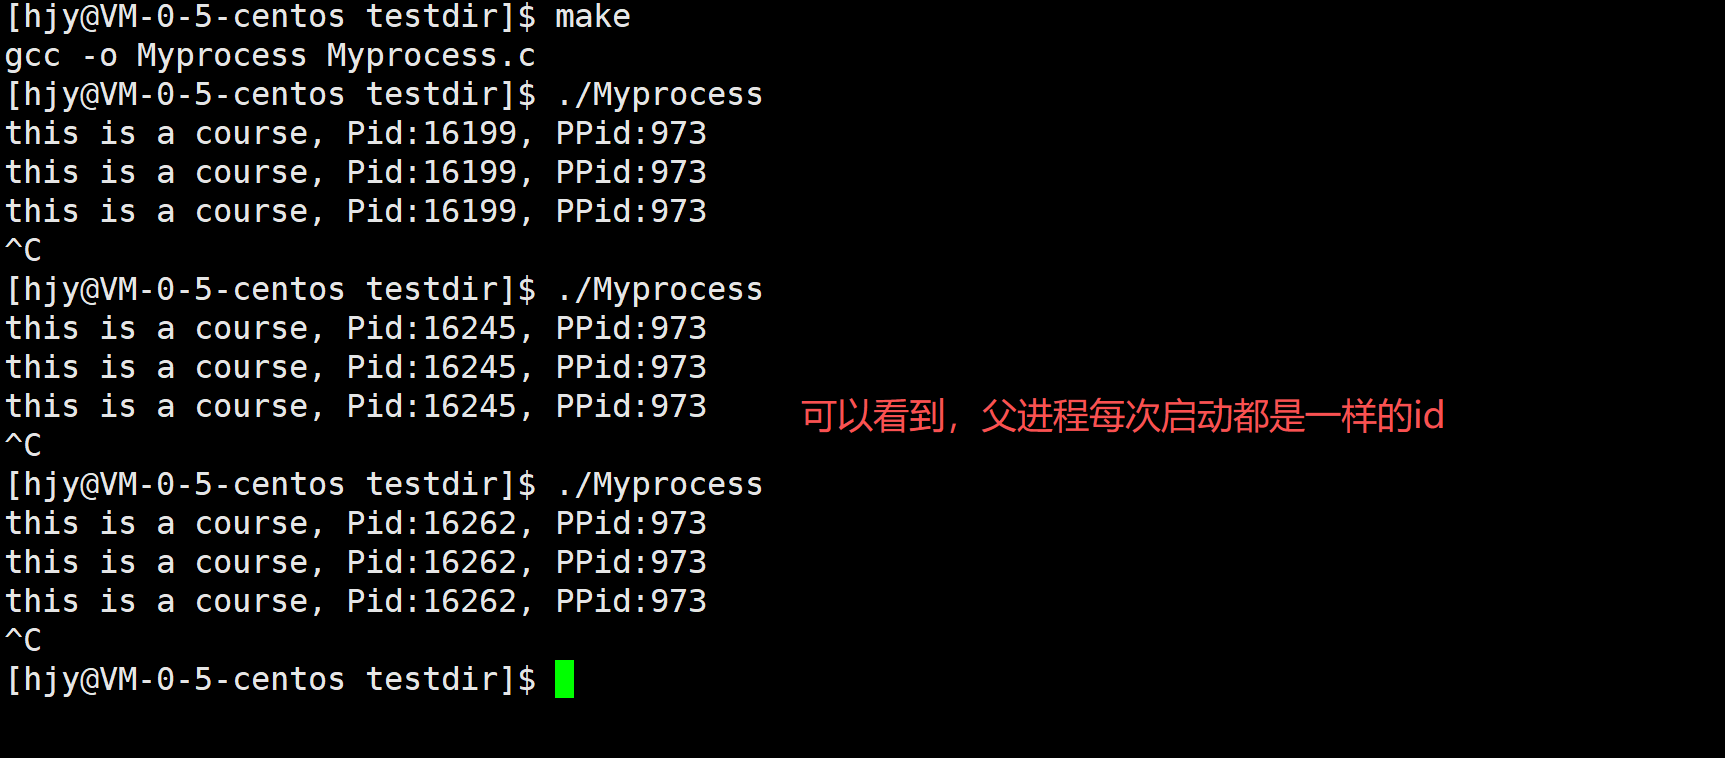
这几次运行中的PID分别是16199、16245和16262,但PPID都是973。说明每次启动形成了新的执行实例,而这几次程序由同一个父进程启动。
PID不是可执行文件的固定编号,以后也可能被系统重新使用,所以不能靠某个历史PID永久认定一个进程哦。
那973是谁呢?继续根据这个编号查看:
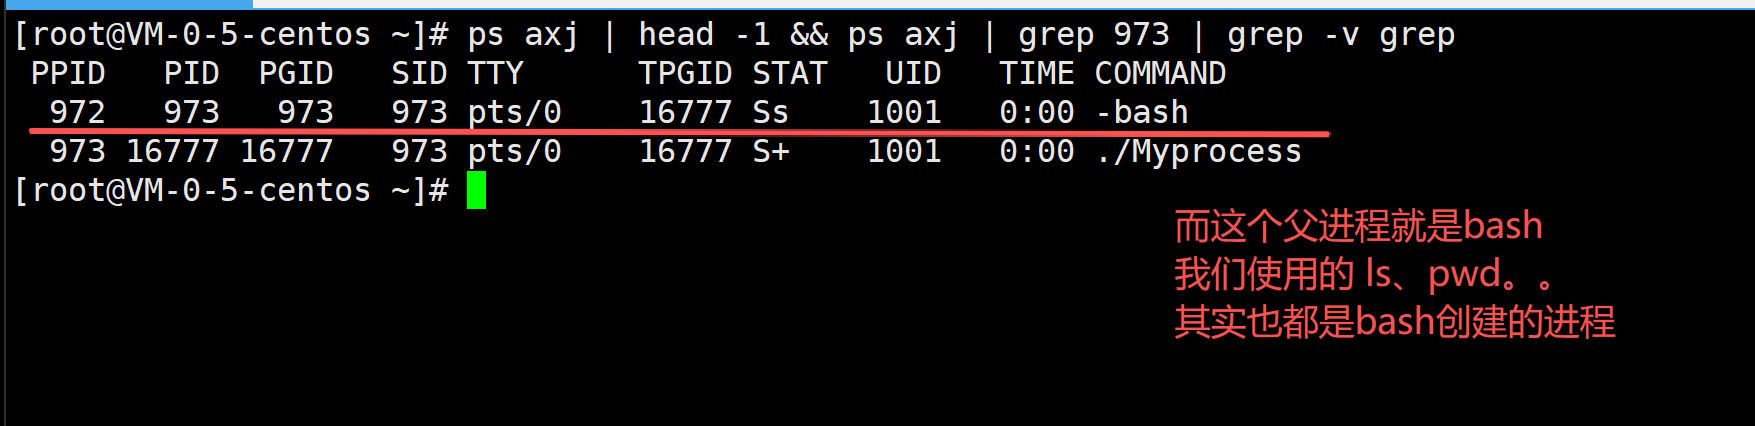
这里可以看到973对应bash。Shell本身也是一个程序,运行起来以后同样是进程。我们在这个Shell中启动外部程序,通常就会产生相应的子进程。
所以这几次PPID相同,是因为启动它们的同一个Shell仍然在运行,不是说所有程序的父进程编号永远不变。
3.3通过proc查看进程信息
除了ps、top,Linux还会通过/proc提供系统和进程信息。
/proc是一个伪文件系统,它提供的是查看内核运行信息的接口,并不是把这些内容当作普通文件长期保存在磁盘上。里面以数字命名的进程目录,对应相应的PID。
例如,假设刚查到的进程PID为883,可以查看:
ls /proc
ls -l /proc/883
实际操作时,要把883换成当前存在的进程PID。不同时间、不同机器上的编号不需要和这里一样。
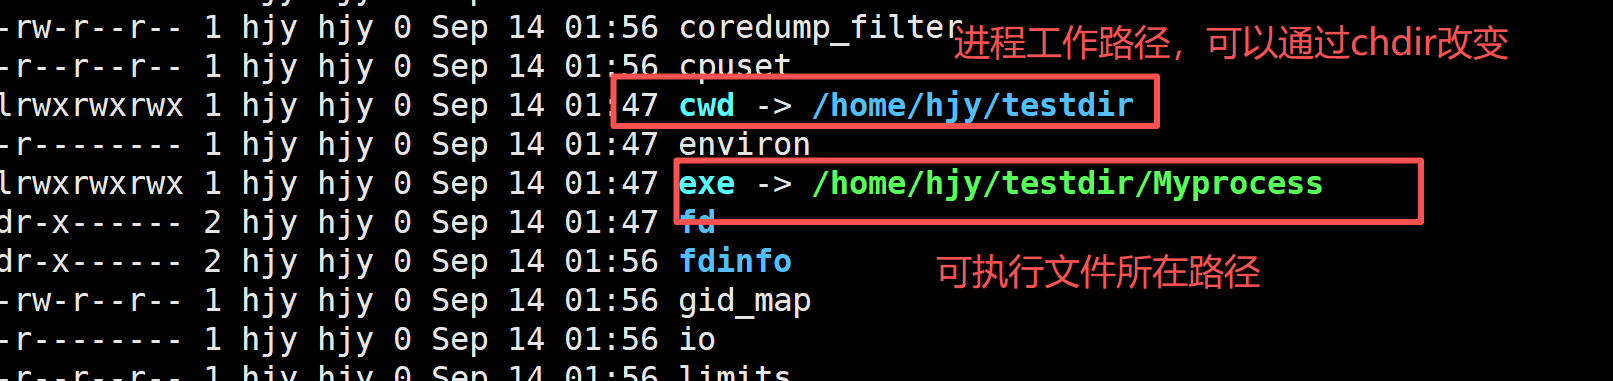
这里先认识两个比较实用的内容:
cwd:指向这个进程当前的工作目录。exe:指向这个进程正在执行的程序文件路径。
进程使用普通相对路径访问文件时,通常会以当前工作目录为起点,并不一定以可执行文件所在的目录为起点。因此“程序文件放在哪里”和“程序运行时在哪个目录下工作”,还是要分开理解。相关含义可查看Linux的proc文件系统文档。
如果前台的小程序一直运行,可以使用Ctrl+C中断它;还可以通过kill PID向指定进程发送结束请求,这里的PID需要换成实际编号。仅对已经确认属于自己、可以结束的进程操作。
kill -9 PID用于强制终止,不给程序执行正常清理逻辑的机会,不必把它当成默认选择。这里先认识这个用途,不展开信号机制。具体区别可以看kill手册。
4.通过fork创建子进程
4.1 父子进程返回值
前面是通过Shell启动程序,接下来看看程序内部怎样创建新的进程。
fork()会基于调用它的进程创建一个子进程。原来的调用者称为父进程,新创建的称为子进程。可以通过下面的命令查看它的说明:
man 2 fork
fork最特别的地方是:成功时,在父进程和子进程中分别返回一次,而且两个返回值的含义不同。
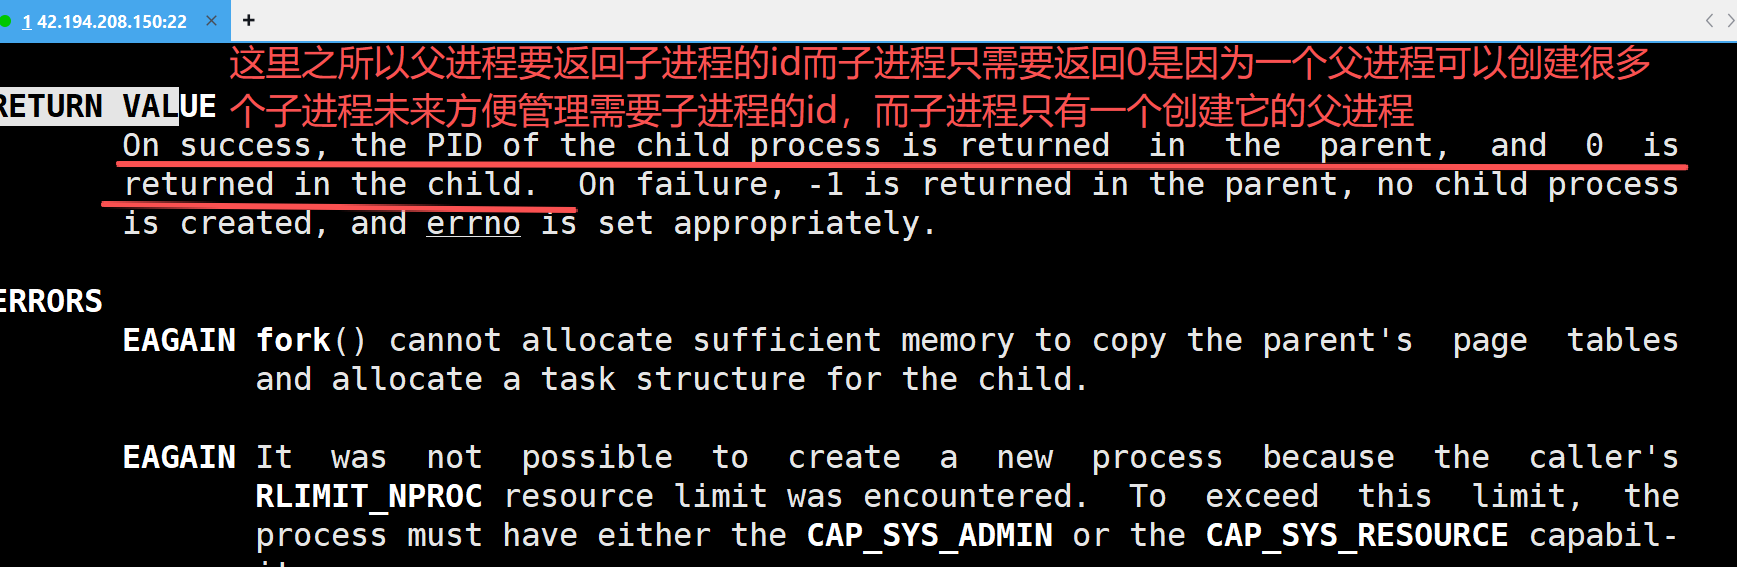
| 执行位置或结果 | fork的返回值 |
|---|---|
| 创建失败 | 在父进程中返回-1,没有子进程被创建 |
| 创建成功,父进程中 | 返回新创建子进程的PID |
| 创建成功,子进程中 | 返回0 |
下面的两段程序是两个独立示例,各自有一个main,应分别保留一个入口进行编译运行。
先看打印父子进程编号的例子:
#include <stdio.h>
#include <unistd.h>
#include <sys/types.h> // 使用getpid要包含这个头文件
#include <stdlib.h>

int main()
{
    printf("父进程运行Pid: %d\n", getpid());
    pid_t id = fork();
    if (id < 0)
    {
        perror("fork fail");
        exit(-1);
    }
    else if (id == 0)
    {
        sleep(1);
        printf("子进程Pid: %d, PPid: %d\n", getpid(), getppid());
    }
    else
    {
        sleep(1);
        printf("父进程Pid: %d, 创建的子进程Pid: %d\n", getpid(), id);
    }


    return 0;
}
在Linux中,单独保留这一段时,可以这样编译、运行:
gcc test.c -o Myprocess
./Myprocess
一次运行的结果如下:
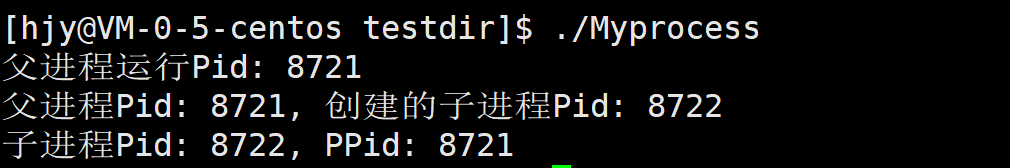
图中原来的进程PID为8721,fork创建了PID为8722的子进程。
对父进程来说,fork返回8722,所以进入最后的else;对子进程来说,fork返回0,所以进入else if (id == 0)。两个进程就可以根据不同的返回值执行不同的代码。
为什么父进程要拿到子进程的PID,而子进程只得到0呢?因为父进程可能创建多个子进程,需要知道这一次创建的是哪一个;子进程通过0已经能识别自己,还可以使用getpid()和getppid()取得相应编号。
还有个问题,就是为什么一个函数可以返回两次?
在调用fork之前,只有原来的进程在执行。创建成功以后,内核已经建立了子进程的管理结构和相应运行环境,接下来就有父、子两个执行实例继续执行。不是一个进程连续收到两次返回值,而是两个进程各收到一次。
子进程从fork返回的位置继续往后运行,不是重新回到main开头把所有语句再执行一遍。所以这里在fork前打印原进程编号的那条语句,不会因为创建了子进程而被子进程重新执行。
同样,后面的if和else也不是在一次判断中同时成立。父进程根据自己得到的id判断,子进程根据自己得到的id判断,执行的是两个进程各自的判断过程。接口行为可以对照fork手册。
先输出父进程信息,再输出子进程信息,这只是其中一次运行的顺序,不能据此认定父进程总是先执行。
4.2父子进程的数据为什么互不影响
fork以后,父子进程从同一份程序继续运行,那变量是不是也共用同一份呢?
再来看下面的例子。它沿用上一段的四个头文件,其余部分作为另一个独立程序:
int gval = 1;

int main()
{
    pid_t id = fork();
    if (id < 0)
    {
        perror("fork fail");
        exit(-1);
    }
    else if (id == 0)
    {
        int cnt = 3;
        while (cnt--)
        {
            gval++;
            printf("子进程执行三次修改每次加1, gval = %d\n", gval);
        }
    }
    else
    {
        int cnt = 3;
        while (cnt--)
        {
            printf("父进程保存原来的值, gval = %d\n", gval);
        }
    }

    return 0;
}
全局变量gval初始值为1。子进程进入自己的分支,每次循环把它加1,执行三次;父进程则只打印它,不进行修改。
对应的一次运行结果如下:
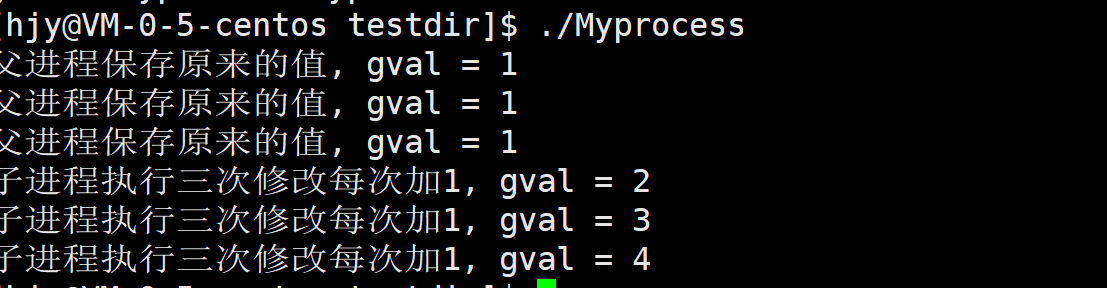
子进程依次输出2、3、4,而父进程三次输出的都是1。也就是说,子进程修改了自己的普通变量,并没有把父进程中的这份变量一起改掉。
这里的“全局”,指的是在各自程序运行环境中的作用范围,不是说它变成了系统中所有进程共用的一份数据。
父子进程有各自的地址空间。刚创建子进程时,普通数据的初始内容与父进程对应内容相同,但后续对这些私有数据的修改互不影响。这就是这个例子体现出来的进程独立性。
Linux的fork使用写时拷贝,也叫Copy-On-Write。创建子进程时,不必立刻把父进程的所有物理内存完整复制一遍;对于能够暂时共享的页面,可以先共享,当一方需要写入相应私有数据时,再进行必要的复制,使修改不会影响另一方。
所以,“逻辑上各自有一份数据”和“创建时立即完整复制所有物理内存”不是同一件事哦。
完

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 1
 0
- 0


 已为社区贡献2条内容

所有评论(0)