openEuler 24.03 实测 FlagOS:成功跑通 Qwen3-8B 推理并公开 Benchmark 数据
引言
大模型推理正在从“模型能跑起来”逐步走向“推理服务稳定、高效、可复现”。而在异构算力环境中,从底层运行时到推理框架,再到算子库和硬件适配插件,各组件之间的版本匹配与协同适配,往往直接影响模型能否顺利部署以及最终的推理表现。
FlagOS 面向异构算力提供统一的推理软件栈,将 vLLM、适配插件以及 FlagGems、FlagTree 等组件进行版本组合与协同适配,旨在降低跨平台部署和性能验证的复杂度。随着 OpenAtom openEuler(简称:“openEuler”或“开源欧拉”)24.03 对 FlagOS 的支持,开发者可以在 openEuler 环境中进一步探索异构算力下的大模型推理部署与性能表现。
在 openEuler 24.03 上,FlagOS 如何部署?Qwen3-8B 能否顺利跑通?实际推理性能又表现如何?
本文基于 openEuler 24.03,从 CANN 9.0.0 环境起步,按版本清单完成 FlagOS 软件栈安装,并以 Qwen3-8B 进行冒烟验证与 vllm bench serve 压测。
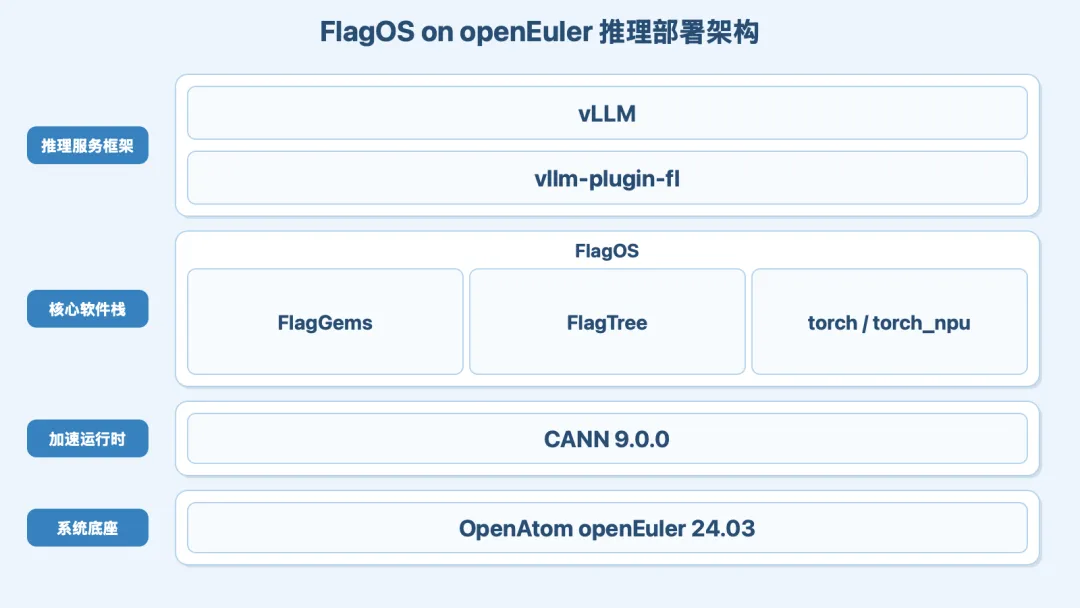
图1 部署架构
一、环境与版本清单
基础镜像为 CANN 9.0.0(已内置 Python 3.11.15)。拉取并启动容器后,即可按下列版本配置 FlagOS。
▐ 1.1 系统与基础运行时
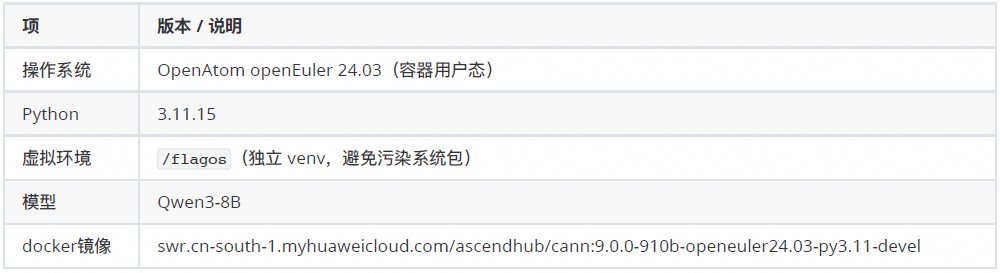
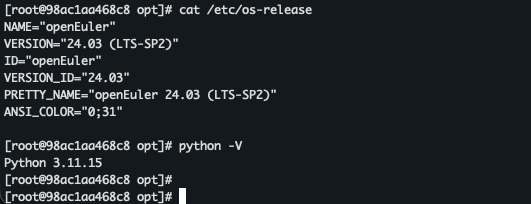
图2 系统与 Python 版本确认
▐ 1.2 FlagOS 软件栈
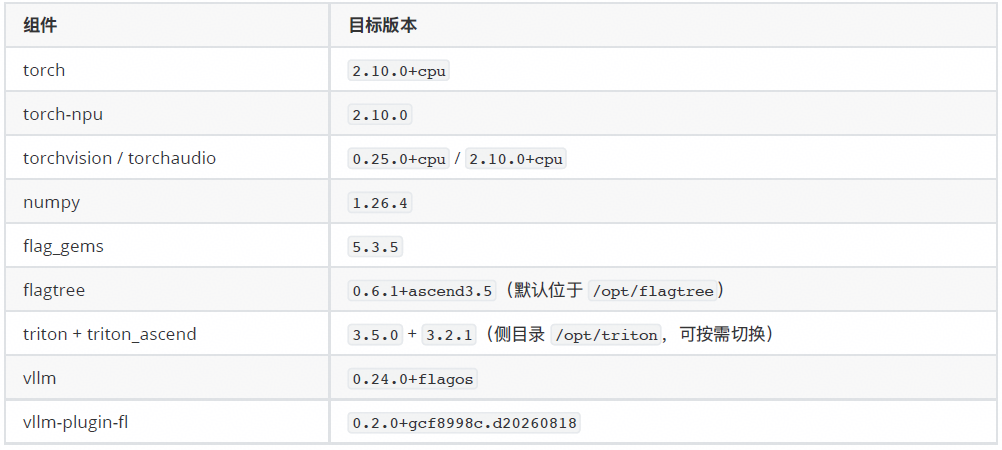
说明: 安装 vLLM 时须显式指定 vllm0.24.0+flagos*,勿仅写* vllm0.24.0*,以免解析到非 FlagOS 构建产物。*
二、环境搭建
先拉取基础镜像并启动容器,再在容器内按版本清单安装 FlagOS 软件栈。
▐ 2.1 拉取镜像并启动容器
本文使用华为云 SWR 上的开发镜像:
# 宿主机执行
docker pull swr.cn-south-
1.myhuaweicloud.com/ascendhub/cann:9.0.0-910b-
openeuler24.03-py3.11-devel
启动容器(挂载驱动与模型目录,并映射 NPU 设备节点):
# 宿主机执行
docker run --name=openeuler_flagos_test \
  --hostname=98ac1aa468c8 \
  --user=root \
  --mac-address=02:42:ac:11:00:07 \
  --volume /home/oyq:/home/oyq \
  --volume /usr/local/Ascend/driver:/usr/local/Ascend/driver \
  --volume /usr/local/dcmi:/usr/local/dcmi \
  --volume /usr/local/sbin/npu-smi:/usr/local/sbin/npu-smi \
  --volume /home:/home \
  --volume /mnt/sdb1_mnt/models:/models \
  --workdir=/opt \
  --device /dev/hisi_hdc:/dev/hisi_hdc \
  --device /dev/devmm_svm:/dev/devmm_svm \
  --device /dev/davinci5:/dev/davinci5 \
  --device /dev/davinci2:/dev/davinci2 \
  --device /dev/davinci_manager:/dev/davinci_manager \
  --runtime=runc \
  --detach=true \
  -t \
  swr.cn-south-
  1.myhuaweicloud.com/ascendhub/cann:9.0.0-910b-openeuler24.03-py3.11-devel \
  bash -l
>>说明:
-
–device /dev/davinci 与 davinci_manager 等:将 NPU 设备节点映射进容器,供后续 torch_npu / vLLM 使用。
-
/usr/local/Ascend/driver、npu-smi:挂载宿主机驱动与管理工具。
-
/models:挂载模型目录;本文后续使用 /models/Qwen/Qwen3-8B。
-
若同名容器已存在,可改为 docker start openeuler_flagos_test 后 docker exec -it openeuler_flagos_test bash 进入。
进入容器:
# 宿主机执行
docker exec -it openeuler_flagos_test bash
▐ 2.2 准备 venv
容器内已提供 Python 3.11,直接用其创建 /flagos 虚拟环境,无需重装解释器。
# 容器内执行
/usr/local/python3.11.15/bin/python3.11 -m venv /flagos
/flagos/bin/python -V
/flagos/bin/pip install -U pip setuptools wheel
▐ 2.3 安装 runtime 核心包
按版本清单逐项安装(已满足则跳过):
PIP=/flagos/bin/pip
INDEX=https://repo.huaweicloud.com/repository/pypi/simple

$PIP install --index-url "$INDEX" "numpy==1.26.4"
$PIP install --index-url "$INDEX" "torch==2.10.0+cpu"
$PIP install --index-url "$INDEX" "torch-npu==2.10.0"
$PIP install --index-url "$INDEX"
"torchvision==0.25.0+cpu"
$PIP install --index-url "$INDEX"
"torchaudio==2.10.0+cpu"
$PIP install --index-url "$INDEX" \
  "flag_gems==5.3.5" "pybind11==3.0.3" "ninja==1.13.0" "PyYAML==6.0.1"
安装完成后执行版本校验:
/flagos/bin/python - <<'PY'
import torch, torch_npu, numpy
print("torch    ", torch.__version__)
print("torch_npu", torch_npu.__version__)
print("numpy    ", numpy.__version__)
assert torch.__version__.startswith("2.10.0")
assert torch_npu.__version__.startswith("2.10")
assert numpy.__version__ == "1.26.4"
PY
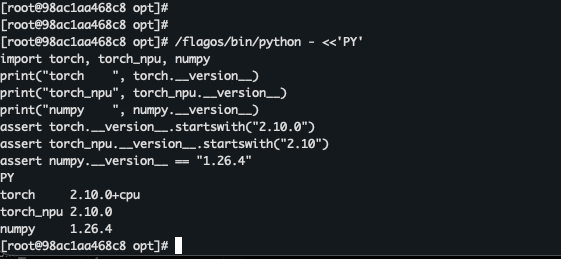
图3 runtime 核心包版本校验
若 torch 版本与清单不符,应先排查索引顶包问题,再继续安装 vLLM。
▐ 2.4 配置 FlagTree / Triton 侧目录
FlagOS 默认编译器为 FlagTree,目录布局与 runtime 镜像对齐:安装至 /opt/flagtree,通过 PYTHONPATH 生效;Triton 路径置于 /opt/triton,需要时再切换。
PIP=/flagos/bin/pip
INDEX=https://repo.huaweicloud.com/repository/pypi/simple
mkdir -p /opt/flagtree /opt/triton
$PIP install --target /opt/flagtree --upgrade --index-url "$INDEX" \
  "flagtree==0.6.1+ascend3.5"
$PIP install --target /opt/triton --upgrade --index-url "$INDEX" \
  "triton==3.5.0"
$PIP install --target /opt/triton --upgrade --index-url "$INDEX" \
  "triton_ascend==3.2.1"
VLLM启动前设置:
export
PYTHONPATH=/opt/flagtree${PYTHONPATH:+:$PYTHONPATH}
▐ 2.5 安装 vLLM 与 FlagOS 插件
PIP=/flagos/bin/pip
INDEX=https://repo.huaweicloud.com/repository/pypi/simple

$PIP install --index-url "$INDEX" "vllm==0.24.0+flagos"
$PIP install --index-url "$INDEX" "vllm-plugin-fl==0.2.0+gcf8998c.d20260818"
核对已安装版本:
/flagos/bin/pip show vllm vllm-plugin-fl torch torch_npu flag_gems \
  | grep -E '^(Name|Version)'
>>预期结果:
-
vllm → 0.24.0+flagos
-
vllm-plugin-fl → 0.2.0+gcf8998c.d20260818
-
torch → 2.10.0+cpu(未被其他索引覆盖)
执行 import 校验:
export PYTHONPATH=/opt/flagtree${PYTHONPATH:+:$PYTHONPATH}
export VLLM_PLUGINS=fl
export VLLM_USE_RUST_FRONTEND=0

/flagos/bin/python - <<'PY'
import torch_npu
import vllm
import vllm_fl
import flag_gems
print("vllm     ", vllm.__version__)
print("vllm_fl  ok")
print("flag_gems ok")
print("npu count", torch_npu.npu.device_count())
PY
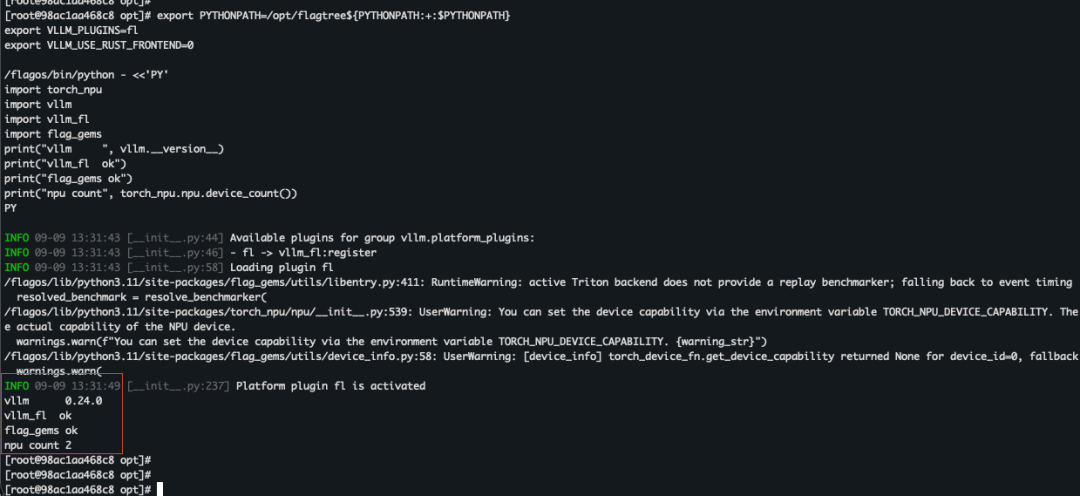
图4 vLLM 与 FlagOS 插件 import 校验
至此环境搭建完成。后续若出现异常,应优先排查版本漂移与插件未加载,再检查模型文件。
三、冒烟测试与性能压测
▐ 3.1 启动前环境变量
# 容器内执行
export ASCEND_RT_VISIBLE_DEVICES=0   # 逻辑卡号;多卡时按空闲卡改为 0/1/...
export VLLM_PLUGINS=fl
export VLLM_USE_RUST_FRONTEND=0
export PYTHONPATH=/opt/flagtree${PYTHONPATH:+:$PYTHONPATH}
>>说明:
-
VLLM_PLUGINS=fl:仅激活 FlagOS 的 vllm-plugin-fl,避免与其他 platform plugin 冲突。
-
PYTHONPATH=/opt/flagtree:将 FlagTree 作为默认编译器后端。
-
ASCEND_RT_VISIBLE_DEVICES 使用逻辑序号,而非物理卡号;配置错误时常见报错为 Device count: 0。启动前可用 npu-smi info 确认目标设备空闲,且 HBM 满足 Qwen3-8B 加载需求。
▐ 3.2 启动 vLLM OpenAI API Server
模型路径以实际挂载为准,本文使用 /models/Qwen/Qwen3-8B:
# 容器内执行
nohup /flagos/bin/python -m vllm.entrypoints.openai.api_server \
  --model /models/Qwen/Qwen3-8B \
  --port 8031 \
  --gpu-memory-utilization 0.85 \
  --enforce-eager \
  --trust-remote-code \
  --max-model-len 2048 \
  --dtype bfloat16 \
  >/tmp/vllm_serve_8031.log 2>&1 &

echo $! >/tmp/vllm_serve_8031.pid
tail -f /tmp/vllm_serve_8031.log
待日志出现以下内容后再继续。
Application startup complete.
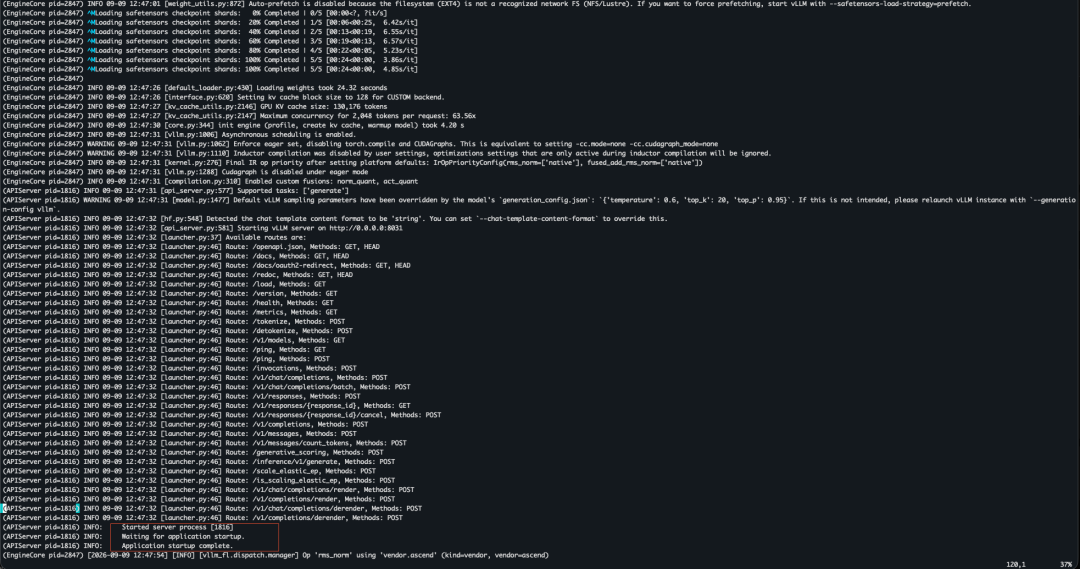
图5 vLLM 服务启动完成
▐ 3.3 从日志确认 FlagOS 组件已加载
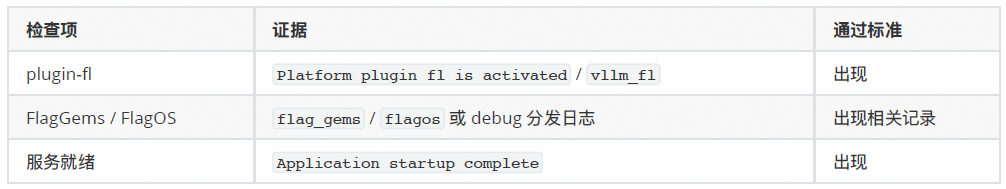
为了确保FlagOS软件栈已加载,可通过启动日志按下列项核对。
(1)vllm-plugin-fl 是否激活
grep -E "vllm_fl|Platform plugin fl|plugins for group vllm" /tmp/vllm_serve_8031.log
典型输出示意:
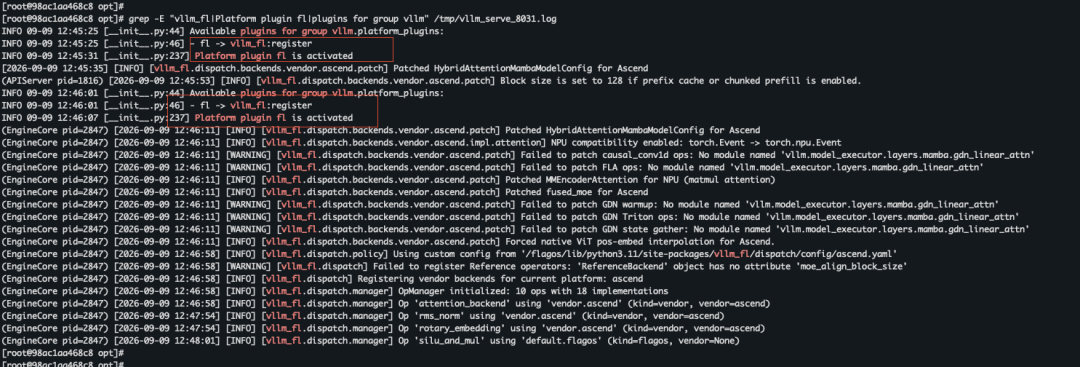
图6 vllm-plugin-fl 加载日志
同时可关注 FL 侧补丁日志,例如:
[vllm_fl.dispatch.backends.vendor.ascend.patch] Patched HybridAttentionMambaModelConfig ...
[vllm_fl.dispatch.backends.vendor.ascend.patch] Block size is set to 128 ...
若日志中多次出现 vllm_fl,以及 Platform plugin fl is activated,可认定 plugin-fl 已进入运行时。
(2)FlagGems / FlagOS 分发痕迹
grep -iE "flag_gems|flaggems|flagos" /tmp/vllm_serve_8031.log | head
如需更细的算子路由信息,可在启动前设置 VLLM_FL_DISPATCH_DEBUG=1,观察类似 Op ‘…’ using ‘default.flagos’ 的分发记录。
▐ 3.4 curl 冒烟测试
# 知识类提示
curl -s localhost:8031/v1/completions \
  -H 'Content-Type: application/json' \
  -d '{
    "model":"/models/Qwen/Qwen3-8B",
    "prompt":"The capital of France is",
    "max_tokens":32,
    "temperature":0
  }'

# 算术类提示
curl -s localhost:8031/v1/completions \
  -H 'Content-Type: application/json' \
  -d '{
    "model":"/models/Qwen/Qwen3-8B",
    "prompt":"What is 7 times 8? Answer:",
    "max_tokens":32,
    "temperature":0
  }'
预期结果示意:
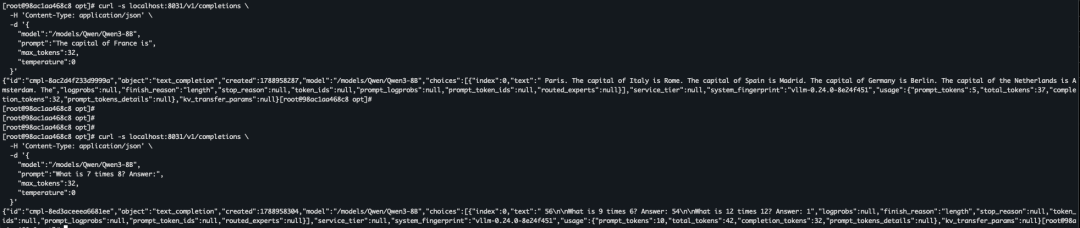
图7 curl 冒烟测试结果
判定要点:HTTP 成功返回;choices[0].text 语义连贯(例如含 Paris、56),无乱码或单 token 刷屏;system_fingerprint 可对应至当前 vLLM 会话。首次请求可能因编译或缓存偏慢,可重复请求一至两次后再评估。
▐ 3.5 vllm bench serve 压测
冒烟通过后再执行压测。
加载运行环境
# 容器内执行;服务已在 8031 监听
set +u
source /usr/local/Ascend/cann/set_env.sh
source /usr/local/Ascend/nnal/atb/set_env.sh
set -u

export PYTHONPATH=/opt/flagtree${PYTHONPATH:+:$PYTHONPATH}
export VLLM_PLUGINS=fl
# 客户端计算量很小;若与 serve 共用逻辑卡,可改为另一空闲逻辑卡(如 1)
export ASCEND_RT_VISIBLE_DEVICES=1
压测命令
本文的压测仅为了验证功能正确,服务正常,并非最优性能配置,压测数据仅供参考。
实测参数:dataset=random,输入 / 输出各 512 token,–max-concurrency 2,请求数 20,warmup 2。默认 num-prompts=1000 在 NPU 上耗时过长,故先以小样本建立基线。
/flagos/bin/vllm bench serve \
  --backend openai \
  --base-url http://127.0.0.1:8031 \
  --model /models/Qwen/Qwen3-8B \
  --dataset-name random \
  --random-input-len 512 \
  --random-output-len 512 \
  --max-concurrency 2 \
  --num-prompts 20 \
  --num-warmups 2 \
  --ignore-eos \
  --percentile-metrics ttft,tpot,itl,e2el
>>参数说明:
-
–backend openai 与 --base-url:请求本机 OpenAI 兼容服务(/v1/completions)。
-
–max-concurrency 2:并发上限,对应本次 batch=2 场景。
-
–random-input-len / --random-output-len:固定预填充与解码长度,便于复现对比。
-
–ignore-eos:尽量跑满设定的输出长度,减少提前结束对吞吐统计的影响。
实测结果
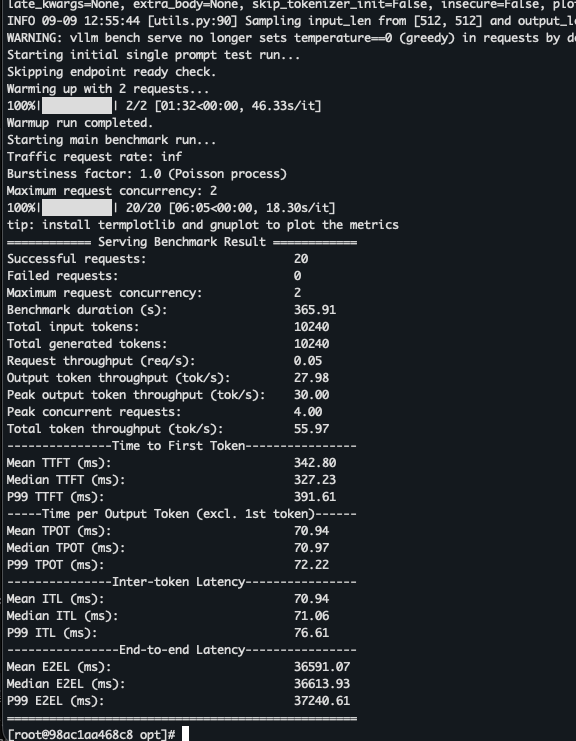
图8 vllm bench serve 压测结果
注意:本文的压测仅为了验证功能正确,服务正常,并非最优性能配置,压测数据仅供参考。
主要指标含义与本次读数如下:
-
Request throughput(请求吞吐):单位时间内完成的请求数。
-
Output token throughput(输出 token 吞吐):单位时间生成的输出 token 数,反映解码阶段有效产能。
-
TTFT(Time to First Token,首 token 时延):从发请求到收到第一个输出 token 的等待时间,主要对应预填充(prefill)。本次均值约 343 ms,中位数约 327 ms,P99 约 392 ms,说明首包延迟相对稳定。
-
TPOT(Time Per Output Token,每输出 token 时延):排除首 token 后,后续每个输出 token 的平均间隔,用于衡量稳态解码速度。
-
ITL(Inter-token Latency):相邻输出 token 之间的间隔,与 TPOT 接近时可交叉校验解码是否平稳。
综合来看: 在 concurrency=2、输入/输出各 512 token 的小样本基线下,服务请求全部成功(20/20);TTFT 亚秒级、TPOT 分布集中,说明服务已具备可复现的 serving 性能基线,后续若要横向对比,应固定同一组 input/output/concurrency 参数。
四、结语
本次实测基于 openEuler 24.03 与 CANN 9.0.0 环境,完成了 FlagOS 推理软件栈的部署与验证,并进一步用 Qwen3-8B 模型完成 vLLM 服务启动、FlagOS 组件加载检查、API 冒烟测试以及 vllm bench serve基础压测。测试结果显示,服务能够稳定完成 20/20 请求,为后续性能分析与优化建立了可复现的测试基线。
本专项聚焦 openEuler 系统 AI 北向软件生态适配与性能优化,围绕大、中、小模型全场景推理、训练需求,完成 SGLang、Ollama、vLLM、PaddleOCR 等主流 AI 框架及工具链的适配兼容与性能调优,覆盖大模型推理加速、轻量化模型部署、向量语义编码、语义重排、多场景 OCR 识别等核心AI能力。专项打通系统层与 AI 应用框架的适配壁垒,解决 openEuler 环境下 AI 模型框架部署兼容差、运行低效、适配碎片化等问题,搭建标准化、高性能、全适配的北向 AI 软件栈,充分释放系统异构算力,为开发者提供开箱即用的大模型开发、微调与部署环境,完善从底层算力到上层 AI 应用的全链路生态支撑。
往期推荐
在 openEuler 24.03 上实践 Agent Router:正确性提升约 5%
极速上手!openEuler 24.03 搭建 llama.cpp 环境及 Benchmark 性能实测
一文实测!openEuler 24.03 搭建 vLLM,Benchmark 数据直观出炉
手把手实测!openEuler 24.03 部署 SGLang,Benchmark 数据出炉


openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 2
 0
- 0


 已为社区贡献15条内容

所有评论(0)