账本相同,堆内存差了5倍:为什么排查NATS内存泄漏不能只看/jsz?
在分布式消息与流式系统的运维体系中,我们往往极度依赖系统自带的监控端点。在 NATS JetStream 集群中,这个端点通常是 /jsz(JetStream 核心监控接口)。绝大多数线上故障,从消费积压、Stream 存储满载到 Raft Leader 选举抖动,只要调一下 /jsz,答案便一目了然。
但你是否遇到过这样一种令人极度抓狂的生产诡局:
- 物理内存天壤之别:同处一个集群的两台承载节点,
nats2的物理内存(RSS)一路狂飙至 7.4 GB,而旁边的基准对照节点nats3却只有 1.5 GB,两者相差整整 4.9 倍(存在近 5.9 GB 的幽灵内存差距); - 业务账本毫厘不差:当你打开
/jsz逐项比对两台机器的 Stream、Consumer、消息总量与磁盘占用时,发现两者的消息总数仅差 0.3%,存储字节数仅差 2%(都在 29 GB 上下),甚至连消费位点ack_floor都严丝合缝; - 伴随性能尖刺:与此同时,基准节点
nats3甚至还伴随着 183% 的异常 CPU 尖刺,整条排障链路扑朔迷离。
团队围绕着 /jsz 的返回数据苦苦搜寻了几个小时,拉取了无数次监控快照,却发现各项指标健康得无可挑剔。
为什么业务账本完全一致,物理内存却能差出近 6 个 G?
深入排查到底层,我们才撞上一堵工程认知的隐形高墙:/jsz 与底层运行时根本就不在同一个抽象维度。 当账本相同而堆内存大相径庭时,差异按定义就不在账本里。继续在 /jsz 里找答案,无异于在路灯下找丢失在黑暗密林里的钥匙。
一、 维度之争:应用层账本 vs Go Runtime 物理堆
要理解为什么 /jsz 会在这次排障中彻底失灵,必须先剖析 NATS 内部两套截然不同的状态抽象:
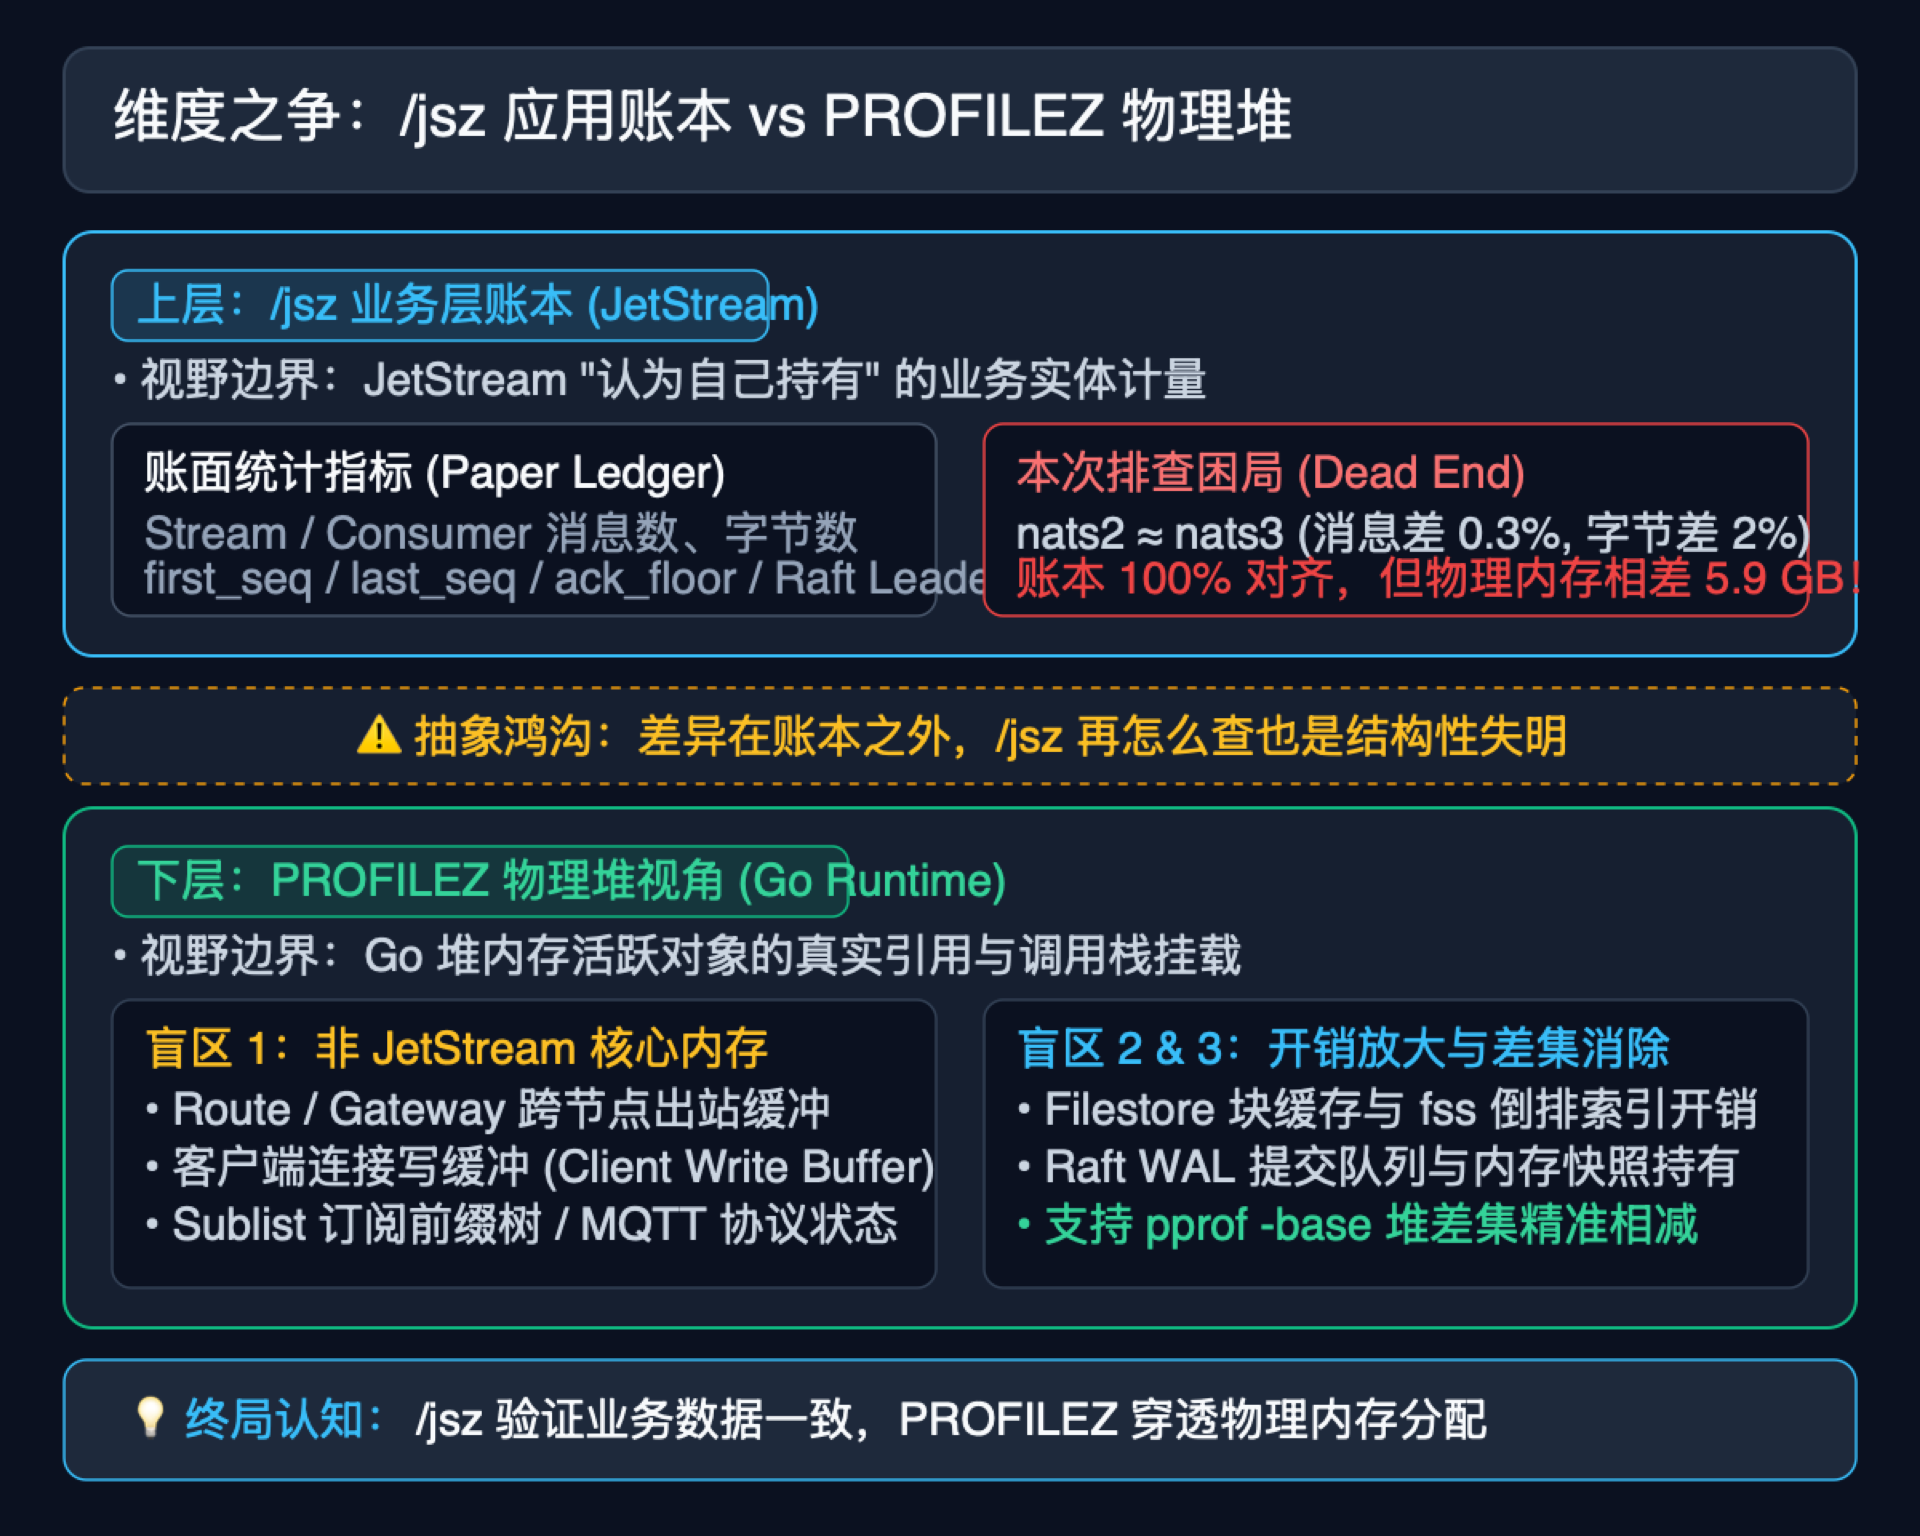
1. /jsz:JetStream 的“应用层账本”
/jsz 暴露的是 JetStream 引擎认为自己持有的业务实体与逻辑资产:
- 每一个 Stream 内究竟存了多少条消息、占用了多少磁盘字节;
- 每一个 Consumer 的未确认条数、
first_seq、last_seq与ack_floor位点; - 当前 Stream 的 Raft Group 状态与 Leader 节点是谁;
- JetStream API 的调用频次与配额开销。
这也就好比银行的客户财务总账:它详尽记录了张三有 100 块存款、李四有 200 块存款。只要业务存取逻辑不出错,账本上的数字永远是对齐且平衡的。
2. PROFILEZ:Go Runtime 的“物理堆剖面”
而 NATS 系统主题 $SYS.REQ.SERVER.*.PROFILEZ,调用的则是 Go 语言底层的 runtime/pprof 机制:
- 它直接穿透业务抽象,对操作系统进程空间内的虚拟内存与堆对象进行采样;
- 它记录的是哪一段代码的调用栈(Call Stack),正在真实引用着多少活跃字节(inuse_space / inuse_objects);
- 它回答的是物理世界的冷酷现实:“这个 Go 进程的堆空间,到底被谁死死钉住无法被 GC 回收?”
这就好比银行金库的物理建筑与安防损耗:金库地基是否沉降、保险柜齿轮是否卡死、运钞车通道是否堆满了杂物。这些物理实体的消耗,无论如何翻阅客户财务账本,也是一个字都查不到的。
这正是这次排障卡住的核心根源:/jsz 已经证明了 nats2 ≈ nats3,两者业务负载对齐;但内存差了 4.9 倍。账本相同、堆不同 —— 差异从定义上就游离在账本之外,/jsz 再怎么查也查不出来。
二、 结构性失明:/jsz 永远看不到的三大盲区
很多工程师会好奇:既然 /jsz 统计了 JetStream 的全部数据,那丢失的 5.9 GB 内存到底藏在哪里?为什么 /jsz 会产生结构性失明?
深入 NATS 架构细节,你会发现 /jsz 存在三处无法逾越的天生盲区:
盲区 1:非 JetStream 的核心通信与网络内存
JetStream 只是挂载在 NATS 核心引擎(Core NATS)上的一个子系统。在整个 NATS 进程的内存版图中,有大量极其吃内存的组件完全不归 JetStream 管辖,因此在 /jsz 里一个字节都不会出现:
- Route / Gateway 跨节点出站缓冲(Outbound Buffers):NATS 集群节点之间通过 Route 网状互联。当集群跨节点广播消息、或发生网络抖动与路由拥塞时,待发送的数据会大量堆积在 Route 的出站写缓冲区中;
- 客户端连接写缓冲(Client Write Buffers):如果有慢消费者(Slow Consumer)未能及时接收消息,NATS 会在连接层做写缓冲,缓冲达到上限前会吃掉巨量内存;
- Sublist 订阅前缀树(Subscription Radix Trie):Core NATS 用于匹配高并发 Subject 的字典树。当通配符订阅(如
foo.*.bar.>)极度复杂、订阅关系高达数十万时,这颗常驻内存的树会膨胀得非常惊人; - MQTT / WebSocket 协议状态机:多协议网关持有的连接会话与解码缓存。
如果那 5.9 GB 膨胀在集群 Route 链路或订阅树中,/jsz 对此是天生全盲的。
盲区 2:账面存量与物理驻留比的“放大黑盒”
/jsz 骄傲地汇报:nats2 在磁盘上存储了 29.3 GB 的消息数据。
但这只是静止躺在磁盘上的数据体量。为了让这 29.3 GB 数据能够被高性能检索与投递,Filestore 存储引擎在 Go 堆内存中维持了多少开销?
- Message Block Cache:被热点读取的消息块缓存;
- Per-block Subject State (
fss):Filestore 为每个消息块构建的 Subject 倒排索引与位点映射; - Raft WAL 缓冲:在内存中等待写入与提交的日志条目。
账本只报物理消息体的纯字节数,它无法告诉你为此在内存里驻留了多少倍率的索引和缓存,更无法解释为什么同样的存储体量,在 nats2 上产生了巨大的驻留放大。 这个比值,正是节点间唯一说不通的死结。
盲区 3:无法进行高维差异消除(Differential Profiling)
在 /jsz 层面,我们能做的最大努力就是把 nats2 和 nats3 的指标拉出来做减法。但两张表一减,差异率只有 0.3%,线索瞬间中断。
而 PROFILEZ 的杀伤力在于:通过 $SYS.REQ.SERVER.PING.PROFILEZ,可以一次性向全集群广播,每个节点独立返回当前运行时的二进制 pprof 数据。拿到之后,我们能直接在 Go 运行时层面执行堆剖面差集相减(Differential Profiling):
两台机器的业务账本 99.7% 一致,意味着业务代码引用的基准堆对象几乎完全重合。一旦执行
pprof -base相减,这 99.7% 的共同噪音将被瞬间清零,那 5.9 GB 独占的调用栈将立刻浮出水面!
这种降维打击的排障手段,是只看应用指标的 /jsz 永远无法企及的。
三、 PROFILEZ 兵器库:调用栈画像与差集消除实战
那么,$SYS.REQ.SERVER.*.PROFILEZ 里面到底封装了什么宝藏?
当客户端向该主题发送请求时,请求体通常指定剖面类型与参数(如 {"name":"heap","debug":0},对于 CPU 采样可传入 duration)。服务端返回的是经 Base64 编码的标准 Go pprof 二进制数据包。
它的兵器库与本案的排障价值直接对应:
| 剖面名称 (Name) | 采集内容与物理含义 | 对本案排障的决定性作用 |
|---|---|---|
heap | 按完整调用栈统计的 inuse_space / inuse_objects(以及累计 alloc) | 核心王牌:直接指认 5.9 GB 挂在谁身上 —— 是 filestore 的 msg block cache、每 block 的 fss 状态、raft WAL 缓冲,还是 route 出站缓冲? |
allocs | 进程启动以来的累计内存分配(包含已释放对象) | 区分“一直在高频分配但能正常 GC 回收” vs “被全局引用长期钉死” |
goroutine | 当前系统内每一个活跃 Goroutine 的完整调用栈 | 排查协程泄露:离散事件诱发的协程悬挂,会连带钉死其调用栈引用的全部大对象上下文 |
mutex / block | 锁争用(Lock Contention)与阻塞等待耗时堆栈 | 直击基准节点 nats3 那 183% 异常 CPU 背后是否存在高频锁争用 |
profile (CPU) | 指定时长(如 10s)的 CPU 指令周期时间采样 | 直接定位 nats3 的 CPU 算力到底烧在了哪一个具体函数上 |
threadcreate | 操作系统原生系统线程(M)的创建堆栈 | 诊断 cgo 调用或运行时系统级阻塞(一般作为兜底参考) |
差集消除实战:用 pprof -base 直击真相
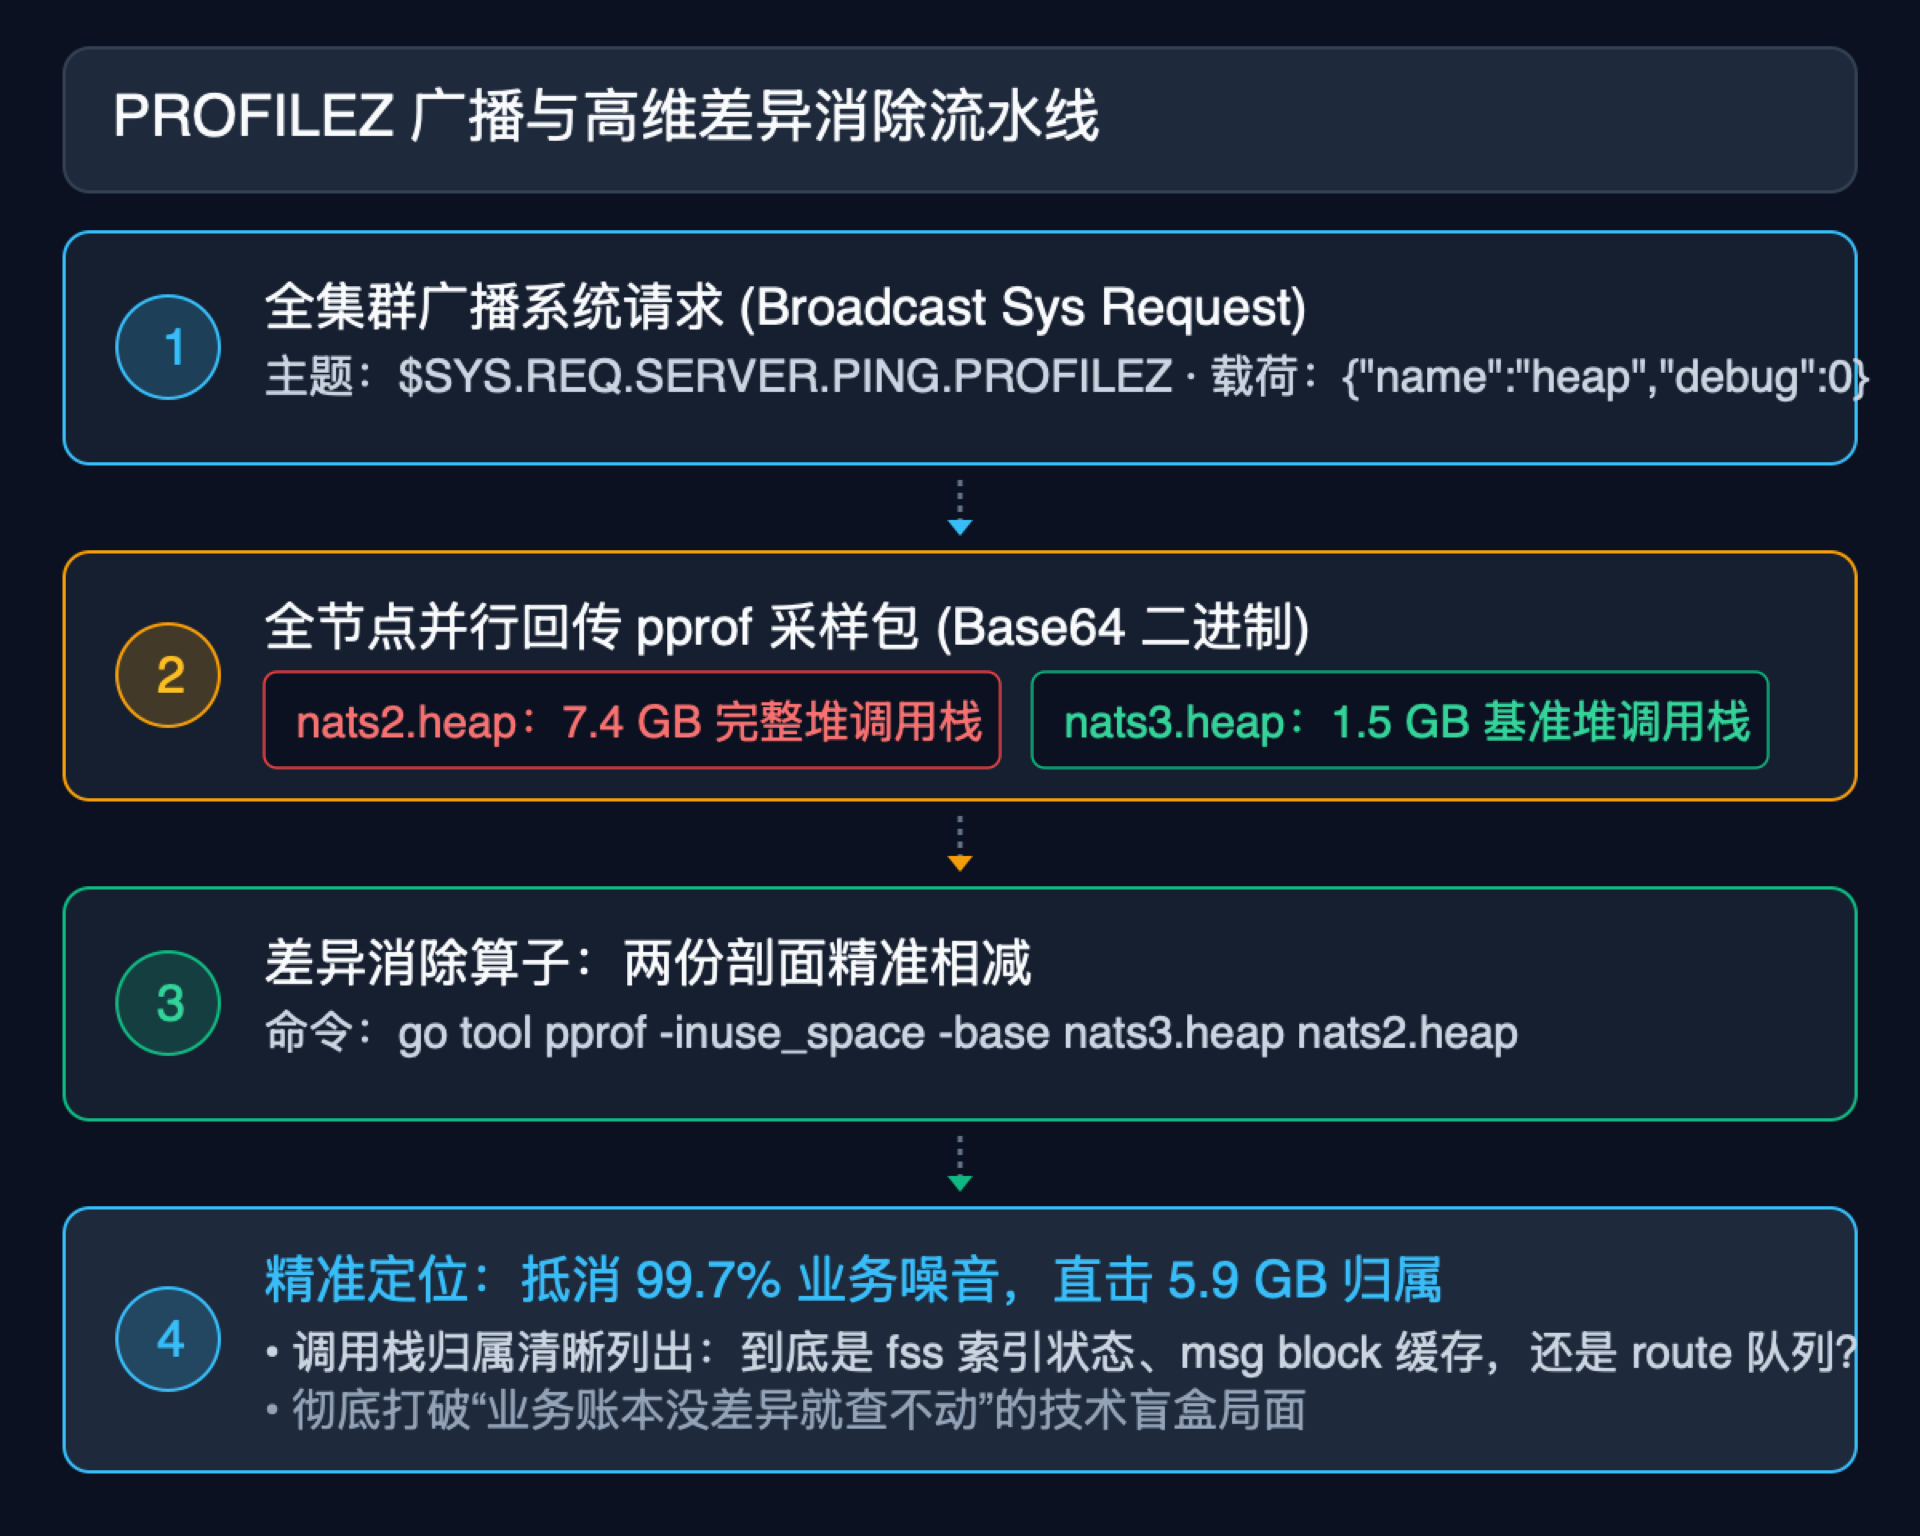
一旦拿到 nats2.heap 和 nats3.heap 两个二进制文件,定位就变成了极其优雅的确定性数学题:
# 1. 以正常的 nats3 为基准底模,对异常的 nats2 执行差集相减
go tool pprof -inuse_space -base nats3.heap nats2.heap

# 2. 在交互终端中直接查看增量 Top 10
(pprof) top10
Showing nodes accounting for 5.82GB, 98.6% of 5.9GB total
      flat  flat%   sum%        cum   cum%
    3.40GB 57.6%  57.6%     3.40GB 57.6%  nats-server/server.(*fileStore).writeMsgRecord
    1.80GB 30.5%  88.1%     1.80GB 30.5%  nats-server/server.(*client).writeLoop
    ...
通过这一流水线,数 GB 级别的幽灵内存将无所遁形,精准暴露在具体的代码包与函数行上。
四、 致命死局:当生产集群的 SYS 账户“被蒸发”
然而,正当我们满怀信心准备拔出 PROFILEZ 这把屠龙宝刀时,现场却遭遇了极其戏剧性的技术死局(Catch-22)。
在生产集群向 $SYS.REQ.SERVER.PING.PROFILEZ 发送请求时,系统返回了一片令人绝望的死寂:毫无响应,超时断开。
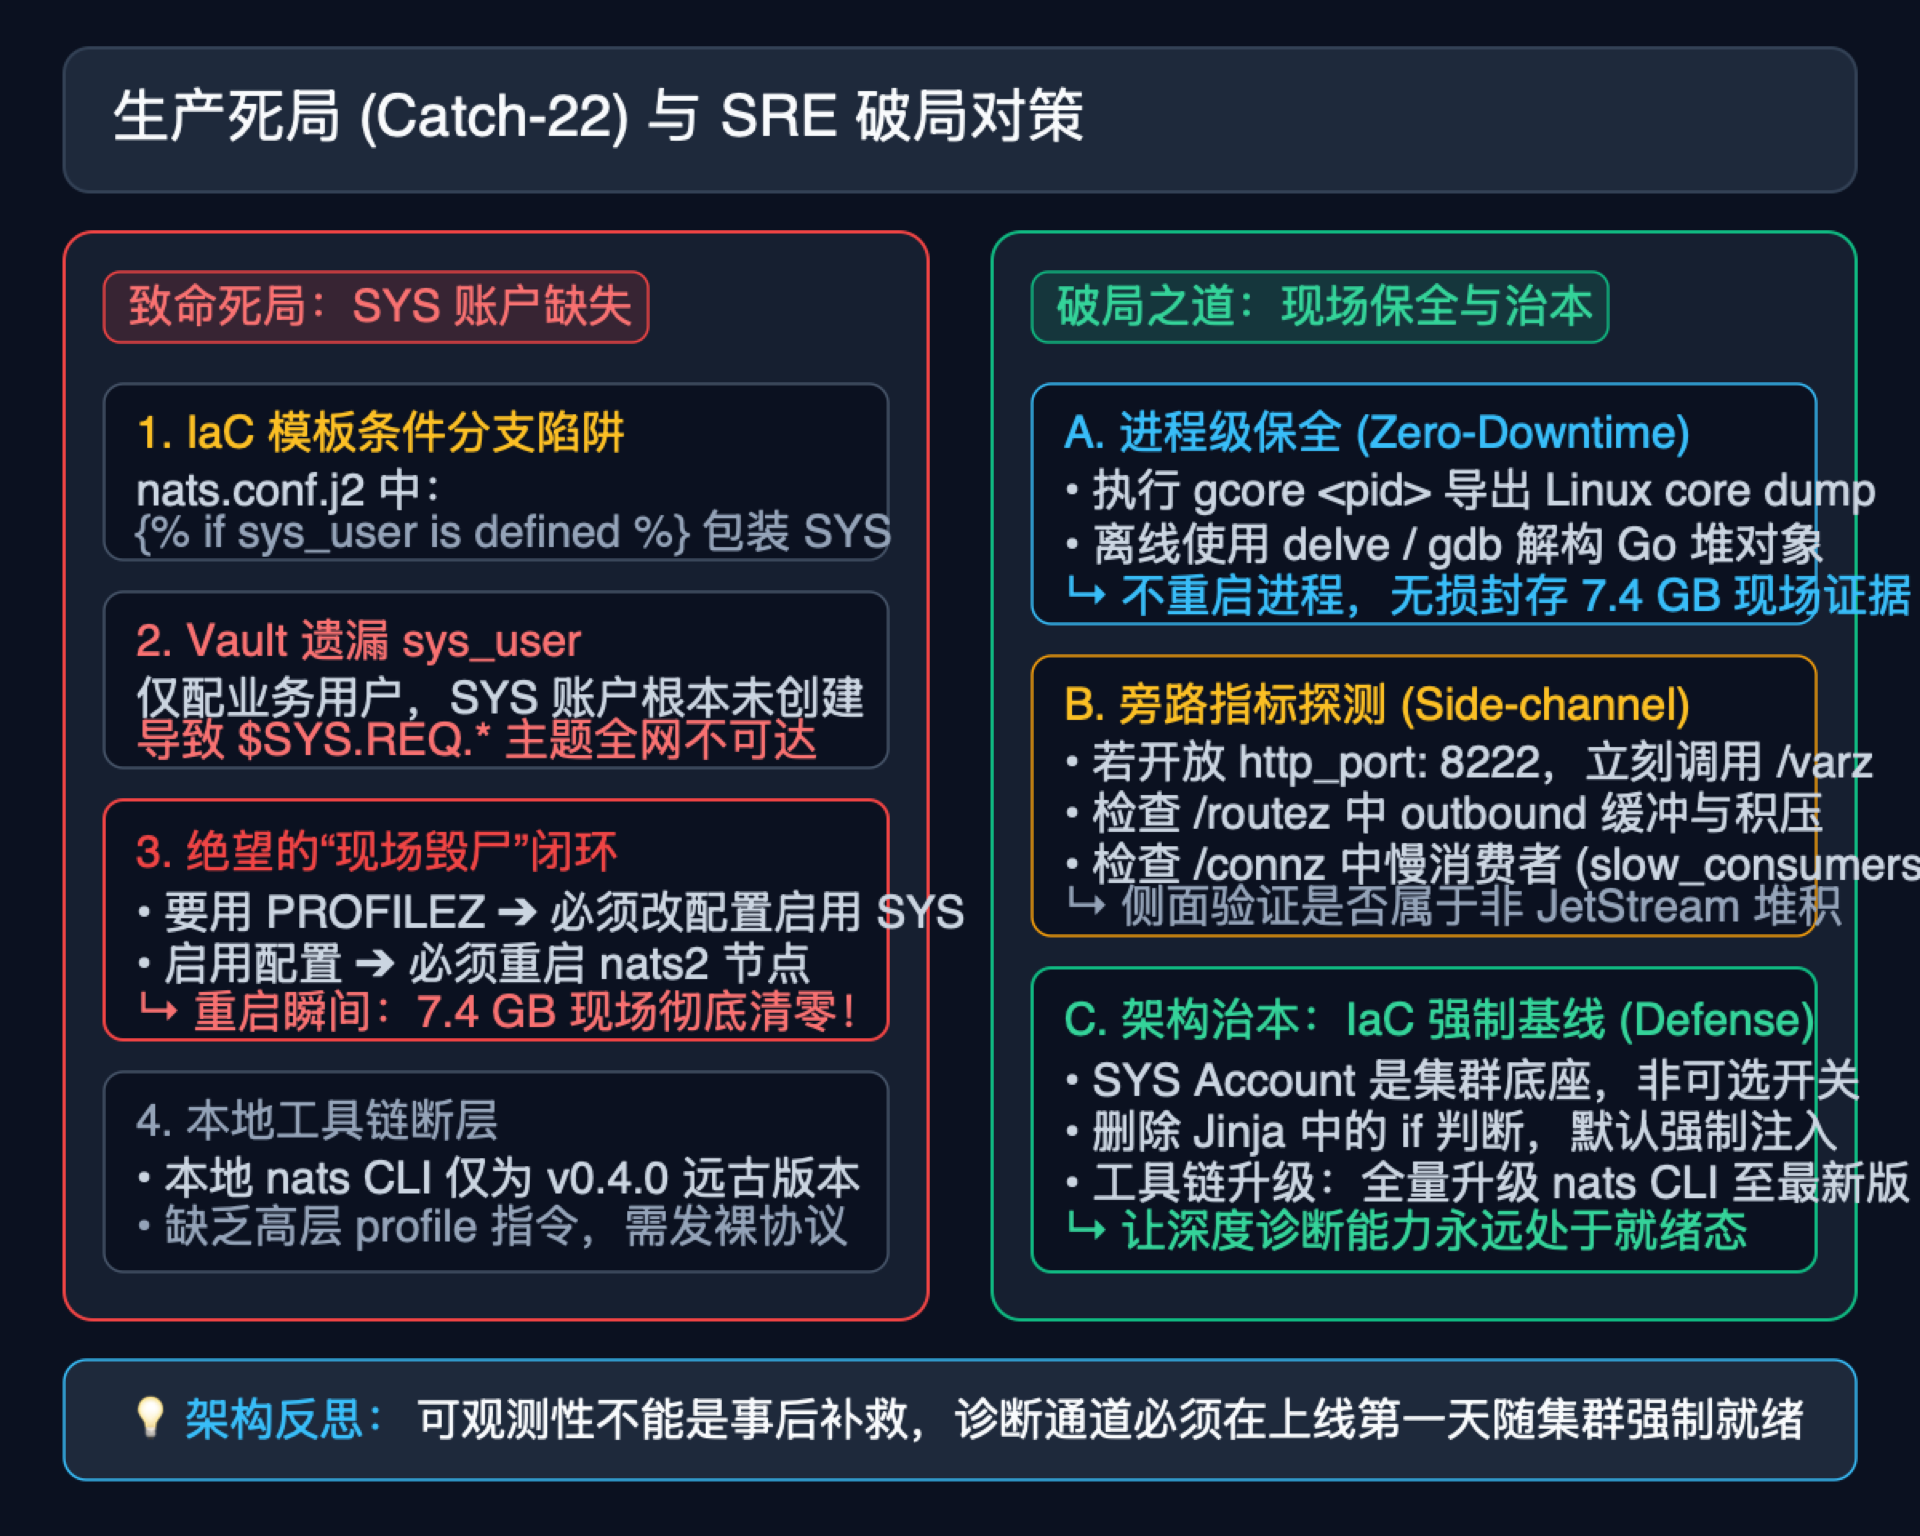
1. IaC 配置模板的“条件分支隐患”
经过紧急追溯 Ansible 部署脚本与 HashiCorp Vault 密钥库,我们还原了背后的真相:
在 Ansible 渲染模板 nats.conf.j2 中,系统账户的配置被写成了一个条件分支:
{% if sys_user is defined %}
system_account: SYS
accounts {
  SYS {
    users = [ { user: "{{ sys_user }}", password: "{{ sys_password }}" } ]
  }
}
{% endif %}
而在生产环境的 Vault 密钥配置文件 nats.yml 中,清晰地配置了业务微服务所需的各类账号:
xxx_password: ******xxx_password: ******agency_affiliate_password: ******
唯独没有 sys_user!
这意味着:生产环境在部署时,因为没有定义该变量,整个 Jinja 模板直接跳过了系统账户的渲染。生产环境根本就没有初始化 $SYS 账户!
这根本不是普通的“权限不足(Permission Denied)”,而是生产节点内部压根没有开启系统管理总线。任何发往 $SYS.REQ.* 的诊断请求,在路由层由于找不到目标账户,被底层静默丢弃。
2. 无法解开的“现场毁尸”悖论
此时,SRE 团队被推进了一个两难的铁壁绝境:
- 要想拿到 PROFILEZ:就必须在配置文件中补齐
sys_user并让 NATS 重新加载; - 要想让配置生效:在绝大多数不可动态重载系统账户的场景下,必须重启 NATS 进程;
- 可一旦重启 nats2 节点:进程内存空间被内核全部收回,现场那宝贵的 7.4 GB 内存泄漏痕迹将在一瞬间被彻底清零、毁尸灭迹!
事故现场一旦重启恢复,下一次内存再次缓慢爬升到 7.4 GB 可能需要数周时间。在没有拿到堆剖面的情况下重启,意味着团队将再次沦为盲人摸象。
此外,现场运维机上的客户端环境也雪上加霜:本地安装的 nats CLI 依然停留在 v0.4.0 的远古版本,甚至连 nats server request profile 这类高层命令都不支持,真到发起裸请求时还必须手动构建 JSON 载荷与监听临时收件箱(Inbox)。
五、 绝境自救与防患未然:SRE 的工程救赎
面对这种“既不能重启、又无法远程 Profile”的死锁,我们该如何在保障线上可用性的同时突围?
1. 现场保留方案:零重启下的物理转储
当应用内通道($SYS)彻底断绝时,必须果断下沉到操作系统底层进行非破坏性现场保全:
-
方案 A:利用 Linux 核心转储(Core Dump)保全现场
在宿主机上,利用 Linux 原生工具直接触发进程转储:# 对 nats2 进程抓取瞬时内存镜像,不终止进程 gcore -o /data/nats2_leak.core <nats_pid>通过
gcore可以在毫秒级完成虚拟内存快照并写盘。随后将 core 文件拉取到线下测试机,利用delve(Delve 调试器)或gdb挂载 NATS 可执行文件与 core dump,即可离线重构 Go 堆内的对象拓扑,无损保全证据。 -
方案 B:旁路监控接口(Monitoring Port)交叉验证
检查 NATS 是否开启了 HTTP 监控端口(如http_port: 8222)。
虽然/jsz失明,但可以立刻调取核心引擎指标:- 检查
/varz中的in_msgs、out_msgs与节点整体内存统计; - 检查
/routez:重点观察集群间各 Route 的pending字节数与出站队列。如果某个 Route 的 pending 高达数 GB,即可直接确认为跨节点通信拥塞; - 检查
/connz:过滤是否存在slow_consumer: true的异常连接。
- 检查
2. 防患未然:架构维度的长治久安
这场由于“缺少 SYS 账户”引发的排障僵局,给所有云原生分布式系统的基础设施建设敲响了警钟:
-
防御性 IaC 设计:系统账户是基础设施基线,绝不能是可选开关
在 Ansible、Terraform 或 Helm 模板中,严禁将可观测性与管理通道包裹在可选的条件判断中(如{% if sys_user is defined %})。系统账户必须作为分布式中间件出厂默认的“强制基线”。哪怕外部密码未显式指定,也应通过基础设施凭据管理中心自动生成并注入,确保生产节点的深度诊断通道永远可用。 -
工具链与 CLI 的常态化演练
统一运维跳板机上的客户端版本。将nats server request profile、nats server ping等高层诊断指令纳入常态化巡检脚本,杜绝在突发事故中才发现本地 CLI 版本落后数年的被动局面。 -
监控分层告警:账面指标与运行时指标联动
告警规则切忌只看/jsz汇报的 Stream 消息堆积。必须将宿主机物理内存(RSS)、Go 堆内存(go_memstats_heap_inuse_bytes)与 JetStream 逻辑存储量建立剪刀差联动监控:当物理内存增长速率与逻辑存储量严重脱节时,第一时间触发“内存驻留异常”告警。
结语:从“看指标”到“看调用栈”的工程升维
在现代微服务与分布式系统的架构演进中,我们习惯了通过 Prometheus、Grafana 查看琳琅满目的统计图表,习惯了翻看 /jsz 这类应用层吐出的工整 JSON。
但请永远记住:业务账本记录的只是理想世界的逻辑投影,而操作系统进程才是承受物理资源损耗的真实载体。
当业务指标向你展示“天下太平”、而系统内存却在无声溃堤时,请果断放下手中的应用账本。跳过那些无休止的业务数据比对,穿透抽象边界,通过 PROFILEZ 与 pprof 去倾听运行时底层的真实调用栈呼声——因为那才是真相唯一藏身的地方。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 0
 0
- 0


 已为社区贡献3条内容

所有评论(0)