操作系统笔记-3.1.2.2 动态分区分配算法
·
王道操作系统笔记,视频链接:3.1.2.2 动态分区分配算法
知识总览
- 动态分区分配算法:在动态分区分配方式中,当很多个空闲分区都能满足需求时,应该选择哪个分区进行分配?
- 动态分区分配算法:
- 首次适应算法(First Fit)
- 最佳适应算法(Best Fit)
- 最坏适应算法(Worst Fit)
- 邻近适应算法(Next Fit)
首次适应算法
- 算法思想:每次都从低地址开始查找,找到第一个能满足大小的空闲分区。
- 如何实现:空闲分区以地址递增的次序排列。
- 每次分配内存时顺序查找空闲分区链(或空闲分区表),
- 找到大小能满足要求的第一个空闲分区。
- PS:两种常用的数据结构:
- 空闲分区表
- 空闲分区链
- 图示:
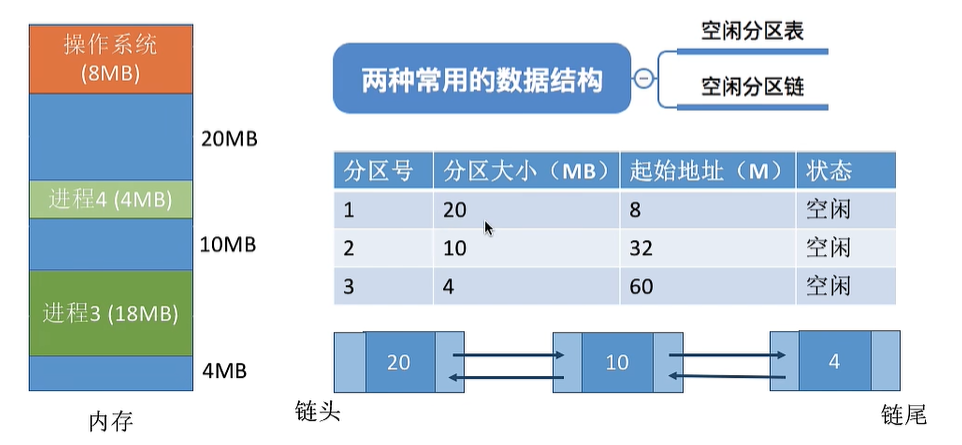
- 以空闲分区链为例:
- 假设现在有一个大小为15MB的进程,链表依次大小为20,10,4
- 结果发现第一个空闲分区就符合,所以修改第一个分区的大小、起始地址
- 链表变为5,10,4
- 此时来了第二个大小8MB的进程,从头开始检索,发现第二个空间分区够,
- 所以从第二个空闲分区给出8MB给进程,修改该分区大小、起始地址
- 链表变成了5,2,4
最佳适应算法
- 算法思想:
- 由于动态分区分配是一种连续分配方式,为各进程分配的空间必须是连续的一整片区域。
- 因此为了保证当“大进程”到来时能有连续的大片空间,
- 可以尽可能多地留下大片的空闲区,即,优先使用更小的空闲区。
- 如何实现:
- 空闲分区按容量递增次序链接。
- 每次分配内存时顺序查找空闲分区链(或空闲分区表),
- 找到大小能满足要求的第一个空闲分区。
- 如图:
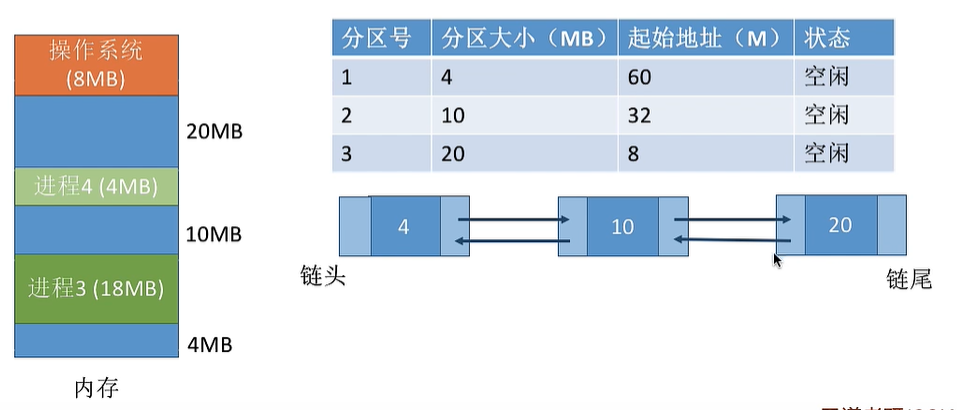
- 例子:
- 按照第2点的图作为例子,假设有一个9MB的进程进入,会被分配到10MB的空闲空间,
- 分配后,该空间只剩余1MB的分区大小,因为最佳适应算法要求从小到大排序,
- 所以排序后,空间大小应该依次为1、4、20
- 缺点:
- 每次都选最小的分区进行分配,
- 会留下越来越多的、很小的、难以利用的内存块。
- 因此这种方法会产生很多的外部碎片。
最坏适应算法
- 又称最大适应算法(Largest Fit),算法思想:
- 为了解决最佳适应算法的问题——即留下太多难以利用的小碎片,
- 可以在每次分配时优先使用最大的连续空闲区,
- 这样分配后剩余的空闲区就不会太小,更方便使用。
- 如何实现:
- 空闲分区按容量递减次序链接。
- 每次分配内存时顺序查找空闲分区链(或空闲分区表),
- 找到大小能满足要求的第一个空闲分区。
- 类似之前的例子,只是顺序变成了由大到小排序,这里就不多赘述
- 缺点:
- 每次都选最大的分区进行分配,虽然可以让分配后留下的空闲区更大,更可用,
- 但是这种方式会导致较大的连续空闲区被迅速用完。
- 如果之后有“大进程”到达,就没有内存分区可用了。
邻近适应算法
- 算法思想:
- 首次适应算法每次都从链头开始查找的。
- 这可能会导致低地址部分出现很多小的空闲分区,
- 而每次分配查找时,都要经过这些分区,因此也增加了查找的开销。
- 如果每次都从上次查找结束的位置开始检索,就能解决上述问题。
- 如何实现:
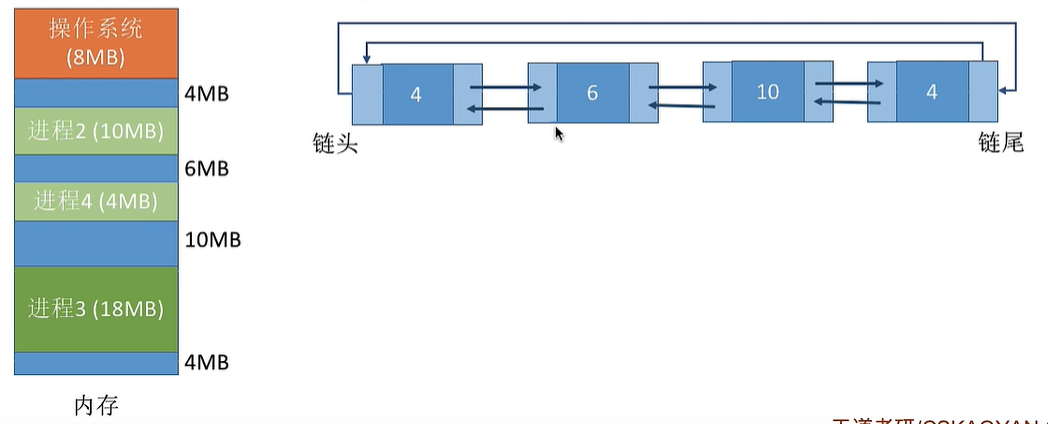
- 空闲分区以地址递增的顺序排列(可排成一个循环链表)。
- 每次分配内存时从上次查找结束的位置开始查找空闲分区链(或空闲分区表),
- 找到大小能满足要求的第一个空闲分区。
- 邻近适应算法和首次适应算法相对其他算法的优势:
- 无论选哪个空闲空间,都不需要对链表进行一个较大幅度的排序
- 因此在这方面的开销较小。
- 邻近适应算法其实就是就是把首次适应算法的链表变成了循环链表,
- 每次保留查找位置,且下次查找从该位置开始,
- 由此避免低地址部分被反复查找增大开销。
- 在此不过多阐述例子,图示大概如下:
- 缺点:
- 首次适应算法每次都要从头查找,每次都需要检索低地址的小分区。
- 但是这种规则也决定了当低地址部分有更小的分区可以满足需求时,
- 会更有可能会用到低地址部分的小分区,
- 也会更有可能会把高地址部分的大分区保留下来(最佳适应算法的优点)
- 邻近适应算法的规则可能会导致无论低地址、高地址部分的空闲分区都有相同的概率被使用,
- 也就导致了高地址部分的大分区更可能被使用,划分为小分区,最后导致无大分区可用(最大适应算法的缺点)
- 综合来看,四种算法中,首次适应算法的效果反而更好
知识回顾与重要考点
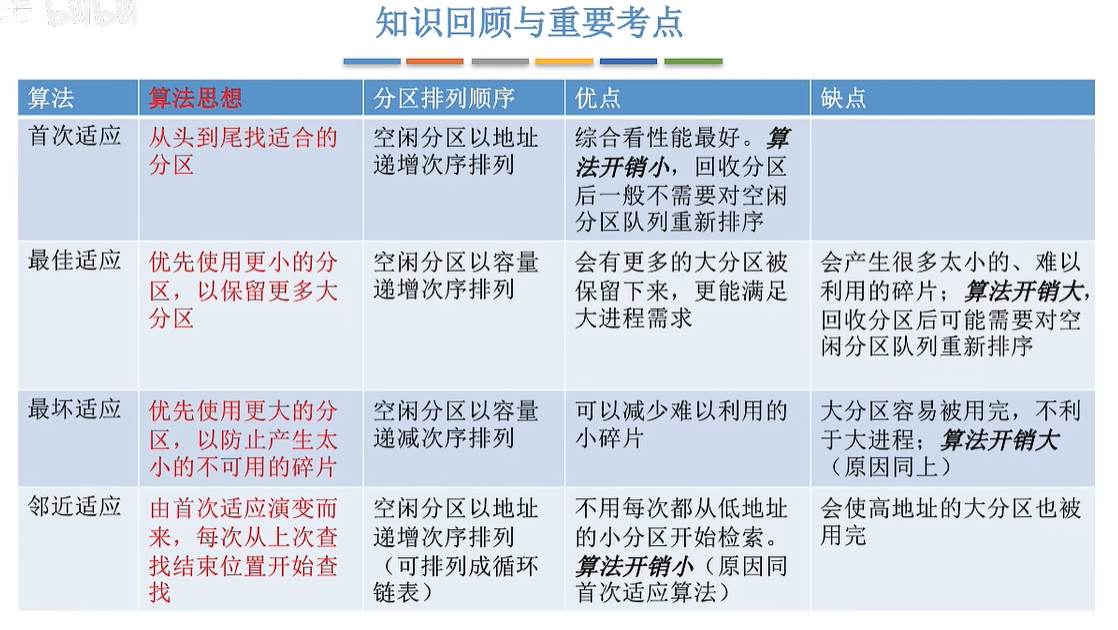
- 最佳适应和最坏适应开销较大主要就是要排序,所以开销较大
- 首次适应和邻近适应因为不需要排序,所以开销小

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 0
 0
- 0


 已为社区贡献47条内容

所有评论(0)