初步了解进程
一.冯·诺伊曼体系结构
大部分的计算机结构都遵循冯诺依曼体系结构,其结构如下:
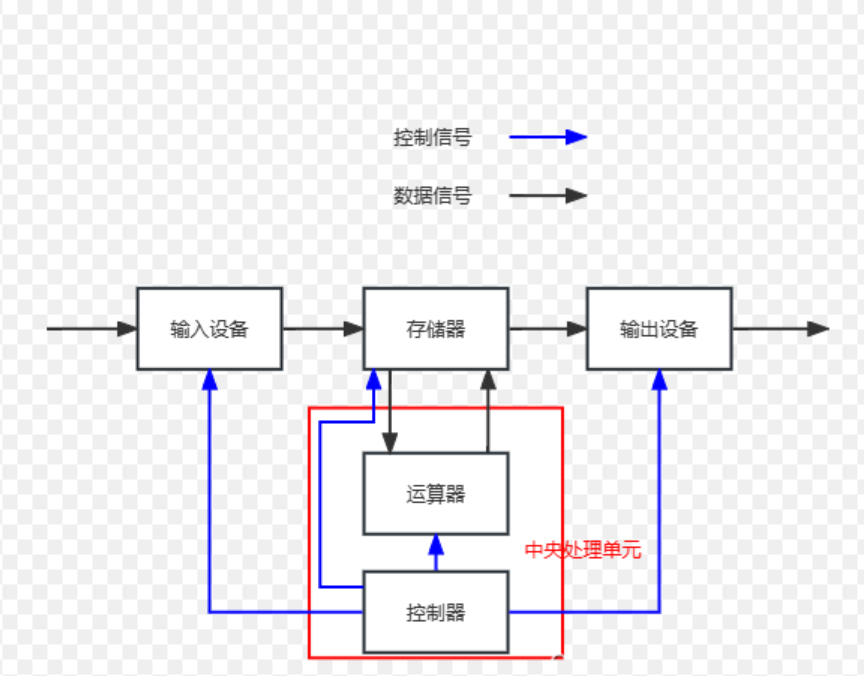
截至目前,我们所认识的计算机都是由一个个硬件组成的:
输入设备:键盘、鼠标、麦克风、摄像头等;
输出设备:显示器、打印机等;
储存器:就是内存;
中央处理单元(CPU):由运算器(数学运算和逻辑运算)和控制器构成;
有些硬件比较特殊,如网卡和硬盘(外存),它们既可以是输入设备也可以是输出设备(可以从中读取和写入信息)。
软件运行为什么要加载到内存?
软件在运行前储存在磁盘即外存中,开始执行时要先将它加载到内存里。注意看图中的数据信号流向(黑色箭头),可以发现,能与CPU进行数据信号交流的只有内存,而软件的运行必须由CPU进行处理,所以软件运行需加载到内存,这是体系结构所规定的。
我们可以不要内存,直接把中央处理单元搬到内存的位置吗?
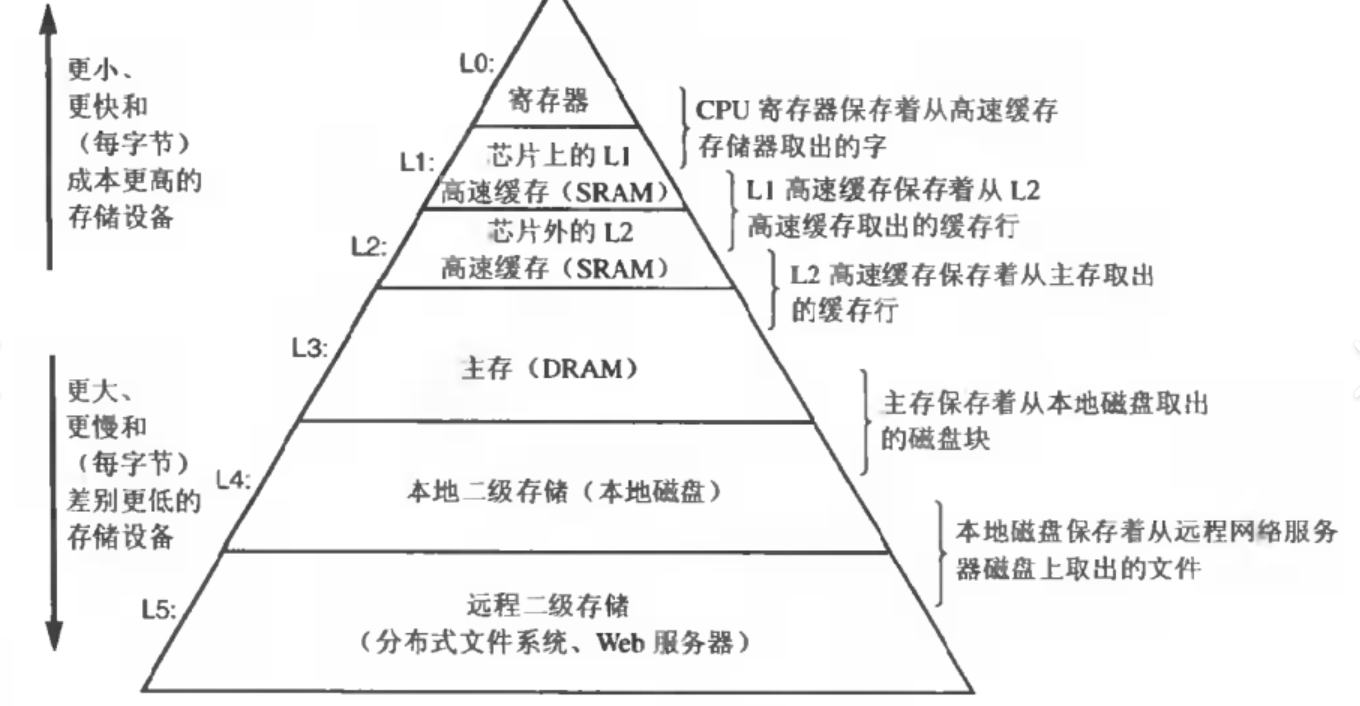
可以,但计算机效率会大幅下降。数据的流动实际上是从一个设备拷贝到另一个设备,也就是说体系结构的效率由设备的拷贝效率决定,而CPU的处理速度是纳秒级的,输入输出设备是毫秒级,这会导致CPU大部分时间没在工作,体系结构的效率完全由输入输出设备的决定。当然如果你把输入输出设备处理数据的硬件换成CPU级别的可以提高计算机效率,但这造价非常高。有了内存计算机才能在保持较高效率的同时又能被大众购买。
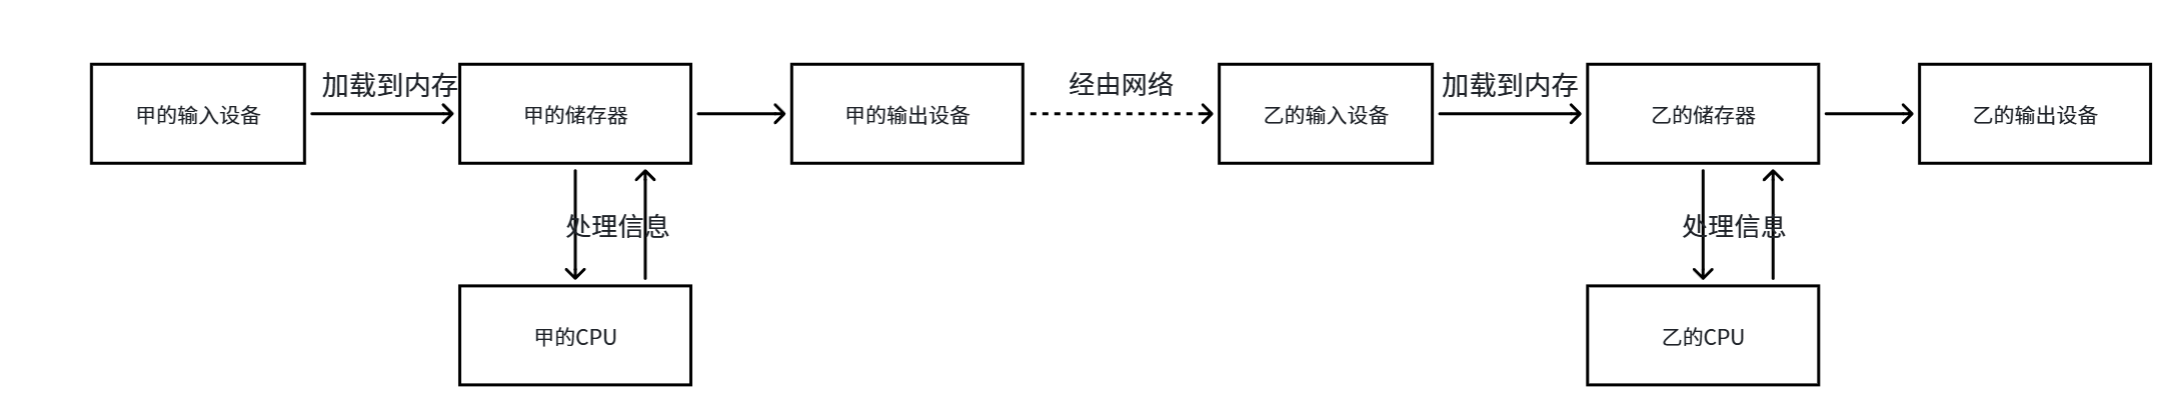
从冯诺依曼体系结构的角度理解网络聊天时数据的流动:
二.操作系统
基本概念(operator system)
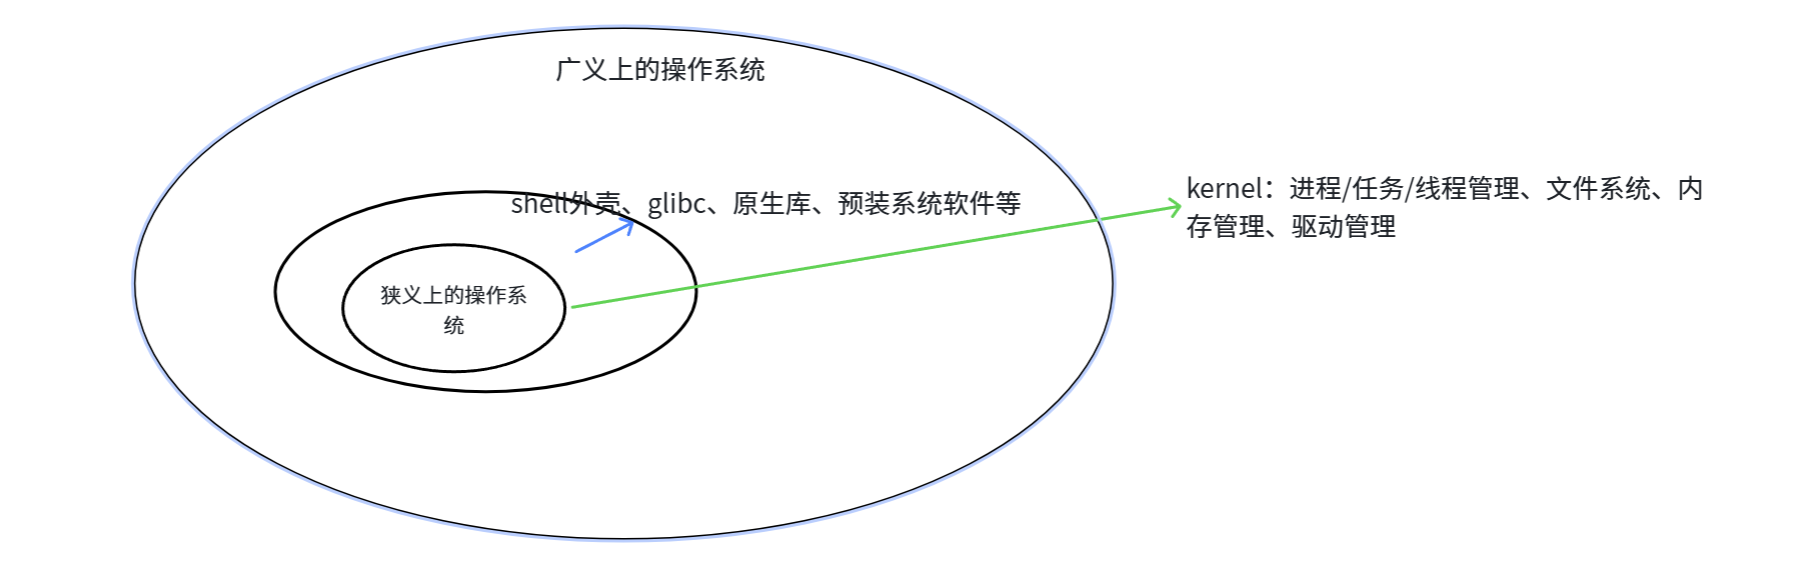
操作系统是一个基本程序的集合,是一个进行软硬件管理的软件。
狭义上的操作系统:操作系统的内核(kernel);
广义上的操作系统:操作系统的内核及其他程序(shell外壳、库函数等)。
设计OS的目的
计算机软硬件体系结构如图:
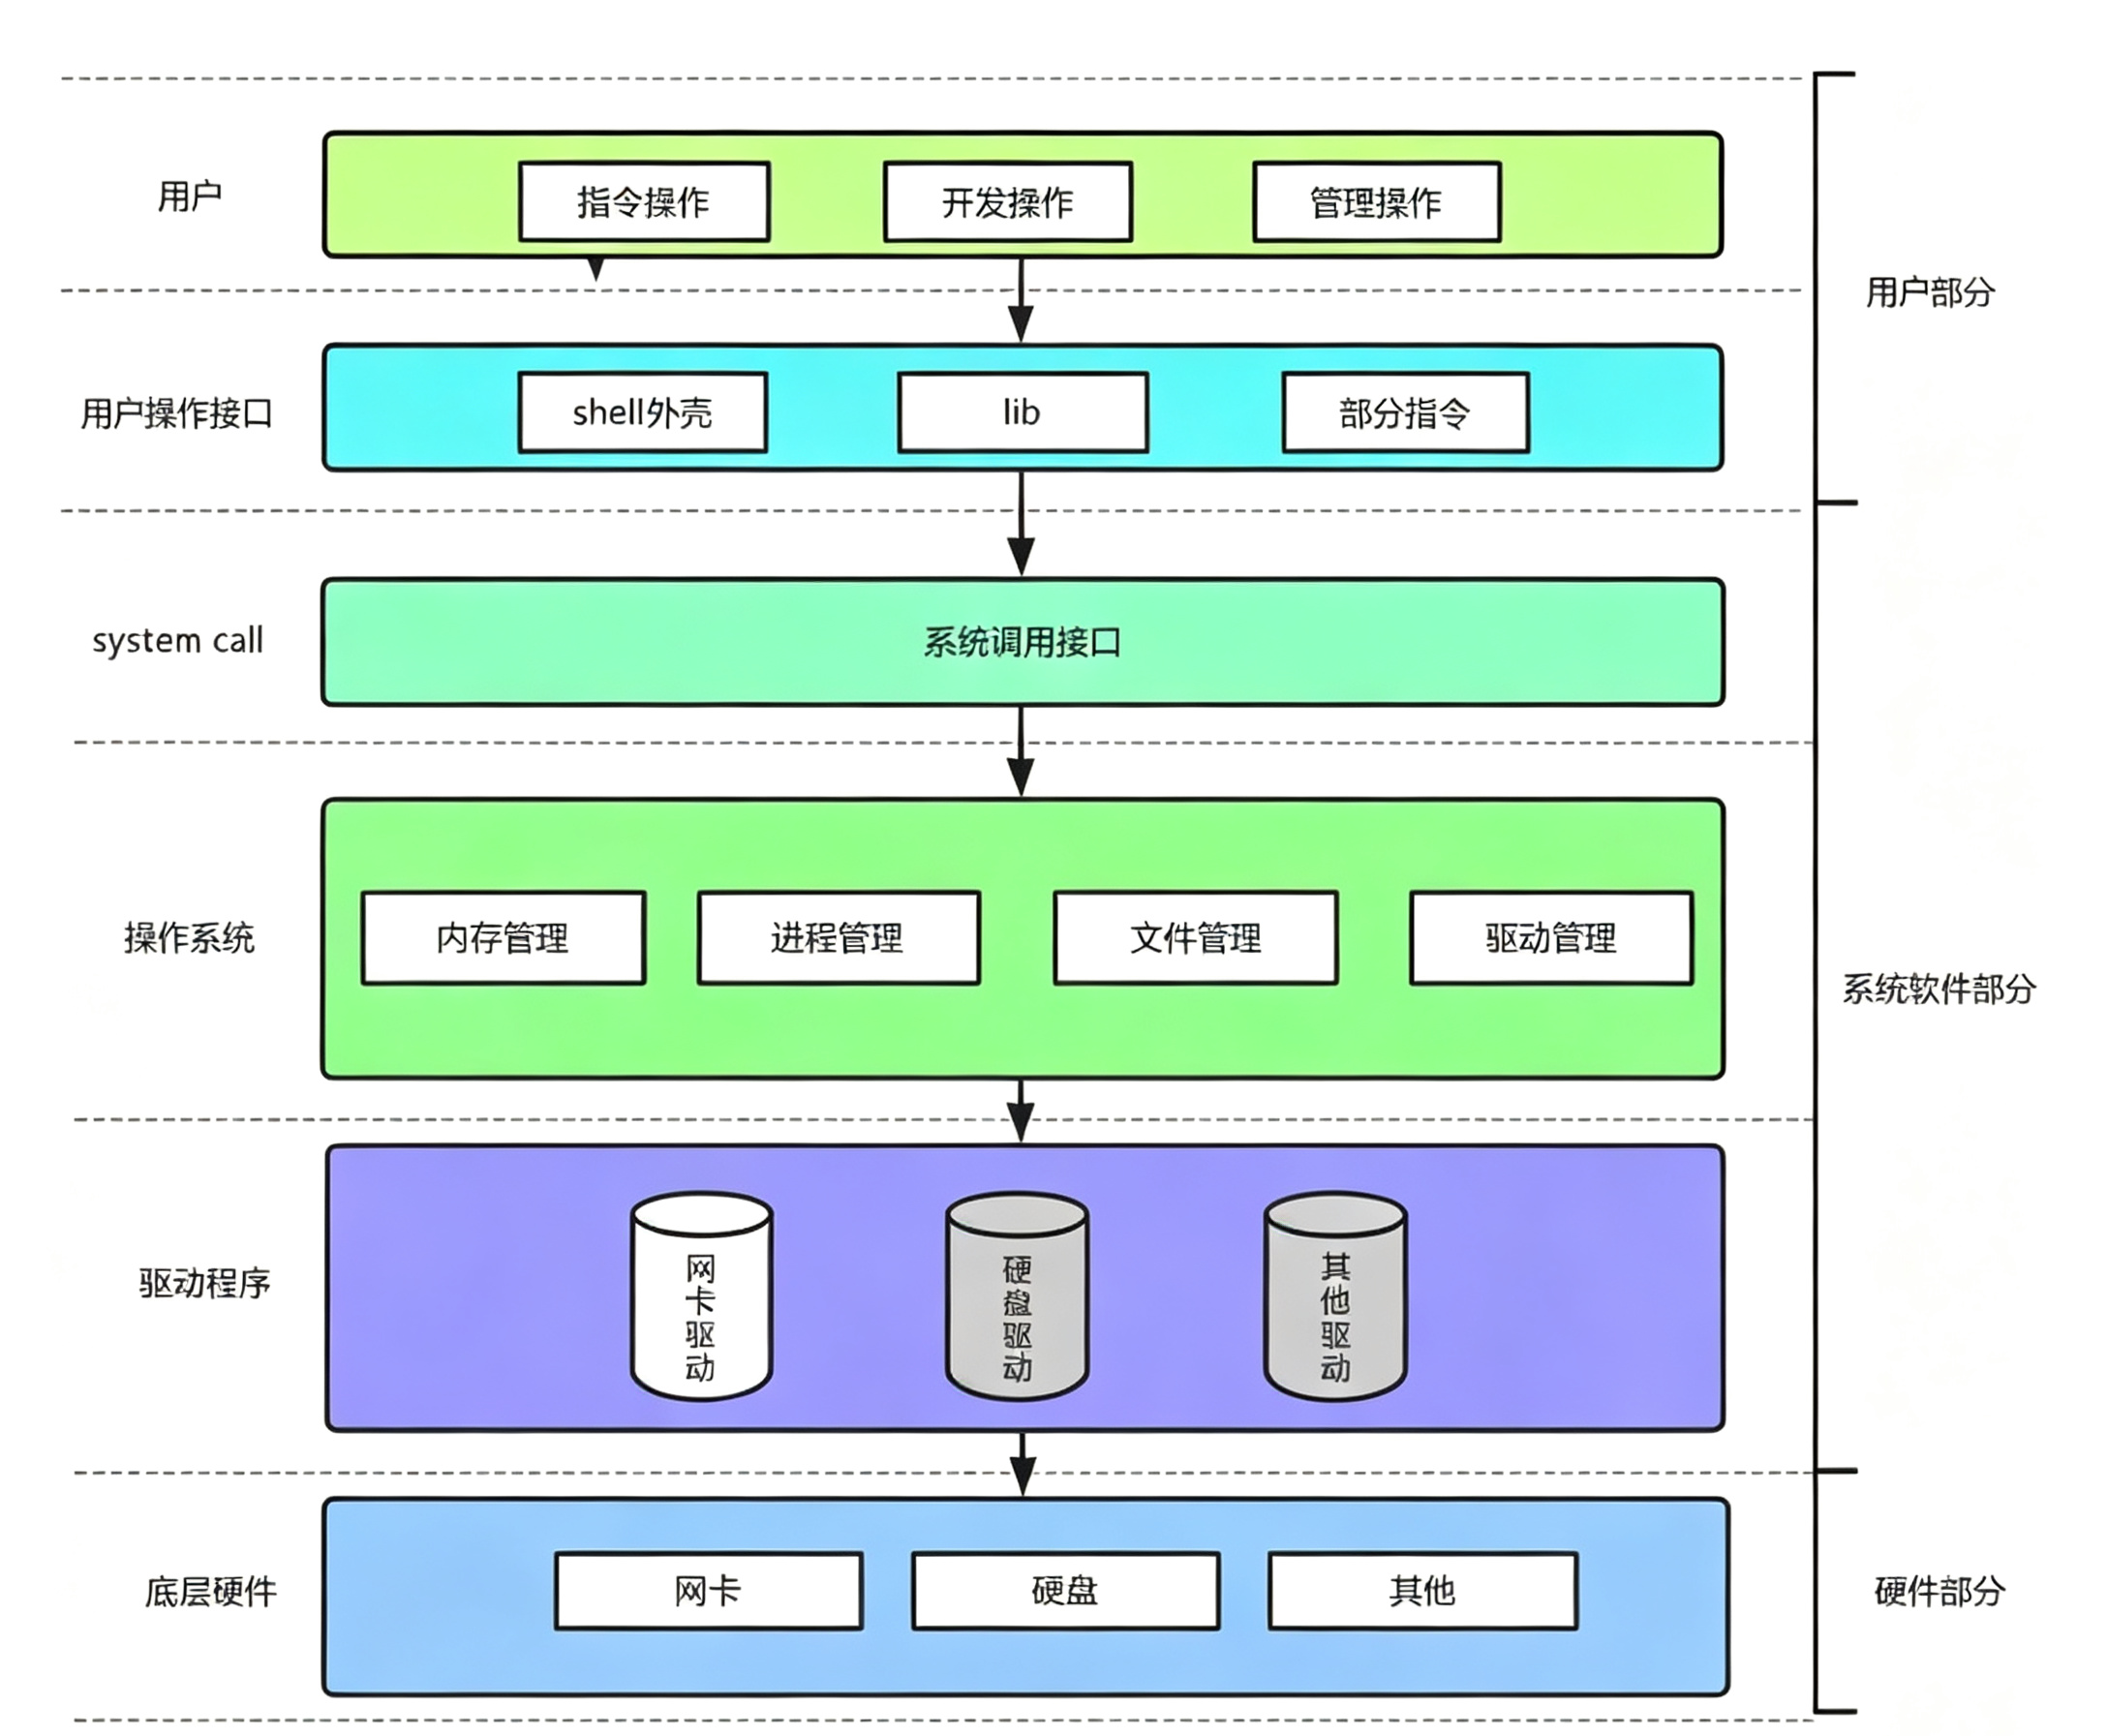
我们不难观察出计算机软硬件体系结构是明显分层的,将实现同一类功能的软硬件放在同一层,然后不同层对相邻层开放同用接口,以实现结构高内聚,低耦合的特性。
高内聚:同一层软硬件执行同类操作;
低耦合:各层间关联度较小,只通过同用接口链接,这就使得每一层都可以被替换,如电脑配置可以是不同品牌的硬件。
我们可以以操作系统为界将图分为两部分:
以向下(操作系统—硬件底层)与硬件交互,管理所有软硬件资源为手段,来达到向上(操作系统—用户)对用户程序提供良好执行环境的目的。
总结
1.计算机软硬件体系结构有高内聚,低耦合的特性;
2.我们要访问操作系统必须经过系统调用(system call,其实就是系统提供的函数);
3.库(用户操作接口层)可能封装了系统调用;
4.如果我们的程序(用户层)访问了底层硬件,那么它一定贯穿了整个软硬件体系结构;
5.目的:对用户程序提供良好的执行环境。
核心功能
在整个软硬件体系中,操作系统是一个纯正的‘搞管理’软件。
如何理解管理?
管理可以分成两个工作:决策、执行;
如果要进行决策,那么你就必须了解事物的信息,以告诉你如何决策。而管理者有了决策之后,就要对被管理者进行执行,但执行这一步并非一定要管理者来,也可以是专门负责执行管理者的决策的角色。
比如一个学校有3个身份:校长(管理者),辅导员(执行者),学生(被管理者);
校长管理学生不是与学生面对面交流进行管理,而是通过观察学生的信息,如果学生A的信息满足了颁发奖学金的条件,校长就可以做出“给A颁发奖学金”的决策,然而执行这个决策的任务可以交给辅导员。
将这些事实带入软硬件体系结构中我们可以得知操作系统通过记录软硬件的各种信息以达到对其管理的目的。
总结下来操作系统的管理可以用6个字概括:先描述,再组织;
先描述:对事物的数据信息进行描述,可以用结构体保存信息;
再组织:将事物的数据信息用数据结构组织起来对其进行管理。
系统调用和库函数概念
系统调用:
操作系统向上提供服务,但操作系统不相信任何人! 就像银行一样,它虽然可以为你提供存钱等各项服务,但它不允许你直接去银行仓库取钱或存钱,而是在前台为你开设服务窗口。这里的服务窗口就相当于系统调用。
在开发角度,操作系统对外表现为一个整体,但会暴露一些接口对上层开发者使用,这些接口就是系统调用。
库函数:
但不是所有人都了解银行服务的具体操作的,比如一些老人家,为了解决这种情况,银行一般都会派人在前台专门指导用户使用银行服务的,这些专门指导的人就相当于库函数。
系统调用在使用上功能比较基础,对用户的要求也比较高,所以有些开发者会对一些系统调用进行封装从而形成库,有了库就更有利于上层开发者进行二次开发。
目前我们就是不懂银行服务(系统调用的实现)的人,需要专门的指导员(库函数,封装了系统调用)来指导我们获得银行服务。
三.进程
进程的概念
到底什么是进程?也许我们会想,程序运行时会被加载到内存,在内存中运行的程序就是进程。但其实这并不是进程。
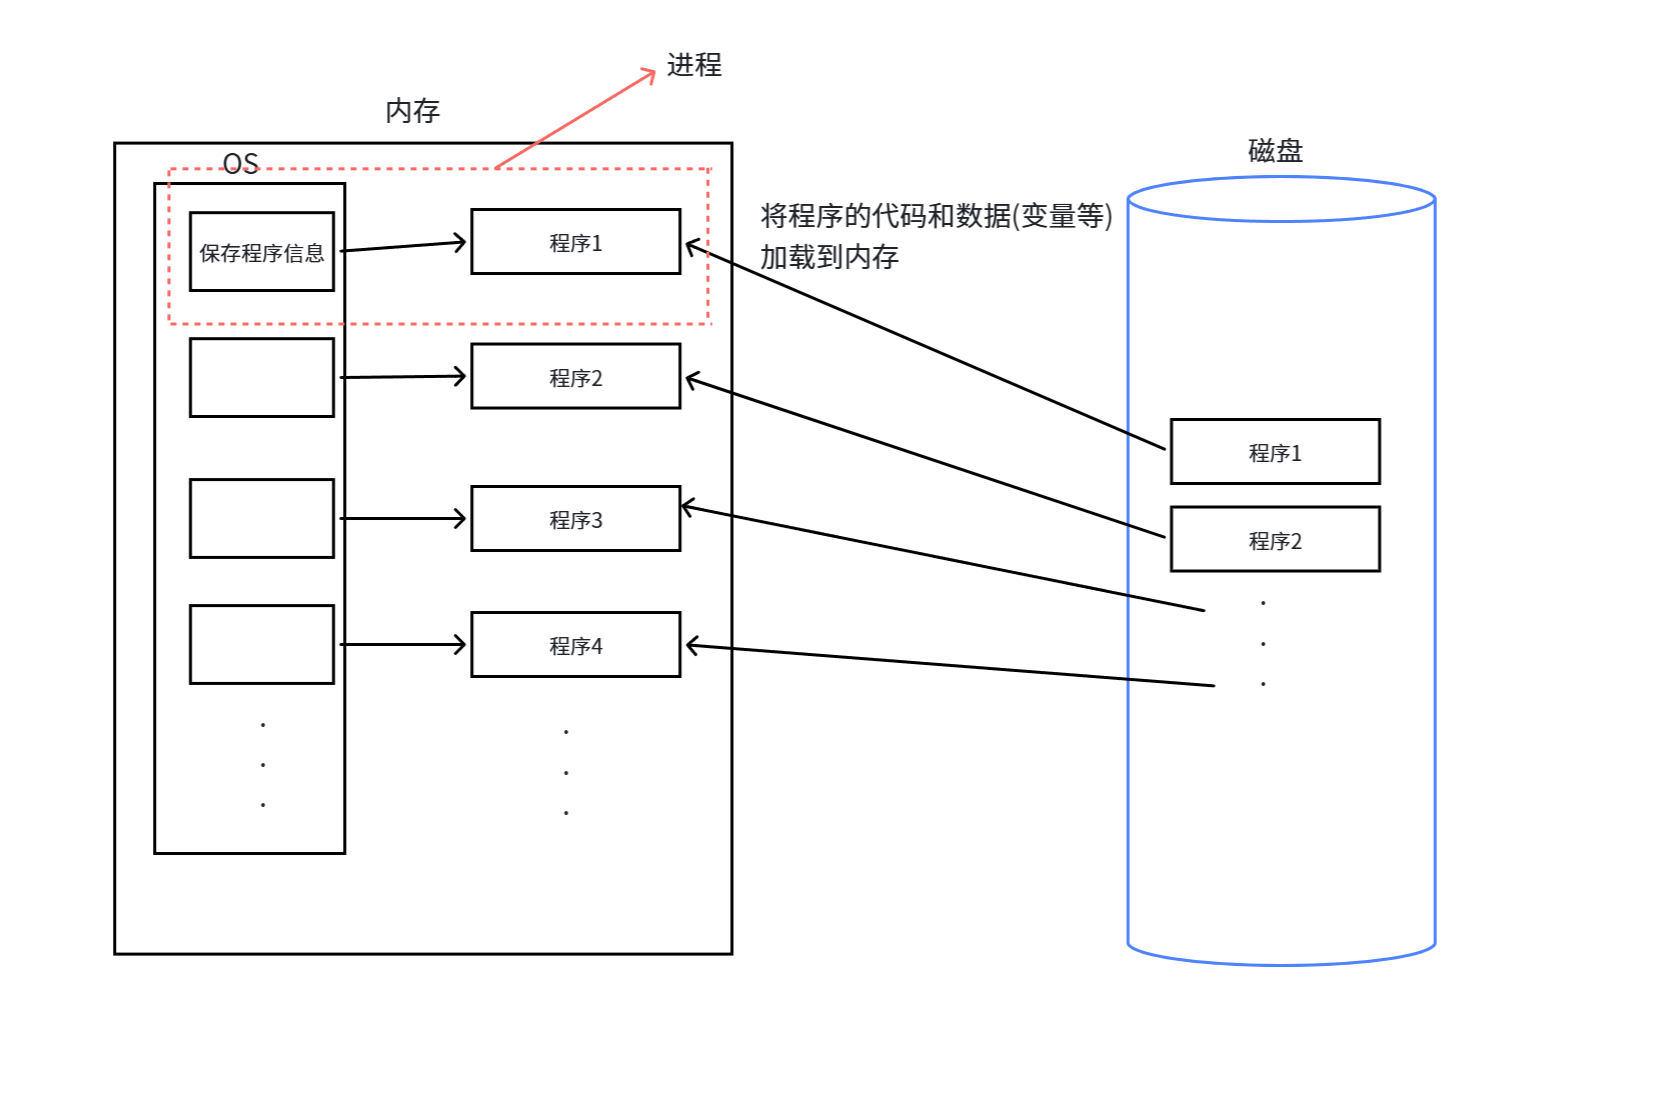
正如前面所说,操作系统需要对运行中的程序进行管理,即创建结构体保存程序的各种信息。这时,加载到内存中的程序与操作系统所创建的结构体就形成了一个进程。
PCB(process control block)与tast_struct
在一个进程中,保存程序信息的结构体,严格来说是储存进程信息的结构体就叫做PCB(进程控制块),在Linux系统中PCB被命名为tast_struct。
tast_struct结构体中包含有以下信息:
标识符(pid:process identification):描述本进程的唯一编号,用来区分其他进程;
状态:任务状态,退出代码,退出信号等;
优先级:相对于其他进程的优先级;
内存指针:包括程序代码和进程相关数据的指针,还有和其他远程共享的内存块的指针;
…
总结
进程 = 内核中的结构体对象(含管理进程所需的所有属性) + 自己的代码和数据 = PCB + 自己的代码和数据。它本质上是担当分配系统资源(CPU时间,内存)的实体。
OS用PCB(结构体)将进程的信息保存起来后,又用数据结构(Linux中用的是特殊的双向链表)将这些结构体组织起来,这样一来,OS对进程的管理就变成了对特定数据结构的增删查改。
在日常的电脑使用中我们可以发现,OS可以同一时间管理众多进程,而某个进程挂了是不会影响其他进程的。因此,进程具有独立性。
进程操作
我们历史上执行的所有命令,工具,自己的程序,运行起来全是进程。当我们执行一个程序时,如果我们想把它停掉就可以使用ctrl c,这就意味着ctrl c终止程序的本质是终止进程。
查看进程
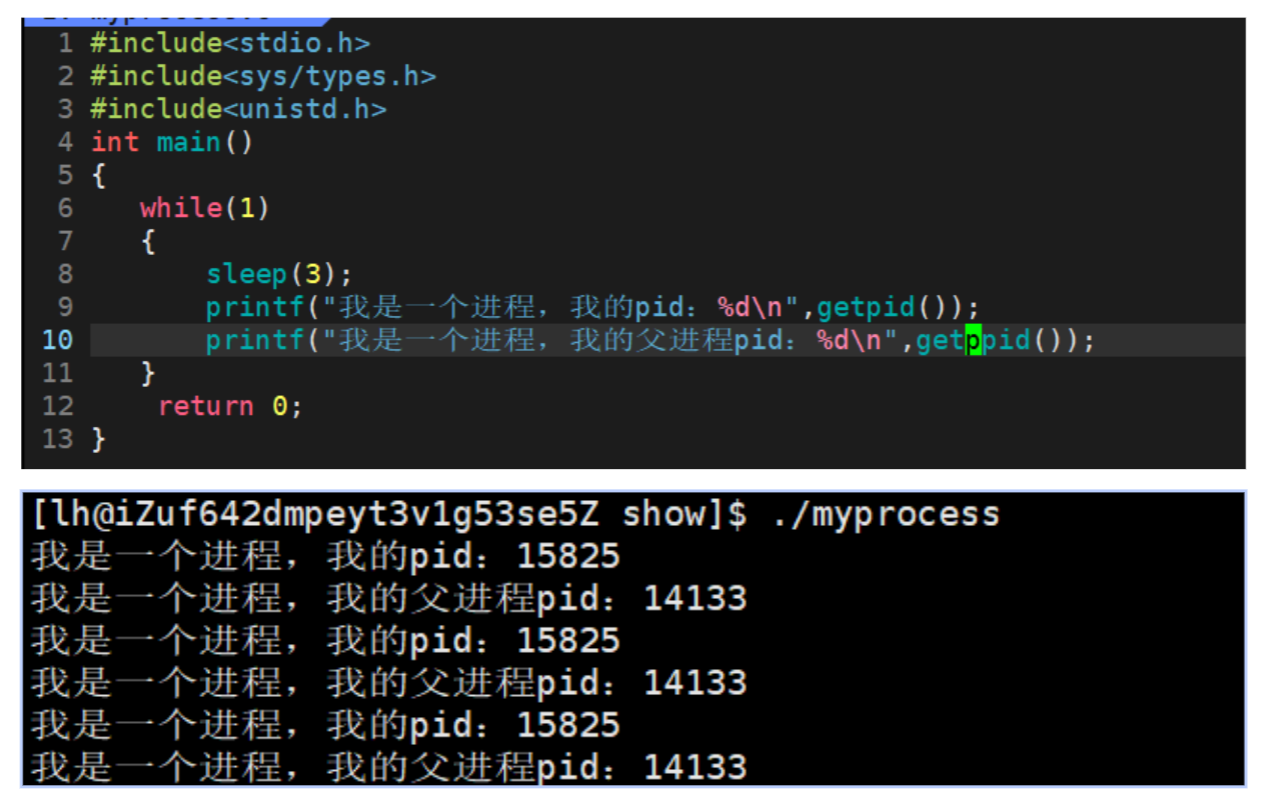
我们可以使用函数getpid() 查看当前程序对应进程的pid:
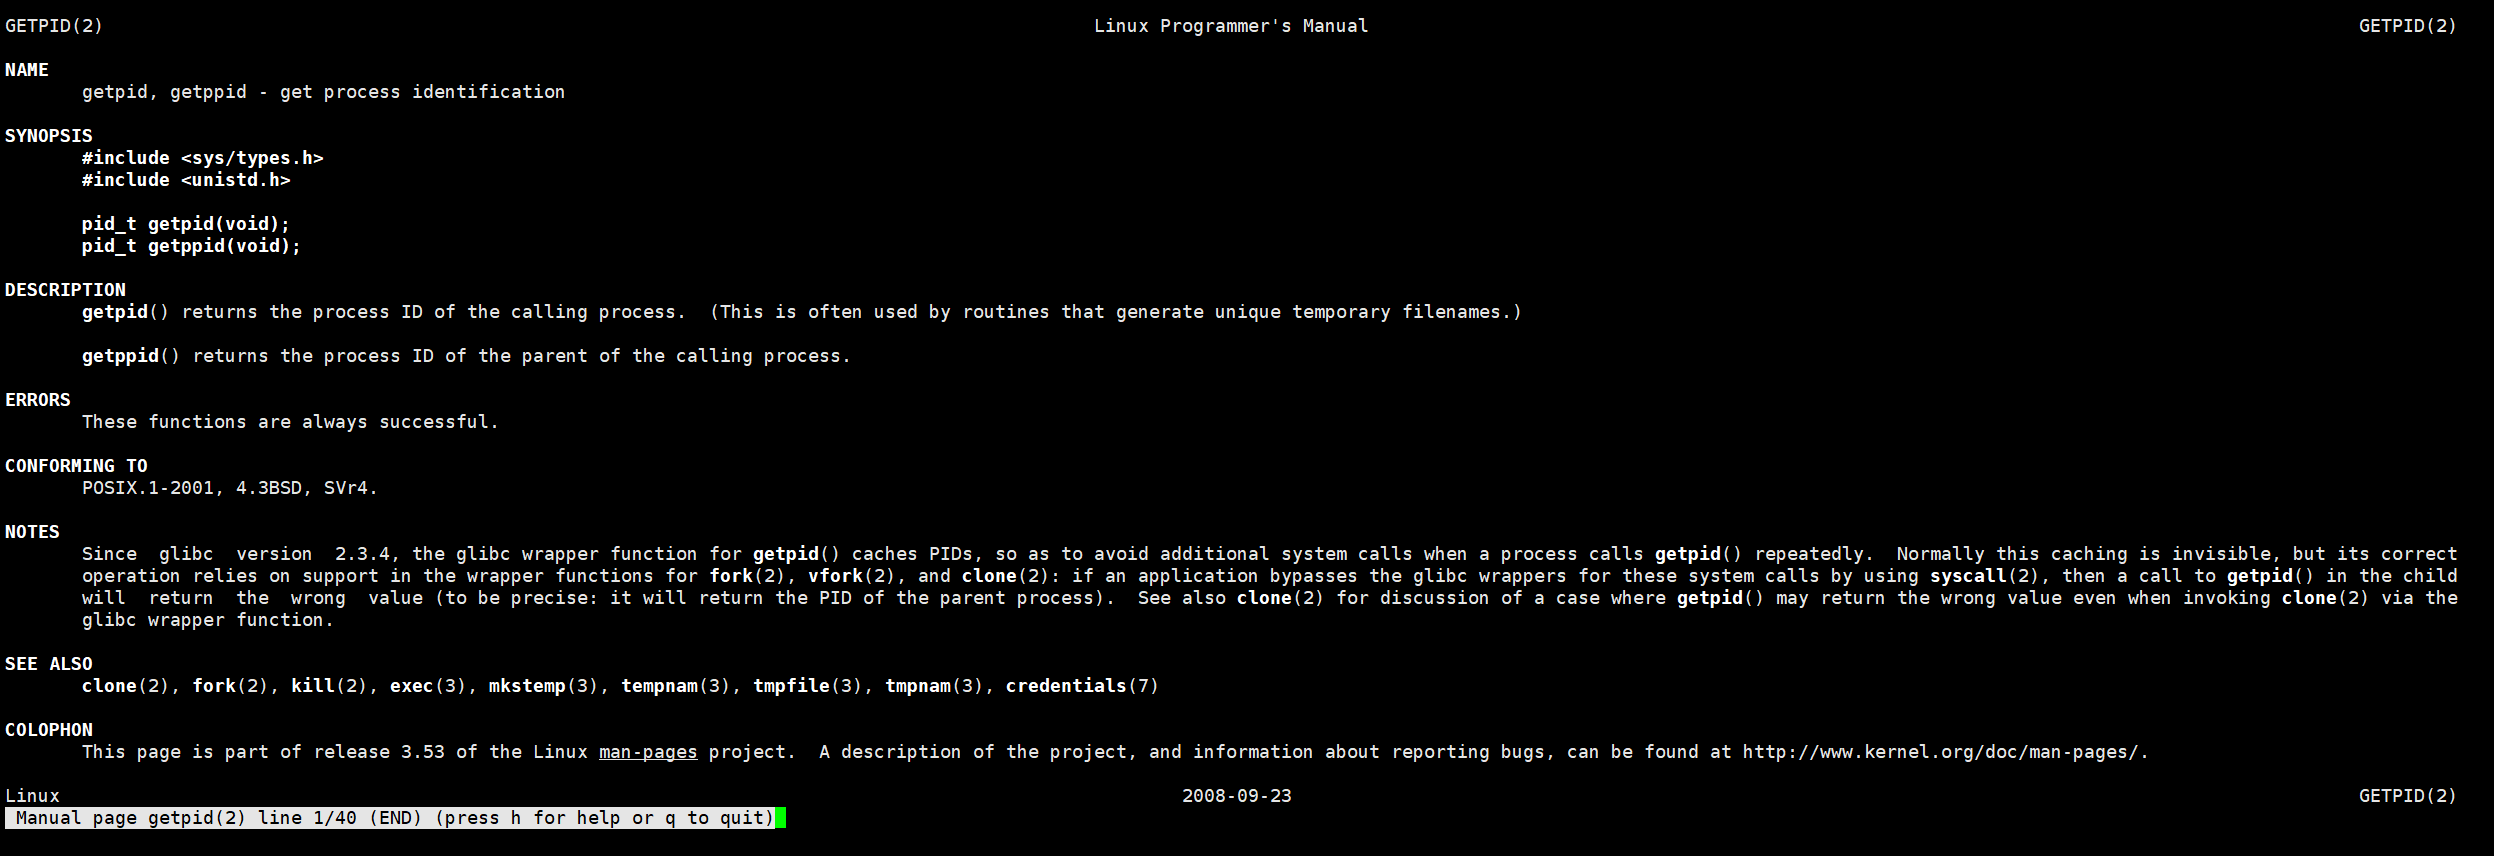
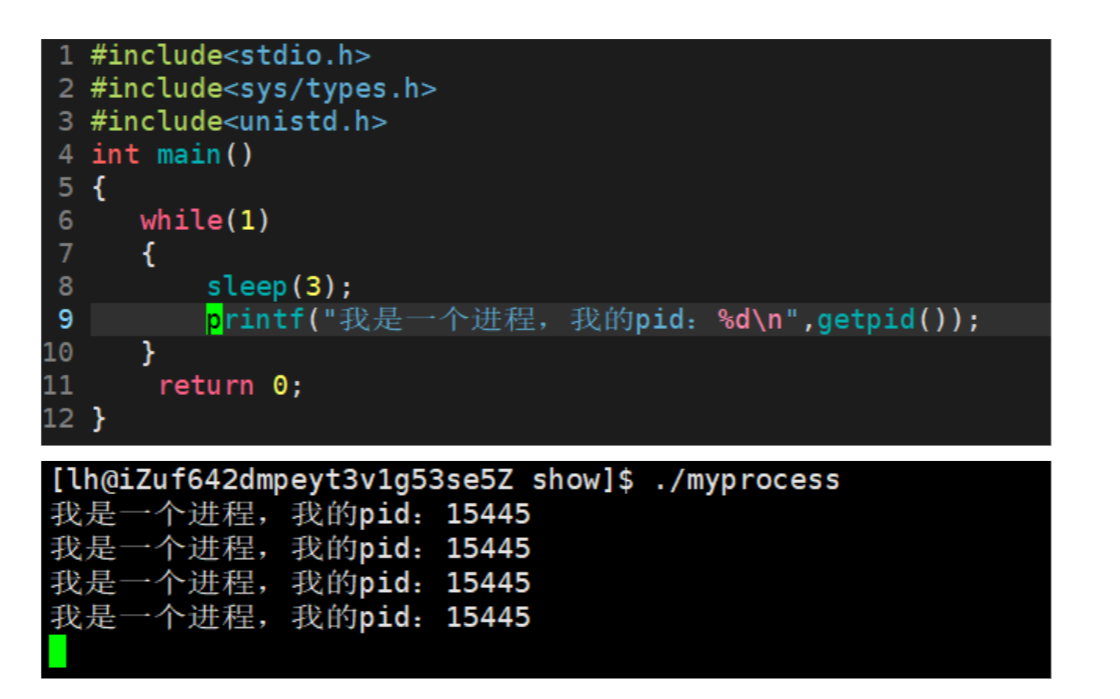
可以用函数getppid() 获取该进程的父进程pid:
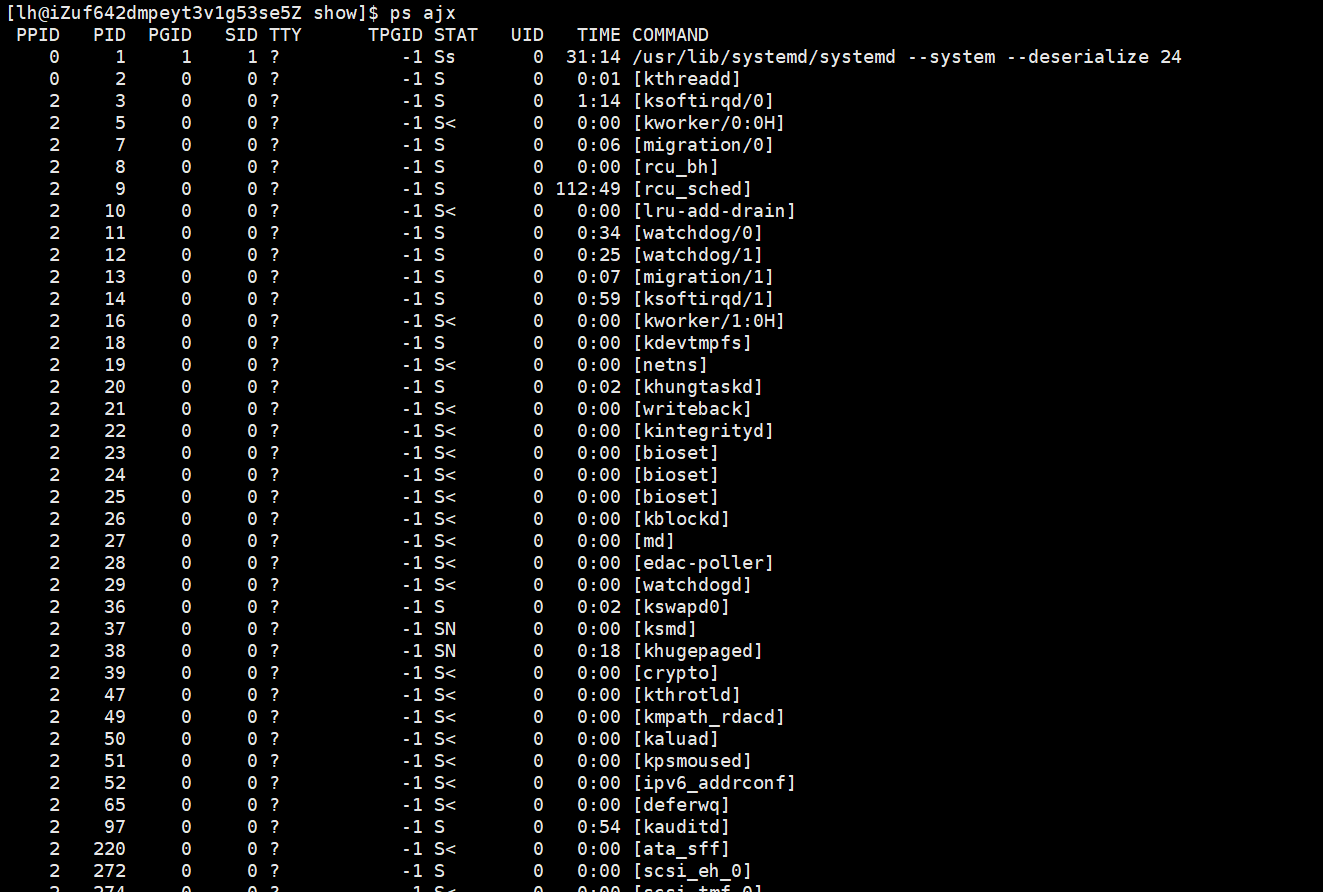
我们可以用ps ajx 查看当前系统中所有的进程:
ps ajx配合grep便可以找到我们想要找的进程:
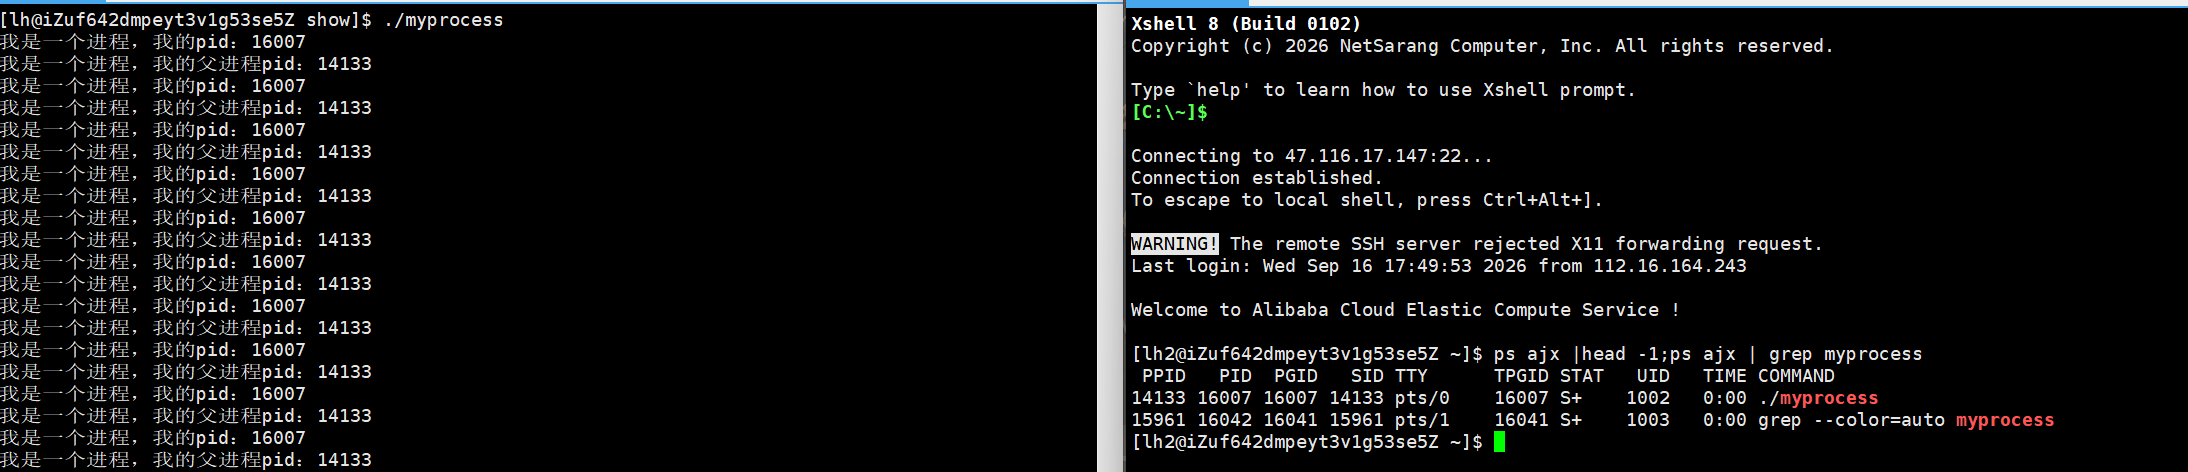
";“作用是先执行它前面的指令,执行完成并显示后开始执行后面指令,换成”&&"也可以。
观察前面的例子我们可以发现,每次运行自己的程序它的pid都会改变,但它的父进程pid(ppid)总是不变,这是为什么呢?
我们先用pid查找对应进程:
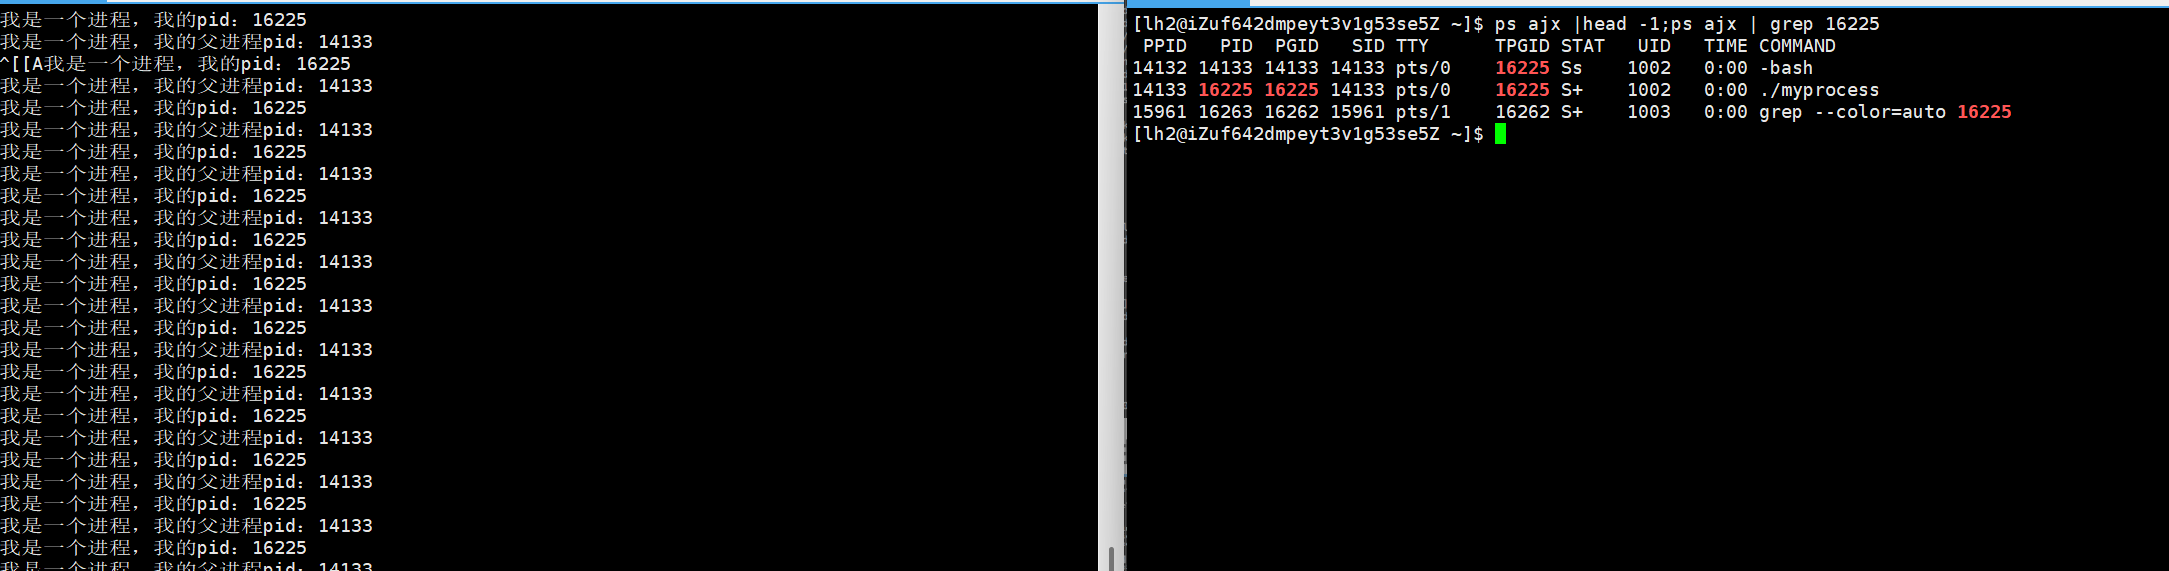
可以发现它的父进程是一个叫bash的指令,实际上,bash就是命令行解释器,每次我们登陆操作系统时,它会给每个用户执行bash指令,只要不退出登陆,bash指令对应的进程就一直存在。我们运行的程序对应的进程都是bash的子进程,所以每次运行虽然它本身pid会变,但ppid不会变。
OS会在/proc文件夹下以目录的方式记录下每个进程的状态,使我们可以动态观察进程:
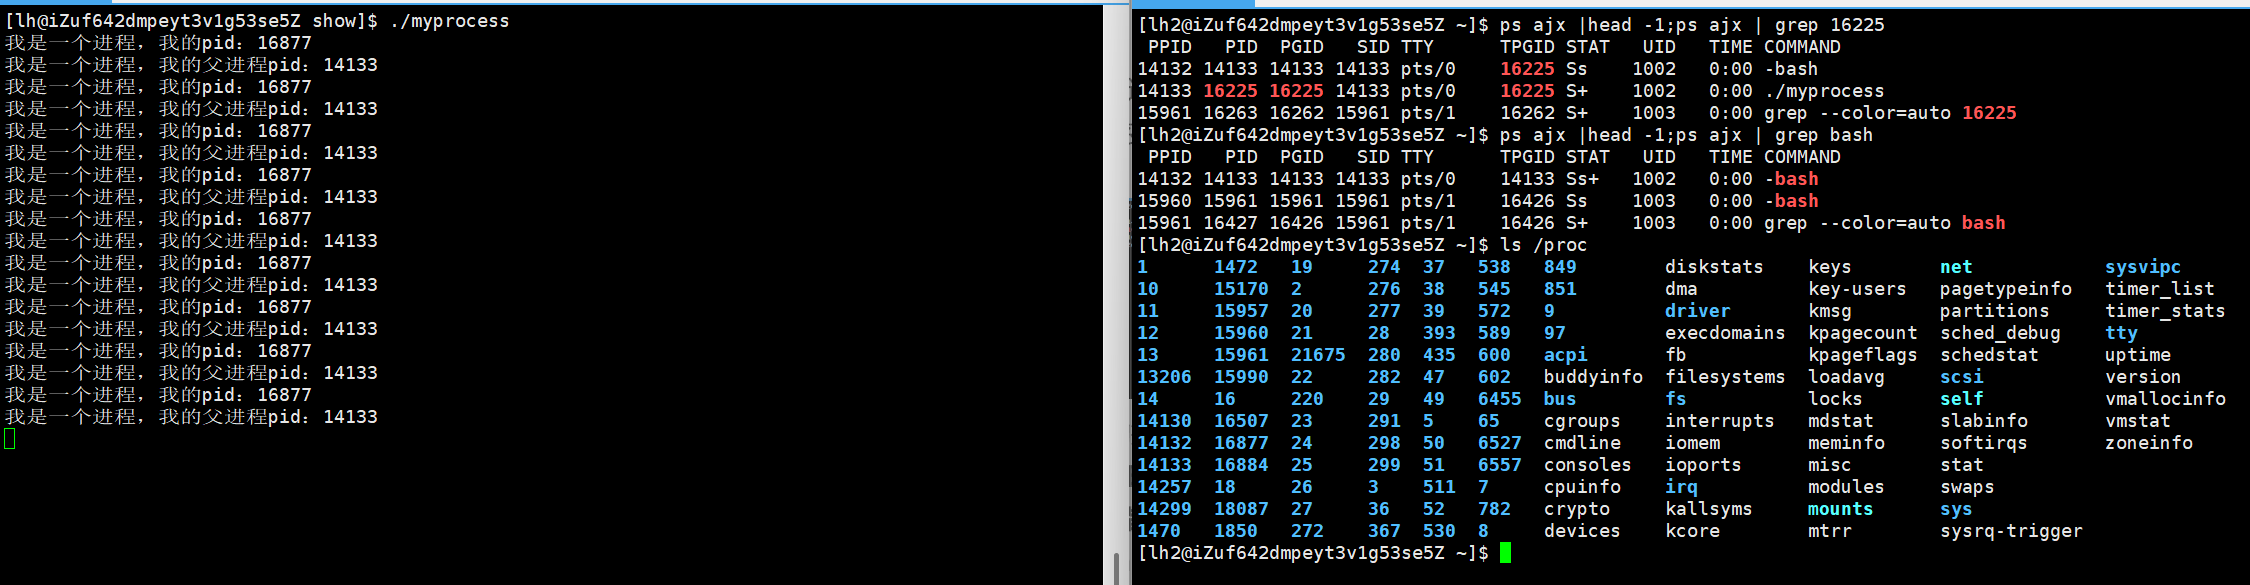
我们可以在该文件下找到以进程pid命名的文件夹,它记录了其对应进程的状态。
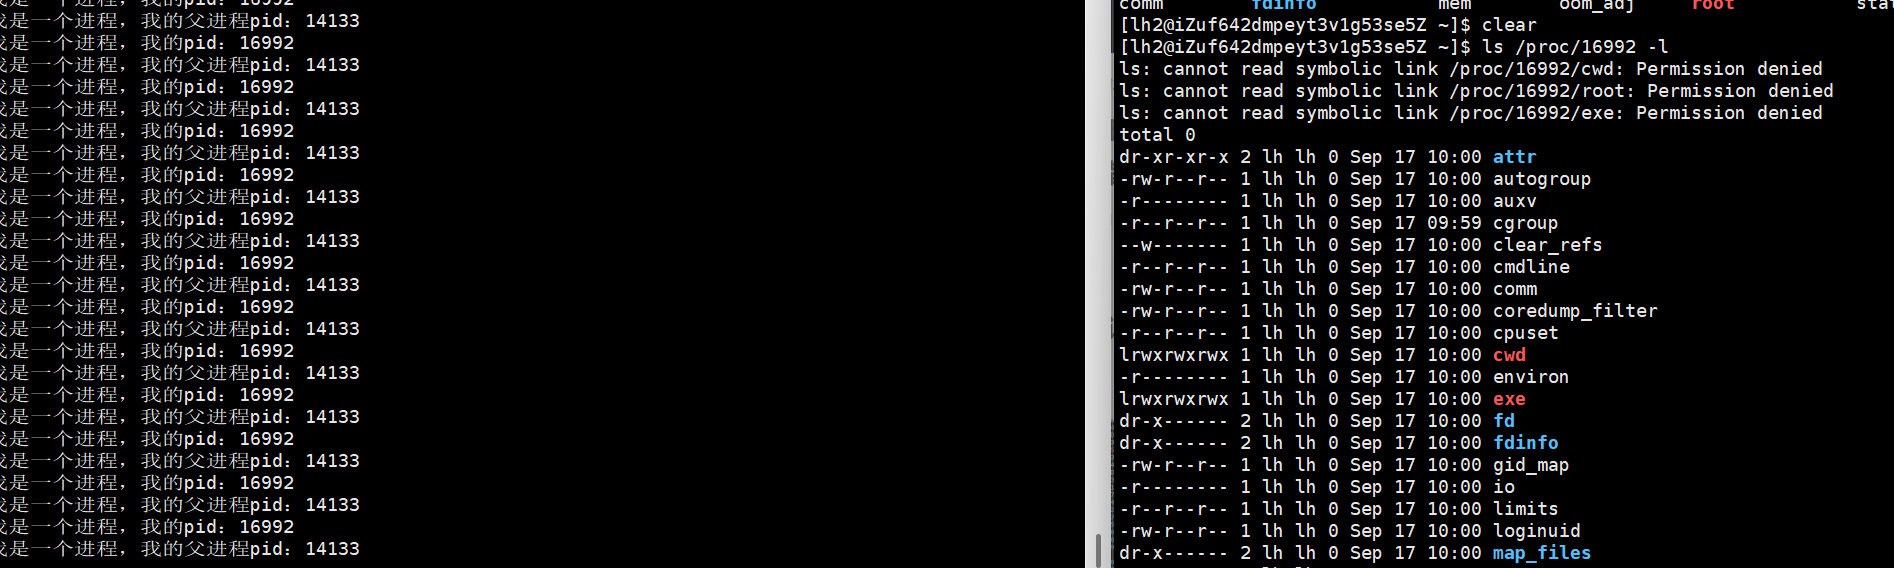
我们查看进程文件夹可以发现它里面有很多文件,注意看两个标红的文件:
exe:记录了进程对应的可执行文件的绝对路径;
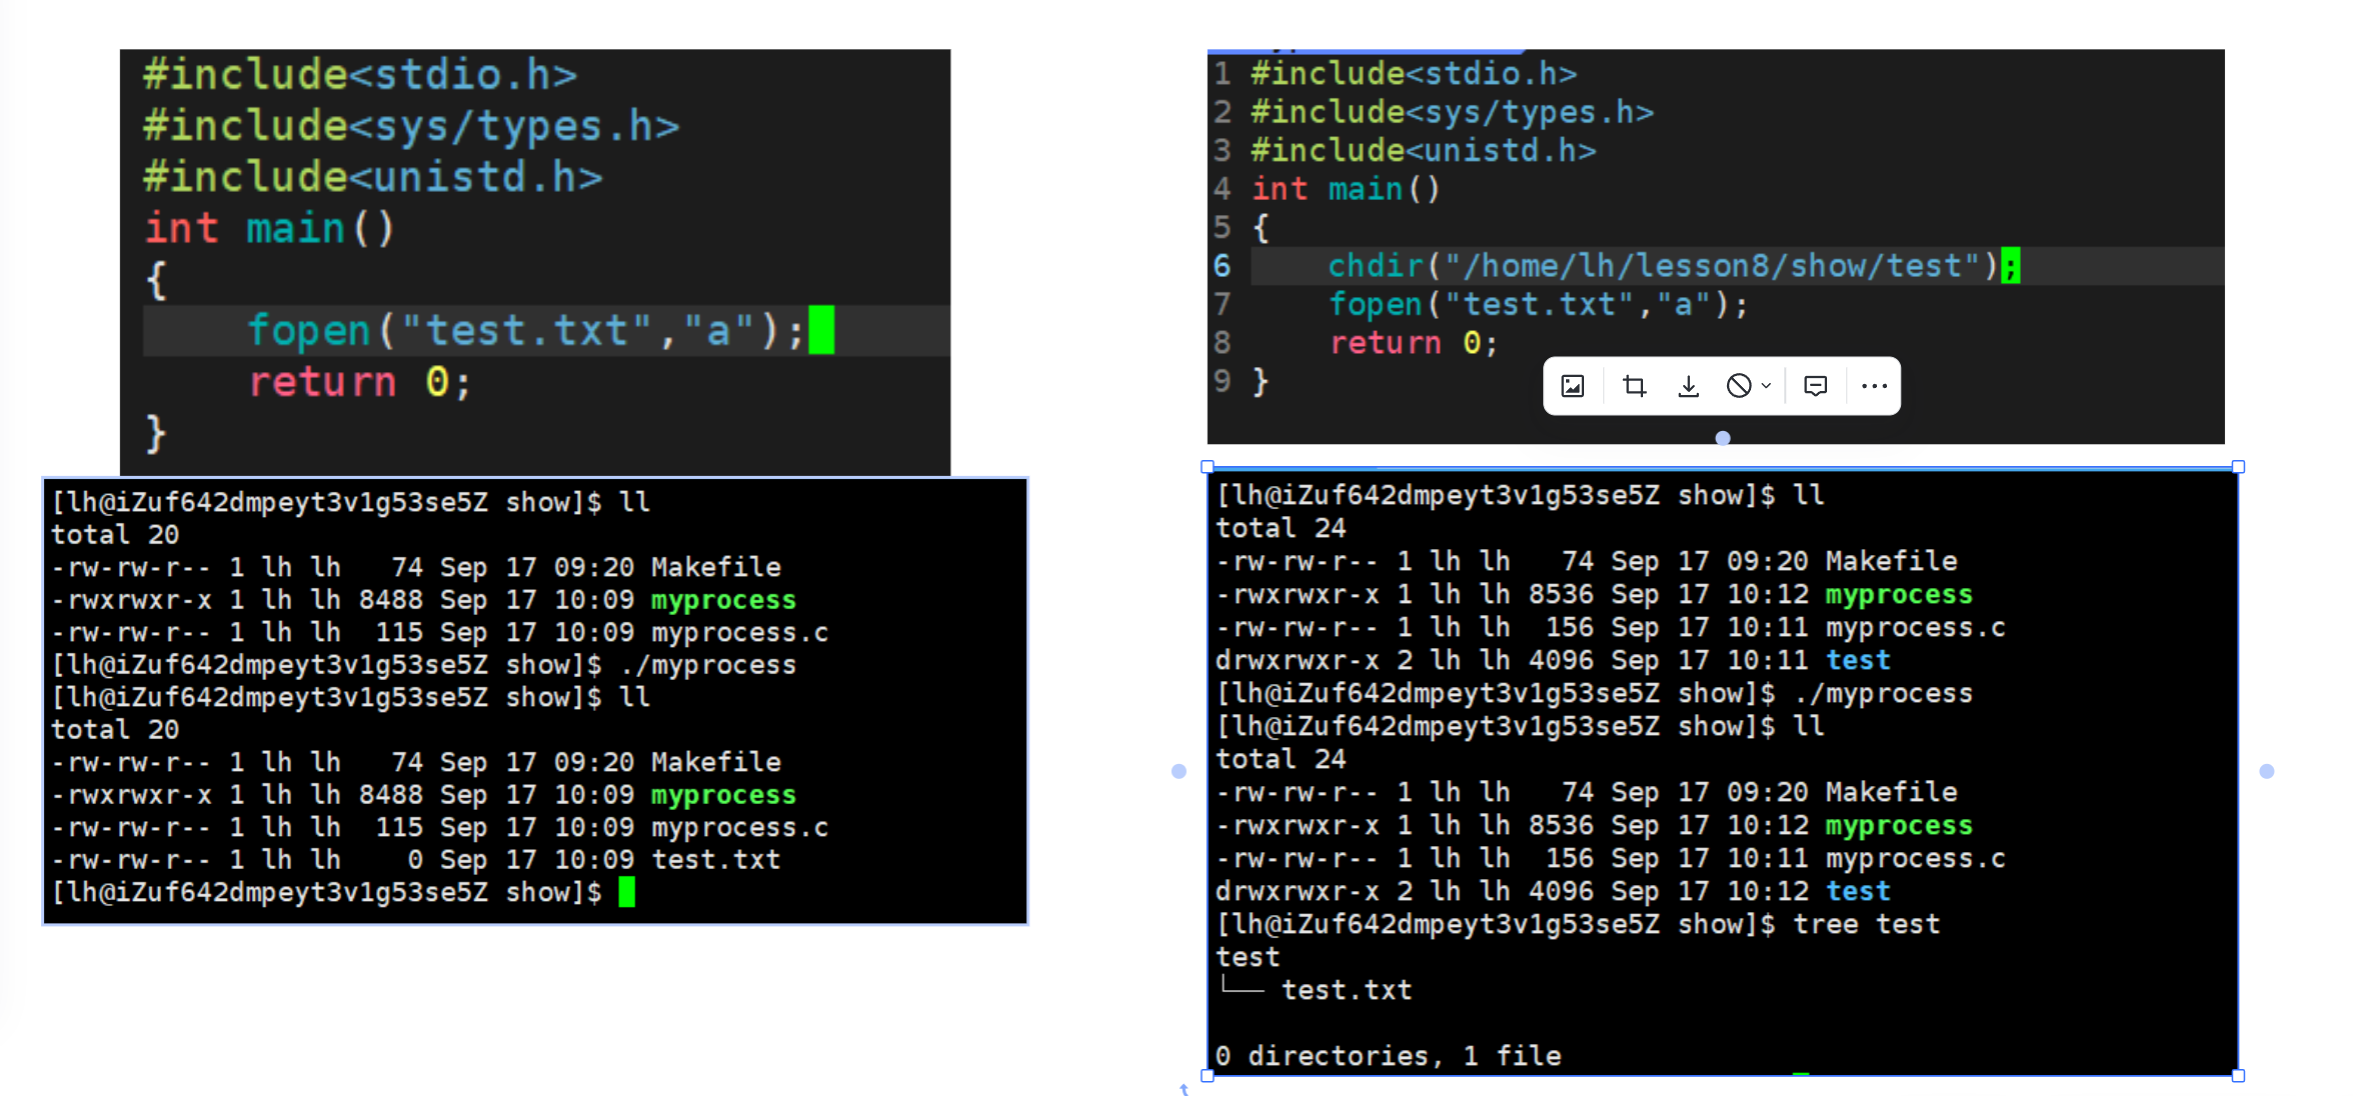
cwd:current work dir 记录的当前工作目录,默认是进程对应可执行文件的所在目录;
我们在C语言学习中学过fopen,它会在当前文件夹中生成指定文件,这个当前文件夹的位置就来自cwd 文件。如果我们想该写它记录的目录,可以用chdir:
终止进程
除了ctrl c可以终止进程外,kill -9 pid也可以终止进程,当然只有自己和root可以终止自己的程序。
创建子程序
我们可以用fork创建子程序,man fork:
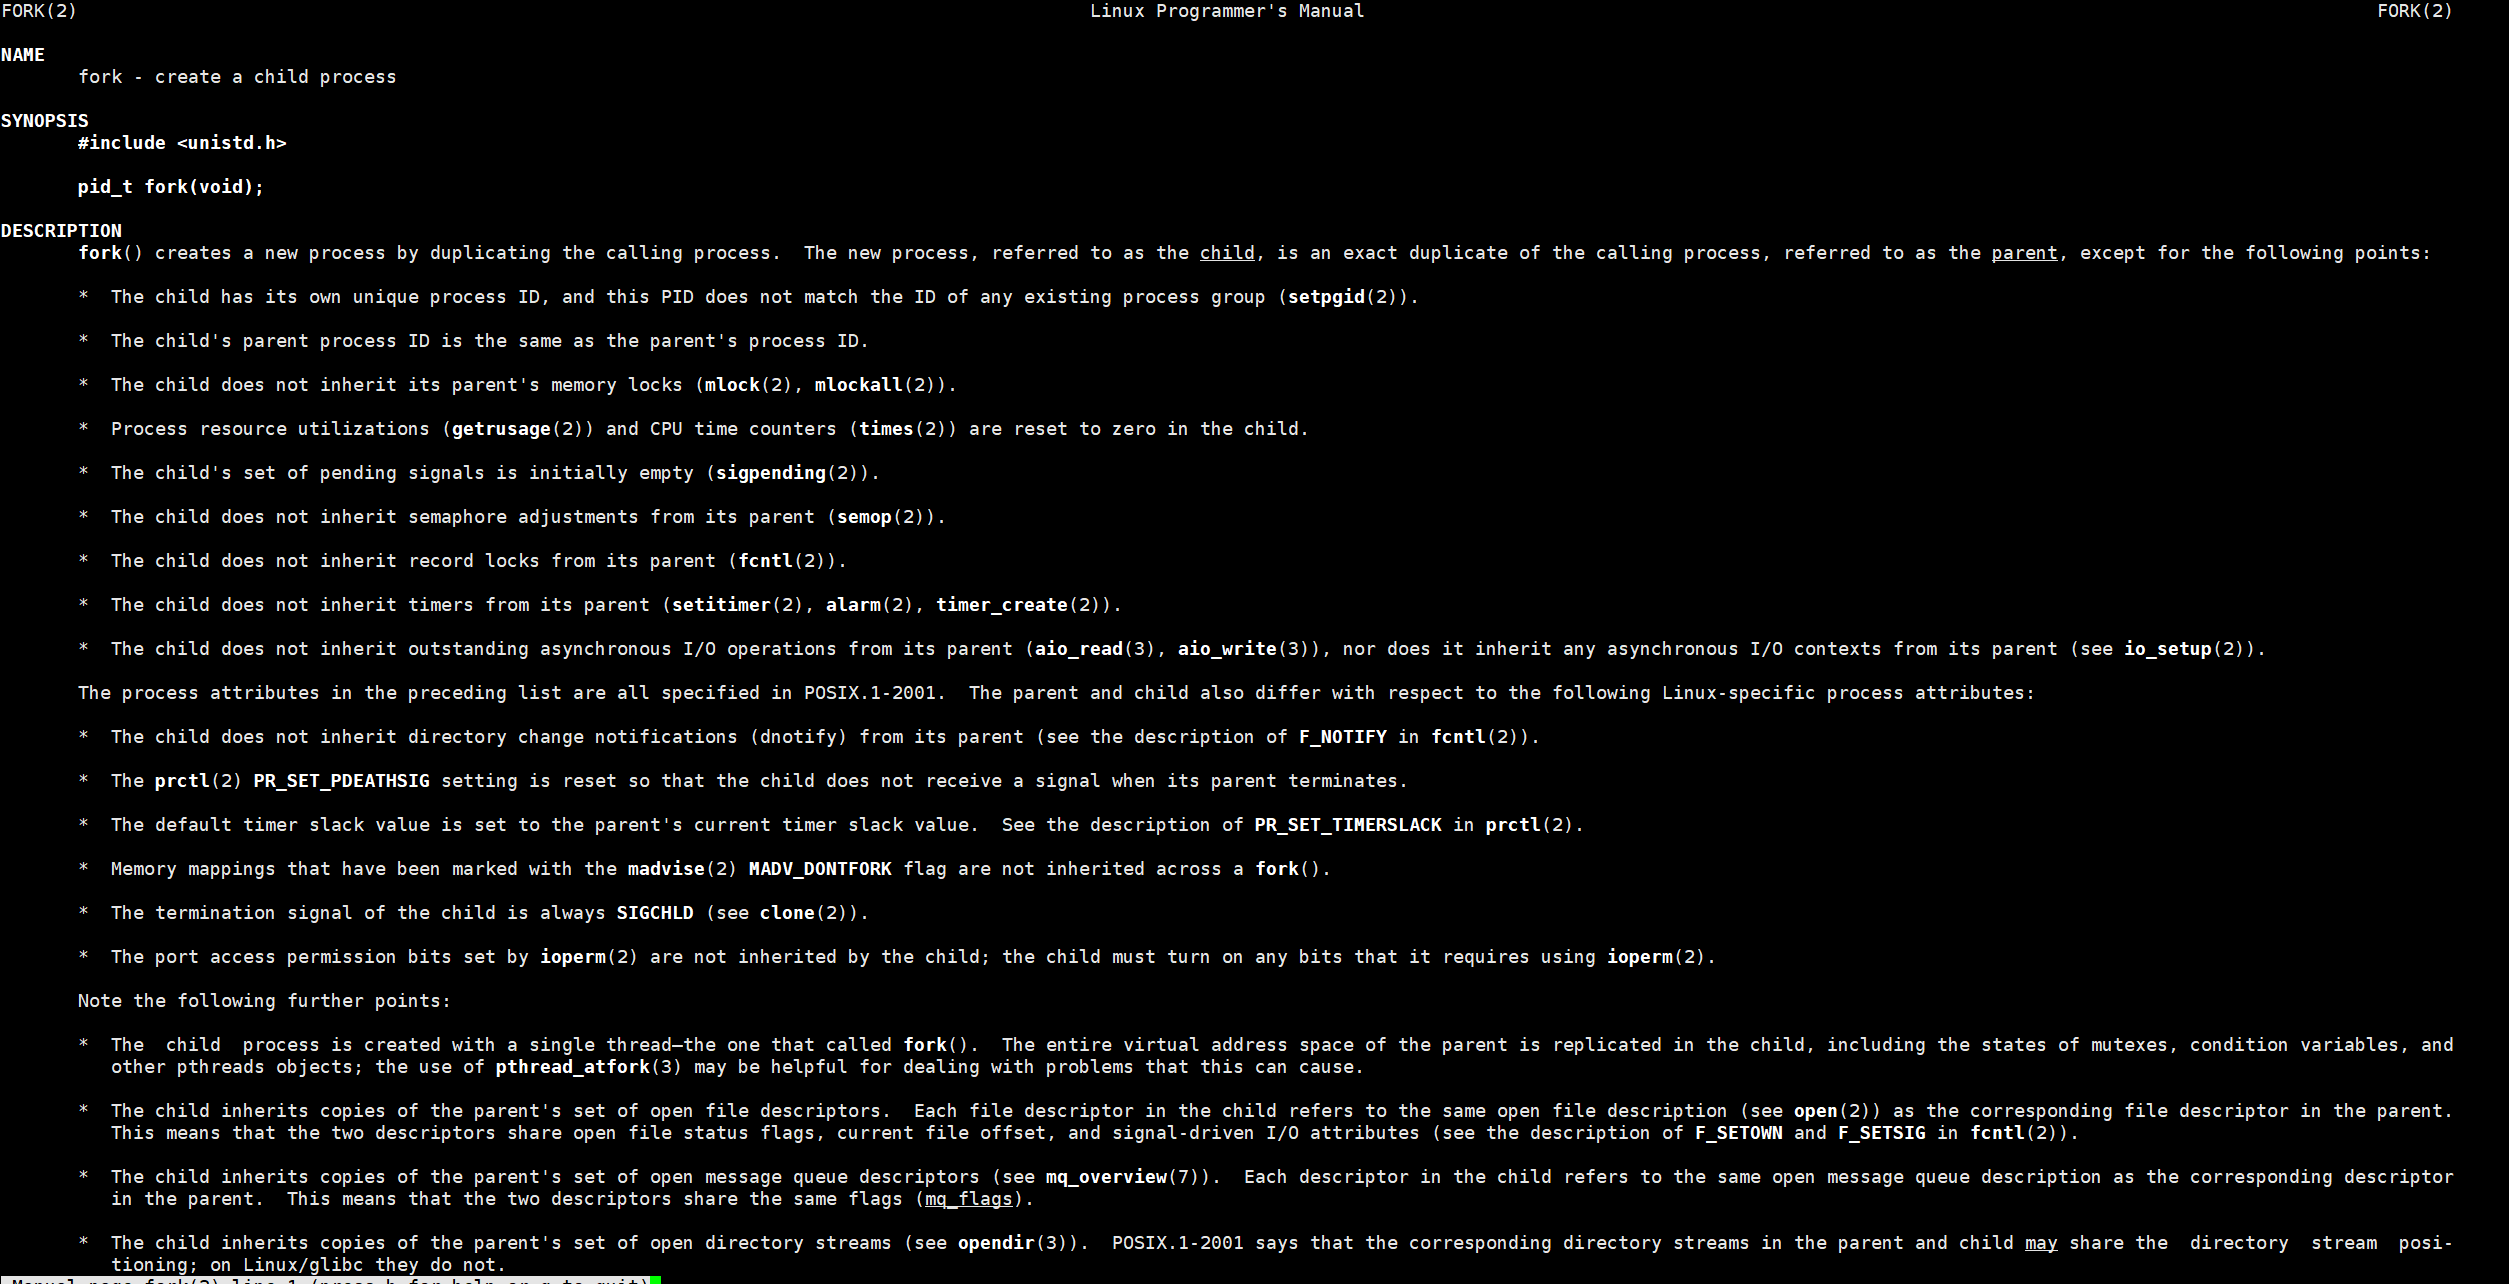
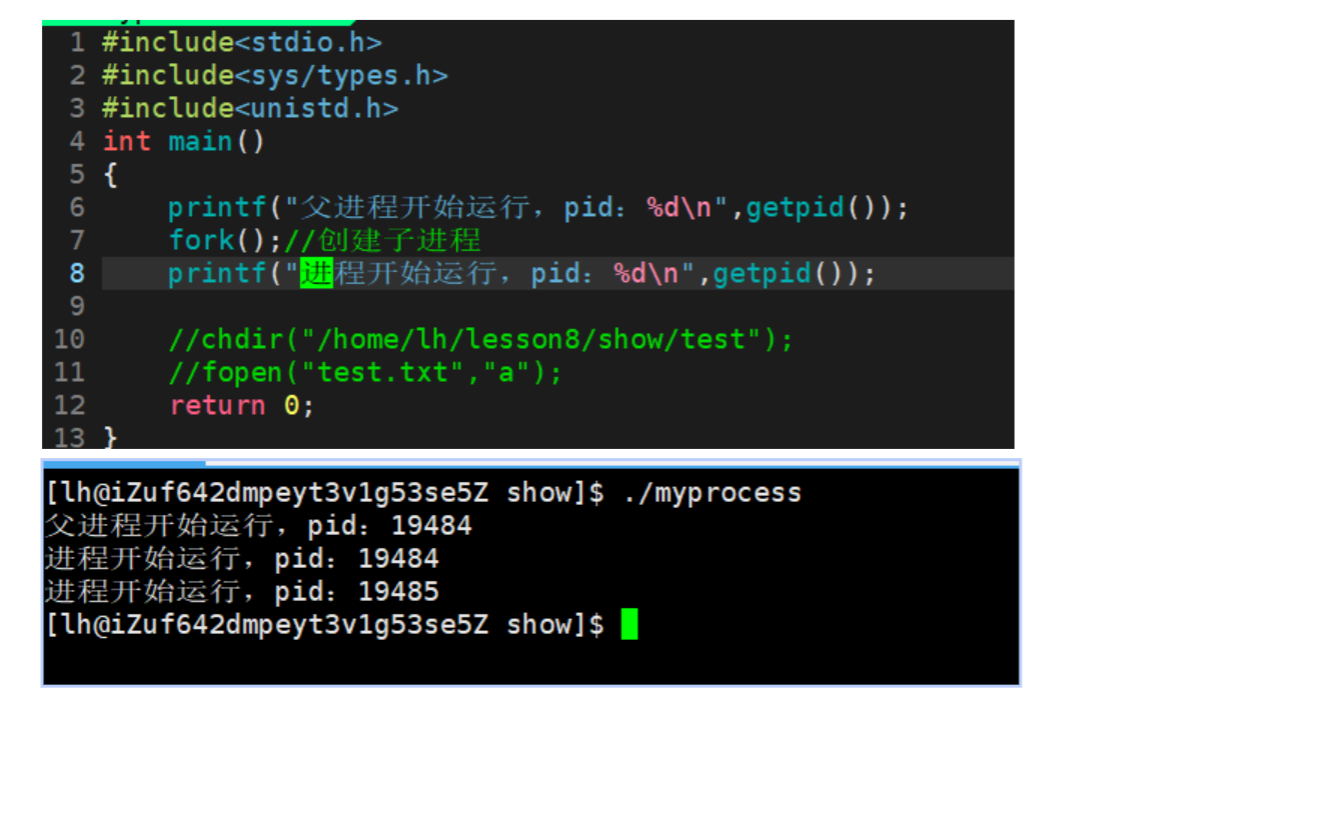
可以发现它执行了两次下面的printf,这是为什么?
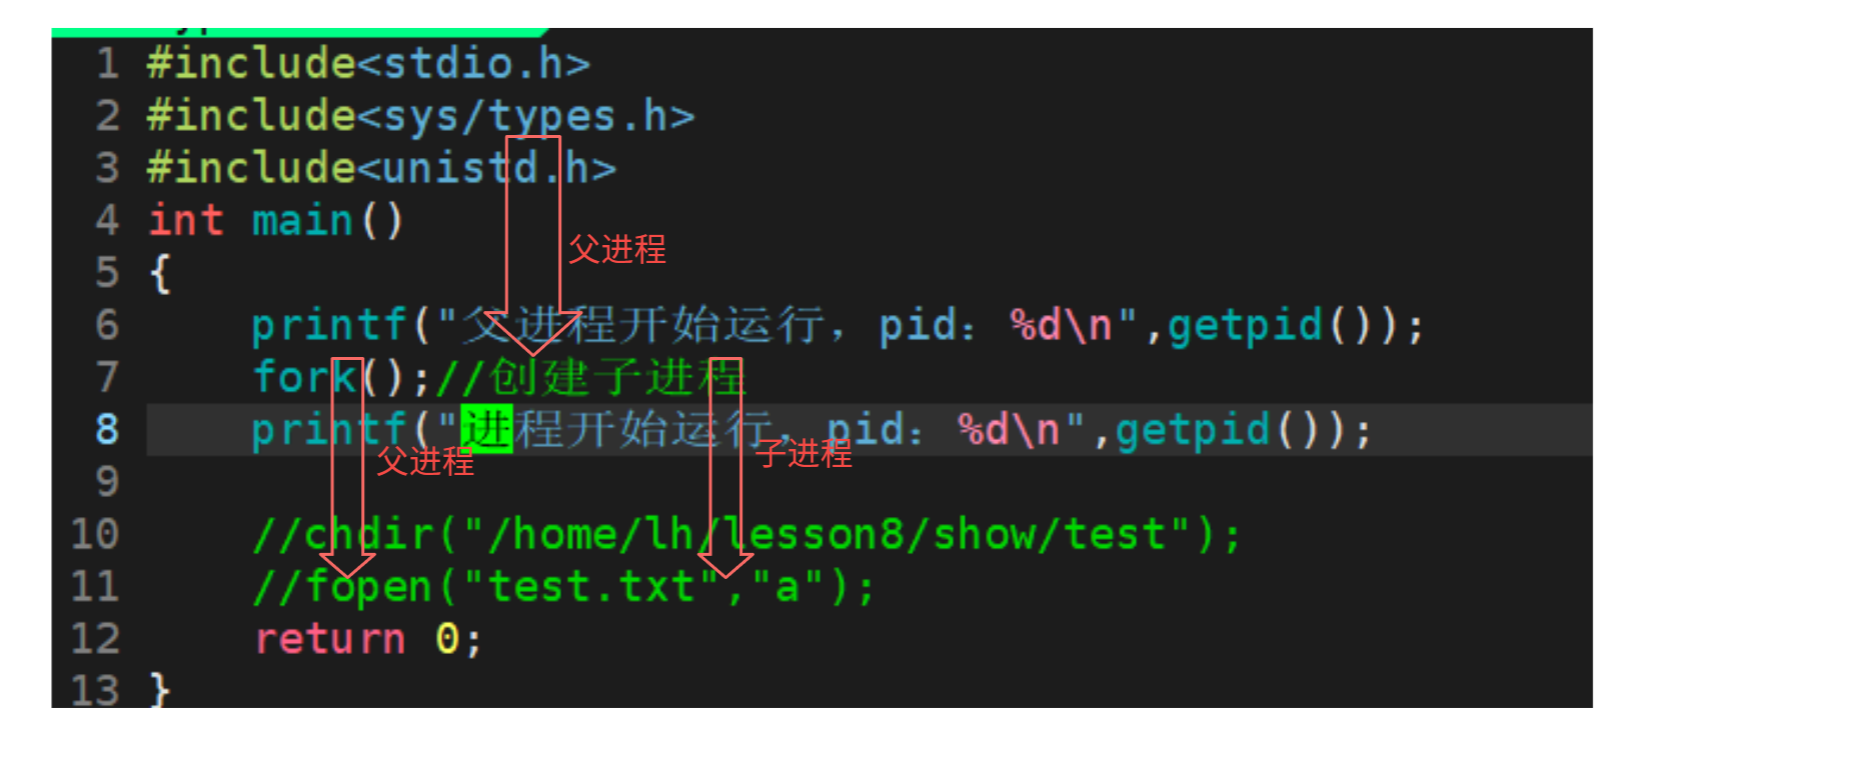
创建子进程后,子进程将于父进程共享一份代码,父进程会继续向下执行代码,因为子进程创建前的代码已经执行完了,子进程便不会从头开始执行代码,而是与父进程一样以当前位置开始向下执行代码。所以创建子进程后的代码会执行两次。
fork函数很特殊,它可以返回两个不同的返回值!
创建子进程成功后,它会向子进程返回0,向父进程返回子进程的pid,这使得父子进程在共享代码的情况下,可以进入代码中相斥的分支:
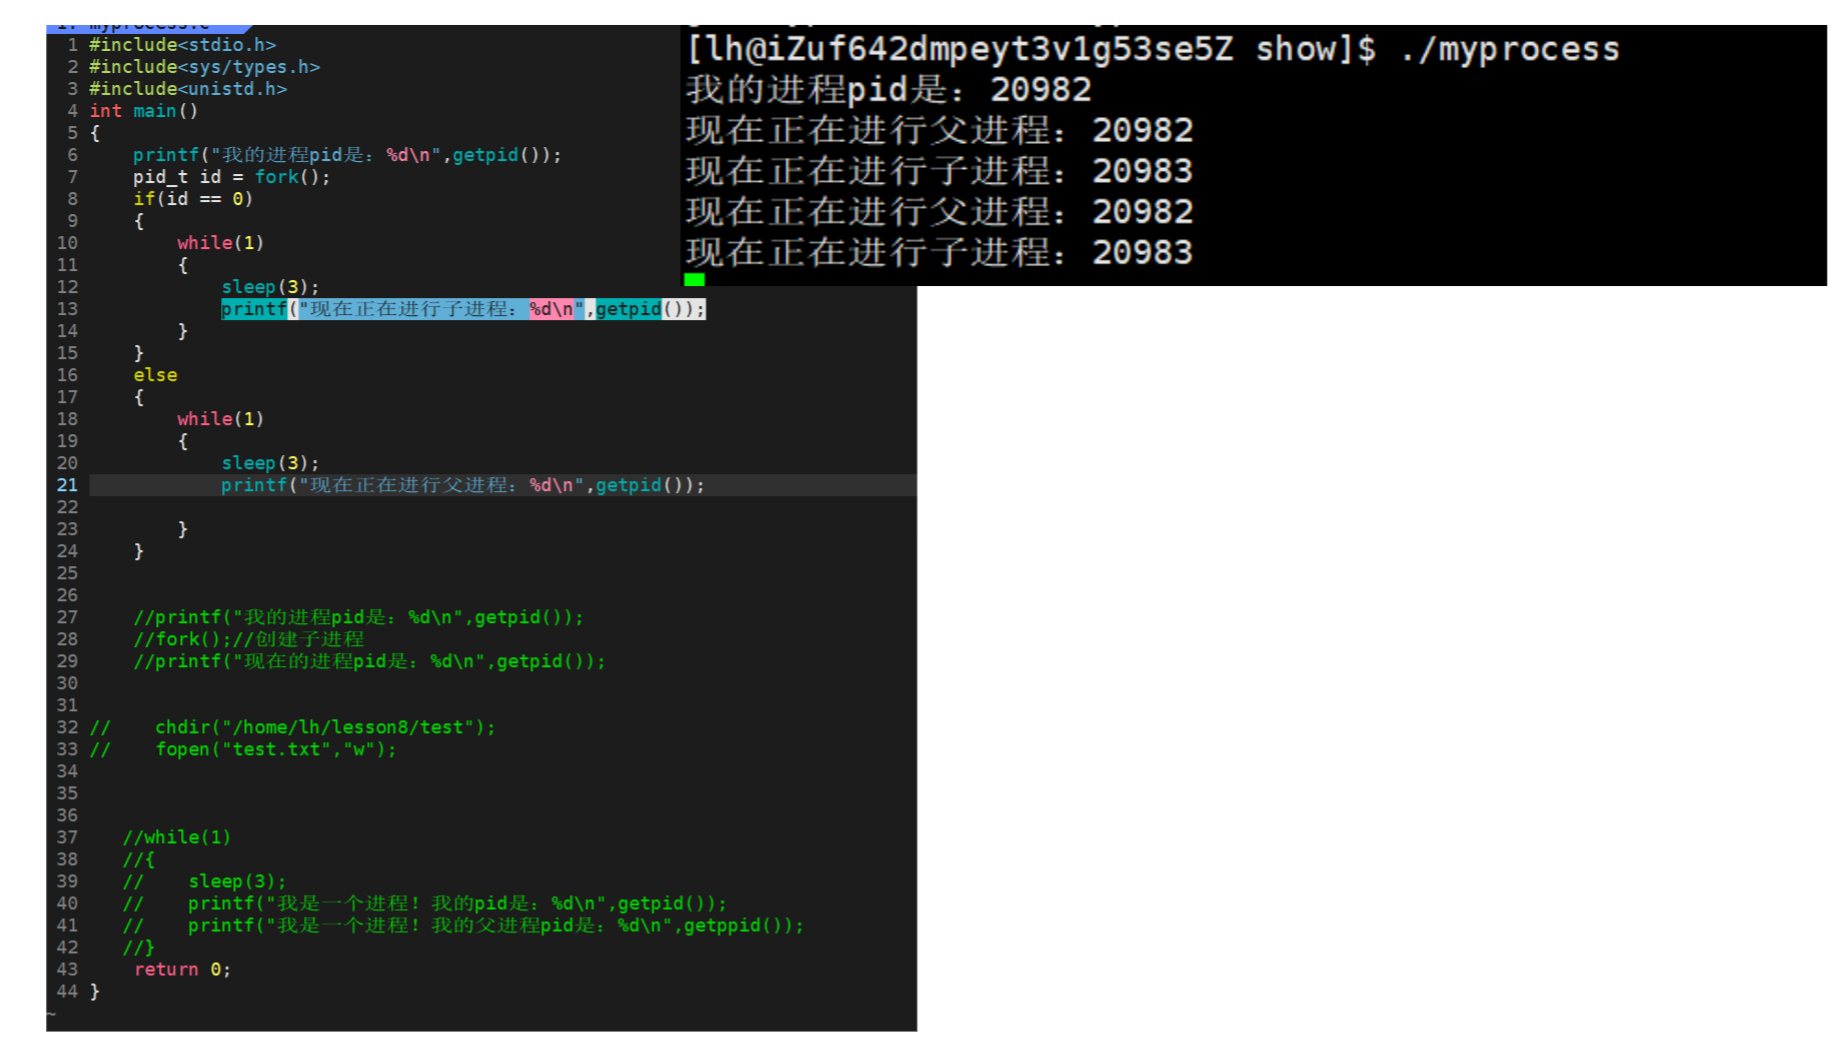
这就会衍生出3个问题:
为什么一个函数可以返回两个返回值?
为什么fork向子进程返回0,向父进程返回子进程pid?
为什么同一个变量可以有两个不同的值?
问题一:
子进程在fork就已经创建好,父进程执行完fork中的return后子进程还会执行一遍;
问题二:
父进程对子进程是一对多的关系,即父进程可以有多个子进程,而子进程只能有一个父进程,因此为了让父进程识别是哪个子进程就需要将该子进程的pid返回给父进程。而子进程只管自己是否创建成功,不需要获取其父进程的pid,因为只有一个;
问题三:
既然子进程和父进程共享一份代码了,我们也许会想代码中的数据(变量)也是父子进程共享的。但实际是如此吗?
在一定条件下是的,这个条件是在各自进程下不修改变量的值。创建子进程后,OS会把父进程PCB的大部分属性拷贝给子进程的PCB,包括代码中变量的属性,这会使父子进程共享同一份变量,但当父子进程任意一方修改某个变量时,OS会把要修改的变量拷贝一份,修改的操作将在拷贝的变量上完成,这个操作为“写实拷贝”。也就是说,我们都用同一个变量来接收fork的返回值了,而fork对父子进程返回值的不同必定会修改代码中的变量,所以父子进程不共享接收fork返回值的变量,所以在不同进程该变量有不同值。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)