ArXiv cs.AI 每日论文精选 | 2026-09-19
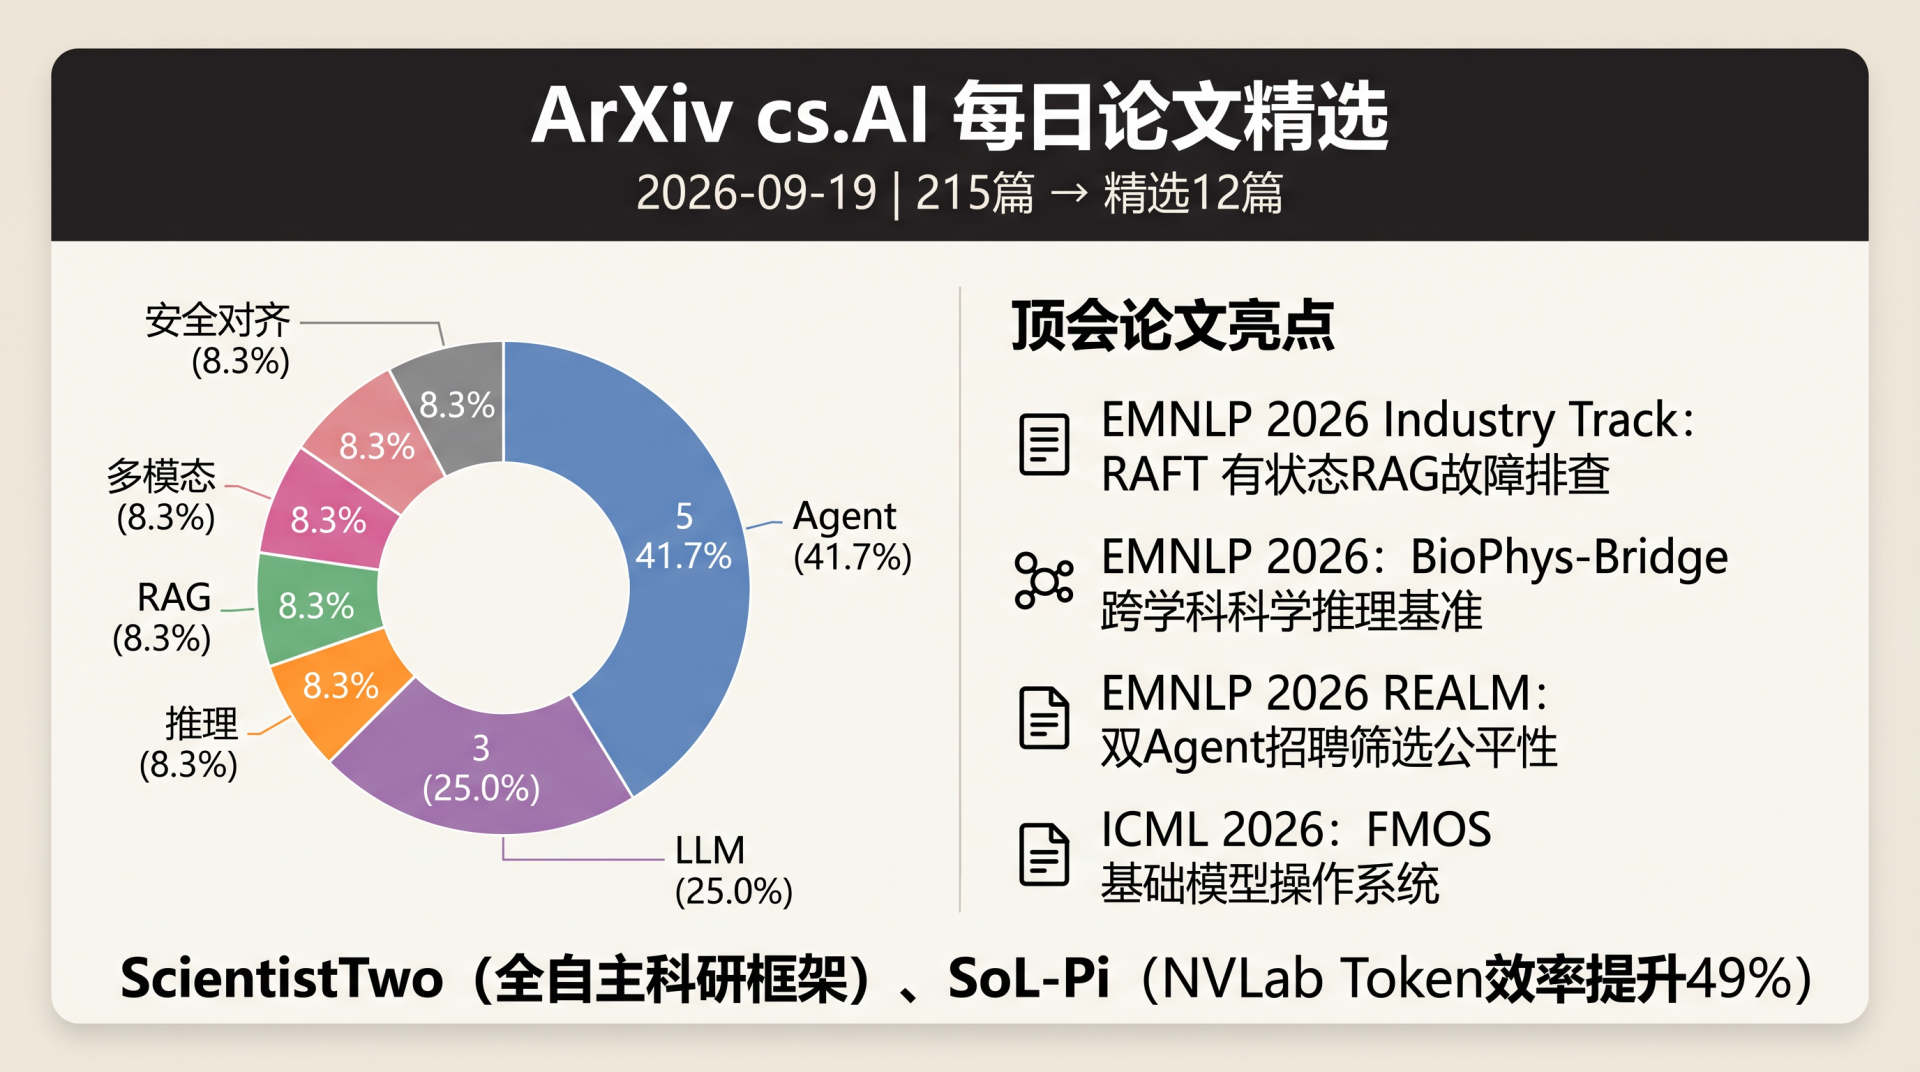
追踪范围:ArXiv cs.AI recent 列表(Artificial Intelligence),过去 24 小时(Fri, 18 Sep 2026) 当日论文总量:215 篇 精选数量:12 篇 筛选标准:顶会论文(ICLR、NeurIPS、ICML、ACL、CVPR、EMNLP 等)+ 热门方向(Agent、LLM、RAG、推理、多模态、安全对齐)
一、标签分布统计表
| 方向 | 篇数 | 占比 |
| Agent | 5 | 41.7% |
| LLM | 3 | 25.0% |
| 推理 | 1 | 8.3% |
| RAG | 1 | 8.3% |
| 多模态 | 1 | 8.3% |
| 安全对齐 | 1 | 8.3% |
| 合计 | 12 | 100% |
二、概览表格
| 序号 | 标题 | 方向 | 亮点 |
| 1 | An Empirical Study of Harness Design for Coding Agents | Agent | 176 组配置的系统消融实验,揭示 Agent Harness 各组件价值边界 |
| 2 | RAFT: A Stateful Retrieval-Augmented Framework for Troubleshooting Agents | RAG | EMNLP 2026 Industry Track,有状态 RAG 框架用于企业故障排查 |
| 3 | SoL-Pi: Recursively Scaling Auto-Research Loops for Efficient Agent Harness | Agent | NVLab 出品,Token 消耗降低 44.7-49.0%,API 成本节省约 1/3 |
| 4 | UnifiedPlayers: Enhance Tool-Integrated Reasoning in Agentic RL | Agent | 三角色协作框架(规划/执行/评估),数学推理提升 3.5%+ |
| 5 | ScientistTwo: Pioneering the Human Knowledge Frontier with Autonomous AI | Agent | 全自主多 Agent 科研框架,自动生成顶会级论文与可执行代码 |
| 6 | An Architecture for Long-Horizon Agents: Levels, Ticks and Cascaded Intelligence | Agent | 长周期 Agent 架构,10 天持续运行实验验证 |
| 7 | Rethinking Multi-Agent Collaboration: When More Is Less | Agent | SAIGE 轻量多 Agent 协作机制,揭示"更多 Agent ≠ 更聪明" |
| 8 | When2Think: Learning Difficulty-Aware Length Control for Efficient Hybrid Reasoning Models | LLM | 难度感知推理长度控制,AIME24 Pass@3 提升 10.0% |
| 9 | Compositional Reasoning in Language Models under RL Post-Training | 推理 | RL 后训练下的组合推理能力研究,发现分解→组合不对称性 |
| 10 | Position: It is Time to Virtualize Foundation Models with a Self-evolving OS Layer | LLM | ICML 2026 Position Paper,提出 FMOS 基础模型操作系统概念 |
| 11 | BioPhys-Bridge: A Benchmark for Interdisciplinary Scientific Reasoning | 多模态 | EMNLP 2026,500 案例跨学科科学推理基准 |
| 12 | When Hiring Becomes Agent-Mediated: Evaluating Access and Recurrence in Two-Agent Résumé Screening | 安全对齐 | EMNLP 2026 REALM Workshop,双 Agent 招聘筛选公平性研究 |
三、详细信息
1. An Empirical Study of Harness Design for Coding Agents
- 作者:Run-Ze Fan, Zihao Zhang, Simin Ma, Yebowen Hu, Shouju Wang, Kaiqiang Song, Fei Liu, Hamed Zamani, Xiaoyang Wang
- ArXiv ID:2609.20804
- 链接:[2609.20804] An Empirical Study of Harness Design for Coding Agents
- 中文摘要:编码 Harness 决定了自主编码 Agent 如何将模型能力转化为长周期软件工程性能。本研究使用轻量级编码 Harness,在固定执行循环下变化三个组件(规划、动作空间、上下文管理),在 SWE-Bench Verified 和 Terminal-Bench 2.1 上评估 4 个模型、176 组匹配配置。核心发现:(1) 上下文管理在预算紧张时价值增大,主要收益来自防止上下文溢出;(2) 先规则删除再 LLM 摘要的策略效率最高;(3) 规划对弱模型是精度支架、对强模型是成本节省器;(4) 预定义工具帮助 bash 能力弱的模型,而 bash 能力强的模型仅需 bash 接口即可高效工作。
- 创新点:首次对 Agent Harness 进行组件级系统消融,提供模型感知和预算感知的 Harness 设计框架。
2. RAFT: A Stateful Retrieval-Augmented Framework for Troubleshooting Agents
- 作者:Mingxuan Zhang, Xiaowen Wang, Anupma Sharan, Zhengyi Chen, Chenyu Diana Zhang, Shanshan Yang, Chittibabu Pacharu
- ArXiv ID:2609.20754
- 链接:[2609.20754] RAFT: A Stateful Retrieval-Augmented Framework for Troubleshooting Agents
- 会议:EMNLP 2026 Industry Track
- 中文摘要:企业客服中的故障排查 Agent 依赖从历史案例中检索可操作指导,但现有 RAG 系统将案例视为静态文档,忽略了其多阶段、有状态的特性。RAFT 将每个已关闭案例抽象为时间线条目链,在条目级别进行检索,返回匹配状态的父案例轨迹。可选的案例级图通过可配置的相似性表示链接案例。在合成基准(Microsoft Learn)和真实 Apache Jira 数据上,RAFT 在每个案例进度阶段的 Case Hit 均优于 vanilla RAG 和 GraphRAG 基线。
- 创新点:提出有状态 RAG 框架,将多阶段案例建模为时间线条目链,在中间状态级别进行匹配检索。
3. SoL-Pi: Recursively Scaling Auto-Research Loops for Efficient Agent Harness
- 作者:Haozhe Liu, Tian Ye, Sensen Gao, Qihang Cao, Yitong Li, Mingchen Zhuge, Duomin Wang, Ruihua Zhang, Ping Luo, Jiawang Bian, Lei Zhu, Ligeng Zhu, Enze Xie, Song Han
- ArXiv ID:2609.20519
- 链接:[2609.20519] SoL-Pi: Recursively Scaling Auto-Research Loops for Efficient Agent Harness
- 代码:https://github.com/NVlabs/SoL-Pi
- 中文摘要:随着编码 Agent 从有监督代码补全走向无人值守的持续探索,Token 效率成为扩展递归自我改进的关键瓶颈。SoL-Pi 采用 RSI 启发的方法在 Harness 层面扩展自动研究循环,通过四种机制(动作执行、上下文压缩、观察处理、委托阅读)在跨多个环境中进行 Harness 滚出。在 51 任务 EdgeBench 评估中,SoL-Pi 在 GPT-5.6 Sol 和 Opus 5 上达到与 Pi 相当的性能,同时将 Token 流量降低 44.7-49.0%,API 成本降低约 1/3,每小时节省 $8.75-$13.50。
- 创新点:NVLab 出品,首次在 Harness 层面实现递归自动研究循环,通过四种机制的进化选择实现大规模 Token 效率提升。
4. UnifiedPlayers: Enhance Tool-Integrated Reasoning in Agentic Reinforcement Learning
- 作者:Wenjie Liao, Liangjie Zhao, Zehong Cao
- ArXiv ID:2609.20089
- 链接:[2609.20089] UnifiedPlayers: Enhance Tool-Integrated Reasoning in Agentic Reinforcement Learning
- 中文摘要:自进化方法通过让工具使用 Agent 自行生成训练数据来减少人工标注需求,但现有方法将轨迹生成与评估分离。UnifiedPlayers 提出三角色协作框架:规划玩家生成任务、执行玩家产出多轮轨迹(含 Python 工具调用)、评估玩家构建可执行验证器。在 GRPO 下设计了角色特定奖励协调三方学习目标。在 2 个模型骨干和 12 个推理基准上,数学推理提升至少 3.5%,通用推理提升 3.9%;学习到的验证器达到 84.2% 对抗检测准确率。
- 创新点:首个将规划、执行、评估三个组件联合自适应的 Agent RL 框架,解决了三方持续互相改变数据/反馈的协调挑战。
5. ScientistTwo: Pioneering the Human Knowledge Frontier with Autonomous AI
- 作者:Jaehyun Nam, Jinsung Yoon, Yanzhou Pan, Yubo Wang, Rui Meng, Parthasarathy Ranganathan, Tomas Pfister
- ArXiv ID:2609.19644
- 链接:[2609.19644] ScientistTwo: Pioneering the Human Knowledge Frontier with Autonomous AI
- 项目主页:ScientistTwo: Autonomous Research at Scale
- 中文摘要:ScientistTwo 是一个完全自主的多 Agent 框架,旨在实现问题驱动的自主科研:给定人类专家提出的根本性挑战,AI 独立导航科学领域、发现理论和经验瓶颈、系统性地扩展知识边界。框架接收初始问题后建立 SOTA 基线、提出新假设、协调专业化 Agent 编排端到端发现周期,无需人类干预。通过多样化数据集和指标进行实验、自动消融研究、闭环模拟同行评审反驳引擎验证发现。在 ICLR、ICML、NeurIPS 顶会论文基准上,ScientistTwo 自主生成专家级可发表论文和完全可验证的可执行代码库,其解决方案持续超越人类 SOTA 模型,并在 AI 自动评审下获得高于人类论文的平均评分。
- 创新点:首个完全自主的多 Agent 科研框架,实现从问题输入到论文输出的端到端无人干预科研周期,包含闭环模拟同行评审。
6. An Architecture for Long-Horizon Agents: Levels, Ticks and Cascaded Intelligence
- 作者:Erik Nijkamp, Anurag Koul, Egor Pakhomov, Bo Pang
- ArXiv ID:2609.19519
- 链接:[2609.19519] An Architecture for Long-Horizon Agents: Levels, Ticks and Cascaded Intelligence
- 中文摘要:语言模型 Agent 被越来越多地要求执行跨越数天或数周的工作(如运维修复或研究项目),这类任务超越了任何上下文窗口、进程和人类关注的间隔。本文论证长周期 Agent 必须在不遗忘的前提下持续运行才能持续学习。从长周期场景中推导出七个瓶颈,提出分层架构的三部分:(i) 按时间尺度索引的层级,每层保持有界文件汇总下层;(ii) 时钟节拍作为自主行动单元;(iii) 级联智能,工作仅在未通过审查时才升级到更强模型。在十天的实验中,Agent 在每天人类仅关注一次的情况下复现了一篇已发表的强化学习结果。
- 创新点:提出长周期 Agent 的三层架构(层级-节拍-级联智能),10 天持续运行实验验证跨上下文重置的知识保持能力。
7. Rethinking Multi-Agent Collaboration: When More Is Less
- 作者:Yishuo Yuan, Yibo Wu, Yihan Zhang, Minyuan Sun, Shenliang Li, Xinkai Ma, Yifan Li, Jiaheng Liu
- ArXiv ID:2609.19759
- 链接:[2609.19759] Rethinking Multi-Agent Collaboration: When More Is Less
- 中文摘要:随着单 Agent 能力的持续提升,多 Agent 协作面临收益递减而上下文开销增加的问题。通过系统分析,本文界定了多 Agent 协作相对于单 Agent 的能力边界:在依赖稀疏的长周期任务中具有系统性优势,而在紧耦合的顺序工作流中单 Agent 更优。提出 SAIGE,基于语义感知增量图演化的轻量多 Agent 协作机制,将协作建模为动态演化图,节点是按需生成的 Agent 实例,边编码通过内容检索建立的语义依赖。实验表明增加 Agent 数量或加深递归层级并不一致提升结果——更多 Agent 不一定更聪明。
- 创新点:首次系统界定多 Agent 协作的能力边界,提出 SAIGE 轻量协作机制,揭示"更多 Agent ≠ 更智能"的关键洞察。
8. When2Think: Learning Difficulty-Aware Length Control for Efficient Hybrid Reasoning Models
- 作者:Jaejun Shim, HyunJin Kim, Young Jin Kim, JinYeong Bak
- ArXiv ID:2609.19671
- 链接:[2609.19671] When2Think: Learning Difficulty-Aware Length Control for Efficient Hybrid Reasoning Models
- 中文摘要:大型推理模型(LRM)在复杂任务上表现强劲但存在系统性低效:对简单问题过度思考、对困难问题思考不足。When2Think 将高效推理形式化为实例自适应计算分配问题,引入 IDAC(实例级难度感知控制)奖励塑形机制,利用预计算参考统计(准确率和 Token 使用量)调控推理深度。结合验证器奖励和批量标准化优势,实现无需学习奖励模型或在线参考模型查询的稳定无批评者优化。在 AIME24 上 Pass@3 提升 10.0%,Token 使用减少 27.9%;在 AIME25 上达到 40.0% Pass@3。
- 创新点:提出实例级难度感知的推理深度控制方法,学习何时使用 System 1(直接回答)vs System 2(扩展推理),实现精度-效率最优权衡。
9. Compositional Reasoning in Language Models under Reinforcement Learning Post-Training
- 作者:Yu He, Yingxi Li, Yifei Wang, Ellen Vitercik
- ArXiv ID:2609.19465
- 链接:[2609.19465] Compositional Reasoning in Language Models under Reinforcement Learning Post-Training
- 中文摘要:组合推理对现实问题求解至关重要:模型必须通过组合已学技能来泛化。本文提出依赖图框架来形式化组合推理,产生三个复杂度递增的组合性层级。使用数据结构任务进行实证(确定性奖励计算和清晰组合结构),发现一致的"分解→组合不对称性":分解技能训练不能可靠迁移到组合任务,而组合任务训练更容易反向迁移到分解任务。提供了该不对称性的理论解释,并在长度外推、结构分布偏移和未见技能迁移上进行进一步评估。在真实工具调用基准上的初步研究表明该不对称性可扩展到实际场景。
- 创新点:首次形式化 RL 后训练下的组合推理能力评估框架,发现并理论解释"分解→组合"迁移不对称性。
10. Position: It is Time to Virtualize Foundation Models with a Self-evolving Operating System Layer
- 作者:Suparna Bhattacharya, Tarun Kumar, Cong Xu, Satish Kumar Mopur, Jiahao Li, Ashish Mishra, Aalap Tripathy, Annmary Justine Koomthanam, Martin Foltin, Ian Foster
- ArXiv ID:2609.19203
- 链接:[2609.19203] Position: It is Time to Virtualize Foundation Models with a Self-evolving Operating System Layer
- 会议:ICML 2026 Position Paper Track
- 中文摘要:AI 应用已从单一基础模型转向复合 Agentic 系统,但当前技术栈仍然碎片化:每个框架都内嵌了状态、记忆、预算和护栏的隐式运行时,导致行为不可移植、治理脆弱。本文提出需要基础模型操作系统(FMOS)——一个虚拟化 FM 交互的系统层,类似于虚拟机抽象物理硬件,为应用提供专属、可信、能力无限的 FM 实例假象。FMOS 内部编排跨记忆层级的知识、模型选择与资源分配、验证与策略执行,像人脑在快速直觉和慢速深思之间切换一样学习何时干预、何时放行推理。
- 创新点:提出 FMOS(Foundation Model Operating System)概念,类比操作系统虚拟化硬件,为基础模型交互提供统一的虚拟化抽象层。
11. BioPhys-Bridge: A Benchmark for Interdisciplinary Scientific Reasoning in Physics-Grounded Biological Research
- 作者:Qingyang Xu
- ArXiv ID:2609.19180
- 链接:[2609.19180] BioPhys-Bridge: A Benchmark for Interdisciplinary Scientific Reasoning in Physics-Grounded Biological Research
- 会议:EMNLP 2026
- 中文摘要:语言模型在分析跨学科科研文献时面临独特挑战。在生物物理研究中,忠实回答需要将观察数据锚定到源证据、通过定量物理模型解释、并关联到生物机制。BioPhys-Bridge 引入新型基准数据集,每个案例包含证据块、稳定证据 ID、定量值、单位、方程、假设、机制和下一步决策作为 QA 和 RAG 的锚定目标。初始版本包含 500 个案例、1,517 个 Agent 面向任务,覆盖 6 个生物领域和 9 个物理模型族。初步评估显示 DeepSeek-V4-Flash 获得最高证据 ID F1。
- 创新点:首个跨学科(生物物理)科学推理基准,包含定量物理模型锚定的证据推理链,支持 RAG 和 Agent 评估。
12. When Hiring Becomes Agent-Mediated: Evaluating Access and Recurrence in Two-Agent Résumé Screening
- 作者:Jian Gao, Hang Jiang
- ArXiv ID:2609.19530
- 链接:https://arxiv.org/abs/2609.19530
- 会议:EMNLP 2026 REALM Workshop
- 中文摘要:招聘是双向的:雇主评估匹配度,候选人展示并辩护资质证据。然而简历筛选通常被自动化为对简历-职位对的静态单次判断。本文研究双 Agent 替代方案:雇主侧和候选人侧 Agent 分别代表双方角色,交换证据并在决定前更新判断。在 600 组构建的简历-职位对上使用 GPT-5.5 和 Claude Opus 4.7 进行实验。双 Agent 筛选推进更多申请(GPT-5.5: 33.3%→39.3%;Opus 4.7: 34.0%→35.5%)。但这不是均匀放宽:双 Agent 筛选也会拒绝单次判断通过的申请。在类似通过量下,两种程序推进不同的申请,且没有单次阈值能一致恢复双 Agent 筛选的选择。
- 创新点:首次研究双 Agent(雇主+候选人)招聘筛选场景,揭示筛选程序(而非仅模型)塑造了谁进入人工评审以及该准入的可靠递归性。
四、顶会论文汇总
| 序号 | 论文标题 | 会议 |
| 2 | RAFT: A Stateful Retrieval-Augmented Framework for Troubleshooting Agents | EMNLP 2026 Industry Track |
| 10 | Position: It is Time to Virtualize Foundation Models with a Self-evolving OS Layer | ICML 2026 Position Paper Track |
| 11 | BioPhys-Bridge: A Benchmark for Interdisciplinary Scientific Reasoning | EMNLP 2026 |
| 12 | When Hiring Becomes Agent-Mediated | EMNLP 2026 REALM Workshop |
注:今日精选 12 篇中 4 篇为顶会论文(3 篇 EMNLP 2026 相关、1 篇 ICML 2026),另有 ScientistTwo(对标 ICLR/ICML/NeurIPS 顶会论文基准)和 SoL-Pi(NVLab 开源项目)为重磅研究。
五、重要开源项目
| 项目 | 来源 | 说明 |
| SoL-Pi | NVLabs | Agent Harness 自动研究循环,Token 效率提升 44.7-49.0% |
| ScientistTwo | 全自主多 Agent 科研框架,生成顶会级论文与可执行代码 |
报告生成时间:2026-09-19 10:00 (Asia/Shanghai) 数据来源:ArXiv cs.AI recent (Fri, 18 Sep 2026)

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 0
 0
- 0


 已为社区贡献4条内容

所有评论(0)