C++ Actor Framework学习:CAF 调度器(Scheduler)详解
1. N 个 Actor 映射到 M 条线程
CAF 运行时的一个核心设计是:把 NNN 个 Actor 映射到 MMM 条线程上运行,其中通常 N≫MN \gg MN≫M(Actor 的数量远远多于线程的数量)。这意味着 CAF 并不会给每一个 Actor 都分配一条独立的操作系统线程,而是让少量的线程去"轮流"执行大量的 Actor。
用 CAF 写应用程序时,推荐的做法是把一个大任务拆分成很多个相互独立的小步骤,每个小步骤都实现成一个 Actor。这样一来,单个 Actor 一次要做的计算量,相比整个程序的总运行时间来说是很小的一部分。这种"拆得足够细"的编程方式,正好能让程序在多核硬件上尽量逼近 Amdahl 定律描述的理论加速上限。
2. Amdahl 定律与"任务拆分"的关系
Amdahl 定律给出了一个程序在多核环境下能获得的加速比的理论上限。假设一个程序里,能够并行执行的部分占总工作量的比例为 ppp(0≤p≤10 \le p \le 10≤p≤1),剩下的 1−p1-p1−p 部分只能串行执行,那么用 nnn 个处理器并行执行整个程序时,能获得的加速比 S(n)S(n)S(n) 满足:
S(n)=1(1−p)+pnS(n) = \frac{1}{(1-p) + \dfrac{p}{n}}S(n)=(1−p)+np1
从这个公式可以看出:ppp 越大(也就是可并行部分占比越高),加速比的理论上限就越高;反过来,如果程序里有大段代码必须串行执行(1−p1-p1−p 较大),无论用多少个处理器,加速效果都会被这部分串行代码"卡住"。
把一个大任务拆分成很多个独立的、可以并发执行的 Actor,本质上就是在尽量提高 ppp 的值:Actor 之间除了通过消息传递交换数据外,各自的内部计算是完全独立、互不阻塞的,拆得越细、独立性越强,可以并行执行的部分占比就越接近 111,从而让程序在多核硬件上跑得越接近理论最优加速比。
3. Actor 是一台轻量级的状态机
正因为要支持"任务拆得很细、Actor 数量很多"这种编程方式,CAF 把每一个 Actor 都建模成一台轻量级的状态机,而不是绑定一条专属线程。一个 Actor 大致会在下面几种状态之间切换:
- 等待中(waiting):邮箱里暂时没有可处理的消息,Actor 处于空闲状态,不占用任何线程;
- 就绪(ready):一旦邮箱收到新消息,这个 Actor 的状态会立刻变成"就绪",表示它现在有事情可做了,等待被调度器挑中去执行;
- 运行中(running):调度器把这个 Actor 分配给某条工作线程,正在实际执行它的消息处理逻辑;
- 终止(terminated):Actor 退出,不会再被调度。
4. 阻塞调用带来的问题与 detached 选项
CAF 的调度器是在用户空间实现的,这意味着它没有能力像操作系统内核那样"强制打断"一个正在运行的 Actor。这就带来一个隐患:如果某个 Actor 内部调用了阻塞式的系统调用(比如同步的文件 I/O、网络 I/O,或者任何会让线程挂起等待的操作),这个线程会被一直占用,调度器没有办法把它抢回来去执行别的 Actor。
这种行为不"配合"调度器的 Actor,文档里称之为"不合作的"(uncooperative)Actor。如果任由它按普通方式被调度,轻则造成负载不均衡(有的线程在忙阻塞调用,有的线程闲着没活干),重则导致"饥饿"(starvation,也就是别的 Actor 一直等不到线程去执行它们)。
解决办法是:程序员在 spawn 这类 Actor 的时候,显式地加上 detached 选项,告诉 CAF"这个 Actor 需要一条专属线程,不要把它放进普通的调度线程池里":
system.spawn<detached>(my_actor_fun);
这样一来,即使 my_actor_fun 内部长时间阻塞,也只会占用它自己专属的那一条线程,完全不会影响调度器线程池里其它 Actor 的正常执行。
5. 外部事件与内部事件
调度器除了要管理 Actor 本身,还承担着"沟通 Actor 世界和非 Actor 世界"的职责。为此,调度器会区分两种性质不同的事件:
| 事件类型 | 触发场景 |
|---|---|
| 外部事件(external event) | 一个 Actor 是从非 Actor 上下文(比如 main 函数)被创建出来的;或者某个 Actor 收到了一条不受调度器管理的线程发来的消息 |
| 内部事件(internal event) | 已经处于调度器管理之下的某个 Actor,执行了发送消息或者创建新 Actor 的操作 |
区分这两种事件的意义在于:外部事件意味着调度器需要处理"来自外部世界、无法预先掌控节奏"的输入,而内部事件则完全发生在调度器已经掌握的执行流程内部,两者在实现上(比如要不要考虑线程同步、要不要走加锁的队列)往往需要不同的处理方式。这也正好呼应了调度器策略里 central_enqueue(对应外部事件)和 internal_enqueue(对应内部事件)这两个不同入口的设计初衷。
6. 完整可运行的代码示例
下面这份代码演示了两种典型场景:一批"轻量、短生命周期"的普通调度 Actor,以及一个会执行阻塞操作、需要用 detached 选项单独处理的"不合作" Actor。
// scheduler_demo.cpp
//
// 编译方式示例(需要先安装 CAF 库):
//   g++ -std=c++17 scheduler_demo.cpp -lcaf_core -lcaf_io -o scheduler_demo
// 运行:
//   ./scheduler_demo
#include <chrono>
#include <cstdint>
#include <thread>
#include "caf/all.hpp"
using namespace caf;
using namespace std::chrono_literals;
// ========================================================================
// 轻量级、由调度器正常托管的 Actor。
// 每个实例只做一次很小的计算就结束,属于"任务拆得很细"的典型写法:
// 单个 Actor 的运行时间相比整个程序的总运行时间来说微不足道,
// 这正是第 2 节里提到的、有利于提高可并行比例 p 的编程方式。
// ========================================================================
behavior lightweight_worker(event_based_actor* self, int id) {
  return {
    [self, id](int32_t task_id) {
      // 模拟一次很快就能完成的小计算,不涉及任何阻塞操作
      int32_t result = task_id * task_id;
      self->println("[worker-{}] 收到任务 {},计算结果 = {}", id, task_id,
                     result);
    }
  };
}
// ========================================================================
// "不合作"的 Actor:内部执行了一次耗时的阻塞调用
// (这里用 sleep 模拟一次耗时的同步 I/O 操作)。
// 注意函数的第一个参数是 blocking_actor*,
// 这类 Actor 本身就需要调用 receive() 之类的阻塞式 API,
// 必须搭配 detached 选项来 spawn,让它拥有一条独立的线程。
// ========================================================================
void blocking_actor_fn(blocking_actor* self) {
  self->println("[blocking-actor] 开始执行一次耗时 2 秒的阻塞操作……");
  // 真实场景里这里可能是同步的磁盘读写、阻塞式的网络调用等,
  // 这里用 sleep_for 模拟"线程被占住动弹不得"的效果。
  std::this_thread::sleep_for(2s);
  self->println("[blocking-actor] 阻塞操作完成,Actor 即将退出");
}
void caf_main(actor_system& sys) {
  // 正常调度:连续 spawn 三个轻量 Actor,它们会被调度器
  // 动态分配到内部的工作线程池上执行,互相之间不需要专属线程。
  for (int i = 0; i < 3; ++i) {
    auto w = sys.spawn(lightweight_worker, i);
    anon_send(w, int32_t{i + 1});
  }
  // 用 detached 选项 spawn 阻塞式 Actor:
  // 它会获得一条专属的操作系统线程,
  // 不会占用调度器工作线程池里的名额,
  // 因此不管它阻塞多久,都不会影响上面那三个轻量 Actor 的正常执行。
  sys.spawn<detached>(blocking_actor_fn);
}
CAF_MAIN()
代码关键点梳理
lightweight_worker的设计意图:每个实例只处理一条消息、做一次乘法就结束,刻意保持"轻、快、独立",对应第 1、2 节里"把任务拆成很多独立小步骤"这一编程思路。blocking_actor_fn为什么需要blocking_actor*:因为它内部要执行阻塞式操作,本质上属于"主动占用线程等待"的 Actor,CAF 要求这类需要阻塞行为的函数以blocking_actor*作为第一个参数。sys.spawn<detached>(blocking_actor_fn):detached这个模板参数明确告诉 CAF——不要把这个 Actor 放进普通调度线程池,而是单独为它开一条线程。这样即使它内部sleep_for(2s)阻塞了 2 秒,也完全不会拖慢其它 Actor 的执行。- 没有加
detached的三个lightweight_worker:它们都是"合作型"的 Actor(不会执行阻塞调用),因此可以放心交给调度器的工作线程池去动态调度,充分利用多核硬件的并发能力。
7. 调度过程时序图
下图展示了 caf_main 里普通调度 Actor 与 detached Actor 各自的执行路径——重点体现"detached Actor 阻塞 2 秒"完全不会影响调度线程池里其它 Actor 正常运行这一点:
8. N:M 映射关系一览图
              N 个 Actor(数量多、生命周期短)
   ┌───┬───┬───┬───┬───┬───┬───┬───┬───┬───┐
   │ a1│ a2│ a3│ a4│ a5│ a6│ a7│ a8│ a9│a10│ ...
   └─┬─┴─┬─┴─┬─┴─┬─┴─┬─┴─┬─┴─┬─┴─┬─┴─┬─┴─┬─┘
     │   │   │   │   │   │   │   │   │   │
     └───┴───┴───┴───┴───┴───┴───┴───┴───┘
                     │ 调度器动态分配
                     ▼
        M 条工作线程(数量少、长期存在)
        ┌────────┐ ┌────────┐ ┌────────┐
        │thread-1 │ │thread-2 │ │thread-3 │
        └────────┘ └────────┘ └────────┘
  额外的 detached Actor 不占用上面这 M 条线程,
  而是各自拥有独立的专属线程:
        ┌──────────────────┐
        │ detached-thread-A │ ← 专门给某个阻塞式Actor使用
        └──────────────────┘
这张图想强调的重点是:绝大多数"合作型"的轻量 Actor 共享固定数量(MMM 条)的调度线程池,靠调度器动态分配来实现"NNN 远大于 MMM"时依然高效运转;而少数会执行阻塞调用的"不合作"Actor,则应该主动通过 detached 选项跳出这个共享线程池,各自拿到一条独立线程,避免拖累整个调度系统的吞吐效率。
CAF 调度器策略(Policies)详解
1. 调度器的基本组成:协调者 + 工作者
CAF 的调度器由两类角色组成:
- 一个协调者(coordinator):它是整个调度系统对外的"入口",主要作用是在"Actor 世界"和"非 Actor 世界"之间搭一座桥。比如你在
main函数里调用sys.spawn(...),这行代码本身并不是在某个 Actor 内部执行的,而是运行在普通的、非 Actor 的上下文里——这时候就需要协调者出面,把"新建了一个 Actor,它已经准备好接收消息了"这件事,转交给真正负责执行任务的工作者去处理。需要注意的是,协调者不一定是一个"活跃运行"的实体(比如不一定对应一个独立的线程),它更多时候只是一个起桥梁作用的单例对象。 - 一组工作者(worker):真正负责执行 Actor 任务的角色,每个 worker 通常对应一个独立的执行单元(在多线程实现里往往就是一条线程),不断地从自己的任务队列里取出准备就绪的任务并执行。
2. 为什么要做成"策略(policy)"
CAF 没有把调度器的实现写死,而是采用了"策略模式"(policy-based design):调度逻辑被抽象成一个统一的接口,具体怎么存储任务队列、怎么分配任务、怎么统计执行时间,全部交给一个"策略类"去实现。这样做的好处是:只要实现了同样的接口,你完全可以换一套自己的调度策略(比如换一种任务队列的数据结构,或者换一种任务分配算法),而不需要改动 CAF 其它部分的代码。
下面这个"概念类"列出了一个调度策略必须提供的全部内容(这不是一份可以直接编译的代码,而是用来说明"接口长什么样"的示意):
struct scheduler_policy {
  // 两个"数据结构":分别给协调者和工作者附加自定义的数据成员,
  // 比如任务队列、计数器、统计信息等,具体存什么完全由策略自己决定。
  struct coordinator_data;
  struct worker_data;
  // 三种"把新任务放进调度系统"的入口,分别对应不同的调用场景(下文详细展开)
  void central_enqueue(Coordinator* self, resumable* job);
  void external_enqueue(Worker* self, resumable* job);
  void internal_enqueue(Worker* self, resumable* job);
  // 任务这一轮配额用完时,重新排队等待下一轮
  void resume_job_later(Worker* self, resumable* job);
  // worker 从自己的队列里取出下一个待执行任务
  resumable* dequeue(Worker* self);
  // 任务执行前后的钩子函数,方便统计单个任务的执行耗时
  void before_resume(Worker* self, resumable* job);
  void after_resume(Worker* self, resumable* job);
  // 任务彻底执行完毕(即将被销毁)时的钩子函数
  void after_completion(Worker* self, resumable* job);
};
coordinator_data 和 worker_data 这两个数据结构,就是策略给协调者和工作者"附加"的自定义状态(比如任务队列本身),这一点非常关键:调度器本身的状态到底长什么样,完全由策略决定,开发者因此能够完全掌控调度器内部的数据组织方式。
3. 三种"入队"函数分别在什么时候被调用
一个新的工作项(通常就是一个刚变成"就绪"状态的 Actor)要被交给调度系统时,会触发下面三种函数之一,具体调用哪一种,取决于"是谁触发的这次调度":
| 函数名 | 调用场景 | 第一个参数的含义 |
|---|---|---|
central_enqueue | 非 Actor 代码与 Actor 系统发生交互的时候被调用,比如在 main 函数里直接 spawn 一个 Actor | 指向协调者单例的指针 |
external_enqueue | 表示协调者(或者另一个 worker)把某个任务转交给指定的 worker,这个函数本身不会被 CAF 主动直接调用,而是被其它 enqueue 函数在内部调用来完成"转交"这个动作 | 接收新任务的那个具体 worker |
internal_enqueue | 一个 Actor 在处理消息的过程中,与系统里的其它 Actor发生了交互(比如把一个原本空闲的 Actor 唤醒),这种"Actor 之间互相触发"的场景下调用 | 当前正在执行任务的 worker |
可以这样理解三者的关系:central_enqueue 处理的是"外部世界 → 调度系统"的入口流量;internal_enqueue 处理的是"调度系统内部,一个 Actor 唤醒了另一个 Actor"这种内部流量;而 external_enqueue 则是这两种流量最终"落地"到某个具体 worker 队列里时,统一会经过的一步。
4. 任务重新排队与取出:resume_job_later 与 dequeue
CAF 里每个 Actor 单次被调度执行时,能处理的消息数量是有上限的(这个上限通常可以配置),我们把这个上限记作 MMM(对应文档里说的"每轮最多处理的消息数")。如果一个 Actor 这一轮要处理的消息数量 nnn 大于 MMM,它并不会一次性把这 nnn 条全部处理完,而是最多处理
min(n,M)\min(n, M)min(n,M)
条消息,剩下的留到下一轮再处理。当一个 Actor 达到这个上限、但还没有把所有消息都处理完时,就会调用 resume_job_later,把它重新放回调度队列,等待被再次调度;而 worker 想要获取下一个可执行的任务时,则调用 dequeue,从自己的队列(或者其它来源)里取出一个任务来执行。
5. 三个"钩子函数":观测调度细节
最后三个函数并不参与"任务应该被放到哪里、什么时候执行"这些决策,它们纯粹是给开发者提供的观测点:
before_resume(self, job):某个任务真正开始执行之前调用,适合在这里记录开始时间;after_resume(self, job):这个任务本轮执行结束之后调用(不管这一轮是处理完了全部消息,还是因为达到配额上限而中途暂停),适合在这里记录结束时间、算出这一轮耗时;after_completion(self, job):这个任务彻底执行完毕(状态变成 done)之后、真正被销毁之前调用,适合在这里做一些收尾工作,比如统计这个 Actor 一生总共存活了多久。
有了这三个钩子,开发者就可以在不修改核心调度逻辑的前提下,精细地观察"调度顺序"和"每个任务的实际执行耗时"这些信息。
6. 完整可运行的教学模拟代码
真实的 CAF 调度器是多线程、无锁队列实现的,直接拿来演示不太方便观察执行顺序。下面这份代码用纯标准库、单线程的方式,模拟了协调者、worker、以及上面这些策略函数之间的调用关系,方便直观地看清楚整个调用时机——它不依赖 CAF 库本身,可以直接编译运行。
// scheduler_policy_demo.cpp
//
// 编译方式:
//   g++ -std=c++17 scheduler_policy_demo.cpp -o scheduler_policy_demo
// 运行:
//   ./scheduler_policy_demo
//
// 说明:这是一个教学用的简化模拟程序,用单线程顺序执行来还原
// CAF 调度器策略里 central_enqueue / external_enqueue / internal_enqueue /
// resume_job_later / dequeue / before_resume / after_resume / after_completion
// 这几个函数各自的调用时机,不代表真实 CAF 调度器的具体实现细节。
#include <deque>
#include <iostream>
#include <string>
#include <vector>
// ------------------------------------------------------------------
// resumable:所有"可被调度执行的工作项"的抽象基类,
// 对应真实 CAF 里"一个就绪的 Actor 被包装成的可调度对象"。
// ------------------------------------------------------------------
class resumable {
public:
  enum class resume_result {
    done,      // 这个任务已经彻底执行完毕
    more_work  // 这一轮配额用完了,但还有剩余工作没做完
  };
  virtual ~resumable() = default;
  // run() 模拟"处理一批消息":
  // max_messages 表示这一轮最多能处理多少条消息。
  virtual resume_result run(int max_messages) = 0;
  virtual std::string name() const = 0;
};
// ------------------------------------------------------------------
// demo_actor:模拟一个"待处理消息数量为 pending_"的 Actor 任务
// ------------------------------------------------------------------
class demo_actor : public resumable {
public:
  demo_actor(std::string id, int pending_messages)
    : id_(std::move(id)), pending_(pending_messages) {}
  resume_result run(int max_messages) override {
    int processed = 0;
    // 每轮最多处理 max_messages 条,处理不完就留到下一轮
    while (pending_ > 0 && processed < max_messages) {
      --pending_;
      ++processed;
    }
    std::cout << "  [" << id_ << "] 本轮处理了 " << processed
              << " 条消息,剩余 " << pending_ << " 条" << std::endl;
    return pending_ > 0 ? resume_result::more_work : resume_result::done;
  }
  std::string name() const override { return id_; }
private:
  std::string id_;
  int pending_; // 还剩多少条消息没处理
};
// 前置声明,因为下面的策略函数需要引用这两个类型
class coordinator;
class worker;
// ------------------------------------------------------------------
// worker:模拟调度器里的一个工作者,内部持有一个任务队列,
// 这个队列就相当于文档里说的"policy 提供的 worker_data"。
// ------------------------------------------------------------------
class worker {
public:
  explicit worker(std::string id) : id_(std::move(id)) {}
  std::deque<resumable*>& queue() { return queue_; }
  const std::string& id() const { return id_; }
private:
  std::string id_;
  std::deque<resumable*> queue_; // 对应 worker_data
};
// ------------------------------------------------------------------
// coordinator:调度器的协调者,负责把外部提交的新任务分发给某个 worker,
// 内部持有 worker 列表,对应文档里说的"policy 提供的 coordinator_data"。
// ------------------------------------------------------------------
class coordinator {
public:
  void add_worker(worker* w) { workers_.push_back(w); }
  const std::vector<worker*>& workers() const { return workers_; }
private:
  std::vector<worker*> workers_; // 对应 coordinator_data
};
// ------------------------------------------------------------------
// scheduler_policy_demo:策略的具体实现,对应文档里的 scheduler_policy。
// ------------------------------------------------------------------
struct scheduler_policy_demo {
  // 非 Actor 代码(比如 main 函数)把新任务交给协调者
  static void central_enqueue(coordinator* self, resumable* job) {
    std::cout << "[central_enqueue] 协调者收到新任务: " << job->name()
              << std::endl;
    // 简化的分配策略:固定丢给第一个 worker
    auto target = self->workers().front();
    external_enqueue(target, job);
  }
  // 把任务转交给某个具体 worker 的队列,
  // 这个函数不会被 CAF 直接调用,而是被别的 enqueue 函数内部调用
  static void external_enqueue(worker* self, resumable* job) {
    std::cout << "[external_enqueue] 任务 " << job->name()
              << " 被转交给 worker " << self->id() << std::endl;
    self->queue().push_back(job);
  }
  // 一个 Actor 在处理消息过程中,唤醒了另一个 Actor,
  // 直接放进"当前 worker"自己的队列,避免跨 worker 的额外开销
  static void internal_enqueue(worker* self, resumable* job) {
    std::cout << "[internal_enqueue] worker " << self->id()
              << " 内部产生新任务: " << job->name() << std::endl;
    self->queue().push_back(job);
  }
  // 任务这一轮配额用完,重新排队,等待下一轮被取出
  static void resume_job_later(worker* self, resumable* job) {
    std::cout << "[resume_job_later] 任务 " << job->name()
              << " 配额用完,重新排队" << std::endl;
    self->queue().push_back(job);
  }
  // worker 从自己的队列里取出下一个待执行任务,
  // 队列为空时返回 nullptr(真实调度器通常还会尝试从别的 worker 那里"偷"任务)
  static resumable* dequeue(worker* self) {
    if (self->queue().empty())
      return nullptr;
    auto job = self->queue().front();
    self->queue().pop_front();
    return job;
  }
  // 任务真正开始执行之前调用,方便记录起始时间
  static void before_resume(worker* self, resumable* job) {
    std::cout << "[before_resume] worker " << self->id() << " 即将执行 "
              << job->name() << std::endl;
  }
  // 任务这一轮执行结束之后调用,方便记录结束时间
  static void after_resume(worker* self, resumable* job) {
    std::cout << "[after_resume] worker " << self->id() << " 执行完一轮 "
              << job->name() << std::endl;
  }
  // 任务彻底完成、即将被销毁之前调用,可以在这里做收尾统计
  static void after_completion(worker* self, resumable* job) {
    std::cout << "[after_completion] 任务 " << job->name()
              << " 已彻底完成,即将从 worker " << self->id() << " 移除"
              << std::endl;
  }
};
// ------------------------------------------------------------------
// 单线程模拟调度循环:不断从 worker 的队列取任务并执行,
// 直到队列清空为止。
// ------------------------------------------------------------------
void run_worker_loop(worker* self) {
  const int max_messages_per_run = 3; // 模拟"每轮最多处理 3 条消息"
  resumable* job = nullptr;
  while ((job = scheduler_policy_demo::dequeue(self)) != nullptr) {
    scheduler_policy_demo::before_resume(self, job);
    auto result = job->run(max_messages_per_run);
    scheduler_policy_demo::after_resume(self, job);
    if (result == resumable::resume_result::more_work) {
      // 没处理完,重新排队,等待下一轮
      scheduler_policy_demo::resume_job_later(self, job);
    } else {
      // 彻底完成,先调用收尾钩子,再销毁
      scheduler_policy_demo::after_completion(self, job);
      delete job;
    }
  }
}
int main() {
  coordinator coord;
  worker w1("worker-1");
  coord.add_worker(&w1);
  // 模拟"非 Actor 上下文"(比如 main 函数)新建了两个 Actor 任务,
  // 通过 central_enqueue 交给协调者去分发
  auto job_a = new demo_actor("actor-A", 7); // 需要处理 7 条消息
  auto job_b = new demo_actor("actor-B", 2); // 需要处理 2 条消息
  scheduler_policy_demo::central_enqueue(&coord, job_a);
  scheduler_policy_demo::central_enqueue(&coord, job_b);
  // 模拟 actor-A 在执行过程中唤醒了一个新的 actor-C(对应 internal_enqueue)
  auto job_c = new demo_actor("actor-C", 4);
  scheduler_policy_demo::internal_enqueue(&w1, job_c);
  std::cout << "===== worker-1 开始调度循环 =====" << std::endl;
  run_worker_loop(&w1);
  std::cout << "===== worker-1 队列已清空,调度结束 =====" << std::endl;
  return 0;
}
代码关键点梳理
resumable抽象基类:对应真实 CAF 里"任何能被调度执行的工作项"这个抽象概念,run(max_messages)的返回值区分了"彻底完成"和"这一轮配额用完但还没做完"两种情况,直接对应文档里resume_job_later会被触发的条件。worker与coordinator各自持有的容器:worker里的queue_对应策略里的worker_data,coordinator里的workers_对应coordinator_data——这两个成员完全是我们自己按需求定义的,体现了"策略决定调度器内部数据长什么样"这一设计思想。central_enqueue内部调用了external_enqueue:这正好呼应文档里的描述——external_enqueue不会被 CAF 直接调用,而是被别的 enqueue 函数在内部用来完成"任务落地到具体 worker 队列"这一步。run_worker_loop里的三段式流程:dequeue取任务 →before_resume→run(...)→after_resume→ 根据结果选择resume_job_later或after_completion,这五步严格按照文档描述的顺序串联在一起,是整个调度策略里最核心的执行循环。
7. 调度流程时序图
以代码里 actor-A(需要处理 7 条消息,每轮最多处理 3 条)为例,下面这张时序图展示了它从最初被提交,到最终彻底完成为止,完整经历了哪些策略函数:
8. 协调者与工作者的整体结构图
                          coordinator(协调者)
                     ┌──────────────────────────┐
   非 Actor 代码       │  coordinator_data:        │
   (例如 main 函数)    │    workers 列表            │
   central_enqueue ──>│                            │
                     └───────────┬──────────────┘
                                 │ external_enqueue
                 ┌───────────────┼───────────────┐
                 ▼               ▼               ▼
          worker-1          worker-2          worker-3
     ┌──────────────┐  ┌──────────────┐  ┌──────────────┐
     │ worker_data:  │  │ worker_data:  │  │ worker_data:  │
     │  任务队列       │  │  任务队列       │  │  任务队列       │
     │ [job1,job2,..]│  │ [job3, ...]  │  │ [ ]           │
     └──────┬───────┘  └──────────────┘  └──────────────┘
            │ dequeue / before_resume / run / after_resume
            ▼
      resume_job_later(未完成,放回队列)
      或 after_completion(彻底完成,准备销毁)
这张图想说明的是:协调者更像是一个"总入口 + 分发中心",真正干活、维护各自任务队列的是一个个 worker;而 internal_enqueue 这种"Actor 之间互相触发"的场景,则是直接把新任务塞进"当前正在忙碌的那个 worker"自己的队列里,并不需要绕道协调者,这样可以减少不必要的跨 worker 通信开销。
CAF 中的工作共享(Work Sharing)调度机制详解
一、整体概念:什么是工作共享
工作共享(work sharing)是 CAF 提供的另一种调度器策略,跟前面讲过的工作窃取(work stealing)正好走了相反的设计路线:不再给每个 worker 分配独立的私有队列,而是所有 worker 共用同一个全局队列。
可以把这两种策略的思路差异概括成一句话:
工作窃取=各自为政, 忙了自己找活干工作共享=大家排一条队, 谁闲了就去队头取活干
\text{工作窃取} = \text{各自为政, 忙了自己找活干} \qquad \text{工作共享} = \text{大家排一条队, 谁闲了就去队头取活干}
工作窃取=各自为政, 忙了自己找活干工作共享=大家排一条队, 谁闲了就去队头取活干
因为只有一个中心化的队列,工作共享在同步方式上也变得简单很多:不需要工作窃取那套"自旋锁 + 三级轮询退避"的复杂机制,只需要经典的**互斥锁(mutex)+ 条件变量(condition variable)**这一对老搭档,就能把整个调度逻辑安全地组织起来。
二、工作共享具体是怎么运作的
工作共享调度器内部维护着一个全局任务队列,配合一把互斥锁和一个条件变量:
- 互斥锁(mutex):保护这个全局队列,确保同一时刻只有一个线程能修改队列内容(往里塞任务,或者从里面取任务),避免多线程同时读写导致数据错乱。
- 条件变量(condition variable):让"队列空的时候,worker 该怎么等待新任务"这件事变得优雅。worker 发现队列是空的,就在条件变量上"睡下",把 CPU 让出去,什么都不做;一旦有新任务被放进队列,负责放任务的那一方会"唤醒"正在睡觉的 worker,worker 醒来后立刻去队列里取任务处理。
这套"睡下等待 —— 被唤醒"的机制,跟工作窃取里"没活干就不停地自旋轮询、隔一段时间再试"的做法形成了鲜明对比:
工作共享:worker 空闲时不消耗 CPU,靠条件变量被动唤醒 \text{工作共享:worker 空闲时不消耗 CPU,靠条件变量被动唤醒} 工作共享:worker 空闲时不消耗 CPU,靠条件变量被动唤醒
工作窃取:worker 空闲时反复主动尝试(自旋 / 轮询),持续消耗一定 CPU \text{工作窃取:worker 空闲时反复主动尝试(自旋 / 轮询),持续消耗一定 CPU} 工作窃取:worker 空闲时反复主动尝试(自旋 / 轮询),持续消耗一定 CPU
三、为什么原文说它"只支持有限的并发"
因为全部 worker 都要抢同一把互斥锁才能操作队列,这意味着任意时刻,只能有一个线程在动这个队列——不管你有多少个 CPU 核心、多少个 worker 线程,取任务、放任务这件事本身永远是串行化的。
用不等式简单表达一下这层限制:
可以同时执行任务的 worker 数量≤P
\text{可以同时执行任务的 worker 数量} \le P
可以同时执行任务的 worker 数量≤P
但可以同时"访问队列"的 worker 数量≤1
\text{但可以同时"访问队列"的 worker 数量} \le 1
但可以同时"访问队列"的 worker 数量≤1
当 worker 数量很多、任务又切得非常碎(每个任务执行时间极短)时,大家频繁去抢那一把锁,锁本身就会变成整个系统的瓶颈——这正是工作窃取算法当初想要规避的问题。所以工作共享天然地不太适合"worker 数量特别多、任务特别碎"的高并发场景。
四、为什么说它适合低功耗设备
工作共享"不用轮询"这个特点,恰好是它在低端设备上具备优势的关键原因。用对比的方式理解会更直观:
| 场景 | 工作窃取的行为 | 工作共享的行为 |
|---|---|---|
| worker 暂时没有任务可做 | 反复自旋 / 轮询, 持续占用 CPU 时间片, 消耗电量 | 在条件变量上休眠, 几乎不占用 CPU, 省电 |
| 新任务突然到达 | 下次轮询周期(最长可能间隔 10 毫秒)才发现 | 条件变量立刻唤醒, 几乎零延迟感知到 |
| 适用场景 | CPU 核心多、追求最大吞吐量的服务器场景 | CPU 核心少、功耗敏感的嵌入式 / 低端设备场景 |
在工作窃取里,哪怕已经进入"放松"轮询阶段(每 10 毫秒尝试一次),也依然是在周期性地唤醒 CPU 去检查有没有活干,这本身就要消耗一定的电量。而工作共享用条件变量,worker 是真正意义上的"睡着了",操作系统层面几乎不会调度这个线程,直到有人明确"叫醒"它——这对于电池供电、追求低功耗的设备来说是更友好的选择。
五、完整可运行的 C++ 示例代码:简化版工作共享调度器
同样地,CAF 真正的工作共享调度器是框架内部实现,用户不能直接操作它的内部细节。为了从零理解这套机制,下面用标准 C++(不依赖 CAF 库)实现一个简化版的"全局队列 + mutex + 条件变量"调度器,直观展示原理。
编译方式:
g++ -std=c++17 -pthread work_sharing_demo.cpp -o work_sharing_demo
./work_sharing_demo
// ============================================================
// work_sharing_demo.cpp
// 一个简化版的工作共享(work sharing)线程池实现,演示 CAF 里
// "单一全局队列 + mutex + condition_variable" 这套调度机制。
// ============================================================
#include <atomic>
#include <condition_variable>
#include <functional>
#include <iostream>
#include <mutex>
#include <queue>
#include <thread>
#include <vector>
// ------------------------------------------------------------
// 全局共享队列:所有 worker 共用同一份任务队列,
// 用一把 mutex 保护队列本身,用一个 condition_variable
// 来实现"队列空时休眠等待,有新任务时立刻唤醒"的机制。
// ------------------------------------------------------------
class shared_work_queue {
public:
  // 往队列里放一个新任务,并唤醒一个正在等待的 worker
  void push(std::function<void()> task) {
    {
      // 用 lock_guard 在这个作用域内持有锁,保证 push_back 是线程安全的
      std::lock_guard<std::mutex> guard(mutex_);
      tasks_.push(std::move(task));
    }
    // notify_one:只唤醒一个正在等待的线程,
    // 因为只放进去一个任务,叫醒多个线程也只有一个能抢到,
    // 唤醒过多反而浪费 CPU(这种现象叫"惊群效应")
    cv_.notify_one();
  }
  // 从队列里取一个任务;如果队列是空的,就在条件变量上等待,
  // 直到有新任务到来,或者收到停止信号
  bool pop(std::function<void()>& task, std::atomic<bool>& stop_flag) {
    // unique_lock 相比 lock_guard 更灵活,可以配合条件变量做"解锁等待、
    // 被唤醒后重新加锁"这样的操作
    std::unique_lock<std::mutex> lock(mutex_);
    // wait 的第二个参数是一个"谓词":
    //   如果谓词返回 true(队列非空 或 收到停止信号),就不用等待,直接往下走;
    //   如果谓词返回 false,wait 会自动释放锁并让当前线程进入休眠,
    //   直到被 notify_one/notify_all 唤醒后,再自动重新加锁、重新检查谓词
    cv_.wait(lock, [this, &stop_flag] {
      return !tasks_.empty() || stop_flag.load(std::memory_order_relaxed);
    });
    // 如果是因为收到停止信号被唤醒、且此时队列确实空了,直接返回 false
    if (tasks_.empty())
      return false;
    task = std::move(tasks_.front());
    tasks_.pop();
    return true;
  }
  // 用于通知所有正在等待的 worker:"该醒了,检查一下是否该退出了"
  void notify_all_for_shutdown() {
    cv_.notify_all();
  }
private:
  std::mutex mutex_;
  std::condition_variable cv_;
  std::queue<std::function<void()>> tasks_;
};
// ------------------------------------------------------------
// 工作共享调度器:管理若干 worker 线程,它们全部共用同一个
// shared_work_queue,没有各自私有的队列,也不需要"偷"这个概念。
// ------------------------------------------------------------
class work_sharing_scheduler {
public:
  explicit work_sharing_scheduler(size_t num_workers)
      : num_workers_(num_workers), stop_flag_(false) {}
  // 提交一个任务到全局队列(不需要指定具体哪个 worker 处理,
  // 因为所有 worker 都从同一个队列里取)
  void submit(std::function<void()> task) {
    queue_.push(std::move(task));
  }
  // 启动所有 worker 线程
  void start() {
    for (size_t i = 0; i < num_workers_; ++i) {
      threads_.emplace_back([this, i] { worker_loop(i); });
    }
  }
  // 停止调度器:设置停止标志,并唤醒所有可能正在休眠的 worker
  void stop() {
    stop_flag_.store(true, std::memory_order_relaxed);
    queue_.notify_all_for_shutdown();
    for (auto& t : threads_)
      t.join();
  }
private:
  // 单个 worker 线程的主循环:不停地从全局队列取任务并执行,
  // 队列空了就自动休眠,被唤醒后继续尝试
  void worker_loop(size_t self_idx) {
    while (true) {
      std::function<void()> task;
      // pop 内部会在队列为空时自动阻塞等待,直到有新任务或者要求停止
      bool got_task = queue_.pop(task, stop_flag_);
      if (!got_task) {
        // 没取到任务,说明是因为收到了停止信号,直接退出循环
        break;
      }
      std::cout << "[Worker " << self_idx << "] 从全局队列取到一个任务, 开始执行"
                << std::endl;
      task();
    }
  }
  size_t num_workers_;
  shared_work_queue queue_;
  std::vector<std::thread> threads_;
  std::atomic<bool> stop_flag_;
};
// ------------------------------------------------------------
// main 函数:创建一个 4 个 worker 的工作共享调度器,
// 一次性提交 20 个任务到全局队列,观察它们被各个 worker 均匀取走处理。
// ------------------------------------------------------------
int main() {
  const size_t num_workers = 4;
  work_sharing_scheduler scheduler(num_workers);
  std::atomic<int> finished_count{0};
  scheduler.start();
  // 提交 20 个任务到共用的全局队列,不区分具体交给哪个 worker
  for (int i = 0; i < 20; ++i) {
    scheduler.submit([i, &finished_count] {
      // 模拟任务需要花一点时间处理
      std::this_thread::sleep_for(std::chrono::milliseconds(5));
      finished_count.fetch_add(1, std::memory_order_relaxed);
    });
  }
  // 主线程等待,直到全部 20 个任务都完成
  while (finished_count.load(std::memory_order_relaxed) < 20) {
    std::this_thread::sleep_for(std::chrono::milliseconds(10));
  }
  std::cout << "全部任务完成,总数: " << finished_count.load() << std::endl;
  scheduler.stop();
  return 0;
}
代码关键点解析
shared_work_queue::push:先用lock_guard持锁把任务塞进队列,锁一释放就立刻调用cv_.notify_one()唤醒一个正在等待的 worker——只唤醒一个而不是全部,是因为只新增了一个任务,没必要把所有睡着的 worker 都吵醒(否则大家醒来后大部分又发现抢不到任务,白白浪费一次上下文切换,这种现象通常叫"惊群效应")。shared_work_queue::pop里的cv_.wait(lock, 谓词):这是条件变量最标准的用法。wait会先检查谓词,如果谓词已经为真(队列非空,或者要求停止)就直接返回,不会真的进入睡眠;如果谓词为假,wait会自动释放持有的锁、让线程进入休眠状态,等到被notify_one/notify_all唤醒后,自动重新加锁并再次检查谓词,直到谓词为真才真正从wait返回——这一整套"检查 - 释放锁 - 休眠 - 唤醒 - 重新加锁 - 再检查"的流程完全由标准库帮你安全地实现,不需要自己手写忙等待循环。- 为什么谓词里要同时检查
!tasks_.empty()和stop_flag_:这是为了避免"调度器要关闭了,但 worker 还傻傻地在等一个永远不会到来的新任务"这种死锁式的等待——把停止信号也纳入唤醒条件,保证stop()被调用时所有 worker 都能被正常唤醒并退出。 work_sharing_scheduler::submit:跟工作窃取版本的submit不一样,这里不需要指定"派给第几个 worker",因为所有 worker 面对的是同一个全局队列,谁先抢到锁、谁先取到任务,完全由操作系统的线程调度决定。stop()里的notify_all_for_shutdown():停止调度器时必须唤醒所有(而不是一个)正在等待的 worker,因为可能同时有好几个 worker 都处于"队列空、正在休眠"的状态,只有全部叫醒,它们才能各自检查到停止标志并退出循环。
六、任务提交与处理过程的时序图
七、休眠等待流程的 ASCII 示意
worker 调用 pop()
        |
        v
+---------------------------+
| 队列是否为空?              |
+---------------------------+
   是 |               | 否
      v               v
+-----------------+   +----------------------+
| 在条件变量上休眠  |   | 直接从队列头部取出任务 |
| 释放锁, 不占CPU   |   | 返回任务, 交给worker执行|
+-----------------+   +----------------------+
      |
      | (有新任务被push, 或收到停止信号)
      v
+---------------------------+
| 被 notify 唤醒, 重新加锁   |
| 再次检查队列是否为空        |
+---------------------------+
      |
      v
   回到最上面的判断
八、工作共享 vs 工作窃取:核心区别对照
| 对比维度 | 工作共享(work sharing) | 工作窃取(work stealing) |
|---|---|---|
| 队列结构 | 单一全局队列 | 每个 worker 一个私有队列 |
| 同步方式 | mutex + condition_variable | 双端队列 + 自旋锁 |
| worker 空闲时的行为 | 在条件变量上休眠, 被动等待唤醒, 不消耗CPU | 主动自旋 / 轮询, 消耗一定CPU |
| 新任务到达的响应延迟 | 几乎立即被唤醒 | 取决于当前轮询阶段, 最坏情况下有延迟 |
| 并发能力 | 受限, 任意时刻只有一个线程能操作队列 | 较高, 大多数操作只涉及自己的私有队列 |
| 功耗特点 | worker 空闲时几乎不耗电, 适合低功耗设备 | 轮询本身持续消耗一定电量, 更适合追求高吞吐的场景 |
九、小结
- 工作共享是 CAF 提供的另一种调度器策略:所有 worker 共用一个全局队列,用经典的 mutex + condition_variable 组合来同步,不需要像工作窃取那样搞轮询退避。
- 因为所有 worker 抢的是同一把锁,同一时刻只能有一个线程真正操作队列,这决定了它的并发能力天然是有限的,不适合 worker 数量很多、任务粒度很碎的高并发场景。
- 它最大的优势在于"不用轮询":worker 空闲时会真正休眠,几乎不消耗 CPU,直到被明确唤醒才恢复运行,这对功耗敏感的低端设备是很有吸引力的特性。
- 简单来说,工作共享是用"牺牲一部分并发扩展性"换来了"更低的功耗和更简单的实现",跟工作窃取正好是两种不同取舍方向的调度策略,CAF 把两者都做成了可切换的调度器策略,用户可以根据实际部署场景(服务器 vs 低功耗设备)来选择。
CAF Actor 注册表(Registry)详解
1. 注册表是用来解决什么问题的
在一个用 CAF 写的程序里,Actor 通常是靠"持有对方的句柄"(比如函数参数、返回值里传来传去的 actor 类型变量)来互相通信的。但有些场景下,某个 Actor 需要被系统里任何地方都能找到,而不只是被直接持有它句柄的那几个 Actor 访问,比如:
- 想给某个"全局唯一"的服务型 Actor 起一个固定的名字,系统里任何代码只要知道这个名字,就能查到它、给它发消息;
- 想统计一下当前系统里到底还有多少个 Actor 在运行;
- 跨网络通信时,需要知道一个 Actor ID 到底对应本地的哪一个具体 Actor,方便做序列化和反序列化。
CAF 为此提供了一个注册表(registry):它本质上是一张"查找表",把 Actor 的 ID,或者一个自定义的名字(用原子 atom 表示),映射到具体的 Actor 句柄上。可以把它理解成一个(不一定覆盖所有 Actor 的)部分映射函数:
f:ID∪Name⇀Actorf : \mathrm{ID} \cup \mathrm{Name} \rightharpoonup \mathrm{Actor}f:ID∪Name⇀Actor
这里用 ⇀\rightharpoonup⇀(而不是普通的 →\to→)来表示这是一个部分函数——因为并不是系统里所有正在运行的 Actor 都会出现在这张表里。
2. 注册表不会自动收录所有 Actor
这一点必须强调清楚:注册表并不包含系统里所有正在运行的 Actor。一个 Actor 想要被记录进注册表,必须由开发者显式地调用注册表提供的写入方法把它存进去;如果什么都不做,一个正常 spawn 出来的 Actor 是不会自动出现在注册表里的(不过它仍然会被计入"当前运行中的 Actor 总数")。
访问注册表的方式是通过 Actor 系统对象调用 system.registry()。
3. 注册表内部存的是什么类型
注册表内部存储 Actor 时,用的不是普通的 actor 句柄,而是 strong_actor_ptr——这是一种"强引用"的 Actor 指针类型,只要这个指针还存在,对应的 Actor 就不会被销毁。把普通句柄和 strong_actor_ptr 互相转换,需要用 actor_cast 来完成。
按名字建立映射用的数据结构是:
// name_map 的定义
using name_map = std::unordered_map<atom_value, strong_actor_ptr>;
也就是说,“名字"这一侧的类型是 atom_value——一种可以在编译期由短字符串直接构造出来的原子值,专门用来充当"标签"或者"键”,而不是用来存放实际数据。
4. 注册表提供的全部接口
| 接口 | 类型 | 作用 |
|---|---|---|
strong_actor_ptr get(actor_id) | 观察者 | 根据给定的 ID,查到对应的 Actor |
strong_actor_ptr get(atom_value) | 观察者 | 根据给定的名字,查到对应的 Actor |
name_map named_actors() | 观察者 | 返回当前所有"名字 → Actor"的映射 |
size_t running() | 观察者 | 返回当前系统里正在运行的 Actor 总数 |
void put(actor_id, strong_actor_ptr) | 修改者 | 把一个 Actor 按 ID 存进注册表 |
void erase(actor_id) | 修改者 | 按 ID 移除一条映射 |
void put(atom_value, strong_actor_ptr) | 修改者 | 把一个 Actor 按名字存进注册表 |
void erase(atom_value) | 修改者 | 按名字移除一条映射 |
从这张表能看出,注册表其实同时维护着两张独立的映射:“ID → Actor” 和 “名字 → Actor”,二者互不依赖,你可以只用其中一种,也可以同时给同一个 Actor 建立两种映射。
5. 注册表的两个典型用途
- 让 Actor 在系统内按名字被随时找到:只要把某个 Actor 用一个固定的名字
put进注册表,系统里任何持有system.registry()引用的代码,都可以用这个名字把它get回来,不需要提前拿到它的句柄。 - 配合 Middleman 做远程通信:当 CAF 需要和远程节点交换 Actor 信息时,Middleman 组件会依赖注册表来跟踪"哪些本地 Actor 是远程节点已知的",从而在序列化、反序列化 Actor 句柄的时候,能正确地把 ID 还原成本地真实存在的 Actor。
6. Actor 终止时的自动清理
当一个被存进注册表的 Actor 终止运行之后,注册表会自动把跟它相关的映射清理掉,开发者不需要在 Actor 退出前手动调用一次 erase。这个自动清理机制,也解释了为什么"运行中的 Actor 总数"这个统计值可以直接通过 running() 实时查询——注册表内部本身就在持续跟踪 Actor 的存活状态。
7. 分布式场景下:每个系统的注册表都是独立的
有一点很容易被忽略:注册表不会在多个互相连接的 Actor 系统之间同步。也就是说,在一个分布式部署里,每一个节点上的 Actor 系统,都维护着自己本地独立的一份注册表,节点 A 往自己的注册表里存了一个名字,节点 B 是完全看不到、也查不到这个名字的,除非借助 Middleman 之类的组件专门去做跨节点的信息交换。
   节点 A 的 actor system                节点 B 的 actor system
  ┌────────────────────────┐           ┌────────────────────────┐
  │ 本地 registry            │           │ 本地 registry            │
  │  "logger" -> actor#7     │           │  "cache"  -> actor#3     │
  │  actor#7  -> actor#7     │           │  actor#3  -> actor#3     │
  └────────────────────────┘           └────────────────────────┘
             ▲                                      ▲
             │  彼此完全独立,不会自动同步               │
             └──────────────|网络|───────────────────┘
                      (需要 Middleman 显式协调,
                       才能实现跨节点的 Actor 查找)
8. 完整可运行的代码示例
下面这份代码演示了:往注册表里按 ID 和按名字存入一个 Actor、分别按 ID 和按名字查回来发消息、查看当前所有名字映射、手动移除名字映射,以及"Actor 终止后注册表自动清理"这一整套流程。
// registry_demo.cpp
//
// 编译方式示例(需要先安装 CAF 库):
//   g++ -std=c++17 registry_demo.cpp -lcaf_core -lcaf_io -o registry_demo
// 运行:
//   ./registry_demo
#include <chrono>
#include <cstdint>
#include <iostream>
#include <thread>
#include "caf/all.hpp"
using namespace caf;
using namespace std::chrono_literals;
// ========================================================================
// 定义一个用于消息匹配的原子类型 ping_atom。
// 注意:这里的 ping_atom(以及它的常量 ping_atom_v)跟本文要讲的
// "注册表里用作名字的 atom_value" 是两回事——
// ping_atom 是编译期静态类型,专门用来标记"消息种类";
// atom_value 则是注册表用来给 Actor 起"名字"的运行期通用原子值。
// ========================================================================
CAF_BEGIN_TYPE_ID_BLOCK(registry_demo, first_custom_type_id)
  CAF_ADD_ATOM(registry_demo, ping_atom)
CAF_END_TYPE_ID_BLOCK(registry_demo)
// 一个简单的 Actor:收到 ping_atom 消息就打印一句话
behavior worker_impl(event_based_actor* self) {
  return {
    [self](ping_atom) {
      self->println("[worker] 收到一次 ping");
    }
  };
}
void caf_main(actor_system& sys) {
  // scoped_actor 用来在 main 函数(非 Actor 上下文)里
  // 发消息、以及阻塞等待某个 Actor 终止。
  scoped_actor self{sys};
  // 通过 actor system 拿到注册表的引用
  auto& reg = sys.registry();
  std::cout << "spawn 之前,运行中的 Actor 数量: " << reg.running()
            << std::endl;
  // 启动一个 worker,此时它还没有被显式存进注册表
  auto worker = sys.spawn(worker_impl);
  std::cout << "spawn 之后,运行中的 Actor 数量: " << reg.running()
            << std::endl;
  // ---------- 按 ID 把这个 Actor 存进注册表 ----------
  // strong_actor_ptr 是注册表实际存储的类型,需要用 actor_cast 转换。
  reg.put(worker.id(), actor_cast<strong_actor_ptr>(worker));
  // ---------- 按一个"名字"把这个 Actor 存进注册表 ----------
  // atom("myworker") 用一个不超过 10 个字符的字符串构造出一个 atom_value,
  // 之后系统里任何代码只要知道这个名字,就能把这个 Actor 查回来。
  auto worker_name = atom("myworker");
  reg.put(worker_name, actor_cast<strong_actor_ptr>(worker));
  // ---------- 按 ID 查回来,转换成可用句柄后发消息 ----------
  if (auto by_id = reg.get(worker.id())) {
    auto handle = actor_cast<actor>(by_id);
    self->send(handle, ping_atom_v);
  }
  // ---------- 按名字查回来,转换成可用句柄后发消息 ----------
  if (auto by_name = reg.get(worker_name)) {
    auto handle = actor_cast<actor>(by_name);
    self->send(handle, ping_atom_v);
  }
  std::cout << "当前已注册的名字数量: " << reg.named_actors().size()
            << std::endl;
  // 稍等一下,让上面发送的两条消息有机会被处理
  std::this_thread::sleep_for(200ms);
  // ---------- 主动移除名字映射 ----------
  reg.erase(worker_name);
  auto after_erase = reg.get(worker_name);
  std::cout << "erase 之后,按名字还能查到吗: "
            << (after_erase ? "能" : "不能") << std::endl;
  // ---------- 让 worker 退出,观察 ID 映射是否被自动清理 ----------
  self->send_exit(worker, exit_reason::user_shutdown);
  self->wait_for(worker); // 阻塞等待 worker 真正终止退出
  std::this_thread::sleep_for(100ms); // 给注册表一点时间完成内部清理
  auto by_id_after = reg.get(worker.id());
  std::cout << "worker 终止之后,按 ID 还能查到吗: "
            << (by_id_after ? "能" : "不能") << std::endl;
  std::cout << "最终运行中的 Actor 数量: " << reg.running() << std::endl;
}
CAF_MAIN(id_block::registry_demo)
代码关键点梳理
actor_cast<strong_actor_ptr>(worker):普通的actor句柄要存进注册表之前,必须先转换成strong_actor_ptr;反过来,从reg.get(...)拿到strong_actor_ptr之后,要用actor_cast<actor>(...)转回可以直接send消息的句柄类型。reg.put的两次调用:分别演示了"按 ID 存"和"按名字存"两种独立的映射方式,两者可以同时用在同一个 Actor 上,互不冲突。reg.erase(worker_name)之后立即验证:通过再调用一次reg.get(worker_name)并检查返回值是否为空,直观验证"名字映射已经被手动移除"。self->send_exit(...)+self->wait_for(...):先给worker发送退出信号,再阻塞等待它真正终止,这样才能保证后面查询注册表时,"Actor 终止后自动清理"这件事已经确实发生了,而不是消息还在半路上。
9. 执行流程时序图
下图对照代码,展示了从"存入注册表"到"Actor 终止后被自动清理"的完整过程:
10. 注册表内部结构一览
                        actor system
                 ┌─────────────────────────┐
                 │        registry           │
                 │ ┌───────────────────────┐ │
                 │ │ ID 映射                │ │
                 │ │  actor#1 -> ptr1       │ │
                 │ │  actor#7 -> ptr2       │ │
                 │ └───────────────────────┘ │
                 │ ┌───────────────────────┐ │
                 │ │ name_map(名字映射)      │ │
                 │ │  "logger" -> ptr1      │ │
                 │ │  "cache"  -> ptr3      │ │
                 │ └───────────────────────┘ │
                 │                            │
                 │ running(): 系统里正在运行   │
                 │           的 Actor 总数     │
                 └─────────────────────────┘
这张图想强调的重点是:ID 映射和名字映射是注册表内部两张互相独立的表,running() 统计的是系统里所有正在运行的 Actor(不管有没有被存进这两张表),而只有显式调用过 put 的 Actor,才会出现在 ID 映射或者名字映射里,一旦这个 Actor 终止,注册表会自动把它从这两张表里清理掉。
CAF 中的工作窃取(Work Stealing)调度机制详解
一、整体概念:为什么需要工作窃取
CAF 内部有大量的 actor 需要被调度到少数几个线程(worker)上去运行。最朴素的做法是:所有 worker 共用同一个全局任务队列,谁空闲了就去这个队列里取任务。但这样做有个明显问题——所有线程都要去抢同一把锁,线程数一多,抢锁本身就会成为性能瓶颈。
工作窃取(work stealing)算法就是为了解决这个瓶颈而设计的。它的核心思路是:
不要用一个全局队列,而是给每个 worker 分配一个属于自己的队列
\text{不要用一个全局队列,而是给每个 worker 分配一个属于自己的队列}
不要用一个全局队列,而是给每个 worker 分配一个属于自己的队列
worker 优先处理自己队列里的任务;自己的任务做完了,就去"偷"别人的
\text{worker 优先处理自己队列里的任务;自己的任务做完了,就去"偷"别人的}
worker 优先处理自己队列里的任务;自己的任务做完了,就去"偷"别人的
这个算法最早由 Blumofe 等人在 1994 年为"完全严格计算(fully strict computation)"这类问题设计,目标是把任意数量的任务调度到 PPP 个处理器上运行(PPP 是可用处理器的数量)。
二、图中展示的"偷窃"过程
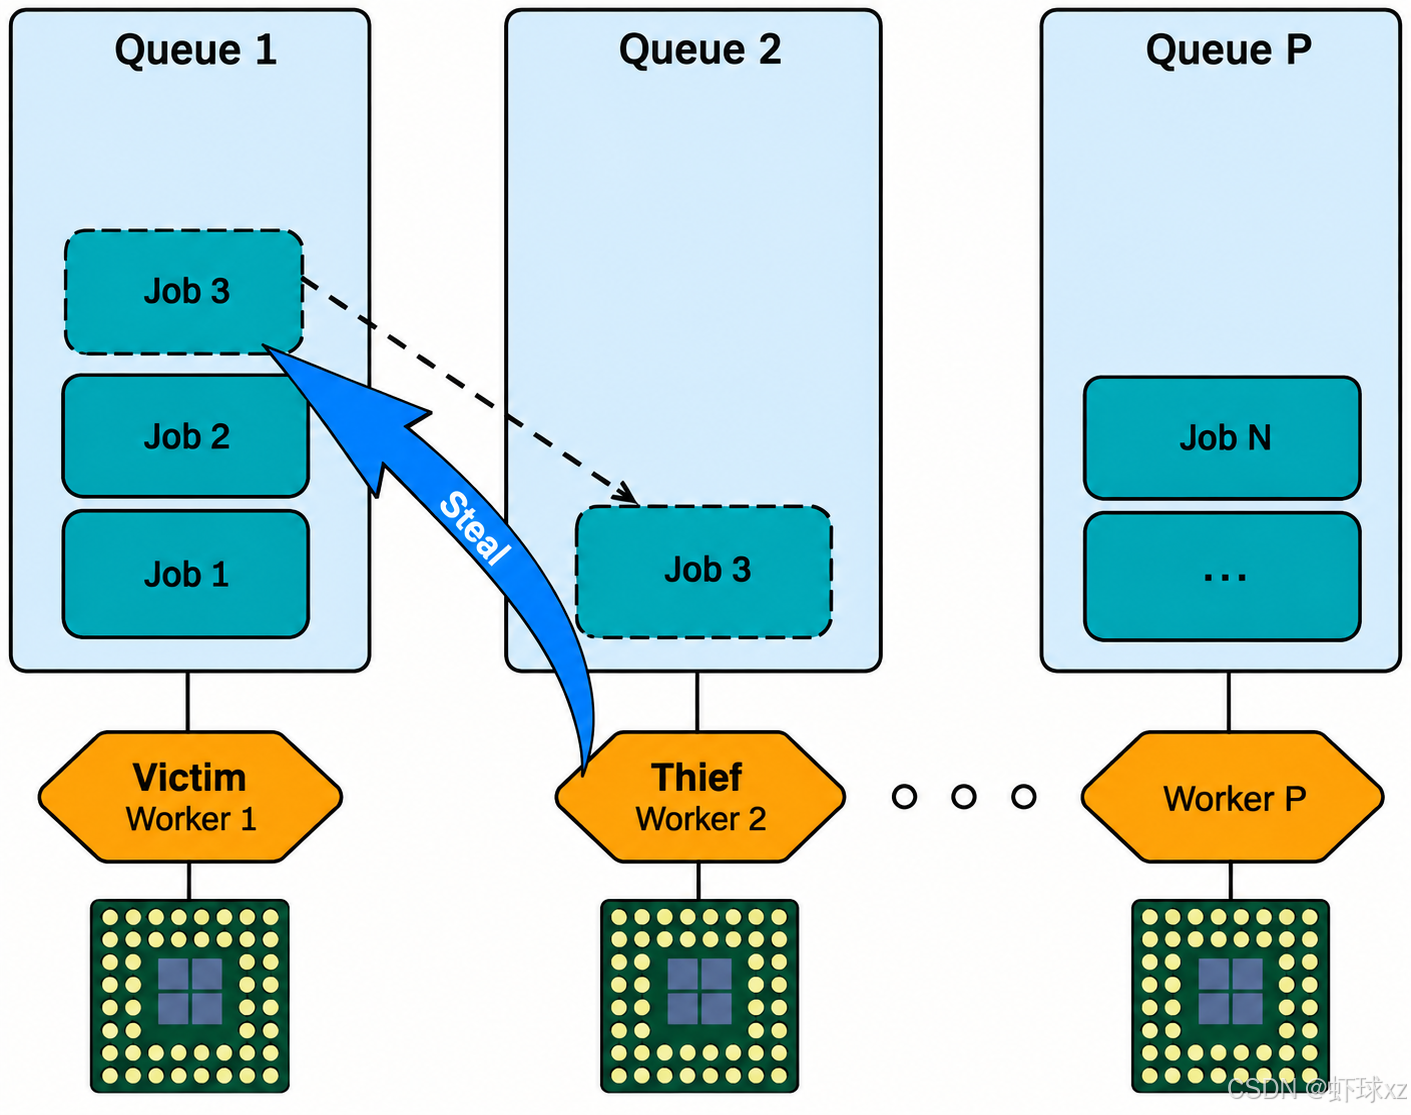
原图描述的场景可以这样理解:
- 有 PPP 个队列(Queue 1、Queue 2、……、Queue P),每个队列对应一个 worker,每个 worker 背后绑定一个具体的处理器核心(图中用芯片图标表示)。
- Worker 1(图中标注为 Victim,受害者)的队列里还剩 3 个任务(Job 1、Job 2、Job 3)。
- Worker 2(图中标注为 Thief,小偷)的队列已经空了,于是它伸手去 Worker 1 的队列里"偷"了一个任务(图中是 Job 3,用虚线框标出,被偷到了 Queue 2 里)。
- 蓝色箭头标注的 “Steal” 就是这次偷窃动作本身。
把这个过程用 mermaid 图重新画一遍,会更清楚:
三、双端队列(deque):为什么每个 worker 内部用两端来操作
工作窃取算法有个很关键的设计细节:每个 worker 自己的队列是一个双端队列(double-ended queue,deque),并且:
- worker 自己从队列的一端(通常是"头部"或者说自己最近放进去的一端)取任务来做;
- 小偷(thief)去偷别人的任务时,是从另一端(尾部)去拿。
这样设计的好处是:worker 自己拿最新放进去的任务,往往跟它刚做完的任务在数据上、缓存上更"相关"(比如同一批递归展开出来的子任务),能提高缓存命中率;而小偷去拿最老的任务,正好是跟当前 worker 手头工作关系最疏远的那批,减少了两边同时抢同一个任务、发生数据竞争的概率。
CAF 具体的做法是:用两把**自旋锁(spinlock)**来同步这个双端队列——一把锁负责 worker 自己那一端的操作,另一把锁负责小偷从另一端偷取的操作,这样"自己取任务"和"被别人偷"这两件事可以在大多数时候并行发生,互不阻塞。
四、空闲检测的难题:三级轮询间隔
工作窃取是一种去中心化的算法——每个 worker 只知道自己的队列状态,不知道全局情况。这就带来一个麻烦:
某个 worker 队列空了,该怎么判断"是只有我没活干"还是"大家都没活干了"?
\text{某个 worker 队列空了,该怎么判断"是只有我没活干"还是"大家都没活干了"?}
某个 worker 队列空了,该怎么判断"是只有我没活干"还是"大家都没活干了"?
因为没有一个中心化的"总管"能一眼看穿全局状态,worker 只能靠"反复尝试去偷"来间接摸索情况。但如果一直不停地疯狂尝试偷(忙等待,busy waiting),会白白浪费 CPU;如果偷不到就立刻睡死过去,又可能错过"马上有新任务来了"这种情况,导致响应变慢。
CAF 的解法是设置三档轮询策略,随着"连续偷不到任务"的次数增加,逐渐从"急躁"变得"淡定":
尝试次数增加→轮询策略:激进(aggressive)→温和(moderate)→放松(relaxed)
\text{尝试次数增加} \to \text{轮询策略:激进(aggressive)} \to \text{温和(moderate)} \to \text{放松(relaxed)}
尝试次数增加→轮询策略:激进(aggressive)→温和(moderate)→放松(relaxed)
| 策略名称 | 默认尝试次数 | 两次尝试之间的休眠时间 | 适用阶段 |
|---|---|---|---|
| 激进(aggressive) | 100 次 | 0(完全不休眠,连续尝试) | 刚空闲, 认为很可能马上就有新任务 |
| 温和(moderate) | 500 次 | 50 微秒 | 激进策略试了 100 次都没偷到之后 |
| 放松(relaxed) | 无限次(一直运行下去) | 10 毫秒 | 温和策略也试了 500 次都没偷到之后 |
用公式描述这个"总共大概要空等多久才会进入放松模式"的过程:
T进入放松前累计耗时≈100×0+500×50μs=25 ms
T_{\text{进入放松前累计耗时}} \approx 100 \times 0 + 500 \times 50\mu s = 25\,\text{ms}
T进入放松前累计耗时≈100×0+500×50μs=25ms
也就是说,一个 worker 从"队列刚变空"开始,大约经过 25 毫秒左右的"激进 + 温和"两轮尝试之后,如果始终偷不到任务,才会进入"放松"模式,每 10 毫秒才检查一次,这样既不会一直白白占用 CPU,也不至于太迟钝地错过新任务。这几个默认值都可以在系统配置里被覆盖修改。
五、完整可运行的 C++ 示例代码:简化版工作窃取调度器
CAF 内部真正的工作窃取调度器是框架内置的,用户平时写 actor 代码时不需要(也不能)直接操作它。为了从零理解这个算法本身是怎么运作的,下面用标准 C++(不依赖 CAF 库)写一个简化版的工作窃取线程池,完整还原"每个线程有自己的双端队列 + 偷别人任务 + 三级轮询退避"这几个核心机制。
编译方式:
g++ -std=c++17 -pthread work_stealing_demo.cpp -o work_stealing_demo
./work_stealing_demo
// ============================================================
// work_stealing_demo.cpp
// 一个简化版的工作窃取线程池实现,用来演示 CAF 调度器内部的核心思想:
//   1) 每个 worker 拥有自己的双端队列(用 std::deque + 自旋锁模拟)
//   2) worker 优先处理自己队列里的任务
//   3) 队列空了之后,尝试从随机挑选的"受害者" worker 那里偷任务
//   4) 偷任务失败次数增多时,逐级切换到更"放松"的轮询策略
// ============================================================
#include <atomic>
#include <chrono>
#include <deque>
#include <functional>
#include <iostream>
#include <mutex>
#include <random>
#include <thread>
#include <vector>
// ------------------------------------------------------------
// 自旋锁:用 std::atomic_flag 实现,忙等待直到抢到锁为止。
// CAF 内部也是用自旋锁来同步双端队列的两端操作。
// ------------------------------------------------------------
class spinlock {
public:
  // 加锁:不断尝试把 flag_ 从"未上锁"改成"已上锁",
  // 改不成功就一直自旋(忙等待)
  void lock() {
    while (flag_.test_and_set(std::memory_order_acquire)) {
      // 忙等待,什么都不做,一直重试
    }
  }
  // 解锁:把 flag_ 重新设回"未上锁"状态
  void unlock() {
    flag_.clear(std::memory_order_release);
  }
private:
  std::atomic_flag flag_ = ATOMIC_FLAG_INIT;
};
// ------------------------------------------------------------
// 每个 worker 私有的双端任务队列。
// 用一把锁保护整个 deque(简化版实现,真实 CAF 用两把锁分别保护
// 两端,这里为了代码清晰用一把锁统一保护)。
// ------------------------------------------------------------
class work_queue {
public:
  // worker 自己:从队列"头部"取出一个任务(自己最近放入的那一批)
  bool try_pop_own(std::function<void()>& task) {
    std::lock_guard<spinlock> guard(lock_);
    if (tasks_.empty())
      return false;
    task = std::move(tasks_.front());
    tasks_.pop_front();
    return true;
  }
  // 小偷:从队列"尾部"偷一个任务(别人最老、最不相关的那批)
  bool try_steal(std::function<void()>& task) {
    std::lock_guard<spinlock> guard(lock_);
    if (tasks_.empty())
      return false;
    task = std::move(tasks_.back());
    tasks_.pop_back();
    return true;
  }
  // 往队列头部塞入一个新任务
  void push(std::function<void()> task) {
    std::lock_guard<spinlock> guard(lock_);
    tasks_.push_front(std::move(task));
  }
  bool empty() {
    std::lock_guard<spinlock> guard(lock_);
    return tasks_.empty();
  }
private:
  spinlock lock_;
  std::deque<std::function<void()>> tasks_;
};
// ------------------------------------------------------------
// 三级轮询策略的参数,对应 CAF 文档里描述的默认值:
//   激进策略:尝试 100 次,两次尝试之间不休眠
//   温和策略:尝试 500 次,两次尝试之间休眠 50 微秒
//   放松策略:无限尝试,两次尝试之间休眠 10 毫秒
// ------------------------------------------------------------
struct polling_config {
  int aggressive_attempts = 100;
  int moderate_attempts = 500;
  std::chrono::microseconds moderate_sleep{50};
  std::chrono::milliseconds relaxed_sleep{10};
};
// ------------------------------------------------------------
// 整个工作窃取调度器:管理 P 个 worker 线程,每个 worker 有自己的
// work_queue,空闲时按"激进 -> 温和 -> 放松"三级策略去偷别人的任务。
// ------------------------------------------------------------
class work_stealing_scheduler {
public:
  explicit work_stealing_scheduler(size_t num_workers)
      : queues_(num_workers), stop_flag_(false), cfg_() {}
  // 把任务派发到第 idx 个 worker 的队列里
  void submit(size_t idx, std::function<void()> task) {
    queues_[idx % queues_.size()].push(std::move(task));
  }
  // 启动所有 worker 线程
  void start() {
    for (size_t i = 0; i < queues_.size(); ++i) {
      threads_.emplace_back([this, i] { worker_loop(i); });
    }
  }
  // 通知所有 worker 停止(这里用一个简单的停止标志,
  // 真实调度器会有更完善的关闭协议)
  void stop() {
    stop_flag_.store(true, std::memory_order_relaxed);
    for (auto& t : threads_)
      t.join();
  }
private:
  // 单个 worker 线程的主循环
  void worker_loop(size_t self_idx) {
    std::mt19937 rng(std::random_device{}());
    std::uniform_int_distribution<size_t> dist(0, queues_.size() - 1);
    while (!stop_flag_.load(std::memory_order_relaxed)) {
      std::function<void()> task;
      // 第一步:优先尝试从自己的队列取任务
      if (queues_[self_idx].try_pop_own(task)) {
        task();
        continue;
      }
      // 自己的队列空了,进入"偷窃模式"
      bool stole = try_steal_with_backoff(self_idx, rng, dist);
      if (stole) {
        // try_steal_with_backoff 内部已经把偷到的任务执行完了
        continue;
      }
      // 如果整个调度器都收到了停止信号,就跳出循环
      if (stop_flag_.load(std::memory_order_relaxed))
        break;
    }
  }
  // 按"激进 -> 温和 -> 放松"三级策略尝试偷任务;
  // 一旦偷到任务就立刻执行并返回 true。
  bool try_steal_with_backoff(size_t self_idx, std::mt19937& rng,
                               std::uniform_int_distribution<size_t>& dist) {
    // ---------- 阶段一:激进策略 ----------
    for (int i = 0; i < cfg_.aggressive_attempts; ++i) {
      if (stop_flag_.load(std::memory_order_relaxed))
        return false;
      if (attempt_steal_once(self_idx, rng, dist))
        return true;
      // 激进阶段完全不休眠,立刻进行下一次尝试
    }
    // ---------- 阶段二:温和策略 ----------
    for (int i = 0; i < cfg_.moderate_attempts; ++i) {
      if (stop_flag_.load(std::memory_order_relaxed))
        return false;
      if (attempt_steal_once(self_idx, rng, dist))
        return true;
      std::this_thread::sleep_for(cfg_.moderate_sleep);
    }
    // ---------- 阶段三:放松策略(这里演示只跑几轮,避免示例卡死)
    // 真实实现中放松策略是"无限期"运行,直到偷到任务或者调度器关闭;
    // 这里为了让示例能正常结束,限制成有限次数。
    for (int i = 0; i < 20; ++i) {
      if (stop_flag_.load(std::memory_order_relaxed))
        return false;
      if (attempt_steal_once(self_idx, rng, dist))
        return true;
      std::this_thread::sleep_for(cfg_.relaxed_sleep);
    }
    return false;
  }
  // 单次尝试:随机挑一个"受害者" worker,尝试偷一个任务并立即执行
  bool attempt_steal_once(size_t self_idx, std::mt19937& rng,
                           std::uniform_int_distribution<size_t>& dist) {
    if (queues_.size() <= 1)
      return false;
    size_t victim_idx = dist(rng);
    if (victim_idx == self_idx)
      return false;
    std::function<void()> task;
    if (queues_[victim_idx].try_steal(task)) {
      std::cout << "[Worker " << self_idx << "] 从 Worker " << victim_idx
                << " 那里偷到了一个任务!" << std::endl;
      task();
      return true;
    }
    return false;
  }
  std::vector<work_queue> queues_;
  std::vector<std::thread> threads_;
  std::atomic<bool> stop_flag_;
  polling_config cfg_;
};
// ------------------------------------------------------------
// main 函数:创建一个 4 个 worker 的调度器,故意把所有任务都塞到
// Worker 0 的队列里,让其他三个 worker 都得靠"偷"来获得工作,
// 直观演示工作窃取的效果。
// ------------------------------------------------------------
int main() {
  const size_t num_workers = 4;
  work_stealing_scheduler scheduler(num_workers);
  // 用一个原子计数器统计总共完成了多少个任务,方便观察结果
  std::atomic<int> finished_count{0};
  // 故意把全部 20 个任务都塞到 Worker 0(也就是图里"Victim"的角色)
  for (int i = 0; i < 20; ++i) {
    scheduler.submit(0, [i, &finished_count] {
      // 模拟这个任务需要花一点时间处理
      std::this_thread::sleep_for(std::chrono::milliseconds(5));
      finished_count.fetch_add(1, std::memory_order_relaxed);
    });
  }
  scheduler.start();
  // 主线程等待,直到全部 20 个任务都被完成
  while (finished_count.load(std::memory_order_relaxed) < 20) {
    std::this_thread::sleep_for(std::chrono::milliseconds(10));
  }
  std::cout << "全部任务完成,总数: " << finished_count.load() << std::endl;
  scheduler.stop();
  return 0;
}
代码关键点解析
spinlock类:用std::atomic_flag模拟 CAF 文档里提到的"自旋锁",加锁时不断循环尝试直到成功,不会像互斥锁那样让线程进入睡眠状态——适合"预期锁很快就能拿到"的短临界区场景。work_queue的头部/尾部区分:try_pop_own从tasks_.front()取(自己最近放入的),try_steal从tasks_.back()取(最老的、跟当前 worker 关系最疏远的),这正是双端队列在工作窃取算法里的经典用法。worker_loop的整体逻辑:先尝试处理自己队列里的任务;自己队列空了,就调用try_steal_with_backoff进入"偷窃 + 退避"流程。try_steal_with_backoff的三段式结构:完全对应文档描述的"激进(无休眠、100 次)→ 温和(50 微秒休眠、500 次)→ 放松(10 毫秒休眠)"三级策略,每一级失败次数用尽后自动降级到下一级,只要中途偷到任务就立即返回。attempt_steal_once的随机选择受害者:用std::mt19937随机数生成器在所有 worker 里随机挑一个作为"受害者",如果挑到自己就直接放弃这次尝试(因为偷自己没有意义)。main函数里刻意的"偏心"分配:把所有 20 个任务都塞进 Worker 0 一个人的队列,让 Worker 1、2、3 的队列从一开始就是空的,这样运行起来就能清楚看到它们全靠"偷"来获得工作,日志里会打印出一条条"Worker X 从 Worker 0 那里偷到了一个任务"。
六、任务分配与窃取过程的时序图
七、三级轮询退避策略的 ASCII 示意
worker 自己的队列空了
        |
        v
+-------------------+
| 阶段一: 激进策略   |   尝试次数: 100 次
| 两次尝试间隔: 0    |   如果偷到任务 -> 立即执行并跳出
+-------------------+
        |
        | (100次都没偷到)
        v
+-------------------+
| 阶段二: 温和策略   |   尝试次数: 500 次
| 两次尝试间隔: 50微秒|  如果偷到任务 -> 立即执行并跳出
+-------------------+
        |
        | (500次都没偷到)
        v
+-------------------+
| 阶段三: 放松策略   |   尝试次数: 无限
| 两次尝试间隔: 10毫秒|  持续尝试, 直到偷到任务为止
+-------------------+
八、工作窃取 vs 全局队列:核心区别对照
| 对比维度 | 单一全局队列 | 工作窃取(每个 worker 独立队列) |
|---|---|---|
| 锁竞争程度 | 高(所有线程抢同一把锁) | 低(大多数时候只操作自己的队列) |
| 缓存局部性 | 差(任务可能被任意线程处理) | 好(任务默认绑定在同一个 worker,只有被偷时才迁移) |
| 空闲检测 | 相对简单(队列空即全局空闲) | 较难(每个 worker 只有局部信息,需要退避轮询策略) |
| 采用该策略的框架举例 | 部分简单线程池 | Java Fork-Join(Akka 底层使用)、Intel TBB、部分 OpenMP 实现、CAF |
九、小结
- 工作窃取算法用"每个 worker 一个私有双端队列"取代了"所有线程共用一个全局队列",大幅降低了锁竞争,同时因为任务默认固定在同一个 worker 上运行,也提升了缓存命中率。
- 队列的两端分工明确:worker 自己从一端取最新任务,小偷从另一端偷最老的任务,减少双方同时操作同一个任务的冲突概率。
- 因为算法是去中心化的,每个 worker 无法直接知道全局是否"真的没活干了",所以 CAF 设计了"激进 → 温和 → 放松"三级轮询退避策略:越久偷不到任务,就越"放松"地降低轮询频率,兼顾响应速度和 CPU 占用。
- 这几个轮询参数(100 次 / 500 次 / 0 休眠 / 50 微秒 / 10 毫秒)都是默认值,可以在系统配置里按需调整。
引用计数与 C++ 标准库共享指针设计详解
一、整体概念:为什么 actor 系统需要引用计数
在一个复杂的 actor 系统里,actor 之间会形成错综复杂的通信关系图:A 可能持有 B 的句柄,B 又把自己的句柄发给了 C,C 又把它转发给了 D……随着系统运行,"到底还有没有人在用这个 actor"这件事会变得极难人工判断。
所以,靠人手动去管理每个 actor 什么时候该销毁,几乎是不可能做到的事情。CAF 的解决方式是:借鉴经典的"引用计数(reference counting)“垃圾回收思路,用**强引用(strong reference)和弱引用(weak reference)**两种计数器来自动追踪一个 actor 还有没有"活着的必要”。
这个思路可以用一句话概括:
只要还有 ≥1 个强引用指向某个对象,这个对象就不能被销毁
\text{只要还有 } \ge 1 \text{ 个强引用指向某个对象,这个对象就不能被销毁}
只要还有 ≥1 个强引用指向某个对象,这个对象就不能被销毁
强引用计数归零时,对象本体被销毁;但只要还有弱引用存在,控制块本身仍需保留
\text{强引用计数归零时,对象本体被销毁;但只要还有弱引用存在,控制块本身仍需保留}
强引用计数归零时,对象本体被销毁;但只要还有弱引用存在,控制块本身仍需保留
二、C++ 标准库里的共享指针:shared_ptr 与 weak_ptr
在讲 CAF 自己的设计之前,先把 C++ 标准库已经提供的这套机制搞明白,因为 CAF 的设计正是在这个基础上"抄了作业、又做了改良"。
1. 核心角色:控制块(control block)
shared_ptr<T> 和 weak_ptr<T> 之所以能够"共享同一份数据、又能自动知道什么时候该销毁它",靠的是一个叫**控制块(control block)**的辅助结构。控制块里存着:
- strong refs:当前有多少个
shared_ptr正指向这份数据(强引用计数); - weak refs:当前有多少个
weak_ptr正观察着这份数据(弱引用计数); - 指向真正数据的指针(或者数据本身,取决于具体的内存布局,下面会细讲)。
强弱引用计数的作用机制可以这样理解:
strong refs→0 ⇒ 立即析构 T 这个对象本体(调用它的析构函数) \text{strong refs} \to 0 \;\Rightarrow\; \text{立即析构 T 这个对象本体(调用它的析构函数)} strong refs→0⇒立即析构 T 这个对象本体(调用它的析构函数)
strong refs→0 且 weak refs→0 ⇒ 控制块本身也被释放 \text{strong refs} \to 0 \text{ 且 } \text{weak refs} \to 0 \;\Rightarrow\; \text{控制块本身也被释放} strong refs→0 且 weak refs→0⇒控制块本身也被释放
也就是说,weak_ptr存在的意义是:即使数据本体已经被销毁了,控制块还得留着,好让weak_ptr能安全地判断出"我曾经指向的东西已经没了",而不会导致野指针式的崩溃。
2. 布局一:手动分配对象(图 1)
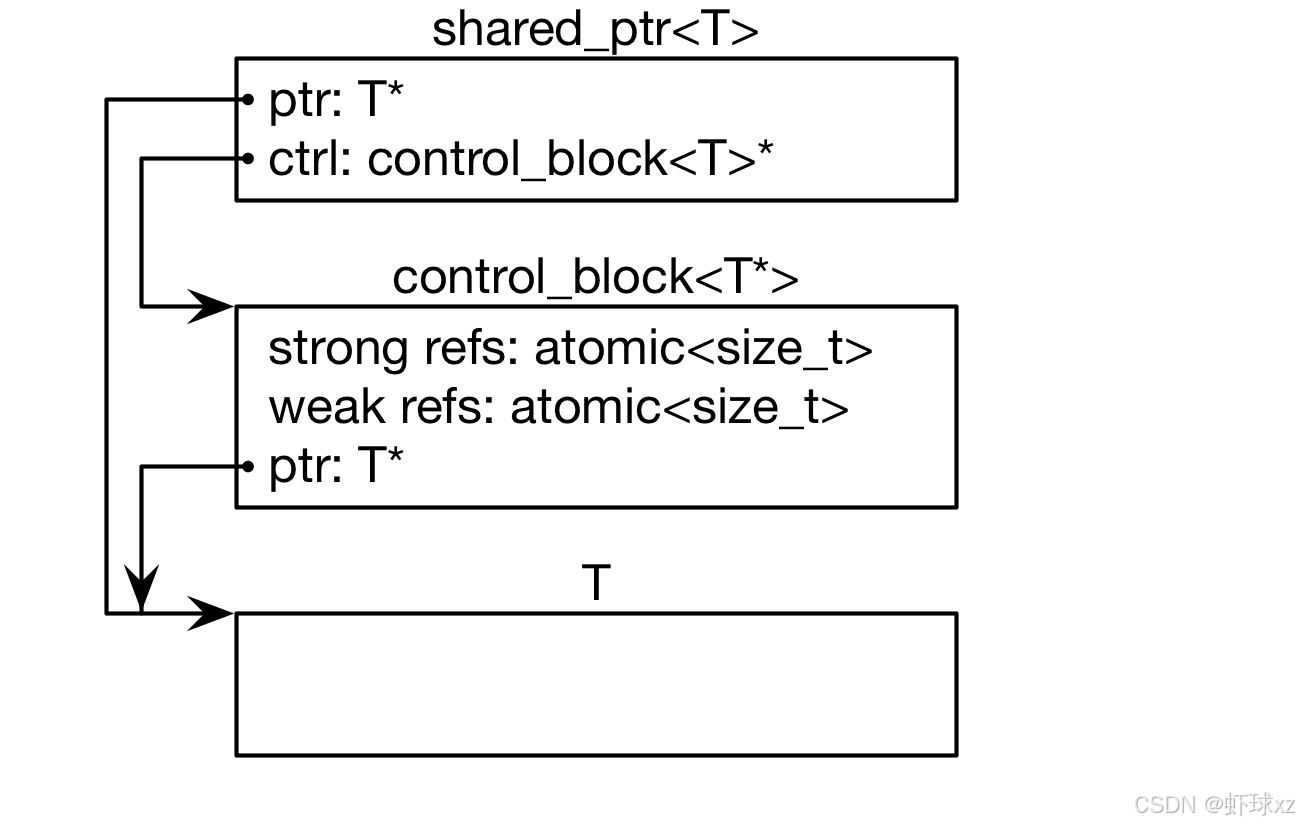
当你这样写代码:
std::shared_ptr<int> iptr{new int};
标准库采用的是原文图 1 所示的布局——数据 T 和控制块是分开两块内存,控制块里额外存一个指向 T 的指针。这样设计的好处是:控制块和数据本体在物理内存上是独立的两块区域,可以各自独立地被释放。
对小对象来说这点区别无关紧要,但如果 T 是一个很大的对象,这种设计能带来更灵活的内存管理。代价是 shared_ptr 本身必须在内部同时存两个指针——一个指向数据 T,一个指向控制块——否则每次解引用(比如 *iptr)都得先跳到控制块里再去找数据的位置,多绕一圈,效率不高。
用 mermaid 还原图 1 的结构:
3. 布局二:make_shared(图 2)
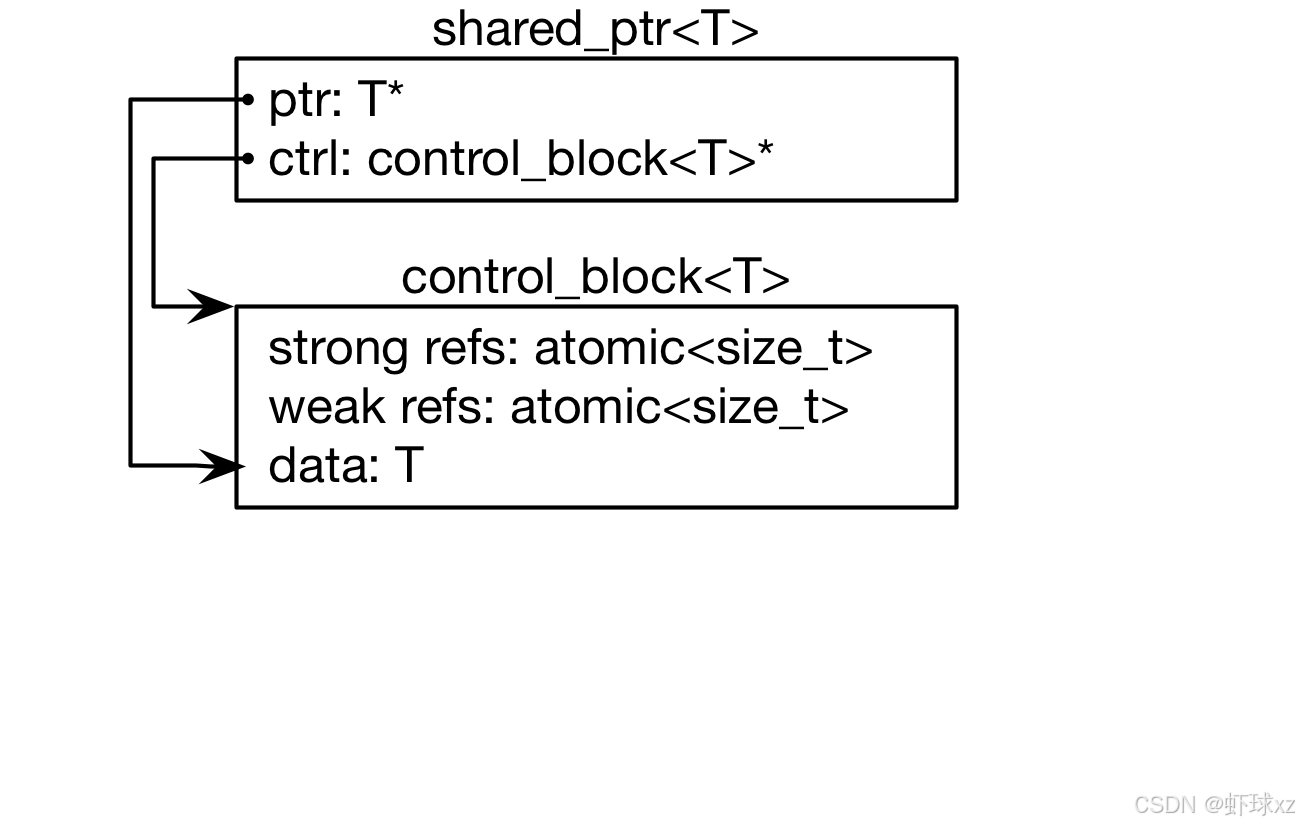
如果改用 make_shared(或者 allocate_shared)来创建对象:
auto iptr = std::make_shared<int>(42);
标准库会做一个优化:把控制块和数据 T 放进同一块内存里一次性分配(原文图 2 里 data: T 直接就在控制块结构体内部,而不是通过一个指针再指向别处)。
这样做的好处很直接:
分配次数从 2 次(数据 + 控制块) 降为 1 次 ⇒ 更少的堆内存碎片、更好的缓存局部性
\text{分配次数从 2 次(数据 + 控制块) 降为 1 次} \;\Rightarrow\; \text{更少的堆内存碎片、更好的缓存局部性}
分配次数从 2 次(数据 + 控制块) 降为 1 次⇒更少的堆内存碎片、更好的缓存局部性
但要注意一点:即使数据和控制块合并存储了,shared_ptr<T> 本身内部结构没有变化,依然要存两个指针(ptr 指向数据、ctrl 指向控制块)——因为 shared_ptr 本身并不知道你到底是用 new 手动分配的(数据和控制块分离),还是用 make_shared 分配的(数据和控制块在一起),它只能统一按"两个指针都存一份"的方式处理,保证接口一致性。
用 mermaid 还原图 2 的结构:
4. 布局三:enable_shared_from_this(图 3)
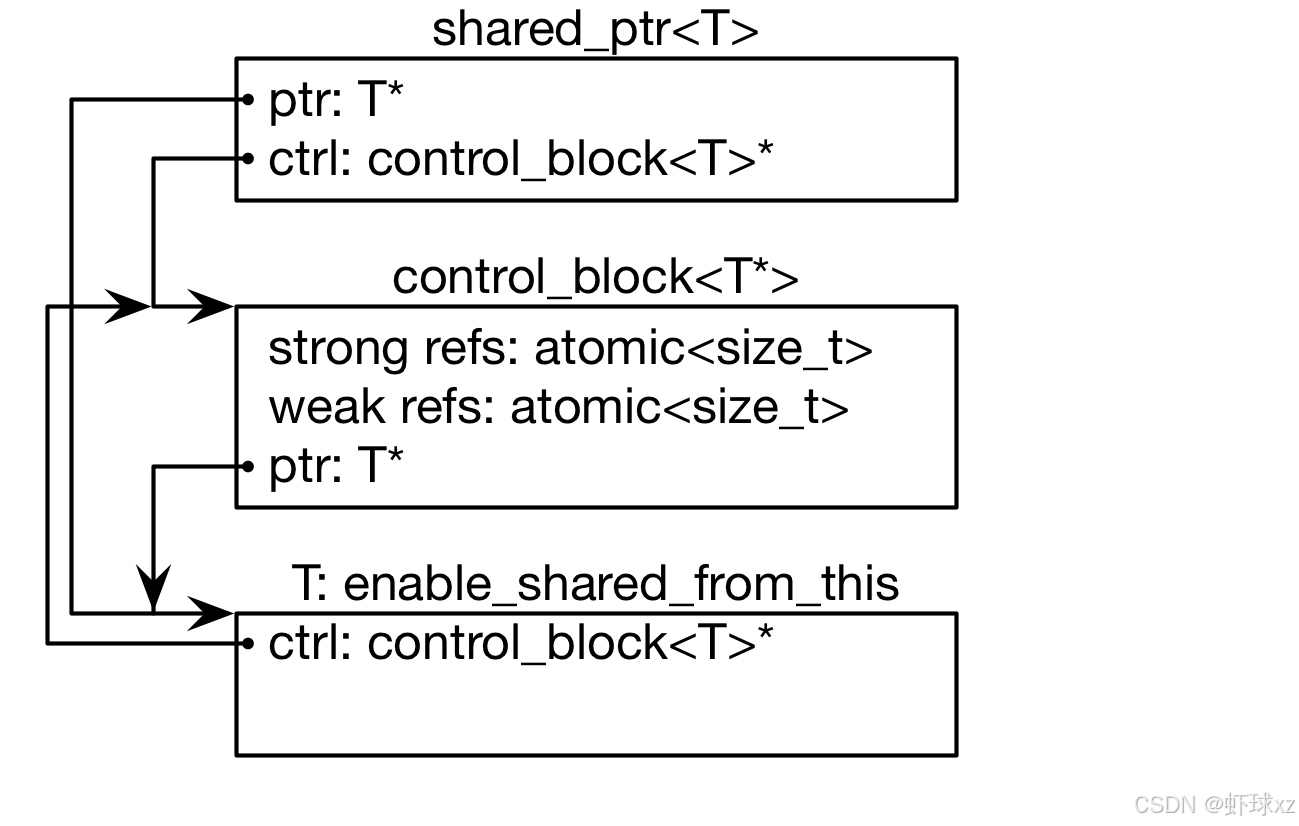
有一种更特殊的需求:一个对象自己内部想要"给自己再生成一个 shared_ptr"(比如某个成员函数需要把 this 包装成 shared_ptr 传给别的模块使用)。直接用 shared_ptr<T>(this) 是不安全的做法,因为这样会凭空创建一个全新的控制块,跟原本已经存在的那个控制块完全无关,导致同一个对象被两套独立的引用计数分别"管理",最终引发重复释放(double free)这类严重问题。
标准库的解决办法是让 T 继承 std::enable_shared_from_this<T>,这样 T 内部就会额外存一个指向控制块的指针(原文图 3 里,T: enable_shared_from_this 这个框内部有一个 ctrl: control_block<T>* 字段)。这样一来,对象自己内部就能"反向导航"回到控制块,进而安全地生成一个跟原来共享同一套计数的新 shared_ptr,而不是另起炉灶。
用 mermaid 还原图 3 的结构:
三种布局放在一起做个总结对比:
| 布局方式 | 数据与控制块是否合并存储 | shared_ptr 内部存几个指针 | 额外特性 |
|---|---|---|---|
手动 new 分配 | 否, 各自独立一块内存 | 2 个(ptr, ctrl) | 可以独立析构数据本体 |
make_shared | 是, 合并在同一块内存 | 2 个(ptr, ctrl) | 减少一次堆分配, 缓存局部性更好 |
enable_shared_from_this | 视创建方式而定(可与make_shared结合) | 2 个(ptr, ctrl) | 对象内部额外存一份指回控制块的指针, 可安全地自己生成shared_ptr |
三、完整可运行的 C++ 示例代码:三种布局逐一验证
下面写一份完整、可编译运行的示例,分别演示上面讲的三种典型用法,并在代码里加打印语句,直观观察引用计数的变化过程。
编译方式:
g++ -std=c++17 shared_ptr_demo.cpp -o shared_ptr_demo
./shared_ptr_demo
// ============================================================
// shared_ptr_demo.cpp
// 演示 C++ 标准库 shared_ptr 的三种典型内存布局场景:
//   1) 手动 new 分配:数据与控制块分离
//   2) make_shared:数据与控制块合并存储
//   3) enable_shared_from_this:对象内部反向导航回控制块
// ============================================================
#include <iostream>
#include <memory>
#include <string>
// ------------------------------------------------------------
// 一个简单的日志类,用于观察构造/析构时机,
// 从而间接验证"数据什么时候被真正销毁"这件事。
// ------------------------------------------------------------
struct traced_object {
  std::string name;
  explicit traced_object(std::string n) : name(std::move(n)) {
    std::cout << "[构造] traced_object(" << name << ") 被创建" << std::endl;
  }
  ~traced_object() {
    std::cout << "[析构] traced_object(" << name << ") 被销毁" << std::endl;
  }
};
// ------------------------------------------------------------
// 场景三所需:一个能"给自己生成 shared_ptr"的类,
// 必须继承 std::enable_shared_from_this<T>
// ------------------------------------------------------------
struct self_aware_object : std::enable_shared_from_this<self_aware_object> {
  std::string name;
  explicit self_aware_object(std::string n) : name(std::move(n)) {
    std::cout << "[构造] self_aware_object(" << name << ") 被创建" << std::endl;
  }
  ~self_aware_object() {
    std::cout << "[析构] self_aware_object(" << name << ") 被销毁" << std::endl;
  }
  // 这个成员函数演示"对象自己生成一个指向自己的 shared_ptr",
  // shared_from_this() 内部正是通过 enable_shared_from_this
  // 存的那个"反向指回控制块的指针"来实现的
  std::shared_ptr<self_aware_object> get_self_ptr() {
    return shared_from_this();
  }
};
// ------------------------------------------------------------
// 场景一:手动 new 分配,数据与控制块是两块独立内存
// ------------------------------------------------------------
void demo_manual_new() {
  std::cout << std::endl << "===== 场景一:手动 new 分配 =====" << std::endl;
  // 用 new 先分配出 traced_object,再交给 shared_ptr 接管,
  // 此时控制块是另外单独分配的一块内存,跟 traced_object 本体是分离的
  std::shared_ptr<traced_object> p1(new traced_object("手动分配对象"));
  std::cout << "此时强引用计数 use_count = " << p1.use_count() << std::endl;
  {
    // 拷贝一份 shared_ptr,强引用计数会 +1
    std::shared_ptr<traced_object> p2 = p1;
    std::cout << "p2 拷贝后, 强引用计数 use_count = " << p1.use_count()
              << std::endl;
    // p2 离开作用域时,强引用计数会自动 -1
  }
  std::cout << "p2 已离开作用域, 强引用计数 use_count = " << p1.use_count()
            << std::endl;
  // p1 离开函数作用域时,强引用计数归零,
  // traced_object 的析构函数会被自动调用
}
// ------------------------------------------------------------
// 场景二:make_shared,数据与控制块合并存储在同一块内存
// ------------------------------------------------------------
void demo_make_shared() {
  std::cout << std::endl << "===== 场景二:make_shared =====" << std::endl;
  // make_shared 只做一次内存分配,同时容纳控制块和数据本体
  auto p1 = std::make_shared<traced_object>("make_shared对象");
  std::cout << "此时强引用计数 use_count = " << p1.use_count() << std::endl;
  // 创建一个 weak_ptr 观察它,验证弱引用不会影响数据的销毁时机
  std::weak_ptr<traced_object> weak_observer = p1;
  std::cout << "创建weak_ptr后, 强引用计数依然是 use_count = "
            << p1.use_count() << std::endl;
  p1.reset();  // 主动释放这个 shared_ptr,强引用计数归零,触发析构
  // 强引用归零后,数据本体已经被销毁,
  // weak_ptr.lock() 应该返回一个空的 shared_ptr
  if (auto locked = weak_observer.lock()) {
    std::cout << "weak_ptr 仍然能锁定到对象(不应该出现这行)" << std::endl;
  } else {
    std::cout << "weak_ptr 已经锁定不到对象了,说明数据本体已被销毁"
              << std::endl;
  }
}
// ------------------------------------------------------------
// 场景三:enable_shared_from_this,对象内部反向生成 shared_ptr
// ------------------------------------------------------------
void demo_enable_shared_from_this() {
  std::cout << std::endl << "===== 场景三:enable_shared_from_this ====="
            << std::endl;
  // 必须先用 shared_ptr(通常配合 make_shared)持有这个对象,
  // 才能安全调用它的 shared_from_this();
  // 如果对象一开始不是被 shared_ptr 管理的,
  // 调用 shared_from_this() 会在运行时抛出异常
  auto original = std::make_shared<self_aware_object>("自我感知对象");
  std::cout << "original 创建后, 强引用计数 use_count = "
            << original->use_count() << std::endl;
  // 对象内部调用 shared_from_this(),
  // 生成的 self_ptr 跟 original 共享同一套引用计数
  auto self_ptr = original->get_self_ptr();
  std::cout << "调用 get_self_ptr() 之后, 强引用计数 use_count = "
            << original->use_count() << std::endl;
  std::cout << "original 和 self_ptr 是否共享同一个控制块: "
            << (original.get() == self_ptr.get() ? "是" : "否") << std::endl;
}
int main() {
  demo_manual_new();
  demo_make_shared();
  demo_enable_shared_from_this();
  return 0;
}
代码关键点解析
traced_object的构造/析构打印:通过在构造函数和析构函数里打印日志,可以直观地在控制台上"看到"对象到底是什么时候被创建、什么时候被真正销毁的,这是理解引用计数生效时机最直接的办法。use_count():这是shared_ptr提供的成员函数,返回当前有多少个shared_ptr共同指向同一份数据(也就是控制块里的 strong refs 计数值)。- 场景一(手动
new):std::shared_ptr<traced_object> p1(new traced_object(...))这种写法下,new先单独分配出traced_object,shared_ptr构造时才另外分配一块控制块内存来管理它——对应原文图 1 的"数据与控制块分离"布局。 - 场景二(
make_shared):std::make_shared<traced_object>(...)会把控制块和traced_object数据本体一次性分配在同一块内存里——对应原文图 2 的"合并存储"布局。代码里额外演示了weak_ptr:强引用计数归零(p1.reset())之后,数据本体被销毁,但控制块本身还留着(因为weak_observer这个弱引用还在),所以weak_observer.lock()能安全地返回一个空指针,而不会导致程序崩溃。 - 场景三(
enable_shared_from_this):self_aware_object继承了std::enable_shared_from_this<self_aware_object>,因此它内部隐式地存了一个指回控制块的指针。get_self_ptr()内部调用的shared_from_this(),正是利用这个隐藏指针,安全地生成一个跟original共享同一套引用计数的新shared_ptr,而不是凭空创建一个无关的控制块。代码最后用original.get() == self_ptr.get()验证两者确实指向同一块数据。
四、三段场景的对象生命周期时序图
五、内存布局的 ASCII 直观示意
场景一: 手动 new 分配
+----------------+        +---------------------+        +------------------+
| shared_ptr<T>  | -----> | control_block<T>     |        |                  |
|  ptr  --------------------------------------------------> |    T (数据本体)  |
|  ctrl ------->  |        |  strong refs         |        |                  |
+----------------+        |  weak refs           |        +------------------+
                           |  ptr ---------------------------> (同上, 指向T)
                           +---------------------+
                           (控制块与T是两块独立内存)
场景二: make_shared 合并存储
+----------------+        +--------------------------------+
| shared_ptr<T>  | -----> | control_block<T>                |
|  ptr  ----------------->|   strong refs                   |
|  ctrl ---------------->|   weak refs                      |
+----------------+        |   data: T   <--- 数据直接嵌在这里 |
                           +--------------------------------+
                           (控制块与T是同一块内存)
场景三: enable_shared_from_this
+----------------+        +---------------------+        +---------------------+
| shared_ptr<T>  | -----> | control_block<T>     |        | T (继承enable_..)   |
|  ptr  --------------------------------------------------> |  ctrl: 指回控制块 --+
|  ctrl ------->  |        |  strong refs         |        +---------------------+
+----------------+        |  weak refs           |                 ^
                           |  ptr --------------------------------|
                           +---------------------+
                           (T内部额外存一份指回控制块的指针, 可自我生成shared_ptr)
六、小结
- C++ 标准库的
shared_ptr/weak_ptr通过一个独立的"控制块"来统一管理强引用(strong refs)和弱引用(weak refs)计数,强引用归零时销毁数据本体,弱引用也归零时才真正释放控制块本身。 - 手动用
new创建对象时,数据和控制块是两块独立内存,各自可以独立析构;用make_shared时,两者合并成一块内存分配,减少一次堆分配开销;这两种情况下shared_ptr本身始终要存两个指针(指向数据、指向控制块),因为它并不知道两者是否合并存储。 - 当一个对象需要在内部"给自己生成一个
shared_ptr"时,必须继承std::enable_shared_from_this<T>,这样对象内部会额外存一份指回控制块的指针,让shared_from_this()能安全地复用已有的引用计数,而不是意外创建一套全新的、互不相关的计数体系。 - CAF 之所以没有直接套用这套标准库方案,而是自己设计了一套类似但略有不同的引用计数机制,主要是因为:一方面需要在控制块里额外存放 actor 的身份信息,另一方面 actor 句柄在消息传递过程中会被极其频繁地复制,标准库那种"始终要存两个指针"的设计会带来不必要的额外开销,CAF 想要一种间接层次更少、更轻量的实现方式。
CAF 中 Actor 的智能指针设计详解
1. 为什么 CAF 不直接用 std::shared_ptr
标准库的 std::shared_ptr 已经是一个很成熟的引用计数智能指针了,但 CAF 并没有直接拿来用,而是自己设计了一套 strong_actor_ptr / weak_actor_ptr。原因主要有三条:
- Actor 对象和它的"控制块"总是一起分配的:CAF 在创建一个 Actor 的时候,会把"控制块"(保存引用计数、身份信息等)和"Actor 对象本身"分配在同一块连续内存里,而不是像
std::shared_ptr那样,控制块和对象可能是分开两次new出来的。 - 控制块里需要存放额外的信息:不只是引用计数,还要存 Actor 的 ID、所在节点的 ID 等身份信息(这些内容马上会详细展开)。
- 只需要存一个裸指针,而不是两个:
std::shared_ptr内部通常同时保存"指向对象的指针"和"指向控制块的指针"这两个裸指针;而 CAF 通过巧妙的内存布局设计,只需要保存一个指向控制块的指针,就能推算出对象的位置(反之亦然),从而把智能指针本身的体积做得更小。
2. strong_actor_ptr 与 weak_actor_ptr 的整体结构
CAF 用 strong_actor_ptr 对应标准库里的 std::shared_ptr,用 weak_actor_ptr 对应 std::weak_ptr。和标准库不同的是,这两种智能指针内部都只存一个指针——一个指向"控制块"(control_block*)的裸指针:
// strong_actor_ptr 的核心组成(示意)
struct strong_actor_ptr {
  control_block* ctrl; // 唯一的一个成员:指向控制块的裸指针
};
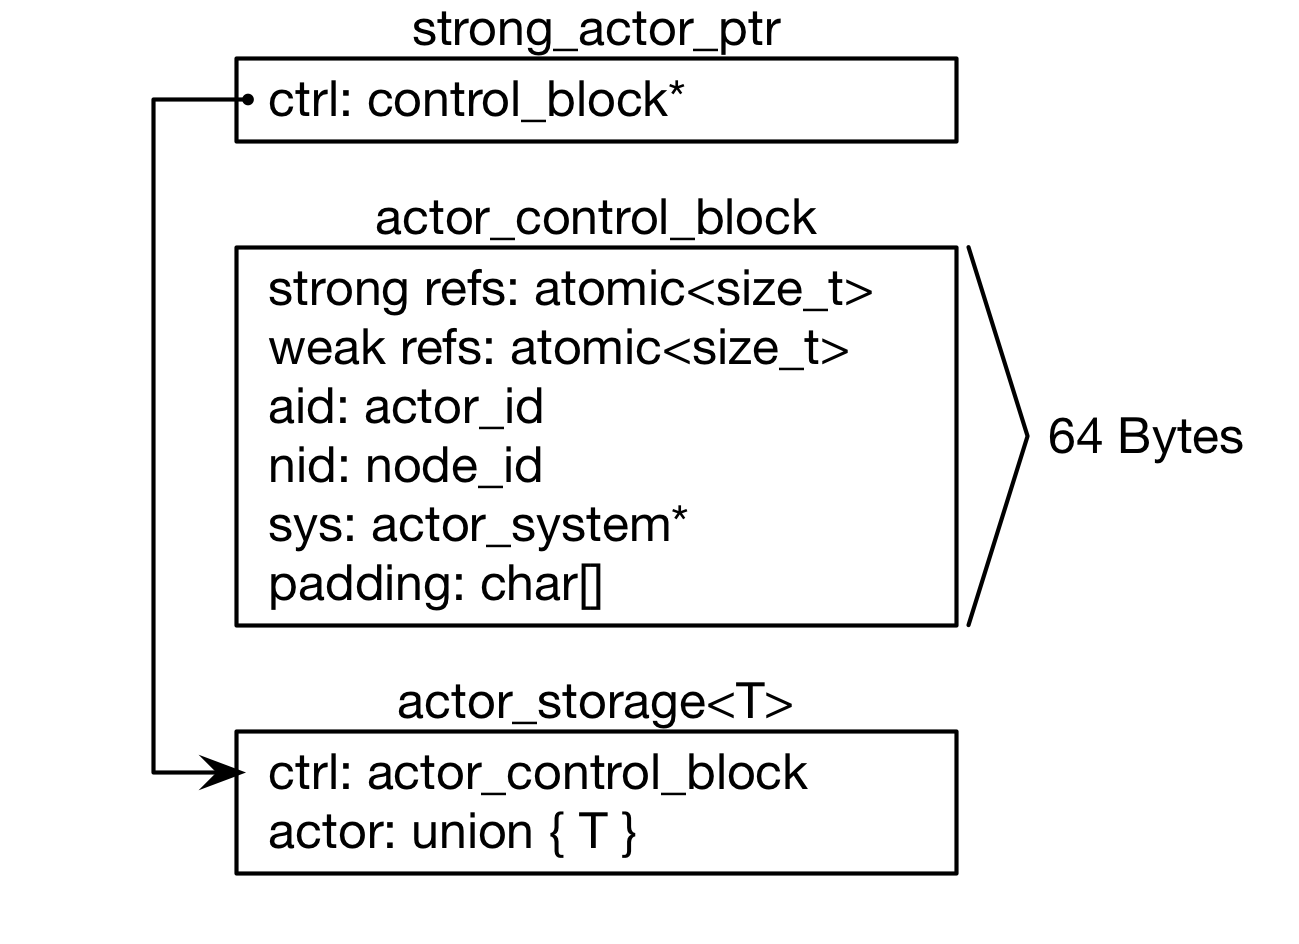
下面这张图对应本节开头那张架构图,展示了 strong_actor_ptr、控制块、以及实际 Actor 对象三者之间的指向关系:
可以看出,strong_actor_ptr 并不是分别记录"控制块地址"和"对象地址"这两份信息,它只记录控制块的地址,对象的地址是靠固定的内存布局推算出来的——这正是 CAF 能把智能指针体积压缩成"只存一个指针"的关键所在。
3. 控制块 actor_control_block 里到底存了什么
CAF 里的控制块和标准库 shared_ptr 的控制块有一处明显不同:它不是模板,也就是说不管 T 是什么具体的 Actor 类型,控制块的结构和大小都是完全一样的。它里面保存的字段如下:
| 字段 | 类型 | 作用 |
|---|---|---|
strong refs | atomic<size_t> | 强引用计数,跟 strong_actor_ptr 的存活数量对应 |
weak refs | atomic<size_t> | 弱引用计数,跟 weak_actor_ptr 的存活数量对应 |
aid | actor_id | 这个 Actor 的编号 |
nid | node_id | 这个 Actor 所在节点(机器)的编号 |
sys | actor_system* | 指回这个 Actor 所属的 Actor 系统 |
padding | char[] | 填充字节,保证整个结构体凑满固定大小 |
之所以要把 aid(Actor 编号)和 nid(节点编号)这两项身份信息也放进控制块,而不是放在 Actor 对象本身里面,是因为控制块的生命周期比 Actor 对象本身更长——即使一个 Actor 已经终止、它的对象已经被销毁了,只要还有 strong_actor_ptr 或 weak_actor_ptr 指着它的控制块,就依然可以通过控制块查到"这曾经是哪个 Actor、在哪个节点上"这些身份信息。
4. 控制块恰好是 64 字节:为了避免"伪共享"
文档特别强调了一点:控制块的大小被精心设计成恰好 64 字节,正好是绝大多数现代 CPU 一条缓存行(cache line)的大小。这么做的原因是为了避免"伪共享"(false sharing)——如果两个毫不相关的 Actor 的控制块被放进了同一条缓存行,那么一个线程频繁修改自己 Actor 的引用计数(strong_refs / weak_refs 都是原子操作),就会连带着让另一个线程里缓存的、本来无关的那个控制块也跟着失效,需要重新从内存加载,造成不必要的性能损耗。把每个控制块的大小精确控制在一条缓存行的宽度,就能保证不同 Actor 的控制块之间永远不会"挤"在同一条缓存行里,从根源上避免这种伪共享。
5. actor_storage<T>:控制块与 Actor 对象的内存布局
actor_storage<T> 描述的是"控制块 + 实际 Actor 对象"在内存里紧挨着排列的布局:
地址偏移(字节)                内容
  0  ┌──────────────────────────────────┐
     │  actor_control_block (共64字节)     │
     │   strong_refs : atomic<size_t>    │ offset  0 ~ 7
     │   weak_refs   : atomic<size_t>    │ offset  8 ~ 15
     │   aid         : actor_id          │ offset 16 ~ 23
     │   nid         : node_id           │ offset 24 ~ 31
     │   sys         : actor_system*     │ offset 32 ~ 39
     │   padding     : char[24]          │ offset 40 ~ 63
 64  ├──────────────────────────────────┤
     │  T actor(实际的 Actor 对象)         │ offset 64 起
     │                                    │
     └──────────────────────────────────┘
因为控制块的大小是固定的 64 字节,并且 CAF 保证所有 Actor 都严格按照 actor_storage<T> 这种布局分配内存,所以只要拿到控制块的起始地址,往后偏移 646464 字节,就一定能拿到紧跟在它后面的 Actor 对象的地址;反过来,拿到 Actor 对象的地址,往前偏移 646464 字节,也一定能推算出它对应的控制块地址。用公式表示就是:
addr(actor)=addr(ctrl)+64\mathrm{addr}(actor) = \mathrm{addr}(ctrl) + 64addr(actor)=addr(ctrl)+64
addr(ctrl)=addr(actor)−64\mathrm{addr}(ctrl) = \mathrm{addr}(actor) - 64addr(ctrl)=addr(actor)−64
6. 为什么这种指针运算要求"不能用虚继承"
上面这种"靠固定字节偏移量互相推算地址"的技巧,有一个前提:从控制块地址算出来的那个内存起始位置,要能通过 reinterpret_cast 直接、安全地当成 abstract_actor* 来使用。也就是说,T* 必须能通过 reinterpret_cast 转换成 abstract_actor*。
这里的关键限制是:Actor 的子类不能使用虚继承(virtual inheritance)。原因在于,普通的公有继承下,子类对象内存里"基类子对象"所在的位置,是编译期就能确定的固定偏移量,所以直接用字节偏移加减就能正确定位;但如果用了虚继承,基类子对象在派生类对象内存里的具体位置,要靠运行时通过虚基类表(vbtable)才能查到,并不是一个编译期固定的偏移量,这样一来"直接按固定字节数做指针运算"的前提就不成立了。CAF 为了保证这套高效的地址推算技巧始终有效,会在编译期用 static_assert 强制检查,一旦某个 Actor 子类使用了虚继承,代码根本无法通过编译。
7. 完整可运行的教学模拟代码
真实的 CAF 控制块和 actor_storage<T> 是库内部的实现细节,不适合直接拿来演示。下面这份代码用纯标准库、不依赖 CAF 的方式,完整还原了"控制块恰好 64 字节"、“控制块与 Actor 对象紧挨着分配”、“通过固定偏移量互相推算地址”、以及"极简版只存一个指针的强引用智能指针"这几个核心设计点,可以直接编译运行。
// actor_smart_pointer_demo.cpp
//
// 编译方式:
//   g++ -std=c++17 actor_smart_pointer_demo.cpp -o actor_smart_pointer_demo
// 运行:
//   ./actor_smart_pointer_demo
#include <atomic>
#include <cstddef>
#include <cstdint>
#include <iostream>
#include <new>
#include <utility>
// ------------------------------------------------------------------
// 简化版的身份信息类型,真实 CAF 里 node_id 包含更多机器识别信息,
// 这里为了演示方便简化成一个普通的 64 位整数。
// ------------------------------------------------------------------
using actor_id = uint64_t;
using node_id = uint64_t;
// 占位用的 actor_system 类型,这里只关心指针本身,不需要真实实现
struct actor_system_stub {};
// ------------------------------------------------------------------
// actor_control_block:对应文档里的控制块。
// 各字段大小在 64 位平台上分别是 8 字节,5 个 8 字节字段一共 40 字节,
// 再加 24 字节的 padding,正好凑满 64 字节,对应一条 CPU 缓存行。
// ------------------------------------------------------------------
struct actor_control_block {
  std::atomic<size_t> strong_refs; // 强引用计数,8字节
  std::atomic<size_t> weak_refs;   // 弱引用计数,8字节
  actor_id aid;                    // Actor 编号,8字节
  node_id nid;                     // 所在节点编号,8字节
  actor_system_stub* sys;          // 指回所属 actor system,8字节
  char padding[24];                // 填充字节,凑满64字节
  actor_control_block(actor_id id, node_id n, actor_system_stub* s)
    : strong_refs(1), weak_refs(1), aid(id), nid(n), sys(s) {}
};
// 编译期强制检查:控制块必须恰好是 64 字节(一条缓存行的大小),
// 这正是"避免伪共享"这一设计目标在代码里的直接体现。
static_assert(sizeof(actor_control_block) == 64,
              "控制块必须恰好是 64 字节,否则可能引发伪共享问题");
// ------------------------------------------------------------------
// abstract_actor_stub:模拟 CAF 里的 abstract_actor 基类,
// 要求所有具体的 Actor 类型都必须以"普通公有继承"(而不是虚继承)
// 的方式派生自它,这样才能保证固定偏移量的地址推算是安全的。
// ------------------------------------------------------------------
struct abstract_actor_stub {
  virtual ~abstract_actor_stub() = default;
  virtual void greet() const = 0;
};
// 一个具体的 Actor 类型,普通公有继承,没有使用虚继承
struct my_actor : abstract_actor_stub {
  int counter = 0;
  void greet() const override {
    std::cout << "  [my_actor] 我还活着,counter = " << counter << std::endl;
  }
};
// ------------------------------------------------------------------
// actor_storage<T>:把控制块和实际的 Actor 对象紧挨着放在同一块内存里,
// 控制块排在最前面(占 64 字节),T 紧跟在控制块后面。
// ------------------------------------------------------------------
template <class T>
struct actor_storage {
  actor_control_block ctrl; // 固定排在最前面,占 64 字节
  union {
    T actor; // 紧跟在控制块后面的实际 Actor 对象
  };
  template <class... Args>
  actor_storage(actor_id id, node_id n, actor_system_stub* s, Args&&... args)
    : ctrl(id, n, s) {
    // union 里的成员不会被自动构造,需要手动用 placement new 构造
    new (&actor) T(std::forward<Args>(args)...);
  }
  ~actor_storage() {
    actor.~T();
  }
};
// ------------------------------------------------------------------
// 从"控制块地址"推算出"Actor 对象地址":
// 直接把地址往后偏移 sizeof(actor_control_block)(也就是 64)个字节。
// ------------------------------------------------------------------
abstract_actor_stub* actor_from_control_block(actor_control_block* ctrl) {
  // reinterpret_cast 把裸字节地址重新解释成 abstract_actor_stub*,
  // 这一步之所以安全,前提正是 T 没有使用虚继承,
  // 对象在内存里的布局是"平坦的、偏移量固定"的。
  auto raw = reinterpret_cast<char*>(ctrl) + sizeof(actor_control_block);
  return reinterpret_cast<abstract_actor_stub*>(raw);
}
// 反过来:从"Actor 对象地址"推算出"控制块地址",往前偏移 64 字节。
actor_control_block* control_block_from_actor(void* actor_ptr) {
  auto raw = reinterpret_cast<char*>(actor_ptr) - sizeof(actor_control_block);
  return reinterpret_cast<actor_control_block*>(raw);
}
// ------------------------------------------------------------------
// 极简版的强引用智能指针:内部只存一个裸指针(指向控制块),
// 对应文档里"strong_actor_ptr 内部只存一个指针"这一设计要点。
// ------------------------------------------------------------------
class simple_strong_actor_ptr {
public:
  explicit simple_strong_actor_ptr(actor_control_block* c) : ctrl_(c) {
    if (ctrl_)
      ++ctrl_->strong_refs;
  }
  simple_strong_actor_ptr(const simple_strong_actor_ptr& other)
    : ctrl_(other.ctrl_) {
    if (ctrl_)
      ++ctrl_->strong_refs;
  }
  ~simple_strong_actor_ptr() {
    if (ctrl_ && --ctrl_->strong_refs == 0) {
      std::cout << "  强引用计数归零,可以销毁 actor_storage 了"
                << std::endl;
    }
  }
  actor_control_block* get() const { return ctrl_; }
private:
  actor_control_block* ctrl_; // 唯一的成员:只存一个裸指针
};
int main() {
  actor_system_stub sys;
  // 用一段对齐好的原始内存,手动 placement new 构造一份
  // actor_storage<my_actor>,模拟 CAF 内部"控制块和 Actor 对象
  // 一起分配"的过程。
  alignas(actor_storage<my_actor>) char
    buffer[sizeof(actor_storage<my_actor>)];
  auto storage = new (buffer) actor_storage<my_actor>(/*aid=*/42,
                                                        /*nid=*/1, &sys);
  std::cout << "actor_storage<my_actor> 总大小: "
            << sizeof(actor_storage<my_actor>) << " 字节" << std::endl;
  std::cout << "其中控制块大小: " << sizeof(actor_control_block) << " 字节"
            << std::endl;
  // 用控制块地址推算出 Actor 对象地址,验证偏移量正好是64字节
  auto* actor_ptr = actor_from_control_block(&storage->ctrl);
  actor_ptr->greet();
  // 反过来,用 Actor 对象地址推算出控制块地址,验证能推回同一个控制块
  auto* ctrl_ptr = control_block_from_actor(&storage->actor);
  std::cout << "反推出的控制块地址与原始控制块地址是否一致: "
            << (ctrl_ptr == &storage->ctrl ? "是" : "否") << std::endl;
  // 用极简智能指针演示引用计数的增减过程
  {
    simple_strong_actor_ptr p1(&storage->ctrl);
    std::cout << "创建 p1 后,strong_refs = " << storage->ctrl.strong_refs
              << std::endl;
    {
      simple_strong_actor_ptr p2 = p1; // 拷贝,引用计数 +1
      std::cout << "拷贝出 p2 后,strong_refs = "
                << storage->ctrl.strong_refs << std::endl;
    } // p2 在这里析构,引用计数 -1
    std::cout << "p2 离开作用域后,strong_refs = "
              << storage->ctrl.strong_refs << std::endl;
  } // p1 在这里析构,引用计数再 -1
  storage->~actor_storage<my_actor>();
  return 0;
}
代码关键点梳理
static_assert(sizeof(actor_control_block) == 64, ...):这一行是整个设计里最重要的编译期保证——只要这个断言通过,就说明控制块确实精确占用了一条缓存行的大小,后续所有"按固定 64 字节偏移量做指针运算"的操作才是安全的。actor_storage<T>里的匿名union:之所以用union而不是直接声明一个T actor;成员,是因为要精确控制"什么时候构造、什么时候析构"这个对象——用普通成员的话,T会在actor_storage构造时自动默认构造,这里通过union手动接管构造和析构的时机(用 placement new 和显式调用析构函数)。actor_from_control_block/control_block_from_actor:这两个函数就是文档里说的"通过固定字节偏移量,互相推算地址"的具体实现,分别对应 addr(actor)=addr(ctrl)+64\mathrm{addr}(actor) = \mathrm{addr}(ctrl) + 64addr(actor)=addr(ctrl)+64 和 addr(ctrl)=addr(actor)−64\mathrm{addr}(ctrl) = \mathrm{addr}(actor) - 64addr(ctrl)=addr(actor)−64 这两条公式。simple_strong_actor_ptr只有一个成员ctrl_:这正是对比std::shared_ptr(内部通常存对象指针和控制块指针两个裸指针)最直观的展示——CAF 的智能指针靠"控制块和对象紧挨着分配"这个前提,省下了一个指针的存储空间。
8. 运行过程时序图
下图展示了 main 函数从"构造 actor_storage"到"通过智能指针增减引用计数"的完整调用过程:
9. 与 std::shared_ptr 存储方式的对比
| 对比项 | std::shared_ptr<T> | CAF 的 strong_actor_ptr |
|---|---|---|
| 内部存储的裸指针数量 | 通常 2 个(对象指针 + 控制块指针) | 只有 1 个(控制块指针) |
| 控制块是否为模板 | 是(内部记录了删除器等类型信息) | 不是,所有 Actor 共用同一种控制块结构 |
| 对象与控制块的内存关系 | 不一定相邻(make_shared 时相邻,其它情况下可能分开分配) | CAF 保证始终相邻,且控制块固定为 64 字节 |
| 获取对象地址的方式 | 直接存储的对象指针 | 用控制块地址 + 固定偏移量(64字节)现算出来 |
这张对比表把整节内容串了起来:正因为 CAF 严格保证了"控制块永远紧挨着 Actor 对象、且控制块大小固定为 64 字节"这两条规则,才使得智能指针不需要像 std::shared_ptr 那样同时存两个指针,只用一个指向控制块的指针,就能随时推算出对象的位置,从而做到既节省内存,又能避免多线程环境下不同 Actor 控制块之间的伪共享问题。
CAF 中的 actor_cast:Actor 引用类型转换详解
一、整体概念:为什么需要 actor_cast
前面几节讲过,CAF 里跟"指向 actor"相关的类型有好几种,各自承担不同的角色:
| 类型 | 引用强度 | 典型用途 |
|---|---|---|
strong_actor_ptr | 强引用 | 一种类型擦除(type-erased)的通用强引用, 不知道具体消息接口 |
actor | 强引用 | 动态类型 actor 句柄, 可以直接用来发消息 |
typed_actor<...> | 强引用 | 静态类型 actor 句柄, 编译期检查消息接口 |
actor_addr | 弱引用 | 只记录 actor 的地址信息, 不保证 actor 一定还活着 |
这些类型虽然都跟"某个 actor"相关,但彼此之间不能直接互相赋值或隐式转换——毕竟它们承载的语义(强引用/弱引用、类型擦除/具体接口)都不一样。actor_cast 就是 CAF 提供的一个统一入口,专门负责在这些类型之间做显式转换。
二、actor_cast 的两个最常见用途
用途一:strong_actor_ptr 转成 actor 或 typed_actor<...>
strong_actor_ptr 是一种"类型擦除"的强引用——它知道自己指向某个 actor、并且持有强引用保证这个 actor 不会被销毁,但它不知道这个 actor 具体能处理哪些消息类型。而真正要给一个 actor 发消息,你必须用 actor(动态类型)或者 typed_actor<...>(静态类型)这种"带着具体接口信息"的句柄。
所以第一种常见场景就是:
strong_actor_ptr(类型擦除的强引用)→actor_castactor 或 typed_actor<...>(可以直接发消息的句柄)
\text{strong\_actor\_ptr(类型擦除的强引用)} \xrightarrow{\text{actor\_cast}} \text{actor 或 typed\_actor<...>(可以直接发消息的句柄)}
strong_actor_ptr(类型擦除的强引用)actor_castactor 或 typed_actor<...>(可以直接发消息的句柄)
用途二:actor_addr(弱引用)"升级"为 strong_actor_ptr(强引用)
第二种常见场景是反过来:你手里只有一个弱引用 actor_addr(比如之前从某个地方存下来的、只是记着地址,不保证对方还活着),现在想拿它去做点什么操作、需要一个强引用来确保这段时间里 actor 不会被销毁掉。这时可以用 actor_cast 把 actor_addr "升级"成 strong_actor_ptr:
actor_addr(弱引用)→actor_caststrong_actor_ptr(强引用)
\text{actor\_addr(弱引用)} \xrightarrow{\text{actor\_cast}} \text{strong\_actor\_ptr(强引用)}
actor_addr(弱引用)actor_caststrong_actor_ptr(强引用)
关键警告:弱引用升级可能失败,产生无效句柄
这里必须特别注意原文强调的一点:把 actor_addr 转成强引用类型(strong_actor_ptr 或具体的 actor/typed_actor<...>),转换结果有可能是一个无效句柄(invalid handle)。
原因很直观:actor_addr 是弱引用,它压根不保证对应的 actor 还活着。如果在你调用 actor_cast 的这一瞬间,那个 actor 已经被销毁了(强引用计数早就归零了),那么"升级成强引用"这个操作自然没法凭空变出一个活的 actor 出来——CAF 的处理方式是返回一个空的(无效的)句柄,而不是让程序崩溃或者返回一个指向已销毁对象的野指针。
用条件表达式来描述这个转换的结果:
actor_cast<strong_actor_ptr>(addr)={一个有效的强引用,如果此刻对应的 actor 依然存活一个空的(无效的)句柄,如果此刻对应的 actor 已经被销毁
\text{actor\_cast<strong\_actor\_ptr>(addr)} =
\begin{cases}
\text{一个有效的强引用}, & \text{如果此刻对应的 actor 依然存活} \\
\text{一个空的(无效的)句柄}, & \text{如果此刻对应的 actor 已经被销毁}
\end{cases}
actor_cast<strong_actor_ptr>(addr)={一个有效的强引用,一个空的(无效的)句柄,如果此刻对应的 actor 依然存活如果此刻对应的 actor 已经被销毁
所以,凡是做了这种"弱引用升级强引用"的转换,调用方都必须检查转换结果是否有效,不能想当然地假设转换一定成功。
三、actor_cast 的语法:像内置的 C++ 强制转换一样使用
原文特意提到,actor_cast 的写法故意设计得跟 C++ 内置的强制转换(比如 static_cast<T>(x))很像,目的就是让熟悉 C++ 的开发者一看就懂它是"把某个东西转成另一个类型"这件事:
actor_cast<actor>(x) // 把 x 转换成 actor 类型的句柄
这里 <actor> 是模板参数,指定"你想转成什么类型";(x) 是函数参数,也就是"你手里现在拿着的那个东西"。
四、完整可运行的 C++ 示例代码
下面写一份完整、可编译运行的示例,演示 actor_cast 的几种典型用法,包括正常转换成功的情况,以及"弱引用升级失败、得到无效句柄"的情况。
编译方式(需要先安装 CAF 库):
g++ -std=c++17 actor_cast_demo.cpp -lcaf_core -o actor_cast_demo
./actor_cast_demo
// ============================================================
// actor_cast_demo.cpp
// 演示 CAF 里 actor_cast 在几种类型之间做转换的用法:
//   1) strong_actor_ptr -> actor(拿到可以发消息的句柄)
//   2) actor -> actor_addr(降级成弱引用)
//   3) actor_addr -> strong_actor_ptr(弱引用升级为强引用, 演示成功场景)
//   4) actor 销毁之后, 再用它遗留下来的 actor_addr 去升级 -> 得到无效句柄
// ============================================================
#include <caf/all.hpp>   // CAF 核心聚合头文件
#include <iostream>
#include <string>
#include <chrono>
#include <thread>
using namespace caf;
using std::cout;
using std::endl;
// ------------------------------------------------------------
// 一个简单的事件驱动 actor:收到字符串消息就打印出来,
// 收到 "quit" 就退出自己。
// ------------------------------------------------------------
behavior echo_actor(event_based_actor* self) {
  return {
    [self](const std::string& msg) {
      if (msg == "quit") {
        cout << "[echo_actor] 收到 quit 指令,准备退出" << endl;
        self->quit();
      } else {
        cout << "[echo_actor] 收到消息: " << msg << endl;
      }
    }
  };
}
void caf_main(actor_system& sys) {
  scoped_actor self{sys};
  // ----------------------------------------------------------
  // 第一步:创建一个 actor,拿到的默认就是 `actor` 类型的句柄
  // ----------------------------------------------------------
  actor typed_handle = sys.spawn(echo_actor);
  cout << "===== 第一步:创建 echo_actor,拿到 actor 句柄 =====" << endl;
  // ----------------------------------------------------------
  // 用途一演示:actor -> strong_actor_ptr(类型擦除)
  // 再从 strong_actor_ptr 转回 actor,验证能正常发消息
  // ----------------------------------------------------------
  cout << endl << "===== 演示 actor -> strong_actor_ptr -> actor =====" << endl;
  // 先把具体类型的 actor 句柄"擦除"成通用的 strong_actor_ptr,
  // 这在写一些不关心具体消息接口、只需要"占住"一份强引用的
  // 通用代码时很常见(比如存进一个异构容器里)
  strong_actor_ptr erased_ptr = actor_cast<strong_actor_ptr>(typed_handle);
  cout << "转换为 strong_actor_ptr 后,是否有效: "
       << (erased_ptr ? "有效" : "无效") << endl;
  // 现在要真正给这个 actor 发消息,必须先把它转换回带具体接口的
  // actor 类型,才能调用 send 等发消息相关的接口
  actor restored_handle = actor_cast<actor>(erased_ptr);
  self->send(restored_handle, std::string("hello from restored_handle"));
  std::this_thread::sleep_for(std::chrono::milliseconds(50));
  // ----------------------------------------------------------
  // 用途二演示:actor(强引用)-> actor_addr(弱引用),
  // 再从 actor_addr 升级回 strong_actor_ptr(此时 actor 还活着,
  // 升级应该成功)
  // ----------------------------------------------------------
  cout << endl << "===== 演示 actor -> actor_addr -> strong_actor_ptr(存活时) =====" << endl;
  // 把强引用降级成弱引用:只记录地址信息,不再阻止这个 actor 被销毁
  actor_addr weak_addr = actor_cast<actor_addr>(typed_handle);
  // 此时 echo_actor 依然存活(typed_handle 这份强引用还在),
  // 所以从 weak_addr 升级回强引用应该能成功
  strong_actor_ptr upgraded_ptr = actor_cast<strong_actor_ptr>(weak_addr);
  cout << "actor 仍存活时,从 actor_addr 升级为 strong_actor_ptr,是否有效: "
       << (upgraded_ptr ? "有效" : "无效") << endl;
  // ----------------------------------------------------------
  // 用途二的另一半演示:先让 actor 真正退出,
  // 再用同一份 actor_addr 去升级,验证会得到无效句柄
  // ----------------------------------------------------------
  cout << endl << "===== 演示 actor 退出后,用旧的 actor_addr 升级会得到无效句柄 =====" << endl;
  // 先保存一份 actor_addr,作为"退出前记下的地址"
  actor_addr addr_before_exit = actor_cast<actor_addr>(typed_handle);
  // 让 echo_actor 真正退出(这里通过发送 quit 消息触发 self->quit())
  self->send(typed_handle, std::string("quit"));
  std::this_thread::sleep_for(std::chrono::milliseconds(100));
  // 注意:这里故意不再持有任何指向 echo_actor 的强引用
  // (typed_handle 这个局部变量虽然还没销毁,但 actor 本体已经调用了
  // self->quit(),强引用计数会在 actor 真正终止时归零,
  // 之后即使 typed_handle 还"存在",它所指向的 actor 本体已经不在了)
  // 用之前保存的弱引用尝试升级成强引用,
  // 因为 actor 本体已经退出,这次升级预期会失败,得到一个无效句柄
  strong_actor_ptr ptr_after_exit = actor_cast<strong_actor_ptr>(addr_before_exit);
  cout << "actor 退出后,从旧的 actor_addr 升级为 strong_actor_ptr,是否有效: "
       << (ptr_after_exit ? "有效(不应该出现这个结果)" : "无效(符合预期)")
       << endl;
  cout << endl << "全部演示完成" << endl;
}
// CAF_MAIN 宏自动生成 main 函数
CAF_MAIN()
代码关键点解析
actor_cast<strong_actor_ptr>(typed_handle):把具体类型的actor句柄"擦除"成通用的strong_actor_ptr,转换后的对象仍然是强引用(依然计入strong refs),只是丢失了"这个 actor 具体能处理什么消息"这部分类型信息,通常用在需要把不同种类的 actor 句柄统一存进同一个容器、或者写不关心具体接口的通用代码时。actor_cast<actor>(erased_ptr):反过来,把类型擦除的strong_actor_ptr转换回带具体接口的actor,这样才能调用send、request等真正用来通信的接口——这正是原文说的"第一个常见用途"。actor_cast<actor_addr>(typed_handle):把强引用actor转换成弱引用actor_addr,转换完之后,这份actor_addr本身不会阻止echo_actor被销毁,它只是"记住了这个 actor 的地址"。actor_cast<strong_actor_ptr>(weak_addr)(成功场景):因为此时还有别的强引用(typed_handle)在维持echo_actor存活,所以从弱引用升级回强引用能够成功,upgraded_ptr是一个有效句柄。actor_cast<strong_actor_ptr>(addr_before_exit)(失败场景):先让echo_actor真正退出(通过self->quit()),之后再用之前保存的旧actor_addr去尝试升级成强引用,因为对应的 actor 本体已经不在了,这次转换会得到一个空的、无效的句柄——代码里用if (ptr_after_exit)这种布尔上下文的判断方式来检测句柄是否有效(CAF 的这些句柄类型都支持这样的隐式布尔转换,空句柄对应false)。- 必须检查转换结果:这段代码反复强调了一件事——任何"弱引用升级强引用"的
actor_cast调用,都应该在使用结果之前先判断它是否有效,直接拿一个可能无效的句柄去发消息,要么什么都不会发生,要么在更严格的错误处理逻辑下会引发问题。
五、几种转换路径的时序图
六、四种引用/句柄类型之间的转换关系图
七、转换是否可能失败的对照表
| 转换方向 | 是否可能得到无效句柄 | 原因 |
|---|---|---|
strong_actor_ptr -> actor / typed_actor<...> | 否(前提是原本就有效) | 强引用本身就保证actor还活着, 只是转换句柄的类型外观 |
actor / typed_actor<...> -> actor_addr | 否 | 从强引用降级到弱引用, 永远能成功, 只是不再持有强引用保证 |
actor_addr -> strong_actor_ptr / actor / typed_actor<...> | 是 | 弱引用不保证actor存活, 若actor已销毁则升级失败, 返回无效句柄 |
八、ASCII 转换流程示意
强引用家族 (strong_actor_ptr / actor / typed_actor<...>)
之间的转换总是"平级转换", 只改变类型外观, 不改变强引用的本质:
    strong_actor_ptr <--------> actor
           ^                      |
           |                      v
           +------------> typed_actor<...>
强引用 "降级" 为弱引用: 永远成功
    actor / typed_actor<...>  ----降级----> actor_addr
弱引用 "升级" 为强引用: 可能失败
    actor_addr  ----升级(可能失败)---->  strong_actor_ptr
                        |
                        v
              +-------------------+
              | actor 是否仍存活?  |
              +-------------------+
               是|              |否
                 v              v
          得到有效句柄      得到无效(空)句柄
九、小结
actor_cast是 CAF 提供的统一入口,用来在strong_actor_ptr、actor、typed_actor<...>(强引用家族)和actor_addr(弱引用)这几种类型之间做显式转换,写法上模仿了 C++ 内置的强制转换语法,比如actor_cast<actor>(x)。- 第一个常见用途:把类型擦除的
strong_actor_ptr转成带具体接口的actor或typed_actor<...>,这样才能真正调用发消息相关的接口。 - 第二个常见用途:把弱引用
actor_addr"升级"成强引用strong_actor_ptr,但这个方向的转换有可能失败——如果对应的 actor 在升级发生前已经被销毁,会得到一个无效(空)的句柄,调用方必须自己检查转换结果,不能想当然地假设一定成功。 - 强引用家族内部(
strong_actor_ptr/actor/typed_actor<...>)之间的互相转换、以及从强引用降级到弱引用(actor_addr)的转换,都是稳定可靠、不会失败的;唯独"弱引用升级为强引用"这条路径需要格外小心。
CAF 中手动打破循环引用(Breaking Cycles Manually)详解
一、整体概念:循环引用问题只发生在"基于类的 actor"里
前面讲强引用/弱引用那一节已经提到:如果两个 actor 用成员变量互相存了一份指向对方的强引用,会形成循环,导致双方永远无法被销毁。这一节要讲的,是这个问题具体在什么场景下会出现、以及该怎么手动解决。
原文的第一句话点出了关键限定条件:
循环引用问题 ⟸ 仅当使用"基于类的 actor"(class-based actor), 并且用成员变量存了指向其他 actor 的引用时才会出现
\text{循环引用问题} \;\Longleftarrow\; \text{仅当使用"基于类的 actor"(class-based actor), 并且用成员变量存了指向其他 actor 的引用时才会出现}
循环引用问题⟸仅当使用"基于类的 actor"(class-based actor), 并且用成员变量存了指向其他 actor 的引用时才会出现
也就是说,不是所有写法的 actor 都会踩到这个坑,只有"基于类"这一种写法才需要格外小心。要理解为什么,得先弄清楚"基于状态类的 actor"(stateful actor)和"基于类的 actor"(class-based actor)在销毁流程上的区别。
二、状态类 actor(stateful actor):为什么它天然不会循环
在前面讲 actor_from_state 的那一节提到过,基于状态类(state class)的 actor 有一个专属的成员函数 make_behavior()。这种风格的 actor 有一个很重要的销毁顺序特性:
actor 终止 ⇒ 先销毁"状态"(state) ⇒ 然后才运行 actor 本身的析构逻辑
\text{actor 终止} \;\Rightarrow\; \text{先销毁"状态"(state)} \;\Rightarrow\; \text{然后才运行 actor 本身的析构逻辑}
actor 终止⇒先销毁"状态"(state)⇒然后才运行 actor 本身的析构逻辑
换句话说,只要这个 actor 一旦终止(比如调用了 self->quit()),它内部持有的"状态"对象会立刻被销毁——而状态对象里存的那些指向其他 actor 的引用(成员变量),当然也就跟着一起被释放了。
这就意味着:只要调用了 quit(),这个 actor 就会自动、立即释放它持有的所有对其他 actor 的引用,根本不需要你操心"什么时候手动断开对别人的引用"这件事——状态类 actor 天生就规避了循环引用的隐患。
三、基于类的 actor(class-based actor):为什么它会有循环风险
基于类的 actor 是另一种写法:你直接写一个继承自 event_based_actor(或者其他 actor 基类)的类,把成员变量和 make_behavior() 都放在这同一个类里,而不是分成"状态类 + 独立的 actor"两部分。
这种写法的销毁顺序跟状态类 actor 不一样:
actor 终止(quit 被调用) ⇒ actor 逻辑上"死了", 但 C++ 对象本体还没被析构
\text{actor 终止}(\text{quit 被调用}) \;\Rightarrow\; \text{actor 逻辑上"死了", 但 C++ 对象本体还没被析构}
actor 终止(quit 被调用)⇒actor 逻辑上"死了", 但 C++ 对象本体还没被析构
只有当这个 C++ 对象真正被析构(析构函数运行)时 ⇒ 成员变量才会被释放
\text{只有当这个 C++ 对象真正被析构(析构函数运行)时} \;\Rightarrow\; \text{成员变量才会被释放}
只有当这个 C++ 对象真正被析构(析构函数运行)时⇒成员变量才会被释放
关键问题就出在这里:"actor 终止"和"这个 C++ 对象被析构"是两件不同时间点发生的事情。quit() 只是让 actor 停止处理消息、逻辑上退出了,但只要还有强引用指向这个对象(比如别的 actor 通过成员变量存着它),C++ 层面的析构函数就迟迟不会被调用——而析构函数不运行,成员变量里存的"指向其他 actor 的强引用"就一直不会被释放。
于是,如果两个基于类的 actor 分别用成员变量存了对方的强引用,就会陷入死循环:
A 的析构函数不运行 ⇒ A 一直持有指向 B 的强引用 ⇒ B 的强引用计数无法归零 ⇒ B 的析构函数不运行
\text{A 的析构函数不运行} \;\Rightarrow\; \text{A 一直持有指向 B 的强引用} \;\Rightarrow\; \text{B 的强引用计数无法归零} \;\Rightarrow\; \text{B 的析构函数不运行}
A 的析构函数不运行⇒A 一直持有指向 B 的强引用⇒B 的强引用计数无法归零⇒B 的析构函数不运行
同理, B 也一直持有指向 A 的强引用 ⇒ A 的强引用计数也无法归零 ⇒ A 的析构函数也不运行
\text{同理, B 也一直持有指向 A 的强引用} \;\Rightarrow\; \text{A 的强引用计数也无法归零} \;\Rightarrow\; \text{A 的析构函数也不运行}
同理, B 也一直持有指向 A 的强引用⇒A 的强引用计数也无法归零⇒A 的析构函数也不运行
这是一个互相"卡死"对方的闭环,谁都等不到自己被析构的那一刻。
四、解决办法:重写 on_exit(),手动调用 destroy(x)
CAF 给基于类的 actor 提供了一个专门用来"手动介入、打破循环"的钩子:重写 on_exit() 这个虚函数。
on_exit() 会在 actor 真正终止的那个时刻被调用——早于 C++ 对象析构函数运行的时机。你可以在这个函数里,对每一个你自己存的、指向其他 actor 的成员变量句柄,手动调用 destroy(x),主动释放这份强引用。
用文字描述这个"补救流程":
quit() 被调用 ⇒ on_exit() 被触发 ⇒ 手动 destroy(每个成员变量句柄) ⇒ 强引用被释放 ⇒ 对方的引用计数得以归零 ⇒ 对方也能正常析构
\text{quit() 被调用} \;\Rightarrow\; \text{on\_exit() 被触发} \;\Rightarrow\; \text{手动 destroy(每个成员变量句柄)} \;\Rightarrow\; \text{强引用被释放} \;\Rightarrow\; \text{对方的引用计数得以归零} \;\Rightarrow\; \text{对方也能正常析构}
quit() 被调用⇒on_exit() 被触发⇒手动 destroy(每个成员变量句柄)⇒强引用被释放⇒对方的引用计数得以归零⇒对方也能正常析构
使用 destroy(x) 之后的注意事项
原文特别强调了两点:
- 销毁之后再使用这个句柄,是未定义行为(undefined behavior):一旦调用了
destroy(x),x这个句柄就不再指向任何有效的 actor 了,如果你还继续拿它去发消息、判断有效性之外的其他操作,程序行为是不可预测的。 - 但给已销毁的句柄重新赋一个新值是安全的:也就是说,
destroy(x)之后,你可以放心地写x = some_other_actor;这样的赋值语句,这是被允许、也是安全的操作,只是不能在赋新值之前继续"使用"那个已经失效的旧句柄。
五、两种 actor 风格销毁流程对照表
| 对比维度 | 基于状态类的 actor (stateful actor) | 基于类的 actor (class-based actor) |
|---|---|---|
| 状态释放时机 | actor 终止时立即释放(先于对象本体析构) | 要等到 C++ 对象析构函数运行时才释放 |
| 是否天然规避循环引用 | 是 | 否, 需要手动处理 |
| 如何手动打破循环 | 通常不需要 | 重写 on_exit(), 手动调用 destroy(x) |
| 典型创建方式 | actor_from_state<State> | 直接继承 event_based_actor 等基类 |
六、完整可运行的 C++ 示例代码
下面写一份完整、可编译运行的示例,包含两部分对比:
- 两个基于类的 actor 互相用成员变量强引用持有对方,不重写
on_exit()——验证它们的析构函数确实不会被调用(循环卡死); - 同样的场景,但这次重写
on_exit()并手动调用destroy(x)——验证两者都能被正常析构。
编译方式(需要先安装 CAF 库):
g++ -std=c++17 breaking_cycles_demo.cpp -lcaf_core -o breaking_cycles_demo
./breaking_cycles_demo
// ============================================================
// breaking_cycles_demo.cpp
// 演示基于类的 actor(class-based actor)中循环引用的问题,
// 以及如何通过重写 on_exit() 并调用 destroy(x) 手动打破循环。
// ============================================================
#include <caf/all.hpp>   // CAF 核心聚合头文件
#include <iostream>
#include <chrono>
#include <thread>
using namespace caf;
using std::cout;
using std::endl;
// ------------------------------------------------------------
// 场景一:不打破循环的基于类的 actor
// 这个类继承自 event_based_actor,用成员变量 peer_ 存一份
// 指向"另一个 actor"的强引用;故意不重写 on_exit(),
// 用来演示循环引用导致析构函数无法被调用的问题。
// ------------------------------------------------------------
class leaky_actor : public event_based_actor {
public:
  leaky_actor(actor_config& cfg, std::string name)
      : event_based_actor(cfg), name_(std::move(name)) {}
  // 提供一个接口,让外部把"对方"的句柄设置进来,
  // 这样两个 leaky_actor 实例就可以互相持有对方
  void set_peer(const actor& peer) { peer_ = peer; }
  // 析构函数打印日志,方便观察它到底有没有被调用
  ~leaky_actor() override {
    cout << "[析构] leaky_actor(" << name_ << ") 被析构" << endl;
  }
  behavior make_behavior() override {
    return {
      [this](const std::string& msg) {
        cout << "[" << name_ << "] 收到消息: " << msg << endl;
      }
    };
  }
private:
  std::string name_;
  actor peer_;  // 成员变量:强引用, 指向另一个 actor
};
// ------------------------------------------------------------
// 场景二:会主动打破循环的基于类的 actor
// 结构跟 leaky_actor 几乎一样,唯一区别是重写了 on_exit(),
// 在 actor 真正终止的时刻手动 destroy(peer_),
// 提前释放对 peer_ 的强引用,从而打破循环。
// ------------------------------------------------------------
class fixed_actor : public event_based_actor {
public:
  fixed_actor(actor_config& cfg, std::string name)
      : event_based_actor(cfg), name_(std::move(name)) {}
  void set_peer(const actor& peer) { peer_ = peer; }
  ~fixed_actor() override {
    cout << "[析构] fixed_actor(" << name_ << ") 被析构" << endl;
  }
  behavior make_behavior() override {
    return {
      [this](const std::string& msg) {
        cout << "[" << name_ << "] 收到消息: " << msg << endl;
      }
    };
  }
  // 重写 on_exit():这个函数会在 actor 真正终止时被调用,
  // 早于 C++ 层面的析构函数运行时机
  void on_exit() override {
    cout << "[on_exit] fixed_actor(" << name_
         << ") 正在手动打破循环, 释放对 peer_ 的强引用" << endl;
    // destroy(x) 会主动释放 x 这个句柄持有的强引用,
    // 相当于提前"清空"了这份引用,不用等到析构函数才释放
    destroy(peer_);
    // destroy 之后,不能再继续使用 peer_ 去发消息等操作(未定义行为),
    // 但可以安全地给它重新赋值,比如:
    // peer_ = actor{};  // 这样赋值是安全的
  }
private:
  std::string name_;
  actor peer_;
};
void caf_main(actor_system& sys) {
  // ----------------------------------------------------------
  // 场景一:不打破循环,观察析构函数确实不会被调用
  // ----------------------------------------------------------
  cout << "===== 场景一:不重写 on_exit(),产生循环引用 =====" << endl;
  {
    auto a1 = sys.spawn<leaky_actor>("leaky-A");
    auto a2 = sys.spawn<leaky_actor>("leaky-B");
    // 通过 actor_cast + 一个自定义消息把彼此的句柄"喂"给对方,
    // 这里为了演示简便,直接借助 CAF 提供的 send 机制,
    // 用一个 lambda 风格的做法把 set_peer 包装成消息处理,
    // 实际工程中通常会设计专门的初始化消息来完成这件事。
    // 这里直接通过 actor_cast 获取到具体类型指针来调用 set_peer
    // (仅用于演示目的,生产代码不建议这样绕过消息机制直接调用成员函数)
    auto* raw_a1 = static_cast<leaky_actor*>(actor_cast<abstract_actor*>(a1));
    auto* raw_a2 = static_cast<leaky_actor*>(actor_cast<abstract_actor*>(a2));
    raw_a1->set_peer(a2);
    raw_a2->set_peer(a1);
    scoped_actor self{sys};
    self->send(a1, std::string("hello"));
    std::this_thread::sleep_for(std::chrono::milliseconds(50));
    // 让两个 actor 都退出(逻辑上终止),
    // 但由于它们互相持有对方的强引用,C++ 对象本体不会被析构
    self->send_exit(a1, exit_reason::user_shutdown);
    self->send_exit(a2, exit_reason::user_shutdown);
    std::this_thread::sleep_for(std::chrono::milliseconds(100));
    cout << "两个 actor 已经 quit,但因为互相持有强引用,"
            "上面不会打印出任何 [析构] 日志(这正是循环引用的问题所在)"
         << endl;
  }
  // a1、a2 这两个局部变量离开作用域,各自的 actor 句柄被释放,
  // 但因为 leaky_actor 内部的 peer_ 还互相强引用着对方,
  // 两个对象本体依然无法被真正析构,造成内存泄漏。
  cout << endl;
  // ----------------------------------------------------------
  // 场景二:重写 on_exit() 并调用 destroy(),验证能正常析构
  // ----------------------------------------------------------
  cout << "===== 场景二:重写 on_exit(),手动打破循环 =====" << endl;
  {
    auto b1 = sys.spawn<fixed_actor>("fixed-A");
    auto b2 = sys.spawn<fixed_actor>("fixed-B");
    auto* raw_b1 = static_cast<fixed_actor*>(actor_cast<abstract_actor*>(b1));
    auto* raw_b2 = static_cast<fixed_actor*>(actor_cast<abstract_actor*>(b2));
    raw_b1->set_peer(b2);
    raw_b2->set_peer(b1);
    scoped_actor self{sys};
    self->send(b1, std::string("hi there"));
    std::this_thread::sleep_for(std::chrono::milliseconds(50));
    // 让两个 actor 退出:这次 on_exit() 会被触发,
    // 在真正析构之前就主动释放对 peer_ 的强引用,
    // 所以应该能看到 [析构] 日志被正常打印出来
    self->send_exit(b1, exit_reason::user_shutdown);
    self->send_exit(b2, exit_reason::user_shutdown);
    std::this_thread::sleep_for(std::chrono::milliseconds(100));
    cout << "上面应该能看到 [on_exit] 和 [析构] 日志,"
            "说明手动打破循环之后, 两个 actor 都能被正常销毁"
         << endl;
  }
}
// CAF_MAIN 宏自动生成 main 函数
CAF_MAIN()
代码关键点解析
leaky_actor与fixed_actor的结构几乎相同:都是继承自event_based_actor的基于类的 actor,都用成员变量peer_(类型是actor,一份强引用)存了另一个 actor 的句柄,唯一的区别是fixed_actor多重写了on_exit()。set_peer与直接操作对象指针(仅用于演示):真实的 CAF 工程实践里,通常会设计一条"初始化消息"来让两个 actor 互相交换句柄,而不是像示例里这样通过actor_cast<abstract_actor*>拿到裸指针直接调用成员函数——这里为了让示例代码保持简洁、聚焦在"循环引用"这个核心主题上,采取了简化写法,实际项目中不建议这样绕开消息机制。- 场景一里"看不到析构日志"这件事本身就是问题的证据:两个
leaky_actor即使都已经通过send_exit逻辑上终止了(quit被触发),但因为它们的peer_成员变量还互相强引用着对方,C++ 层面的析构函数永远不会运行,~leaky_actor()里的打印语句也就永远不会出现——这正是循环引用导致内存泄漏的直接体现。 fixed_actor::on_exit()里的destroy(peer_):on_exit()会在 actor 真正终止的时刻(早于析构函数)被调用,在这里主动调用destroy(peer_),相当于提前把peer_这份强引用清空掉,这样对方的强引用计数就能顺利归零,进而触发对方的析构;同理对方也做了同样的操作,最终双方都能正常析构。destroy(x)之后不要再"使用"这个句柄:代码注释里提到,销毁后如果需要,可以安全地给peer_重新赋一个新值(比如赋成一个空的actor{}),但绝不能在销毁之后继续拿它去发消息或做其他依赖有效性的操作。
七、两种场景的销毁流程时序图
八、循环引用被打破前后的 ASCII 对比
场景一: 未打破循环 (析构函数永远不会运行)
  leaky_actor A  --成员变量peer_(强引用)--> leaky_actor B
       ^                                        |
       |            成员变量peer_(强引用)         |
       +----------------------------------------+
  quit() 只让 A、B "逻辑上退出",但对象本体析构函数
  要等 peer_ 被释放才会运行;而 peer_ 又要等对方析构才释放 => 死循环, 谁都等不到自己被析构
场景二: on_exit() 手动打破循环
  fixed_actor A  --on_exit()调用 destroy(peer_)--> 主动释放对B的强引用
  fixed_actor B  --on_exit()调用 destroy(peer_)--> 主动释放对A的强引用
  A 释放对 B 的引用 => B 的强引用计数得以归零 => B 正常析构
  B 释放对 A 的引用 => A 的强引用计数得以归零 => A 正常析构
九、小结
- 循环引用问题只出现在"基于类的 actor"(class-based actor)里:这类 actor 的成员变量要等 C++ 对象析构函数运行时才会被释放,而
quit()只是让 actor 逻辑上终止,并不等价于对象立刻被析构。 - 基于状态类的 actor(stateful actor)天然规避了这个问题,因为它的状态会在 actor 终止时立即释放,早于对象本体析构,所以状态里存的引用会自动、及时地被清空。
- 解决基于类 actor 的循环引用问题,要靠重写
on_exit(),在这个钩子函数里对每个存着其他 actor 强引用的成员变量调用destroy(x),提前释放这份引用,从而打破循环,让双方都能顺利被析构。 destroy(x)之后,这个句柄本身处于失效状态,继续使用它是未定义行为;但可以安全地给它重新赋一个新值。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 0
 0
- 0


 已为社区贡献56条内容

所有评论(0)