操作系统 第5章操作系统的历史以及常见的题目
补充 操作系统概论
1.程序向操作系统的迈进
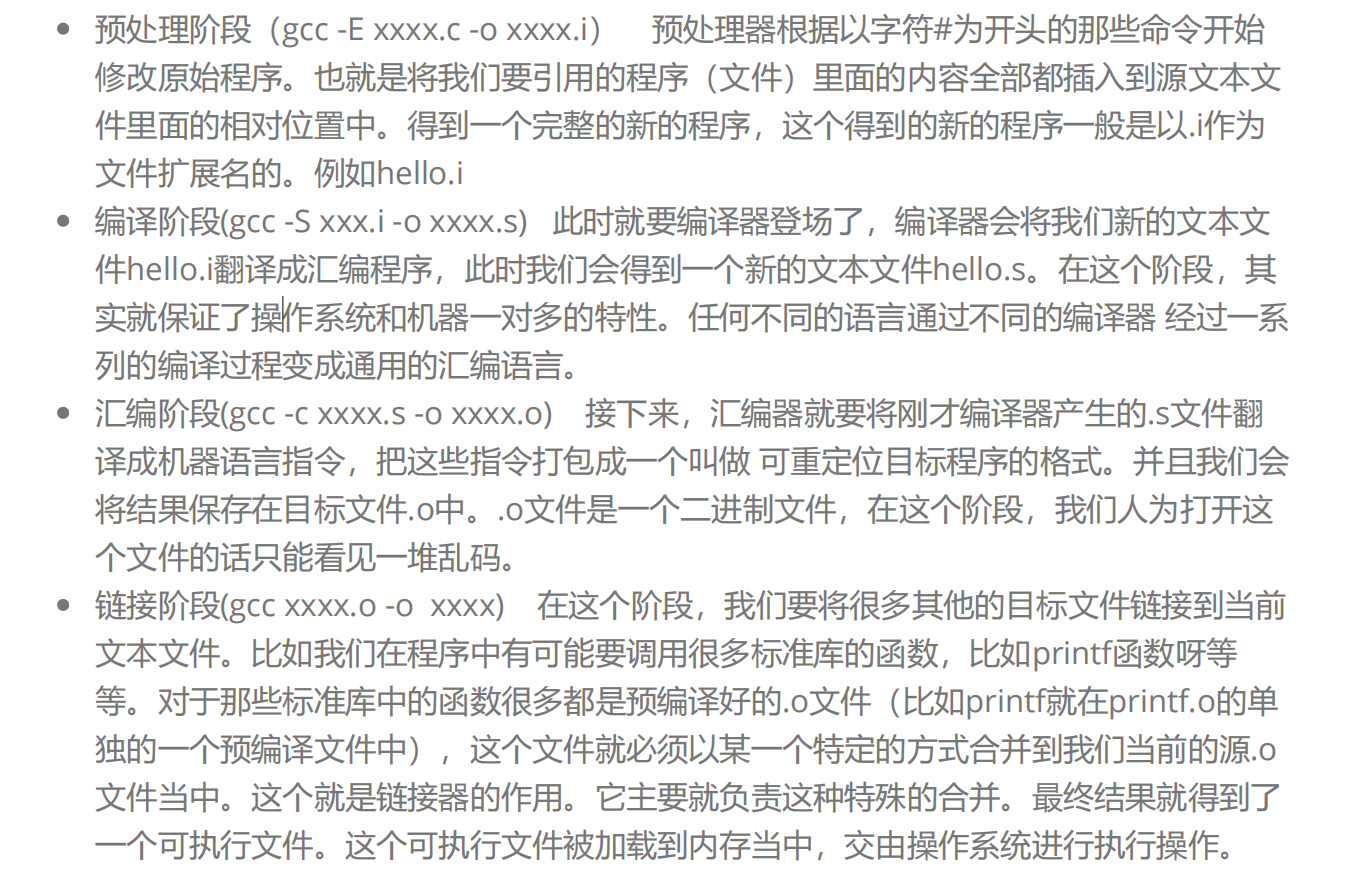
linux> gcc -o hello hello.c
//gcc -o选项用来指定输出文件,如果不使用 -o 选项,那么将采用默认的输出文件。例如默认情况下,生
成的可执行文件的名字默认为 a.out。
//对于上述语句 hello就是我们用来输出的文件名字 hello.c就是我们的源文件名字
//要注意好-c -o的区别 -c是生成目标文件
2.信息就是context + byte
通过对于这个程序的存储,我们很容易的得出一个结论:在我们操作系统当中,所有的信息(包括
磁盘上的信息,内存中存储的信息,数据库当中的数据,图片,音视频,网络中传输的数据)全部都是
由一系列的二进制流(比特)表示。那么问题来了,当我们面对一个字节序列的时候,我们怎么知道这
个序列是整数、字符还是别的什么乱七八糟的东西呢?
其实区分不同的数据对象的方式是根据一个数据所在的环境(也叫做语境 context)。在语言学当
中,语意学(semantics)不包含语境(context),语用学(pramatics)则考虑语境对于语意的影
响。对应对编程当中同样如此,一些编程的组件(比如函数)就需要根据当时的编译或者运行时的环
境,才可以理解他的语意(运行时的结果)。所以我们才看得见老外context-free language每一条的产
生式的解释被称为semantics。其实就是类似我们以前做语文题目的那个结合上下文,或者选词填空的
那个路子。根据上下文的意思来判断这个空格应该填什么单词。对于编程语言的判别同理,我们通过结
合上下文来判断这是整数、浮点数、字符串还是一个机器指令。
你查不到是因为上下文这个东西不是一个具体的东西,上下文在不同的地方表示不同的含义,要感
性理解。
context其实说白了,和文章的上下文是一个意思,在通俗一点,我觉得叫环境更好。
…
林冲大叫一声“啊也!”
…
问:这句话林冲的“啊也”表达了林冲怎样的心里?
答:啊你妈个头啊!
看,一篇文章,给你摘录一段,没前没后,你读不懂,因为有语境,就是语言环境存在,一段话说
了什么,要通过上下文(文章的上下文)来推断。
子程序之于程序,进程之于操作系统,甚至app的一屏之于app,都是一个道理。
程序执行了部分到达子程序,子程序要获得结果,要用到程序之前的一些结果(包括但不限于外部变
量值,外部对象等等);
app点击一个按钮进入一个新的界面,也要保存你是在哪个屏幕跳过来的等等信息,以便你点击返
回的时候能正确跳回,如果不存肯定就无法正确跳回了。
看这些都是上下文的典型例子,理解成环境就可以,(而且上下文虽然叫上下文,但是程序里面一般
都只有上文而已,只是叫的好听叫上下文。。进程中断在操作系统中是有上有下的,不过不给题主说
了,免得产生新的问题)
这就是context的含义,至于这个单词到底是谁直接翻译成上下文的,站出来我保证不打死你
3.操作系统
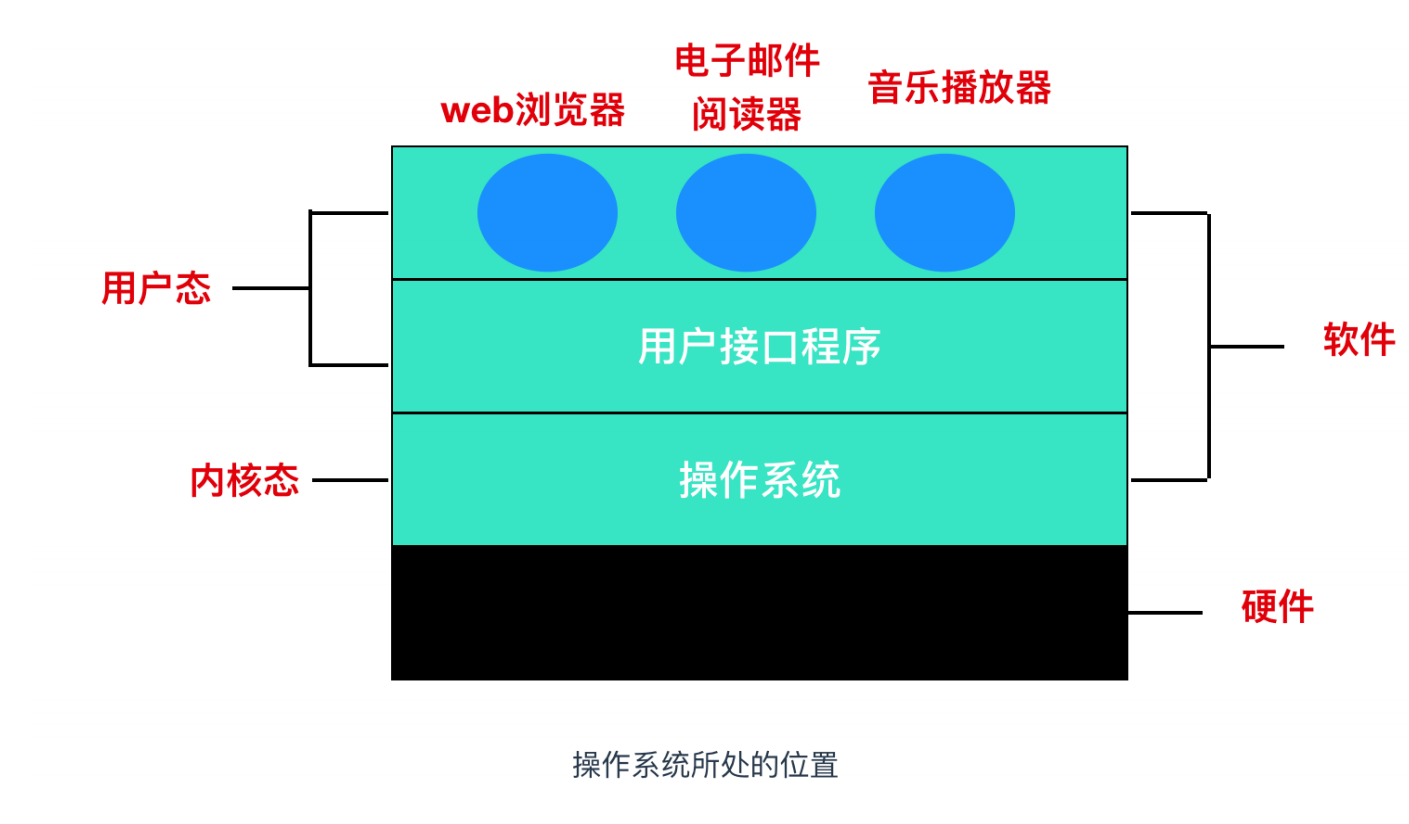
在硬件之上是软件。大部分计算机有两种运行模式: 内核态 和 用户态 ,软件中最基础的部分是 操
作系统 ,它运行在 内核态 中,内核态也称为 管态 和 核心态 ,它们都是操作系统的运行状态,只不过
是不同的叫法而已。操作系统内核负责管理硬件资源,如内存分配、进程调度、设备驱动等,并提供了
一组系统调用接口供用户态程序使用。
用户接口程序(shell 或者 GUI) 处于用户态中,是用户与操作系统交互的方式。并且它们位于用户
态的最低层,允许用户运行其他程序,例如 Web 浏览器、电子邮件阅读器、音乐播放器等。而且,越
靠近用户态的应用程序越容易编写,如果你不喜欢某个电子邮件阅读器你可以重新写一个或者换一个,
但你不能自行写一个操作系统或者是中断处理程序。这个程序由硬件保护,防止外部对其进行修改。
这张图还强调了操作系统所处的位置,它介于硬件和用户之间,起到了管理和协调的作用。用户态
的应用程序无法直接访问硬件,必须通过操作系统内核提供的服务来间接访问。这样的设计提高了系统
的安全性,避免了恶意软件或错误的程序破坏系统稳定性。同时,这也意味着用户态的应用程序更容易
编写和维护,因为它们不需要直接处理底层硬件细节。
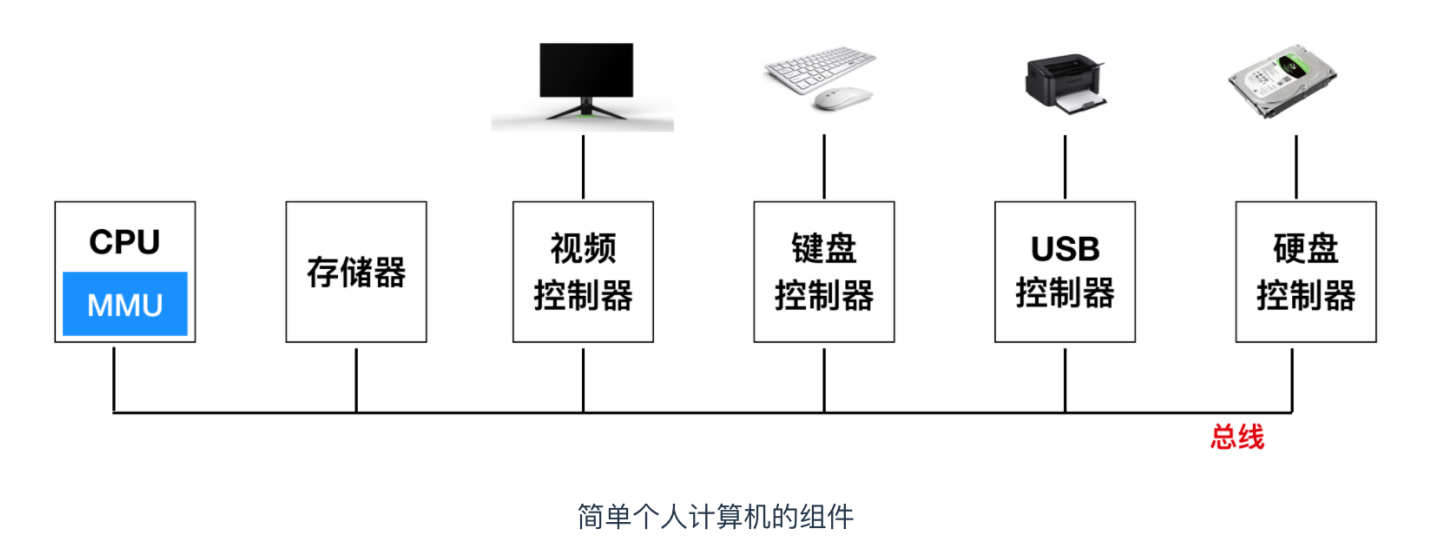
4.计算机硬件简介
5.CPU
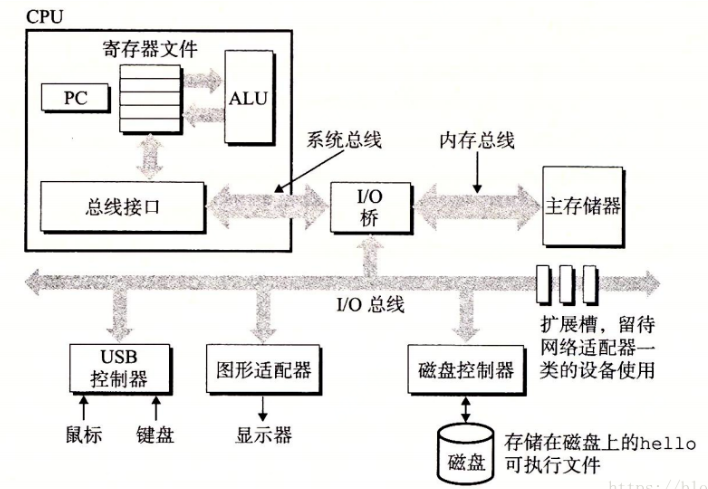
CPU就是中央处理单元,CPU的作用简单点说就是处理和执行指令。这些指令构成了程序。它是一
个核心组件,但不是唯一组件。它是计算机的大脑。正因为它是处理指令的,前面我们又讲过内存是存
放指令的。CPU又是大脑,我们都知道,大脑是用来下命令的。所以无论任何时候,它都指向主存中的
某个机器指令(通过地址)。但是,它不是直接跟主存交互。而是通过一个内部组件,叫做程序计数器
(PC),也就是我们熟知的寄存器。所以,寄存器的作用就是用来存储指向下一条指令的地址,也就是
即将执行的指令代码。为什么叫程序计数器呢?这个就要牵扯到一个概念,就是多线程。我们后面会详
细讲解。
所以说,处理器要处理指令,就需要从PC读取要处理的指令的地址,然后处理指令。处理完当前指
令以后,处理器不可能只处理一条指令呀,此时,PC就要做相对应的更新。那么,更新就牵扯到计算,
我需要计算新的数据和地址值。用来计算的东西,我们就管它叫做算数/逻辑单元(ALU)。至此,CPU
要执行一条指令的过程也就彻底理出来了。
处理器想要处理一条指令,也需要通过一定的规则,这个规则叫做指令集架构。处理器是完全按照
指令集架构来的么?在现代处理器中,其实执行一条指令是一个非常复杂的过程。在现代处理器中实际
又做了一层区分,将指令集架构和处理器的微体系结构做了划分。指令集架构是用来描述每条机器代码
指代的效果,微体系结构是用来描述处理器的具体实现。
在指令集中,通常包含以下几种类型的指令:
加载指令:用于将数据从内存加载到寄存器中。
存储指令:用于将数据从寄存器存回到内存中。
运算指令:用于对来自寄存器和内存的操作数进行运算,例如 add 指令将两个操作数相加并
将结果保存在寄存器或内存中。
通过这种方式,CPU可以高效地处理数据和执行复杂的计算任务。
除了用于保存变量和临时结果的通用寄存器外,大多数计算机还具有一些特殊的寄存器,这些寄存
器对于程序员是可见的。
其中一个重要的寄存器是 程序计数器(Program Counter, PC)。程序计数器指示了下一条需要
从内存中提取的指令的地址。当指令被提取后,程序计数器会自动更新为下一条需要提取的指令的地
址,从而确保指令能够按正确的顺序执行。
另一个重要的寄存器是 堆栈指针(Stack Pointer, SP)。堆栈指针指向内存中当前栈的顶端。它
包含了函数调用过程中传递的参数、局部变量以及未保存在寄存器中的临时变量。通过堆栈指针,CPU
可以管理函数调用期间的数据和返回地址。
6.内存
计算机中的第二个主要组件是内存。理想情况下,内存应该是非常快速的(比执行一条指令还要
快,以避免拖慢CPU的执行效率),同时容量足够大且成本低廉。然而,当前的技术手段无法同时满足
这三个要求。因此,存储系统采用了一种分层次的结构来解决这个问题。
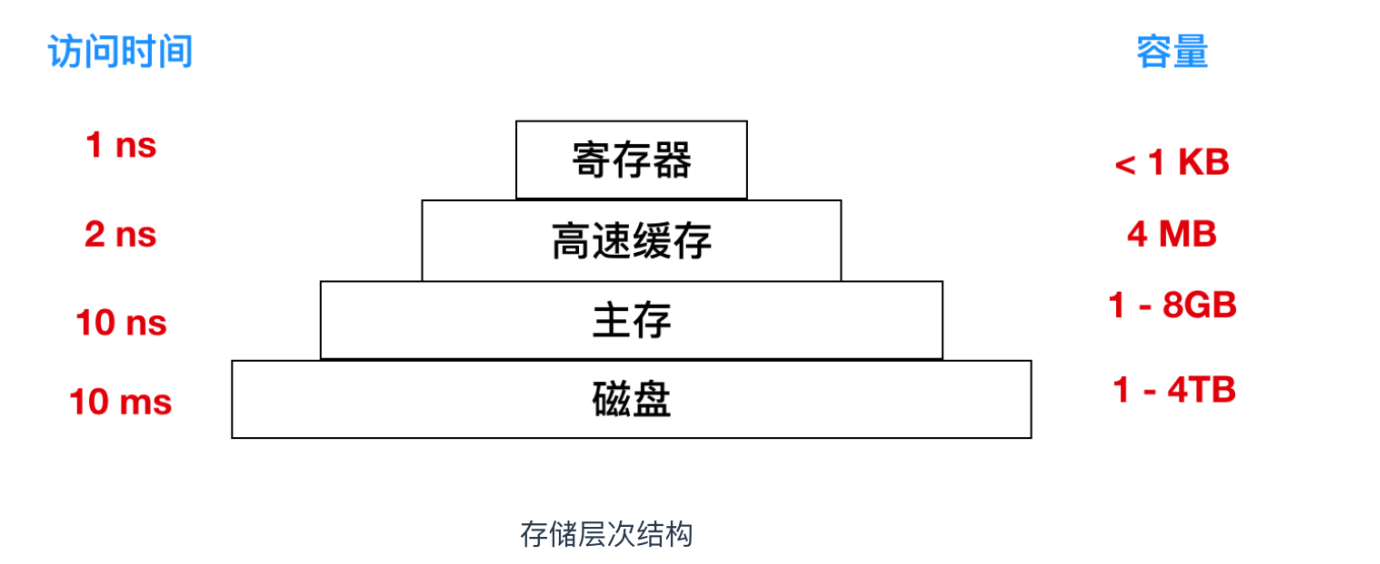
寄存器之下是高速缓存,它主要由硬件控制。主存被分割成高速缓存行(cache lines),通常每
行大小为64字节。例如,内存地址0-63对应高速缓存行0,地址64-127对应高速缓存行1,依此类推。
使用最频繁的数据块被保存在位于CPU内部或非常靠近CPU的高速缓存中。当应用程序需要从内存中读
取数据时,高速缓存硬件会检查所需的高速缓存行是否在高速缓存中。如果在,这就是高速缓存命中
(cache hit),高速缓存会满足该请求,无需通过总线将请求发送到主内存。高速缓存命中通常只需
要两个时钟周期。如果未命中,则需要从主内存中提取数据,这将消耗大量时间。高速缓存行的数量受
限于其高昂的成本。有些机器会有两到三级高速缓存,每一级比前一级容量更大但速度略慢。
通过以上例子,我们可以看到,将所需信息从一个地方复制到另一个地方会产生较大的开销。数据
从磁盘加载到主存中,然后处理器从主存中提取指令,字符串也经历了从磁盘到主存再到显示器的过
程。这一系列操作增加了系统的开销,开销主要体现在数据复制上。因此,系统设计者需要考虑如何让
这些操作更高效地完成,这时高速缓存就起到了关键作用。
为什么会出现缓存呢?这与硬件技术有关。通常,较大的存储设备速度较慢(不要拿固态和机械来
抬杠哦),而同等存储量的高速存储设备则更为昂贵。此外,硬件的处理速度实际上又在一个瓶颈,说
白了,发展到头了。很难在快速发展了。处理器与内存之间的速度差距变得越来越大。为了在不大幅增
加成本的前提下提高数据处理效率,设计者选择不在提高内存本身的速度上下功夫,而是在处理器端引
入高速缓存。
高速缓存是一种更小、更快的存储设备,作为处理器近期可能需要用到的数据的暂存区。利用计算
机的局部性原理,大部分内存操作可以在缓存中完成,从而大大减少了访问主存的次数,提升了整体性
能。
ublic class Main {
    public static void main(String[] args) {
//验证局部性原理
        long sum = 0;
        int[][] dataArray = new int[10000][10000];
        for (int i = 0;i < 10000;i++){
            for (int j = 0;j< 10000;j++){
//初始化数据
                dataArray[i][j] = 1;
            }
        }
        long beginTime = System.currentTimeMillis();
        for (int i = 0;i < 10000;i++){
            for (int j = 0;j< 10000;j++){
//初始化数据
                sum += dataArray[i][j];
            }
        }
        System.out.println(sum + "cost" + (System.currentTimeMillis() -
                beginTime));
        beginTime = System.currentTimeMillis();
        for (int i = 0;i < 10000;i++){
            for (int j = 0;j< 10000;j++){
//初始化数据
                sum += dataArray[j][i];
            }
        }
        System.out.println(sum + "cost" + (System.currentTimeMillis() -
                beginTime));
    }
}
7.主存
在存储系统的层次结构中,紧接高速缓存之下的是主存(Main Memory),也称为
RAM(Random Access Memory,随机存取存储器)。尽管在1950年代与1960年代,计算机曾采用
微小的可磁化铁氧体磁芯作为主存储介质,因而那时主存有时也被称为核心存储器,但现代技术已显著
进化。所有未能通过高速缓存满足的内存访问需求,最终都会转向主存处理。
除了主存之外,许多计算机还配备了一定量的非易失性随机存取存储器。这类存储器与RAM不同,
在电源断电后不会丢失内容。ROM(Read Only Memory,只读存储器)的内容一旦存储后就不会被
修改。ROM速度快且成本低,因此如果有人问你有什么既快又便宜的存储设备,答案就是ROM。在计
算机中,用于启动计算机的引导加载模块(即bootstrap)通常存储在ROM中。此外,一些I/O卡也使用
ROM来处理底层设备控制。
另一类非易失性存储器包括 EEPROM(Electrically Erasable Programmable Read-Only
Memory,电可擦可编程只读存储器) 和 闪存(Flash Memory) 。与ROM不同,EEPROM和闪存支持数据
的擦除与重新写入,尽管这一过程相较于写入RAM更为耗时。因此,它们在使用上虽与ROM有相似之
处,但能通过重写数据来修正程序错误,提供了更高的灵活性。
闪存尤其被广泛应用于便携式存储设备中,成为数码相机中的“数字胶卷”和便携式音乐播放器的“虚
拟磁盘”。其速度介于RAM与磁盘之间,但值得注意的是,闪存存在擦写寿命限制,频繁擦除会导致磨
损。
此外,还有一类特殊的存储器—— CMOS(Complementary Metal-Oxide-Semiconductor,互补金
属氧化物半导体) 存储器,尽管其存储的数据在断电后会丢失(因此被认为是易失性的),但许多计算
机仍利用CMOS来保存当前的时间和日期信息,确保即使在电源关闭后也能持续追踪这些关键数据。
8.磁盘
磁盘是一种机械装置,在一个磁盘中有一个或多个金属盘片,它们以 5400rpm、7200rpm、
10800rpm 或更高的速度旋转。从边缘开始有一个机械臂悬横在盘面上,这类似于老式播放塑料唱片
33 转唱机上的拾音臂。信息会写在磁盘一系列的同心圆上。在任意一个给定臂的位置,每个磁头可以
读取一段环形区域,称为 磁道(track) 。把一个给定臂的位置上的所有磁道合并起来,组成了一个 柱面
(cylinder) 。
别慌,这个知识点其实就建立在一个核心概念上。把这个概念吃透,剩下的全是顺理成章的事。
一、先补地基:文件名 ≠ 文件本身
在 Linux/Unix 文件系统里,文件数据是这么存的:
目录项(dentry) inode(索引节点) 数据块
┌──────────┬──────┐ ┌──────────┬────────┐ ┌──────────┐
│ 文件名 │inode号│───▶│ 权限/大小 │数据块指针│───▶│ 实际内容 │
│ hello.txt│ 12345│ │ 所有者 │ … │ └──────────┘
└──────────┴──────┘ └──────────┴────────┘
关键结论:真正标识一个文件的是 inode 号,文件名只是一个"标签",贴在 inode 上。
你可以给同一个 inode 贴多个标签 —— 这就是硬链接。
你也可以新建一个专门存路径的小文件,指向另一个文件 —— 这就是软链接。
二、硬链接(hard link):同一个文件的多个名字
echo “hello” > a.txt # 创建文件,假设 inode = 12345
ln a.txt b.txt # 创建硬链接(不加任何参数就是硬链接)
ls -li # -i 显示 inode 号
输出:
12345 -rw-r–r-- 2 user group 6 Sep 25 a.txt
12345 -rw-r–r-- 2 user group 6 Sep 25 b.txt
注意三个细节:
inode 号完全一样(都是 12345) → 它们是同一个文件,不是副本。
第二列数字变成 2 → 这是"链接计数"(link count),表示有几个名字指向它。
改 b.txt,a.txt 的内容同步变;反过来也一样。因为根本不存在"两个文件"。
删掉其中一个会怎样?
rm a.txt
cat b.txt # → 依然输出 hello,完全正常
因为 rm 其实叫"unlink",它只撕掉一个标签,链接计数从 2 减到 1。只有当计数归零、且没有进程打开它时,数据块才会被真正回收。
三、软链接(symbolic link / symlink):一张写着地址的纸条
ln -s a.txt c.txt # -s 就是 symbolic
ls -li
输出:
12345 -rw-r–r-- 1 user group 6 Sep 25 a.txt
54321 lrwxrwxrwx 1 user group 5 Sep 25 c.txt -> a.txt
区别非常明显:
inode 号不同(54321 vs 12345) → 它是一个独立的新文件。
权限是 lrwxrwxrwx,开头那个 l 代表 link。
大小是 5 字节(就是字符串 “a.txt” 的长度)→ 它的内容就是目标的路径字符串,不是真实数据。
箭头 -> a.txt 告诉你它指向谁。
删掉原文件会怎样?
rm a.txt
cat c.txt # → cat: c.txt: No such file or directory(死链接 / dangling link)
ls -l c.txt # → 红色闪烁的 c.txt -> a.txt(还在,但废了)
纸条还在,但照着纸条去找,房子已经没了。
四、一句话类比(记住这个就够了)
类比
硬链接 一个人有两个名字(大名和小名)。你叫他哪个名字,来的都是同一个人。注销户口(删名字)不影响这个人活着,直到最后一个名字也被注销。
软链接 一张写着地址的便利贴。便利贴本身是个独立物件,撕了它不影响房子;但房子拆了,便利贴就指了个空。
Windows 里:快捷方式 (.lnk) ≈ 软链接(但快捷方式是用户态的东西,symlink 是文件系统级的);NTFS 也有硬链接和目录联结(junction)。
五、核心对比表(考试最爱考)
比较项 硬链接 软链接
inode 号 与源文件相同 不同,自己有独立 inode
本质 同一 inode 的又一个目录项 一个独立的文件,内容是目标路径
能否跨文件系统/分区 ❌ 不能(inode 号只在单个文件系统内唯一) ✅ 可以
能否链接目录 ❌ 一般不行(root 用 ln -d 除外,会破坏树形结构) ✅ 可以
源文件被删除后 ✅ 仍可通过链接访问内容 ❌ 变成死链接(broken link)
对权限的影响 无独立权限,与源文件共享 有自己的权限位(但实际访问按目标文件权限算)
文件大小 就是数据大小 等于路径字符串的长度
命令 ln 源 目标 ln -s 源 目标
六、几个帮你彻底理解的"反直觉"例子
例1:硬链接看不出谁是"源"
ln a.txt b.txt
执行完这句,a.txt 和 b.txt 地位完全平等,不存在"谁是原件谁是副本"。所谓"源文件"只是你的心理概念。这一点跟软链接完全不同(软链接有明确的方向性,c.txt -> a.txt)。
例2:软链接可以"指空气"
ln -s /tmp/不存在的文件 ghost.txt
ls -l ghost.txt # → ghost.txt -> /tmp/不存在的文件(照样创建成功)
系统不会检查目标是否存在。这是硬链接做不到的(硬链接的目标必须存在)。
例3:跨分区必崩
假设 /home 和 /boot 在不同分区
ln /home/a.txt /boot/b.txt # → ln: failed to create hard link: Invalid cross-device link
ln -s /home/a.txt /boot/b.txt # ✅ 成功
原因回到地基:inode 号只在同一个文件系统内唯一,跨分区就没法共用号码了。
例4:软链接的路径是"相对"的,容易踩坑
cd /tmp
mkdir dir && cd dir
echo hi > file.txt
ln -s file.txt …/link.txt # 在上级目录创建链接
cat …/link.txt # ❌ 可能报错!
为什么?因为链接里存的是字面字符串 file.txt,解析时是相对于链接文件自己所在目录(/tmp),而不是相对于你创建它时的位置。所以它会去找 /tmp/file.txt,而文件其实在 /tmp/dir/file.txt。
👉 经验:写软链接尽量用绝对路径 ln -s /tmp/dir/file.txt /tmp/link.txt。
例5:怎么判断一个文件有几个硬链接?
ls -l # 第二列数字就是 link count
stat a.txt # Links: 2
find / -inum 12345 # 找出所有指向同一 inode 的名字(排查重复文件神器)
七、常见考题 & 易错点
“删除源文件后,硬链接还能读吗?” → 能。因为根本没有"源",大家平级。
“软链接占不占磁盘空间?” → 占,但极小(只占路径字符串那么点,通常几十字节)。
“修改软链接的内容会改到原文件吗?” → 会,因为写入操作会顺着链接追到目标 inode。
“cp 复制一个硬链接文件,新文件还是硬链接吗?” → 不是,cp 默认是拷贝数据,会产生新的 inode。要用 cp -a / cp -l 才能保留链接关系。
“为什么硬链接不能链目录?” → 如果允许,目录结构就从"树"变成"图"了,cd …、find、du 这些遍历算法会陷入死循环。(这也是为什么每个目录下的 . 和 … 是特例。)
“软硬链接哪个性能更好?” → 硬链接(少一次路径解析跳转),但差距微乎其微,日常不用纠结。
八、随手可以做的实验(5分钟,比看书管用)
cd /tmp
echo “OS exam” > original.txt
ln original.txt hard.txt
ln -s original.txt soft.txt
stat original.txt # 看 Inode、Links
stat hard.txt # Inode 相同,Links=2
stat soft.txt # Inode 不同,Size 很小,类型 Symbolic link
echo “changed” >> hard.txt
cat original.txt # → OS exam + changed(同一个文件)
rm original.txt
cat hard.txt # → 正常
cat soft.txt # → No such file or directory(死了)
跑一遍这套命令,这节课基本就通了。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 1
 0
- 0


 已为社区贡献6条内容

所有评论(0)