企业级打印管理软件核心架构设计与多场景落地实践全流程详解
背景与问题
我们团队在设计某分布式打印管理方案的过程中,接触到大量企业级文印场景的共性痛点,这些痛点也是我们架构设计的核心出发点:
设备兼容成本高:不同品牌打印设备的私有协议不统一,早期每新增一类机型就要单独开发适配逻辑,迭代效率极低,无法满足多品牌设备混合部署的需求;
跨地域打印体验差:多分支组织的漫游打印默认走总部VPN传输作业,大文件打印极易占满带宽,作业延迟高甚至丢失,用户侧体验极差;
安全合规能力缺失:传统打印架构无全链路审计能力,敏感文件打印、复印、扫描操作无法追溯,不符合等保2.0等合规要求;
运维效率低:设备故障、耗材不足无法提前预警,IT人员需被动响应大量零散问题,人力成本居高不下。
技术原理
该方案的核心技术逻辑围绕「兼容、效率、安全、可控」四个维度设计,底层核心原理如下:
设备抽象层原理:将不同品牌打印、复印、扫描的私有协议抽象为统一API接口,上层业务无需感知底层设备差异,实现多品牌设备统一管控;
漫游打印路由原理:基于用户当前IP、设备负载、网络链路质量三个维度做动态调度,优先将作业下发到就近边缘节点,减少跨网传输开销;
全链路审计原理:对文印全流程(提交、认证、输出、留存)做埋点采集,结合OCR识别技术对内容做敏感词匹配,实现事前拦截、事中监控、事后追溯;
高可用集群原理:采用主从节点分布式部署,节点故障时客户端自动切流,无单点故障风险,支持私有化部署与数据闭环流转。
架构设计与关键实现
整体采用分层解耦的云原生架构设计,从上到下分为5个层级:
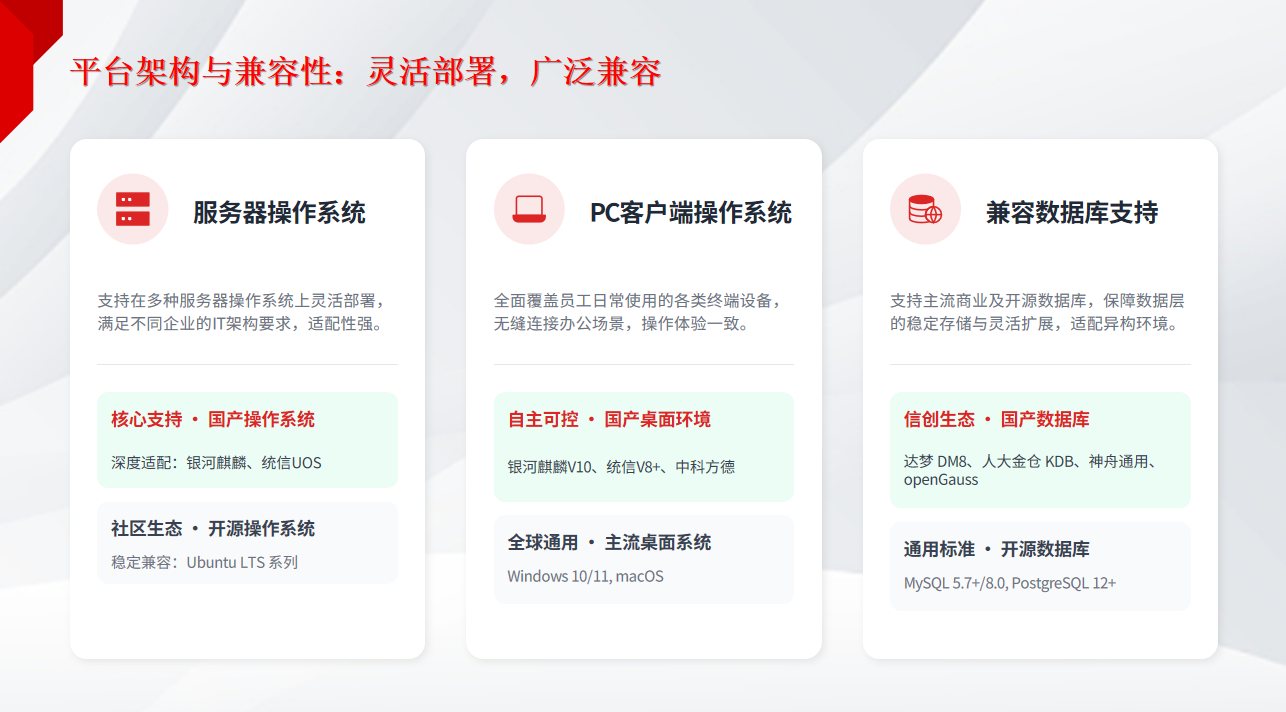
接入层:覆盖Windows、macOS、银河麒麟、统信等多端客户端,支持12种身份认证方式,可对接OA、ERP及主流办公协作平台;
设备适配层:抽象统一的设备操作协议,覆盖主流打印品牌的私有协议,支持多品牌设备利旧;
业务逻辑层:包含漫游打印调度、权限管控、OCR审计、审批流程、配额管理、外发文件管控等核心模块;
数据层:兼容开源数据库与达梦、人大金仓等国产数据库,数据多副本备份,支持日志全量导出追溯;
运维层:内置智能运维驾驶舱,实时监控设备状态、服务器负载,支持故障自动告警与远程抄表。
核心代码示例1:漫游打印作业动态路由逻辑
python def route_print_job(user_ip: str, job_size: int, available_devices: list) -> dict: """ 漫游打印作业动态路由逻辑 :param user_ip: 用户当前IP地址 :param job_size: 打印作业大小(单位:MB) :param available_devices: 可用设备列表,包含IP、负载、所属区域、支持的格式 :return: 最优分配的设备信息 """
same_region_devices = [dev for dev in available_devices if is_same_subnet(user_ip, dev["ip"])]
candidate_devices = same_region_devices if same_region_devices else available_devices

# 2. 过滤负载高于70%的繁忙设备
candidate_devices = [dev for dev in candidate_devices if dev["load"] < 0.7]

# 3. 按链路延迟、作业适配度计算得分
for dev in candidate_devices:
    dev["score"] = cal_routing_score(dev["latency"], dev["max_job_size"], job_size)

# 返回得分最高的最优设备
return sorted(candidate_devices, key=lambda x: x["score"], reverse=True)[0]
核心配置示例2:企业身份源同步配置
yaml
identity_source: type: feishu # 支持feishu/wework/dingtalk/ldap等多种身份源 corp_id: "your_corp_id" app_key: "your_app_key" app_secret: "your_app_secret" api_endpoint: "https://open.example.com" sync_config: sync_interval: 3600 # 同步周期,单位秒 sync_fields: ["user_id", "name", "department", "email", "phone"] default_permission: print_quota: 100 # 新用户默认月度打印配额(单位:张) color_permission: false # 默认关闭彩色打印权限 audit_enable: true # 默认开启全操作审计
性能验证
在标准实验室环境下对该架构进行压力测试,核心能力指标如下:
单集群支持1000台以上打印设备并发接入,可承载10万+用户规模的日常使用;
作业提交吞吐量可达1000笔/秒,作业平均调度延迟小于200ms;
节点故障时客户端自动切换到空闲节点的时间小于30秒,无作业丢失;
OCR敏感内容识别准确率可达98%以上,100MB以内的PDF文件识别耗时小于10秒;
支持WEB与数据库双机互备,故障自动接管RTO小于1分钟。
踩坑与优化
在多场景落地过程中,我们也遇到了不少问题,通过迭代优化逐步完善了架构能力:
跨网带宽占用过高问题:最初跨分支漫游打印时大作业全量回传总部,极易占满VPN带宽,后来我们在每个分支部署边缘缓存节点,作业只在用户所在分支的本地节点存储,无需回传总部,跨网带宽占用降低了90%以上;
新机型适配效率低问题:最初每新增一类机型就要单独开发适配逻辑,周期长达数周,后来我们抽象了统一的设备适配层协议,将打印、复印、扫描操作封装为标准接口,理论上可以将新机型适配周期从数周缩短到数天;
信创环境兼容问题:适配国产数据库时遇到语法不兼容的问题,我们新增了SQL方言适配层,上层业务逻辑无需修改即可适配达梦、人大金仓、openGauss等多种国产数据库;
大文件OCR识别超时问题:最初单线程识别大文件极易超时,我们优化为分片异步识别,将大文件拆分为多个小分片并行识别,识别效率提升了3倍以上。
适用边界与总结
该架构适用于以下技术场景:
多分支、多品牌设备混合部署的环境,需要统一管控文印资源;
需要文印全流程审计与敏感内容拦截的场景,满足合规要求;
信创全栈适配的国产化环境,需要兼容国产操作系统、数据库、CPU;
需要精细化核算文印成本的组织,实现印量按部门、用户维度分摊。
整体来看,该架构通过分层解耦的设计思路,解决了多设备兼容、跨地域打印、安全合规、运维效率等核心问题,经过大量场景验证具备较高的稳定性和扩展性。后续我们会继续优化边缘计算能力和AI内容识别的准确率,覆盖更多细分场景需求。
本文含AI生成内容,已由作者审核修改。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)