RA-L 2026 | 反应式扩散策略:从 RDP 到 ImplicitRDP【文献解读】
文献:Reactive Diffusion Policy: Slow-Fast Visual-Tactile Policy Learning for Contact-Rich Manipulation
会议:Robotics: Science and Systems(RSS 2025),Best Student Paper Finalist
论文地址:https://arxiv.org/abs/2503.02881
项目主页:https://reactive-diffusion-policy.github.io/
RDP 代码:https://github.com/xiaoxiaoxh/reactive_diffusion_policy
TactAR 代码:https://github.com/xiaoxiaoxh/TactAR_APP
延伸文献:ImplicitRDP: An End-to-End Visual-Force Diffusion Policy With Structural Slow-Fast Learning
期刊:IEEE Robotics and Automation Letters(RA-L 2026), Vol. 11, No. 8, pp. 10010–10017
论文地址:https://arxiv.org/abs/2512.10946
项目主页:https://implicit-rdp.github.io/
代码:https://github.com/Chen-Wendi/ImplicitRDP
1. 研究背景与核心问题
接触丰富操作(contact-rich manipulation)与普通抓取、搬运的本质区别,在于任务成功不仅依赖“末端执行器应该到哪里”,还依赖“接触后应该以多大的力、沿什么方向继续运动,以及环境变化后能否立即修正”。削皮、擦拭、夹持纸杯、拨动开关、插孔等任务都具有这一特点。
视觉模仿学习近年来大量采用 Action Chunking(动作块预测):策略一次预测未来若干步动作,再按块执行。Diffusion Policy、ACT 等方法因此获得了更好的时间一致性,并能表达停顿、往复等非马尔可夫行为以及多模态轨迹。但代价是:动作块执行期间,本质上仍存在一段开环区间。如果接触状态在块内突然变化,即使策略输入中包含触觉或力信号,也无法保证当前正在执行的后续动作立即随之变化。
论文因此聚焦于三个相互耦合的技术矛盾:
- 长时序动作建模与高频闭环反应之间的矛盾。 长动作块有利于保持轨迹一致性,却降低反馈刷新速度;缩短动作块虽然能提升闭环频率,却会破坏非马尔可夫行为建模并增加抖动、卡滞。
- 视觉与触觉/力信号的频率不匹配。 视觉适合提供全局几何和任务上下文,但处理频率低;触觉/力信号只反映局部接触,却需要在几十赫兹甚至更高频率下快速响应。
- 训练数据质量问题。 接触任务中的“专家动作”与接触力高度相关。如果遥操作员只能看 RGB 图像而感知不到切向力、法向力和扭转载荷,采集到的数据本身就可能存在不稳定接触,最终策略很难学到稳定的“力—动作修正”对应关系。
RDP 的回答不是单纯“给 Diffusion Policy 再加一个 tactile observation”,而是同时解决数据采集与策略结构两个层面的问题:
- 用 TactAR 在遥操作阶段把触觉/力反馈以增强现实方式实时呈现给操作者,提高示范质量;
- 用 Slow-Fast Policy 将复杂轨迹建模和快速触觉闭环分开处理:慢策略负责“计划”,快策略负责“接触后的即时修正”。
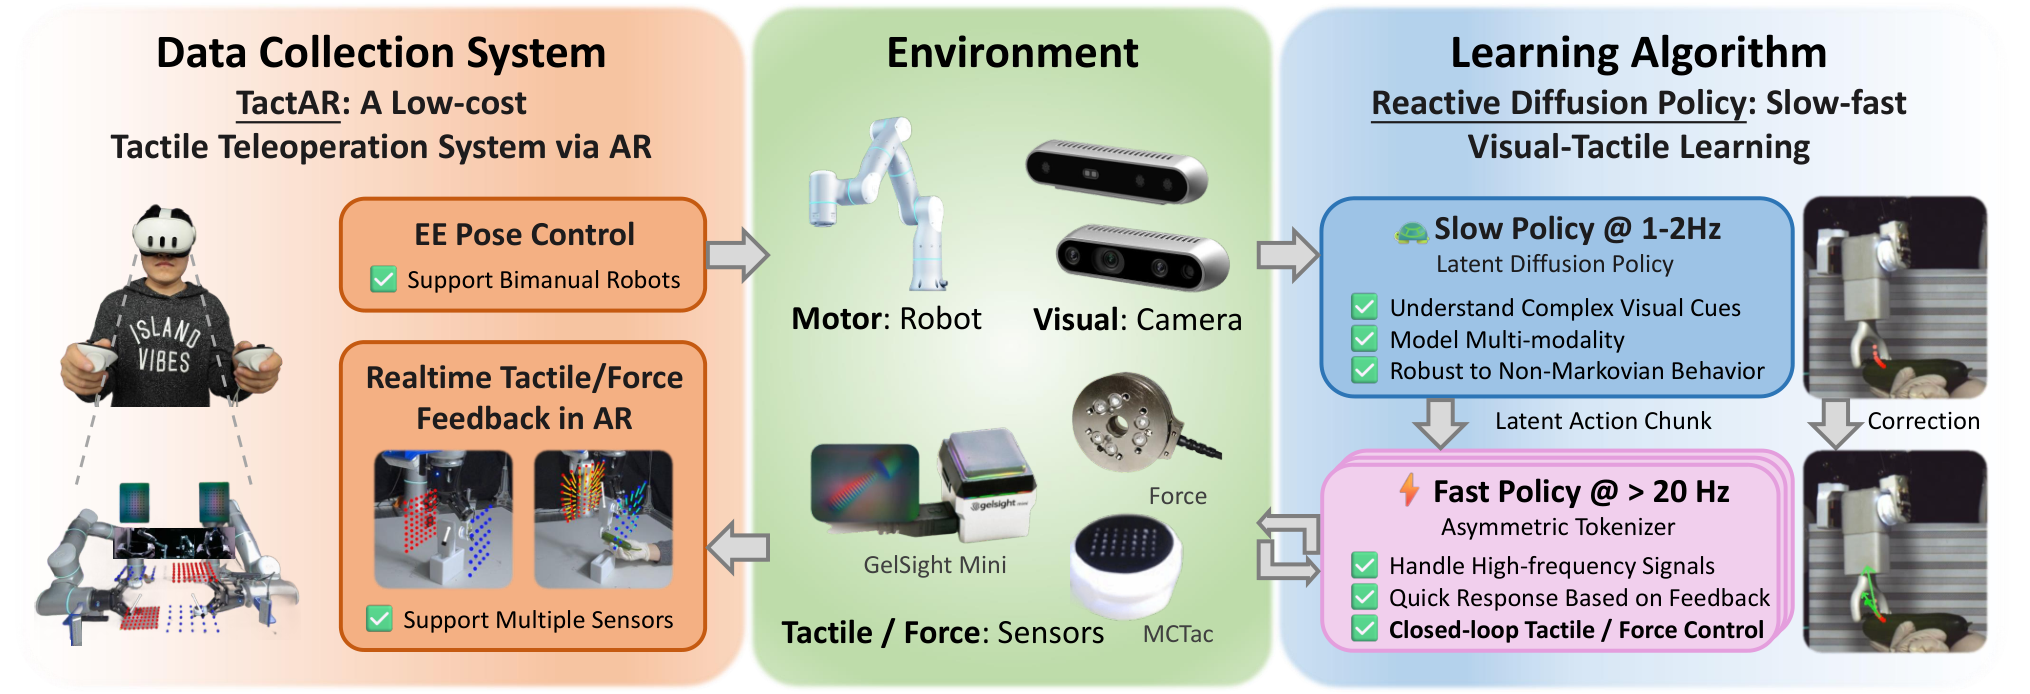
图 1(RDP 原文 Fig. 1)TactAR 与 Reactive Diffusion Policy 的整体思想:低频慢策略负责复杂动作块建模,高频快策略依据触觉/力反馈进行闭环修正。
来源:Xue et al., RSS 2025, Fig. 1。
2. TactAR:面向接触任务的数据采集系统
2.1 为什么论文首先改造遥操作系统
接触丰富模仿学习的一个容易被忽略的问题是:策略上限受到示范数据上限限制。若操作者在采集削皮数据时只能看相机画面,很难稳定判断刀具是否“压得过重”“刚好接触”或“已经失去接触”。此时动作轨迹中会夹杂大量不一致的力反馈,快策略即使拥有很高模型容量,也难以从数据中识别稳定的反应规律。
TactAR 使用消费级 AR/VR 头显,把机器人末端的触觉/力信息转成三维变形/力场并“附着”在末端执行器附近显示,同时支持 RGB 相机和触觉相机流。这样操作者可以在控制末端位姿的同时直观看到接触方向与强弱。
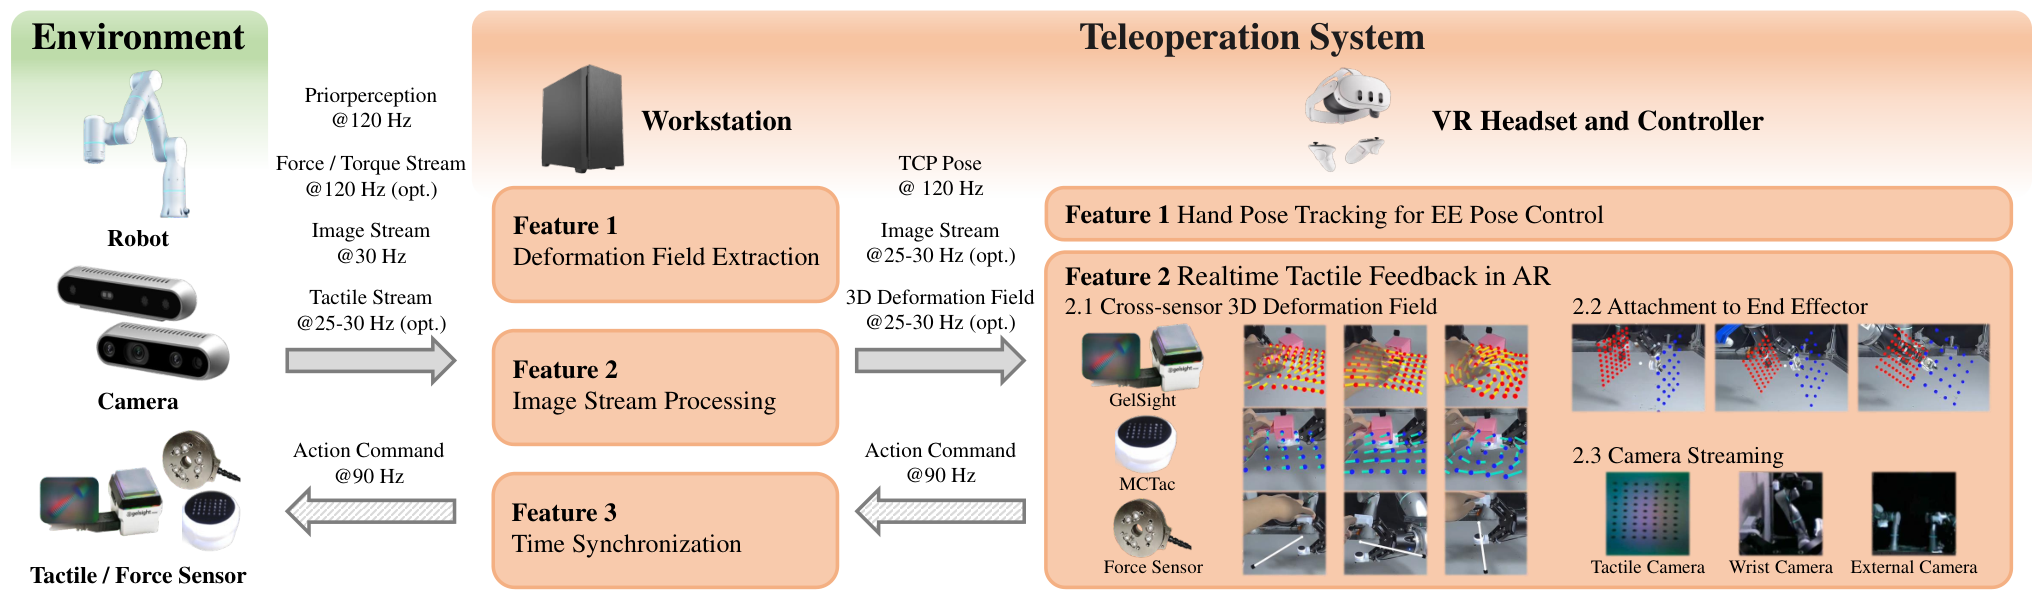
图 2(RDP 原文 Fig. 2)TactAR 遥操作系统结构:机器人、RGB/触觉/力传感器经过工作站同步与处理后,将三维变形/力场和图像流送入 AR 端。
来源:Xue et al., RSS 2025, Fig. 2。
2.2 三维变形场:统一不同触觉/力传感器的表示
对带 marker 的光学触觉传感器,系统首先从初始帧与当前帧中提取 marker 位置,并计算二维光流:
F t = [ d x , d y ] = Flow ( D 0 , D t ) . F_t=[\mathbf d_x,\mathbf d_y]=\operatorname{Flow}(D_0,D_t). Ft=[dx,dy]=Flow(D0,Dt).
其中 D 0 D_0 D0 是无接触状态下的 marker 位置, D t D_t Dt 是当前时刻 marker 位置。随后构造三维变形场:
V t = [ d x , d y , o z ] , V_t=[\mathbf d_x,\mathbf d_y,\mathbf o_z], Vt=[dx,dy,oz],
其中 o z \mathbf o_z oz 表示法向方向的偏移量。对于直接输出力的传感器,则可以统一表示为:
V t = [ f x , f y , f z ] . V_t=[\mathbf f_x,\mathbf f_y,\mathbf f_z]. Vt=[fx,fy,fz].
这一设计的关键并不在于“精确恢复真实三维接触力”,而在于构造一个低门槛、可跨传感器、可实时可视化的接触反馈接口。操作者不需要完成昂贵的力/力矩标定,也能看到法向、切向和扭转接触模式。
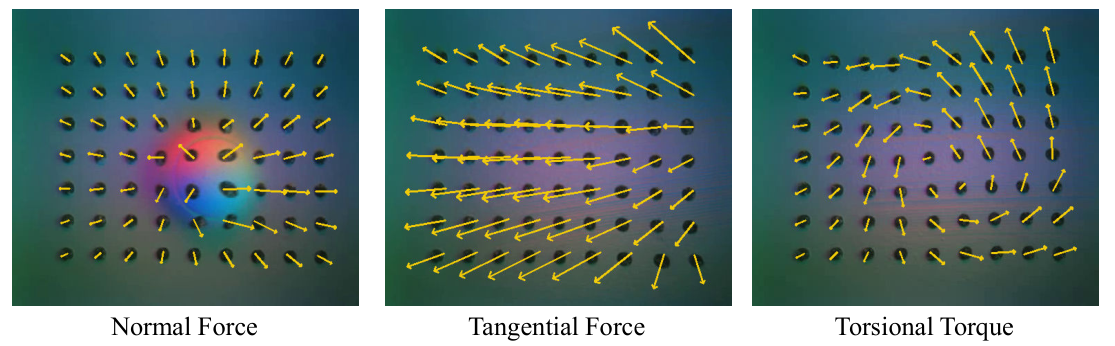
图 3(RDP 原文 Fig. 3)GelSight Mini 在法向力、切向力与扭转载荷下的 marker 变形场。
来源:Xue et al., RSS 2025, Fig. 3。
2.3 AR 坐标标定
AR 中的虚拟坐标系必须与机器人 TCP/world 坐标对齐,否则变形场虽然可见,却不能正确表达“力从哪个方向作用于末端”。论文采用人工交互式方式调整平移和旋转,使虚拟坐标系与预定义 TCP 位置以及世界坐标原点完成对齐。
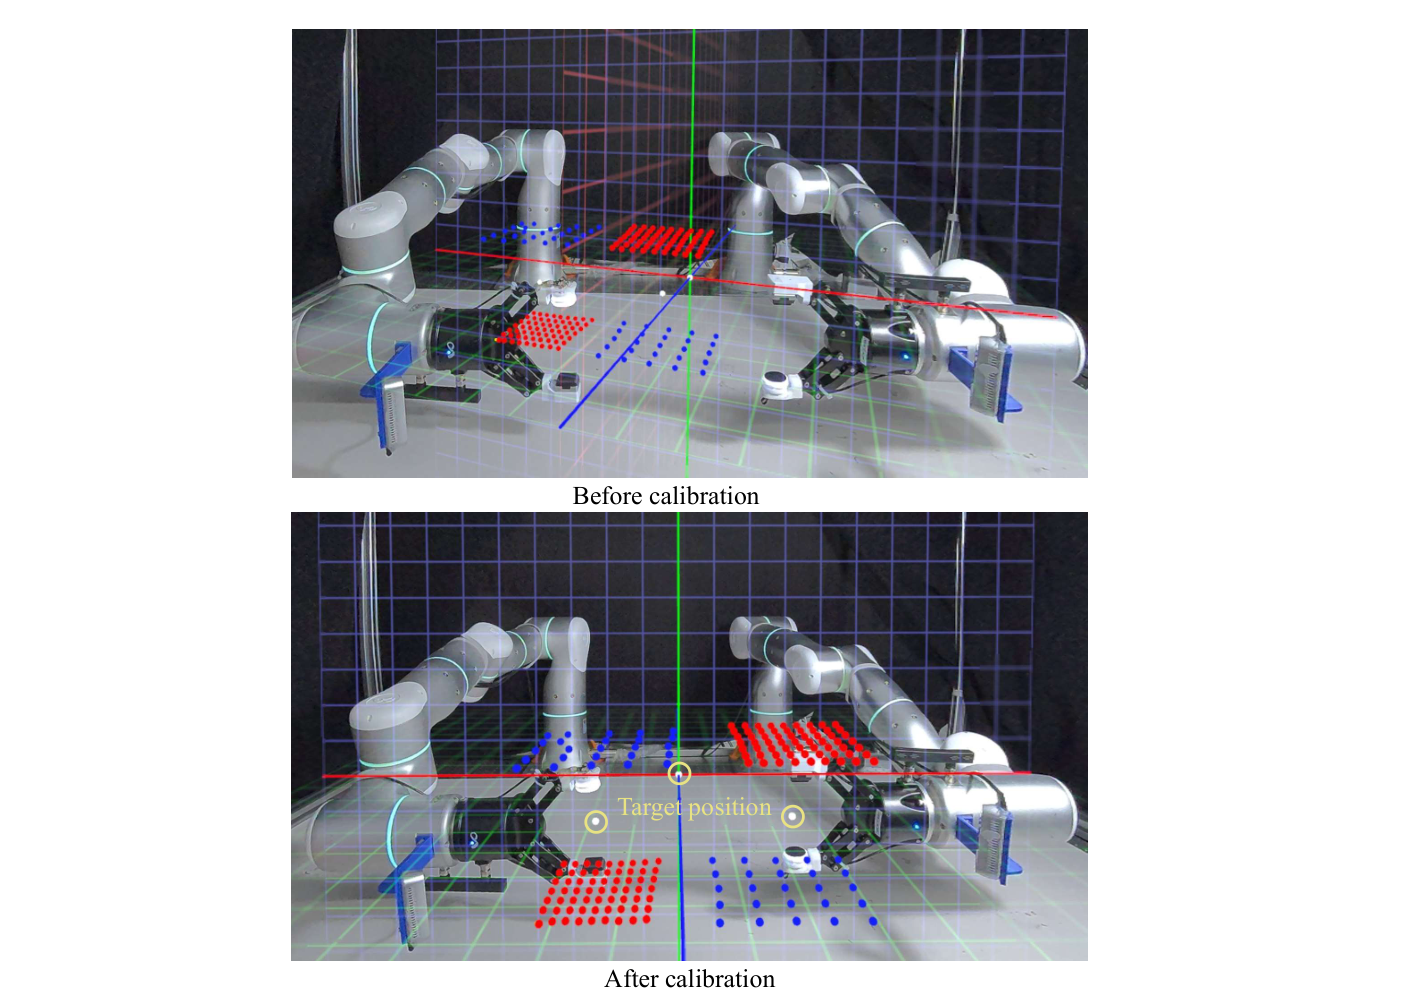
图 4(RDP 原文 Fig. 4)TactAR 的 AR 坐标标定过程:由标定前的坐标错位调整到虚拟坐标系与机器人 TCP/world 对齐。
来源:Xue et al., RSS 2025, Fig. 4。
2.4 系统延迟与可复现性
论文附录给出的系统延迟量级为:触觉 marker 跟踪约 10 m s 10\,\mathrm{ms} 10ms,Quest 渲染约 10 m s 10\,\mathrm{ms} 10ms,局域网通信约 1 ∼ 6 m s 1\sim6\,\mathrm{ms} 1∼6ms;光学触觉本身还存在约 10 ∼ 60 m s 10\sim60\,\mathrm{ms} 10∼60ms 的内部延迟。TactAR 的优势因此不是“零延迟”,而是用消费级硬件获得足以支撑高质量接触示范的实时反馈。
3. 为什么传统 Action Chunking 难以同时获得一致性与反应性
RDP 对现有策略执行方式的比较非常重要。原文把四类控制模式放在同一张图中:
- Vanilla Action Chunking:一次预测完整 chunk,块内完全开环;
- Temporal Ensembling:每个时刻重新预测并对多个重叠动作取加权平均,形成“半闭环”;
- RDP Slow-Fast:慢策略保持 chunk 级一致性,快策略在 chunk 内按高频触觉反馈逐步修正;
- Human Control:类似“先做预测性粗动作,再利用触觉快速微调”。
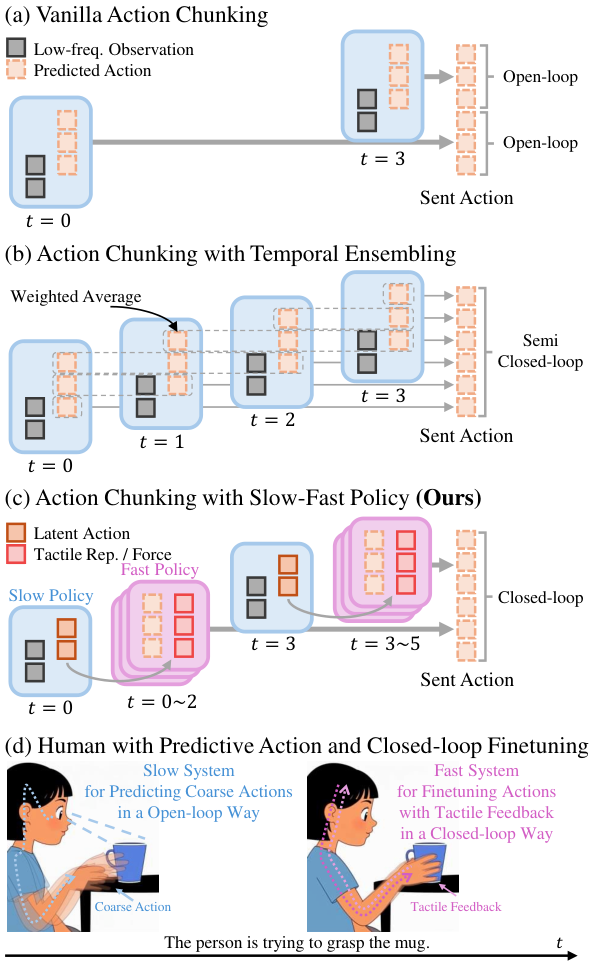
图 5(RDP 原文 Fig. 5)Vanilla Action Chunking、Temporal Ensembling、RDP Slow-Fast 与人类控制模式的对比。
来源:Xue et al., RSS 2025, Fig. 5。
Temporal Ensembling 看似可以兼顾二者,但它本质上是在多个历史预测之间做平滑。当权重偏向新预测时,会接近短 chunk,容易破坏非马尔可夫行为;当权重偏向旧预测时,又会过度平滑,降低对突发接触变化的响应速度。因此,论文提出的核心判断是:“时序一致性”和“闭环反应性”不应依赖一个时间平滑系数折中,而应由不同频率、不同职责的模块显式承担。
4. 触觉/力表示:从高维图像到低维接触变量
4.1 PCA 触觉表示
直接把光学触觉 RGB 图像喂入策略存在两个问题:维度高、易受光照/胶层损伤/替换影响。RDP 不直接学习 RGB 触觉图,而是先跟踪 marker 变形,再用 PCA(Principal Component Analysis,主成分分析) 压缩。
把多个触觉帧的二维 marker 位移拼成矩阵:
F c o n c a t ∈ R m × 2 n , F_{\mathrm{concat}}\in\mathbb{R}^{m\times 2n}, Fconcat∈Rm×2n,
通过 PCA 得到投影矩阵 T p r o j T_{\mathrm{proj}} Tproj:
F r e d u c e d = T p r o j F c o n c a t , F_{\mathrm{reduced}}=T_{\mathrm{proj}}F_{\mathrm{concat}}, Freduced=TprojFconcat,
新触觉帧对应的低维表示为:
f t ′ r e d u c e d = T p r o j F t ′ . f_{t'}^{\mathrm{reduced}}=T_{\mathrm{proj}}F_{t'}. ft′reduced=TprojFt′.
论文指出 d = 15 d=15 d=15 已能够较好重建原始变形场。更重要的是,前几个 PCA 主成分具有较清晰的物理可解释性:C1/C3 主要对应切向变形,C2 对应扭转,C4 主要对应法向接触。
对于直接的力/力矩传感器,RDP 则将 **6-D wrench(3 维力 + 3 维力矩)**直接拼接进观测向量。
5. RDP 核心算法:Slow-Fast Visual-Tactile Policy
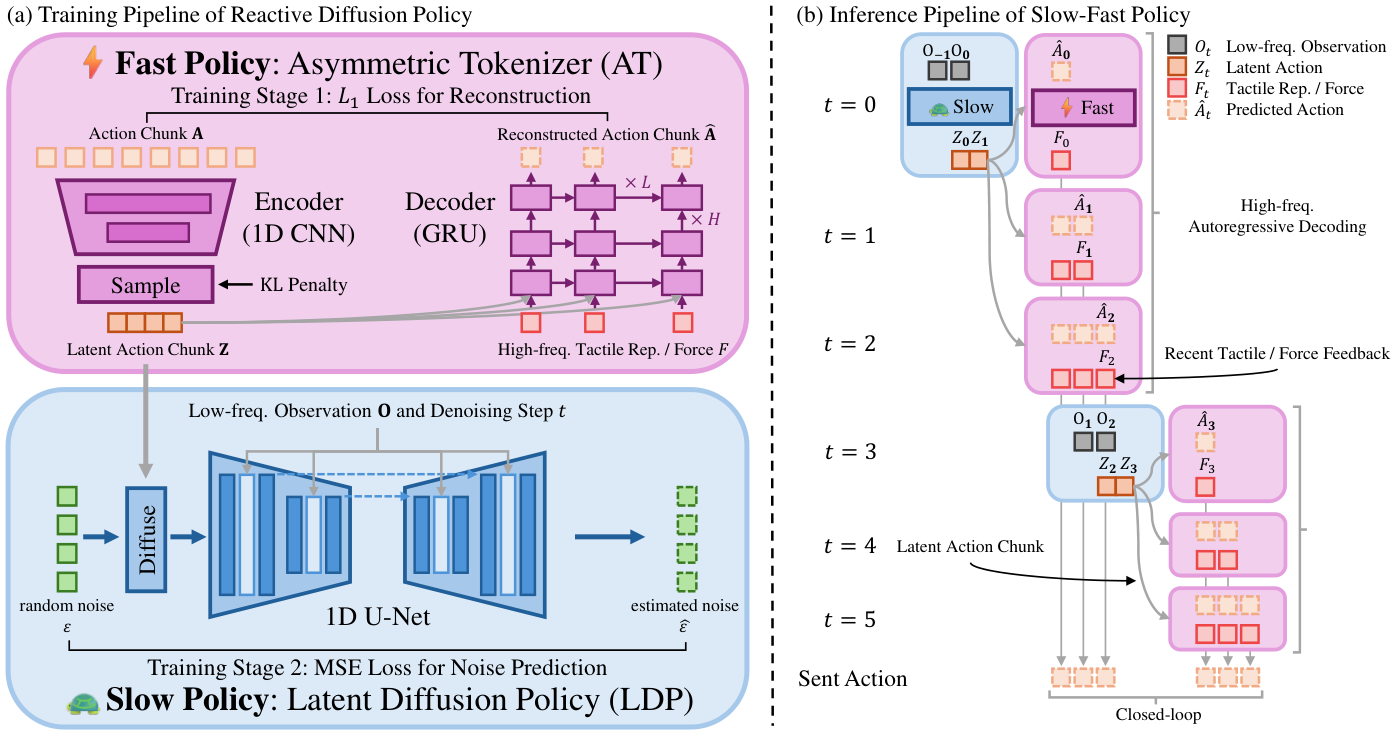
图 6(RDP 原文 Fig. 6)Reactive Diffusion Policy 的训练与推理框架:Stage 1 训练 Asymmetric Tokenizer,Stage 2 在潜在动作空间训练 Latent Diffusion Policy;推理时慢策略低频生成 latent chunk,快策略依据最新触觉/力信号自回归解码动作。
来源:Xue et al., RSS 2025, Fig. 6。
5.1 快策略:Asymmetric Tokenizer(AT)
快策略由一个 1D-CNN 编码器 E \mathcal E E 和一个 GRU 解码器 D \mathcal D D 组成。给定动作块:
A ∈ R T × D , \mathbf A\in\mathbb R^{T\times D}, A∈RT×D,
编码器将其下采样为潜在动作块:
Z = E ( A ) ∈ R t × d . \mathbf Z=\mathcal E(\mathbf A)\in\mathbb R^{t\times d}. Z=E(A)∈Rt×d.
解码阶段再结合对应的触觉表示:
A ^ = D ( concat [ Z , F r e d u c e d ] ) . \hat{\mathbf A}=\mathcal D\left(\operatorname{concat}\left[\mathbf Z,\mathbf F^{\mathrm{reduced}}\right]\right). A^=D(concat[Z,Freduced]).
训练目标为:
L A T = E [ ∥ A − A ^ ∥ 1 + λ K L L K L ] . L_{AT}=\mathbb E\left[\|\mathbf A-\hat{\mathbf A}\|_1+\lambda_{KL}L_{KL}\right]. LAT=E[∥A−A^∥1+λKLLKL].
这里最重要的不是 CNN 或 GRU 本身,而是 Asymmetric(非对称):触觉只进入 decoder,不进入 encoder。这样做的目的,是让 Z \mathbf Z Z 尽量只保存“高层动作模式/策略”,而将需要实时接触反馈决定的精细位置修正留给 decoder。
换句话说,AT 不只是一个普通自编码器,而是在结构上强迫网络形成如下分工:
Latent Chunk Z ≈ 粗粒度动作意图 , Tactile/Force ≈ 实时接触校正量 . \text{Latent Chunk }\mathbf Z\approx\text{粗粒度动作意图},\qquad \text{Tactile/Force}\approx\text{实时接触校正量}. Latent Chunk Z≈粗粒度动作意图,Tactile/Force≈实时接触校正量.
论文测得快策略在 RTX 4090 上单次推理低于 1 m s 1\,\mathrm{ms} 1ms,理论上可支持 > 300 H z >300\,\mathrm{Hz} >300Hz 的输入更新;实际实验频率主要受触觉相机帧率限制。
5.2 慢策略:Latent Diffusion Policy(LDP)
慢策略不直接在原始动作空间扩散,而是在 AT 编码后的 latent action chunk 上进行 Diffusion Policy 学习。令:
Z 0 = E ( A 0 ) , \mathbf Z^0=\mathcal E(\mathbf A^0), Z0=E(A0),
论文写出的 DDPM 训练目标为:
L L D P = E ( O , A 0 ) , k , ϵ k ∥ ϵ k − ϵ θ ( O , Z 0 + ϵ k , k ) ∥ 2 . L_{LDP}=\mathbb E_{(\mathbf O,\mathbf A^0),k,\epsilon^k} \left\|\epsilon^k-\epsilon_\theta(\mathbf O,\mathbf Z^0+\epsilon^k,k)\right\|_2. LLDP=E(O,A0),k,ϵk ϵk−ϵθ(O,Z0+ϵk,k) 2.
其中 O \mathbf O O 包括视觉、触觉/力和本体状态, k k k 为扩散步, ϵ k \epsilon^k ϵk 为噪声。实现采用 CNN-based Diffusion Policy,并通过 FiLM 注入条件。
把扩散过程放到 latent 空间有两个直接效果:
- latent 序列更短、更低维,降低生成成本;
- 细粒度接触反应已被 AT decoder“剥离”出去,LDP 只需学习更平滑、更宏观的动作多模态结构,因此低频视觉更新也可以工作。
5.3 推理:慢规划 + 快触觉闭环
推理时,慢策略约以 1 ∼ 2 H z 1\sim2\,\mathrm{Hz} 1∼2Hz 生成 latent action chunk;在一个 chunk 内,快策略用最新触觉/力信号以约 20 ∼ 30 H z 20\sim30\,\mathrm{Hz} 20∼30Hz 自回归解码当前动作。实验中由于 GelSight 约 25 FPS,实际使用 24 FPS 的快策略更新;论文同时指出底层 Flexiv RDK 会将动作进一步插值到 > 500 H z >500\,\mathrm{Hz} >500Hz 执行。
可以把整个执行过程理解为:
RGB + proprioception → 低频 LDP Z 0 : H → 高频 AT decoder + tactile/force a ^ t . \text{RGB + proprioception} \xrightarrow[\text{低频}]{\text{LDP}} \mathbf Z_{0:H} \xrightarrow[\text{高频}]{\text{AT decoder + tactile/force}} \hat a_t. RGB + proprioceptionLDP低频Z0:HAT decoder + tactile/force高频a^t.
这与传统阻抗控制有相似的功能分层,但快策略不是手工设计的力—位移控制律,而是从示范中学习出来的“可学习反应式控制器”。
5.4 两个容易被忽略、但消融证明非常重要的工程设计
(1)Relative Trajectory Prediction(相对轨迹预测)
RDP 不是让快策略直接回归绝对末端位姿,而是尽量使用相对于 chunk 参考状态的动作表示。相对动作的数值范围更紧凑,使小网络更容易学习“接触变强时往哪里退一点”“失去接触时往哪里补一点”这类局部反应规律,也压缩了 latent 空间。
(2)Latency Matching(延迟匹配)
视觉处理、网络推理、通信和执行均存在系统延迟。如果训练数据中的观测与动作时间对齐方式和实际部署不一致,那么 chunk 切换附近会出现明显的 OOD 状态。RDP 通过对预测/执行步做延迟匹配,保证新 chunk 与当前实际状态具有一致的时间关系,从而减少动作跳变。
表 I(RDP 原文 Table I)RTX 4090 上不同模块推理时间
| 模块 | Diffusion Policy | Slow Policy(LDP) | Fast Policy(AT) |
|---|---|---|---|
| 推理时间 | 120 ms | 100 ms | < 1 ms |
6. 实验设计
6.1 硬件与数据
RDP 使用两台 Flexiv Rizon 4 与 Flexiv Grav gripper,并根据任务组合使用 GelSight Mini、改进版 MCTac 和机器人内置关节力矩/力信息;RGB 视觉使用腕部与外部 RealSense 相机。计算平台为高性能 CPU + RTX 4090。
用于策略学习的示范规模分别约为:Peeling 60 条、Wiping 80 条、Bimanual Lifting 50 条。用于 PCA 触觉表示的数据则通过多种物体与接触模式单独采集。
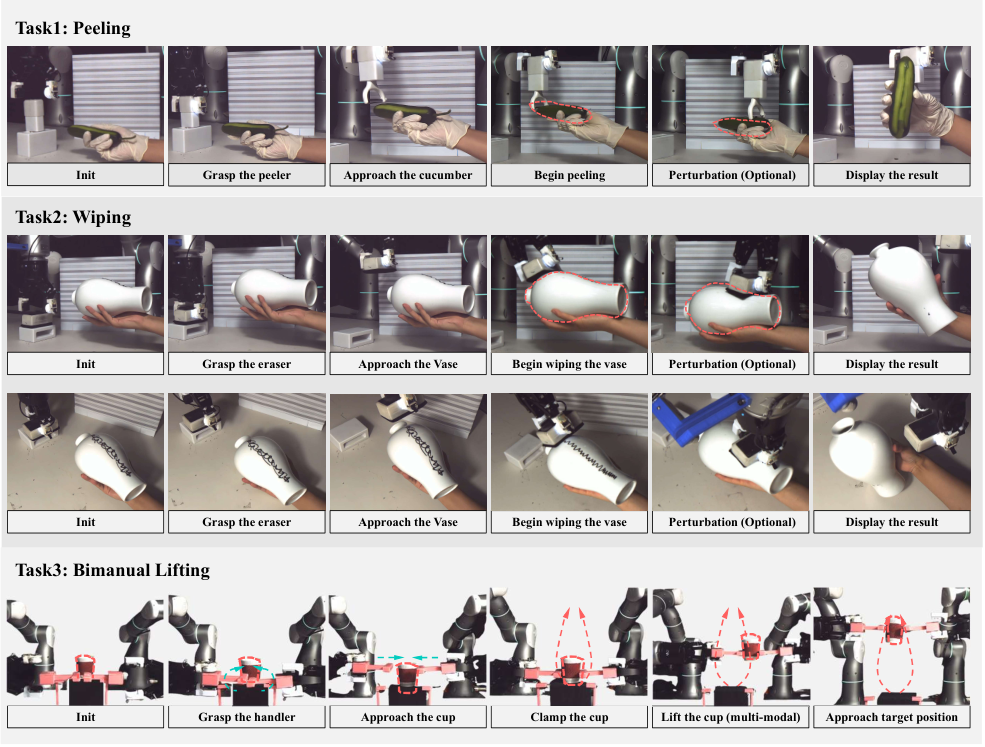
图 7(RDP 原文 Fig. 7)三个真实机器人接触丰富任务:Peeling、Wiping 与 Bimanual Lifting。
来源:Xue et al., RSS 2025, Fig. 7。
6.2 三类任务分别在测什么
**Peeling(削皮)**主要检验毫米级轨迹精度和扰动后的快速恢复。测试包含无扰动、接触前扰动、接触后扰动,后者最能暴露动作块开环执行的缺陷。
**Wiping(擦拭)**要求末端沿曲面移动并维持合适接触力,同时还要处理曲率变化、旋转与人为扰动,因此更接近“位置—力耦合”的柔顺操作。
**Bimanual Lifting(双臂夹杯抬升)**要求两臂协调地夹紧纸杯:力太小会滑落,力太大会压坏杯体,同时示范中存在两种上升轨迹,用于检验扩散策略是否保留多模态动作建模能力。
6.3 Baseline
核心基线包括纯视觉 Diffusion Policy、加入 raw tactile image 的 DP、加入 PCA tactile embedding 的 DP,以及 RDP 的不同传感器版本。论文还用短 chunk、Temporal Ensembling、绝对动作、去除 latency matching 等设置做消融。
7. 主实验结果
7.1 Peeling:最能体现“接触后扰动”的价值
表 II(RDP 原文 Table II)Peeling 任务策略表现
| 方法 | 无扰动 | 接触前扰动 | 接触后扰动 | Overall |
|---|---|---|---|---|
| DP | 0.56 | 0.58 | 0.19 | 0.44 |
| DP + tactile image | 0.60 | 0.49 | 0.16 | 0.41 |
| DP + tactile embedding | 0.48 | 0.55 | 0.15 | 0.39 |
| RDP(GelSight) | 0.98 | 0.93 | 0.80 | 0.90 |
| RDP(MCTac) | 1.00 | 0.84 | 0.79 | 0.88 |
| RDP(Force) | 0.99 | 0.98 | 0.88 | 0.95 |
最关键的结果不是 RDP 的最高分,而是:给普通 DP 加 tactile 并没有带来整体提升。 接触后扰动下,DP + tactile embedding 只有 0.15,而 RDP(GelSight)达到 0.80,RDP(Force)达到 0.88。这直接证明瓶颈不只是“有没有触觉输入”,更是“动作执行结构是否允许触觉在 chunk 内改变动作”。
7.2 Wiping:曲面跟踪与自适应接触力
表 III(RDP 原文 Table III)Wiping 任务策略表现
| 方法 | 无扰动 | 接触前扰动 | 接触后扰动 | Overall |
|---|---|---|---|---|
| DP | 0.75 | 0.70 | 0.25 | 0.57 |
| DP + tactile embedding | 0.60 | 0.75 | 0.15 | 0.50 |
| RDP(GelSight) | 0.85 | 0.95 | 0.50 | 0.77 |
| RDP(Force) | 0.95 | 0.85 | 0.80 | 0.87 |
RDP(Force)在接触后扰动时仍达到 0.80,而普通 DP 为 0.25。这说明快策略不是单纯检测“接触/未接触”,而是在持续利用力信号调整曲面跟踪轨迹。
7.3 Bimanual Lifting:精确夹持 + 双臂协调 + 多模态
表 IV(RDP 原文 Table IV)Bimanual Lifting 任务策略表现
| 方法 | Soft:Clamp | Soft:Lift | Soft:Score | Hard:Clamp | Hard:Lift | Hard:Score | Overall |
|---|---|---|---|---|---|---|---|
| DP | 0% | 0% | 0.00 | 0% | 0% | 0.00 | 0.00 |
| DP + tactile embedding | 10% | 10% | 0.10 | 20% | 10% | 0.05 | 0.08 |
| RDP(GelSight + MCTac) | 100% | 100% | 0.55 | 90% | 80% | 0.40 | 0.48 |
| RDP(Force) | 100% | 90% | 0.80 | 90% | 90% | 0.60 | 0.70 |
该任务同时说明 LDP 并没有因为快策略加入而丧失 Diffusion Model 的多模态建模能力:论文观察到 RDP(Force)仍能生成不同的上抬轨迹。
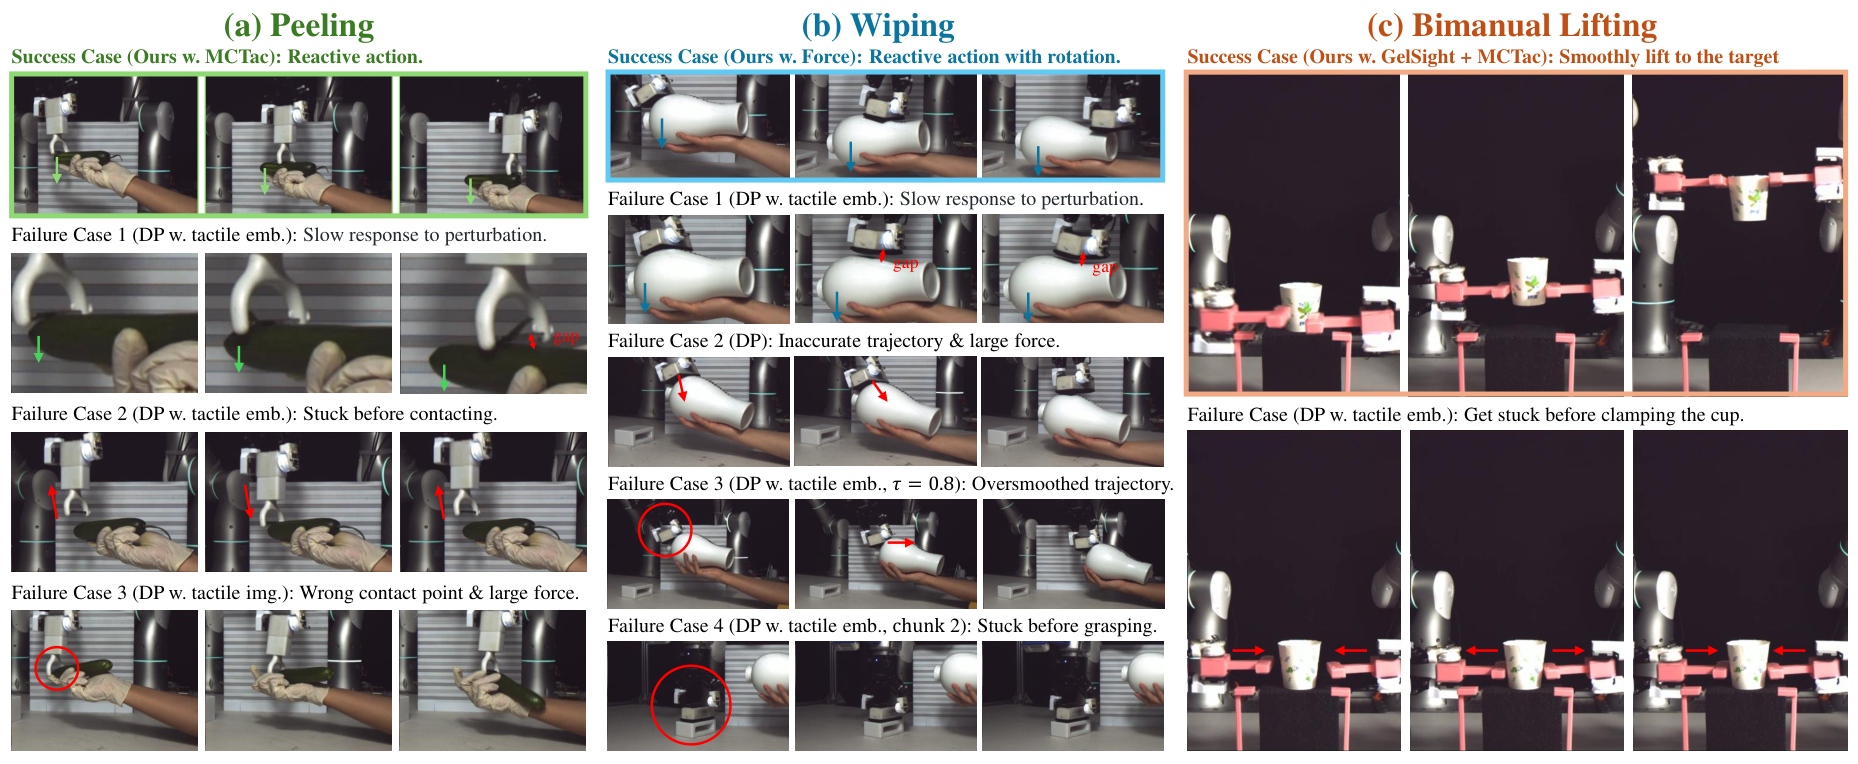
图 8(RDP 原文 Fig. 8)三类任务中的成功案例和 baseline 失败模式:失去接触、轨迹偏差/大接触力、卡滞以及 Temporal Ensembling 过度平滑。
来源:Xue et al., RSS 2025, Fig. 8。
7.4 RDP 到底在“修正”什么
论文把慢策略原始 action chunk 与快策略加入触觉后的 reactive action 进行可视化。典型行为包括:接触力突然升高时产生向上的微小修正;接近黄瓜末端时向下补偿以贴住表面;双臂夹杯接触后产生向外修正,避免挤压纸杯。修正量通常只有亚毫米级,但接触任务中这种微小变化足以决定是否失稳。
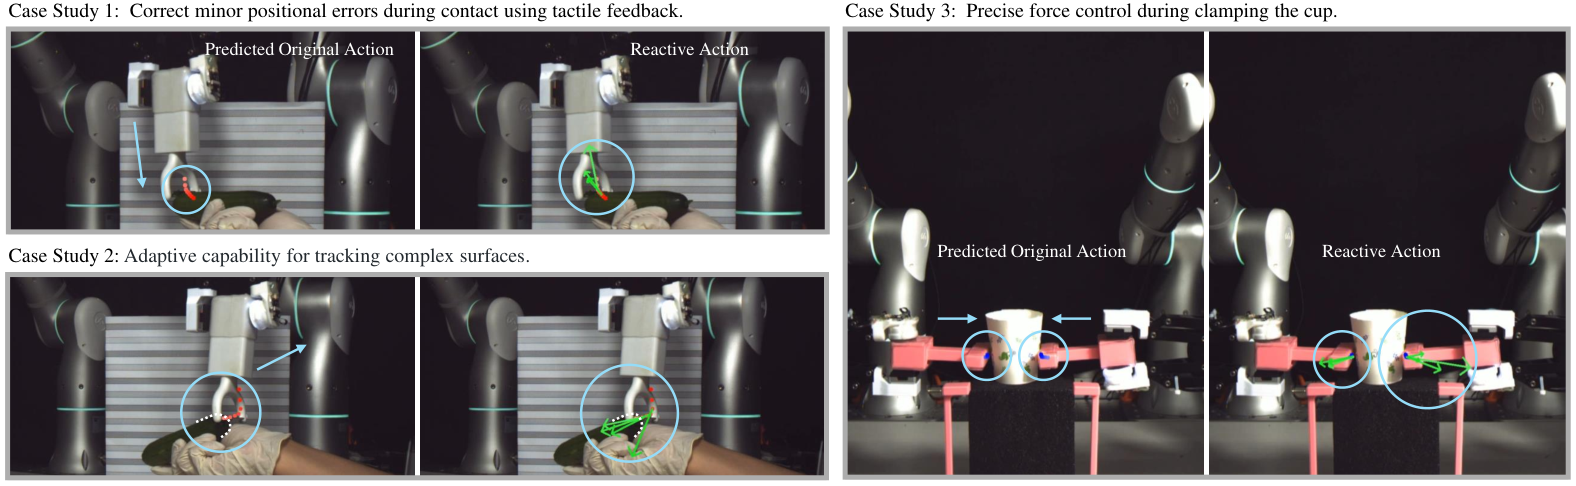
图 9(RDP 原文 Fig. 9)RDP 推理可视化:红/蓝点表示慢策略预测的原始动作趋势,绿色箭头表示快策略根据实时触觉反馈产生的修正方向与幅值。
来源:Xue et al., RSS 2025, Fig. 9。
8. 消融实验:为什么不是“把 chunk 调短”就够了
表 V(RDP 原文 Table V)Chunk Size 与 Temporal Ensembling 对 Wiping(接触后扰动)的影响
| Action chunk size | Temporal ensemble τ \tau τ | Grasp | Score |
|---|---|---|---|
| 8 | – | 100% | 0.15 |
| 2 | – | 20% | 0.10 |
| 8 | 0.2 | 30% | 0.05 |
| 8 | 0.5 | 0% | 0.00 |
| 8 | 0.8 | 100% | 0.15 |
| RDP(GelSight) | – | 100% | 0.50 |
短 chunk 的问题在于,它会显著降低对停顿、等待、重复尝试等非马尔可夫动作的建模能力;Temporal Ensembling 则对 τ \tau τ 非常敏感。RDP 通过结构分工绕开了这个折中。
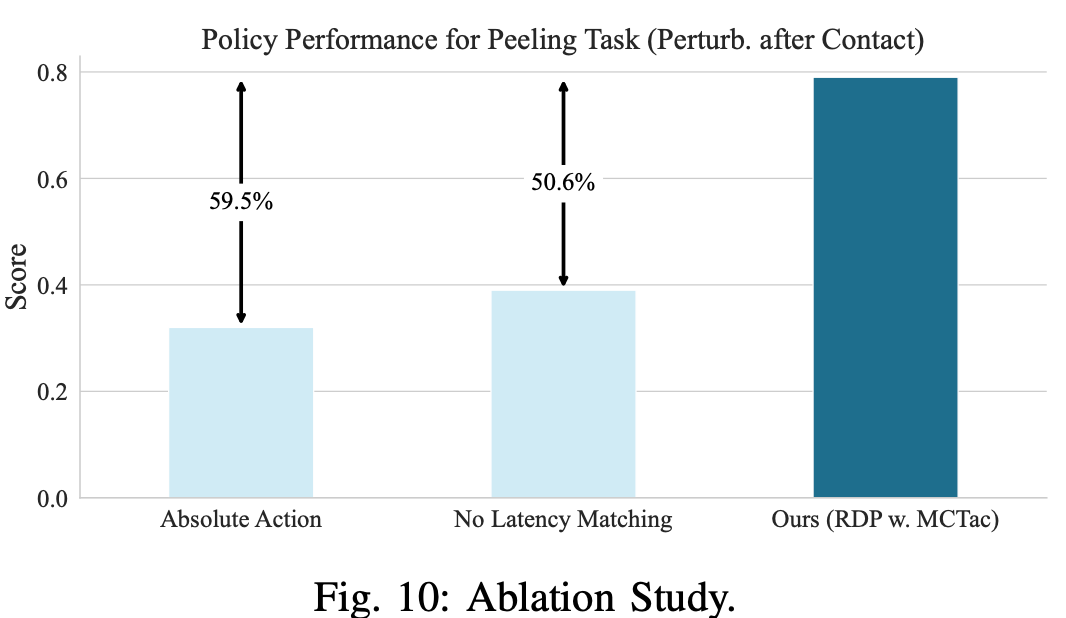
图 10(RDP 原文 Fig. 10)关键设计消融:绝对动作和去除 Latency Matching 都显著降低 Peeling 接触后扰动表现。
来源内容:Xue et al., RSS 2025, Fig. 10;图像为论文原图的在线镜像,数值与 RSS Proceedings PDF 逐项核对。
原文图 10 给出的下降比例分别约为 59.5%(Absolute Action)与 50.6%(No Latency Matching),说明高频快策略并不是全部,相对动作表示 + 时延对齐同样是系统稳定工作的关键。
8.1 Asymmetric Tokenizer 与完整力信息
表 VI(RDP 原文 Table VI)Peeling 任务的进一步消融
| 方法 | 无扰动 | 接触前扰动 | 接触后扰动 | Overall |
|---|---|---|---|---|
| DP | 0.56 | 0.58 | 0.19 | 0.44 |
| RDP,仅 normal force | 0.47 | 0.62 | 0.36 | 0.48 |
| RDP,symmetric tokenizer | 0.75 | 0.62 | 0.36 | 0.58 |
| RDP(default) | 0.99 | 0.98 | 0.88 | 0.95 |
这组结果支持两个结论:第一,接触任务并不只依赖法向力,切向力和扭转载荷同样提供重要信息;第二,AT 的非对称结构不是形式设计,若触觉同时进入 encoder,latent 更容易混入低层接触细节,慢—快职责分解会变差。
9. TactAR 用户研究:数据质量为什么会影响策略上限
论文邀请 10 名具有不同 VR/IL 经验的用户进行 Peeling 数据采集,每名用户分别采用传统 VR 与 TactAR 各进行 10 次试验,总计:
10 × 10 × 2 = 200 trials . 10\times 10\times 2=200\text{ trials}. 10×10×2=200 trials.
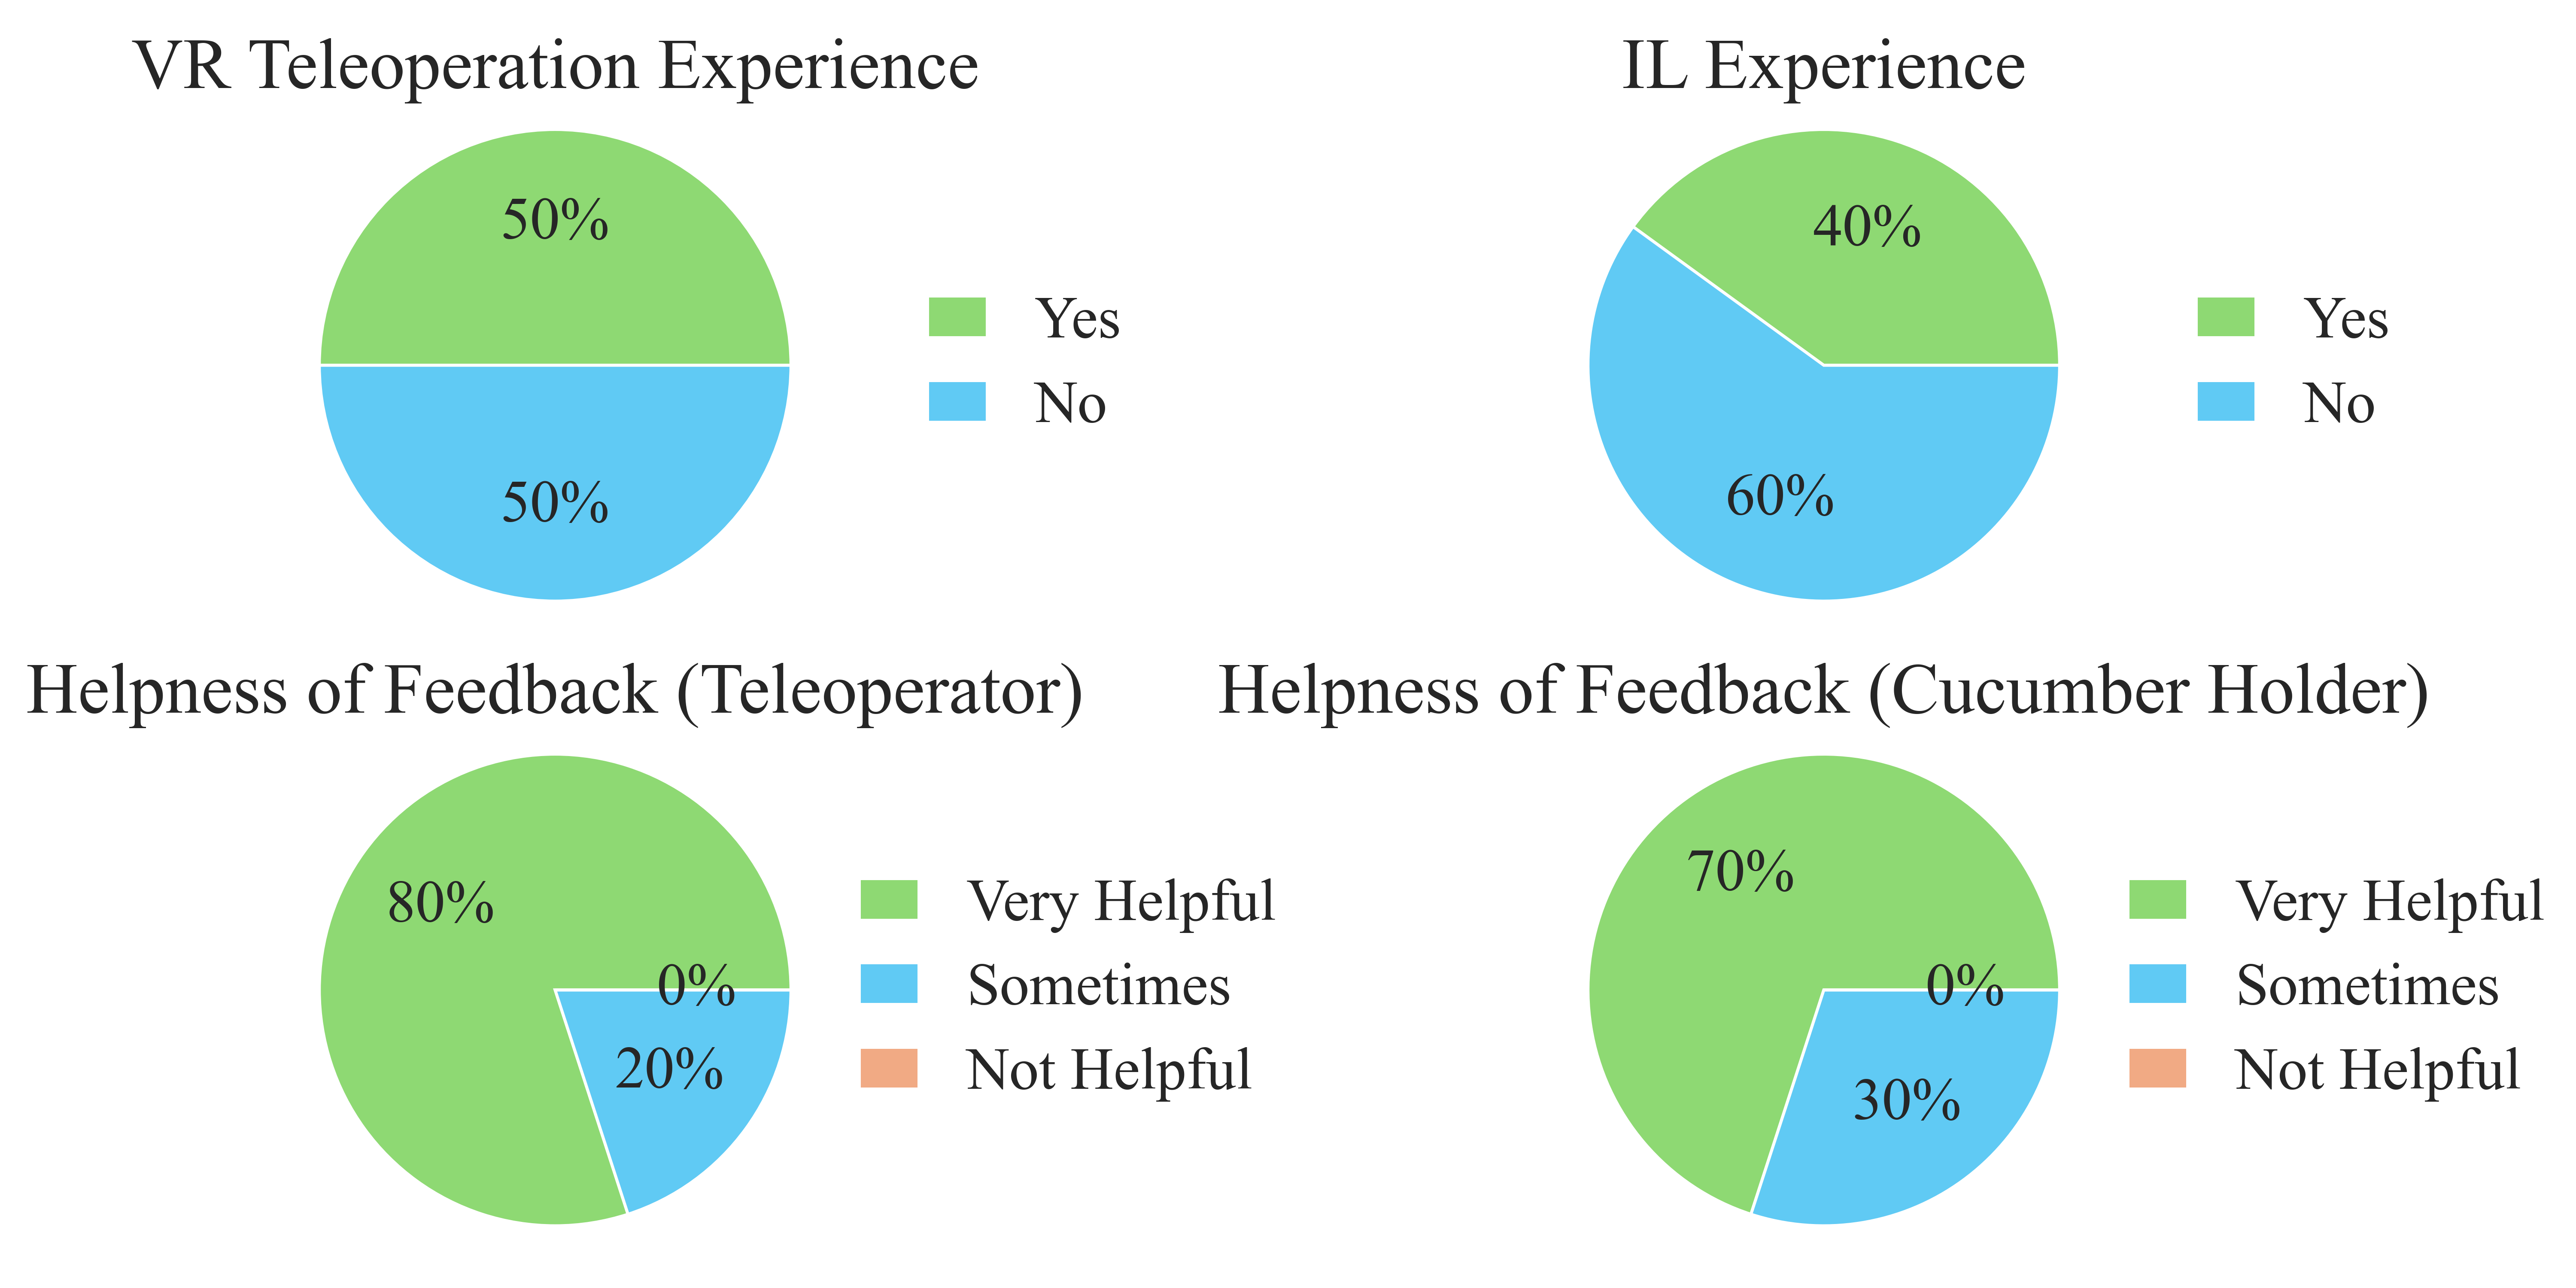
图 11(RDP 原文 Fig. 11)10 名用户对 TactAR 反馈帮助程度的主观评价:无论操作者还是持物者,至少 70% 认为 AR 触觉/力反馈非常有帮助。
来源:Xue et al., RSS 2025, Fig. 11;项目页提供同源原图。
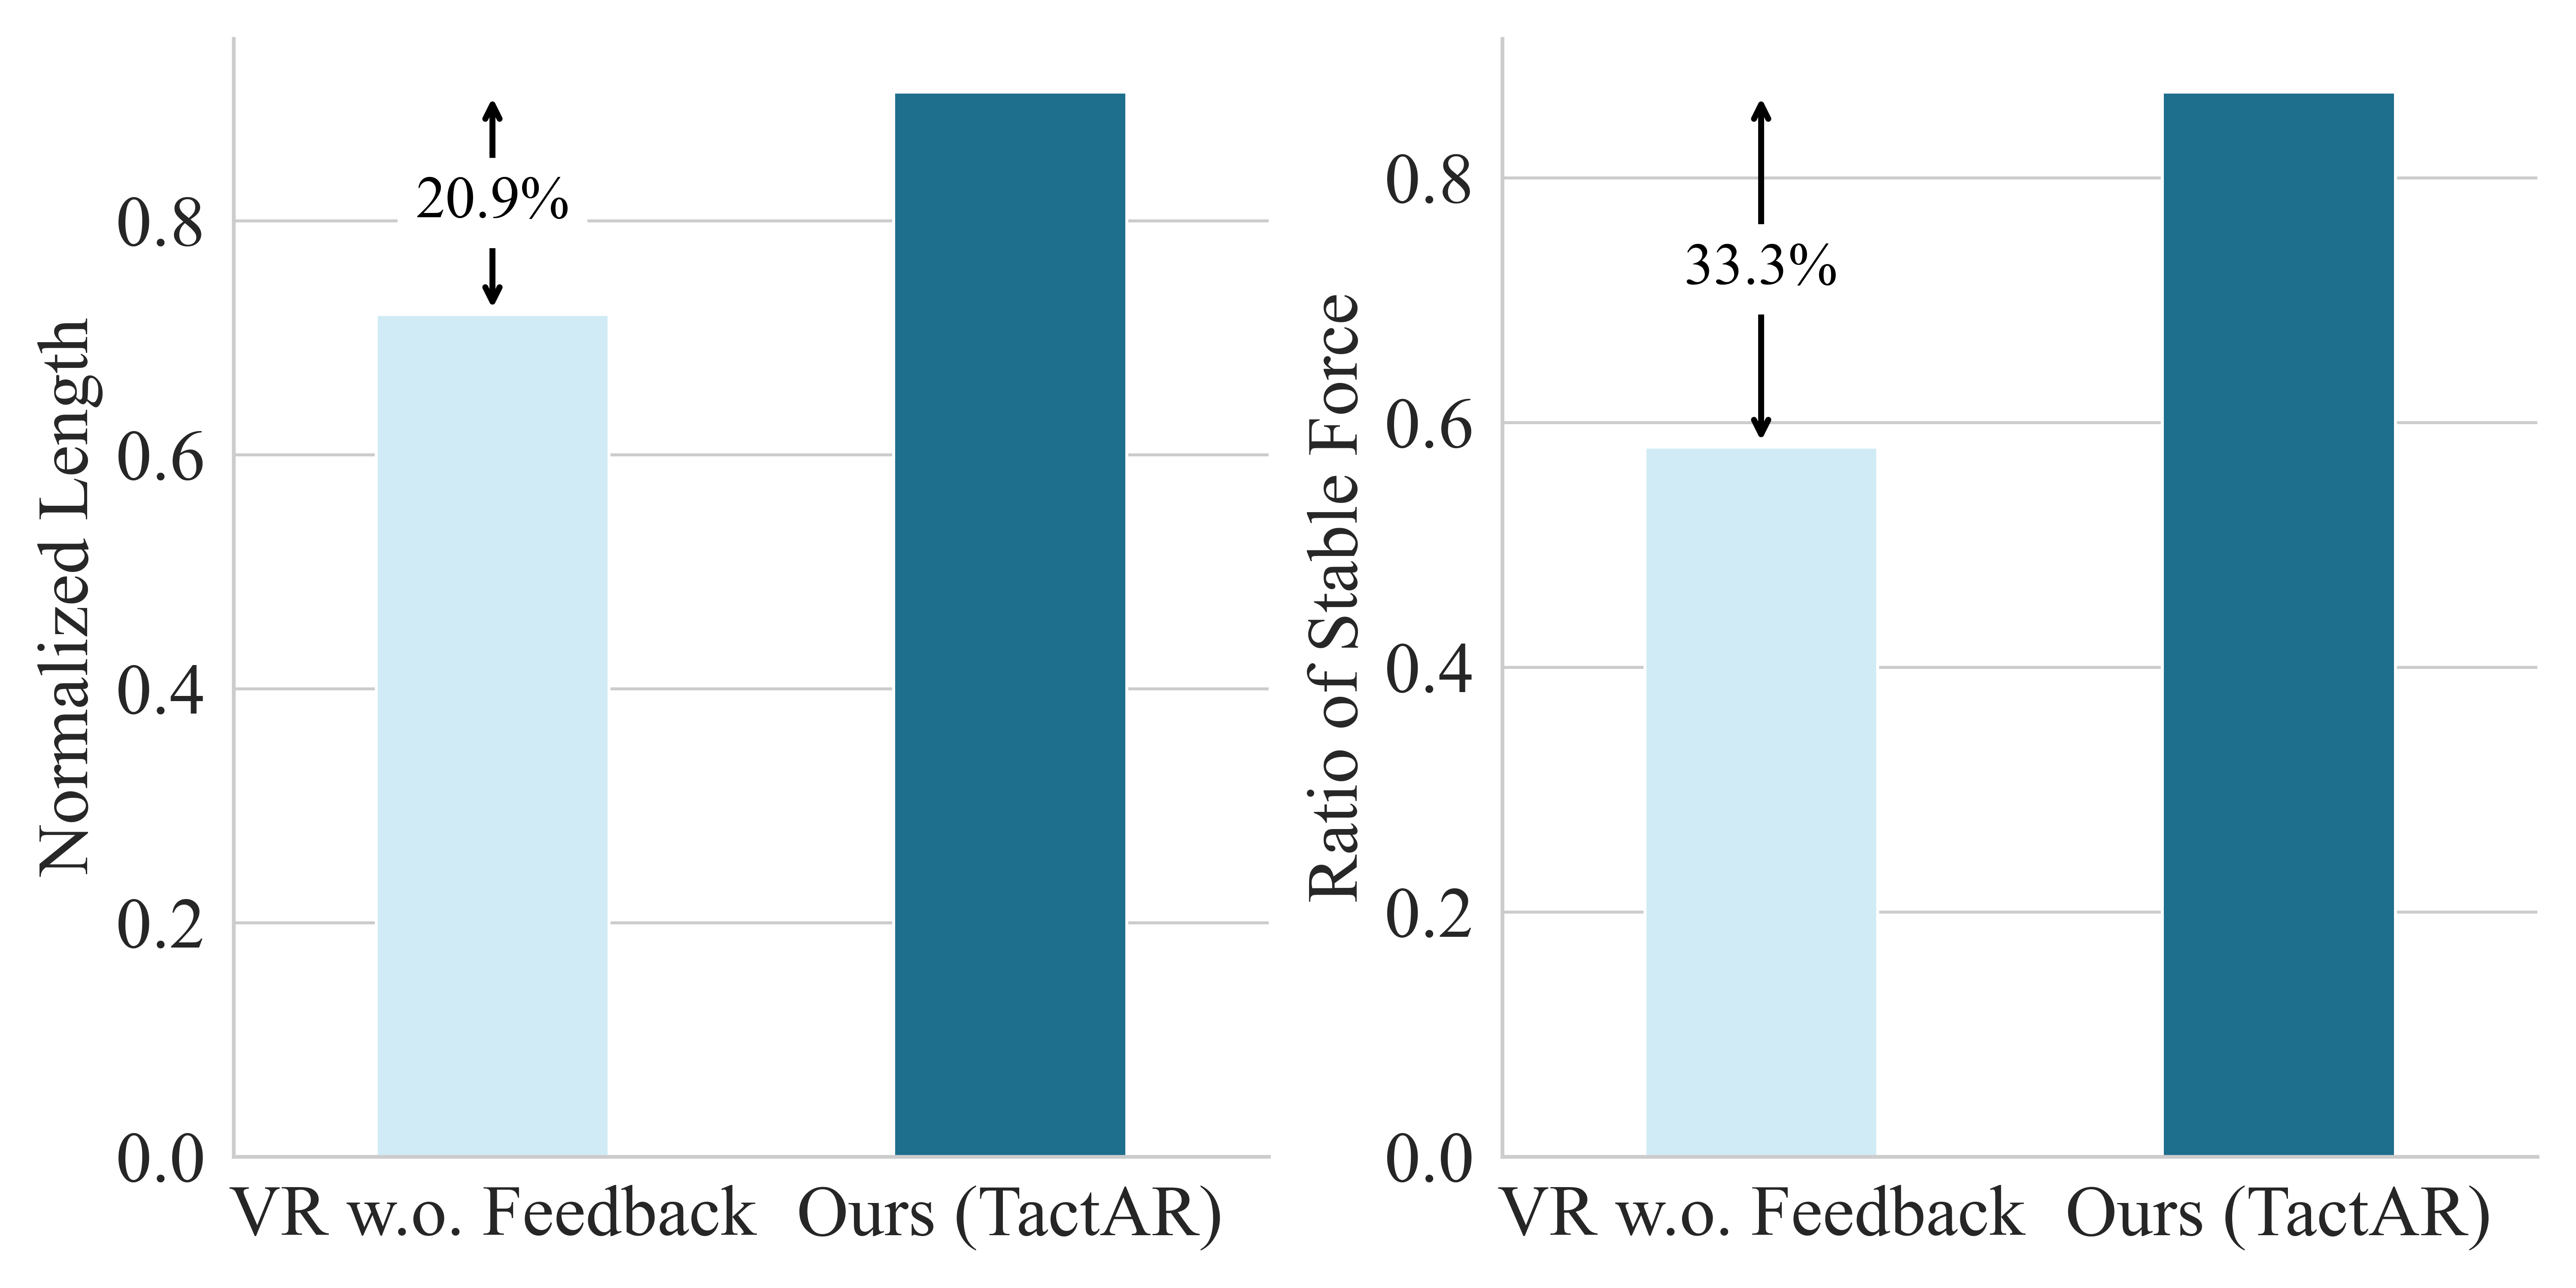
图 12(RDP 原文 Fig. 12)传统 VR 与 TactAR 的示范质量比较:归一化削皮长度由 0.72 提升至 0.91,稳定接触力比例由 0.58 提升至 0.87。
来源:Xue et al., RSS 2025, Fig. 12;项目页提供同源原图。
为了进一步定量比较接触力稳定性,作者对同一操作者的数据计算窗口长度为 10 步的 Rolling Standard Deviation。TactAR 分布明显集中在较小标准差区域,说明力波动更小。
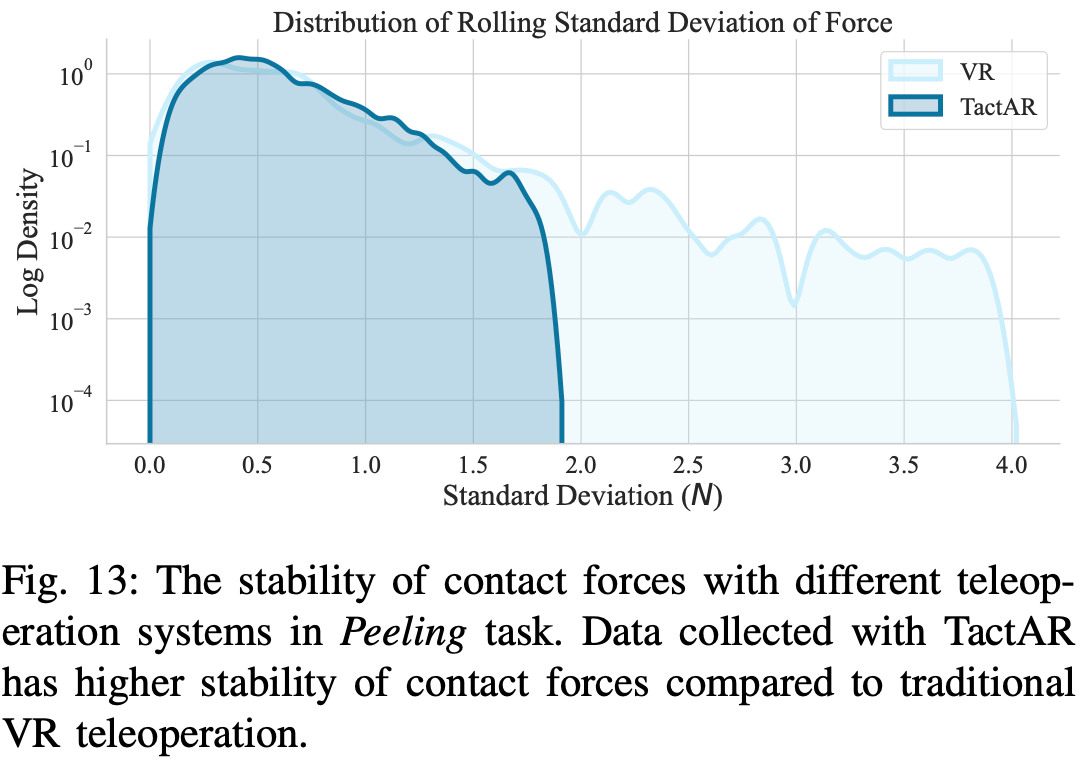
图 13(RDP 原文 Fig. 13)Peeling 中接触力 Rolling Standard Deviation 的分布:TactAR 数据的力波动更小。
来源内容:Xue et al., RSS 2025, Fig. 13;图像为论文原图的在线镜像,曲线与 RSS Proceedings PDF 核对。
更重要的是,作者用传统 VR 再采集同样数量的 60 条 Peeling 示范训练 RDP(Force),策略得分在三种评测条件下均明显下降,下降幅度超过 30%。这证明快策略学习的是示范中的“接触状态—动作修正”相关性:如果专家自身接触力就非常不稳定,网络无从提取一致规律。
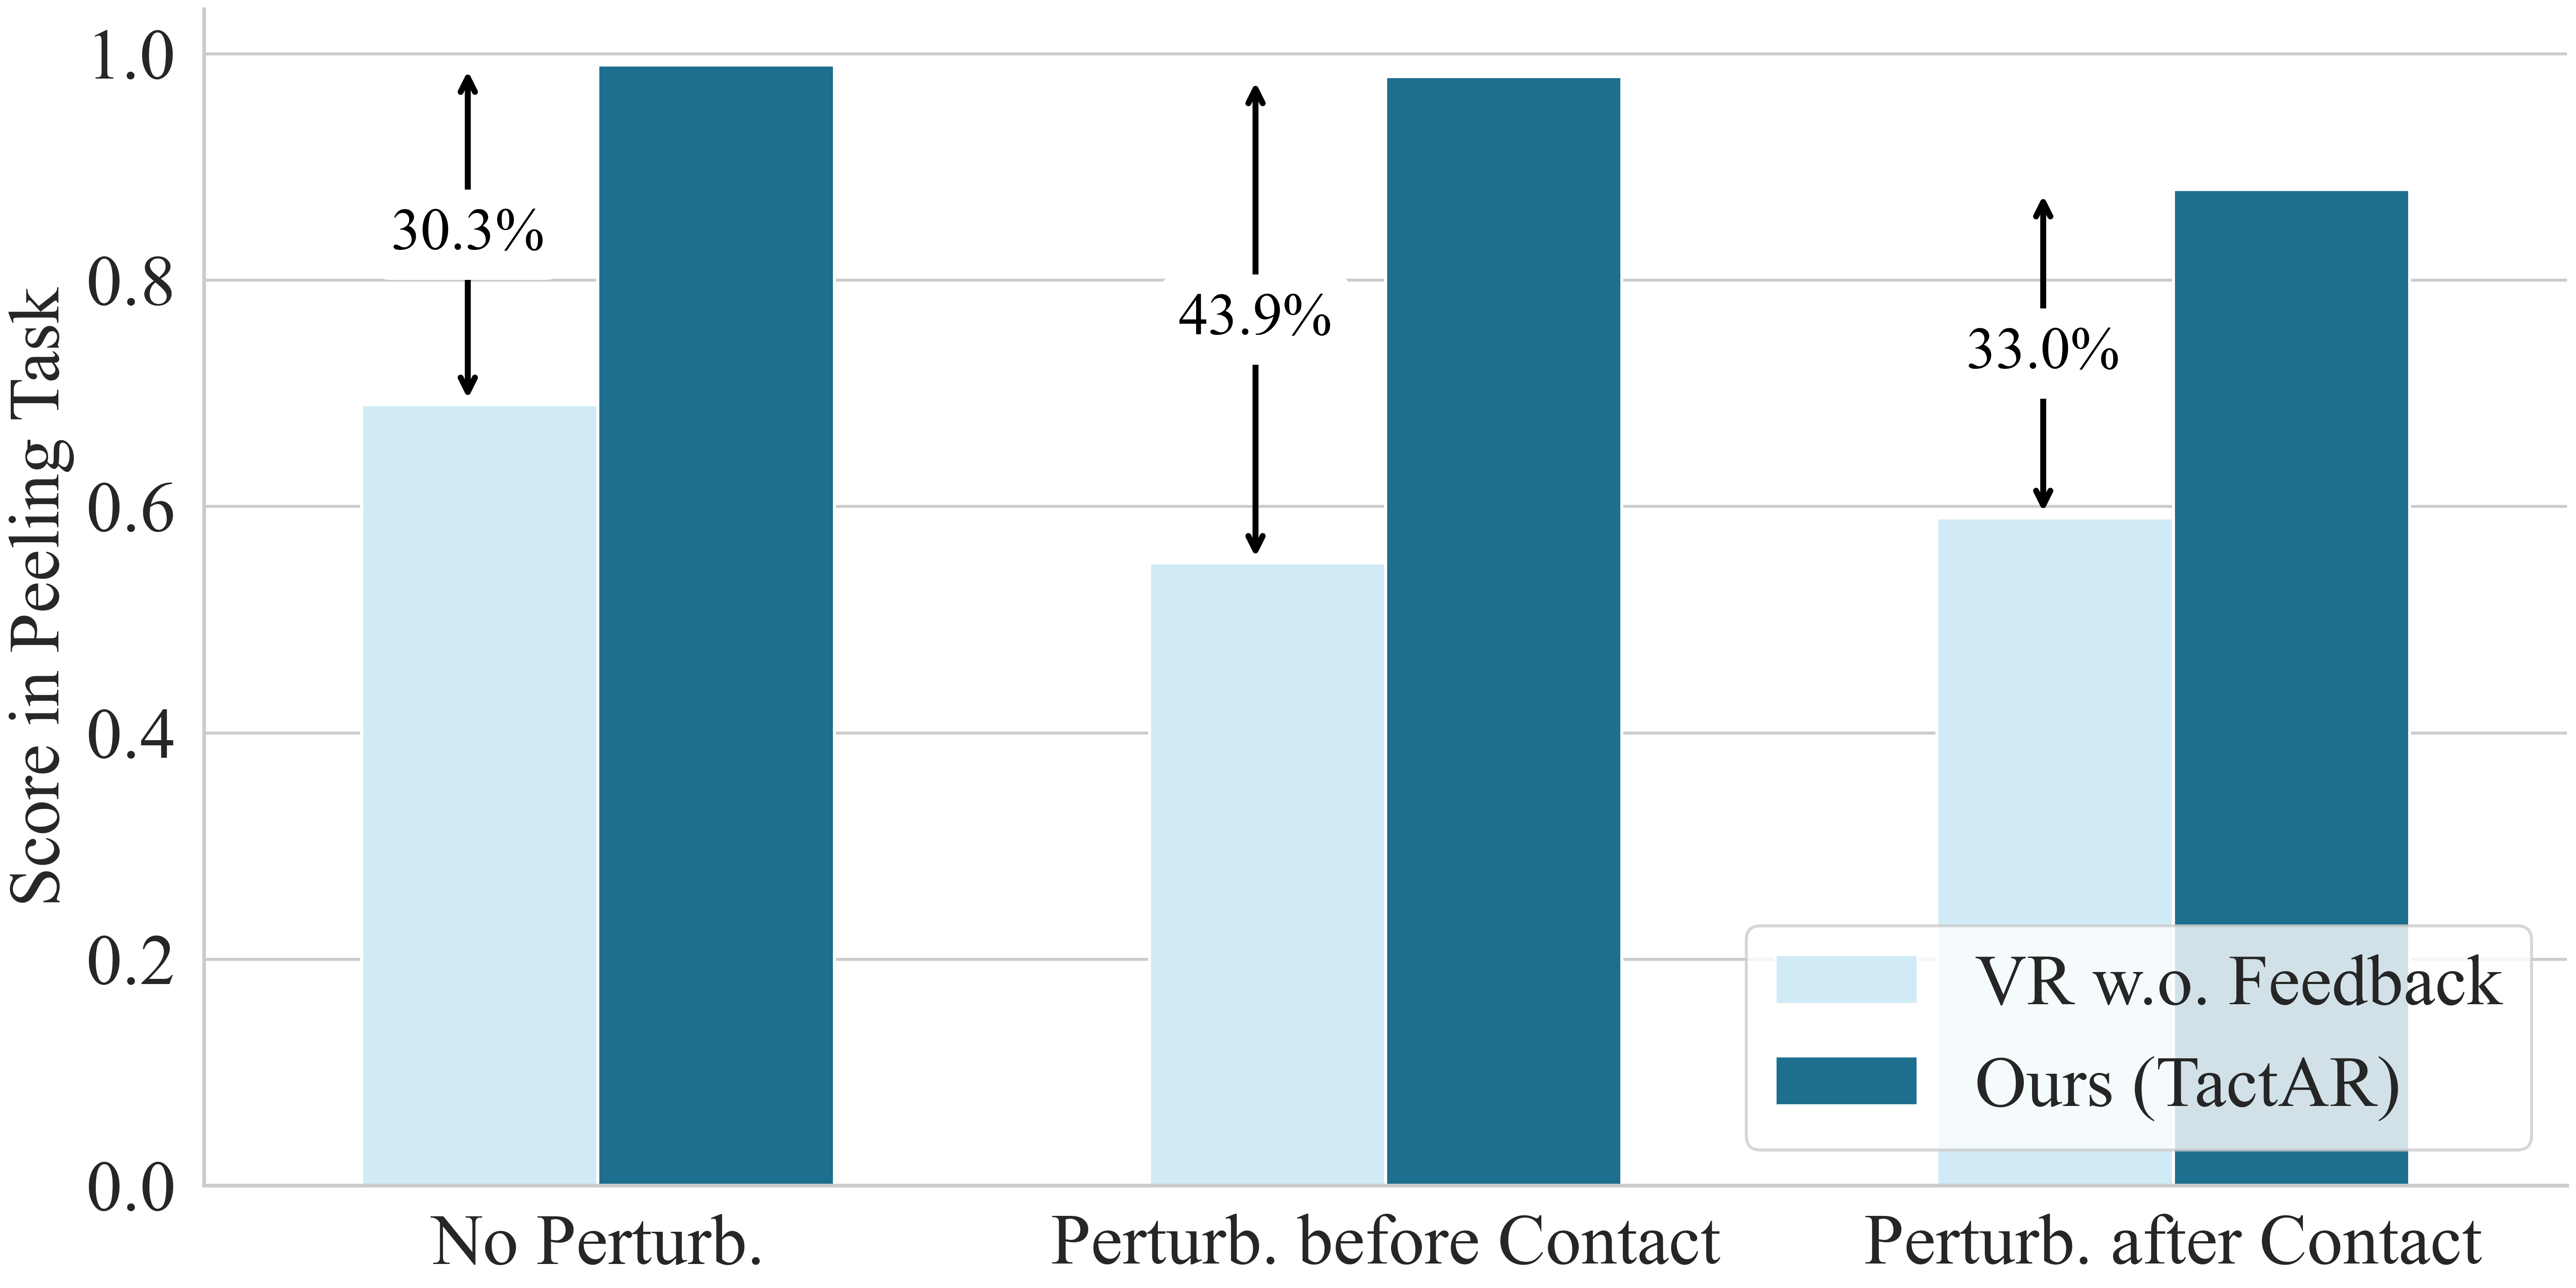
图 14(RDP 原文 Fig. 14)数据质量对 RDP(Force)Peeling 性能的影响:使用无触觉/力反馈的传统 VR 数据训练后,三个测试条件均出现明显下降。
来源:Xue et al., RSS 2025, Fig. 14;项目页提供同源原图。
10. 触觉硬件与 PCA 附录图核对
RDP 还在附录中给出改进版 MCTac、PCA 重建和 PCA 主成分解释。这些图不是装饰信息,而是支撑“跨传感器 + 低维触觉表示”论点的重要证据。
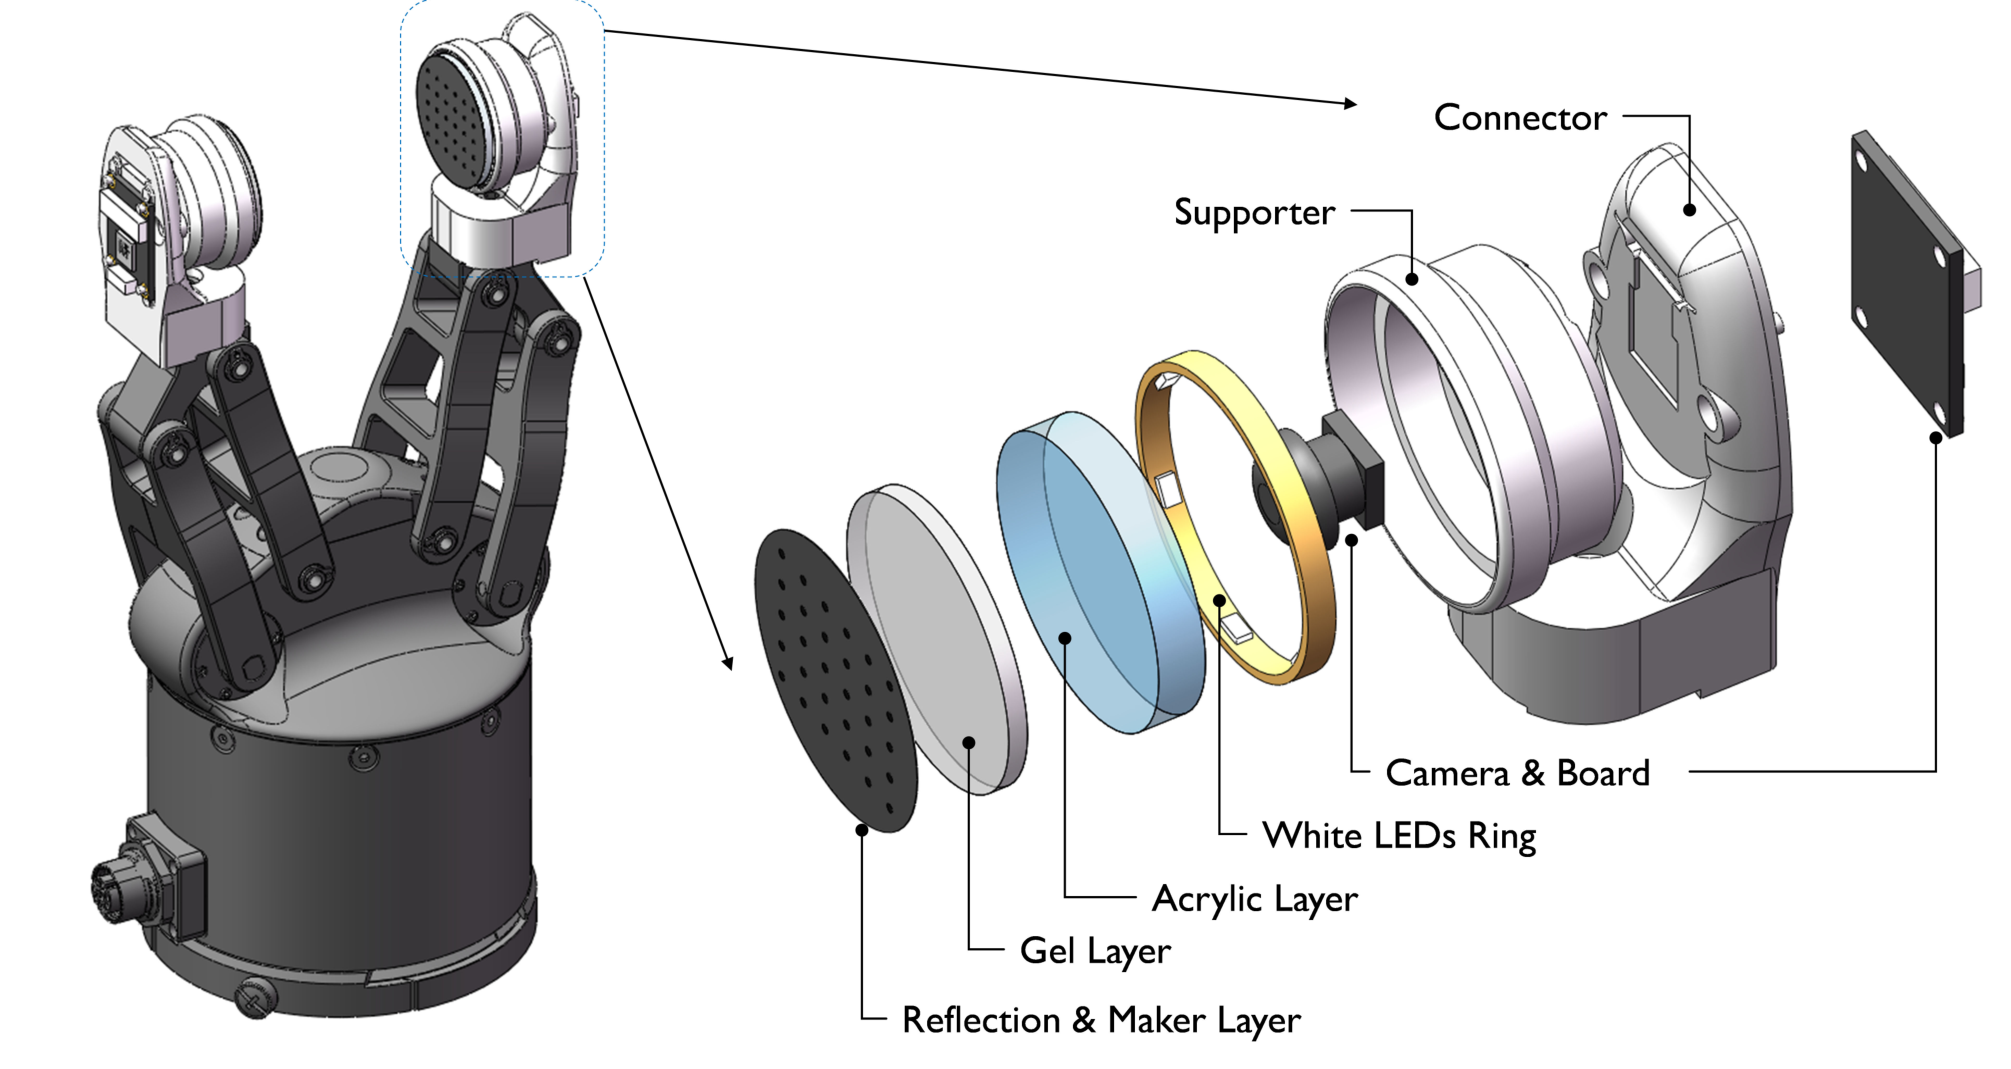
图 15(RDP 原文 Fig. 15)改进版 MCTac 的结构设计与在夹爪上的安装方式。
来源:Xue et al., RSS 2025, Fig. 15。
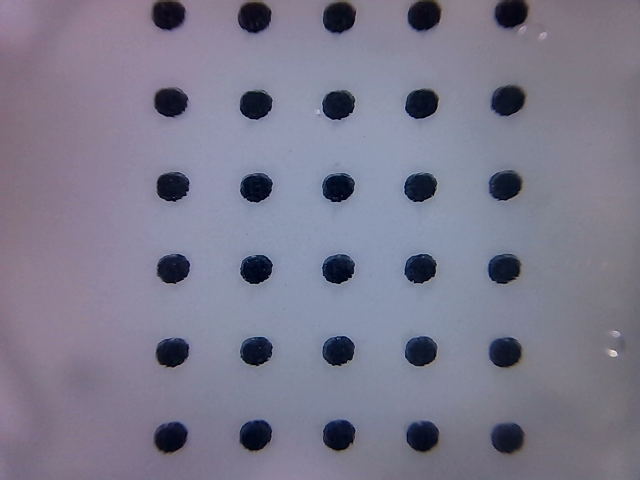
图 16(RDP 原文 Fig. 16)改进 MCTac 的 marker 图像。
来源:Xue et al., RSS 2025, Fig. 16。
**原文内部细节提示:**正文 V-B 在比较 GelSight 与 MCTac 时写到 marker array 为 7 × 9 7\times9 7×9 与 5 × 7 5\times7 5×7;附录硬件描述则写到激光加工得到 5 × 6 5\times6 5×6 marker array,且 Fig. 16 的可见排列也更接近 5 × 6 5\times6 5×6。这是论文文本中的细节不一致,本文不擅自替作者改成唯一答案;复现实验时应以实际传感器配置与开源代码为准。
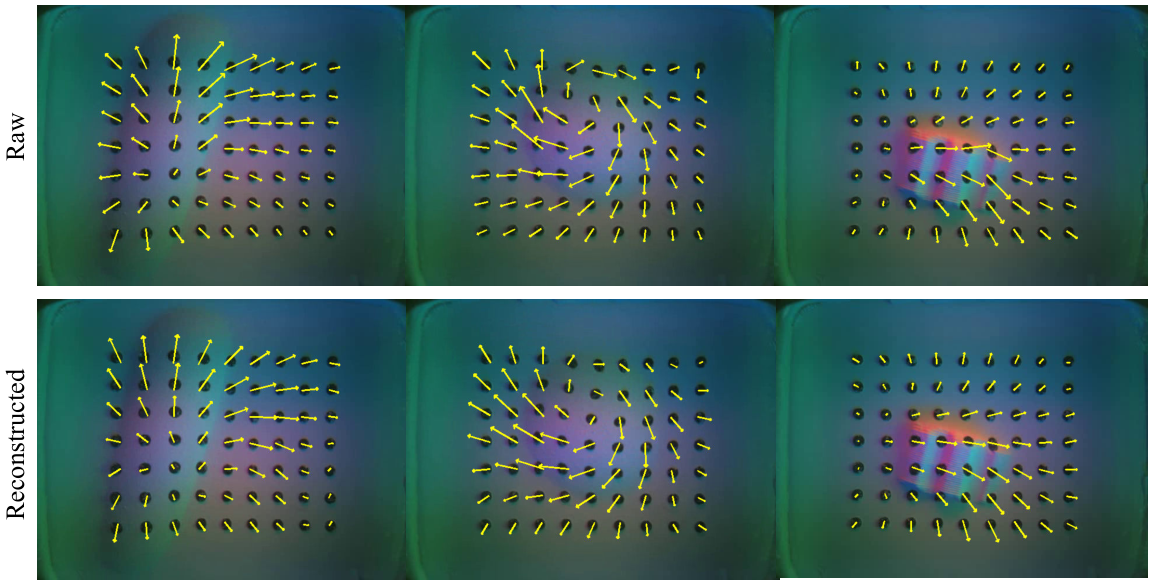
图 17(RDP 原文 Fig. 17)PCA 低维触觉表示对 marker deformation field 的重建效果。
来源:Xue et al., RSS 2025, Fig. 17。
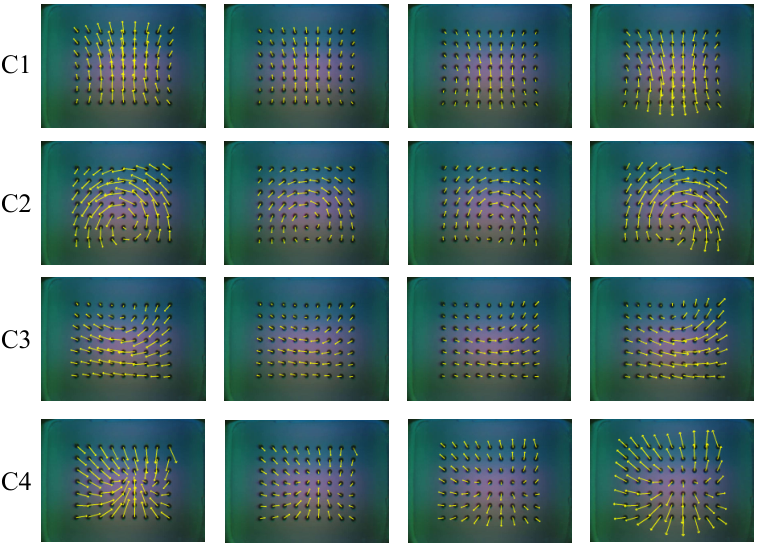
图 18(RDP 原文 Fig. 18)前四个 PCA 主成分的物理模式:不同分量分别对应主要的切向、扭转与法向变形趋势。
来源:Xue et al., RSS 2025, Fig. 18。
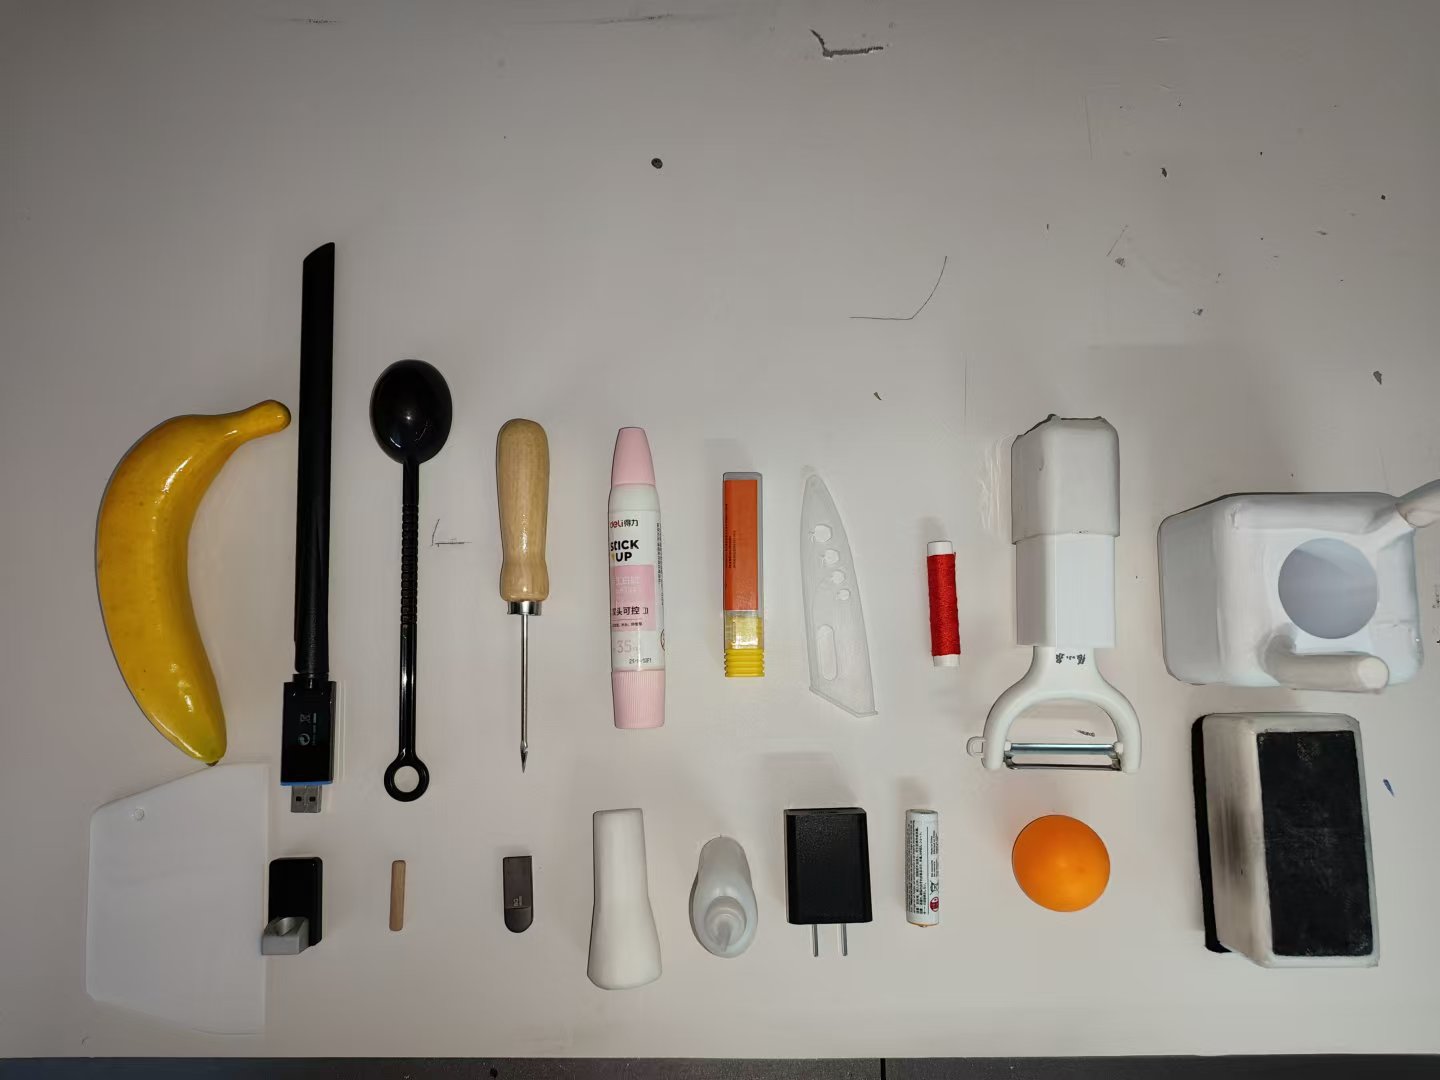
图 19(RDP 原文 Fig. 19)用于构建 PCA 触觉表示的数据采集物体集合。
来源:Xue et al., RSS 2025, Fig. 19。
表 VII(RDP 原文 Table VII)RDP 与 DP 的主要超参数
| 模块 | 参数 | 取值 |
|---|---|---|
| AT | prediction horizon | 32 @ 24 Hz |
| AT | downsample ratio | 4 |
| AT | hidden dim. | 32 |
| AT | latent action dim. | 4(Peeling),8(Wiping & Lifting) |
| AT | training epoch | 600 |
| AT | max learning rate | 10 − 3 10^{-3} 10−3 |
| AT | weight decay | 10 − 4 10^{-4} 10−4 |
| AT | KL penalty multiplier | 10 − 6 10^{-6} 10−6 |
| LDP | observation horizon | 2 @ 12 Hz |
| LDP | proprioception | relative(Peeling/Wiping),absolute(Lifting) |
| LDP | image resolution | 240 × 320 240\times320 240×320 |
| LDP | 1D U-Net kernel | 3 |
| LDP | hidden dims | 512, 1024, 2048 |
| LDP | training epoch | 400 |
| LDP | max learning rate | 10 − 4 10^{-4} 10−4 |
| LDP | weight decay | 10 − 6 10^{-6} 10−6 |
| LDP | diffusion iterations | train 100 / inference 8 |
| DP | prediction horizon | 16 @ 12 Hz |
| DP | proprioception | absolute |
| DP | 1D U-Net kernel | 5 |
| DP | training epoch | 600 |
11. RSS 2025 RDP 的主要创新与学术贡献
11.1 从“观测级融合”推进到“动作级闭环”
此前很多视觉—触觉模仿学习方法解决的是“策略能不能看到 tactile”,RDP 进一步追问“tactile 能不能在一个动作块尚未执行完时改变动作”。这一区别决定了触觉究竟只是状态补充,还是一个真正参与闭环控制的反馈信号。
11.2 以显式频率分工化解 action chunking 的结构矛盾
RDP 没有放弃 Action Chunking,也没有简单把 chunk 缩短,而是把宏观序列一致性和局部快速反馈拆给 LDP 与 AT。慢策略保留 Diffusion Policy 对多模态、非马尔可夫轨迹的建模能力,快策略承担接触阶段的局部反应。
11.3 Asymmetric Tokenizer 把“意图”和“反应”分开编码
AT 的结构性价值在于 latent 的语义约束:encoder 不看到 tactile,迫使 latent 表示高层动作;decoder 才结合实时 tactile/force 完成细节恢复。这比简单多模态 concat 更容易形成可解释的职责分解。
11.4 TactAR 把数据采集质量纳入算法闭环
论文没有把演示数据视为固定输入,而是证明“触觉反馈更好的示范 → 更稳定的接触力 → 快策略更容易学到力—动作对应关系 → 部署性能更高”。这一点使论文形成从数据采集、表示学习到控制执行的完整闭环。
11.5 跨触觉/力传感器验证
GelSight、MCTac 与力/力矩输入均能被同一 slow-fast 框架使用,尤其 GelSight 与 MCTac 的 Peeling 结果接近,说明 PCA deformation representation 对不同光学触觉硬件具有一定可迁移性。
12. RSS 2025 RDP 的局限
RDP 的效果显著,但结构上仍存在明确边界:
- 两阶段训练较复杂。 AT 与 LDP 分别训练,latent dimension、下采样率、chunk horizon 等超参数需要协调;
- 快策略看不到完整视觉几何。 它主要依赖 latent + tactile/force。如果慢策略在自由空间阶段就给出错误语义或精确位置,快策略缺少原始视觉信息去重新规划;
- latent compression 可能损失空间精度。 对极精细插孔或自由空间精确对位,潜在动作压缩会引入误差;
- 快通道当前主要处理 tactile/force。 原论文明确指出尚不能同样快速地处理高频视觉;
- 主要是 single-task 学习。 原文提出未来可将 Asymmetric Tokenizer 与 VLA 结合,但 RSS 2025 本身并不是 VLA;
- TactAR 仍非真实手部触觉。 AR 可视化降低成本,却仍不如直接人手触觉直观,并受传感器/渲染/网络延迟影响。
这些局限正是 RA-L 2026 ImplicitRDP 的出发点。
第二部分:RA-L 2026 ImplicitRDP——从显式两级层次到端到端结构化慢—快学习
以下图号重新严格对应 ImplicitRDP 原论文 Fig. 1–7,不与前面的 RDP Fig. 1–19 混排。
13. 为什么还需要 ImplicitRDP
ImplicitRDP 对 RDP 的评价非常明确:RDP 的 slow-fast 分解有效,但显式两阶段层次结构会带来三个问题。
第一是 Information Bottleneck(信息瓶颈)。RDP 的快策略只接收压缩后的 latent action 和 force/tactile,不能直接访问原始视觉空间信息,因而在精细接触点选择或自由空间定位中可能损失几何精度。
第二是 Modal Conflict / Compounding Error(模态冲突与模块级误差累积)。如果慢策略已做出错误的高层空间判断,快策略即便感知到力,也不一定知道正确目标在何处。
第三是 Rigid Handover(固定模态交接)。RDP 人为规定“视觉慢、力快、先 latent 后解码”,这种硬编码职责虽然可解释,却限制了单一网络自主调整不同模态权重的能力。
因此 ImplicitRDP 的目标是:保留 slow-fast 的时间结构,但去掉 slow network / fast network 的显式网络层级。
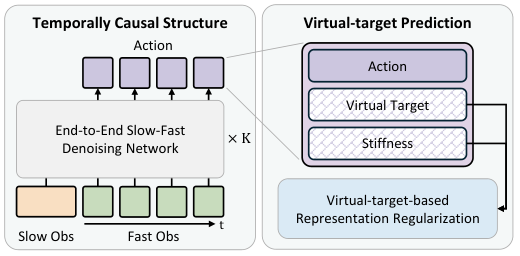
图 1(ImplicitRDP 原文 Fig. 1)ImplicitRDP 的两个核心:Structural Slow-Fast Learning 以时间因果结构实现块内闭环,Virtual-target-based Representation Regularization 通过虚拟目标辅助预测抑制模态塌缩。
来源:Chen et al., IEEE RA-L 2026, Fig. 1。
14. ImplicitRDP 的总体框架
ImplicitRDP 使用统一 Transformer Diffusion Policy,同时接收:
- 慢观测:视觉 I t \mathcal I_t It、proprioception P t \mathcal P_t Pt;
- 快观测:动作时刻对齐的 Force sequence F t \mathbf F_t Ft;
- noisy action token;
- diffusion timestep k k k。
视觉由 ResNet-18 编码,本体状态与 diffusion step 由 MLP 编码,力序列由 GRU 编码;随后在 Transformer Decoder 中通过 **Causal Cross Attention(因果交叉注意力)**完成融合。
图 2(ImplicitRDP 原文 Fig. 2)ImplicitRDP 网络结构:慢视觉/本体 token、快力 token 和 noisy action token 在 Transformer 中通过因果交叉注意力统一建模。
来源:Chen et al., IEEE RA-L 2026, Fig. 2;项目主页提供同源原图。
15. Structural Slow-Fast Learning(SSL)
15.1 关键不是“两张网络”,而是“谁可以看到哪个时间的信号”
标准 Diffusion Policy 在时刻 t t t 根据观测窗口 O t \mathbf O_t Ot 预测一个动作序列:
A t = { a t − h o + 1 , … , a t − h o + h a } . \mathbf A_t=\{a_{t-h_o+1},\ldots,a_{t-h_o+h_a}\}. At={at−ho+1,…,at−ho+ha}.
前向加噪为:
A t k = α ˉ k A t 0 + 1 − α ˉ k ϵ k , \mathbf A_t^k=\sqrt{\bar\alpha_k}\mathbf A_t^0+\sqrt{1-\bar\alpha_k}\epsilon^k, Atk=αˉkAt0+1−αˉkϵk,
标准噪声预测损失为:
L ϵ = E [ ∥ ϵ k − ϵ θ ( O t , A t k , k ) ∥ 2 ] . \mathcal L_\epsilon=\mathbb E\left[\|\epsilon^k-\epsilon_\theta(\mathbf O_t,\mathbf A_t^k,k)\|^2\right]. Lϵ=E[∥ϵk−ϵθ(Ot,Atk,k)∥2].
问题在于普通 action chunking 执行一个 chunk 时,后来到达的新力信号不能直接影响已经生成的后续动作。
SSL 的做法是把力信号也变成按时间排列的 token,并设置因果 mask:相对时刻为 s s s 的 action token,只允许关注到“不晚于 s s s”的 force token,不能偷看未来力信息。这样训练时可以并行使用记录好的整段 force sequence,同时仍满足部署时的因果性。
可以将 mask 理解为:
M s , j = { 0 , j ≤ s , − ∞ , j > s . M_{s,j}=\begin{cases} 0,&j\le s,\\ -\infty,&j>s. \end{cases} Ms,j={0,−∞,j≤s,j>s.
因此,网络虽然是单一 Transformer,但从时序结构上已经具有“慢上下文 + 快反馈”的控制能力。
15.2 Consistent Inference:为什么要缓存同一份初始噪声
若每个快控制步都重新从随机高斯噪声开始采样 Diffusion Policy,即使观测只发生微小变化,输出动作序列也可能因为随机噪声改变而不连续。ImplicitRDP 因此使用 DDIM, η = 0 \eta=0 η=0 的确定性采样,并在每个 chunk 开始时只采样一次初始噪声。
慢循环开始:
Z s l o w = E s l o w ( O s l o w ) , A K ∼ N ( 0 , I ) . \mathbf Z_{slow}=\mathcal E_{slow}(\mathbf O_{slow}),\qquad \mathbf A^K\sim\mathcal N(0,I). Zslow=Eslow(Oslow),AK∼N(0,I).
随后快循环第 i i i 步仅更新新的 force context,并取同一噪声序列的前缀:
A t K = A K [ : i + h o + l ] . \mathbf A_t^K=\mathbf A^K[:i+h_o+l]. AtK=AK[:i+ho+l].
再用同一份 cached slow token 与 initial noise 做 DDIM:
A ^ t 0 = DDIM ( π θ , Z s l o w , Z f a s t , A t K , η = 0 ) , \hat{\mathbf A}_t^0= \operatorname{DDIM}(\pi_\theta,\mathbf Z_{slow},\mathbf Z_{fast},\mathbf A_t^K,\eta=0), A^t0=DDIM(πθ,Zslow,Zfast,AtK,η=0),
最后执行当前预测序列的最后一个动作:
a t = A ^ t 0 [ − 1 ] . a_t=\hat{\mathbf A}_t^0[-1]. at=A^t0[−1].
这样,快循环每次确实利用了最新 force,但生成轨迹仍来自同一个确定性扩散“母序列”,避免了频繁重采样造成的动作跳变。
16. Virtual-target-based Representation Regularization(VRR)
16.1 为什么端到端多模态网络会发生 Modality Collapse
把视觉、force 一股脑送进同一个 Transformer,并不意味着网络一定会合理利用两种模态。因为视觉往往已经可以解释大量轨迹变化,网络可能在训练中形成捷径,长期依赖某一种模态,导致接触后无法及时提高对 force token 的权重。这就是论文所说的 Modality Collapse(模态塌缩)。
直接加一个“预测未来 force”的 auxiliary loss 有帮助,但 force 在 TCP 传感器坐标系中,和 world-frame Cartesian action 的语义并不统一;而且自由空间中的小 force 大量来自噪声,如果一视同仁地回归,会浪费模型容量。
16.2 从柔顺控制推导 Virtual Target
经典弹簧—质量—阻尼形式为:
f e x t = M x ¨ v t + D x ˙ v t + K ( x v t − x r e a l ) . f_{ext}=M\ddot x_{vt}+D\dot x_{vt}+K(x_{vt}-x_{real}). fext=Mx¨vt+Dx˙vt+K(xvt−xreal).
对准静态接触,忽略惯性与阻尼项:
x v t = x r e a l + K − 1 f e x t . x_{vt}=x_{real}+K^{-1}f_{ext}. xvt=xreal+K−1fext.
x v t x_{vt} xvt 可以理解为:如果系统具有刚度 K K K,为了产生当前外力,虚拟命令目标应该位于哪里。它把“力”转成了和 Cartesian action 同一个空间中的“位置偏移语义”。
16.3 自适应刚度相当于自动调整 force 信息的重要性
沿外力方向定义:
k a d p = { k m a x , ∥ f e x t ∥ < f m i n , k m a x − k m a x − k m i n f m a x − f m i n ( ∥ f e x t ∥ − f m i n ) , f m i n ≤ ∥ f e x t ∥ ≤ f m a x , k m i n , ∥ f e x t ∥ > f m a x . k_{adp}=\begin{cases} k_{max}, & \|f_{ext}\|<f_{min},\\ k_{max}-\dfrac{k_{max}-k_{min}}{f_{max}-f_{min}} (\|f_{ext}\|-f_{min}), & f_{min}\le\|f_{ext}\|\le f_{max},\\ k_{min}, & \|f_{ext}\|>f_{max}. \end{cases} kadp=⎩ ⎨ ⎧kmax,kmax−fmax−fminkmax−kmin(∥fext∥−fmin),kmin,∥fext∥<fmin,fmin≤∥fext∥≤fmax,∥fext∥>fmax.
自由空间时 ∥ f ∥ \|f\| ∥f∥ 很小, K K K 很大,因而:
Δ x = x v t − x r e a l = K − 1 f e x t ≈ 0 , \Delta x=x_{vt}-x_{real}=K^{-1}f_{ext}\approx0, Δx=xvt−xreal=K−1fext≈0,
网络会自然忽略小幅 force 噪声。进入接触后, K K K 降低,同样的 force 会产生更明显的 Δ x \Delta x Δx,高强度接触事件因此在辅助目标中获得更高“表示权重”。
最终增强动作向量为:
a a u g , t = concat ( [ a t , x v t , k a d p ] ) . a_{aug,t}=\operatorname{concat}([a_t,x_{vt},k_{adp}]). aaug,t=concat([at,xvt,kadp]).
训练时扩散模型共同预测动作、virtual target 与 adaptive stiffness;部署时只保留真实动作 a ^ t \hat a_t a^t,辅助维度被丢弃。因此 VRR 是表示正则化,不是部署时额外串联一个柔顺控制器。
17. 学习稳定性:v-prediction、Euler angle 与底层控制
Force signal 高频且含噪,Transformer Diffusion Policy 容易过拟合噪声并产生 action jitter。论文采用 **velocity prediction(v-prediction)**替代标准 ϵ \epsilon ϵ-prediction:
v t k = α ˉ k ϵ − 1 − α ˉ k A t 0 , \mathbf v_t^k=\sqrt{\bar\alpha_k}\epsilon- \sqrt{1-\bar\alpha_k}\mathbf A_t^0, vtk=αˉkϵ−1−αˉkAt0,
对应损失:
L v = E [ ∥ v t k − v θ ( O t , A t k , k ) ∥ 2 ] . \mathcal L_v= \mathbb E\left[ \|\mathbf v_t^k-\mathbf v_\theta(\mathbf O_t,\mathbf A_t^k,k)\|^2 \right]. Lv=E[∥vtk−vθ(Ot,Atk,k)∥2].
旋转表示方面,作者选择 Euler angles,而不是 6D rotation 或 quaternion。论文认为,在其相对动作设置下,Euler 三个分量更独立,有利于回归稳定;同时作者认为相对动作使实际运动范围远离欧拉角不连续与 gimbal lock 区域。这个结论是该实验设置下的经验结果,不应推广成“Euler 总是优于 6D rotation”。
硬件上,作者设计了 compliant fingertip,使刚性环境接触时产生更明显、更容易学习的力—位移变化;底层 Cartesian impedance controller 则提高 PI 中的 integral gain( k i : 0 → 10 k_i:0\rightarrow10 ki:0→10),保持默认 proportional gain,使机器人在该设置下达到约 0.1 m m 0.1\,\mathrm{mm} 0.1mm 的位置跟踪精度。这里的逻辑是:学习策略负责反应性,低层控制器尽量忠实执行策略给出的微小位置调整。
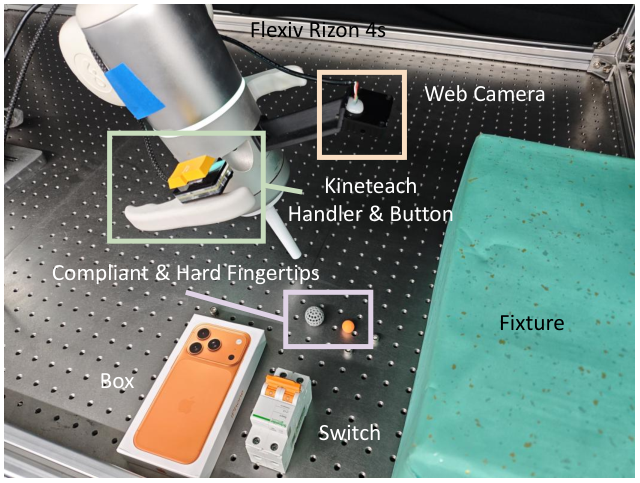
图 3(ImplicitRDP 原文 Fig. 3)实验硬件:Flexiv Rizon 4s、6 轴 F/T、kinesthetic teaching handle/button、腕部相机与自定义 compliant fingertip。
来源:Chen et al., IEEE RA-L 2026, Fig. 3。
18. ImplicitRDP 实验设计与结果
18.1 执行频率与参数
相机与策略所用 force/torque stream 都以 10 Hz 记录;内部 F/T 延迟低于 20 ms,ROS2 多传感器同步延迟低于 120 ms。部署时快闭环为 10 Hz,慢循环每 0.6 s 刷新一次。在 RTX 4090 上,每个快循环的推理耗时低于 30 ms,小于 100 ms 控制预算。
VRR 统一采用:
f m i n = 0.5 N , f m a x = 5 N , f_{min}=0.5\,\mathrm N,\qquad f_{max}=5\,\mathrm N, fmin=0.5N,fmax=5N,
k m i n = 200 N / m , k m a x = 10000 N / m . k_{min}=200\,\mathrm{N/m},\qquad k_{max}=10000\,\mathrm{N/m}. kmin=200N/m,kmax=10000N/m.
每个任务采集 40 条 demonstration,每个报告的成功率来自 20 次二值成功/失败测试。
18.2 三个任务
Box Flipping 要求持续施加适当推力把薄盒翻起;示范约为 8 N,测试中超过 14 N 即判失败,避免“暴力推过去”。
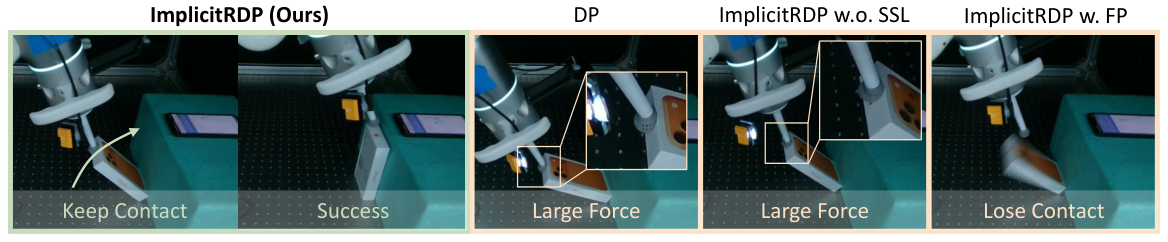
图 4(ImplicitRDP 原文 Fig. 4)Box Flipping:DP 或去除 SSL 的模型容易施加过大力,ImplicitRDP 能维持接触并完成翻转。
来源:Chen et al., IEEE RA-L 2026, Fig. 4。
Switch Toggling 要求达到足够触发力后再拨动开关。视觉几乎看不出“力阈值是否已达到”,因此对 force 闭环非常敏感。
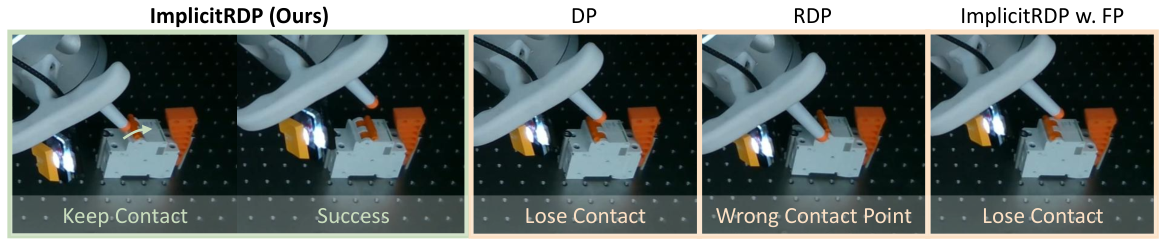
图 5(ImplicitRDP 原文 Fig. 5)Switch Toggling:DP 易过早拨动,RDP 可能因 latent 压缩出现错误接触点,ImplicitRDP 同时利用视觉位置和 force 阈值完成动作。
来源:Chen et al., IEEE RA-L 2026, Fig. 5。
Hole Inserting 只有约 1 mm 裕量,要求发生错误接触后利用 force 继续沿表面修正位置,是最典型的 contact-guided correction。
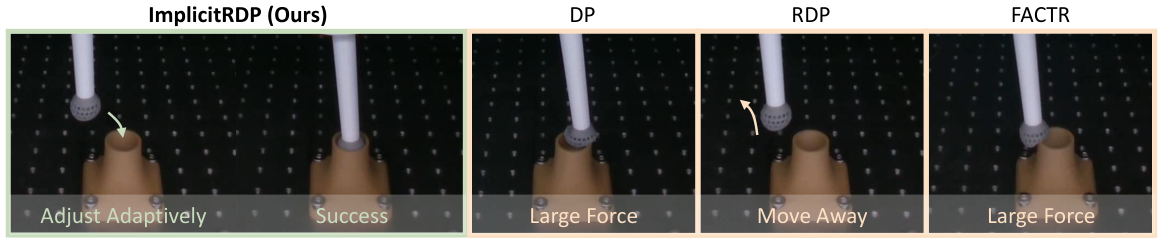
图 6(ImplicitRDP 原文 Fig. 6)Hole Inserting:ImplicitRDP 可在错误接触后保持接触并逐步调整;DP、RDP 与 FACTR 的典型失败分别表现为大力、漂离或无法完成接触引导修正。
来源:Chen et al., IEEE RA-L 2026, Fig. 6。
18.3 与 DP、RDP 的直接比较
表 I(ImplicitRDP 原文 Table I)与 baseline 的成功率比较
| 方法 | Box Flipping | Switch Toggling | Hole Inserting |
|---|---|---|---|
| DP | 0/20 | 8/20 | 0/20 |
| RDP | 16/20 | 10/20 | 5/20 |
| ImplicitRDP | 18/20 | 18/20 | 8/20 |
RDP 在 Box Flipping 上已经很强,说明显式 fast force controller 对持续接触确实有效;但在 Switch Toggling 与 Hole Inserting 中,其 latent action compression 和快策略缺乏原始视觉上下文的问题更加明显。ImplicitRDP 直接在原始 action space 中端到端 denoise,并允许 action token 同时访问视觉与 force,因此在“自由空间定位 + 接触后微调”混合任务上更占优势。
Hole Inserting 的 8/20 也说明问题尚未被完全解决:即便 ImplicitRDP 明显领先 baseline,1 mm 裕量的接触引导装配仍然是困难任务。
18.4 SSL 是否真的提供闭环价值
表 II(ImplicitRDP 原文 Table II)Open-loop 与 Closed-loop 比较
| 方法 | Box Flipping | Switch Toggling |
|---|---|---|
| w/o SSL and VRR | 6/20 | 5/20 |
| w/o SSL | 4/20 | 15/20 |
| ImplicitRDP | 18/20 | 18/20 |
即便重新加入 VRR,如果没有 SSL,Box Flipping 仍只有 4/20。原因是持续推力任务要求每个动作时刻根据力变化立即修正,辅助损失本身不能代替闭环执行结构。
18.5 VRR 为什么比直接 Force Prediction 有效
表 III(ImplicitRDP 原文 Table III)不同辅助任务比较
| Auxiliary task | Box Flipping | Switch Toggling |
|---|---|---|
| None | 6/20 | 6/20 |
| Force Prediction | 8/20 | 10/20 |
| Virtual Target Prediction | 18/20 | 18/20 |
VRR 的提升不仅来自“多一个监督目标”,而是因为它同时提供:
- 坐标/任务对齐:virtual target 与 Cartesian action 在同一表示空间;
- 自适应重要性加权:自由空间 force 噪声被高刚度压低,接触阶段的真实 force 被低刚度放大。
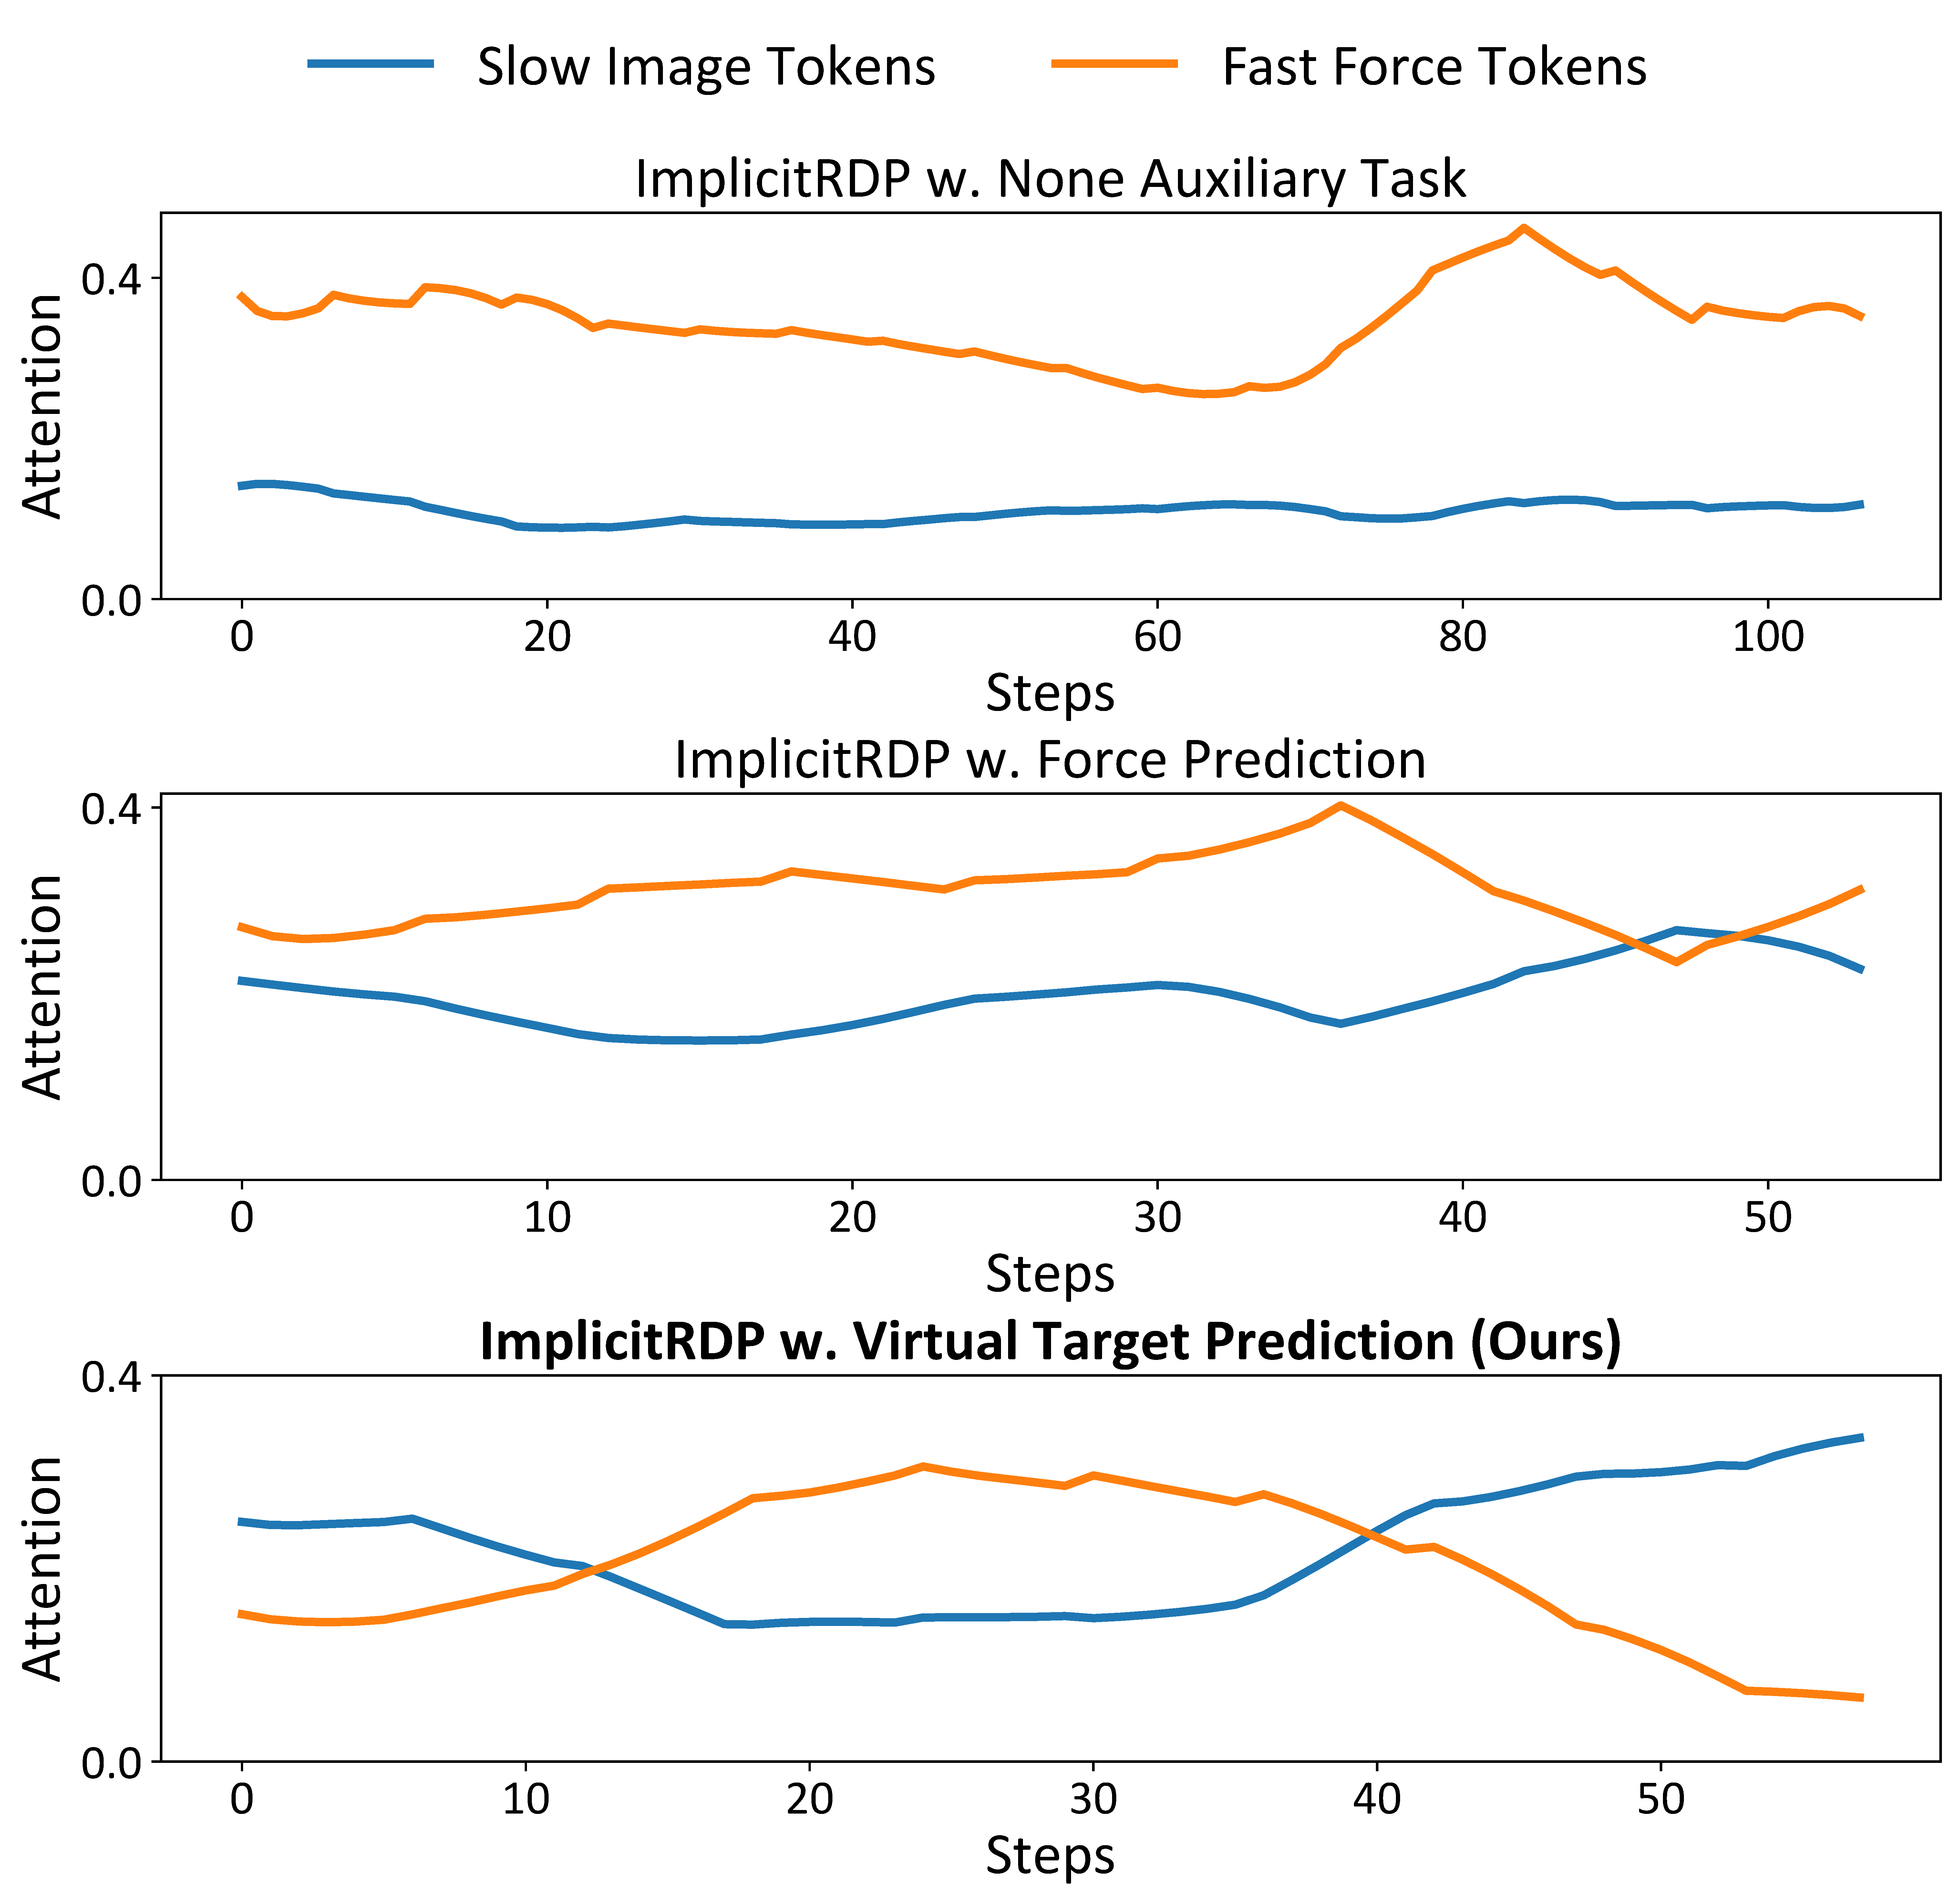
图 7(ImplicitRDP 原文 Fig. 7)Switch Toggling 中第一层 Transformer 的模态注意力可视化:Virtual Target Prediction 使视觉与 force token 权重随任务阶段明显重分配,说明 VRR 有助于抑制模态塌缩。
来源:Chen et al., IEEE RA-L 2026, Fig. 7;项目主页提供同源原图。
18.6 学习稳定性消融
表 IV(ImplicitRDP 原文 Table IV)Diffusion parameterization 与旋转表示消融
| 方法 | Box Flipping | Switch Toggling |
|---|---|---|
| ϵ \epsilon ϵ-prediction | 9/20 | 18/20 |
| sample-prediction | 7/20 | 14/20 |
| 6D Rotation | 16/20 | 12/20 |
| ImplicitRDP(v-prediction + Euler) | 18/20 | 18/20 |
这组实验表明,接触丰富任务的成败不仅取决于高层网络结构,还依赖扩散参数化、旋转表示、传感器噪声与底层位置跟踪精度等“系统级”因素。
19. 从 RDP 到 ImplicitRDP:算法演进关系
表 8 RDP 与 ImplicitRDP 的核心差异
| 维度 | RDP(RSS 2025) | ImplicitRDP(RA-L 2026) |
|---|---|---|
| 基本结构 | 显式两级 Slow Policy + Fast Policy | 单个端到端 Transformer Diffusion Policy |
| Slow 信息 | 视觉、触觉/力、本体状态 | 视觉、本体状态等 slow tokens |
| Fast 信息 | tactile/force → AT decoder | force tokens 直接进入统一 Transformer |
| 慢—快实现方式 | 网络层级分工 | 因果注意力的时序结构分工 |
| 动作生成空间 | LDP 在 latent action space 扩散,再由 AT 解码 | 直接在原始/增强 action space 端到端扩散 |
| 块内闭环 | AT 高频自回归解码 | Causal force tokens + consistent DDIM inference |
| 避免模态塌缩 | 通过显式 hierarchy 强制职责 | VRR 辅助预测主动调整模态权重 |
| 优点 | 模块职责清晰、快策略极快、触觉适配性强 | 无 latent 信息瓶颈、端到端训练、几何与力统一融合 |
| 主要代价 | 两阶段训练、fast policy 缺少原始视觉 | 单网络训练更易受多模态噪声/塌缩影响,需要 VRR 与稳定性技巧 |
最简洁的理解是:
RDP:显式 Slow-Fast Hierarchy ⟹ ImplicitRDP:隐式 Slow-Fast Temporal Structure \boxed{\text{RDP:显式 Slow-Fast Hierarchy}} \quad\Longrightarrow\quad \boxed{\text{ImplicitRDP:隐式 Slow-Fast Temporal Structure}} RDP:显式 Slow-Fast Hierarchy⟹ImplicitRDP:隐式 Slow-Fast Temporal Structure
RDP 把视觉与触觉的职责“写进了两个网络”;ImplicitRDP 则把这种职责“写进了时间因果关系和训练目标”,让一个网络自行学习什么时候应该主要看视觉、什么时候应该主要看力。
20. 与 Diffusion Policy、阻抗/柔顺控制的关系
20.1 它仍然是 Diffusion Policy,不是传统力控制器
RDP/ImplicitRDP 的最终动作都来自学习策略。触觉/力反馈改变的是策略的动作生成,而不是直接把 f e x t f_{ext} fext 代入一个固定控制律求出最终关节力矩。因此不能把 RDP 简化为“Diffusion Policy + impedance controller”。
RDP 的快策略在功能上类似可学习的局部阻抗修正器;ImplicitRDP 的 Virtual Target 又借用了 compliance control 的物理概念,但 VRR 只是训练辅助目标。真正部署时,策略仍输出 Cartesian action,由低层机器人控制器执行。
20.2 为什么不能只把力作为额外 observation
标准 DP 的形式可以写为:
A ^ t : t + H ∼ p θ ( A ∣ I t , q t , f t ) . \hat{\mathbf A}_{t:t+H} \sim p_\theta(\mathbf A\mid I_t,q_t,f_t). A^t:t+H∼pθ(A∣It,qt,ft).
即使条件里有 f t f_t ft,只要该动作块随后开环执行, f t + 1 , f t + 2 f_{t+1},f_{t+2} ft+1,ft+2 到来时都不能改变已生成的 chunk。因此“多模态输入”和“多模态闭环控制”是两个不同问题。
20.3 RDP 的思想与经典分层控制很相似
从控制角度看,RDP 可以类比为:
低频规划/参考生成 → 高频反馈修正 → 底层执行器控制 . \text{低频规划/参考生成} \rightarrow \text{高频反馈修正} \rightarrow \text{底层执行器控制}. 低频规划/参考生成→高频反馈修正→底层执行器控制.
区别在于,上层参考生成和中层反馈修正都通过示范学习得到,而不是传统的解析模型 + 手工增益。
21. 与 VLA 的关系:RDP 本身不是 VLA,但其结构非常适合补足 VLA 的“慢”
RSS 2025 原文已明确把与 Vision-Language-Action(VLA) 的结合列为未来方向:可以将 VLA 中的 action tokenizer 替换/扩展为类似 RDP 的 asymmetric tokenizer,使大模型负责低频语义规划和复杂动作分布,触觉/力通道负责高频闭环。
其潜在结构可以概括为:
Language + Vision → VLA / Slow semantic policy high-level action tokens → fast tactile/force adaptation reactive robot action . \text{Language + Vision} \xrightarrow{\text{VLA / Slow semantic policy}} \text{high-level action tokens} \xrightarrow{\text{fast tactile/force adaptation}} \text{reactive robot action}. Language + VisionVLA / Slow semantic policyhigh-level action tokensfast tactile/force adaptationreactive robot action.
RA-L 2026 的 ImplicitRDP 又进一步证明,slow-fast 不一定非要拆成两个独立网络,而可以在统一 Transformer 中通过 causal token structure 实现。论文结论同样将扩展到 VLA 和更高频 F/T、tactile sensing 作为未来方向。
因此,从技术演进上看,RDP/ImplicitRDP 对 VLA 的价值不是“让 Diffusion Policy 变成 VLA”,而是提供一种很清晰的接口:让低频大模型负责语义与全局空间上下文,让高频物理反馈真正进入闭环动作生成。
22. 论文最值得记住的五个结论
- 接触任务的关键问题不是有没有 tactile,而是 tactile 能不能在 action chunk 内实时改变动作。普通 DP 加触觉仍可能因为开环 chunk 而表现不佳。
- RDP用显式 Slow-Fast 分层拆掉“轨迹一致性 vs. 高频闭环”的矛盾。LDP 负责复杂、多模态、非马尔可夫轨迹,AT 负责触觉反应。
- 示范数据中的力稳定性本身决定策略能学到什么。TactAR 不是配套 UI,而是整个方法的重要组成部分。
- ImplicitRDP 的核心不是“再换一个 Transformer”,而是把 Slow-Fast 从网络层级改写成因果时间结构,并用 consistent DDIM 保证块内多次推理的一致性。
- VRR 解决的是端到端多模态策略的模态塌缩。Virtual Target 将 force 映射到 action-aligned Cartesian representation,再利用 adaptive stiffness 自动突出真正重要的接触阶段。
23. 对机器人接触操作研究的启示
这两篇工作的价值并不局限于削皮、擦拭或插孔。它们给出了一个可推广的系统设计原则:**不同模态不必以相同频率、相同网络路径、相同监督权重参与控制。**视觉、语言、触觉、力、本体感知所承担的物理角色不同,策略结构也应承认这种异步性。
对于更一般的机器人操作,可将任务拆成三层时间尺度:语义/任务层负责秒级甚至更慢的目标与阶段判断;视觉动作策略负责数百毫秒级的轨迹生成;触觉/力通道负责几十毫秒级的接触修正。RDP 用显式层次实现这一思想,ImplicitRDP 则证明同样的结构可以“隐式”编码进统一生成模型。
这也是两篇论文相对于“直接把所有传感器 concat 后送入大模型”的更重要贡献:多模态融合不是输入拼接问题,而是信息频率、因果关系、反馈闭环和表示空间如何共同设计的问题。
24. 局限与后续研究方向
RDP 与 ImplicitRDP 仍留下若干开放问题。首先,目前实验规模仍是少量单任务 real-world demonstrations,尚未证明大规模多任务泛化;其次,ImplicitRDP 的 fast loop 在实验中为 10 Hz,距离工业级高带宽力控制仍有差距;再次,强接触任务仍高度依赖力传感器、柔顺末端以及高精度底层位置控制,学习策略并没有消除硬件设计的重要性。
更值得继续研究的方向包括:VLA + 高频触觉/力闭环、dexterous hand 的高维触觉 token、更高频 F/T sensing、多任务统一 policy,以及把语言/视觉的低频语义 token 与高频物理 token 在同一因果 Transformer 中进行异步更新。ImplicitRDP 已经给出了一个具有可扩展性的基本模板。
25. 参考链接
- Reactive Diffusion Policy,RSS 2025 Proceedings:https://www.roboticsproceedings.org/rss21/p052.html
- Reactive Diffusion Policy,arXiv:https://arxiv.org/abs/2503.02881
- Reactive Diffusion Policy,Project:https://reactive-diffusion-policy.github.io/
- Reactive Diffusion Policy,Code:https://github.com/xiaoxiaoxh/reactive_diffusion_policy
- TactAR APP:https://github.com/xiaoxiaoxh/TactAR_APP
- ImplicitRDP,IEEE RA-L DOI:https://doi.org/10.1109/LRA.2026.3710031
- ImplicitRDP,arXiv:https://arxiv.org/abs/2512.10946
- ImplicitRDP,Project:https://implicit-rdp.github.io/
- ImplicitRDP,Code:https://github.com/Chen-Wendi/ImplicitRDP

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)