subprocess 的 communicate 只能调用一次?管道交互的三坑与一条 64KB 死线
昨天写 MCP 探针,第一版循环里每个请求都调了一次 popen.communicate(body),第二个请求直接抛 ValueError。查了下发现这是个新手高频坑,而且它背后连着一整族「不报错、只挂死」的更危险问题。这篇把 subprocess 管道交互的三种姿势和三处陷阱全部实测一遍——全标准库,Python 3.13,可复现。
文章目录
一、坑一:communicate 是一次性买卖
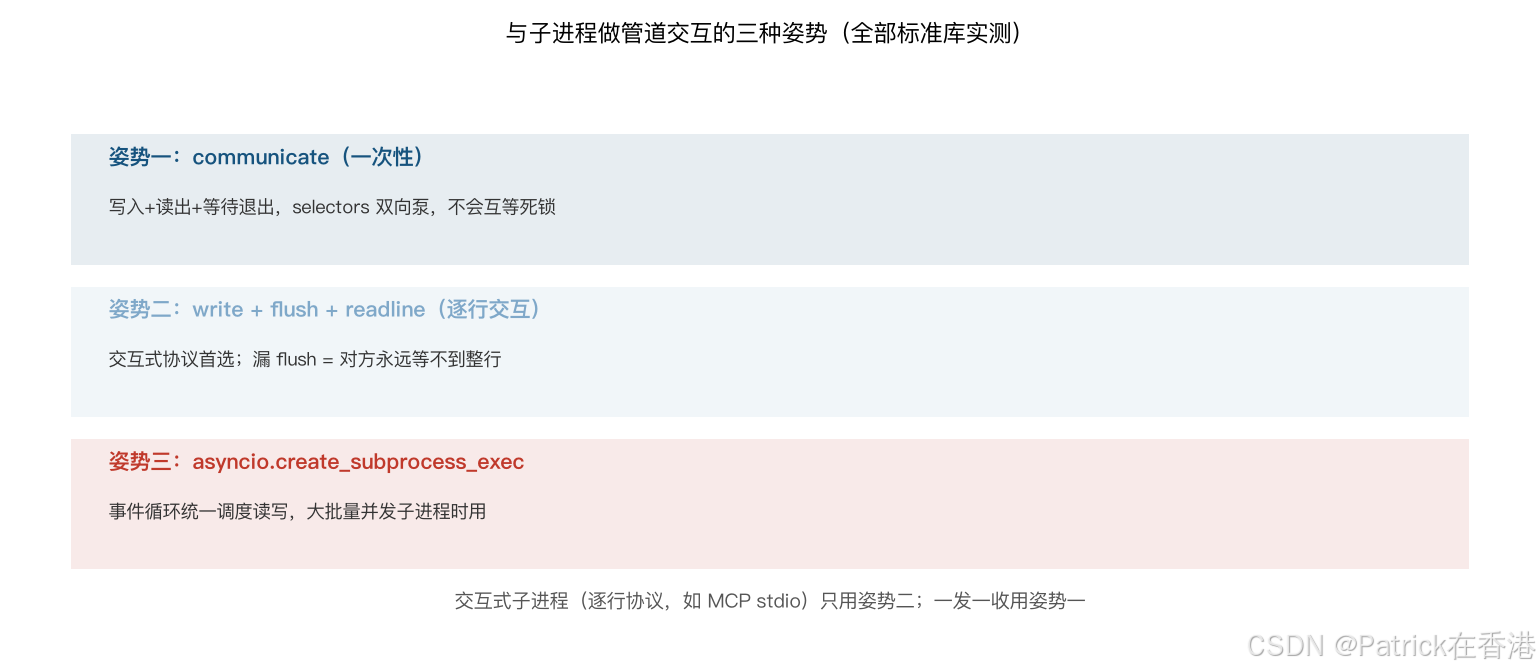
communicate 的语义是「写入全部输入、读回全部输出、等待进程退出」的一站式流程,每进程只能走一次流程。第二次调用的报错取决于你带不带输入:
import subprocess, sys

p = subprocess.Popen([sys.executable, "-c", "print('ok')"],
                     stdin=subprocess.PIPE, stdout=subprocess.PIPE, text=True)
p.communicate("first\n")
try:
    p.communicate("second\n")     # 第二次还带输入
except ValueError as e:
    assert str(e) == "Cannot send input after starting communication"

p2 = subprocess.Popen([sys.executable, "-c", "print('ok')"],
                      stdout=subprocess.PIPE, text=True)
p2.communicate()
try:
    p2.communicate()              # 第二次不带输入
except ValueError as e:
    assert str(e) == "I/O operation on closed file."
两种报错,同一个原因:第一次调用后管道已关闭、状态机已消费。有意思的是带输入的那条报错——「Cannot send input after starting communication」——它防的其实是不太一样的场景:第一次 communicate 已经启动但还没跑完时又想喂数据。一句话记住:想发第二条消息,就别用 communicate。
二、坑二:不 flush,对方永远等不到整行
交互式协议(逐行 JSON-RPC 之类)必须用姿势二:write + flush + readline。实测漏掉 flush 的后果:子进程的 readline 永远不返回,父进程的 readline 也永远不返回——双向挂死,零报错。补上 flush,应答立刻到达。
原因在缓冲模式:管道不是终端,Python 的 TextIOWrapper 对它用块缓冲,换行符不触发自动刷出。你以为「写了一行」,实际那一行还躺在父进程的用户态缓冲里。我扫了一遍这个缓冲的被动刷出边界:8,192 字节及以下、不 flush,子进程 2 秒内永远收不到;超过 8,192 字节的单次写入反而会绕过缓冲直写。也就是说这个坑专打小消息——而逐行交互协议的消息恰恰全是小消息,demo 里一行几百字节,全中。
三、坑三:64KB 死线
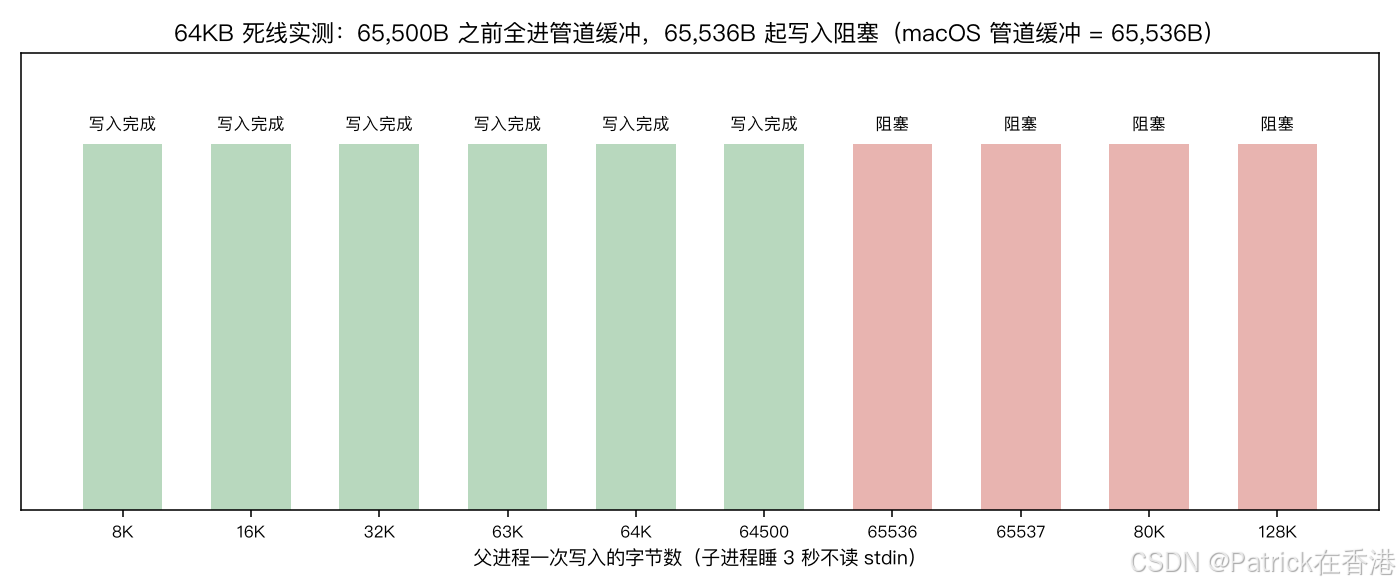
更狠的一条:就算你 flush 了,只要子进程暂时不读 stdin,一次写入超过管道缓冲就会阻塞。我把边界扫了出来:子进程先睡 3 秒再读 stdin,父进程一次写入——65,500 字节及以下全部进了管道缓冲、写入完成;65,536 字节(64KB)起,写入阻塞。macOS 的管道缓冲正好是 65,536 字节,Linux 默认也是 64KB 量级。
阻塞本身不是死锁,互等才是:子进程在睡或卡在别的事上、不消费 stdin,父进程的 write 等缓冲腾空;如果子进程恰好在等父进程读它的输出,两端就永远互相等。这种死锁不抛任何异常,进程树看着都健康,只有超时能救。
那 communicate 为什么喂 200KB 都安全?实测同一场景走 communicate 正常返回——它内部用 selectors 同时盯两根管道,谁可读读谁、谁可写写谁,双向泵不会让自己堵在自己写的路上。大块数据用 communicate,不是因为它方便,是因为它防死锁。
四、挂死了怎么办:自救模板
死锁不报错,唯一的护身符是超时。我的做法是把所有「等子进程」的调用都包一层观察线程:起一个 daemon 线程去执行 readline 或 communicate,主线程 join(超时秒数);到点还没回来就 kill() 子进程、把现场(已收到的输出、退出码、当时正写入的大小)记进日志再重试。signal.alarm 也能干这事,但它只在主线程可用,放进常驻进程里就废了,线程做法不挑调用位置。记现场这一步别省——死锁的排查线索全在「挂死那一刻双方各自卡在哪个调用上」。
五、四种踩法对照表
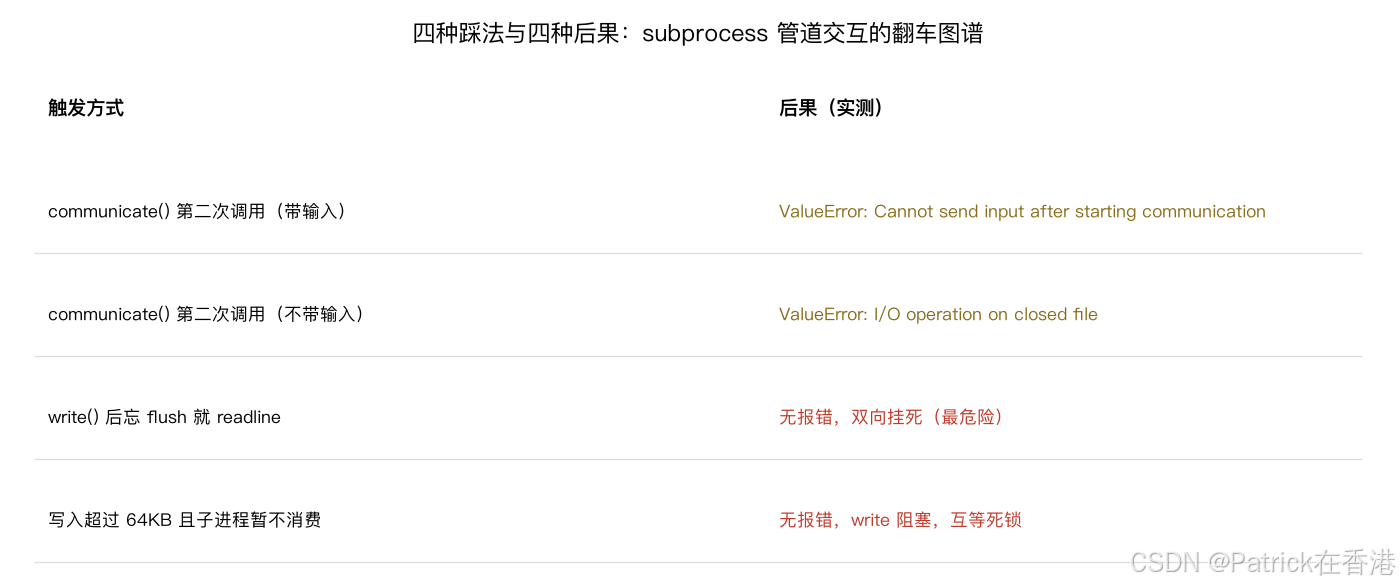
把三坑排成翻车图谱:communicate 二次调用(两种报错形态)、漏 flush(双向挂死)、超缓冲写入(互等死锁)。注意后两种都不报错——报错的坑是好人,挂死的坑才吃时间。
六、为什么 demo 总能跑过、上线就挂
回看这四个坑会发现一个共同模式:它们全都在小数据、低频次下无症状。communicate 的第二次调用只在程序长到有第二轮请求时出现;漏 flush 只在消息小于 8KB 时发作;64KB 死线只在子进程偶尔变慢(GC、日志、网络)时触发。demo 环境恰好躲开了全部四个条件,于是「本地好好的」成了一句准确的废话。这也解释了为什么这类问题的搜索结果里全是「重启就好了」——症状消失和问题消失是两回事。
七、怎么选:三条判断
- 一发一收(跑个脚本拿结果):
subprocess.run或一次communicate,别自己摸管道。这一档没有交互需求,管道只被消费一次,一切坑都与它无关; - 逐行交互协议(MCP stdio、REPL 类):
write+ flush +readline循环,每条消息几百字节,离 64KB 死线还有一千倍余量——真正的威胁是忘了 flush,所以把 flush 和 write 绑定成一个函数,从结构上杜绝; - 大批量子进程或大流量:
asyncio.create_subprocess_exec,事件循环统一调度读写,单线程里天然避开互等;单进程单请求仍然朴素地 await 一发一收即可,别为简单场景引入复杂度。
三档共同的一条底线:任何「等子进程」的调用都要有超时。communicate 的 timeout 参数、线程 join 的秒数、asyncio 的 wait_for,形式不限,没有兜底的超时就没有排障的起点。
边界声明:实测在 macOS(Apple Silicon、Python 3.13.12)完成,Linux 的管道缓冲默认 64KB 但可通过 fcntl 调整,Windows 的管道实现不同、64KB 数字不适用;死锁判定用 2 秒超时的观察线程,属于行为验证而非时序证明。
八、30 秒带走版
communicate每进程一次;第二次带输入报 Cannot send input,不带输入报 I/O operation on closed file;- 管道是块缓冲,换行不自动 flush,交互协议必须显式 flush;
- 管道缓冲 65,536 字节:子进程不消费时,写入超线即阻塞,双向互等就是死锁;
communicate用 selectors 双向泵,天然防互等——大流量别手搓 write;- 报错的坑修一行,挂死的坑查半天:上超时,永远上超时。
参考链接
- https://docs.python.org/3/library/subprocess.html
- https://docs.python.org/3/library/asyncio-subprocess.html

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 9
 0
- 0


 已为社区贡献1条内容

所有评论(0)