JavaEE 初阶 - 多线程(初阶)
1、认识线程(Thread)
1.1 概念
1.什么是线程
我们之前编写的 Java 程序,大多数都是这样的:
public class ThreadDemo {

    public static void main(String[] args) {

        System.out.println("程序开始");

        for (int i = 0; i < 5; i++) {
            System.out.println(i);
        }

        System.out.println("程序结束");
    }
}
程序执行的时候,代码基本上是按照一定的顺序执行。
这种执行方式,我们可以简单理解为一个线程从头到尾负责执行一条执行流。
那么什么是线程?
简单来说,线程(Thread)是操作系统进行调度和执行的基本单位之一。
在 Java 程序中,我们可以创建多个线程,让多个任务同时处于执行状态。
例如:
线程1:下载文件
线程2:播放音乐
线程3:处理用户请求
线程4:刷新界面
这些任务就可以由不同的线程来执行。
所以,多线程,就是在一个进程中同时存在多个线程,让多个线程共同完成任务。
2.为什么需要线程
假设我们正在开发一个聊天软件。
用户打开软件以后,需要同时完成:
接收消息
发送消息
播放提示音
刷新聊天界面
上传文件
如果所有事情都由一个线程完成:
接收消息 -> 发送消息 -> 播放声音 -> 刷新界面 -> 上传文件
那么某一个任务如果执行时间比较长,就可能影响其他任务。
例如:
上传文件 -> 需要 10 秒 -> 其他任务只能等待
用户就可能感觉软件卡住了。
如果使用多个线程:
线程1 -> 接收消息
线程2 -> 发送消息
线程3 -> 播放声音
线程4 -> 上传文件
多个任务就可以交错执行。
这就是线程最直接的价值,把一个程序中的不同任务拆分成多个执行流。
3.进程和线程的区别
学习线程之前,必须先理解进程。
当我们启动一个 Java 程序时,操作系统会创建一个进程。
例如:
1.启动 Java 程序

2.操作系统创建进程

3.JVM 在进程中运行
一个进程里面又可以包含多个线程,所以可以简单理解为进程是资源分配的基本单位之一,线程是进程内部的执行流。
例如:
微信进程中,有接收消息线程、发送消息线程、网络线程、界面线程,不同进程之间通常拥有相互独立的内存空间。
而同一个进程中的线程,共享进程中的大部分资源。
这既是多线程的优势,也是后面出现线程安全问题的重要原因。
4.Java 线程和操作系统线程的关系
我们在 Java 中写:
Thread t = new Thread();
这里创建的是 Java 层面的 Thread 对象。
当我们t.start();之后,Java 会请求运行环境创建并调度相应的线程执行任务。
现代 Java 还提供了虚拟线程(Virtual Thread)。Java 21 起,虚拟线程成为正式特性;虚拟线程由 JVM 调度,可以大量创建,并不等同于传统的平台线程。
5.并发和并行的简单理解
这两个概念非常容易混淆。
并发
并发:多个任务在一段时间内交替推进。
例如只有一个 CPU 核心:
时间 →
线程1:████    ████
线程2:    ████    ████
CPU 在不同线程之间进行切换。
从宏观上看,线程1和线程2同时推进,这就是并发。
并行
并行:多个任务在同一时刻真正同时执行。
例如有多个 CPU 核心:
CPU核心1 → 线程1 █████████
CPU核心2 → 线程2 █████████
CPU核心3 → 线程3 █████████
多个任务真正同时运行。
可以简单记一下:
并发:一个时间段内一起推进
并行:同一时刻真正一起执行
多线程程序既可以体现并发,也可以在多核 CPU 上实现真正的并行。
1.2 第一个多线程程序
1.创建第一个线程
先来看最简单的线程创建方式。
public class ThreadDemo {

    public static void main(String[] args) {

        Thread thread = new Thread() {
            @Override
            public void run() {
                while (true) {
                    System.out.println("新线程正在运行");
                }
            }
        };

        thread.start();
    }
}
这里thread.start();非常重要。
调用 start() 之后,JVM 会调度这个线程开始执行它的 run() 方法。Oracle 官方教程也把“定义 run() 中的任务”和调用 start() 启动线程作为创建线程的基本模式。
2.观察多个线程同时执行
我们可以让主线程和新线程同时打印。
public class ThreadDemo {

    public static void main(String[] args) {

        Thread thread = new Thread() {
            @Override
            public void run() {
                for (int i = 0; i < 5000; i++) {
                    System.out.println("新线程:" + i);
                }
            }
        };

        thread.start();

        for (int i = 0; i < 5000; i++) {
            System.out.println("主线程:" + i);
        }
    }
}
运行结果是随机的,多个线程的执行顺序通常不是固定的。
3.理解多线程执行的不确定性
刚学的时候看到这个:
thread.start();
System.out.println("main");
会下意识认为,一定先执行 thread,再执行 main
这是不对的。
start() 的作用是:让线程进入可调度执行的状态。
而不是现在立刻执行这个线程,并且执行完以后再执行下面的代码。
具体谁先执行、执行多久、什么时候切换,是由 JVM 和底层操作系统调度机制共同决定的。
因此,多线程程序的执行顺序通常具有不确定性。
1.3 创建线程
1.继承 Thread 类
class MyThread extends Thread {

    @Override
    public void run() {
        System.out.println("线程执行");
    }

}

public class ThreadDemo {

    public static void main(String[] args) {

        MyThread thread = new MyThread();

        thread.start();
    }

}
这里的关键是class MyThread extends Thread,并重写了run(),最后start()启动线程。
Oracle 官方教程同样把“继承 Thread 并重写 run()”列为创建线程的基本方式之一。
2.实现 Runnable 接口
class MyRunnable implements Runnable {

    @Override
    public void run() {
        System.out.println("线程执行");
    }

}

public class ThreadDemo {

    public static void main(String[] args) {

        Runnable runnable = new MyRunnable();

        Thread thread = new Thread(runnable);

        thread.start();
    }
}
Runnable -> 表示一个任务
Thread -> 负责执行这个任务
这种方式将任务和线程进行了分离。
这也是官方教程比较推荐理解的方式,因为任务对象不需要继承 Thread,更加灵活。
3.使用匿名内部类
如果只使用一次,就没有必要专门定义一个类。
可以:
Thread thread = new Thread(new Runnable() {

    @Override
    public void run() {
        System.out.println("线程执行");
    }
});

thread.start();
这样代码更加简洁。
4.使用 Lambda 表达式
因为 Runnable 是一个函数式接口,所以可以使用 Lambda。
Thread thread = new Thread(() -> {
    System.out.println("线程执行");
});

thread.start();
甚至可以进一步写成:
new Thread(() -> System.out.println("线程执行")).start();
这种写法在现代 Java 代码中非常常见。
5.其他创建线程的方式简单介绍
Java 还提供了更高级的并发工具。
例如:
Callable
Future
Executor
ExecutorService
ThreadPoolExecutor
后面我们会学习线程池。
1.4 多线程的优势——增加运行速度
1.单线程执行
假设现在有两个任务:
任务A:执行1000次计算
任务B:执行1000次计算
单线程:
线程1
 ↓
执行任务A
 ↓
执行任务B
假设:
任务A:5秒
任务B:5秒
总时间大约为10秒。
2.多线程执行
如果两个任务彼此独立:
线程1 → 任务A
线程2 → 任务B
在多核 CPU 的情况下,两个任务可能真正并行执行。
理论上:
任务A:5秒
任务B:5秒

总时间大约为5秒
所以多线程可能提高程序效率。
3.多线程为什么可能提高程序效率
主要原因是可以让多个独立任务同时推进。
尤其是CPU 密集型任务、IO 密集型任务。
在合适的场景下,多线程可以充分利用 CPU 或者在等待 IO 时让其他任务继续执行。
例如:
线程1 -> 等待网络数据

线程2 -> 继续执行计算
这样 CPU 就不会因为线程1等待网络而完全闲置。
4.多线程为什么不一定更快
很多人会误以为线程越多,程序越快。
实际上完全不是。
因为线程本身也有成本:
创建线程
线程调度
线程上下文切换
线程同步
线程之间竞争资源
例如:
线程1
线程2
线程3
线程4
……
线程1000
如果任务本身非常小,线程管理和切换的成本可能比真正执行任务的成本还高。
而且多个线程同时修改共享数据,还会引入:
线程安全
锁竞争
死锁
内存可见性
等问题。
所以多线程不是为了简单地增加线程数量,而是为了合理利用并发能力。
2、Thread 类及常见方法
2.1 Thread 的常见构造方法
1.Thread()
最简单:
Thread thread = new Thread();
然后可以继承 Thread 并重写 run()。
2.Thread(Runnable target)
Runnable task = () -> {
    System.out.println("执行任务");
};

Thread thread = new Thread(task);
thread.start();
Runnable -> 任务
Thread -> 执行任务
3.Thread(String name)
可以指定线程名称:
Thread thread = new Thread("worker");
线程名称对于调试、日志、排查问题非常有帮助。
4.Thread(Runnable target, String name)
同时指定任务和名称:
Runnable task = () -> {
    System.out.println("执行任务");
};

Thread thread = new Thread(task, "worker");

thread.start();
2.2 Thread 的几个常见属性
1.线程名称
获取:
Thread.currentThread().getName();
例如:
System.out.println(Thread.currentThread().getName());
主线程通常叫 main 。
自定义线程可以:
Thread t = new Thread(() -> {
    System.out.println(Thread.currentThread().getName());
}, "myThread");

t.start();
输出 myThread 。
2.线程优先级
可以:
线程对象.setPriority(Thread.MAX_PRIORITY);
优先级范围通常是:1 ~ 10
常量:
MIN_PRIORITY = 1
NORM_PRIORITY = 5
MAX_PRIORITY = 10
但是需要注意,线程优先级不是严格的执行顺序保证。
不能因为,thread.setPriority(10);设置了之后,就认为线程一定先执行。
线程调度仍然是复杂的运行时行为。
3.守护线程
Java 中线程可以分为:
- 用户线程 -> 也叫前台线程
- 守护线程 -> 也叫后台线程
用户线程:程序中的核心线程,JVM 必须等待所有用户线程结束后才会退出。
守护线程:为其他线程提供服务的辅助线程,当所有用户线程结束后,守护线程会被 JVM 自动终止,JVM 随之退出。通常用于执行一些后台辅助工作。
例如:
Thread thread = new Thread(() -> {

    while (true) {
        System.out.println("后台工作");
    }

});

thread.setDaemon(true);
/*
setDaemon(true) 必须在 start() 之前调用。
如果线程已经启动,再调用 setDaemon() 会抛出 IllegalThreadStateException。
*/

thread.start();
这里 thread 就是一个守护线程。
当 JVM 中只剩下守护线程时,JVM 可以结束,所以,守护线程一般不能承担必须保证完成的核心业务。
注意:
只要还有一个用户线程没有结束,JVM 就不会退出。
当所有用户线程都结束后,JVM 会直接退出,不管守护线程是否还在运行。
4.线程是否存活
可以使用thread.isAlive();判断线程是否还处于存活状态。
例如:
Thread thread = new Thread(() -> {
    System.out.println("执行");
});

System.out.println(thread.isAlive());

thread.start();

System.out.println(thread.isAlive());
线程启动以后,直到执行结束之前,通常都处于存活状态。
2.3 启动一个线程——start()
1.start() 的作用
启动线程。
thread.start();这是线程真正进入执行流程的入口。
2.start() 和 run() 的区别
这是比较容易搞混的问题。
看下面例子:
Thread thread = new Thread(() -> {
    System.out.println(Thread.currentThread().getName());
});
如果调用:
thread.run();
那么它只是普通的方法调用,执行它的仍然是当前线程。
而 thread.start() 才是启动新的线程。
3.为什么不能直接调用 run() 启动线程
例如主线程main执行 thread.run();
实际上:
main -> 调用 thread.run() -> run 中代码仍然由 main 线程中执行
而 thread.start() 则是:
main -> start() -> 新线程被调度 -> 新线程执行 run()
因此:
run() -> 普通方法调用

start() -> 启动新线程
Oracle 当前 Thread API 也明确指出,run() 是线程执行任务的方法,而 start() 用于调度线程开始独立执行;一个线程最多只能启动一次。
4.为什么不能重复调用 start()
例如:
Thread thread = new Thread(() -> {
    System.out.println("hello");
});

thread.start();
thread.start();
第二次调用会抛出:
IllegalThreadStateException
因为一个 Thread 对象只能被启动一次。
线程结束以后,也不能通过再次 start() 把它重新启动。
2.4 中断一个线程
1.interrupt() 是什么
线程有时候会执行很长时间。
例如:
Thread thread = new Thread(() -> {

    while (true) {
        System.out.println("执行中...");
    }

});

thread.start();
如果我们想让它结束,可以使用:
thread.interrupt();
但是 interrupt() 不是强制杀死线程。
2.interrupt 并不是强制杀死线程
例如:
Thread thread = new Thread(() -> {

    while (true) {
        System.out.println("执行中...");
    }

});

thread.start();

thread.interrupt();
如果线程自己的代码根本没有检查中断状态:
interrupt() -> 线程可能继续运行
所以,interrupt() 更准确地说是向线程发出“希望你停止/处理中断”的信号。
3.中断标志
可使用 Thread.currentThread().isInterrupted() 查看当前线程的中断状态。
例如:
Thread thread = new Thread(() -> {

    while (!Thread.currentThread().isInterrupted()) {

        System.out.println("执行中...");
    }

    System.out.println("线程结束");
});

thread.start();
主线程执行后:
thread.interrupt();
那么新线程最终就可以结束 thread 线程的循环了。
4.阻塞状态下的中断
如果线程正在 Thread.sleep(…) 等可中断阻塞操作中:
try {
    Thread.sleep(10000);
} catch (InterruptedException e) {
    System.out.println("线程被中断");
}
此时另一个线程:
thread.interrupt();
可能使 sleep() 抛出 InterruptedException 这个异常,从而让线程获得处理退出机会。
5.如何正确结束一个线程
比较推荐的思想:
1.不要强制杀死

2.发出中断信号

3.线程自己检查

4.完成必要清理

5.正常退出
例如:
Thread thread = new Thread(() -> {

    while (!Thread.currentThread().isInterrupted()) {

        System.out.println("工作中");

        try {
            Thread.sleep(1000);
        } catch (InterruptedException e) {
            Thread.currentThread().interrupt();
            break;
        }
    }

    System.out.println("线程结束");
});
这里尤其要注意:
Thread.currentThread().interrupt();
是为了在捕获 InterruptedException 后恢复中断状态,让更上层代码仍然能够观察到这个中断请求。
2.5 等待一个线程——join()
1.join() 的作用
假设:
线程A执行任务

线程B需要等待线程A完成
可以使用:
threadA.join();
表示当前线程等待 threadA 执行结束。
2.为什么需要等待线程
例如:
Thread thread = new Thread(() -> {
    System.out.println("开始计算");

    // 模拟耗时操作
});

thread.start();

System.out.println("获取计算结果");
如果主线程直接继续执行:
主线程 -> 启动计算线程 -> 马上获取结果
计算线程可能还没有计算完成。
所以可以:
thread.start();
thread.join();

System.out.println("获取结果");
变成:
启动线程 -> 等待线程结束 -> 获取结果
3.join() 的基本使用
Thread thread = new Thread(() -> {

    for (int i = 0; i < 5; i++) {
        System.out.println(i);
    }

});

thread.start();

try {
    thread.join();
} catch (InterruptedException e) {
    Thread.currentThread().interrupt();
}

System.out.println("线程执行结束");
4.join() 和线程执行顺序
注意,join() 可以人为建立一种等待关系。
例如:
main
 ↓
start thread
 ↓
join
 ↓
等待 thread
 ↓
thread结束
 ↓
main继续
所以,join 可以让原本不确定的执行关系变成明确的等待关系。
2.6 获取当前线程引用
1.currentThread()
使用:
Thread.currentThread();
获取当前正在执行代码的线程。
例如:
System.out.println(Thread.currentThread().getName());
2.什么是当前线程
例如:
public static void main(String[] args) {

    System.out.println(Thread.currentThread().getName());

}
这里当前线程就是 main 。
如果在线程任务中:
Thread thread = new Thread(() -> {

    System.out.println(
        Thread.currentThread().getName()
    );

});

thread.start();
那么当前线程就是新创建的线程。
3.创建线程与当前线程的区别
例如:
Thread thread = new Thread(() -> {
    System.out.println("任务线程:" +
            Thread.currentThread().getName());
});

System.out.println("当前线程:" +
        Thread.currentThread().getName());

thread.start();
thread 是一个 Thread 对象。
而 Thread.currentThread() 表示当前正在执行这段代码的线程。
这是两个不同的概念。
2.7 休眠当前线程
1.sleep()
让当前线程休眠:
Thread.sleep(1000);
表示大约暂停 1000ms ,也就是1秒。
2.sleep() 的基本使用
public class SleepDemo {

    public static void main(String[] args)
            throws InterruptedException {

        for (int i = 0; i < 5; i++) {

            System.out.println(i);

            Thread.sleep(1000);
        }
    }
}
运行时每次输出之间大约间隔 1 秒。
3.sleep() 对线程状态的影响
线程调用 sleep() 之后,会进入 TIMED_WAITING 状态。
休眠结束以后由 TIMED_WAITING 这个状态,变为 RUNNABLE 这个状态,然后等待调度执行。
4.sleep() 是否释放锁
这是面试中非常经典的问题:
sleep 会不会释放锁?

答案:不会。
例如:
synchronized (lock) {

    Thread.sleep(1000);

}
线程虽然睡眠了,但是它仍然持有 lock ,因此其他线程仍然无法进入需要同一把锁的同步区域。
这一点和 wait() 完全不同,后面学习 wait/notify 时会重点对比。
3、线程的状态
3.1 观察线程的所有状态
Java 的 Thread.State 定义了六种线程状态:
NEW
RUNNABLE
BLOCKED
WAITING
TIMED_WAITING
TERMINATED
1.NEW
线程对象创建出来,但是还没有调用 start() 。
例如:
Thread thread = new Thread(() -> {
    System.out.println("hello");
});
此时,thread的状态就是new。
2.RUNNABLE
调用 thread.start() 以后,线程进入可运行状态。
需要注意,Java 的 RUNNABLE 是一个比较宽泛的状态。
它既可以表示正在运行,也可以表示已经准备运行,等待 CPU 调度。
所以 Java 中没有单独定义 RUNNING 状态。
3.BLOCKED
表示排队等着其他事情。
比如说:线程A持有 lock ,但线程B尝试获取 lock,这时候是获取不到的,所以线程B就是 BLOCKED 这个状态。
4.WAITING
也表示排队等着其他事情,但是这个是没有超时时间的等待。
例如:
thread.join();
或者:
object.wait();
都可能让线程进入 WAITING 的状态。
5.TIMED_WAITING
带时间限制的等待。
例如:
Thread.sleep(1000);
或者:
object.wait(1000);
或者:
thread.join(1000);
都可能进入 TIMED_WAITING 状态。
6.TERMINATED
线程执行完成以后,TERMINATED 表示线程已经结束。
注意:TERMINATED 以后不能再次 start() 启动线程。
3.2 线程状态和状态转移的意义
1.为什么需要了解线程状态
因为多线程程序出现问题时,我们经常需要回答:
这个线程现在在干什么?
为什么没有执行?
为什么一直等待?
为什么获取不到锁?
为什么一直不结束?
这些问题最终都可以通过:线程状态 + 线程之间的关系进行分析。
2.不同状态分别代表什么
可以总结:
| 状态 | 含义 |
|---|---|
| NEW | 创建了线程对象,还没启动 |
| RUNNABLE | 可运行/正在运行 |
| BLOCKED | 等待获取 synchronized 锁 |
| WAITING | 无限期等待 |
| TIMED_WAITING | 限时等待 |
| TERMINATED | 执行结束 |
3.Java 线程状态与操作系统线程状态的区别
这里要注意,Java 的六种状态不是操作系统线程状态的简单一一映射。
Java Thread.State 是 JVM 层面对线程生命周期的抽象。
例如 RUNNABLE 在 Java 层面可以覆盖:
正在运行
等待 CPU 调度
因此不能简单认为:RUNNABLE = CPU 正在执行。
4.Java 中为什么没有单独的 RUNNING 状态
因为 Java 将 Ready、Running 等执行相关状态统一抽象为 RUNNABLE ,这样 Java 层面的线程状态模型更加简单。
所以看到 RUNNABLE,不代表线程一定正在 CPU 上执行。
3.3 观察线程的状态和转移
可以通过:
thread.getState();
获取线程状态。
例如:
Thread thread = new Thread(() -> {

    try {
        Thread.sleep(3000);
    } catch (InterruptedException e) {
        Thread.currentThread().interrupt();
    }

});

System.out.println(thread.getState());

thread.start();

System.out.println(thread.getState());

Thread.sleep(100);

System.out.println(thread.getState());

thread.join();

System.out.println(thread.getState());
可能观察到:
NEW
RUNNABLE
TIMED_WAITING
TERMINATED
具体时刻可能略有不同,因为线程调度具有不确定性。
4、多线程带来的风险——线程安全(重点)
这一章开始进入多线程真正的核心。
前面我们一直在讲多线程可以提高效率。
但是多线程也会带来新的问题。
其中最重要的问题之一就是线程安全。
4.1 观察线程不安全
先看一个经典案例。
假设有一个变量:
private static int count = 0;
然后创建多个线程,每个线程执行:
count++;
例如:
public class ThreadDemo {

    private static int count = 0;

    public static void main(String[] args) throws InterruptedException {

        Thread t1 = new Thread(() -> {
            for (int i = 0; i < 10000; i++) {
                count++;
            }
        });

        Thread t2 = new Thread(() -> {
            for (int i = 0; i < 10000; i++) {
                count++;
            }
        });

        t1.start();
        t2.start();

        t1.join();
        t2.join();

        System.out.println(count);
    }
}
我们期待的结果是20000,但实际运行结果可能小于20000。
例如18342或者19427,甚至每次运行结果都不同。
这就是线程不安全问题。
4.2 线程安全的概念
1.什么是线程安全
简单来说:多个线程同时执行某段代码时,程序仍然能够得到符合预期的结果,那么这段代码可以认为是线程安全的。
反过来:多个线程同时执行时可能产生错误结果,就是线程不安全。
2.什么是线程不安全
例如:
count++;
多个线程同时执行:
线程1 → count++

线程2 → count++
如果没有合理同步,就可能出现:
数据覆盖
数据丢失
结果不一致
3.为什么线程安全很重要
多线程程序中,一旦线程安全出现问题:
数据错误
订单重复
库存超卖
余额错误
状态异常
以上都有可能发生。
例如:
商品库存 = 1

用户A购买
用户B购买
如果两个线程同时判断:
库存 > 0
然后同时扣库存:
1 → 0
1 → 0
最终可能出现,两个用户都买成功,但库存实际上只有一个。
这就是不安全的问题。
4.3 线程不安全的原因
1.线程调度的不确定性
多个线程执行:线程1、线程2、线程3执行顺序不是固定的。
例如:
线程1:读取
线程2:读取
线程1:修改
线程2:修改
就可能产生问题。
2.多线程共享数据
例如:
static int count;
多个线程都可以访问到这个 count ,这就是共享数据。
多线程安全问题通常就发生在共享数据 + 并发修改这样的场景中。
3.操作不具有原子性
重点看:
count++;
很多人以为 count++ 就是一步操作。
实际上可以粗略理解成:
读取 count -> 加 1 -> 写回 count
假设 count = 10 ,两个线程同时执行:
线程1:读取10
线程2:读取10

线程1:10+1=11
线程2:10+1=11

线程1:写回11
线程2:写回11
最后 count = 11,而不是12
这就是典型的复合操作不是原子的。
4.内存可见性问题
多个线程共享变量时,还可能出现:线程A修改变量之后,线程B没有及时观察到最新值。
这就是可见性问题。
例如:
boolean running = true;
线程A中检测这个变量:
while (running) {
}
线程B修改这个变量:
running = false;
理论上我们希望线程A看到 false ,然后结束。
但在没有建立适当内存可见性保证时,线程之间对共享变量的观察不能简单按照“一个线程写了,另一个线程立刻就能看到”的方式理解。
这就是后面:
volatile
synchronized
要解决的问题。
5.指令重排序问题
现代编译器、JIT 和处理器为了提高性能,可能对部分操作进行重排序。
单线程情况下,只要最终效果符合程序语义,一些执行顺序可以进行调整。
但是多线程情况下:
线程A
线程B
之间的观察关系可能受到影响。
因此 Java 内存模型需要提供:可见性、有序性方面的保证。
现在暂时不需要深入 CPU 缓存一致性协议、指令级流水线等底层细节。
先记住:多线程程序不仅有“操作顺序”的问题,还有“什么时候看到其他线程修改”的问题。
4.4 解决之前的线程不安全问题
解决线程安全问题,不能一上来就写:
synchronized
更重要的是先分析问题。
1.找到共享数据
例如:
static int count;
多个线程都会访问 count ,所以 count 就是共享数据。
2.找到临界区
所谓临界区,可以简单理解为:访问共享数据,并且需要保证并发安全的代码区域。
例如:
count++;
就是需要重点保护的区域。
3.找到需要保证原子性的操作
我们真正需要保证的是:读取 + 修改 + 写回不能被其他线程在中间插入破坏。
比如说也就是希望:线程1中的读取 → 修改 → 写回作为一个整体完成。
4.为 synchronized 做铺垫
于是我们就需要一种机制:同一时间,只允许一个线程进入关键代码
这就是:互斥。
Java中,synchronized 就可以完成这件事情。
5、synchronized 关键字——监视器锁(Monitor Lock)
5.1 synchronized 的特性
1.互斥
synchronized 最核心的特性就是同一把锁在同一时刻只能由一个线程持有。
例如:
synchronized (lock) {
    count++;
}
如果:线程A先拿到 lock,那么线程B也想拿 lock,这个时候线程B拿不到,就会等待,直到线程A释放锁。
因此,synchronized 可以保证多个线程对同一共享资源的互斥访问。
2.可重入
synchronized 还是可重入锁。
例如:
public synchronized void methodA() {
    methodB();
}

public synchronized void methodB() {

}
同一个线程已经持有对象锁,再次获取同一把锁,而不会把自己锁死。
3.synchronized 的基本工作方式
可以简单理解:
1.线程进入 synchronized

2.尝试获取锁

3.获取成功?

4.如果获取成功,等待执行完成,然后释放锁;如果获取失败的话,就进行等待
Java 官方文档将 synchronized 的同步机制建立在对象的 intrinsic lock / monitor 上,并指出同步可以用于避免线程干扰和内存一致性问题。
5.2 synchronized 使用示例
1.synchronized 修饰代码块
synchronized (lock) {

    count++;

}
例如:
public class ThreadDemo {

    private static int count = 0;

    private static final Object lock = new Object();

    public static void main(String[] args) throws InterruptedException {

        Thread t1 = new Thread(() -> {

            for (int i = 0; i < 10000; i++) {

                synchronized (lock) {
                    count++;
                }
            }
        });

        Thread t2 = new Thread(() -> {

            for (int i = 0; i < 10000; i++) {

                synchronized (lock) {
                    count++;
                }
            }
        });

        t1.start();
        t2.start();

        t1.join();
        t2.join();

        System.out.println(count);
    }
}
这时候结果就是正确的。
因为线程1、线程2都是使用的是同一把锁,同一时间只有一个线程能够进入临界区。
2.synchronized 修饰实例方法
可以这样:
public synchronized void increment() {
    count++;
}
它等价于对当前对象的锁进行同步。
可以粗略理解:
public void increment() {

    synchronized (this) {
        count++;
    }
}
所以,实例 synchronized 方法锁的是当前对象 this。
3.synchronized 修饰静态方法
例如:
public static synchronized void method() {

}
静态方法没有普通对象的 this。
因此它同步时对应的是当前类的 Class 对象。
可以粗略理解为:
public static void method() {

    synchronized (MyClass.class) {

    }

}
4.synchronized 到底锁的是什么
这个问题非常重要。
例如:
synchronized (obj) {
}
锁的是 obj 对应的监视器。
如果:
Object lock1 = new Object();
Object lock2 = new Object();
那么:
synchronized (lock1)
和:
synchronized (lock2)
是两把不同的锁。
5.不同锁对象之间的关系
例如:
synchronized (lock1) {
    count++;
}
另一个线程:
synchronized (lock2) {
    count++;
}
因为 lock1 不等于 lock2 ,所以它们并不会互相阻塞。
这说明:synchronized 是否互斥,关键不是“都写了 synchronized”,而是“是不是同一把锁”。
6.使用 synchronized 解决线程安全问题
之前 count++ 存在问题。
现在上锁之后:
synchronized (lock) {
    count++;
}
就可以保证读取 + 修改 + 写回是在同一把锁的保护下完成的。
所以解决线程安全问题的基本思路是:
找到共享数据 -> 找到临界区 -> 选择合适的锁 -> 使用 synchronized 保护
5.3 Java 标准库中的线程安全类
1.什么是线程安全类
如果一个类在多个线程并发使用时,能够按照其设计保证操作安全,那么可以称为线程安全类。Java 标准库中存在一些线程安全的集合和并发工具。
例如:ConcurrentHashMap、CopyOnWriteArrayList、BlockingQueue等。
2.常见线程安全类
例如:
ConcurrentHashMap<Integer, String> map
用于并发场景下的 Map。
又例如:
CopyOnWriteArrayList<Integer> list
用于特定并发读多写少场景。
还有:
BlockingQueue
用于生产者消费者模型。
3.线程安全类的基本使用
例如:
ConcurrentHashMap<Integer, String> map =
        new ConcurrentHashMap<>();

map.put(1, "Java");
map.put(2, "Thread");
多个线程可以安全地对其执行很多并发操作。
4.使用线程安全类时的注意事项
需要注意的是,线程安全类并不代表你的整个业务逻辑天然线程安全。
例如:
if (!map.containsKey(key)) {
    map.put(key, value);
}
虽然 containsKey() 和 put() 单独都是安全操作,但判断和插入是两个操作,在多个线程之间仍然可能产生竞态。
所以,类的方法线程安全,不等于任意组合出来的业务操作都是原子的。
5.4 死锁
1.什么是死锁
死锁是多线程中非常经典的问题。
例如:
线程A持有锁1
线程A等待锁2

线程B持有锁2
线程B等待锁1
于是 A 等 B ,B -> 等 A 两个人互相等。
最终,谁都无法继续执行。
2.死锁产生的典型场景
代码:
Object lock1 = new Object();
Object lock2 = new Object();

Thread t1 = new Thread(() -> {

    synchronized (lock1) {

        synchronized (lock2) {

        }
    }
});
另一个线程:
Thread t2 = new Thread(() -> {

    synchronized (lock2) {

        synchronized (lock1) {

        }
    }
});
执行过程中可能:
t1 持有 lock1
t2 持有 lock2

t1 等 lock2
t2 等 lock1
于是死锁。
3.synchronized 为什么可能产生死锁
因为synchronized是互斥锁。线程获取锁以后必须释放其他线程才能获取。
如果线程A:
拿着锁1
等待锁2
而线程B:
拿着锁2
等待锁1
就形成循环等待。
4.死锁产生的必要条件
经典的死锁必要条件包括:
互斥
占有且等待
不可剥夺
循环等待
其中最容易理解的是:
A -> 等B
B -> 等A
形成一个循环。
Java 语言规范也明确指出,Java 并不会自动保证所有死锁条件都被检测或避免;程序设计时需要采用合理的锁策略。
5.如何避免死锁
一个重要方法:统一获取锁的顺序。
例如:
所有线程都按照顺序获取。
lock1 -> lock2
而不要:
线程A:
lock1 -> lock2
线程B:
lock2 -> lock1
按顺序获取还可以:
减少锁的数量
减少锁的持有时间
避免嵌套锁
6.如何发现死锁
实际开发中可以使用:
JVM 线程转储
jstack
JDK Mission Control
VisualVM
IDE 调试工具
查看线程之间的锁等待关系。
如果发现:
Thread-1 waiting for lock A
Thread-2 waiting for lock B
同时:
Thread-1 持有 B
Thread-2 持有 A
就需要重点检查死锁。
6、volatile 关键字
6.1 volatile 的基本概念
volatile 是 Java 中用于处理多线程共享变量的关键字。
例如:
private volatile boolean running = true;
它主要解决共享变量的内存可见性问题。
但需要特别注意:volatile 不保证复合操作的原子性。
所以volatile和synchronized解决的问题并不完全相同。
6.2 volatile 能保证内存可见性
1.什么是可见性
假设:
boolean running = true;
线程A:
while (running) {
}
线程B:
running = false;
我们希望,线程B修改 running ,线程A可以看到,退出循环。
这就是:可见性。
2.为什么会出现可见性问题
多线程程序中,可能对共享变量存在不同的观察。
现代计算机为了提高性能,会涉及:
CPU缓存
编译器优化
JIT优化
内存访问重排
因此不能简单认为:一个线程修改变量后,其他线程一定按照我们直觉中的方式立即看到。
3.volatile 如何保证可见性
例如:
private static volatile boolean running = true;
线程A:
while (running) {

}
线程B:
running = false;
使用 volatile 后,对这个变量的写入和后续读取具有明确的内存可见性保证。
所以线程B修改 running 后,线程A能及时的读取到并结束循环,这就是 volatile 的重要作用。
6.3 volatile 不保证原子性
1.什么是原子性
原子性可以简单理解为:一个操作要么完整执行,要么不被其他线程插入破坏。
例如:
count++;
实际上可以理解成:
读取 count
 ↓
+1
 ↓
写回 count
它不是一个完整不可分割的原子操作。
2.count++ 为什么不是原子操作
假设 count = 10 。
线程A读取10
线程B读取10
线程A:10 + 1 = 11
线程B:10 + 1 = 11
然后:A写11、B写11
最终看到的是11,正确的结果应该是12才对。
3.volatile 为什么不能解决 count++
即使:
private static volatile int count;
count++仍然是不安全。
因为 volatile 主要解决的是可见性问题,而 ++ 需要的是原子性。
所以:volatile 不等于 synchronized。
6.4 volatile 与有序性
1.什么是指令重排序
为了优化性能,编译器、JIT 和处理器可能对某些操作进行重新排序。
单线程情况下,只要最终结果符合程序语义,一些重排是允许的。
但是:
线程A
线程B
同时观察共享数据时,执行顺序就可能影响结果。
2.volatile 对重排序的影响
volatile 不仅仅涉及可见性,还具有与内存顺序相关的语义,可以阻止某些不允许跨越 volatile 读写的重排序。
现在不用深入:
CPU 指令
内存屏障
StoreLoad
LoadLoad
这些底层细节。
只需要先记住,volatile 除了保证可见性,还对内存操作的有序性提供了重要保证。
6.5 volatile 的典型使用场景
1.线程停止标志
例如:
private volatile boolean running = true;
线程:
while (running) {

}
停止需要把 running 置为 false 。
这是 volatile 非常典型的使用方式。
2.共享状态标志
例如:
private volatile boolean initialized;
一个线程:
initialized = true;
其他线程:
if (initialized) {
    // 使用资源
}
需要多个线程及时看到状态变化时,volatile 就可能非常合适。
7、wait 和 notify
这也是非常重要的知识点,它们定义在 Object 中,而不是 Thread 中。
7.1 wait() 方法
1.wait() 的作用
wait() 的作用可以简单理解为:让当前线程进入等待状态,并释放它当前持有的、与调用 wait() 的对象相关联的监视器锁。。
比如说现在使用 lock.wait(),那么释放的只有 lock 这个锁。
例如:
synchronized (lock) {
    lock.wait();
}
执行流程:
线程A现在持有 lock
 ↓
线程A执行wait()后
 ↓
释放当前线程的 lock
 ↓
进入等待
2.wait() 的基本使用
Object lock = new Object();

synchronized (lock) {
    try {
        lock.wait();
    } catch (InterruptedException e) {
        Thread.currentThread().interrupt();
    }
}
3.wait() 为什么必须配合 synchronized
因为调用某个对象的 wait() 时,当前线程必须已经持有这个对象的监视器锁。
例如:
synchronized (lock) {
    lock.wait();
}
是正确的。
但是:
lock.wait();
如果当前线程没有持有 lock 的监视器,就会产生:
IllegalMonitorStateException
Oracle 官方教程也明确要求 wait() 必须在持有对应对象 intrinsic lock 的情况下调用。
4.wait() 为什么会释放锁
假设:
线程A
 ↓
拿到 lock
 ↓
发现条件不满足
 ↓
wait()
如果 wait 不释放锁:
线程A一直拿着锁
 ↓
线程B无法拿到锁
 ↓
线程B无法修改条件
 ↓
线程A永远等
所以 wait() 后必须要释放锁,这样其他线程才能获取到锁,从而执行其他的代码。
7.2 notify() 方法
1.notify() 的作用
lock.notify();
表示唤醒一个正在等待该对象监视器的线程(随机唤醒的)。
例如:
synchronized (lock) {
    lock.notify();
}
2.被唤醒的线程会发生什么
注意:
notify()
并不意味着被唤醒线程马上执行。
例如:
线程A执行wait()后,进入等待状态

线程B执行notify()
线程A只是从等待队列中被唤醒。
但是线程B此时仍然持有 lock ,线程A必须重新竞争锁 lock ,拿到以后才能继续执行。
Oracle 文档明确说明,被 notify/notifyAll 唤醒的线程并不会立即执行,而是要重新竞争对应的锁。
3.notify 和锁之间的关系
notify() 必须在持有对应对象监视器的情况下调用。
例如:
synchronized (lock) {
    lock.notify();
}
而不是单独的使用:
lock.notify();
4.notify 后线程是否立即执行
不是立即执行的,流程是:
线程B使用notify()
 ↓
线程A被唤醒
 ↓
线程A等待重新获取锁
 ↓
线程B继续执行
 ↓
线程B释放锁
 ↓
线程A竞争锁
 ↓
获得锁
 ↓
继续执行
7.3 notifyAll() 方法
1.notifyAll() 的作用
lock.notifyAll();
会唤醒所有等待该对象监视器的线程。
2.notify() 和 notifyAll() 的区别
notify() 是随机唤醒一个。
notifyAll() 是唤醒全部。
但是,“唤醒全部”不代表“全部同时执行”。
所有线程仍然需要重新竞争锁。
3.为什么有时候需要 notifyAll()
假设:
线程A等待条件1
线程B等待条件2
线程C等待条件3
如果 notify() 只能唤醒一个线程,又刚好唤醒的是不满足当前条件的线程,那么它可能再次等待。
这种情况下,notifyAll() 往往更加稳妥:
唤醒所有等待线程
 ↓
每个线程重新判断条件
 ↓
满足条件的继续
 ↓
不满足条件的继续等待
Oracle 官方的 guarded block 示例也采用 while 配合 wait(),并使用 notifyAll() 进行通知。
7.4 wait 和 sleep 的对比
这是 Java 多线程非常经典的面试题。
| 对比 | wait() | sleep() |
|---|---|---|
| 所属类 | Object | Thread |
| 是否释放锁 | 是 | 否 |
| 是否必须 synchronized | 是 | 否 |
| 主要作用 | 线程协作/等待 | 休眠一段时间 |
| 唤醒方式 | notify/notifyAll/中断等 | 时间结束或中断 |
| 是否需要条件判断 | 通常需要 | 不需要 |
最重要的一条:
wait() 是等待并释放锁

sleep() 是等待但不释放锁
Oracle 官方文档对 wait() 的定义明确包含释放对应监视器锁,而 sleep() 是线程的定时等待机制。
7.5 wait/notify 使用中的常见问题
1.为什么通常使用 while 判断条件
// 推荐
while (!condition) {
    wait();
}

// 不推荐
if (!condition) {
    wait();
}
原因是:线程被唤醒以后,条件不一定仍然满足。
例如:
线程A等待
 ↓
notifyAll()
 ↓
线程A、B、C都被唤醒
 ↓
竞争锁
 ↓
线程A先拿到锁
 ↓
修改条件
 ↓
线程B拿到锁
 ↓
原来的条件可能已经不成立
因此线程重新获得锁以后必须再次检查条件。
Oracle 官方教程明确建议:wait() 应该放在检查条件的循环中,而不是只检查一次。
2.为什么不能随意调用 wait()
因为 wait() 要求当前线程持有对应对象的监视器锁。
所以必须:
synchronized (lock) {
    lock.wait();
}
3.线程被唤醒后的再次竞争
流程应该是这样的:
wait()
 ↓
释放锁
 ↓
等待
 ↓
notify()
 ↓
被唤醒
 ↓
重新竞争锁
 ↓
获得锁
 ↓
继续执行
而不是 notify() 后马上执行。
8、多线程案例
8.1 单例模式
1.什么是单例模式
单例模式是一种设计模式,那么什么又叫做设计模式呢,设计模式就好比象棋中的 “棋谱” ,针对一方的走法,另一个有一些固定的套路来应对他。
单例模式要求:一个类在整个程序运行过程中只能创建一个实例。
例如:
class Singleton {

		// 单例模式中的“点睛之笔”,在类外面进行new操作,就会编译失败
    private Singleton() {
    }

		// 静态成员初始化,在类加载的时候触发
    private static final Singleton INSTANCE = new Singleton();

		// 后面可以通过这个方法来获取实例
    public static Singleton getInstance() {
        return INSTANCE;
    }

}
创建对象的时候:
Singleton s1 = Singleton.getInstance();
Singleton s2 = Singleton.getInstance();
这样可以保证这两个对象都相等。
2.饿汉模式
所谓饿汉,就是类加载时就创建对象。
class Singleton {

    private static final Singleton INSTANCE =
            new Singleton();

    private Singleton() {
    }

    public static Singleton getInstance() {
        return INSTANCE;
    }

}
优点:实现简单、线程安全
缺点:对象可能用不到,但已经创建
3.懒汉模式——单线程版
懒汉模式:真正需要对象时才创建。
class Singleton {

    private static Singleton instance;

    private Singleton() {
    }

    public static Singleton getInstance() {

        if (instance == null) {
            instance = new Singleton();
        }

        return instance;
    }

}
这个代码,在单线程没有问题。
但是多线程环境下:
线程A:instance == null
线程B:instance == null

A:new
B:new
可能创建多个对象。
所以,这个代码单线程正确,不代表多线程正确。
4.懒汉模式——多线程版
在多线程中,可以这样:
public static synchronized Singleton getInstance() {

    if (instance == null) {
        instance = new Singleton();
    }

    return instance;
}
线程A
 ↓
拿锁
 ↓
创建对象

线程B
 ↓
等待

A结束
 ↓
B拿锁
 ↓
发现对象已经存在
这样就可以保证安全。
5.使用 synchronized 改进
synchronized 加在整个方法上,每次获取单例都需要参与同步。
于是可以进一步优化。
6.双重检查锁
经典写法:
class Singleton {

    private static volatile Singleton instance;

    private Singleton() {
    }

    public static Singleton getInstance() {

        if (instance == null) {

            synchronized (Singleton.class) {

                if (instance == null) {
                    instance = new Singleton();
                }
            }
        }

        return instance;
    }

}
这里出现了:
第一次检查
 ↓
加锁
 ↓
第二次检查
 ↓
创建对象
所以叫双重检查锁。
7.为什么双重检查锁需要 volatile
因为这一句代码:
instance = new Singleton();
从概念上并不是简单的一步。
可以粗略理解成:
1. 分配内存
2. 初始化对象
3. 将引用指向对象
volatile 在这里的核心作用是禁止 new Singleton() 中的指令重排序,确保对象在引用赋值之前已经完成了初始化。
因此双重检查锁中的 volatile 是非常重要的。
它不仅提供可见性,还提供必要的有序性保证。
8.2 阻塞队列
1.什么是阻塞队列
普通队列:先进先出(FIFO)
阻塞队列:当队列满了,生产者可以等待;当队列空了,消费者可以等待。
2.为什么需要阻塞
假设队列容量 = 10,如果生产者生产太快导致队列满,这时候生产者不能继续无限添加。
合理做法是等待。
反过来:队列为空,消费者也不能拿数据。
合理做法也是等待。
3.生产者消费者模型
模型如图所示:
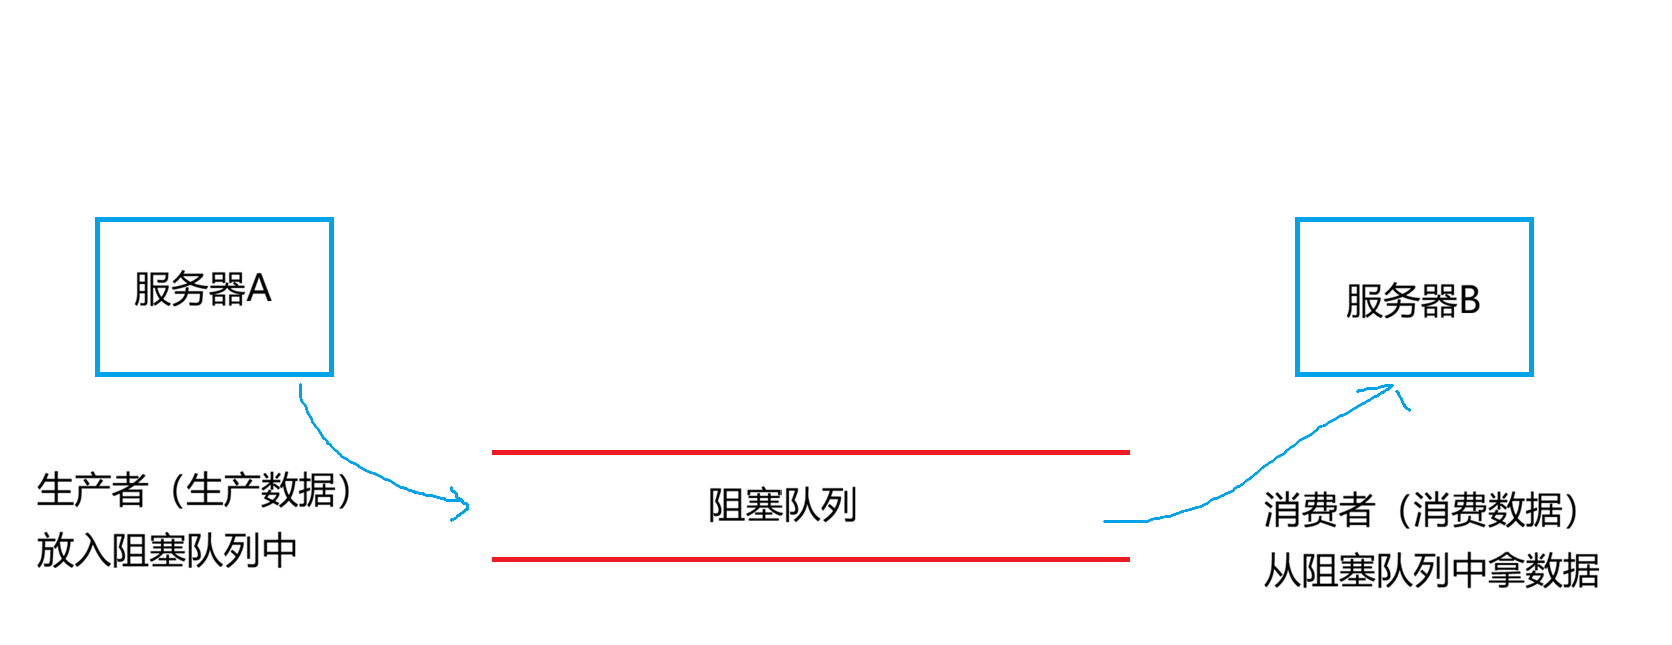
生产者:put()
消费者:take()
4.使用 wait/notify 实现阻塞队列
简单实现:
class MyBlockingQueue {

    private final Queue<Integer> queue = new LinkedList<>();

    private final int capacity = 10;

    public synchronized void put(int value) throws InterruptedException {

        while (queue.size() >= capacity) {
            wait();//等价于this.wait();
        }

        queue.offer(value);

        notifyAll();//等价于this.notifyAll();
    }

    public synchronized int take() throws InterruptedException {

        while (queue.isEmpty()) {
            wait();//等价于this.wait();
        }

        int value = queue.poll();

        notifyAll();//等价于this.notifyAll();

        return value;
    }

}
队列满的时候,生产者 wait ,队列空的时候,消费者 wait 。
生产者添加数据以后,使用 notifyAll() 通知消费者。
消费者取走数据以后,使用 notifyAll() 通知生产者。
5.标准库中的 BlockingQueue
Java 已经提供java.util.concurrent.BlockingQueue。
常见实现:
ArrayBlockingQueue
LinkedBlockingQueue
PriorityBlockingQueue
实际开发中,优先使用标准库提供的并发工具通常比自己从底层实现更加可靠。Oracle 的并发工具文档也强调,标准并发工具能够减少自己实现同步机制时出现死锁、竞态和其他并发错误的风险。
6.使用阻塞队列实现生产者消费者
例如:
BlockingQueue<Integer> queue = new ArrayBlockingQueue<>(10);
生产者:
Thread producer = new Thread(() -> {

    try {

        for (int i = 0; i < 100; i++) {
            queue.put(i);
            System.out.println("生产:" + i);
        }

    } catch (InterruptedException e) {
        Thread.currentThread().interrupt();
    }

});
消费者:
Thread consumer = new Thread(() -> {

    try {

        while (true) {
            Integer value = queue.take();
            System.out.println("消费:" + value);
        }

    } catch (InterruptedException e) {
        Thread.currentThread().interrupt();
    }

});
这就是非常典型的生产者消费者模型。
8.3 定时器
1.什么是定时器
定时器就是:让某个任务在指定时间执行,或者按照一定周期重复执行。
例如:
5秒后执行
每隔1秒执行
每天凌晨执行
2.定时任务的基本需求
例如:每隔1秒打印一次当前时间……
可以使用 Java 提供的定时任务机制。
3.标准库中的 Timer
Java 提供了 Timer 和 TimerTask 。
例如:
Timer timer = new Timer();

timer.schedule(new TimerTask() {

    @Override
    public void run() {
        System.out.println("执行任务");
    }

}, 1000);
表示延迟约 1 秒执行。
4.Timer 和 TimerTask
简单理解:
Timer表示负责调度

TimerTask表示任务
例如:
timer.schedule(task, 1000);
5.使用 ScheduledExecutorService 实现定时任务
现代 Java 并发编程中,更常见的是ScheduledExecutorService。
例如:
ScheduledExecutorService executor =
        Executors.newScheduledThreadPool(1);

executor.schedule(() -> {
    System.out.println("执行任务");
}, 1, TimeUnit.SECONDS);
周期任务:
executor.scheduleAtFixedRate(() -> {
    System.out.println("周期执行");
}, 0, 1, TimeUnit.SECONDS);
6.简单实现一个定时器
public class TimerDemo {

    public static void main(String[] args) {

        ScheduledExecutorService executor =
                Executors.newScheduledThreadPool(1);

        executor.scheduleAtFixedRate(() -> {

            System.out.println(
                    System.currentTimeMillis()
            );

        }, 0, 1, TimeUnit.SECONDS);
    }
}
这样就可以:
启动
 ↓
立即执行
 ↓
1秒
 ↓
执行
 ↓
1秒
 ↓
执行
……
8.4 线程池
1.什么是线程池
假设服务器不断接收到任务:
任务1
任务2
任务3
……
任务10000
如果每个任务都创建线程,一万个任务就要一万个线程,这就导致效率很低,因为线程创建、销毁、调度本身都有成本。
所以可以提前准备一些线程:
线程池:worker1、worker2、worker3、worker4
任务来了以后就直接提交线程池,让线程池安排线程执行。
2.为什么需要线程池
线程池主要解决两个问题:
第一:减少线程创建和销毁的开销
线程可以重复利用。
任务1 → worker1
任务2 → worker1
任务3 → worker1
而不是频繁的创建销毁。
第二:控制线程数量
如果无限制创建线程,任务就会越来越多,从而线程越来越多,这样就导致系统资源被大量消耗。
线程池可以限制和管理线程资源。Oracle 官方文档也指出,线程池能够减少大量线程创建带来的开销,并提供线程资源管理能力。
3.线程池的基本工作原理
提前创建一批线程放在池子里,任务来了复用已有线程,任务结束线程不销毁,等待下一个任务;避免频繁创建 / 销毁线程的开销。
如果线程暂时都忙:
任务
 ↓
任务队列
 ↓
等待线程处理
因此线程池一般包含:
工作线程
任务队列
线程数量控制
拒绝策略
任务提交机制
4.Executor
Java 提供Executor接口。
最核心的方法:
void execute(Runnable command);
例如:
Executor executor = ...;

executor.execute(() -> {
    System.out.println("执行任务");
});
它把任务提交和任务具体由哪个线程执行进行了分离。
5.ExecutorService
这也是一个接口,但ExecutorService 比 Executor 功能更丰富。
例如:
ExecutorService executor = Executors.newFixedThreadPool(3)(3);
提交任务:
executor.submit(() -> {
    System.out.println("执行任务");
});
最后:
executor.shutdown();
关闭线程池。
6.Executors
Executors 这是一个工具类,提供了一些创建线程池的工厂方法。
例如:
Executors.newFixedThreadPool(3);
固定大小线程池。
还有:
Executors.newSingleThreadExecutor();
单线程执行器。
以及:
Executors.newCachedThreadPool();
等。
Oracle 官方教程也介绍了 fixed、cached、single 等线程池工厂方式。
7.ThreadPoolExecutor
更底层、更灵活的线程池实现。
例如:
// 参数列表
public ThreadPoolExecutor(int corePoolSize,
                              int maximumPoolSize,
                              long keepAliveTime,
                              TimeUnit unit,
                              BlockingQueue<Runnable> workQueue,
                              ThreadFactory threadFactory,
                              RejectedExecutionHandler handler)
这里的参数非常重要:
corePoolSize -> 核心线程数,常驻线程

maximumPoolSize -> 最大线程数(核心 + 非核心总和上限)

keepAliveTime -> 非核心线程空闲存活时间

unit -> keepAliveTime 的时间单位

workQueue -> 阻塞队列,存放等待执行的任务

threadFactory -> 线程工厂,用来创建线程,可以自定义线程名字

handler -> 拒绝策略,任务满了之后的处理方案
8.使用线程池执行任务
完整示例:
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;

public class PoolDemo {

    public static void main(String[] args) {

        ExecutorService executor =
                Executors.newFixedThreadPool(3);

        for (int i = 0; i < 10; i++) {

            int taskId = i;

            executor.submit(() -> {

                System.out.println(
                        Thread.currentThread().getName()
                                + " 执行任务:"
                                + taskId
                );
            });
        }

        executor.shutdown();
    }
}
这里的10个任务并不是创建10个线程,而是3个工作线程 + 10个任务,多个任务由线程池中的工作线程复用执行。
9.简单实现一个线程池
为了真正理解线程池,可以自己实现一个非常简化的版本。
思路:
任务队列
   ↓
工作线程
   ↓
不断取任务
   ↓
执行任务
例如:
class MyThreadPool {

    private final BlockingQueue<Runnable> queue = new LinkedBlockingQueue<>();

    public MyThreadPool(int count) {

        for (int i = 0; i < count; i++) {

            Thread thread = new Thread(() -> {

                while (true) {

                    try {

                        Runnable task = queue.take();

                        task.run();

                    } catch (InterruptedException e) {

                        Thread.currentThread().interrupt();
                        break;
                    }
                }
            });

            thread.start();
        }
    }

    public void submit(Runnable task) {

        queue.offer(task);
    }
}
使用:
MyThreadPool pool = new MyThreadPool(3);

for (int i = 0; i < 10; i++) {

    int taskId = i;

    pool.submit(() -> {

        System.out.println(
                Thread.currentThread().getName()
                        + " 执行任务:"
                        + taskId
        );
    });
}
这就是一个非常简化的线程池。
当然,真正的 ThreadPoolExecutor 要复杂得多,它还需要处理这些问题:
核心线程
最大线程
任务队列
空闲超时
拒绝策略
线程工厂
关闭
任务取消
统计信息
9、对比线程和进程
9.1 线程的优点
1.创建和销毁成本相对较低
相比进程,线程共享所属进程的大部分资源。
因此创建和切换线程通常比创建、切换独立进程更加轻量。
2.线程之间共享进程资源
例如:
堆
类信息
打开的资源
进程地址空间中的很多数据
可以由同一个进程中的线程共同访问。
但正因为共享,线程安全问题才会出现。
3.线程之间通信更加方便
同一个进程中的线程可以直接访问共享内存中的对象。
多个线程都可以访问。所以线程之间的数据交换可以比较方便。
但是方便并不代表安全。
必须考虑竞态条件、可见性、原子性、同步。
4.适合执行并发任务
例如服务器:
请求1 -> 线程1
请求2 -> 线程2
请求3 -> 线程3
多个请求可以并发处理。
再例如:
下载
日志
计算
网络 IO
定时任务
都可以利用多线程进行任务组织。
9.2 进程与线程的区别
| 对比 | 进程 | 线程 |
|---|---|---|
| 定义 | 程序运行时的资源和执行实体 | 进程中的执行流 |
| 资源 | 拥有相对独立的资源空间 | 共享所属进程的大部分资源 |
| 内存 | 不同进程通常相互隔离 | 同一进程中的线程共享进程资源 |
| 通信 | 通常需要进程间通信机制 | 可以直接共享内存中的数据 |
| 创建成本 | 相对较高 | 相对较低 |
| 切换成本 | 通常更高 | 通常更低 |
| 安全性 | 进程间隔离更强 | 共享资源带来线程安全问题 |
| 使用场景 | 独立应用、资源隔离 | 并发执行多个任务 |
9.3 一个整体的理解
一个操作系统里面有多个进程,进程里面又包含多个线程。
进程之间相对独立,线程之间共享进程资源。
所以线程的优势:
共享资源方便
创建成本相对较低
适合并发执行
同时也带来了:
线程安全
死锁
可见性
原子性
同步
等一系列问题。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐


 6
 0
- 0


 已为社区贡献1条内容

所有评论(0)