知识库三巨头:RAG vs LLM Wiki vs Ontology 本体深度解析
目录
一、引言:为什么你需要搞懂这三个概念?
2026 年,知识库已经不是"要不要建"的问题,而是"用哪种方案建"的问题。但很多人一提到知识库就只会说 RAG,好像 RAG 是万能解药——丢一堆文档进去,向量检索一拉,大模型一生成就完事了。
九天Hector 在这期视频里提出了一个核心观点:知识库领域有三巨头——RAG、LLM Wiki、Ontology 本体,它们不是替代关系,而是分工完全不同的三种东西。搞不清分工就开干,要么过度开发,要么用错了工具。
"三者不是替代关系,分工完全不同:RAG 负责检索资料,回答找依据;LLM Wiki 负责提前整理、沉淀知识词条,解决文档散乱、版本冲突;Ontology 本体负责定义业务实体与关系,打通多系统业务数据,让规则匹配真实业务对象。"——九天Hector
这篇文章不仅梳理视频内容,还会结合行业最新实践,深度解析这三者的本质区别、适用场景,以及为什么 2026 年的知识库选型逻辑正在发生根本性变化。
二、RAG:检索资料,回答找依据
2.1 RAG 到底在做什么?
RAG(Retrieval-Augmented Generation,检索增强生成)的核心逻辑很简单:你问一个问题,系统先去文档库里检索相关片段,然后把片段塞给大模型,让大模型基于这些片段生成回答。
它的本质是"检索 + 生成"的两步走:
RAG 简化流程 用户提问 → 向量检索 Top-K 文档片段 → 将片段拼入 Prompt → LLM 生成回答
定位非常精准:RAG 负责检索资料,回答找依据。关键词是"依据"——RAG 的价值不是生成答案,而是让答案有出处。每一条回答都能追溯到具体的文档段落,这是它最大的优势。
2.2 RAG 的适用边界
视频明确给出了场景判断:简单文档问答,RAG 足够。
但"足够"两个字背后有严格的适用条件:
| 维度 | RAG 适合 | RAG 不适合 |
|---|---|---|
| 文档规模 | 中等,数百到数千篇 | 海量(数十万篇+)或极少(个位数) |
| 文档更新频率 | 低频更新或基本不变 | 高频实时更新(新闻、行情) |
| 问答类型 | 事实查询、单点知识问答 | 需要跨文档综合推理 |
| 知识深度 | 表层事实检索 | 需要"编译"后的深层知识网络 |
| 维护成本 | 低——建好向量索引后近乎零维护 | — |
2.3 RAG 的根本局限
RAG 存储的是原始文档的切片——"原材料" [](https://developer.aliyun.com/article/1738671)。但人类专家的知识不是原材料的堆砌,而是经过综合、提炼、建立联系的结构化网络。RAG 缺的就是这一步"知识编译"。
具体来说有三个硬伤:
- 没有知识编译:RAG 存的是文档切片,不是提炼后的知识。问到"对比 A 和 B 的优劣",如果 A 和 B 的信息分散在不同文档的不同切片里,RAG 很难把它们拼到同一个上下文窗口中做综合推理 [](https://www.datacamp.com/vi/blog/llm-wiki)
- 没有关系建模:文档之间的关系没有被保存,每次查询时 Agent 需要临时发现、临时综合。复杂问题的回答质量不稳定 [](https://developer.aliyun.com/article/1738671)
- 没有自我进化:用了一年,RAG 库还是那个 RAG 库,不会因为使用次数增多而变聪明 [](https://developer.aliyun.com/article/1738671)
RAG 的认知误区
很多团队沉迷于把公司里又臭又长的文档全部丢进 RAG,期待 Agent 通过检索使其焕发生机。但文档里真正高价值的内容只占很小一部分,低价值资料不会因为被交给 LLM 就变成高价值 [](https://juejin.cn/post/7652284932754145286)。如果你的 Agent 产品总是需要"接入新知识"才能成立,说明使用场景和产品边界还没有想清楚。
三、LLM Wiki:提前整理,沉淀知识词条
3.1 LLM Wiki 是什么?
LLM Wiki 是 Karpathy 在 2026 年提出的概念,核心思想是:不是把原始文档丢给模型检索,而是先由人+AI 共同整理、提炼、沉淀知识词条,形成结构化的知识库,再供 Agent 查询使用 [](https://juejin.cn/post/7652284932754145286)。
九天Hector 给出的定位是:LLM Wiki 负责提前整理、沉淀知识词条,解决文档散乱、版本冲突。它的关键词是"提前整理"和"沉淀"——不是临时检索,而是事先编译。
3.2 LLM Wiki 的核心流程
LLM Wiki 三步流程:原始资料 → 重要结论 → 回查
- 原始资料:收集各种文档、报告、笔记等原始素材
- 重要结论:从原始资料中提炼关键结论,形成知识词条
- 回查:每个结论都能追溯到原始资料,确保可信
关键设计原则
强调了两条核心原则:
- "每个关键结论都保留来源"——保证可审计性
- "冲突和不确定的地方也留下"——不粉饰矛盾,保留知识的不确定性
这意味着 LLM Wiki 不是简单地把文档变短,而是做了一次知识编译:综合、提炼、建立联系,形成结构化的知识网络。原始资料也要保留,因为回查需要它。
3.3 LLM Wiki vs RAG:本质区别
| 维度 | RAG | LLM Wiki |
|---|---|---|
| 存储内容 | 原始文档切片 | 整理后的知识词条 + 原始资料 |
| 知识形态 | 原材料堆砌 | 编译后的结构化知识网络 |
| 检索确定性 | 弱——依赖 Top-K 匹配质量 | 强——基于索引和页面结构逻辑路由 [](https://juejin.cn/post/7652284932754145286) |
| 跨文档综合 | 弱——受限于上下文窗口 | 强——综合已在编译时完成 [](https://www.datacamp.com/vi/blog/llm-wiki) |
| 维护成本 | 低——近乎零维护 | 高——需要持续人工审校、冲突检测 [](https://www.datacamp.com/vi/blog/llm-wiki) |
| Query 时成本 | 高——每次查询都要检索+生成 | 低——知识已预编译,查询时 token 消耗小 [](https://pieteams.github.io/piekbs/ecosystem/paradigm-comparison) |
| 自我进化 | 无——用一年还是那个库 | 有——知识积累和改进 [](https://developer.aliyun.com/article/1738671) |
3.4 LLM Wiki 的适用场景
视频给出的场景判断:文档多、持续更新,长期维护知识库。具体来说:
- 个人长期学习——构建第二大脑,知识随时间积累
- 团队项目复盘——确保组织学习不会随人员流动而流失
- 核心 SOP 固化——高价值领域专家知识需要持续提炼和更新 [](https://juejin.cn/post/7652284932754145286)
何时该从 RAG 升级到 LLM Wiki?
当你的知识库需要"审计"(每个结论必须有出处)、需要"积累"(知识随使用不断丰富)、需要"跨文档综合"(单次检索拼不出完整答案)时,就该从 RAG 升级到 LLM Wiki 了。判断标准很简单:如果 RAG 的回答经常"看不到全局",就是该升级的信号 [](https://www.datacamp.com/vi/blog/llm-wiki)。
四、Ontology 本体:定义业务实体与关系
4.1 Ontology 本体到底在解决什么问题?
视频给出一个很形象的例子——字幕显示:"用户说的'这单'到底是哪一单?"。这个看似简单的问题,在企业系统里是个大麻烦。
想想这个场景:一个用户在客服系统里说"帮我查一下这单",但用户同时有一个订单、一个退款单、一个售后工单——"这单"到底指哪个?如果 AI 不理解业务实体的语义关系,就无法正确理解用户意图。
九天Hector 给出定位:Ontology 本体负责定义业务实体与关系,打通多系统业务数据,让规则匹配真实业务对象。
4.2 Ontology 的核心构成
Ontology(本体)在计算机科学中是指"对特定领域内存在的事物、属性及其关系的形式化描述" [](https://cloud.tencent.com/developer/article/2646437)。用大白话说就是:给业务领域画一张标准化的概念地图,不仅规定有哪些"东西",还规定它们叫什么、有什么属性、彼此是什么关系、遵守什么规则 [](https://developer.cloud.tencent.com/article/2741696)。
一个 Ontology 通常包含三个核心构件 [](https://cloud.tencent.com/developer/article/2646437):
| 构件 | 作用 | 举例 |
|---|---|---|
| Object Type(对象类型) | 定义业务实体的"类" | 客户、订单、商品、退款单 |
| Link Type(链接类型) | 定义实体间的关系(1:1 / 1:N / M:N) | "客户—下过—订单"、"订单—包含—商品" |
| 规则与动作 | 定义业务约束和可执行操作 | 退款金额不能超过订单金额 |
4.3 没有 Ontology 会怎样?
视频字幕提到:"未必能把这个缺口补上"。这个"缺口"指的是业务认知缺口——企业有数据库、有文档、有业务系统,模型也能搜索和问答,但它仍然不知道:
- "这条记录代表谁?"
- "两张表里的对象是不是同一个?"
- "一条规则适用于哪些对象?"
- "这次判断用了什么证据?"
这些问题的本质都是业务语义对齐 [](https://dbaplus.cn/news-73-7469-1.html)。没有 Ontology,每个系统各说各话:
经典场景:同一个"销售额",三个数字
没有 Ontology 的企业里,门店系统说的"销售额"是实付金额,财务系统说的是含税金额,电商后台说的是 GMV——三个数字完全不同,但都叫"销售额"。AI 做跨系统分析时直接懵了 [](https://developer.cloud.tencent.com/article/2741696)。Ontology 就是要解决这种"鸡同鸭讲"的问题。
4.4 Ontology 的适用场景
视频给出的场景判断:跨系统业务判断。具体包括:
- 多系统数据打通——统一业务语义,消除"同名不同义"
- Agent 需要理解业务对象间的语义关系——知道"这单"是哪个单
- 规则引擎需要匹配真实业务对象——不是匹配字符串,是匹配实体 [](https://dbaplus.cn/news-73-7469-1.html)
- 企业级智能体的统一业务语义基座——让 AI 在真实业务语境中理解问题 [](https://www.yonyou.com/subject/yonbip/news/7056)
五、三者关系:不是替代,是分工
5.1 一张表看懂三者分工
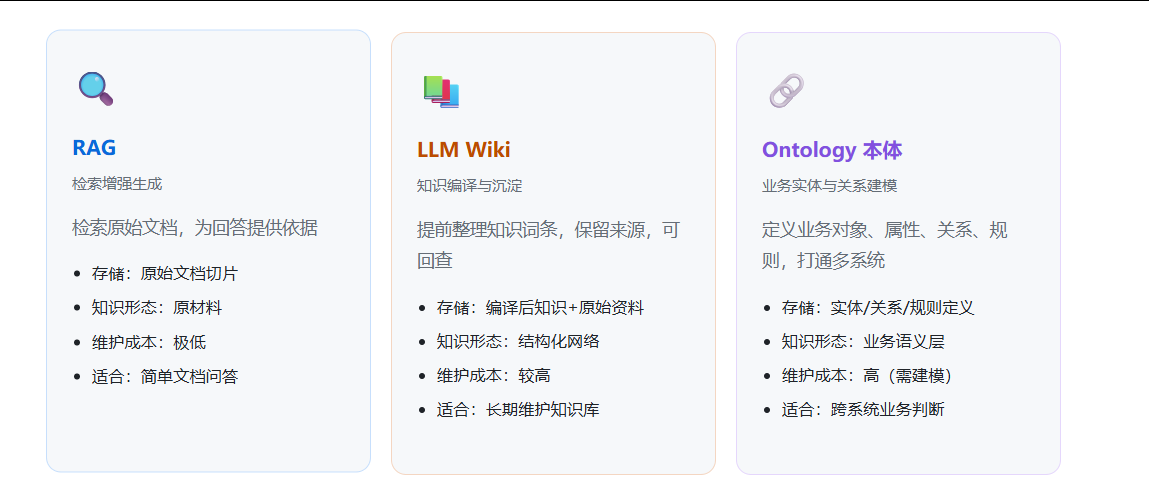
🔍RAG
检索增强生成
检索原始文档,为回答提供依据
- 存储:原始文档切片
- 知识形态:原材料
- 维护成本:极低
- 适合:简单文档问答
📚LLM Wiki
知识编译与沉淀
提前整理知识词条,保留来源,可回查
- 存储:编译后知识+原始资料
- 知识形态:结构化网络
- 维护成本:较高
- 适合:长期维护知识库
🔗Ontology 本体
业务实体与关系建模
定义业务对象、属性、关系、规则,打通多系统
- 存储:实体/关系/规则定义
- 知识形态:业务语义层
- 维护成本:高(需建模)
- 适合:跨系统业务判断
5.2 核心观点:按需选用,避免过度开发
九天Hector 在 04:57 章节里明确强调:三者分工不同,按需选用,避免过度开发。这是一个非常务实的提醒。
实际上,很多人的第一反应是"我全都要"——但这样做几乎一定翻车。原因很简单:这三者的建设和维护成本天差地别:
| 方案 | 建设成本 | 维护成本 | 技术门槛 |
|---|---|---|---|
| RAG | 低(丢文档进向量库) | 极低 | 低 |
| LLM Wiki | 中(需人工整理+编译) | 高(持续审校) | 中 |
| Ontology | 高(需业务建模) | 高(随业务变化) | 高 |
5.3 决策流程图
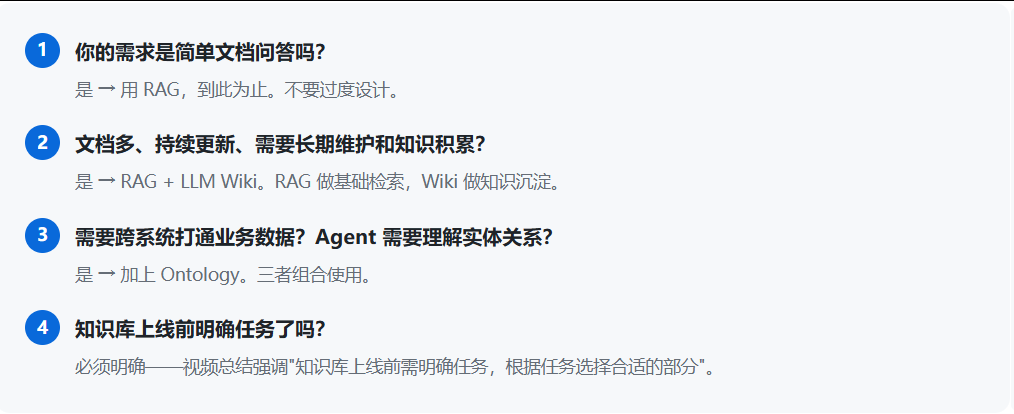
1、你的需求是简单文档问答吗?
是 → 用 RAG,到此为止。不要过度设计。
2、文档多、持续更新、需要长期维护和知识积累?
是 → RAG + LLM Wiki。RAG 做基础检索,Wiki 做知识沉淀。
3、需要跨系统打通业务数据?Agent 需要理解实体关系?
是 → 加上 Ontology。三者组合使用。
4、知识库上线前明确任务了吗?
必须明确——视频总结强调"知识库上线前需明确任务,根据任务选择合适的部分"。
六、深度洞察:视频之外的专家视角
6.1 三者的本质差异:知识的不同"加工深度"
如果用食品加工来类比,三者的区别非常直观:
- RAG = 生鲜超市:存的是原材料(文档切片),你点什么它取什么,不加工。好处是新鲜(实时)、品种全(覆盖广),但你得自己做饭(模型自己综合推理)。
- LLM Wiki = 预制菜中央厨房:原材料经过清洗、切配、调味(知识编译),成品可以直接加热吃(查询时 token 消耗低)。但中央厨房需要持续运营(维护成本高),且预制菜有保质期(需要定期审校更新)。
- Ontology = 菜品标准体系:不是具体的菜,而是定义了"什么叫川菜""麻婆豆腐的原料配比和工艺标准"。它不直接产出答案,但保证所有系统对"菜品"的理解一致。
6.2 2026 年知识库技术趋势预判
结合行业最新动态,我认为有三个趋势值得关注:
趋势一:RAG 的"退场"不是消失,而是下沉为基础设施。RAG 不会消失,但会从"知识库方案的主角"下沉为"底层检索能力"——就像数据库的索引,你不会把它当作产品功能,但每个产品都离不开它。未来 RAG 更可能作为 LLM Wiki 或 Ontology 系统的内部组件存在 [](https://juejin.cn/post/7652284932754145286)。
趋势二:LLM Wiki 的"编译"理念会催生新工具链。就像 IDE 之于编程,LLM Wiki 需要"知识编译器"——自动检测过时结论、发现矛盾内容、生成知识图谱、做 lint 检查。这些工具目前还是空白,是创业和开源的好方向 [](https://www.datacamp.com/vi/blog/llm-wiki)。
趋势三:Ontology 会成为企业 AI 的"操作系统"层。Palantir 的 Foundry、用友的 YonOnto 都在做企业级本体平台 [](https://cloud.tencent.com/developer/article/2646437) [](https://www.yonyou.com/subject/yonbip/news/7056)。未来企业 AI 的竞争,可能不是比谁的模型大,而是比谁的本体建得好——因为本体决定了 AI 能否真正理解业务。
6.3 实践建议
给开发者的三条实践建议
- 先问需求,再选技术。不要"先建 RAG 再找需求"。视频总结反复强调"知识库上线前需明确任务"——这是成本最低但最容易被忽视的一步。
- 从 RAG 起步,按需升级。RAG 的建设成本最低,先用它验证需求是否成立。需求验证后再考虑 LLM Wiki 做知识沉淀,最后在需要跨系统打通时才上 Ontology。
- 警惕"全都要"陷阱。三者同时上的建设成本是 O(n²) 级别的——不是简单叠加,而是两两之间都需要对接。先跑通一条线(比如 RAG→Wiki),再考虑扩展。
七、总结
九天Hector 这期视频的价值在于:它把一个容易混淆的选题讲清楚了——RAG、LLM Wiki、Ontology 本体不是三选一的竞品,而是分工不同的工具。
核心要点回顾:
- RAG = 检索资料,回答找依据。适合简单文档问答,建设成本低,但无知识编译、无关系建模、无自我进化。
- LLM Wiki = 提前整理,沉淀知识词条。适合长期维护知识库,做了"知识编译"让结论可回查、可审计,但维护成本高。
- Ontology 本体 = 定义业务实体与关系,打通多系统。适合跨系统业务判断,解决"同名不同义"问题,但建模门槛高。
- 三者不是替代关系,按需选用,避免过度开发。先明确任务,再选技术。
- 2026 年趋势:RAG 下沉为基础设施,LLM Wiki 的"知识编译"理念催生新工具链,Ontology 成为企业 AI 的语义操作系统。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)