什么是内存分配算法?首次适应、最佳适应、最坏适应
这是“操作系统系列教程”的第三十七篇。前面几篇我们讲了分页、分段、段页式、页表、缺页中断、页面置换算法、内存碎片和交换空间。这些机制解决的是"内存怎么用"的问题。但还有一个更基础的问题没有回答:当程序需要一块内存时,操作系统到底怎么从空闲内存中找到一块合适的区域分配给它?这就是——内存分配算法要解决的问题。
一个"找车位"的问题
先来想象一个场景。你开车去商场,停车场里有很多空位,但大小不一、位置分散。你需要找一个车位停车。你会怎么找?
- 方式一:从入口开始,看到第一个能停进去的车位就停。简单快速,但可能把大车位占用了,后面来了一辆大车就停不进去。
- 方式二:转一圈,找一个大小最接近你车长的车位。浪费最少,但找起来费时间。
- 方式三:找一个最大的车位停进去。这样剩下的车位还很大,但大车位很快就被用完了。
这三种方式,对应操作系统中的三种经典内存分配算法:首次适应(First Fit)、最佳适应(Best Fit)和最坏适应(Worst Fit)。
内存分配算法是操作系统内存管理的基础。无论是分页、分段,还是动态分区,都需要一套算法来决定"从空闲内存中选哪一块"分配给请求者。选得好,内存利用率高,碎片少;选得不好,内存浪费严重,甚至无法满足分配请求。
这篇文章,我们就来把"内存分配算法"这件事讲清楚。
说明:本文涉及动态分区、空闲链表、碎片等概念。初学者如果遇到暂时看不懂的术语,可以先跳过细节,重点理解"操作系统从空闲内存中选一块分配给程序,不同选择策略就是不同的分配算法"这一核心思想。
一、内存分配算法到底是什么?
1.1 从"空闲内存管理"说起
在动态分区分配中,操作系统维护一张空闲分区表或空闲分区链表,记录当前所有空闲内存块的位置和大小。
当程序请求一块大小为 N 的内存时,操作系统需要:
- 在空闲分区表/链表中查找;
- 找到一块大小 ≥ N 的空闲区域;
- 把这块区域的一部分(或全部)分配给程序;
- 更新空闲分区表/链表。
选择哪一块空闲区域,就是内存分配算法的核心问题。
1.2 内存分配算法的定义
给出一个正式的定义:
内存分配算法是操作系统在收到内存分配请求时,从空闲内存区域中选择一块合适的区域分配给请求者的策略。不同的选择策略会影响内存利用率、碎片数量和分配速度。
这个定义里有四个关键点:
- 分配请求:程序请求一块内存;
- 空闲区域:操作系统维护的空闲内存块;
- 选择策略:决定用哪一块;
- 影响:影响内存利用率、碎片和性能。
1.3 内存分配算法在系统中的位置
图 1:内存分配算法在系统中的位置。 操作系统通过分配算法从空闲区域中选择一块分配给程序。
二、内存分配的三种基本策略
内存分配算法有很多种,但最基础、最经典的是三种:首次适应、最佳适应和最坏适应。它们的思想可以用一句话概括:
| 算法 | 核心思想 |
|---|---|
| 首次适应 | 找第一个够大的空闲块 |
| 最佳适应 | 找最接近请求大小的空闲块 |
| 最坏适应 | 找最大的空闲块 |
接下来,我们逐一详细讲解。
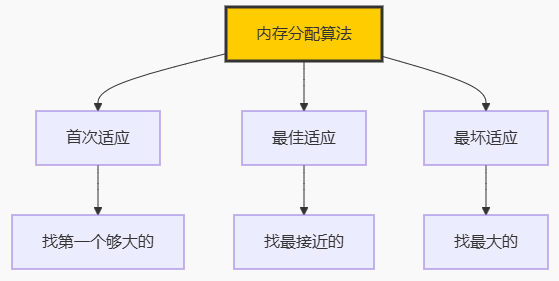
图 2:三种基本内存分配算法。
三、首次适应算法(First Fit)
3.1 算法思想
首次适应(First Fit)的核心思想是:从空闲分区链表的头部开始查找,找到第一个大小 ≥ 请求大小的空闲块,就分配给它。
简单来说,就是"第一个够大的就给它"。
3.2 算法流程
图 3:首次适应算法的流程。
3.3 一个具体的例子
假设空闲分区链表如下(按地址顺序):
| 空闲块 | 起始地址 | 大小 |
|---|---|---|
| A | 0x0000 | 100KB |
| B | 0x1000 | 50KB |
| C | 0x2000 | 200KB |
| D | 0x3000 | 80KB |
现在有一个程序请求 60KB 内存。
首次适应算法从头开始遍历:
- 块 A(100KB)≥ 60KB,选中 A;
- 从 A 中分配 60KB,剩余 40KB;
- 更新空闲链表:A 变为 40KB,B、C、D 不变。
图 4:首次适应算法示例。 请求 60KB,选中第一个够大的块 A。
3.4 首次适应的优缺点
| 优点 | 说明 |
|---|---|
| 实现简单 | 从头遍历,找到就分配 |
| 速度快 | 通常不需要遍历整个链表 |
| 大块保留 | 倾向于保留高地址的大空闲块 |
| 缺点 | 说明 |
|---|---|
| 低地址碎片多 | 低地址区域容易被反复分割,产生大量小碎片 |
| 分配不均匀 | 高地址区域很少被使用 |
关键特点:首次适应算法倾向于优先使用低地址的空闲区域,导致低地址区域碎片化严重,高地址区域保留大块空闲。
四、最佳适应算法(Best Fit)
4.1 算法思想
最佳适应(Best Fit)的核心思想是:遍历整个空闲分区链表,找到大小最接近请求大小的空闲块,分配给它。
简单来说,就是"最合适的就给它"。这样分配的剩余空间最小,浪费最少。
4.2 算法流程
图 5:最佳适应算法的流程。
4.3 一个具体的例子
同样假设空闲分区链表如下:
| 空闲块 | 起始地址 | 大小 |
|---|---|---|
| A | 0x0000 | 100KB |
| B | 0x1000 | 50KB |
| C | 0x2000 | 200KB |
| D | 0x3000 | 80KB |
程序请求 60KB 内存。
最佳适应算法遍历整个链表:
- 块 A(100KB)≥ 60KB,候选,剩余 40KB;
- 块 B(50KB)< 60KB,跳过;
- 块 C(200KB)≥ 60KB,候选,剩余 140KB;
- 块 D(80KB)≥ 60KB,候选,剩余 20KB;
- 选择剩余最小的块 D,分配 60KB,剩余 20KB。
图 6:最佳适应算法示例。 请求 60KB,选中剩余最小的块 D。
4.4 最佳适应的优缺点
| 优点 | 说明 |
|---|---|
| 浪费最少 | 分配的剩余空间最小 |
| 内存利用率高 | 每次分配都尽可能"刚好" |
| 缺点 | 说明 |
|---|---|
| 外部碎片多 | 每次分配都留下很小的碎片 |
| 速度慢 | 需要遍历整个链表 |
| 小碎片无法利用 | 留下的碎片往往太小,无法再分配 |
关键特点:最佳适应算法每次都选择"最合适"的块,但留下的碎片也最小,最终会积累大量无法利用的小碎片,反而降低内存利用率。这就是所谓的"最佳适应算法并不最佳"。
五、最坏适应算法(Worst Fit)
5.1 算法思想
最坏适应(Worst Fit)的核心思想是:遍历整个空闲分区链表,找到最大的空闲块,分配给它。
简单来说,就是"最大的就给它"。这样分配的剩余空间仍然很大,可以继续被利用。
5.2 算法流程
图 7:最坏适应算法的流程。
5.3 一个具体的例子
同样假设空闲分区链表如下:
| 空闲块 | 起始地址 | 大小 |
|---|---|---|
| A | 0x0000 | 100KB |
| B | 0x1000 | 50KB |
| C | 0x2000 | 200KB |
| D | 0x3000 | 80KB |
程序请求 60KB 内存。
最坏适应算法遍历整个链表:
- 最大的块是 C(200KB),选中 C;
- 从 C 中分配 60KB,剩余 140KB;
- 更新空闲链表:C 变为 140KB。
图 8:最坏适应算法示例。 请求 60KB,选中最大的块 C。
5.4 最坏适应的优缺点
| 优点 | 说明 |
|---|---|
| 剩余块大 | 分配后剩余空间仍较大,可继续利用 |
| 减少小碎片 | 避免产生太小无法使用的碎片 |
| 缺点 | 说明 |
|---|---|
| 大块很快耗尽 | 最大的块被反复分割,很快就没有大块了 |
| 速度慢 | 需要遍历整个链表 |
| 不适合大请求 | 大块耗尽后,大请求无法满足 |
关键特点:最坏适应算法每次都"砍"最大的块,导致大块很快消失。当后续有大请求时,可能无法满足。
六、三种算法的对比
6.1 用一个例子对比
假设空闲分区链表如下:
| 空闲块 | 大小 |
|---|---|
| A | 100KB |
| B | 50KB |
| C | 200KB |
| D | 80KB |
依次有请求:60KB、40KB、100KB。
首次适应:
- 60KB:选 A(100KB),剩余 40KB;
- 40KB:选 A 剩余(40KB),刚好;
- 100KB:选 C(200KB),剩余 100KB。
最佳适应:
- 60KB:选 D(80KB),剩余 20KB;
- 40KB:选 B(50KB),剩余 10KB;
- 100KB:选 C(200KB),剩余 100KB。
最坏适应:
- 60KB:选 C(200KB),剩余 140KB;
- 40KB:选 C 剩余(140KB),剩余 100KB;
- 100KB:选 A(100KB),刚好。
6.2 综合对比
| 对比项 | 首次适应 | 最佳适应 | 最坏适应 |
|---|---|---|---|
| 查找方式 | 从头找到第一个够大的 | 遍历找最接近的 | 遍历找最大的 |
| 查找速度 | 快 | 慢 | 慢 |
| 剩余碎片 | 低地址碎片多 | 小碎片多 | 大块耗尽快 |
| 内存利用率 | 较高 | 理论最高,实际较低 | 较低 |
| 大请求支持 | 好(保留大块) | 中 | 差(大块耗尽) |
| 实现复杂度 | 简单 | 中等 | 中等 |
| 实际应用 | 常用 | 较少 | 较少 |
图 9:三种内存分配算法的对比。
6.3 结论
首次适应算法通常是最好的选择,因为:
- 实现简单,速度快;
- 内存利用率较高;
- 保留高地址的大块,有利于大请求。
最佳适应算法理论上浪费最少,但实际效果往往不好,因为它产生大量小碎片。
最坏适应算法很少使用,因为它很快耗尽大块,不利于后续大请求。
七、其他内存分配算法
除了三种基本算法,还有一些改进算法。
7.1 循环首次适应(Next Fit)
循环首次适应(Next Fit)是首次适应的改进版:不是每次从头开始查找,而是从上次分配的位置继续查找。
优点:分配更均匀,避免低地址碎片化。
缺点:大块可能被过早分割。
7.2 快速适应(Quick Fit)
快速适应(Quick Fit)维护多个空闲链表,每个链表对应一种常用大小。分配时直接在对应链表中查找。
优点:分配速度快。
缺点:链表维护复杂,合并困难。
7.3 伙伴系统(Buddy System)
伙伴系统(Buddy System)把内存按 2 的幂次划分,分配时找到最接近的 2 的幂次块。释放时,如果相邻的"伙伴"也空闲,就合并。
优点:分配和释放快,合并简单。
缺点:内部碎片较大(只能分配 2 的幂次大小)。
| 算法 | 优点 | 缺点 |
|---|---|---|
| 循环首次适应 | 分配均匀 | 大块易分割 |
| 快速适应 | 分配快 | 维护复杂 |
| 伙伴系统 | 合并简单 | 内部碎片大 |
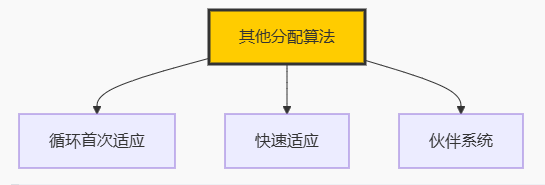
图 10:其他常见的内存分配算法。
八、实际应用
8.1 Linux 中的内存分配
Linux 内核使用多种分配器:
| 分配器 | 用途 |
|---|---|
| 伙伴系统 | 管理物理页框 |
| slab 分配器 | 管理小对象 |
| slub 分配器 | slab 的改进版,现代内核默认 |
| vmalloc | 分配虚拟地址连续但物理不连续的内存 |
8.2 用户态 malloc
C 标准库的 malloc() 底层使用内存分配器,如:
- ptmalloc:glibc 默认分配器;
- jemalloc:Facebook 开发,适合多线程;
- tcmalloc:Google 开发,高性能。
这些分配器内部使用多种策略,包括首次适应、快速适应等。
// malloc 底层可能使用首次适应
void *ptr = malloc(1024);
// 分配器从空闲链表中找一块合适的
8.3 数据库中的内存分配
数据库系统有自己的内存池管理,通常使用伙伴系统或slab 分配器,减少碎片并提高分配速度。
图 11:内存分配算法的实际应用。
九、常见误区澄清
| 误区 | 真相 |
|---|---|
| “最佳适应算法是最好的” | 理论上浪费最少,但实际产生大量小碎片 |
| “首次适应算法效率低” | 实际上首次适应速度快,内存利用率较高 |
| “最坏适应算法能减少碎片” | 它减少小碎片,但很快耗尽大块 |
| “所有分配算法都用链表” | 也有位图、树等实现方式 |
| “分配算法只影响速度” | 还影响内存利用率和碎片 |
| “伙伴系统没有碎片” | 有内部碎片,只能分配 2 的幂次大小 |
| “malloc 就是系统调用” | malloc 是库函数,底层调用 brk/mmap |

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐

 0
 0
- 0


 已为社区贡献32条内容

所有评论(0)