Linux内核驱动模块开发入门:Hello模块实战

简介:Linux内核驱动模块是用于扩展操作系统功能的代码段,可以在不重启系统的前提下动态加载或卸载。本教程以一个基础的"hello"模块为例,详细讲解了编写和编译内核模块的流程,包括模块的入口和出口函数、编程使用的特定头文件和函数,以及如何通过Makefile组织多文件编译。本模块旨在帮助初学者快速了解内核编程的基础知识,并掌握编译、加载和卸载Linux内核模块的基本技能。 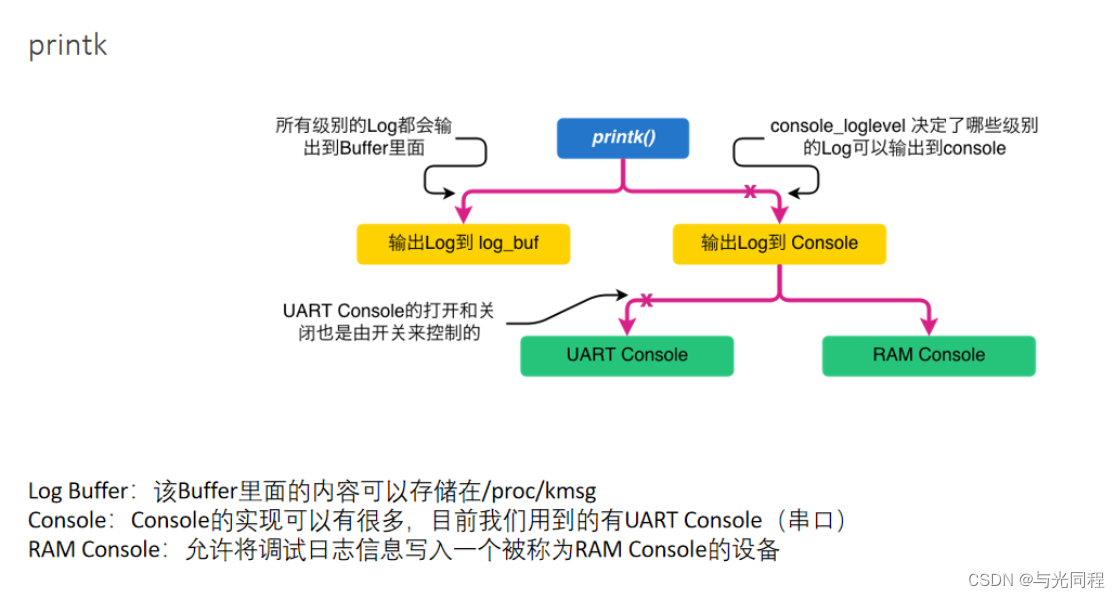
1. Linux内核驱动模块概念及动态加载特性
Linux内核驱动模块简介
在Linux操作系统中,内核驱动模块是一种特殊的程序,它可以在系统运行时动态地加载到内核中,也可以从内核中卸载,而无需重新启动系统。Linux内核驱动模块的主要作用是扩展内核功能,实现硬件设备的驱动程序、文件系统等核心功能的模块化管理。内核驱动模块可以根据其功能和作用被分类为文件系统模块、设备驱动模块、网络协议模块等。
动态加载特性探究
动态加载的原理是通过函数 request_module() 实现的,它允许内核在运行时请求加载指定的模块。动态加载的主要优势包括: - 减小了初始内核的大小,因为不需要将所有可能用到的功能都编译进内核映像。 - 提高了系统的灵活性和可维护性,因为可以独立于内核更新和修复模块。 - 允许热插拔,即在运行中的系统插入或移除硬件设备时,系统能够动态地加载或卸载相应的设备驱动模块。
模块化的优点是它让Linux内核保持了高度的灵活性和可扩展性,应用场景广泛,比如添加对新型硬件的支持、对系统进行功能增强或优化等。
2. hello模块编写与编译过程
hello模块编写基础
编写一个内核模块可以看作是学习Linux内核编程的“Hello World”。内核模块允许开发者在不重新编译整个内核的情况下,向内核中添加或删除代码。其核心是一个C语言编写的源文件,里面定义了模块加载(module_init)和卸载(module_exit)时的函数。
编写第一个内核模块的步骤
编写内核模块需要遵循一系列的步骤。首先,需要包含一个头文件 <linux/module.h> ,它提供了模块加载和卸载的相关宏定义。接着,定义两个函数,分别对应模块加载时执行的函数(通常是module_init宏指定的函数)和模块卸载时执行的函数(通常是module_exit宏指定的函数)。这两个函数分别代表模块的入口点和出口点。
下面是一个简单的内核模块示例代码:
#include <linux/module.h>       // 必须包含的头文件
#include <linux/kernel.h>       // 包含KERN_INFO等日志级别

MODULE_LICENSE("GPL");          // 指定模块的许可证
MODULE_AUTHOR("Your Name");     // 模块作者信息
MODULE_DESCRIPTION("A simple Hello World module."); // 模块描述信息

static int __init hello_start(void) {
    printk(KERN_INFO "Loading hello module...\n");
    printk(KERN_INFO "Hello world\n");
    return 0;
}

static void __exit hello_end(void) {
    printk(KERN_INFO "Goodbye Mr.\n");
}

module_init(hello_start);
module_exit(hello_end);
在上述代码中, __init 和 __exit 宏用于优化内核空间的内存使用。 module_init 和 module_exit 宏分别指定模块加载和卸载时调用的函数。
模块代码的基本结构和要求
在编写模块时,代码结构应遵循以下几点: - 必须包含 <linux/module.h> 以支持模块化功能。 - 模块加载和卸载函数的声明和定义需要严格规范。 - 模块应包含一些基本信息,如许可证、作者和描述。 - 代码风格应遵循Linux内核代码的规范,以便于维护和阅读。
编译hello模块
内核模块的编译与普通应用程序的编译有所不同。它依赖于Linux内核的源码和相应的构建系统。
配置Linux内核源码环境
编译内核模块前需要确保系统安装了内核头文件和构建工具。这可以通过安装 linux-headers 和 build-essential 包来完成。一旦安装这些工具和头文件,配置内核源码环境就相对直接了当了。通常,开发者会根据内核版本,从官方仓库下载或从源码编译内核,并确保构建环境配置正确。
在终端中执行以下命令进行环境配置:
sudo apt-get install linux-headers-$(uname -r) build-essential
使用gcc进行模块编译
一旦环境准备就绪,接下来就可以使用gcc编译内核模块。通常,内核模块的编译会使用内核提供的Makefile模板。在模块的源码目录下,通常需要创建一个 Makefile 文件,其内容大致如下:
obj-m += hello.o

all:
    make -C /lib/modules/$(shell uname -r)/build M=$(PWD) modules

clean:
    make -C /lib/modules/$(shell uname -r)/build M=$(PWD) clean
上述Makefile文件定义了目标 obj-m ,其值为 hello.o ,表明要将 hello.c 编译成内核模块。接下来是两个目标: all 和 clean 。 all 目标利用内核构建系统调用make命令,构建模块。 clean 目标执行清理工作,移除编译生成的目标文件。
编译命令执行如下:
make
成功编译后,你将得到一个名为 hello.ko 的内核模块文件,这个文件可以在加载到内核时执行。
以上步骤是内核模块编写和编译的基础流程。在后续的章节中,将更深入地介绍模块编程的高级技巧和最佳实践。
3. 模块入口和出口函数的使用
在Linux内核模块编程中,入口和出口函数扮演着至关重要的角色。它们分别在模块加载和卸载时被调用,成为模块与内核通信的首要接口。深入理解并正确使用这些函数,对于编写稳定且高效的内核模块是不可或缺的。
模块入口函数的重要性
模块加载时的入口点
模块入口点是模块被加载到内核时最先执行的函数。通常这个函数会被命名为 init_module ,它负责初始化模块需要的所有资源。比如注册设备号、申请内核内存、创建内核线程等。这个函数的原型如下:
int init_module(void) {
    // 初始化模块资源代码
    return 0; // 返回0表示初始化成功
}
模块入口函数的返回值非常关键,返回0表示模块加载成功,任何非零值都表示加载失败,内核将不会加载这个模块。
函数init_module()的实现与注意点
编写 init_module 函数时,需要注意以下几点:
- 必须要检查所有内核函数调用的返回值,确保初始化过程中的每一步都成功执行。
- 在函数体内应尽量避免使用可能失败的操作,特别是在模块卸载时不会执行清理操作的情况下。
- 使用
module_init()宏来标记入口函数,这是推荐的做法,它可以帮助内核自动识别模块的入口点。
module_init(init_module);
模块在加载时,内核会调用指定的入口函数。如果入口函数因为某些原因失败了,模块将不会被加载,你需要提供足够的错误处理逻辑以确保内核稳定运行。
模块出口函数的作用
模块卸载时的出口点
与入口函数相对应,模块的出口函数是模块被卸载时执行的函数。这个函数一般命名为 cleanup_module ,它负责释放模块分配的所有资源。这包括注销设备号、释放内核内存、停止内核线程等。
void cleanup_module(void) {
    // 清理模块资源代码
}
函数cleanup_module()的实现与注意点
在实现 cleanup_module 时,需要注意以下几点:
- 必须确保所有由模块申请的资源都被妥善释放,避免内存泄漏和内核崩溃。
- 清理函数应该能够处理由于某些原因未能完全初始化的资源。
- 使用
module_exit()宏来标记出口函数,这样可以确保内核在卸载模块时能够调用正确的清理函数。
module_exit(cleanup_module);
出口函数是模块生命周期的终点,因此它的重要性不言而喻。确保在模块卸载时,所有资源都被正确释放,对于维护系统的稳定性和可靠性至关重要。
使用代码块展示模块入口和出口函数的使用
下面是一个简单的示例代码,展示了如何定义和使用模块入口和出口函数:
#include <linux/module.h>   // 必须的,支持动态添加和卸载内核模块
#include <linux/kernel.h>   // 包含了KERN_INFO等内核日志级别宏定义

// 模块入口函数
static int __init my_module_init(void) {
    printk(KERN_INFO "Loading my_module...\n");
    // 这里放置模块加载时需要执行的代码
    return 0;
}

// 模块出口函数
static void __exit my_module_exit(void) {
    printk(KERN_INFO "Unloading my_module...\n");
    // 这里放置模块卸载时需要执行的清理代码
}

module_init(my_module_init);
module_exit(my_module_exit);

MODULE_LICENSE("GPL"); // 指定许可证
MODULE_AUTHOR("Your Name"); // 指定作者
MODULE_DESCRIPTION("A simple example Linux module."); // 模块描述
MODULE_VERSION("0.1"); // 模块版本号
在上面的代码中,我们使用了 module_init 和 module_exit 宏来明确指定入口和出口函数,同时使用 printk 来输出日志信息。这些日志信息可以在内核日志中查看,帮助我们了解模块的加载和卸载状态。
在定义模块加载和卸载函数时,始终要考虑到错误处理和资源释放的重要性。在入口函数中,你应确保所有资源分配成功;在出口函数中,要确保所有资源被正确释放,以此保证系统的稳定和安全。
通过以上示例,可以看到模块入口和出口函数是内核模块编程中不可或缺的部分。通过它们,模块能够在系统中注册自身,并在不再需要时优雅地退出,为系统维护和资源管理提供了便利。通过合理的编码实践和细致的错误处理,你可以编写出更加健壮和高效的Linux内核模块。
4. C语言内核编程的关键头文件和函数
内核编程的关键头文件
包含内核特有数据类型和宏定义的头文件
在Linux内核编程中,特定的数据类型和宏定义是必不可少的。这些定义通常包含在特定的头文件中,为内核开发人员提供了丰富的资源。比如, <linux/types.h> 头文件定义了标准的整数类型如 u8 、 u16 、 u32 、 u64 等,以及内核使用的指针类型别名如 void __user * 。这些类型的使用确保了代码的可移植性和一致性。
#include <linux/types.h>

void my_function(u32 number) {
    // 使用类型u32
}
这段代码展示了如何包含并使用内核定义的无符号32位整数类型 u32 。在内核中,使用这些类型比直接使用标准类型(如 unsigned int )更为常见,这有助于确保代码在不同的平台和架构之间保持一致性。
指定模块加载卸载函数的头文件
为了实现模块的动态加载和卸载,内核提供了两个主要的入口点: init_module() 和 cleanup_module() 。这些函数需要在模块的代码中进行声明,通常这个声明是通过包含 <linux/module.h> 头文件来实现的。
#include <linux/module.h>

static int __init my_module_init(void) {
    // 模块初始化代码
    return 0;
}

static void __exit my_module_exit(void) {
    // 模块卸载代码
}

module_init(my_module_init);
module_exit(my_module_exit);
在这段示例代码中,我们看到通过 module_init() 和 module_exit() 宏来指定模块的入口和出口函数。这样内核在加载模块时会调用 my_module_init() 函数,在卸载模块时会调用 my_module_exit() 函数。这里也使用了 __init 和 __exit 标记宏来指示这些函数仅在模块初始化和卸载时使用,以优化内核空间的内存使用。
内核编程常用函数
内存分配与释放函数
在内核空间进行动态内存分配时,不能使用用户空间的 malloc() 和 free() 函数。相反,内核提供了如 kmalloc() 和 kfree() 等函数来分配和释放内核内存。
#include <linux/slab.h>

void *my_allocation = kmalloc(1024, GFP_KERNEL);
if (!my_allocation) {
    // 分配失败处理
}

// ... 使用分配的内存 ...

kfree(my_allocation);
在这段代码中, kmalloc() 用于分配1024字节的内存,并且指定了 GFP_KERNEL 标志,表示内核将要使用这个内存。分配成功后,我们得到一个指针 my_allocation ,用来访问内存。使用完毕后,必须通过 kfree() 释放这段内存,以避免内存泄漏。
错误处理与状态报告函数
内核提供了如 printk() 这样的函数用于内核空间的日志记录。 printk() 类似于用户空间的 printf() ,但是更为精简,并且能够将日志信息输出到内核日志缓冲区,然后可以通过 dmesg 命令查看。
#include <linux/kernel.h>

int result = do_something_complex();
if (result) {
    printk(KERN_ERR "Error during operation: %d\n", result);
    return -EINVAL; // 返回错误代码
}
在这段示例代码中,如果 do_something_complex() 函数执行失败,我们通过 printk() 记录错误信息,并返回一个负的错误代码。使用 KERN_ERR 作为优先级参数,表示这个信息是一个错误信息。
需要注意的是,内核编程与用户空间编程在错误处理和内存管理上有很大的不同。在内核中进行内存分配时,分配失败不能依赖于异常处理机制(如抛出异常),而应当进行适当的错误检查和处理。同样,错误代码通常以负数形式返回,以区分正常状态(通常是0)。这样的处理方式保证了系统的健壮性和稳定性。
5. printk()函数在内核日志记录中的应用
printk()函数基础
printk()函数的参数和格式化
printk() 函数是Linux内核中用于日志记录的核心函数,类似于标准C库中的 printf() 函数。不过,它的输出目标是内核日志缓冲区(Kernel Ring Buffer),而不是标准输出流。
#include <linux/kernel.h>
#include <linux/module.h>
#include <linux/init.h>

MODULE_LICENSE("GPL");
MODULE_AUTHOR("Your Name");

static int __init hello_start(void)
{
    printk(KERN_INFO "Hello, world! This is kernel speaking.\n");
    return 0;
}

static void __exit hello_end(void)
{
    printk(KERN_INFO "Goodbye, world! I'm leaving.\n");
}

module_init(hello_start);
module_exit(hello_end);
在上面的代码中, KERN_INFO 是一个日志级别宏,它定义了消息的重要性。 printk 的第一个参数是日志级别,之后是消息内容。日志级别由高到低依次为 KERN sürek 、 KERN_CRIT 、 KERN_ERR 、 KERN_WARNING 、 KERN_NOTICE 、 KERN_INFO 和 KERN_DEBUG 。
日志级别的使用和意义
在内核模块开发中,合理使用日志级别可以帮助我们更好地理解系统运行情况和调试代码。不同的日志级别能够帮助开发者快速定位问题所在。例如:
- 使用
KERN_ERR记录错误信息,提示模块或内核遇到了严重的错误。 - 使用
KERN_WARNING记录警告信息,这些信息不一定是错误,但可能会引起注意。 - 使用
KERN_INFO记录常规信息,如模块加载和卸载的日志。
开发者应该根据需要记录的日志类型选择合适的日志级别,以避免产生过多不必要的信息。
内核日志的查看与分析
使用dmesg命令查看日志信息
dmesg 命令用于查看内核的环形缓冲区中的信息。这个命令可以用来获取系统启动信息,查看硬件信息,以及查找和分析内核消息。
dmesg | less
使用 dmesg 命令时,添加 | less 可以方便地逐页浏览输出信息。
分析日志信息来调试模块
通过 dmesg 获取的日志信息,可以帮助开发者发现和解决内核模块开发过程中遇到的问题。例如,如果模块加载失败, dmesg 可能会输出错误信息和失败原因。下面是一个示例输出:
[  123.456789] Hello, world! This is kernel speaking.
[  123.467890] ERROR: Failed to allocate some resource.
[  123.467991] Goodbye, world! I'm leaving.
在上述日志中,我们可以看到模块加载时成功输出了一条信息,但之后出现了一个资源分配失败的错误,最终模块卸载时输出了另一条信息。通过分析这些信息,可以指导开发者进行进一步的调试工作。
示例:记录和查看自定义日志信息
让我们来看一个 printk 的更实际使用场景。下面是一个模块初始化和退出时记录不同级别的日志信息的例子:
#include <linux/kernel.h>
#include <linux/module.h>
#include <linux/init.h>

MODULE_LICENSE("GPL");
MODULE_AUTHOR("Your Name");

static int __init example_init(void)
{
    printk(KERN_DEBUG "Debug message.\n");
    printk(KERN_INFO "Info message.\n");
    printk(KERN_WARNING "Warning message.\n");
    printk(KERN_ERR "Error message.\n");
    return 0;
}

static void __exit example_exit(void)
{
    printk(KERN_DEBUG "Bye debug.\n");
    printk(KERN_INFO "Bye info.\n");
}

module_init(example_init);
module_exit(example_exit);
编译并加载该模块后,我们可以使用 dmesg 命令查看输出的日志信息:
dmesg | grep "example"
搜索包含"example"的关键字信息,可以看到如下输出:
[  123.456789] Debug message.
[  123.456790] Info message.
[  123.456791] Warning message.
[  123.456792] Error message.
通过这种方式,我们可以更深入地了解系统如何记录和管理内核消息,进而更有效地使用 printk() 函数进行开发和调试。
以上内容详细介绍了 printk() 函数的参数使用、日志级别的意义以及如何查看和分析内核日志。这些信息对于开发Linux内核模块至关重要,可以帮助开发者记录和追踪程序运行时的详细信息,进而进行有效的调试和错误诊断。
6. Makefile的编写与多文件项目编译组织
在Linux内核开发中,Makefile是一个非常关键的部分,它定义了如何编译和链接项目。一个正确编写的Makefile能够高效地组织多个源文件和目标文件,使得整个编译过程自动化且易于管理。本章我们将深入探讨Makefile编写基础和多文件项目的编译组织。
Makefile编写基础
Makefile的作用和基本语法
Makefile描述了整个项目的编译规则和流程。它告诉 make 程序如何编译和链接程序,哪些文件需要先编译,如何处理依赖关系等等。
Makefile的基本组成包括:
- 目标(target)
- 依赖(dependencies)
- 命令(commands)
示例语法:
target: dependencies
        commands
解释:
-
target:通常是需要生成的文件名。 -
dependencies:生成目标所需的文件。 -
commands:实际的编译命令。
编写针对内核模块的Makefile文件
内核模块的Makefile需要遵循特定的格式,以便内核的构建系统能够正确识别和编译。以下是一个简单的内核模块Makefile示例:
obj-m += mymodule.o
all:
    make -C /lib/modules/$(shell uname -r)/build M=$(PWD) modules
clean:
    make -C /lib/modules/$(shell uname -r)/build M=$(PWD) clean
参数解释:
-
obj-m:声明需要构建成模块的对象文件。 -
make -C:切换到指定目录并执行make命令。 -
M=$(PWD):指定当前目录为模块构建位置。 -
clean:清理编译生成的文件。
多文件项目的编译组织
在处理具有多个源文件和头文件的项目时,Makefile变得尤为重要,它能管理复杂的依赖关系。
处理多个源文件的编译和链接
假设项目中有三个源文件: mymodule.c 、 helper.c 和 support.c ,对应的头文件为 mymodule.h 、 helper.h 和 support.h 。我们可以创建一个Makefile如下:
obj-m += mymodule.o

mymodule-objs := mymodule.o helper.o support.o

all:
    make -C /lib/modules/$(shell uname -r)/build M=$(PWD) modules

clean:
    make -C /lib新规/modules/$(shell uname -r)/build M=$(PWD) clean
参数解释:
-
mymodule-objs:列出模块依赖的所有对象文件。
模块化编程中Makefile的进阶使用
在更复杂的项目中,可能需要使用变量、模式规则以及条件判断等高级特性。以下是一个进阶的Makefile示例:
# 变量定义
SRC := $(wildcard *.c)
OBJ := $(SRC:.c=.o)
MOD := $(OBJ:.o=.ko)

# 默认目标
all: $(MOD)

# 模块构建规则
%.o: %.c
    $(CC) -c -o $@ $< -I$(shell pwd)

# 链接模块
%.ko: %.o
    $(LD) -r -o $@ $^

# 清理规则
clean:
    rm -rf *.o *.ko

# 全局依赖
.PHONY: all clean
解释:
-
SRC:获取所有.c文件。 -
OBJ和MOD:分别生成对应的.o和.ko文件。 -
%.o: %.c:模式规则,将.c文件编译为.o文件。 -
%.ko: %.o:模式规则,将.o文件链接成.ko文件。 -
.PHONY:声明all和clean为伪目标。
在处理多文件项目时,Makefile允许使用通配符、自动变量、函数和条件语句等高级特性。通过合理组织Makefile,可以极大提高编译效率和项目的可维护性。随着项目的扩展,灵活运用这些高级特性将使项目的构建更加灵活和强大。
通过本章节的介绍,您应该对Makefile在内核模块开发中的重要性有了深入的理解,能够编写出适合您项目的Makefile,从而优化您的开发和编译流程。
7. 模块加载和卸载的命令行操作
使用insmod和rmmod命令
insmod命令的使用方法和参数
insmod 是一个用于向 Linux 内核插入模块的命令。它允许用户无需重新编译内核即可增加新的功能。使用 insmod 需要指定要加载的模块文件的路径。
最简单的使用方法如下:
insmod /path/to/module.ko
其中 /path/to/module.ko 是编译好的内核模块的路径。如果模块依赖于其他模块, insmod 也能尝试加载依赖模块。
insmod 命令支持的常用参数包括:
-
-f,--force:强制加载模块,即使符号版本不匹配。 -
-v,--verbose:详细输出。 -
-x,--show-deps:显示模块的依赖关系。
执行 insmod 后,你可以使用 lsmod 命令查看模块是否成功加载。
rmmod命令的使用方法和参数
rmmod 是用于从内核中移除(卸载)模块的命令。与 insmod 相反, rmmod 不支持模块之间的依赖处理,需要确保模块不再被使用,并且没有任何依赖模块。
使用 rmmod 命令非常简单,基本语法如下:
rmmod module_name
例如,如果你想要卸载名为 example_module 的模块,可以使用以下命令:
rmmod example_module
rmmod 支持以下常用参数:
-
-f,--force:强制卸载模块,即使它正在使用。 -
-v,--verbose:详细输出。 -
-w,--wait:等待直到模块不再被使用。
请注意,对于正在使用的模块,使用 rmmod -f 可以强制卸载,但这可能导致系统不稳定。
使用modprobe命令进行高级操作
modprobe命令的智能加载和依赖处理
modprobe 命令是一个更高级的工具,它不仅加载和卸载模块,还能够处理模块的依赖关系。这意味着当你加载一个模块时, modprobe 会自动加载所有依赖的模块,并且在卸载模块时,也会自动卸载不再需要的依赖模块。
基本使用方法如下:
modprobe module_name
对于卸载, modprobe 可以使用如下命令:
modprobe -r module_name
-r 参数是 --remove 的简写,指示 modprobe 卸载指定的模块及其依赖。
如何使用modprobe命令管理模块依赖
管理模块依赖涉及到在模块不存在时自动编译模块以及正确地卸载依赖模块。例如,如果模块 foo 依赖于模块 bar ,你可以使用以下命令:
modprobe foo
此命令会首先检查并加载 bar ,然后再加载 foo 。
当不再需要 foo 和它的依赖时,可以使用:
modprobe -r foo
这会确保 foo 和 bar 都被卸载,避免了循环依赖和孤立模块的情况。
请注意,为了使用 modprobe 命令,你需要有一个配置好的 /etc/modprobe.d/ 目录和 /etc/modules 文件,这样 modprobe 才能正确地管理模块。
此外, modprobe 命令还支持 -n 参数来模拟加载或卸载模块的操作,而不实际执行这些操作,这对于调试和规划非常有用。
简介:Linux内核驱动模块是用于扩展操作系统功能的代码段,可以在不重启系统的前提下动态加载或卸载。本教程以一个基础的"hello"模块为例,详细讲解了编写和编译内核模块的流程,包括模块的入口和出口函数、编程使用的特定头文件和函数,以及如何通过Makefile组织多文件编译。本模块旨在帮助初学者快速了解内核编程的基础知识,并掌握编译、加载和卸载Linux内核模块的基本技能。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐


 7
 0
- 0


 已为社区贡献1条内容

所有评论(0)