全面解读Linux内核:权威指南中文版

简介:《Linux内核手册》中文版是一本详尽介绍Linux内核各个核心组成部分的指南。它为读者提供了对Linux内核架构、进程管理、内存管理、文件系统、设备驱动、网络协议栈、模块化设计、安全与权限、调试技术、内核配置与编译等关键领域的深入理解。本书是系统管理员、开发人员及Linux爱好者的必备参考资料,旨在帮助用户深入掌握内核机制,并优化系统性能。书中附带的图像文件为理解复杂概念提供辅助。 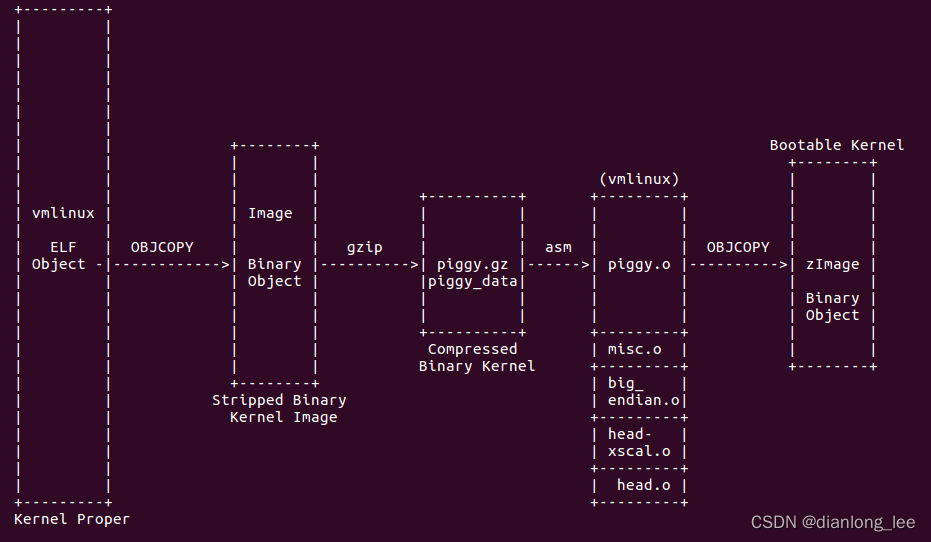
1. Linux内核基础和设计原理
Linux操作系统是开源软件的典型代表,其内核是整个系统的核心。Linux内核具有模块化、可移植性等特点,它基于UNIX的设计哲学,同时又进行了大量的创新。本章将介绍Linux内核的基础知识,包括内核的设计原理、代码结构以及它的核心功能。
1.1 Linux内核的角色和职责
Linux内核负责管理计算机硬件资源,提供系统服务给上层应用。它在硬件和软件之间起到了桥梁的作用。内核处理所有的硬件设备,同时向应用程序提供一个稳定的运行环境。内核不仅要处理低级的硬件交互,还要维护进程调度、内存管理等核心功能。
1.2 Linux内核设计的原则
Linux内核的设计基于一组核心原则,这些原则包括:
- 模块化 :内核功能被组织成独立的模块,以支持可选功能的动态加载和卸载。
- 可移植性 :设计时考虑到了不同硬件平台的兼容性,使得Linux能在多种架构上运行。
- 性能 :内核代码优化以减少系统开销,并提供高效的处理能力。
接下来的章节将深入探讨Linux内核的架构、子系统间的交互、进程管理和内存管理等关键技术。
2. Linux内核架构与子系统交互
2.1 Linux内核的整体架构
Linux内核的设计遵循了模块化和分层的原则,使得整个系统更加灵活、易于维护和扩展。在这一节中,我们将深入了解Linux内核的组成结构,并探讨各个子系统之间是如何互相协作、共同工作的。
2.1.1 内核的主要组成部分
Linux内核主要由以下几个核心组件构成:
- 进程调度器(Scheduler) :负责管理和调度进程,包括进程的创建、执行以及终止等。
- 内存管理器(Memory Manager) :负责处理物理和虚拟内存的映射、分配和回收。
- 文件系统(File System) :管理存储设备上的文件和目录,提供数据的持久化。
- 网络协议栈(Networking Stack) :处理网络通信,包括数据包的发送和接收。
- 设备驱动程序(Device Drivers) :为硬件设备提供接口,允许内核与硬件设备通信。
这些组件紧密协作,使得Linux操作系统能够高效地管理和调度系统资源,为用户提供稳定的服务。
2.1.2 各子系统的基本功能和交互方式
每个子系统都承担着特定的功能,并通过定义良好的接口与其它子系统进行交互。以下是各子系统的基本功能和交互方式概述:
- 进程调度器 通过进程控制块(PCB)管理进程信息,并与内存管理器交互来分配进程运行所需的内存空间。
- 内存管理器 负责虚拟内存的管理,通过页面置换算法优化物理内存的使用,并与文件系统协作实现换页。
- 文件系统 处理所有文件和目录相关的操作,同时需要与内存管理器合作,实现文件缓存等功能。
- 网络协议栈 通过各种协议处理网络数据包的发送和接收,与内核其它组件交互,提供Socket接口供用户空间进程使用。
- 设备驱动程序 为硬件设备提供操作接口,并通过中断、直接内存访问(DMA)等机制与内存管理器和进程调度器协作。
2.2 子系统间的协同工作
Linux内核的高效性在很大程度上取决于子系统间的协同工作。通过理解这些协作机制,我们可以更好地优化系统性能和资源利用率。
2.2.1 调度器与进程管理的协作
调度器主要负责进程的调度,它根据调度策略和进程优先级决定哪个进程获得CPU时间。调度器和进程管理的协作流程如下:
- 当进程创建时,内核为新进程分配一个PCB,初始化进程状态。
- 进程调度器将新进程插入到就绪队列中,等待CPU资源。
- 当进程的时间片用完或者因为其他原因被阻塞时,调度器将其从运行队列中移除,并根据优先级放入相应的队列中。
- 当进程变为就绪状态时,调度器负责选择合适的进程继续在CPU上运行。
进程调度策略是内核的核心部分,它对系统性能有着决定性的影响。常见的调度算法包括完全公平调度器(CFS)和实时调度器等。
2.2.2 文件系统与存储管理的整合
文件系统和存储管理的整合是通过虚拟文件系统(Virtual File System,VFS)完成的。VFS提供了一个统一的文件系统接口,使得用户可以通过相同的系统调用访问不同的文件系统。其工作流程如下:
- 用户空间的应用程序通过VFS接口发出文件操作请求。
- VFS根据文件系统的类型,将请求转发给相应的文件系统驱动。
- 文件系统驱动处理请求,并通过底层的存储管理接口与硬件交互。
- 存储管理负责在物理设备上进行实际的读写操作。
整合的关键在于VFS层,它抽象了不同的文件系统细节,为用户空间提供了一个统一的视图。
2.2.3 网络子系统与协议栈的配合
网络子系统和协议栈的配合是通过一套复杂的网络层、传输层和应用层协议实现的。其工作流程大致如下:
- 当应用程序需要发送数据时,它会通过socket接口将数据传递给网络子系统。
- 网络子系统将数据封装成IP数据包,并根据路由表决定数据包的下一跳地址。
- 数据包在到达目标主机后,网络子系统通过相应的协议栈处理数据包,然后将数据交付给目标应用程序。
网络子系统和协议栈的配合要处理各种网络情况,如包重传、拥塞控制等,以确保数据可靠地传输。
通过以上分析,我们对Linux内核的架构和子系统间的交互有了初步的认识。在接下来的章节中,我们将进一步深入探讨这些子系统的工作原理及其优化策略。
3. 进程管理与进程间通信(IPC)
Linux作为一个多用户、多任务的操作系统,其强大的进程管理功能和丰富的进程间通信(IPC)机制是其核心特性之一。进程管理保证了系统资源的有效分配和回收,而IPC则提供了不同进程间共享数据和协调工作的手段。本章节将深入探讨Linux进程管理的原理和IPC的实现方式。
3.1 Linux进程管理机制
3.1.1 进程状态和生命周期
在Linux中,进程是系统进行资源分配和调度的一个独立单位。每个进程都有其状态,这些状态反映了进程在执行过程中的不同阶段。Linux进程主要有以下几种状态:
- 运行(Running):进程正在处理器上运行。
- 就绪(Ready):进程等待系统分配处理器以便运行。
- 等待(Waiting):进程等待某个事件的发生或者资源的分配。
- 停止(Stopped):进程收到SIGSTOP、SIGTSTP、SIGTTIN或SIGTTOU信号后停止执行。
- 僵尸(Zombie):进程结束但其父进程尚未进行回收。
进程的生命周期从创建(fork或clone系统调用)开始,经过各种状态变迁,最终以退出(exit系统调用)结束。系统中的进程管理器如init或systemd负责监控这些进程的状态变化,并在必要时进行干预。
3.1.2 上下文切换和调度策略
Linux内核使用调度器(scheduler)管理进程的执行。调度器决定何时以及如何把CPU的控制权从一个进程切换到另一个进程,这个过程称为上下文切换。上下文切换涉及到保存当前进程的状态信息,并装入另一个进程的状态信息。
Linux调度器支持多种调度策略,如:
- SCHED_FIFO(实时先进先出)
- SCHED_RR(实时轮转)
- SCHED_OTHER(普通进程调度)
- SCHED_BATCH(批处理调度)
- SCHED_IDLE(空闲调度)
在这些策略中,SCHED_OTHER是最常见的调度策略,它基于时间片轮转的方式工作。内核调度器使用复杂的算法来平衡系统的吞吐量和响应时间。
// 示例:创建一个新进程
#include <stdio.h>
#include <stdlib.h>
#include <sys/types.h>
#include <unistd.h>

int main() {
    pid_t pid = fork(); // 调用fork()创建新进程
    if (pid < 0) {
        // fork失败
        perror("fork failed");
        exit(EXIT_FAILURE);
    } else if (pid == 0) {
        // 子进程代码
        printf("Hello from the child process!\n");
        exit(EXIT_SUCCESS);
    } else {
        // 父进程代码
        printf("Hello from the parent process!\n");
        wait(NULL); // 等待子进程结束
    }
    return 0;
}
上述代码展示了使用fork()系统调用创建一个新进程的过程。创建成功后,子进程和父进程都会执行后续代码,但会根据fork的返回值进行不同的操作。
3.2 进程间通信技术
进程间通信(IPC)是指在不同进程之间传输数据或状态,是操作系统提供的进程同步和协作机制。Linux支持多种IPC机制,包括信号、信号量、管道、消息队列和共享内存。
3.2.1 信号与信号量
信号(Signal)是IPC的最基本形式之一,用于通知进程发生了某个事件。每个信号都有一个整数编号,例如SIGINT(中断信号)、SIGKILL(终止信号)和SIGTERM(软件终止信号)。
信号量(Semaphore)是一种用于多进程同步的变量,保证两个或多个进程在访问共享资源时不会出现冲突。信号量可以实现进程间的互斥和同步。
3.2.2 管道、消息队列和共享内存
管道(Pipe)是一种最基本的IPC方式,允许进程间通过文件描述符进行单向通信。管道可以是无名的,也可以有命名。
消息队列(Message Queue)是一种在两个或多个进程间传递数据块的数据结构。消息队列比管道更灵活,允许指定消息类型,且每个消息可以包含不同类型的数据。
共享内存(Shared Memory)允许两个或多个进程共享一块内存空间,它是最快的IPC方式。共享内存直接在内存中共享数据,不需要数据复制。
// 示例:使用管道进行进程间通信
#include <stdio.h>
#include <unistd.h>
#include <stdlib.h>
#include <sys/wait.h>

int main() {
    int pipefd[2]; // 创建管道,pipefd[0]为读端,pipefd[1]为写端
    char buf;
    if (pipe(pipefd) == -1) {
        perror("pipe");
        exit(EXIT_FAILURE);
    }

    pid_t cpid = fork(); // 创建子进程
    if (cpid == -1) {
        perror("fork");
        exit(EXIT_FAILURE);
    }

    if (cpid == 0) { // 子进程
        close(pipefd[1]); // 关闭写端
        while (read(pipefd[0], &buf, 1) > 0) {
            write(STDOUT_FILENO, &buf, 1);
        }
        write(STDOUT_FILENO, "\n", 1);
        close(pipefd[0]);
        _exit(EXIT_SUCCESS);

    } else { // 父进程
        close(pipefd[0]); // 关闭读端
        write(pipefd[1], "O", 1); // 写入'O'
        write(pipefd[1], "K", 1); // 写入'K'
        close(pipefd[1]); // 关闭写端
        wait(NULL); // 等待子进程结束
        exit(EXIT_SUCCESS);
    }
}
本章节通过深入分析Linux的进程管理和IPC机制,展示了系统如何管理和调度进程,以及进程间如何进行通信和协作。这些知识对于设计和优化多任务、多用户环境中的应用程序至关重要。在下一章中,我们将进一步探讨Linux内存管理策略及其优化技巧。
4. 内存管理策略与优化
内存管理是操作系统内核的核心组成部分之一,它直接关系到系统的性能和稳定性。Linux操作系统采用了一系列高效而复杂的内存管理策略,不仅保证了内存的有效利用,还提供了优化机制以应对不同的应用场景。本章节将深入探讨Linux内存管理机制,并介绍内存管理优化的方法和技巧。
4.1 Linux内存管理机制
在深入探讨内存管理优化之前,需要先了解Linux内存管理的基础知识。Linux使用虚拟内存系统,将物理内存抽象化,为每个进程提供一个统一和连续的地址空间,从而解决了物理内存的碎片问题,并且提高了内存使用的安全性。
4.1.1 虚拟内存和物理内存的映射
虚拟内存允许系统中的每个进程都认为自己拥有整个系统的内存。实际的物理内存由内存管理单元(MMU)通过页表机制映射到虚拟内存地址上。这个映射过程是非常复杂的,涉及到了分页和分段的概念。
在分页系统中,内存被划分为大小相同的页(通常为4KB),而分段则允许内存被划分为逻辑上更为合适大小的段。Linux内核使用了混合的分页和分段策略,其中分页机制是最为重要的。
4.1.2 分页机制和分段机制
分页机制在硬件层面得到支持,每一页的映射信息存储在页表中,页表可以位于内存中的任何位置。当进程访问一个虚拟地址时,MMU会查找页表以确定对应的物理地址。如果页表条目不在缓存中(TLB miss),则需要通过访问内存中的页表来进行地址翻译,这个过程涉及到额外的性能开销。
分段机制则主要由操作系统管理,它将内存划分为代码、数据和堆栈等段,每个段有自己的属性,如访问权限等。在Linux中,分段的使用并不像分页那样频繁,但段机制为内存保护提供了额外的层次。
4.2 内存管理优化技巧
随着硬件的发展,物理内存已经变得越来越大,但是应用程序对内存的需求也在不断增长。因此,优化内存管理策略对于提升系统性能至关重要。
4.2.1 内存碎片整理和回收策略
内存碎片是内存管理中的一个重要问题。随着时间的推移,内存分配和释放会导致大块连续的内存空间被分散成许多小块,这种现象被称为内存碎片化。内存碎片整理是减少碎片化影响的常用方法。Linux内核通过伙伴系统算法和slab分配器来管理内存碎片问题。
伙伴系统将内存划分为多个大小不一的块,并试图通过合并相邻的空闲块来减少碎片。slab分配器则专门用于管理内核中的小对象,它通过缓存常用的对象类型来减少碎片,并加速内存的分配和回收。
4.2.2 内存压缩和大页支持
内存压缩技术可以在物理内存紧张时临时腾出更多的内存空间。Linux内核中的Zswap和Zram机制可以实现内存压缩。Zswap在RAM中分配一个交换空间,当物理内存不足时,使用压缩算法将内存中的数据压缩后存放到这个交换空间中。而Zram则是在内存中创建一个压缩块设备,通过压缩来减少内存的占用。
大页(Huge Pages)支持是另一种提高内存管理效率的技术,尤其是在需要处理大量数据的应用中。大页减少了页表项的数量,从而减少了TLB的压力,并且因为更少的页表项也降低了内存的使用量。Linux内核支持透明大页(THP),它允许自动地将4KB的小页合并成2MB的大页。
// 示例代码:使用hugetlb系统调用分配大页内存
// 本代码仅为示例,具体细节和参数解释请参见Linux内核文档

#include <sys/mman.h>
#include <fcntl.h>
#include <stdio.h>

#define HPAGE_SIZE 2 * 1024 * 1024  // 2 MB size huge page
#define HPAGE_SHIFT 21              // log2 of huge page size

int main() {
    void *addr;
    size_t size = HPAGE_SIZE;

    // 分配大页
    addr = mmap(0, size, PROT_READ | PROT_WRITE,
                MAP_PRIVATE | MAP_ANONYMOUS | MAP_HUGETLB, -1, 0);

    if (addr == MAP_FAILED) {
        perror("mmap");
        return 1;
    }

    // 使用addr进行内存操作...

    // 解除映射
    if (munmap(addr, size) == -1) {
        perror("munmap");
        return 1;
    }

    return 0;
}
在上述示例中,通过 mmap 系统调用,我们将大页内存映射到进程地址空间。我们使用了 MAP_HUGETLB 标志,这告诉内核我们需要分配大页内存。请注意,要成功运行此代码,系统必须支持大页,并且必须具有足够的大页内存供分配。
通过本章节的介绍,我们了解了Linux内存管理的基础和优化策略。这些策略对于保持系统的高性能和稳定性至关重要。通过结合使用分页机制、伙伴系统、slab分配器、内存压缩技术和大页支持,Linux内核提供了一个强大而灵活的内存管理框架。
5. 文件系统类型与内核实现
文件系统是操作系统用于组织、存储和检索数据的子系统。Linux内核提供了对多种文件系统类型的支持,并且设计了虚拟文件系统(VFS)来抽象具体文件系统的细节。本章将探讨Linux支持的文件系统类型、文件系统的安装与卸载,以及文件系统在内核中的实现机制。
5.1 Linux支持的文件系统类型
Linux提供了对多种文件系统的支持,包括但不限于ext2/ext3/ext4、XFS、Btrfs、FAT和NTFS等。这些文件系统各有特点和应用场景,理解它们的特性能帮助我们更好地管理和优化存储资源。
5.1.1 常见文件系统特性对比
Linux社区对文件系统的不断研究和改进,使得文件系统种类繁多。我们从性能、稳定性和功能等方面对几种常见文件系统进行对比分析:
- ext系列 : ext2是早期广泛使用的文件系统,它对小文件的处理性能良好,但不支持日志功能。ext3在ext2的基础上引入了日志功能,提高了文件系统的稳定性。ext4是目前最常用的Linux文件系统,它具有更高效的磁盘空间管理、更好的文件系统性能和更大的文件大小限制。
- XFS : 是一个高性能的64位文件系统,最初由SGI为IRIX操作系统开发,之后移植到Linux。XFS擅长处理大量数据,并且在处理大文件和大文件系统方面表现出色。
- Btrfs : 被认为是下一代Linux文件系统,它在设计上强调了容错性、易用性和性能优化。Btrfs支持动态扩展、快照、校验和等功能,适合用于大规模存储。
- FAT和NTFS : 这些文件系统通常用于Windows系统和USB驱动器。FAT是一个较为简单和老旧的文件系统,而NTFS则提供了更好的性能和安全性。
5.1.2 文件系统的安装和卸载
在Linux系统中,安装和卸载文件系统是非常常见的操作,通常可以通过挂载(mount)和卸载(umount)命令来管理。
-
挂载文件系统 : Linux通过挂载点将文件系统关联到目录树的某个点。使用
mount命令可以将一个分区或存储设备挂载到一个指定的目录。例如:bash sudo mount /dev/sda1 /mnt这条命令将/dev/sda1分区挂载到了/mnt目录。 -
卸载文件系统 : 当不再需要访问某个文件系统时,可以使用
umount命令来安全卸载。例如:bash sudo umount /mnt这条命令将/mnt目录下的文件系统卸载。
文件系统的安装和卸载是一个敏感操作,需要确保没有进程正在访问该文件系统,否则卸载操作可能会失败。
5.2 文件系统在内核中的实现
5.2.1 VFS的概念和作用
虚拟文件系统(VFS)是Linux内核中的一个抽象层,它为不同的文件系统提供了一个通用的接口。通过VFS,用户空间的应用程序可以不必关心底层具体文件系统的实现,只需要使用统一的系统调用来访问文件。
VFS定义了四个主要的对象类型:超级块(superblock)、索引节点(inode)、目录项(dentry)和文件(file)。每个文件系统类型需要实现这些对象的特定操作,以符合VFS的通用接口。
5.2.2 文件系统驱动的编写要点
编写文件系统驱动是一个复杂的过程,需要深入理解VFS的工作原理和文件系统的设计哲学。以下是文件系统驱动编写时需要考虑的要点:
- 文件系统注册与卸载 : 开发者需要实现
init_module和cleanup_module函数(或者在较新的Linux内核中使用module_init和module_exit宏),分别用于注册和注销文件系统。 - 文件系统操作 : 实现VFS定义的超级块、索引节点、目录项和文件操作函数,如
read、write、open、release等。 - 元数据管理 : 文件系统的元数据通常包括文件属性(如大小、权限、所有者)、文件系统的组织方式(如块的分配与释放)、索引节点的管理等。
- 错误处理 : 确保驱动能够在遇到错误时正确处理,包括文件系统的格式化、检查、修复等操作。
一个简单的文件系统驱动代码示例如下:
#include <linux/module.h>
#include <linux/fs.h>

static int myfs_open(struct inode *inode, struct file *file) {
    printk(KERN_INFO "myfs: file opened\n");
    return 0;
}

static int myfs_close(struct inode *inode, struct file *file) {
    printk(KERN_INFO "myfs: file closed\n");
    return 0;
}

static struct file_operations myfs_fops = {
    .owner = THIS_MODULE,
    .open = myfs_open,
    .release = myfs_close,
    // 其他操作如read/write等可以在这里实现
};

static int __init myfs_init(void) {
    printk(KERN_INFO "Loading myfs\n");
    // 注册文件系统,此处省略具体代码
    return 0;
}

static void __exit myfs_exit(void) {
    printk(KERN_INFO "Exiting myfs\n");
    // 注销文件系统,此处省略具体代码
}

module_init(myfs_init);
module_exit(myfs_exit);

MODULE_LICENSE("GPL");
MODULE_AUTHOR("Your Name");
MODULE_DESCRIPTION("My Example Filesystem Module");
这段代码定义了打开和关闭文件时的操作函数,并注册和注销了一个简单的文件系统模块。当然,实际开发中需要根据具体文件系统的需求实现更完整的功能。
通过文件系统类型与内核实现的深入探讨,我们可以发现Linux文件系统架构的灵活性和扩展性。在实际工作中,了解这些知识能帮助我们更好地设计和维护系统。
6. 设备驱动编写与硬件交互
6.1 设备驱动的结构和分类
6.1.1 字符设备和块设备驱动的区别
字符设备和块设备是Linux内核中两类基本的设备类型。字符设备的特点是数据可以按照字符流的方式进行读写,通常不支持随机访问,而块设备则以块为单位进行读写,并支持随机访问。这些差异导致了字符设备驱动和块设备驱动的设计有所不同。
字符设备驱动通常实现为一个字符设备文件,通过文件操作函数(如open, close, read, write等)与用户空间进行交互。块设备驱动则通常通过一个或者多个请求队列(request queues)来处理来自文件系统的读写请求。
在编写字符设备驱动时,需要实现 file_operations 结构体,其中包括了对字符设备进行各种操作的函数指针,例如:
static const struct file_operations my_char_fops = {
    .owner = THIS_MODULE,
    .open = my_char_open,
    .release = my_char_release,
    .read = my_char_read,
    .write = my_char_write,
    // 其他操作...
};
而块设备驱动通常需要实现 block_device_operations 结构体,并注册一个 block_device 。块设备的处理较为复杂,因为它涉及到了请求管理,需要创建和维护请求队列:
static const struct block_device_operations my_block_fops = {
    .owner = THIS_MODULE,
    .open = my_block_open,
    .release = my_block_release,
    // 其他操作...
};

static struct request_queue *my_block_queue;

// 初始化请求队列和注册块设备
my_block_queue = blk_init_queue(do_request, &my_lock);
register_disk(&my_disk, MKDEV(MY_MAJOR, MY_MINOR), 1, &my_block_fops, sizeof(struct my_block_device));
6.1.2 网络设备驱动的特点
网络设备驱动主要处理的是数据包的发送和接收。相比于字符设备和块设备,网络设备不直接与文件系统或用户空间文件关联,而是通过套接字(sockets)与用户空间通信。
网络设备驱动需要实现 net_device_ops 结构体,其中包括了网络接口的操作函数,如启动、停止、发送数据包等:
static const struct net_device_ops my_netdev_ops = {
    .ndo_open = my_net_open,
    .ndo_stop = my_net_stop,
    .ndo_start_xmit = my_net_start_xmit,
    // 其他操作...
};
网络设备驱动程序通常需要维护一个接收队列用于接收数据包,以及一个发送队列用于发送数据包。此外,网络设备驱动还需要处理中断,响应来自硬件的事件通知。
表格:字符设备、块设备与网络设备驱动的对比
| 特性 | 字符设备驱动 | 块设备驱动 | 网络设备驱动 | |-----------------------|------------------------------------------|-----------------------------------------|------------------------------------------| | 数据单位 | 字符流 | 数据块 | 数据包 | | 用户空间交互 | 字符设备文件 | 文件系统 | 套接字 | | 驱动操作函数 | file_operations | block_device_operations | net_device_ops | | 硬件交互方式 | 直接使用设备文件操作 | 通过请求队列间接操作 | 通过套接字操作,发送和接收数据包 | | 内存管理 | 直接映射到用户空间 | 间接通过块设备管理层 | 通过网络缓冲区管理,无需直接内存管理 | | 中断处理 | 可能涉及中断处理(如串口) | 通常涉及中断处理(如硬盘) | 必须处理中断,响应数据包收发 | | 与内核子系统关联 | 通常与VFS子系统关联 | 通常与块I/O子系统关联 | 与网络子系统关联 |
6.1.3 设备驱动编写实践
编写设备驱动时,遵循内核开发标准和最佳实践是非常重要的。首先,编写驱动之前,应当了解驱动将要操作的硬件设备的技术规范,包括其寄存器映射、中断处理机制、内存布局等。
在实现驱动时,首先定义设备与内核的接口,如上述的 file_operations 、 block_device_operations 、 net_device_ops 等结构体。其次,需要处理设备的初始化和清理工作,确保在设备注册和注销时进行适当的资源申请和释放。
内核提供了一系列的宏和API,如 alloc_chrdev_region 、 alloc_disk 、 register_netdev 等,这些函数用于注册设备并使其在系统中可用。完成设备的注册之后,相应的操作函数就可以被调用,比如字符设备的read/write操作。
int __init my_driver_init(void) {
    // 注册字符设备、块设备或网络设备驱动
    // ...
    return 0;
}

void __exit my_driver_exit(void) {
    // 注销字符设备、块设备或网络设备驱动
    // ...
}

module_init(my_driver_init);
module_exit(my_driver_exit);
驱动程序应当遵守内核编码规范,并且做到可配置化和可移植化。在开发过程中,使用内核提供的调试工具,比如printk、ftrace等来跟踪和调试驱动的行为。编写测试代码,并在多种硬件和内核版本上进行测试,以确保驱动的稳定性和兼容性。
6.2 硬件通信与交互协议
6.2.1 I/O控制和中断处理机制
硬件通信在Linux内核驱动编写中占据核心地位,它主要通过两种方式实现:直接I/O控制和中断处理机制。直接I/O控制允许驱动程序直接与硬件寄存器交互,而中断处理机制则允许驱动程序响应硬件发出的信号。
直接I/O控制通常涉及到对硬件设备的寄存器进行读写操作。在Linux内核中,这些操作可以使用 inb 、 outb 、 inw 、 outw 等函数进行,这些函数允许内核代码访问硬件的I/O端口。例如,以下代码片段展示了一个简单的读操作:
unsigned char status_register;

// 假设设备的I/O端口为0x378
status_register = inb(0x378);
除了直接I/O操作,中断处理机制是硬件通信的另一个重要方面。当中断发生时,CPU暂时停止当前的执行流程,跳转到预设的中断处理程序执行中断服务。在Linux内核中,中断处理程序需要注册到内核中,以便在中断发生时被正确调用:
static irqreturn_t my_irq_handler(int irq, void *dev_id) {
    // 中断处理逻辑
    // ...

    // 明确告知内核,中断处理完毕
    return IRQ_HANDLED;
}

static int __init my_init_irq(void) {
    // 注册中断处理函数
    request_irq(MY_IRQ, my_irq_handler, IRQF_SHARED, "my_driver", NULL);
    return 0;
}
中断处理程序必须尽可能的短小和高效,因为它们直接关系到系统的响应速度和稳定性。
6.2.2 DMA传输和总线技术在驱动中的应用
直接内存访问(DMA)是一种允许外设直接读写系统内存的技术,而不需要CPU介入。这种技术可以极大提高数据传输的效率,减少CPU负担。在编写设备驱动时,正确地使用DMA传输可以有效提升系统性能。
在内核中,使用DMA通常需要分配一块连续的内存区域,并将这块内存的物理地址告知硬件设备,之后设备就可以直接进行读写操作。当DMA操作完成后,内核会接收一个中断信号,并执行相关的清理工作。
// 分配DMA兼容的内存
void *buffer = dma_alloc_coherent(&my_device->dev, PAGE_SIZE, &dma_handle, GFP_KERNEL);

// 使用DMA传输数据
// ...

// 释放DMA内存
dma_free_coherent(&my_device->dev, PAGE_SIZE, buffer, dma_handle);
总线技术,如PCIe、USB等,是硬件设备与计算机系统连接的桥梁。在编写设备驱动时,必须考虑到不同总线的特点和规范。例如,PCI设备驱动需要读取和写入PCI配置空间,使用内核提供的接口,如 pci_enable_device 、 pci_request_regions 等函数来初始化和配置设备。
struct pci_dev *pdev;

// 初始化PCI设备
pci_enable_device(pdev);
pci_request_regions(pdev, "my_pci_driver");
现代的总线技术还支持热插拔,内核为热插拔事件提供了丰富的API,如 bus_register_driver 、 device_register 等,以便驱动程序能够响应设备的热插拔事件。
static int my_pci_probe(struct pci_dev *pdev, const struct pci_device_id *ent) {
    // 初始化PCI设备
    // ...

    return 0;
}

static void my_pci_remove(struct pci_dev *pdev) {
    // 清理PCI设备
    // ...
}

static struct pci_driver my_pci_driver = {
    .name = "my_pci_driver",
    .id_table = my_pci_id_table,
    .probe = my_pci_probe,
    .remove = my_pci_remove,
};

module_pci_driver(my_pci_driver);
mermaid格式流程图:字符设备驱动的读操作流程
flowchart LR
    A[打开设备] --> B[请求读操作]
    B --> C{是否有数据可读}
    C -->|有| D[从缓冲区读数据]
    C -->|无| E[等待数据]
    D --> F[返回数据给应用]
    E -->|数据到来| D
设备驱动是操作系统与硬件设备通信的桥梁。通过内核提供的各种接口和规范,驱动开发人员可以构建稳定、高效的硬件交互程序。无论是字符设备、块设备还是网络设备,都需要遵循Linux内核的驱动开发标准,充分考虑硬件设备的技术规范和应用场景,从而开发出高质量的驱动程序。
7. 网络协议栈详解与socket编程
7.1 Linux网络协议栈架构
7.1.1 协议栈分层模型
Linux网络协议栈遵循ISO/OSI模型和TCP/IP模型,这两者的分层非常相似。网络协议栈的主要层次包括链路层、网络层、传输层和应用层。每一层都有其特定的功能和协议,负责不同的网络通信任务。
- 链路层 :负责数据链路的建立、维护和拆除,实现物理硬件之间的通信,主要协议有以太网(Ethernet)和Wi-Fi。
- 网络层 :主要协议是IP(Internet Protocol),负责数据包的路由选择和转发,确保数据能够从源主机传送到目的主机。
- 传输层 :主要实现端到端的数据传输,主要的协议有TCP(Transmission Control Protocol)和UDP(User Datagram Protocol)。
- 应用层 :为用户应用程序提供接口,如HTTP、FTP、DNS等,用户程序通过套接字(sockets)与内核网络层交互。
7.1.2 数据包的处理流程
当一个数据包进入系统时,它会从链路层开始,按照协议栈的层次结构逐层进行处理:
- 链路层接收 :网络接口接收到数据帧后,首先进行帧同步和错误检测,然后将数据帧传送到网络层。
- 网络层处理 :网络层对IP包头进行解析,检查目的地址,并进行路由决策,将数据包转发到相应的下一跳或者最终目的地。
- 传输层处理 :如果数据包是TCP包,那么TCP层将进行连接管理、流量控制、错误检查和数据重组等。如果是UDP包,则直接将数据包传递给应用层。
- 应用层交付 :传输层将数据传递给对应的应用程序,应用程序通过socket API进行数据的接收和处理。
7.2 socket编程实践
7.2.1 socket接口基础和API使用
Socket接口是应用程序与网络协议栈通信的主要方式。在Linux下,socket编程使用的是BSD socket API。一个socket实际上是一个通信端点。
创建socket
创建一个socket的基本函数是 socket() :
#include <sys/socket.h>
int socket(int domain, int type, int protocol);
-
domain:定义了socket的寻址族,常见的有AF_INET(IPv4地址)和AF_INET6(IPv6地址)。 -
type:定义了socket的类型,比如SOCK_STREAM(TCP流)和SOCK_DGRAM(UDP数据报)。 -
protocol:指定特定的协议,通常在使用TCP时设置为0,因为SOCK_STREAM已足够。
连接socket
对于面向连接的socket(如TCP),你需要使用 connect() 函数连接到一个服务器:
#include <sys/socket.h>
int connect(int sockfd, const struct sockaddr *addr, socklen_t addrlen);
-
sockfd:是一个socket文件描述符。 -
addr:指向包含服务器地址的sockaddr结构体。 -
addrlen:表示地址结构体的大小。
发送和接收数据
数据的发送和接收可以通过 send() 和 recv() 函数进行:
#include <sys/socket.h>
ssize_t send(int sockfd, const void *buf, size_t len, int flags);
ssize_t recv(int sockfd, void *buf, size_t len, int flags);
-
sockfd:是一个socket文件描述符。 -
buf:指向数据的缓冲区。 -
len:表示要发送或接收的数据大小。 -
flags:可以影响函数行为的额外标志。
7.2.2 高级网络编程技术与实例解析
非阻塞和异步IO
高级的网络编程中,通常会使用非阻塞IO和异步IO以避免阻塞调用。这些可以通过 fcntl() 设置socket为非阻塞模式:
#include <fcntl.h>
int flags = fcntl(sockfd, F_GETFL, 0);
fcntl(sockfd, F_SETFL, flags | O_NONBLOCK);
使用 select() 或 poll() 可以实现异步IO,监控多个socket是否可读或可写:
#include <sys/select.h>
#include <sys/time.h>

int maxfd = sockfd;
fd_set readmask, writemask, exceptmask;
FD_ZERO(&readmask);
FD_SET(sockfd, &readmask);

struct timeval tv;
tv.tv_sec = 10;
tv.tv_usec = 0;

int n = select(maxfd + 1, &readmask, &writemask, &exceptmask, &tv);
带外数据的处理
带外数据(OOB)是一种紧急数据传输机制,可以用于中断正常的IO流。在Linux中,可以使用 MSG_OOB 标志发送和接收带外数据。
实例解析
下面是一个简单的TCP服务器端和客户端的socket编程示例:
服务器端代码 :
// 省略包含和错误处理代码...

// 创建socket
int server_fd = socket(AF_INET, SOCK_STREAM, 0);

// 绑定地址和端口
struct sockaddr_in server_addr;
server_addr.sin_family = AF_INET;
server_addr.sin_port = htons(12345);
server_addr.sin_addr.s_addr = INADDR_ANY;
bind(server_fd, (struct sockaddr *)&server_addr, sizeof(server_addr));

// 监听连接
listen(server_fd, 3);

// 接受连接
struct sockaddr_in client_addr;
socklen_t client_len = sizeof(client_addr);
int client_fd = accept(server_fd, (struct sockaddr *)&client_addr, &client_len);

// 接收和发送数据
recv(client_fd, buffer, BUFFER_SIZE, 0);
send(client_fd, buffer, BUFFER_SIZE, 0);

// 关闭socket
close(client_fd);
close(server_fd);
客户端代码 :
// 省略包含和错误处理代码...

// 创建socket
int client_fd = socket(AF_INET, SOCK_STREAM, 0);

// 连接到服务器
struct sockaddr_in server_addr;
server_addr.sin_family = AF_INET;
server_addr.sin_port = htons(12345);
server_addr.sin_addr.s_addr = inet_addr("192.168.1.2");
connect(client_fd, (struct sockaddr *)&server_addr, sizeof(server_addr));

// 发送和接收数据
send(client_fd, message, strlen(message), 0);
recv(client_fd, buffer, BUFFER_SIZE, 0);

// 关闭socket
close(client_fd);
在这些示例代码中,我们展示了如何创建一个socket,设置地址和端口,以及基本的客户端和服务器端的通信流程。通过这些基础的构建块,开发者可以构建复杂的网络应用。
简介:《Linux内核手册》中文版是一本详尽介绍Linux内核各个核心组成部分的指南。它为读者提供了对Linux内核架构、进程管理、内存管理、文件系统、设备驱动、网络协议栈、模块化设计、安全与权限、调试技术、内核配置与编译等关键领域的深入理解。本书是系统管理员、开发人员及Linux爱好者的必备参考资料,旨在帮助用户深入掌握内核机制,并优化系统性能。书中附带的图像文件为理解复杂概念提供辅助。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐

 14
 0
- 0


 已为社区贡献3条内容

所有评论(0)