登录社区云,与社区用户共同成长
邀请您加入社区
很多开发者在编写 Go 命令行工具时,最先尝试的往往是标准库的fmt.Scanln或手写 ANSI 转义序列来实现光标定位。这种方式写一些简单的确认交互尚可,一旦需要实现类似于 Git 交互式变基、K8s Pod 实时选择器或者支持动态过滤的列表组件,代码就会迅速滑向灾难:终端光标在不同操作系统终端模拟器上乱跳,输入高频按键时出现内容撕裂,用户调整终端窗口大小(Resize)直接导致排版彻底错乱。
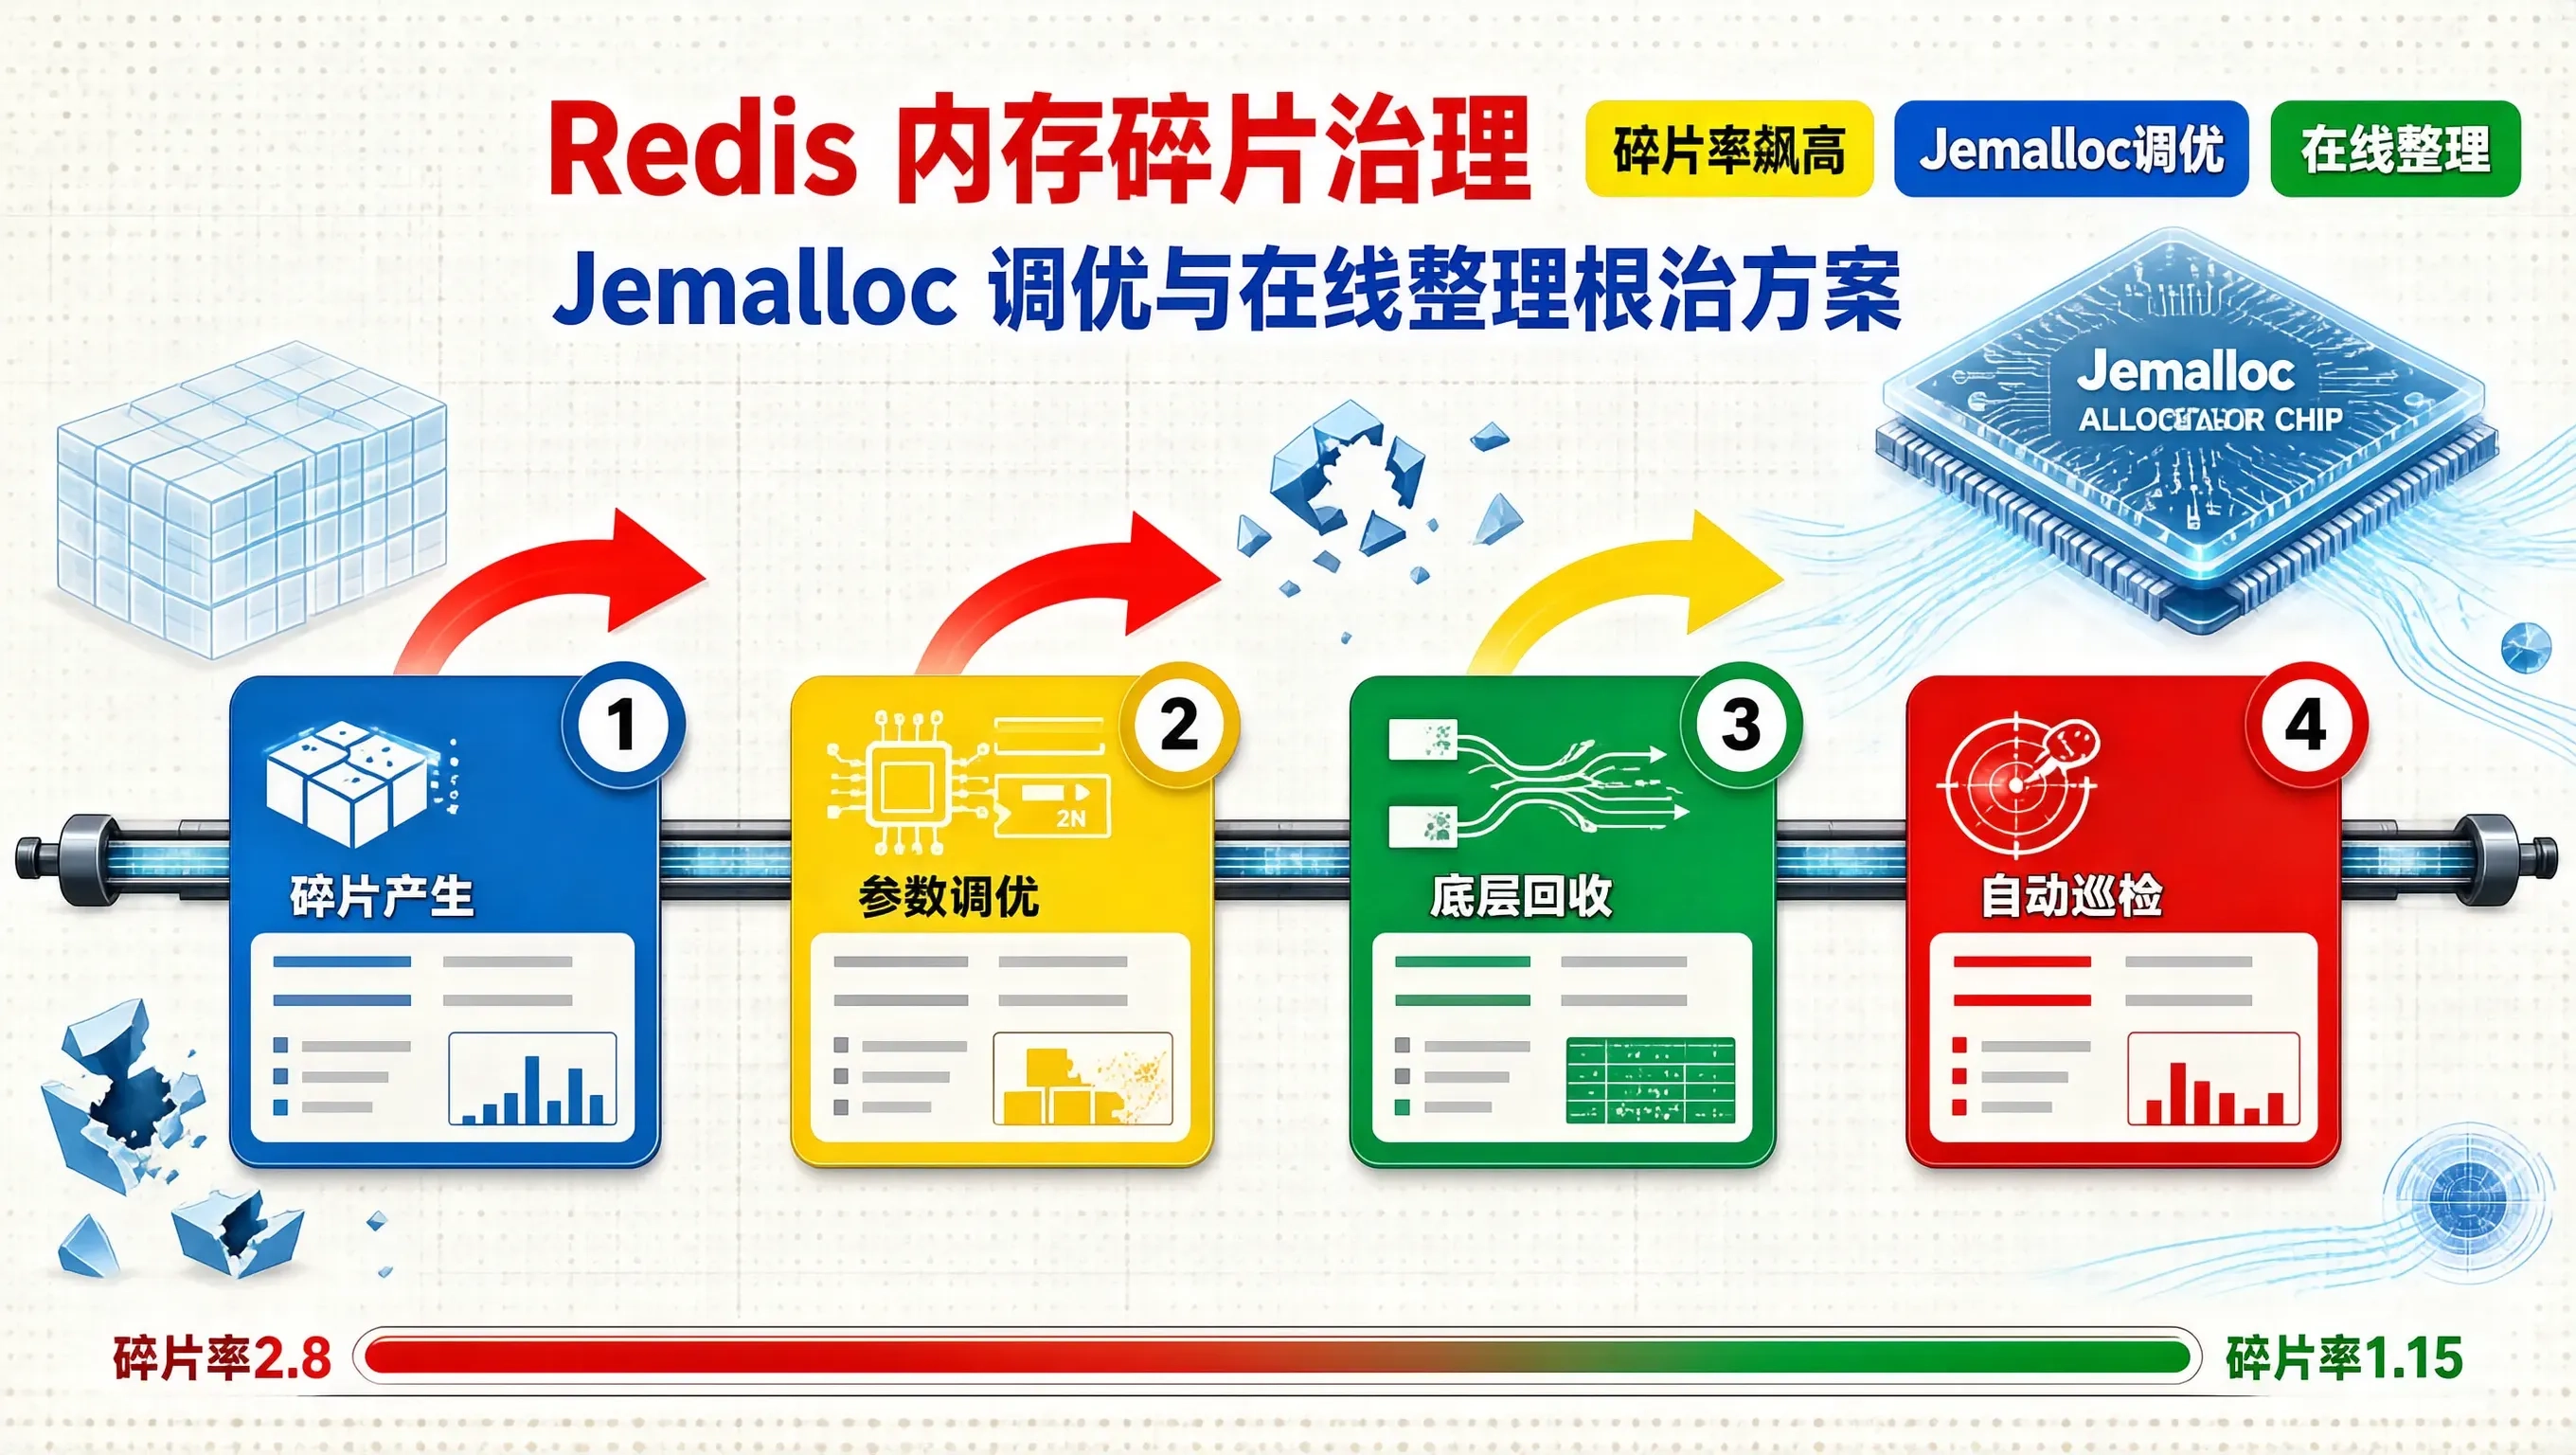
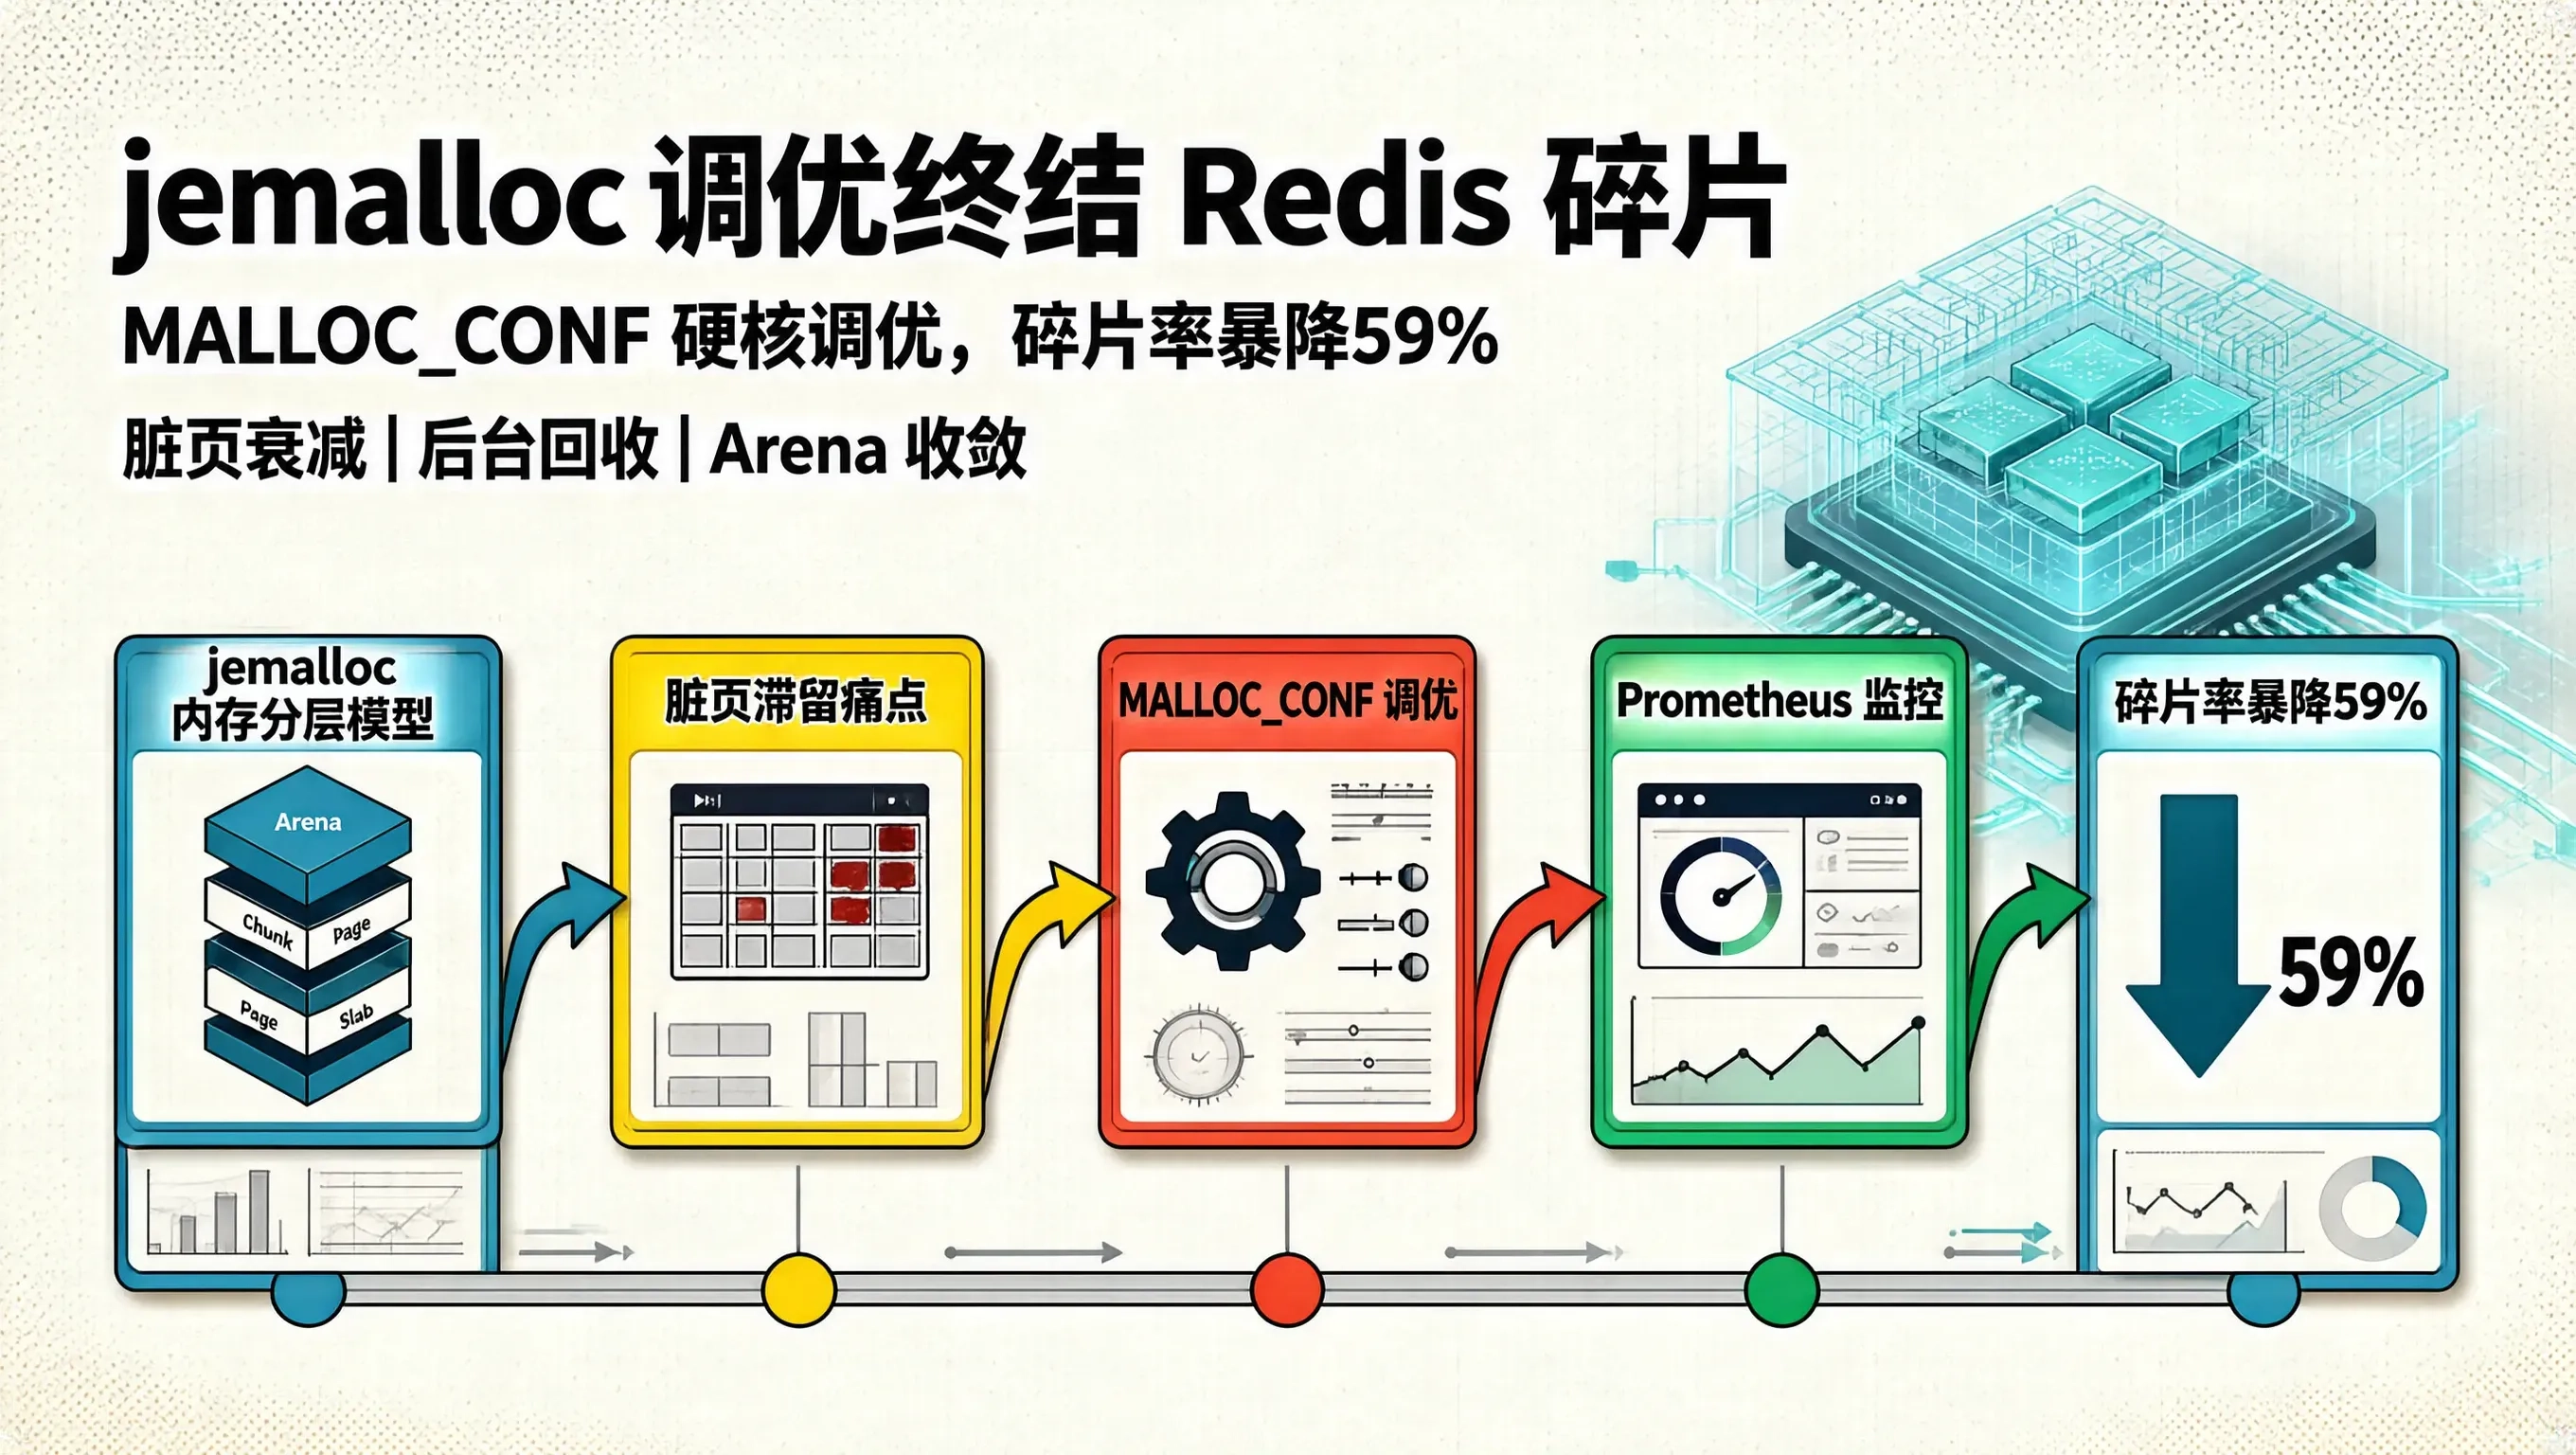
在生产环境中维护承载千万级高并发的大型 Redis 集群时,运维与架构团队经常会遭遇一种令人困惑的资源危机:通过命令查看实例状态,(Redis 实际存储数据占用的内存)显示仅有 16GB,但 Linux 宿主机通过top或ps查看到的进程物理常驻内存(RSS)却已经高达 45GB,内存碎片率指标飙升至 2.8 甚至更高。这种严重的内存虚高现象不仅会极大挤占宿主机的可用资源,甚至可能直接触发操作系统
在无法开启硬件级 MIG 切片、或者业务需要极细粒度动态算力配额(如给某个临时分析任务分配 15% 算力,给在线轻量模型分配 35% 算力)的场景下,很多云原生平台会转向基于软件劫持(API Hook)的时间片共享(Time-Slicing vGPU)方案。然而,不少自研 vGPU 调度器在上线初期,都会被宿主机上狂转的 CPU 与剧烈抖动的业务延迟上一堂残酷的工程课。过去很多开发者的实现方式极其
大模型代码解释器的本质,是在生产环境执行不可信的任意输入。靠 Prompt 里写“请不要执行破坏性命令”只是自欺欺人的君子协议;唯有依靠操作系统底层的命名空间隔绝、gVisor 独立内核截断和 cgroups 物理配额,才能让大模型在最野蛮狂放地写代码的同时,系统底层依然安如磐石。
在利用 DPDK 开发千万级 PPS 高性能网关、软负均衡或防火墙系统时,几乎所有开发者都会面临一个极其现实的工程尴尬:当物理网卡被vfio-pci或igb_uio驱动接管后,操作系统内核协议栈对该网卡的控制权被彻底剥离。在 Linux 系统视图中,该物理网卡瞬间“消失”了——运维人员常用的ifconfigip addr无法看到接口,ping无法响应,tcpdump。
在 openEuler 24.03 上编译部署 JeecgBoot 3.9.5 后端:JDK 17 + Maven 编译、systemd 托管、PostgreSQL 连接配置、LiteFlow 报错修复、PostgreSQL 15+ public schema 授权。附开源工具链,从零到接口可访问。
做开源项目,最耗费心力的往往不是写核心业务代码,而是每天早晨打开邮箱时面对的一堆“幽灵 Issue”。“项目跑不起来,请问怎么解决?“打包报错了,急求指导!没有日志,没有复现代码,没有操作系统和版本号,甚至连复现步骤那一栏都大喇喇地写着两个字——“如题”。维护者在下面回一句“请提供详细复现仓库”,对方可能一周不理;一周后想起来了,贴一张用手机拍摄的屏幕反光截图。这种低效沟通像无形的钝刀子,迅速消磨
在 Linux 多进程或多线程高性能网络网关(如 Nginx、自研反向代理服务)的设计中,为了充分压榨多核 CPU 算力,系统通常会启动与 CPU 物理核心数对齐的多个 Worker 工作进程。然而,在早期的架构实现中,一个隐秘而沉重的性能内耗长年困扰着系统架构师——。当 32 个工作进程同时监听同一个服务端端口的连接事件时,每当外部有一个新的客户端发起 TCP 三次握手建连,操作系统内核会如临大
很多从多线程同步编程转入 Python 异步开发的工程师,常抱有一个极其危险的误解:“asyncio是单线程事件循环驱动的,既然没有操作系统级抢占式线程切换,那我就不需要锁,代码天然线程安全!然而,在面对高吞吐生产服务时,现实会用一连串离奇的“死锁事故”和“状态撕裂”给这部分开发者上一堂极其沉重的课。在异步协程的世界里,await。在下一个await返回之前,成百上千个其他并发协程完全有可能插队进
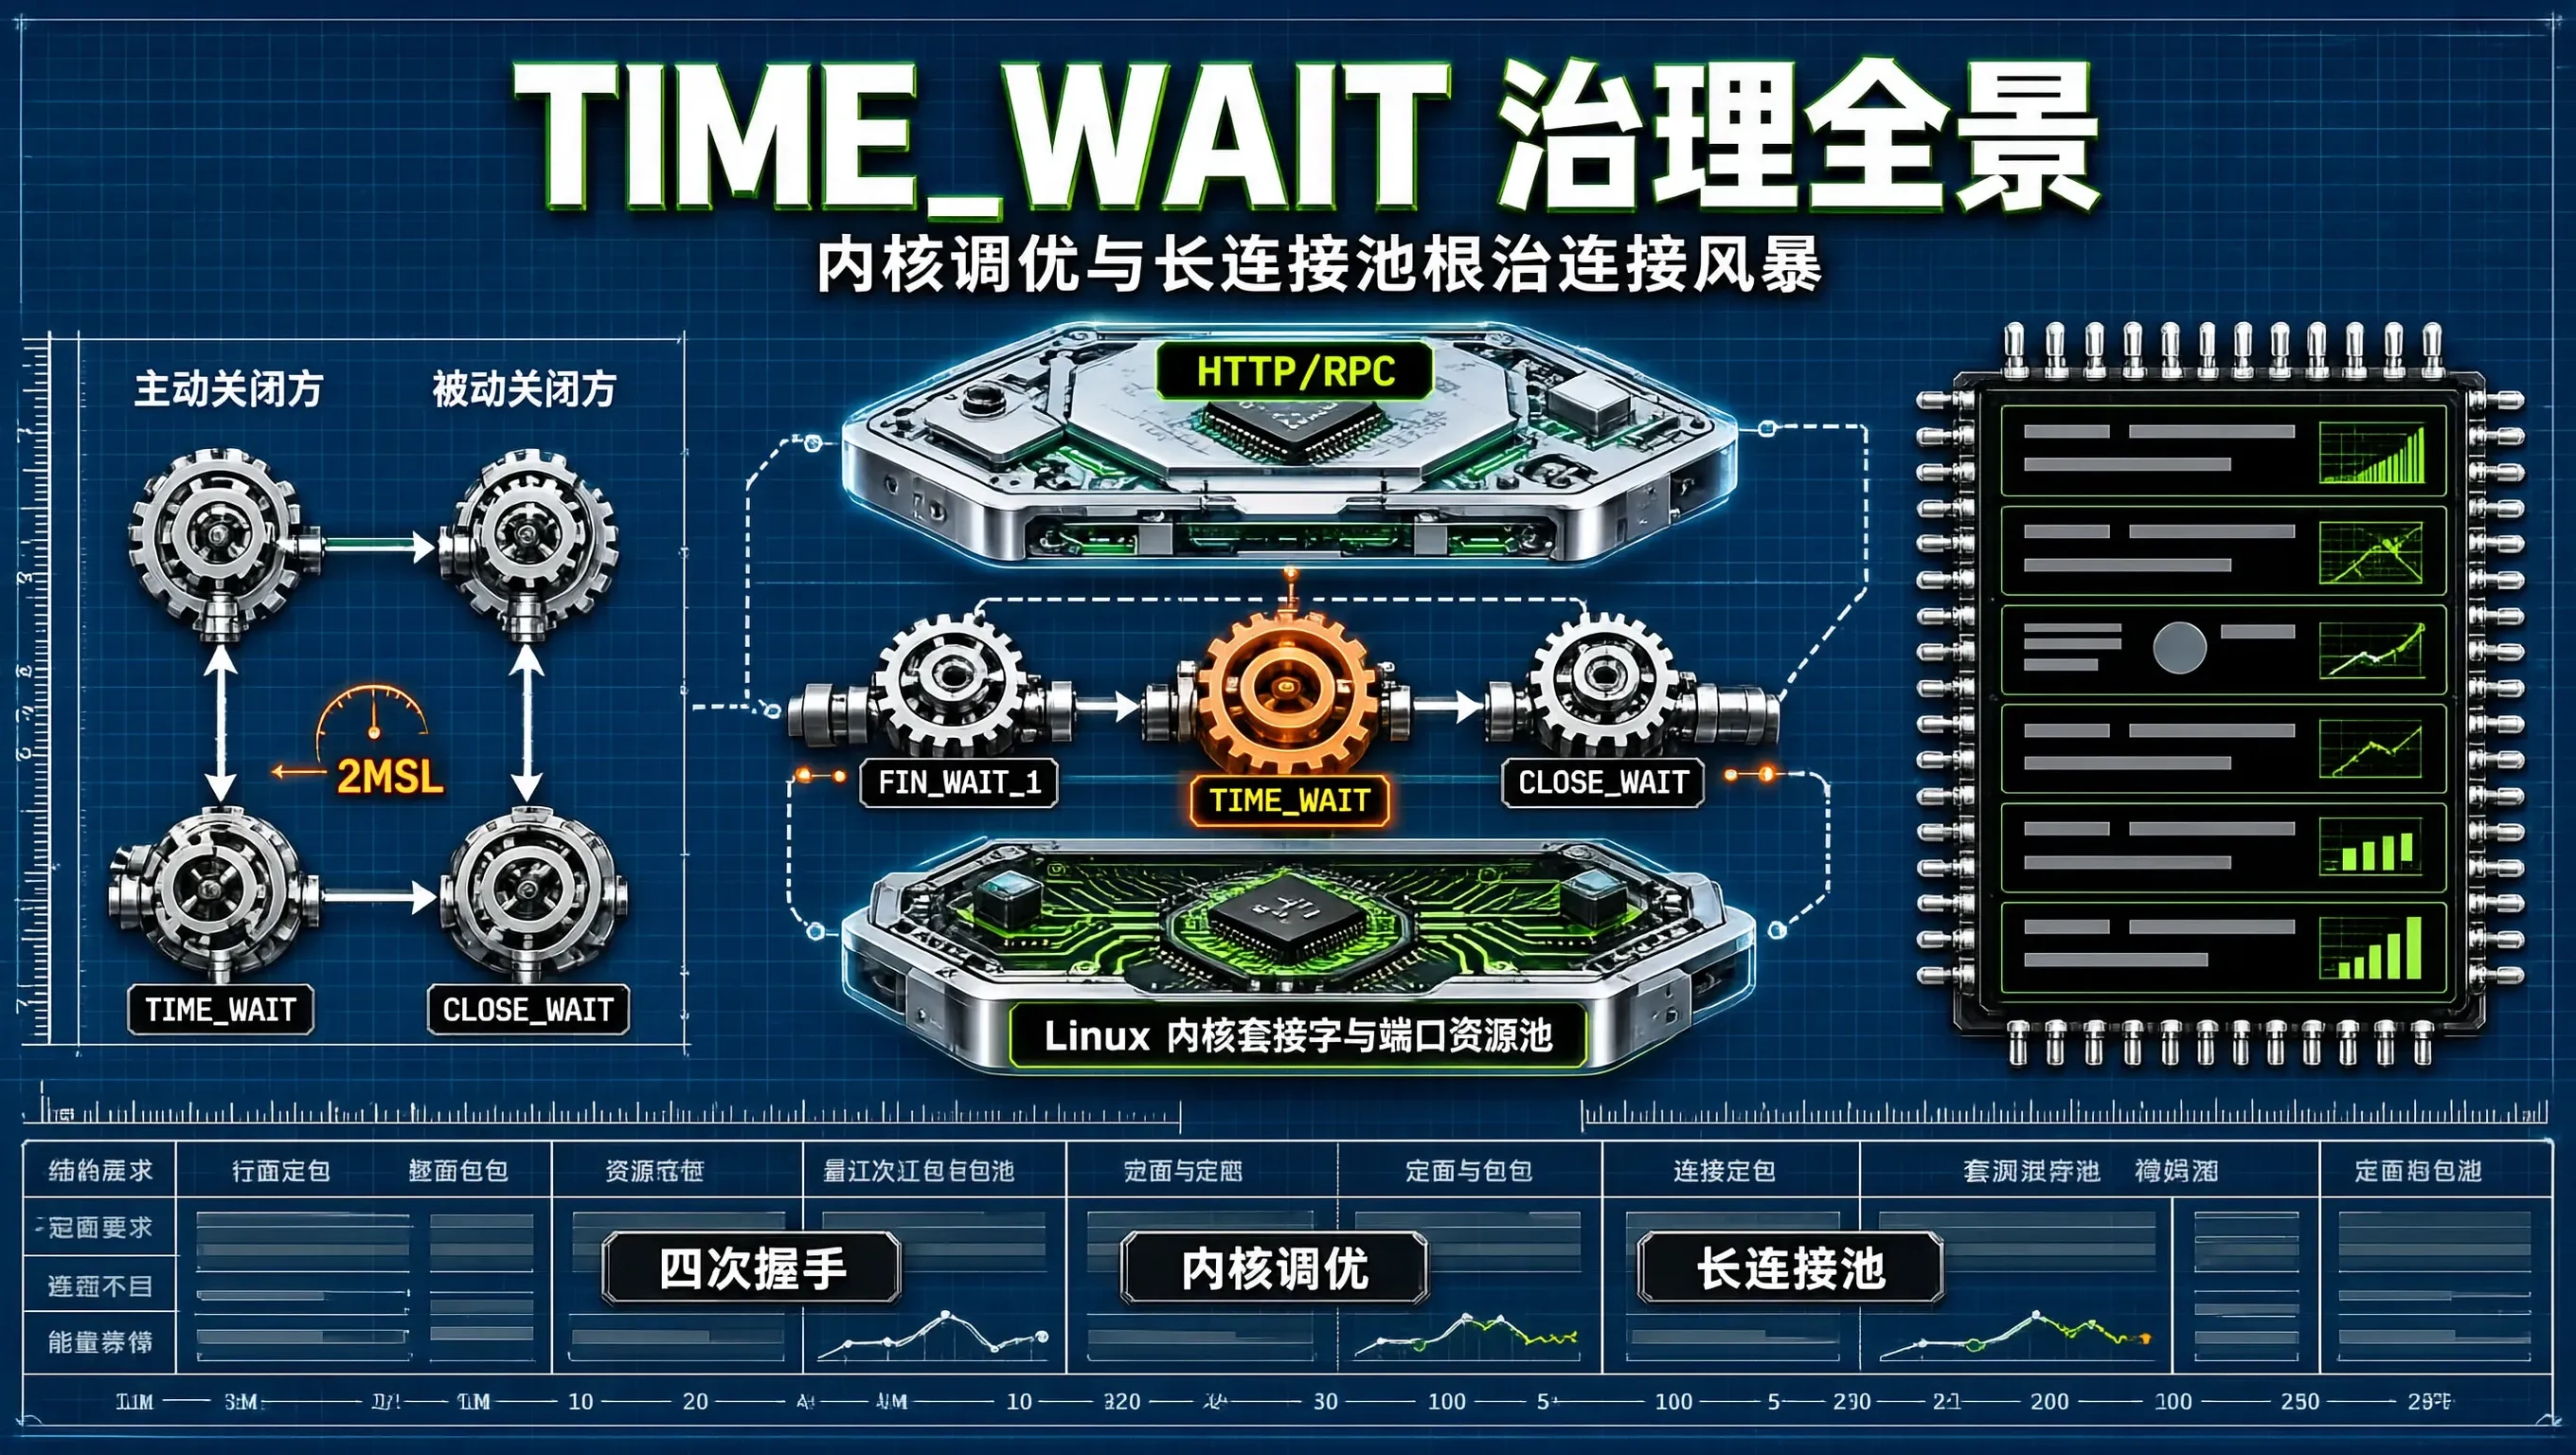
敲下命令ss -s或者检查系统网络状态,一行刺眼的统计数字立刻跳入眼帘:系统当前竟然驻留着TIME_WAIT!操作系统可用的本地临时端口(Ephemeral Ports)已经被全部占满,新连接根本无法申请到可用的端口发起握手。面对堆积如山的TIME_WAIT,很多人会在网上搜索出一堆所谓的“优化参数”,甚至盲目开启早就被 Linux 内核官方废弃的危险参数,结果不仅没解决问题,反而引发了局域网大面
在 DPDK(Data Plane Development Kit)庞大的高性能代码库中,如果只能挑选一个最精妙、最核心的数据结构,那非 rte_ring莫属。整个 DPDK 的内存池分配()、核心间通信(IPC)、数据包收发调度,底层全部牢牢依托于这个无锁队列。它在单核上的存取开销仅需不到 10 个 CPU 时钟周期,而在多核多线程极端并发争抢下,依然能维持每秒数亿次指针流转的恐怖吞吐。没有操作
上周例行巡检数仓计算集群时,一条监控指标异常刺眼:一个平时只要跑两分钟的日级汇总任务,昨天突然跑了近一个半小时,Spark UI 上一个原本平平无奇的 Stage 堆满了上百次 Shuffle Spill(Disk)。点进执行日志一看,某个业务线新增了按“用户客户端设备指纹(device_fingerprint)”进行分组聚合的逻辑。原本业务只按“省份 + 年龄段 + 操作系统”聚合,总分组数(基
Tauri 是一个用于构建桌面应用的跨平台轻量级框架。前端 UI 视图:使用任何 Web 技术(React、Vue、Svelte 或纯 HTML/JS/CSS)来绘制界面。后端系统逻辑:使用Rust编写系统级业务逻辑,负责处理硬件访问、高吞吐计算、文件系统和操作系统原生的 API 调用。对于 C++ / 后端程序员来说,可以把 Tauri 理解为一个由 Rust 驱动的轻量级胶水层——它在底层将系
在大多数应用层开发者的心智模型中,内存往往是一个平坦、无限且廉价的数组。你调用一次new或malloc,系统就返回给你一个看似干净的十六进制指针(例如你顺着这个指针读写数据,操作系统和硬件仿佛隐形了一般,忠实地在背后完成一切支撑。然而,对于整天和高性能算子、大模型显存分配器打交道的底层系统工程师来说,这层平坦的表象之下,奔涌着一条充满精密规则与物理定律的壮阔河流。
单有高效的事件循环还不够。如果 Linux 内核的网络缓冲区和连接监听队列被卡死在默认的保守值,uvloop依然会遭遇“巧妇难为无米之炊”的尴尬。在大促高吞吐服务器上,必须对操作系统执行配套参数固化(# 提高系统单进程最大打开文件句柄上限# 增大全局套接字最大监听队列(全连接队列 Backlog)# 增大 TCP 半连接队列(SYN Flood 缓冲区)# 开启 TCP 连接快速复用,防范大量 T
在操作系统内核、高性能网络数据面(如 DPDK)以及极致低延迟的实时算子调度引擎中,互斥锁(std::mutex)往往被视为“昂贵”的代名词。因为传统的std::mutex底层依赖于操作系统的 Futex(Fast Userspace Mutex)系统调用。当一个线程发生锁竞争失败时,它会触发从用户态陷入内核态的上下文切换,并将当前线程挂起并让出 CPU。这套线程睡眠与重新唤醒的开销,通常在级别。
记录从 JeecgBoot 3.8.3 升级到 3.9.5 的决策过程:3.8.3 的多个安全漏洞(含 RCE、XSS、越权)、功能不足,以及 3.9.5 在安全加固、框架升级、AI 应用、Online 表单方面的关键改进。附信创环境完整部署规划(openEuler + PostgreSQL 17 + Redis 7.4 + Nginx 1.28)。
建议首选Java或Go,深入理解变量、循环、函数、面向对象、异常处理、集合框架。同时必须补计算机基础:操作系统(进程/线程、内存管理、文件系统)、计算机网络(TCP/IP、HTTP/HTTPS、DNS)、数据结构与算法(数组、链表、栈、队列、树、排序、查找)。同时要具备非功能需求的设计能力:高可用(熔断、限流、降级、容灾)、高扩展(水平扩容、无状态设计)、安全性(认证授权、加密、防攻击)、可观测性
内核版本决定系统的基础能力,生态则决定可用的软件、工具和社区支持。是 Linux 下最常用的文本编辑器之一,用于查看和修改配置文件、编写代码等。动态库类似公用设施,静态库类似私有物品;动态库公用传址,静态库多需要一份空间。版本号格式:主版本号.次版本号.源程序发行号.主机平台.cpu架构。是 GNU 编译器套件,用于把 C 语言源代码编译成可执行程序。)来实现软件包的下载和安装功能。评估一个操作系
Tokio 将 Rust 语言的编译期安全与操作系统的底层事件驱动融为一体,构建出了全人类软件工程史上最轻盈、最坚固、吞吐最恐怖的异步并发底座。掌握了 Tokio 的全景微观机制,你便掌握了驾驭百万高并发世界的终极钥匙。
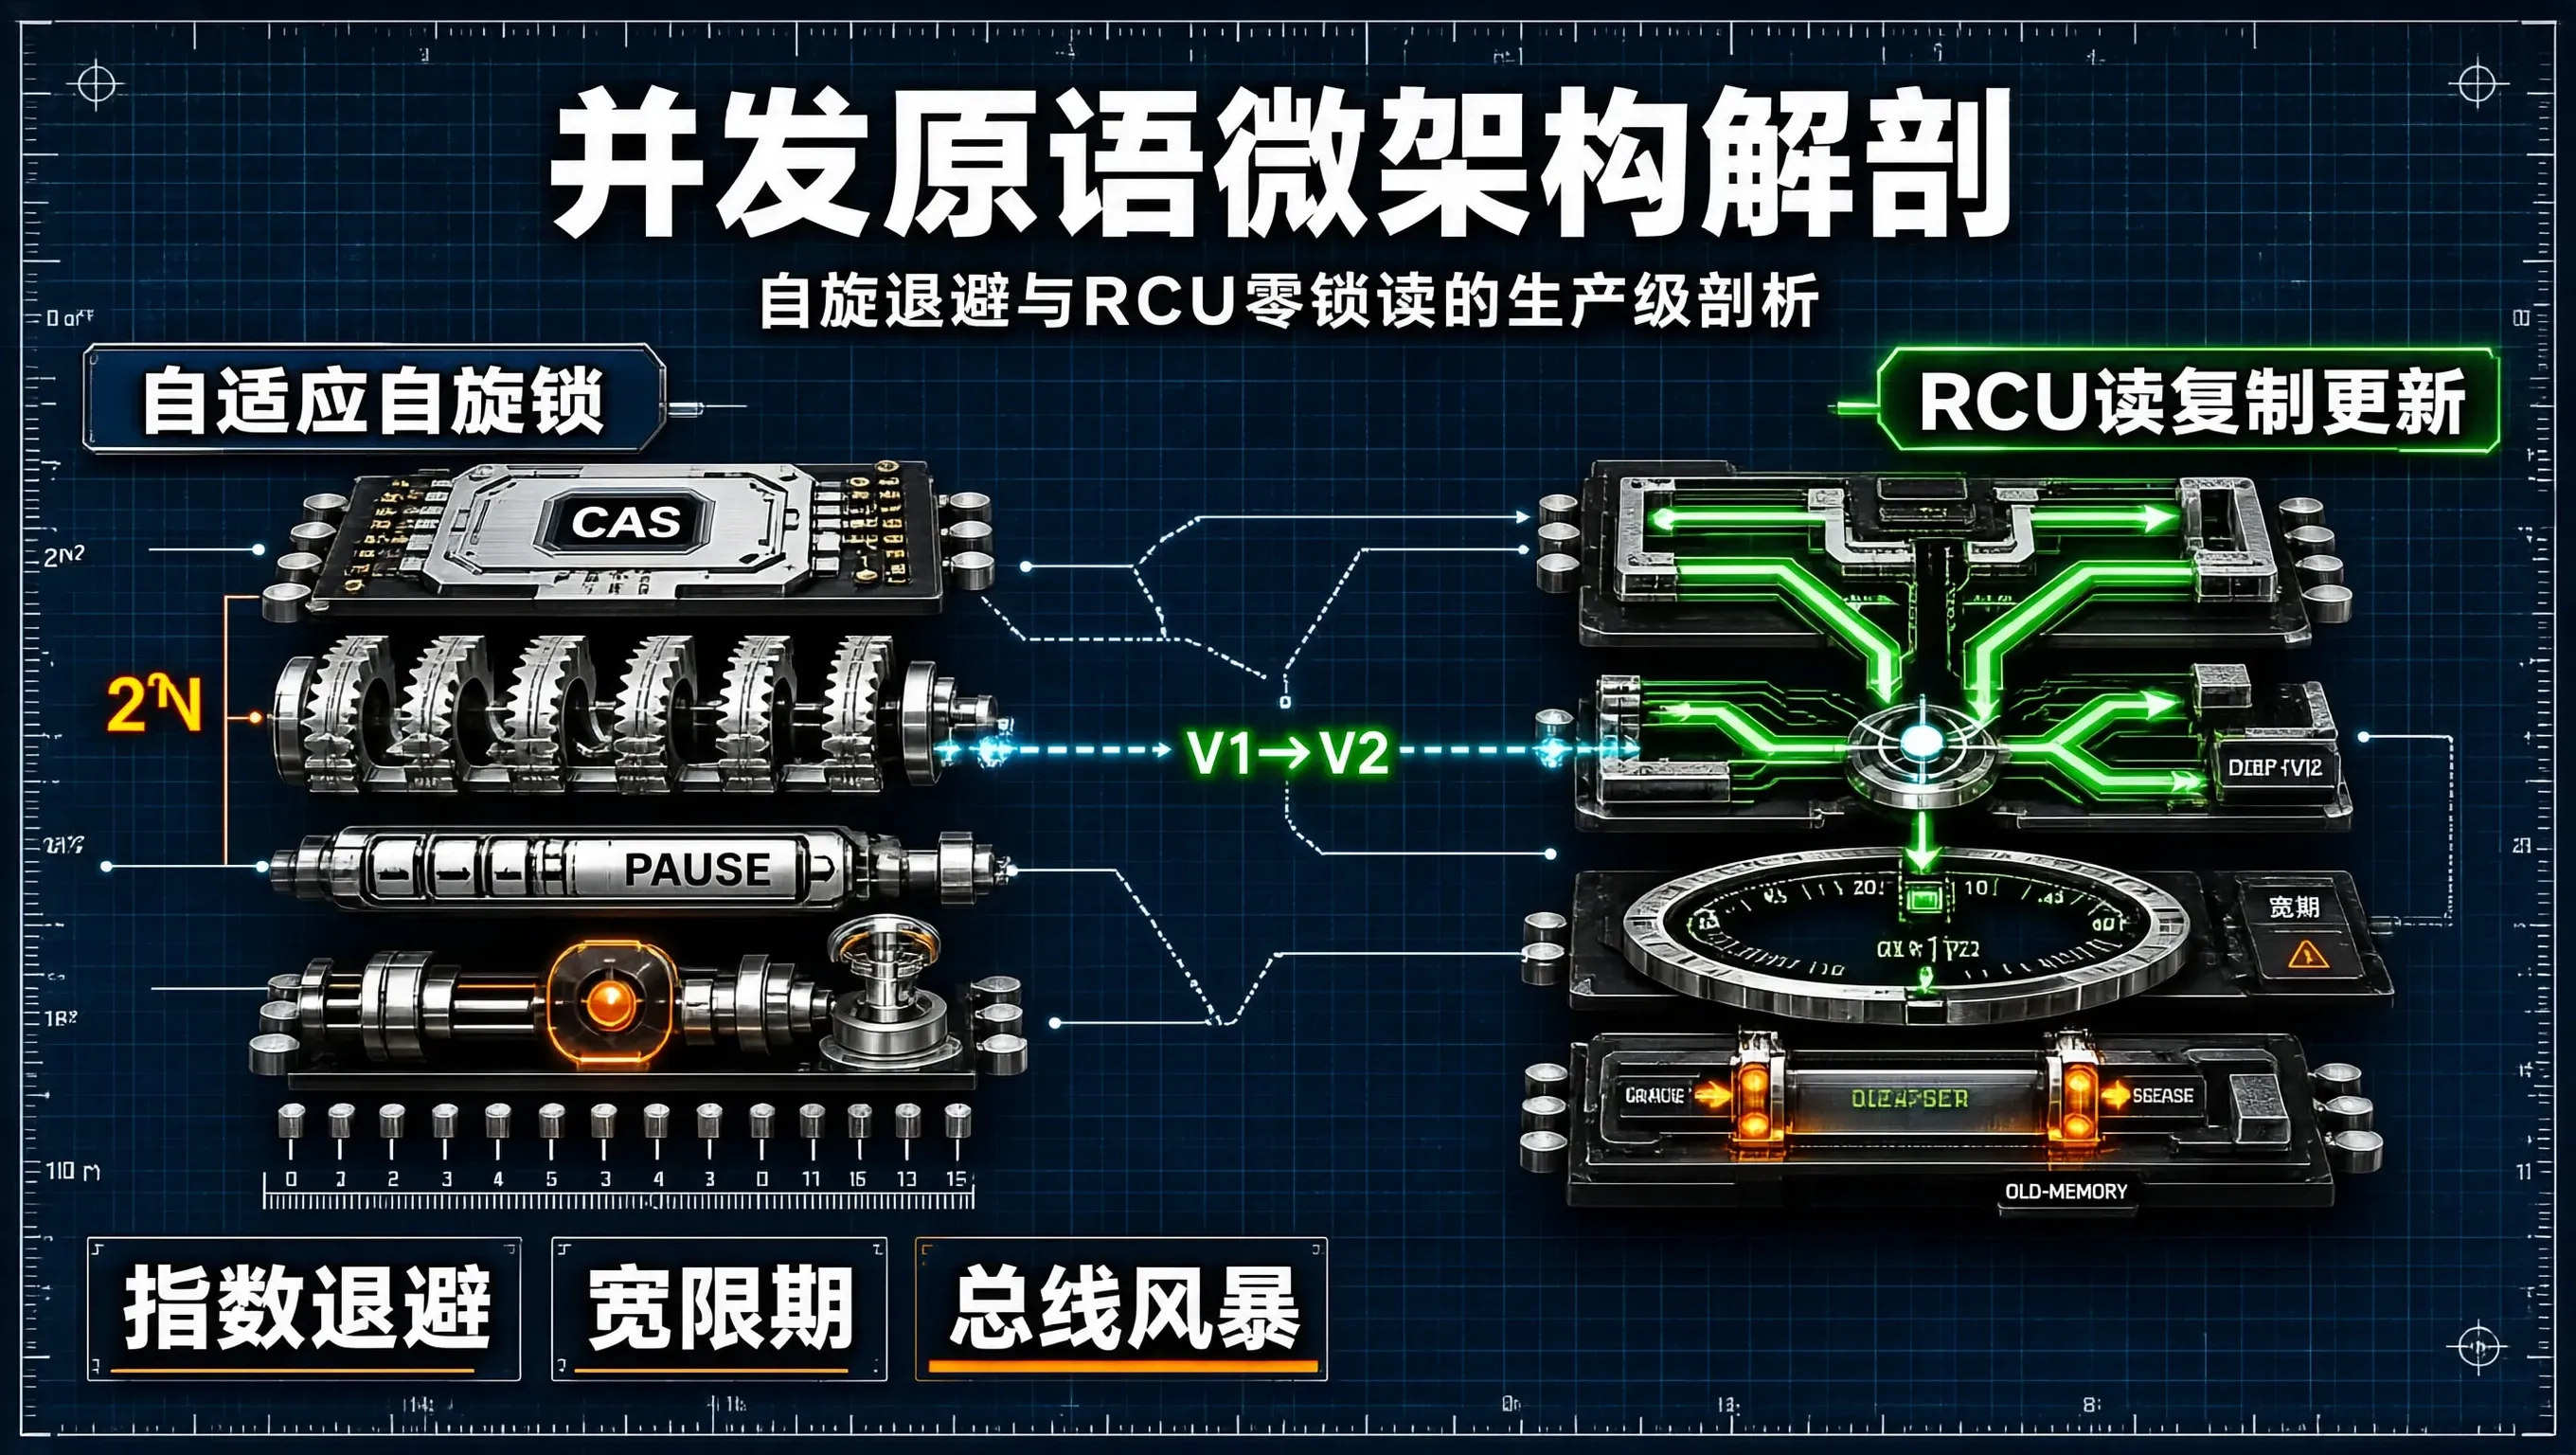
在多核对称多处理(SMP)与非统一内存访问(NUMA)架构下,编写能够线性扩展的高性能并发程序,本质上是一场。回顾九月在“并发原语”专栏中的探索,我们从操作系统互斥锁(Mutex)的底层上下文切换开销,到硬件原子指令(CAS / FAA)的总线一致性风暴,再到基于 64 字节缓存行对齐的无锁队列(Lock-Free RingBuffer)、带 PAUSE 退避的自适应自旋锁,以及读端绝对零开销的
在九月份的“Node/Go 高并发”专栏中,我们从操作系统底层的 Linux 内核参数出发,一路深入到运行时垃圾回收、事件循环、流式背压管道、连接池管理以及分布式限流熔断。面对高并发流量浪潮,如何用最小的资源消耗构筑最稳固的服务底座?在月度终章,我们将整月的性能调优心法提炼为一张。
先调内核,再写代码:操作系统内核是承载高并发的地基,FD 上限和 TCP 缓冲区大小是无法逾越的物理红线。海量长连接坚决抛弃“一连接一协程”:在海量空闲连接(如 IoT、消息推送)场景下,Reactor 异步事件驱动是降本增效的终极答案。敬畏内存分配:在网络包编解码中,全面推行sync.Pool字节切片复用,彻底消灭 GC 压力,系统才能在百万并发下波澜不惊。
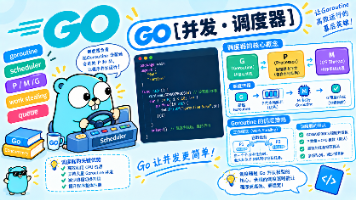
本文深入解析Go运行时调度器(Scheduler),揭示goroutine如何在有限操作系统线程中高效并发执行。核心概念为G(goroutine)、M(OS线程)、P(执行资源),调度器任务是将可运行的G分配给有P的M。通过本地/全局队列、工作窃取机制实现负载均衡;阻塞操作(如channel、锁、I/O)不占用CPU,由netpoller和抢占机制保障响应性。借助GODEBUG=schedtrac
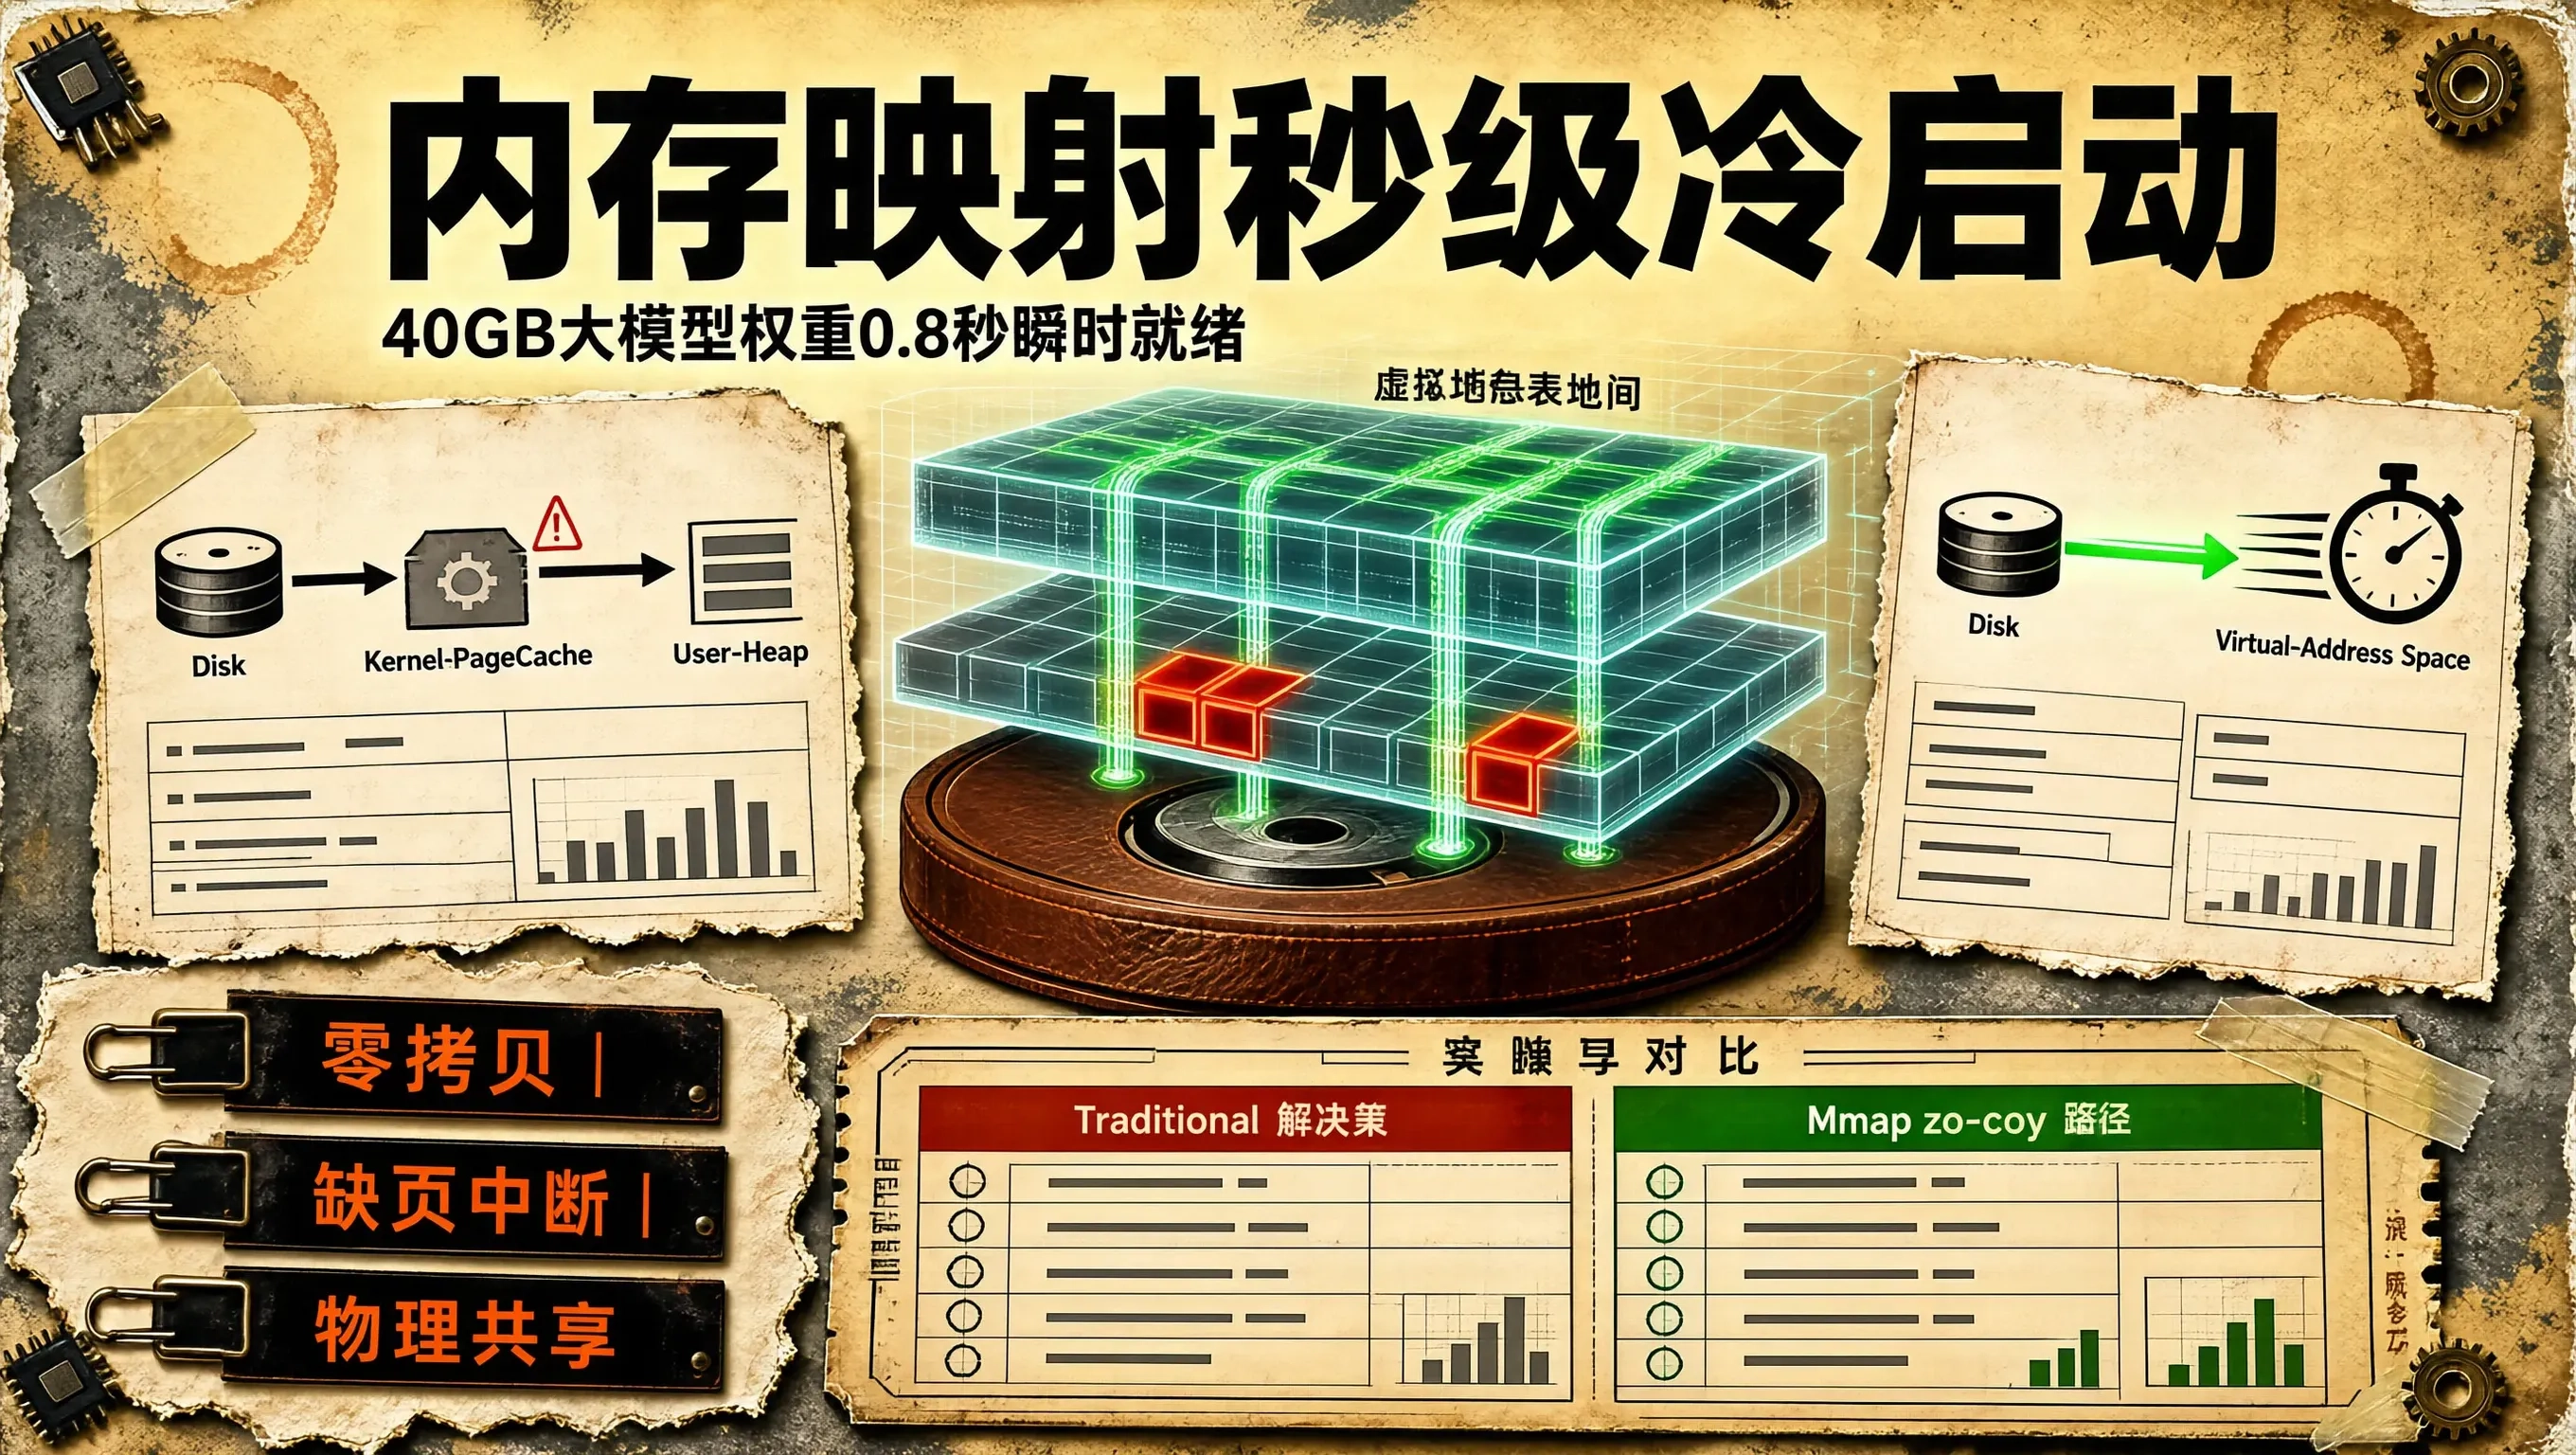
在针对数十吉字节(如 70B 模型权重文件约 40GB)的大语言模型开展服务部署与弹性自动扩缩容(Serverless Auto-Scaling)时,是决定系统弹性和资源利用率的核心指标。在传统的模型加载实现中(如经典的 Python/PyTorchtorch.load或标准 C 语言freadmalloc利用操作系统底层的 mmap原语与实现了的工程奇迹。深入剖析mmap的虚拟页表缺页机制与按需
在多核高性能并发编程中,当临界区(Critical Section)极其短小(仅耗时数纳秒到数十纳秒)时,直接使用操作系统的互斥锁(Mutex)会因为陷入内核态 futex 休眠与线程唤醒调度,导致长达数微秒的系统延迟。此时,成为了极客们的首选武器。然而,朴素的自旋锁在多核争用剧烈时,会导致所有争用核心疯狂执行原子指令,引发总线风暴(Bus Storm)并使 CPU 功耗暴增、流水线指令重排崩溃。
VM 是通过 Hypervisor 在物理机上模拟完整电脑,自带操作系统,隔离性强但资源开销大。Docker 共享宿主内核,轻量快速,适合微服务与开发一致性。Serverless 由平台按需调度,零运维、按调用计费,适合事件驱动与波动流量。三者从左到右抽象层级递增:VM(全掌控)→ Docker(应用级控制)→ Serverless(代码即服务)。现代应用多采用 Docker + VM 组合,Se
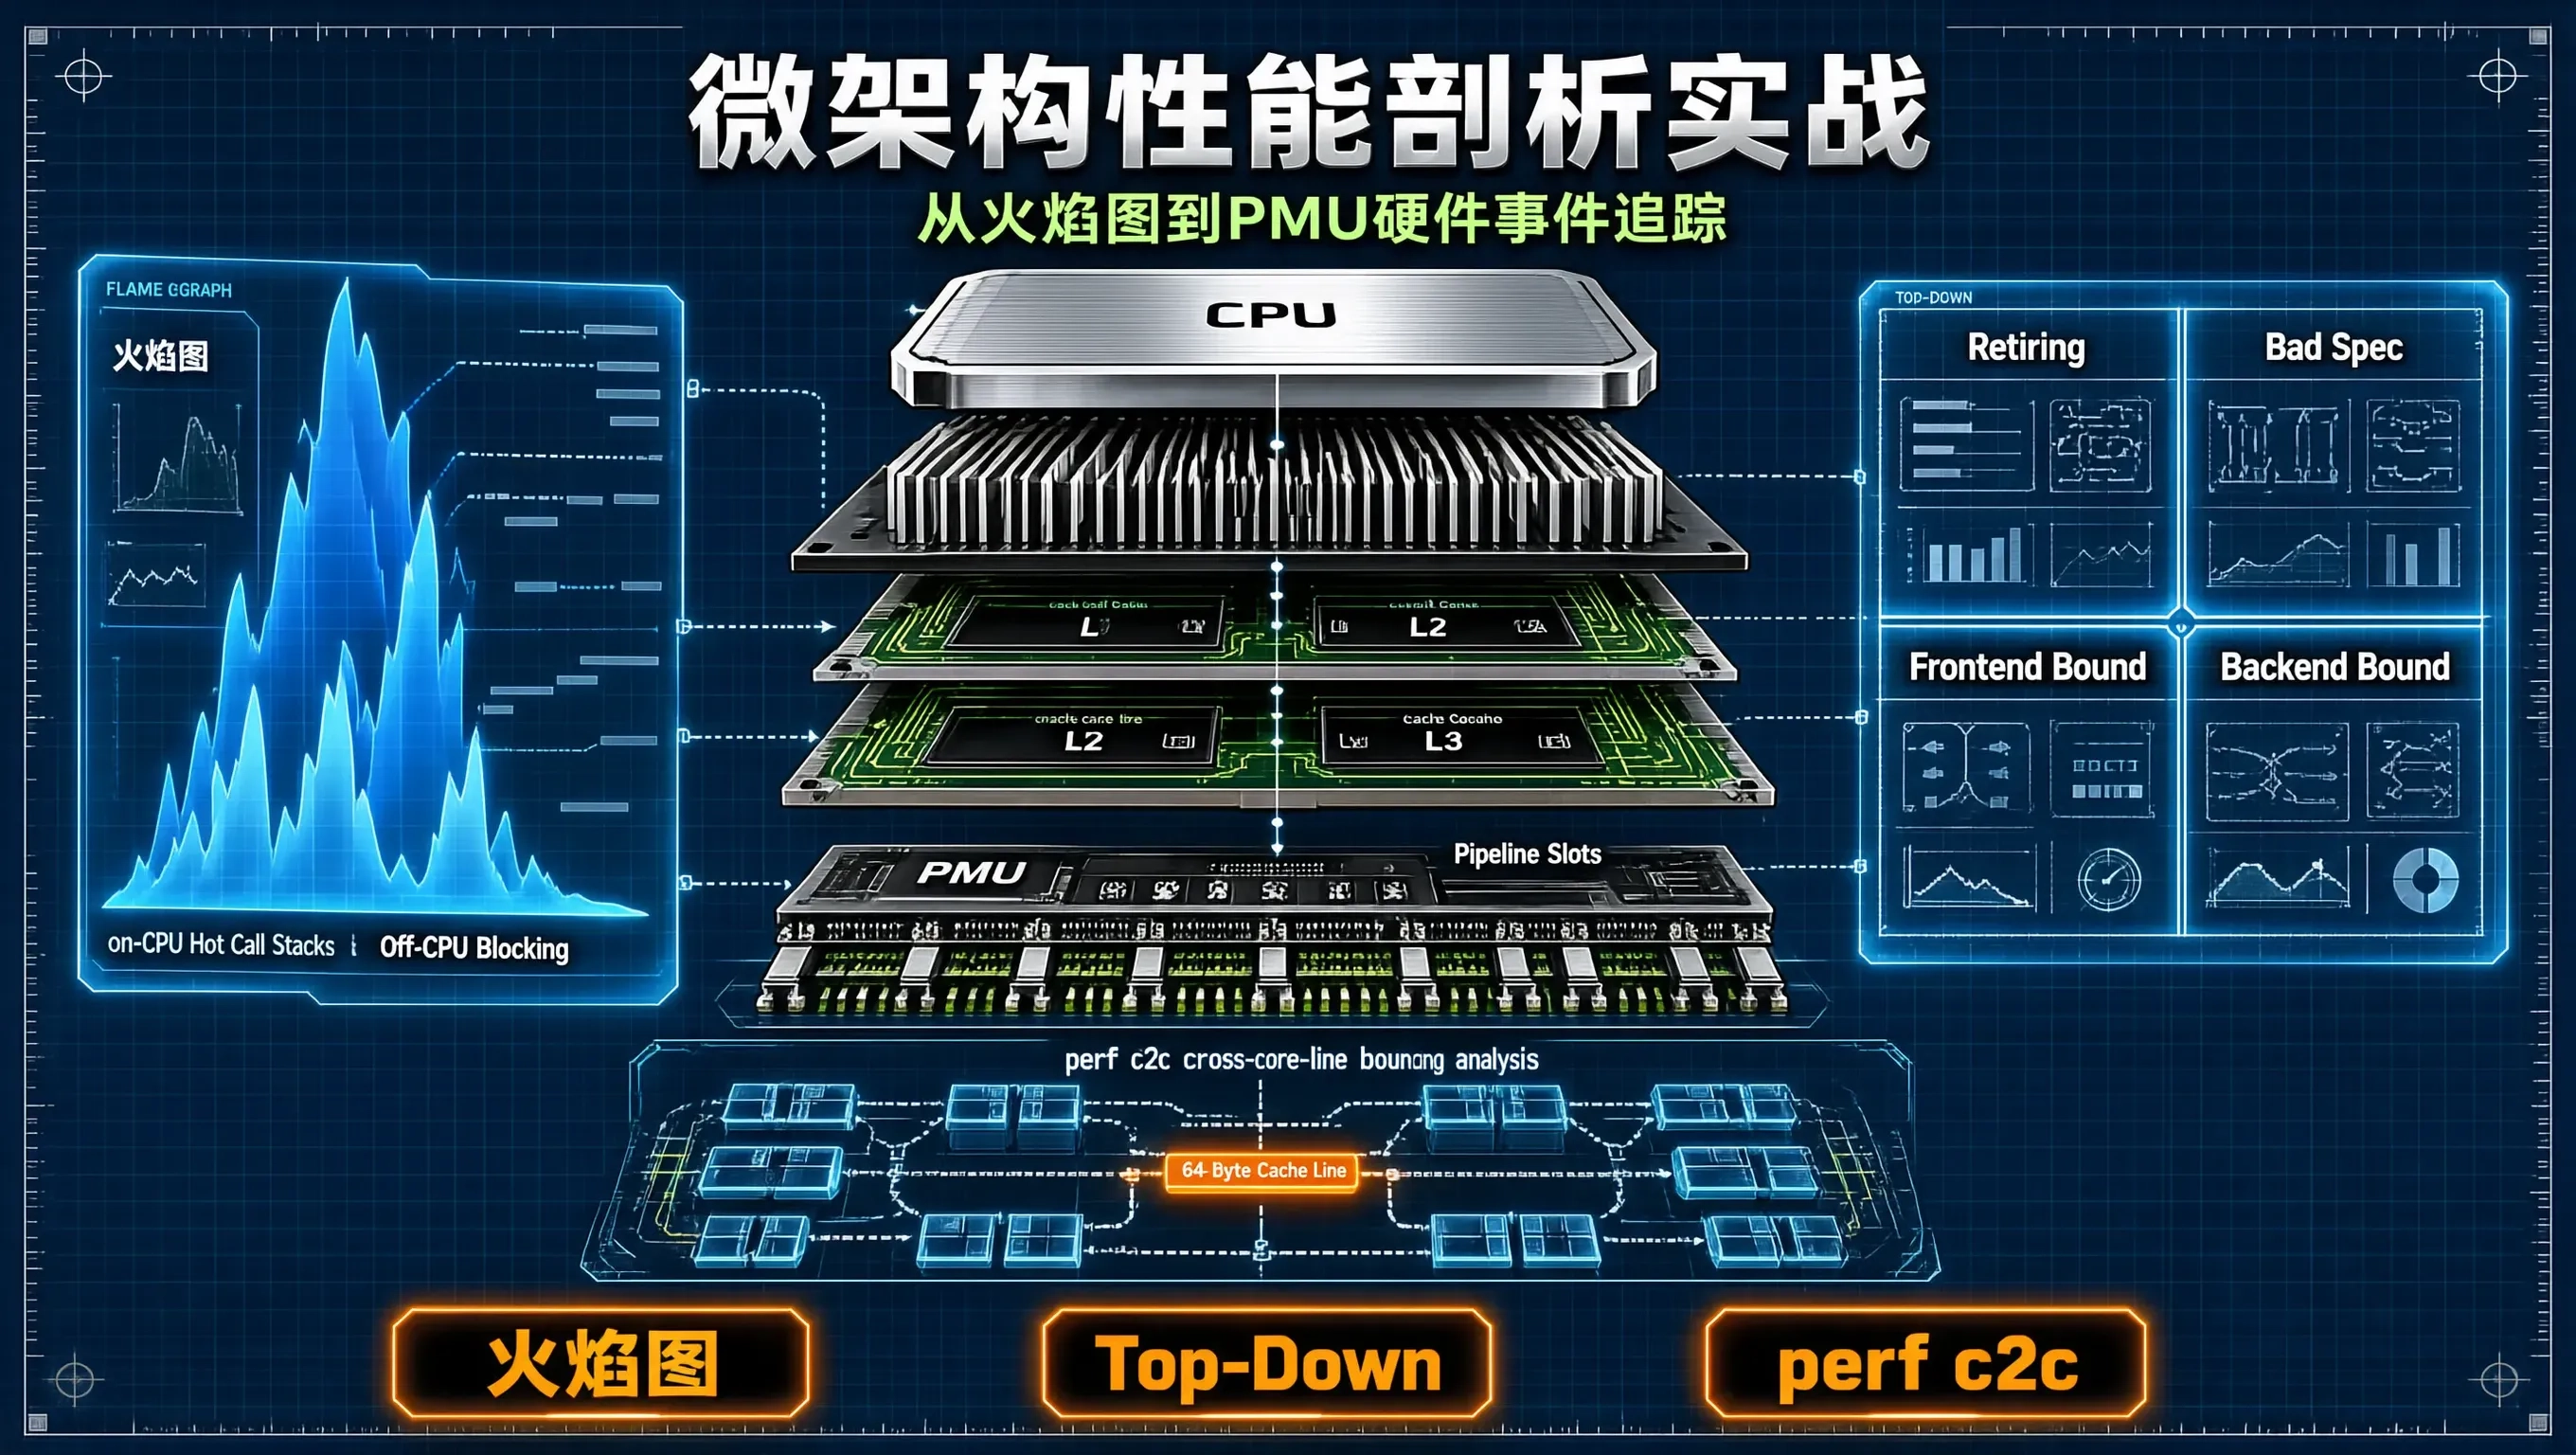
在大型服务端程序与高性能系统的调优实战中,许多工程师往往停留在看应用日志、打印打点耗时或使用通用的 CPU 使用率监控(如 top/htop)。然而,当 CPU 达到瓶颈或系统在低 CPU 利用率下吞吐依然无法提升时,传统的粗粒度监控手段便彻底失效。性能分析(Profiling)的本质是一门建立在硬件微架构(Microarchitecture)与操作系统内核调度基础上的严密诊断科学。从识别算力瓶颈
7、了解分布式系统设计与开发、负载均衡技术,系统容灾设计,高可用系统等知识;6、全面、扎实的软件知识结构,掌握操作系统、数据结构、网络等专业知识;1. 参与交易平台的设计、开发与测试,实现交易策略、风控等需求;4、编程基本功扎实,熟练C/C++开发语言、常用算法和数据结构;#幻方#明汯#九坤#鸣石#天演#进化论#佳期#量化研究员#C++5、熟悉TCP/UDP网络协议及相关编程、进程间通讯编程;春招
在高并发大语言模型(LLM)在线推理服务(如 vLLM、TensorRT-LLM、自研推理引擎)中,是制约 GPU 批处理并发容量(Concurrency Capacity)的最致命杀手。借鉴操作系统经典的思想,解构与,是彻底终结显存浪费的核心技术方案。
vLLM 的成功给推理优化树立了一个范式:用系统级的思维解决模型级的问题。PagedAttention 学的是操作系统,连续批处理学的是调度器——它没有改变模型本身,却通过工程手段把硬件潜力释放了出来。对工程团队而言,这条路径同样适用:先搞懂瓶颈在哪(带宽与容量,而非算力),再选择匹配的手段(显存管理、批处理、量化),最后用数据验证收益。模型在迭代,硬件在升级,但"找到瓶颈、对症下药、数据说话"的
我见过一个朋友,把《流畅的Python》翻了三遍,笔记做了两大本,让他写个批量重命名文件的脚本,他卡在os模块上。我的建议很直接:先选一个方向,扎进去,做出三个能拿得出手的项目,再考虑横向扩展。比如你选Web开发,就用FastAPI或Django写一个完整的博客系统,带用户认证、数据库、部署上线。可现实是,你写得出代码,但不知道为什么这样写。项目做完了,再回头看基础,补数据结构,补操作系统。花点时
老子说“知止不殆”,知道不做什么,比知道做什么更重要。曾国藩说“大处着眼,小处着手”,架构师要能看三年,也能改一行。缓存穿透、雪崩、击穿,消息重复、顺序、积压,分库分表后的全局ID和跨库查询。但底层不变,网络、操作系统、数据结构、算法,这些是内功。每天读源码,每周写博客,每年参与开源。不只是队列,它的分区、副本、ISR,决定吞吐和可靠。苏轼说“博观而约取,厚积而薄发”,架构师不是学出来的,是踩坑踩
在大促微服务 RPC 相互调用、反向代理与大模型 API 网关集群中,系统工程师经常遭遇一种诡异的“网络瘫痪”:服务器 CPU 占用率不到 20%,内存剩余充足,网络带宽利用率不足 15%,但新发起的 HTTP/RPC 请求却大面积报错(无法分配请求地址)或。通过netstat或ss命令排查,会发现系统中堆积了TIME_WAITCLOSE_WAIT。这些套接字不仅占用了宝贵的内核内存,更耗尽了操作
重点理解MVC、依赖注入、AOP、拦截器、参数校验、全局异常处理。数据库先学MySQL:建表、索引、事务、锁、慢查询优化。所以先学一门语言的基础:变量、循环、函数、面向对象、异常、集合、IO、多线程。同时补上计算机网络(HTTP、TCP/IP)、操作系统(进程、线程、内存)、数据结构与算法。后端语言很多:Java、Go、Python、Node.js、C++。一门精通,触类旁通。很多初学者学后端,今
后端新技术的涌现速度确实让人眼花缭乱,但如果你把目光从“框架怎么用”移到“问题怎么解”,就会发现它们大多是在重复解决那几类老问题。网络、数据、并发、缓存与消息、部署与观测——这5样构成了后端工程师的“底层操作系统”。它们不会过时,只会不断被新的实现方式重新包装。与其追逐每一个新名词,不如先把这5样吃透。不是新技术变简单了,而是你变强了。
在百万级高并发大促活动打响之前,对核心 Rust 底座(包含手写无锁环形队列、自定义内存池、SIMD 裸指针运算与 FFI 跨语言边界)执行 全面的 Unsafe 专项安全审计,是保障系统绝对零崩溃的最后一道硬核防线。很多开发者以为:“只要我的代码通过了 ,且在高压测试下没有触发操作系统 Segfault,代码就是绝对安全的。”然而,在 Rust 与 LLVM 编译器的严谨语义世界中,存在着大量极
真正的系统级性能调优,必须直击操作系统的底层分配器。“通过开启 jemalloc 后台回收线程,将脏页衰减时间压缩至 1 秒,将 Arena 数量死死限制在 2 个”,配合 Prometheus 深层度量监控,从物理内存最底层彻底终结 Redis 碎片虚胖,是用硬核内功为企业换取数倍硬件利用率提升的工业级技术典范。
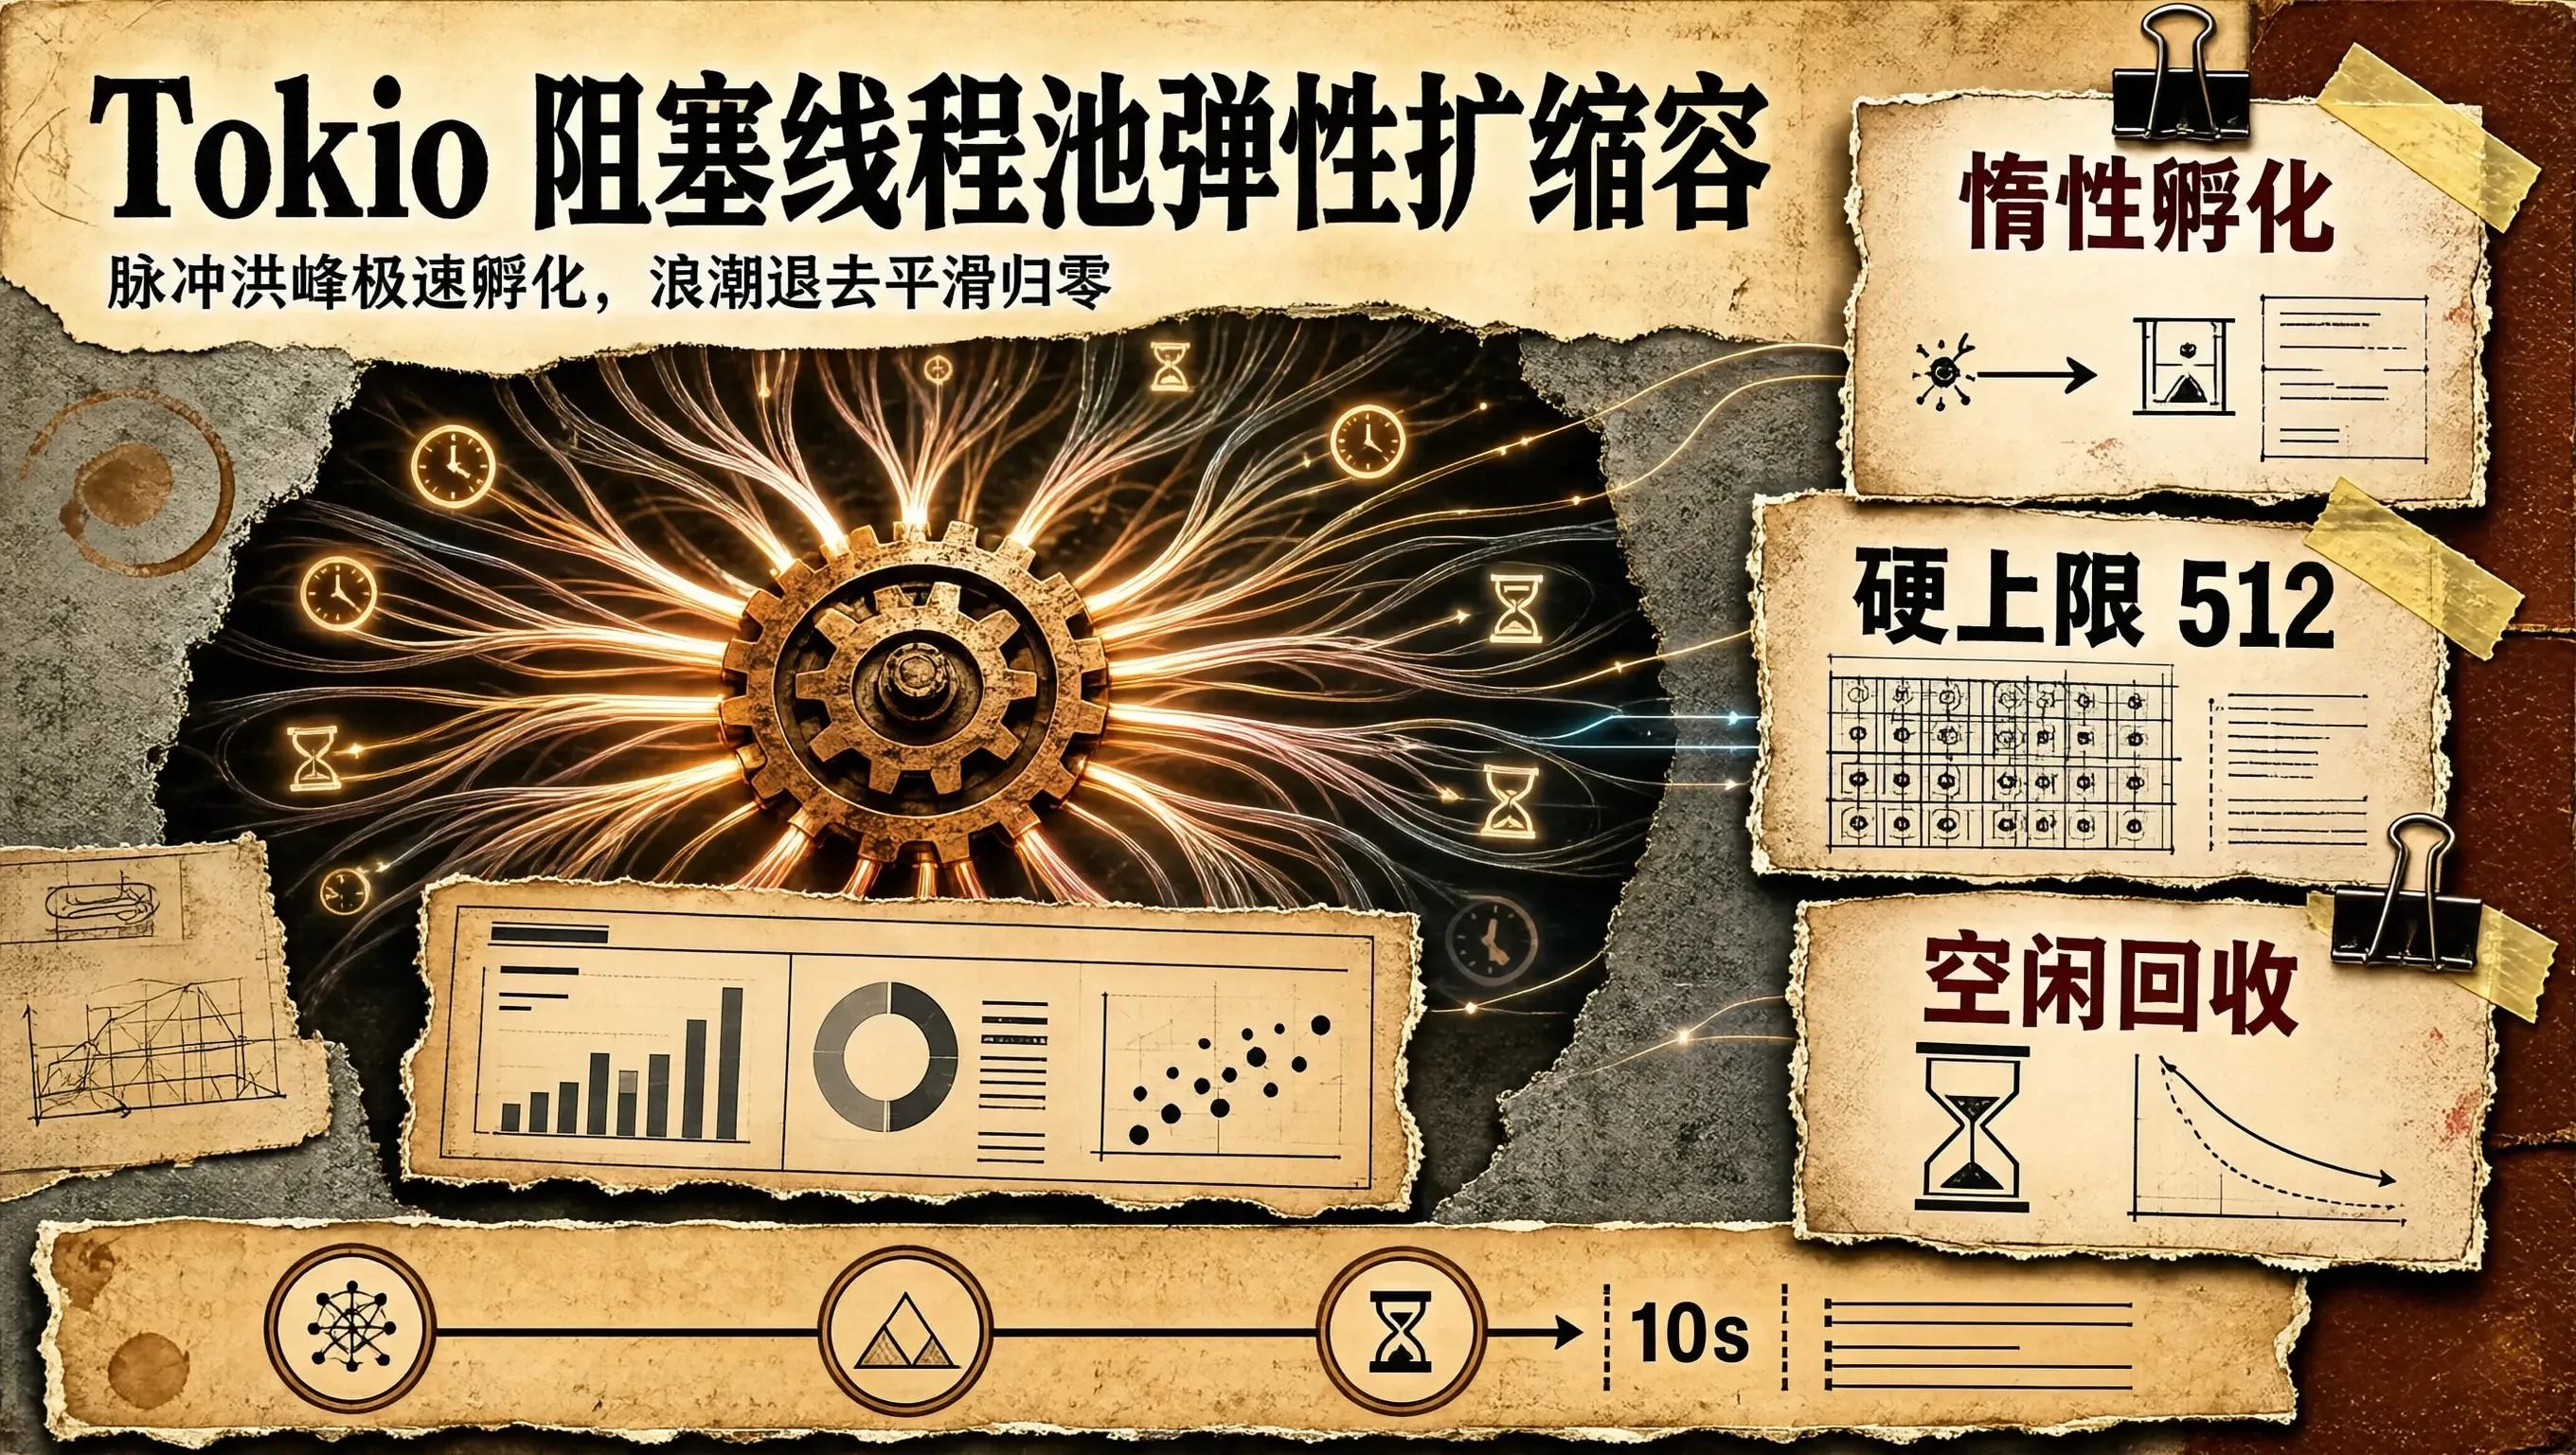
std::fs很多开发者以为只是一个简简单单的固定大小线程池。如果阻塞线程池采用固定大小(如固定 16 线程),突发任务会发生严重的排队阻塞;如果采用无限创建线程,又会瞬间耗尽操作系统的内存与 PID 描述符(引发崩溃)。深入剖析 Tokio 阻塞线程池是如何通过与实现丝滑弹性扩缩容的?
第 12 课的线程模型有个物理瓶颈:线程是操作系统资源——每个线程要一块独立栈(默认几 MB),上下文切换有内核开销。1 万个并发连接开 1 万线程,系统直接顶不住。而网络/LLM/文件这类场景,绝大多数时间线程只是等(等网络包、等响应),…
Shell 是用户与操作系统交互的一层程序。它既可以读取用户输入并执行命令,也可以解释脚本文件中的流程控制、变量和函数。用户或脚本↓Shell 命令解释器↓系统调用、程序和文件↓Linux 内核常见 Shell 包括 Bash、Zsh、Dash 和 Fish。它们有相似的基本用途,但语法和扩展特性并不完全相同。本文使用 Bash。编写脚本时应明确目标解释器,不要默认所有/bin/sh都等同于 Ba
在大语言模型(LLM)与超大规模多模态模型的高性能在线推理服务(如 vLLM、TensorRT-LLM、Triton Inference Server)中,。cudaMalloccudaFreecudaMalloc借鉴现代操作系统与 Linux 内核内存管理的精髓,在用户态构建一套融合与的层级显存池,是推理引擎打通极致吞吐的工业级基石。
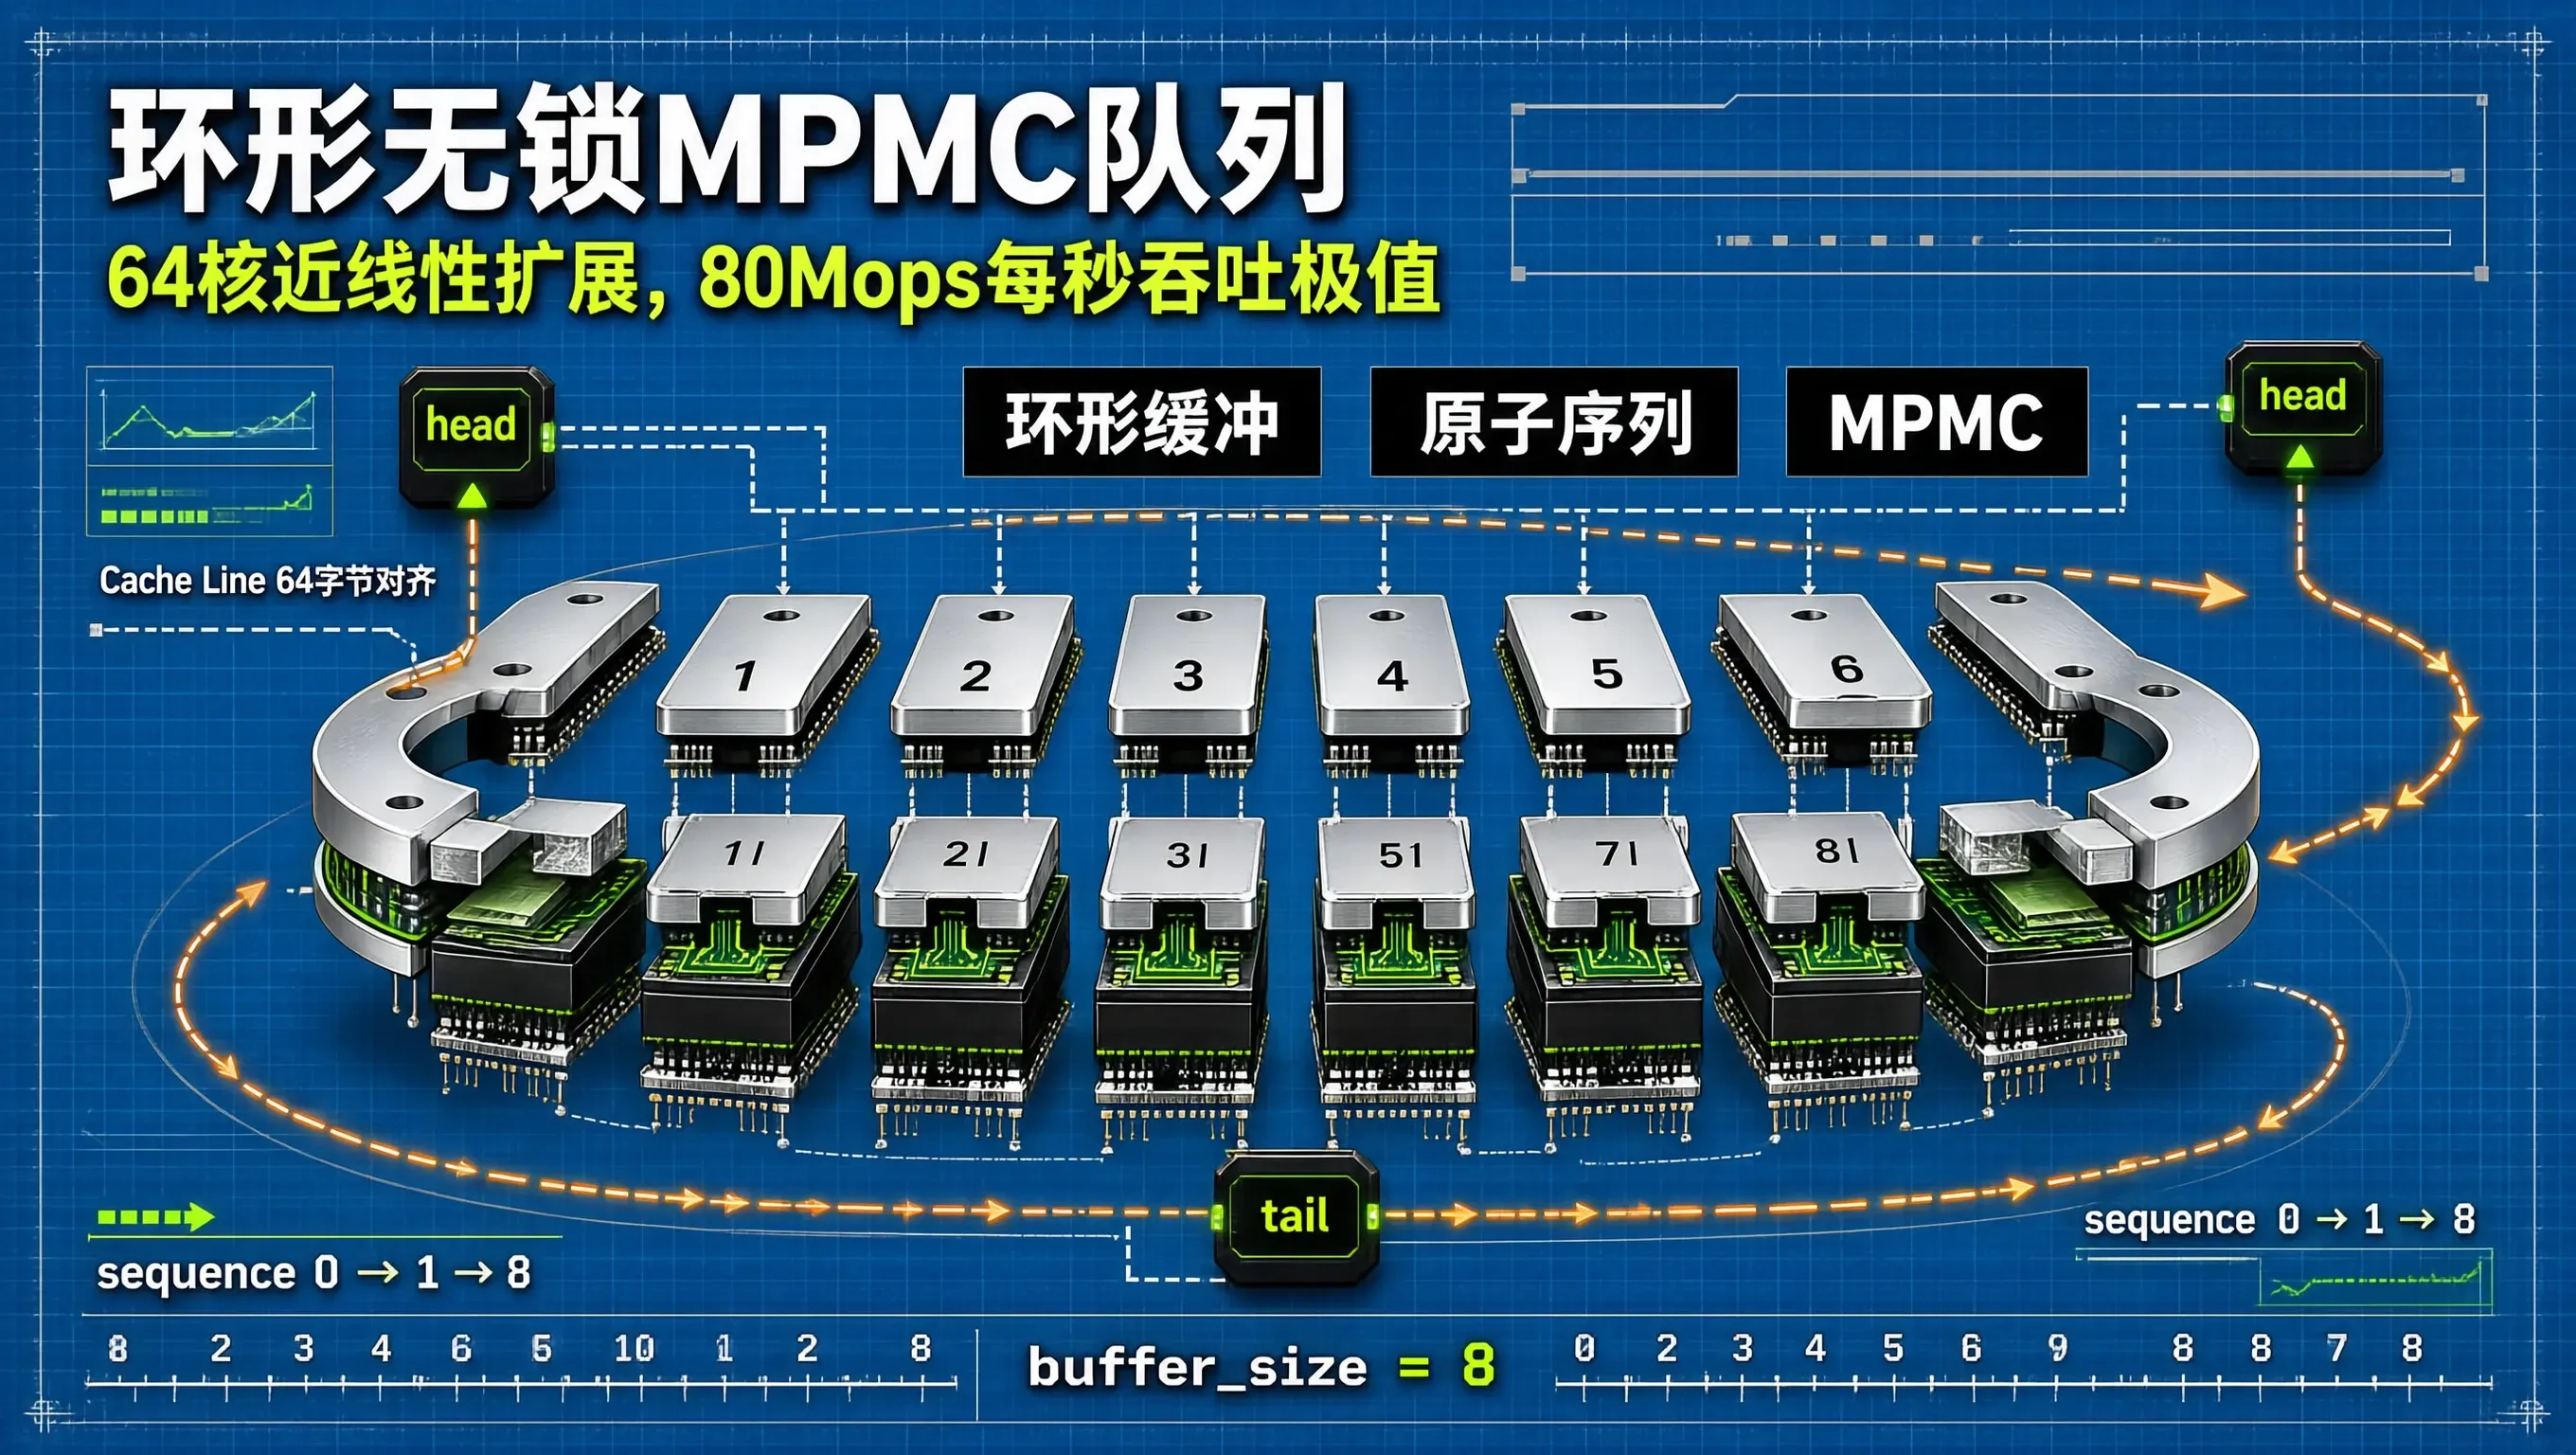
在现代多核高并发系统(如异步 Actor 框架、高性能日志收集器、分布式 RPC 线程池与撮合引擎)的底层架构中,多生产者多消费者(MPMC, Multi-Producer Multi-Consumer)无锁队列是被广泛依赖的高性能并发原语。传统的基于std::mutex互斥锁的 MPMC 队列在 32 核或 64 核高并发负载下,会引发剧烈的锁争用与频繁的操作系统上下文切换,导致吞吐量断崖式下滑
但如果你回头看,操作系统、网络协议、数据库原理、数据结构、设计模式,这些十年都没大变。今天学Redis,明天学Kafka,后天学K8s。真正的高手不是什么都懂,而是知道什么该学,什么可以暂时不学。
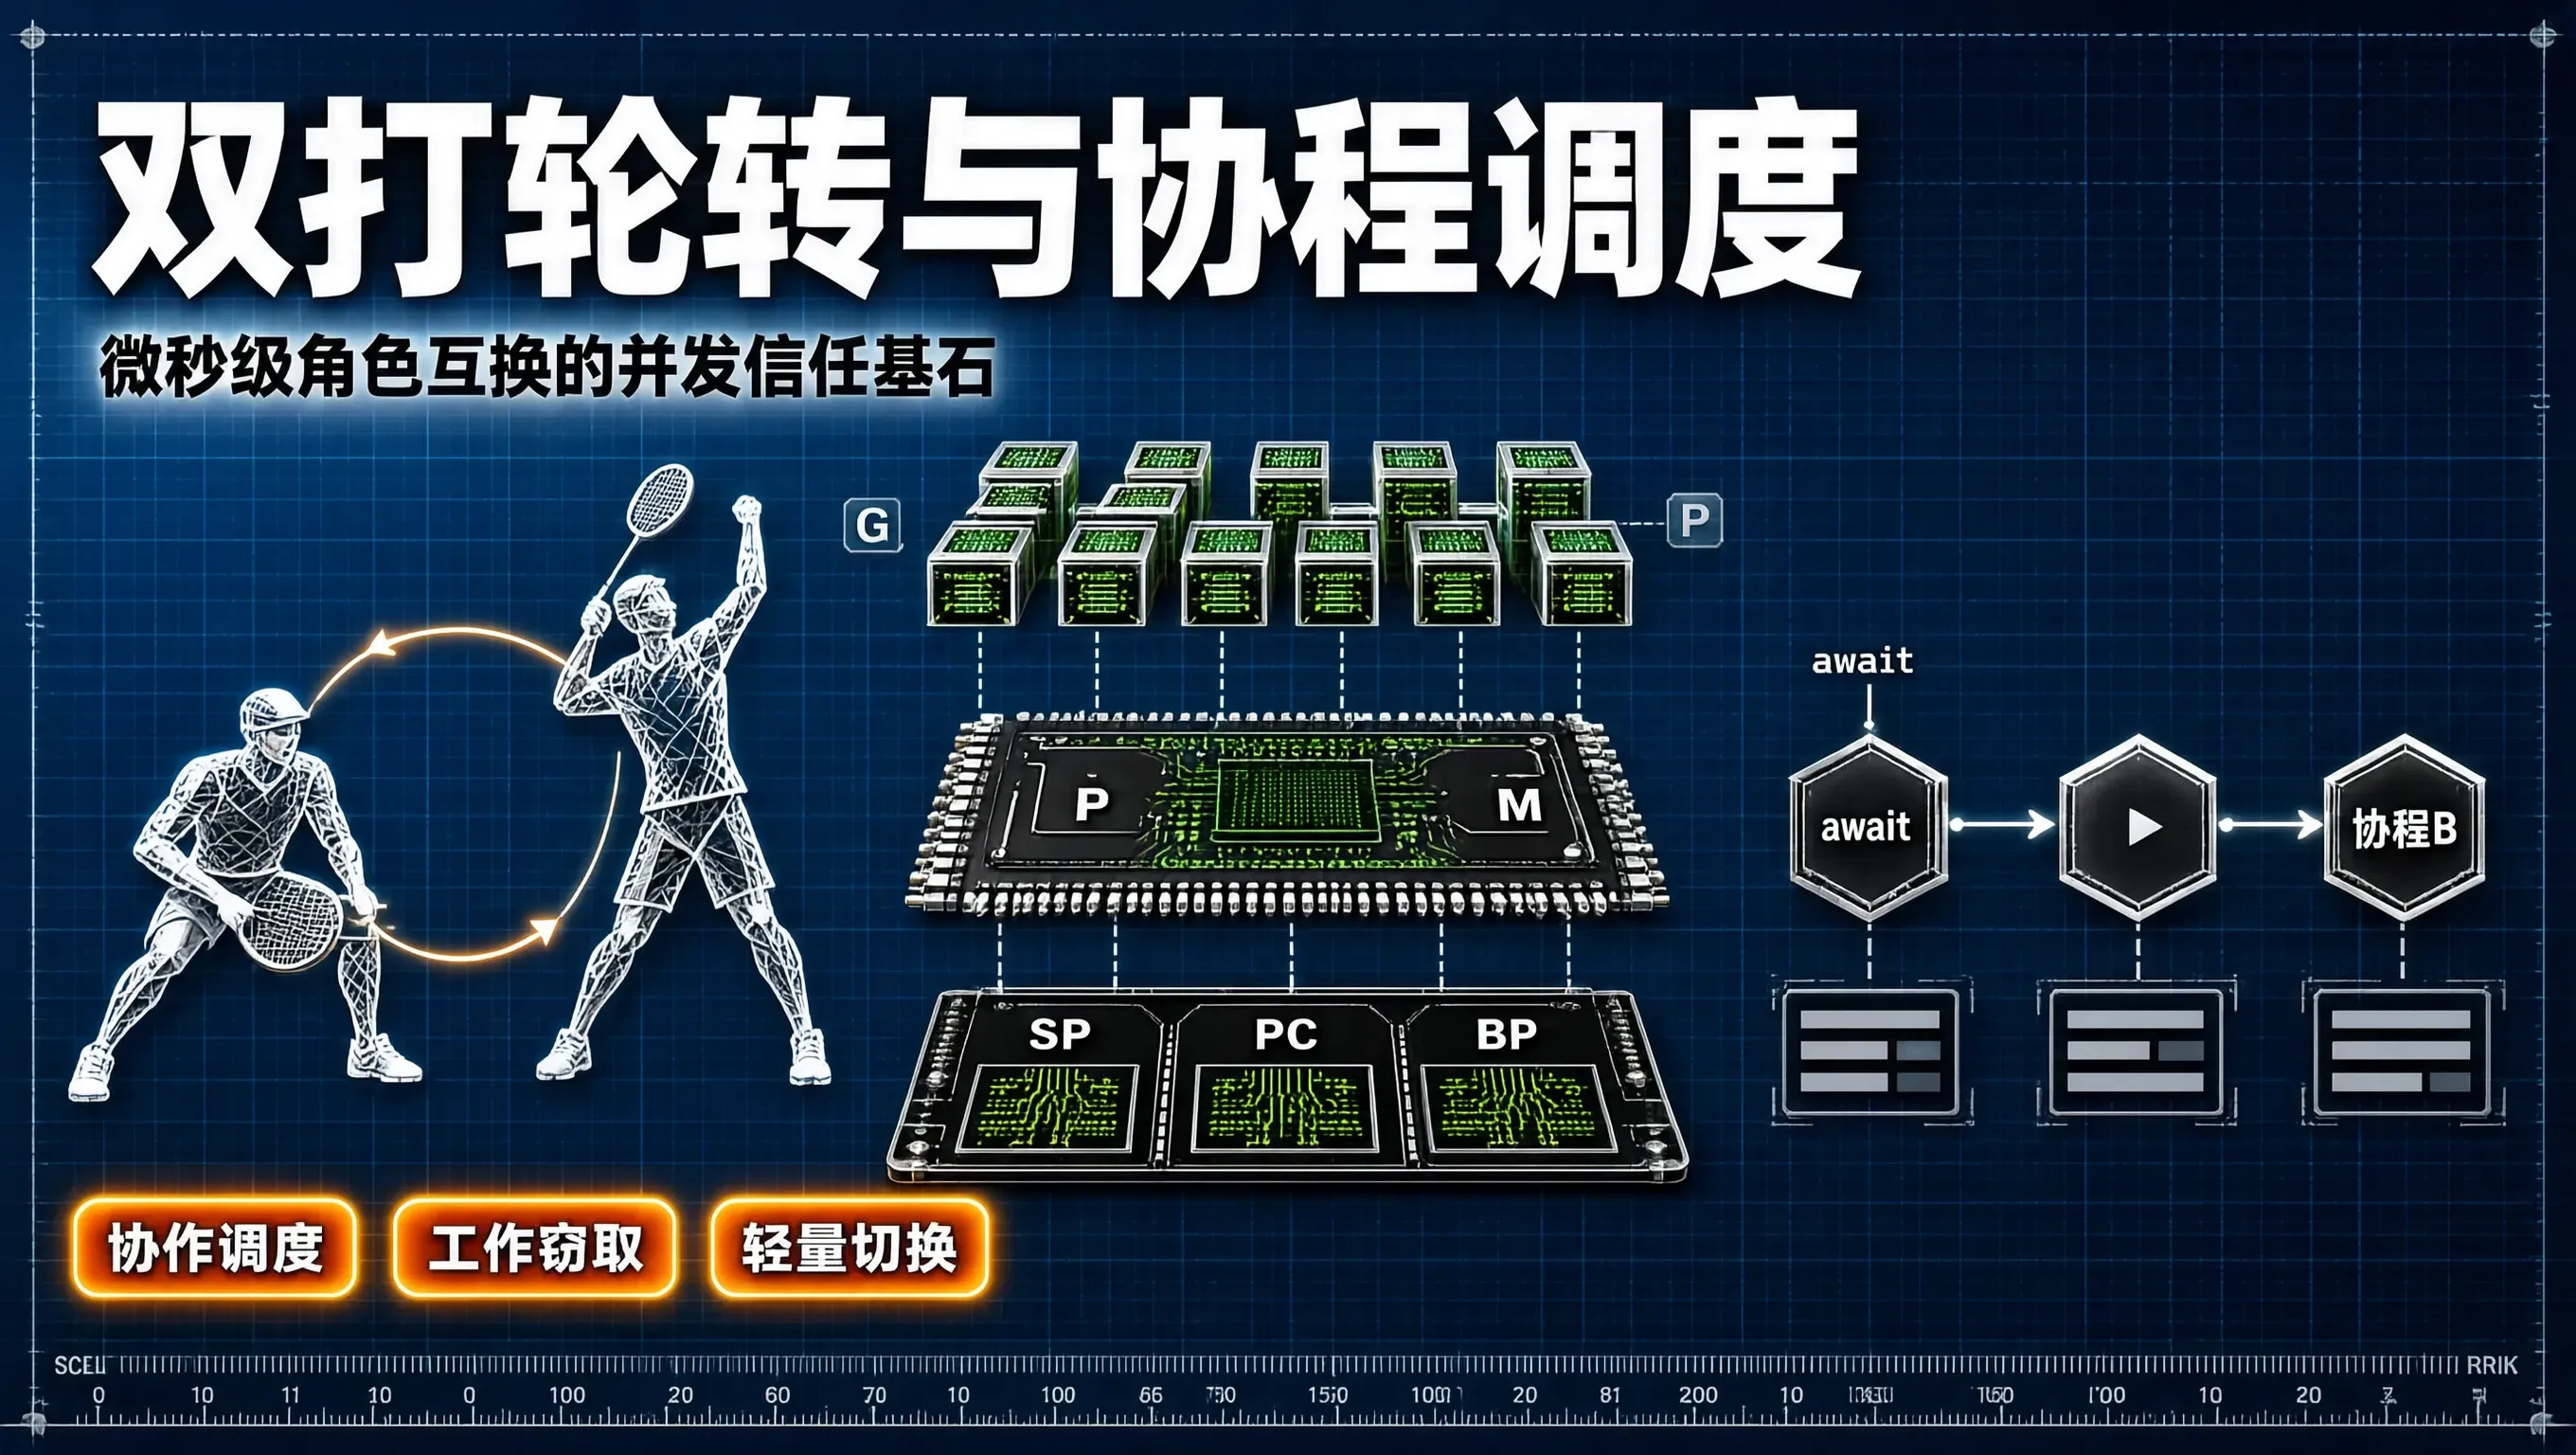
在羽毛球竞技体系中,高水平双打对抗的节奏极快、攻防转换极其剧烈。在整个轮转过程中,前场队员绝对不会回头去看搭档。他之所以敢毫无顾忌地全力向前封网,是因为对搭档拥有绝对的信任——他确信只要自己前插,身后的整片后场空档就一定会被搭档在几十毫秒内精准补位。将这种依托协作契约实现微秒级角色互换的竞技智慧投射到操作系统与并发架构中,现代编程语言中的协程调度(如 Go 的 G-P-M、Rust 的 Async
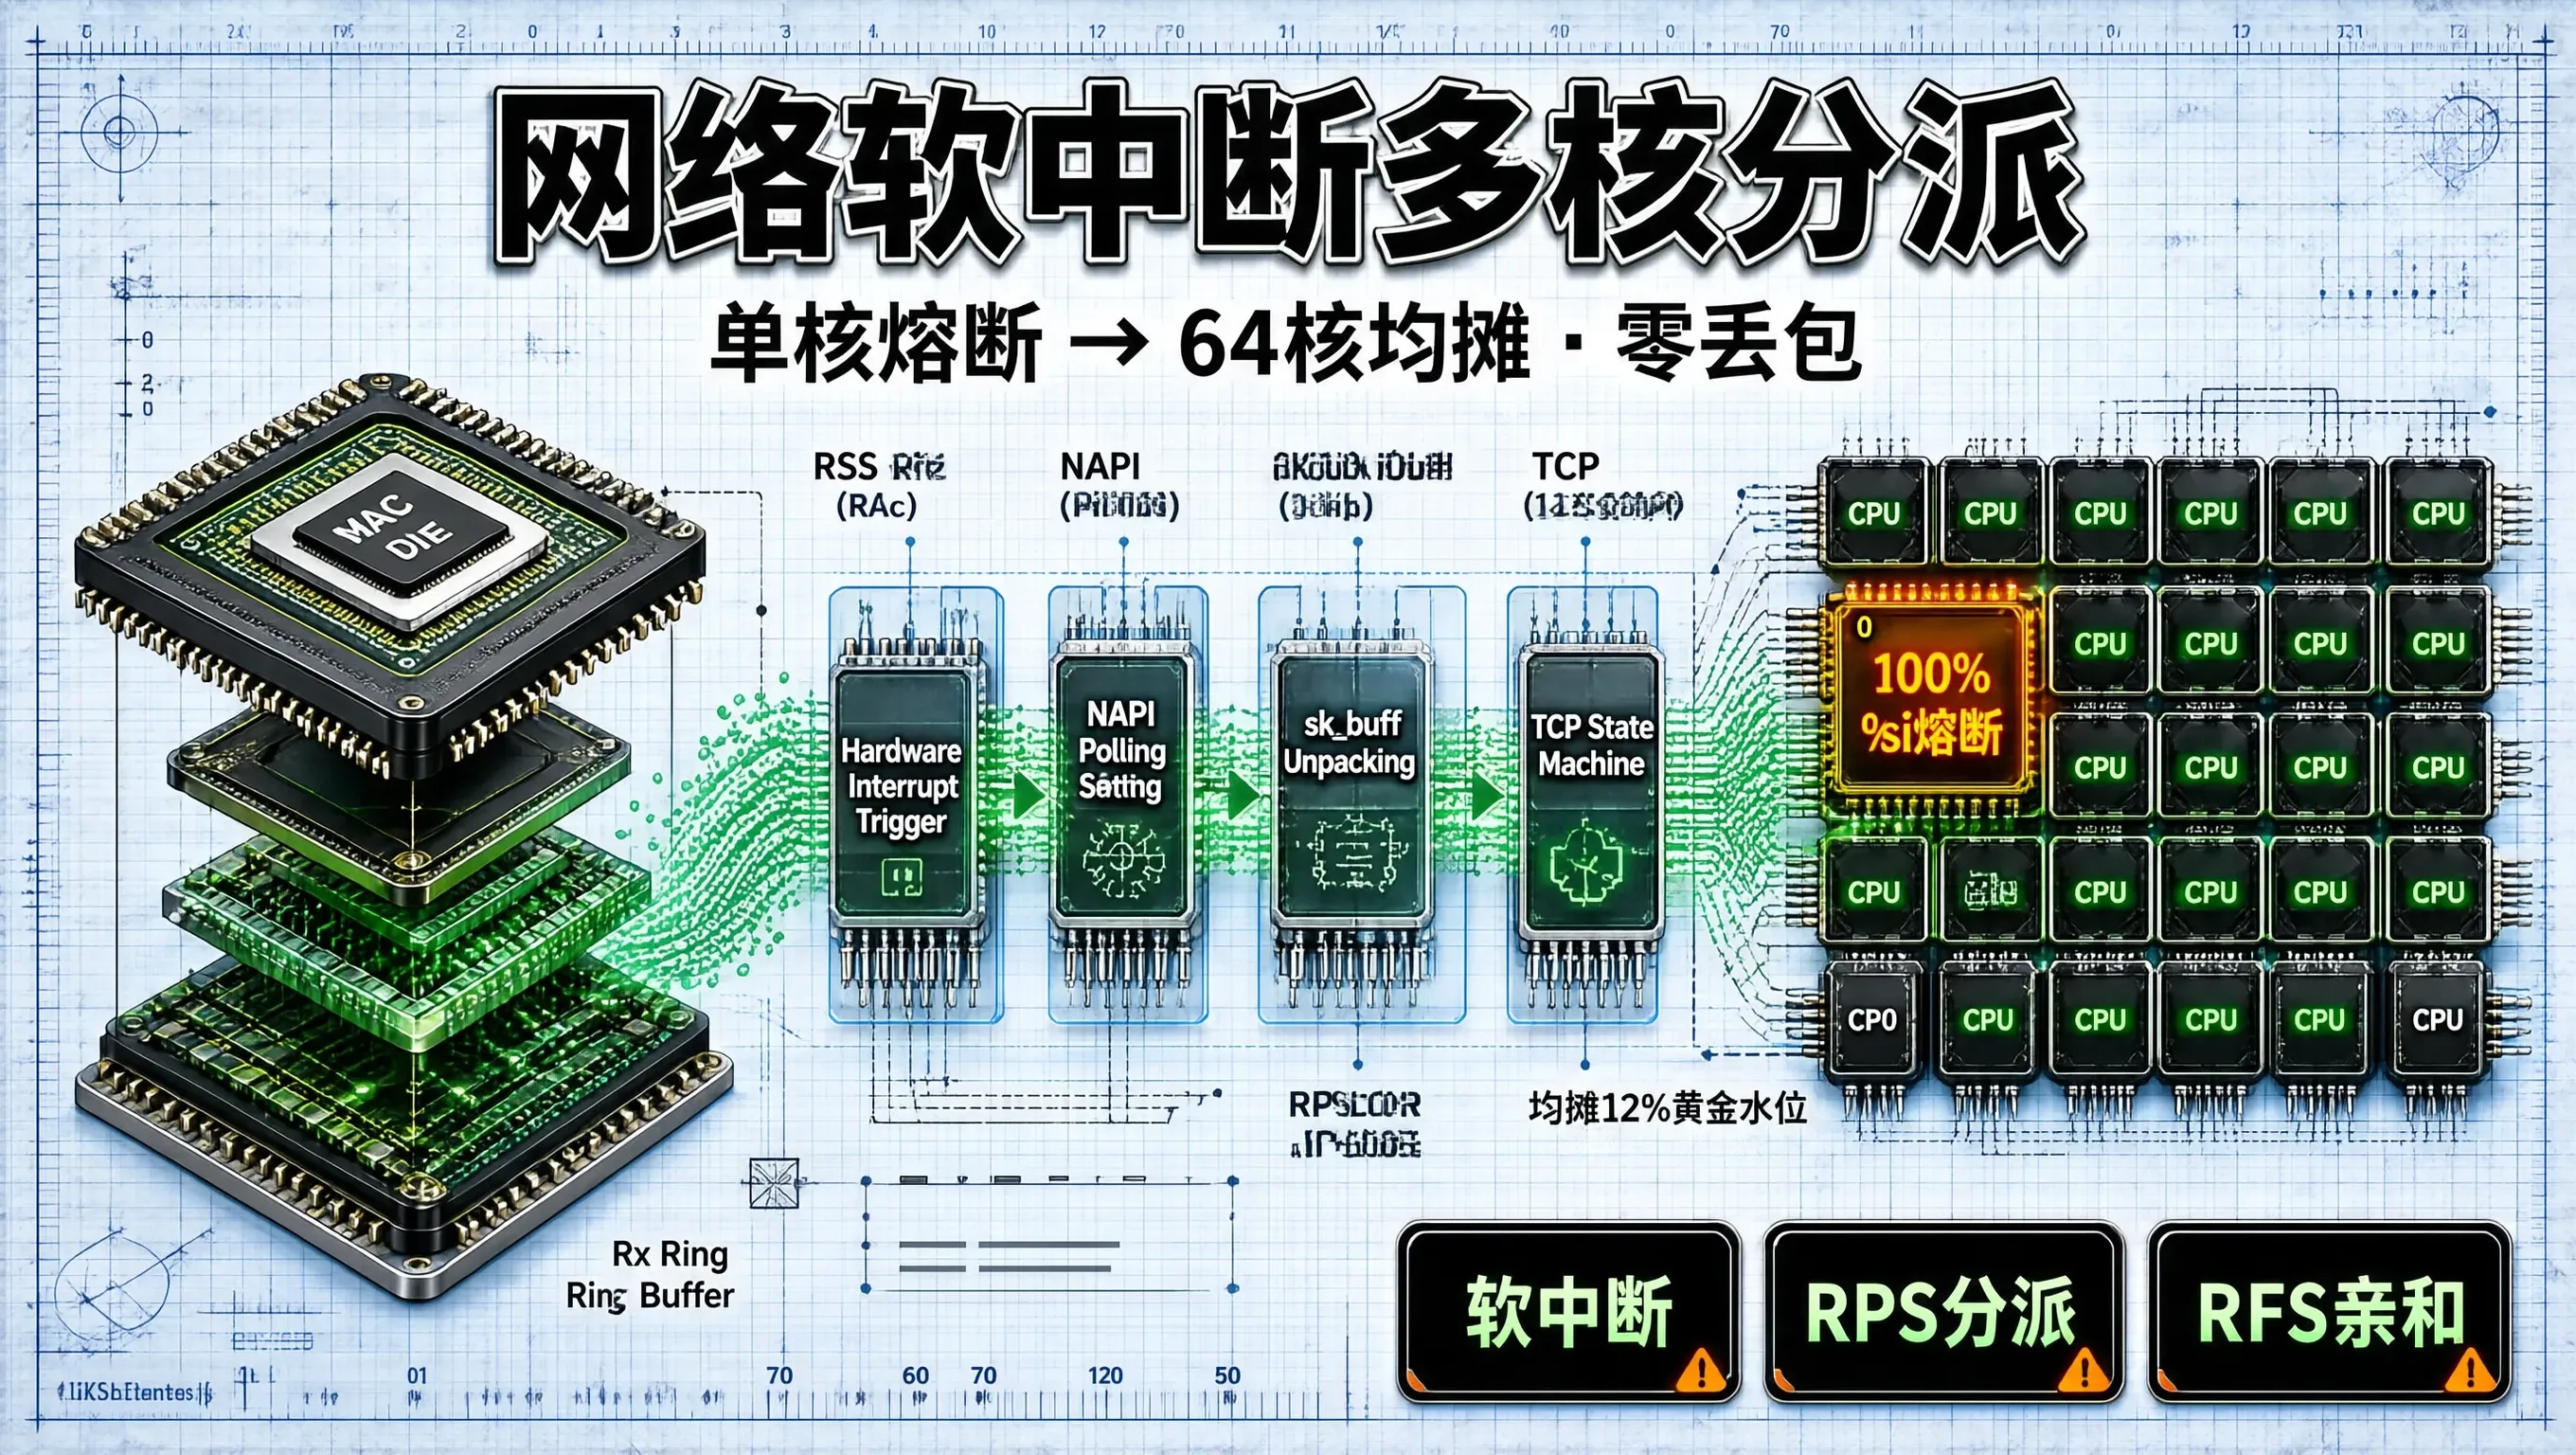
现代高并发系统的性能极限,往往受制于操作系统协议栈最底层的时钟与中断分配。搞懂硬中断与NET_RX软中断的微观流转,合理利用 RPS/RFS 机制将单核重压化解于多核阵列之中,才能让服务器的每一颗 CPU 核心协同共振,在海量网络洪峰的冲击下保持绝对的从容与流畅。
在现代基于事件循环的高性能异步运行时(如 Tokio、Node.js、Rust async-std)中,调度器采用的核心范式是,而非传统操作系统线程使用的。在协作式模型中,调度器(Tokio Worker 线程)!.await如何通过 tokio::task::yield_now与,在不引入独立线程池的前提下实现协作式调度的极致平滑?
传统推理中,KV Cache 需要为每个请求预分配连续显存,按最大可能长度预留,导致大量显存浪费在"用不上的位置"。PagedAttention 把 KV Cache 切成固定大小的块(类似操作系统的分页内存),按需分配、不连续存放。效果是显存碎片率大幅下降、利用率显著提升,同样的显存能装下更多并发请求。。传统批处理要等一个 batch 全部生成完才处理下一个,GPU 在生成后期大量空转。连续批处
在 Rust 的设计哲学中,内存泄漏是完全被类型系统所允许的(Safe Rust 允许Box::leak在真实的生产级中大型 Rust 系统中,内存泄漏往往不会以野指针崩溃的方式暴露,而是悄无声息地吞噬服务器的物理 RAM,直到触发 Linux OOM Killer 导致整个服务被操作系统瞬间杀死。深入排查 Rust 中三大隐蔽的内存泄漏陷阱——Rc/Arc与,是保障系统长期稳健运转的硬核必修课。
new Thread()就创建了一个线程了?这么描述不太对,准确地说,new Thread()只创建了一个Java对象,真正的线程还不存在。我们写了后,到操作系统里创建一个真正可执行的线程,中间经历了好几步,每一步涉及不同的层级。我们可以来追踪new Thread()之后的完整链路:Java层做了什么,JVM层做了什么,操作系统层又做了什么。然后再看sleep和interrupt这些操作,在这三层