登录社区云,与社区用户共同成长
邀请您加入社区
linux内核的编译方式,适合各种linux环境下,包括ubuntu、centos等
摘要:本文详细介绍了在飞腾芯片(FT-2000系列)上移植PREEMPT_RT实时内核的全流程,旨在将中断延迟控制在≤20μs,满足工业控制需求。内容涵盖环境搭建、内核补丁应用、设备树修改、编译部署及性能验证等关键步骤,并以矿山皮带运输机控制系统为应用案例,展示了国产芯片在实时控制领域的可行性。通过该方法可实现SIL2/PLd级安全控制,缩短国产化替代周期30天。文中提供可复现的命令序列和常见问题
本文深入解析了Linux内核中kallsyms符号压缩的完整构建流程。该流程通过多趟链接和符号压缩技术,有效解决了内核符号存储的内存消耗问题。 主要分为两个核心阶段: 多趟链接流程:由scripts/link-vmlinux.sh脚本调度,采用迭代收敛方式确保符号地址稳定。包含三个阶段: 首先生成基础镜像和空符号表 通过2-3次迭代链接,逐步修正符号地址 最终生成包含准确符号表的vmlinux内核
*eBPF(Extended Berkeley Packet Filter)**是Linux内核的一项功能,允许在内核中运行用户定义的代码,以实现高性能的数据处理和事件监控。
最近想尝试把新的Linux内核移植到tq2440的开发板上,看看还能不能顺利的跑起来。我的基础版本是买板子的时候提供的2.6.30版本,编译器版本是4.3.3.。
一直以来都想从驱动一直到应用,添加一套新的调用流程,来进一步理解Android系统的架构流程。后面会连续写几篇文章,从Android系统的驱动一直到应用层一步一步添加接口,从驱动到应用。由于目前手头仅有Android9.0的全套代码,因此就直接在Android9.0上面适配了,手头仅有Android 10的模拟器代码,因此没有在Android10上面适配。首先这篇文章先简单介绍下,如何编写linu
本文系统探讨文件变更可追溯性技术体系,从文件系统元数据(mtime/ctime/atime/btime)到实时事件监控(inotify/fanotify),再到内核级审计(auditd、eBPF)与应用层方案(Git、CAS、不可变基础设施)。通过多个可运行代码示例,构建从内核事件到产物哈希的完整证据链,解决“谁在何时改了什么、为何改、是否合规”等核心问题,助力软件交付、安全取证与合规审计。
本文基于生产 3 节点 Elasticsearch 集群实战,完整覆盖 ES 从 0 到 1 全流程:硬件架构规划、操作系统内核调优、Docker‑Compose 集群部署、JVM 堆内存调优、索引 Mapping 设计与别名零停机切换、Canal+MQ 实现 MySQL 数据同步、XPack 安全加固、监控告警。汇总 6 个高频生产事故踩坑复盘:脑裂、磁盘打满只读、OOM、分片热点、GC 长停顿
直接在linux下执行,将以下命令中的密码占位符替换为你实际要设置的密码,并将替换为当前管理员账号的密码,我这里创建一个esReader账号,分两步,创建角色和账号,然后新账号关联角色。
下载地址。
ELK套件(尤其是Elasticsearch和Logstash)是用Java编写的,而Kibana则基于Node.js环境运行。它们无法在裸操作系统上直接运行。压缩包存放在相应目录下并赋予该目录用户权限以及执行权限;1、模拟生成测试日志(node-3节点)修改 Logstash JVM 内存。1、准备三台虚拟机组合一个集群;配置服务文件以及加载(同上)配置服务文件以及加载(同上)配置服务文件以及加
化神之前的所有境界,本质上都在解决问题。凡人:怎么用软件解决业务问题?炼气期:怎么用代码解决小问题?筑基期:怎么用数据结构、算法提升效率?金丹期:怎么在系统层面优化性能?元婴期:怎么让代码直接操控硬件?化神期之后,问题的性质变了——你不再是解决问题,而是定义问题本身。造一门语言之前,先要回答:为什么这个世界需要一门新的语言?C 诞生于 1972 年,因为 Dennis Ritchie 需要一种能直
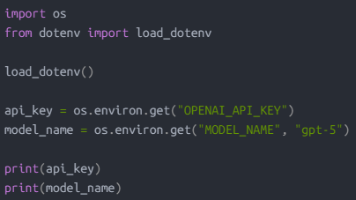
环境变量(environment variable)操作系统提供给程序的一组外部配置值。API Key数据库地址当前运行模式日志级别默认模型名不用把敏感信息写进代码不同环境可以用不同配置改配置时不用改源码配置系统(configuration system)程序用来统一管理“可变参数”的一套机制。模型名最大循环步数日志级别工具列表超时时间工作目录API 地址代码越来越多后,这样会变乱。用配置对象统一
BashTool 是 Claude Code 中最具"破坏力"也最常用的工具之一:它把模型的文本输出直接交给系统 shell 执行,是模型与操作系统交互的"万能钥匙"。正因为能力强大,BashTool 的实现同时承担了三重职责——给模型清晰的 prompt 指引、对命令输出做格式化与安全处理、在终端里渲染出可读的执行过程与结果。承载核心call与权限逻辑;prompt.ts生成模型可见的工具描述与
volatile通过内存屏障保证了可见性和有序性,但无法保证原子性;synchronized通过锁升级路径(偏向锁→轻量级锁→重量级锁)在低竞争场景下实现了接近volatile的性能,在高竞争场景下则退化为操作系统级别的互斥锁。理解两者的底层机制,有助于在并发编程中做出正确的选择。
本文介绍了在Windows 10环境下搭建Elasticsearch 7.0.0和Kibana 7.0.0的开发环境配置流程。主要内容包括:1)安装JDK 1.8.0_201并配置环境变量;2)下载并启动Elasticsearch,通过访问localhost:9200验证服务;3)下载并启动Kibana,可在DevTools中进行功能验证。文中提供了各组件下载地址,并说明可通过修改对应的yml配置
容器 = 被隔离的进程容器不是虚拟机,它不像虚拟机那样拥有独立的操作系统内核。容器的本质是利用 Linux 内核的隔离机制,将一个进程及其依赖资源(文件系统、网络、进程空间等)打包在一起,使其看起来像在一台独立的机器上运行。│ 物理服务器 ││ │ 容器 A │ │ 容器 B │ ││ │ │ Libs/依赖 │ │ │ │ Libs/依赖 │ │ ││ │ 容器运行时 (Docker Engin
本文介绍了如何利用Elastic Agent Builder MCP、AWS Bedrock Agent Core和Strands SDK构建一个智能代理,将自然语言问题转换为对Elasticsearch数据的查询操作。该解决方案通过三层架构实现:Elastic Cloud提供数据存储和工具执行层,AWS Bedrock负责推理层,Strands SDK则协调整个代理循环。文章详细说明了技术栈集成
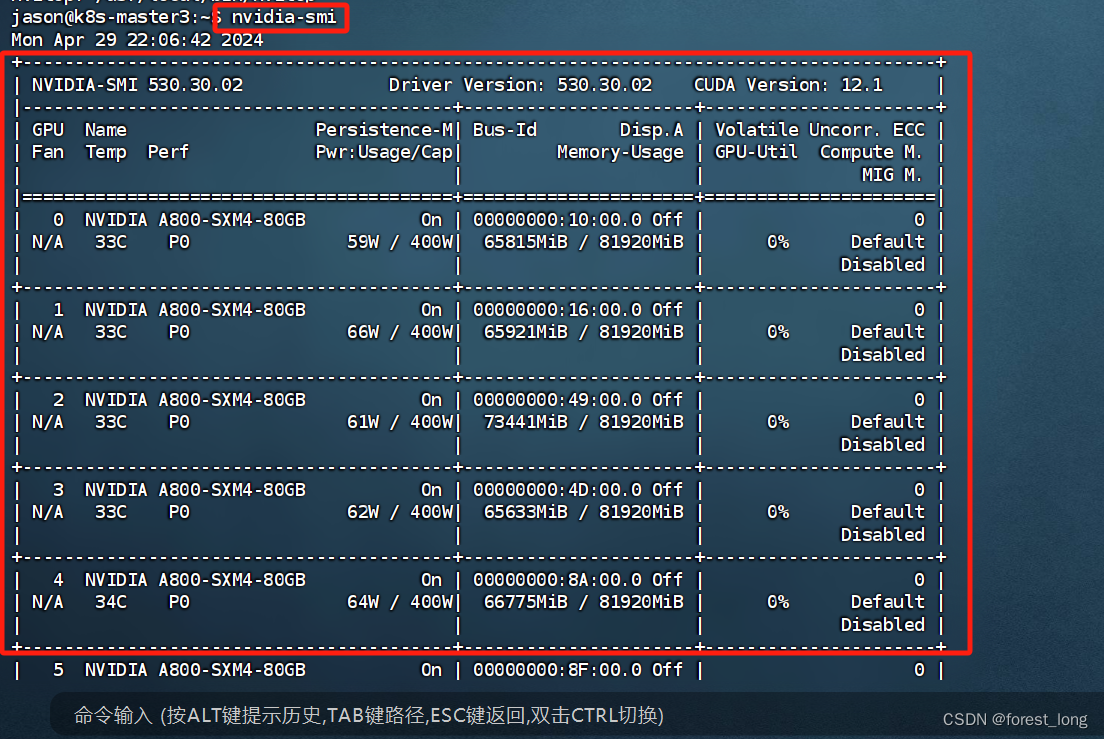
相信大家在用NVIDIA-GPU训练网络模型的时候,都会习惯性的在终端nvidia-smi一下吧?最直接的目的是为了查看哪些卡正在使用,哪些卡处在空闲,然后挑选空闲的卡号进行网络训练。咱们作为一名资深的算法工程师,毕竟身兼多职:上要开发AI算法,下要管理服务器,左要带新人,右要PPT汇报上级。对于管理服务器:刚买的新服务器你得装系统吧?得装DriverCudaCudnn吧?
本文《Git跨仓库同步与子模块管理指南》针对常见Git协作问题提供了15类解决方案: 子模块管理:解决"已存在于索引中"错误、合并冲突导致索引损坏、子模块文件操作限制等问题 分支迁移:详细讲解使用git bundle和临时远程两种方法迁移本地分支 远程分支异常:处理本地缓存与服务器不一致、"找不到远程引用"等错误 跨仓库操作:包括合并特定提交、标签同步(1.74→1.75)、补丁应用与冲突解决 构
本文介绍了Dify系统的安装与配置步骤:1)安装Git、Curl等基础依赖;2)克隆源码仓库并切换版本;3)配置环境变量(数据库连接、API密钥等);4)通过Poetry安装Python依赖;5)初始化数据库并创建管理员;6)启动开发服务器或生产环境部署(推荐Gunicorn);7)访问默认5000端口服务,建议配置Nginx反向代理和Supervisor进程管理。文中还提供了各Linux发行版的
本文基于实际项目,记录了使用 Docker Compose 部署 ELK 日志收集平台的完整过程,包括架构设计、配置详解、踩坑记录和效果展示。
这次不是引发者,而是受害者
https://www.cnblogs.com/qmillet/p/12565723.htmlES在数据量很大的情况下如何提高查询效率?一、性能优化的杀手锏——filesystem cache你往es里写的数据,实际上都写到磁盘文件里去了,查询的时候,操作系统会将磁盘文件里的数据自动缓存到filesystem cache里面去。es-search-processes 的搜索引擎严重依赖于底层的fi
某Elasticsearch集群节点在每周日凌晨3点固定宕机,经排查发现是某平台定时执行脚本采集ES信息时调用elasticsearch -V查询版本号导致CPU和内存暴增。临时解决方案包括停止问题脚本和扩容服务器资源,永久方案建议重建ES集群。该问题已提交ES官方寻求根本原因。排查过程涉及定时任务、中间件日志分析及资源监控脚本编写,最终通过agent日志定位到问题脚本。
ES 就是一个能存海量数据、搜得快、还能做实时统计的分布式搜索引擎。配置好了,它就像个听话的超级助理,你问什么它秒回;配砸了,它能让你加班到天亮。生产环境务必角色分离、开安全、锁内存、监控磁盘。Logstash 就是一根万能的“数据水管”:进水管(input)可以接各种源头,中间可以加各种“净水器”(filter)来清洗、转换数据,最后出水管(output)把干净水送到 ES、文件或其他地方。配置
2019年双十一的那个凌晨,我正在公司值夜班,监控大屏上突然一片飘红——搜索服务响应时间从正常的50ms飙升到3秒以上,订单页面的搜索框彻底卡死。运营同事疯狂@我:“用户搜不了商品了!我手忙脚乱地登录服务器,发现问题比我想象的更严重:单节点ES集群的磁盘IO已经打满,查询队列堆积了上千个pending请求。更要命的是,那个只有500GB数据的索引,在双十一当晚硬是被塞进去了超过2TB的日志和数据,
本文介绍了如何为MCP服务器添加OpenTelemetry追踪功能,实现在Elastic APM中可视化工具调用性能。通过Elastic提供的OpenTelemetry SDK(EDOT)对Node.js MCP服务器进行插桩,开发者可以追踪工具调用的延迟、错误和性能基线。文章详细说明了MCP的OTel语义约定、工具span的包装模式,以及如何在Elastic APM中查看和分析追踪数据。特别值得
摘要:为MCP服务器实现AI自省能力的可观测性方案 本文介绍了一种创新方法,通过OpenTelemetry追踪技术让MCP服务器具备AI自省能力。核心方案包括: 数据闭环设计:AI助手能实时查询分析自己的工具调用数据,无需人工介入仪表盘检查 自动插桩:通过--import参数实现Node.js进程的零代码自动插桩 手动埋点规范:定义MCP专用的Span命名规则和语义约定属性 双服务器架构:同时运行
将搜索延迟从“秒级”降低到“毫秒级”,并提供强大的相关性评分(搜索结果谁更匹配排在前面)。:搜索“Java开发”,MySQL 很难精准匹配到只包含“Java”或“开发”的记录。ES 自带的分词器会将中文按字拆分(如:重、头、写...),这不符合业务逻辑。:监听 MySQL Binlog,全自动同步。,可以添加公司特有的专业术语(如你的项目名“Antigravity”)。:关键词 -> 文档 ID
Elasticsearch是使用Java构建的,并且至少需要才能运行。只支持Oracle的Java和OpenJDK。在所有Elasticsearch节点和客户端上应使用相同的JVM版本。我们建议安装Java版本。如果使用已知的错误版本的Java,Elasticsearch将拒绝启动。Elasticsearch使用的Java版本可以通过设置JAVA_HOME环境变量进行配置。注意Elasticsea
计算层解决了 Agent 运行环境的完整谱系,从完整操作系统(Sandbox)到轻量隔离(Workers),以及 Agent 生成代码的存储和执行(Artifacts、Dynamic Workers)。安全层将零信任从人类用户延伸到了机器身份——Agent 需要有自己的 OAuth 流程、有自己的访问权限边界,而不是借用人类账户的凭证。工具箱层补齐了 Agent 完成真实任务所需的感知与行动能力:
版本控制系统(VCS)可以记录文件的每次改动和版本迭代,方便回溯历史,也支持多人协作。举个例子:你每天都在写代码,某天电脑突然故障,本地文件全部丢失。如果使用了版本控制系统,你的代码已经保存在远程服务器上(如 GitLab、GitHub),只需一键克隆即可恢复,相当于多了一道保险。本地版本控制系统:如 RCS,只在单机上记录文件差异,但无法协同工作。集中式版本控制系统(CVCS):如 CVS、Su
支持入库格式:2025-05-08 10:20:30自定义的时间格式可以随意自定义,只是搭建可以看一下底层原理,就理解了为什么不太推荐使用。适用场景:国内单体项目、全服务器东八区、无海外业务、无需跨时区统计优点:MySQL数据无需转换,同步代码极简,开发效率高缺点:不支持跨时区,扩展性差},对应Mapping无时区格式,使用,必须加格式化注解@Data// 格式必须与ES Mapping完全一致。
设置本地工作区。生成代码以使用您选择的语言实现 API。对文件进行代码检查以提高代码质量和一致性。检测破坏性变更以避免破坏下游消费者。使用集成生成代码的服务器应用程序访问您的 API。要了解如何在大型组织中更有效地使用 Protobuf 模式,请接着完成Buf Schema Registry 快速入门。
本文介绍了如何通过Elastic的Model Context Protocol(MCP)解决开发中日志与代码脱节的问题。MCP作为开放标准,使AI客户端能连接外部数据源,实现生产日志与代码的直接关联。文章以电商搜索应用为例,展示了两种典型开发场景:通过Agent Builder创建工具分析前端筛选器使用情况,以及调试后端500错误。详细说明了工具创建过程、ES|QL查询语法,并提供了性能优化建议,
摘要:Elastic宣布与AI编码平台Cursor深化合作,推出Elastic插件,将实时可观测性、安全性和搜索数据直接集成到开发工作流中。该插件包含开源Elastic Agent Skills和Elastic Docs MCP服务器,使开发者能在编辑器内查询日志、处理告警和搜索语法,无需切换平台。这一合作旨在通过上下文工程,让AI代理基于实时生产数据进行精准决策,提升开发效率和AI应用可靠性。插
本文介绍了Elasticsearch推出的ES|QL查询构建器,支持JavaScript和TypeScript开发。该工具提供流式API、类型安全和方法链式调用,避免了手动拼接字符串的风险,并支持自动值转义和IDE自动补全。文章通过Web服务器错误日志分析的示例,展示了如何逐步构建复杂查询,包括过滤、计算列、聚合和时间维度分析。同时介绍了三种表达式写法(原始字符串、表达式构建器和模板标签)和安全查
本文介绍了如何通过Elastic Agent Builder MCP Server将Cursor编辑器与Elastic APM数据连接,实现开发环境与生产数据的无缝对接。主要内容包括:1)建立MCP服务器连接,创建两个Agent Builder工具(获取筛选器使用数据和错误日志);2)演示两个典型应用场景:基于用户行为数据优化UI筛选组件,以及通过生产错误日志快速定位代码问题。这种方法让开发者能在
ES性能调优不是单一维度的优化,而是“写入、查询、集群、JVM”的协同优化,记住以下10条黄金准则,可解决90%的生产性能问题:写入必用Bulk批量,控制单批大小5~15MB;查询优先用filter,利用缓存减少打分;深度分页禁用from+size,首选search_after;聚合、排序、精确匹配必须用keyword类型;text字段仅用于全文检索,关闭不必要的索引;JVM堆内存设为32GB以内
本文介绍了一种基于Elasticsearch和LLM的智能房产搜索实现方案。文章对比了三种技术路径:1)Python代码实现;2)MCP服务器方案;3)AIBuilder+Workflow组合。重点推荐了最简便的第三种方案,详细说明了如何通过创建property_search_skill技能来实现地理编码和DSL模板搜索功能。该方案无需额外编程,直接在Kibana中配置agent和workflow
Filebeat 是 Elastic 官方推出的轻量级日志采集器,部署在需要采集日志的服务器上,核心作用是:实时监控指定路径的日志文件,读取日志内容,不存储日志(或本地存储),低CPU、低内存占用,可将日志输出到本地文件、Kafka等(本文重点适配本地存储,无任何额外依赖),是日志收集链路的“入口”。tar 压缩包安装无需依赖系统包管理工具,解压即可使用,路径可自由选择,适合无外网、无yum/rp
在 Elasticsearch 分布式架构中,Node(节点)是构成集群的最小独立运行单元,可以理解为一台独立的 ES 服务实例。无论是单机测试、集群部署,还是生产环境高可用架构设计,都必须理解节点的作用、类型与角色分工。很多新手因为不了解节点角色,导致集群不稳定、查询缓慢、甚至出现脑裂故障。本文将从节点定义→核心特性→节点角色分类→功能详解→集群架构流程图→最佳实践,用最通俗、最系统的方式讲透
Elasticsearch(简称ES)作为一款分布式、高扩展的搜索引擎,是大数据、日志分析、全站搜索场景的核心组件。正确启动与基础配置是使用ES的第一步,很多新手因环境配置错误、参数设置不当导致ES启动失败、无法远程访问、内存溢出等问题。本文将从环境准备→下载安装→核心配置→启动服务→验证访问全流程讲解,搭配启动流程图、配置详解、避坑指南,零基础也能快速搭建ES服务器。本文完整讲解了Elastic
本文详细介绍了Git版本控制的本地与服务器端操作指南。本地操作部分包含环境配置、SSH密钥设置、仓库管理、日常开发流程、分支管理以及撤销操作等实用技巧。服务器操作部分重点强调身份隔离、密钥安全、文件忽略规则,并提供远程同步流程和隐私管理建议。文章还针对常见问题提供解决方案,如权限错误、大文件误传等问题,是一份全面的Git使用手册,适合开发者在不同场景下高效管理代码版本。
在微服务、云原生、分布式架构下,服务日志散落在多台服务器,传统查看日志方式效率极低。实时日志分析系统已成为运维监控、故障排查、安全审计的核心基础设施。是业界标准的实时日志分析方案,具备实时采集、清洗、存储、检索、可视化能力,支持PB级日志秒级查询。本文从架构设计、组件分工、部署流程、日志采集、实时检索、可视化大屏全流程讲解,带你从零搭建一套生产级实时日志分析系统,流程图+实战命令+配置文件直接可用