GO语言八股
GO语言
1、Go语言的编译过程?
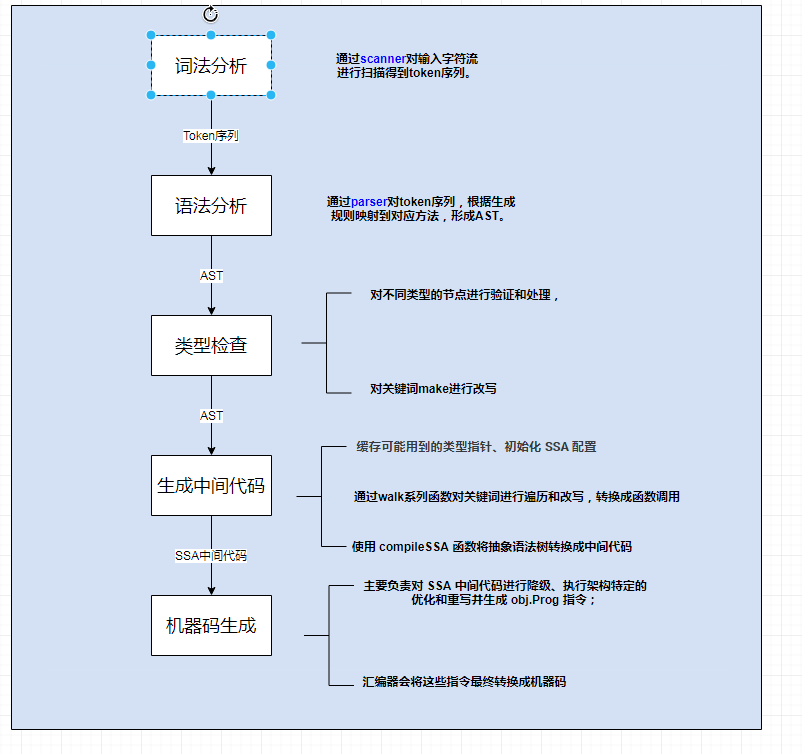
前端编译
前端编译主要负责词法分析、语法分析、语义检查和生成中间代码,输入是 Go 源代码,输出是 IR(Intermediate Representation,中间表示)。
- 词法分析: 将源代码字符拆分成为Token(词法单元)
- 语法分析: 根据Go语言的语法规则,将Token序列转化成为抽象语法树(AST)。表示代码的语法结构,比如:函数定义、表达式嵌套。
- 类型检查(语义检查):遍历抽象语法树,验证代码语义的合法性。
- 中间代码生成: 将代类型信息的AST转化为 SSA(Static Single Assignment,静态单赋值) 形式的 IR。
-
- SSA 特点:每个变量仅被赋值一次,便于编译器进行优化(如常量折叠、死代码消除)。
- 示例:x := 1 + 2 会被优化为 x := 3(常量折叠)。
后端编译
后端编译将 IR 转换为目标平台的机器码,主要包括优化、代码生成和链接。
5. 中间代码优化: 对于SSA形式的IR进行一系列优化。提升最终的二进制文件的性能。
- 常量传播:将常量直接替换到使用处(如 a = 5; b = a + 3 → b = 8);
- 死代码消除:移除永远不会执行的代码(如 if false { ... } 中的内容);
- 函数内联:将小型函数的代码直接嵌入调用处,减少函数调用开销;
- 循环优化:如循环展开、循环不变量外提等。
6. 机器码生成: 将优化后的中间代码(IR)转化成为对应平台的汇编代码,再进一步转化成为机器码(二进制指令)
7. 链接: 将多个编译单元(.o目标文件)和依赖的标准库合并成为一个可执行文件。
示意图
源代码(.go)
→ 词法分析 → Token 序列
→ 语法分析 → AST(抽象语法树)
→ 类型检查 → 带类型的 AST
→ 中间代码生成 → SSA 形式的 IR
→ 中间代码优化 → 优化后的 IR
→ 机器码生成 → 目标文件(.o)
→ 链接 → 可执行二进制文件
2、Go语言的运行过程? 操作系统加载内存,Go运行初始化,执行包级别的init函数,初始化全局变量,执行main函数,执行结束,收回资源
指的是go程序的编译好的二进制文件,从加载到内存,并执行的全过程。涉及程序启动,初始化,主逻辑执行,资源清理等阶段
1、程序启动
当用户执行编译好的二进制文件时,操作系统会先完成加载程序到内存中的相关工作,随后进行程序初始化阶段。
- 操作系统加载:
-
- 操作系统通过系统调用将程序加载到内存中,解析可执行文件头,设置程序的代码段(指令),数据段(全局变量)。
- 建立进程上下文(栈空间、寄存器状态),将程序入口点设置为初始化执行地址。
- Go运行初始化:
-
- 启动线程创建:操作系统创建第一个线程(通常称:m0,初始机器线程),执行Go运行时的启动代码。
- 内存分配器初始化:初始化堆内存管理结构。为后续的分配内存做准备。
- Goroutine调度器初始化:初始化调度器核心组件:G结构体、M结构体、P结构体
2、运行代码的初始化: 全局变量->init函数执行 import –> const –> var –>init()–>main()
- 全局变量初始化: 初始化包级别的全局变量,初始化顺序按变量在代码中声明的顺序执行;若有依赖关系(如 b 依赖 a),则先初始化被依赖的变量。
- init函数执行: 执行顺序:同一个包,按照包的声明顺序执行;不同的包按照包的依赖关系执行;全部的init函数在main函数执行前全部执行,并且只执行一次。
3、主逻辑执行
初始化完成之后,函数进入核心阶段。执行main函数以及main中启动的Goroutine函数
5. 启动主Goroutine(main Goroutine)
- 创建第一个用户Goroutine(main Goroutine) ,将main 函数作为执行入口。
- main Goroutine 被加入调度模型,分配给某个M 和P执行。
6. 调度器工作
- Go 调度器(GPM 模型)负责在多个 M(系统线程)上调度 G(Goroutine),通过 抢占式调度 实现并发。
- 用户代码执行:main 函数中的逻辑(如函数调用、循环、条件判断等)被翻译成机器码,由 M 按指令顺序执行;若代码中使用 go 关键字启动新 Goroutine,新 G 会被加入调度队列,等待执行。
7. 并发同步: 若多个 Goroutine 访问共享资源,通过 sync.Mutex、channel 等同步机制协调,确保数据安全(由运行时负责底层同步支持)
4、程序退出:main函数执行结束和资源清理回收
- 运行时清理
-
- GC 最终回收: 运行时触发最后一次垃圾回收,释放所有未被引用的内存。
- 关闭资源: 关闭打开的文件、网络连接等资源(若用户代码未显式关闭,部分资源可能由操作系统回收)。
- 销毁 Goroutine: 终止所有剩余的 Goroutine(包括运行时内部的 Goroutine,如定时器线程)。
- 进程终止
-
- 运行时调用操作系统的 exit 系统调用,终止当前进程,释放所有内存和系统资源(如文件描述符、网络端口)。
- 操作系统回收进程占用的内存和 CPU 资源,程序彻底退出。
示意图
执行二进制文件
→ 操作系统加载程序到内存
→ Go 运行时初始化(内存分配器、调度器、GC 等)
→ 用户代码初始化(全局变量 → init 函数)
→ 启动 main goroutine,执行 main 函数
→ 调度器调度 main goroutine 及子 Goroutine 并发执行
→ main 函数结束(等待子 Goroutine 完成后)
→ 运行时清理资源(GC、关闭连接等)
→ 进程终止,释放所有资源
m0是什么?
在 Go 语言的 runtime 源码中,m0 是一个特殊的 m 结构体实例,代表程序启动时创建的第一个系统线程(OS thread),是 Go 调度器初始化和运行的基础。
核心概念
在 Go 的调度模型中,m 代表一个操作系统线程(OS thread),负责执行 goroutine。而 m0 是程序启动时由内核创建的初始线程,是整个 Go 程序运行的“根线程”。
m0 的作用
- 启动程序初始化
程序启动时,内核首先创建m0线程,它会执行 Go 运行时的初始化逻辑:
-
- 初始化调度器(
sched结构体)、内存分配器、垃圾回收(GC)系统等核心组件。 - 创建第一个 goroutine(
g0,特殊的“系统 goroutine”),用于调度其他用户 goroutine。
- 初始化调度器(
- 作为初始执行载体
m0是第一个执行 Go 代码的线程,在初始化完成后,会负责执行程序的main函数(包装在main goroutine中)。 - 支撑调度器运行
在程序运行过程中,m0与其他m线程一样参与 goroutine 调度,但由于它是初始线程,在某些特殊场景(如程序退出、紧急信号处理)中会承担特殊角色。
特殊之处
m0是唯一不需要通过clone系统调用创建的m实例,由操作系统直接初始化。- 它的栈空间是固定的(通常在进程的栈空间中),不参与 Go 运行时的动态栈管理。
- 在程序生命周期内始终存在,不会被销毁。
总结
m0 是 Go 程序启动时的第一个系统线程,是运行时初始化的“起点”,负责启动整个程序并支撑调度器的初始运行,是 Go 并发模型从操作系统层面过渡到用户态调度的关键载体。
g0 是什么?有什么用
在 Go 语言的运行时(runtime)中,g0 是一种特殊的 goroutine(协程),被称为“系统栈协程”或“调度协程”,它是每个操作系统线程(m)绑定的专属协程,负责协助调度器管理用户协程(即我们代码中创建的普通 goroutine)。
g0 的核心特性
- 与线程绑定
每个m(操作系统线程)都会绑定一个专属的g0,二者一一 一对应。程序启动时,第一个m(即m0)会先创建第一个g0,后续新创建的m也会自动初始化自己的g0。 - 特殊的栈空间
g0的栈是 固定大小的系统栈(而非普通 goroutine 的动态增长栈),通常由操作系统分配(如 Linux 上默认 8MB),用于执行内核相关操作(如系统调用、上下文切换)。 - 无用户代码
g0不执行用户编写的业务逻辑,仅运行 Go 运行时的调度代码(如协程切换、栈管理、垃圾回收等底层操作)。
g0 的核心作用
- 调度用户协程
当需要切换运行中的 goroutine 时(如超时、I/O 阻塞),由g0执行调度逻辑:保存当前 goroutine 的上下文(寄存器、栈指针等),从调度队列中取出下一个待运行的 goroutine,并恢复其上下文使其运行。 - 处理系统调用
当普通 goroutine 执行系统调用(如syscall.Read)时,会切换到g0的栈执行内核操作,避免用户栈被内核污染。系统调用完成后,再由g0切换回原 goroutine 继续运行。 - 支持垃圾回收(GC)
在 GC 过程中,g0负责协助暂停所有用户 goroutine(“stop the world”),执行内存标记/清理操作,完成后再恢复用户 goroutine 运行。 - 初始化与退出
程序启动时,g0负责初始化运行时环境(如内存分配器、调度器),并启动main函数所在的用户 goroutine;程序退出时,g0负责清理资源。
总结
g0 是 Go 运行时的“调度助手”,作为每个系统线程(m)的专属协程,它承担了调度用户 goroutine、处理系统调用、支持 GC 等底层核心工作,是 Go 协程模型能够高效运行的关键基础设施。普通开发者无需直接操作 g0,但理解它的作用有助于深入理解 Go 的并发调度原理。
3、Go语言中的new make var 以及短声明的区别?new 分配内存,返回指针;make 切片 返回本身,初始化结构;var 显示声明自动赋值,申请内存并初始化;短声明,自动推断变量
new
- 为某种类型分配内存,返回该类型的指针
- 分配内存,不初始化(除了零值)
var
- 声明变量(可以带初始值,也可以不带)。
- 不赋值时,自动初始化为零值(0、""、nil 等)。
- 适用于包级变量或需要显式声明类型的地方。
make
- 只用于创建 slice、map、channel,并完成初始化。
make会分配内存并初始化底层数据结构。- 返回的是引用类型本身(不是指针)。
短声明变量
- 声明并初始化变量(只能在函数内用)自动推算变量的类型。
4、Go语言中切片(slice)和数组的区别,用途?切片扩容机制?切底层结构包括容量,长度,引用的底层数组的地址,数组是不可变化长度的。 1024前是2 倍,后是1.25倍。切片底层是共享数组的
数组
- 数组的长度是在初始化就定好的,一旦声明就不能改变。
- 值类型:数组赋值或作为函数参数时,会拷贝整个数组(而非引用),修改副本不会影响原数组。
切片:切片本身仅包含三个信息(指向底层数组的指针、长度、容量)
切片是对数组的动态视图,它本身不存储数据,而是引用底层数组的一段连续元素。
- 长度是动态可变的。
- 具有容量(cap),长度(len)两个特性。
- 引用类型:切片赋值或作为函数参数时,传递的是引用(指针),修改切片会影响底层数组和其他引用同一数组的切片。
切片扩容机制
- 当
append导致切片长度超过容量时,Go 会创建一个新的底层数组(通常是原容量的 2 倍,大容量(256)时可能为 1.25 倍),并复制原数据。此时切片会指向新数组,原数组若无人引用则会被 GC 回收。
newcap := oldCap

if newcap < 256 {
    newcap *= 2
} else {
    for newcap < required(追加后需要的容量) {
        newcap += (newcap + 3*256) / 4
    }
}
切片的“贡献底层数组”
- 多个切片引用同一底层数组时,修改一个切片可能影响其他切片。若需独立修改,可使用
copy函数创建新切片
s1 := []int{1, 2, 3}
s2 := make([]int, len(s1))
copy(s2, s1)  // s2 是独立切片,修改不影响 s1
package main

import "fmt"

func main() {
    // 创建一个底层数组并生成切片
    numbers := []int{1, 2, 3, 4, 5}

    // 从原片创建子切片(共享底层数组)
    subSlice := numbers[1:3] // 包含元素 [2, 3]
    fmt.Println("原始子切片:", subSlice) // 输出: [2 3]

    // 错误操作:修改子切片,预期只影响子切片
    subSlice[0] = 99
    fmt.Println("修改后的子切片:", subSlice) // 输出: [99 3]

    // 意外结果:原始切片也被修改了
    fmt.Println("被影响的原始切片:", numbers) // 输出: [1 99 3 4 5]

    // 更隐蔽的错误:通过append扩容前的修改仍会影响原始数组
    subSlice = append(subSlice, 6)
    subSlice[1] = 88
    fmt.Println("再次修改的子切片:", subSlice) // 输出: [99 88 6]
    fmt.Println("再次被影响的原始切片:", numbers) // 输出: [1 99 88 4 5]
}
for range 的时候,它的地址会发生什么变化?
1.21版本前for range 循环会声明一个循环变量(如 v),每次迭代时,会将当前元素的值复制到这个循环变量中。关键是:这个循环变量在整个循环过程中是同一个变量,地址始终不变,只是值在每次迭代时被更新。
1.21版本后:range 每次迭代创建新的循环变量。
for _, v := range arr {
    v := v   // 创建新变量
    go func() {
        fmt.Println(v)
    }()
}
如何高效地拼接字符串?
在 Go 语言中,字符串是不可变的(每次修改都会创建新字符串),因此高效拼接字符串需要避免频繁的内存分配和复制。以下是几种常用方法的对比及最优实践:
一、不同拼接方式的效率对比
|
方法 |
原理 |
时间复杂度 |
适用场景 |
|
|
每次拼接创建新字符串 |
O(n²) |
少量固定次数的拼接 |
|
|
格式化字符串时内部拼接 |
O(n²) |
需格式化的简单场景 |
|
|
内部用字节切片动态扩容 |
O(n) |
大量拼接操作(推荐) |
|
|
字节缓冲区,支持动态扩容 |
O(n) |
需同时处理字节和字符串的场景 |
|
|
提前计算容量,手动拼接 |
O(n) |
已知大致长度的拼接 |
二、高效拼接的实现方法
1. 推荐:使用 strings.Builder(最优选择)
strings.Builder 是 Go 1.10 引入的专门用于字符串拼接的工具,内部维护一个字节切片([]byte),通过 WriteString 方法避免重复分配内存,效率最高。
2. 关键优化点
- 预分配容量:通过
Grow(n)方法(strings.Builder和bytes.Buffer)或手动创建指定容量的切片(make([]byte, 0, n)),避免动态扩容时的内存复制开销。 - 减少内存分配:
strings.Builder和bytes.Buffer内部通过字节切片积累数据,最终通过String()方法转换为字符串(仅一次内存分配)。
三、性能差异原因
+运算符每次拼接都会创建新字符串(复制原有数据),对于 n 次拼接,总操作量为 1+2+...+n = O(n²),效率极低。strings.Builder等工具通过复用底层字节切片,仅在容量不足时扩容(按 2 倍或 1.25 倍增长),总内存复制量为 O(n),接近最优。
四、总结
- 优先使用
strings.Builder:专为字符串拼接设计,API 简洁,性能最优。 - 预分配容量:若能预估总长度,通过
Grow()或预分配切片进一步提升效率。 - 避免
+运算符和fmt.Sprintf:仅用于少量、固定次数的拼接场景。
通过以上方法,可显著提升字符串拼接的效率,尤其在处理大量字符串或高频拼接场景(如日志生成、数据序列化)中效果明显。
strings.Builder是如何避免频繁内存分配的?
strings.Builder 是 Go 语言中高效字符串拼接的核心工具,其避免频繁内存分配的核心原理是 “内部维护可动态扩容的字节切片,并通过预分配和减少复制实现” 实现的。具体机制如下:
一、核心数据结构:底层字节切片
strings.Builder 的底层通过一个 []byte 类型的字段(源码中为 buf)存储拼接的临时数据:
type Builder struct {
    buf []byte  // 用于积累拼接内容的字节切片
}
与直接使用字符串拼接(+ 运算符)不同,Builder 不会每次拼接都创建新字符串,而是将所有内容先写入 buf 切片,最终通过一次转换得到结果字符串。
二、避免频繁分配的关键机制
1. 延迟内存分配,复用已有空间
- 初始时,
buf是一个空切片(nil),不分配内存。 - 第一次写入时(如
WriteString),才会根据写入内容的大小初始化buf。 - 后续写入时,若
buf已有足够空间,直接追加内容(append),不触发新的内存分配。
2. 动态扩容策略:减少扩容次数
当 buf 空间不足时,Builder 会按 “指数级扩容” 策略重新分配内存,避免频繁扩容:
- 扩容规则:新容量 = 现有容量 × 2(若现有容量 < 64,则直接扩到 64;若超过最大容量,则使用最大容量)。
- 优势:相比线性扩容(每次加固定大小),指数级扩容能将扩容次数从 O(n) 降至 O(log n),大幅减少内存分配和数据复制的开销。
示例:
若初始容量为 0,依次写入 1、2、4、8... 字节的内容,仅需 log2(n) 次扩容。
3. 预分配机制:Grow 方法主动规避扩容
Builder 提供 Grow(n int) 方法,允许提前预留 n 字节的空间:
var b strings.Builder
b.Grow(100)  // 预分配至少 100 字节的空间
b.WriteString("hello")  // 无需扩容,直接写入
- 若当前
buf容量不足,Grow会直接扩容到“现有长度 + n”的大小,确保后续n字节的写入无需再次扩容。 - 适用于已知拼接内容总长度的场景(如拼接固定数量的字符串),可彻底避免扩容带来的分配和复制。
4. 最终一次性转换为字符串
所有内容拼接完成后,通过 String() 方法将 buf 转换为字符串:
func (b *Builder) String() string {
    return *(*string)(unsafe.Pointer(&b.buf))
}
- 这里使用
unsafe.Pointer进行“零复制”转换(直接将字节切片的底层数据转为字符串),不产生新的内存分配(仅创建字符串头部结构,指向原有字节数组)。 - 这是
Builder相比bytes.Buffer.String()更高效的原因之一(bytes.Buffer转换时可能需要复制数据)。
三、与 + 运算符的对比
|
操作 |
|
|
|
每次拼接的行为 |
创建新字符串,复制全部原有数据 + 新数据 |
直接追加到 |
|
内存分配次数 |
O(n)(n 为拼接次数) |
O(log n)(仅扩容时分配) |
|
总数据复制量 |
O(n²)(累加复制) |
O(n)(仅扩容时复制一次) |
四、总结
strings.Builder 避免频繁内存分配的核心逻辑是:
- 用 可动态扩容的字节切片 临时存储内容,避免每次拼接创建新字符串。
- 采用 指数级扩容 策略,减少扩容次数和数据复制量。
- 提供 预分配接口(
Grow),允许主动规避扩容。 - 最终通过 零复制转换 生成结果字符串,彻底消除额外开销。
这种设计使其在字符串拼接场景(尤其是大量拼接)中性能远超 + 运算符,是 Go 语言中字符串拼接的最优选择。
// 测试不同拼接方式的性能和内存分配情况
func main() {
	// 模拟需要拼接的大量字符串片段
	numParts := 100000 // 10万个片段
	parts := make([]string, numParts)
	for i := 0; i < numParts; i++ {
		parts[i] = fmt.Sprintf("part_%d", i)
	}

	// 1. 使用 + 运算符拼接(低效方式)
	start := time.Now()
	result := ""
	for _, part := range parts {
		result += part
	}
	fmt.Printf("+ 运算符:耗时 %v,结果长度 %d\n", time.Since(start), len(result))

	// 2. 使用 strings.Builder 拼接(基础用法)
	start = time.Now()
	var b1 strings.Builder
	for _, part := range parts {
		b1.WriteString(part)
	}
	result1 := b1.String()
	fmt.Printf("strings.Builder(基础):耗时 %v,结果长度 %d\n", time.Since(start), len(result1))

	// 3. 使用 strings.Builder 并预分配容量(最优用法)
	start = time.Now()
	var b2 strings.Builder
	// 预计算总长度并分配空间
	totalLen := 0
	for _, part := range parts {
		totalLen += len(part)
	}
	b2.Grow(totalLen) // 预分配恰好需要的空间,避免任何扩容
	for _, part := range parts {
		b2.WriteString(part)
	}
	result2 := b2.String()
	fmt.Printf("strings.Builder(预分配):耗时 %v,结果长度 %d\n", time.Since(start), len(result2))
}
go语言中interface 的常见比较问题
在 Go 语言中,interface 的比较是一个容易出错的点,主要源于其底层结构的特殊性。interface 包含类型信息和值信息两部分,比较时需同时满足这两部分的条件,否则可能出现不符合预期的结果。以下是常见的比较问题及解析:
一、interface 比较的底层逻辑
interface 在底层由两个字段组成:
type iface struct {
    typ  *type  // 存储值的类型
    data unsafe.Pointer  // 存储值的指针
}
比较两个 interface 时,需同时满足:
- 两者的
typ必须完全相同(类型一致)。 - 两者的
data指向的值必须相等(值一致)。
若不满足以上任一条件,比较结果为 false。
二、常见比较问题及示例
1. 不同类型的 interface 比较返回 false
即使底层值相同,若 interface 存储的类型不同,比较结果为 false。
package main

import "fmt"

func main() {
    var a interface{} = 10  // 类型为 int,值为 10
    var b interface{} = int32(10)  // 类型为 int32,值为 10

    fmt.Println(a == b)  // 输出: false(类型不同)
}
2. 包含不可比较类型的值时,比较会 panic
若 interface 存储的值是不可比较类型(如切片、映射、函数),直接比较会触发运行时 panic。
package main

import "fmt"

func main() {
    var a interface{} = []int{1, 2}
    var b interface{} = []int{1, 2}

    // fmt.Println(a == b)  // 运行时 panic: 不可比较类型 []int
}
原因:切片、映射等类型没有定义相等性比较规则(如切片比较需遍历元素,Go 不支持直接比较),因此包含这些类型的 interface 无法安全比较。
3. nil 接口与存储 nil 的接口不等价
nil 接口(未存储任何值和类型)与存储了 nil 指针的接口(类型明确,值为 nil)不相等。
package main

import "fmt"

func main() {
    var a interface{} = nil  // 真正的 nil 接口:typ 和 data 均为 nil
    var b interface{} = (*int)(nil)  // 类型为 *int,值为 nil

    fmt.Println(a == nil)  // 输出: true
    fmt.Println(b == nil)  // 输出: false(类型不为 nil)
    fmt.Println(a == b)    // 输出: false(类型不同)
}
常见坑点:函数返回 interface{} 时,若返回 nil 指针(如 (*int)(nil)),判断其是否为 nil 会失败。
4. 结构体比较中的字段不可比较导致整体不可比较
若 interface 存储的结构体包含不可比较字段(如切片),则该结构体不可比较,比较时会 panic。
package main

import "fmt"

type Data struct {
    Values []int  // 切片字段(不可比较)
}

func main() {
    var a interface{} = Data{Values: []int{1}}
    var b interface{} = Data{Values: []int{1}}

    // fmt.Println(a == b)  // 运行时 panic: 结构体包含不可比较字段
}
5. 浮点数的特殊比较(NaN 不等于自身)
interface 存储浮点数时,需注意 NaN(非数值)的特殊性:NaN 不等于任何值,包括自身。
package main

import "fmt"
import "math"

func main() {
    var a interface{} = math.NaN()
    var b interface{} = math.NaN()

    fmt.Println(a == b)  // 输出: false(NaN 不等于自身)
}
三、安全比较 interface 的建议
- 先判断类型是否一致:使用
type assertion或reflect.TypeOf确认类型后再比较值。
func safeEqual(a, b interface{}) bool {
    if reflect.TypeOf(a) != reflect.TypeOf(b) {
        return false
    }
    // 处理可比较类型(需排除不可比较类型)
    // ...
}
- 避免比较包含不可比较类型的
interface:若需比较,手动实现比较逻辑(如遍历切片元素)。 - 区分 nil 接口和 nil 指针:判断
interface是否为真正的nil时,需同时检查类型和值。
func isNil(v interface{}) bool {
    return v == nil || (reflect.ValueOf(v).Kind() == reflect.Ptr && reflect.ValueOf(v).IsNil())
}
总结
interface 的比较需同时满足类型相同和值可比较且相等,常见问题集中在:
- 类型不匹配导致比较为
false; - 包含不可比较类型导致 panic;
- nil 接口与存储 nil 指针的接口混淆;
- 特殊值(如 NaN)的比较异常。
在使用 interface 比较时,需格外注意类型一致性和值的可比较性,必要时通过反射或手动逻辑确保安全。
nil和interface{}的比较问题
在 Go 语言中,nil 的比较是一个容易产生困惑的点,尤其是涉及接口(interface{})时,nil 的判断逻辑与其他类型有显著差异。这一问题的核心源于 nil 的本质 和 接口的底层结构,具体可从以下几个方面深入分析:
一、nil 的本质
nil 在 Go 中表示“零值指针”,即未指向任何内存地址的指针。它不是一个具体的值,而是多种指针类型(如 *int、[]int、map、chan、func、interface{} 等)的零值。
例如:
var p *int = nil:p是*int类型的 nil 指针。var m map[string]int = nil:m是map类型的 nil 引用。
二、普通类型的 nil 比较(非接口类型)
对于非接口类型的指针或引用类型(如 *T、[]T、map 等),nil 比较逻辑直观:只有当变量未指向任何对象时,与 nil 的比较结果为 true。
package main

import "fmt"

func main() {
    var p *int = nil
    var m map[string]int = nil
    var s []int = nil

    fmt.Println(p == nil) // true(*int 类型的 nil)
    fmt.Println(m == nil) // true(map 类型的 nil)
    fmt.Println(s == nil) // true(切片类型的 nil)

    // 初始化后不再是 nil
    m = make(map[string]int)
    fmt.Println(m == nil) // false
}
规则:同类型的 nil 变量之间比较结果为 true(如 var p1, p2 *int = nil; p1 == p2 // true), 不同类型的 nil 变量无法直接比较(如 p == m 会编译错误)。
三、接口(interface{})与 nil 的比较(核心坑点)
接口类型的 nil 比较是最容易出错的场景,因为 接口的底层结构包含“类型”和“值”两部分,只有当两者均为 nil 时,接口才被视为 nil。
1. 接口的底层结构
空接口(interface{})的底层由 runtime.eface 结构体表示:
type eface struct {
    _type *rtype        // 存储值的类型
    data  unsafe.Pointer // 存储值的指针
}
- 当接口变量为“真正的
nil”时:_type和data均为nil(未存储任何值和类型)。 - 当接口变量存储了一个“
nil指针”时:_type为该指针的类型(如*int),data为nil(值是nil,但类型明确)。
2. 典型问题:“存储 nil 指针的接口 != nil”
当一个接口变量存储了一个 nil 指针(如 *int 类型的 nil),它与 nil 的比较结果为 false,因为接口的 _type 字段不为 nil。
package main

import "fmt"

func main() {
    var p *int = nil       // p 是 *int 类型的 nil 指针
    var i interface{} = p  // i 存储了 *int 类型的 nil 指针

    fmt.Println(p == nil)  // true(p 是 nil 指针)
    fmt.Println(i == nil)  // false(i 的 _type 是 *int,不为 nil)
}
原因:接口 i 的 _type 字段记录了 *int 类型,data 字段为 nil,但由于 _type 不为 nil,因此 i 不被视为 nil 接口。
3. 函数返回值的陷阱
函数返回 interface{} 类型时,若返回一个 nil 指针(而非真正的 nil 接口),调用方判断 nil 会失败:
package main

import "fmt"

// 返回 *int 类型的 nil 指针,隐式转换为 interface{}
func getNil() interface{} {
    var p *int = nil
    return p // 接口的 _type = *int,data = nil
}

func main() {
    res := getNil()
    fmt.Println(res == nil) // false(预期 true,实际 false)
}
解决方案:若需返回 nil 接口,应直接返回 nil,而非 nil 指针:
func getRealNil() interface{} {
    return nil // 真正的 nil 接口:_type 和 data 均为 nil
}
4. 两个存储 nil 指针的接口比较
若两个接口存储了同类型的 nil 指针,则比较结果为 true(类型相同且值均为 nil):
package main

import "fmt"

func main() {
    var p1 *int = nil
    var p2 *int = nil

    var i1 interface{} = p1
    var i2 interface{} = p2

    fmt.Println(i1 == i2) // true(类型均为 *int,值均为 nil)
}
四、如何正确判断接口是否为 nil?
若需判断一个接口变量是否为“真正的 nil”(即未存储任何类型和值),可通过反射检查其类型和值是否均为 nil:
package main

import "fmt"
import "reflect"

// 判断接口是否为真正的 nil
func isNil(i interface{}) bool {
    if i == nil {
        return true
    }
    // 检查类型是否为指针,且值为 nil
    v := reflect.ValueOf(i)
    return v.Kind() == reflect.Ptr && v.IsNil()
}

func main() {
    var a interface{} = nil
    var b interface{} = (*int)(nil)

    fmt.Println(isNil(a)) // true(真正的 nil)
    fmt.Println(isNil(b)) // true(存储了 nil 指针)
}
- 若业务逻辑中“存储
nil指针的接口”应被视为nil,可使用上述方法判断。 - 若需严格区分“真正的
nil接口”和“存储nil指针的接口”,直接使用i == nil即可。
五、总结
nil 的比较问题核心在于接口的底层结构:
- 普通类型:
nil比较直观,仅判断变量是否未指向任何对象。 - 接口类型:
nil比较需同时满足“类型为nil”和“值为nil”:
-
- 真正的
nil接口:_type和data均为nil,与nil比较为true。 - 存储
nil指针的接口:_type不为nil,与nil比较为false。
- 真正的
- 常见陷阱:函数返回
nil指针时,接口变量不等于nil,需直接返回nil才能得到真正的nil接口。
理解这一机制,可避免在接口 nil 判断中出现逻辑错误,尤其是在错误处理、函数返回值等场景中。
5、Go是引用传递还是值传递?go只有值传递,基本类型就是典型的值传递,符合类型(结构体,数组)也是值传递,但是成本较高,引用类型的传递的是(底层指针地址,容量,长度),本质上还是指向原数据
在 Go 语言中,所有参数传递都是值传递(pass by value),不存在传统意义上的 “引用传递”。这意味着函数接收的是参数的 “副本”,而非参数本身。
基本类型(int、string、bool 等):典型的值传递
基本类型作为参数传递时,函数会复制参数的值。修改副本不会影响原变量。
复合类型(数组、结构体等):值传递但成本较高
数组、结构体等复合类型作为参数时,会复制整个数据结构(而非引用)。修改副本不会影响原变量,但复制成本随数据量增大而增加。
引用类型(切片、map、chan、指针等):值传递 “引用的副本”
切片、map、通道等类型本质是 “引用类型”,但传递时仍是值传递—— 传递的是 “引用的副本”(如切片的指针、长度、容量)。
这些副本指向底层数据结构,因此修改副本指向的底层数据会影响原变量,但修改副本本身(如重新赋值)不会影响原变量。
6、Go中的协程、线程、进程的区别? 协程程序执行的最小单元,用户级的轻线程不需要内核参与;进程,资源分配的最小单元,具有隔离性,独立资源,线程,共享进程的内存,
进程
进程是程序的一次执行过程,是操作系统进行资源(CPU、内存、文件句柄等)分配和管理的最小单位。
- 独立资源:每个进程拥有独立的内存空间、文件描述符等资源,进程间默认不共享内存(需通过 IPC 机制如管道、共享内存通信)。
- 重量级:创建、销毁和切换进程的开销大(涉及内存分配、上下文保存等),因此并发数量有限(通常数百个以内)。
- 隔离性:一个进程崩溃不会影响其他进程,安全性高。
线程
共享进程的内存空间和资源,是操作系统调度(CPU 分配)的最小单位。
- 资源共享:同一进程内的线程共享进程的内存、文件句柄等资源,通信成本低(直接读写共享内存)。
- 轻量级:线程的创建、销毁和切换开销远小于进程(无需重新分配内存),并发数量比进程多(通常数千个)。
- 依赖性:线程依赖于进程存在,一个进程崩溃会导致其所有线程终止;同一进程内的线程崩溃可能影响整个进程。
协程
是最小的执行单元,用户态轻量级线程,不属于操作系统内核调度,而是由程序自身控制切换。
- 用户态调度:协程的创建、销毁和切换完全在用户态完成(无需内核参与),开销极小(上下文切换仅需保存少量寄存器状态)。
- 极高并发:一个进程可支持数万甚至数百万个协程(如 Go 的 Goroutine、Python 的 asyncio)。
- 协作式调度:多数协程采用 “协作式” 切换(需显式调用
yield或遇到 I/O 操作时主动让出 CPU),而非操作系统的 “抢占式” 调度(少数语言如 Go 支持抢占式协程)。 - 资源共享:同一进程内的协程共享进程 / 线程资源,需通过锁或 channel 等机制保证同步。
7、Go中的GMP模型是什么?如何调度的?G是协程,M是线程,P是处理器,其中G是由go关键字创建,每一个P独有本地的G队列,还存在一个全局队列,当M想要执行G,需要绑定一个空闲的P,获取本地队列里面的G,执行。如果本地没有,就去窃取其他的P的本地队列(一半),如果阻塞,M就会放弃P,寻找新的空闲P,执行。阻塞之后,G重新被P存在到本地队列。
GPM模型,G表示协程(Goroutine)、P表示处理器、M表示线程。线程 M想要运行任务 G ,就需要获取P, 从P的本地队列获取 G。
模型原理
P(Processor): G 和 M 之间的中间层,负责管理 G 的调度队列,并提供执行 G 所需的资源(如内存缓存)。每个P都有自己的本地队列(P队列-Goroutine)。
抢占式调度:Goroutine是协作式的,一个协程只有让出CPU才能让下一个协程执行,而Goroutine执行超过10ms就会强制让出CPU,防止其他协程饿死。
M(操作系统线程):绑定一个 P,执行P中的本地队列 G。
当 G 执行阻塞操作(如 I/O、锁等待)时,M 会释放 P,让其他 M 可以绑定该 P 继续执行其他 G
- G0:每次启动一个M都会创建的第一个
Goroutine,仅用于调度,不指向任何可执行的函数。每个M都有一个自己的G0,在调度或系统调用时使用G0的栈空间。 - M0:启动程序后的第一个主线程,负责执行初始化操作和启动第一个
Goroutine,此后与其他M一样。
调度流程
- G的创建与入队
- 开发者通过
go关键字创建G。运行时将G加入当前P的本地队列。如果本地队列满,则加入全局队列。
- M绑定P并执行G
- M 启动后,会绑定一个空闲的 P。
- 绑定成功之后,获取 P 本地队列中的 G ,并且执行。
- 工作窃取-负载均衡
- 当 P 中没有本地队列后,窃取其他 P 的本地队列。一般是窃取一半。
- 如果还是没有,则获取全局队列中的 G。
- G 的阻塞与唤醒
- 当 G 进入 阻塞状态, M 就会释放当前 P 。寻找新的 P 去执行 G。当前 P 可能会被其他 M 获取,再执行 P 的本地队列(其他的 G )。
- 阻塞结束之后,G 重新加入 P 的本地队列。等待下次被调度。
8、Go中的CSP( Communicating Sequential Process)模型是什么意思?
通过 “通信” 而非 “共享内存” 实现进程间协作,强调 “顺序进程” 与 “消息传递” 的结合。
- 避免竞态条件:
数据通过通道传递,而非多个 Goroutine 直接修改共享内存,从根本上减少了锁的使用,降低了并发错误的概率。 - 清晰的协作关系:
通道明确了 Goroutine 之间的依赖关系(谁生产数据,谁消费数据),代码逻辑更易理解和维护。 - 天然的同步机制:
通道的发送 / 接收操作是阻塞的,无需额外的同步工具(如 Mutex)即可实现 Goroutine 之间的协调。
9、Go中的垃圾回收机制(GC)流程?三色标记,混合写屏障。标记准备(STW暂停),标记阶段(三色标记+混合写屏障(可达(黑色),不可达(白色),未知(灰色)),从全局堆、goroutine的栈。寄存器 获取对象,标记为灰色,遍历灰色的子对象,全部遍历之后,灰-白,没有遍历的就是白色,在标记过程中,如果创建新对象,或者修改了引用,那么都标记为灰色),标记终止(STW),标记清除
GC流程
Go 语言的垃圾回收(GC)是自动管理内存的机制,用于回收不再被引用的对象,释放内存资源。Go 的 GC 经过多版本优化(目前主要是三色标记法 + 混合写屏障),具有低延迟、高并发的特点。其主要流程可分为以下几个阶段:
Go GC 流程简图
准备阶段 → 短暂 STW,初始化 GC 状态
  ↓
标记阶段 → 根对象扫描(短暂 STW)→ 并发标记(与用户代码并行,写屏障监控)→ 辅助标记
  ↓
标记终止 → 短暂 STW,清理标记状态
  ↓
清理阶段 → 并发回收白色对象,释放内存
一、准备阶段:标记准备(Mark Setup)
在正式开始垃圾回收前,Go 运行时会做一些初始化工作:
- 暂停所有用户 Goroutine(STW 短暂停顿):
为了确保标记的准确性,需要短暂暂停所有用户 Goroutine(Stop The World),此时 CPU 只执行 GC 相关任务。这个阶段非常短暂(微秒级)。 - 初始化 GC 状态:
-
- 重置 GC 相关计数器(如已分配内存大小);
- 准备标记所需的数据结构(如标记队列、三色标记的状态标记)。
二、标记阶段(Marking)
标记阶段的目标是找出所有仍被引用的“存活对象”,未被标记的对象将在后续阶段被回收。此阶段采用三色标记法,并尽可能与用户 Goroutine 并发执行(减少 STW 时间)。
三色标记法的核心逻辑:
- 白色对象:未被标记的对象(默认状态),可能是垃圾。
- 灰色对象:已被标记,但引用的子对象尚未处理的对象。
- 黑色对象:已被标记,且所有子对象都已处理完毕的对象(存活对象)。
标记阶段流程:
- 根对象扫描(STW 短暂停顿):
-
- 根对象是指“一定存活”的对象(如全局变量、当前 Goroutine 的栈上变量、寄存器中的指针等)。
- 扫描根对象,将其标记为灰色,加入标记队列,随后恢复用户 Goroutine 执行。
- 并发标记(与用户代码并行):
-
- GC 后台 Goroutine 从标记队列中取出灰色对象,遍历其引用的子对象:
-
-
- 若子对象是白色,将其标记为灰色并加入队列;
- 处理完所有子对象后,将当前灰色对象标记为黑色。
-
-
- 同时,用户 Goroutine 继续执行,但会受到写屏障(Write Barrier) 的监控:
-
-
- 当用户代码修改对象引用(如将
A 指向 B改为A 指向 C)时,写屏障会拦截操作,确保新引用的对象(C)被标记为灰色,避免漏标记(解决“并发标记时对象引用被修改”的问题)。对象(B)如果是灰色或者是白色,也被标记为灰色。
- 当用户代码修改对象引用(如将
-
- 辅助标记(Mutator Assist):
-
- 若用户 Goroutine 分配内存的速度过快,会被强制参与标记工作(辅助 GC),避免 GC 标记进度落后于内存分配速度。
三、标记终止阶段(Mark Termination)
当所有可达对象(存活对象)都被标记为黑色后,标记阶段结束,进入终止阶段:
- 再次 STW:暂停所有用户 Goroutine,确保标记工作彻底完成。
- 清理标记状态:
-
- 回收标记过程中产生的临时数据结构;
- 统计存活对象数量和内存使用情况。
四、清理阶段(Sweeping)
清理阶段的目标是回收所有未被标记(白色)的垃圾对象,释放其占用的内存。此阶段完全与用户代码并发执行(无需 STW)。
- 遍历堆内存:逐个检查堆中的对象,若为白色(未标记),则将其占用的内存块归还给内存分配器(放入空闲链表)。
- 复用内存:回收的内存块将在后续的内存分配中被重新使用,避免频繁向操作系统申请内存。
Go 垃圾回收的核心优化目标是减少 STW 时间(目前毫秒级甚至微秒级),通过三色标记、写屏障、并发清理等机制,在保证回收效率的同时,尽可能降低对业务代码的影响,这也是 Go 适合高并发服务的重要原因之一。
10、触发GC的条件?(定期、内存超过阈值,手动)
Go 的 GC 自动触发,主要时机包括:
- 内存分配达到阈值:当新分配的内存达到上一次 GC 后存活内存的一定比例(默认 100%,可动态调整)时触发。
- 定时触发:若长时间未触发 GC(默认 2 分钟),会强制触发一次,避免内存泄漏累积。
- 手动触发:通过
runtime.GC()函数手动触发(一般用于测试或特殊场景)。
11、Go中常见的内存泄漏原因?协程没有正常退出(死循环,channe没有配对,阻塞),资源没有关闭,栈上变量逃逸到堆上,闭包内部变量被外部使用
一、未关闭的资源
程序打开的资源(如文件、网络连接、数据库连接等)若未正确关闭,会导致资源关联的内存无法释放,造成泄漏。
二、goroutine 泄漏(最常见)
Goroutine 若因逻辑错误一直处于阻塞状态(未退出),其占用的栈内存、引用的对象都不会被回收,导致泄漏。这是 Go 中最容易出现的内存泄漏场景。
- 无缓冲 channel 的发送 / 接收未配对
若一个 Goroutine 向无缓冲 channel 发送数据,但没有对应的接收者(或反之),Goroutine 会永久阻塞。 - Goroutine 内部死循环
若 Goroutine 陷入无限循环且未退出条件,会一直占用内存。 - 未处理的
context.Done()
使用context控制 Goroutine 生命周期时,若未监听context.Done(),Goroutine 可能在上下文取消后仍继续运行。
三、切片导致的内存泄漏
切片的底层数组若被引用,即使切片本身缩小,底层数组也不会被回收,可能导致大量未使用内存被占用。
解决:复制切片内容到新数组,切断对原数组的引用
func leak() []int {
    large := make([]int, 10000) // 大数组
    // 返回切片(仅引用大数组的前 10 个元素)
    return large[:10]
}
func fixLeak() []int {
    large := make([]int, 10000)
    small := make([]int, 10)
    copy(small, large[:10]) // 复制到新切片
    return small
}
12、Go语言如何实现继承和多态?通过组合接口实现继承和多态
通过 结构体组合 和 接口 机制,可以灵活实现类似继承和多态的功能,且更强调 “组合优于继承” 的设计哲学。
实现 “继承”:结构体组合(匿名嵌套)
Go 采用 “组合” 思想,通过结构体匿名嵌套实现代码复用,模拟继承的效果。外层结构体可以直接访问内层结构体的字段和方法,也能重写方法。
实现 “多态”:接口(隐式实现)
Go 的接口是隐式实现的(无需 implements 关键字),只要类型实现了接口的所有方法,就属于该接口类型。这种特性天然支持多态:同一接口变量可存储不同实现,调用方法时自动适配具体类型。
13、Map的底层实现?map 主要是通过哈希实现的,通过哈希种子,低位为哈希桶 高位为桶内的值,解决冲突(链地址法)
在 Go 语言中,map 的底层实现基于哈希表(Hash Table),具体采用了数组 + 链表(或红黑树) 的组合结构,通过哈希函数将键(key)映射到数组的索引位置,实现高效的增删改查操作。
一、map 的核心数据结构
Go 的 map 底层由 hmap(hash map)结构体表示,核心结构如下(简化版):
type hmap struct {
    count     int           // 当前 map 中的键值对数量(len(map) 的返回值)
    flags     uint8         // 状态标记(如正在扩容、迭代中、删除等)
    B         uint8         // 桶数量的对数(桶总数 = 2^B,例如 B=3 表示 8 个桶)
    noverflow uint16        // 溢出桶的数量(近似值,用于判断是否需要扩容)
    hash0     uint32        // 哈希种子(随机数,用于计算 key 的哈希值,避免哈希碰撞攻击)

    buckets    unsafe.Pointer // 指向桶数组的指针(每个元素是 *bmap)
    oldbuckets unsafe.Pointer // 扩容时指向旧桶数组的指针(渐进式扩容期间非 nil)
    nevacuate  uintptr        // 记录扩容时已迁移的旧桶数量(用于渐进式迁移)

    extra *mapextra // 指向额外信息的指针(如溢出桶、备用桶等)
}

// 额外信息结构体,存储溢出桶等辅助数据
type mapextra struct {
    overflow    *[]*bmap // 指向溢出桶的指针数组
    oldoverflow *[]*bmap // 扩容时旧桶的溢出桶
    nextOverflow *bmap   // 下一个可用的溢出桶(预分配的备用桶)
}
核心组件说明:
- 哈希桶数组(
buckets):
由多个bmap组成,每个bmap可存储 8 个键值对。桶的数量为2^B(B 是hmap的字段),确保桶数量是 2 的幂,便于通过哈希值取模快速定位桶。 - 哈希函数:
对键(key)计算哈希值(hash(key)),得到一个 64 位整数。其中:
-
- 低位用于计算桶索引(
hash(key) & (2^B - 1)),确定键值对属于哪个桶; - 高位(
tophash)存储在bmap中,用于快速比较键是否匹配(减少全量比较的开销)。
- 低位用于计算桶索引(
- 溢出桶(overflow):
当一个桶存储的键值对超过 8 个时,会通过bmap中的溢出指针 链接到新的桶(溢出桶),形成链表结构。
二、map 的基本操作原理
1. 查找(Get)
- 对 key 计算哈希值
h; - 用哈希值低位计算桶索引
i = h & (2^B - 1),定位到桶buckets[i]; - 遍历该桶及溢出桶,对比
tophash与哈希值高位,找到匹配的 key 后返回对应 value。
2. 插入(Put)
- 计算 key 的哈希值,定位到目标桶;
- 若桶中有空闲位置(未满 8 个),直接插入键值对,并记录
tophash; - 若桶已满,创建溢出桶,将新键值对插入溢出桶,并更新原桶的溢出指针。
3. 删除(Delete)
- 定位到 key 所在的桶及位置;
- 清空该位置的键值对,标记为“空”(不删除桶结构,仅标记无效);
- 若桶中所有键值对都被删除,可能会回收溢出桶(视情况优化)。
三、哈希冲突与解决
哈希冲突指不同的 key 计算出相同的哈希值(或相同的桶索引)。Go 采用链地址法解决冲突:
- 当多个 key 映射到同一个桶时,它们会被存储在该桶或其链接的溢出桶中,形成链表;
- 查找时需遍历链表中的所有桶,直到找到匹配的 key。
优化:当溢出桶中的元素过多(链表过长),Go 会将链表转换为红黑树(Go 1.18+ 针对某些类型优化),将查找时间复杂度从 O(n) 降至 O(log n)。
四、map 的特性与限制
- 无序性:遍历
map时,键值对的顺序不固定(因哈希分布和扩容影响)。 - key 必须可比较:key 必须是支持
==比较的类型(如 int、string、指针等),切片、map、函数等不可作为 key。 - 引用类型:
map是引用类型,赋值或传参时传递的是指针副本,修改会影响原 map。 - 不可并发修改:多个 Goroutine 同时修改
map会导致 panic(需用sync.Map或锁保证并发安全)。
14、Map如何实现扩容?
扩容机制(Resizing)
当 map 中的键值对数量过多(负载因子6.5 count/(2^B) 超过阈值),或溢出桶链过长时,会触发扩容,避免哈希冲突加剧导致性能下降。
扩容分为两种类型:
- 等量扩容(Same-size Grows):
当溢出桶过多但键值对总数不多时,重新分配同样数量的桶,将键值对重新哈希分散到新桶中,减少溢出桶数量(解决“哈希分布不均”问题)。 - 翻倍扩容(Growing):
当键值对数量超过阈值(通常是桶数量的 6.5 倍),新桶数量变为原来的 2 倍(B+1),所有键值对重新哈希到新桶中,降低负载因子。
扩容过程:
- 扩容是渐进式的(不一次性完成),每次操作(增删改查)会迁移部分键值对到新桶,避免单次扩容耗时过长影响性能;
- 迁移期间,
hmap同时持有旧桶和新桶,直到所有键值对迁移完成。
15、如何避免Map的并发问题?sync.map、 锁、copy副本
- 使用互斥锁(
sync.Mutex或sync.RWMutex) sync.Map是 Go 标准库提供的并发安全 map,专为 “读多写少” 场景优化,内部通过分离读写 map 和原子操作实现高效并发。- 复制私有副本(无共享访问)
让每个 Goroutine 持有 map 的私有副本,通过避免共享来实现并发安全。适用于读多写少且数据变更频率低的场景。
16、Map和Slice的区别?map 无序键值对,slice有序
- Slice 是有序的动态数组,适合按顺序存储同类型元素,强调索引访问和连续性;
- Map 是无序的键值对集合,适合通过 key 快速操作数据,强调查找效率和关联性。
17、Go中的select语句的执行流程。监听通道是否存在数据,随机进入(防止饿死)
select 是用于处理多个通道(channel)操作的控制结构,类似于 switch,但专门用于通道的读写操作。它能同时等待多个通道的操作,当其中一个通道可操作时,就执行对应的分支;若多个通道可操作,则随机选择一个执行,从而实现 Goroutine 间的高效协作。
select 是 Go 并发模型中连接多个通道的关键工具,广泛用于超时控制、退出通知、多事件监听等场景。
- 若有多个
case可执行:通过伪随机算法选择一个分支执行(确保公平性,避免某个通道被饿死)。 - 若只有一个
case可执行:直接执行该分支。
17、slice作为函数参数传递,会改变原slice吗?
在 Go 语言中,slice 作为函数参数传递时,是否会改变原 slice 取决于操作的类型。这是因为 slice 在 Go 中是引用类型,但传递的是其引用的副本(即 slice 结构体的副本)。
核心原理
slice 的底层结构包含三个部分:
- 指向底层数组的指针(
pointer) - 切片的长度(
len) - 切片的容量(
cap)
当 slice 作为参数传递给函数时,函数接收的是这个结构体的副本,但副本中的指针仍指向原底层数组。
两种情况分析
- 修改 slice 中的元素 → 会改变原 slice
由于副本和原 slice 共享底层数组,修改元素会直接操作底层数组,原 slice 会受到影响。
func modifyElement(s []int) {
    s[0] = 100 // 修改底层数组元素
}

func main() {
    a := []int{1, 2, 3}
    modifyElement(a)
    fmt.Println(a) // 输出 [100 2 3],原 slice 被改变
}
- 修改 slice 的结构(长度、容量或重新分配底层数组)→ 不会改变原 slice
若函数内对 slice 进行append导致扩容(底层数组更换),或直接重新赋值,只会影响函数内的副本,原 slice 不受影响。
func modifySlice(s []int) {
    s = append(s, 4) // 若触发扩容,副本指向新数组
    s[0] = 100       // 仅修改副本的底层数组(可能是新数组)
}

func main() {
    a := []int{1, 2, 3}
    modifySlice(a)
    fmt.Println(a) // 输出 [1 2 3],原 slice 未改变
}
总结
- 修改元素:会改变原 slice(共享底层数组)。
- 修改结构(如
append扩容、重新赋值):不会改变原 slice(副本与原 slice 分离)。
若需在函数内修改 slice 结构并同步到外部,需通过指针传递(*[]int)。
18、defer是什么?怎么用?执行延迟函数(关闭资源,捕获异常 ),每一个g都有一个defer链,按照先进后出的顺序执行。
多个 defer 通过 link 串联成单向链表,每个 Goroutine 维护一个 defer 链表。
当包含 defer 的函数即将退出时(无论正常返回还是 panic),运行时会触发 defer 执行:
- 遍历
defer链表:从当前 Goroutine 的defer链表头部开始,依次取出_defer实例。 - 执行延迟函数:调用
_defer.fn执行延迟函数,同时标记started=true(避免重复执行)。 - 清理链表:执行完一个
_defer后,将其从链表中移除,继续遍历下一个,直到链表为空。
若函数因 panic 退出:defer 执行完成后,panic 会继续向上传播(除非 defer 中调用 recover() 捕获异常)。
链表结构:多个 defer 以头插法形成单向链表,注册顺序与链表顺序相反。
执行顺序:函数退出时从链表头部开始执行,即后进先出(LIFO),与声明顺序相反。
19、Context是什么?怎么用?基于树形结构和继承,可以派生子context,传递元数据,控制协程退出,超时
可组合性:可以从一个context生成多个context,每个子context都有自己的取消函数和超时时间.
一、Context 的核心原理
Context 的设计基于树形结构和接口继承,核心思想是:
- 每个
Context实例可以派生出子Context(通过WithCancel、WithTimeout等方法),形成父子关系。 - 当父
Context被取消时,所有子Context会被递归取消,实现 “一父死,全子亡” 的生命周期管理。
二、取消传播机制
当父 Context 被取消时(调用取消函数或超时),会触发以下流程:
- 关闭自身的
Done()通道(通知依赖它的 Goroutine 退出)。 - 递归取消所有子
Context(调用子Context的取消函数)。 - 清除父与子的关联(避免内存泄漏)。
这种机制确保了所有关联的 Goroutine 能被统一、及时地终止。
三、使用场景
主要用于协调多个 Goroutine 的生命周期和传递请求上下文
(一) 控制 Goroutine 退出(避免泄漏)
当一个请求需要启动多个 Goroutine 协作(如并行查询多个接口),可用 Context 确保所有 Goroutine 在请求结束(或超时)时及时退出,避免资源泄漏。
(二) 超时控制
对外部服务调用(如 HTTP 请求、数据库查询)设置超时时间,防止长时间阻塞:
(三) 传递请求元数据
在分布式系统中,一个请求可能经过多个函数或服务,Context 可传递请求 ID、用户认证信息等,无需修改函数参数列表。
20、Channel底层实现是什么? 环形队列,接收和发送队列
其底层实现基于环形队列和等待队列,通过精巧的结构设计保证了并发安全性和高效性。
type hchan struct {
    qcount   uint           // 队列中当前元素数量
    dataqsiz uint           // 环形队列的容量(缓冲大小)
    buf      unsafe.Pointer // 指向环形队列的指针(存储缓冲数据)
    elemsize uint16         // 每个元素的大小(字节)
    closed   uint32         // 通道是否关闭(0:未关闭,1:已关闭)
    elemtype *_type         // 元素类型信息(用于内存操作)
    sendx    uint           // 发送操作的索引(环形队列的写入位置)
    recvx    uint           // 接收操作的索引(环形队列的读取位置)
    recvq    waitq          // 等待接收的 Goroutine 队列
    sendq    waitq          // 等待发送的 Goroutine 队列

    // 保护 hchan 所有字段的互斥锁
    lock mutex
}

// 等待队列(双向链表),存储等待的 Goroutine
type waitq struct {
    first *sudog
    last  *sudog
}
channel 的底层实现是带锁的环形队列 + 等待队列:
- 缓冲通道通过环形队列暂存数据,减少阻塞;
- 无缓冲通道直接在 Goroutine 间传递数据,实现强同步;
- 等待队列(
recvq/sendq)存储阻塞的 Goroutine,通过唤醒机制实现协作。
1. 发送操作(ch <- val)
发送操作的核心逻辑是 “将数据放入缓冲,或直接传递给等待的接收方”,步骤如下:
- 加锁:获取
hchan.lock,确保操作原子性。 - 检查通道状态:
-
- 若通道已关闭(
closed=1),触发 panic(向关闭的通道发送数据)。
- 若通道已关闭(
- 尝试直接发送给接收方:
-
- 若
recvq(等待接收的 Goroutine 队列)不为空(有等待的接收 Goroutine),直接将数据拷贝到接收方的内存(跳过缓冲),并唤醒接收 Goroutine。
- 若
- 尝试放入缓冲队列:
-
- 若缓冲未满(
qcount < dataqsiz),将数据拷贝到buf[sendx],更新qcount和sendx(环形队列索引 +1 取模)。
- 若缓冲未满(
- 阻塞等待:
-
- 若缓冲已满,当前 Goroutine 包装成
sudog加入sendq,释放锁并休眠(等待被唤醒)。
- 若缓冲已满,当前 Goroutine 包装成
- 解锁:操作完成后释放锁。
2. 接收操作(val <- ch 或 <-ch)
接收操作的核心逻辑是 “从缓冲取数据,或等待发送方的数据”,步骤如下:
- 加锁:获取
hchan.lock。 - 检查通道状态:
-
- 若通道已关闭且缓冲为空(
closed=1 && qcount=0),返回元素零值(不阻塞)。
- 若通道已关闭且缓冲为空(
- 尝试直接从发送方接收:
-
- 若
sendq(等待发送的 Goroutine 队列)不为空(有等待的发送 Goroutine):
- 若
-
-
- 若为无缓冲通道,直接从发送方拷贝数据到接收变量。
- 若为缓冲通道且缓冲已满,先从缓冲取一个元素到接收变量,再将发送方的数据放入缓冲。
- 唤醒发送 Goroutine。
-
- 尝试从缓冲队列取数据:
-
- 若缓冲非空(
qcount > 0),从buf[recvx]拷贝数据到接收变量,更新qcount和recvx。
- 若缓冲非空(
3. 关闭操作(close(ch))
关闭操作的核心是 “标记通道为关闭状态,唤醒所有等待的 Goroutine”,步骤如下:
- 加锁:获取
hchan.lock。 - 检查通道状态:
-
- 若通道已关闭(
closed=1),触发 panic(重复关闭)。
- 若通道已关闭(
- 标记为关闭:设置
closed=1。 - 唤醒等待队列:
-
- 唤醒
recvq中所有等待的接收 Goroutine(返回零值)。 - 唤醒
sendq中所有等待的发送 Goroutine(触发 panic,因向关闭的通道发送数据)。
- 唤醒
- 清空缓冲:(逻辑上)标记缓冲数据可被读取(直到为空)。
- 解锁:释放锁。
21、Go语言中Goroutine协程常见的通信方式 互斥锁,channel,
一、通道(channel):Go 推荐的通信方式
channel 是 Goroutine 间最常用、最安全的通信方式,通过传递数据实现协作,底层由同步机制保证线程安全。
二、共享内存 + 锁:通过共享变量通信
多个 Goroutine 共享同一块内存区域(如全局变量),通过锁(sync.Mutex 或 sync.RWMutex)保证并发安全。这种方式需手动控制同步,容易引发竞态条件,Go 通常不推荐,但在特定场景下适用。
三、Context:控制 Goroutine 生命周期
context.Context 主要用于传递取消信号、超时信号,协调多个 Goroutine 同步退出,是 “控制流通信” 的核心方式。
四、WaitGroup:等待多个 Goroutine 完成
sync.WaitGroup 用于等待一组 Goroutine 全部执行完毕,本质是通过计数器实现的同步机制,不直接传递数据,而是协调执行顺序。
22、如何避免协程数量无限增加或者说如何控制协程的数量?
一、使用带缓冲的通道实现 “信号量” 控制
通过带缓冲的 channel 作为 “信号量”(Semaphore),缓冲大小即为允许的最大并发 Goroutine 数量。每个 Goroutine 启动前先从 channel 取一个 “信号”,结束后放回,从而限制并发数。
package main
import (
	"fmt"
	"time"
)
func main() {
	const maxConcurrent = 3 // 最大并发 Goroutine 数量
	semaphore := make(chan struct{}, maxConcurrent)
	totalTasks := 10        // 总任务数

	for i := 0; i < totalTasks; i++ {
		// 从信号量取一个位置,若满则阻塞(等待其他任务释放)
		semaphore <- struct{}{}

		go func(taskID int) {
			defer func() {
				<-semaphore // 任务结束,释放信号量位置
			}()

			// 模拟任务执行
			fmt.Printf("任务 %d 开始执行\n", taskID)
			time.Sleep(1 * time.Second) // 模拟耗时操作
			fmt.Printf("任务 %d 执行完毕\n", taskID)
		}(i)
	}

	// 等待所有信号量位置释放(所有任务完成)
	for i := 0; i < maxConcurrent; i++ {
		semaphore <- struct{}{}
	}
	fmt.Println("所有任务完成")
}
二、使用工作池(Worker Pool)模式
创建固定数量的 “工作 Goroutine”,通过一个 channel 传递任务,工作 Goroutine 从 channel 中获取任务并执行。这种模式下,Goroutine 数量固定(工作池大小),避免无限增长。
package main

import (
	"fmt"
	"sync"
	"time"
)

func main() {
	const (
		workerCount = 3    // 工作 Goroutine 数量(固定)
		totalTasks  = 10   // 总任务数
	)

	// 创建任务通道
	taskChan := make(chan int, totalTasks)
	var wg sync.WaitGroup

	// 启动固定数量的工作 Goroutine
	for i := 0; i < workerCount; i++ {
		wg.Add(1)
		go func(workerID int) {
			defer wg.Done()
			// 循环从任务通道取任务
			for taskID := range taskChan {
				fmt.Printf("工作者 %d 处理任务 %d\n", workerID, taskID)
				time.Sleep(1 * time.Second) // 模拟处理耗时
			}
		}(i)
	}

	// 向任务通道发送所有任务
	for i := 0; i < totalTasks; i++ {
		taskChan <- i
	}
	close(taskChan) // 关闭通道,通知工作者任务已全部发送

	wg.Wait() // 等待所有工作者完成
	fmt.Println("所有任务处理完毕")
}
三、使用第三方库(如 golang.org/x/sync/errgroup)
errgroup 库在 sync.WaitGroup 基础上增加了错误处理和上下文控制,可通过 SetLimit 方法限制并发 Goroutine 数量(Go 1.21+ 标准库 sync 包也引入了类似的 WaitGroupLimit
package main

import (
	"fmt"
	"time"

	"golang.org/x/sync/errgroup"
)

func main() {
	const maxConcurrent = 3 // 最大并发数
	g, _ := errgroup.WithContext(context.Background())
	g.SetLimit(maxConcurrent) // 设置并发限制

	totalTasks := 10
	for i := 0; i < totalTasks; i++ {
		taskID := i // 避免循环变量捕获问题
		g.Go(func() error {
			fmt.Printf("任务 %d 开始执行\n", taskID)
			time.Sleep(1 * time.Second)
			fmt.Printf("任务 %d 执行完毕\n", taskID)
			return nil
		})
	}

	// 等待所有任务完成
	if err := g.Wait(); err != nil {
		fmt.Printf("任务出错: %v\n", err)
	} else {
		fmt.Println("所有任务完成")
	}
}
四、协程复用(Goroutine Reuse)
是通过创建固定数量的 Goroutine 并重复使用它们处理多个任务,而非为每个任务创建新的 Goroutine,从而减少 Goroutine 创建销毁的开销(如内存分配、调度成本),尤其适合高并发、短任务场景。
package main

import (
	"fmt"
	"sync"
	"time"
)

// 任务结构体(可根据业务定义字段)
type Task struct {
	ID  int
	Data interface{}
}

// 工作池结构体
type WorkerPool struct {
	workerCount int       // 工作协程数量(复用的协程数)
	taskChan    chan Task // 任务队列
	wg          sync.WaitGroup
}

// 创建工作池
func NewWorkerPool(workerCount int, taskChanSize int) *WorkerPool {
	return &WorkerPool{
		workerCount: workerCount,
		taskChan:    make(chan Task, taskChanSize),
	}
}

// 启动工作池(创建并复用工作协程)
func (wp *WorkerPool) Start() {
	for i := 0; i < wp.workerCount; i++ {
		wp.wg.Add(1)
		go func(workerID int) {
			defer wp.wg.Done()
			// 循环从任务队列取任务(复用当前Goroutine)
			for task := range wp.taskChan {
				fmt.Printf("工作协程 %d 处理任务 %d,数据:%v\n", workerID, task.ID, task.Data)
				time.Sleep(500 * time.Millisecond) // 模拟任务处理耗时
			}
			fmt.Printf("工作协程 %d 退出\n", workerID)
		}(i)
	}
}

// 提交任务到工作池
func (wp *WorkerPool) Submit(task Task) {
	wp.taskChan <- task
}

// 关闭工作池(等待所有任务处理完毕)
func (wp *WorkerPool) Close() {
	close(wp.taskChan) // 关闭任务队列,通知工作协程退出
	wp.wg.Wait()       // 等待所有工作协程结束
}

func main() {
	// 创建工作池:5个复用的工作协程,任务队列容量为100
	pool := NewWorkerPool(5, 100)
	pool.Start() // 启动工作协程

	// 提交10个任务(复用已创建的5个工作协程)
	for i := 0; i < 10; i++ {
		pool.Submit(Task{
			ID:  i,
			Data: fmt.Sprintf("任务数据 %d", i),
		})
	}

	// 等待任务提交完成,关闭工作池
	time.Sleep(1 * time.Second)
	pool.Close()
	fmt.Println("所有任务处理完毕,工作池关闭")
}
23、什么是互斥锁(Mutex)?悲观锁还是乐观锁?
sync.Mutex(互斥锁)是一种用于保证共享资源在并发环境下安全访问的同步机制。它通过独占访问的方式,确保同一时间只有一个 Goroutine 能执行临界区代码(即被锁保护的代码段),从而避免多个 Goroutine 同时操作共享资源导致的数据竞争和不一致问题。
互斥锁是悲观锁
互斥锁(sync.Mutex)属于悲观锁,原因如下:
- 悲观锁的核心思想:假设并发访问共享资源时一定会发生冲突(即 “悲观” 地认为冲突是常态),因此在每次访问资源前,都会先加锁,强制其他访问者等待,直到当前操作完成并释放锁。
- Mutex 的行为符合悲观锁定义:
-
- 每次访问共享资源前,必须先通过
Lock()获取锁,无论是否真的会发生冲突。 - 即使实际冲突概率很低,也会严格限制并发访问,通过阻塞等待保证安全性。
- 每次访问共享资源前,必须先通过
与乐观锁的对比
乐观锁的思想与悲观锁相反:
- 假设并发访问时冲突很少发生,因此不主动加锁,而是在操作结束时检查是否有冲突(通常通过版本号或 CAS 操作实现)。
- 若没有冲突,则操作成功;若有冲突,则重试或报错。
24、Mutex的存在的两种模式?正常模式、饥饿模式 正常模式,唤醒最早的协程,最新的和最早的随即获取。如果等待超过1ms,进入饥饿模式,队列获取
正常模式
正常模式是 Mutex 的默认工作模式,也是大多数情况下的运行模式,其核心逻辑如下:
- 锁竞争机制:
当一个 Goroutine 释放锁时,会唤醒等待队列中最早的 Goroutine(队首元素)。但此时,新到达的 Goroutine 可以和被唤醒的 Goroutine 一起竞争锁(通过自旋或直接尝试获取)。 - 潜在问题:
在高竞争场景下,新 Goroutine 可能频繁插队,导致等待队列中的 Goroutine 长期获取不到锁,陷入 “饥饿” 状态(等待时间超过 1ms 时,会触发模式切换)。
饥饿模式(Starvation Mode)
当某个 Goroutine 等待锁的时间超过 1ms 时,Mutex 会从正常模式切换到饥饿模式,核心逻辑如下:
- 严格的 FIFO 机制:
锁的所有权直接传递给等待队列中最早的 Goroutine(队首),新到达的 Goroutine 不会参与竞争,而是直接加入等待队列尾部(不允许插队)。 - 模式切换回正常模式的条件:
-
- 持有锁的 Goroutine 是等待队列中的最后一个元素(队列已空)。
- 持有锁的 Goroutine 等待时间小于 1ms。
满足任一条件时,锁会从饥饿模式切换回正常模式,以恢复吞吐量。
模式切换的触发流程
- 正常模式 → 饥饿模式:
当一个 Goroutine 等待锁的时间超过 1ms,且当前处于正常模式时,会将锁标记为饥饿模式,并将自己移到等待队列头部。 - 饥饿模式 → 正常模式:
当持有锁的 Goroutine 释放锁时,若发现:
-
- 等待队列中只有自己(无其他等待者),或
- 自己的等待时间小于 1ms,
则将锁切换回正常模式。
Go语言互斥锁mutex底层是怎么实现的?
Go 语言的 sync.Mutex(互斥锁)是并发编程中保证临界区互斥访问的核心机制,其底层实现兼顾了性能与公平性,经历了多个版本的优化(当前主流版本为 Go 1.18+ 的饥饿模式实现)。
底层实现核心原理
sync.Mutex 的核心是一个 32 位整数状态(state) 和一个 等待队列(sema 信号量队列),状态字段通过位运算存储多种信息:
1. 状态位定义(state)
- 锁标志位(bit 0):
1表示锁被持有,0表示未持有。 - 唤醒标志位(bit 1):
1表示有 goroutine 被唤醒,用于饥饿模式下的优先级控制。 - 饥饿标志位(bit 2):
1表示当前处于饥饿模式,0表示正常模式。 - 等待计数(bits 3+):记录等待队列中 goroutine 的数量。
2. 两种工作模式
Mutex 通过模式切换适应不同竞争强度:
(1)正常模式(默认,低竞争场景)
- 特点:允许自旋(spin)尝试获取锁,减少上下文切换开销。
- 流程:
-
- 当 goroutine 请求锁时,若锁未被持有(
state为 0),直接通过 CAS 操作将state设为1(持有状态),成功获取锁。 - 若锁已被持有,尝试 自旋等待(短时间循环检查锁是否释放,最多自旋 4 次或直到 CPU 核心数不足),适合锁持有时间短的场景。
- 自旋失败后,goroutine 进入等待队列(通过
sema信号量阻塞),state等待计数 +1。 - 锁释放时,唤醒队列中的一个 goroutine(FIFO 顺序),被唤醒的 goroutine 与新请求锁的 goroutine 竞争(新请求可能通过自旋“插队”)。
- 当 goroutine 请求锁时,若锁未被持有(
(2)饥饿模式(高竞争场景)
- 触发条件:当一个 goroutine 等待锁的时间超过 1ms,或等待队列中超过 1 个 goroutine 时,切换为饥饿模式。
- 特点:禁止自旋,严格按 FIFO 顺序唤醒,避免“新 goroutine 持续插队导致老 goroutine 饥饿”。
- 流程:
-
- 锁释放时,直接将锁交给等待队列的第一个 goroutine(不允许新请求插队)。
- 被唤醒的 goroutine 获取锁后,若发现自己是队列中最后一个等待者,或持有锁时间较短,切换回正常模式。
3. 核心操作(Lock 与 Unlock)
Lock():
-
- 先尝试 CAS 获取锁(无竞争时直接成功)。
- 失败则进入自旋(正常模式下),自旋失败后加入等待队列并阻塞。
- 若符合饥饿模式条件,切换模式并按顺序等待。
Unlock():
-
- 释放锁(将
state锁标志位设为 0)。 - 若处于正常模式,唤醒队列中的一个 goroutine 竞争锁;若处于饥饿模式,直接将锁传递给队列第一个 goroutine。
- 释放锁(将
关键优化点
- 自旋限制:仅在锁持有者正在运行且未进入系统调用时自旋,避免无效消耗 CPU。
- 模式自适应:低竞争用正常模式(自旋提高效率),高竞争用饥饿模式(保证公平性)。
- 精简状态:通过位运算将多状态压缩到一个 32 位整数,减少内存访问开销。
总结
sync.Mutex 底层通过 状态位(state) 跟踪锁状态,结合 自旋 和 等待队列 处理竞争,并通过 正常/饥饿模式切换 平衡性能与公平性。这种设计让 Mutex 在低竞争时接近无锁性能,在高竞争时避免饥饿,是 Go 语言并发安全的核心保障之一。
sync.WaitGroup底层实现?
Go 语言中的 sync.WaitGroup 用于等待一组 goroutine 完成,其核心功能是阻塞主 goroutine 直到所有注册的子 goroutine 都执行完毕。底层通过计数器 + 信号量实现,逻辑简洁但设计精巧。
核心原理
WaitGroup 内部维护一个计数器(count),通过三个核心方法协同工作:
Add(n int):增加计数器的值(n通常为正,代表要等待的 goroutine 数量)。Done():计数器减 1(等价于Add(-1),每个子 goroutine 结束时调用)。Wait():阻塞当前 goroutine,直到计数器变为 0。
底层实现细节
WaitGroup 的结构体(简化版)包含三个关键字段:
type WaitGroup struct {
    noCopy noCopy       // 避免值拷贝(通过编译期检查)
    state1 [3]uint32    // 存储计数器和信号量状态
}
其中 state1 通过位运算划分出两个核心信息:
- 计数器(count):表示未完成的 goroutine 数量(
state1[0])。 - 等待者数量(waiters):表示调用
Wait()阻塞的 goroutine 数量(state1[1])。 - 信号量(semaphore):基于操作系统信号量实现,用于阻塞/唤醒等待的 goroutine(
state1[2]相关)。
工作流程
- 初始化与添加任务
主 goroutine 调用wg.Add(n),将计数器增加n(如启动 3 个子 goroutine 则Add(3))。 - 子 goroutine 执行与结束
每个子 goroutine 执行完毕前调用wg.Done(),将计数器减 1。 - 等待所有任务完成
主 goroutine 调用wg.Wait()后:
-
- 若计数器已为 0,直接返回(无需等待)。
- 若计数器 > 0,将自己加入等待队列(等待者数量 +1),并通过信号量阻塞。
- 唤醒等待者
当最后一个子 goroutine 调用Done()使计数器变为 0 时:
-
- 若有等待者(
waiters > 0),则释放信号量,唤醒所有阻塞的等待者(通常是主 goroutine)。
- 若有等待者(
关键特性
- 不可复制:
noCopy字段通过编译期检查阻止WaitGroup被拷贝(避免计数器状态混乱)。 - 原子操作:计数器的增减和状态检查均通过原子操作(
atomic包)实现,保证并发安全。 - 一次性使用:
WaitGroup计数器归 0 后,若再次调用Add()可能导致不可预期的行为(建议用完即丢弃,不重复使用)。
示例代码
func main() {
    var wg sync.WaitGroup
    wg.Add(2) // 注册 2 个待等待的 goroutine

    go func() {
        defer wg.Done() // 完成后计数器减 1
        fmt.Println("子任务 1 完成")
    }()

    go func() {
        defer wg.Done()
        fmt.Println("子任务 2 完成")
    }()

    wg.Wait() // 阻塞,直到两个子任务都调用 Done()
    fmt.Println("所有任务完成")
}
总结
sync.WaitGroup 通过原子计数器跟踪子 goroutine 状态,结合信号量实现等待者的阻塞与唤醒,核心是“计数器归 0 时唤醒所有等待者”。它是 Go 中协调多 goroutine 同步的轻量且高效的工具,适合“等待一组任务全部完成”的场景。
25、什么是自旋锁?怎么实现的?主要使用场景? 一般阻塞会协程暂时睡眠,自旋锁则一直循环获取锁,占用CPU和资源,适用与短时间的锁。在mutex中也使用了,先自旋数次,再睡眠。
自旋锁(Spin Lock) 是一种特殊的锁机制,当线程(或 Goroutine)尝试获取锁而未能成功时,不会立即阻塞休眠,而是循环重试(自旋) 直到获取到锁为止。这种 “忙等” 特性使其适用于锁持有时间极短的场景。
与互斥锁(如 sync.Mutex)的区别:
- 互斥锁获取失败时,线程会进入阻塞状态(放弃 CPU,由操作系统调度唤醒)。
- 自旋锁获取失败时,线程会持续占用 CPU 并循环检查锁状态(忙等)。
自旋锁的主要使用场景
自旋锁适用于锁持有时间极短(纳秒或微秒级)且并发冲突不频繁的场景,典型包括:
- 内核态编程:
操作系统内核中,当临界区操作非常短时(如修改内核数据结构),自旋锁可避免线程切换的开销(内核态线程切换成本高)。 - 多处理器系统的短临界区:
在多 CPU 环境下,若一个 CPU 上的线程持有锁,另一个 CPU 上的线程自旋等待可能比阻塞更高效(无需上下文切换)。 - 高性能并发数据结构:
如无锁队列、计数器等,操作时间极短,自旋等待的成本低于阻塞唤醒。 - Go 语言
sync.Mutex内部优化:
Go 的互斥锁在正常模式下,会先自旋几次尝试获取锁,失败后才进入阻塞队列,平衡性能和公平性。
26、Go语言中的原子操作实现原理?和锁的区别?
原子操作(sync/atomic 包)是一种无锁的同步机制,通过 CPU 提供的原子指令指令直接直接操作内存,确保操作的不可分割性(即 “原子性”),从而无需通过锁(如 Mutex.Mutex)来保护共享资源。
常见命令:CPU 提供了专门的原子指令,例如:
- CAS(Compare-And-Swap):比较内存中的值与预期值,若相等则替换为新值(如
LOCK CMPXCHG指令)。 - 原子增减:如
LOCK XADD(原子加法)、LOCK XDEC(原子减法)。 - 原子加载 / 存储:如
MOV指令配合内存屏障,确保读写的原子性。 atomic.AddInt64:原子累加 int64 类型变量。atomic.CompareAndSwapInt32:CAS 操作(比较并交换)。atomic.LoadUint64:原子读取 uint64 类型变量。
区别
- 原子操作:基于 CPU 硬件指令,实现单个内存操作的原子性,效率极高但功能有限,适用于简单变量的并发控制。
- 锁:基于操作系统同步机制,可保护复杂临界区,功能灵活但有性能开销,适用于多步操作或复杂数据结构。
27、Go如何进行错误处理?defer中的recover 捕获、 error包装
Go 的错误处理核心是:
- 用
error接口显式传递错误,通过nil判断操作状态; - 支持自定义错误类型和错误包装,丰富错误上下文;
- 配合
panic/recover处理致命异常,但避免滥用。
Go的sync.map的底层实现
sync.Map 是 Go 语言标准库中为并发场景设计的线程安全映射表,专为 读多写少 场景优化,底层通过 两个普通 map + 原子操作 实现,避免了传统 map + Mutex 方案的全局锁开销。
核心设计思路
sync.Map 内部维护两个 map:
- read map:一个只读的 map(通过原子指针访问),存储大部分稳定数据,支持无锁读取。
- dirty map:一个可写的 map,存储新写入或修改的数据,需要加锁访问。
通过分离读写路径,sync.Map 在读取频繁的场景下,大部分操作无需加锁,显著提升性能。
底层结构(简化版)
type Map struct {
    mu Mutex          // 保护 dirty map 的互斥锁
    read atomic.Value // 存储 readOnly 结构体(包含只读 map)
    dirty map[interface{}]*entry // 可写的 dirty map
    misses int        // 记录 read map 未命中后查询 dirty map 的次数
}

// readOnly 是 read 字段的实际类型,包含一个只读 map 和一个修改标记
type readOnly struct {
    m  map[interface{}]*entry // 只读 map
    amended bool              // 标记 dirty map 有 read map 没有的键(true 表示有差异)
}

// entry 存储值的指针,支持原子更新
type entry struct {
    p unsafe.Pointer // 指向实际值(nil 表示已删除,expunged 表示从 dirty 中删除)
}
核心操作原理
1. 读取操作(Load)
读取是sync.Map 最优化的操作,流程如下:
- 先从
read map中读取(无锁,通过原子操作获取readOnly结构体)。 - 若找到键且值未被删除,直接返回结果(无需加锁,性能极高)。
- 若
read map中未找到,且amended为true(表示 dirty map 有新数据),则加锁查询dirty map:
-
- 若在
dirty map中找到,misses计数器 +1。 - 当
misses等于dirty map长度时,将dirty map提升为read map(减少后续查询开销),并重置dirty map和misses。
- 若在
2. 写入操作(Store)
- 若
read map中已存在该键,且值未被删除,直接通过原子操作更新值(无需加锁)。 - 若
read map中不存在或值已被删除:
-
- 加锁检查
dirty map:
- 加锁检查
-
-
- 若
dirty map存在该键,直接更新。 - 若
dirty map不存在,先将read map中所有未删除的键复制到dirty map(仅第一次需要),再写入新键值对,并标记amended = true(表示 read 和 dirty 有差异)。
- 若
-
3. 删除操作(Delete)
- 先尝试从
read map中找到该键,若存在且未被删除,通过原子操作将其标记为删除(设置p = nil)。 - 若
read map中无该键,且dirty map存在,则加锁从dirty map中删除,并标记为expunged(表示彻底删除,区别于nil)。
核心优势与适用场景
- 优势:读多写少场景下性能远超
map + Mutex,因为大部分读操作无需加锁。 - 劣势:写操作(尤其是频繁写入新键)会触发
dirty map复制,开销较大。 - 适用场景:缓存(如配置项、静态数据)、日志收集等读频繁、写较少的并发场景。
总结
sync.Map 通过 分离读写 map 和 原子操作 减少锁竞争,核心是让读操作尽量在无锁的 read map 中完成,写操作通过 dirty map 加锁处理,并在适当时候将 dirty map 提升为 read map。这种设计使其在 读多写少 场景下性能优异,但不适合写操作密集的场景。
interface的底层实现
Go 语言中的 interface(接口)是实现多态的核心机制,其底层通过 两个指针 实现,分别存储 类型信息 和 数据信息,结构轻量且灵活。
底层结构
interface 在 runtime 中表现为 iface 或 eface 两种结构体,取决于是否包含方法:
- 非空接口(iface)
包含方法的接口(如io.Reader),结构如下:
type iface struct {
    tab  *itab      // 类型信息表(包含类型和方法集)
    data unsafe.Pointer // 指向实际数据的指针
}

// itab 存储接口与具体类型的匹配信息
type itab struct {
    inter *interfacetype // 接口自身的类型信息(如方法集)
    _type *_type         // 具体类型的元信息(如 int、struct 等)
    hash  uint32         // 类型哈希(用于快速比较)
    _     [4]byte
    fun   [1]uintptr     // 方法集(动态分派的函数指针列表)
}
- 空接口(eface)
不包含任何方法的接口(即interface{}),结构更简单:
type eface struct {
    _type *_type         // 具体类型的元信息
    data  unsafe.Pointer // 指向实际数据的指针
}
其中,_type 是所有类型的公共元信息结构体,包含类型名称、大小、对齐方式、哈希函数等基础信息。
核心原理
- 接口赋值过程
当一个具体类型的值赋值给接口时,Go 会:
例:
var x interface{} = 42      // eface{_type: int类型, data: 指向42的指针}
var r io.Reader = os.Stdin  // iface{tab: 匹配信息, data: 指向os.Stdin的指针}
-
- 提取该值的类型信息(
_type)。 - 若为非空接口,还会生成
itab(验证类型是否实现接口方法集,并缓存方法指针)。 - 复制值的地址到
data指针(对于值类型,会先分配内存并拷贝值;对于引用类型,直接存储原指针)。
- 提取该值的类型信息(
- 类型断言(type assertion)
判断接口中存储的具体类型时,底层通过比较_type或itab._type实现:
-
- 若类型匹配,返回
data指向的值。 - 若不匹配,返回
false(或触发 panic,当使用x.(T)形式时)。
- 若类型匹配,返回
- 方法调用
非空接口调用方法时,通过itab.fun中的函数指针直接调用(动态分派),无需再进行类型检查,效率接近直接调用。
关键特性
- 值拷贝语义:接口存储的是值的副本(值类型)或引用(引用类型),修改接口内部数据不会影响原变量。
- 延迟绑定:接口与具体类型的匹配在运行时完成(编译期仅做静态检查)。
- 内存优化:对于小值类型(如
int、bool),data指针可能直接存储值(通过指针对齐优化,避免额外内存分配)。
总结
interface 底层通过 类型指针(_type/itab) 和 数据指针(data) 实现,空接口(interface{})仅需存储类型和数据,非空接口还需维护方法集匹配信息。这种设计兼顾了灵活性和性能,是 Go 多态特性的基础,也是类型系统的核心组成部分。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 10
 0
- 0


 已为社区贡献1条内容

所有评论(0)