【四】Linux进程概念
1冯诺依曼体系结构
我们常⻅的计算机,如笔记本。我们不常⻅的计算机,如服务器,⼤部分都遵守冯诺依曼体系。
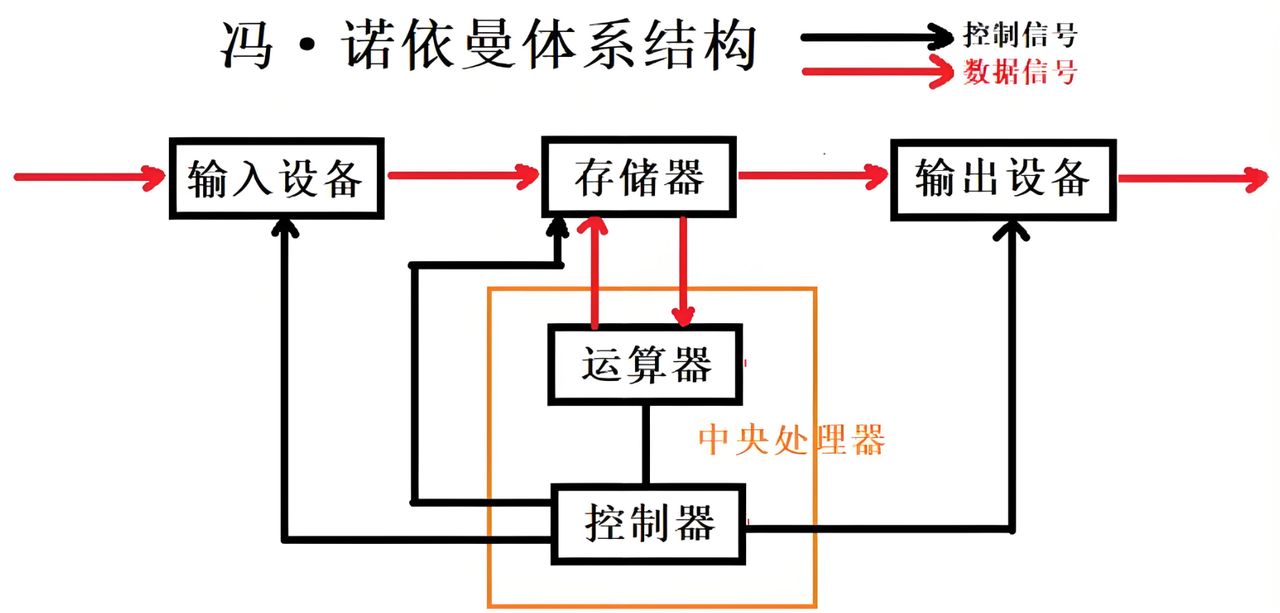
关于冯诺依曼,必须强调⼏点:
• 这⾥的存储器指的是内存
• 不考虑缓存情况,这⾥的CPU能且只能对内存进⾏读写,不能访问外设(输⼊或输出设备)(数据层⾯)
• 外设(输⼊或输出设备)要输⼊或者输出数据,也只能写⼊内存或者从内存中读取。
• ⼀句话,所有设备都只能直接和内存打交道。
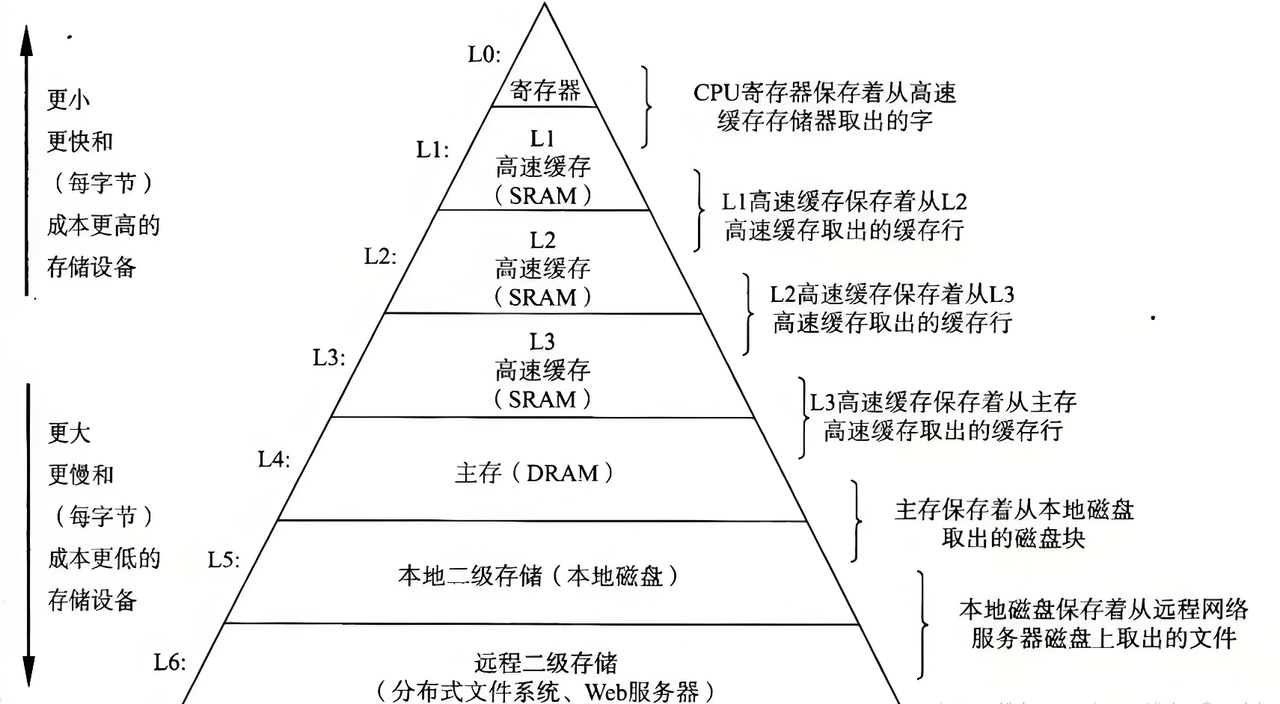
为什么要有缓存?
计算机最大的性能瓶颈本质:不是 CPU 算得不够快,而是低速设备的数据搬运速度跟不上 CPU 的运算速度。
为缓解这种速度矛盾,现代计算机在 CPU 与内存之间增设多级高速缓存,构建起一套存储金字塔:越靠近 CPU 的存储介质,速度越快、容量越小、单位成本越高;越底层的存储,速度越慢、容量越大、价格更低,以此兼顾性能与硬件成本。
2.操作系统
了解了硬件的运作规律之后,新的问题出现了:谁负责把程序从硬盘搬到内存?谁来协调多个程序同时使用 CPU?这就引出了操作系统。
2.1 操作系统的定义与组成
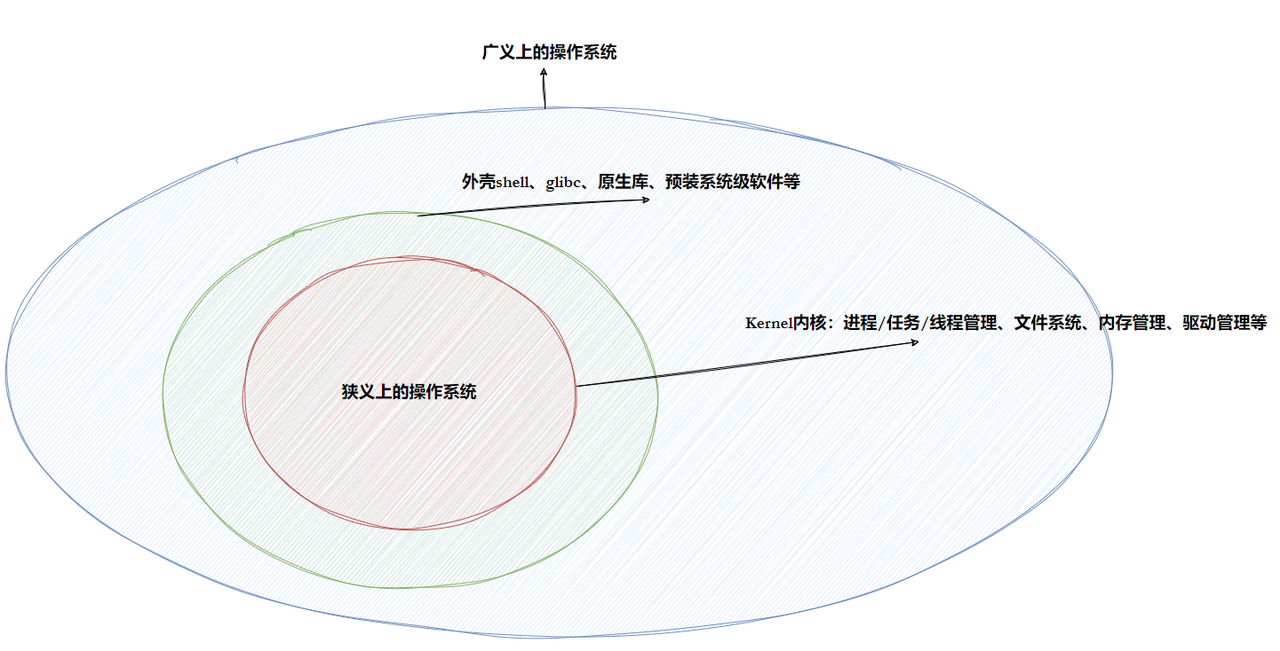
任何一台完整的 计算机系统里,都包含一套最基本的程序集合,它叫做操作系统(Operating System,OS)。它可以粗略分成两大块:
• 内核(进程管理,内存管理,⽂件管理,驱动管理)
• 其他程序(例如函数库,shell程序等等)
2.2设计OS的⽬的?
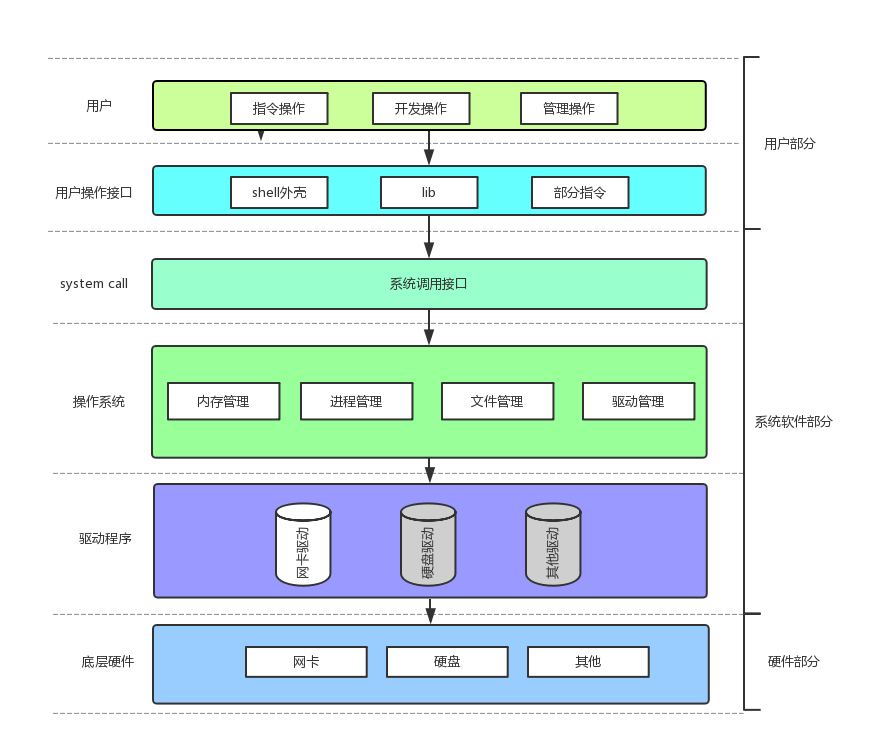
• 对下,与硬件交互,管理所有的软硬件资源
• 对上,为⽤⼾程序(应⽤程序)提供⼀个良好的执⾏环境
2.3核⼼功能?
• 在整个计算机软硬件架构中,操作系统的定位是:⼀款纯正的“搞管理”的软件
2.4总结
计算机管理硬件
- 描述起来,⽤struct结构体
- 组织起来,⽤链表或其他⾼效的数据结构
先描述再组织
2.5系统调⽤和库函数概念?
• 在开发⻆度,操作系统对外会表现为⼀个整体,但是会暴露⾃⼰的部分接⼝,供上层开发使⽤,这部分由操作系统提供的接⼝,叫做系统调⽤。
• 系统调⽤在使⽤上,功能⽐较基础,对⽤⼾的要求相对也⽐较⾼,所以,有⼼的开发者可以对部分系统调⽤进⾏适度封装,从⽽形成库,有了库,就很有利于更上层⽤⼾或者开发者进⾏⼆次开发。
3进程(非常重要)
3.1基本概念与基本操作
• 课本概念:程序的⼀个执⾏实例,正在执⾏的程序等
• 内核观点:担当分配系统资源(CPU时间,内存)的实体。
• 当前:进程 = 内核数据结构(task_struct)+⾃⼰的程序代码和数据
3.1.1描述进程-PCB
基本概念
• 进程信息被放在⼀个叫做进程控制块的数据结构中,可以理解为进程属性的集合。
• 课本上称之为PCB(process control block), Linux 操作系统下的 PCB 是: task_struct ,task_struct-PCB的⼀种
• 在 Linux 中描述进程的结构体叫做 task_struct 。
• task_struct 是 Linux 内核的⼀种数据结构类型,它会被装载到RAM(内存)⾥并且包含着进程的信息。
3.1.2task_struct
内容分类
• 标⽰符:描述本进程的唯⼀标⽰符,⽤来区别其他进程。
• 状态:任务状态,退出代码,退出信号等。
• 优先级:相对于其他进程的优先级。
• 程序计数器:程序中即将被执⾏的下⼀条指令的地址。
• 内存指针:包括程序代码和进程相关数据的指针,还有和其他进程共享的内存块的指针
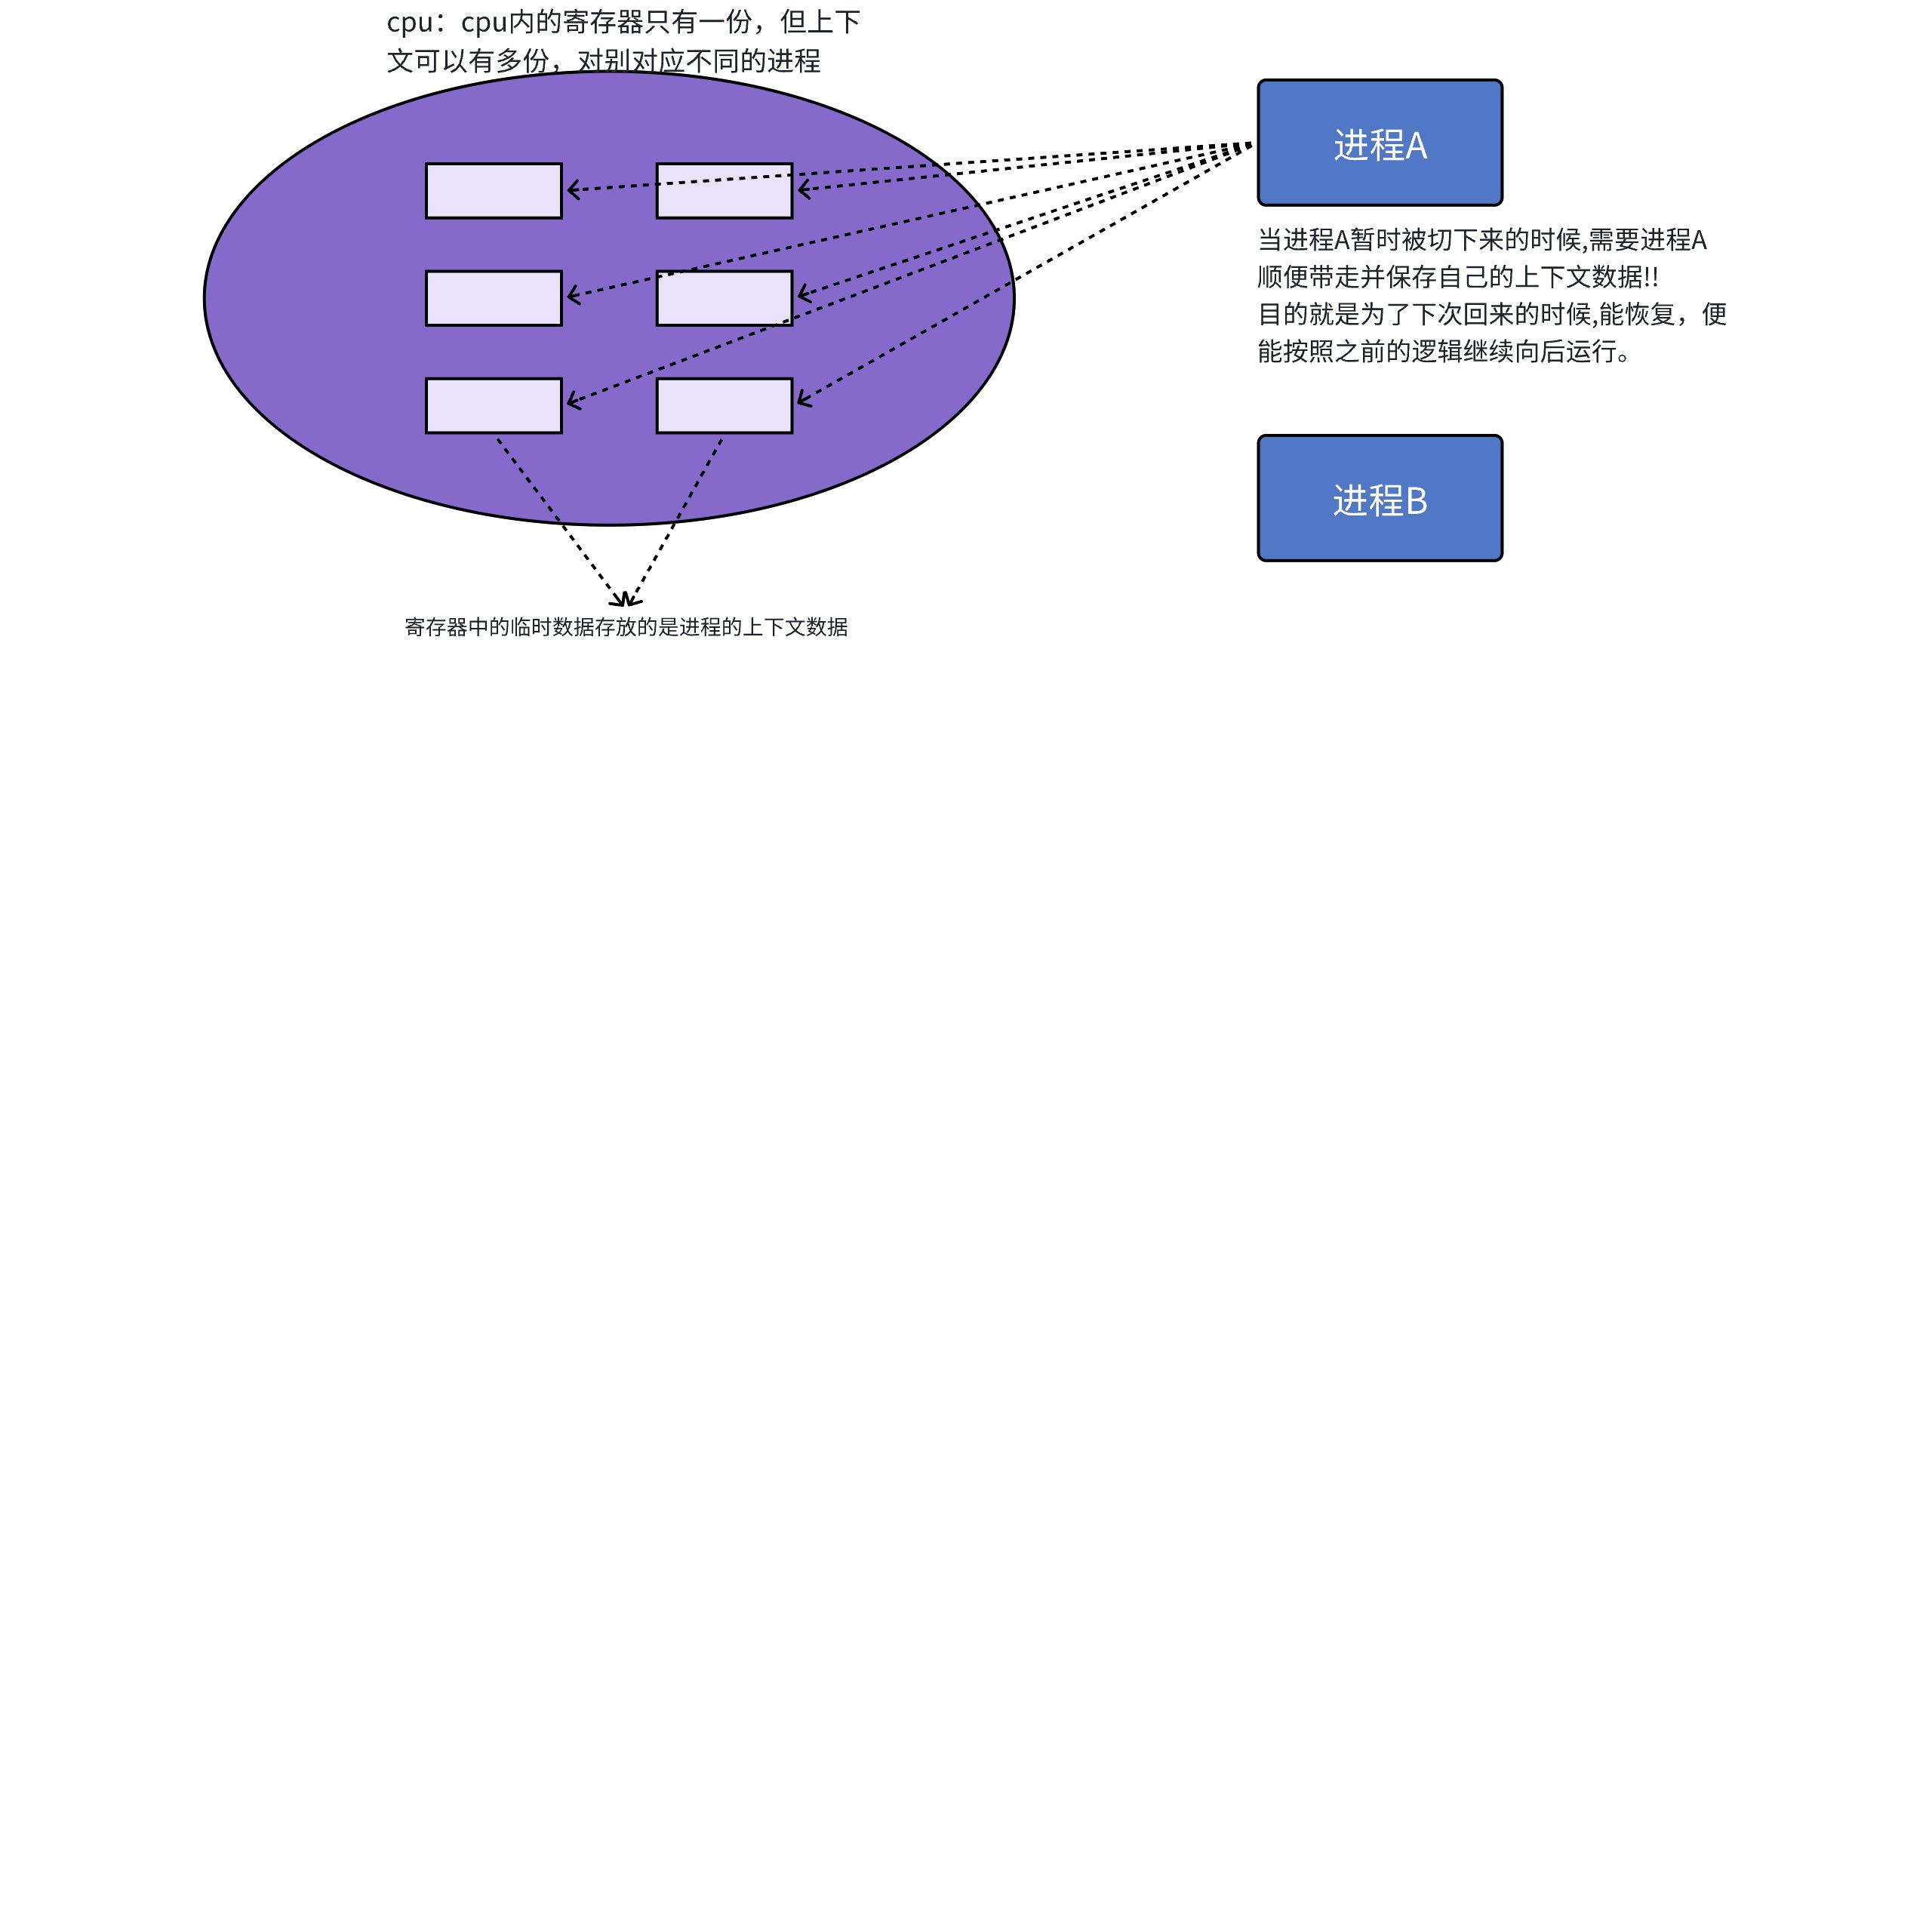
• 上下⽂数据:进程执⾏时处理器的寄存器中的数据[休学例⼦,要加图CPU,寄存器]。
• I/O状态信息:包括显⽰的I/O请求,分配给进程的I/O设备和被进程使⽤的⽂件列表。
• 记账信息:可能包括处理器时间总和,使⽤的时钟数总和,时间限制,记账号等。
• 其他信息
• 具体详细信息后续会介绍
组织进程
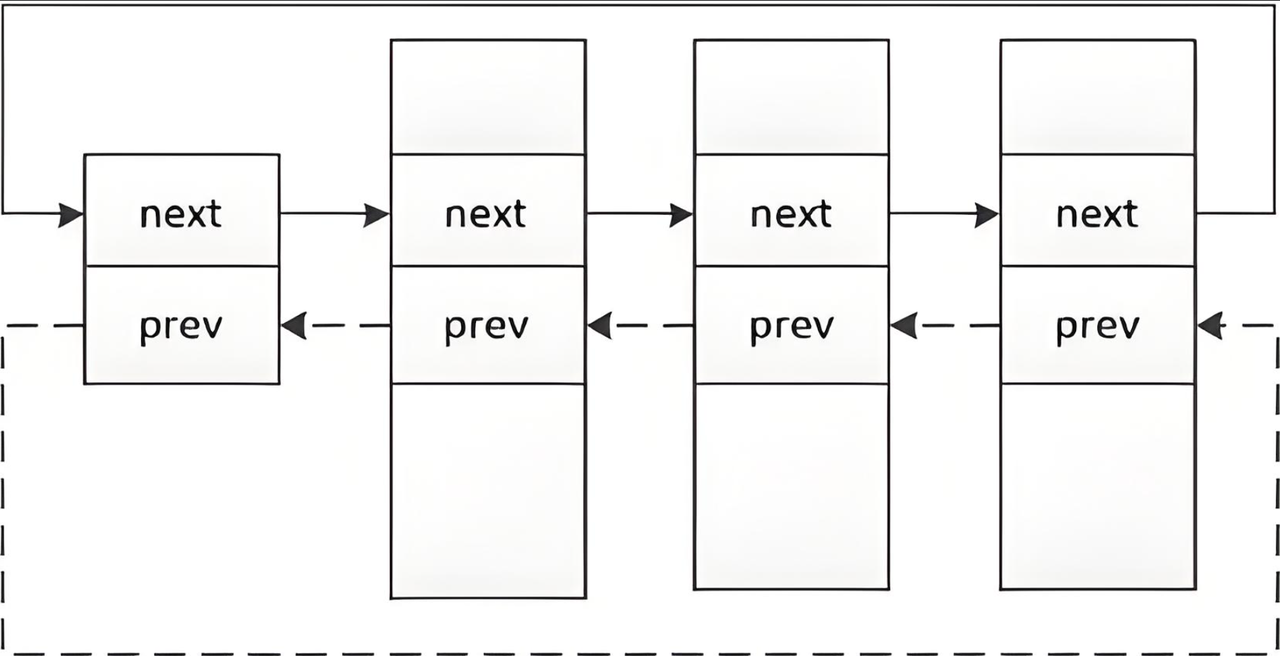
可以在内核源代码⾥找到它。所有运⾏在系统⾥的进程都以 task_struct 双链表的形式存在内核⾥。
3.1.3查看进程
- 进程的信息可以通过 /proc 系统⽂件夹查看
如:要获取PID为1的进程信息,你需要查看 /proc/1 这个⽂件夹。
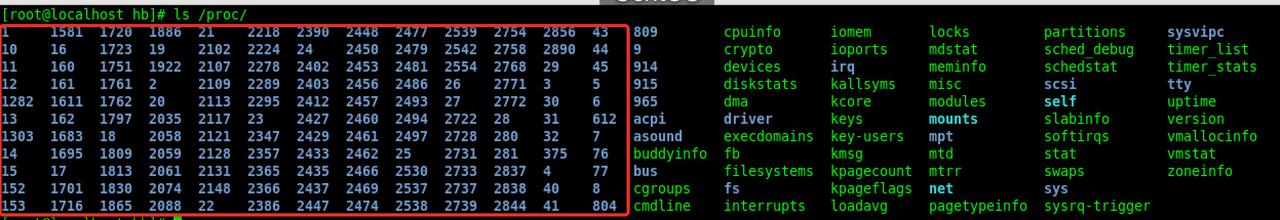
- ⼤多数进程信息同样可以使⽤top和ps这些⽤⼾级⼯具来获取

3.1.4过系统调⽤获取进程标⽰符
• 进程id(PID)
• ⽗进程id(PPID)
#include <stdio.h>
#include <sys/types.h>
#include <unistd.h>
int main()
{
printf("pid: %d\n", getpid());
printf("ppid: %d\n", getppid());
return 0;
}
3.1.5通过系统调⽤创建进程-fork初识
• 运⾏ man fork 认识fork
• fork有两个返回值
• ⽗⼦进程代码共享,数据各⾃开辟空间,私有⼀份(采⽤写时拷⻉)
#include <stdio.h>
#include <sys/types.h>
#include <unistd.h>
int main()
{
int ret = fork();
if(ret < 0){
perror("fork");
return 1;
}
else if(ret == 0){ //child
printf("I am child : %d!, ret: %d\n", getpid(), ret);
}else{ //father
printf("I am father : %d!, ret: %d\n", getpid(), ret);
}
sleep(1);
return 0;
}
fork之后通常要⽤ if 进⾏分流
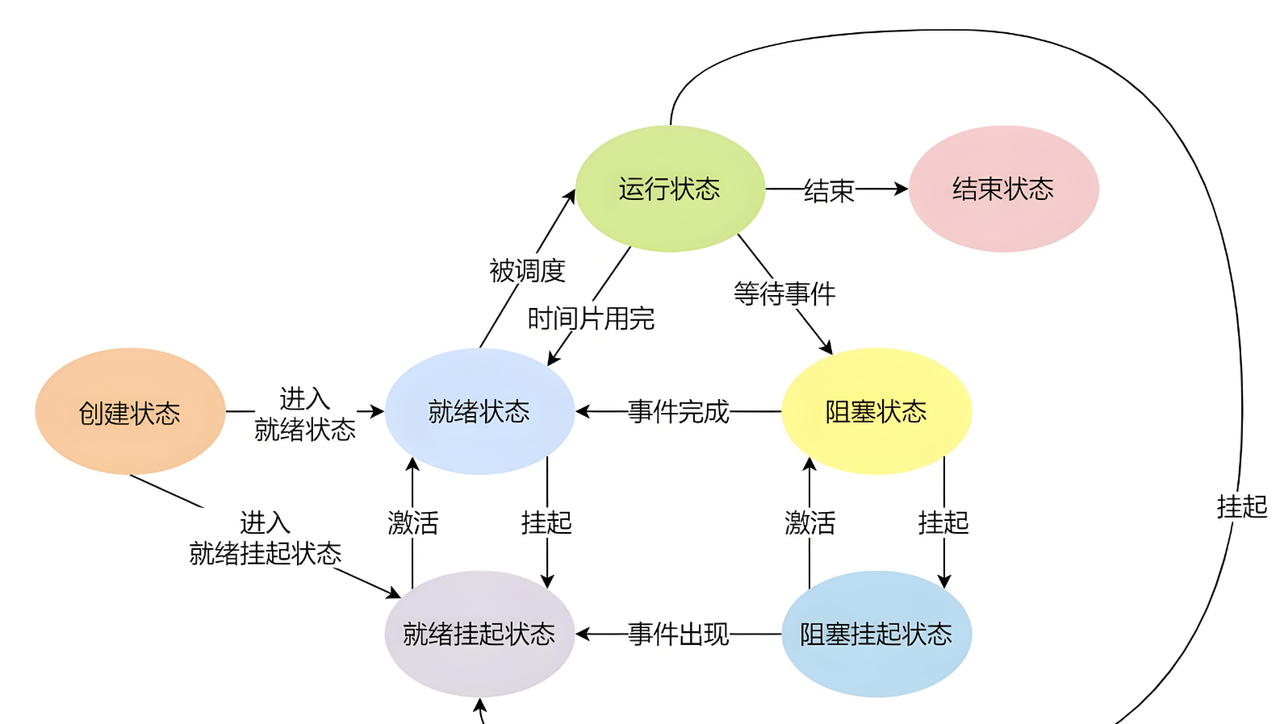
进程状态(运行,阻塞,挂起)
3.2.1Linux内核源代码怎么说?
• 为了弄明⽩正在运⾏的进程是什么意思,我们需要知道进程的不同状态。⼀个进程可以有⼏个状态(在Linux内核⾥,进程有时候也叫做任务)。
下⾯的状态在kernel源代码⾥定义:
/*
*The task state array is a strange "bitmap" of
*reasons to sleep. Thus "running" is zero, and
*you can test for combinations of others with
*simple bit tests.
*/
static const char *const task_state_array[] = {
"R (running)", /*0 */
"S (sleeping)", /*1 */
"D (disk sleep)", /*2 */
"T (stopped)", /*4 */
"t (tracing stop)", /*8 */
"X (dead)", /*16 */
"Z (zombie)", /*32 */
};
• R运⾏状态(running):并不意味着进程⼀定在运⾏中,它表明进程要么是在运⾏中要么在运⾏队列⾥。
• S睡眠状态(sleeping):意味着进程在等待事件完成(这⾥的睡眠有时候也叫做可中断睡眠(interruptible sleep))。
• D磁盘休眠状态(Disk sleep)有时候也叫不可中断睡眠状(uninterruptible sleep),在这个状态的进程通常会等待IO的结束。
• T停⽌状态(stopped):可以通过发送SIGSTOP?信号给进程来停⽌(T)进程。这个被暂停的进程可以通过发送SIGCONT信号让进程继续运⾏。
• X死亡状态(dead):这个状态只是⼀个返回状态,你不会在任务列表⾥看到这个状态。
3.2.2进程状态查看
ps auxj 命令
• a:显⽰⼀个终端所有的进程,包括其他⽤⼾的进程。
• x:显⽰没有控制终端的进程,例如后台运⾏的守护进程。
• j:显⽰进程归属的进程组ID、会话ID、⽗进程ID,以及与作业控制相关的信息
• u:以⽤⼾为中⼼的格式显⽰进程信息,提供进程的详细信息,如⽤⼾、CPU和内存使⽤情况等
3.2.3Z(zombie)-僵⼫进程
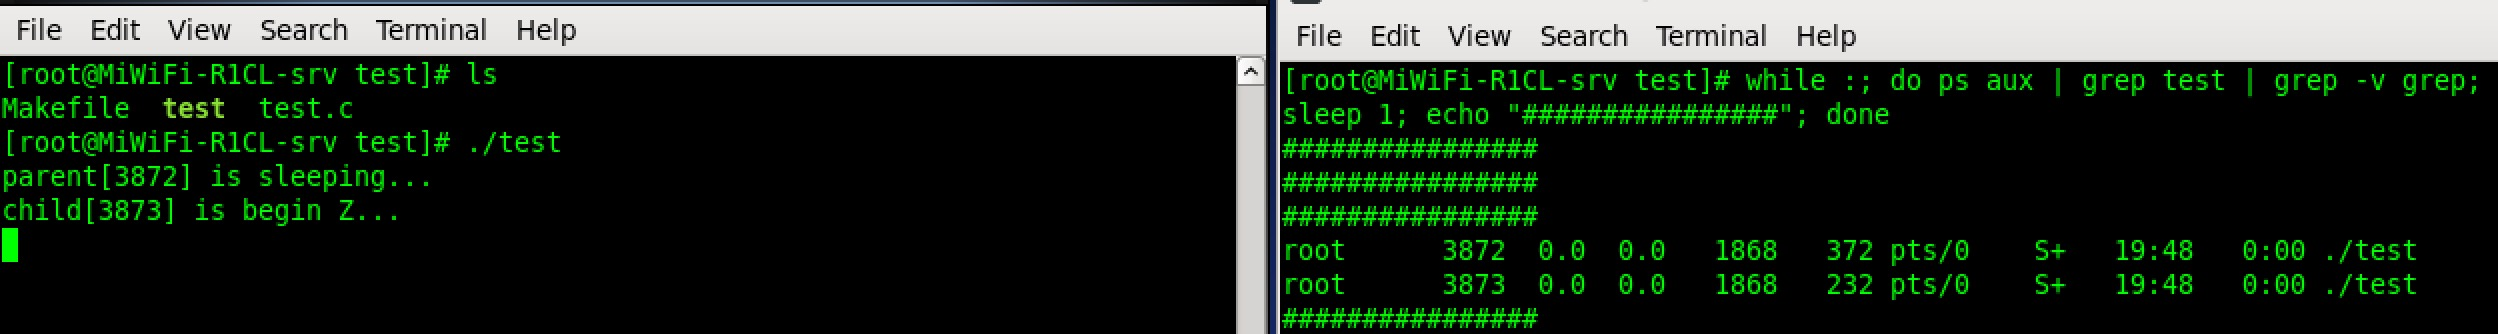
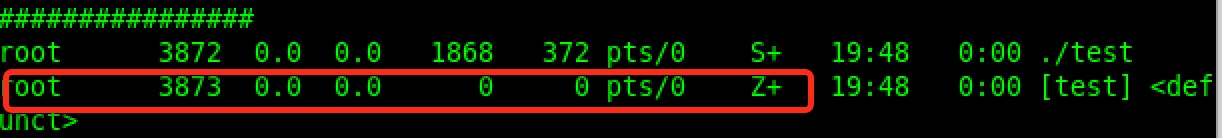
• 僵死状态(Zombies)是⼀个⽐较特殊的状态。当进程退出并且⽗进程(使⽤wait()系统调⽤,后⾯讲)没有读取到⼦进程退出的返回代码时就会产⽣僵死(⼫)进程
• 僵死进程会以终⽌状态保持在进程表中,并且会⼀直在等待⽗进程读取退出状态代码。
• 所以,只要⼦进程退出,⽗进程还在运⾏,但⽗进程没有读取⼦进程状态,⼦进程进⼊Z状态
#include <stdio.h>
#include <stdlib.h>
int main()
{
pid_t id = fork();
if(id < 0){
perror("fork");
return 1;
}
else if(id > 0){ //parent
printf("parent[%d] is sleeping...\n", getpid());
sleep(30);
}else{
printf("child[%d] is begin Z...\n", getpid());
 sleep(5);
exit(EXIT_SUCCESS);
}
return 0;
}
3.2.4僵⼫进程危害
• 进程的退出状态必须被维持下去,因为他要告诉关⼼它的进程(⽗进程),你交给我的任务,我办的怎么样了。可⽗进程如果⼀直不读取,那⼦进程就⼀直处于Z状态?是的!
• 维护退出状态本⾝就是要⽤数据维护,也属于进程基本信息,所以保存在task_struct(PCB)中,换句话说,Z状态⼀直不退出,PCB⼀直都要维护?是的!
• 那⼀个⽗进程创建了很多⼦进程,就是不回收,是不是就会造成内存资源的浪费?是的!因为数据结构对象本⾝就要占⽤内存,想想C中定义⼀个结构体变量(对象),是要在内存的某个位置进⾏开辟空间!
• 内存泄漏?是的!
3.2.5孤⼉进程
• ⽗进程如果提前退出,那么⼦进程后退出,进⼊Z之后,那该如何处理呢
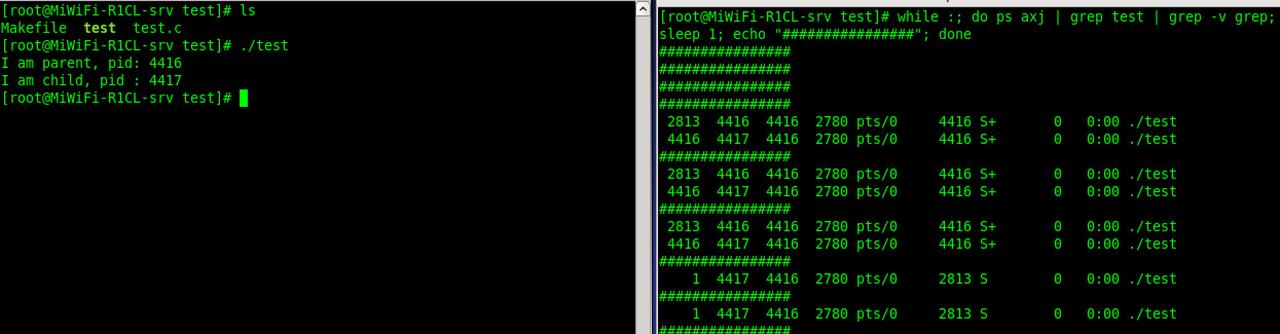
• ⽗进程先退出,⼦进程就称之为“孤⼉进程”
• 孤⼉进程被1号init/systemd进程领养,当然要有init/systemd进程回收喽。
#include <stdio.h>
#include <unistd.h>
#include <stdlib.h>
int main()
{
pid_t id = fork();
if(id < 0){
perror("fork");
return 1;
}
else if(id == 0){ //child
printf("I am child, pid : %d\n", getpid());
sleep(10);
}else{ //parent
printf("I am parent, pid: %d\n", getpid());
sleep(3);
exit(0);
}
return 0;
}
3.3进程优先级
3.3.1基本概念
• cpu资源分配的先后顺序,就是指进程的优先权(priority)。
• 优先权⾼的进程有优先执⾏权利。配置进程优先权对多任务环境的linux很有⽤,可以改善系统性能。
• 还可以把进程运⾏到指定的CPU上,这样⼀来,把不重要的进程安排到某个CPU,可以⼤⼤改善系统整体性能。
3.3.2查看系统进程
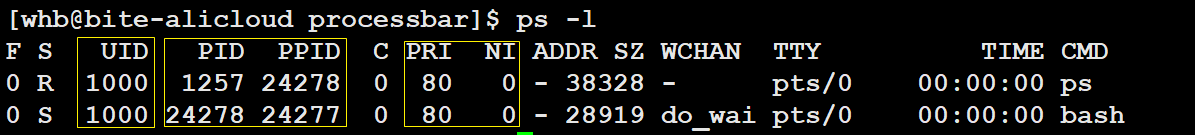
在linux或者unix系统中,⽤ps‒l命令则会类似输出以下⼏个内容:
我们很容易注意到其中的⼏个重要信息,有下:
• UID:代表执⾏者的⾝份
• PID:代表这个进程的代号
• PPID:代表这个进程是由哪个进程发展衍⽣⽽来的,亦即⽗进程的代号
• PRI:代表这个进程可被执⾏的优先级,其值越⼩越早被执⾏
• NI:代表这个进程的nice值
3.3.3PRI and NI
• PRI也还是⽐较好理解的,即进程的优先级,或者通俗点说就是程序被CPU执⾏的先后顺序,此值越⼩进程的优先级别越⾼
• 那NI呢?就是我们所要说的nice值了,其表⽰进程可被执⾏的优先级的修正数值
• PRI值越⼩越快被执⾏,那么加⼊nice值后,将会使得PRI变为:PRI(new)=PRI(old)+nice
• 这样,当nice值为负值的时候,那么该程序将会优先级值将变⼩,即其优先级会变⾼,则其越快被执⾏
• 所以,调整进程优先级,在Linux下,就是调整进程nice值
• nice其取值范围是-20⾄19,⼀共40个级别。
3.3.4查看进程优先级的命令
⽤top命令更改已存在进程的nice:
• top
• 进⼊top后按“r”‒>输⼊进程PID‒>输⼊nice值
注意:
• 其他调整优先级的命令:nice,renice
• 系统函数:
#include <sys/time.h>
#include <sys/resource.h>
int getpriority(int which, int who);
int setpriority(int which, int who, int prio);
3.3.5补充概念-竞争、独⽴、并⾏、并发
• 竞争性:系统进程数⽬众多,⽽CPU资源只有少量,甚⾄1个,所以进程之间是具有竞争属性的。为了⾼效完成任务,更合理竞争相关资源,便具有了优先级
• 独⽴性:多进程运⾏,需要独享各种资源,多进程运⾏期间互不⼲扰
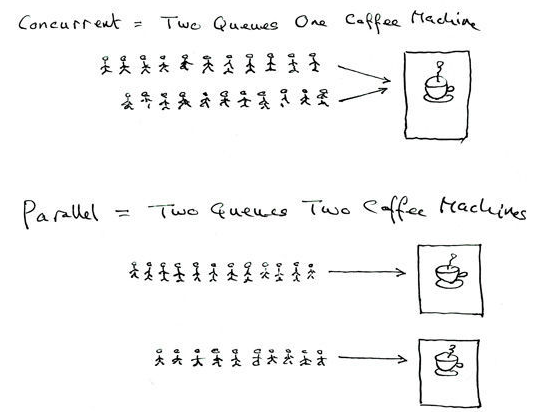
• 并⾏:多个进程在多个CPU下分别,同时进⾏运⾏,这称之为并⾏
• 并发:多个进程在⼀个CPU下采⽤进程切换的⽅式,在⼀段时间之内,让多个进程都得以推进,称之为并发
3.4进程切换(时间切片)
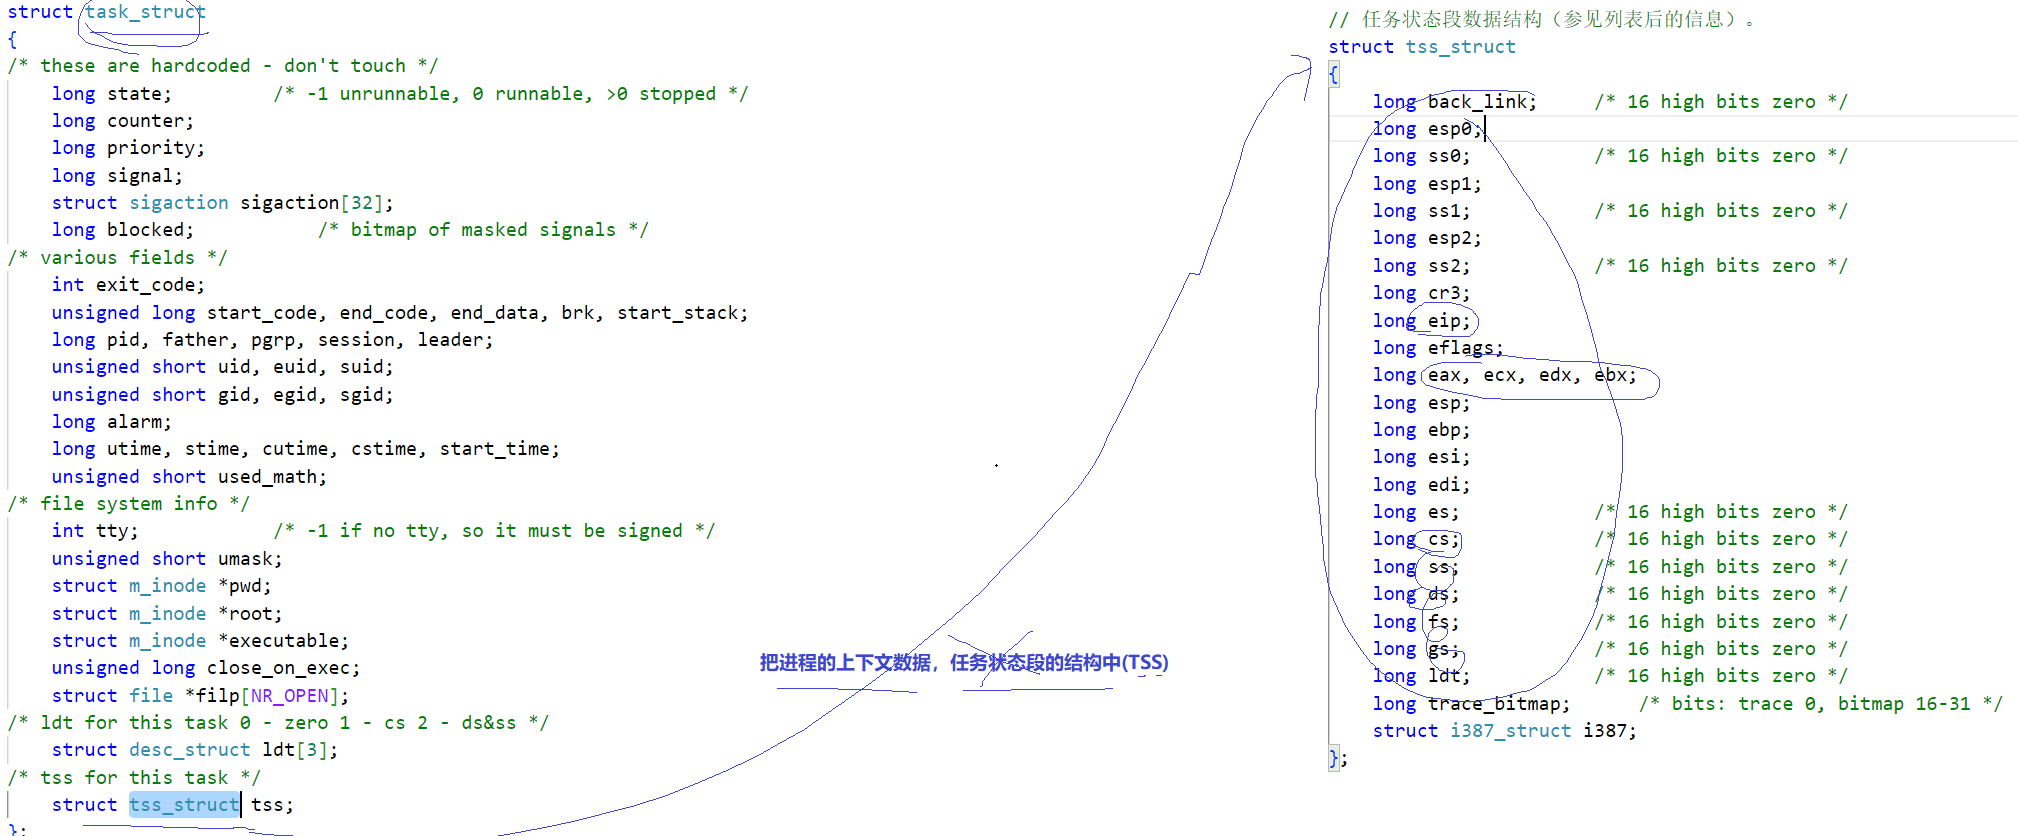
CPU上下⽂切换:其实际含义是任务切换,或者CPU寄存器切换。当多任务内核决定运⾏另外的任务时,它保存正在运⾏任务的当前状态,也就是CPU寄存器中的全部内容。这些内容被保存在任务⾃⼰的堆栈中,⼊栈⼯作完成后就把下⼀个将要运⾏的任务的当前状况从该任务的栈中重新装⼊CPU寄存器,并开始下⼀个任务的运⾏,这⼀过程就是context switch。
Linux源码
注意:
时间⽚:当代计算机都是分时操作系统,没有进程都有它合适的时间⽚(其实就是⼀个计数器)。时间⽚到达,进程就被操作系统从CPU中剥离下来。
3.4.1Linux2.6内核进程O(1)调度队列(重要)
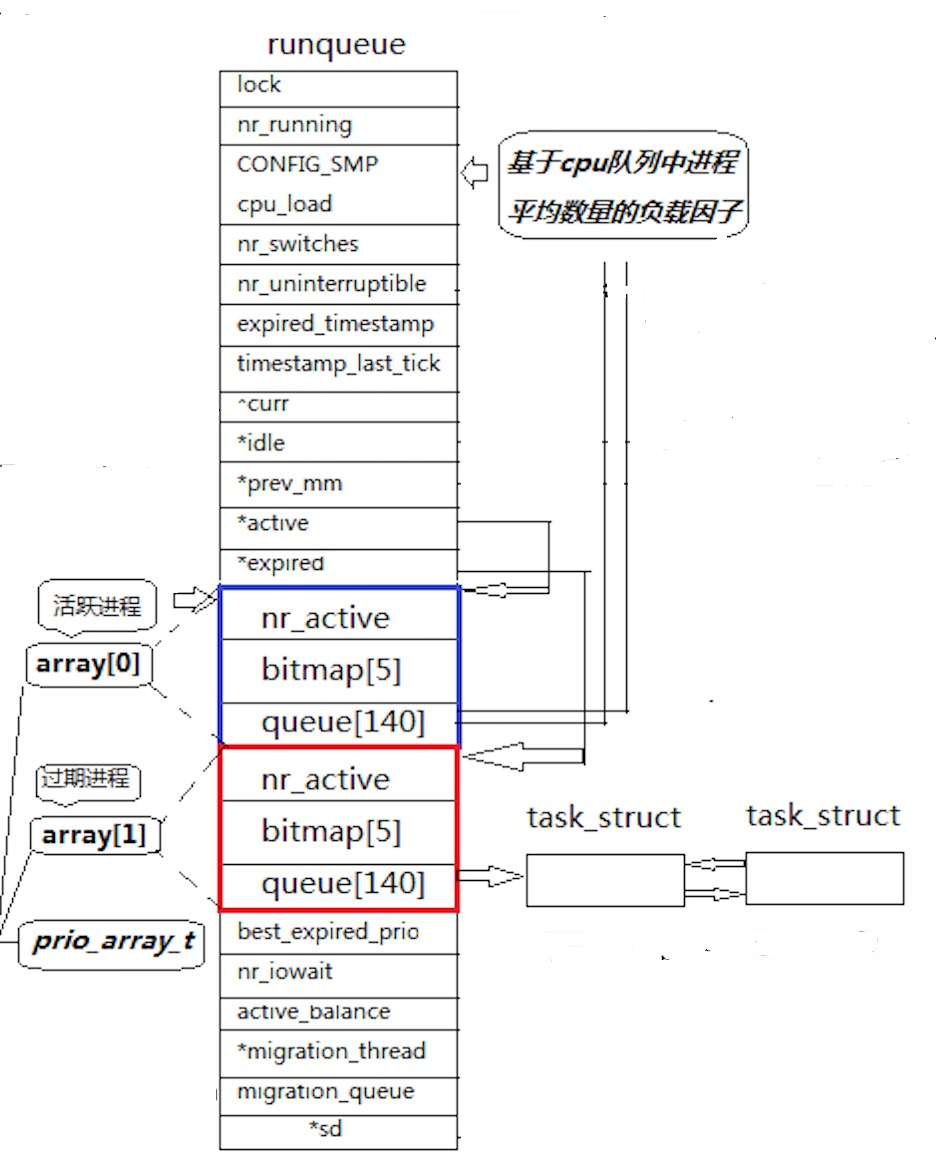
3-4-1⼀个CPU拥有⼀个runqueue
• 如果有多个CPU就要考虑进程个数的负载均衡问题
3-4-2优先级
• 普通优先级:100〜139(我们都是普通的优先级,想想nice值的取值范围,可与之对应!)
• 实时优先级:0〜99(不关⼼)
3-4-3 活动队列
• 时间⽚还没有结束的所有进程都按照优先级放在该队列
• nr_active:总共有多少个运⾏状态的进程
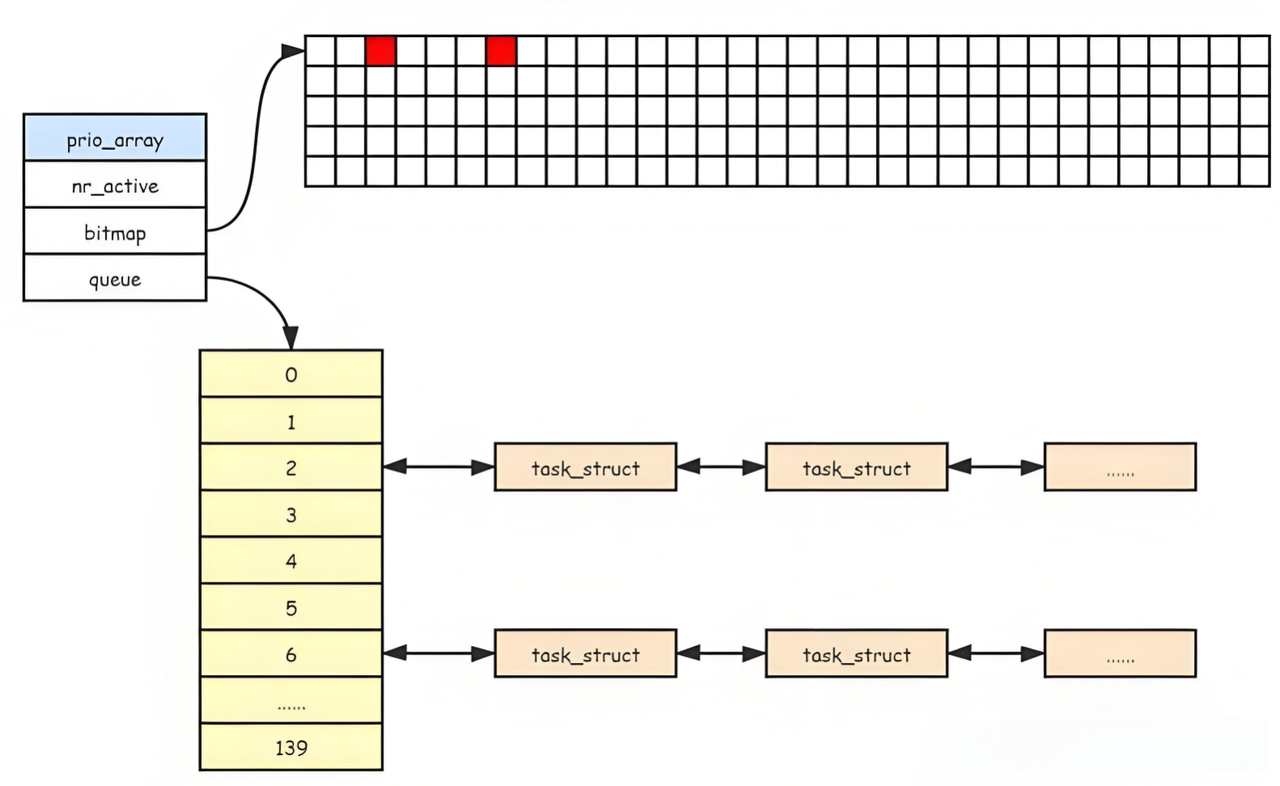
• queue[140]:⼀个元素就是⼀个进程队列,相同优先级的进程按照FIFO规则进⾏排队调度,所以,数组下标就是优先级!
• 从该结构中,选择⼀个最合适的进程,过程是怎么的呢?
1.从0下表开始遍历queue[140]
2.找到第⼀个⾮空队列,该队列必定为优先级最⾼的队列
3.拿到选中队列的第⼀个进程,开始运⾏,调度完成!
4.遍历queue[140]时间复杂度是常数!但还是太低效了!
• bitmap[5]:⼀共140个优先级,⼀共140个进程队列,为了提⾼查找⾮空队列的效率,就可以⽤5*32个⽐特位表⽰队列是否为空,这样,便可以⼤⼤提⾼查找效率!(位图)
3-4-4 过期队列
•
过期队列和活动队列结构⼀模⼀样
•
过期队列和活动队列结构 模 样
• 过期队列上放置的进程,都是时间⽚耗尽的进程
• 当活动队列上的进程都被处理完毕之后,对过期队列的进程进⾏时间⽚重新计算
3-4-5active指针和expired指针
• active指针永远指向活动队列
• expired指针永远指向过期队列
• 可是活动队列上的进程会越来越少,过期队列上的进程会越来越多,因为进程时间⽚到期时⼀直都存在的。
• 没关系,在合适的时候,只要能够交换active指针和expired指针的内容,就相当于有具有了⼀批新的活动进程!
3-4-6总结
• 在系统当中查找⼀个最合适调度的进程的时间复杂度是⼀个常数,不随着进程增多⽽导致时间成本增加,我们称之为进程调度O(1)算法!
struct rq {
spinlock_t lock;
/*
* nr_running and cpu_load should be in the same cacheline because
* remote CPUs use both these fields when doing load calculation.
*/
unsigned long nr_running;
unsigned long raw_weighted_load;
#ifdef CONFIG_SMP
unsigned long cpu_load[3];
#endif
unsigned long long nr_switches;
/*
* This is part of a global counter where only the total sum
* over all CPUs matters. A task can increase this counter on
* one CPU and if it got migrated afterwards it may decrease
* it on another CPU. Always updated under the runqueue lock:
*/
unsigned long nr_uninterruptible;
unsigned long expired_timestamp;
unsigned long long timestamp_last_tick;
struct task_struct *curr, *idle;
struct mm_struct *prev_mm;
struct prio_array *active, *expired, arrays[2];
int best_expired_prio;
atomic_t nr_iowait;
#ifdef CONFIG_SMP
struct sched_domain *sd;
/* For active balancing */
int active_balance;
int push_cpu;
struct task_struct *migration_thread;
struct list_head migration_queue;
#endif
#ifdef CONFIG_SCHEDSTATS
/* latency stats */
struct sched_info rq_sched_info;
/* sys_sched_yield() stats */
unsigned long yld_exp_empty;
unsigned long yld_act_empty;
unsigned long yld_both_empty;
unsigned long yld_cnt;
/* schedule() stats */
unsigned long sched_switch;
unsigned long sched_cnt;
unsigned long sched_goidle;
/* try_to_wake_up() stats */
unsigned long ttwu_cnt;
unsigned long ttwu_local;
#endif
struct lock_class_key rq_lock_key;
};
/*
* These are the runqueue data structures:
*/
struct prio_array {
unsigned int nr_active;
DECLARE_BITMAP(bitmap, MAX_PRIO+1); /* include 1 bit for delimiter */
struct list_head queue[MAX_PRIO];
};
4命令行参数和环境变量
4-1基本概念
• 环境变量(environment variables)⼀般是指在操作系统中⽤来指定操作系统运⾏环境的⼀些参数
• 如:我们在编写C/C++代码的时候,在链接的时候,从来不知道我们的所链接的动态静态库在哪⾥,但是照样可以链接成功,⽣成可执⾏程序,原因就是有相关环境变量帮助编译器进⾏查找。
• 环境变量通常具有某些特殊⽤途,还有在系统当中通常具有全局特性
4-2常⻅环境变量
• PATH:指定命令的搜索路径
• HOME:指定⽤⼾的主⼯作⽬录(即⽤⼾登陆到Linux系统中时,默认的⽬录)
• SHELL:当前Shell,它的值通常是/bin/bash。
4-3查看环境变量⽅法
echo $NAME //NAME:你的环境变量名称
测试PATH
- 创建hello.c⽂件
#include <stdio.h>
int main()
{
printf("hello world!\n");
return 0;
}
- 对⽐ ./hello 执⾏和之间 hello 执⾏
- 为什么有些指令可以直接执⾏,不需要带路径,⽽我们的⼆进制程序需要带路径才能执⾏?
- 将我们的程序所在路径加⼊环境变量PATH当中, export PATH=$PATH:hello程序所在路径
测试HOME
- ⽤root和普通⽤⼾,分别执⾏ echo $HOME ,对⽐差异
- 执⾏ cd ~; pwd ,对应 ~ 和HOME 的关系
##4-4和环境变量相关的命令
- echo:显⽰某个环境变量值
- export:设置⼀个新的环境变量
- env:显⽰所有环境变量
- unset:清除环境变量
- set:显⽰本地定义的shell变量和环境变量
4-5环境变量的组织⽅式
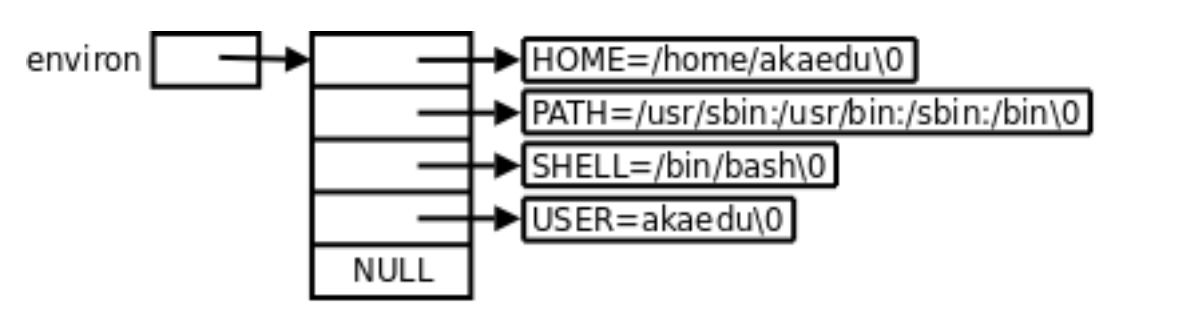
每个程序都会收到⼀张环境表,环境表是⼀个字符指针数组,每个指针指向⼀个以’\0’结尾的环境字符串
4-6通过代码如何获取环境变量
• 命令⾏第三个参数
#include <stdio.h>
int main(int argc, char *argv[], char *env[])
{
int i = 0;
for(; env[i]; i++){
printf("%s\n", env[i]);
}
return 0;
}
argc:命令行参数的个数(argument count)。
argv:字符串指针数组,保存各个参数(argument vector)。
env:环境变量字符串指针数组(environment vector)。
• 通过第三⽅变量environ获取
#include <stdio.h>
int main(int argc, char *argv[])
{
extern char **environ;
int i = 0;
for(; environ[i]; i++){
printf("%s\n", environ[i]);
}
return 0;
}
libc中定义的全局变量environ指向环境变量表,environ没有包含在任何头⽂件中,所以在使⽤时要⽤extern声明。
更全面参考环境变量
5程序地址空间
5-1研究平台
• kernel2.6.32
• 32位平台
虚拟地址空间

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)