基于 vLLM 与 K8s 的高并发推理服务:PagedAttention 显存优化实践
基于 vLLM 与 K8s 的高并发推理服务:PagedAttention 显存优化实践
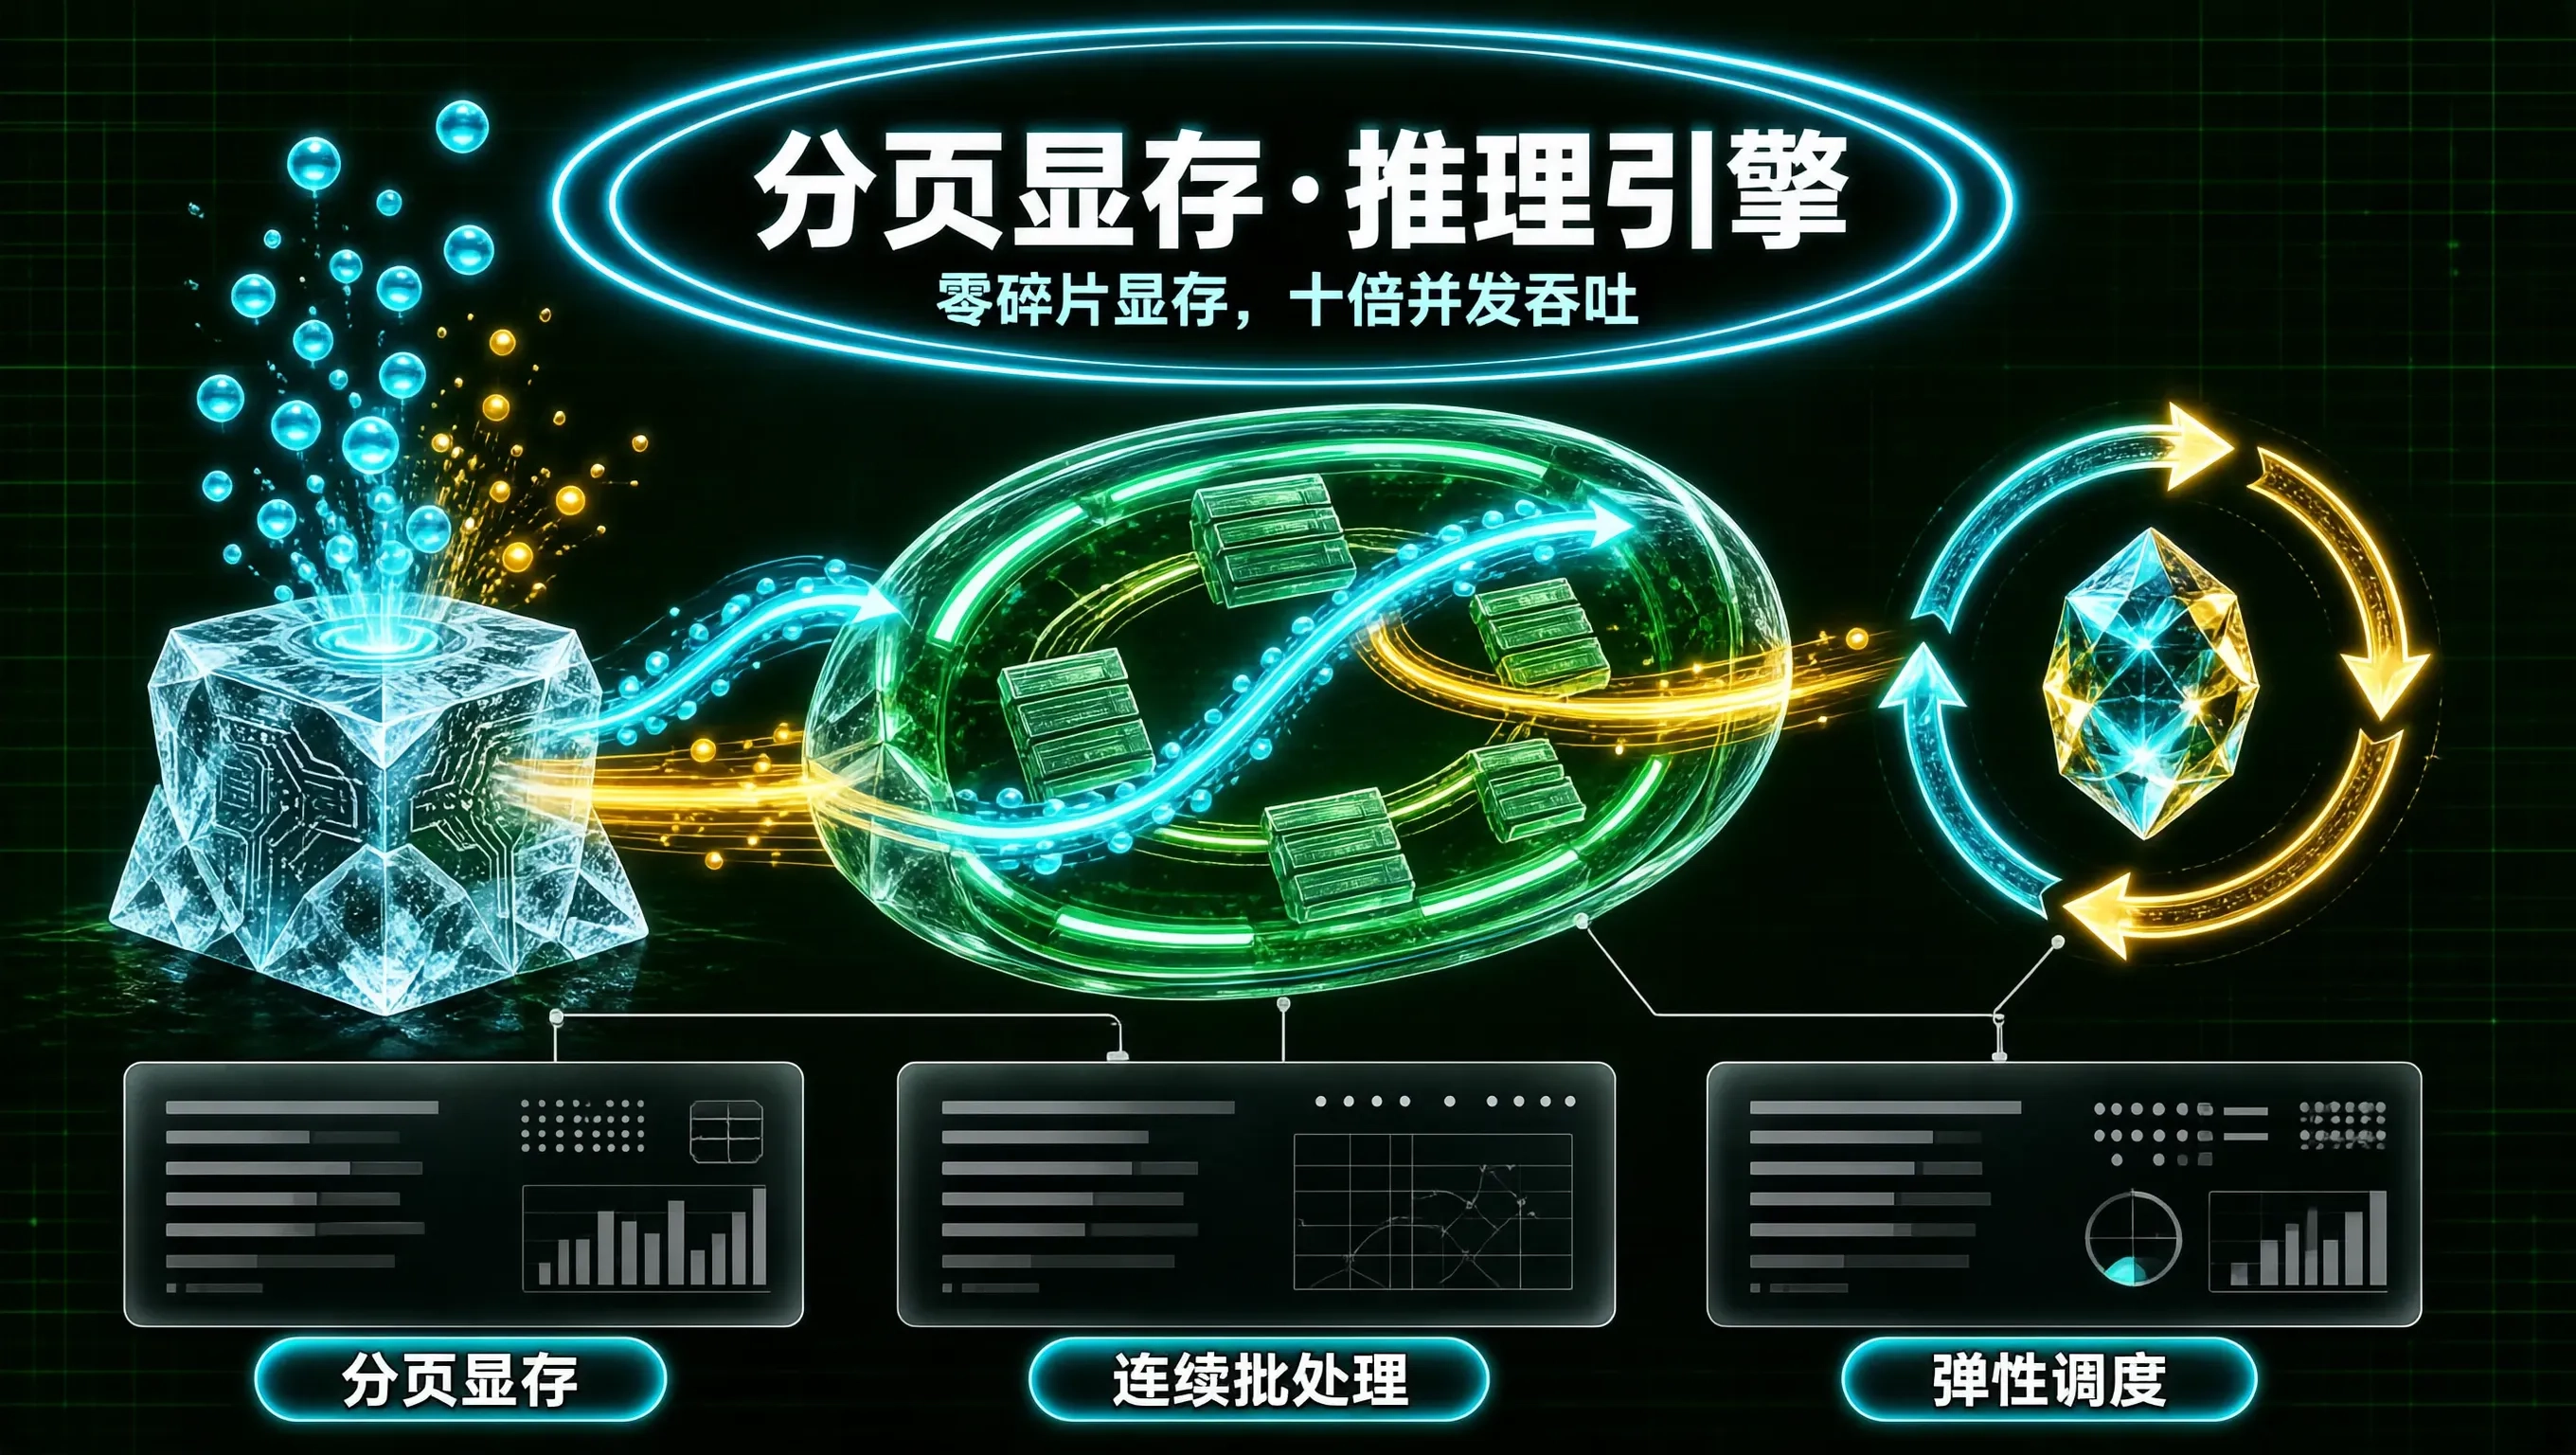
在将大型语言模型(LLM)从本地原型推向生产高并发场景时,基于传统 HuggingFace Transformers 框架构建的推理服务往往会遭遇严重的吞吐瓶颈。
当几十个并发请求同时涌入时,传统推理框架会因为必须为每个请求预分配最大上下文长度(Max Sequence Length)的 KV Cache,导致 GPU 显存迅速发生碎片化(Fragmentation)并触发 OOM 崩溃。单张 80GB 的 A100 显卡往往只能支撑 5~8 个并发,并发 QPS 惨不忍睹。
vLLM 框架引入了受操作系统虚拟内存启发的 PagedAttention 算法,将 KV Cache 离散存储在非连续的显存块(Blocks)中,消除了 96% 以上的显存碎片浪费。结合 Kubernetes 的弹性调度与连续批处理(Continuous Batching),能够将单卡并发吞吐提升 5 到 10 倍。
PagedAttention 与传统静态显存分配对比
【传统 HuggingFace 静态显存分配】
Request 1 (预分配 4096 tokens): [████已用 200 tokens | ░░░░░░░░░░░░░░░░ 浪费 3896 tokens 空闲显存]
Request 2 (预分配 4096 tokens): [████已用 150 tokens | ░░░░░░░░░░░░░░░░ 浪费 3946 tokens 空闲显存]
==> 显存有效利用率 < 20%,极早触发 OOM

【vLLM PagedAttention 分页显存管理】
物理显存池被切分为标准 Block (每个 Block 存放 16 个 Tokens 的 KV)
Logical Blocks (逻辑页) ──[Page Table 页表动态映射]──> Physical GPU Blocks (物理显存块)
==> 显存按需分配,零碎片浪费,并发吞吐提升 5~10 倍
生产级 vLLM Kubernetes Deployment 配置
在生产 K8s 集群中部署 vLLM 服务,必须精细配置显存利用率(gpu-memory-utilization)、最大模型上下文长度(max-model-len)以及存活探针:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: vllm-deepseek-service
  namespace: ai-inference
spec:
  replicas: 2
  selector:
    matchLabels:
      app: vllm-deepseek
  template:
    metadata:
      labels:
        app: vllm-deepseek
    spec:
      containers:
      - name: vllm-server
        image: vllm/vllm-openai:v0.6.2
        imagePullPolicy: IfNotPresent
        command: ["python3", "-m", "vllm.entrypoints.openai.api_server"]
        args:
        - "--model=/models/deepseek-7b-chat"
        - "--port=8000"
        - "--gpu-memory-utilization=0.90" # 允许 vLLM 占用 90% 显存作为 KV Cache 池
        - "--max-model-len=8192"
        - "--max-num-seqs=256"           # 允许单实例最大并发序列数
        - "--tensor-parallel-size=1"     # 单卡部署设为 1,多卡分布式设为卡数
        - "--disable-log-requests"       # 生产高并发下关闭全量请求日志,避免 IO 阻塞
        env:
        - name: NCCL_DEBUG
          value: "INFO"
        resources:
          requests:
            cpu: "8"
            memory: "32Gi"
            nvidia.com/gpu: "1"
          limits:
            cpu: "16"
            memory: "64Gi"
            nvidia.com/gpu: "1"
        volumeMounts:
        - name: shared-memory
          mountPath: /dev/shm
        - name: model-weights
          mountPath: /models
          readOnly: true
        ports:
        - containerPort: 8000
        # 就绪探针:必须在模型完全加载并分配好 PagedAttention 显存池后才接入流量
        readinessProbe:
          httpGet:
            path: /health
            port: 8000
          initialDelaySeconds: 40
          periodSeconds: 10
          timeoutSeconds: 5
        livenessProbe:
          httpGet:
            path: /health
            port: 8000
          initialDelaySeconds: 60
          periodSeconds: 15
          timeoutSeconds: 5
      volumes:
      - name: shared-memory
        emptyDir:
          medium: Memory
          sizeLimit: 8Gi
      - name: model-weights
        persistentVolumeClaim:
          claimName: ceph-model-weights-pvc
前端与 BFF 层的流式 SSE 接入与背压控制
vLLM 原生兼容 OpenAI API 规范。在前端或 Node.js BFF 层调用时,采用流式 SSE(Server-Sent Events)接入,并利用 TransformStream 控制数据流速(Backpressure):
import { createParser, ParsedEvent, ReconnectInterval } from 'eventsource-parser';

export async function* streamLlmInference(prompt: string, signal?: AbortSignal) {
  const response = await fetch('http://vllm-deepseek-service.ai-inference.svc:8000/v1/chat/completions', {
    method: 'POST',
    headers: {
      'Content-Type': 'application/json',
      'Authorization': 'Bearer internal-token',
    },
    body: JSON.stringify({
      model: '/models/deepseek-7b-chat',
      messages: [{ role: 'user', content: prompt }],
      stream: true,
      temperature: 0.7,
      max_tokens: 2048,
    }),
    signal,
  });

  if (!response.ok || !response.body) {
    throw new Error(`vLLM stream error: ${response.statusText}`);
  }

  const reader = response.body.getReader();
  const decoder = new TextDecoder();

  let queue: string[] = [];

  const parser = createParser((event: ParsedEvent | ReconnectInterval) => {
    if (event.type === 'event') {
      if (event.data === '[DONE]') return;
      try {
        const json = JSON.parse(event.data);
        const delta = json.choices[0]?.delta?.content || '';
        if (delta) queue.push(delta);
      } catch (e) {
        // 忽略残缺 JSON chunk
      }
    }
  });

  while (true) {
    const { done, value } = await reader.read();
    if (done) break;
    parser.feed(decoder.decode(value, { stream: true }));
    while (queue.length > 0) {
      yield queue.shift()!;
    }
  }
}
性能压测实测数据对比
使用 Locust 对单张 RTX 4090 (24GB) 运行 7B 模型的集群进行并发压测:
| 框架方案 | 显存碎片率 | 最大安全并发数 | 首字平均延迟 (TTFT) | 整体吞吐 (Tokens/s) |
|---|---|---|---|---|
| 原生 Transformers + FastAPI | 78% | 8 并发 (再高 OOM) | 1250 ms | 142 tokens/s |
| vLLM (PagedAttention) | < 4% | 64 并发 | 180 ms | 1180 tokens/s |
总结
vLLM 与 PagedAttention 将大模型推理从原先的“手工作坊”带入了现代操作系统的“虚拟分页”时代。在 Kubernetes 体系中标准化部署 vLLM,是构建企业级低成本、高并发 AI 基础设施的基石标准。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 4
 0
- 0


 已为社区贡献14条内容

所有评论(0)