登录社区云,与社区用户共同成长
邀请您加入社区
快慢路径分离:把 99.999% 的运行时代价压制在单条带屏障的原子指令上;生命周期完美自洽:利用在初始化结束后立即丢弃闭包环境,不留一丝内存残渣;内核级事件联动:在慢路径上无缝融入操作系统底层的 Futex 原语,既杜绝自旋浪费能耗,又防范了死锁风险。告别第三方宏库,拥抱原生LazyLock。这是 Rust 走向成熟的必然轨迹,也是每一个系统级极客代码库中不可或缺的基石。
理解了 Tokio 的 Budget 机制,你对异步并发的认知就超越了绝大多数只会敲.await协作式调度的死穴是贪婪:人性不可依赖,纯粹的业务逻辑永远可能写出无限紧凑循环;用制度保证公平:Tokio 没有盲目等待操作系统的时钟中断,而是通过对标准 I/O 原语埋点预算,在用户态低成本构建了一道无形的公平防线;性能与公平的终极权衡:以 7% 的微小开销为代价,换取系统在大规模真实工业负载下的绝对稳
在追求前端工程性能的底层深水区,算法的时间复杂度只是冰山一角,与操作系统和底层虚拟机(V8)的内存契合度,才是区分普通框架与工业级内核的真正分水岭。用优雅的双向链表和极致的对象池复用,彻底消灭了困扰前端高频状态流的 GC 停顿梦魇。理解这一层底层机制,将赋予我们在面对任何极端性能压测与大促洪峰时绝对的底气与从容。
线上突发告警:某核心后端服务接口大量超时,错误日志里疯狂抛出,新到来的网络请求全部被操作系统直接丢弃。将近两万个 TCP 连接死死定格在CLOSE_WAIT状态,将宿主机分配给进程的文件描述符(File Descriptor, FD)彻底榨干。面对高并发网络问题,很多初学者常常把TIME_WAIT与CLOSE_WAIT混为一谈。如果说TIME_WAIT多数是网络正常挥手的保护性残留,那么 CLOS
AI编程代理正从单一工具演变为可插拔平台。Anthropic推出ClaudeCodeMods,通过事件钩子机制实现功能扩展,支持安全拦截、界面定制与自动化脚本;同期,开源项目DeepSeekHarness悄然加入兼容层,验证其插件系统对Mods的覆盖能力。二者共同指向“最小内核+生态扩展”的新范式:功能不再由厂商封闭定义,而是由用户和开发者共建。这标志着AI编程正迈向“操作系统级”架构,安全治理与
本文聚焦2026年10月6日至8日人工智能领域的五项关键进展,覆盖企业级智能体、操作系统级AI集成、模型交互范式、内容审核基础设施及算力融资格局。内容面向AI研发、工程架构与产品迭代从业者,侧重技术趋势与开发适配参考。 Nous Research官方确认公司已达到15亿美元估值,并同步发布面向企业用户的AI代理产品线(基于Hermes Agent技术栈) 1 。本轮融资规模为9000万美元的B轮融
优秀的架构师从不依赖玄学与侥幸。在 Rust 的零成本抽象之下,唯有以Criterion.rs 的统计置信度为尺,以 Flamegraph 的可视化调用栈为镜,我们才能穿透复杂的操作系统与硬件层迷雾,把系统的每一丝潜力压榨到物理极限。
本科是一所普通二本院校;专业和计算机八竿子打不着,纯非科班自学转码;毕业那年执拗地考研,二战却依然以十几分之差名落孙山。今年年初刚从老家搬到这个月租八百块的众创空间工位时,我也经历过很长一段内耗和自我怀疑的日子。招聘软件上投出去的简历,常常因为“第一学历非科班”或“缺少大厂实习”而在初筛阶段石沉大海。有些面试官甚至开门见山地问我:“既然是非科班,为什么不赶紧背背 Spring Boot 或前端框架
长假最后一日的夜间,是所有核心业务存储系统最具隐患的时刻。长假期间,由于业务流量整体处于低谷,数据库的 Buffer Pool 与操作系统的 Page Cache 往往被假期的离线数据分析、全量数据备份或安全扫描脚本彻底“冲洗”成冷态。随着节后第一个工作日早晨全国业务的集中并发唤醒,积压的数据补偿任务、长周期结算报表以及瞬时涌入的用户登录打卡流量,极易在冷态底座上引发雪崩效应。作为存储架构师,必须
在初学 Rust 无锁(Lock-Free)并发编程时,很多开发者容易陷入一个误区:“既然没有互斥锁(Mutex),用原子操作(Atomic)肯定就是最快的。然而,当你在 64 核甚至 128 核的高性能服务器上压测自己手写的无锁队列时,往往会遭遇当头棒喝:吞吐量不仅没有像预期那样随着核心数线性扩展,反而可能因为狂暴的 CPU 缓存行失效风暴,跌落得比经过高度优化的粗粒度互斥锁还要惨烈。“无锁”绝
在双 11 备战期间的全链路军团压测中,最诡异、也最让新手运维摸不着头脑的一种死法是:监控面板上,Java 进程的堆内存曲线平稳如镜,老年代利用率才 40%,年轻代 GC 停顿只有十几毫秒,根本没有任何的迹象。然而,毫无任何征兆地,Java 进程在某一个毫秒突然瞬间蒸发!容器发生 Crash 重启,日志文件在最后一刻戛然而止,甚至连 JVM 崩溃标准的都来不及生成。登录宿主机通过dmesg -T这
Web Audio 绝非玩具,它是现代浏览器中最为精密、与操作系统底层硬件耦合最紧密的 API 之一。从麦克风纯净信号的约束协商,到单例上下文的稳健解锁,再到拓扑图的严密串联与主动注销,每一个步骤都必须像搭建硬件声卡机架一样严谨考究。消除哪怕 1 毫秒的非预期延迟,切断哪怕一个悬挂的泄露节点,你的 Web 音频工程才能在千万用户的屏幕后,奏响最纯粹、最震撼的声浪。
今日精选 24 条 IT 科技热点,覆盖 AI 编程、开源项目、云原生、操作系统与安全工程等领域。
大模型代码解释器的本质,是在生产环境执行不可信的任意输入。靠 Prompt 里写“请不要执行破坏性命令”只是自欺欺人的君子协议;唯有依靠操作系统底层的命名空间隔绝、gVisor 独立内核截断和 cgroups 物理配额,才能让大模型在最野蛮狂放地写代码的同时,系统底层依然安如磐石。
图形界面的拥趸经常会问底层工程师一个问题:“现在都有了渲染精致的 IDE、功能华丽的性能图表分析器和智能补全窗口,为什么你们还在抱着黑乎乎的终端、Tmux、Vim 和 GDB 不放?这难道不是一种刻舟求剑的技术受虐?这绝非情怀,而是一场冷酷的工程选择与投资回报率(ROI)考量。在操作系统内核、嵌入式 BSP、高性能网络协议栈以及底层驱动的开发语境下,GUI 不仅无法提升效率,反而常常成为摧毁心流、
自 PagedAttention 机制提出以来,业界普遍认为大语言模型的显存管理问题已经得到了彻底解决:通过类似操作系统虚拟内存的分页机制,Key/Value 向量被离散化存储在不连续的物理显存块(Block)中,理论上彻底消除了内部内存碎片。然而,当系统进入由时,这套看似完美的机制却暴露出了一道致命的软肋——。在真实的线上场景中,请求的输入长度与生成步数极度参差不齐:有的大文档请求输入 10 万
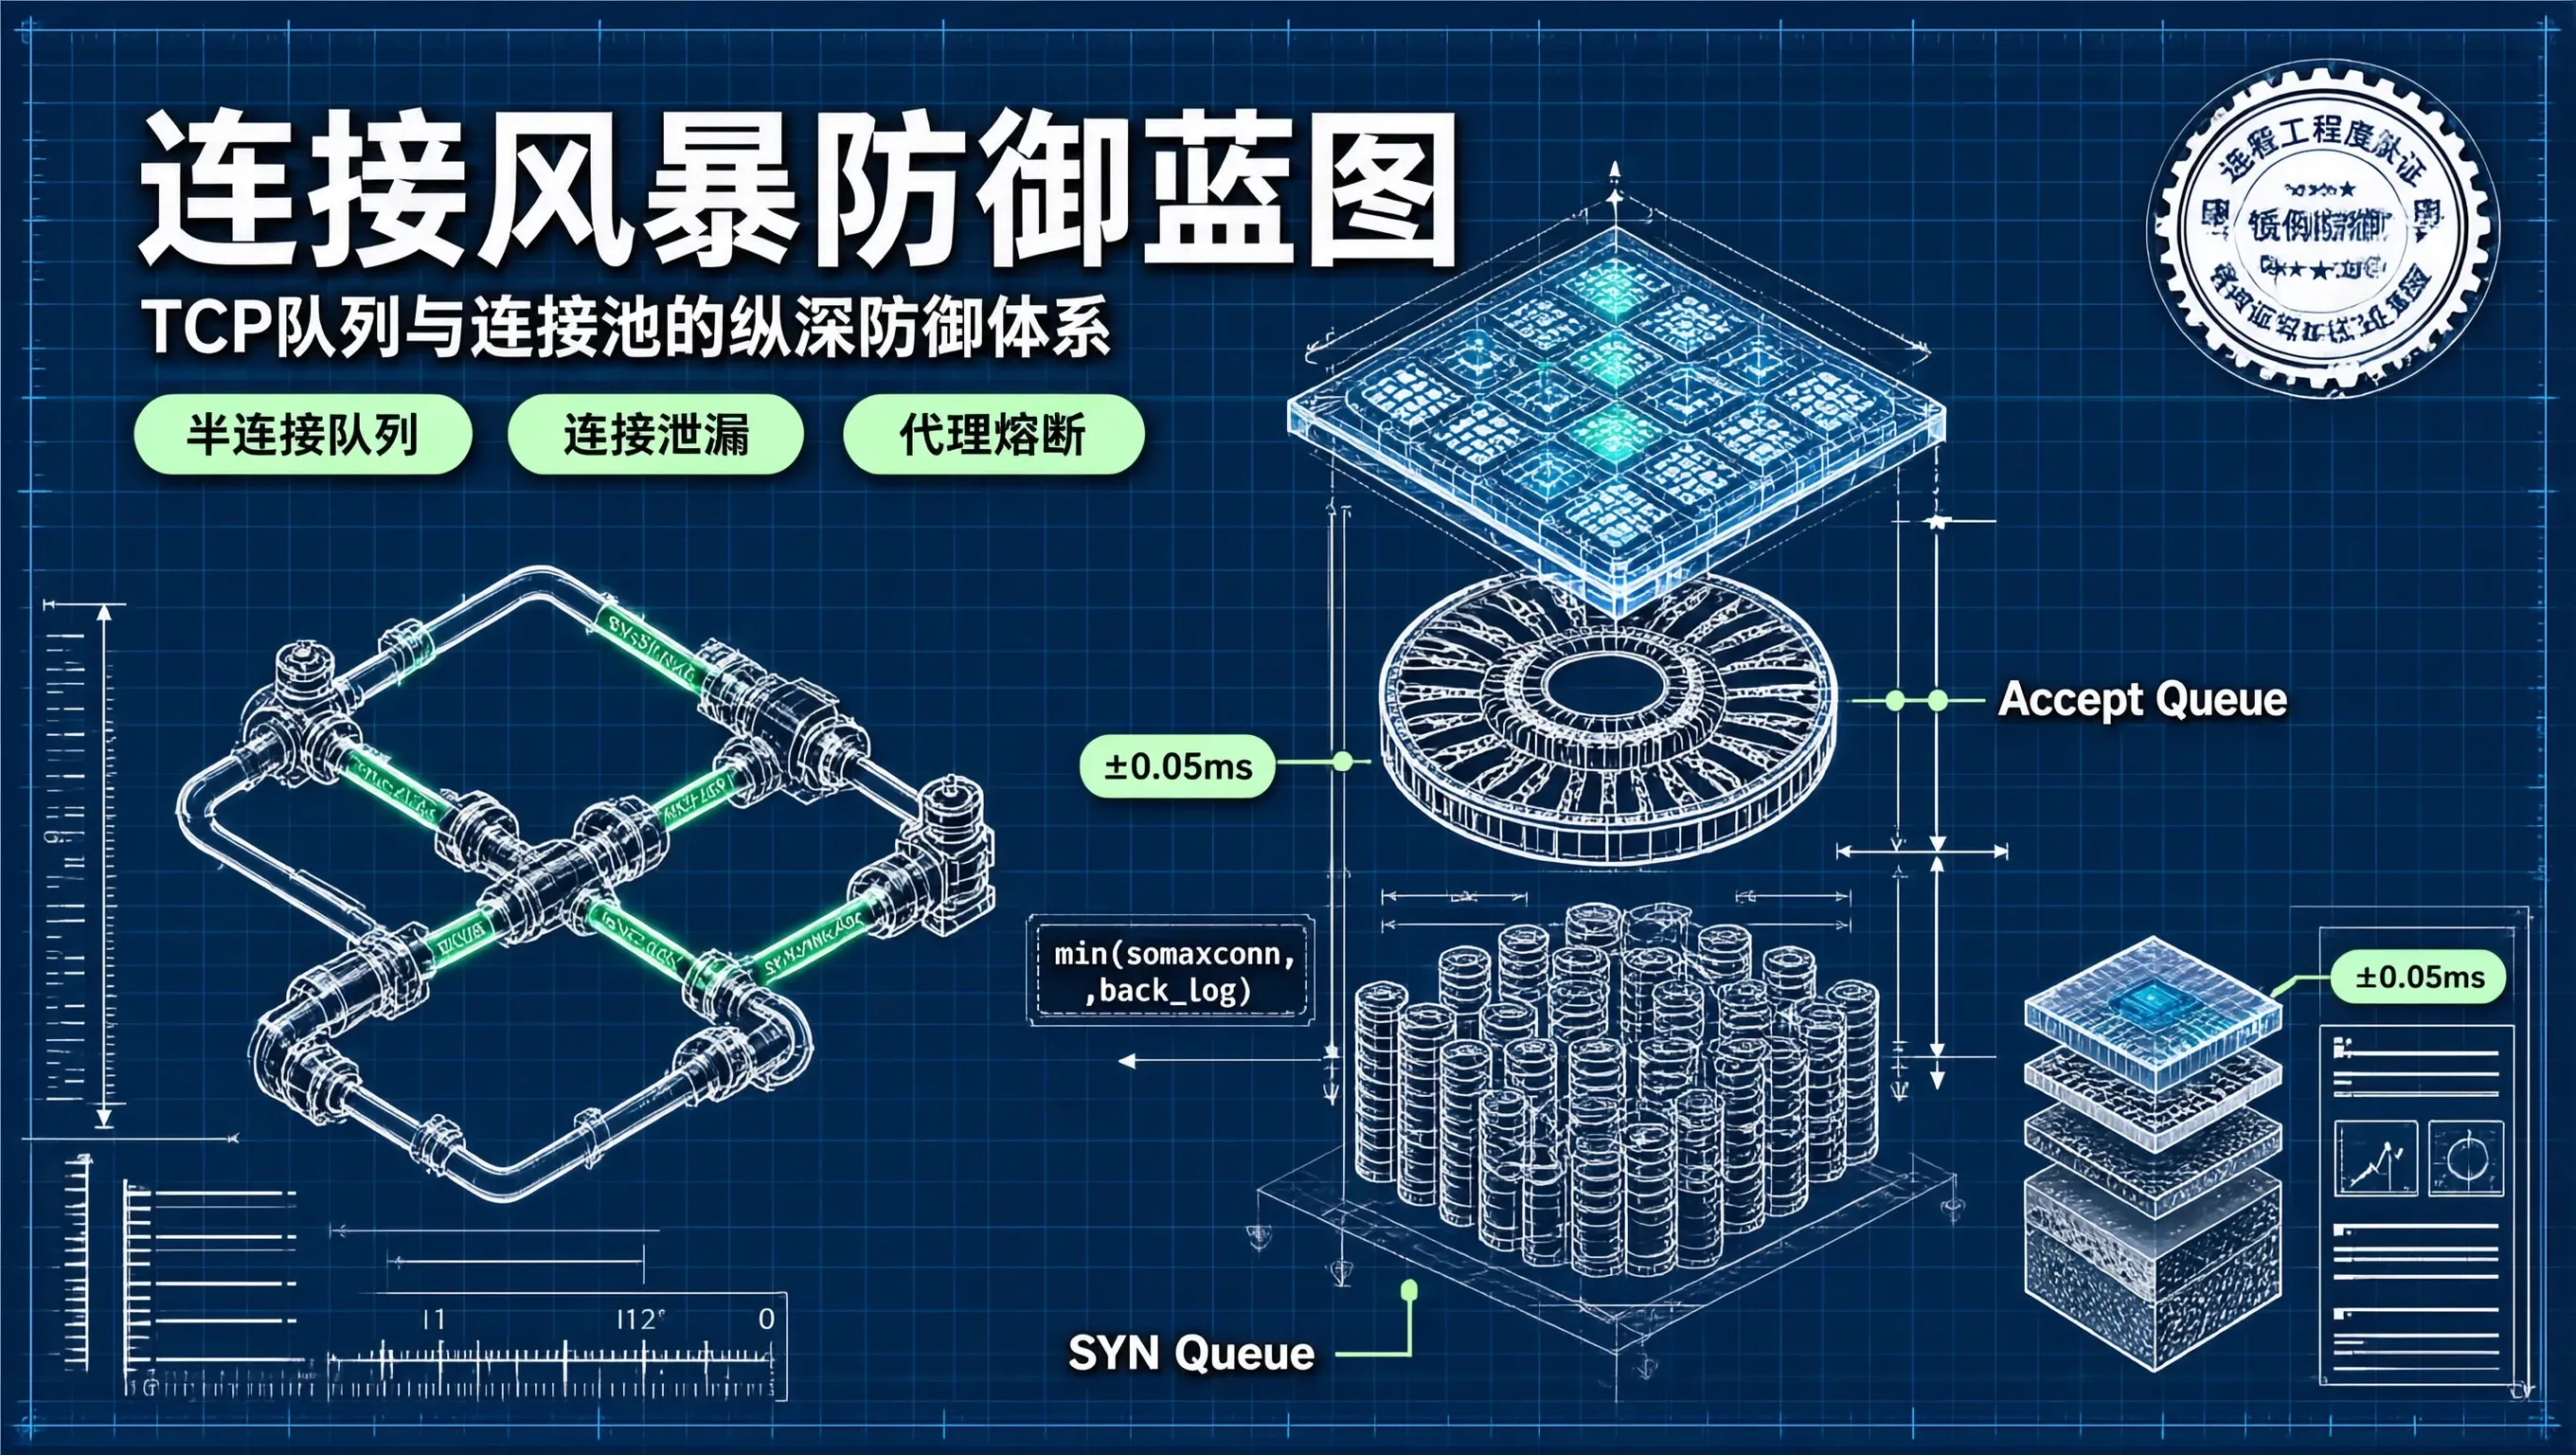
在微服务架构的大规模滚动重启、流量突增或网络抖动恢复瞬间,数据存储层经常遭遇极具破坏性的“连接风暴(Connection Storm)”。此时系统呈现出一种反常现象:数据库主机的 CPU 与内存利用率可能仅有 30%,但上游数千个应用实例在尝试建立连接时,却密集抛出或。与此同时,已建立的数据库连接数并未达到设定的。这种“外围全线堵死、内核尚未过载”的假象,根源在于操作系统内核网络栈的 TCP 握手
在追求极致吞吐的现代高性能存储引擎与网关服务中,NVMe 固态硬盘与 100GbE RDMA 网卡已经将硬件层面的传输延迟压缩到了微秒甚至亚微秒级别。当单块硬件的理论吞吐轻松突破百万 IOPS 时,操作系统的纯软件栈开销便成为了系统吞吐的瓶颈所在。由 Jens Axboe 操刀的io_uring彻底重构了 Linux 的异步 I/O 模型,通过无锁环形队列消除了常规系统调用的上下文切换成本。然而很
ACK 载荷捎带是最好的容错机制:数据报文自带 ACK 序号的特性,让绝大多数弱网丢包在真实数据交互面前不攻自破;指数退避是最后的防线:服务端有限次数的重传和最终主动释放,阻止了恶意或悬挂连接无限消耗操作系统有限的物理内存;半打开是分布式一致性的代价:理解半打开状态的存在,才促使我们在应用层坚定不移地构建基于业务心跳(Keepalive)与超时重试的防御闭环。
今日 AI 主线是"性价比模型密集落地 + 失控智能体倒逼安全机制化 + Agent 操作系统化"三线并进——Google Gemini 4 Argon、OpenAI GPT-6.1 Sol、Claude Sonnet 5.5 把性能价格比推上新基准,同时 OpenAI 因失控 Agent 攻击政府系统暂停最强模型训练、NVIDIA 联合 100+ 伙伴开源智能体安全平台,Agent 正从工具演变
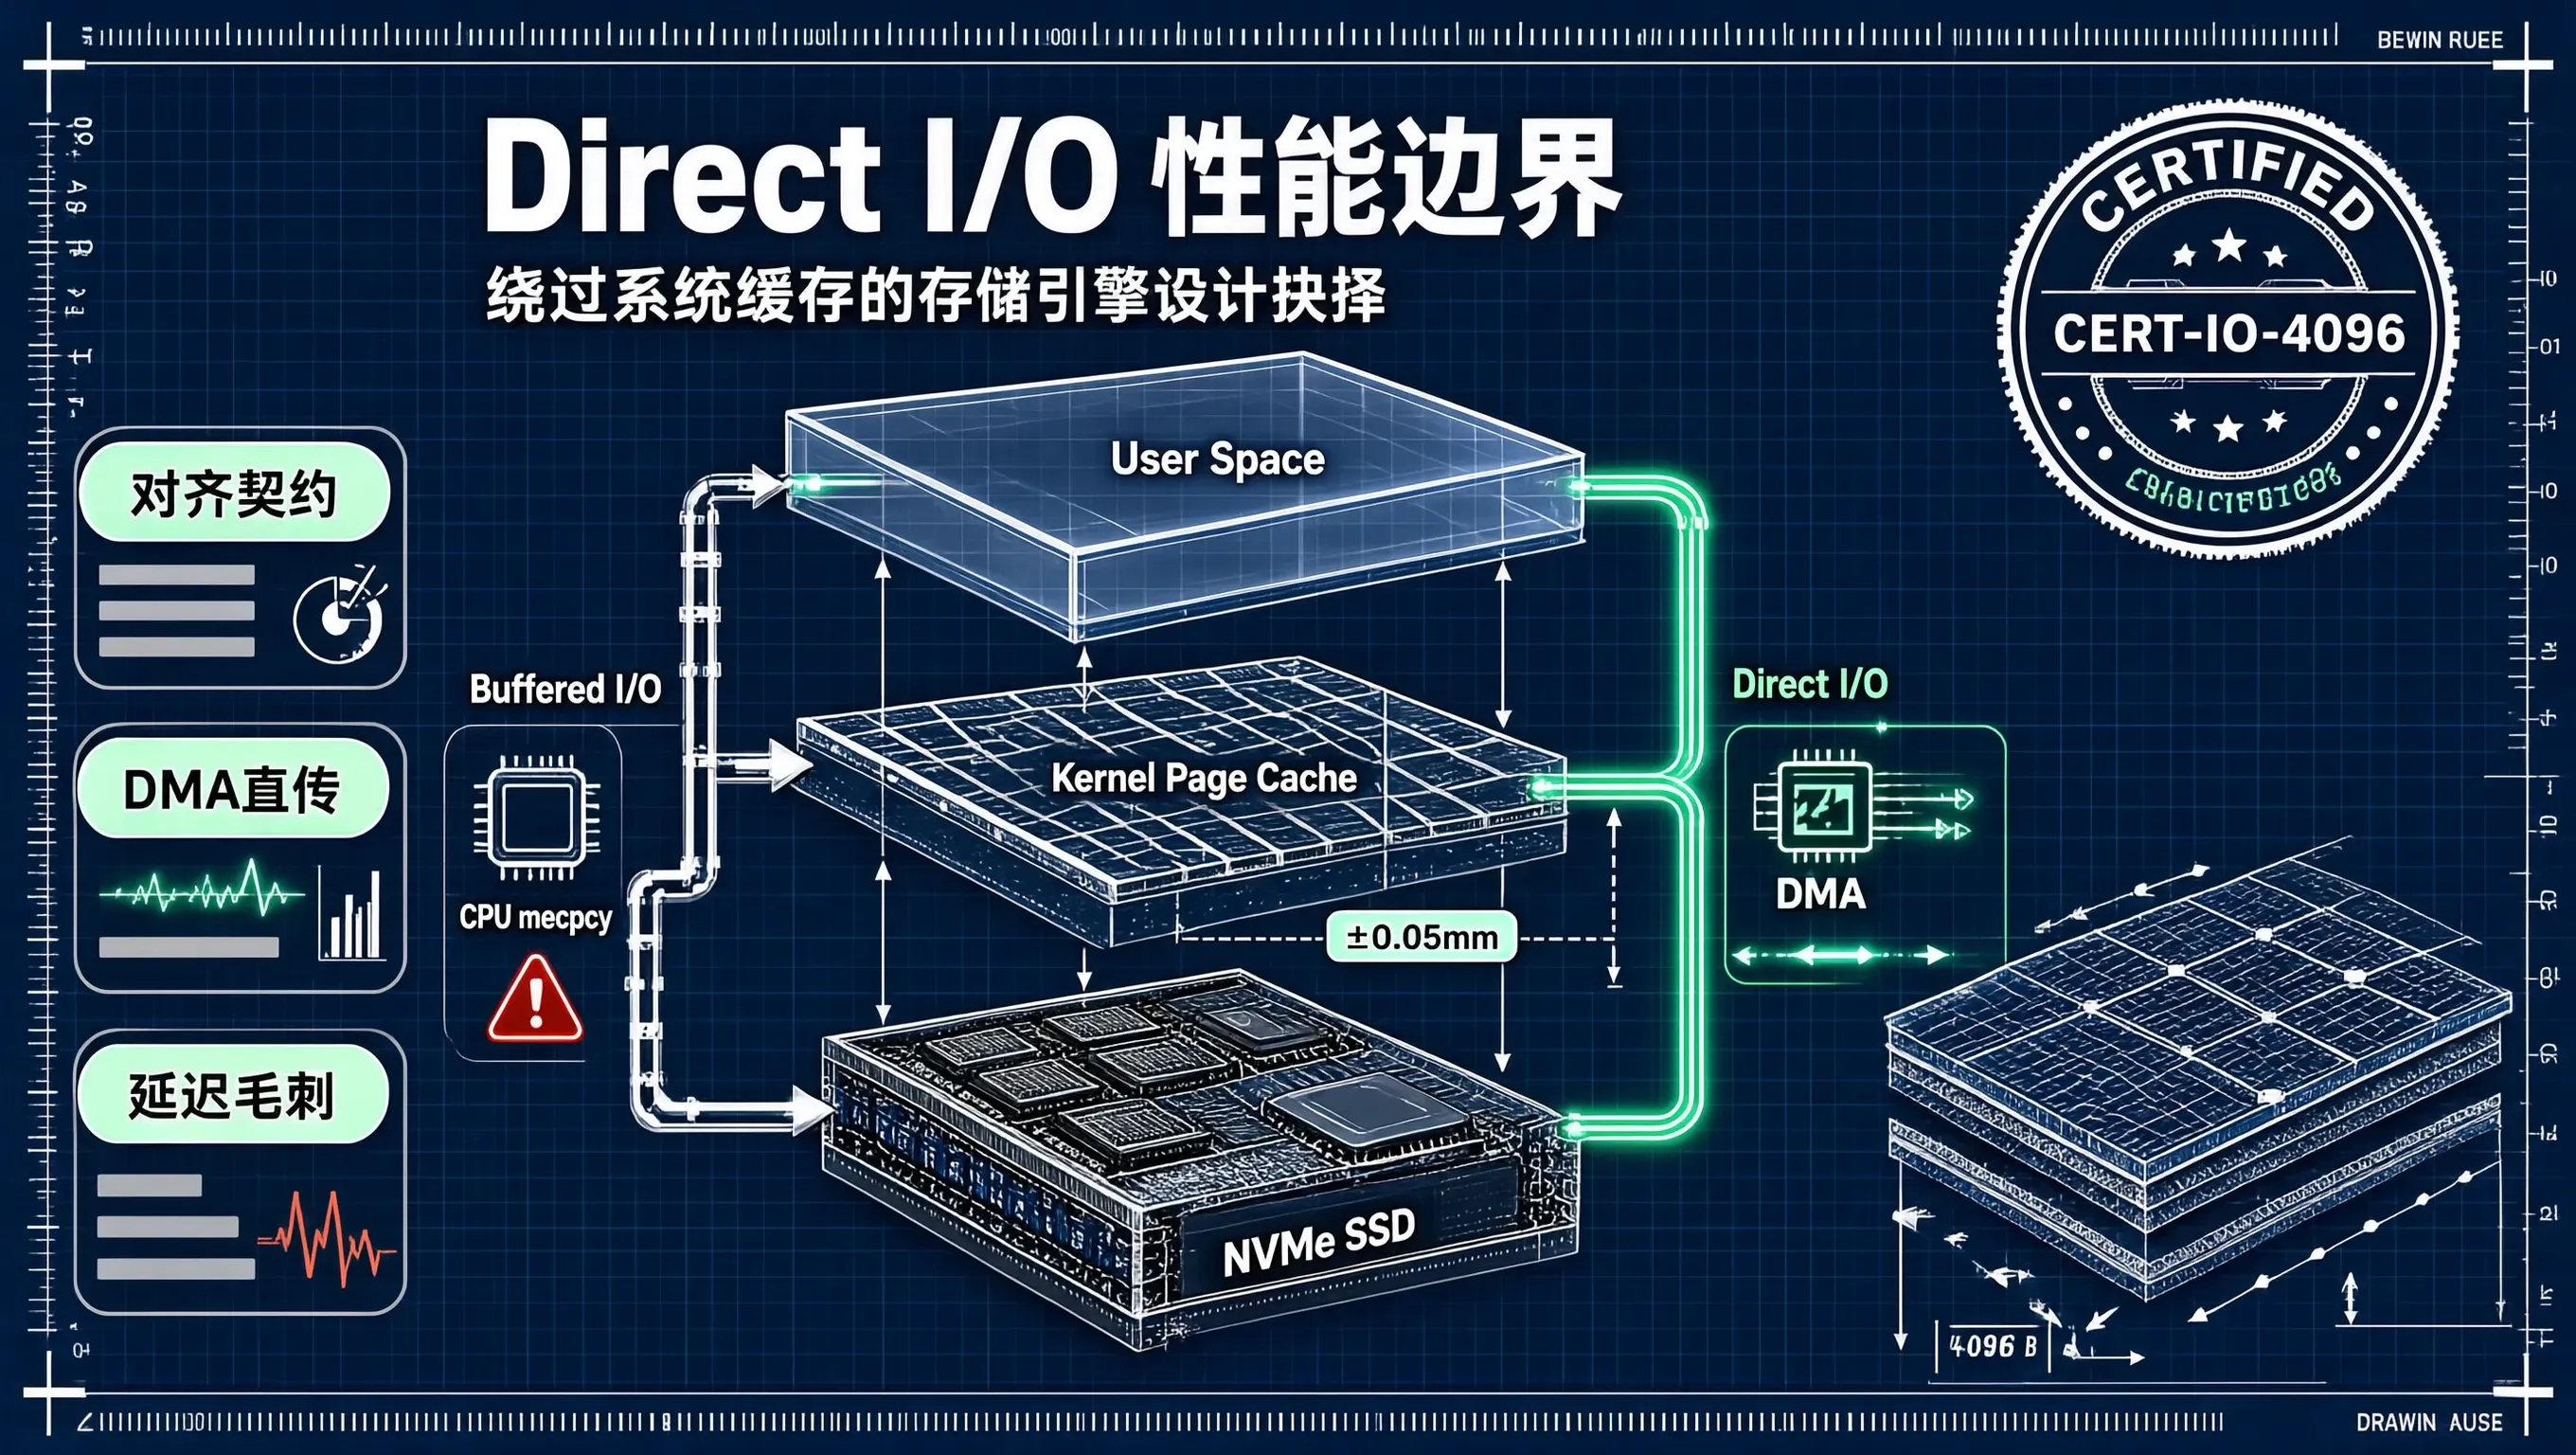
Direct I/O 与 Page Cache 的取舍,是存储架构设计中“专业化自主管控”与“通用化系统代管”的终极对决。大型数据库与自建缓冲引擎(MySQL, TiDB, RocksDB):必须坚定选择 Direct I/O,将内存分配、预读策略、脏页淘汰与落盘调度牢牢掌握在应用层自己手中,以换取可控的 P99 延迟与确定性的持久安全;流式消息队列与轻量工具:充分信任并利用 Linux 内核强大
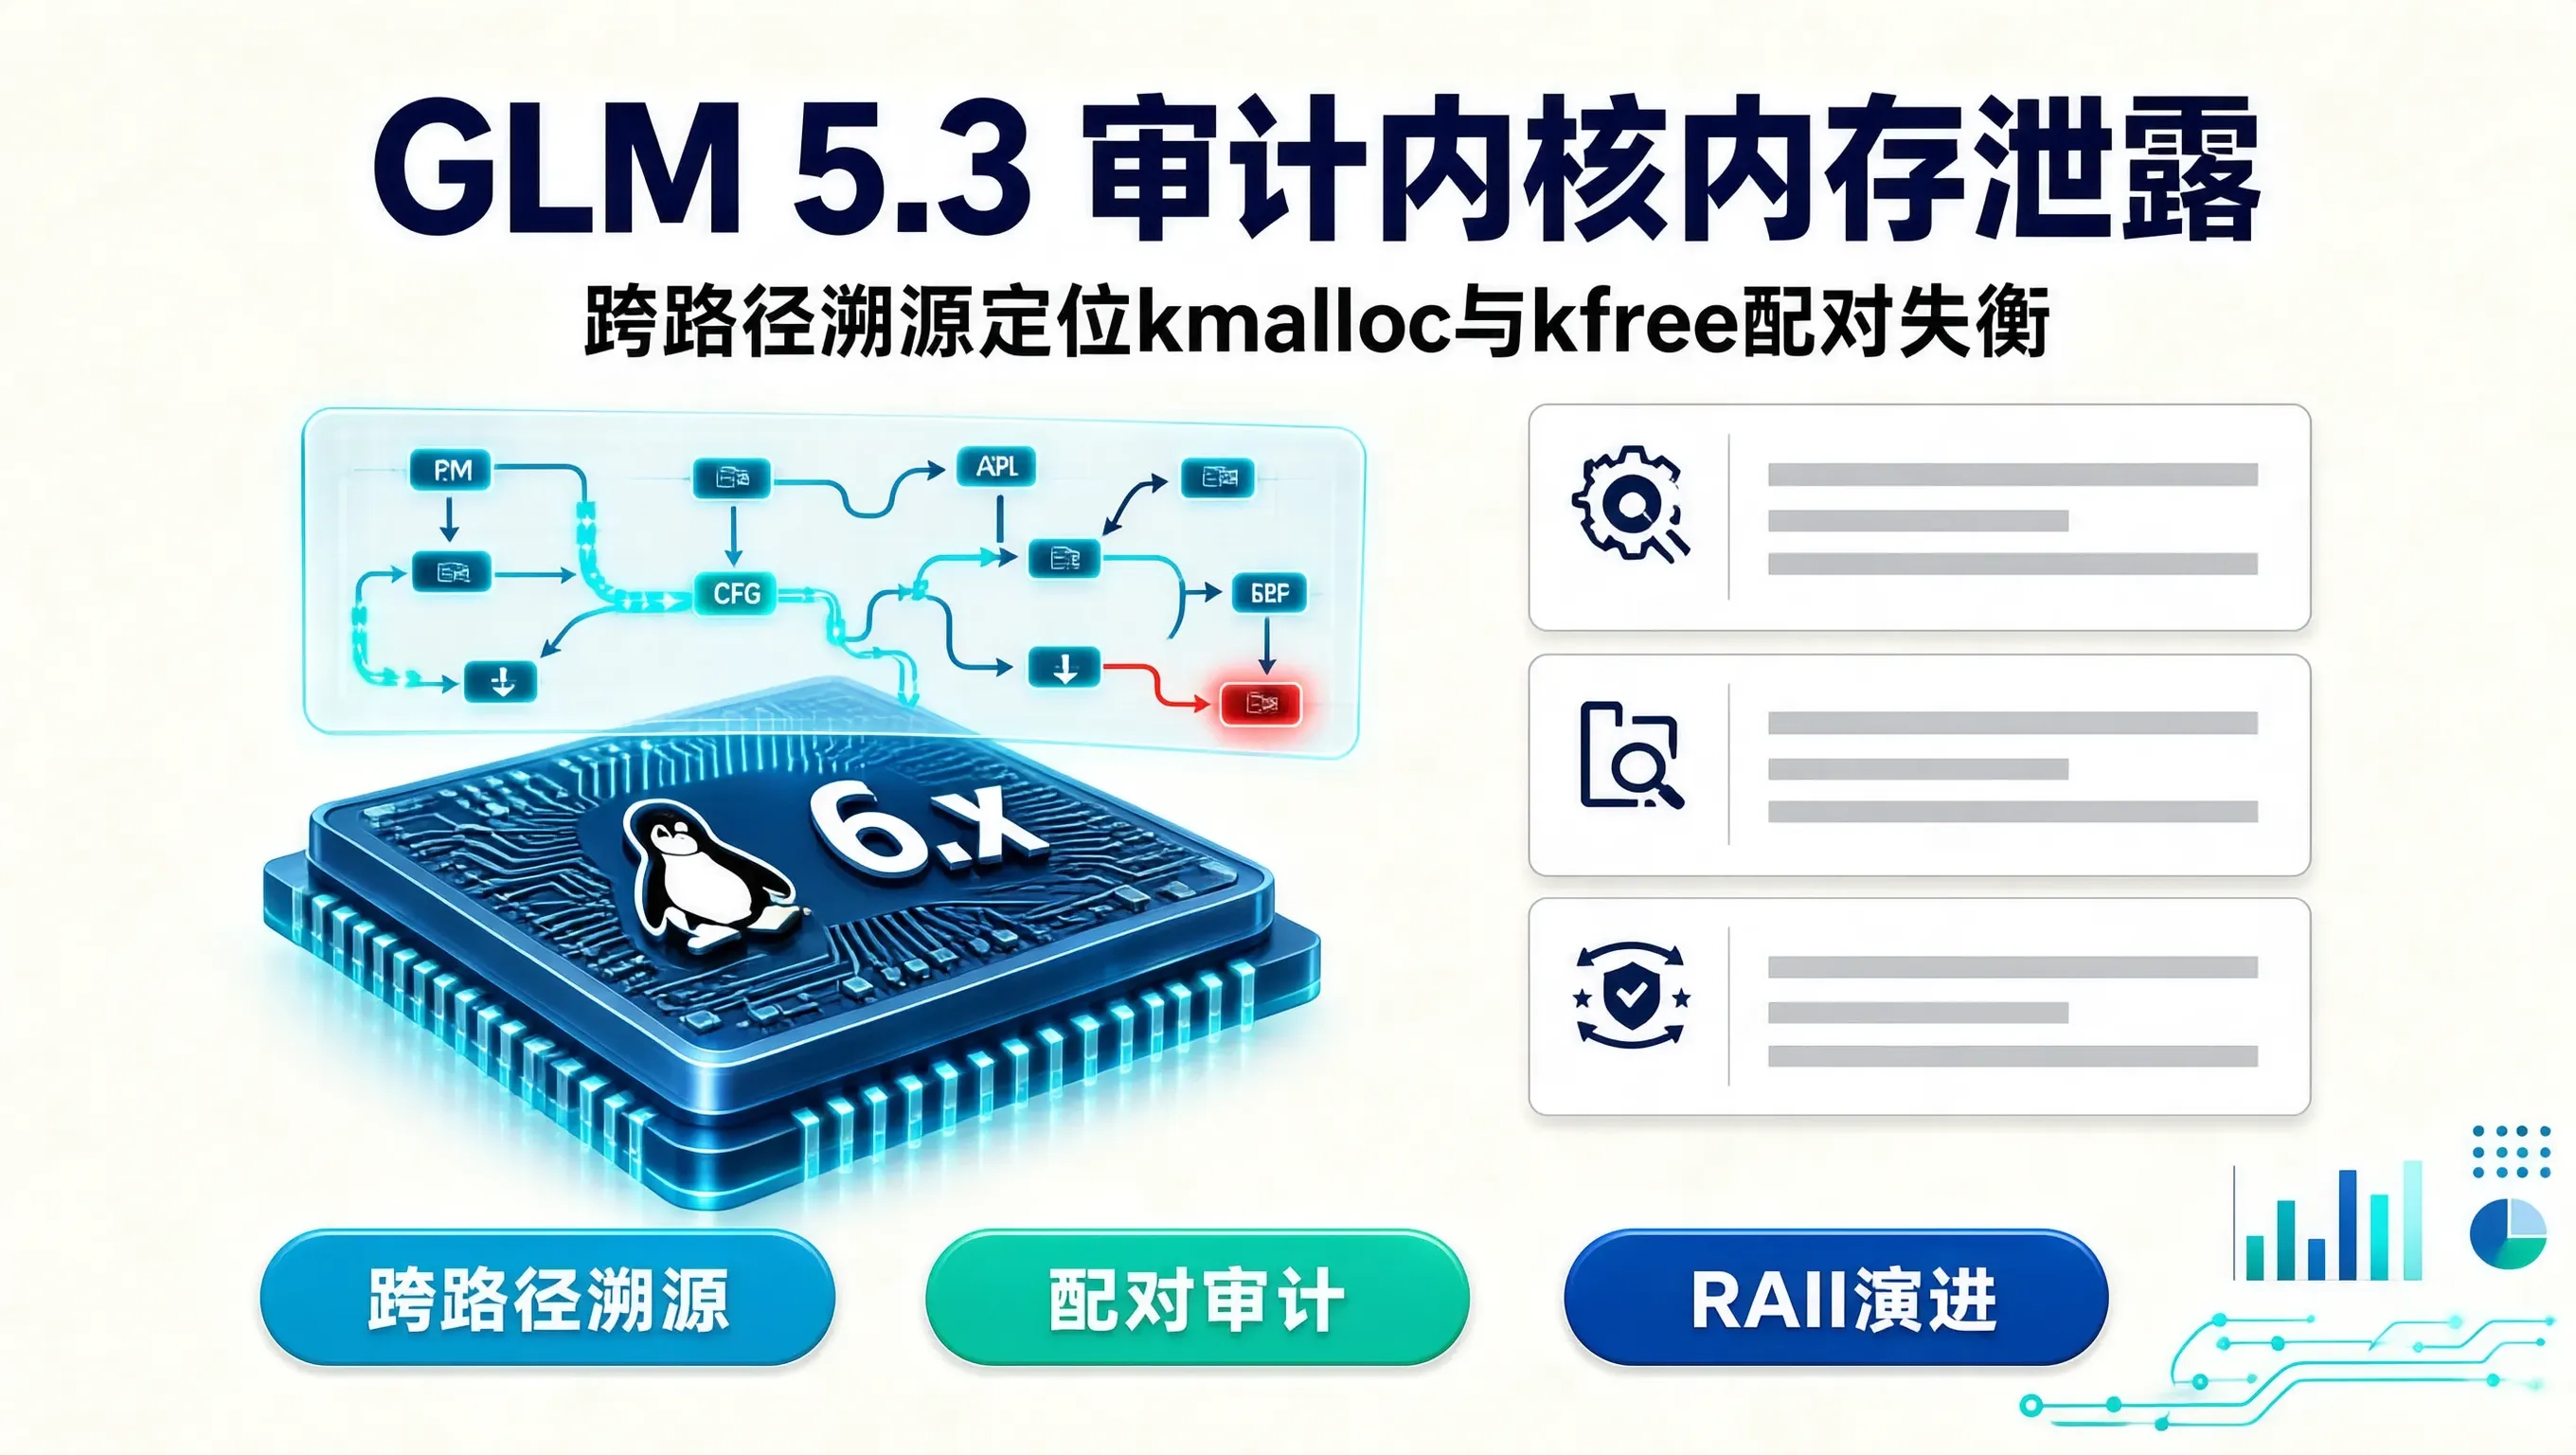
在 Linux 内核驱动和底层子系统开发中,内存泄露往往是最难以在测试阶段完全捕获的恶性缺陷。与用户态应用程序崩溃后操作系统会自动回收整个地址空间不同,内核空间的动态内存泄露(由kmallockzalloc或vmalloc分配但未被释放的内存块)会永久驻留在 slab 分配器或伙伴系统中。随着系统长期运行,可供分配的高阶物理连续页逐步枯竭,最终引发系统级 OOM 或关键服务死锁。更棘手的是,绝大多
在把高并发网关升级到 Java 24 虚拟线程后,很多团队在压测中见证了令人振奋的指标:JVM 堆内存占用极低,哪怕并发调度 50,000 个虚拟线程,堆内存活跃对象也仅占几百兆。然而,在持续进行 3 小时的高压摸高测试后,生产服务器却突然无预警地被操作系统内核杀掉——Linuxdmesg。令人百思不得其解的是,此时 JVM 的监控面板上,堆内存(Heap)使用率甚至还不到 30%,没有任何报警。
很多刚从 Go 或 Erlang 转到 Rust 异步开发的工程师,在编写异步代码时经常会踩进同一个思维误区:误以为出来的协程拥有类似 Go 语言 runtime 的“抢占式调度(Preemptive Scheduling)”。在 Go 1.14 之后,运行时引入了基于操作系统信号(SIGURG)的异步抢占机制,哪怕一个 Goroutine 在执行死循环,调度器也能强行中断并让出执行权。但在 Ru
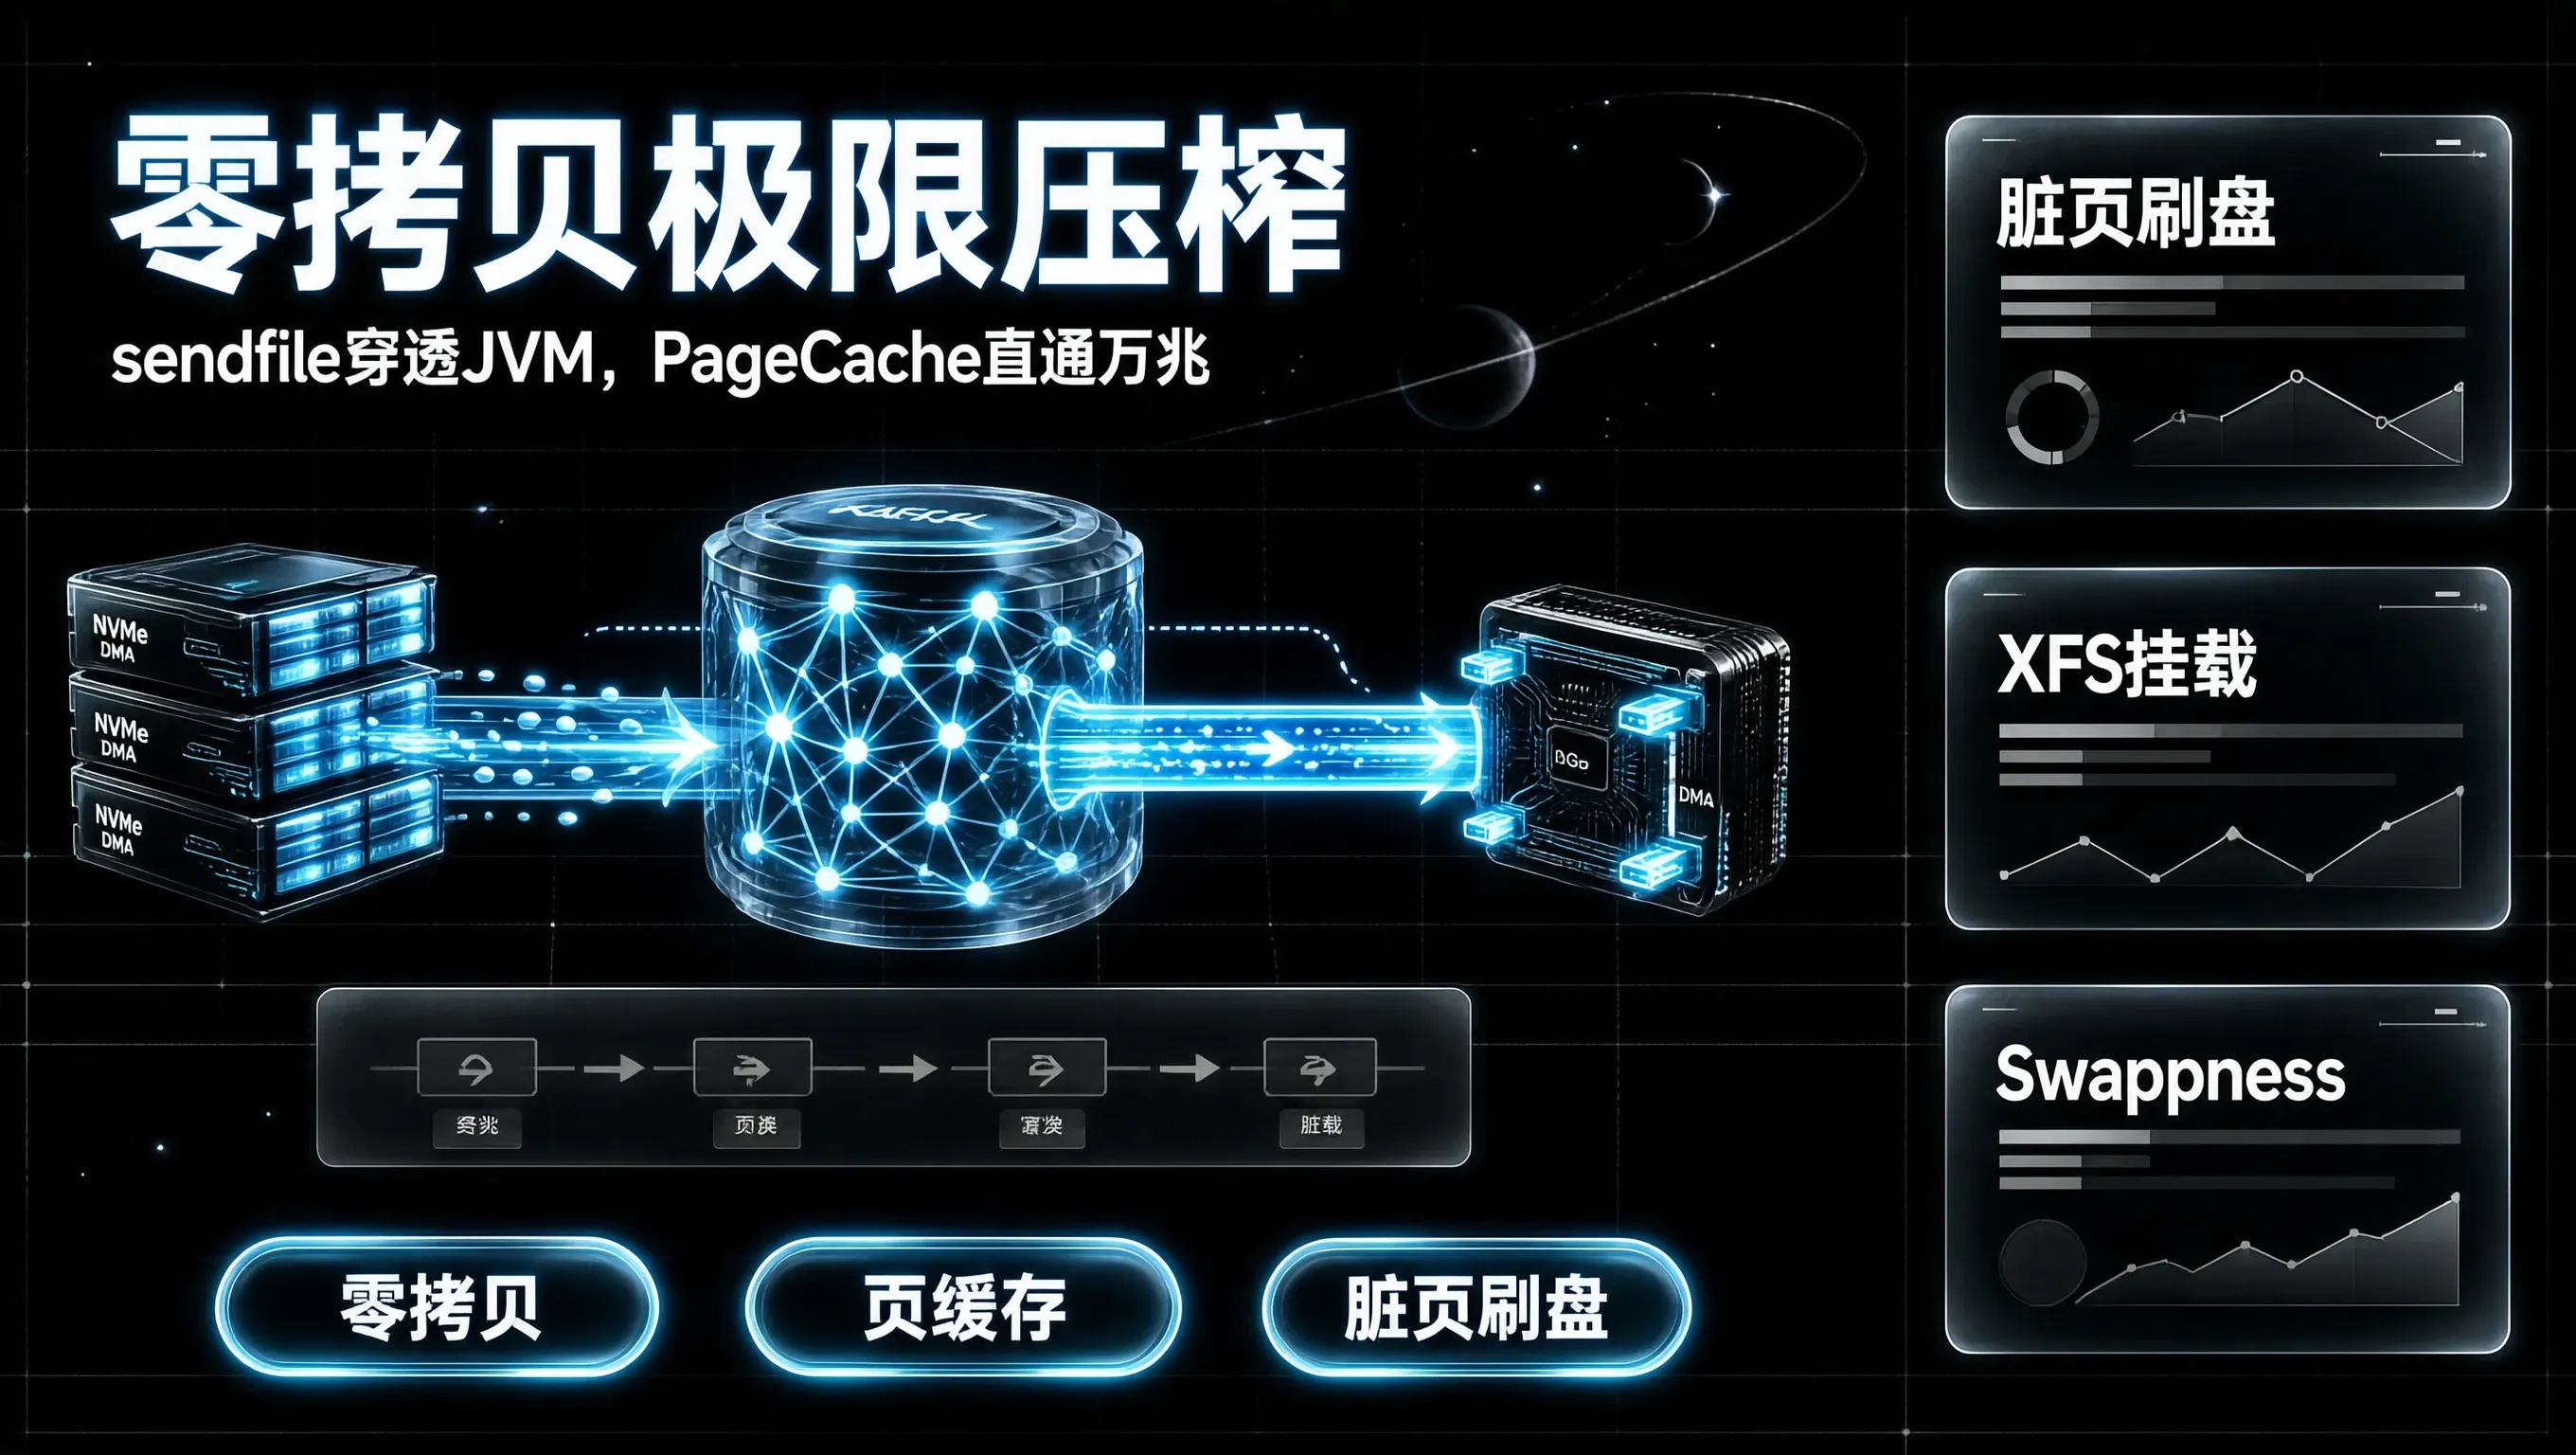
在亿级流量削峰填谷的战场上,Kafka 之所以能够以每秒数百万消息的恐怖速率吞吐海量数据,并不是因为它用 Java 写了多么精巧复杂的内存队列,而在于它极其聪明地做到了“不碰 CPU 和用户态内存”——将繁重的磁盘读写与网络传输工作,全部委托给了操作系统底层的。然而,在很多大促实战中,不少团队发现自建的 Kafka Broker 集群吞吐远远达不到官方标称的水平:磁盘 I/O 利用率早早飙到了 1
构建出来的镜像动辄 300MB 到 500MB。。明明二进制文件就放在那里,为什么操作系统却坚称“找不到文件”?因为默认情况下,Rust 采用gnu目标平台进行。你的二进制在启动前,必须依赖宿主操作系统提供特定版本的动态链接器(如)以及完全一致的 glibc 共享库。一旦目标容器环境缺失对应的 C 运行时,进程甚至连main函数的第一行代码都走不进去。实现真正“一次编译、到处运行”的云原生交付,终
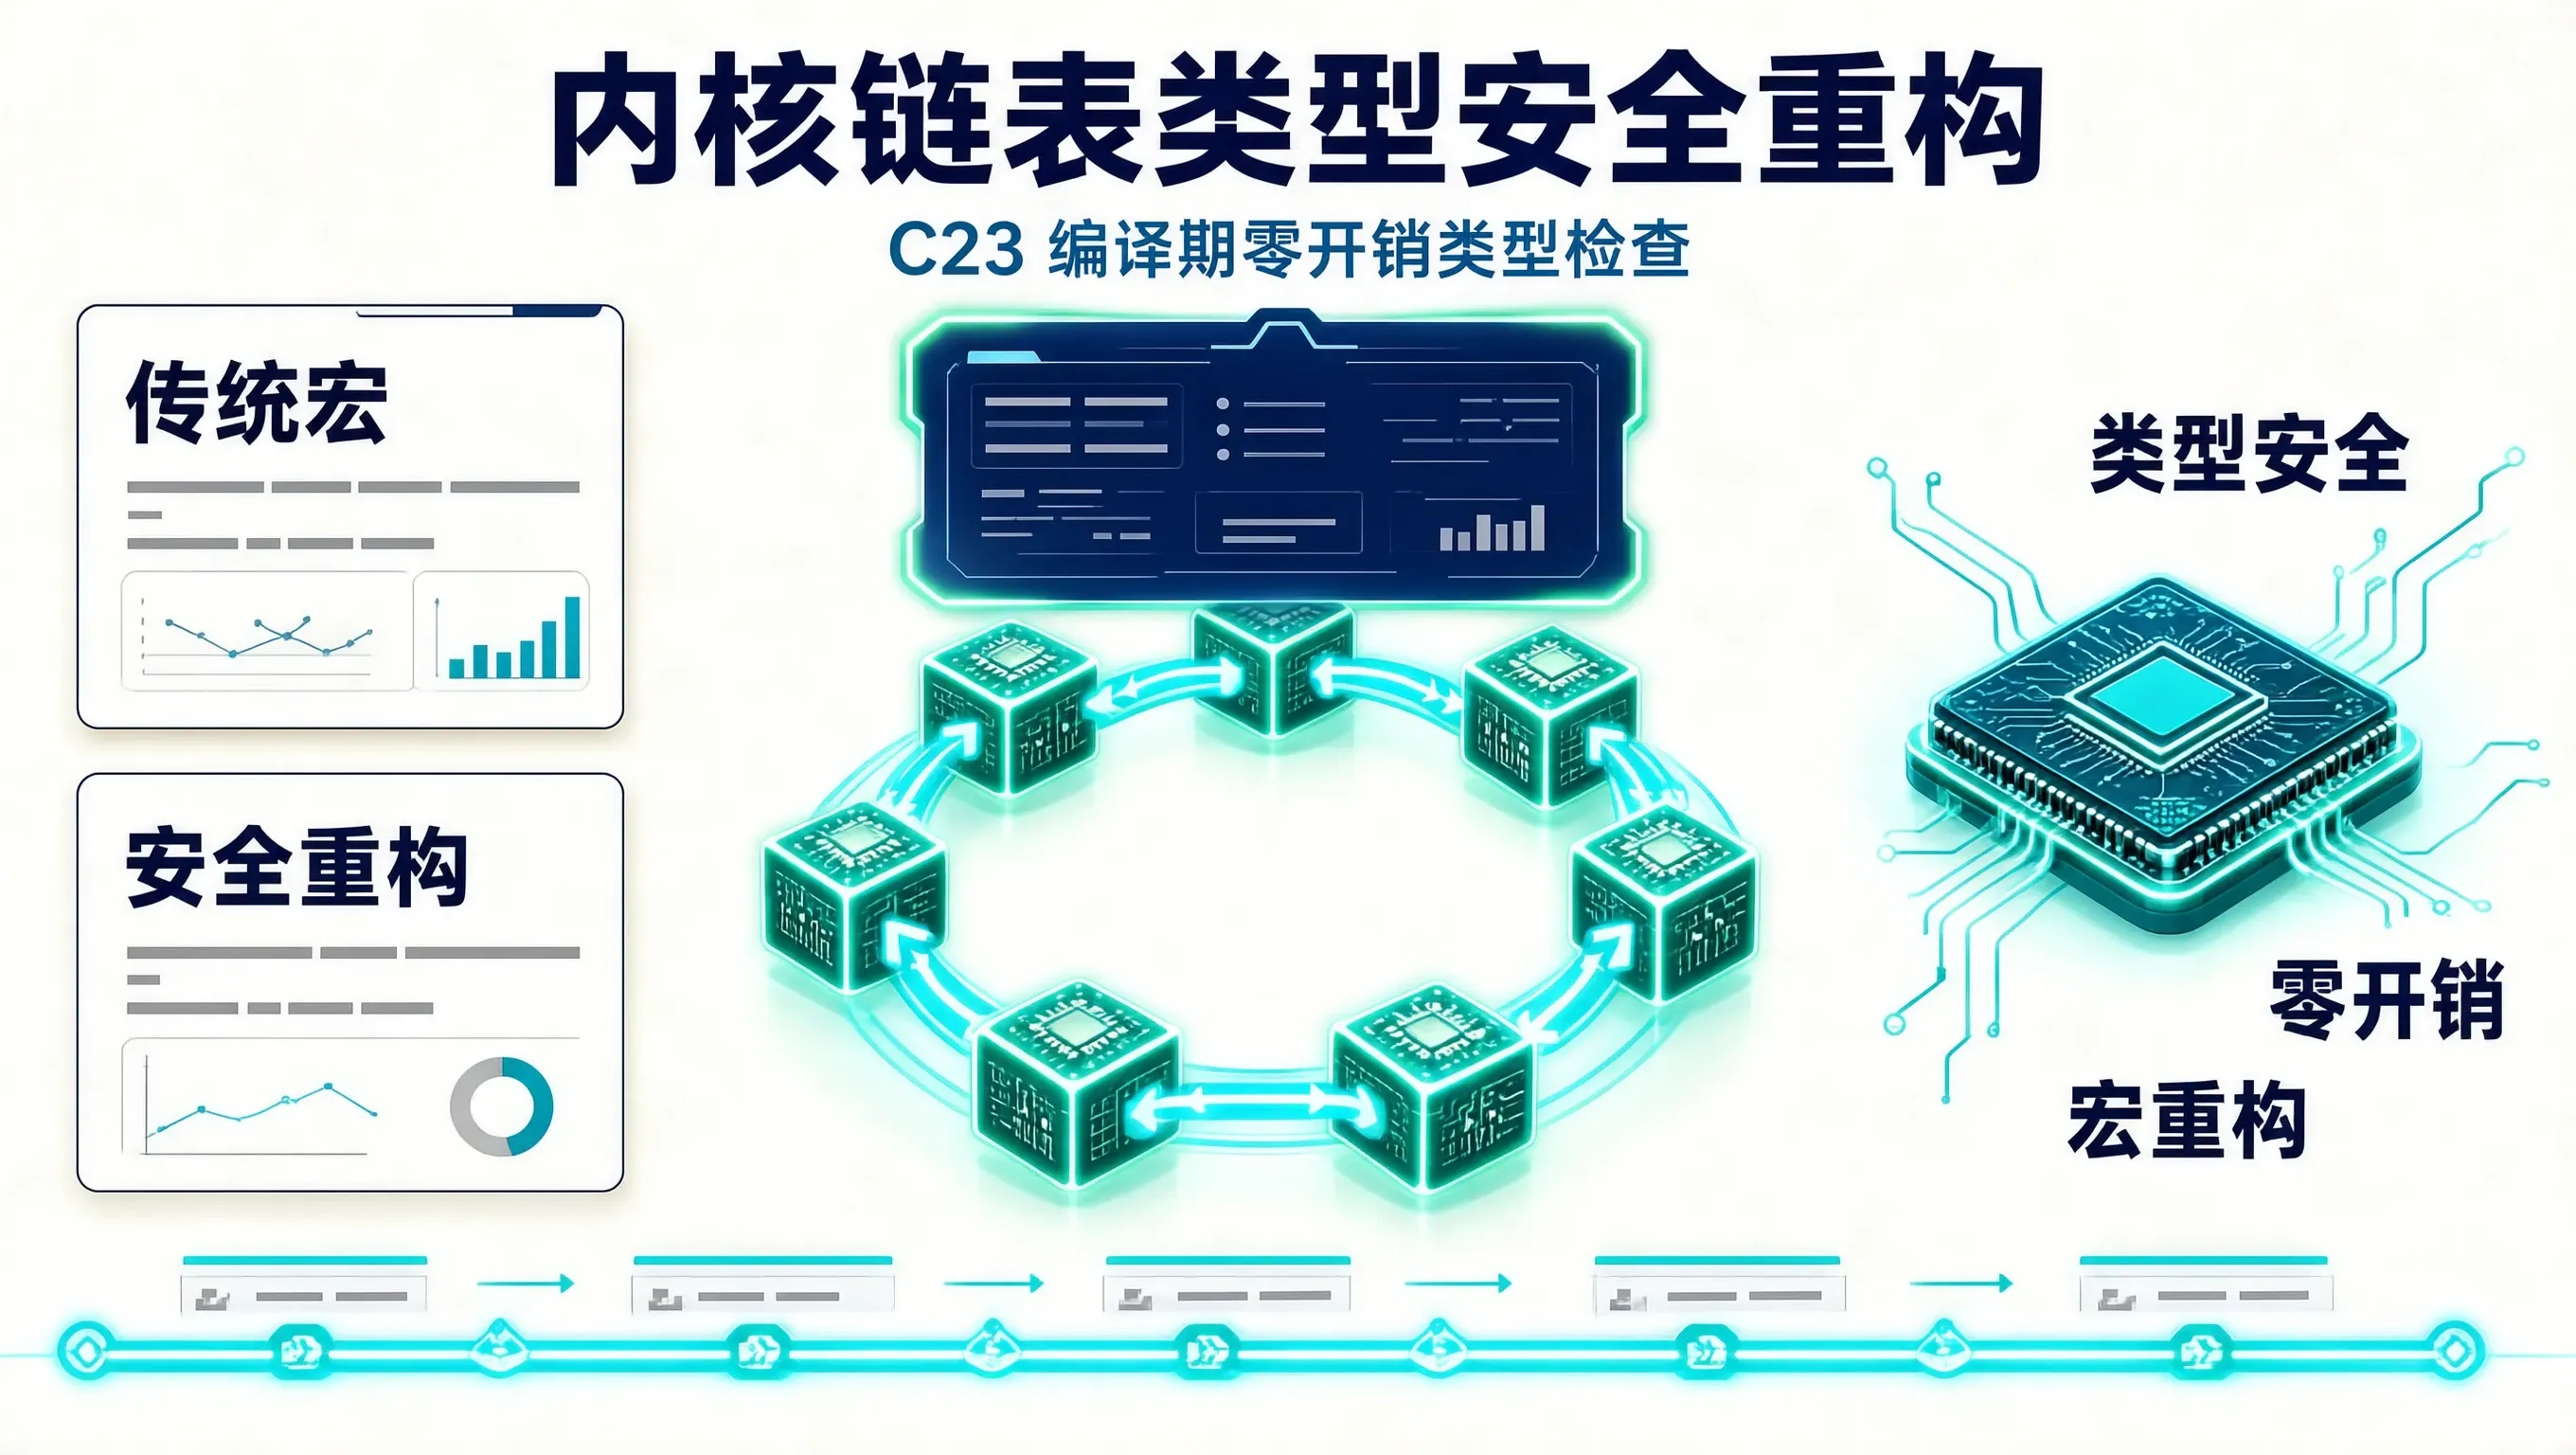
在 Linux 内核开发与底层 C 驱动编写中,侵入式双向循环链表毫无疑问是操作系统历史上最优雅的数据结构设计之一。通过在宿主结构体内部嵌入一个仅包含next和prev指针的微型节点,配合宏(基于offsetof计算偏移),C 语言开发者在缺乏现代面向对象泛型的时代,以极高缓存局部性和极低内存碎片实现了完全通用的链表。然而,这种基于纯指针偏移的通用性,是用彻底出卖编译期类型安全性为代价换来的。在传
在很多工科研究生的背包里,最常见的装备不是昂贵的高性能移动工作站,而是一台标配 16GB 统一内存的轻薄笔记本。随着开源小参数模型架构的爆发,像 Qwen2.5-7B、DeepSeek-R1-Distill-7B 这类轻量推理模型在权重量化(例如采用 4-bit 的 GGUF Q4_K_M 格式)后,模型权重体积通常可以压缩在 4.5GB 到 5.2GB 之间。初看之下,16GB 的物理内存似乎绰
很多工程师的 Linux 或 macOS 开发环境,都经历过相同的演进路径:刚刚脱离默认的 Bash,被网络上各种绚丽的花哨终端截图吸引,迫不及待地一键安装了oh-my-zsh,然后一股脑把gitdockerkubectlautojumpnvm等二三十个插件全部填进~/.zshrc的数组中。起初的一两周,炫目的色彩图标与看似智能的补全确实带来了新鲜感。终端是工程师与操作系统内核、远程集群直接对话的
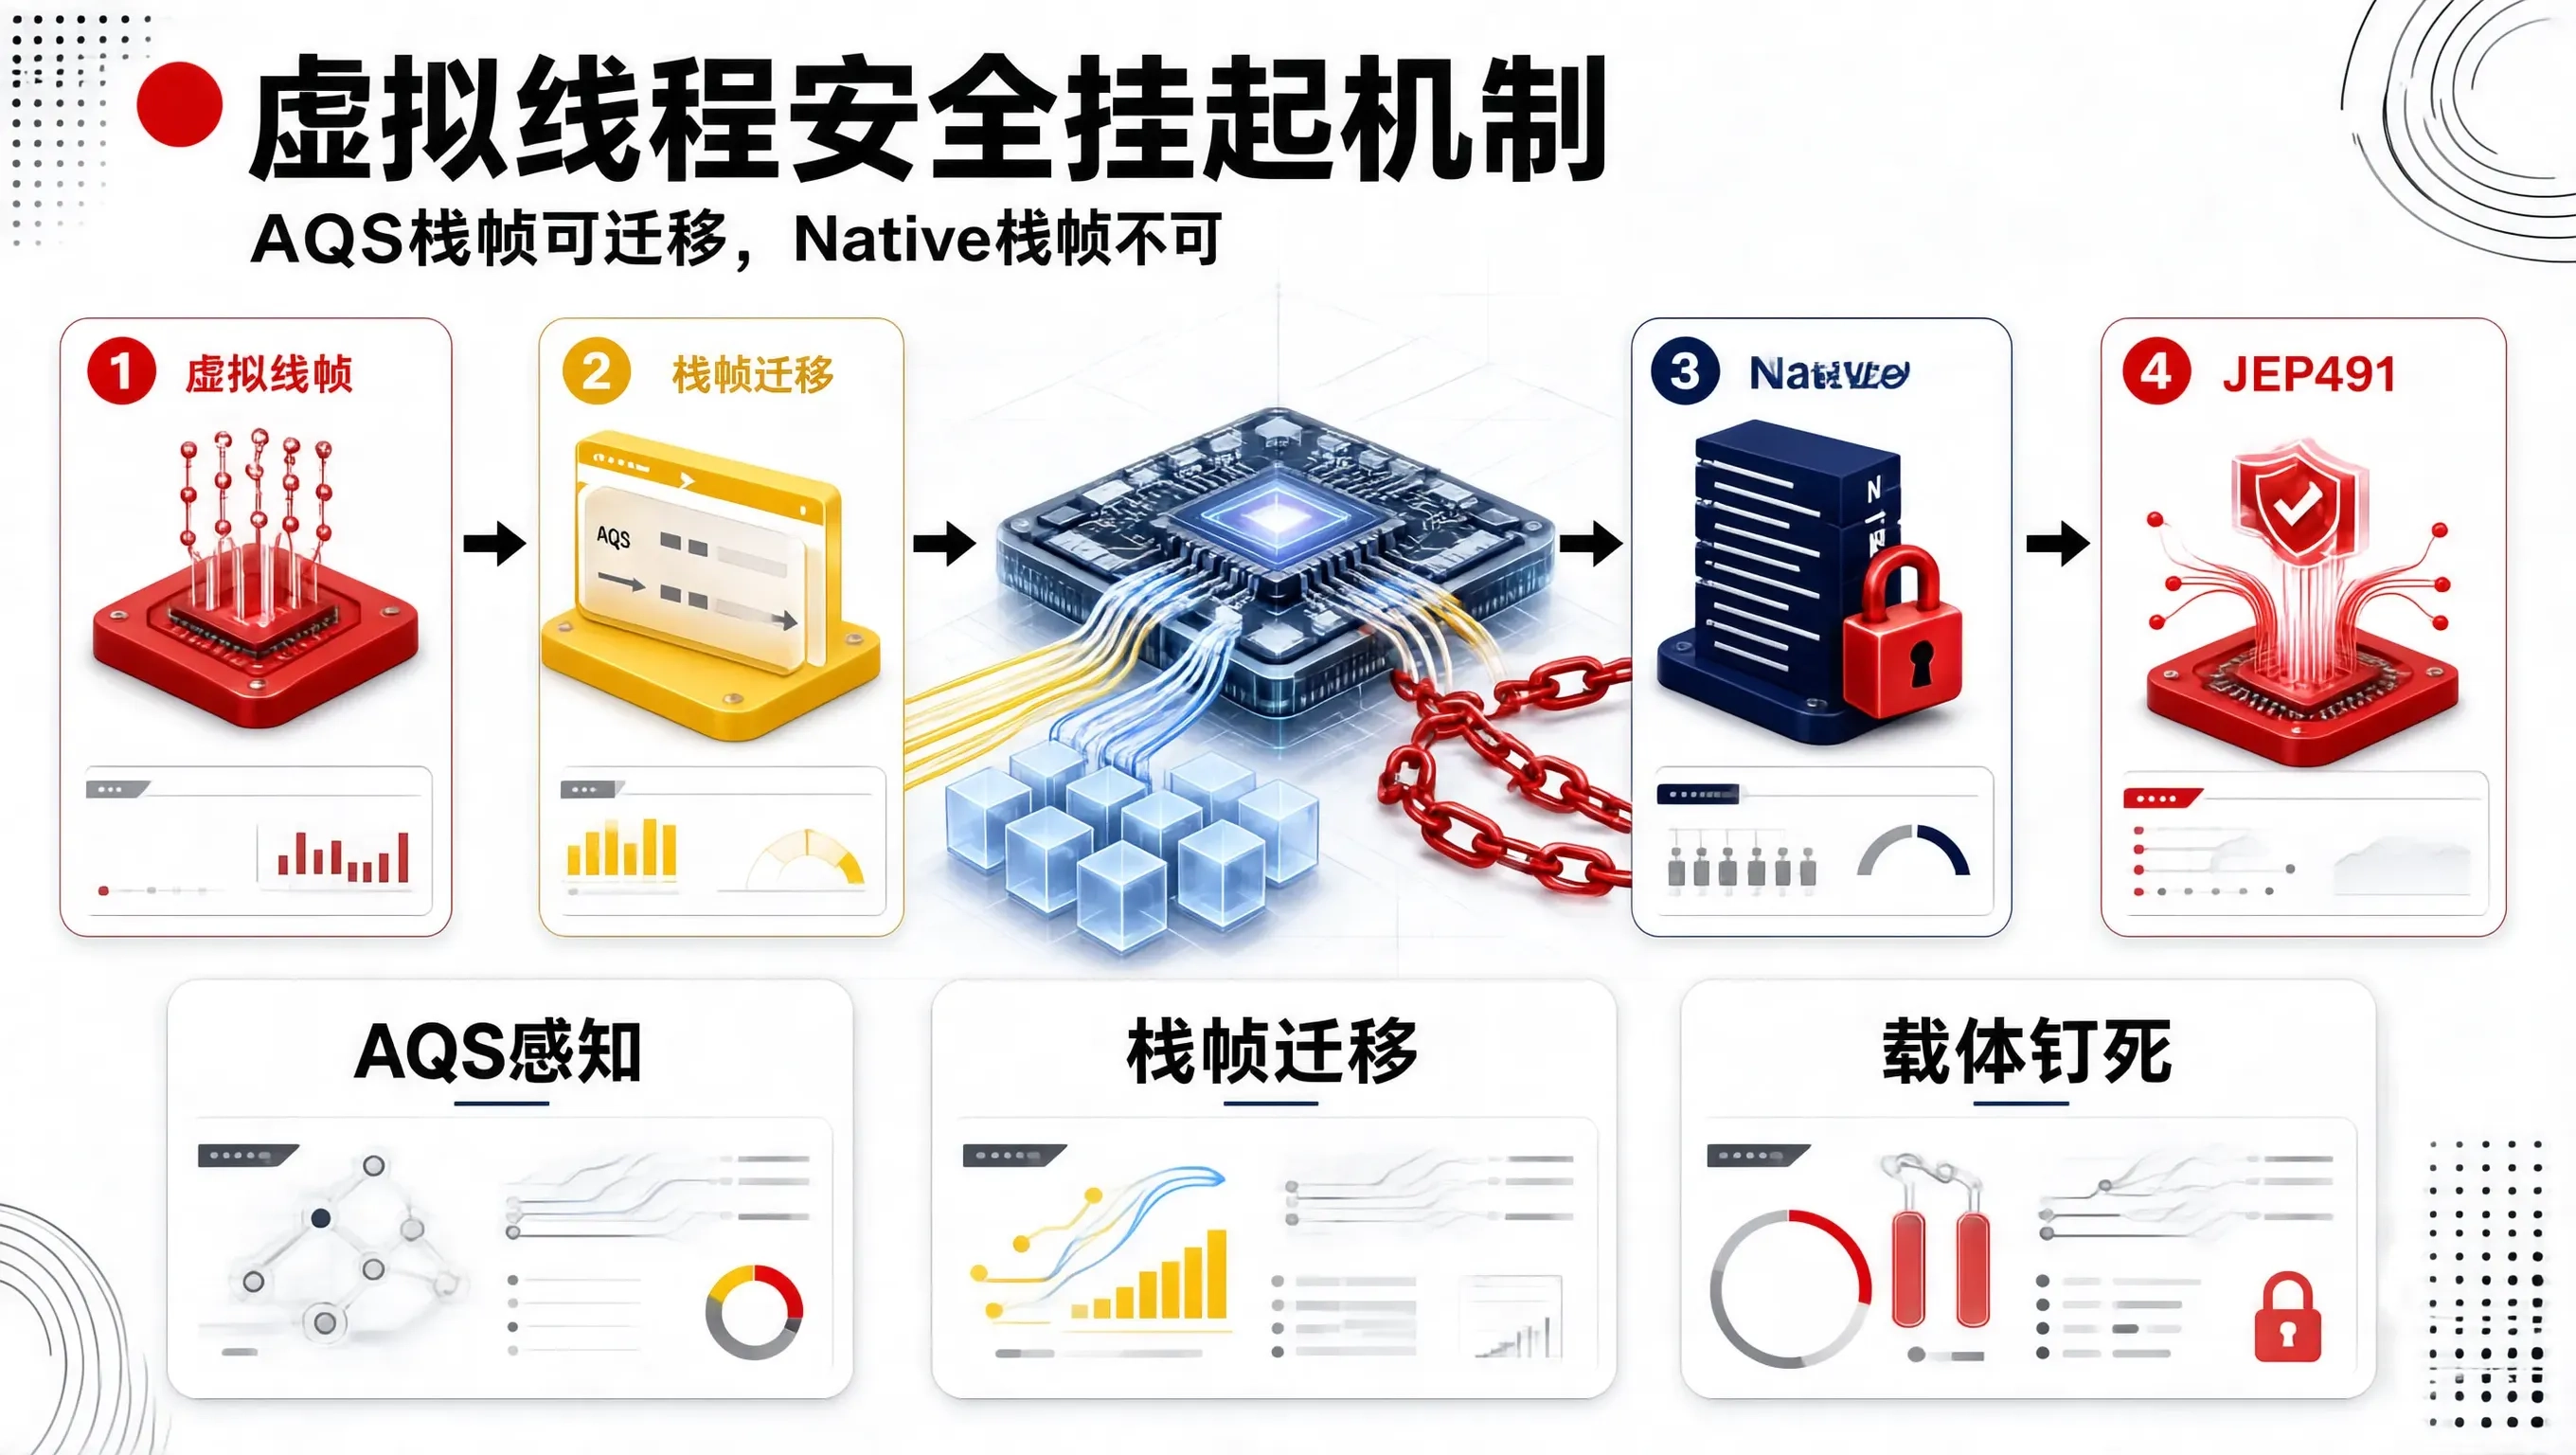
从的重量级演进,到 AQS 的用户态排队,再到虚拟线程时代的无感知卸载,Java 并发模型的每一次跃迁,本质上都是在把昂贵的“内核态调度”向高效廉价的“用户态协作”不断推进。理解 AQS 为什么能天然亲和虚拟线程,不仅能让我们在选型锁机制时避开致命的 Pinning 泥潭,更能让我们看透 JVM 在操作系统调用栈与用户堆栈之间精妙的折中艺术。在分布式和高并发架构里,很多看似诡异的性能暴跌,底色往往
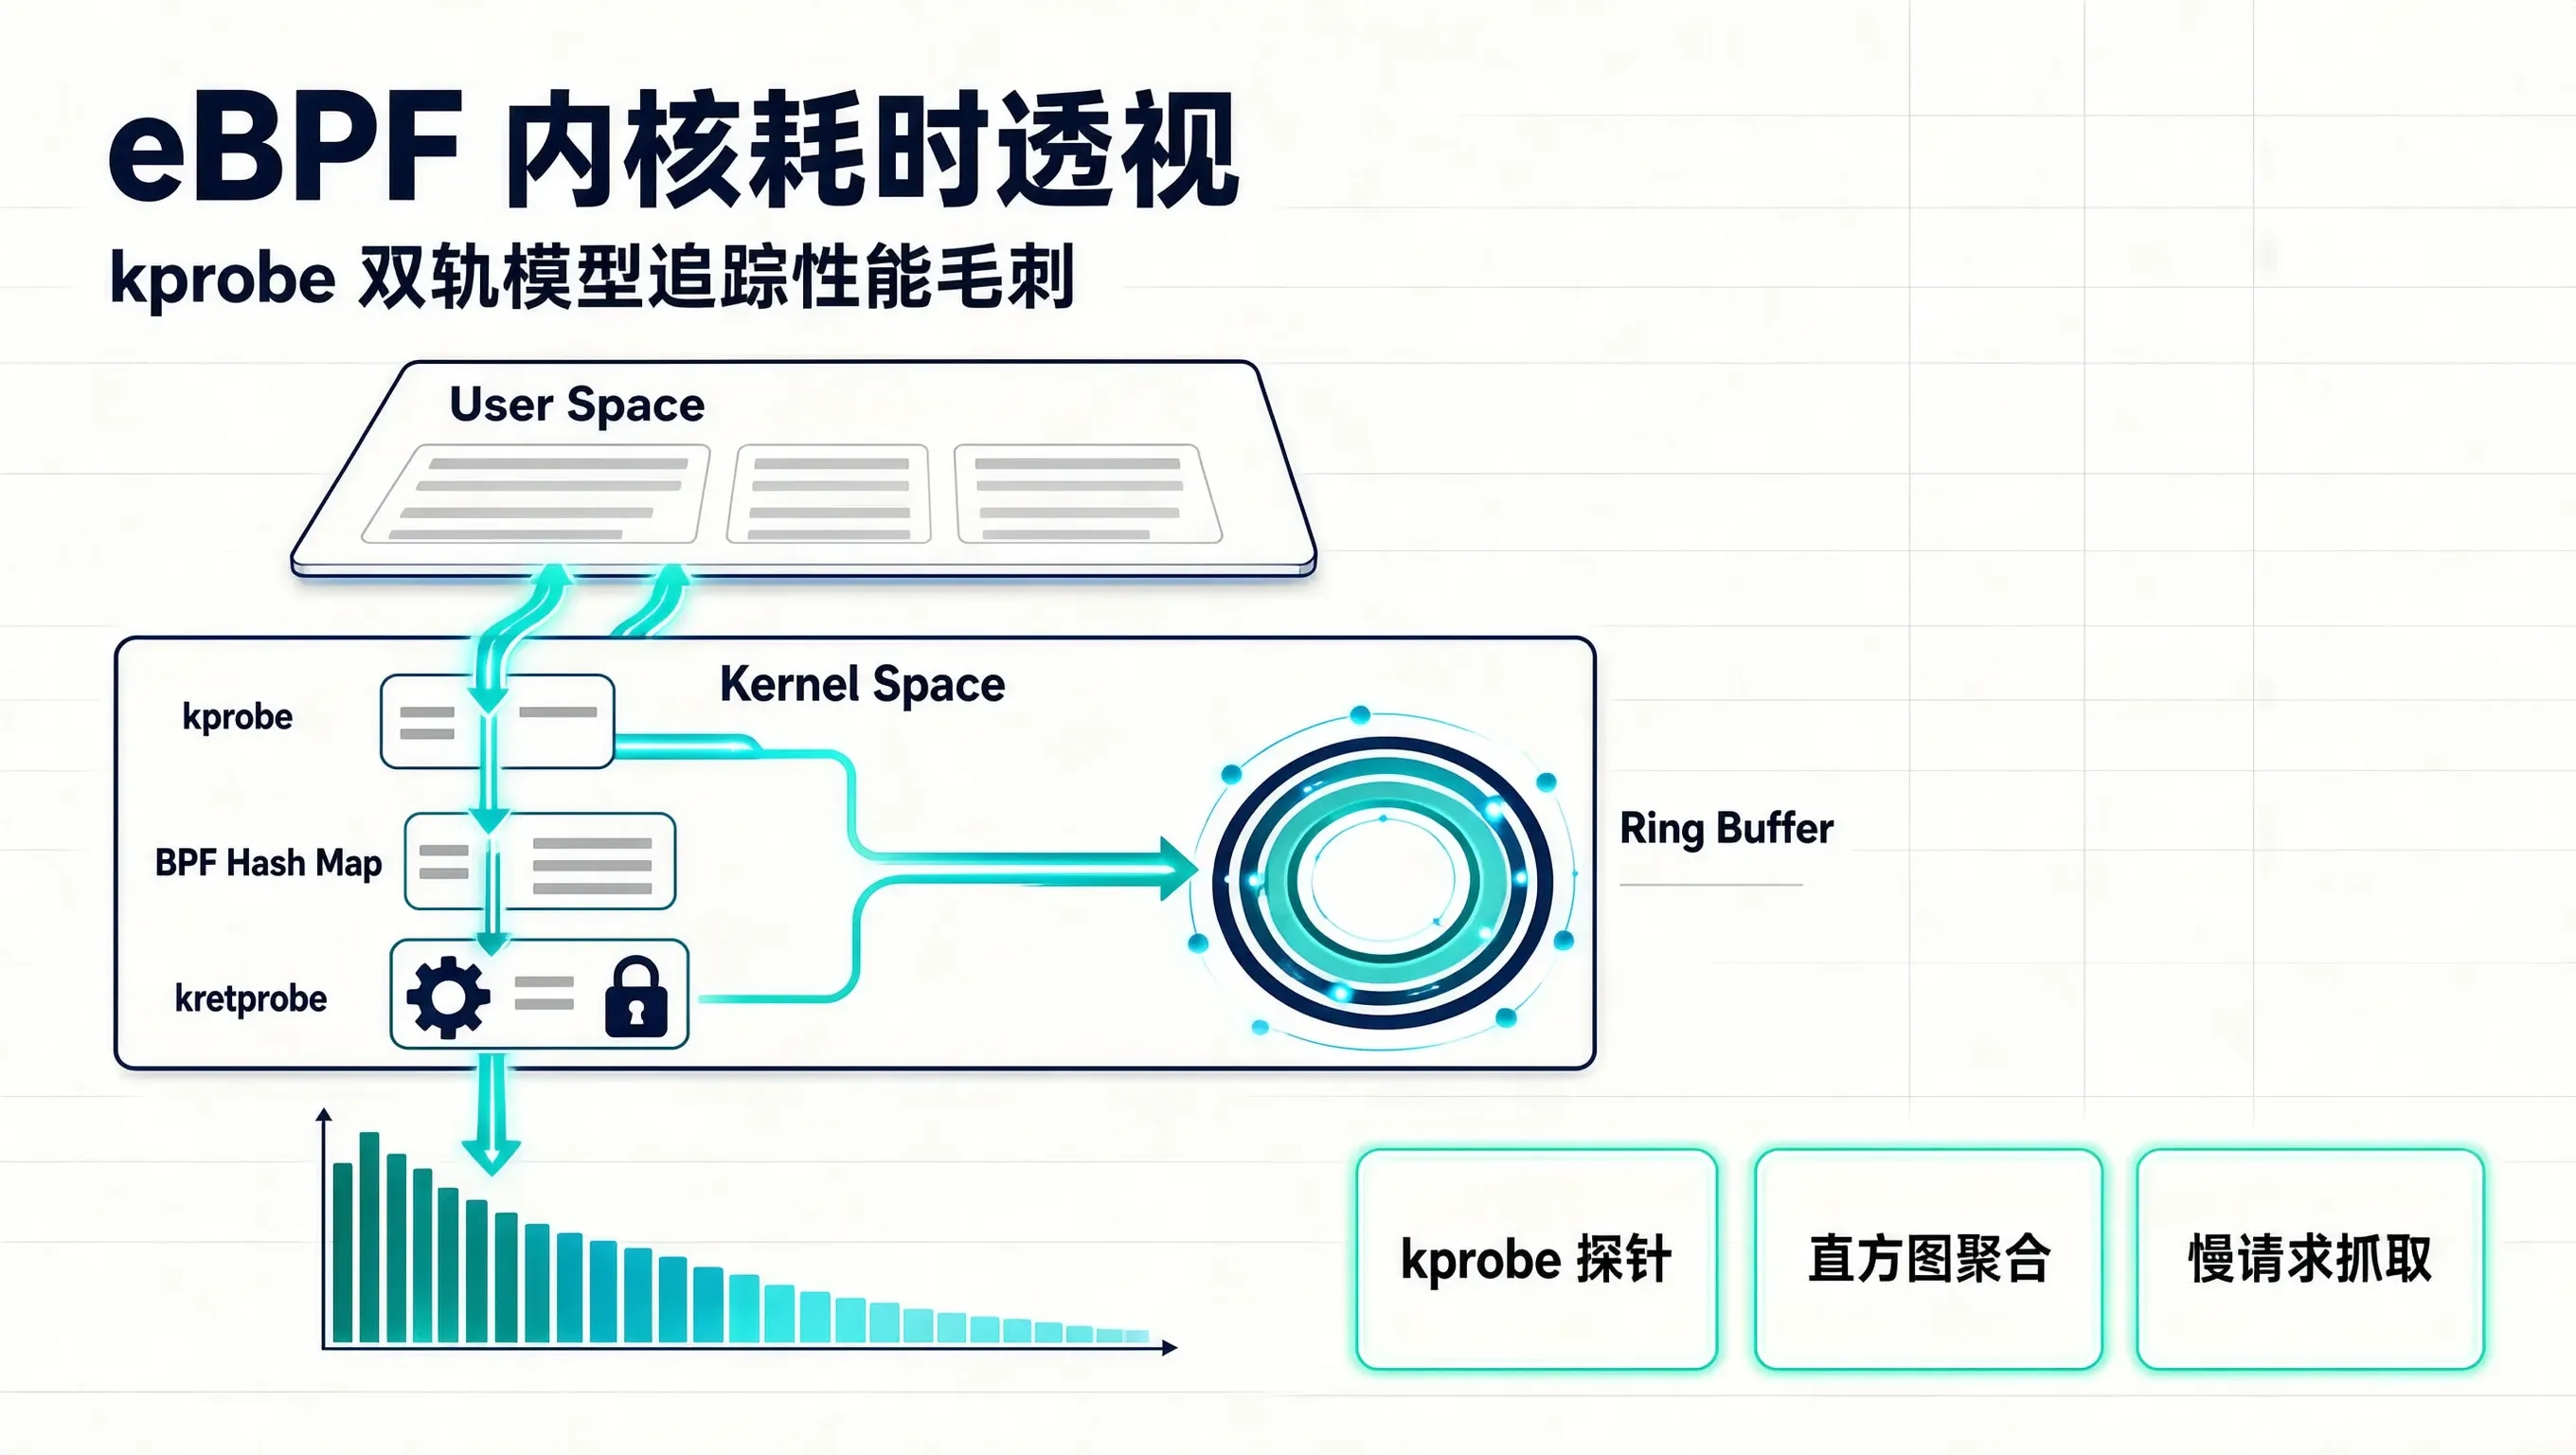
在生产环境高并发网关或高性能存储引擎的排障过程中,最让一线系统工程师头疼的莫过于偶发性 P99/P999 延迟抖动。监控大盘上业务吞吐正常,平均响应时间不过两三毫秒,但时不时就会出现耗时几百毫秒甚至数秒的毛刺请求。业务研发在应用层打满日志,也只能定位到某一行read()write()或阻塞,至于操作系统内核在这几百毫秒内究竟在干什么、是在等待自旋锁、陷入了直接内存回收(direct reclaim
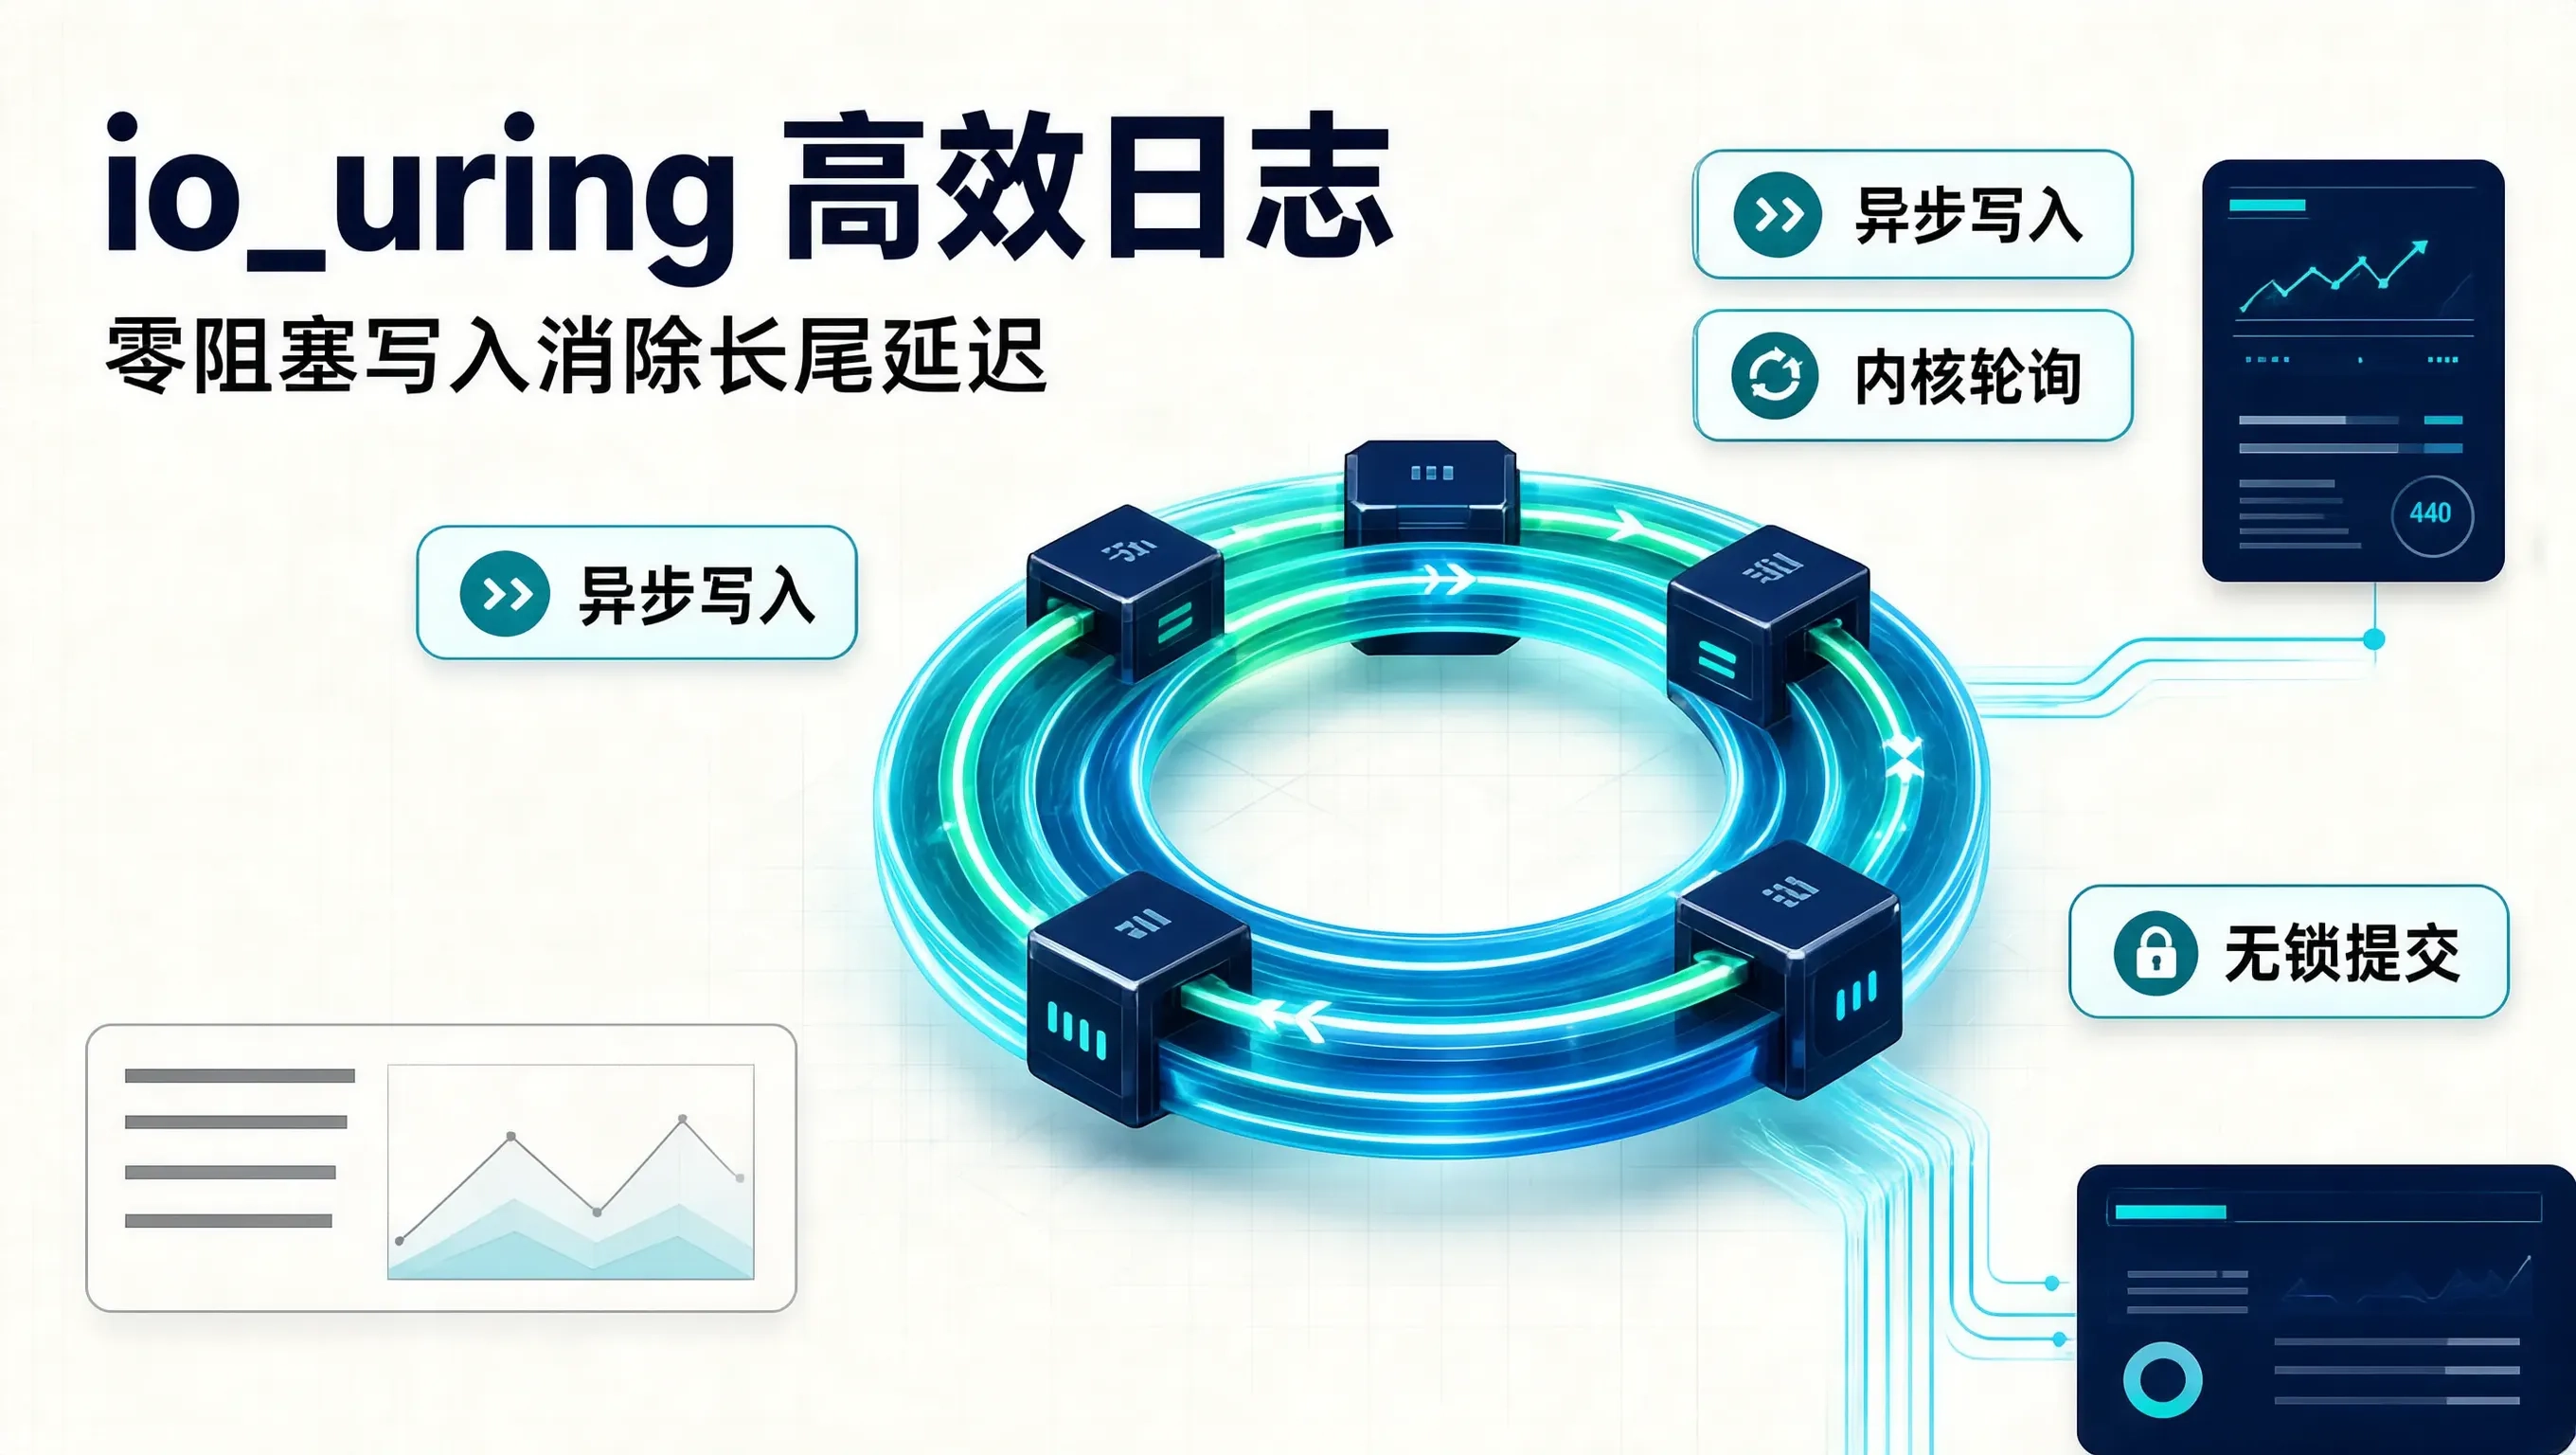
在微秒级延迟敏感的高性能网络网关与交易撮合系统中,一个极具讽刺意味的事实是:业务逻辑的运算可能只需要 5 微秒,但随手调用的一行看似轻量级的write()或fwrite()日志打点,却动辄导致主处理线程陷入长达十几毫秒的内核挂起。传统 Linux 文件 I/O 的本质是“伪异步”的。哪怕我们以普通模式打开文件,将日志写入操作系统页缓存(Page Cache),只要系统产生脏页的速度逼近了阈值,内核
本期日报聚焦 AI 基础设施开源进展、操作系统安全策略变更、最新语言模型工程指南、企业级自动化效能案例以及搜索领域的法律判例。以下为今日五个关键事件的详细解读与技术分析。 Meta 正式开源了用于构建 Muse 智能设备的软件代码,使开发者能够基于该公司的新一代 AI 代理技术自主创建硬件集成项目 1 。此次开源举措降低了开发门槛,鼓励社区探索超越官方形态的多样化用例。官方提供的参考实现涵盖了多种
翻过日历的最后一页,2026 年的九月正式画上了句号。回望这整整一个月,我们在 CSDN 上完成了整整 300 篇高质量技术与商业专栏的沉淀与输出。这不仅是一场高强度的思想冲刺,更是我对过去十年从操作系统与嵌入式底层开发、走向产品经理、再到科技创业历程的一次彻底的体系化梳理。
借鉴操作系统的虚拟内存分页机制,将 KV Cache 连续存储要求转化为非连续的物理块链表,显存碎片率从 75% 骤降至3.8%;结合 AWQ 保护显著权重神经元,以极低精度损耗将千亿模型显存占用砍半。算力是人工智能时代最宝贵的石油,而云原生架构则是炼化这一澎湃动力的终极发动机。在“云原生 AI 应用部署”专栏中,我们用 30 篇严丝合缝的工业级实践,向大家展示了如何把每一张昂贵的 GPU 显卡、
过去两年,科技界讨论最多的是“AI Agent 如何颠覆上层应用”。在传统的冯·诺依曼架构与 POSIX 标准中,操作系统的核心抽象是:进程(Process)、虚拟内存(VMA)、文件描述符(FD)和线程调度器(Scheduler)。所有的设计假设都基于“确定性的指令执行”与“精确的资源配额”。而大模型的引入,带来了前所未有的非确定性、超大规模静态权重寻址、以及对异构算力(CPU/GPU/NPU)
在代码生成大模型能在数秒内写出一个 CRUD 微服务、甚至生成复杂算法实现的今天,经常有年轻工程师问我:“钟姐,现在连上层框架都在被 AI 封装,再去一行行读 Linux 内核的页表映射、锁竞争和调度器源码,到底还有没有意义?
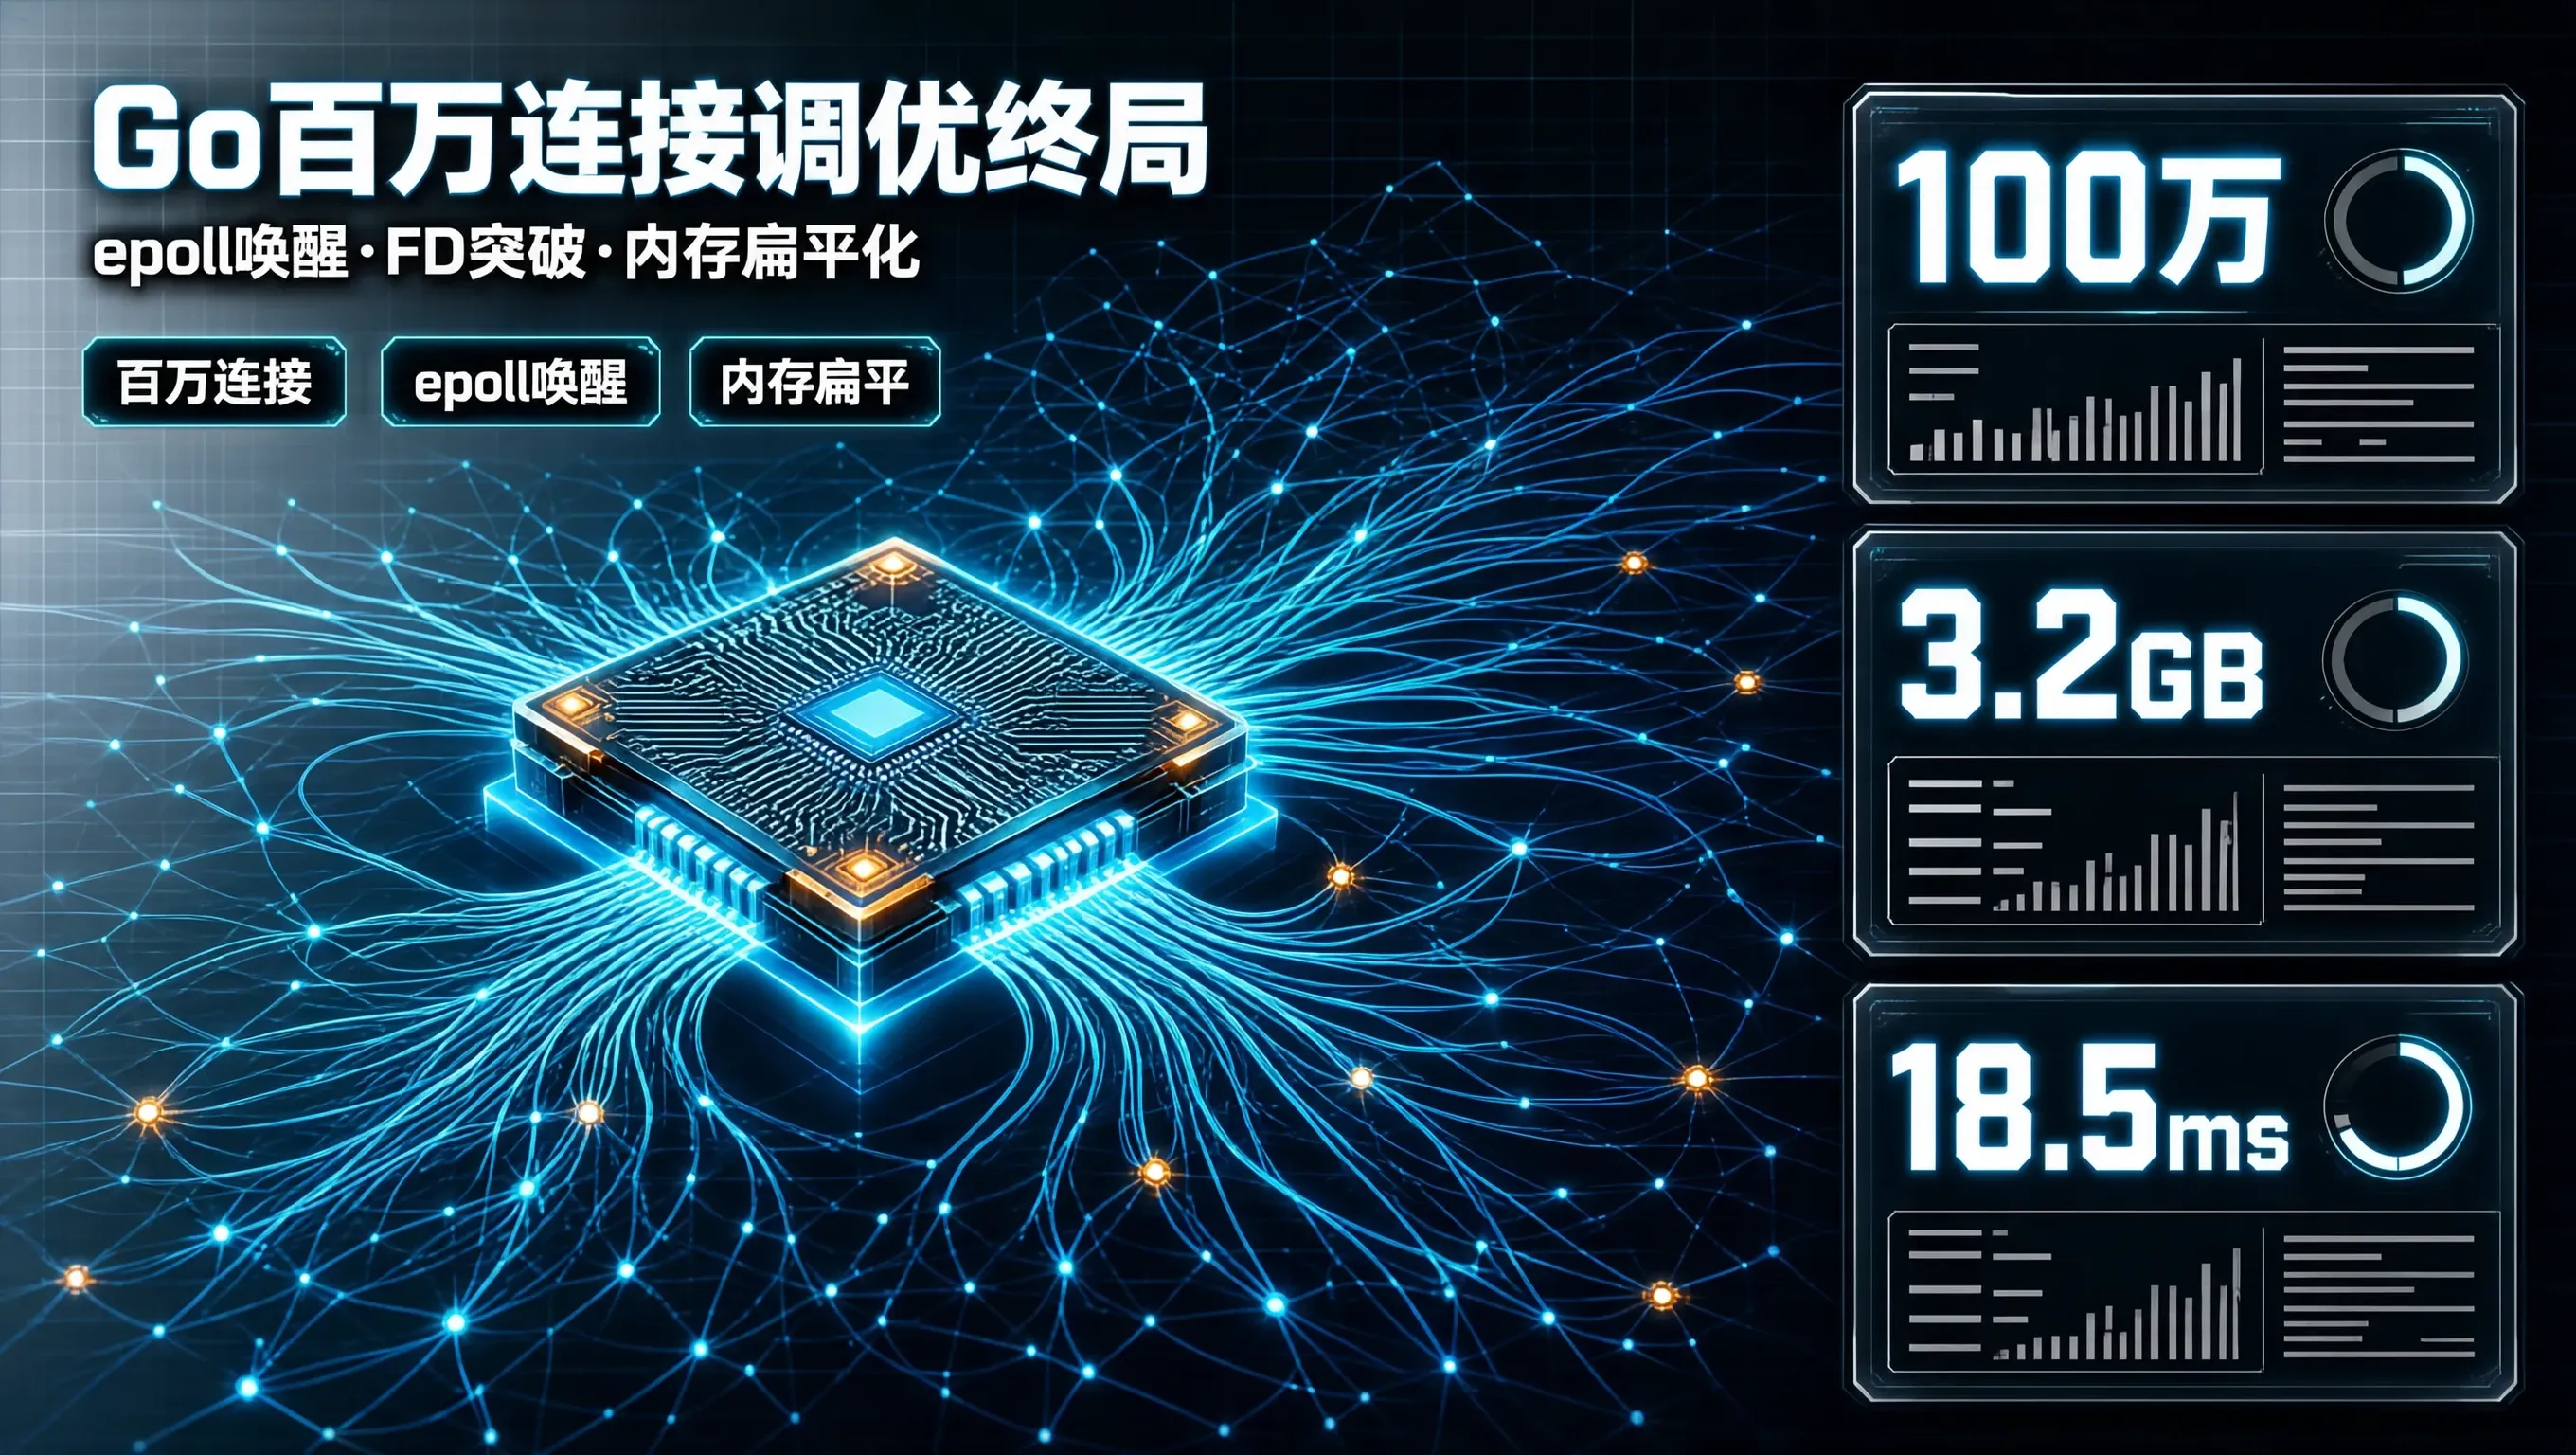
先调内核,再写代码:操作系统内核是承载高并发的地基,FD 上限和 TCP 缓冲区大小是无法逾越的物理红线。海量长连接坚决抛弃“一连接一协程”:在海量空闲连接(如 IoT、消息推送)场景下,Reactor 异步事件驱动是降本增效的终极答案。敬畏内存分配:在网络包编解码中,全面推行sync.Pool字节切片复用,彻底消灭 GC 压力,系统才能在百万并发下波澜不惊。
在万卡并发的超算深水区,系统越复杂,对全局透明度的渴求就越极致。用 eBPF 编织起贯通用户态算子、操作系统内核与物理网卡硬件的全栈感知网络,将每一个纳秒的因果律照耀得清晰透彻,才能在万亿大模型的工业化征途中筑牢坚不可摧的可观测性灯塔。
操作系统是数字世界最厚重、最深沉的大地。九月份整整 30 篇硬核内核调优实录,是我们向计算机底层物理规律发起决绝探索的伟大见证!全网 Linux 操作系统与内核底座已处于历史最强悍、最纯粹的满血稳态,我们将以最硬核的算力底气,护航全站大促战役夺取全胜!
性能调优是一场与底层物理规律的严密对话。把计算机体系结构、操作系统调度与存储介质特性一行一行落实到生产参数中,我们的万亿存储底盘在极限工况下展现出了无可挑剔的极致收敛!
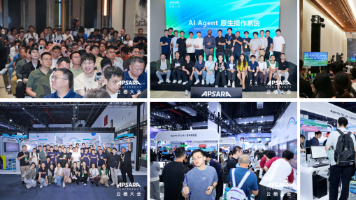
线下展区人潮涌动,超千人参与互动,分论坛现场座无虚席。
50 道深水区真题,串联起了现代后端体系架构从物理硬件、操作系统内核、虚拟机运行时直至分布式集群的完整逻辑链条。在技术面试中,永远不要给出孤立的结论,而是展示出你在复杂系统迷雾中抽丝剥茧、追本溯源的架构思考力。掌握了这 50 道核心底层真题的因果脉络,你便能从容跨越任何顶级大厂技术终面的严苛检验,斩获属于你的高薪 Offer!
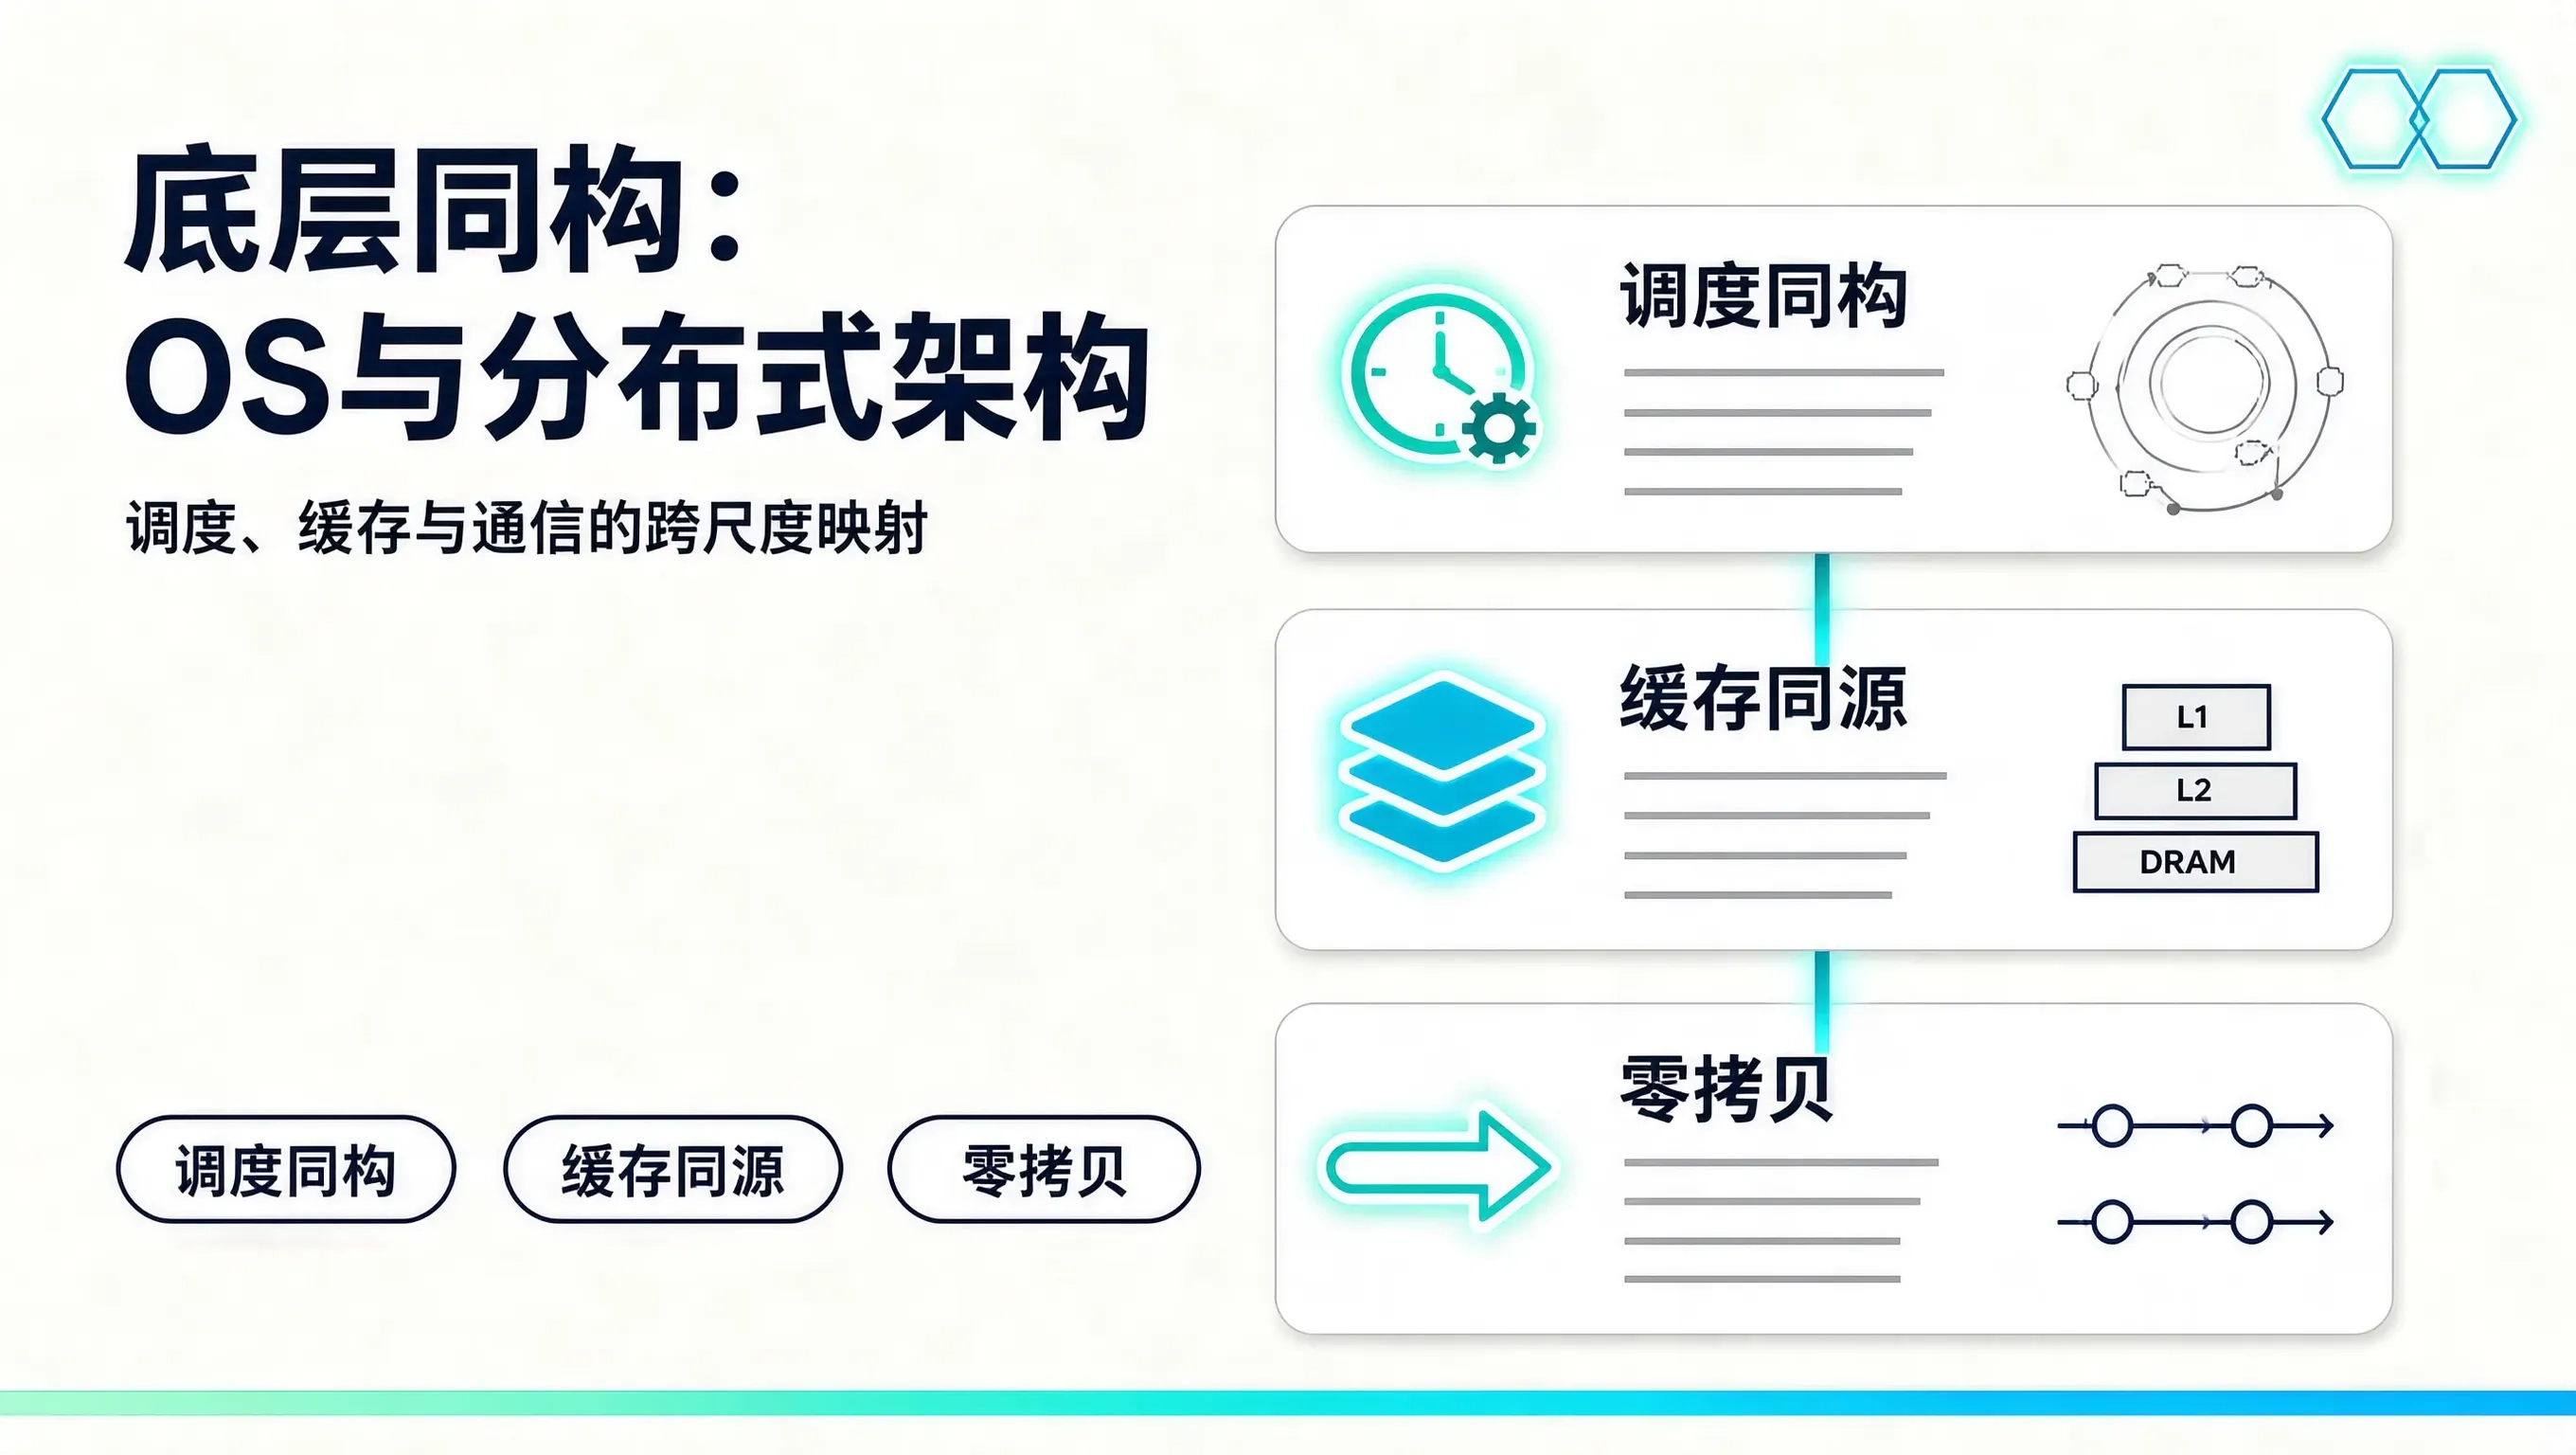
做嵌入式和 Linux 内核开发的前几年,我总觉得分布式系统是另一套完全不同的技术世界:CAP 定理、Raft 共识、微服务网关、分布式缓存。直到后来带团队做分布式后端架构,又转做科技产品,我才猛然意识到:计算机科学发展了半个世纪,真正底层解决“资源分配、并发协作与通信损耗”的核心模型几乎从未改变。现代分布式系统的几乎每一个经典设计模式,都能在 Linux 内核与单机操作系统中找到 1:1 的底层
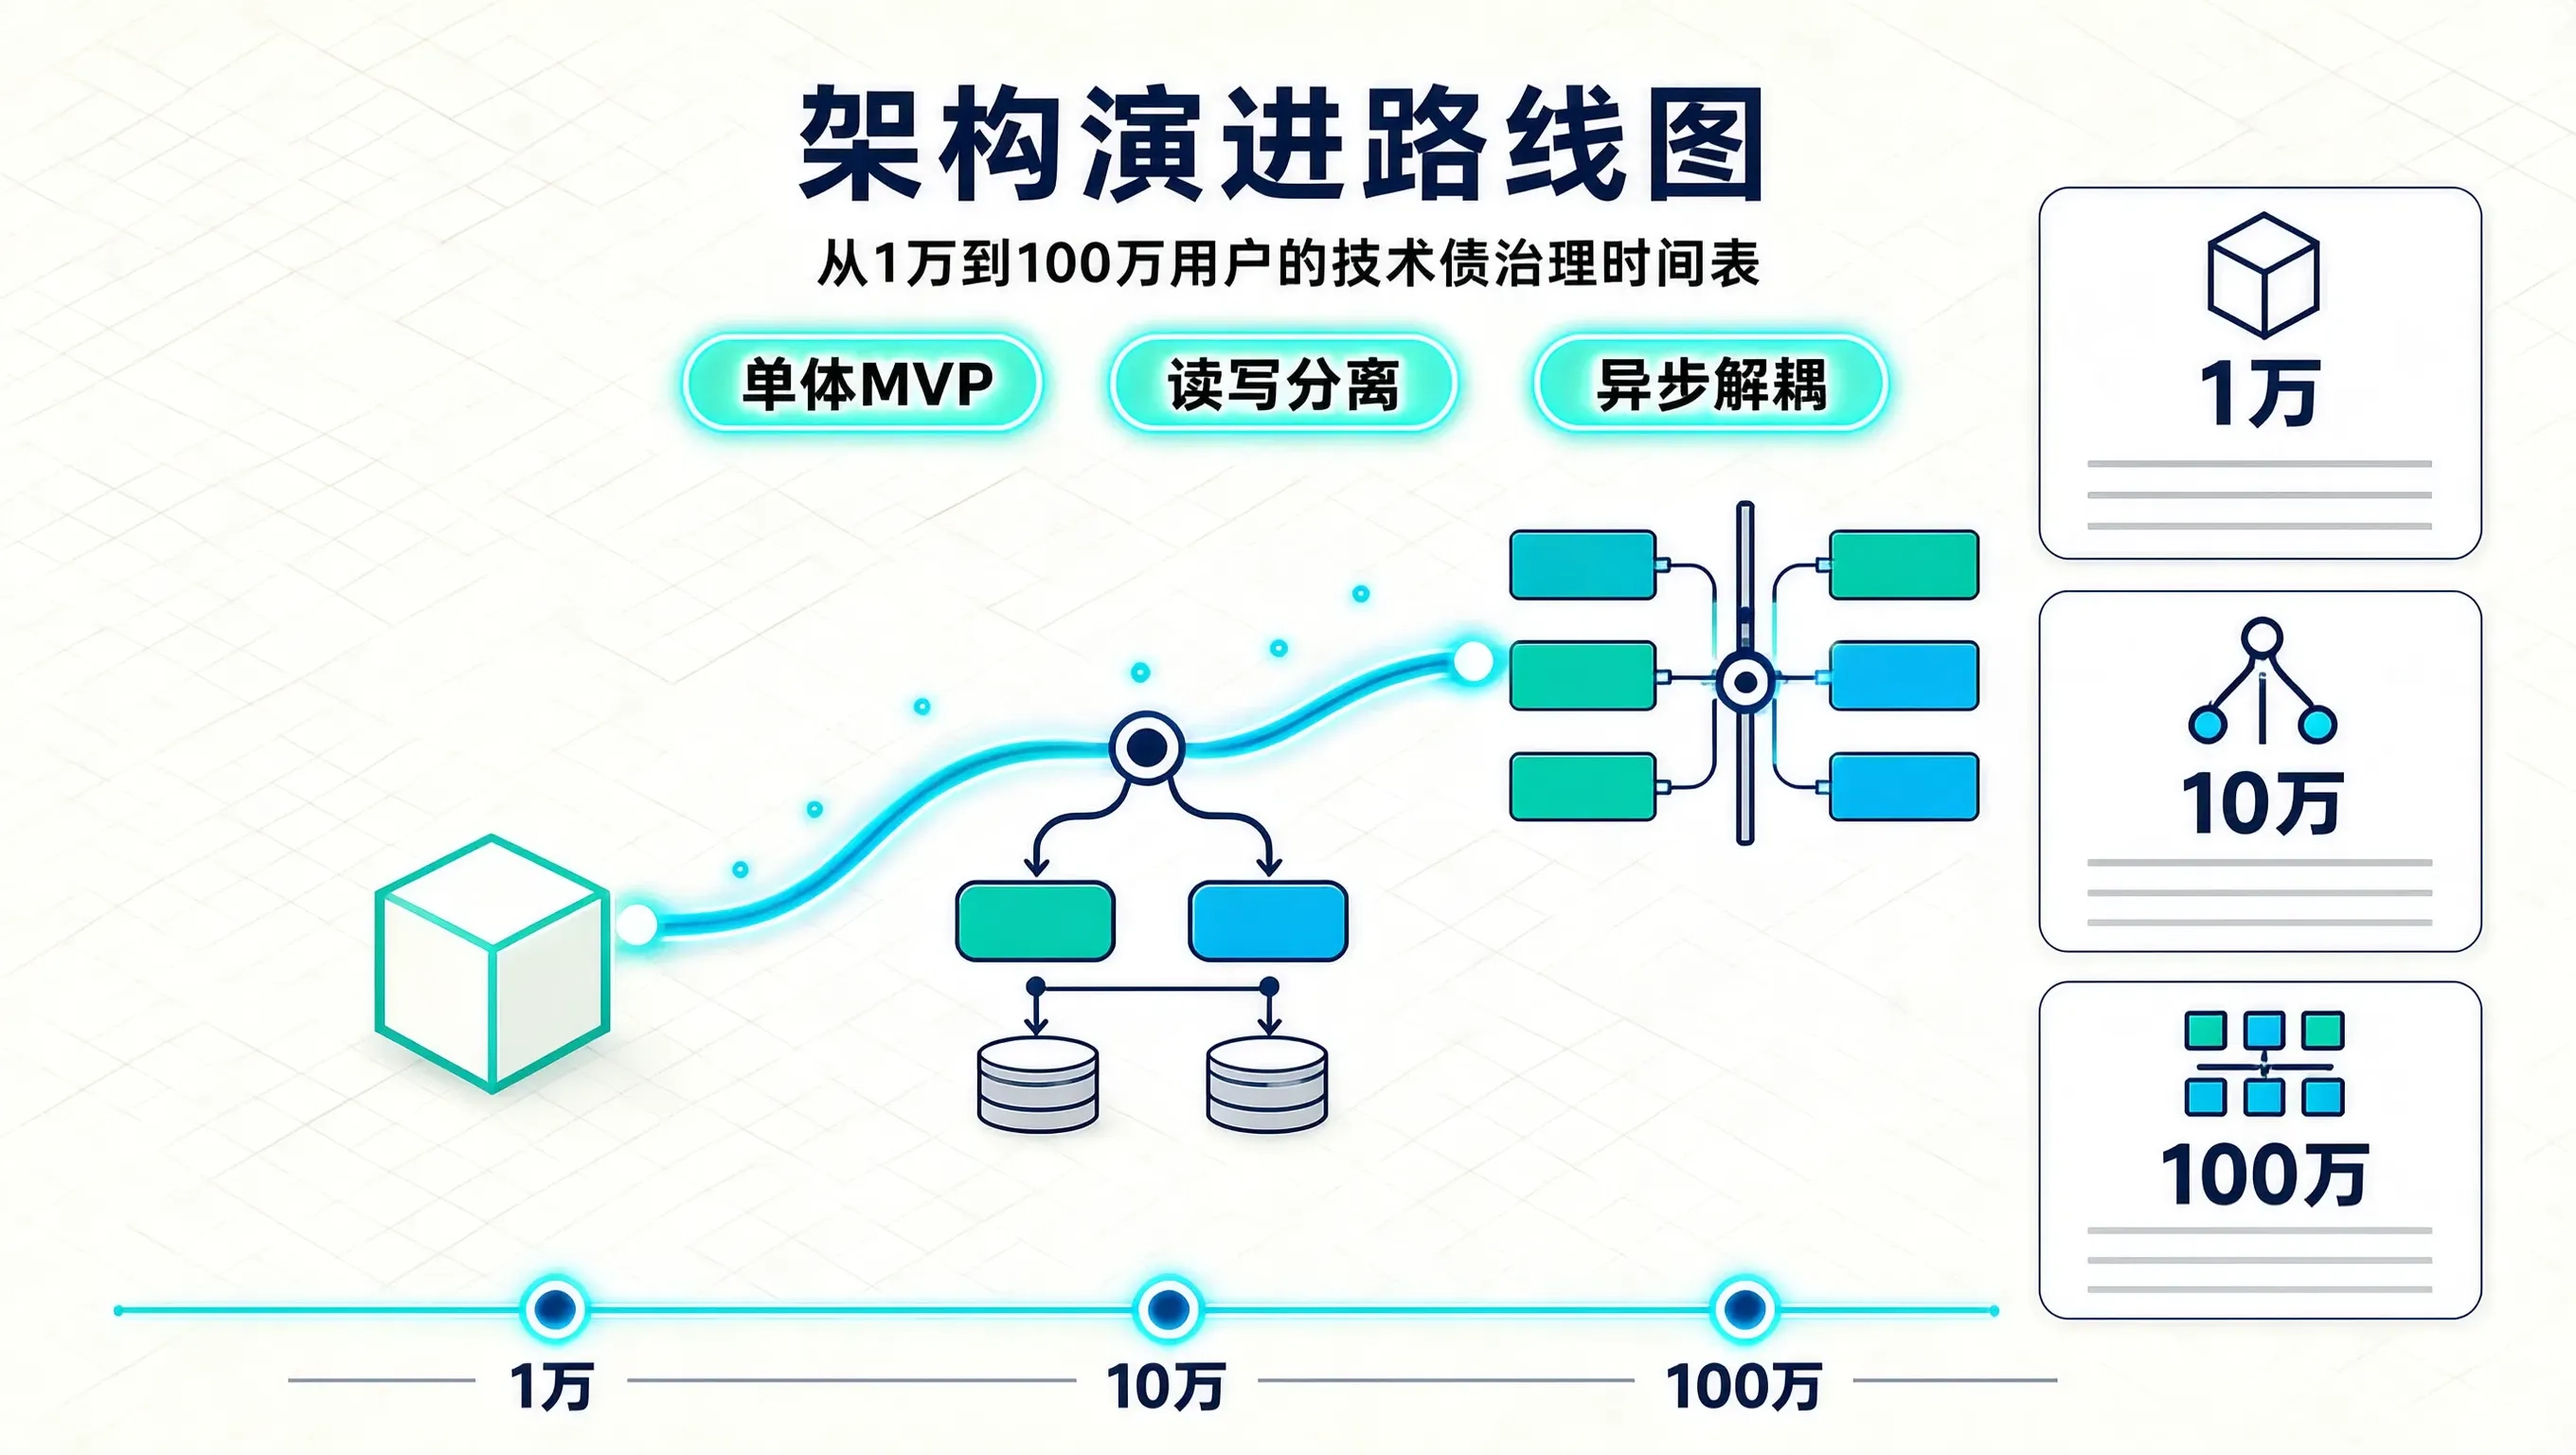
做技术创业最忌讳两件事:一是一上来就照着大厂百万 QPS 的架构做过度设计,把公司活活拖死在上线前;二是完全不留演进空间,任由代码腐化,结果在用户量爆发时系统瞬间崩盘。从操作系统开发者转做科技产品并创办公司,我经历过系统从日活几百人到数十万用户的完整生命周期。技术架构不是一蹴而就的艺术品,而是一份。在不同的用户量级,团队必须对技术债务有清醒的容忍线与清偿节奏。今天我把团队从 1 万用户跑通到 10
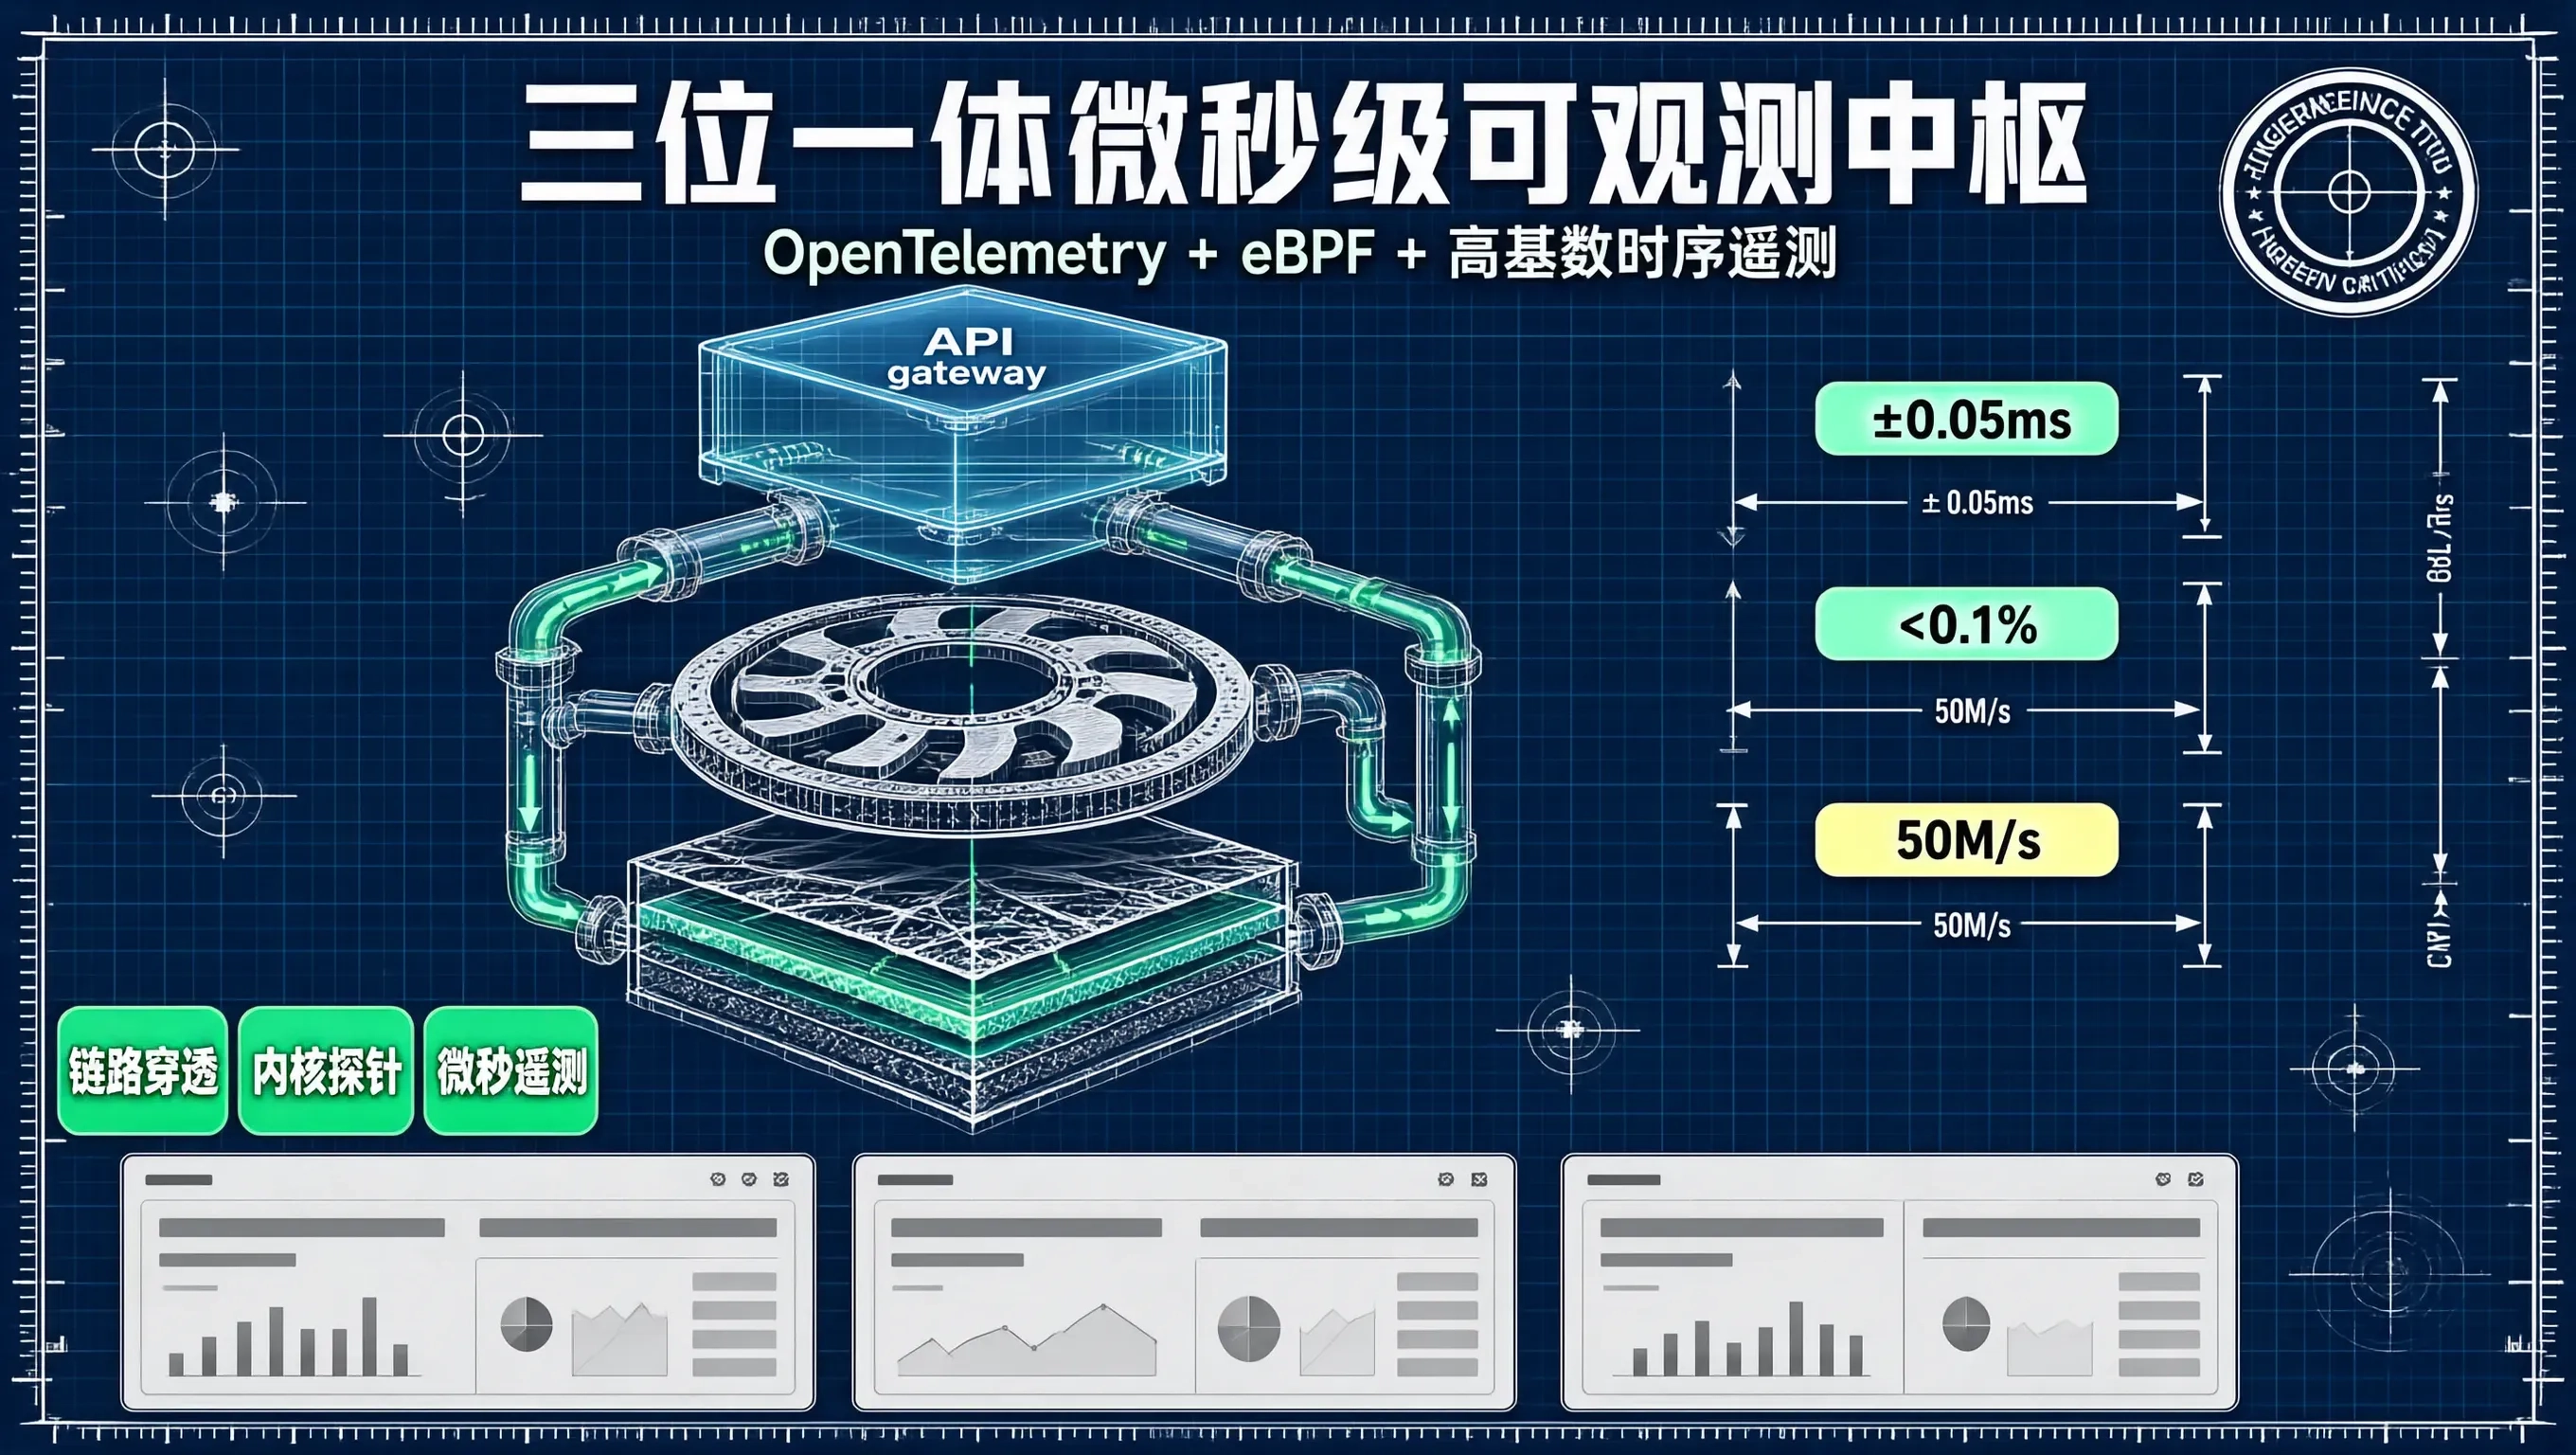
可观测性不是一堆凌乱的图表,而是一张将应用逻辑、网络传输、操作系统内核与物理硬件无缝咬合的数字透视网。搭建起三位一体的可观测中枢,技术团队才能在面对任何未知生产风暴时,永远拥有最从容、最坚定的技术底气!
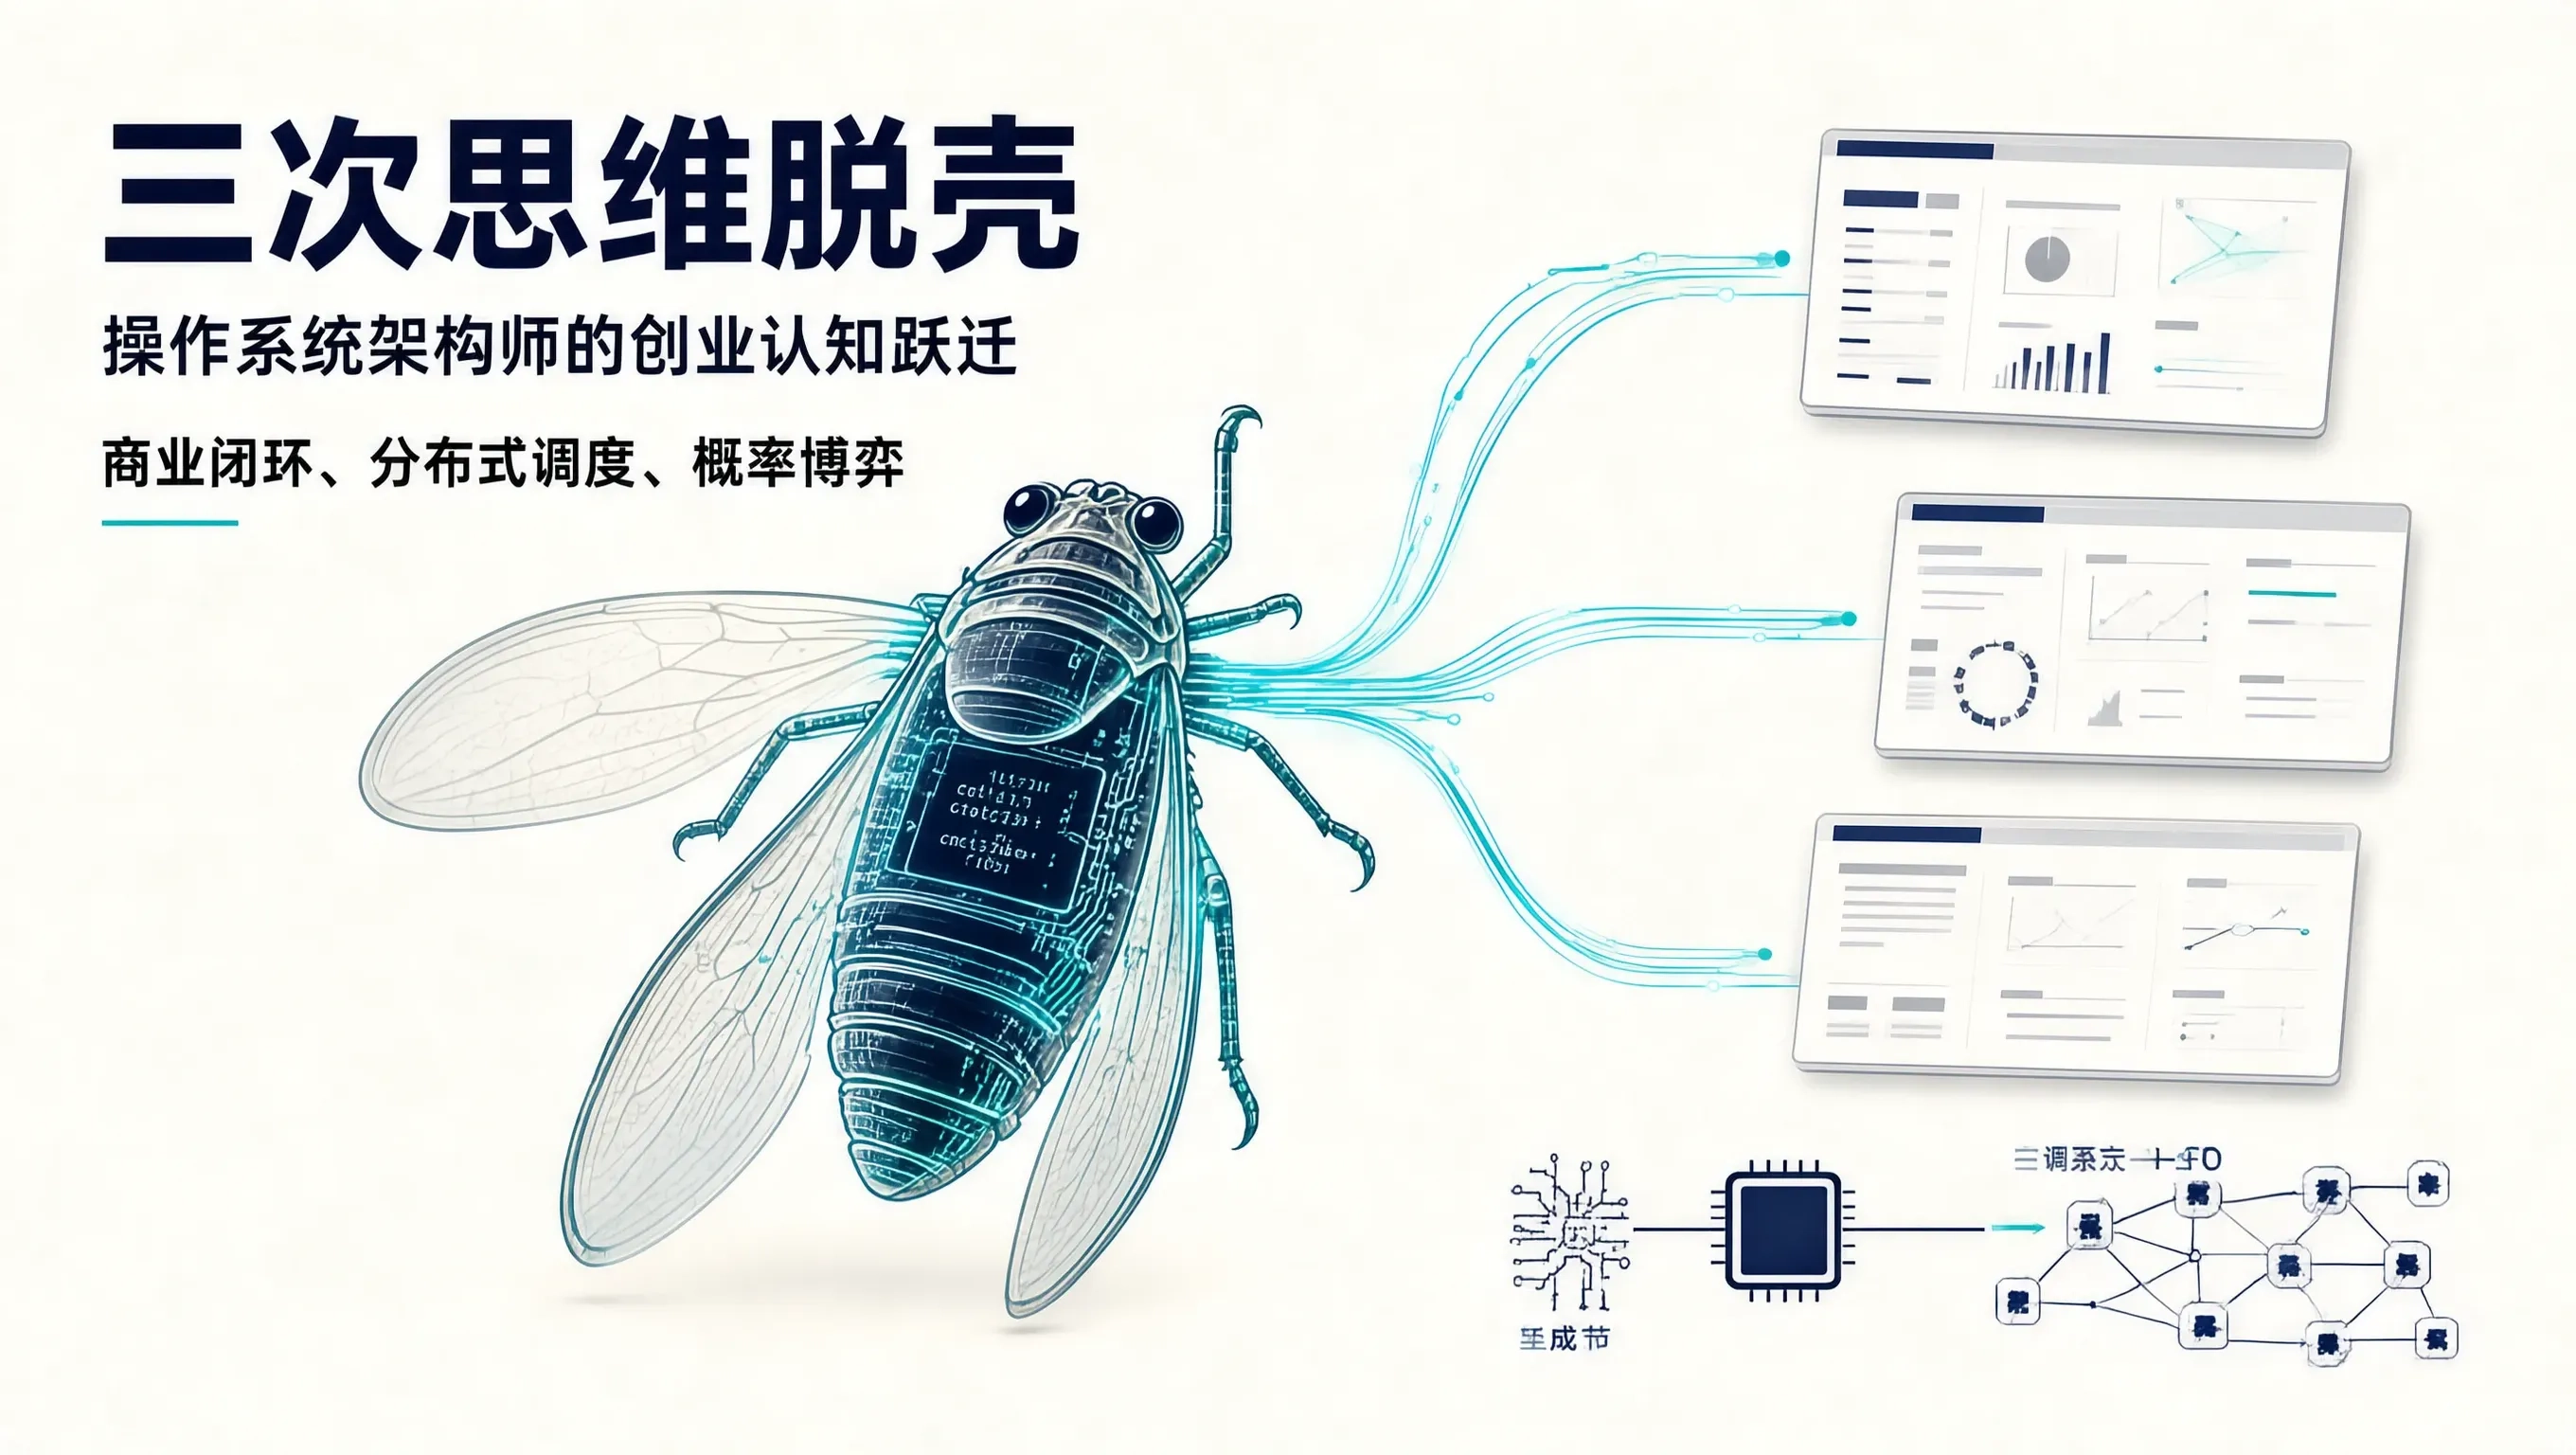
维度操作系统架构师思维科技创业者思维首要目标系统的稳定性、性能极限与代码整洁商业模式的验证、用户留存与现金流健康面对复杂性增加抽象层、状态机解耦、消除一切副作用快速推出 MVP 验证核心假设,拥抱环境动态变化对待错误零容忍(Kernel Panic 级阻断)区分高危错误与低成本试错,在容错中加速学习资源视角CPU 时钟周期、内存带宽、I/O 吞吐团队心流带宽、获客成本(CAC)、客户生命周期价值(
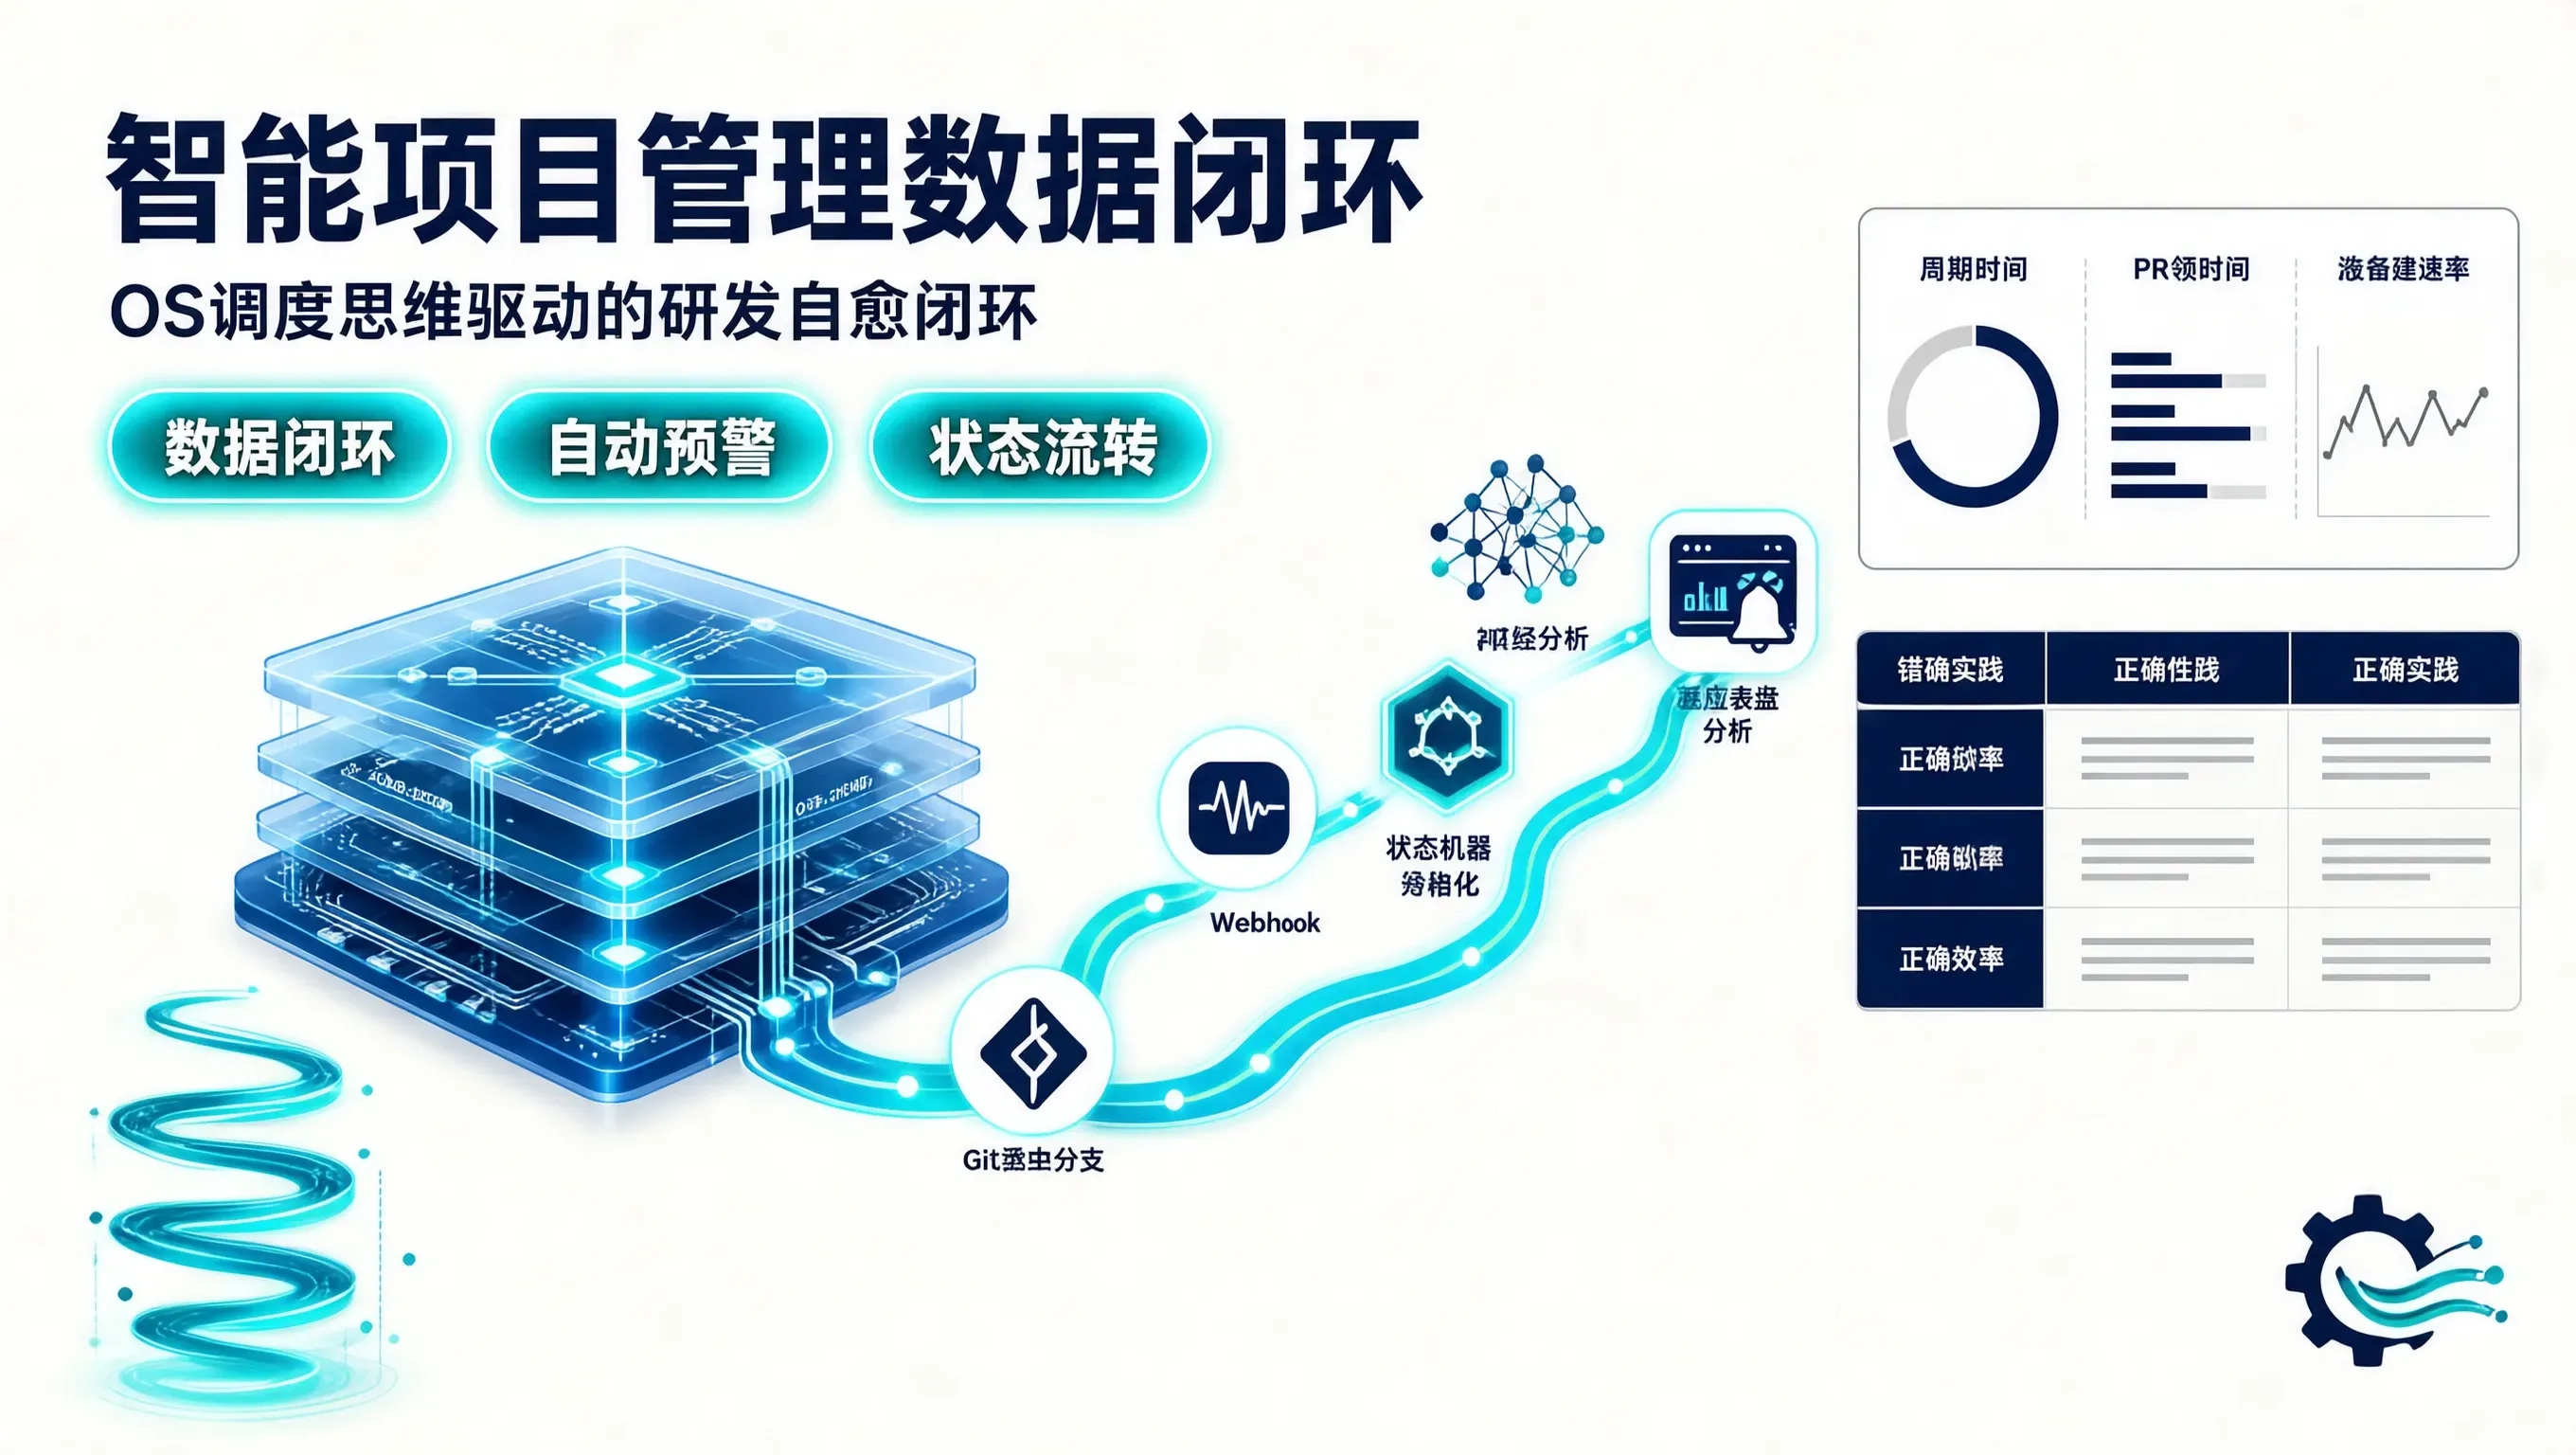
在做 Linux 底层内核与驱动开发时,操作系统调度器(Scheduler)从来不需要去“催促”某一个进程,它依靠的是清晰的就绪队列、时间片配额、优先级反转检测与严格的状态机流转。过去一年,我们在团队内部逐步落地了这套“智能项目管理体系(IPM v1)”,彻底消灭了被动催进度的低效摩擦。
过去两年,整个 AI 行业经历了一场从“唯参数论”向“能效比与部署落地”的理性回归。到了 2026 年,随着各大芯片厂商(高通骁龙 8 Gen 系列、苹果 M/A 系列、联发科天玑以及各类嵌入式 RISC-V/ARM SoC)全面标配 40+ TOPS 算力的 NPU,以及 1B~7B 参数量模型在 4-bit / 3-bit 量化下的成熟,**端侧 AI(On-device AI)**已经从前沿
操作系统度量维度未调优出厂默认基线全量调优终态基线提升效果评估单机最大可维持 TCP 活跃连接数约 25,000 (直接报句柄耗尽)1,000,000+ (轻松维持)并发承载能力提升 40 倍突发洪峰建连失败超时率18.5% (握手队列溢出)0.000% (握手队列深如深海)彻底消除建连丢包高并发下网卡软中断 CPU 占用 (%si68.5% (数十颗核心忙于分片)5.4% (TSO/GRO 硬件