Linux:基础IO的认识
一、以语言的角度认识文件
怎么对文件进行操作
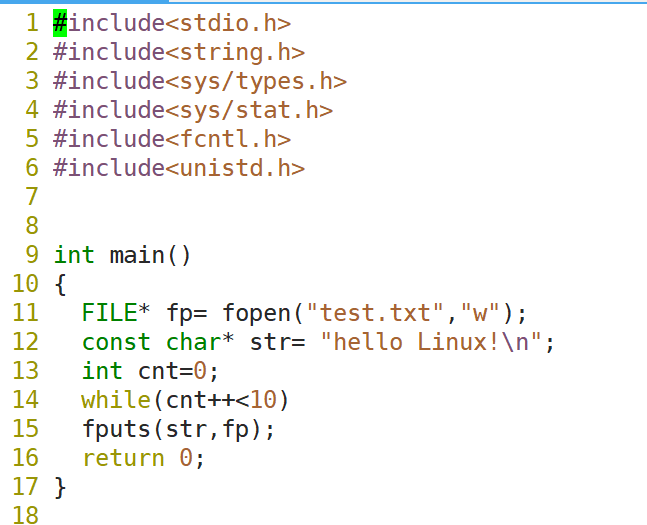
我们知道我们C语言打开某个文件是用fopen()函数,其他语言都有其对应的接口,我们知道一个文件=属性+内容,我们对文件进行的操作无非就是对属性(如:修改文件权限)和内容(输入数据)做改变
那于进程初步能有什么关系?
如上图,我们打开一个文件是在运行一个程序中打开的,也就是说,对文件的写入读取都是动态的,那这就证明谁能打开文件? 进程!所以我们实际上在学进程与文件的关系!
Linux能否同时打开多个文件?如果可以,那没被打开的文件在哪?
可以,当我们打开文件时,它会被加载到内存里面,没被打开的文件存在我们的磁盘里,这个过程就是从磁盘到内存
如何管理这些被打开的文件呢?
先描述,再组织!,与进程一样,会有数据结构来管理这些被打开的文件
回顾C语言的打开文件类型
“r”: 从指定文件读数据
特点:文件不存在时会报错,不能向文件里写数据,只能读出数据或把数据读到其他文件中
“w”:从指定文件写入数据
特点:如果文件不存在会创建,并且会先清空文件里的数据,再做写入
“w+” 既能读文件也能写文件
特点:同"w"加"r"的特点相反
“r+”:既能读文件也能写文件,但不能清空文件
上面这三个都是从文件开头开始写数据
“a":从指定文件追加数据,
特点:如果文件不存在会创建,并且它是从文件内容末尾写入数据
“a+”:既能读文件也能写文件
特点:读出数据或把数据读到其他文件中,写入数据是从文件内容末尾开始追加写入数据
二、系统IO
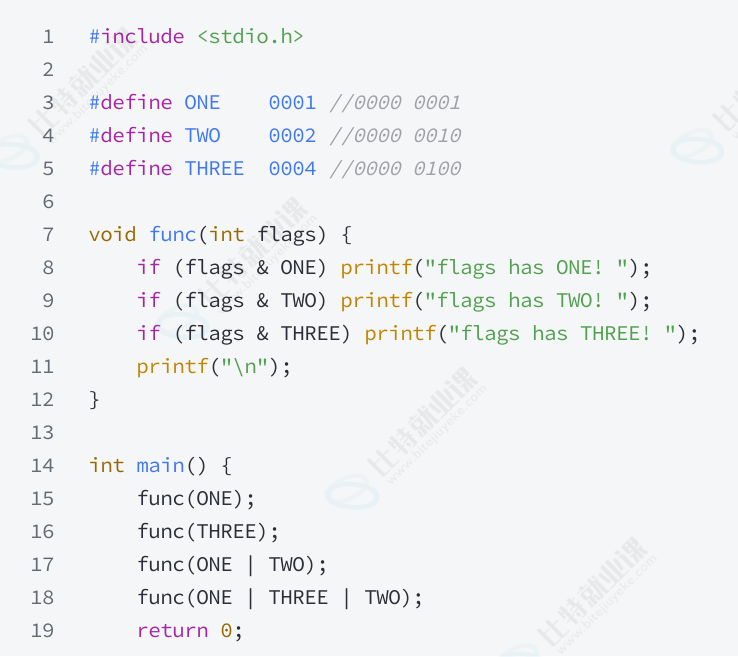
打开⽂件的⽅式不仅仅是fopen,ifstream等流式,语⾔层的⽅案,其实系统才是打开⽂件最底层的⽅案。不过,在学习系统⽂件IO之前,先要了解下如何给函数传递标志位,该⽅法在系统⽂件IO接⼝中会使⽤到
标志位: 位运算把一些被宏替换的数字通过 按位或(“|”)装进位图里面通过这个整数进行按位与("&') 最终实现多个函数
宏替换的数字一定是二进制位上的某个1,也就是通过 1<< i 左移i位得到的数字
系统IO调用函数
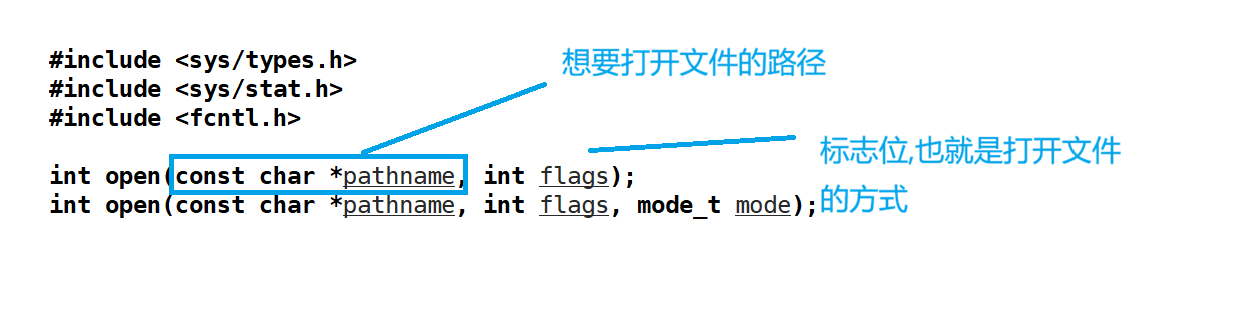
open函数
flags: 打开⽂件时,可以传⼊多个参数选项,⽤下⾯的⼀个或者多个常量进⾏或”运算,构成flags。
参数:
O_RDONLY: 只读打开
O_WRONLY: 只写打开
O_RDWR : 读写打开
这上面三个常量,必须指定⼀个且只能指定
O_CREAT : 若⽂件不存在,则创建它。需要使⽤mode选项,来指明新⽂件的访问权限
O_APPEND: 追加写
O_TRUNC:清空文件数据
这些都是二进制位通过宏替换的数字然后通过或运算来选择你要几个参数选项
与语言提供的文件函数的关系
可以看出fopen,ifstream等库函数都是对系统调用函数进行的封装
文件描述符
open函数的返回值就是一个整型,它是文件结构体中的管理文件的数组的下标
也就是说可以通过数组下标来找到对应下标的内容也就是对应的文件
⽽现在知道,⽂件描述符就是从0开始的⼩整数。当我们打开⽂件时,操作系统在内存中要创建相应的
数据结构来描述⽬标⽂件。于是就有了file结构体。表⽰⼀个已经打开的⽂件对象。⽽进程执⾏open系
统调⽤,所以必须让进程和⽂件关联起来。每个进程都有⼀个指针*files,指向⼀张表files_struct,该表
最重要的部分就是包含⼀个指针数组,每个元素都是⼀个指向打开⽂件的指针!所以,本质上,⽂件
描述符就是该数组的下标。所以,只要拿着⽂件描述符,就可以找到对应的⽂件
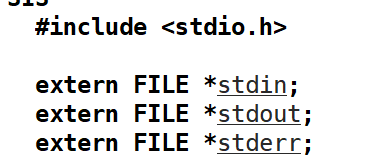
• Linux进程默认情况下会有3个缺省打开的⽂件描述符,分别是标准输⼊0,标准输出1,标准错误2.
• 0,1,2对应的物理设备⼀般是:键盘,显⽰器,显⽰错误
他们都是FILE类型
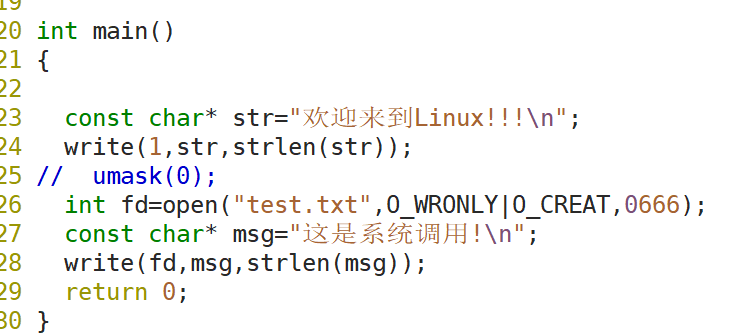
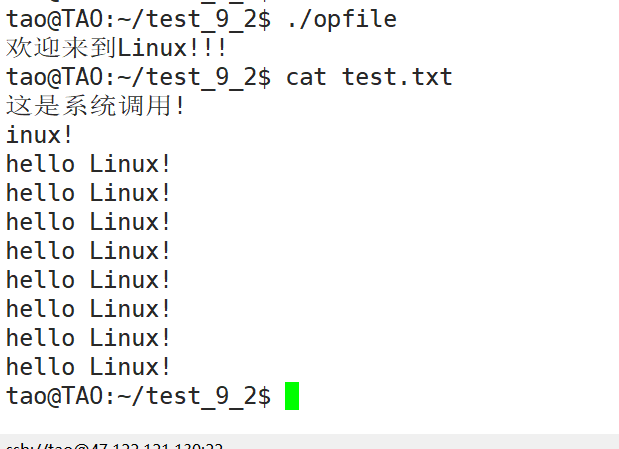
下面是一个小demo
write()第一个参数是:文件描述符,第二个:想写入文件的内容,第三个:写入的大小
文件描述符规则
创建的新文件会就近的放在数组下标里没有文件的小的下标里
小结总结
C语言的返回值是FILE*是结构体类型C++是ifstream 类类型,所以不管怎样,它们当中都会封装fd这个文件描述符来来找到进程管理的文件数组最后把对应文件进行打开关闭等操作,这个也证明了进程与文件的关系

三、重定向
有输出重定向,输入重定向,和追加重定向三种
重定向的意思就是现在不往标准输出和标准输入里操作而是对一个文件做标准输出和输入
看下面一个小demo:
神奇的是printf的内容没有打印在显示器上,而是写入了test.txt文件里,
其原理就是:我先关闭了标准输入1下标的显示器文件,然后创建的test.txt会在1下标下,但1下标不是标准输入流,但用户层面调用接口是不知道实际被改变,所以还是会向1下标的文件下输入数据,但现在1下标的文件是test.txt,所以最终就往test.txt输入数据了
这就是改变了原有的输入重定向,不往显示器文件输入,往test.txt文件输入了
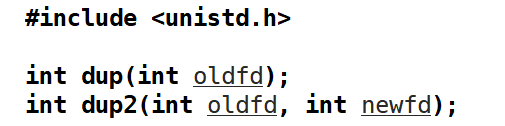
dup2系统接口
这样写关闭指定描述符的文件有点挫的代码,可以用这个接口代替,
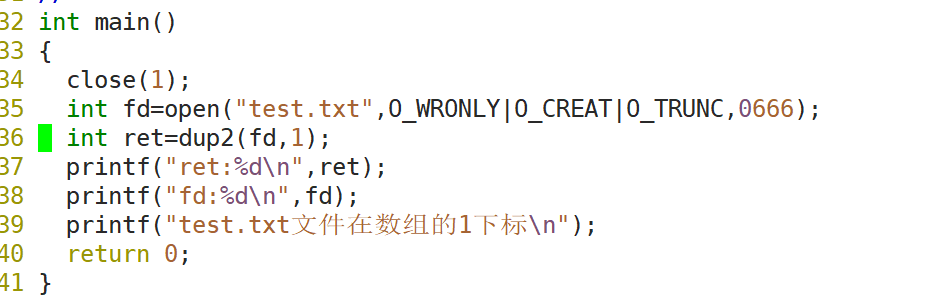
一般用第二个,将oldfd里的文件拷贝到newfd里面,也就是上面的代码可以这样写
也就是让1和fd指向的文件是一样的,将来输入的数据是往描述符1输入,但里面的文件是fd里的所以这样也做到了输入重定向,追加重定向也就是把O_TRUNC去掉就行
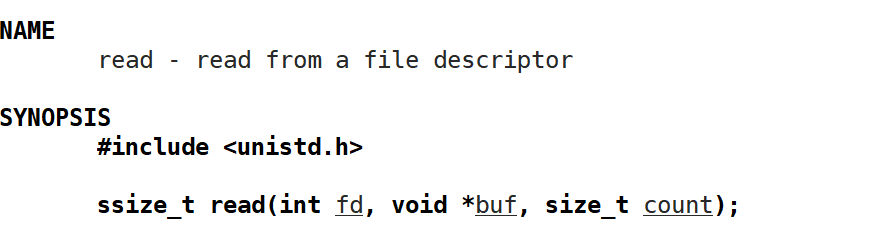
输出重定向就调用read()接口
从指定描述符读取count大小的数据到buf数组中,


四、缓冲区
内核缓冲区
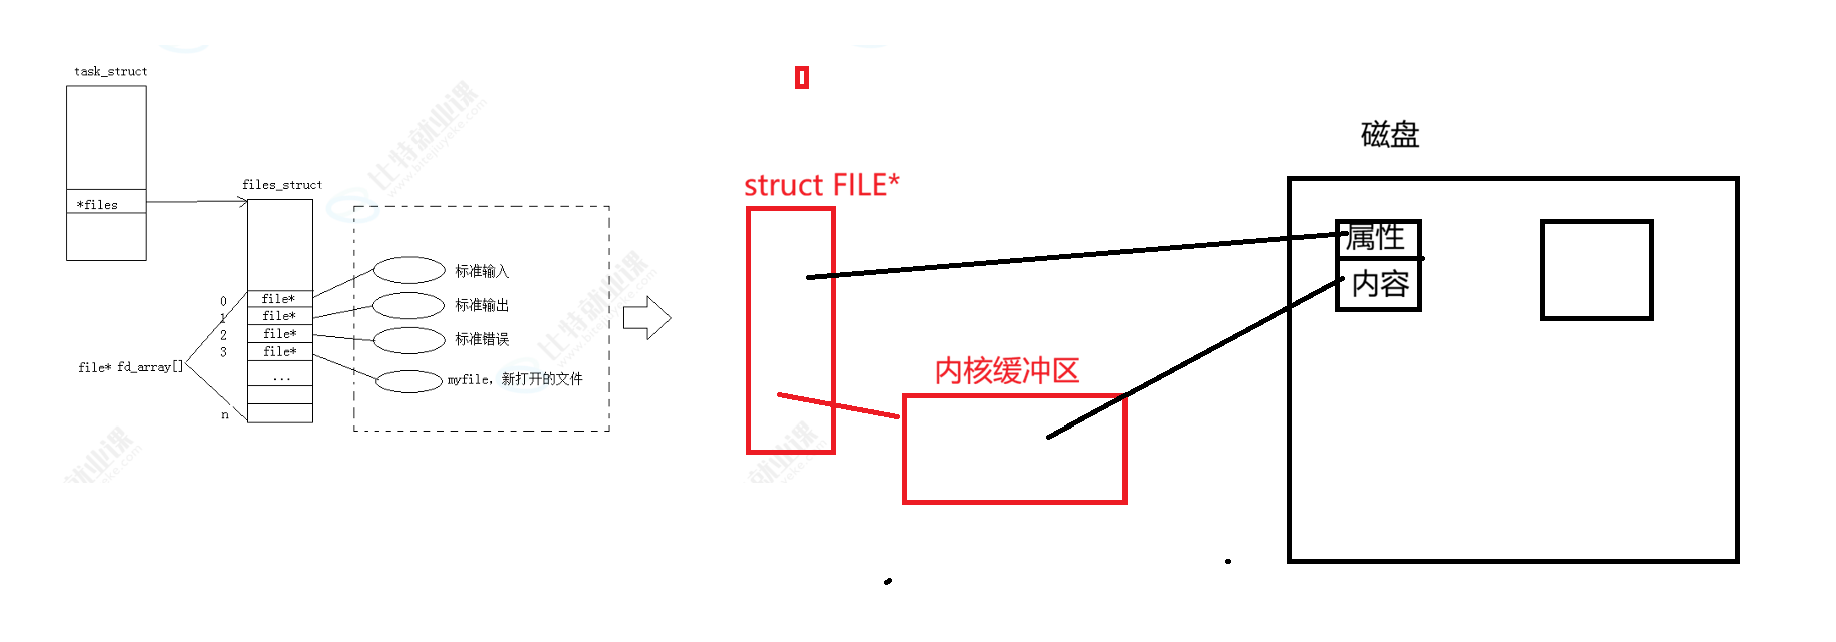
我们通过上面的知识知道了进程与文件的相关关系,那磁盘中将要写入或读取操作的文件要怎么给CPU执行呢?
根据冯诺依曼体系,我们知道CPU是不直接与外设打交道,要内存来作为媒介的,所以将来要操作的文件的内容和属性会加载到内存,那管理其的结构体自然就是文件结构体了,那将来的数据就会加载到内核缓冲区,我们如果用系统调用read或write等,CPU拿的数据不是磁盘上的,而是拷贝到内核缓冲区的数据,对内核缓冲区做修改等操作,最后再将内核缓冲区的呢容覆盖到对应磁盘文件内容上
那其实也变相的证明了read和write这种系统调用函数本质是拷贝函数!!!,内核缓冲区的缺陷
如果我们频繁的去读写操作时,那么
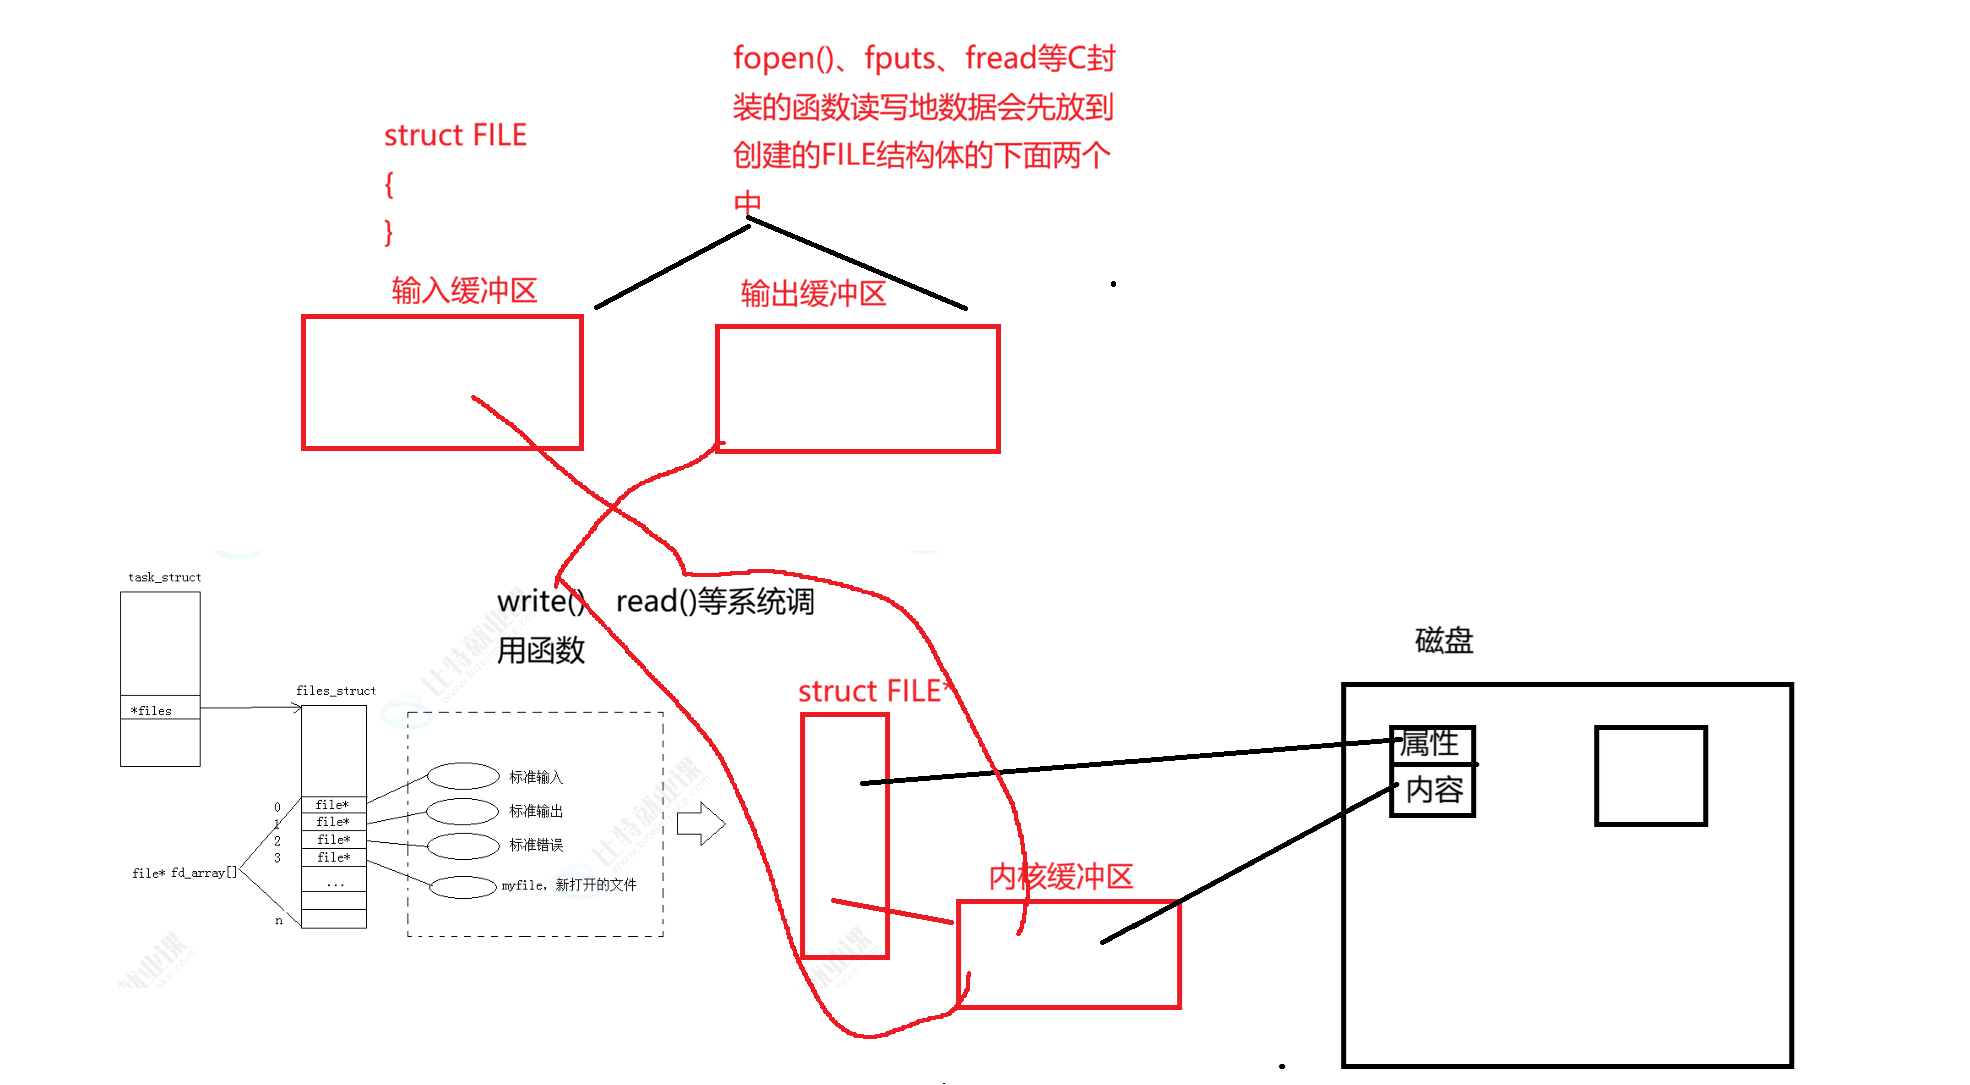
每次对⽂件进⾏⼀次读写操作时,都需要使⽤读写系统调⽤来处理此操作,即需要执⾏⼀次系统调⽤,执⾏⼀次系统调⽤将涉及到CPU状态的切换,即从⽤⼾空间切换到内核空间,实现进程上下⽂的切换,这将损耗⼀定的CPU时间,频繁的磁盘访问对程序的执⾏效率造成很⼤的影响,所以接下来的语言封装的接口中就有相对应的输入、输出缓冲区语言层面上的缓冲区
其实我们口中的缓冲区都是这个我们语言层面的缓冲区,我们将来C语言的FILE结构体中会有输入缓冲区和输出缓冲区的指针,指向一块空间来存放用户将来要输入输出地数据
将来通过存储一定的数据后再调用系统调用去把数据写入到内核缓冲区内再让操作系统对磁盘做刷新最后不就对文件完成了增删查改的操作
刷新类型
1、进程结束自动把缓冲区内的数据写入到内核缓冲区,也就是自动刷新
2、如果目标文件是显示器,进行行刷新(比如\n作为一行的数据显示)
3.如果是普通文件,全缓冲,一般缓冲区满了才会刷新(比如fflush就是立即刷新缓冲区)
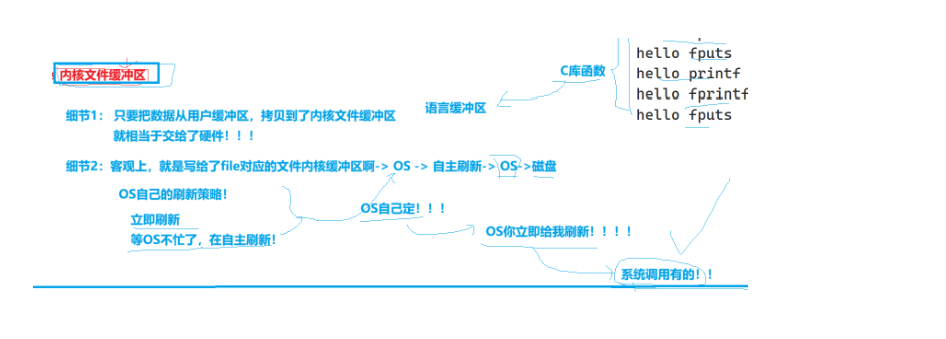
内核缓冲区的细节
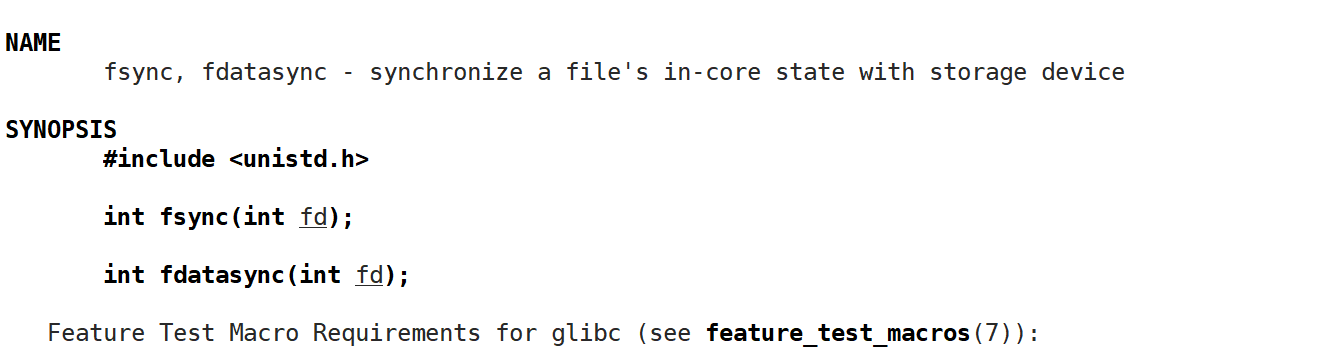
这个函数是对内核缓冲区立即刷新的系统调用

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 26
 0
- 0


 已为社区贡献1条内容

所有评论(0)