【Linux】文件系统
9. 文件系统
我们的文件分为被打开的文件和没被打开的文件,被打开的文件在内存里,没被打开的在磁盘里。既然没被打开的文件在磁盘上,我们的操作系统又是怎么找到那些文件的?
我们有一个文件系统,操作系统要找到它们,靠的是文件系统在磁盘上维护的一套索引结构。
9.1 磁盘
磁盘(Disk)是指利用磁记录技术来存储数据的存储器。它利用电流的磁效应,通过读写磁头改变盘片表面磁性材料的磁化方向,从而将电信号转化为磁信号持久化存储。
也就是我们用来存储文件的外设。
事先说明一点,就是现在大部分笔记本电脑已经不再使用磁盘了,而是使用固态硬盘。但是存储空间特别大的不少台式机依然还采用着我们的磁盘进行存储,只是笔记本电脑很少了。
9.1.1 磁盘的物理结构
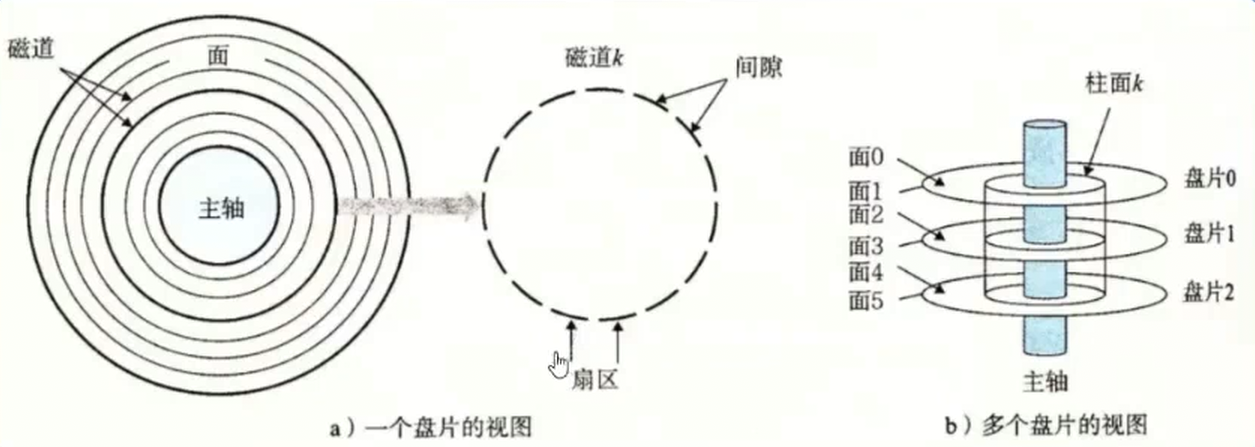
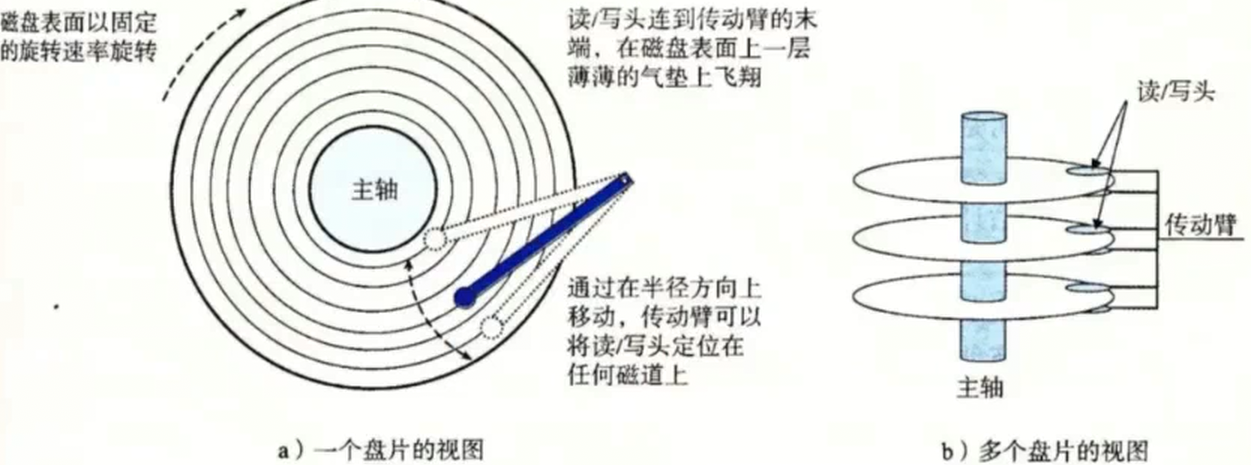
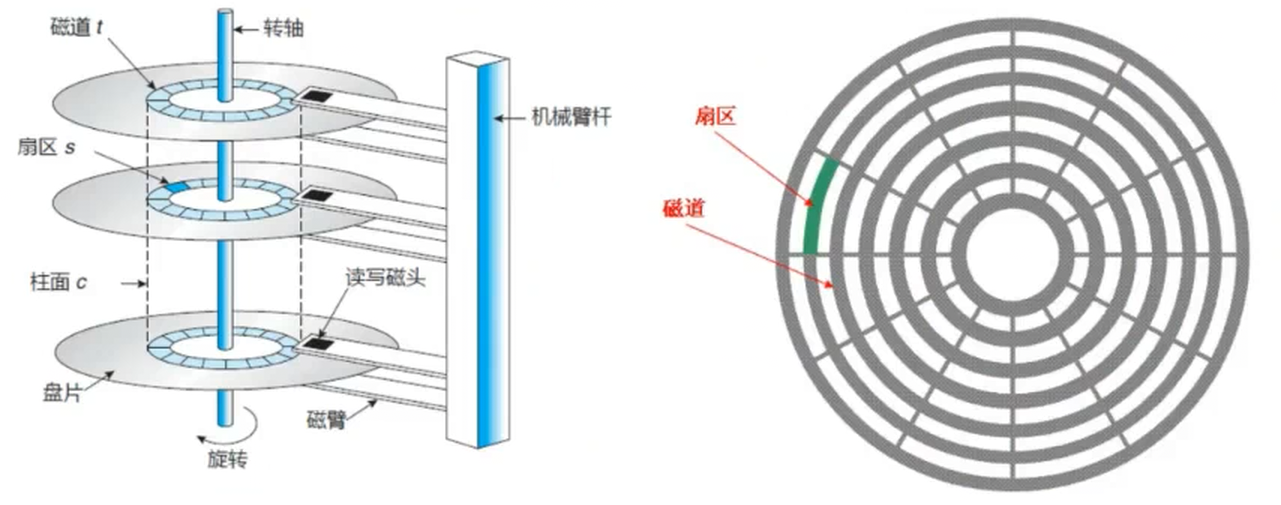
如上都是磁盘盘片的示意图。
我们磁盘的基本单位是扇区,512字节,块设备。
什么意思呢?意思是如果你某一天,操作系统想要修改某一个比特位上的数据,你的操作系统都必须把整个扇区所有的数据都加载到我们的内存当中。把其中那个比特位由0或1的更改再写回指定扇区。
每一个扇区的结构大致如下:
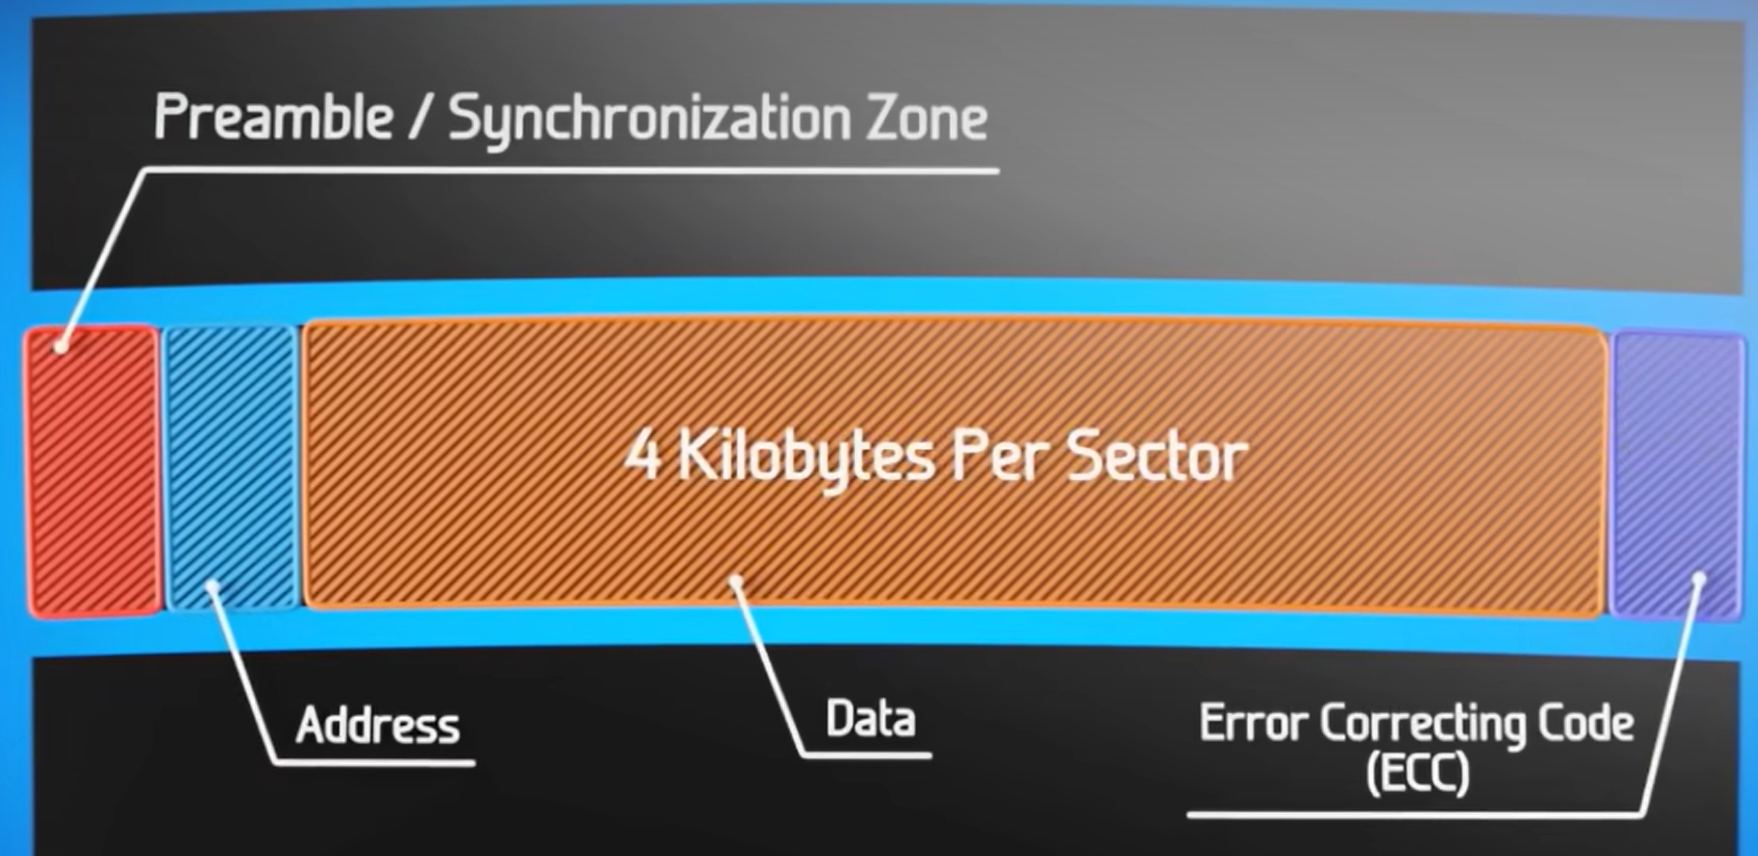
而我们写入数据其实是通过磁头磁盘的单元进行磁化,改变其磁场方向做到的。每一个扇区内的磁盘单元大小仅仅只有约 90×100×125 纳米,当磁盘单元内原子的磁场方向都指向同一方向时,就相当于写入了一位数据。
我们的磁盘其实是有不止一个盘片的,多个盘片形成了柱面,通过一个机械臂杆连接着一个个读写的磁头,柱面的盘片旋转后,磁头可以对盘片的颗粒进行磁化从而完成数据读写入磁盘。
我们的磁盘容量 = 磁头数 × 柱面数 × 每个柱面的扇区数 × 每个扇区的字节数
9.1.2 磁盘的逻辑结构
我们实际上是通过一个线性的结构对磁盘进行管理的。
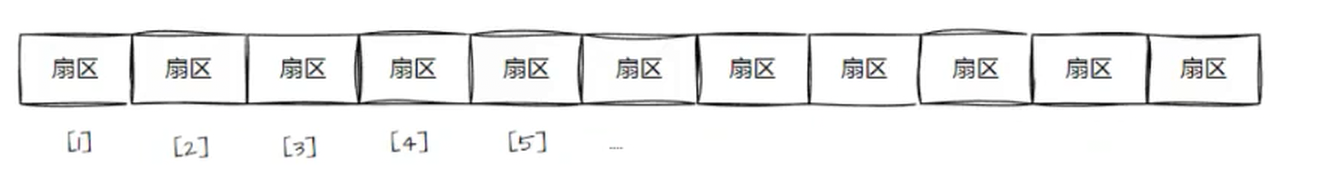
这其实就是 LBA(逻辑块寻址) 最经典的抽象表达。它把原本在物理上呈同心圆一圈圈分布的扇区,“拍扁”成了一条首尾相连的线性长链。
对于操作系统来说,它不再需要关心机械臂停在哪个柱面、哪个盘面,它看到的只有这条链。当程序需要读取数据时,直接喊出链上的编号就行:
-
LBA 0:代表第一个扇区
-
LBA 1:代表第二个扇区
-
LBA 2:代表第三个扇区
对于代码而言:
首先,我们要定义图里的一个“扇区”长什么样。
// 现代硬盘一个扇区通常是 4096 字节(4K)
#define SECTOR_SIZE 4096
// 内存中的一个扇区数据块
struct sector
{
unsigned char data[SECTOR_SIZE];
};
在操作系统内核(比如 Linux 的块设备层)里,当我们拿到了硬盘的控制权,我们会做如下抽象:
// 模拟一块硬盘的硬件
struct disk
{
unsigned long long total_sectors; // 硬盘总共有多少个扇区(比如 2TB 硬盘大概有 5 亿个扇区)
void *base_address; // 【关键】这块硬盘在系统中的基地址(可以理解为数组的起始指针 [0])
};
// 核心操作:读取链上的第 N 个扇区
// 这里的 n 就是图里的 [n]
void read_sector(struct disk *my_disk, unsigned int n)
{
// 检查边界:防止访问越界(比如硬盘只有10个扇区,你却要读第11个)
if (n >= my_disk->total_sectors)
{
printf("Error: 扇区越界!\n");
return;
}
// 计算内存偏移量
// 公式:基地址 + (索引号 * 每个盒子的大小)
void *target_address = my_disk->base_address + (n * SECTOR_SIZE);
// 此时 target_address 就精准指向了链上第 [n] 个扇区的物理内存或硬件接口
printf("成功定位到第 [%u] 个扇区\n", n);
}
因此底层大概是一个三维数组存储的,要找到对应数据要先找哪个柱面, 然后哪个磁头最后看看哪个扇区的。
9.2 文件系统相关概念
9.2.1 块
其实硬盘是典型的“块”设备,操作系统读取硬盘数据的时候,其实是不会一个个扇区地读取,这样效率太低,而是一次性连续读取多个扇区,即一次性读取一个“块”(block)。
硬盘的每个分区是被划分为一个个的“块”。一个“块”的大小是由格式化的时候确定,并且不可以更改,最常见的是4KB,即连续八个扇区组成一个“块”。“块”是文件存取的最小单位。
其实这个就是外存上的物理页框。物理页框和块一个是内存的概念一个是外存的概念罢了。
9.2.2 分区
硬盘出厂时是一整块“裸设备”,但操作系统不会直接把整块盘当一个单位来管。于是就在物理磁盘上划出一段段连续的区域,每一段叫一个“分区”(partition)。
分区的好处是:可以把系统、数据、备份分开存放,互不干扰;也可以在一块盘上装多个操作系统;还能针对不同分区用不同的文件系统。
分区信息记录在分区表里,常见的有 MBR 和 GPT 两种。MBR 最多 4 个主分区,最大支持约 2TB;GPT 则几乎不限分区数,支持超大容量磁盘,现代系统基本都用 GPT。
每个分区在系统里会被当成一个独立的“逻辑磁盘”来使用。Windows 里体现为 C 盘、D 盘;Linux 里体现为 /dev/sda1、/dev/sda2 这样的设备文件。
其实分区就是给硬盘划“地盘”。一块地盘可以盖不同的房子(文件系统),住不同的住户(文件)。而分区表就是这块地的“产权登记簿”,记录哪块地从哪里到哪里、归谁用。
9.2.3 inode
分区格式化之后,文件系统会在分区里维护一张“目录表”,用来记录每个文件放在哪些块里、有多大、权限是什么、修改时间等。这张表里的每一条记录,就叫一个 inode(索引节点)。
每个文件(以及目录)都对应一个唯一的 inode。inode 里存的是文件的元数据:文件大小、所有者、权限、时间戳、占用了哪些数据块等。但注意,inode 里不存文件名,文件名是存在目录项里的,目录项把“文件名 → inode 号”映射起来。
操作系统访问一个文件时,先通过文件名找到目录项,拿到 inode 号,再根据 inode 找到对应的数据块,最后把数据读出来。
inode 的数量在格式化时就确定了,用完之后即使磁盘还有空间,也创建不了新文件。可以用 df -i 查看 inode 的使用情况。
其实 inode 就是文件的“档案卡”。文件名是你在外面看到的名字,inode 才是系统内部真正认的那个“人”。档案卡上记着这个人的所有信息,但唯独不记名字,名字是归目录管的。数据块则是这个人实际住的房子,inode 负责指路。
要注意一点: 目录的数据块会保存 inode 编号,普通文件不会。
9.3 块组内部构成
文件系统格式化时,会把分区划分为许多个块组(Block Group)。每个块组大小通常为 128MB,ext4 可以更大。
为什么要分块组?因为如果整个分区只维护一份“哪些块空闲、哪些 inode 空闲”的表,那么每次分配文件都要跨越整个磁盘去查表,效率极低,而且容易产生碎片。分成块组后,每个块组自己管自己的一亩三分地,分配文件时优先在本块组内找空闲块和 inode,速度快,碎片少。
还有一个原因:局部性原理。文件系统在创建文件时,会尽量把文件的 inode 和数据块放在同一个块组里,这样读 inode 和读数据块的时候,磁头移动距离短,或者对于 SSD 来说,访问的闪存页更集中,性能更好。如果一个目录下的文件都放在同一个块组,那么遍历目录时也能减少跨块组的访问。
每个块组内部,由图里的 6 个部分组成。这 6 个部分各司其职,有的管全局,有的管局部,有的存管理信息,有的存实际数据。
9.3.1 超级块
记录整个文件系统全局信息的数据结构。比如:总共有多少个块、多少个 inode、每个块多大、空闲块有多少、空闲 inode 有多少、文件系统类型、挂载状态等。
操作系统挂载一个分区时,第一件事就是读超级块,知道这个文件系统长什么样、怎么管。没有超级块,系统就不知道这个分区是什么文件系统、块多大、inode 多大,根本没法访问。
超级块里存的字段非常多,较重要的如下:
-
s_inodes_count:整个文件系统总共有多少个 inode。 -
s_blocks_count:整个文件系统总共有多少个块。 -
s_free_blocks_count:当前还有多少个空闲块。 -
s_free_inodes_count:当前还有多少个空闲 inode。 -
s_log_block_size:块大小的对数值,实际块大小是1024 << s_log_block_size。如果是 0,块大小就是 1024 字节;如果是 2,块大小就是 4096 字节。 -
s_blocks_per_group:每个块组有多少个块。 -
s_inodes_per_group:每个块组有多少个 inode。 -
s_magic:魔数,ext2/ext3/ext4 都是0xEF53。系统读到这个值,才确认这是一个 ext 系列文件系统。 -
s_state:文件系统状态,比如是否 clean、是否有错误。 -
s_first_ino:第一个可供普通文件使用的 inode 号。通常 1 到 10 号 inode 被保留给特殊用途,比如坏块 inode、根目录 inode 等。 -
s_inode_size:每个 inode 占多少字节,ext4 通常是 256 字节。 -
s_feature_compat、s_feature_incompat、s_feature_ro_compat:特性标志位,决定这个文件系统支持哪些高级功能,比如 extents、64bit、metadata_csum 等。
超级块非常重要,坏了整个文件系统就废了。所以 ext 文件系统会在每个块组里都备份一份超级块,不是所有块组都备份,通常是 0、1、3、5、7、9…… 这些稀疏的块组。主超级块在块组 0,坏了可以用备份恢复。
为什么是 0、1、3、5、7、9 这些块组?因为这是按 3 的幂次方、5 的幂次方、7 的幂次方来的。具体规则是:块组号是 0、1,以及 3、5、7 的幂次方。比如 3、9、27、81,5、25、125,7、49、343。这样备份分散得比较开,既不会占用太多空间,又能保证一旦磁盘某片区域损坏,还有其他备份可用。
如果主超级块坏了,可以用备份超级块恢复:
结构体如下:
struct ext4_super_block {
    __le32  s_inodes_count;        // 总 inode 数
    __le32  s_blocks_count_lo;     // 总块数(低 32 位)
    __le32  s_r_blocks_count_lo;   // 保留块数
    __le32  s_free_blocks_count_lo;// 空闲块数
    __le32  s_free_inodes_count;   // 空闲 inode 数
    __le32  s_first_data_block;    // 第一个数据块号
    __le32  s_log_block_size;      // 块大小 = 1024 << 这个值
    __le32  s_log_cluster_size;    // 簇大小
    __le32  s_blocks_per_group;    // 每个块组多少块
    __le32  s_clusters_per_group;  // 每个块组多少簇
    __le32  s_inodes_per_group;    // 每个块组多少 inode
    __le32  s_mtime;               // 最后挂载时间
    __le32  s_wtime;               // 最后写入时间
    __le16  s_mnt_count;           // 挂载次数
    __le16  s_max_mnt_count;       // 最大挂载次数
    __le16  s_magic;               // 魔数,ext4 是 0xEF53
    __le16  s_state;               // 文件系统状态
    __le32  s_first_ino;           // 第一个可用的 inode 号
    __le16  s_inode_size;          // 每个 inode 多大
    __le16  s_block_group_nr;      // 这个超级块所在的块组号
    __le32  s_feature_compat;      // 兼容特性
    __le32  s_feature_incompat;    // 不兼容特性
    __le32  s_feature_ro_compat;   // 只读兼容特性
    __u8    s_uuid[16];            // 文件系统 UUID
    char    s_volume_name[16];     // 卷标
    // ... 后面还有很多字段,ext4 比 ext2 复杂得多
};
这里 s_block_group_nr 字段很关键。每个备份超级块里都记录了自己所在的块组号。如果主超级块坏了,系统扫描磁盘时,只要在某个位置读到一个魔数是 0xEF53 的结构,再看 s_block_group_nr,就知道这是第几个块组的备份超级块。然后用它来推算其他块组的位置,进而恢复整个文件系统。
可以用 dumpe2fs 命令查看一个分区的超级块信息:
$ dumpe2fs -h /dev/sda1
dumpe2fs 1.46.5 (30-Dec-2021)
Filesystem volume name:   <none>
Filesystem UUID:          a1b2c3d4-e5f6-7890-abcd-ef1234567890
Filesystem magic number:  0xEF53
Filesystem state:         clean
Filesystem features:      has_journal ext_attr resize_inode dir_index filetype needs_recovery extent 64bit flex_bg sparse_super large_file huge_file dir_nlink extra_isize metadata_csum
Inode count:              655360
Block count:              2621440
Free blocks:              2100000
Free inodes:              620000
First block:              0
Block size:               4096
Inode size:               256
Inodes per group:         8192
Blocks per group:         32768
这里 Block size: 4096 就是我们说的 4KB 块,Inodes per group: 8192 说明每个块组有 8192 个 inode,Blocks per group: 32768 说明每个块组有 32768 个块,乘一下 32768 × 4096 = 128MB,正好是一个块组的大小。Inode count: 655360 除以 Inodes per group: 8192 等于 80,说明这个文件系统一共有 80 个块组。Block count: 2621440 除以 Blocks per group: 32768 也等于 80,两个数对得上。
Filesystem features 那一行列出了这个文件系统启用的所有特性。has_journal 表示有日志功能,extent 表示支持 extents 分配方式,64bit 表示支持 64 位块号,metadata_csum 表示元数据有校验和。这些特性都是在格式化时决定的,有的可以后期调整,有的不行。
9.3.2 GDT
描述每一个块组的信息。每个块组对应 GDT 里的一项,记录:这个块组的块位图在哪、inode 位图在哪、inode 表在哪、这个块组有多少空闲块、多少空闲 inode、多少已用目录等。
超级块管全局,GDT 管每个块组的具体位置和状态。有了 GDT,系统才知道去哪个块组找位图和 inode 表。没有 GDT,系统只知道总共有多少个块组,但不知道每个块组的元数据放在哪。
GDT 本身也占用磁盘空间。如果文件系统有 80 个块组,每个块组描述符占 32 字节或 64 字节,那么 GDT 总共占 80 × 32 = 2560 字节,或者 80 × 64 = 5120 字节。这些描述符连续存放,放在块组 0 的超级块之后。如果 GDT 太大,一个块装不下,就会占用多个块,这些块叫“保留 GDT 块”(Reserved GDT blocks)。
GDT 对应的结构体叫 ext4_group_desc,简化后:
struct ext4_group_desc {
    __le32  bg_block_bitmap_lo;    // 块位图所在的块号(低 32 位)
    __le32  bg_inode_bitmap_lo;    // inode 位图所在的块号
    __le32  bg_inode_table_lo;     // inode 表起始块号
    __le16  bg_free_blocks_count_lo; // 本块组空闲块数
    __le16  bg_free_inodes_count_lo; // 本块组空闲 inode 数
    __le16  bg_used_dirs_count_lo;   // 本块组目录数
    __le16  bg_flags;                // 标志位
    __le32  bg_exclude_bitmap_lo;    // 快照排除位图
    __le16  bg_block_bitmap_csum_lo; // 块位图校验和
    __le16  bg_inode_bitmap_csum_lo; // inode 位图校验和
    __le16  bg_itable_unused_lo;     // 未使用的 inode 数
    __le16  bg_checksum;             // 本描述符校验和
};
bg_block_bitmap_lo、bg_inode_bitmap_lo、bg_inode_table_lo 这三个字段最关键,分别指向本块组的块位图、inode 位图、inode 表的起始块号。系统要分配块或 inode 时,先查 GDT 找到这些位置,再去对应的位图里找空闲位。
bg_free_blocks_count_lo 和 bg_free_inodes_count_lo 记录了本块组的空闲资源数量。系统在分配时,会优先选择空闲资源多的块组,这样可以平衡各块组的负载,避免某个块组过早用完。
bg_used_dirs_count_lo 记录本块组有多少个目录。这个字段用于目录分配策略,系统在创建新目录时,会尽量选择目录少的块组,让目录分布更均匀。
bg_flags 是标志位,比如 EXT4_BG_INODE_UNINIT 表示 inode 表还没初始化,EXT4_BG_BLOCK_UNINIT 表示块位图还没初始化。这些标志用于加速格式化过程,格式化时不用把所有位图都写一遍,只标记为“未初始化”,等真正用到时再初始化。
bg_checksum 是校验和,用于检测 GDT 是否损坏。如果校验和不匹配,说明 GDT 有问题,可能需要用备份恢复。
说白了就是gdt管块组内的,超级块管的是文件系统的。
9.3.3 块位图
一个二进制位图,每一位对应本块组里的一个数据块。0 表示空闲,1 表示已占用。
创建文件需要分配数据块,系统通过块位图快速找到空闲块;删除文件时,把对应位清零即可。块位图是文件系统分配数据块的唯一依据,如果块位图损坏,系统就不知道哪些块空闲、哪些块占用,可能导致数据被覆盖。
块位图占用的空间可以算出来:一个块组有 s_blocks_per_group 个块,每个块需要 1 位,所以需要 s_blocks_per_group / 8 字节。如果每个块组 32768 个块,那就是 32768 / 8 = 4096 字节,正好一个 4KB 块装得下。如果块组更大,比如 65536 个块,那就需要 8192 字节,两个 4KB 块才能装下。
块位图里,哪些位是 1?本块组里已经用于存元数据的块,比如超级块、GDT、保留 GDT 块、块位图本身、inode 位图、inode 表,这些块都标记为 1。剩下的数据块区域,初始时都是 0,表示空闲。随着文件创建,分配出去的块逐渐变成 1。
在代码里,判断某一位是否被占用的逻辑大概是这样:
// 判断块组 bg 中第 bit 位对应的块是否被占用
static int ext4_test_bit(int nr, const void *addr)
{
const unsigned char *p = addr;
return 1 & (p[nr >> 3] >> (nr & 7));
}
// 设置某一位为 1,表示占用
static void ext4_set_bit(int nr, void *addr)
{
unsigned char *p = addr;
p[nr >> 3] |= 1 << (nr & 7);
}
// 清除某一位为 0,表示空闲
static void ext4_clear_bit(int nr, void *addr)
{
unsigned char *p = addr;
p[nr >> 3] &= ~(1 << (nr & 7));
}
9.3.4 inode位图
一个二进制位图,每一位对应本块组里的一个 inode。0 表示空闲,1 表示已占用。
创建文件需要分配一个 inode,系统通过 inode 位图快速找到空闲 inode;删除文件时,把对应位清零。和块位图一样,inode 位图也是分配 inode 的唯一依据。
inode 位图的大小取决于每个块组有多少 inode。如果 s_inodes_per_group 是 8192,那么需要 8192 / 8 = 1024 字节。如果 s_inodes_per_group 是 16384,那就需要 2048 字节。inode 位图通常比块位图小,因为 inode 数量一般远少于块数量。一个块组 32768 个块,但可能只有 8192 个 inode,比例是 4:1。
inode 位图和块位图的操作方式完全一样,都是位操作。区别只是:块位图的每一位对应一个数据块,inode 位图的每一位对应一个 inode。系统分配 inode 时,也是按 32 位一组扫描,跳过全 1 的组,找到第一个 0 位。
inode 位图里,哪些位是 1?已经被分配出去的 inode 对应的位是 1。初始时,只有 1 到 10 号 inode 被保留,对应位是 1,根目录 inode 是 2 号,对应位也是 1。其他位都是 0,表示空闲。随着文件创建,分配出去的 inode 对应位逐渐变成 1。
9.3.5 节点表
真正存放 inode 的地方。每个块组里有一张 inode 表,里面是一排排的 inode 结构。每个文件/目录对应其中一个 inode,里面存元数据和数据块指针。
inode 位图只记录“哪个 inode 空闲”,真正的 inode 内容存在 inode 表里。系统通过 inode 号找到对应的 inode 表项,读取出文件的元数据和数据块指针。
inode 表占用的空间可以算出来:每个块组有 s_inodes_per_group 个 inode,每个 inode 占 s_inode_size 字节。如果 8192 个 inode,每个 256 字节,那就是 8192 × 256 = 2MB。2MB 除以 4KB 等于 512 个块。所以块组 0 的 inode 表占 516 到 1031,共 516 个块,差不多是 2MB。
inode 结构体在 ext4 里叫 ext4_inode,简化后:
struct ext4_inode {
    __le16  i_mode;        // 文件类型和权限
    __le16  i_uid;         // 所有者 UID(低 16 位)
    __le32  i_size_lo;     // 文件大小(低 32 位)
    __le32  i_atime;       // 访问时间
    __le32  i_ctime;       // inode 修改时间
    __le32  i_mtime;       // 文件内容修改时间
    __le32  i_dtime;       // 删除时间
    __le16  i_gid;         // 所属组 GID(低 16 位)
    __le16  i_links_count; // 硬链接计数
    __le32  i_blocks_lo;   // 占用块数
    __le32  i_flags;       // 文件标志
    __le32  i_osd1;        // 操作系统相关
    __le32  i_block[15];   // 数据块指针,重点在这
    __le32  i_generation;  // 文件版本
    __le32  i_file_acl_lo; // ACL
    __le32  i_size_high;   // 文件大小(高 32 位)
    // ... 后面还有扩展字段
};
i_mode 字段很关键,它同时表示文件类型和权限。高 4 位表示文件类型:0x1000 是普通文件,0x4000 是目录,0x2000 是字符设备,0x6000 是块设备,0xA000 是符号链接,0x8000 是普通文件。低 12 位表示权限:所有者、组、其他人的读、写、执行权限。
i_links_count 是硬链接计数。创建一个硬链接时,这个计数加 1;删除一个硬链接时,计数减 1。只有计数变成 0,系统才会真正释放 inode 和数据块。所以硬链接不是复制文件,只是给同一个 inode 增加一个名字。
i_size_lo 和 i_size_high 合起来是文件大小,64 位。i_size_lo 是低 32 位,i_size_high 是高 32 位。对于小于 4GB 的文件,高 32 位是 0。
i_atime、i_ctime、i_mtime、i_dtime 是四个时间戳:
-
i_atime:访问时间,读文件时更新。 -
i_ctime:inode 修改时间,修改权限、所有者等元数据时更新。 -
i_mtime:文件内容修改时间,写文件时更新。 -
i_dtime:删除时间,删除文件时写入。
i_blocks_lo 记录文件占用了多少个 512 字节的扇区。注意,不是块数,是扇区数。一个 4KB 块等于 8 个 512 字节扇区,所以如果文件占了一个块,i_blocks_lo 是 8。
重点看 i_block[15]。这 15 个 32 位整数是数据块指针,结构是这样:
-
i_block[0]到i_block[11]:12 个直接指针,直接指向数据块。 -
i_block[12]:一级间接指针,指向一个块,这个块里存的是数据块指针。 -
i_block[13]:二级间接指针,指向一个块,这个块里存一级间接块的指针。 -
i_block[14]:三级间接指针。
这个设计使得小文件用直接指针就够了,大文件才用间接指针,节省 inode 空间。一个 4KB 块能存 4096 / 4 = 1024 个指针。
9.3.6 Data Block
真正存放文件内容的地方。普通文件的数据、目录的内容都放在数据块里。
数据块是文件系统里数量最多的部分。一个块组里,元数据只占开头一小部分,剩下的大部分都是数据块。比如块组 0 里,超级块 1 个、GDT 1 个、保留 GDT 块 512 个、块位图 1 个、inode 位图 1 个、inode 表 516 个,加起来 1032 个块,而块组总共 32768 个块,剩下 31736 个块都是数据块。
目录也是一种文件,它的数据块里存的是目录项,每个目录项记录“文件名 → inode 号”的映射。
目录项结构大概是这样:
struct ext4_dir_entry_2 {
    __le32  inode;      // inode 号
    __le16  rec_len;    // 这个目录项的长度
    __u8    name_len;   // 文件名长度
    __u8    file_type;  // 文件类型
    char    name[255];  // 文件名
};
9.4 文件格式化
所以格式化的本质就是干这些事情:
在一个分区里建好文件系统的管理结构,让它能存文件。
-
定块大小 比如 4KB 一块,定完不能改。
-
划分块组 把分区切成一个个块组,比如每 128MB 一组。
-
算 inode 总数 决定总共能建多少个文件,定完不能改。
-
写超级块 记录全局信息:总块数、总 inode 数、块多大、inode 多大、魔数、UUID。主份在块组 0,备份分散在其他块组。
-
写 GDT 每个块组一项,记录这个块组的块位图、inode 位图、inode 表在哪,空闲多少块、多少 inode。
-
初始化位图 块位图标记哪些数据块已占用、哪些空闲;inode 位图标记哪些 inode 已占用、哪些空闲。已用于元数据的块标为占用,其余标为空闲。
-
初始化 inode 表 清空 inode 表,建根目录
/的 inode(通常是 2 号)和数据块,里面放.和..。 -
写文件系统标识 写入类型、UUID、卷标。
-
建日志区 ext4 会分一块区域做日志,记录元数据修改,崩溃后可恢复。
因此格式化本质就是写入文件系统的管理信息。
9.5 inode与Data Block映射
9.5.1 ext2 / ext3
文件内容存在 data block 里,但 data block 是一堆散落的块,系统怎么知道某个文件的数据在哪些块?答案是再inode 里记录。
每个文件有一个 inode,inode 里除了元数据(大小、权限、时间),还有一组数据块指针。这些指针指向实际存文件内容的 data block。
ext4 的 inode 里有个字段叫 i_block[15],15 个 32 位整数,分成四段:
i_block[0] ~ i_block[11]:12 个直接指针
i_block[12]:一级间接指针
i_block[13]:二级间接指针
i_block[14]:三级间接指针
直接指针:
i_block[0] 到 i_block[11] 直接指向数据块。
比如一个文件只有 10KB,占 3 个 4KB 块:
i_block[0] → 块 1000
i_block[1] → 块 1001
i_block[2] → 块 1002
系统读文件时,直接顺着这些指针去读块 1000、1001、1002。
一级间接指针:
文件再大,12 个直接指针不够用,就用 i_block[12]。
它指向一个间接块,这个块里存的不是文件数据,而是一堆数据块指针。一个 4KB 块能存 4096 / 4 = 1024 个指针。
i_block[12] → 间接块 2000
                间接块 2000 里:
                  指针 0 → 块 3000
                  指针 1 → 块 3001
                  指针 2 → 块 3002
                  ...
这样一级间接就能多管 1024 个块,即 4MB。
二级、三级间接:
再大就用 i_block[13]、i_block[14],多级跳转。
i_block[13] → 一级间接块 → 一堆二级间接块 → 一堆数据块
i_block[14] → 一级 → 二级 → 三级 → 数据块
所以意思就是:
直接指针是直接指向一个块,意思就是 4KB 大小的那些块。总共能放48KB大小的数据,位置为i_block[0] 到 i_block[11]。
间接指针(一级间接指针)而是指向一个个指针组。每一个指针组里头都是一个个直接指向块的指针,一个 4KB 的指针数据块能存 4096 / 4 = 1024 个指针。总共可以放 4MB,位置为i_block[12]。
二级指针(二级间接指针)则是套娃,指向一个个间接指针组。总共可以放 4GB ,位置为i_block[13]。三级指针等等同理。
也就是说12 个直接指针指向的数据块:
一级间接指针块里的 1024 个指针指向的数据块
二级间接指针块里的 1024×1024 个指针指向的数据块
三级间接指针块里的 1024×1024×1024 个指针指向的数据块
9.5.2 ext4
ext4 默认开启 extent 特性,inode 里不再放 15 个块指针,而是放 extent 树的根。
一个 extent 描述的是一段连续的物理块:从逻辑块 X 开始,连续 N 个块,映射到物理块 Y。
好处:
-
大文件用少量 extent 就能描述一大片连续区域
-
减少元数据开销
-
减少寻道
extent 树:
-
小文件:inode 内 4 个 extent 直接放得下,深度 0。
-
较大文件:inode 内放不下,用一层索引节点(extent 索引),深度 1。
-
更大文件:多层索引,深度最多到 5 左右。
所以 ext4 里也有“多级”的概念,但它是 extent 树的多级索引,不是传统意义上的“一级/二级/三级间接指针块”。
| ext2/ext3 | ext4 默认 | |
|---|---|---|
| inode 寻址 | 12 直接 + 1/2/3 级间接 | extent 树 |
| 小文件 | 直接指针 | inode 内 extent |
| 大文件 | 逐级启用间接 | extent 树加深 |
| 连续大文件 | 每个块都要记 | 一个 extent 记一大段 |
| 最大文件 | ~4TB(4K 块) | 16TB 级别(受 extent 限制) |
结构如下:
struct ext4_extent_header {
    __le16 eh_magic;       // 魔数,固定 0xF30A
    __le16 eh_entries;     // 当前节点实际有多少个条目
    __le16 eh_max;         // 当前节点最多能放多少个条目
    __le16 eh_depth;       // 当前节点在树中的深度,0 表示叶子
    __le32 eh_generation;  // 用于调试/一致性检查
};
struct ext4_extent {
    __le32 ee_block;      // 本 extent 覆盖的逻辑起始块号
    __le16 ee_len;        // 覆盖的块数
    __le16 ee_start_hi;   // 物理起始块号高 16 位
    __le32 ee_start_lo;   // 物理起始块号低 32 位
};
操作系统下一切都是先描述再组织,extent方式其实说白了就是极大减少了描述时所需要的数据。不过文件内容在分配的过程中过于离散,产生大量文件碎片的话其实优势会被压缩。
但是要注意要是ext4吧extent关了就退回ext2/ext3的指针管理了。对于其他文件系统的话:XFS 用 B+ 树,Btrfs 用 B 树,NTFS 用 runlist,ZFS 用 ZAP/块指针,思路类似但结构不同。
9.6 目录与文件名
问题:我们访问⽂件,都是⽤的⽂件名,没⽤过inode号啊?⽬录是⽂件吗?如何理解?
答案:⽬录也是⽂件,但是磁盘上没有⽬录的概念,只有⽂件属性+⽂件内容的概念。⽬录的属性不⽤多说,内容保存的是:⽂件名和Inode号的映射关系
说白了就是磁盘层面只有 inode + 数据块,没有“目录”这种特殊东西;目录不过是 ” 内容被解释成文件名→inode 号映射表 “ 的普通文件。意思就是普通文件的数据块放着用户数据还有其他内容等等,但是目录的数据库放着的inode号还有文件名。然后通过访问目录的数据块得到inode号和文件名以后,通过inode表拿到对应数据块指针直接找到对应文件进行访问。
#include <stdio.h>
#include <string.h>
#include <stdlib.h>
#include <dirent.h>
#include <sys/types.h>
#include <unistd.h>
int main(int argc, char *argv[]) {
if (argc != 2) {
fprintf(stderr, "Usage: %s <directory>\n", argv[0]);
exit(EXIT_FAILURE);
}
DIR *dir = opendir(argv[1]); // 打开目录,拿到目录流
if (!dir) {
perror("opendir");
exit(EXIT_FAILURE);
}
struct dirent *entry;
while ((entry = readdir(dir)) != NULL) { // 逐个读取目录项
// 跳过 "." 和 ".."
if (strcmp(entry->d_name, ".") == 0 || strcmp(entry->d_name, "..") == 0) {
continue;
}
printf("Filename: %s, Inode: %lu\n",
entry->d_name, (unsigned long)entry->d_ino);
}
closedir(dir);
return 0;
}
而这段代码就是用 opendir、readdir、closedir 打开一个目录,把目录数据块里的目录项一条条读出来,每条里面就是文件名(d_name)和 inode 号(d_ino),跳过 . 和 .. 之后打印成“Filename: xxx, Inode: n”。
说白了,目录就是普通文件,它的数据块里放的就是“文件名 → inode 号”这张映射表。它打印出来的结果和 ls -li / 里的文件名、inode 号完全对得上,就说明目录项里确实存的是这俩东西;而 readdir 的顺序和 ls 的排序不一样,也说明目录数据块里目录项的物理排列顺序跟用户看到的排序没关系。拿到 inode 号之后,再去 inode 表里找到对应的 inode,从 inode 里拿到数据块指针,就能访问文件的数据块了。
9.7 路径解析
路径解析就是把用户或程序给出的“路径字符串”,转换成系统能定位到的实际文件或目录的过程。
说白了就是操作系统会拿 /后的文件(目录),然后去查目录手中的inode表,找里面对应的inode编号然后跳到下一个文件,然后再根据下一个文件名字继续不断去翻inode表到对应的下一个文件。
9.8 路径缓存
路径解析每级都要查目录,太慢。所以内核把解析过的路径结果缓存在内存里,这就是 dentry 缓存。
缓存的基本单位是 dentry(目录项),一个 dentry 代表"路径中的一段",记录了:
-
名字(如
home、whb、test.c) -
对应的 inode
-
和父目录、子目录的关联
这些 dentry 连起来,就构成内存中的目录树。
第一次访问 /home/whb/code/test.c,逐级读磁盘,查 / → home → whb → code → test.c,每级的结果都生成 dentry,挂进缓存。
第二次访问同一路径直接从缓存里按名字逐级命中 dentry,不用再读磁盘的目录数据块。
也就是说:
dentry 缓存就是把解析过的路径结果留在内存里。
访问过的路径,各级 dentry 都挂在缓存中。下次再访问:
-
直接从内存里按名字逐级命中
-
不用再读磁盘的目录数据块
解析一次,缓存下来,之后直接复用。
9.9 htree
哈希表和b树的结合版,是ext4下Linux操作系统管理文件系统的一种数据结构。
htree 只管一件事:
目录文件内部,目录项 (name → inode) 按 name 哈希分区后落在哪个逻辑块,以及怎么快速定位到那个块。
主要就是:
-
对象:目录文件的内容(那一堆目录项)。
-
排布规则:按 name 的哈希值分区,一个区间塞一个逻辑块。
-
索引结构:哈希值 → 块号 的映射树(根节点 + 可能的中间节点 + 叶子块)。
-
查找:给一个 name,算哈希,二分定位到块,块内线性比对。
-
插入/分裂:往对应块插目录项,块满了分裂并更新索引。
不归它管的:
-
哪个目录是父目录 → 路径解析
-
目录项落到磁盘哪个物理块 → extent
-
inode 本身怎么分配、内容怎么存 → inode 表 / extent
-
归属关系本身 → 就是那条目录项的存在,不是 htree 建立的
和extent不同,extent啥也不管,只是映射关系的描述,大幅度减少了描述时所需要的数据,减少了内存的使用。htree管的是逻辑空间上,一个该目录下的文件,根据name哈希应该到哪些块去找到。
htree 是目录这个文件内部的一种索引结构。它建立的是:文件名哈希值 → 目录数据块(逻辑块号)的关系。
完整步骤就是:
-
对文件名算哈希。
-
用哈希在 HTree 里查 → 得到目录下的某个逻辑块号。
-
读那个块。
-
在块里逐条比对文件名,找到匹配的目录项。
-
读出 inode 号。
路径解析后跳转也就可以理解成实际上是通过哈希映射找到对应的数据块了,然后看看里面的inode编号找到下一要去的文件或者目录,因为目录本身也是文件只是文件里装了文件,日常我们叫文件夹。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 2
 0
- 0


 已为社区贡献3条内容

所有评论(0)