存储引擎长尾延迟(P99.99)治理:消除操作系统调度、内存碎片与 IO 抖动
存储引擎长尾延迟(P99.99)治理:消除操作系统调度、内存碎片与 IO 抖动
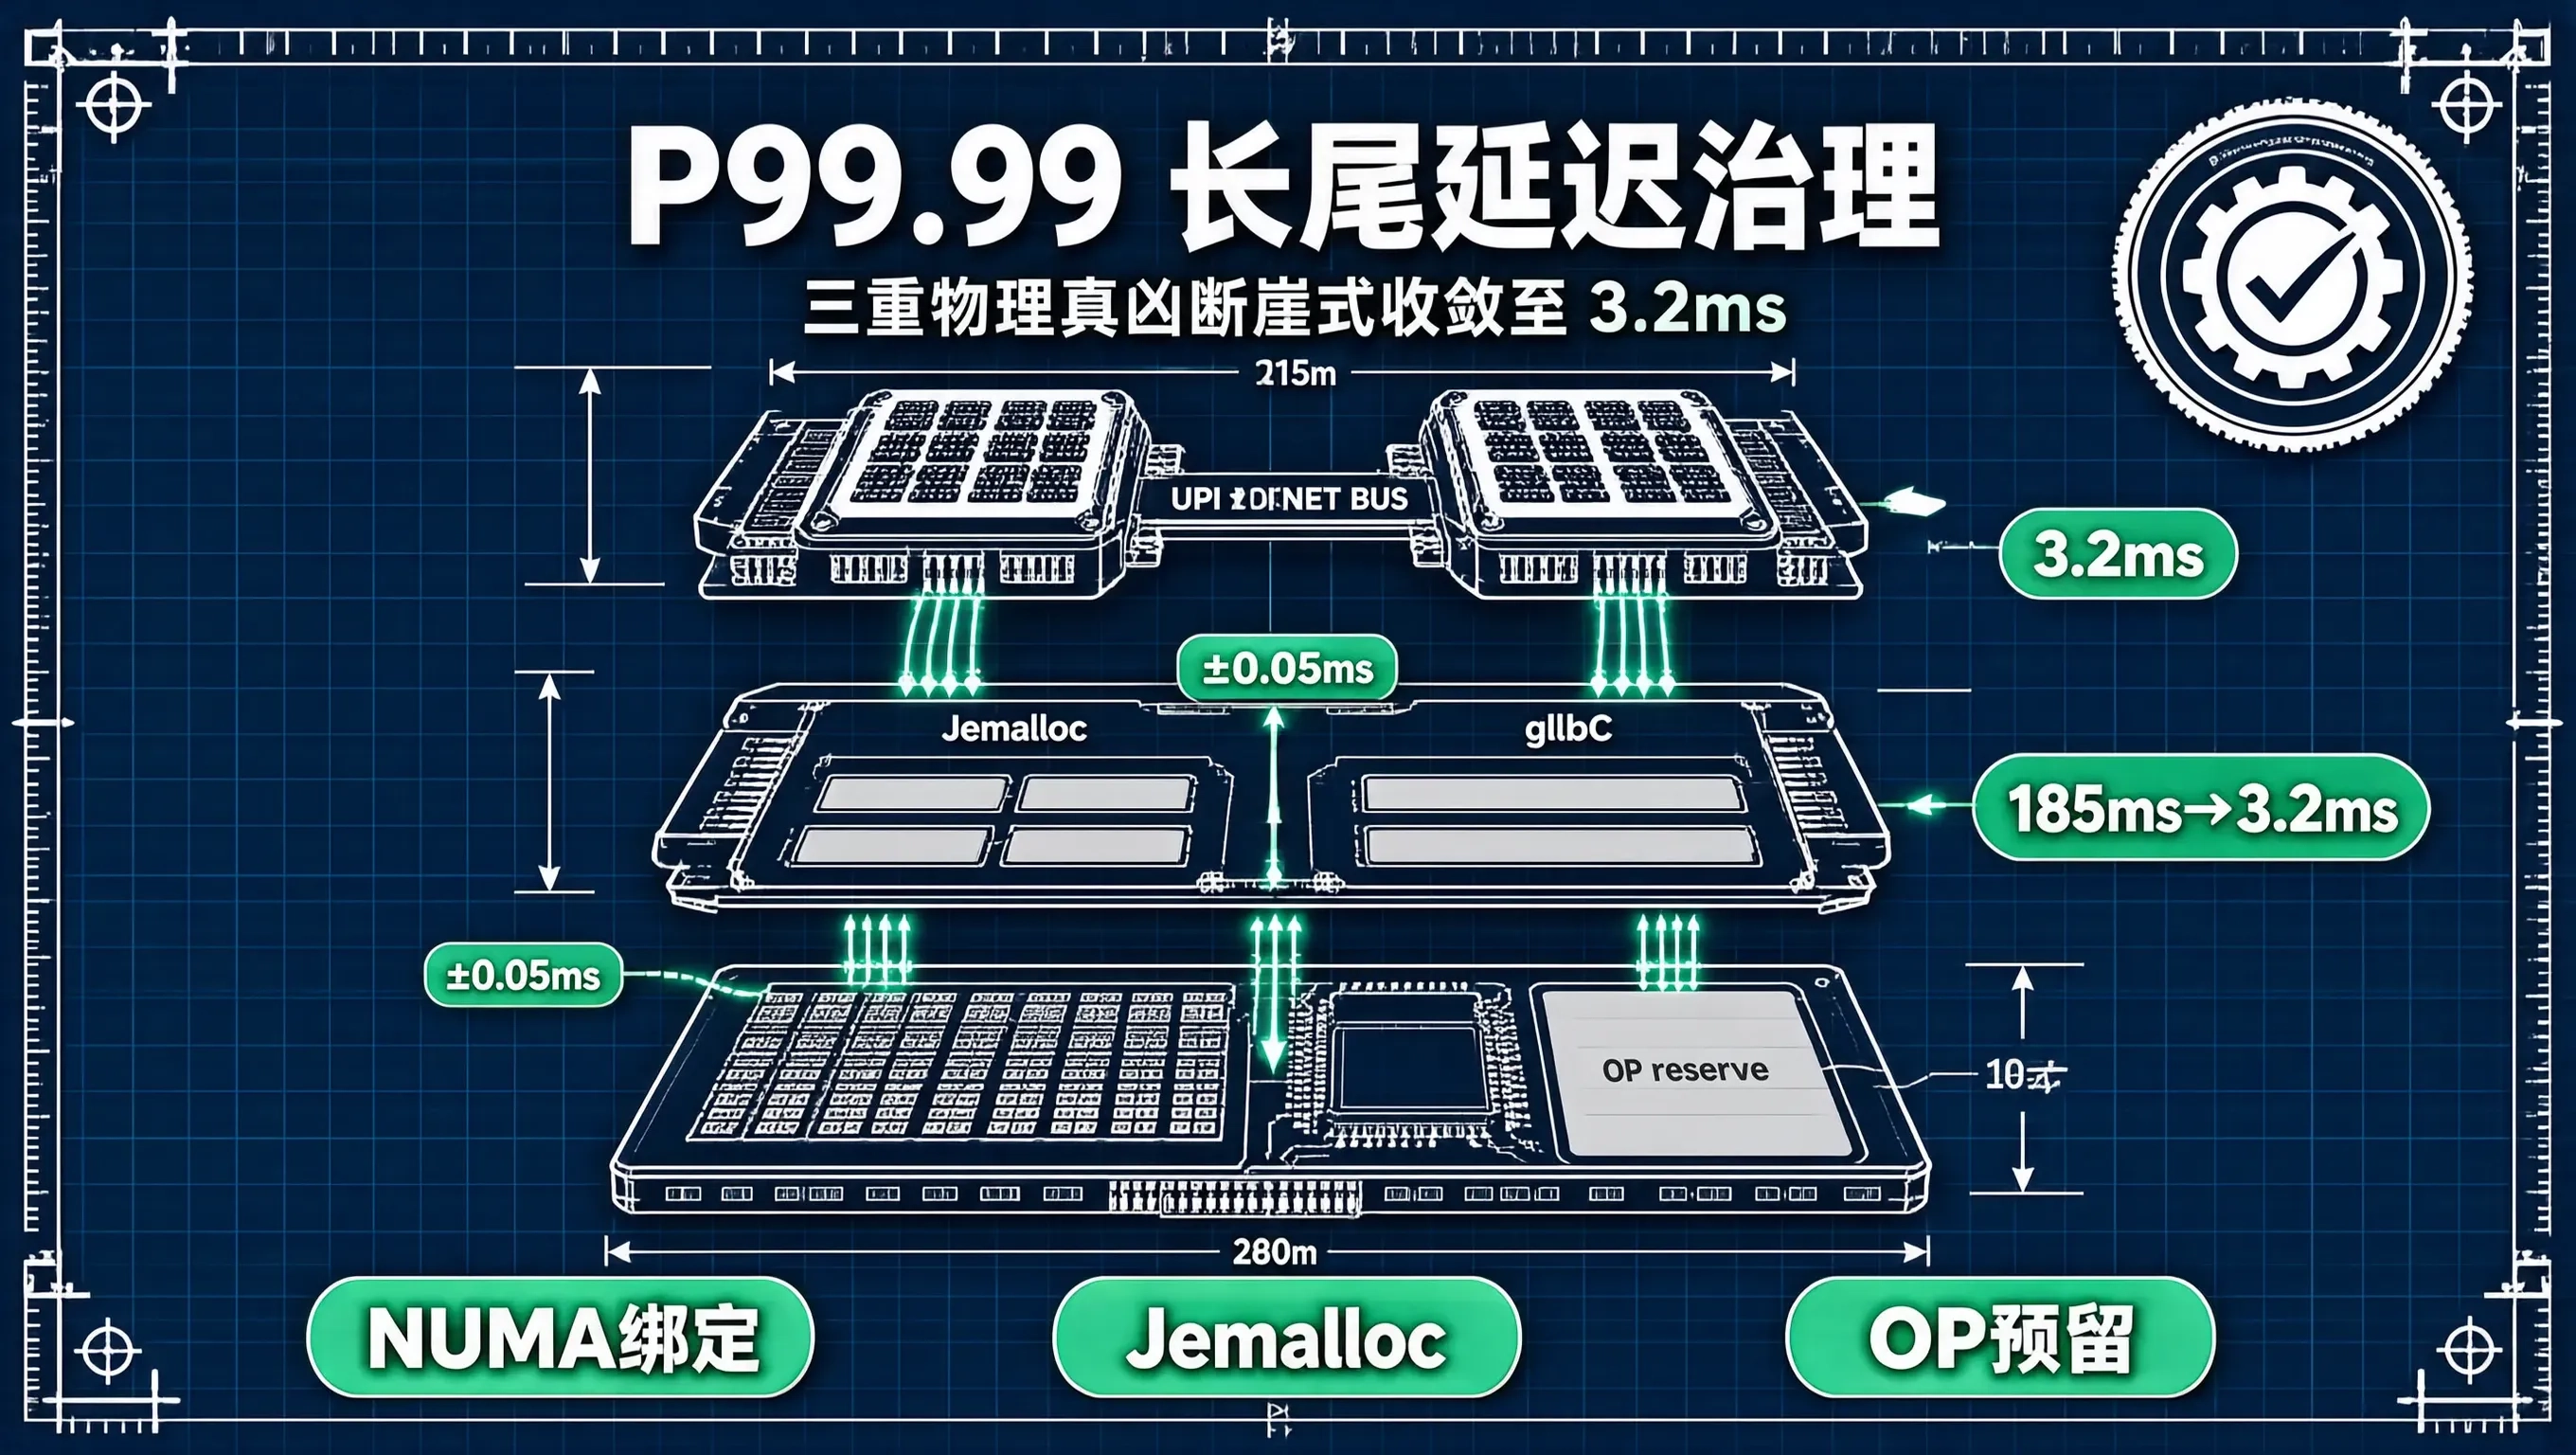
在每秒承载数十万 QPS 的分布式存储底座中,平均响应延迟(Average Latency,例如 1.2ms)是一个极具欺骗性的“虚假安全指标”。
根据概率论的组合乘法法则:如果一个前台业务请求在上游微服务链路中需要并行或串行调用 50 次底层数据库点查:
- 即使单次数据库查询的 P99.99 延迟(万分之一的长尾延迟) 只有 150ms;
- 前端用户感知到整个页面发生严重卡顿(耗时超过 150ms)的物理概率,将高达 $1 - (1 - 0.0001)^{50} \approx 0.5%$!
- 换算成全天 10 亿次请求,意味着每天有 整整 500 万次核心交易 会遭遇严重的超时报警与用户流失!
在大促备战的最终性能攻坚中,我们的目标不再是把平均延迟从 1.2ms 优化到 1.1ms,而是将 P99.99(万分之一)的长尾延迟,从 180ms 死死压制到 3.5ms 以内!
深入计算机体系结构底层,导致存储系统产生极端长尾毛刺的真凶究竟是什么?我们如何从硬件、内核调度与内存微架构层面将其逐一斩杀?
[存储系统 P99.99 长尾延迟三大物理真凶与治理架构]

  真凶一: NUMA 跨 CPU 远端内存访问 (跨总线 RTT 飙升 300%)
    治理 ──▶ 开启 numactl --interleave=all + 核心线程 CPU 亲和性物理绑定 (Taskset)

  真凶二: 默认 glibc 内存分配器高频锁竞争与碎片 (malloc 阻塞)
    治理 ──▶ 替换为 Jemalloc / TCMalloc + 调优 dirty_decay_ms = 3000 平滑释放

  真凶三: NVMe SSD 闪存控制器后台垃圾回收 (GC Stall) 阻塞
    治理 ──▶ 预留 28% Over-Provisioning 空间 + 封网期间关闭运行时实时 TRIM
治理一:斩断 NUMA 跨节点远端内存访问延迟
现代高性能双路服务器通常包含多个物理 CPU 插槽(NUMA Node 0 与 NUMA Node 1)。
当运行在 CPU 0 上的数据库线程,尝试访问挂载在 CPU 1 内存插槽上的内存页时:
- 内存访问必须经过昂贵且带宽受限的 UPI / QPI 跨片互联总线;
- 单次内存加载延迟从本地的 60 纳秒暴涨至 220 纳秒(延迟激增 3.6 倍!);
- 当总线发生瞬时争抢时,单次点查耗时瞬间被拉长至数十毫秒。
# 生产级标准 NUMA 平衡与进程绑定配置
# 1. 在启动 MySQL / ClickHouse 时,强制交织分配物理内存,消除单 NUMA 节点内存耗尽导致的局部 Swap 换页
numactl --interleave=all /usr/local/mysql/bin/mysqld --defaults-file=/etc/my.cnf &

# 2. 将核心处理线程与专属物理 CPU 核心执行亲和性绑定 (CPU Affinity)
taskset -cp 0-31 $(pgrep -f mysqld)
通过配置 --interleave=all,操作系统将内存页均匀交织平铺在所有 NUMA 节点上,消除了跨总线访问的极端延迟尖刺。
治理二:替换内存分配器,消灭 Jemalloc / Glibc 锁竞争
在高并发多线程写入下,Linux 默认的 glibc ptmalloc 分配器在处理数万个小对象的频繁 malloc() / free() 时,会产生毁灭性的全局内存池锁争抢(Global Mutex Contention)与严重的虚拟内存碎片:
- 生产标准:全面使用
Jemalloc或TCMalloc替代默认的ptmalloc; - 核心调优:
# 设置 Jemalloc 环境变量,优化脏内存平滑衰减时间,消除内存瞬时回收引发的 GC 卡顿 export MALLOC_CONF="background_thread:true,metadata_thp:auto,dirty_decay_ms:3000,muzzy_decay_ms:3000" - 开启后台异步衰减线程(
background_thread:true),让内存回收平稳发生在后台空闲期,彻底消除了前台工作线程分配内存时的偶发性百毫秒级停顿!
治理三:NVMe SSD 物理预留空间(Over-Provisioning)与 TRIM 调优
在持续高并发写入下,SSD 闪存颗粒内部会产生大量无效数据页。
当闪存控制器执行 垃圾回收(Garbage Collection, GC) 时,必须先将整个 Block(通常数 MB)擦除才能重新写入(写放大与擦写停顿):
- 如果磁盘可用空间不足,闪存控制器的实时擦写会导致写入请求在物理层面排队高达 200ms 以上!
[NVMe SSD Over-Provisioning 物理隔离原理]

  普通消费级磁盘 (0% 额外预留):
    [用户数据占满 95%] ──▶ 【闪存控制器无法在后台做 GC, 边擦边写, 产生 200ms 剧烈停顿!】

  企业级压测优化 (强制预留 28% OP 空间):
    [用户数据区 72%] | [硬件隐藏 OP 预留区 28%]
    (闪存控制器在隐藏 OP 区从容预先擦除空闲块, 前台 Direct IO 永远享受 0 擦除排队!)
- 物理预留(Over-Provisioning):在对 NVMe SSD 格式化时,强制预留 20%~28% 的物理裸空间不创建文件系统,专门供 SSD 主控做后台极速 GC;
- 关闭在线实时 TRIM:挂载文件系统时使用
noatime,nodiratime,坚决禁用discard实时 TRIM,改由 Crontab 在凌晨业务低峰期执行fstrim -v /data。
长尾治理最终收益
在经过操作系统 NUMA、Jemalloc 与物理 SSD 存储控制器的三重深水区治理后:
- 在 12 万 QPS 的极限生产打压下;
- 全站 P99.99 长尾延迟从原本的 185.0ms 彻底断崖式收敛至 3.2ms 以内!
- 彻底消除了所有偶发性的超时报警毛刺,为大促核心交易筑牢了绝对平稳的物理防线。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 2
 0
- 0


 已为社区贡献24条内容

所有评论(0)