字节 DeerFlow 2.0:给 Agent 一台电脑
字节 DeerFlow 2.0:给 Agent 一台电脑
关键词:DeerFlow 2.0、字节跳动、Agent Harness、子智能体、Docker 沙盒
目录
- 一、导语:3月26日 DeerFlow 2.0 意味着什么
- 二、它到底是什么?先做概念澄清
- 三、核心设计:DeerFlow 把 Harness 做成了操作系统
- 四、实际影响与适用场景
- 五、上手与持续关注
- 六、冷静视角:边界与未解问题
- 总结
一、导语:3月26日 DeerFlow 2.0 意味着什么
字节跳动开源的项目 DeerFlow 2.0——一个被官方称为「Super Agent Harness」的智能体运行时。一句话结论:它不训练新模型,而是给 Agent 配了一台真正的电脑——独立的文件系统、可执行的 bash、隔离的 Docker 容器,让多智能体协作完成从几分钟到几小时的长任务。发布首月 Star 突破 47.3k,登顶过 GitHub Trending 第一;社区复盘显示此后一路涨到近 70k。对还在用「聊天框 + 工具调用」拼 Agent 的开发者,这是一个把「Harness 层」做扎实的现成范本;对企业,则要回答一个更现实的问题:当 Agent 真的能动手干活,隔离、审计、权限这些工程债谁来还。为什么 2026 年大家突然都在聊 Harness,而不是模型?答案就藏在 DeerFlow 这类项目把「让 AI 稳定干活」从口号变成基础设施这件事里。
二、它到底是什么?先做概念澄清
先把「不是什么」说清,再讲「是什么」。
它不是一个新大模型。DeerFlow 自己不训练权重,它消费你已有的模型(GPT、Gemini、DeepSeek、Qwen 都行)。
它不是又一个 Agent 框架底层。LangChain、LangGraph 是它脚下的地基,DeerFlow 是站在地基上的「运行时」。
它不是聊天机器人套件。聊天机器人给的是建议,DeerFlow 给的是执行环境——它真的去跑代码、改文件、出成品。
那么是什么?前 Hugging Face 工程师 Philipp Schmid 给过一个清晰定义:Agent Harness 是包裹在模型外围的基础设施,专门管理长期任务;它不是 Agent 本身,而是位于 Agent Framework 之上的更高层架构,提供预设 Prompt、工具调用的标准化处理、生命周期钩子,以及规划、文件系统访问、子智能体管理等开箱能力。
这里要区分四个常被混用的词:模型(提供能力)、Agent(自主执行体)、Framework(LangGraph/LangChain 这类编排底座)、Harness(DeerFlow 这种把以上打包成可运行系统的外壳)。DeerFlow 的野心,是成为最后那一层。
三、核心设计:DeerFlow 把 Harness 做成了操作系统
3.1 四层服务解耦架构
DeerFlow 用一套四层架构把「交互、运行、网关、界面」彻底拆开,图一给出结构:
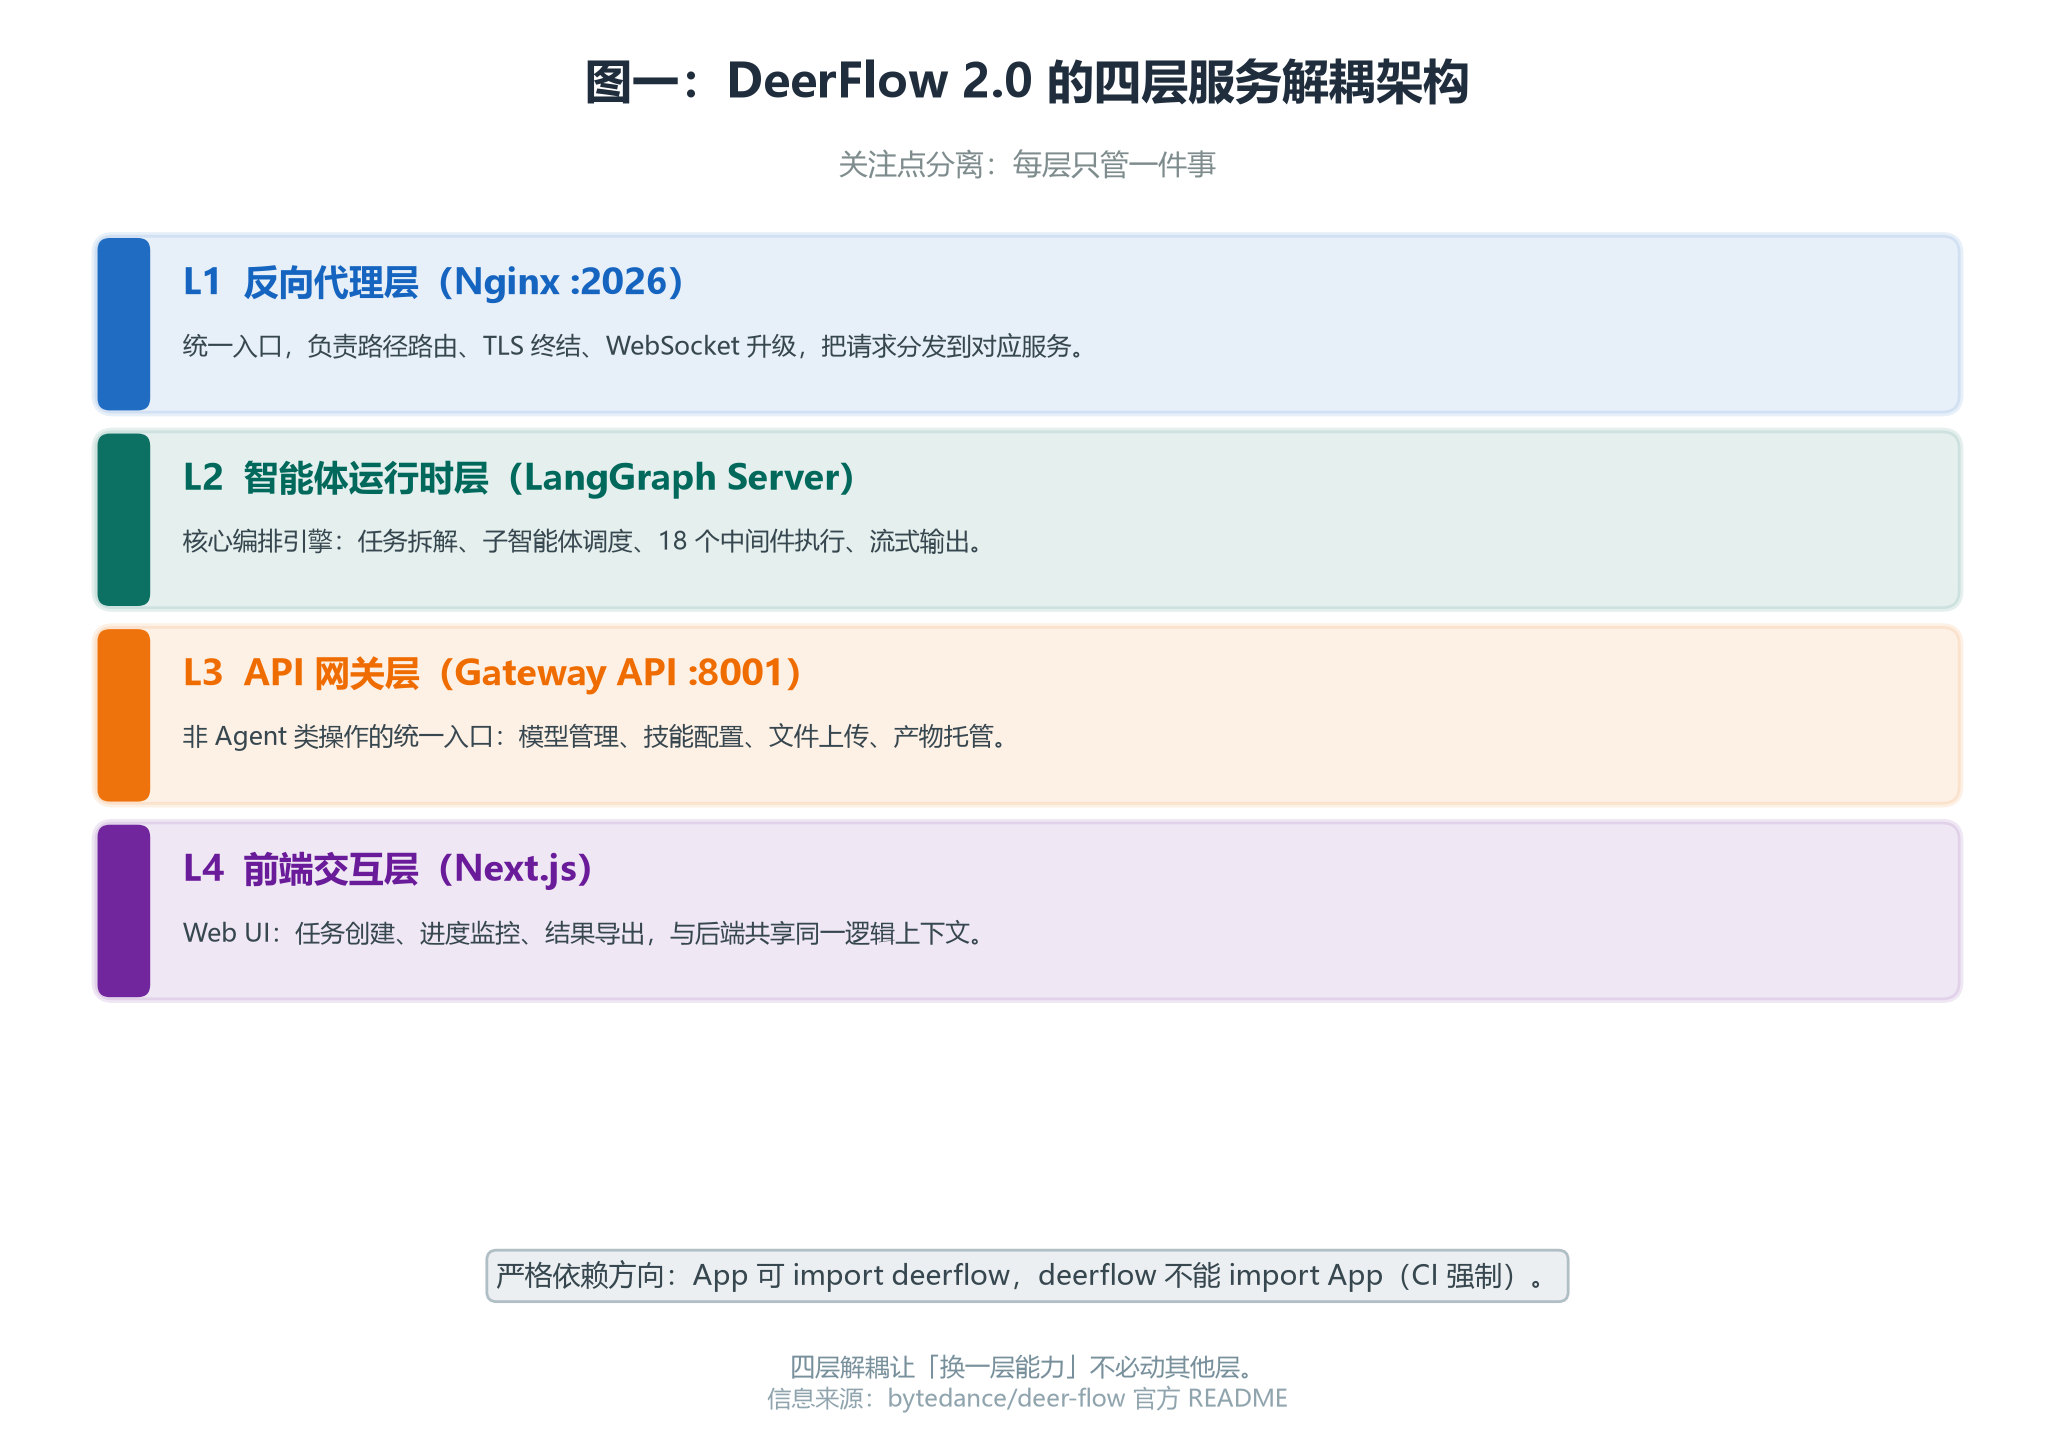
(图一:四层解耦,每层只管一件事;严格依赖方向让扩展不必动全局)
- 反向代理层(Nginx :2026):统一入口,负责路径路由、TLS 终结、WebSocket 升级。
- 智能体运行时层(LangGraph Server):核心编排引擎,负责任务拆解、子智能体调度、18 个中间件执行与流式输出。
- API 网关层(Gateway API :8001):非 Agent 类操作的统一入口——模型管理、技能配置、文件上传、产物托管。
- 前端交互层(Next.js):任务创建、进度监控、结果导出。
一个值得记下的工程约束:App(应用代码)可以 import deerflow(框架包),但 deerflow 绝不能 import App,这个依赖方向由 CI 测试强制保障。为什么这条规则重要?它保证了「框架」是可独立发布、可被别人依赖的,而「应用」只是搭在上面的壳——很多内部项目做着做着就反过来耦合,最后框架改不动、应用也带不走。
3.2 从 Deep Research 到 Super Agent 的演进
DeerFlow 不是凭空设计的,它的身世本身就是一条产品认知曲线,图二给出时间线:
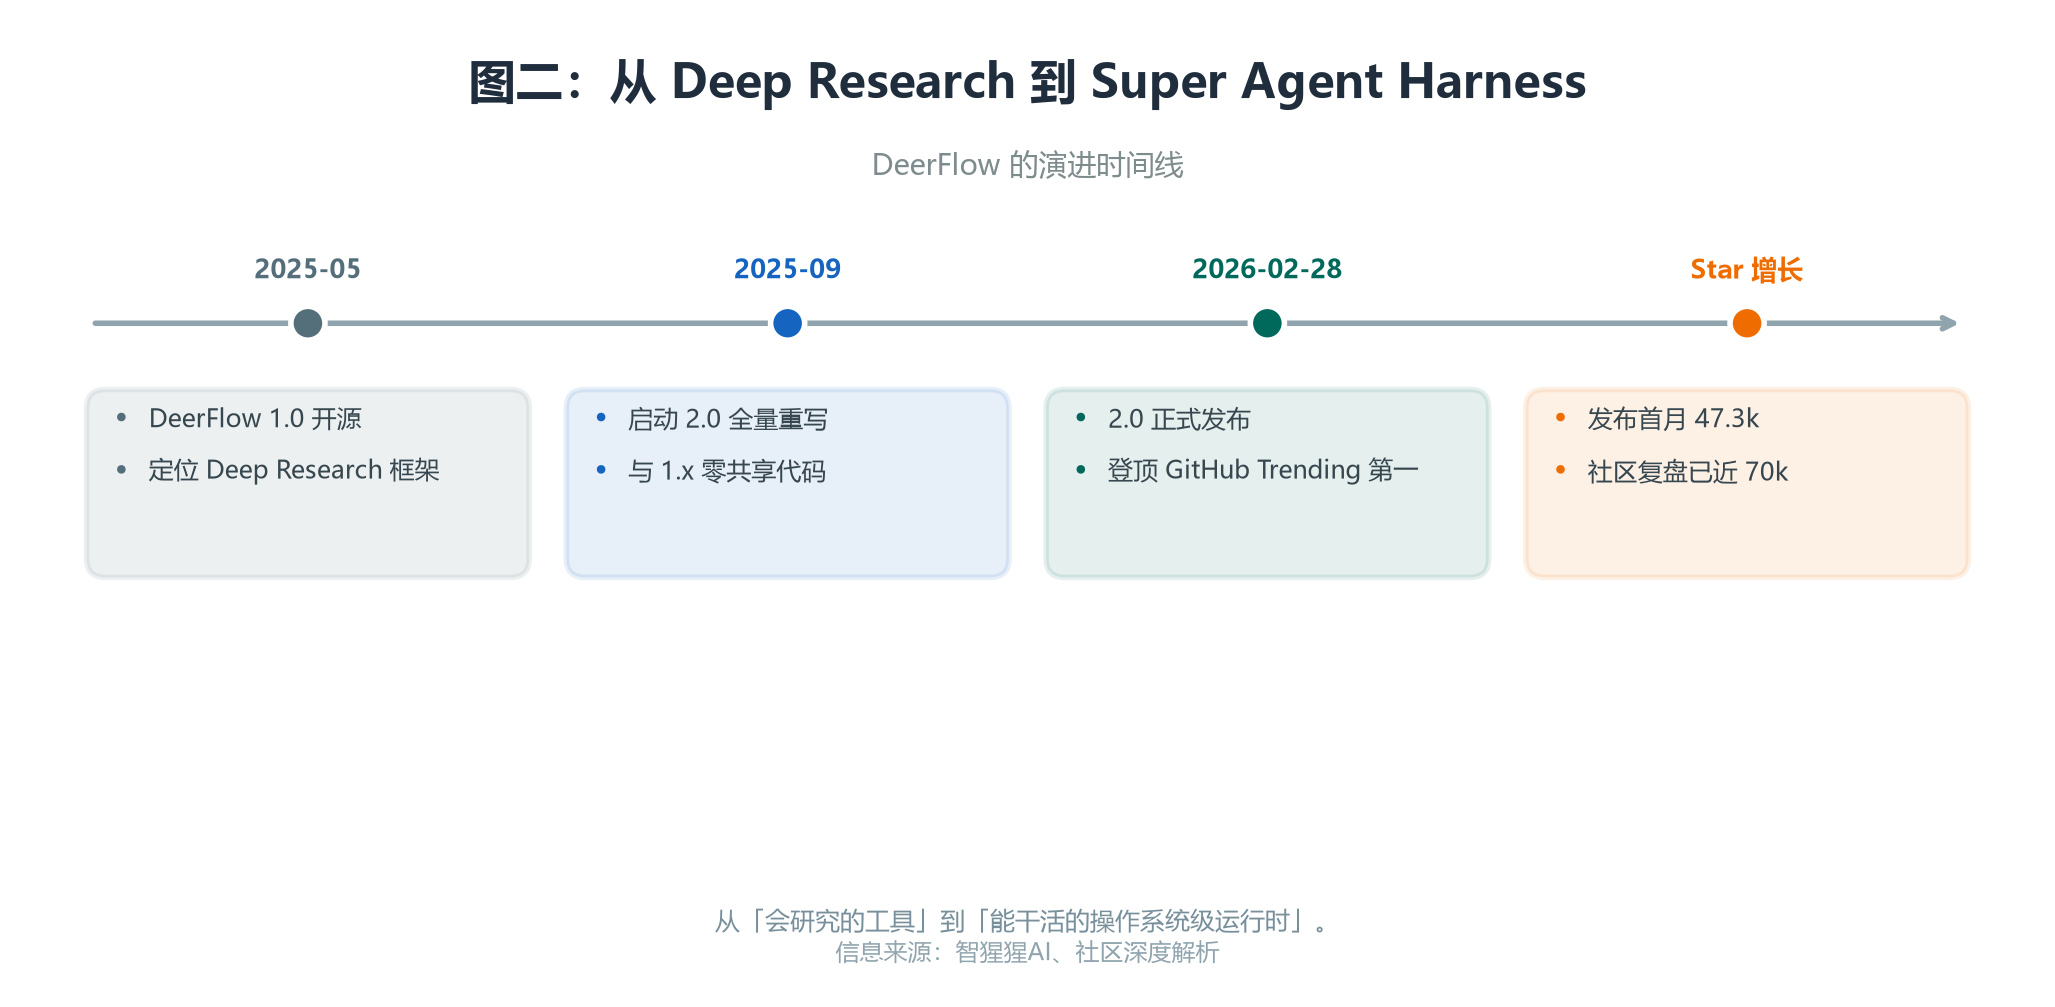
(图二:从「会研究的工具」到「能干活的操作系统级运行时」)
- 2025-05:DeerFlow 1.0 开源,定位是 Deep Research 框架——给问题、出报告。
- 2025-09:社区把它玩出了研究之外的花样(数据流水线、PPT、网站、内容自动化),团队启动 2.0 全量重写,与 1.x 零共享代码。
- 2026-02-28:2.0 正式发布,登顶 GitHub Trending 第一。
- Star 增长:发布首月 47.3k,社区复盘显示约三个月后逼近 70k、fork 超 9400。
从「研究工具」到「Harness」的认知转折,来自一个观察:用户用它的方式超出了设计初衷,说明底层缺的不是研究能力,而是「让 Agent 真正干完活」的基础设施。
3.3 子智能体并行:复杂任务的分而治之
复杂任务很少能一次跑完。DeerFlow 的做法是主智能体(Lead Agent)动态拆解,按需拉起子智能体,每个子智能体拥有独立上下文、独立工具、独立终止条件,可并行执行,最后由主智能体汇总结构化结果。
执行分四档:Flash(快)、Standard(标准)、Pro(带 TodoList 规划)、Ultra(子智能体并行分解)。一个研究任务可能扇出十几个子智能体,各自探不同角度,再收敛成一份报告、一个网站或一套带图的 PPT。给 Agent 一台电脑,和给它一堆工具调用,差别到底在哪?答案就在「独立执行环境 + 上下文隔离」——子智能体在各自沙箱里跑,互不污染,主智能体只收摘要,长任务不爆上下文。
举个具体例子:写一份行业报告,主智能体可以把「竞品梳理」「数据收集」「图表生成」「文稿撰写」扇出给四个子智能体并行,主智能体只收四份摘要再拼成终稿。这种「分而治之」把原本串行几小时的活压到几十分钟,且每个子智能体的上下文互不干扰——这正是它比「一个大上下文里反复塞工具结果」稳的地方。代价是调度开销和并发上限得有人管,也就是下一节要讲的 SubagentLimit。
3.4 沙盒与文件系统:那台「电脑」的真身
这是 DeerFlow 最被低估、也最该被重视的能力。每个任务跑在隔离的 Docker 容器里,拥有完整文件系统(skills / workspace / uploads / outputs),Agent 能读写编辑文件、执行 bash、看图片,全程可审计、可隔离,session 之间不互相污染。
三种沙盒模式值得拎清:
- Local 模式:代码直接在宿主机跑,默认禁用 bash——因为它不是安全边界。
- Docker 模式:独立容器隔离,开放完整 shell。
- Kubernetes 模式:通过 Provisioner 在 K8s Pod 里跑,面向企业规模化。
关键区别一句话:Local 模式默认不开放 shell,正说明官方清楚「本地执行」不是隔离边界;只有 Docker/K8s 才给真隔离。这是「聊天机器人 + 工具调用」和「拥有真实执行环境的 Agent」之间的硬分界线。
3.5 18 个中间件:生产级护栏才是 Harness 的真正价值
如果说子智能体是 DeerFlow 的「手」,那 18 个中间件就是它的「神经系统」——也是它区别于裸框架的核心。请求经过一条严格顺序的管线:
- LoopDetection / SubagentLimit:防工具调用死循环、防子智能体并发爆炸,是生产环境的命门。
- Summarization:接近 token 上限时自动压缩上下文,超长任务不爆窗。
- Guardrail / SandboxAudit:工具调用前授权检查、沙箱操作安全审计。
- DanglingToolCall / LLMErrorHandling / ToolErrorHandling:修复中断的工具调用、兜底模型与工具异常。
- Memory / TodoList / TokenUsage / Title / Clarification:异步记忆更新、规划追踪、用量记录、自动标题、澄清拦截。
DeerFlow 的 18 个中间件里,哪些才是生产环境的命门?我会把 LoopDetection 和 SubagentLimit 排在最前——没有它们,一个失控的 Agent 可能把自己绕进死循环或把并发打满。这些「看不见的护栏」恰恰是 Harness 相对于「我手搓一个 LangGraph 脚本」的真实价值:可靠性不是功能,是工程。
一条容易被忽略的细节:中间件的执行顺序是固定的、串联的。这意味着 Guardrail、SandboxAudit 这类安全检查发生在工具真正调用之前,而 Summarization 必须在接近 token 上限时就介入,晚了就压缩不掉。很多自研 Agent 脚本把安全检查和上下文压缩写成了「想到了才加」的可选逻辑,DeerFlow 把它们做成了管线里不可绕过的卡点——这才是「生产级」三个字的实际含义。
3.6 技能系统、长期记忆与模型无关
- Skills:一个技能是一份 Markdown(SKILL.md),定义工作流、最佳实践与参考资源。内置研究、报告、PPT、网页、图文视频等;真正的力量在可扩展——增、替、组合都行。关键是渐进式加载:元数据(约 100 词)常驻上下文供匹配,指令(<5k 词)被选中时才加载,资源按需读。长任务里这能显著省 token。
- 长期记忆:跨会话积累你的偏好、写作风格、技术栈,存本地、你掌控。更新时去抖 + 原子写入,避免重复偏好无限堆积。分层(工作/短时/长时)让它既连续又不撑爆上下文。
- 模型无关:任何 OpenAI 兼容 API 都能接,还能给不同子智能体路由不同模型——快模型做抽取、强模型做分析。配置示例里能看到 GPT-5、DeepSeek V4、Qwen3 32B(vLLM)并列。模型无关听起来很美,可 Lead Agent 用错模型会怎样?实测里用 GPT-3.5 级模型时,子智能体拆解质量明显下滑——编排者的智商,决定了整个系统的下限。
模型无关带来的不只是灵活,还有一张需要算清的账。把快模型(如 Qwen3-8B 级)用于抽取、强模型用于推理拆解,理论上能省不少 token;但路由逻辑本身要你提前规划——哪些子任务是粗活、哪些是细活,配错了就是「强模型干粗活浪费、弱模型干细活翻车」。对一个刚上手的小团队,先把所有子智能体统一接到一个够强的模型上跑通,再回头做分级路由,是更稳妥的路线。
3.7 与同类方案的关键差异
把 DeerFlow 放进 Agent 方案的谱系里看,图三做四维横评,图四看社区热度:
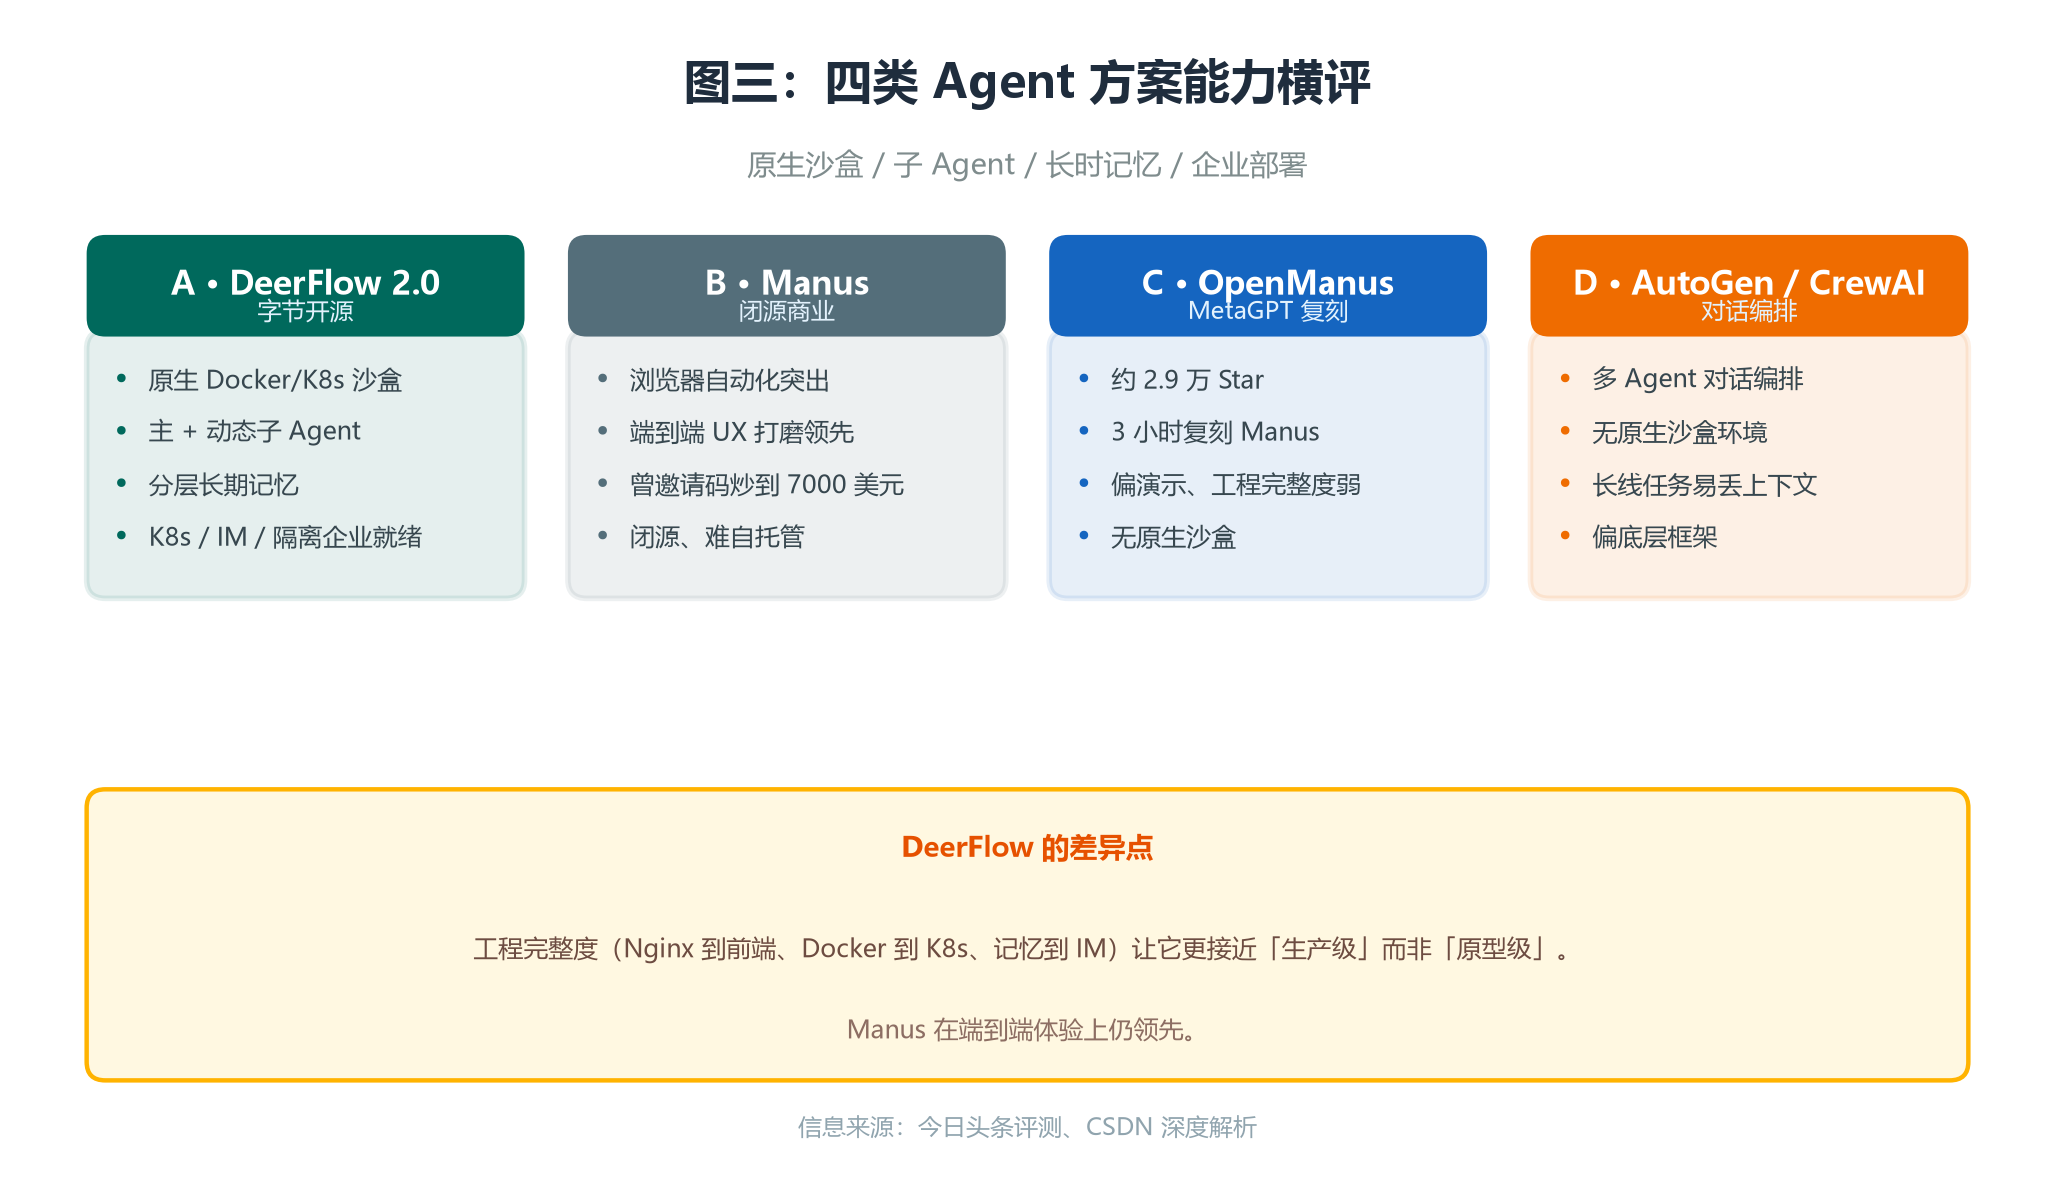
(图三:四类方案在沙盒、子 Agent、记忆、企业部署上的分野)
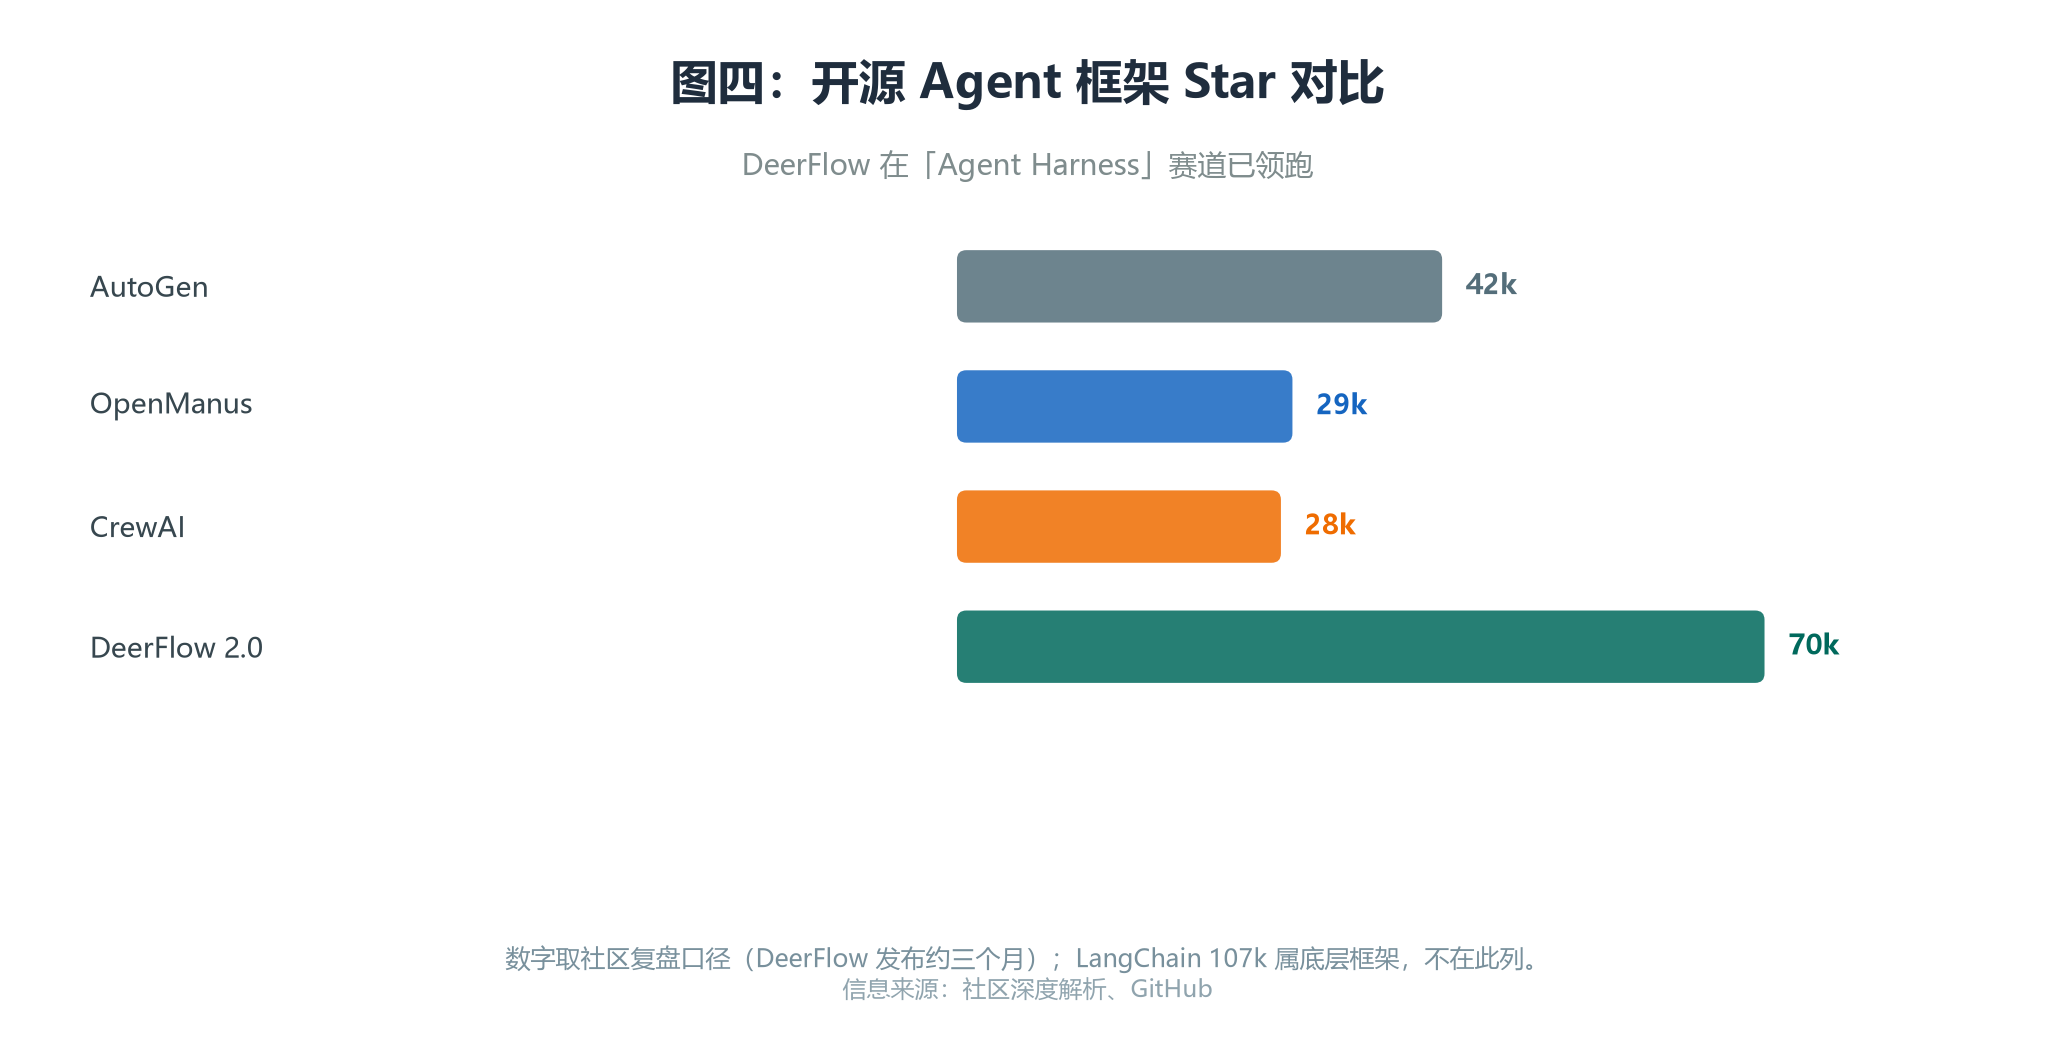
(图四:在「Agent Harness」赛道,DeerFlow 已领先同类开源方案)
| 维度 | DeerFlow 2.0 | Manus | OpenManus | AutoGen / CrewAI |
|---|---|---|---|---|
| 原生沙盒 | Docker / K8s 隔离 | 浏览器自动化 | 无 | 无 |
| 子 Agent | 主 + 动态子 Agent | 闭源内部 | 偏演示 | 对话编排 |
| 长时记忆 | 分层持久化 | 闭源 | 弱 | 弱 |
| 开箱即用 | 高(全栈) | 高(商业) | 中 | 中低 |
| 企业部署 | K8s / IM / 隔离就绪 | 闭源难自托管 | 弱 | 偏底层 |
Manus 是闭源商业产品,浏览器自动化体验领先、曾邀请码炒到 7000 美元;OpenManus 由 MetaGPT 团队 3 小时复刻、约 2.9 万 Star,但工程完整度弱。DeerFlow 的竞争力根基是工程完整度——从 Nginx 到前端、从 Docker 到 K8s、从记忆到 IM 集成,是一套全栈方案,MIT 协议也消除了商用法律障碍。
四、实际影响与适用场景
落到具体人群:
- 个人开发者 / 研究者:
git clone+make config+make docker-start,访问localhost:2026就能跑起来;MIT 协议可放心改。它适合想研究「Agent 运行时怎么搭」的人——18 个中间件和四层架构就是活教材。但要注意,多智能体并行对基础设施要求不低,本地模型至少得 Qwen3.5+ / DeepSeek 级才扛得住 Lead Agent 的编排。 - 企业 / 团队:DeerFlow 在企业级部署(K8s、IM 集成、安全隔离)和架构完整度上明显胜出,适合做内部「数字员工」底座。但字节出品的出身是把双刃剑——代码完全开源可审计,可在美国金融、医疗、政府等受监管行业,中国公司来源的软件会触发额外合规审查。安全分析师 Edward Kiledjian 的提醒值得听进去:「公众的热情正在跑在治理、隐私和安全评估的前面。」
- 生态层面:它印证了一个判断——2026 年 Agent 的竞争焦点,已从「谁的模型更会聊」转向「谁能造出更成熟的 Harness」。DeerFlow 这类项目走向普及,AI 才真正进化为「能理解、会规划、可执行、敢交付、长期负责」的生产力形态。
那么,什么样的团队最该第一时间试?答案是那些「任务长、要动手、且对隔离与审计有要求」的场景——深度研究、数据分析流水线、PPT/文档自动化、多步骤复杂任务都在此列;而简单问答、轻量代码补全、实时对话,这套架构大概率过度设计。
还有一类容易被忽略的受益者:做内容工厂、投研中台、内部知识库的团队。这类业务的特征是「任务模式固定、批量大、对成品格式有要求」,正好是 DeerFlow「技能固化 + 子智能体并行 + 文件产物」三件套的最佳舞台——把一套工作流沉淀成一个 Skill,之后每次只需换输入数据。但前提是这套工作流已经相对成熟;拿一个还在天天变的流程去套 Agent,自动化只会放大混乱,而不是消灭它。
五、上手与持续关注
最小启动(Docker 推荐):
git clone https://github.com/bytedance/deer-flow.git
cd deer-flow
make config          # 基于模板生成本地配置
make docker-init     # 首次拉取 sandbox 镜像
make docker-start    # 启动服务(按 config.yaml 判沙盒模式)
# 访问 http://localhost:2026
配置模型在 config.yaml 定义至少一个(如 gpt-4、gemini-2.5-flash、deepseek-v4),API key 写在 .env。多模型兼容,子智能体可路由不同模型。
Claude Code 用户可直接装 claude-to-deerflow 技能,不用离开终端就能下发研究任务、查状态、管线程:
npx skills add https://github.com/bytedance/deer-flow --skill claude-to-deerflow
IM 通道原生支持飞书 / Lark、企业微信、Slack、Telegram,无需公网 IP,命令 /new /status /models /memory /help 直接在群聊里用。
持续关注几个指标更实在:① 是否出现确认的大型生产部署案例(目前还缺);② 长期记忆在真实业务里的可靠性表现;③ 多智能体并行下的资源账单——GPU/VRAM 消耗不可忽视。
六、冷静视角:边界与未解问题
-
项目极年轻,生产证据不足。2.0 发布仅月余时,还没有公开确认的大型企业生产部署;VentureBeat 的建议是「在非敏感工作负载上做有限范围试点」。把一个刚发布不久的 Harness 直接扛核心业务,风险不小。
-
字节出身是双刃剑。开源可审计是优点,但在受监管行业会触发额外合规流程,采购时要算进评估周期。
-
资源消耗不可忽视。多智能体并行在 Docker 里会快速推高基础设施需求,尤其 GPU 集群与显存;本地模型需要较强基座才胜任编排。一个 2 小时任务约消耗 50–80k token,成本要提前评估。
-
长期记忆可靠性仍待验证。多位评测者指出「持久化记忆在 Agent 系统里仍是个未解决的问题」,置信度评分「理论上很好但在生产中以有趣的方式失败」。依赖记忆前,务必针对你的工作负载充分验证。
-
模型无关不等于模型无要求。编排者(Lead Agent)的智商决定下限,用错模型会让整套拆解崩盘。这不是 DeerFlow 的锅,而是「把决策权交给模型」这件事的固有边界。
-
沙盒解决了隔离,没解决权限边界。Docker/K8s 容器里 Agent 默认能读写 workspace 内一切,一旦接到 IM 群的
/new指令,它就有可能按用户话说动真实文件。把 Agent 接入生产系统前,最好再做一层文件级白名单与命令级审批——这是框架给不了、得团队自己补的最后一公里。
总结
DeerFlow 2.0 最核心的价值,是把「Agent Harness」从一句行业口号,落地成一套可运行、可审计、可扩展的操作系统级基础设施——四层解耦架构、18 个生产级中间件、真隔离的 Docker/K8s 沙盒,加上分层长期记忆与模型无关设计。它没有改变「模型是能力来源」这个事实,而是把「怎么让模型稳定、可靠、长期地干活」变成了框架的内置能力。值得关注的是要做长任务、要动手、且在意隔离与审计的团队——它很可能比「再调一个更大的模型」更划算;而对受监管行业与资源敏感型团队,出身背景与算力账单是必须正视的两笔账。下一步可以看两点:社区里是否冒出确认的生产级落地案例,以及长期记忆在真实业务中的可靠性表现。
#DeerFlow2.0 #字节跳动 #AgentHarness #子智能体 #Docker沙盒

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)