【Linux】进程(上)从冯诺依曼到 fork
【Linux】进程(上)从冯诺依曼到 fork
概览
- 冯诺依曼体系结构:五大部件怎么连,为什么数据永远绕不开内存
- 操作系统是什么:内核加库和 shell,它到底在管哪些事
- 如何理解管理:先描述再组织,描述用结构体,组织用链表
- 系统调用与库函数的分层:用户程序到底可以访问什么
- 进程的三种说法,以及进程等于什么
- PCB 与 task_struct:八个字段分类,双链表组织
- 查看进程的三种方式:/proc、ps、top
- getpid 与 getppid:进程的身份和父子关系
- fork:一个函数为什么有两个返回值,代码共享与数据私有
核心知识
一、冯诺依曼体系结构
先看这台机器的硬件底子。
# 所属目录:/home/cocatrice/lab8
uname -a                        # 内核名、主机名、内核版本、架构
cat /proc/version               # 内核版本,附带编译时用的编译器
cat /etc/os-release             # 发行版信息
grep -m1 'model name' /proc/cpuinfo   # CPU 型号
nproc                           # 几个核
free -h                         # 内存
df -h /                         # 磁盘
冯诺依曼体系把计算机拆成五个部件:输入单元、输出单元、存储器、运算器、控制器。后两个合起来就是 CPU。
关于它有两句话必须记住:CPU 能且只能对内存进行读写,不能直接访问外设;外设要输入输出数据,也只能写进内存或者从内存里读。 一句话总结就是,所有设备都只能直接和内存打交道。
这句话看着像废话,但它决定了程序里每一个 scanf 和 printf 的走向。你敲键盘,数据先进内存;CPU 从内存里把数据取走;算完了写回内存;显示器再从内存里把结果取走显示出来。整条链路上没有任何一步是设备之间直接对话的。
用发消息这件事走一遍更清楚:你按下键盘上的字符,输入单元把按键变成数据写进内存;CPU 从内存读到这段数据,交给聊天程序处理,处理结果再写回内存;网卡从内存里取走数据发出去。对面收到消息时是反过来的:网卡把收到的数据写进内存,CPU 从内存里读出来交给程序,程序把要显示的内容写进显存对应的内存区域,显示器再取走画出来。全程 CPU 没有碰过键盘、网卡和显示器中的任何一个。
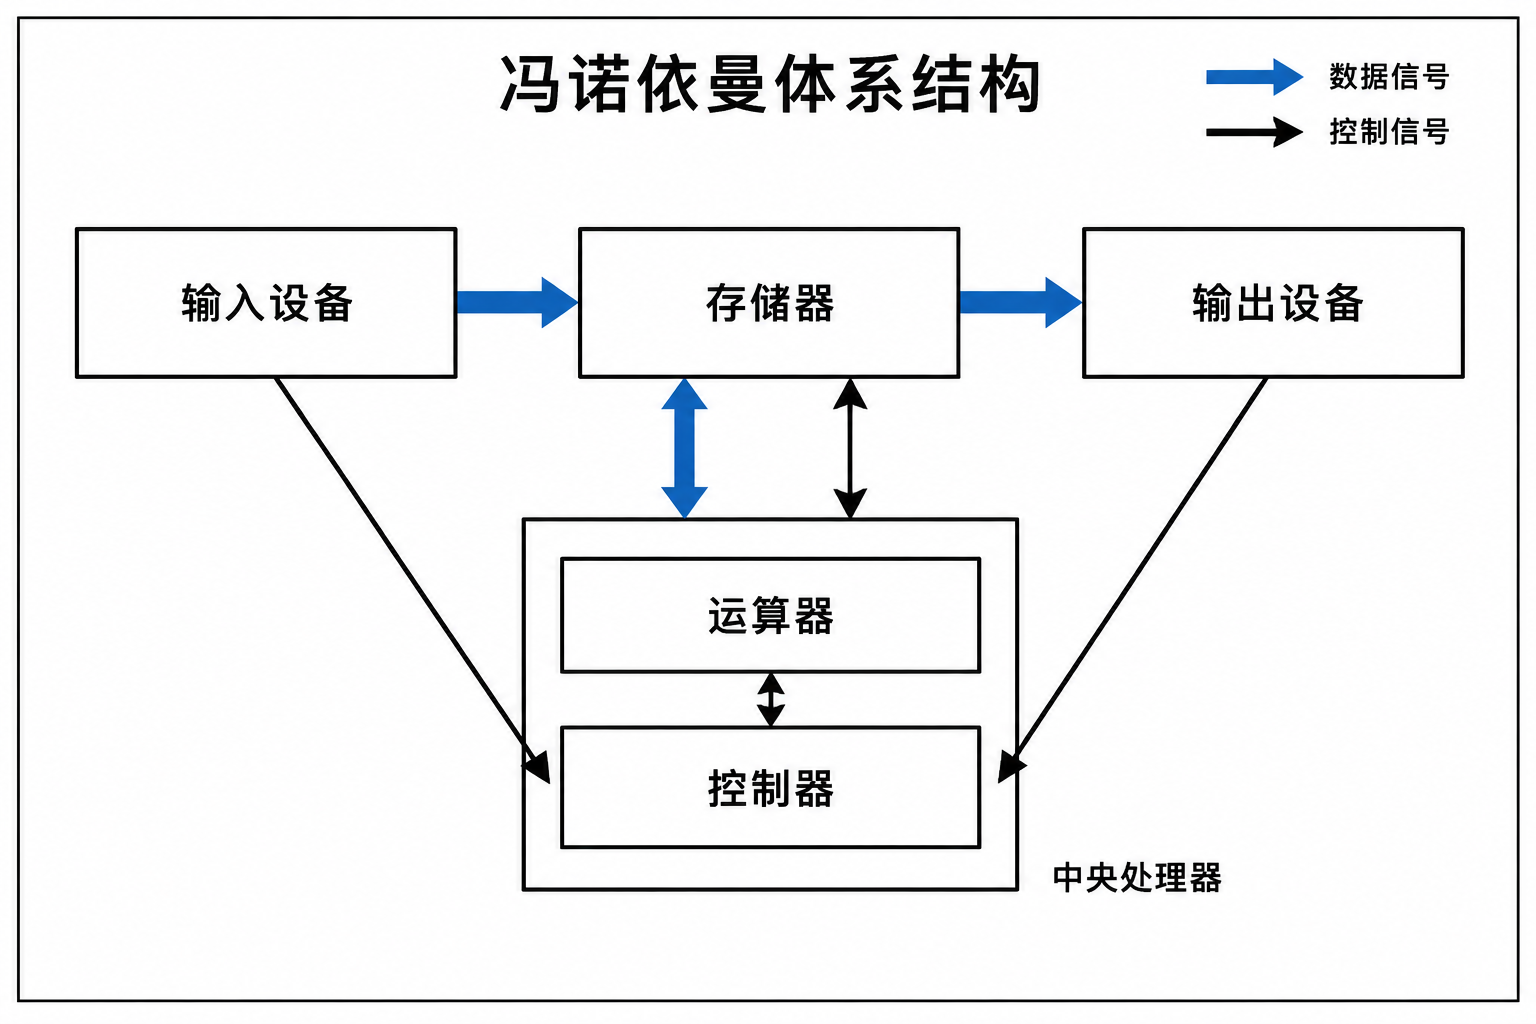
图 1 冯诺依曼体系结构与数据流向
二、操作系统
# 所属目录:/home/cocatrice/lab8
ls /lib/modules/$(uname -r)/kernel   # 内核模块按功能分目录
cat /proc/filesystems | head -6      # 内核认得的文件系统
cat /proc/cpuinfo | grep -c '^processor'   # 内核能看到几个处理器
cat /proc/meminfo | head -4          # 内核眼里的内存
任何计算机系统里都有一大坨基本的程序集合,这个集合叫操作系统。笼统地分,它包含两部分:内核,负责进程管理、内存管理、文件管理、驱动管理;其他程序,比如函数库、shell 程序等等。
设计操作系统就两个目的:对下,跟硬件交互,把所有的软硬件资源管起来;对上,给用户程序提供一个良好的执行环境。
它的定位可以用一句话概括:一款纯正搞管理的软件。它自己并不生产数据,也不负责计算,它的全部工作就是协调。
三、管理:先描述,再组织
先看内核模块的目录:arch、crypto、drivers、fs、kernel、lib、mm、net、sound、virt。驱动在一个目录里,文件系统在一个目录里,内存管理在一个目录里,网络协议栈在一个目录里。这些目录就是"管理"的产物。
管理的第一个动作是描述。要管一个东西,先得用一个结构体把它记下来:它叫什么、什么状态、归谁管、占多少资源。第二个动作是组织。光有一堆记下来的结构体没法用,还得用某种数据结构把它们串起来,链表也好、数组也好、树也好,方便快速找到想要的某一个。
一句话:描述起来用结构体,组织起来用链表或者其他高效的数据结构。
举个不写代码的例子:学校里管学生,先要有学籍表,每张表记录一个学生的姓名、学号、班级、成绩,这就是描述;再把这些表按班级分类放进不同的档案柜,或者按学号排好序,这就是组织。辅导员要找一个学生,靠的是档案柜加排序,不是把全校学生挨个问一遍。
操作系统管硬件是同一套逻辑。它先给每一种设备定义一个结构体,再把同类的结构体串成链表。你要操作某个设备,操作系统拿着链表找到对应的那个结构体,按里面记的信息去操作。它从头到尾碰的都是结构体,不是设备本身。
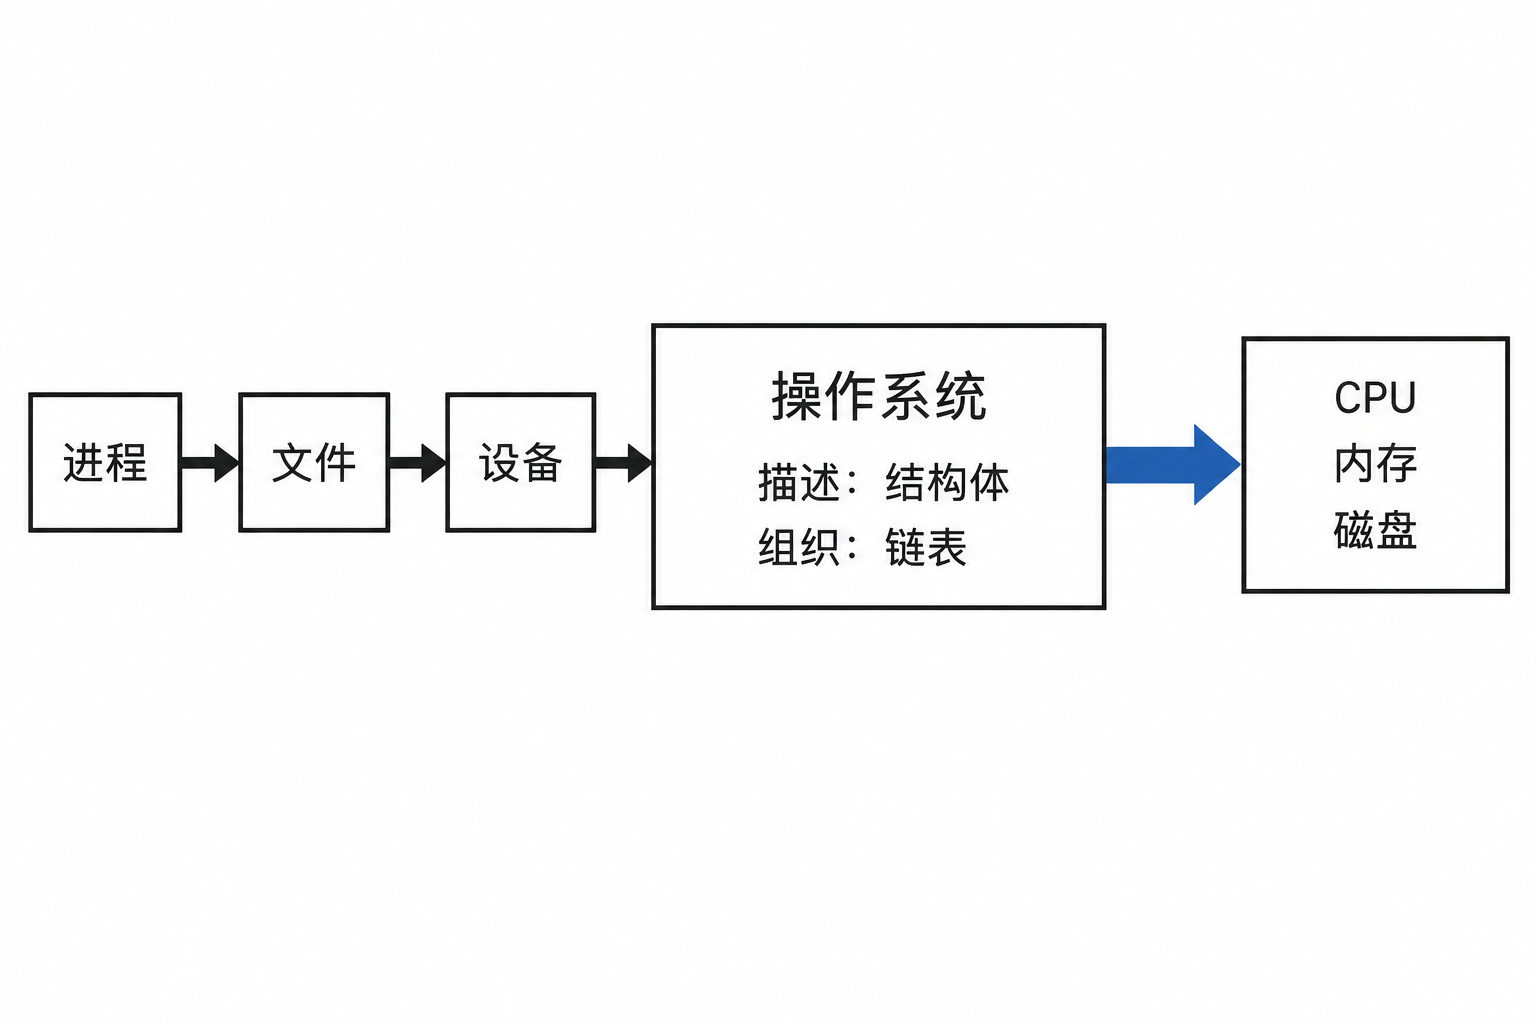
图 2 管理和被管理对象的关系
回到进程上:操作系统要管进程,也是先描述再组织。用 task_struct 描述一个进程,再用双链表把它们串起来。这篇后面所有的内容,都是这两个动作的展开。
四、系统调用与库函数
# 所属目录:/home/cocatrice/lab8
ls -l /lib64/libc.so.6                     # C 标准库的真身
ldd /bin/ls                                # 一个普通命令依赖哪些库
nm -D /lib64/libc.so.6 | wc -l             # 库导出了多少个符号
grep -c '#define __NR_' /usr/include/asm/unistd_64.h   # 内核开了多少个系统调用
strace -c /bin/true                        # 一个程序背后调了多少次系统调用
操作系统对外表现为一个整体,但它会暴露一部分接口供上层使用,这部分接口叫系统调用。
系统调用的特点是功能基础、对使用者要求高。比如想读写文件,系统调用只给你最原始的读写能力,怎么打开、怎么判断出错、怎么处理缓冲,全要自己来。所以有心的人会对系统调用做一层封装,形成库。有了库,上层的开发者就轻松多了。
分层是这样的:
应用程序(你的 C 程序)
      ↓  调用
库函数(printf、malloc、fopen 都在 libc 里)
      ↓  调用
系统调用(write、brk、open,内核真正认的接口)
      ↓  进入内核
内核(进程管理、内存管理、文件管理、驱动管理)
      ↓  驱动
硬件(磁盘、网卡、显示器)
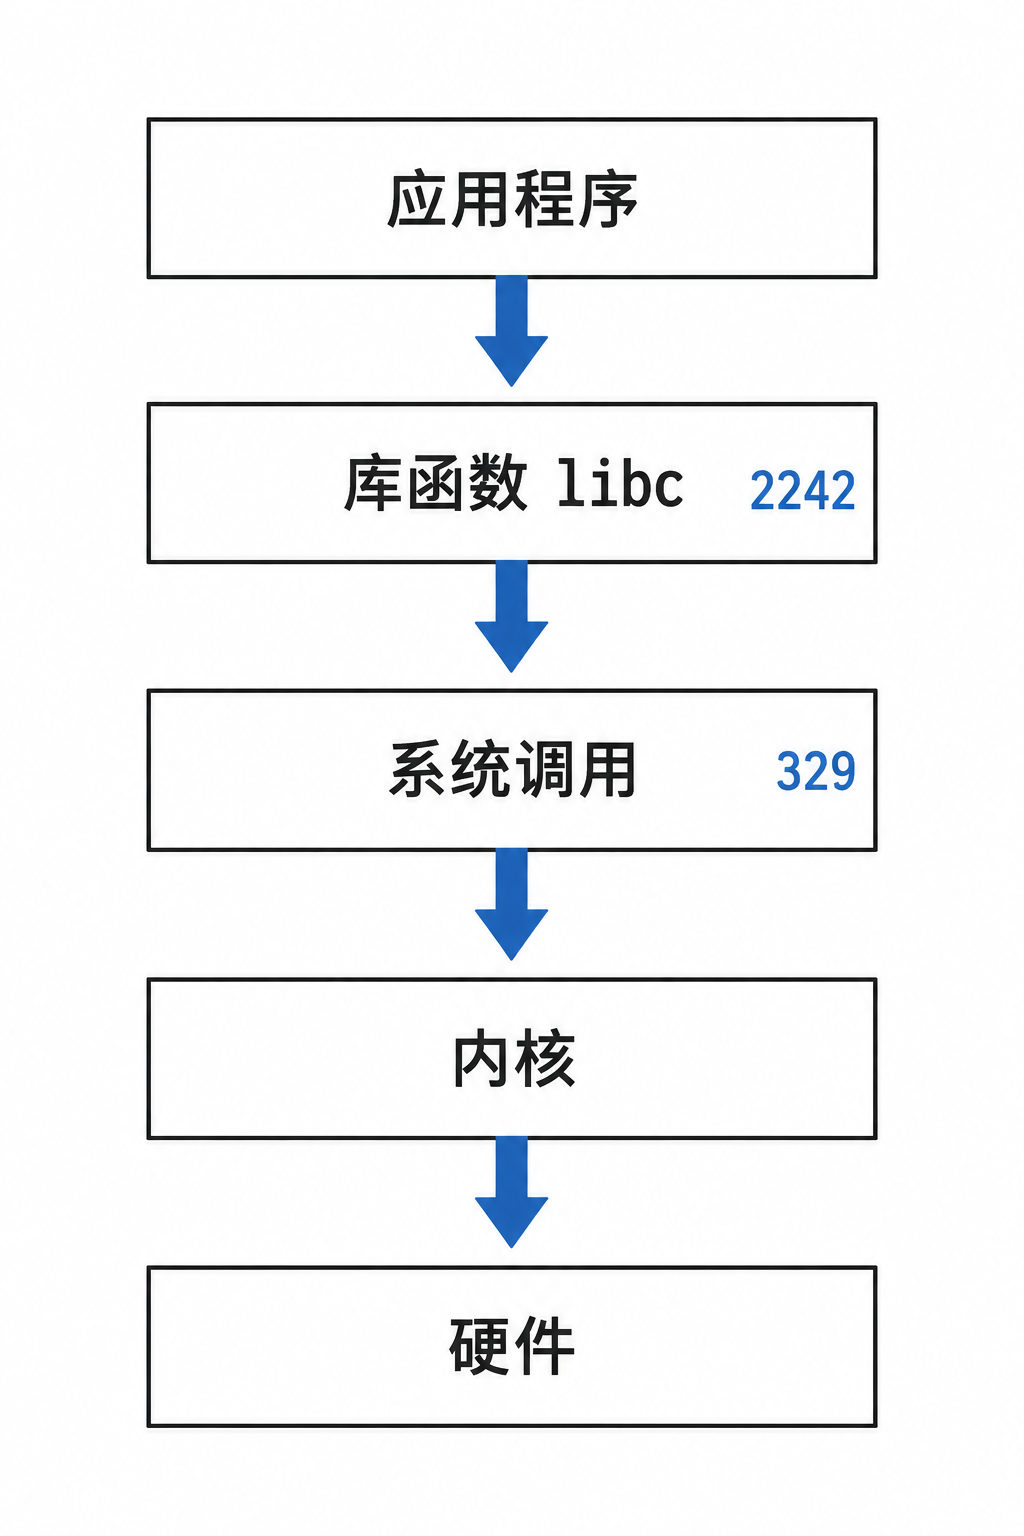
图 3 用户程序到硬件的分层
实测出来的两个数字最能说明这层关系。这台机器上的 libc 导出 2242 个符号,而内核一共开了 329 个系统调用。库函数的数量是系统调用的将近七倍,多出来的那些全是封装:一个 printf 背后可能要经过格式化、缓冲区管理、最后落到一次 write。
再用 strace -c 数一下 /bin/true 这个什么都不干的程序:它一共调了 37 次系统调用,涉及 14 种。/bin/true 的源码里只有一行 return 0,那 37 次调用全是程序启动和退出时标准库和内核帮着做的准备工作。这就是"程序跑起来"的真实成本。
用 strace -e trace=write 单独盯住 write 这一个系统调用,看 echo 是怎么把 hi 打出来的:
write(1, "hi\n", 3) = 3
第一个参数 1 是文件描述符,代表标准输出;第二个是写的内容;第三个是写几个字节;等号后面 3 表示真的写成功了 3 个字节。printf 再花哨,最后落地的都是这一行。
五、什么是进程
进程有三种说法,三种都对,看具体在哪个层次上说。
- 课本上说:程序的一个执行实例,正在执行的程序。
- 内核观点:担当分配系统资源(CPU 时间、内存)的实体。
- 当前最实用的说法:进程 = 内核数据结构(task_struct)+ 自己的程序代码和数据。
第三种说法最好,因为它把进程拆成了两个能分别观察的部分:一份内核里的记录,一份磁盘上的代码和内存里的数据。后面讲的 fork、状态、优先级,动的都是前半部分。
程序不等于进程。同一个可执行文件,跑一次是一个进程,跑两次就是两个互不相干的进程,它们在内存里各有一份数据,各自有各自的编号。
| 对比项 | 程序 | 进程 |
|---|---|---|
| 存在形式 | 磁盘上的一个可执行文件 | 内存里的一份 task_struct 加代码和数据 |
| 数量 | 一个文件只有一份 | 跑几次就有几个 |
| 生命周期 | 一直在磁盘上,除非被删掉 | 从 fork 出来到退出为止 |
| 占用资源 | 只占磁盘空间 | 占 CPU 时间、内存、文件描述符 |
| 能不能改 | 改了就变了,所有运行中的实例不受影响 | 改的是自己那一份,别人看不见 |
# 所属目录:/home/cocatrice/lab8
cat > sleep_loop.c <<'EOF'
#include <stdio.h>
#include <unistd.h>

int main(void)
{
    while (1) {
        sleep(1);
    }
    return 0;
}
EOF
gcc -o sleep_loop sleep_loop.c
./sleep_loop &              # 第一份
./sleep_loop &              # 第二份,同一个文件
ps -o pid,ppid,stat,cmd -C sleep_loop
pkill -f sleep_loop
同一个 ./sleep_loop,两份进程,两个 PID,父进程都是当前这个 shell。它们之间没有任何关系,改其中一个的变量不会影响另一个。
六、PCB 与 task_struct
进程信息被放在一个叫进程控制块(PCB,process control block)的数据结构里,可以理解为进程属性的集合。Linux 下这个结构体叫 task_struct。
task_struct 是内核里的一种数据结构类型,它会被装载到内存里,包含着一个进程的全部信息。字段按用途分八类:
| 分类 | 记的是什么 |
|---|---|
| 标示符 | 描述本进程的唯一标识,用来区别于其他进程 |
| 状态 | 任务状态、退出代码、退出信号 |
| 优先级 | 相对于其他进程的优先级 |
| 程序计数器 | 程序中即将被执行的下一条指令的地址 |
| 内存指针 | 程序代码和数据的指针,以及和其他进程共享的内存块指针 |
| 上下文数据 | 进程执行时处理器寄存器里的数据 |
| I/O 状态信息 | 分配的 I/O 设备、被进程使用的文件列表 |
| 记账信息 | 处理器时间总和、使用的时钟数总和、时间限制、账号 |
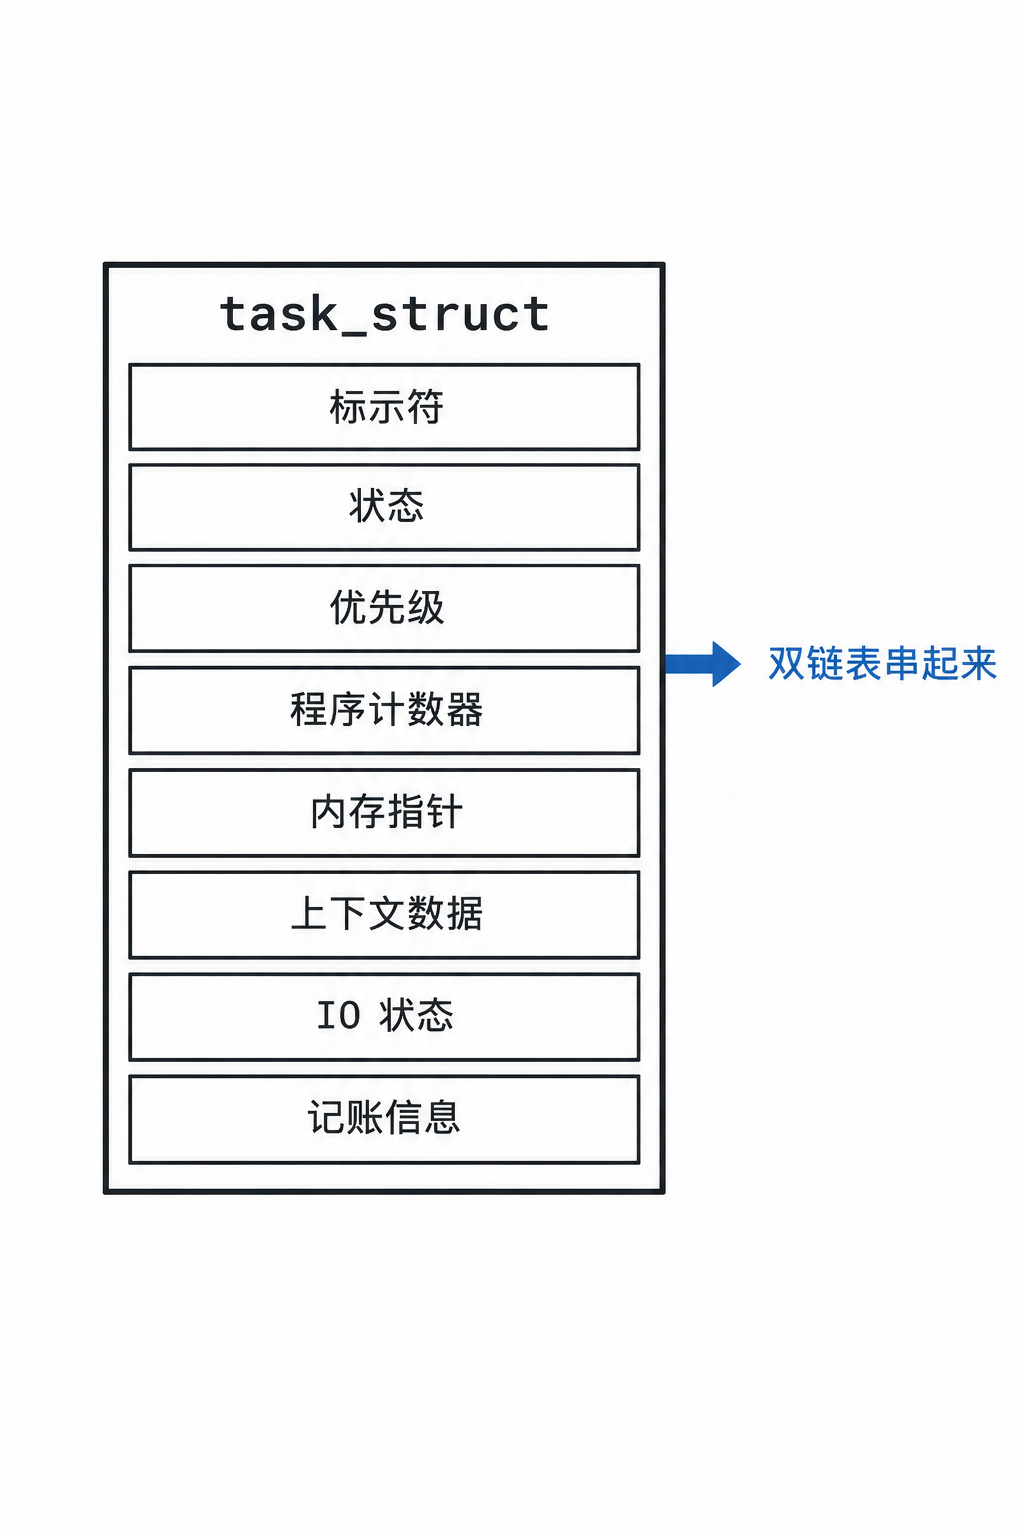
图 4 task_struct 的字段分类
八类里最容易被忽略的是程序计数器和上下文数据。进程被从 CPU 上换下来的时候,如果不把"下一条该执行哪条指令"和"当前各个寄存器里是什么值"记下来,下次换回来就接不上了。中篇讲进程切换时会专门展开这一对。
组织方式:所有运行在系统里的进程,都以 task_struct 双链表的形式存在内核里。
这里留一个坑给中篇:链表结点里只有两个指针,一个指向前一个、一个指向后一个,凭什么从一个结点能找回整个 task_struct、进而访问到 pid 和 mm?答案是按偏移量往回退,中篇会专门开一章把这件事讲透。
七、查看进程的三种方式
内核把 task_struct 摆在内存里,用户想看得通过它留出来的窗口。
# 所属目录:/home/cocatrice/lab8
ls /proc                  # 全是数字,一个数字就是一个进程
ls /proc | wc -l          # 当前有多少个
ls /proc/1                # 看看 1 号进程暴露了什么
cat /proc/1/status        # 摘录几个字段
第一种是 /proc 目录。 这是内核直接暴露出来的窗口,目录名就是 PID。要获取 PID 为 1 的进程信息,看 /proc/1 这个目录就行。这个目录不是真的存在磁盘上,每次读都是内核现算出来的。
/proc/1 里能看到 status、cmdline、environ、exe、cwd、fd、maps 这些条目,分别对应 task_struct 里不同类别的字段。
# 所属目录:/home/cocatrice/lab8
ps aux                    # 所有进程的详细列表
ps -ef                    # 另一种排布,看父子关系更方便
top -b -n 1               # 跑一屏就退出
第二种是 ps,第三种是 top。 它们都是用户级工具,做的事情是把 /proc 里的数据读出来,重新排版给人看。所以本质上它们不产生新信息,只是让信息好读。
ps aux 和 ps -ef 的差别在排布:前者以用户为中心,把 CPU、内存占用摆在显眼位置;后者把 PID 和 PPID 挨着放,看谁是谁的子进程更方便。
八、getpid 与 getppid
# 所属目录:/home/cocatrice/lab8
cat > show_pid.c <<'EOF'
#include <stdio.h>
#include <sys/types.h>
#include <unistd.h>

int main(void)
{
    printf("pid : %d\n", getpid());
    printf("ppid: %d\n", getppid());
    return 0;
}
EOF
gcc -o show_pid show_pid.c
./show_pid
echo $$                   # 对照一下当前 shell 的 PID
getpid 返回当前进程的 PID,getppid 返回父进程的 PID。这两个都是系统调用,不是普通函数。
程序打印出来的 ppid 和 echo $$ 打出来的数字一致,说明这个程序的父进程就是当前这个 shell。每次在命令行敲一个命令,shell 都会先 fork 出一个子进程,再用 exec 把那个子进程换成目标程序,所以命令行上跑的每一个程序,父进程都是 shell。
九、fork:一个函数为什么有两个返回值
创建进程用 fork。
# 所属目录:/home/cocatrice/lab8
man 2 fork                      # 第 2 节是系统调用
man 2 fork | sed -n '/RETURN VALUE/,/^$/p'
手册里对返回值的描述是:成功时,父进程拿到子进程的 PID,子进程中返回 0;失败时父进程返回 -1,不创建子进程,同时设置 errno。
# 所属目录:/home/cocatrice/lab8
cat > fork_demo.c <<'EOF'
#include <stdio.h>
#include <sys/types.h>
#include <unistd.h>

int main(void)
{
    int ret = fork();
    printf("hello proc : %d, ret: %d\n", getpid(), ret);
    sleep(1);
    return 0;
}
EOF
gcc -o fork_demo fork_demo.c
./fork_demo
程序只调用了一次 fork,只写了一行 printf,屏幕上却出现两行。第一行是父进程打的,ret 是子进程的 PID;第二行是子进程打的,ret 是 0。
为什么会有两个返回值? 因为 fork 执行完之后,系统里多了一个进程,父子两个都从 fork 这一行往下继续跑。它们各拿到一份返回值,父进程拿到的是"我造出来的那个孩子的编号",子进程拿到的是 0,用来表明"我是被造出来的那个"。给父进程返回子 PID 是因为一个父进程可能有很多子进程,得知道这次造出来的是哪一个;给子进程返回 0 是因为它只有一个父亲,想知道父亲是谁直接调 getppid 就行,不需要额外给。
理解 fork 的关键是两个进程各自返回一次,不是一个函数返回了两次。fork 在父进程的上下文里返回一次,在新创建的子进程的上下文里返回一次,两次返回各自回到自己的那行代码。
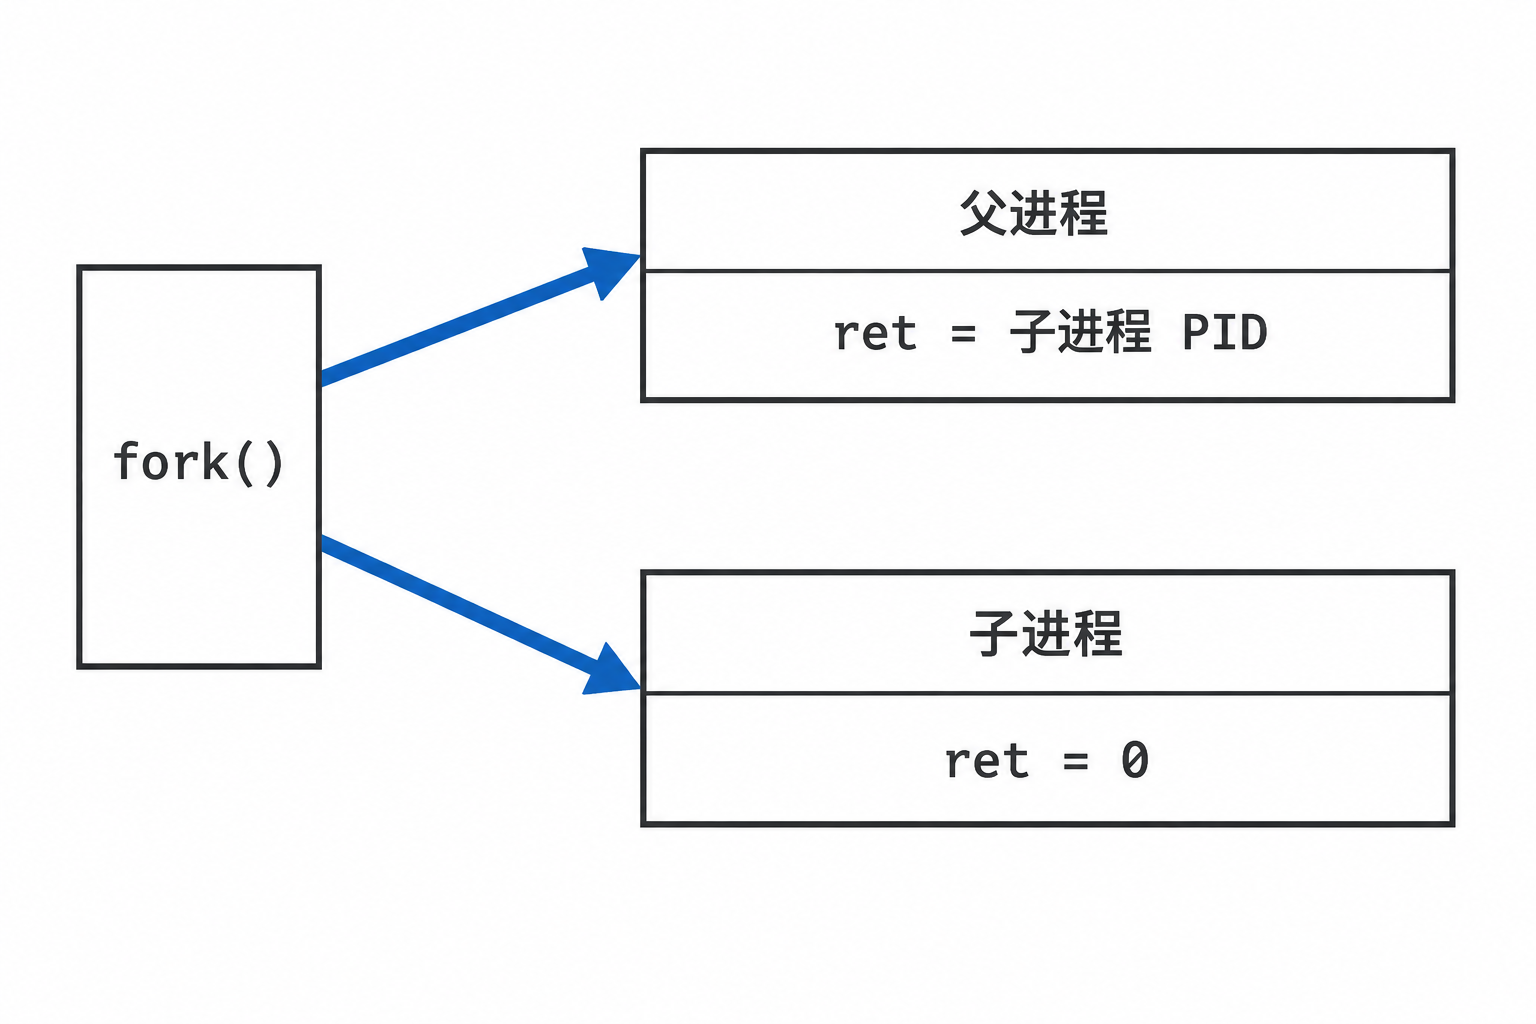
图 5 fork 之后父子各自返回
返回值不同,所以 fork 之后通常要用 if 分流:
# 所属目录:/home/cocatrice/lab8
cat > fork_branch.c <<'EOF'
#include <stdio.h>
#include <sys/types.h>
#include <unistd.h>

int main(void)
{
    int ret = fork();
    if (ret < 0) {
        perror("fork");
        return 1;
    } else if (ret == 0) {
        printf("I am child  : pid=%d, ret=%d, ppid=%d\n", getpid(), ret, getppid());
    } else {
        printf("I am father : pid=%d, ret=%d\n", getpid(), ret);
    }
    sleep(1);
    return 0;
}
EOF
gcc -o fork_branch fork_branch.c
./fork_branch
三个分支各管一件事:返回值小于 0 说明创建失败,用 perror 打出原因就返回;等于 0 的走子进程分支;大于 0 的走父进程分支。这个三段式是 fork 的标准写法,漏掉失败分支是最常见的疏忽。
代码共享、数据私有。 fork 出来的子进程,代码段和父进程共用同一份物理内存,数据段则各有一份。这件事的验证放在下篇讲地址空间时做,那里会看到父子两个打印出同一个地址、值却不一样。
补充:fork 背后其实是 clone
# 所属目录:/home/cocatrice/lab8
strace -e trace=clone,fork,vfork ./fork_demo
nm -D /lib64/libc.so.6 | grep -wE 'fork|getpid|printf|malloc'
fork 在 libc 里是一个符号,但内核里并没有一个叫 fork 的系统调用。用 strace 盯住 clone 一族就能看到,程序实际发起的是 clone,三个参数分别是子进程栈、标志位和子线程 ID 指针。标志位里带着 SIGCHLD,意思是子进程结束时给父进程发个信号,这样父进程才能知道孩子走了。
这就是系统调用与库函数分层的又一个例子:fork 是库提供的门面,clone 才是内核真正认的接口。
十、从敲回车到 main
前面讲了 shell 会先 fork 再 exec,也讲了系统调用和库函数的分层。把这两条线接起来看一遍,就知道从敲下回车到自己的 main 开始跑,中间到底经历了什么。
# 所属目录:/home/cocatrice/lab8
strace -f ./show_pid 2>&1 | head -22
[cocatrice@hcss-ecs-4cd1 lab8]$ strace -f ./show_pid 2>&1 | head -22
execve("./show_pid", ["./show_pid"], 0x7ffcd0f824b8 /* 22 vars */) = 0
brk(NULL)                               = 0x1c96000
mmap(NULL, 4096, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) = 0x7f05ae53a000
access("/etc/ld.so.preload", R_OK)      = -1 ENOENT (No such file or directory)
open("tls/x86_64/libc.so.6", O_RDONLY|O_CLOEXEC) = -1 ENOENT (No such file or directory)
open("tls/libc.so.6", O_RDONLY|O_CLOEXEC) = -1 ENOENT (No such file or directory)
open("x86_64/libc.so.6", O_RDONLY|O_CLOEXEC) = -1 ENOENT (No such file or directory)
open("libc.so.6", O_RDONLY|O_CLOEXEC)   = -1 ENOENT (No such file or directory)
open("/home/cocatrice/.VimForCpp/vim/bundle/YCM.so/el7.x86_64/tls/x86_64/libc.so.6", O_RDONLY|O_CLOEXEC) = -1 ENOENT (No such file or directory)
stat("/home/cocatrice/.VimForCpp/vim/bundle/YCM.so/el7.x86_64/tls/x86_64", 0x7ffe15657a50) = -1 ENOENT (No such file or directory)
open("/home/cocatrice/.VimForCpp/vim/bundle/YCM.so/el7.x86_64/tls/libc.so.6", O_RDONLY|O_CLOEXEC) = -1 ENOENT (No such file or directory)
stat("/home/cocatrice/.VimForCpp/vim/bundle/YCM.so/el7.x86_64/tls", 0x7ffe15657a50) = -1 ENOENT (No such file or directory)
open("/home/cocatrice/.VimForCpp/vim/bundle/YCM.so/el7.x86_64/x86_64/libc.so.6", O_RDONLY|O_CLOEXEC) = -1 ENOENT (No such file or directory)
stat("/home/cocatrice/.VimForCpp/vim/bundle/YCM.so/el7.x86_64/x86_64", 0x7ffe15657a50) = -1 ENOENT (No such file or directory)
open("/home/cocatrice/.VimForCpp/vim/bundle/YCM.so/el7.x86_64/libc.so.6", O_RDONLY|O_CLOEXEC) = -1 ENOENT (No such file or directory)
stat("/home/cocatrice/.VimForCpp/vim/bundle/YCM.so/el7.x86_64", {st_mode=S_IFDIR|0775, st_size=4096, ...}) = 0
open("/etc/ld.so.cache", O_RDONLY|O_CLOEXEC) = 3
fstat(3, {st_mode=S_IFREG|0644, st_size=21152, ...}) = 0
mmap(NULL, 21152, PROT_READ, MAP_PRIVATE, 3, 0) = 0x7f05ae534000
close(3)                                = 0
open("/lib64/libc.so.6", O_RDONLY|O_CLOEXEC) = 3
read(3, "\177ELF\2\1\1\3\0\0\0\0\0\0\0\3\0>\0\1\0\0\0`&\2\0\0\0\0\0"..., 832) = 832
把这 22 行读下来,程序的启动过程就摊在眼前了:
execve把自己装载进来。第一个参数是程序路径,第二个是 argv,第三个是环境变量表,注释里的 22 vars 说明这次传进来 22 个环境变量。brk和mmap是在向内核要内存。brk问的是堆从哪里开始,mmap给动态链接器先腾出一页。access检查/etc/ld.so.preload在不在。这个文件用来强制预加载某些库,不存在就直接跳过,返回 ENOENT 是正常的。- 接下来那一长串返回 ENOENT 的
open,是动态链接器在找libc.so.6。它按一套固定顺序在若干个目录里挨个试:先试相对路径,再试LD_LIBRARY_PATH里的目录,最后才去系统目录。 open("/etc/ld.so.cache")成功,这是读缓存。这个文件里存着系统上所有已知库的实际路径,有了它就不用每次都把目录遍历一遍。open("/lib64/libc.so.6")成功,接着读它的 ELF 头,后面就是映射各个段、做重定位、跳进 libc 的启动代码,最后才轮到你写的main。
第 4 步里那几条带 /home/cocatrice/.VimForCpp/ 的路径要说一句。这台机器的 LD_LIBRARY_PATH 是 :/home/cocatrice/.VimForCpp/vim/bundle/YCM.so/el7.x86_64,开头那个冒号表示当前目录也在搜索范围内,动态链接器把里面每个目录都试了一遍,全都扑空。这串 ENOENT 不是错误,是链接器的正常试探过程,只要最后有一行 open 成功,库就找到了。
把这一节和前面连起来看:冯诺依曼说数据必须经过内存,这里前两步就在向内核要内存;系统调用是最小的原子能力,这 22 行里出现了 12 种不同的调用;库函数是封装,execve 之后那一大段全是 libc 的启动代码在替我们干活。而这一切的起点,是 shell 先 fork 出一个子进程,再把那个子进程换成了 ./show_pid。
于是,进程诞生了。
测试代码及用例
正常情况
- 先看机器的底子。
冯诺依曼的五个部件:/proc/cpuinfo 是运算器和控制器,/proc/meminfo 是存储器,df 是外存。
[cocatrice@hcss-ecs-4cd1 lab8]$ uname -a
Linux hcss-ecs-4cd1 3.10.0-1160.119.1.el7.x86_64 #1 SMP Tue Jun 4 14:43:51 UTC 2024 x86_64 x86_64 x86_64 GNU/Linux
[cocatrice@hcss-ecs-4cd1 lab8]$ cat /proc/version
Linux version 3.10.0-1160.119.1.el7.x86_64 (mockbuild@kbuilder.bsys.centos.org) (gcc version 4.8.5 20150623 (Red Hat 4.8.5-44) (GCC) ) #1 SMP Tue Jun 4 14:43:51 UTC 2024
[cocatrice@hcss-ecs-4cd1 lab8]$ cat /etc/os-release | head -4
NAME="CentOS Linux"
VERSION="7 (Core)"
ID="centos"
ID_LIKE="rhel fedora"
[cocatrice@hcss-ecs-4cd1 lab8]$ grep -m1 'model name' /proc/cpuinfo
model name	: General Purpose Processor
[cocatrice@hcss-ecs-4cd1 lab8]$ nproc
2
[cocatrice@hcss-ecs-4cd1 lab8]$ free -h
              total        used        free      shared  buff/cache   available
Mem:           1.8G        196M        133M         96M        1.5G        1.3G
Swap:            0B          0B          0B
[cocatrice@hcss-ecs-4cd1 lab8]$ df -h / | tail -1
/dev/vda1        40G  6.6G   32G  18% /
/proc/version 这一行信息量最大:它不光给出内核版本,还给出内核是被哪个编译器编出来的(gcc 4.8.5)和编译时间。model name 显示 General Purpose Processor,说明这是一台云主机,CPU 型号被虚拟化层抹掉了。两个核、1.8G 内存、40G 系统盘,这就是后面所有实验的硬件底子。
- 内核给自己开了一扇窗,窗外是
/proc。
[cocatrice@hcss-ecs-4cd1 lab8]$ ls /proc | head -8
1
10
106
11
12
13
13480
14
[cocatrice@hcss-ecs-4cd1 lab8]$ ls /proc | wc -l
167
[cocatrice@hcss-ecs-4cd1 lab8]$ ls /proc/1
attr		 cwd	   map_files   oom_adj	      schedstat  task
autogroup	 environ   maps        oom_score      sessionid  timers
auxv		 exe	   mem	       oom_score_adj  setgroups  uid_map
cgroup		 fd	   mountinfo   pagemap	      smaps	 wchan
clear_refs	 fdinfo    mounts      patch_state    stack
cmdline		 gid_map   mountstats  personality    stat
comm		 io	   net	       projid_map     statm
coredump_filter  limits    ns	       root	      status
cpuset		 loginuid  numa_maps   sched	      syscall
[cocatrice@hcss-ecs-4cd1 lab8]$ cat /proc/1/status | head -14
Name:	systemd
Umask:	0000
State:	S (sleeping)
Tgid:	1
Ngid:	0
Pid:	1
PPid:	0
TracerPid:	0
Uid:	0	0	0	0
Gid:	0	0	0	0
FDSize:	128
Groups:
VmPeak:	  190992 kB
VmSize:	  125456 kB
/proc 下面清一色是数字,一个数字就是一个进程,除此之外还有 meminfo、cpuinfo、filesystems 这些非数字条目。这台机器当时有 167 个条目。
/proc/1 是 1 号进程的档案。status 里 Name 是进程名,State 是当前状态,Pid 和 PPid 是它和它父亲,VmSize 是它占的虚拟内存。这些字段一个一个都能在 task_struct 里找到对应的成员。PPid: 0 说明 1 号进程没有父亲,它是内核直接拉起来的第一个用户态进程。
- 库和系统调用各有多少,实测出来的两个数字最能说明分层。
[cocatrice@hcss-ecs-4cd1 lab8]$ ls -l /lib64/libc.so.6
lrwxrwxrwx 1 root root 12 Jul 26  2024 /lib64/libc.so.6 -> libc-2.17.so
[cocatrice@hcss-ecs-4cd1 lab8]$ ldd /bin/ls
	linux-vdso.so.1 =>  (0x00007fff7c570000)
	libselinux.so.1 => /lib64/libselinux.so.1 (0x00007fdacf52c000)
	libcap.so.2 => /lib64/libcap.so.2 (0x00007fdacf327000)
	libacl.so.1 => /lib64/libacl.so.1 (0x00007fdacf11e000)
	libc.so.6 => /lib64/libc.so.6 (0x00007fdaced50000)
	libpcre.so.1 => /lib64/libpcre.so.1 (0x00007fdaceaee000)
	libdl.so.2 => /lib64/libdl.so.2 (0x00007fdace8ea000)
	/lib64/ld-linux-x86-64.so.2 (0x00007fdacf753000)
	libattr.so.1 => /lib64/libattr.so.1 (0x00007fdace6e5000)
	libpthread.so.0 => /lib64/libpthread.so.0 (0x00007fdace4c9000)
[cocatrice@hcss-ecs-4cd1 lab8]$ nm -D /lib64/libc.so.6 | wc -l
2242
[cocatrice@hcss-ecs-4cd1 lab8]$ nm -D /lib64/libc.so.6 | head -6
0000000000043990 T a64l
0000000000037930 T abort
00000000003c8e00 B __abort_msg
000000000003a1d0 T abs
00000000000ff790 W accept
00000000000fff30 T accept4
[cocatrice@hcss-ecs-4cd1 lab8]$ grep -c '#define __NR_' /usr/include/asm/unistd_64.h
329
libc.so.6 是一个软链接,真身是 libc-2.17.so。ldd 把一个普通命令的依赖摊开:/bin/ls 一共挂了九个动态库,libc 只是其中之一,另外还有管 SELinux 的、管能力的、管访问控制的、管正则的。
nm -D 数出来的是 libc 导出的动态符号,2242 个。而内核那头一共开了 329 个系统调用。两千多个库函数压在三百多个系统调用上面,中间那一千九百多个全是封装和组合。这就是分层的意义:内核只提供最小的原子能力,库在上面拼出好用的东西。
nm 输出里第一个字母是符号类型:@Q Q@ 表示在代码段里定义的全局符号,B 是未初始化的全局数据,W 是弱符号,链接时可以被别人覆盖。
- 再看一个程序跑起来到底调了多少次系统调用。
[cocatrice@hcss-ecs-4cd1 lab8]$ strace -c /bin/true 2>&1 | tail -14
  0.00    0.000000           0         1           read
  0.00    0.000000           0        10         8 open
  0.00    0.000000           0         2           close
  0.00    0.000000           0         4         3 stat
  0.00    0.000000           0         2           fstat
  0.00    0.000000           0         7           mmap
  0.00    0.000000           0         4           mprotect
  0.00    0.000000           0         1           munmap
  0.00    0.000000           0         1           brk
  0.00    0.000000           0         3         3 access
  0.00    0.000000           0         1           execve
  0.00    0.000000           0         1           arch_prctl
------ ----------- ----------- --------- --------- ----------------
100.00    0.000000                    37        14 total
[cocatrice@hcss-ecs-4cd1 lab8]$ strace -e trace=write /bin/echo hi 2>&1 | tail -4
write(1, "hi\n", 3hi
)                     = 3
+++ exited with 0 +++
/bin/true 的源码只有一行 return 0,但它在启动和退出过程中一共调了 37 次系统调用,涉及 14 种。open 调了 10 次,mmap 调了 7 次,execve 调了 1 次(就是自己被装载进来的那一次)。最后一行 total 是汇总。
下面那条把 write 单独拎出来看:第一个参数 1 代表标准输出这个文件描述符,第二个是写的内容,第三个是字节数,等号后面是实际写入的字节数。printf 再复杂,最后落地的就是这一行。
- 内核管的四件事,在文件系统上各有各的地盘。
[cocatrice@hcss-ecs-4cd1 lab8]$ ls /lib/modules/$(uname -r)/kernel
arch  crypto  drivers  fs  kernel  lib	mm  net  sound	virt
[cocatrice@hcss-ecs-4cd1 lab8]$ cat /proc/filesystems | head -6
nodev	sysfs
nodev	rootfs
nodev	ramfs
nodev	bdev
nodev	proc
nodev	cgroup
[cocatrice@hcss-ecs-4cd1 lab8]$ cat /proc/cpuinfo | grep -c '^processor'
2
[cocatrice@hcss-ecs-4cd1 lab8]$ cat /proc/meminfo | head -4
MemTotal:        1881260 kB
MemFree:          104812 kB
MemAvailable:    1409772 kB
Buffers:            88280 kB
内核模块目录里 drivers 是驱动管理,fs 是文件管理,mm 是内存管理,kernel 里装着进程管理和调度。四个目录正好对应操作系统的四项核心功能。/proc/filesystems 列出了内核当前认得的文件系统,前面带 nodev 的表示它不挂在具体设备上。
meminfo 里 MemFree 只有 104812 kB,而 MemAvailable 有 1409772 kB,差额是被拿去当文件缓存的部分。判断内存够不够要看 MemAvailable,不是 MemFree。
- 进程的身份靠两个系统调用就能问出来。
[cocatrice@hcss-ecs-4cd1 lab8]$ ./show_pid
pid : 3412
ppid: 3362
[cocatrice@hcss-ecs-4cd1 lab8]$ echo $$
3362
[cocatrice@hcss-ecs-4cd1 lab8]$ ./show_pid; ./show_pid
pid : 3413
ppid: 3362
pid : 3414
ppid: 3362
程序报出来的 ppid 是 3362,echo $$ 打出来的也是 3362,说明这个程序的父亲就是当前这个 shell。连跑两次,两次的 pid 不同(3413 和 3414),ppid 都是同一个,因为父亲始终是这一个 shell。
这就是命令行上每敲一条命令背后的动作:shell 先 fork 一个子进程,再用 exec 把那个子进程换成目标程序,所以每个命令的父进程都是 shell。
- 同一个可执行文件,跑两份就是两个进程。
[cocatrice@hcss-ecs-4cd1 lab8]$ ps -o pid,ppid,stat,cmd -C sleep_loop
  PID  PPID STAT CMD
 3415  3362 Ss   ./sleep_loop
 3416  3362 Ss   ./sleep_loop
[cocatrice@hcss-ecs-4cd1 lab8]$ ps aux | grep -v grep | grep sleep_loop
cocatri+  3415  0.0  0.0   4212   352 ?        Ss   19:27   0:00 ./sleep_loop
cocatri+  3416  0.0  0.0   4212   356 ?        Ss   19:27   0:00 ./sleep_loop
两行记录里 PID 不同,PPID 相同,CMD 一模一样。ps -o 是自己指定列,这里只要了 PID、PPID、状态和命令;ps aux 是固定的一套列,多出用户、CPU、内存、时间这些。
状态列显示的 Ss 两个字符分别有含义,S 表示可中断睡眠(进程在等事件),s 表示它是会话首进程。中篇会把这一列每个字符拆开讲。
/proc里同一个 PID 的目录,就是这两份进程的档案。
[cocatrice@hcss-ecs-4cd1 lab8]$ ls /proc/3416
attr		 cwd	   map_files   oom_adj	      schedstat  task
autogroup	 environ   maps        oom_score      sessionid  timers
auxv		 exe	   mem	       oom_score_adj  setgroups  uid_map
cgroup		 fd	   mountinfo   pagemap	      smaps	 wchan
clear_refs	 fdinfo    mounts      patch_state    stack
cmdline		 gid_map   mountstats  personality    stat
comm		 io	   net	       projid_map     statm
coredump_filter  limits    ns	       root	      status
cpuset		 loginuid  numa_maps   sched	      syscall
[cocatrice@hcss-ecs-4cd1 lab8]$ cat /proc/3416/status | head -8
Name:	sleep_loop
Umask:	0002
State:	S (sleeping)
Tgid:	3416
Ngid:	0
Pid:	3416
PPid:	3362
TracerPid:	0
[cocatrice@hcss-ecs-4cd1 lab8]$ cat /proc/3416/cmdline; echo
./sleep_loop
[cocatrice@hcss-ecs-4cd1 lab8]$ readlink /proc/3416/exe
/home/cocatrice/lab8/sleep_loop
status 里的 Name 是进程名 sleep_loop,State 是当前状态,Pid 和 PPid 一对父子编号。cmdline 是启动它的命令行,exe 用 readlink 读出来是磁盘上的真实路径。这几个文件都是内核现场算出来的,磁盘上没有这些东西。
- fork 的两个返回值。
[cocatrice@hcss-ecs-4cd1 lab8]$ ./fork_demo
hello proc : 3437, ret: 3438
hello proc : 3438, ret: 0
两行输出,第一行是父进程打的:自己的 pid 是 3437,fork 返回 3438,也就是它造出来的那个孩子的编号。第二行是子进程打的:自己的 pid 正好是 3438,fork 返回 0。
父进程拿到的返回值是子进程的 PID,子进程拿到的返回值是 0,这两个数字在同一份代码里是两回事。
- 走哪个分支。
[cocatrice@hcss-ecs-4cd1 lab8]$ ./fork_branch
I am father : pid=3440, ret=3441
I am child  : pid=3441, ret=0, ppid=3440
父进程打进来说自己是父亲,返回值 3441;子进程进来说自己是孩子,返回值 0,它的 ppid 正好是 3440,也就是父亲的 PID。三个数字环环相扣,对得上。
- fork 背后不是 fork。
[cocatrice@hcss-ecs-4cd1 lab8]$ strace -e trace=clone,fork,vfork ./fork_demo
clone(child_stack=NULL, flags=CLONE_CHILD_CLEARTID|CLONE_CHILD_SETTID|SIGCHLD, child_tidptr=0x7f35d63cda10) = 3511
hello proc : 3511, ret: 0
--- SIGCHLD {si_signo=SIGCHLD, si_code=CLD_EXITED, si_pid=3511, si_uid=1000, si_status=0, si_utime=0, si_stime=0} ---
hello proc : 3510, ret: 3511
+++ exited with 0 +++
[cocatrice@hcss-ecs-4cd1 lab8]$ nm -D /lib64/libc.so.6 | grep -wE 'fork|getpid|printf|malloc'
00000000000c5a30 W fork
00000000000c69a0 T getpid
0000000000085740 T malloc
0000000000053450 T printf
第一条输出就是真相:程序实际发起的是 clone,不是 fork。clone 返回 3511,那个数字立刻出现在子进程那行的 pid 位置。标志位里带着 SIGCHLD,意思是孩子退出时给父亲发个信号,所以后面紧接着一条 SIGCHLD 的记录。
nm 那四条是 libc 里的符号:fork 的类型是 W,弱符号;getpid、malloc、printf 都是 @Q Q@,在代码段里定义。你在源码里写的 fork 和 getpid,一个在库里有门面,一个在库里就是实现,真正干活的都是内核那一侧的接口。
- 手册页要按节查。
[cocatrice@hcss-ecs-4cd1 lab8]$ whatis fork 2>&1 | head -6
fork (2)             - create a child process
fork (3p)            - create a new process
[cocatrice@hcss-ecs-4cd1 lab8]$ man 2 fork 2>/dev/null | head -12
FORK(2)                    Linux Programmer's Manual                   FORK(2)

NAME
       fork - create a child process

SYNOPSIS
       #include <unistd.h>

       pid_t fork(void);
[cocatrice@hcss-ecs-4cd1 lab8]$ man 2 fork 2>/dev/null | sed -n '/RETURN VALUE/,/^$/p' | head -12
RETURN VALUE
       On success, the PID of the child process is returned in the parent, and
       0  is returned in the child.  On failure, -1 is returned in the parent,
       no child process is created, and errno is set appropriately.
[cocatrice@hcss-ecs-4cd1 lab8]$ man 3 printf 2>/dev/null | head -8
PRINTF(3)                  Linux Programmer's Manual                 PRINTF(3)

NAME
       printf,   fprintf,  sprintf,  snprintf,  vprintf,  vfprintf,  vsprintf,
       vsnprintf - formatted output conversion
[cocatrice@hcss-ecs-4cd1 lab8]$ ldd --version | head -1
ldd (GNU libc) 2.17
[cocatrice@hcss-ecs-4cd1 lab8]$ gcc --version | head -1
gcc (GCC) 4.8.5 20150623 (Red Hat 4.8.5-44)
whatis 一下子就列出了两个 fork:第 2 节是系统调用,第 3p 节是 POSIX 标准里的库接口。要查系统调用就写 man 2 fork,查库函数就写 man 3 printf,手册页标题行末尾括号里的数字就是节号。
手册页按内容分成九节,常用的就这么几个:
| 节号 | 内容 | 例子 |
|---|---|---|
| 1 | 用户命令 | man 1 ls |
| 2 | 系统调用 | man 2 fork |
| 3 | 库函数 | man 3 printf |
| 5 | 文件格式 | man 5 proc |
| 7 | 杂项与约定 | man 7 signal |
| 8 | 管理命令 | man 8 shutdown |
同一个名字可能同时出现在好几节里,whatis printf 一口气列出了四个:1 是命令行的 printf,3 是库函数,另外两个是 POSIX 标准里的接口。RETURN VALUE 那一节把三件事一次说清了:成功时父进程拿到子进程 PID、子进程拿到 0;失败时父进程拿到 -1,不创建子进程,同时设置 errno。前面所有关于返回值的说法,依据都是这三行。
常见报错
- fork 也会失败,失败时返回 -1。
改前
/* 不判返回值,直接假设 fork 一定成功 */
pid_t id = fork();
if (id == 0) {
    /* 子进程干活 */
} else {
    /* 父进程接着往下走 */
}
这种写法平时看不出问题,只有当系统不让再开进程时才暴露:父进程以为自己有了孩子,实际上没有,后面所有基于这个假设的逻辑全错,而且屏幕上一点提示都没有。
改后
/* 三个分支,失败单独处理 */
pid_t id = fork();
if (id < 0) {
    fprintf(stderr, "fork failed: %s\n", strerror(errno));
    return 1;
} else if (id == 0) {
    /* 子进程干活 */
} else {
    /* 父进程接着往下走 */
}
把进程数上限压到 60 就能把失败跑出来:
[cocatrice@hcss-ecs-4cd1 lab8]$ bash -c 'ulimit -u 60; timeout 10 ./fork_fail'; echo $?
fork failed after 55 children: Resource temporarily unavailable
1
程序在造出第 55 个子进程之后失败了,打印出 Resource temporarily unavailable,这就是 errno 里的 EAGAIN。原因是外面的 ulimit -u 60 把这个 shell 能开的进程数限制到了 60,加上 shell 自己和其他进程,到第 55 个就满了。
这个实验说明了三件事。fork 失败是正常的,不是程序写错了;失败的具体原因在 errno 里,用 strerror 转成人话;不判返回值的 fork 代码在生产环境里是会出事的,因为失败之后没有子进程,父进程却以为自己有了孩子,后面所有基于这个假设的逻辑全错。
- 输出莫名其妙翻倍。
改前
printf("hello");    /* 没有换行,内容留在缓冲区里 */
fork();             /* 缓冲区跟着地址空间一起被复制 */
[cocatrice@hcss-ecs-4cd1 lab8]$ ./dup_out; echo
hellohello
改后
printf("hello\n");  /* 带换行,行缓冲遇到换行当场刷出去 */
fork();             /* 这时候缓冲区是空的,没东西可复制 */
[cocatrice@hcss-ecs-4cd1 lab8]$ ./dup_ok; echo
hello
程序里只有一次 printf("hello"),屏幕上却出现两个 hello。原因是 printf 的内容先放进标准库的缓冲区,fork 会把整个进程的地址空间复制一份,缓冲区也一起被复制了;父子两个各自退出时都把缓冲区刷出去,于是同一句话被打印了两遍。
加上换行就没事了:行缓冲模式下遇到换行会立刻刷出去,fork 的时候缓冲区是空的,也就没有东西可以被复制。这个坑在把输出重定向到文件时更容易踩,因为那时候是块缓冲,连换行都不刷。
- 忘了包含头文件,编译器只给个警告。
[cocatrice@hcss-ecs-4cd1 lab8]$ gcc -Wall no_include.c -o no_include
no_include.c: In function 'main':
no_include.c:5:5: warning: implicit declaration of function 'getpid' [-Wimplicit-function-declaration]
     printf("pid: %d\n", getpid());
     ^
[cocatrice@hcss-ecs-4cd1 lab8]$ ./no_include
pid: 3866
忘了 #include <unistd.h>,编译器不知道 getpid 的返回类型,就按老规矩猜成 int,只给一条警告,程序照样编出来、照样能跑。在 64 位机器上,函数返回指针时这个猜测就会出错,拿到的高 32 位会丢。这类警告必须当错误处理,加上 -Werror 就能强制自己修掉。
边界情况
- fork 之后在中间函数里 return,会一路返回到 main。
[cocatrice@hcss-ecs-4cd1 lab8]$ ./ret_vs_exit
father : in do_fork, pid=3792
main   : pid=3792
child  : in do_fork, pid=3793
main   : pid=3793
do_fork 这个函数里 fork 了一次,子进程分支里写的是 return。结果子进程从这个 return 出来之后,继续往下执行了 do_fork 的调用者,也就是 main 剩下的那行打印。所以 main 那行出现了两次,一次是父进程打的,一次是子进程打的。
在 main 里 return 和 exit 效果一样,但在中间函数里完全不一样:return 只是回到上一层继续跑,exit 才是结束整个进程。子进程分支里想结束自己,用 exit,不要用 return,除非你确实想让它继续往下走。
- 同一个可执行文件跑两份,是彻底独立的两份。
[cocatrice@hcss-ecs-4cd1 lab8]$ ps -o pid,ppid,stat,cmd -C sleep_loop
  PID  PPID STAT CMD
 3415  3362 Ss   ./sleep_loop
 3416  3362 Ss   ./sleep_loop
两个进程各自有一个 PID,各自在 /proc 下有一个目录,各自的 status 里 Pid 不同、PPid 相同。它们在内存里是两份数据段,动其中一个的变量,另一个一点感觉都没有。前面 fork 出来的父子也是这个关系,区别只是父子之间多了一个返回值作为线索。
printf的缓冲区在终端和管道下都会被复制。
[cocatrice@hcss-ecs-4cd1 lab8]$ ./dup_out; echo
hellohello
[cocatrice@hcss-ecs-4cd1 lab8]$ ./dup_out | cat; echo
hellohello
两种方式都是两个 hello。直觉上会以为接到管道之后变成块缓冲、情况会不同,实测下来一样,因为缓冲区被复制这件事和缓冲模式无关:只要 fork 的那一刻缓冲区里还有东西,它就会被复制一份。
踩坑点
fork会失败,返回值小于 0 时必须处理,不判返回值的代码在进程数受限的环境里会静默出错。fork会把标准库缓冲区一起复制,printf没刷出去的内容父子各打一遍,写日志时尤其明显。- 子进程分支里结束自己要用
exit而不是return,在中间函数里return会让子进程继续往下跑。 - 冯诺依曼体系里 CPU 不能直接访问外设,所有数据都要经过内存,这一条是后面理解缓冲和 I/O 的基础。
- 操作系统管硬件管的是结构体,不是设备本身;描述用结构体,组织用链表,这两步是所有内核子系统的通用套路。
- 库函数不等于系统调用,libc 导出 2242 个符号,内核只开了 329 个系统调用,中间那一层是封装。
/proc不是磁盘上的目录,是内核现场算出来的窗口,读一次算一次。getpid和getppid是系统调用,不是普通函数,忘了包含头文件只会得到一条警告。- 进程不等于程序,同一个可执行文件跑两次就是两个互不相干的进程。
fork之后父子两个都从fork的下一行继续执行,两个返回值分别给两个进程,不是同一个函数返回了两次。- 父进程拿到子进程 PID 是为了区分多个孩子,子进程拿 0 是因为它只有一个父亲,用
getppid就能问出来。 fork在 libc 里是弱符号,内核里对应的系统调用叫clone。- 查手册要写节号,
man 2 fork是系统调用,man 3 printf是库函数。
本篇总结(模拟面试问题)
问:进程是什么?
核心要点:三种说法都要会说。课本上说是程序的一个执行实例;内核观点是担当分配系统资源的实体;最实用的是进程等于内核数据结构 task_struct 加上自己的程序代码和数据。
问:PCB 是什么,Linux 下叫什么?
核心要点:进程控制块,是进程属性的集合。Linux 下的 PCB 就是 task_struct,会被装载到内存里,装着标识符、状态、优先级、程序计数器、内存指针、上下文、I/O 状态和记账信息这八类字段。
问:怎么查看一个进程的信息?
核心要点:三条路。/proc/PID 是内核直接暴露的窗口,ps 和 top 是把里面的数据读出来重新排版。查某个进程用 ps -o pid,ppid,stat,cmd -C 进程名 最直接。
问:fork 的返回值分别是什么?
核心要点:父进程得到子进程的 PID,子进程得到 0,失败时父进程得到 -1 并设置 errno,不创建子进程。
问:为什么要给父子返回不同的值?
核心要点:一个父进程可能有多个子进程,拿到子 PID 才知道这次造的是哪一个;子进程只有一个父亲,返回 0 表示自己是孩子,想知道父亲是谁调 getppid 就行。
问:冯诺依曼体系里为什么说 CPU 不能直接访问外设?
核心要点:CPU 只和内存交换数据,外设也只和内存交换数据,所有数据流动都要经过内存。这样设计的好处是设备之间的速度差异由内存和缓冲来抹平,CPU 不用去适配各种外设的时序。
问:操作系统是怎么管理硬件的?
核心要点:先描述再组织。给每一类硬件定义一个结构体,把它的信息记下来;再用链表之类的结构把同类的串起来。之后所有的操作都是对结构体做,不是直接碰设备。
问:fork 之后父子进程的数据是共享的还是各自的?
核心要点:代码段共享同一份物理内存,数据段各有一份,采用写时拷贝:fork 时先共享,谁写谁复制。验证方法放在下篇的地址空间里做,父子打印同一个地址、值却不同。
问:为什么说 fork 不是返回了两次?
核心要点:fork 之后系统里多了一个进程,父子两个各自从 fork 的下一行继续跑,各自拿到一份返回值。是两次独立的返回,不是一个函数返回了两遍。
问:fork 在 libc 里是弱符号,这说明了什么?
核心要点:说明它只是一个门面,可以被更强的实现覆盖,内核里真正干活的系统调用是 clone。用 strace -e trace=clone 能看到实际发起的就是 clone,标志位里带着 SIGCHLD。
问:printf 的内容为什么会在 fork 之后打印两遍?
核心要点:printf 先把内容放进标准库缓冲区,fork 复制整个地址空间时把缓冲区一起复制了,父子退出时各自刷新一次。加换行及时刷掉、或者 fork 前手动 fflush 都能避免。
问:/proc 目录里的文件是真的文件吗?
核心要点:不是。它们不占磁盘空间,每次读都由内核现场算出来。目录名就是 PID,里面的 status、cmdline、exe 分别对应 task_struct 里不同类别的字段。
问:一个程序从敲回车到 main 之间经历了什么?
核心要点:shell 先 fork 出子进程,子进程再 execve 装载目标程序;动态链接器接着查找并加载 libc,读 ld.so.cache 加速查找;然后是映射各个段、做重定位,跳进 libc 的启动代码,最后才调用到 main。
问:uname -a 输出里哪一段是内核版本?
核心要点:第三个字段,这台机器上是 3.10.0-1160.119.1.el7.x86_64。
问:查 PID 为 1 的进程信息,看哪个目录?
核心要点:/proc/1。
问:getpid 和 getppid 需要包含哪个头文件?
核心要点:<unistd.h>,另外习惯上还会带上 <sys/types.h>。
问:列出三种查看进程信息的方式。
核心要点:/proc/PID 目录、ps 命令、top 命令。前一个是内核直接暴露出来的窗口,后两个是用户级工具,做的事情是把 /proc 里的数据读出来重新排版。
问:printf 和 write 有什么区别?
核心要点:printf 是库函数,负责格式化和缓冲;write 是系统调用,直接把字节交给内核。printf 最后会调用 write 把缓冲区里的内容送出去。
问:写一个 fork 之后父子各自打印一句话的程序,要求父进程先打印。
核心要点:fork 之后判断返回值,大于 0 的分支里打印并 sleep 一小会儿,等于 0 的分支里等一会儿再打印。父子谁先跑由调度器决定,要保证顺序只能靠 sleep 或者信号同步。
问:fork 失败时怎么知道原因?
核心要点:返回值小于 0 说明失败,原因在 errno 里,用 strerror(errno) 打印出来,常见的是进程数超限时的 EAGAIN。
问:为什么 ps 能看到别的用户的进程?
核心要点:/proc 下每个进程的目录对所有用户都可读,ps 读的就是这些目录。能不能看到取决于 /proc/PID 里各个条目的读权限,能不能操作那个进程则由内核在做权限检查时决定。
参考
- fork 系统调用手册页,返回值约定和写时拷贝都在里面:https://man7.org/linux/man-pages/man2/fork.2.html
- getpid 与 getppid 手册页:https://man7.org/linux/man-pages/man2/getpid.2.html
- clone 系统调用手册页,fork 底下真正调的那个:https://man7.org/linux/man-pages/man2/clone.2.html
- /proc 目录说明,一个数字一个进程:https://man7.org/linux/man-pages/man5/proc.5.html
- printf 系列手册页,第 3 节是库函数:https://man7.org/linux/man-pages/man3/printf.3.html
- ps 手册页,aux 与 -ef 各列的含义:https://man7.org/linux/man-pages/man1/ps.1.html
- top 手册页:https://man7.org/linux/man-pages/man1/top.1.html
- strace 手册页:https://man7.org/linux/man-pages/man1/strace.1.html
- nm 手册页,看库导出了哪些符号:https://man7.org/linux/man-pages/man1/nm.1.html
- 信号总览,SIGCHLD 在这里:https://man7.org/linux/man-pages/man7/signal.7.html

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 6
 0
- 0


 已为社区贡献1条内容

所有评论(0)