Ext2文件系统与inode、数据块的组织方式
文件放到磁盘以后,需要有人把这些东西管理起来。
比如:
- 哪些 Block 已经被使用了?
- 哪些 Block 还是空闲的?
- 一个文件对应哪个 inode?
- inode 又是怎么找到文件内容的?
这些问题最终都要靠文件系统来解决。
一、为什么需要文件系统?
我们可以把磁盘简单理解成很多个 Block。
但是如果这些 Block 就这么直接堆在一起,操作系统根本不知道每一个 Block 是干什么的。
比如创建一个文件,总得先找到一个空闲的 inode,再找到一些空闲的数据块;以后访问这个文件的时候,还得知道数据到底放在哪里。
所以,磁盘上的这些数据不能只是简单地存起来,还必须按照一定的规则组织起来。
这个负责组织和管理磁盘文件的东西,就是文件系统。
Linux 中常见的 Ext 系列文件系统有:
ext2
ext3
ext4
它们之间虽然有发展和增强,但整体的核心设计还是比较接近的,所以这里主要拿 ext2 来理解整个文件系统的基本结构。
二、Ext2的整体结构
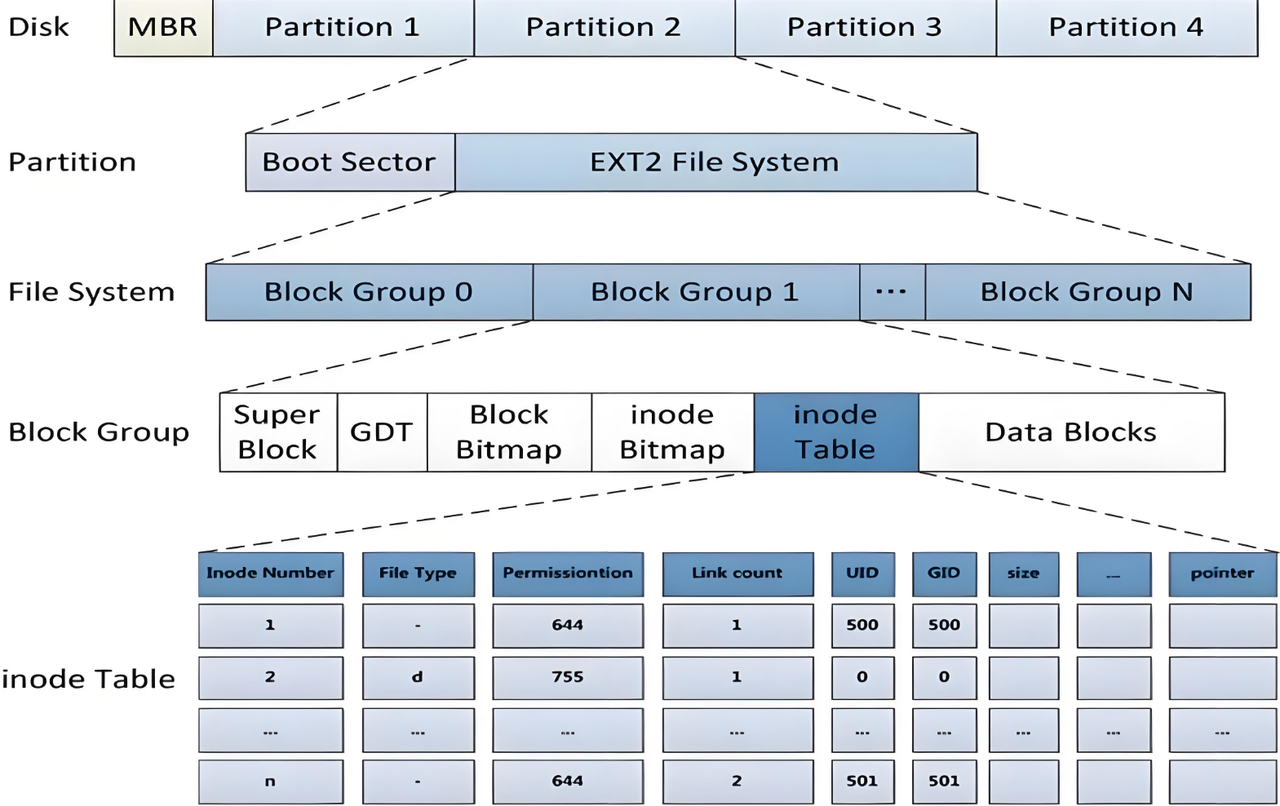
Ext2 不会把整个分区直接作为一个整体来管理,而是会把一个分区划分成很多个大小相同的:
Block Group,也就是块组。
整体结构可以先简单理解成:
一个分区
    ↓
多个 Block Group
这样做以后,就可以把一个比较大的分区分成很多个区域分别管理。
另外,在 Ext2 文件系统前面还有一个启动块,也叫 Boot Block / Sector。
它的大小是固定的 1KB,主要用来保存磁盘分区信息和启动信息。启动块之后,才真正进入 Ext2 文件系统的区域。
三、Block Group里面有什么?
知道了一个分区会被划分成很多个 Block Group,接下来就要看看:
一个 Block Group 里面到底放了些什么?
主要可以分成下面几个部分:
Super Block
GDT
Block Bitmap
Inode Bitmap
Inode Table
Data Blocks
每一部分负责的事情都不一样。
只要把这几个结构搞明白,Ext2 的整体框架基本也就清楚了。
四、Super Block:保存整个文件系统的信息
首先是:
Super Block(超级块)
它主要保存整个文件系统的结构信息。
比如:
Block 总数
Inode 总数
空闲 Block 数量
空闲 Inode 数量
Block 大小
Inode 大小
最近一次挂载时间
最近一次写入时间
最近一次检查磁盘时间
这些信息描述的是整个文件系统,而不是某一个具体文件。
所以我在理解的时候,会把 Super Block 想成一个“总说明书”。
比如系统需要知道:
这个分区有多少 Block?
还有多少 inode 可以使用?
一个 Block 到底多大?
都可以从 Super Block 中找到相关信息。
Super Block 这么重要,所以一般不会只保存一份。它会在多个 Block Group 中保存副本,用来提高文件系统的可靠性。第一个块组一定存在,后面的块组可以根据情况决定是否保存。
五、GDT:描述每个Block Group
接下来是:
GDT(Group Descriptor Table)
也就是块组描述符表。
既然整个分区有很多 Block Group,那系统还得知道:
每个 Block Group 的具体情况怎么样?
这就是 GDT 负责的事情。
一个块组描述符里面会记录类似这样的信息:
Block Bitmap 在哪里
Inode Bitmap 在哪里
Inode Table 在哪里
空闲 Block 有多少
空闲 Inode 有多少
目录有多少
所以可以简单记成:
Super Block
    ↓
描述整个文件系统

GDT
    ↓
描述具体的 Block Group
两者管理的范围是不一样的。
六、Block Bitmap:记录哪些Block已经被使用
再往下就是:
Block Bitmap
这个东西的功能其实很好理解,就是记录 Data Block 的使用情况。
也就是:
这个 Block 有没有被占用?
可以用一个 bit 来表示一个 Block 的状态。
例如简单理解成:
0 -> 空闲
1 -> 已使用
这样就可以用很少的空间记录大量 Block 的使用情况。
所以以后创建文件的时候,系统就可以通过 Block Bitmap 去寻找空闲的数据块。
七、Inode Bitmap:记录哪些inode可以使用
Block 有自己的 Bitmap,inode 当然也一样。
对应的就是:
Inode Bitmap
它负责记录 inode 的使用情况。
同样可以理解成:
0 -> inode 空闲
1 -> inode 已使用
一个 bit 对应一个 inode,用来表示这个 inode 是否还可以分配。
所以这两个 Bitmap 可以直接对应起来理解:
Block Bitmap
    ↓
管理 Block

Inode Bitmap
    ↓
管理 inode
八、Inode Table:真正存放inode
前面 Inode Bitmap 只是告诉我们:
哪些 inode 在使用,哪些 inode 空闲。
真正保存 inode 内容的地方,是:
Inode Table。
这里面存放着一个个 inode。
比如:
文件大小
所有者
权限
时间信息
硬链接数
数据块映射信息
这些和文件属性有关的信息都会保存在 inode 中。
这里还有一个需要记住的地方:
inode 编号是以分区为单位划分的,不能跨分区。
九、Data Block:真正保存文件内容
最后就是:
Data Block
这个地方保存真正的数据。
对于普通文件来说:
Data Block
    ↓
文件内容
比如一个文本文件里面写了一大段字符串,这些真正的数据最终就是放在 Data Block 里的。
但是目录有一点特殊。
目录其实也是文件,它自己的 Data Block 里面保存的是:
文件名
+
inode号
也就是说,目录主要负责建立:
文件名 -> inode
这样的对应关系。
而文件的权限、所有者等其他属性,还是放在 inode 里面。
所以这时候有一个很重要的认识:
目录其实也是一种文件。
十、inode怎么找到数据块?
现在已经知道 inode 和 Data Block 分别是什么了。
但还有一个关键问题:
inode 怎么知道自己的文件内容到底存在哪些 Block?
这个信息就记录在 inode 的:
__le32 i_block[EXT2_N_BLOCKS];
里面。
这里:
EXT2_N_BLOCKS = 15
这些信息用来完成 inode 和数据块之间的映射。
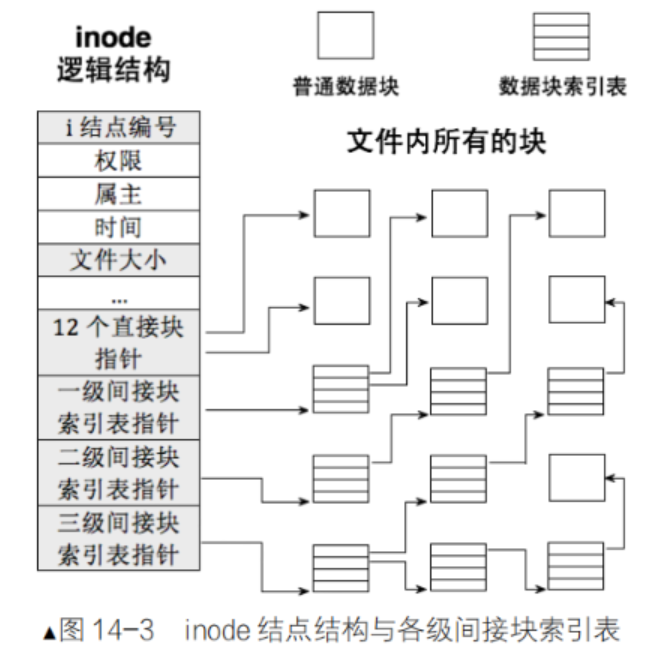
也就是说:
inode
   ↓
找到对应的数据块
   ↓
找到真正的文件内容
这样一来,一个文件的两部分就都能找到了:
文件
├── inode
│   └── 保存属性
│
└── Data Block
    └── 保存内容
所以以前我容易把文件理解成“一堆数据”,现在感觉这种理解还是有点太简单了。
更准确一点应该是:
文件的属性和文件的内容是分开保存的。
十一、创建一个新文件,到底发生了什么?
这个地方我觉得特别值得理解,因为前面的各种结构一下就能串起来了。
假设我们执行:
touch abc
然后:
ls -i abc
可以看到这个文件对应的 inode 号。
那么创建 abc 的时候,系统大概需要完成下面四件事情。
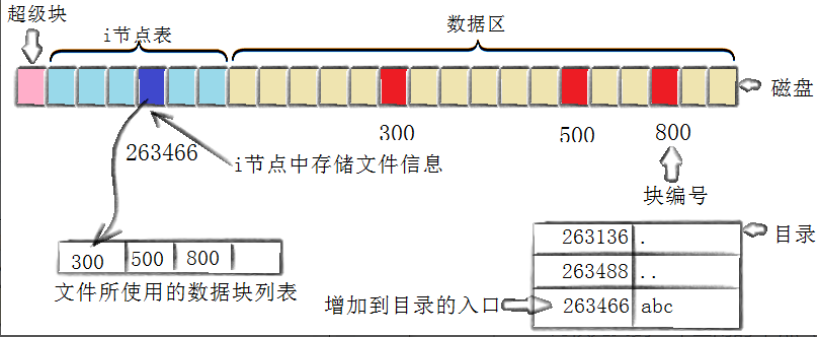
1. 给文件找一个inode
首先找到一个空闲 inode。
然后把文件的属性写进去。
比如文件大小、权限、时间等。
2. 给文件找数据块
如果文件里面有数据,那么还需要找到空闲的 Data Block。
文件数据被放到了:
300
500
800
这三个 Block 中。
3. 把Block的对应关系记录下来
文件现在知道自己的内容放在:
300
500
800
这几个块里。
那系统就需要把这个对应关系记录到 inode 中。
这样以后通过 inode,就能够继续找到真正的数据。
4. 在目录中记录文件名
到这里其实还差最后一步。
我们平时访问文件的时候输入的是:
abc
而不是 inode 号。
所以目录里面还需要建立:
abc
 ↓
263466
这样的映射。
也就是:
文件名 -> inode号
这样文件名、inode 和文件内容之间才真正联系起来。
十二、重新理解“文件名”和“inode”
这一点是我这部分学习过程中比较容易搞混的地方。
以前我会觉得:
abc
就是这个文件。
但是从文件系统的角度来看,实际上并不是这样。
真正保存文件属性和数据块映射的是 inode,而文件名并不直接放在 inode 结构中。
所以可以把它理解成:
目录
  ↓
文件名
  ↓
inode
  ↓
文件属性 + 数据块映射
  ↓
Data Block
  ↓
文件内容
这样整个关系就顺起来了。
十三、这一篇的总结
学完 Ext2 之后,我觉得最重要的不是死记几个结构,而是把它们之间的关系真正串起来。
一个分区大致可以看成:
Partition
   ↓
多个 Block Group
一个 Block Group 里面又有:
Block Group
   ├── Super Block
   ├── GDT
   ├── Block Bitmap
   ├── Inode Bitmap
   ├── Inode Table
   └── Data Blocks
而访问一个具体文件时,可以继续往下:
文件名
   ↓
目录
   ↓
inode
   ↓
文件属性
   +
数据块映射
   ↓
Data Blocks
   ↓
真正的文件内容
这样一看,整个 Ext2 文件系统其实就是在做一件事情:
把磁盘上的各种资源组织起来,让操作系统能够快速找到文件,同时知道哪些资源已经使用、哪些资源还可以继续分配。
以前看到 inode、Block Bitmap、Super Block 这些名词的时候,感觉都是零散的知识点。
现在把它们放到一起之后,就能发现它们其实是一整套相互配合的结构。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 2
 0
- 0


 已为社区贡献6条内容

所有评论(0)