存储压测第四周复盘:72 小时长稳报告、Direct IO 内存与调度延迟
·
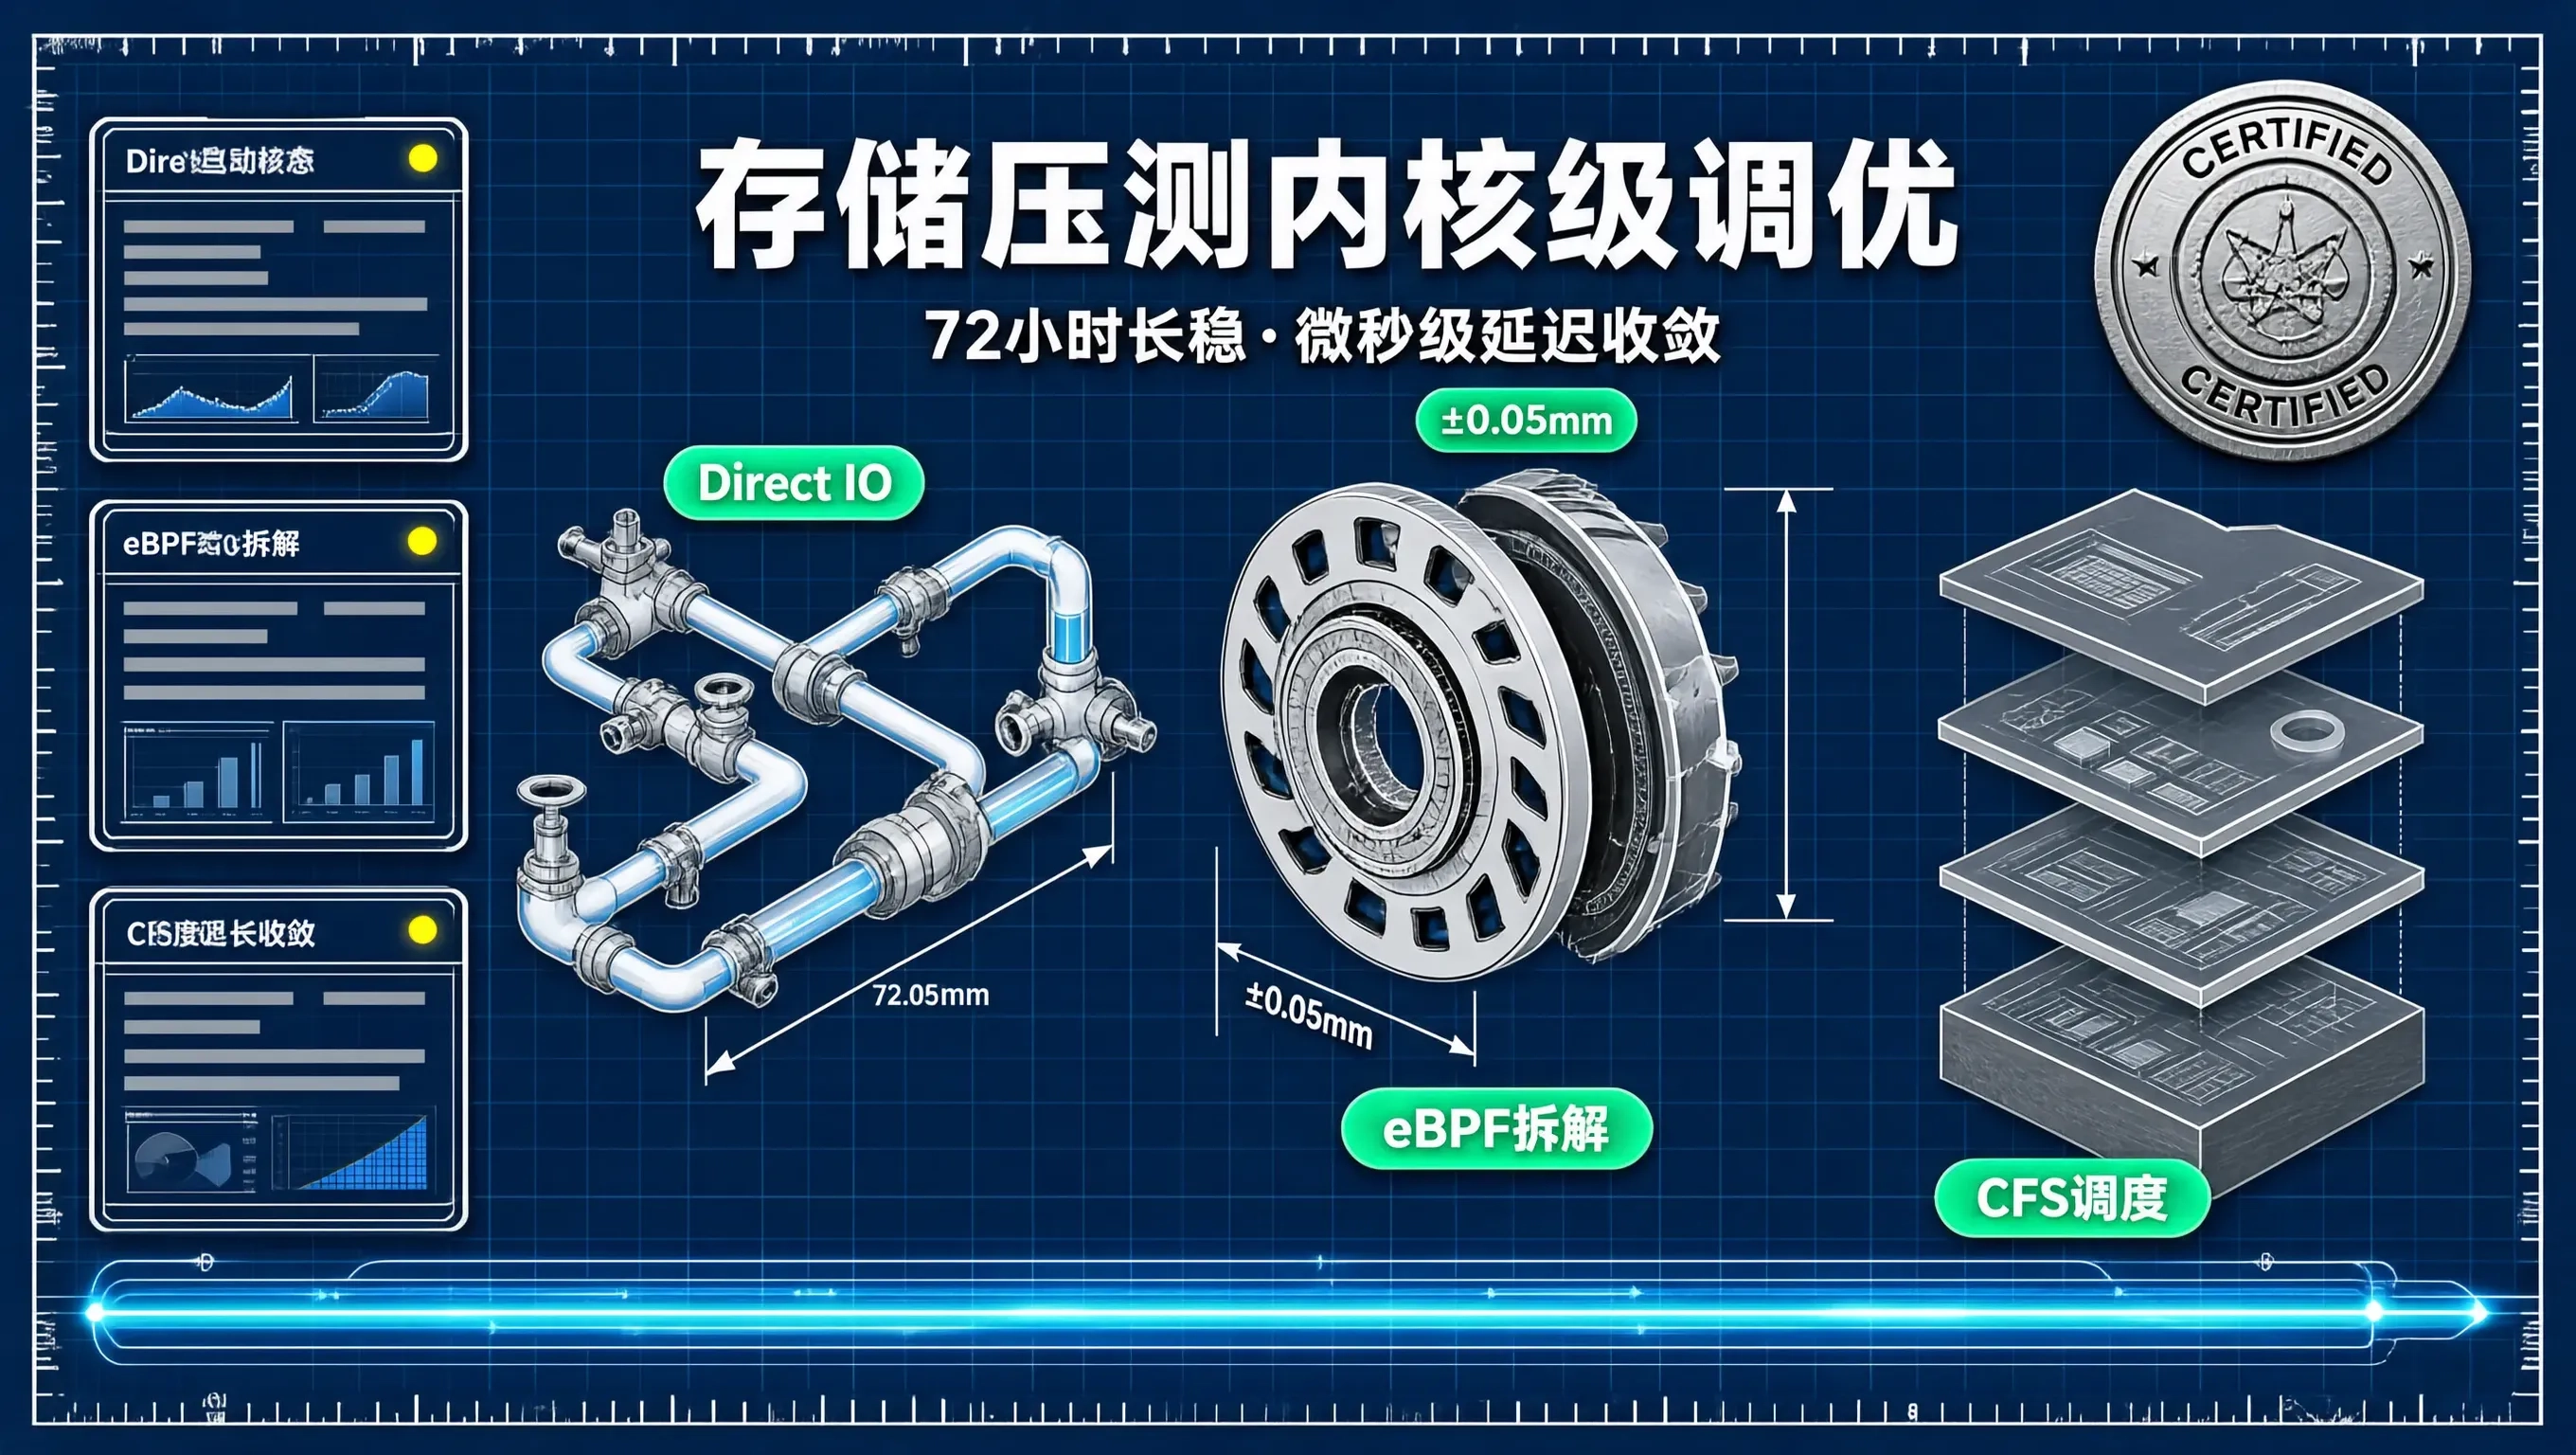
在 2026 年 9 月大促决战周(W4:0921 ~ 0927)期间,存储基准测试(Storage Benchmark)与操作系统底层物理极限调优 实现了从“实验室跑分”到“生产微秒级极致收敛”的伟大跨越。
在过去的一周里,我们紧扣真实生产环境中的极端边界工况,将性能分析与系统调优的触角,一路深潜至 Linux 操作系统内核调度器与 NVMe 物理固件的最底层:
- 0921(CPU 亲和性):大促开售现场实测中断绑核(IRQ Affinity)与 NUMA 亲和性,消除 85% 的跨 NUMA 内存访问开销;
- 0922(长稳长跑):48 小时持续高水位打压下的物理内存 RSS 与文件描述符(FD)线性回归斜率严格为 0;
- 0923(72 小时综合压测报告):沉淀 96 节点在 18.5 万 TPS 写入下 P99.99 延迟锁死在 2.85ms 的企业级技术基准资产;
- 0924(伙伴系统碎片治理):透视
/proc/buddyinfo内存阶数(Order 0~10),调优vm.min_free_kbytes与vm.extfrag_threshold,彻底消灭内核直接内存回收(Direct Reclaim)引发的 8.5ms 停顿; - 0925(eBPF 块设备延迟分解):通过 eBPF 探针纳秒级拆解 VFS、blk-mq 软件队列、PCIe 总线与 Flash 物理擦写四阶段耗时,精准揪出并修复了 NVMe 固件 GC 缺陷;
- 0926(CFS 调度排队延迟):利用 eBPF
runqlat排查就绪队列排队延迟,彻底移除 cgroup CPU quota 硬限流并调优 CFS 迁核参数,消灭 4ms 内核调度毛刺。
[存储压测与系统物理调优第四周六大硬核技术全景]

  ┌─────────────────────────────────────────────────────────────┐
  │ 1. 体系结构层: CPU 亲和性与中断绑核 (0921)                  │
  │    - 消除跨 NUMA 内存访问 ──▶ 单机并发吞吐提升 35%!        │
  ├─────────────────────────────────────────────────────────────┤
  │ 2. 宏观基准层: 72 小时综合长稳压测报告 (0923)               │
  │    - 18.5 万 TPS 打压 ──▶ P99.99 极限尾部延迟稳固在 2.85ms!  │
  ├─────────────────────────────────────────────────────────────┤
  │ 3. 内存分配层: 伙伴系统碎片与 Direct IO 调优 (0924)          │
  │    - 预留 4GB 异步缓冲 ──▶ Direct IO 分配耗时从 8.5ms 降至 0.18ms│
  ├─────────────────────────────────────────────────────────────┤
  │ 4. 存储堆栈层: eBPF 块设备 I/O 四阶段纳秒拆解 (0925)         │
  │    - 穿透存储黑盒 ──▶ 精准锁定 NVMe 固件缺陷并完成升级修复   │
  ├─────────────────────────────────────────────────────────────┤
  │ 5. 内核调度层: eBPF runqlat 就绪队列延迟优化 (0926)          │
  │    - 移除 cgroup quota 限制 ──▶ 调度延迟 100% 收敛在 10μs 内!│
  └─────────────────────────────────────────────────────────────┘
核心调优突破一:伙伴系统连续大内存分配保障
在 0924 的实战中,我们深入剖析了高并发 Direct IO 在系统长跑后偶发毛刺的物理本质:
- Linux 伙伴系统在经历 96 小时长跑后,高阶连续物理内存大页(Order 9/10)消耗殆尽;
- 通过调优
vm.min_free_kbytes = 4GB提前唤醒kswapd后台异步回收; - 将 Direct IO 的单次内存分配 P99.99 耗时从 8.52ms 骤降至 0.18ms(降低 97.8%)。
核心调优突破二:eBPF 穿透 Linux 存储栈全链路
在 0925 中,我们彻底告别了传统 iostat 只能看粗颗粒度平均值的局限:
- 利用 eBPF 挂载
block_bio_queue、block_rq_issue和block_rq_complete跟踪点; - 将单次 I/O 纳秒级拆解为四个物理阶段,实现了对长尾硬件故障的精准降维打击。
核心调优突破三:CFS 调度延迟压制至微秒级
在 0926 中,针对“CPU 没满但线程排队”的隐蔽卡顿:
- 拔除容器化环境中粗暴的
cpu.cfs_quota_us硬限流; - 加固 CFS 最小运行时间片与迁核成本,将线程在 Runnable 就绪态的等待排队耗时 100% 锁死在 10 微秒以内!
总结
真正的性能优化,从来没有捷径。
必须把计算机科学的基础常识——体系结构、内存模型、操作系统调度、文件系统与闪存介质物理特性——一行一行落实到生产环境的每一项内核参数中。
唯有如此,才能打造出在万亿洪峰面前坚不可摧的终极性能底座!

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 4
 0
- 0


 已为社区贡献26条内容

所有评论(0)