线程的概念和理解
一、什么是线程
1.1 教材定义
线程是进程内部的一个执行分支。
进程最终会被 CPU 调度,本质也是一个"执行流"的概念——它能让 CPU 执行自己的代码、完成进程要完成的任务。如果进程内部可以拆出多个这样的执行分支,那就是线程。
1.2 为什么教材上的定义总让人不可理解
因为操作系统教材谈论的向来不是具体的操作系统,它只提供指导思想,不提供实现方案。
- 学科里:“线程是进程内部的执行分支” —— 这是概念
- Linux 为实现这个概念,采用的是"用进程模拟线程"的方案
- Windows 为实现同一个概念,采用的是"PCB + TCB"的方案
💡 操作系统是计算机学科的指导手册(哲学)。你让一个从一线打上来的将军理解"大战该怎么打",他能懂;但你对着一个没上过战场的书呆子只讲指导思想,就是空中楼阁——人往往先理解具体实现方案,再理解抽象思想。
所以要先把学习思路转变一下:聚焦具体的 Linux,看到它真实的实现,再推而广之。也就是先学具体,再学抽象。
二、重新定义进程与线程
先把结论摆出来(后面逐条解释):
| 定义 | 关键词 | |
|---|---|---|
| 进程 | 承担分配系统资源的基本实体 | 要资源 |
| 线程 | CPU 调度的基本单位 | 被调度 |
💡 重新定义不是否定旧概念(进程 = 内核数据结构 + 代码和数据),而是换一个角度看同一枚硬币——侧看是一条圆弧,俯看是一个圆。不同角度是为了后面理解线程做准备。
2.1 为什么进程是"承担分配系统资源的基本实体"
想一个问题:创建一个进程时,就是"创建一个执行流"吗?
✖ 不是。进程一旦创建,就要:
- 创建 PCB、地址空间(mm_struct)、页表
- 加载代码和数据、构建映射关系
- 创建文件描述符表、信号相关的表结构
- 可能还要加载动静态库
这一大堆内核数据结构 + 自己的代码数据,归根结底都要占据内存资源、占用 CPU 资源。而内存是硬件资源,总有上限——申请一个进程,系统资源就少一份。
✔ 所以从"资源"的角度看:进程首先要干的是"给我整一批资源出来",它就是承担分配系统资源的基本实体。
那申请的资源是给谁用的?给执行流(线程)用的。以前进程内部只有一个执行流,所以看起来"进程 = 执行流"。
2.2 家庭比喻(感性理解)
| 概念 | 现实对应 |
|---|---|
| 社会 | 操作系统 |
| 社会分配资源的基本实体 = 家庭 | 承担分配系统资源的基本实体 = 进程 |
| 家庭内部成员(爸妈赚钱、你上学、爷奶养老) | 线程——各做各的事 |
| 公园/学校/公司/土地 | CPU——每个人在不同的"CPU"上被调度 |
| 全家共同目标:过好日子 | 进程要完成的任务 |
| 只有一个人的家庭(留守老人/独居) | 以前讲的单进程 = 内部只有一个线程的特殊情况 |
家庭里:房子、学校、医院、冰箱、电视是共享的;但你自己的作业、病历本、存折是独享的。对应到进程/线程:大部分资源是共享的,小部分资源是各线程私有的。
三、资源划分的真相:地址空间是"资源窗口"
3.1 一个进程拥有的资源,取决于它的"窗口"有多大
✔ 进程访问的绝大部分资源,都是通过地址空间访问的:
- 自己的代码、堆、栈、加载的动静态库
- 通信时申请的共享内存
- 访问系统调用(3-4GB 内核区)
因为地址空间就是进程看到资源的窗口(mm_struct + 一堆 vm_area_struct 描述出范围)。所以:
一个进程拥有多少资源,本质是这个进程通过地址空间窗口能看到多少资源。
(打开的文件、信号不属于地址空间范畴,是 PCB 通过 fd 表、信号表直接找到的,属于"另一把事"。)
3.2 虚拟地址就是资源的代表
- 地址空间上的每个合法虚拟地址,都一定有页表映射关系 → 能找到对应物理地址
- 而物理地址对应的是存储空间,以及空间里的代码/数据
💡 虚拟地址 = 资源的代表。 你有多少合法虚拟地址,就拥有多少资源。(malloc 时只是把堆区的 start/end 往上挪了挪,本质是给虚拟地址范围,物理内存后面才申请。)
3.3 怎样把资源划分给不同线程:靠"函数"
既然资源划分 = 划分虚拟地址范围,那代码区怎么划分?
- C/C++ 写代码,最终都是由一个一个函数构成的;每个函数都有入口地址(所以语言里才有回调、函数指针)
- 函数本质是代码块,块里每一行代码都有地址,第一份地址叫入口地址
- ELF 编译采用平坦虚拟逻辑地址(段基址为 0,只留偏移)——所以:函数就是虚拟地址空间的集合
于是划分方式自然就出来了:
让不同的执行流,执行不同的入口函数。 各执行流从自己的入口函数开始跑,天然就会访问虚拟地址空间的不同区域——资源划分天然就完成了,不需要人为切分。
✔ 结论串起来:资源划分本质 = 划分地址空间(虚拟地址范围)= 划分页表条目;资源共享本质 = 地址空间共享 = 页表条目共享。
四、Linux 的实现方案:用进程模拟线程(轻量级进程)
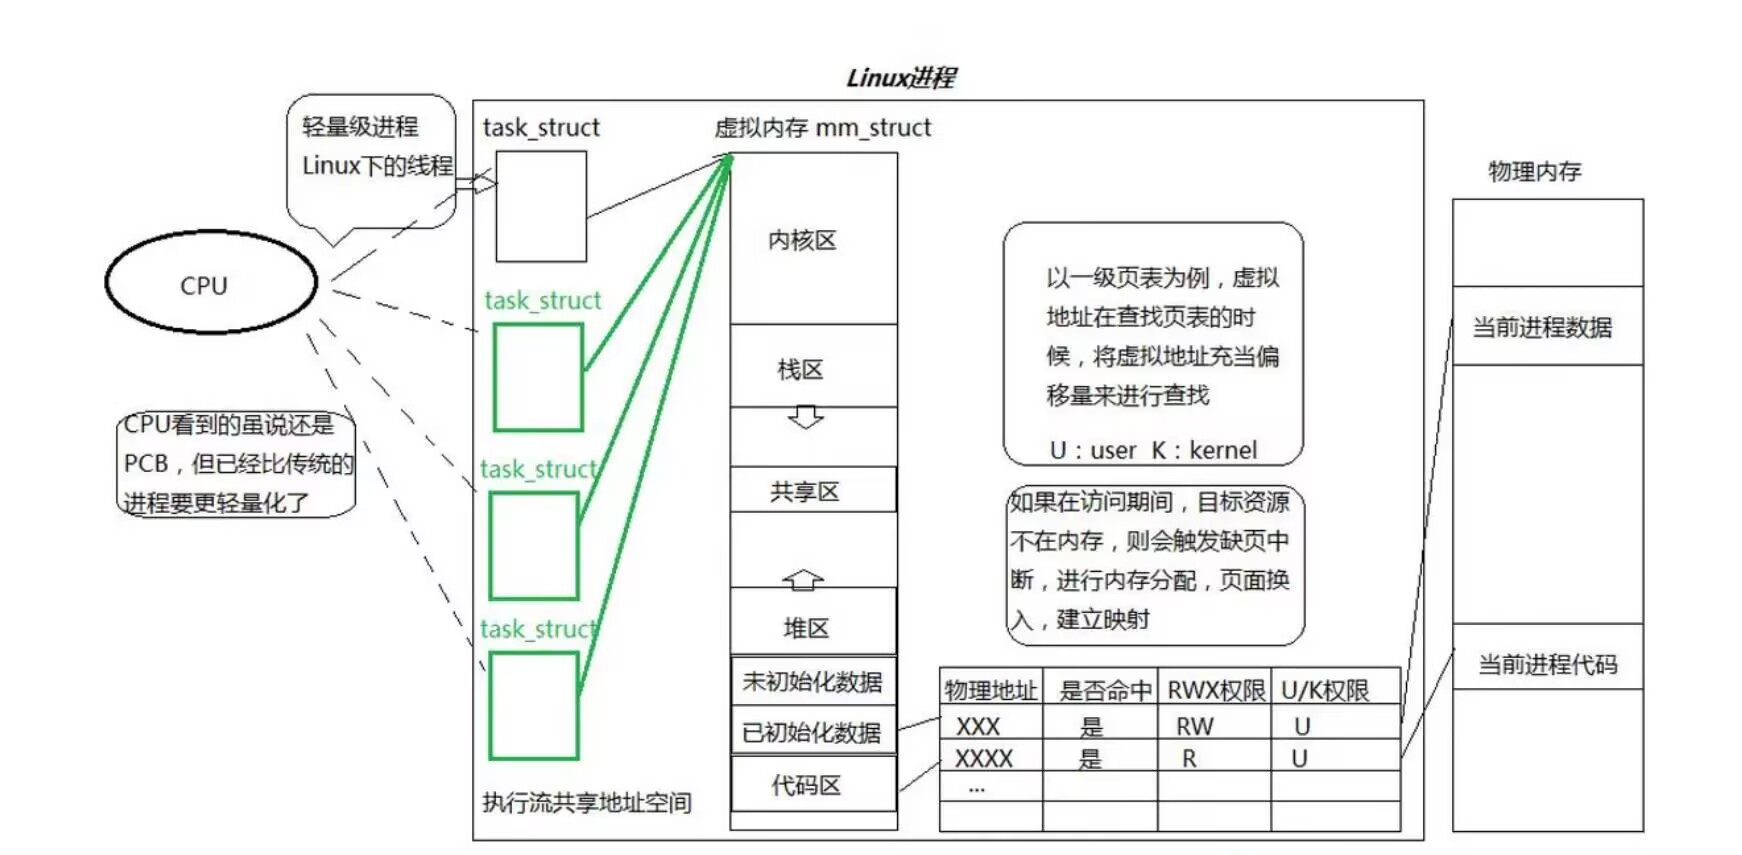
4.1 思路
创建一批"特殊的进程":
- 不给它们分配独立的地址空间(mm_struct)
- 不给它们创建独立的页表
- 只创建一个个 task_struct,让它们全部指向同一个地址空间
这样所有执行流就看到了同一份资源——这就叫线程。
4.2 为什么不单独设计线程结构(TCB)
理论上,如果要在内核里"真正实现"线程:
- 线程数量一定比进程多,管理需求更迫切(也要创建/终止/调度/阻塞/挂起)
- 先描述再组织 → 就需要 TCB(Thread Control Block),还要维护 TCB 与 PCB 的关系(PCB 里挂一条 TCB 链表,或全部 TCB 用链表组织起来)
但 Linux 程序员认为没必要:线程和进程在调度属性上相似度高达 90%——都要被调度、都要切换、都要上下文保存、都会被时钟中断、都要做时间片检查。
所以 Linux 直接把 task_struct 复用过来模拟线程:
- 执行流的优先级、状态、切换、调度算法 一行代码都不用改(连多写一套调度器都不用)
- 复用的是历史上被无数次印证过的代码 → 更健壮、测试/维护/debug 成本更低
- 这正是 Linux 能长期当服务器后端的原因之一(进程/线程创建释放是高频操作)
4.3 对比:Windows 怎么做
| 方案 | Linux | Windows |
|---|---|---|
| 实现 | 用进程模拟线程(复用 task_struct) | 专门为线程创建 TCB(PCB + TCB 双结构) |
| 特点 | 结构简单、复用历史代码、健壮 | 数据结构更多、内核维护成本更高、调度算法要另行设计 |
| 称呼 | 轻量级进程 LWP | 线程(有单独的线程创建接口) |
💡 思维观念很重要:说 Linux 优秀不代表 Windows 糟糕——只是从"代码复用/生命周期"角度看,Linux 的设计更漂亮。
4.4 CPU 视角:不区分进程还是线程
- 操作系统软件视角:统一都叫执行流
- CPU 硬件视角:更不管——CPU 只干两件事:① 主动不停向系统触发时钟中断,要求操作系统调度;② 被动地"你给我什么我就执行什么"
所以 CPU 眼里:执行流 ≤ 进程(等于进程 = 一个 PCB 代表整个进程;小于进程 = 多线程里的某一个 PCB)。
Linux 底层不存在真正意义上的"线程",一个一个的 PCB 统一叫轻量级进程(LWP)。
五、理性角度①:物理内存是怎么被管的
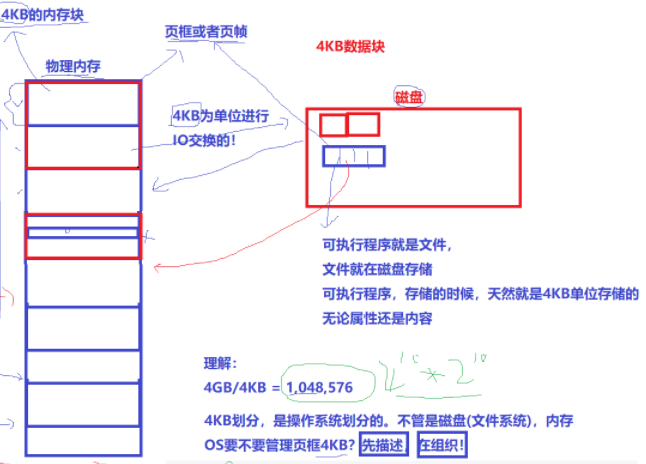
5.1 4KB 页框与页帧
- 磁盘以 4KB 为单位划分数据块;可执行程序(ELF)也是按 4KB 存储的(section 合并成 segment 就是为了 4KB 对齐加载)
- 物理内存同样被操作系统划分为 4KB 的内存块(使用上仍可按字节访问,但申请/管理以 4KB 为单位)
- 4KB 的内存块叫页框(页帧):页 = 数据块(内容),页框 = 存储区(空间)
💡 4KB 这个数字一旦定下来,磁盘数据块、内存管理、虚拟地址划分全都要遵守它。32 位系统页 4KB,64 位一般是 8KB。
5.2 怎么管理这么多页框:先描述,再组织
4GB / 4KB = 1048576 个页框 → 就需要 100 多万个描述结构:
struct page {
    /* 标志位(位图)、引用计数、LRU 链表、缓存相关字段、虚拟地址… */
};
struct page mem[1048576];   // 全局定义,位于内核头部,位置固定
- 描述:一个
struct page描述一个 4KB 页框(必须很小,十几个字节,否则自身就吃掉十几 MB) - 组织:定义成数组,于是"管理整个物理内存"变成"对数组的增删改查"(基于数组之上还有伙伴系统等算法,本课不展开)
✔ 关键结论:数组下标 × 4KB = 该页框的起始物理地址,而 物理地址 = 起始物理地址 + 页内偏移。所以 struct page 里不用记录自己的物理地址。
5.3 申请物理内存在干什么
申请物理内存 = ① 在全局数组中找到一个 flag 为"未占用"的 page
             ② 把它置为"已占用"(改 page)
             ③ 建立内核数据结构对应关系(让进程/线程能挂上这块内存)
- 谁申请:载体永远是进程或线程(打开文件要内存、申请堆空间要内存)
- 怎么挂上:以为文件缓存页为例——
struct file→address_space→ radix tree(基数树) → 叶子节点指向具体struct page;再由 page 反算下标/物理地址 - 💡 内核数据结构可以被同时挂到多种结构上(数组、哈希表、LRU 链表、基数树)——这不冲突,是一种常规做法
struct page 里几个值得注意的字段:
| 字段 | 含义 |
|---|---|
flags 位图 | PG_locked(被锁定,不能被换出)、PG_dirty、PG_writeback、PG_private、是否空闲等 |
_mapcount / _refcount | 引用计数——有多少个页表项指向该页框 |
virtual | 记录该页对应的虚拟地址(因为内核有时需要物理→虚拟反向查询权限) |
💡 引用计数是写时拷贝的判定依据:权限位是 R(只读)、引用计数 > 1、又位于数据区 → 判定为写时拷贝,而不是普通缺页。
六、理性角度②:页表体系
6.1 页表不能是单张
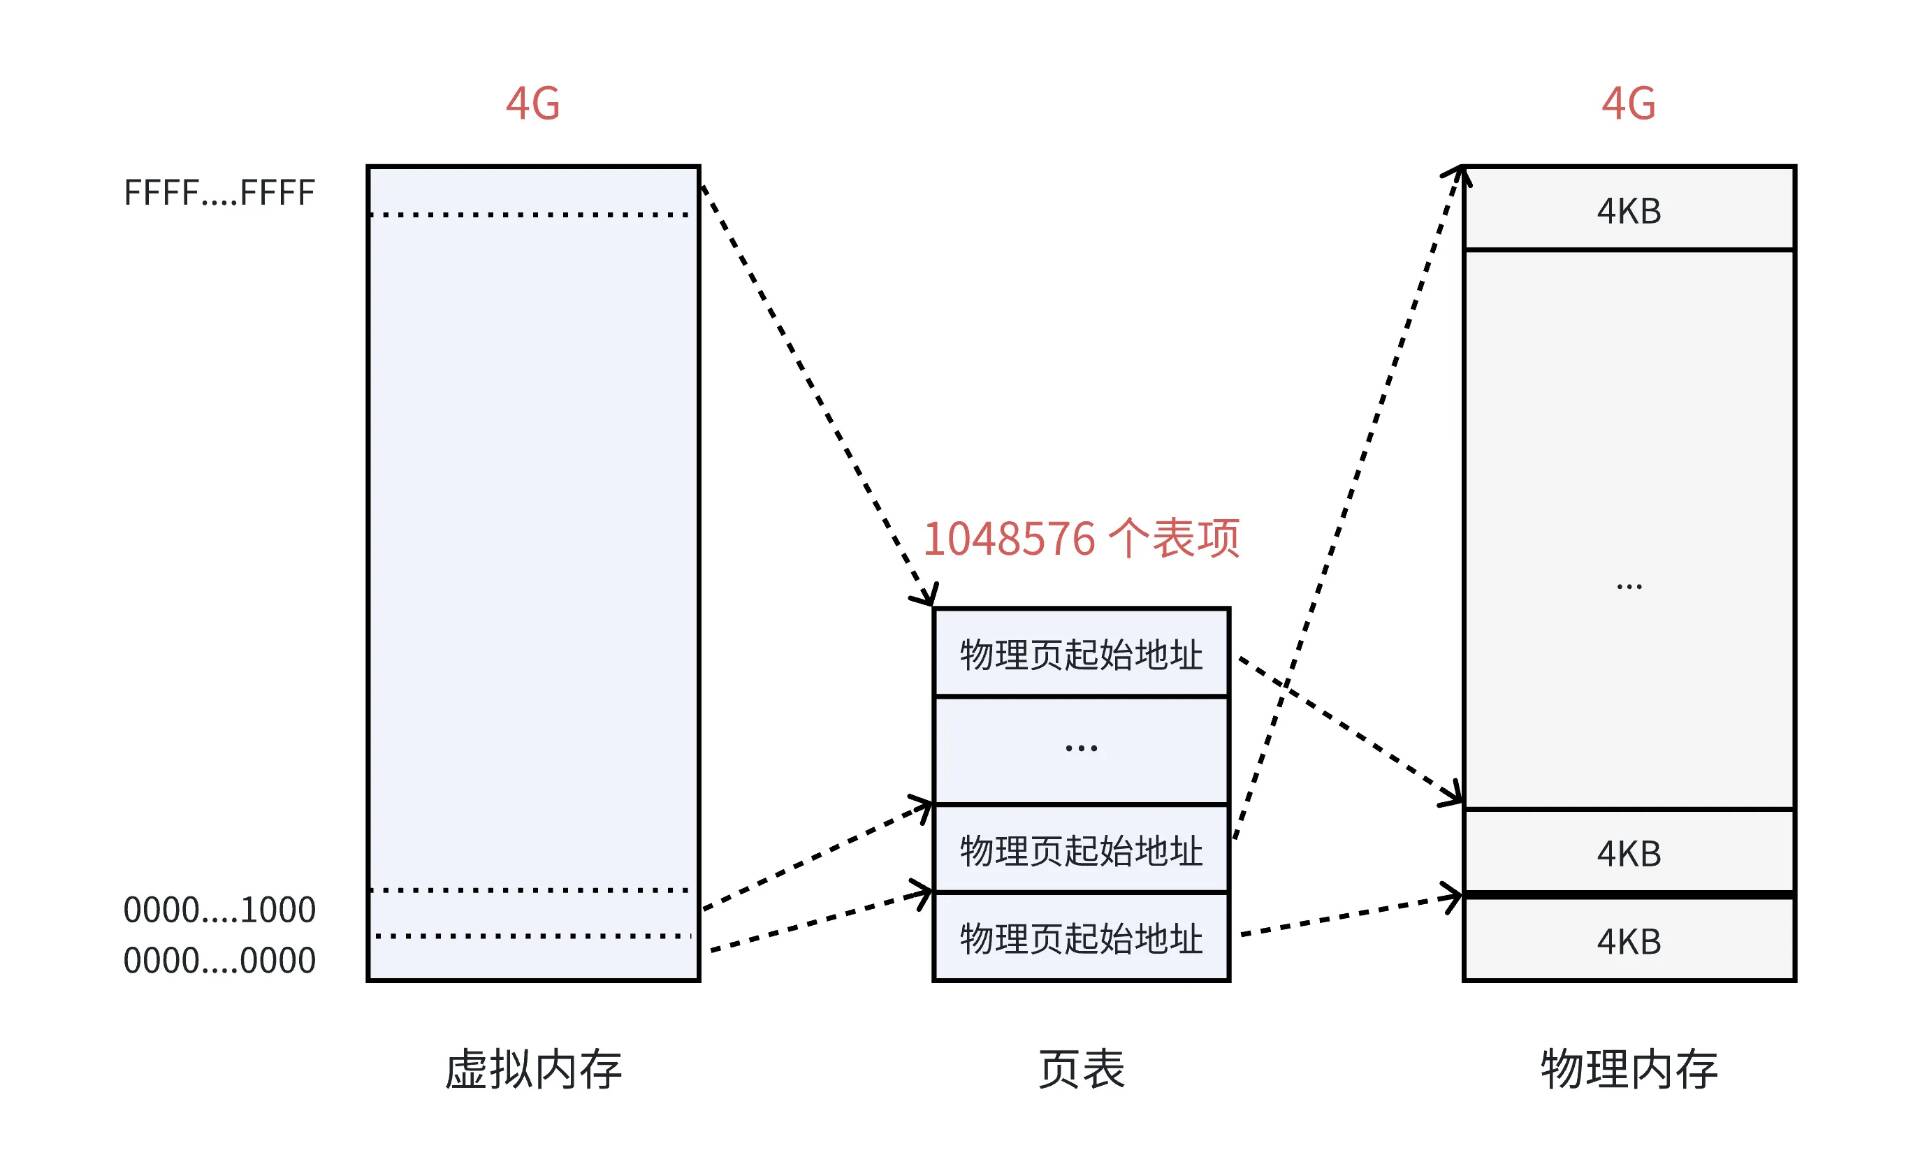
假设一张页表、每条目记录一对虚拟↔物理映射:4GB 空间按字节算就有 4G 条映射,条目按 8 字节算——
✖ 光页表就要 32GB,而整个内存才 4GB。这还没算操作系统自己的代码、中断向量表、各种 PCB/地址空间数据结构。
✔ 所以:页表绝对不能是单张页表。
6.2 二级页表:10 + 10 + 12
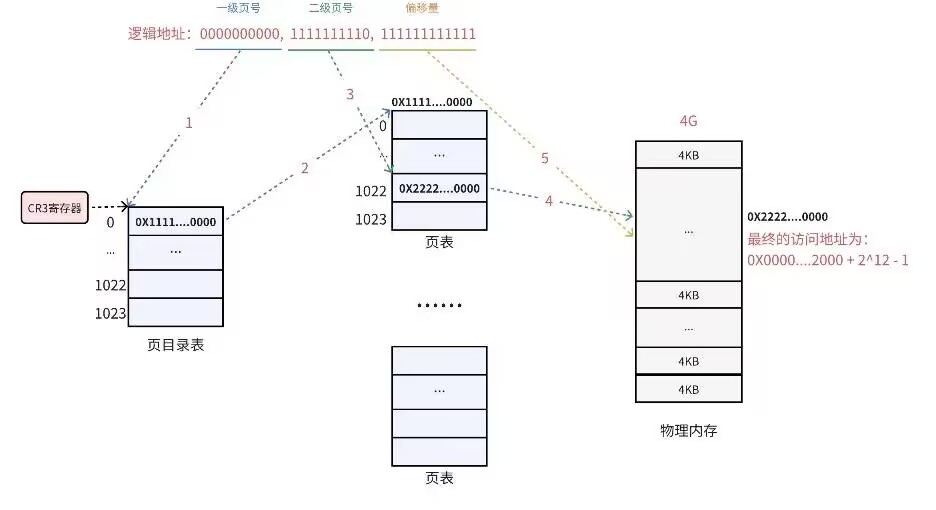
32 位虚拟地址在逻辑上拆成三段:
| 段 | 位数 | 取值范围 | 作用 |
|---|---|---|---|
| 高 10 位 | 10 | 0 ~ 1023 | 查页目录(1024 个页目录项) |
| 中 10 位 | 10 | 0 ~ 1023 | 查页表(1024 个页表项) |
| 低 12 位 | 12 | 0 ~ 4095 | 页内偏移 |
- 页目录:一张,最多 1024 个目录项,每项指向一张页表
- 页表:最多 1024 张,每项记录一个页框(物理)地址(只需要 20 位表示页框,剩下的位做标志)
- 每张页表 = 4 字节 × 1024 = 4KB = 正好一页
- 拉满的情况下:1024 × 4KB + 页目录 4KB ≈ 4MB(而不是 32GB)
- 但一个进程不会用满整个物理内存,所以实际页表只有十几张、二十几张,远远小于 4MB → 方案可行
✔ 严格来说:页表记录的是"虚拟地址 → 页框"的映射(页框级),具体字节由低 12 位偏移定位。
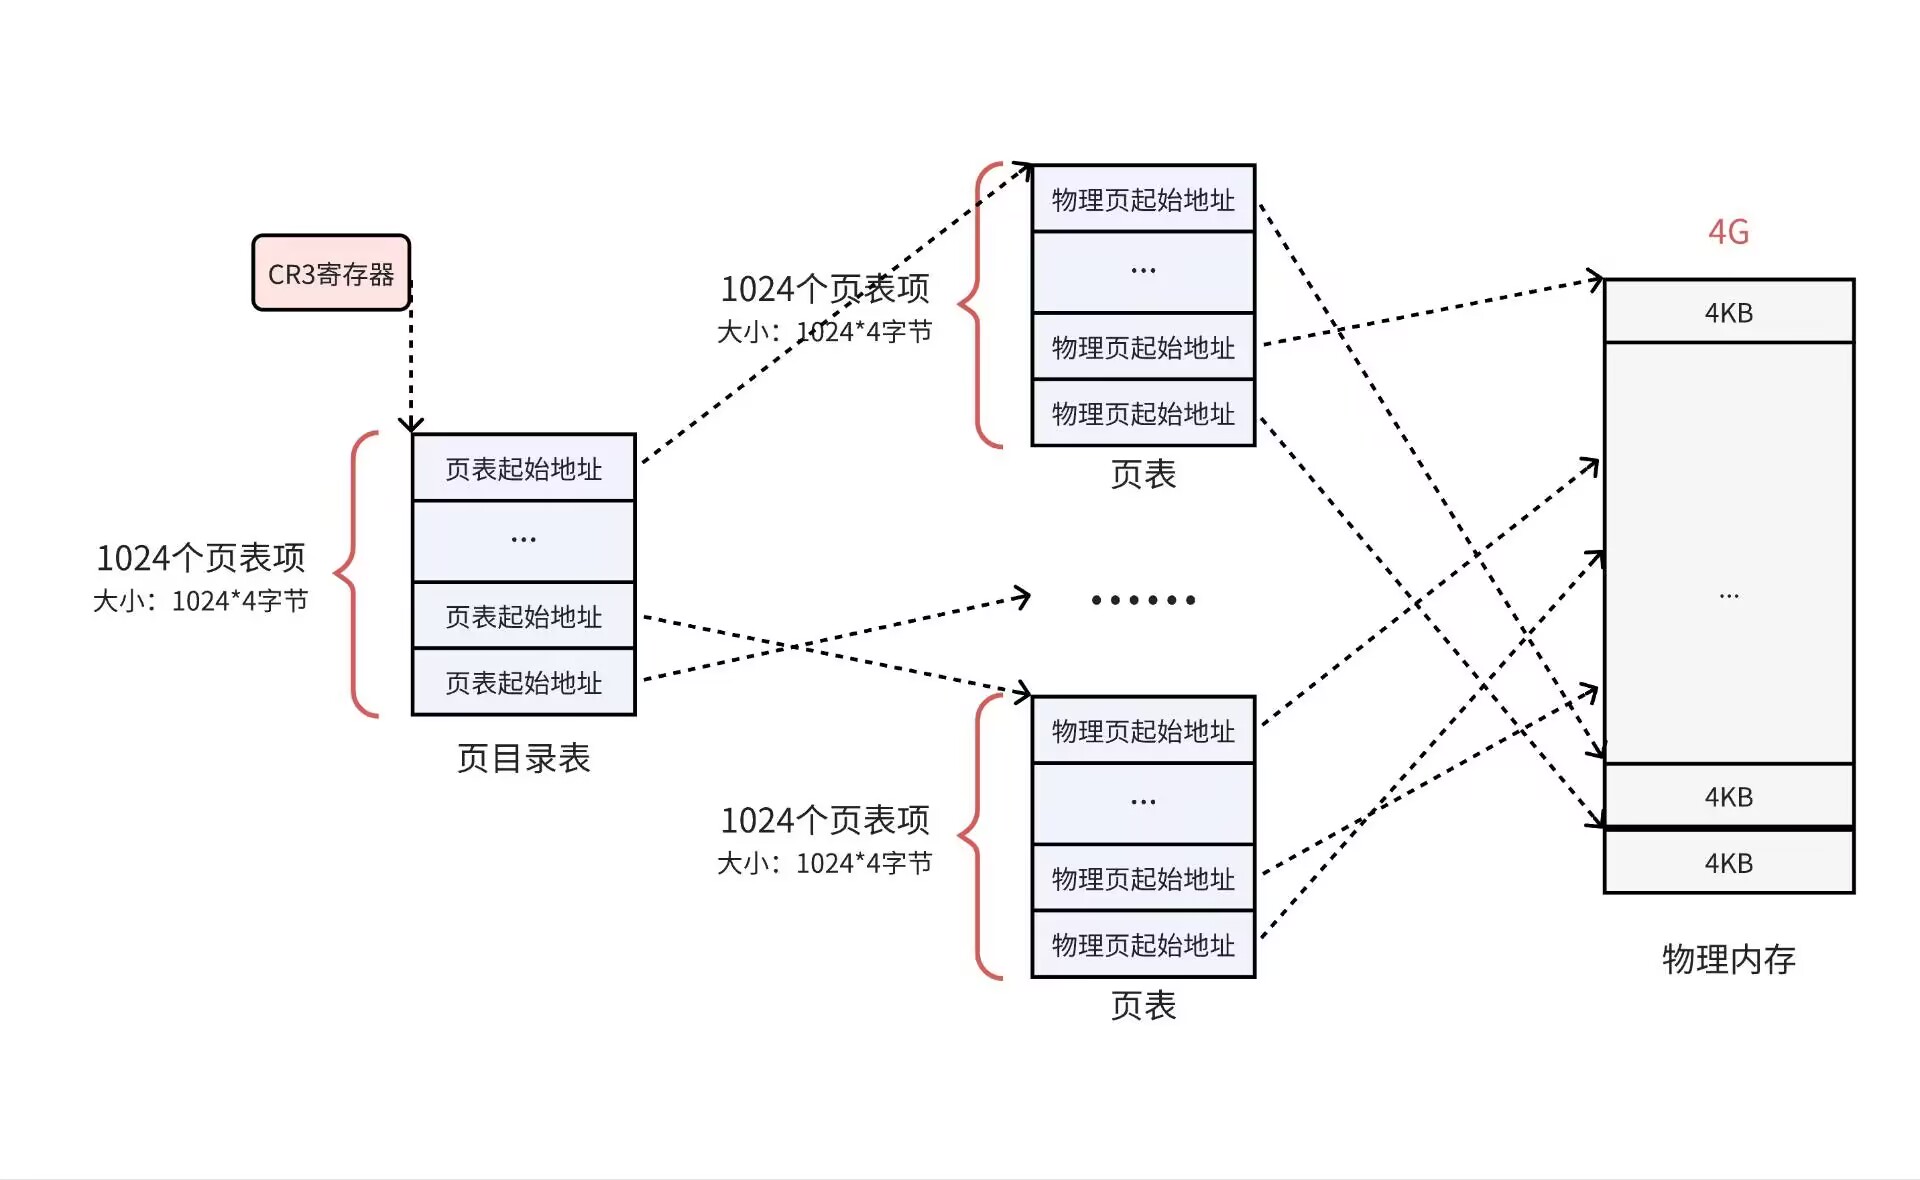
6.3 谁来查页表:CR3 + MMU
- CR3 寄存器:保存当前进程页目录的起始物理地址,属于进程的硬件上下文。进程切换时上下文一换,页表、地址空间全跟着换
- MMU(内存管理单元):CPU 内部集成的硬件组件,虚拟地址 → 物理地址的转换由硬件完成
- 只做"索引 + 加法",硬件实现很简单
- CPU 输入虚拟地址,经过 MMU(结合 CR3 指向的页表)后输出的直接就是物理地址,连到地址总线上
6.4 TLB 快表
多级页表是双刃剑:省了空间,但降低了查询效率——页表本身也在内存里,一次转换要多次访存(而且计算机里所有操作都要经过虚实转换,慢一点就整体都慢)。
于是引入中间层:
- TLB(Translation Lookaside Buffer,快表 / 转译后备缓冲器):CPU 内集成的一段存储空间,与 MMU 直接协同工作
- 流程:CPU 给 MMU 虚拟地址 → MMU 先查 TLB → 命中就直接拿到物理地址送内存;**未命中(TLB Miss)**则走多级页表这个"保底武器",查完顺便把映射关系写进 TLB
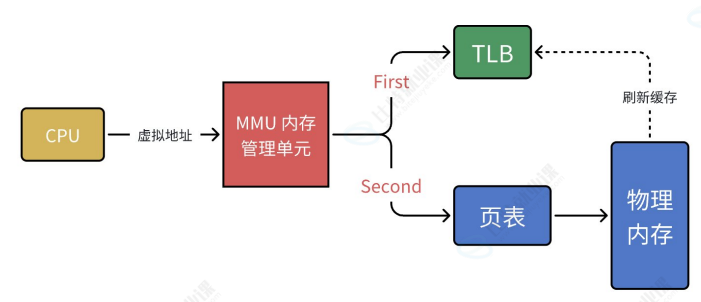
💡 一句话:计算机里所有性能问题都可以"加一个中间层"来解决。
七、为什么页内偏移是低 12 位
两个问题:为什么数字是 12?为什么是低 12 位?
① 为什么是 12:页框大小 4KB,取值范围 0 ~ 4095(共 4096 个字节),而 2¹² = 4096 ——用 12 位刚好完整覆盖一个页框的范围。
② 为什么是低位:编译时 ELF 是从低地址向高地址平坦有序编排的,所以高 20 位相同 → 一定落在同一个 4KB 页框里;用低 12 位做页内偏移,意味着用高 20 位来区分页框。
💡 这样设计的好处:聚集效果 + 局部性原理。程序访问第 10 行代码时,大概率接着访问它周边的代码(那些地址的高 20 位相同,在同一个页框内)——一次页表映射就能覆盖一大片连续访问,这正是预加载/局部性原理的根本。
八、页表标志位决定了内存管理的所有决策
8.1 缺页异常(Page Fault)
当 MMU 在 TLB 和页表中都没找到物理页,但该虚拟地址是合法的(在进程地址空间范围内),CPU 硬件就自动触发缺页异常:
- 用户程序被打断 → CPU 转去执行中断向量表里对应的处理方法(缺页中断处理程序)
- 处理方法会申请物理内存、修改
struct page标志位、把页框号和页表项填充/重建映射关系
缺页异常分两类:
| 类型 | 含义 | 处理 |
|---|---|---|
| Hard / Major Page Fault(硬件缺页 / 主缺页) | 物理内存中确实没有对应物理页 | 打开磁盘设备把数据读入内存,再重建映射 |
| Soft / Minor Page Fault(软件缺页 / 次缺页) | 物理页已经存在,只是当前进程还没建立映射(典型:动态库已被其他进程载入) | 只需在内存中补建映射,不用读数据 |
| Invalid Page Fault | 地址非法(越界、空指针等) | 内核返回 SIGSEGV(段错误),终止进程 |
8.2 越界了不一定会崩溃
经典例子:
int i = 0;
int array[10];
for (i = 0; i <= 10; i++)   // 故意写成 <=
    array[i] = 0;
array[10] 越界访问到了紧挨着的 i(栈上变量),把 i 又改回 0 → 循环变死循环,但进程没崩。
✔ 本质:你的越界操作系统都不知道。指针指向的仍是你的合法地址空间,OS 没有理由拦你。所以:
- 越界问题需要你自己 debug
- 只有当你访问的地址本身非法(不在进程的映射方案内)时,才会被判为越界 → SIGSEGV
8.3 操作系统如何区分"缺页"和"越界"
- 前提:查页表失败(MMU 转不过去),触发异常
- 执行缺页中断处理程序,检查虚拟地址的页号是否合法——依据就是进程自己的地址空间布局(
mm_struct+vm_area_struct描述的各区域范围) - 判定:
- 页号合法、但页不在内存 → 缺页中断(补申请 + 建映射)
- 页号非法 → 越界访问(SIGSEGV 终止)
- 映射已建立但权限不对(比如用户态写只读页、访问内核页)→ 非法访问,同样可判非法
8.4 串起前面学过的两个申请资源的知识点
malloc / new 的本质是"延迟申请":
- 底层是系统调用 brk(改堆区大小,即改 data 段/堆的 start-end)或 mmap(基于文件)
- 它们只改虚拟地址范围,不申请物理内存——因为你申请完不一定马上用
- 真正访问时触发缺页中断,才做物理内存的二次申请
- 好处:你不用的时候,这块物理内存可以给别人用,提高内存利用率
写时拷贝的本质是"以页框为单位":
- fork 之后父子进程指向同一批页框,权限位被置为只读
- 因为页表映射以页框为单位,所以权限管理也只能以页框为单位 → 触发写时拷贝时,拷贝的是整个页框,而不是那一个字节/变量
- 💡 这和 STL 扩容按 1.5/2 倍、共享内存必须是 4KB 整数倍一样,都是在资源浪费与效率之间做平衡

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 3
 0
- 0


 已为社区贡献1条内容

所有评论(0)