关于IO的学习
IO的学习
IO基础
文件基础
1.Linux系统
2.文件类型
文件类型现阶段必须记住两个:
-:普通文件
d:目录文件
3.系统调用
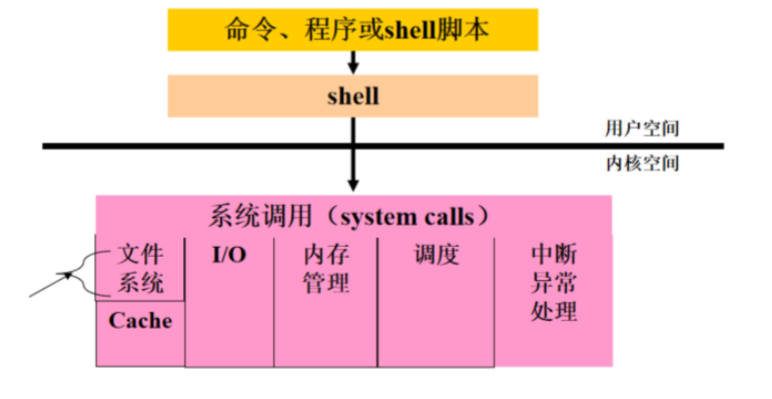
为了保护系统的安全,应用程序没有直接对内核层直接操作的权限,操作系统提供系统调用,供用户态程序请求操作系统服务的一种机。所以,系统调用是操作系统和应用程序的“媒介”。
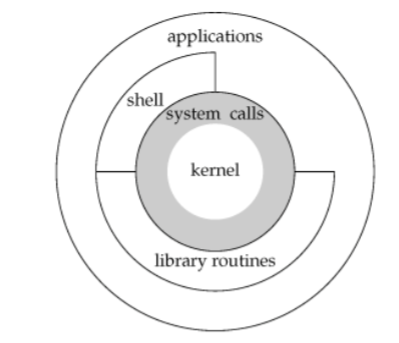
概念:
系统调用先将要执行的系统调用编号、所需的参数,设置到相关寄存器里,最后再使用syscall汇编指令告诉cpu进入到内核态,开始执行请求的服务
在各种的编程语言中,我们并不需要使用汇编方式来执行请求的服务,编程语言为我们已经封装成对应的系统调用函数接口(方法),简称API。简单来说,我们之前使用的像printf这种函数就是API
系统调用具体内容
4.IO接口是什么
IO接口是设备与系统之间的桥梁
5.库函数
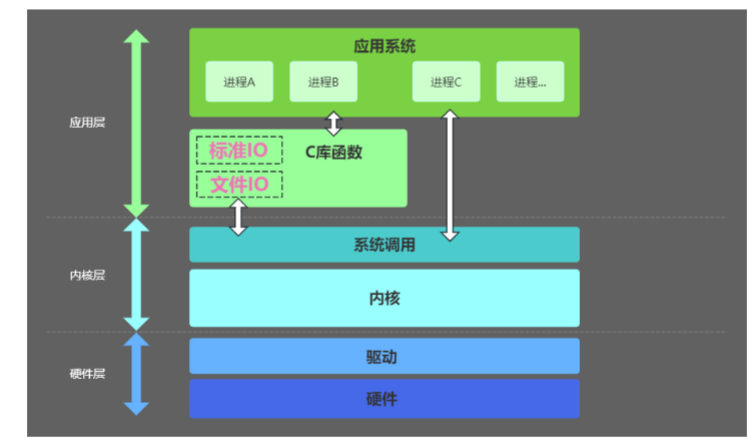
一些库函数的实现,直接与硬件设备、系统内核密切相关,例如系统调用函数
一些库函数的实现侧重屏蔽底层差异,提供兼容性更广的应用编程的数据交换方法,例如库函数
总结:
系统调用:普通的应用程序在用户空间运行,总是需要可以和内核空间之间交换数据。一些IO指令都被限制在只有内核模式可以执行,为了操作系统的安全,操作系统有必要提供封装了系统调用的接口函数来尾应用层提供诸如读取磁盘某位置的数据的功能,这些接口被称为系统调用函数,简称系统调用
库函数:如果我们把系统调用封装成抽象的功能函数,就可以起到隔离保护的作用。库函数是在函数内部调用该系统的系统调用接口,并封装入库供用户使用的应用编程接口函数
应用编程接口函数:简称API,封装一些常见的编程操作、系统调用的应用层函数
个人理解:应用层程序运行在用户态,不能直接访问硬件,想要让内核去操控硬件,必须走内核开放的唯一合法通道:系统调用。 系统调用是内核提供的底层接口,功能非常原始、基础,参数繁琐,不好直接用。 于是人们写了库函数(比如 libc),跑在用户态,封装系统调用,增加缓存、校验、辅助逻辑,包装成更好用、功能更完整的现成函数,给程序员直接调用。而API是一个统称:只要一段代码对外暴露、可供别人调用的函数/接口,都叫API
文件IO
文件IO指封装了系统调用实现的应用编程接口函数,与硬件有强耦合关系(每次调用必定会引起系统调用)。和标准IO相比最大的区别就是文件IO每次操作都要引起系统调用,而标准IO是一段数据才引起系统调用,就是说文件IO没有缓冲机制
文件描述符
英文缩写:fd(file descriptor)
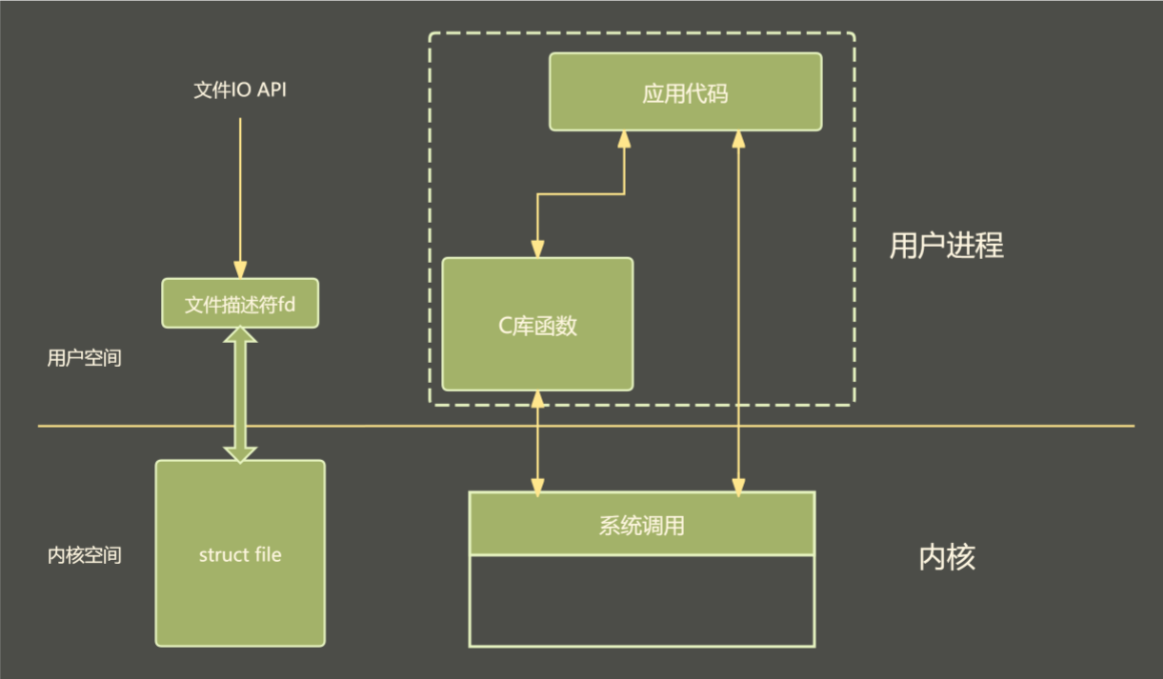
Linux为程序中每个打开的文件,分配、对应一个文件描述符
文件描述符是一个非负整数,从0开始分配,依次递增(Linux操作系统中默认一个进程可以打开的数量是1024(0,1023的数字,可以修改扩增)
文件IO操作是通过文件描述符来完成的
规定:0为标准输入,1为标准输出,2为标准出错
补充:
stdin(fd = 0) 标准输入
stdout(fd = 1) 标准输出
stderr(fd = 2) 标准错误
我们每个文件在内核中都会有一个struct file结构体来存储文件相关信息,而文件描述符就是返回的可以让用户查看该文件的相关信息的符号
man手册是使用
系统调用函数是:
man 2 要查找的函数名
库函数是:
man 3 要查找的函数名
其它的需要用时自己去了解,上述是目前学习要会的
文件的打开与关闭
open函数
用来创建和打开一个文件
头文件
#include <sys/types.h>
#include <sys/stat.h>
#include <fcntl.h>
有两种用法:
1.打开文件,文件不存在时不能创建新文件
int open(const char *pathname, int flags);
2.打开文件,当文件不存在时创建新文件,当文件存在时会覆盖原文件生成新的文件。但是可以通过O_EXCL这个来限制它检测文件是否存在,文件存在时不覆盖生成。第三个参数是用来指定新文件的存取权限,真正建立文件时的存取权限会受到umask值影响->mode-umask
int open(const char *pathnane, int flags, mode_t mode);
返回值:成功时返回文件描述符,出错返回EOF(-1)
参数:
pathname:文件名
flag:打开文件的读写方式
mode:打开文件时不存在,创建新文件时指定该文件的存储权限
常用的flags:
O_RDONLY:只读方式打开文件
O_WRONLY:可写方式打开文件
O_RDWR:读写方式打开文件
O_CREAT:如果文件不存在,就创建一个新文件,并用第三的参数为其设置权限
O_EXCL:如果使用O_CREAT时文件存在,则可返回错误消息。这样参数可测试文件是否存在
O_NOCTTY:使用本参数时,如果文件为终端,那么终端不可以作为调用open()系统调用的那个进程的控制终端
O_TRUNC:如文件已经存在,那么打开文件时先删除文件中的原有数据
O_APPEND:以添加方式打开文件,所以对文件的写操作都在文件的末尾进行
注意:
1.当多个flags要同时写入时,用“|”将它们连接。
2.当用户对文件的权限不够时,我们再想以没有的权限打开文件,那就将报错,所以使用前要重点关注文件的权限
代码使用:
#include <sys/types.h>
#include <sys/stat.h>
#include <fcntl.h>
#include <stdio.h>
#include <unistd.h>

int main(int argc, const char *argv[])
{
	int fd = -1;
#if 0
	if ((fd = open("3.txt", O_RDONLY)) < 0) {
		printf("open error!\n");
		return -1;
	}
	printf("open successfully!\n");
#else
	if ((fd = open("3.txt", O_CREAT|O_RDONLY|O_EXCL, 0664)) < 0) {
		printf("open error\n");
		return -1;
	}
	printf("open successful\n");
#endif
	if (!close(fd))
	{
		printf("close erroe\n");
	}
	return 0;
}
补充知识点:
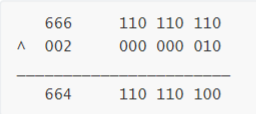
umake:
用来设置作为默认文件或目录的初始权限的掩码
例如,umask 002,假设新创建的文件是664权限
异或运算:
ulimit:
文件可以打开的最大数量情况:ulimit -n
当前系统可以操作的资源限制值情况:ulimit -a
close函数
用来关闭文件,也就是回收文件描述符
close(文件描述符);
文件的读取
read函数
头文件:
#include <unistd.h>
函数原型:
ssize_t read(int fd, void *buf, size_t count);
返回值:成功时返回实际读取的数字,出错时返回EOF,读到文件末尾时返回0
参数:
buf:接收数据的缓冲区
count:一次性读入的大小(不应超过缓冲区buf的大小)
代码使用:
#include <sys/types.h>
#include <sys/stat.h>
#include <fcntl.h>
#include <unistd.h>
#include <stdio.h>
#define N 15

int main(int argc, const char *argv[])
{
	int fd;
	int n;
	char buf[N];
	int total = 0;

	if (argc < 2)
		return -1;

	if ((fd = open(argv[1], O_RDWR)) < EOF) {
		printf("open error!\n");
		return -1;
	}

	while((n = read(fd, buf, N)) > 0) {
		printf("%s", buf);
		total += n;
	}

	printf("Read characters: %d\n", total);
	printf("Finished reading\n");
	close(fd);

	return 0;
}
文件的写入
write函数
头文件:
#include <unistd.h>
函数原型:
ssize_t write(int fd, void *buf, size_t count);
返回值:成功时返回实际写入的字节数,出错时返回EOF
参数:
buf:发送数据的缓存区
count:一次读入的字节大小(不应超过缓冲区buf的大小)
代码的使用:
#include <sys/types.h>
#include <sys/stat.h>
#include <fcntl.h>
#include <stdio.h>
#include <unistd.h>
#define N 20

int main(int argc, const char *argv[])
{
	int fd;
	char buf[N] = "hello world";
	int n, total = 0;

	if ((fd = open(argv[1], O_RDWR)) < 0) {
		printf("open error!\n");
		return -1;
	}

	do {
		n = write(fd, buf, N);
		total += n;
	} while(n < 0);

	printf("write characters:%d\n", total);
	printf("Finished writing\n");
	close(fd);
	return 0;
}
总结:
我们先open打开文件得到文件描述符(fd),然后通过fd才可以操作文件,对文件进行读取和写入,对文件操作完后要关闭文件,这就是总体的流程
,其中文件描述符的获取是重中之重,没有它一切都开展不了
文件的光标位置的定位
当对文件进行操作时我们离不开对光标位置的操控进行读取和写入,
现在我们学习对光标位置的定位
lseek函数
头文件:
#include <sys/types.h>
#include <unistd.h>
函数原型:
off_t lseek(int fd, off_t offste, int whence);
返回值:成功时返回当前文件的读写位置,出错时返回EOF
参数:
offste:表示相对whence的偏移量字节数值
whence是选项:
1.SEEK_SET:定位到文件开头
2.SEEK_CUR:定位到当前的读写指针处
3.SEEK_END:定位到末尾处
注意:当使用这个函数之后,光标就会定位到对应的位置,值得注意的是,如果光标后面还有内容,此时进行写操作的话会覆盖后边等字节长度的内容
代码使用:
#include <sys/types.h>
#include <sys/stat.h>
#include <fcntl.h>
#include <stdio.h>
#include <unistd.h>
#include <string.h>
#define N 20

int main(int argc, const char *argv[])
{
	int fd;
	char buf[N] = {'0'};
	int n, total = 0;
	int ret;

	if (argc < 2) {
		printf("argc < 2\n");
		return -1;
	}

	if (chmod(argv[1], 0000)) {
		printf("chmod error!\n");
	}

	if ((fd = open(argv[1], O_RDWR)) < 0) {
		printf("open error!\n");
		return -1;
	}

	ret = lseek(fd, 0, SEEK_CUR);
	printf("%u\n", ret);
	while ((n = read(fd, buf, strlen(buf))) > 0) {
		printf("%s", buf);
		total += n;
	}
	printf("Read character:%d\n", total);
	printf("Finished reading\n");

	ret = lseek(fd, 0, SEEK_CUR);
	printf("%u\n", ret);
	ret = lseek(fd, 0, SEEK_SET);
	printf("%u\n", ret);
	ret = lseek(fd, 0, SEEK_END);
	printf("%u\n", ret);
	write(fd, "aaa", strlen("aaa"));
	ret = lseek(fd, 0, SEEK_END);
	printf("%u\n", ret);


	close(fd);
	return 0;
}
文件权限的修改
前面提到过文件的权限没有和我们想要的权限进行打开时,还有我们想让文件的权限变小时,我们要怎么做?
chmod函数
头文件
#include <sys/stat.h>
函数原型:
int chmod(const char *path, mode_t mode);
返回值:成功时返回0,出错时返回EOF
注意:只有root和文件所有者能修修改文件的访问权限
参数:
path:文件名
mode:要修改成的文件权限
使用:
if (chmod(argv[1], 0000)) {
		printf("chmod error!\n");
	}

	if ((fd = open(argv[1], O_RDWR)) < 0) {
		printf("open error!\n");
		return -1;
	}
标准IO
标准IO是C函数库的常见IO操作接口,提供了缓存机制,减少触发系统调用次数,实现了更高的效率。
文件IO和标准IO的对比
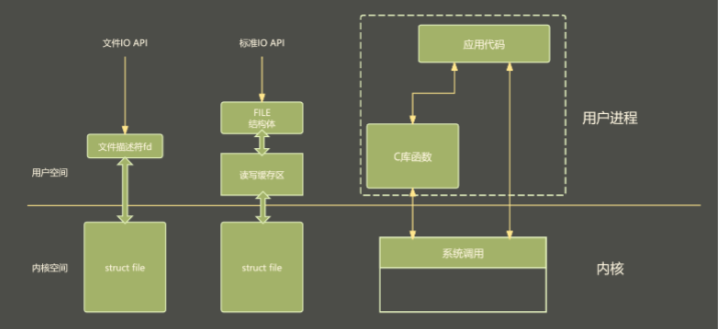
实际上是对系统提供的系统调用(文件IO)进行了封装,进一步降低与硬件的耦合,例如:
fopen函数是由封装open函数实现的
fclose函数是由封装close函数实现的
读函数是由封装read函数实现的
写函数是由封装write函数实现的
文件定位是由封装lseek函数实现的
流(FILE)
FILE是一个结构体,是标准IO用来存放打开的文件的相关信息的一个结构体
FILE结构体里存的东西:(简化版,内容很多,只了解重点)
struct _IO_FILE {
    int _fileno;         // 底层对应的文件描述符 fd(重点!)
    char *_IO_buf_base;  // 用户缓冲区起始地址
    char *_IO_buf_end;   // 用户缓冲区结束地址
    char *_IO_ptr;       // 当前读写位置指针
    // 还有标记:读写模式、缓冲类型(_IOFBF/_IOLBF/_IONBF)、错误标志、EOF标志等
};
标准IO的所有操作都是围绕FILE来进行的
流又分为文本流和二进制流
文本流和二进制流
文本流:数值以字符形式,每一个字符都是一个字节,对应ASCII码值。文本流中的数据可以直接显示和打印出来,都是用户可以读懂的信息
二进制流:流中的数据是按照二进制编码的方式来存放文件。二进制数据也可以在屏幕上显示,但是用户无法读懂其内容
二进制流比文本流更节省空间,且不用对换行符进行转换,这样可以大大加快流的速度,提高效率,二进制没有行长度限制,也可以包含空字符,因此,
对于含有大量数据信息的数据流,可以常采用二进制流的方式
对于含有大量字符信息的流,则采用文本流的方式
流的缓冲类型
全缓冲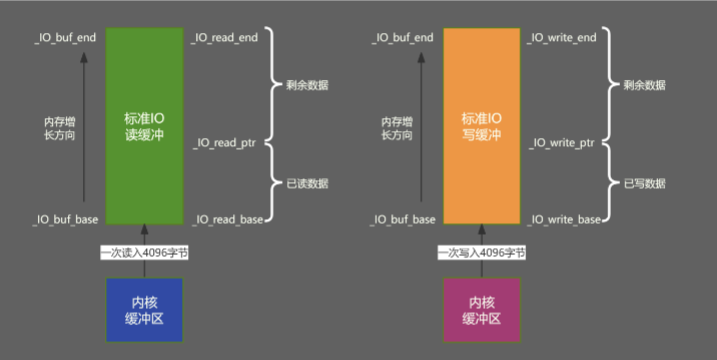
全缓冲只有当缓冲区满时才会刷新缓冲区(也就是进行IO操作),当对文件数据这种大型的文件进行IO操作时为了提高效率才使用全缓冲
行缓冲
行缓冲在当缓冲区满时或者遇到换行符时才会刷新缓冲区(也就是继续IO操作),正常的输入输出操作是行缓冲
当流和一个终端关联时,典型的行缓冲
无缓冲
无缓冲没有缓冲区,直接进行IO操作,数据直接写入文件,流不进行缓冲,标准错误的输出就是无缓冲,当错误一发生的时候就可以直接弹出报错
注意:当打开文件的时候,如果系统检测到非必要开缓冲的时候是没有缓冲区的,只有当你开始使用的时候才会有
且缓冲区的大小是根据系统来决定的,不同的系统的缓冲区不同,要学会自己检测
检测行缓冲:
#include <stdio.h>
#include <unistd.h>

int main(int argc, const char *argv[])
{
	int i = 0;
#if 0
	do {
	printf("a");
	i++;
	} while(i < 100);
#else

	do {
	printf("a");
	i++;
	} while(i < 1025);
#endif
	sleep(10);
	return 0;
}
检测全缓冲:
#include <stdio.h>
#include <unistd.h>

int main(int argc, const char *argv[])
{
	printf("a");
	sleep(5);


	return 0;
}
linux@linux-vir--mac:~/iocode$ cat BufferAll.c
#include <stdio.h>
#include <unistd.h>

int main(int argc, const char *argv[])
{
	FILE* fp = fopen("a.txt", "a+");

	//fprintf(fp, "a");
    //根据上面那个缓冲区的图,可以利用指针计算
	printf("%lu ", (fp->_IO_buf_end - fp->_IO_buf_base));
	int i = 0;
	do {
		fprintf(fp, "a");
		i++;
	} while(i<4098);
	printf("%lu ", fp->_IO_write_ptr - fp->_IO_write_base);

	sleep(5);
	return 0;
}
修改缓冲的类型
setvbuf函数
头文件
#include <stdio.h>
函数原型
int setvbuf(FILE *stream, char *buf, int mode, size_t size);

//有个简化版本
void setbuf(FILE *stream, char *buf);
参数:
stream:要修改缓冲的文件的流(stdin\stdout/stdrr或者fopen返回的FILE*)
buf:自定义缓冲区地址
NULL:让stdio库自动malloc一块缓冲区
传自己定义的数组:使用你这块内存当缓冲区
mode:缓冲模式
1._IOFBF:全缓冲
2._IOLBF:行缓冲
3._IONBF:无缓冲
size:缓冲区的大小(buf不为NULL时,就是填你数组的长度)
返回值:成功返回0,失败返回非0
setbuf
setbuf(fp, buf);
当buf != NULL时,等价于 setvbuf(fp, buf, _IOFBF, sizeof(buf));
当buf == NULL时,等价于 setvbuf(fp, NULL, _IONBF, 0);
代码使用
#include <stdio.h>
#include <unistd.h>

int main(int argc, const char *argv[])
{
	printf("a");
	sleep(5);

	setbuf(stdout, NULL);//将stdout的缓冲类型改为无缓冲

	printf("b");
	sleep(5);


	return 0;
}
文件的打开与关闭
打开就是占用资源
关闭就是释放资源
fopen函数
头文件
#include <stdio.h>
函数原型
FILE *fopen(const char *path, const char *mode);
返回值:成功时返回有关文件的FILE指针,出错返回NULL
参数:
path:普通文件当前路径不需要加目录,不在当前目录要使用完整的路径
mode:文件打开的模式
”r" 或 “rb":以只读方式打开文件,文件必须存在
"r+“或"r+b”:以只读的方式打开文件,文件必须存在
“w"或”wb”:以只写方式打开文件,若文件存在则文件长度清为0。若文件不存在则创建
“w+“或’'w+b”:以读写方式打开文件,其它同"w”
"a"或“ab”:以只写方式打开文件,若文件不存在则创建;向文件写入的数据被追加到文件末尾
“a+”或“a+b":以读写方式打开文件,其它同"a"
这里体现了标准IO和文件IO的联系
标准IO			文件IO
 "r"			  O_RDONLY
 "r+"			  O_RDWR
 "w"			  O_WRONLY | O_CREAT | O_TRUNC, 0664
 "w+"			  O_RDWR | O_CREAT | O_TRUNC, 0664
 "a"			  O_WRONLY | O_CREAT | O_APPEND, 0664
 "a+"			  O_RDWR | O_CREAT | O_APPEND, 0664
fclose函数
关闭流,且自动刷新缓冲区中的数据并释放缓冲区
头文件
#include <stdio.h>
函数原型
int fclose(FILE *stream)
返回值:调用成功返回0,失败返回EOF并设置error
注意:函数的参数是流,且要保证为非空,否则出现错误
代码演示
#include <stdio.h>

int main(int argc, const char *argv[])
{
	FILE *fp = NULL;
	if ((fp = fopen("test.txt", "a")) == NULL) {
		printf("fopen error\n");
		return -1;
	}
	printf("fopen success\n");

	fclose(fp);

	return 0;
}
处理错误信息
errno
存放错误号,标准库中有个专门存放错误号的文件
错误号对应着不同的错误消息
每个API被调用时都会生成一个对应的errno
要使用errno,要
头文件
#include <error.h>
函数原型
extern int errno;
perror函数
可以自动获取错误号,无需人工写入,并将其翻译成对应的错误信息
头文件
#include <stdio.h>
函数原型
void perror(const char *s);
参数:
s可以是我们输入的提示信息,它会先输出字符串s,再输出错误号对应的错误信息
strerror
根据错误号返回对应的错误信息
头文件
#include <string.h>
函数原型
char* strerror(int errno);
参数是对应的错误号
代码演示
#include <stdio.h>
#include <unistd.h>
#include <errno.h>
#include <string.h>

extern int errno;

int main(int argc, const char *argv[])
{
	FILE * fp = NULL;
#if 0
	if ((fp = fopen("test.txt", "r")) == NULL){
	printf("error:%d\n", errno);
	perror("fopoen:");
	return -1;
	}
#else
	if ((fp = fopen("test.txt", "r")) == NULL){
	printf("error:%d\n", errno);
	printf("open:%s\n", strerror(errno));
	return -1;
	}
#endif
	printf("errno:%d\n", errno);
	perror("perror:");
	sleep(3);

	fclose(fp);
	return 0;
}
文件的读写
fgetc函数
用来输入一个字符
头文件:
#include <stdio.h>
函数原型
int fgetc(FILE *stream);//从流中读取下一个字符,并将其作为Unsigned char强制转化为int类型返回,若到文件末尾或出错时返回EOF
函数宏
int getc(FILE *stream);//等价于fgetc(),不同之处是它可以作为一个宏来实现,对stream进行多次求值,getc和fgetc的区别的一个是宏一个是函数
标准输入
int getchar(void);
//成功时返回读取的字符;若到文件末尾或出错时返回EOF,getchar()等同于fgetc(stdin);
注意事项:
1.函数返回值是int类型不是char类型,主要是为了拓展返回值的范围
2.stdin也是FILE * 的指针,是系统定义好的,指向的是标准输入
3.打开文件后读取,从文件开头开始读,读完一个后读写指针会后移,读取注意文件位置
4.调用getchar()会阻塞,等待你的键盘输入
代码演示:
#include <stdio.h>

int main(int argc, const char *argv[])
{
	FILE *fp = NULL;
	int c;
	if ((fp = fopen("test.txt", "r+")) == NULL) {
		perror("fopen");
		return -1;
	}

	printf("fopen success\n");

	while(1) {
#if 0
	if ((c = fgetc(fp)) == EOF) {
		perror("fgetc");
		break;
	}
#else
	if ((c = getc(fp)) == EOF) {
		perror("getc");
		break;
	}
#endif
		printf("%c", (char)c);
	}

	fclose(fp);

	return 0;
}
fputc函数
用来输出一个字符
头文件
#include <stdio.h>
函数原型
int fputc(int c, FILE *stream);//将字符c(强制转换为无符号字符)写入流
宏函数
int putc(int c, FILE *stream);//不同之处是可以作为宏来实现,对stream进行多次求值
标准输出
int putchar(int c);//成功返回写入的字符,出错时返回EOF,putchar(c)等于于fputc(c, stdout)
返回值:返回写入的字符,错误时返回EOF
注意:
1.返回和输入的参数都是int类型
2.遇到错误:Bad file descriptor,很有可能是文件打开的模式错误
代码演示
#include <stdio.h>

int main(int argc, const char *argv[])
{
	FILE *fp = NULL;
	int c;
	if ((fp = fopen("test.txt", "w")) == NULL) {
		perror("fopen");
		return -1;
	}

	printf("fopen success\n");

#if 0
	if ((c = fputc('a', fp)) == EOF) {
		perror("fputc");
		return -1;
	}

#elif 0
	if ((c = putc('a', fp)) == EOF) {
		perror("putc");
		return -1;
	}

#else
	putchar('a');
#endif
	printf("c = %c\n", c);
	fclose(fp);

	return 0;
}
实践案例——字符读写拷贝复制函数
#include <stdio.h>

int main(int argc, const char *argv[])
{
	FILE *fp_a = NULL, *fp_b = NULL;
	int c;

	if (argc < 3) {
		printf("Usage: %s <File_beCopied> <File_Copied>\n", argv[0]);
		return -1;
	}

	if ((fp_a = fopen(argv[1], "r+")) == NULL) {
		perror("fgetc");
		return -1;
	}

	if ((fp_b = fopen(argv[2], "w+")) == NULL) {
		perror("fputc");
		fclose(fp_a);
		return -1;
	}

	printf("fopen is ok\n");

	do {
		if ((c = fgetc(fp_a)) == EOF) {
			perror("fgetc");
			break;
		}

		if ((c = fputc(c, fp_b)) == EOF) {
			perror("fputc");
			break;
		}
	} while(1);

	printf("Finished copy\n");
	fclose(fp_a);
	fclose(fp_b);
	return 0;
}
fgets函数
用来输入一行
头文件
#include <stdio.h>
函数原型
char* gets(char *s);//读取标准输入到缓冲区
//这个函数是危险的,它不检查缓冲区s溢出,尽量不要使用。因为事先不知道数据的大小情况,它如果数据大于缓冲区也将继续存储

//下面这个函数将解决这个问题
char *fgets(char *s, int size, FILE *stream);
参数:
s:缓冲区
size:缓冲区的大小
stream:要读取的文件的流
返回值:成功是返回s,到文件末尾或出错时返回NULL
注意:
fget函数的第二个参数,输入的数据超出size, size-1个字符会保存到缓冲区,最后添加‘\0’,如果输入数据少于size - 1,后面会添加’\n’和’\0’。当读取到’\n’时会停止这一轮的读取,并在缓冲区后面添加’\0’,所以’\n’后面是剩余字符,只能在下一轮进入缓冲区
代码演示
#include <stdio.h>
#define N 6

int main(int argc, const char *argv[])
{
	FILE *fp;
	char buf[N];
	if ((fp = fopen("test.txt", "r+")) == NULL) {
		perror("fopen");
		return -1;
	}
	printf("fopen success\n");

	while(1) {
		if (fgets(buf, N, fp) == NULL) {
			perror("fgets");
			break;
		}
		printf("test show:%s\n", buf);
	}
	printf("Finished show\n");
	return 0;
}
fputs函数
输出字符串
头文件
#include <stdio.h>
函数原型
int puts(const char *s);//输出到stdout
int fputs(const char *s, FILE *stream);
返回值:成功时返回非负整数(输出字符的个数),出错时返回EOF(-1)
参数;
puts将缓冲区s中的字符串输出到stdout,并追加‘\n’
fputs将缓冲区s中的字符串输出到stream,不追加’\n’
代码演示
#include <stdio.h>
#define N 15

int main(int argc, const char *argv[])
{
	FILE *fp;
	char buf[N];
	if ((fp = fopen("test.txt", "a+")) == NULL) {
		perror("fopen");
		return -1;
	}
	printf("fopen success\n");

		if (fgets(buf, N, stdin) == NULL) {
			perror("fgets");
			fclose(fp);
			return -1;
		}

		if (fputs(buf, fp) == EOF) {
			perror("fputs");
			fclose(fp);
			return -1;
		}

	printf("fputs success\n");
	fclose(fp);

	return 0;
}
实践案例——统计文件行数
#include <stdio.h>
#include <string.h>
#define N 15

int main(int argc, const char *argv[])
{
	FILE *fp;
	int count = 0;
	char buf[N] = {0};
	if ((fp = fopen("test.txt", "a+")) == NULL) {
		perror("fopen");
		return -1;
	}
	printf("fopen success\n");

	while(1) {
		if (fgets(buf, N, fp) == NULL) {
			perror("fgets");
				break;
		}

		if (buf[strlen(buf) - 1] == '\n') {
			count++;
		}

	}
	printf("count:%d\n", count);

	fclose(fp);

	return 0;
}
二进制的读写、对象读写
文本文件:每一个字符都是一个字节,外存存储对应ASCII码值。对于数值,以字符形式在外存上存储对应的ASCII码值。文本流中的数据可以显示和打印出来,都是用户可以读懂的信息
二进制文件:流中的数据是按照二进制编码的方式来存放数据。二进制也可以显示在屏幕上,但是用户读不懂
fread函数
头文件:
#include <stdio.h>
函数原型
size_t fread(void *ptr, size_t size, size_t n, FILE *fp);
参数:
ptr:要读入的内容的位置指针
size:读一个块的大小
n:每次读入块的个数
fp:要读入文件的流
fwrite函数
和fread是一对
头文件
#include <stdio.h>
函数原型
size_t fwrite(const void *ptr, size_t size, size_t n, File *fp);
ptr:要写入的内容的位置指针
size:写一个块的大小
n:每次写入块的个数
fp:要写入文件的流
返回值:
成功返回读写的对象个数;出错返回EOF
这两个函数既可以读写文本文件,也可以读写二进制文件
代码演示:
#include <stdio.h>

#define N 10
int main(int argc, const char *argv[])
{
	FILE *fp;
	char buf[N];

	if (argc < 2) {
		printf("Usage:%s <BeReadfile>\n", argv[0]);
		return -1;
	}
	if((fp = fopen(argv[1], "r+")) == NULL) {
		perror("fopen");
		return -1;
	}

	size_t ret = -1;
	if ((ret = fread(buf, sizeof(buf), 1, fp)) < 0) {
		perror("fread");
		fclose(fp);
		return -1;
	}
	printf("test buf=%s", buf);

	fclose(fp);


	return 0;
}
#include <stdio.h>
#include <unistd.h>
typedef struct node{
	int id;
	char name[10];
	float score;
}STU;

int main(int argc, const char *argv[])
{
	FILE *fp = NULL;
	STU s[] = {{1, "su", 100}, {2, "pan", 99}};

	if ((fp = fopen("test.txt", "w+")) < 0) {
		perror("fopen");
		return -1;
	}

		if (fwrite(&s[0], sizeof(STU), 1, fp) < 0) {
			perror("fwrite");
			fclose(fp);
			return -1;
		}

	sleep(5);
	//重新打开文件进行文件位置的重新定位
	fclose(fp);
	if ((fp = fopen("test.txt", "r+")) < 0) {
		perror("fopen");
		return -1;
	}


	STU ret;
	fread(&ret, sizeof(ret), 1, fp);
	printf("%d, %s, %f\n", ret.id, ret.name, ret.score);
	fclose(fp);

	return 0;
}
实践案例——二进制读写复制文件
#include <stdio.h>
#include <string.h>
#define N 512

int main(int argc, const char *argv[])
{
	FILE *fp_r = NULL, *fp_w = NULL;
	char buf[N] = {0};
	size_t bytes_fread;
	size_t bytes_fwrite;

	if (argc < 3) {
		printf("Usage:%s <Read File> <Write File>\n", argv[0]);
		return -1;
	}

	if ((fp_r = fopen(argv[1], "r")) == NULL) {
		perror("Read file open failed\n");
		return -1;
	}

	if ((fp_w = fopen(argv[2],"w")) == NULL) {
		perror("Destinational file open failed\n");
		fclose(fp_r);
		return -1;
	}

	while(1) {
		//判断是否读到末尾
		if (feof(fp_r)) {
			printf("read file in last line\n");
			break;
		}

		if ((bytes_fread = fread(buf, sizeof(buf), 1, fp_r)) < 0) {
			perror("read file");
			goto END;
		}

		if ((bytes_fwrite = fwrite(buf, sizeof(buf), 1, fp_w)) < 0) {
			perror("destinationa file");
			goto END;
		}

		//清空缓冲区buf
		bzero(buf, sizeof(buf));//'\0'
	}
	printf("Finished Copy!\n");

END:
		fclose(fp_r);
		fclose(fp_w);
		return 0;
}
补充两个函数:
bzero函数
用于给指定的空间都填充上0,一般用于清空数组
头文件
#include <string.h>
函数原型
void bzero(void *s, size_t n);
feof函数
用于判断文件是否读到末尾
头文件
#include <stdio.h>
函数原型
int feof(FILE *stream);
返回值:非零表示到达文件末尾,返回0表示没有到达文件末尾
格式化输入输出
fscanf函数和sscanf函数
int fscanf(FILE *stream, const char *format,...);//使用流
int sscanf(const char *str, const char *format,...);//不使用流
fprintf函数和sprintf函数
int fprintf(FILE *stream, const char *format,...);//使用流
int sprintf(char *s,const char *format,...);//不使用流
返回值:成功时返回字符个数,出错时返回EOF
代码演示:
#include <stdio.h>

int main(int argc, const char *argv[])
{
	char buf[20] = {0};
#if 0
	FILE *fp = NULL;
	if ((fp = fopen(argv[1], "a+")) == NULL) {
		perror("fopen");
		return -1;
	}

	fscanf(fp, "%s", buf);
	fprintf(stdout, "%s", buf);
#else
	int a,b,c;
	sscanf("1 3 5", "%d%d%d", &a, &b, &c);
	sprintf(buf, "a=%d, b=%d, c=%d", a, b, c);
	printf("%s",buf);
#endif
	return 0;
}
文件的刷新与定位
fflush函数
将流缓冲区中的数据刷新出来,写入实际的文件,Linux只能刷新输出缓冲区
头文件
#include <stdio.h>
函数原型
int fflush(FILE *fp);
参数:指定要刷新的流,注意只能是输出流
返回值:成功返回0,出错返回EOF
ftell函数
返回当前文件流的文件读写指针的偏移量
long ftell(FILE *stream);
rewind函数
设置文件读写指针回到文件的开头位置
void rewin(FILE *stream);
fseek函数
用于设置文件流的读写指针位置
int fseek(FILE *stream, long offset, int whence);
参数:
stream:要操作的流
offset:对偏移位置的偏移量
whence:偏移位置
偏移位置:
SEEK_SET:从距文件开头offset位移量为新的读写位置
SEEK_CUR:以目前的读写位置往后增加offset个位移量
SEEK_END:将读写位置指向文件尾后再增加offset个位移量
注意:
文件的打开使用a模式 fseek无效,因为这个模式指定了是在文件尾追加
rewind(fp),相当于fseek(fp, 0, SEEK_SET);
这三个函数都只适用于2G以下的文件
代码演示:
#include <stdio.h>

int main(int argc, const char *argv[])
{
	FILE *fp = NULL;
	char buf[10] = {0};
	long ret;
	if ((fp = fopen(argv[1], "w+")) == NULL) {
		perror("fopen");
		return -1;
	}

	ret = ftell(fp);
	printf("ret = %ld\n", ret);

	fwrite("helloworld", sizeof(char), 10, fp);

	ret = ftell(fp);
	printf("ret=%ld\n", ret);

	//fseek(fp, 0, SEEK_SET);
	//回到开头还可以用rewind
	rewind(fp);

	ret = ftell(fp);
	printf("ret = %ld\n", ret);

	fread(buf, sizeof(char), 10, fp);

	ret = ftell(fp);
	printf("ret = %ld\n", ret);

	fclose(fp);
	return 0;
实践案例——获取文件大小
#include <stdio.h>

int main(int argc, const char *argv[])
{
	FILE *fp = NULL;
	long file_size = 0;
	if (argc < 2) {
		printf("Usage: %s <source file>\n", argv[0]);
		return -1;
	}

	if ((fp = fopen(argv[1],"r")) == NULL) {
		printf("fopen source file failed\n");
		return -1;
	}

	//获取一个文件的大小,先将文件位置定位到末尾再区获取距离开头的偏移量
	fseek(fp, 0, SEEK_END);
	file_size = ftell(fp);
	printf("file_size:%ld\n", file_size);

	fclose(fp);
	return 0;
}
目录操作
访问读取文件
opendir函数
用来打开一个目录文件
头文件:
#include <dirent.h>
函数原型:
DIR *opendir(const char *name);//参数是文件名,建议给绝对路径
DIR *fdopendir(int fd);//使用文件描述符,要配合open函数使用
返回值:
成功时返回目录流指针,出错时返回NULL
补充:
DIR用来描述一个打开的目录文件的结构体类型,typedef重命名而来的类型名
在C语言的标准中,DIR类型被用于表示一个目录流。它通常定义在<dirent.h>头文件中,并用于目录的遍历操作,DIR类型可能是一个不完整类型,这意味着它的具体实现细节再<dirent.h>头文件中并没有完全展开,而只是声明了它的存在
closedir函数
用来关闭目录文件
头文件
#include <dirent.h>
函数原型
int closedir(DIR *dirp);
返回值:成功返回0,出错时返回EOF
readdir函数
用来读取目录流中的内容
头文件
#include <dirent.h>
函数原型
struct dirent* readdir(DIR *dirp);
返回值:struct dirent是用来描述目录流中一个目录项的结构体类型
成功时返回目录流drip中的一个目录项
出错时或到末尾时返回NULL
代码使用:
int main(int argc, const char *argv[])
{
	DIR * dirt = NULL;
	if (argc < 2) {
		printf("Usage: %s <filedir>\n", argv[0]);
		return -1;
	}

	if ((dirt = opendir(argv[1])) == NULL) {
		perror("DIRT:");
		return -1;
	}

	struct dirent *dp = NULL;
	while(dp = readdir(dirt)) {
		if (dp->d_type == DT_DIR) {
			printf("Dir file: %s\n", dp->d_name);
		} else if(dp->d_type == DT_REG) {
			printf("regular file: %s\n", dp->d_name);
		} else {
			printf("other type file: %s\n", dp->d_name);
		}
		 }

	printf("this is all\n");
	closedir(dirt);
	return 0;
}
获取文件的属性
stat、lstat和fstat函数都可以用来获取文件的属性
它们的头文件
#include <sys/types.h>
#inlcude <sys/stat.h>
#include <unistd.h>
函数原型
获取路径名指向的文件信息、文件的状态,会跟随获取符号链接文件
int stat(const char* path, struct stat *buf);

和stat的功能基本一致,除了不会跟随获取符号链接文件,它对于符号链接返回的是链接本身的信息,而不是链接引用的文件
int lstat(const char *path, struct stat *buf);

功能和stat相同,只是要检索的信息是又文件描述符fd指定的
int fstat(int fd, struct stat *buf);
返回值:
成功返回0,出错返回EOF,并讲error设置为指示该错误的信息
参数:如果path是符号链接stat获取的是目标文件的属性,而lstat获取的是链接文件的属性
简单了解一下stat结构体
struct stat是存放文件属性的结构体类型,常用的几个属性:
mode_t st_mode;  //类型个访问权限
uid_t st_uid;  //所有者id
uid_t st_gid;   //用户组id
off_t st_size;  //文件大小
time_t st_mtime;  //最后修改时间

具体的内容
struct stat {
	dev_t st_dev; //文件的设备编号
	ino_t st_ino; //节点
	mode_t st_mode; //文件的类型和存取的权限
	nlink_t st_nlink; //连到该文件是硬连接数目,新建立的文件值为1
	uid_t st_uid; //用户id
	gid_t st_gid; //组id
	dev_t st_rdev; //设备类型,若此文件为设备文件,则为其设备编号
	off_t st_size; //文件字节数大小
	unsigned long st_blksize; //块大小
	unsigned long st_blocks; //块数
	time_t st_atime; //最后一次访问时间
	time_t st_mtime; //最后一次修改时间
	time_t st_ctime; //最后一次属性的改变时间
};
重点了解mode_t
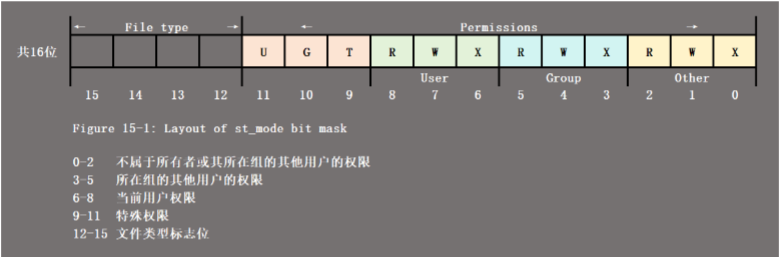
对于权限位,哪一个位置为1就代表拥有哪个权限
判断文件类型的两种方法
第一种:掩码的方式,通过系统提供的宏来判断文件类型:
//S_IFMT 0170000 文件类型的位字段的位掩码
S_IFSOCK 0130000 socket
S_IFLNK 0120000 symbolic link 符号连接
S_IFREG 0100000 普通文件
S_IFBLK 0060000 块设备
S_IFDIR 0040000 目录
S_IFCHR 0020000 字符设备
S_IFIFO 0010000 FIFO 管道
第二种:使用提供的宏来判断文件类型
S_ISREG(st_mode) 0100000 是否常规文件
S_ISDIR(st_mode) 0040000 是否目录
S_ISCHR(st_mode) 0020000 是否字符设备
S_ISBLK(st_mode) 0060000 是否块设备
S_ISFIFO(st_mode) 0120000 是否链接文件
S_ISSOCK(st_mode) 0140000 是否SOCKET文件
通过系统提供的宏来获取文件访问权限
//S_IRWXU 00700 用来判断文件拥有者权限的掩码
S_IRUSR 00400 所有者拥有读权限
S_IWUST 00200 所有者拥有写权限
S_IXUST 00100 所有者拥有执行文件

S_IRWXG 00070 用来判断文件群拥有权限的掩码
S_IRGRP 00040 群组拥有读权限
S_IWGRP 00020 群组拥有写权限
S_IXGRP 00010 群组拥有执行权限

S_IRWXO 00007 用来判断文件其它用户拥有权限的掩码
S_IROTH 00004 其他用户拥有读权限
S_IWOTH 00002 其他用户拥有写权限
S_IXOTH 00001 其他用户拥有执行权限
实践编程——获取文件夹中的文件的信息
#include <sys/stat.h>
#include <fcntl.h>
#include <unistd.h>
#include <time.h>

int main(int argc, const char *argv[])
{
	if (argc < 2) {
		printf("Usage:%s <filename>\n", argv[1]);
		return -1;
	}

	struct stat statbuf;
#if 1
  	if (stat(argv[1], &statbuf) == -1) {
		perror("stat:");
		return -1;
	}
	//printf("file size:%ld\n", statbuf.st_size);
#elif 0
	if (lstat(argv[1], &statbuf) == -1) {
		perror("lstat:");
		return -1;
	}
	printf("file size:%ld\n", statbuf.st_size);

#elif 0
	int fd;
	if ((fd = open(argv[1], O_RDONLY)) < 0) {
		perror("open:");
		return -1;
	}

	if (fstat(fd, &statbuf) == -1) {
			perror("fstat:");
			return -1;
			}
	printf("file size:%ld\n", statbuf.st_size);
#endif

	switch(S_IFMT&statbuf.st_mode) {
	case S_IFREG:
		printf("-");
		break;
	case S_IFDIR:
		printf("d");
		break;
	case S_IFSOCK:
		printf("s");
		break;
	case S_IFLNK:
		printf("l");
		break;
	case S_IFCHR:
		printf("c");
		break;
	case S_IFIFO:
		printf("f");
		break;
	case S_IFBLK:
		printf("b");
		break;
	default:
		printf("have a error\n");
		return -1;
	}

	int n = 8;//这里是为了控制1左移的位数
	do {
		if (statbuf.st_mode & (0x1<<n)) {    //不为零判断权限类型,为零直接为‘-’
			switch(n%3) {
			case 2:
				putchar('r');
				break;
			case 1:
				putchar('w');
				break;
			case 0:
				putchar('e');
				break;
			}
		}else {
			putchar('-');
		} }while(n--);

	printf("\t%ld", statbuf.st_size);
	printf("\t%s\n", ctime(&statbuf.st_mtime));


	return 0;
程序库
库是一个二进制文件,包含的代码可被程序调用。库是事先编译好的,可以复用的代码。
静态库
编译(链接)时把静态库中相关代码复制到可执行文件中,运行时不需要加载静态库,优化运行过程;程序运行时无需等待,调用接口更快,优化运行速度
静态库的创建
1.写好对应的原码文件
2.编译生成目标文件(.o)
gcc -c xxx.c -o xxx.o -wall
3.创建静态库
ar -rsv lib库名.a 目标文件名.o
注意:
1.静态库名字必须以lib开头,.a为后缀
2.没有main函数的.c文件不能被生成可执行文件
命令ar的参数
c 禁止在创建库时产生的正常信息
r 如果指定的文件已经存在于库中,则替换它
s 无论ar命令是否修改了库内容都强制重新生成库符号表
v 将创建新库的详细的逐个文件的描述写至标准输出
q 将指定的文件添加到库的末尾
t 将库的目录写至标准输出
查看库中符号信息的命令
nm命令
显示指定文件中的所有符号信息
nm 文件名 -a
链接静态库
1.写好包含静态库中函数的程序
2.编译xxx.c并链接到静态库
gcc -o 要生成的目标文件名 源码.c -L路径 -l静态库名
说明:
-L 后面跟库所在的路径
-l 后面跟库的名称
-I 指定头文件所在路径
动态库
也称为共享库,是一种在运行是由可执行文件动态链接和加载的代码库。
主要特点包括:
代码共享:多个程序可以共享同一个动态库,从而节省内存和磁盘空间
更新无需重新编译:动态库更新后,只需要更新库文件即可,不需要重新编译使用它的程序
版本控制:可以同时存在多个版本的动态库,程序可以选择使用哪个版本
扩展功能:动态库可以用于扩展程序的功能,无需修改代码
动态库的创建
1.编写源代码
2.编译生成位置无关代码的目标文件.o,确保库中的代码可以在内存中的不同位置加载
gcc -fPIC -c xxx.c -o xxx.o
3.生成动态库
gcc -shared xxx.o -o libxxx.so
注意:动态库名必须由lib开头,以.so为后缀
链接动态库
1.编写应用程序xxx.c
2.链接动态库,编译可执行文件
gcc -O 目标文件.o 源码.c -L路径 -l动态库名
常见的错误:

执行调用了动态库的可执行文件,出现错误:
./main: error while loading shared libraries: libhello.so: cannot open shared object file: No such file directory
含义:可执行文件所使用的动态库找不到
解决方法1:
找到动态库,拷贝一份到/usr/lib路径里面
  sudo cp libxxx.xo /usr/lib/

解决方法2:
在~/.bashrc文件里面添加如下语句
	export LD_LIBRARY_PATH=$LD_LIBRARY_PATH:你的动态库的绝对路径
使用source ~/.bashrc命令保存生效
静态库与动态库的区别: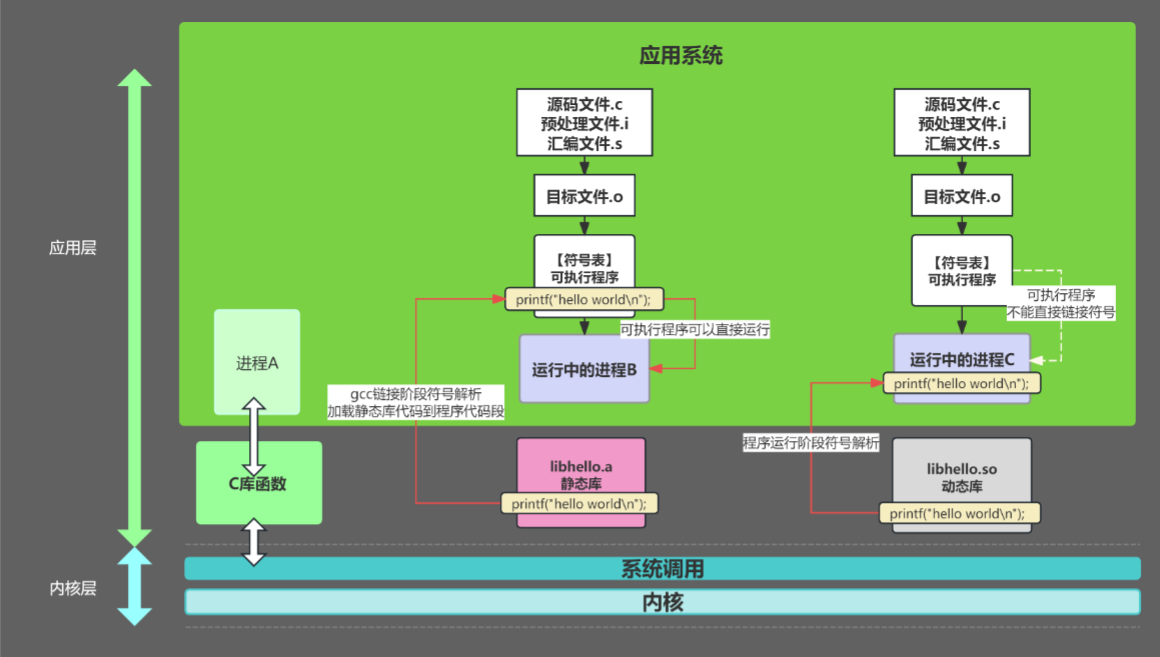
静态库:在程序编译时,静态库的代码会被链接到目标代码中。因此,程序运行时将不再需要该库。链接过程在编译时期完成,执行时代码加载速度快
动态库:在程序编译时,动态库的代码并不会被链接到目标文件中。而是在程序运行时,当需要用到动态库中的函数或类时,才将其载入内存。链接过程推迟到了运行时执行。(理解:每个进程启动时,动态链接器把动态库函数在当前进程的虚拟地址填到进程的 call 指令中;不同进程填入的虚拟地址不一样,但这些虚拟地址最终指向物理内存里同一份库代码)
生成的可执行文件大小与内存占用:
静态库:由于整个函数库的所有数据都会被整合进可执行程序中,因此生成的可执行文件通常比较大。这会导致计算机内存和磁盘的空间浪费
动态库:程序在运行时执行到相关函数时才调用动态库中的相应函数,因此生成的可执行文件比较小。多个程序可以共享一个动态库的代码,内存中只需要存一份动态库的代码,从而节省了空间
更新与维护
静态库:如果静态库发生更改,所有使用它的程序都需要重新编译。这使得程序的更新和发布相对不便
动态库:动态库的更改不会影响已经编译的程序,只需要更新动态库文件,而无需重新编译程序,这使得程序的升级和维护更加简单
理解:静态库更新之后,原来的可执行文件里保存的还是旧版本的函数代码,不会自动更新。所以必须重新链接(一般伴随重新编译源码),让链接器再次从新版静态库拷贝新的函数代码,生成新的可执行文件。
使用场景上:
静态库:适用于需要确保程序在所有环境中都能独立运行且不需要依赖外部库文件的场景。由于所有使用的函数都已经被编译进程序中,因此程序的运行更加稳定可靠
动态库:适用于需要节省内存和磁盘空间的场景,以及需要频繁更新库文件的场景。动态库使得多个程序可以共享痛一个库文件,提高资源利用率。同时,动态库的升级也更加方便,只需要更新库文件即可
补充:
nm命令中显示的两种类型的符号
T:这表示一个全局文本符号。在ELF格式的对象文件中,T通常意味着该符号是一个函数或变量,他在目标文件中定义(即它是可执行文件的一部分)
U:这表示一个未定义的符号。在链接阶段,如果一个符号被引用但未在任何对象文件中定义,那么该符号会被标记为U。这通常意味着该符号是在其他库中定义的,或者在链接时需要通过某种方式(如链接器脚本或命令行参数)来指定其定义位置
s 无论ar命令是否修改了库内容都强制重新生成库符号表
v 将创建新库的详细的逐个文件的描述写至标准输出
q 将指定的文件添加到库的末尾
t 将库的目录写至标准输出
查看库中符号信息的命令

nm命令

显示指定文件中的所有符号信息
nm 文件名 -a
##### 链接静态库

1.写好包含静态库中函数的程序

2.编译xxx.c并链接到静态库
gcc -o 要生成的目标文件名 源码.c -L路径 -l静态库名
说明:

-L 后面跟库所在的路径

-l 后面跟库的名称

-I 指定头文件所在路径


### 动态库

也称为共享库,是一种在运行是由可执行文件动态链接和加载的代码库。

主要特点包括:

代码共享:多个程序可以共享同一个动态库,从而节省内存和磁盘空间

更新无需重新编译:动态库更新后,只需要更新库文件即可,不需要重新编译使用它的程序

版本控制:可以同时存在多个版本的动态库,程序可以选择使用哪个版本

扩展功能:动态库可以用于扩展程序的功能,无需修改代码


##### 动态库的创建

1.编写源代码

2.编译生成位置无关代码的目标文件.o,确保库中的代码可以在内存中的不同位置加载
gcc -fPIC -c xxx.c -o xxx.o
3.生成动态库
gcc -shared xxx.o -o libxxx.so
注意:动态库名必须由lib开头,以.so为后缀


##### 链接动态库

1.编写应用程序xxx.c

2.链接动态库,编译可执行文件
gcc -O 目标文件.o 源码.c -L路径 -l动态库名
常见的错误:
执行调用了动态库的可执行文件,出现错误:
./main: error while loading shared libraries: libhello.so: cannot open shared object file: No such file directory
含义:可执行文件所使用的动态库找不到
解决方法1:
找到动态库,拷贝一份到/usr/lib路径里面
sudo cp libxxx.xo /usr/lib/
解决方法2:
在~/.bashrc文件里面添加如下语句
export LD_LIBRARY_PATH=$LD_LIBRARY_PATH:你的动态库的绝对路径
使用source ~/.bashrc命令保存生效
##### 静态库与动态库的区别:[外链图片转存中...(img-ywA7EXAw-1790605023673)]

静态库:在程序编译时,静态库的代码会被链接到目标代码中。因此,程序运行时将不再需要该库。链接过程在编译时期完成,执行时代码加载速度快

动态库:在程序编译时,动态库的代码并不会被链接到目标文件中。而是在程序运行时,当需要用到动态库中的函数或类时,才将其载入内存。链接过程推迟到了运行时执行。(理解:每个进程启动时,动态链接器把动态库函数在当前进程的虚拟地址填到进程的 call 指令中;不同进程填入的虚拟地址不一样,但这些虚拟地址最终指向物理内存里同一份库代码)


生成的可执行文件大小与内存占用:

静态库:由于整个函数库的所有数据都会被整合进可执行程序中,因此生成的可执行文件通常比较大。这会导致计算机内存和磁盘的空间浪费

动态库:程序在运行时执行到相关函数时才调用动态库中的相应函数,因此生成的可执行文件比较小。多个程序可以共享一个动态库的代码,内存中只需要存一份动态库的代码,从而节省了空间


更新与维护

静态库:如果静态库发生更改,所有使用它的程序都需要重新编译。这使得程序的更新和发布相对不便

动态库:动态库的更改不会影响已经编译的程序,只需要更新动态库文件,而无需重新编译程序,这使得程序的升级和维护更加简单

理解:静态库更新之后,原来的可执行文件里保存的还是旧版本的函数代码,不会自动更新。所以必须**重新链接**(一般伴随重新编译源码),让链接器再次从新版静态库拷贝新的函数代码,生成新的可执行文件。


使用场景上:

静态库:适用于需要确保程序在所有环境中都能独立运行且不需要依赖外部库文件的场景。由于所有使用的函数都已经被编译进程序中,因此程序的运行更加稳定可靠

动态库:适用于需要节省内存和磁盘空间的场景,以及需要频繁更新库文件的场景。动态库使得多个程序可以共享痛一个库文件,提高资源利用率。同时,动态库的升级也更加方便,只需要更新库文件即可


补充:

nm命令中显示的两种类型的符号

T:这表示一个全局文本符号。在ELF格式的对象文件中,T通常意味着该符号是一个函数或变量,他在目标文件中定义(即它是可执行文件的一部分)

U:这表示一个未定义的符号。在链接阶段,如果一个符号被引用但未在任何对象文件中定义,那么该符号会被标记为U。这通常意味着该符号是在其他库中定义的,或者在链接时需要通过某种方式(如链接器脚本或命令行参数)来指定其定义位置

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 4
 0
- 0


 已为社区贡献2条内容

所有评论(0)