PostgreSQ数据库安装及入门
PostgreSQL 安装、配置与使用完全教程(CentOS 7.9 / openEuler 24.03 双环境)
从"这台数据库到底是什么"讲起,到在云主机上装好、建库、授权、远程连接、备份恢复、接进 Django。
主流程是 CentOS 7.9 云主机上的真实执行记录(最终装成 PostgreSQL 15.19),另给出 openEuler 24.03 上一路到 PG 17 的对照命令。
如果你只用过 MySQL,第四、五两节是给你准备的。
目录
- 一、先认识 PostgreSQL:它是什么,为什么值得用
- 二、核心概念与架构速览
- 三、版本与系统选型:先看清天花板
- 四、CentOS 7.9 安装实录
- 五、openEuler 24.03 安装对照
- 六、目录结构、配置文件与 systemd 管理
- 七、开始使用:登录、psql 常用命令
- 八、建库、建用户、授权
- 九、PostgreSQL 能力尝鲜(SQL 小练习)
- 十、从 MySQL 过来的对照速查表
- 十一、远程连接与安全加固
- 十二、Django 接入示例
- 十三、日志与故障排查
- 十四、备份、恢复与定时备份
- 十五、小内存云主机调优参考
- 十六、常见故障速查表
- 十七、上线收尾 checklist
一、先认识 PostgreSQL:它是什么,为什么值得用
1.1 一句话概括
PostgreSQL 是一个开源的对象-关系型数据库(ORDBMS),起源于 1986 年加州大学伯克利分校的 POSTGRES 项目,经过三十多年持续开发,现在由 PostgreSQL 全球开发组(PGDG)以社区方式维护。它采用宽松的 PostgreSQL License(类 BSD/MIT),可以免费商用、闭源二次分发,没有 GPL 传染性,也没有 Oracle/MySQL 那种"社区版 / 企业版"的功能阉割。
它在 DB-Engines 排行榜上常年位于前四,而且是其中唯一一个完全由社区驱动、不被单一商业公司控制的通用数据库 —— 这点在长期技术选型上很重要:不用担心某天被改授权、被分叉、被停止开源。
官网:https://www.postgresql.org/
1.2 它强在哪
| 能力 | 说明 | 对个人/小团队意味着什么 |
|---|---|---|
| 完整的事务性 DDL | CREATE TABLE、ALTER TABLE 都可以在事务里执行并回滚 | 迁移脚本失败能真正回滚,不会留下半张表 |
| MVCC 并发控制 | 读写互不阻塞,读不加锁 | 备份不用停服,长查询不会卡住写入 |
| 类型系统极其丰富 | 数组、JSON/JSONB、UUID、网络地址(inet/cidr)、范围类型、枚举、复合类型、几何类型 | 很多场景可以省掉一张关联表或一个中间件 |
| JSONB | 二进制存储 + GIN 索引 + 丰富操作符 | 半结构化数据不用上 MongoDB 也能查得飞快 |
| 内置全文检索 | tsvector / tsquery、权重、排序、高亮 | 站内搜索不必引 Elasticsearch |
| 强大的索引体系 | B-tree / Hash / GIN / GiST / SP-GiST / BRIN,支持部分索引、表达式索引、覆盖索引 | 优化空间远超"加个索引" |
| 可扩展性 | 自定义类型、函数、操作符、聚合、索引访问方法、FDW 外部数据包装器 | PostGIS(地理)、pgvector(AI 向量检索)、TimescaleDB(时序)都是它的扩展 |
| WAL + PITR | 预写日志 + 时间点恢复 | 可以恢复到"误删数据前 30 秒" |
| 成熟的复制方案 | 流复制(物理)、逻辑复制、级联复制 | 从主从到异地容灾都有官方方案 |
| SQL 标准符合度高 | 窗口函数、CTE、递归查询、物化视图、MERGE(15+) | 复杂报表一条 SQL 搞定 |
1.3 和 MySQL 怎么选
| 维度 | PostgreSQL | MySQL |
|---|---|---|
| 定位 | 功能完整、标准严格,偏"正确优先" | 简单易用、生态庞大,偏"够用就好" |
| 复杂查询 | 优化器更强,支持并行查询、多种索引 | 简单主键查询极快,复杂查询优化器较弱 |
| JSON | jsonb 可索引、可查询嵌套字段 | 有 JSON 类型,索引需生成列 |
| 全文检索 | 内置且强大(需中文分词插件配合) | InnoDB 全文索引能力有限,中文分词依赖第三方 |
| DDL 事务 | 支持 | 不支持(DDL 会隐式提交) |
| 复制 | 流复制 + 逻辑复制,官方方案完善 | 主从复制成熟,生态工具多 |
| 生态/运维人才 | 稍少但增长快 | 极其庞大,招人容易 |
| 典型场景 | 分析型查询、GIS、JSON 混合、复杂业务 | 简单 OLTP、读多写少、互联网高并发 |
结论:博客、CMS、内部系统、数据分析类项目,PostgreSQL 几乎没有短板;只有当你依赖某个"仅支持 MySQL 的第三方系统",或团队完全没有 PG 运维经验时,MySQL 才更合适。
1.4 版本策略
PGDG 每年发布一个大版本(如 15 → 16 → 17),每个大版本提供 5 年支持。所以任选一个当前受支持的版本都不亏:
| 版本 | 状态 | 建议 |
|---|---|---|
| 17 / 16 | 主流支持中 | 新机器首选 |
| 15 / 14 | 支持中(14 将于 2026-11 停止修复) | 老系统上的现实选择 |
| 13 及更早 | 已 EOL 或接近 EOL | 不该用于新项目 |
二、核心概念与架构速览
第一次接触 PG,先把这几个概念理顺,后面所有操作都会用到。
2.1 三层结构:实例 → 数据库 → schema
PostgreSQL 实例(一个数据目录 + 一个 postmaster 进程 + 端口 5432)
├── 数据库 blogdb
│   ├── schema public        ← 命名空间,不是用户
│   │   ├── 表 posts
│   │   ├── 视图 / 索引 / 函数 / 序列
│   ├── schema analytics     ← 可以有多个 schema
├── 数据库 test
└── 角色(role)              ← 注意:角色是实例级别的,不属于任何库
三个必须记住的差异点:
- 数据库之间完全隔离,不能跨库 JOIN(MySQL 可以)。要跨库查询得用
postgres_fdw或dblink。 - schema 是命名空间,不是用户。
public只是默认 schema 的名字,跟"公共权限"无关。 - 角色(role)是实例级的。
CREATE USER其实是CREATE ROLE ... LOGIN的别名 —— PG 里"用户"就是"能登录的角色"。
2.2 账号与权限模型
- 没有 MySQL 的
'user'@'192.168.1.%'概念。主机来源限制统一写在pg_hba.conf,账号本身不带 host。 - 权限分层次授予:
DATABASE(CONNECT)→SCHEMA(USAGE/CREATE)→TABLE(SELECT/INSERT/…)。少任何一层都会报错。 - 常见的三个默认角色属性:
SUPERUSER(绕过一切检查)、CREATEDB、CREATEROLE。应用账号一个都别给。
2.3 进程与内存结构
postmaster(主进程,PID 1 of PG)
├── logger              -- 日志收集
├── checkpointer        -- 检查点刷盘
├── background writer   -- 后台写脏页
├── walwriter           -- 写 WAL
├── autovacuum launcher -- 自动清理(别关)
├── logical replication launcher
└── 每个客户端连接一个后端进程 postgres: user db host(cmd)
关键内存区域:shared_buffers(PG 自己的数据缓存)、wal_buffers、work_mem(每操作的排序/哈希内存)。第十节会给出具体数值。
2.4 MVCC 与 VACUUM
PG 的 MVCC 靠"多版本元组"实现:更新一行不是原地改,而是插入新版本、把旧版本标记为死元组。读操作看到的是事务开始时的快照,因此读写互不阻塞。
代价是死元组会堆积,需要 VACUUM 回收 —— 这就是 autovacuum 进程存在的意义。永远不要关掉 autovacuum,关了表会无限膨胀,最后磁盘和性能一起崩。
2.5 WAL
所有修改先写 WAL(Write-Ahead Log)再落数据文件。WAL 是崩溃恢复、流复制、PITR 的共同基础。数据目录下的 pg_wal 就是它,别手动删。
三、版本与系统选型:先看清天花板
装之前先接受现实:PGDG 官方 YUM 仓库目前只为 RHEL / Rocky / AlmaLinux 的 10、9、8 三个大版本出包,官方下载页面已经不再列出 EL7。而 CentOS 7 本身在 2024-06-30 就已 EOL,系统基础源不再更新。
| 系统 | 可达成的 PG 版本 | 说明 |
|---|---|---|
| CentOS 7.9(PGDG 历史仓) | PG 15(实测 15.19) | 本次演示环境,能装但后续小版本更新无保证 |
| CentOS 7 自带源 | PG 9.2 | 太老,不要碰 |
| CentOS 7 + SCL 源 | PG 10 / 12 / 13 | 兜底方案,路径在 /var/opt/rh/... |
| openEuler 24.03 LTS(EPOL) | PG 17(postgresql-17-server 17.7) | 直接 dnf install,新机器首选 |
| openEuler 22.03 LTS(默认源) | PG 13.x | 官方 OS 源直装,版本偏旧 |
| Rocky / Alma 9 | PG 16 / 15 / 13 | PGDG 官方支持,最省心 |
选型结论:老机器老实停在 PG 15;新机器直接 openEuler 24.03 + PG 17。别在 CentOS 7 上硬上 16/17,源路径和依赖链会拖垮你。
四、CentOS 7.9 安装实录
环境:x86_64 云主机,root 权限,最终版本 psql (PostgreSQL) 15.19。
4.1 系统准备
cat /etc/redhat-release
rpm -qa | grep -i postgres        # 检查是否已装旧版
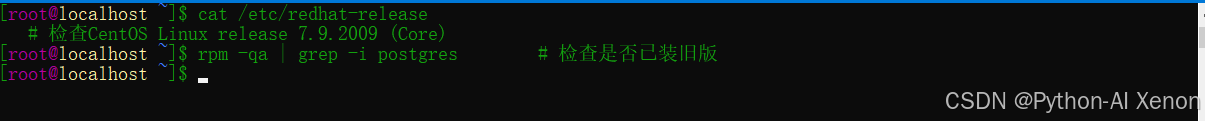
如果输出里有系统自带的 9.2,先卸掉避免冲突:
sudo yum remove -y postgresql postgresql-server postgresql-libs
顺手把时区改成上海 —— 后面看日志、排查故障会省很多事(本机默认 EDT,日志时间戳和北京时间差 12 小时):
sudo timedatectl set-timezone Asia/Shanghai
timedatectl | grep "Time zone"

4.2 修复 CentOS 7 基础源(EOL 之后的必做一步)
CentOS 7 在 2024-06-30 停止维护后,mirrorlist.centos.org 这个域名已被下线。此时任何 yum 操作都会卡在这里:
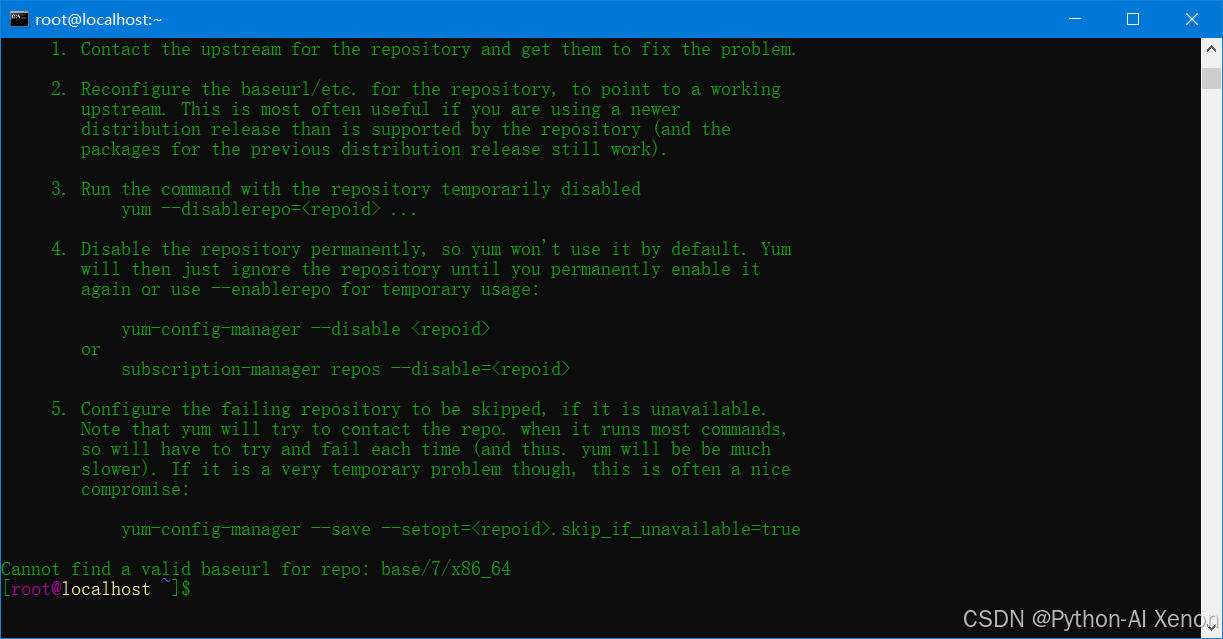
注意这是域名已经不存在,不是你的 DNS 配错了,换 DNS、改 /etc/resolv.conf 都没用。唯一的解法是把 base / updates / extras 指向官方归档站 vault.centos.org(CentOS 7 的最后一个版本归档路径是 7.9.2009)。
CentOS 7 在 2024-06-30 停止维护后,mirrorlist.centos.org 域名已下线,同时 PGDG 官方也移除了 EL-7 上 PostgreSQL 12 及更早版本的仓库路径(返回 410 Gone)。此时直接执行 yum makecache 会先后遭遇两次失败:
- Could not resolve host: mirrorlist.centos.org —— 基础源不可用
- HTTPS Error 410 - Gone —— pgdg12 等旧子仓已不存在
解决方案:替换基础源 + 禁用无效 PGDG 子仓。
第一步:替换 CentOS 基础源为阿里云 vault 归档
sudo cp -a /etc/yum.repos.d/CentOS-Base.repo /etc/yum.repos.d/CentOS-Base.repo.bak.$(date +%s)

sudo tee /etc/yum.repos.d/CentOS-Base.repo > /dev/null <<'EOF'
[base]
name=CentOS-7.9.2009 - Base - aliyun vault
baseurl=https://mirrors.aliyun.com/centos-vault/7.9.2009/os/$basearch/
gpgcheck=1
gpgkey=file:///etc/pki/rpm-gpg/RPM-GPG-KEY-CentOS-7
enabled=1

[updates]
name=CentOS-7.9.2009 - Updates - aliyun vault
baseurl=https://mirrors.aliyun.com/centos-vault/7.9.2009/updates/$basearch/
gpgcheck=1
gpgkey=file:///etc/pki/rpm-gpg/RPM-GPG-KEY-CentOS-7
enabled=1

[extras]
name=CentOS-7.9.2009 - Extras - aliyun vault
baseurl=https://mirrors.aliyun.com/centos-vault/7.9.2009/extras/$basearch/
gpgcheck=1
gpgkey=file:///etc/pki/rpm-gpg/RPM-GPG-KEY-CentOS-7
enabled=1
EOF
如果 vault.centos.org 在你所在网络访问不畅(海外站点,国内偶尔抽风),换成国内镜像的归档目录,把上面三个 baseurl 的域名部分替换即可:
https://mirrors.tencent.com/centos-vault/7.9.2009/
https://mirrors.aliyun.com/centos-vault/7.9.2009/
https://mirrors.huaweicloud.com/centos-vault/7.9.2009/
不确定哪个能用,直接测(返回 200 就是通的):
curl -sI -o /dev/null -w "%{http_code}\n" http://vault.centos.org/7.9.2009/os/x86_64/repodata/repomd.xml
修好基础源之前,yum-utils、epel-release、libzstd 全都装不上(它们都在 base / EPEL 里),后续步骤也就无从谈起。所以这一步必须排在最前面。
第二步:禁用所有不需要的 PGDG 子仓(只保留 pgdg15)
PGDG 官方源安装后会启用多个版本的子仓(pgdg12、pgdg13……),其中 pgdg12 等已失效。直接在 repo 文件中将它们禁用:
sudo sed -i \
    -e '/^\[pgdg12\]/,/^\[/ s/^enabled=1/enabled=0/' \
    -e '/^\[pgdg13\]/,/^\[/ s/^enabled=1/enabled=0/' \
    -e '/^\[pgdg14\]/,/^\[/ s/^enabled=1/enabled=0/' \
    -e '/^\[pgdg16\]/,/^\[/ s/^enabled=1/enabled=0/' \
    -e '/^\[pgdg17\]/,/^\[/ s/^enabled=1/enabled=0/' \
    -e '/^\[pgdg18\]/,/^\[/ s/^enabled=1/enabled=0/' \
    -e '/^\[pgdg15\]/,/^\[/ s/^enabled=0/enabled=1/' \
    /etc/yum.repos.d/pgdg-redhat-all.repo
验证并清理缓存:
sudo yum clean all
sudo yum makecache
如果太慢,直接换更快的镜像源:
# 把 mirrors.aliyun.com 替换为中科大
sed -i 's|mirrors.aliyun.com|mirrors.ustc.edu.cn|g' /etc/yum.repos.d/CentOS-Base.repo

# 或者用清华的
# sed -i 's|mirrors.aliyun.com|mirrors.tuna.tsinghua.edu.cn|g' /etc/yum.repos.d/CentOS-Base.repo
这样不在会报错了
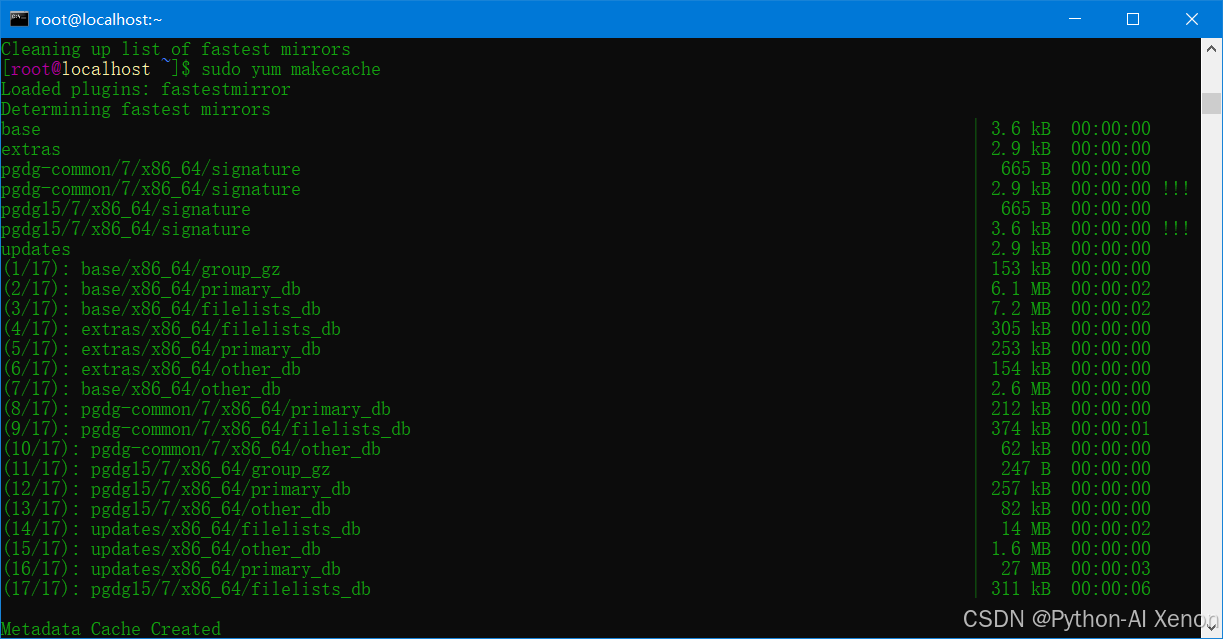
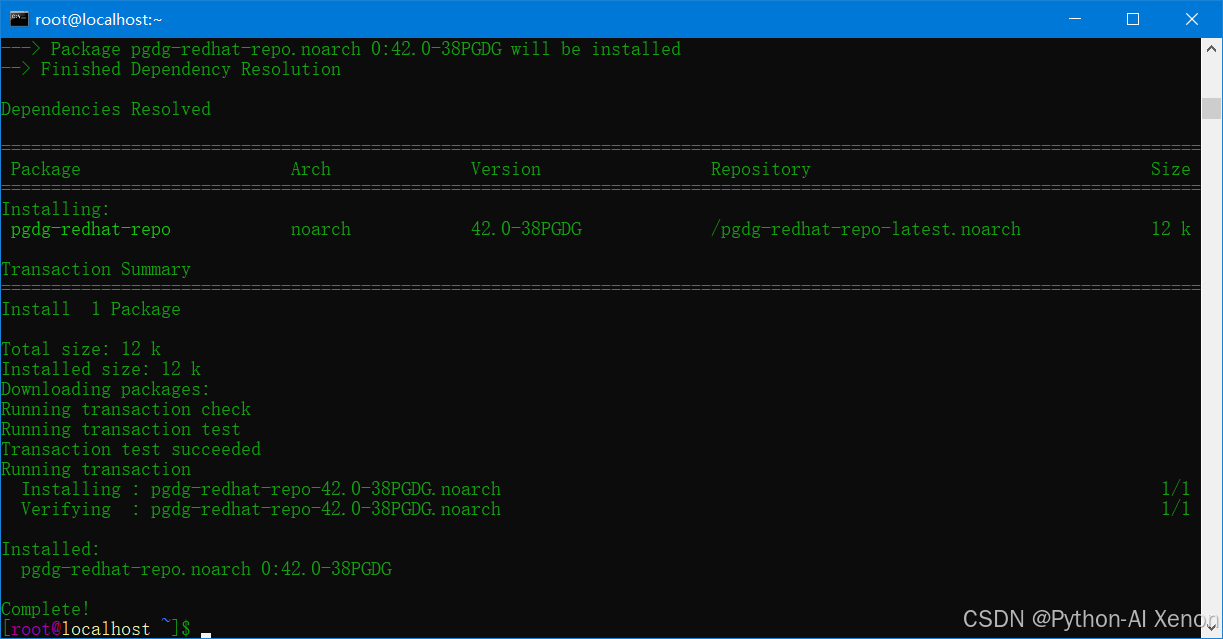
4.3 添加 PGDG 官方源
sudo yum install -y https://download.postgresql.org/pub/repos/yum/reporpms/EL-7-x86_64/pgdg-redhat-repo-latest.noarch.rpm
安装完成后会生成 /etc/yum.repos.d/pgdg-redhat-all.repo,里面每个 PG 大版本对应一个 [pgdgNN] 段。
4.4 只启用你需要的版本子仓
PGDG 的 EL7 目录下,部分旧版本的仓库已经被摘掉,访问时返回 HTTP 410 Gone。而 yum makecache 会刷新所有已启用子仓,撞到失效的那个就整体失败:
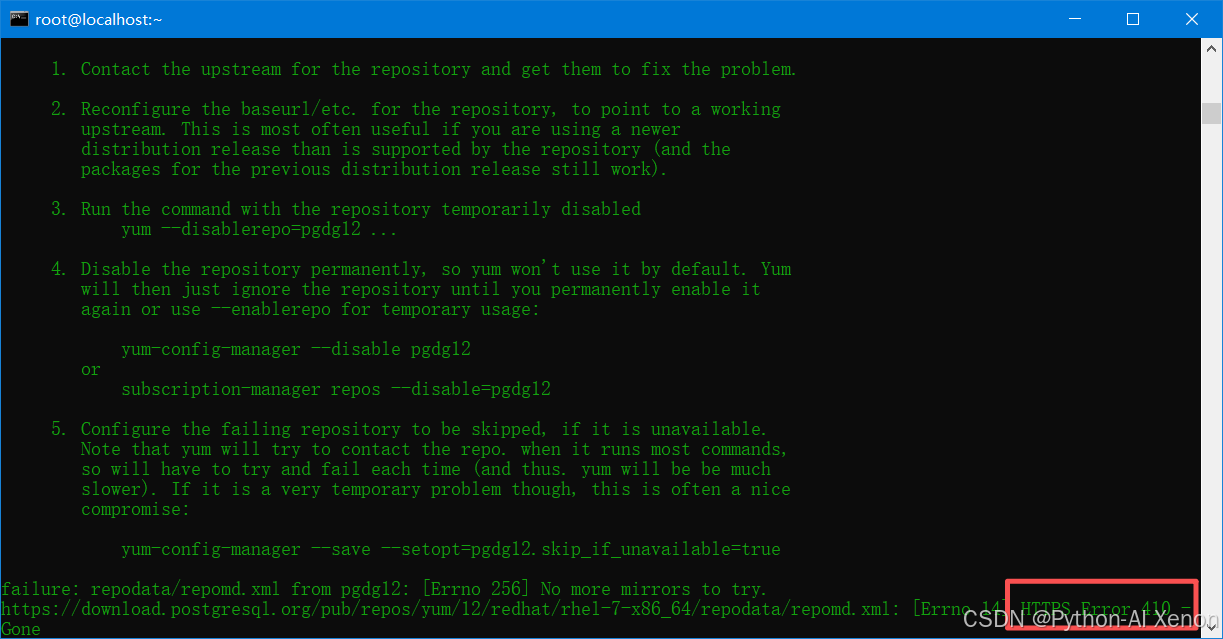
https://download.postgresql.org/pub/repos/yum/12/redhat/rhel-7-x86_64/repodata/repomd.xml: [Errno 14] HTTPS Error 410 - Gone
Trying other mirror.
failure: repodata/repomd.xml from pgdg12: [Errno 256] No more mirrors to try.
这不是网络问题,是资源已被永久移除。 解法是只保留目标版本的子仓:
不动全局,只在装包时临时绕开失效仓:
sudo yum --disablerepo=pgdg12,pgdg13,pgdg14 install -y postgresql15-server postgresql15 postgresql15-contrib
确认 15 已在列表中、不再报 410:
yum repolist | grep pgdg
# pgdg-common/7/x86_64   PostgreSQL common RPMs for RHEL / CentOS 7 - x86_64   545
# pgdg14/7/x86_64        PostgreSQL 14 for RHEL / CentOS 7 - x86_64         1,021
# pgdg15/7/x86_64        PostgreSQL 15 for RHEL / CentOS 7 - x86_64           745
4.5 补上 libzstd 依赖
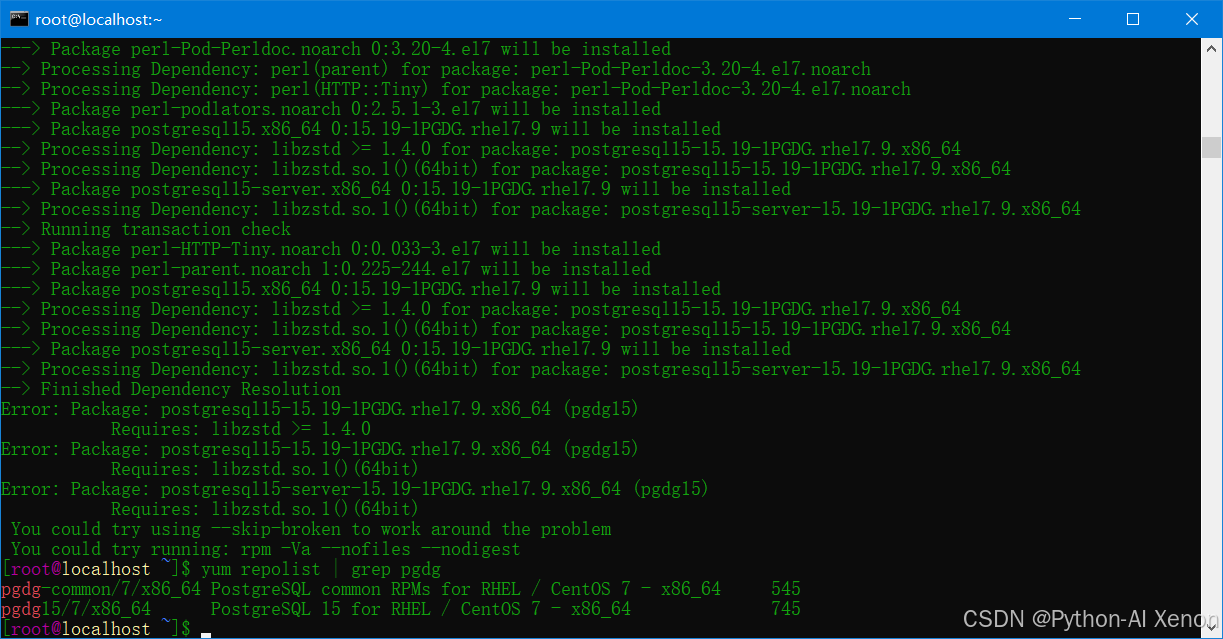
PG 15 编译时启用了 zstd 压缩(用于 WAL / TOAST 压缩),因此硬依赖 libzstd >= 1.4.0。但 CentOS 7 的 base / updates 源里没有这个包,直接 yum install libzstd 只会得到 No package libzstd available,安装 PG 时则会报:
Error: Package: postgresql15-15.19-1PGDG.rhel7.9.x86_64 (pgdg15)
           Requires: libzstd >= 1.4.0
Error: Package: postgresql15-server-15.19-1PGDG.rhel7.9.x86_64 (pgdg15)
           Requires: libzstd.so.1()(64bit)
 You could try using --skip-broken to work around the problem
⚠️ 千万不要用
--skip-broken。 跳过去装完,运行时缺libzstd.so.1,postmaster起不来,报错比现在更隐蔽。
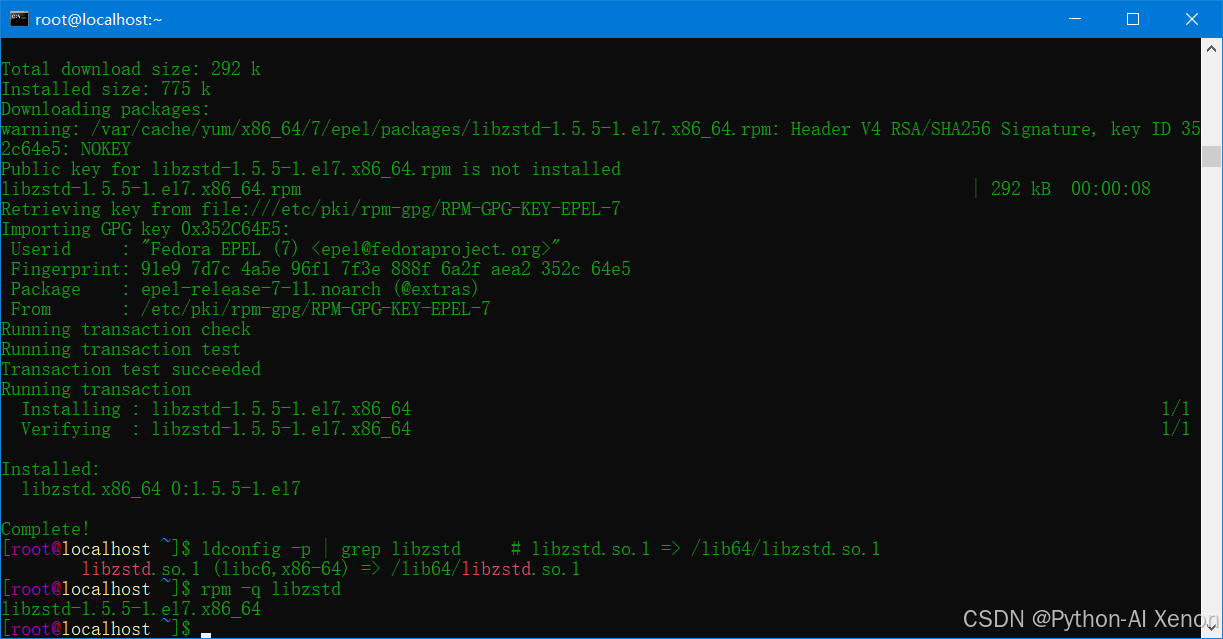
方式 A:走 EPEL(推荐)
sudo yum install -y epel-release
sudo yum clean all && sudo yum makecache
sudo yum install -y libzstd
ldconfig -p | grep libzstd     # libzstd.so.1 => /lib64/libzstd.so.1
rpm -q libzstd                 # 版本需 >= 1.4.0,EPEL7 一般为 1.5.x
方式 B:手动安装 el7 的 rpm(EPEL 不通时)
cd /tmp
wget https://archives.fedoraproject.org/pub/archive/epel/7/x86_64/Packages/l/libzstd-1.5.5-1.el7.x86_64.rpm
# 若该路径失效,换成 1.4.4 / 1.5.2,或进目录自己挑:
#   https://archives.fedoraproject.org/pub/archive/epel/7/x86_64/Packages/l/
sudo yum install -y ./libzstd-1.5.5-1.el7.x86_64.rpm
sudo ldconfig && ldconfig -p | grep libzstd
其它依赖不必操心,yum 会自动从 base/updates 解决:libicu(base 有 50.2)、libxslt(contrib 需要)、python3-libs 3.6(contrib 的 plpython3 需要)、libpq.so.5(随 postgresql15-libs 装上)。真正卡住的只有 libzstd 一项。
4.6 安装与初始化
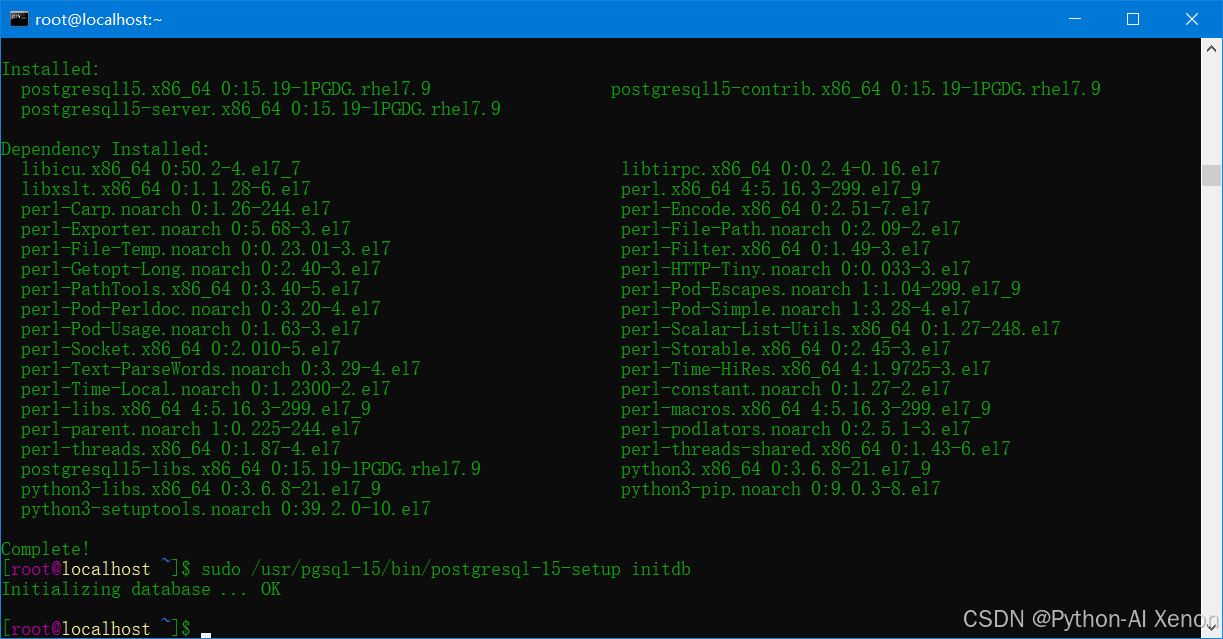
sudo yum install -y postgresql15-server postgresql15 postgresql15-contrib
PGDG 的 RPM 不会自动建数据目录,必须手动初始化:
sudo /usr/pgsql-15/bin/postgresql-15-setup initdb
# Initializing database ... OK
4.7 启动并设置开机自启
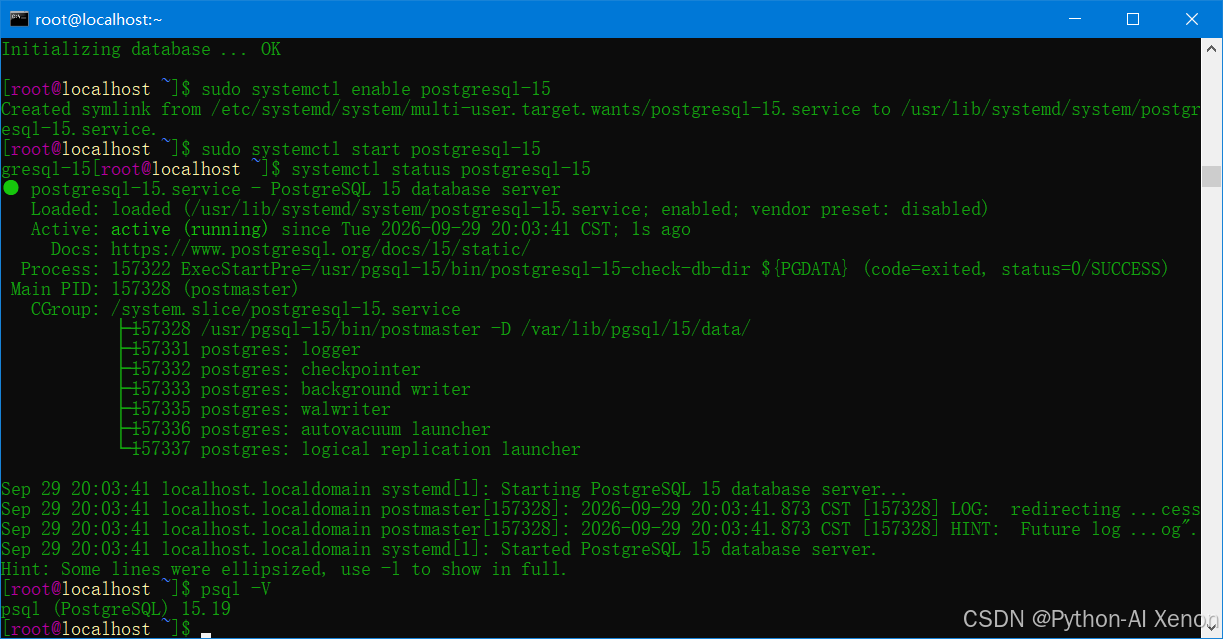
sudo systemctl enable postgresql-15
# Created symlink from /etc/systemd/system/multi-user.target.wants/postgresql-15.service \
#   to /usr/lib/systemd/system/postgresql-15.service.
sudo systemctl start postgresql-15
systemctl status postgresql-15
验证客户端版本:
psql -V
# psql (PostgreSQL) 15.19
正常运行的输出长这样:
五、openEuler 24.03 安装对照
openEuler 属于另一条生态:PGDG 官方不提供 openEuler 仓库,不要照抄上面的 PGDG 源。走官方 OS 源 + EPOL(Extra Packages for openEuler)即可,EPOL 源实测可提供 postgresql-17-server 17.7。
5.1 安装 PG 17
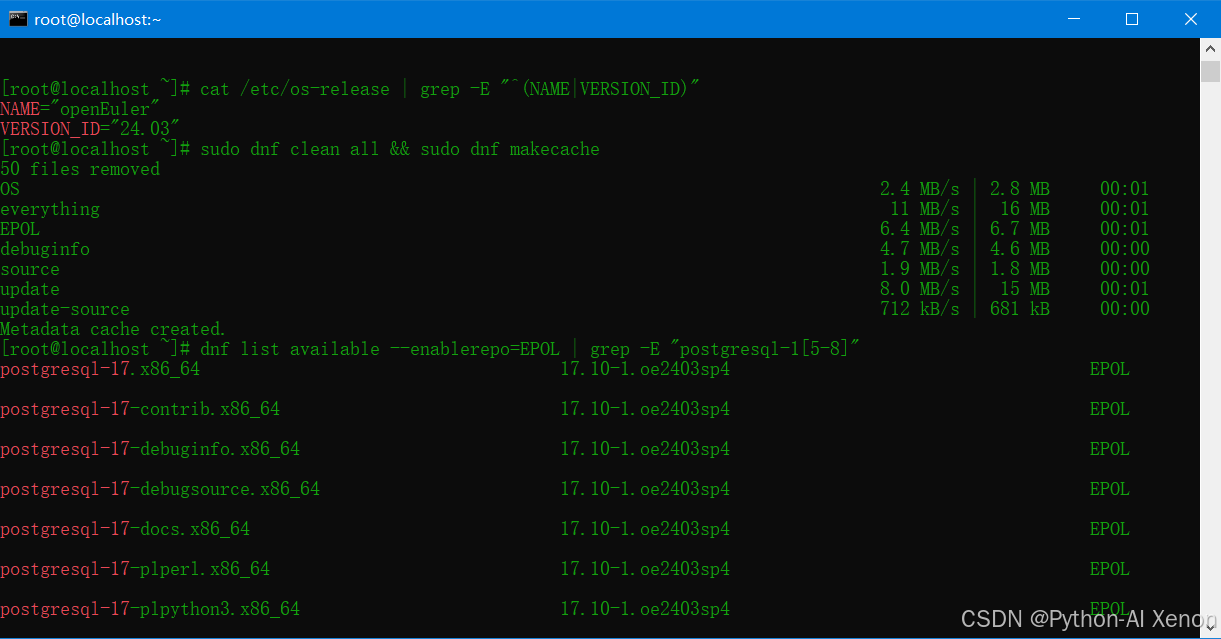
cat /etc/os-release | grep -E "^(NAME|VERSION_ID)"
sudo dnf clean all && sudo dnf makecache

# 看 EPOL 里有哪些版本可用
dnf list available --enablerepo=EPOL | grep -E "postgresql-1[5-8]"
# postgresql-17-server.x86_64    17.7-1.oe2403sp3    EPOL

# 安装
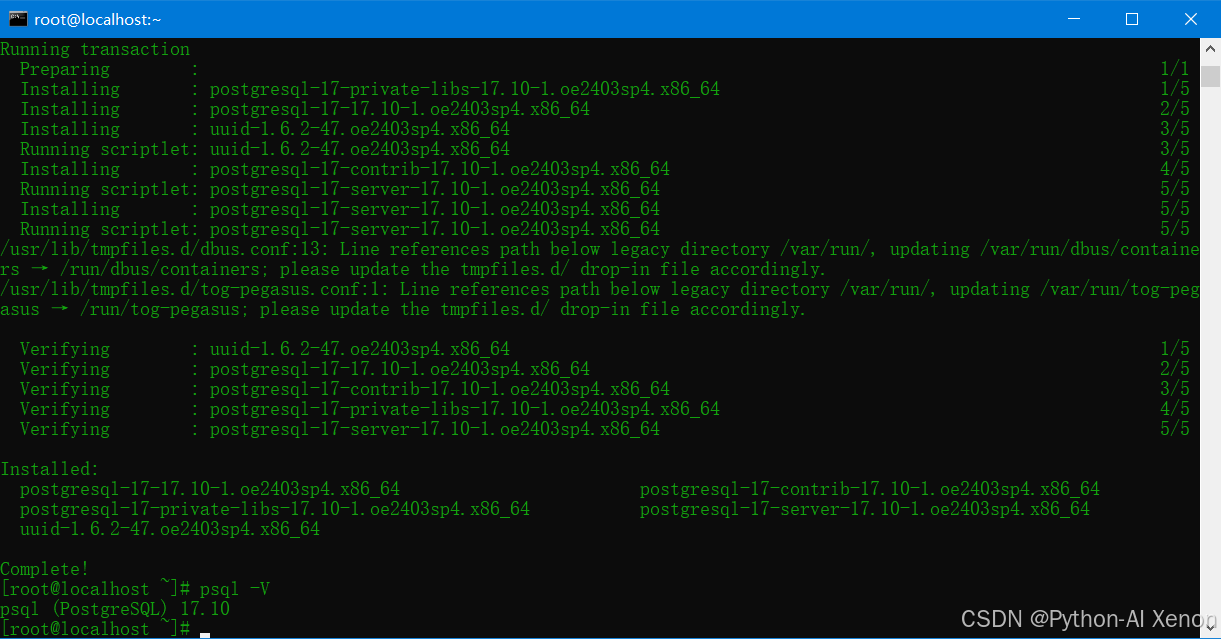
sudo dnf install -y postgresql-17-server postgresql-17 postgresql-17-contrib
# 查看版本
psql -V
注:openEuler 22.03 LTS 的默认 OS 源里
postgresql-server版本约为 13.x,如需 PG 17 同样看 EPOL 是否提供对应版本。EPOL 里也提供带版本号的postgresql-15-server等包。
5.2 初始化与启动
openEuler 的包是发行版自己打的,命名和路径与 PGDG 不一样:
# 1. 初始化(不要加 --unit,用默认 /var/lib/pgsql/data)
sudo /usr/bin/postgresql-setup --initdb

# 2. 启动并开机自启
sudo systemctl enable --now postgresql

# 3. 看状态
sudo systemctl status postgresql

# 4.验证
sudo -u postgres psql -c "SELECT version();"
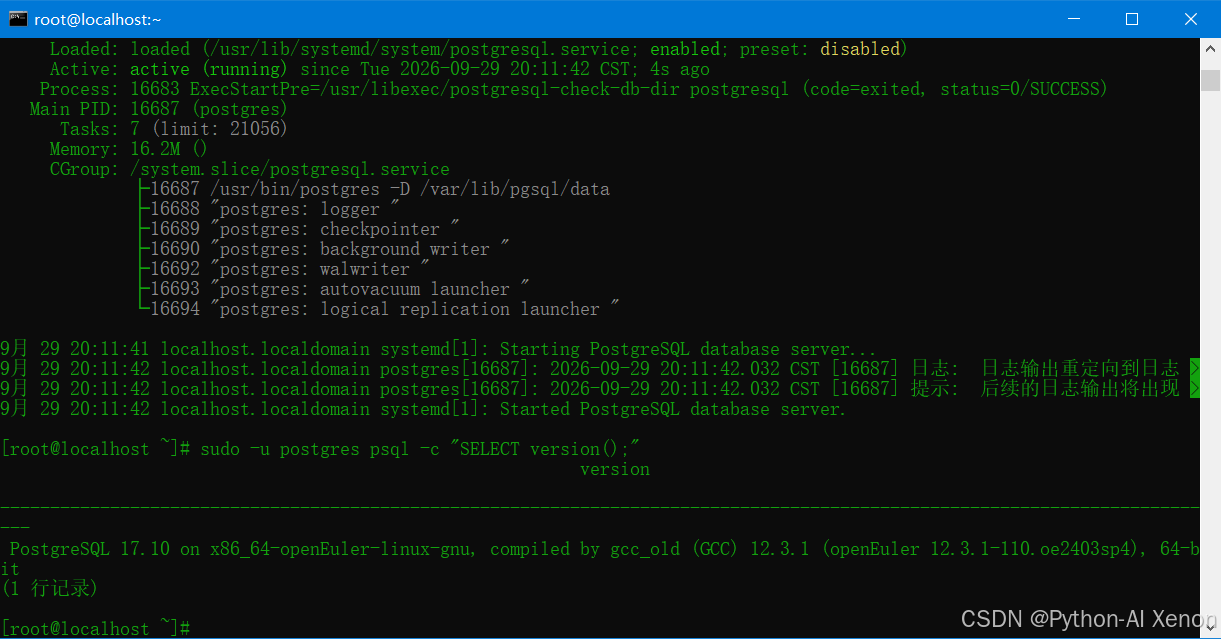
不要猜服务名,装完直接查:
systemctl list-unit-files | grep -i postgres     # 可能是 postgresql17 或 postgresql
sudo -u postgres psql -c "SHOW data_directory;"  # 真实数据目录
sudo -u postgres psql -c "SHOW config_file;"     # 真实配置文件路径
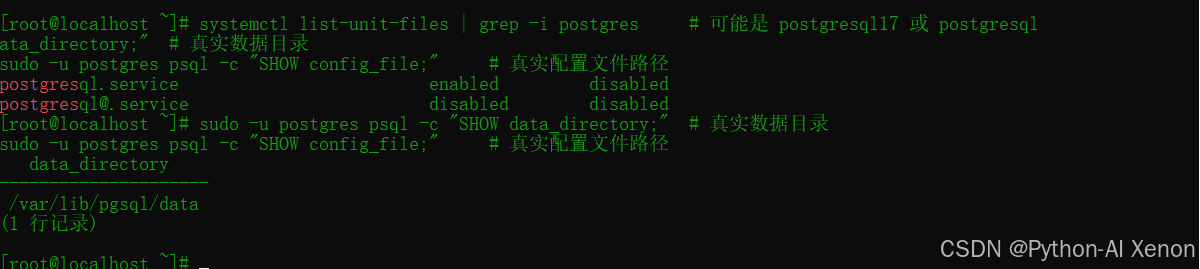
这两条能一次性拿到准确路径,后面所有命令以它为准。
5.3 三套环境路径对照表
| 项目 | CentOS 7 + PGDG | CentOS 7 + SCL | openEuler 24.03(PG 17) |
|---|---|---|---|
| 安装命令 | yum install postgresql15-server | yum install rh-postgresql13-postgresql-server | dnf install postgresql-17-server |
| 二进制目录 | /usr/pgsql-15/bin | /opt/rh/rh-postgresql13/root/usr/bin | /usr/bin(以实际为准) |
| 数据目录 | /var/lib/pgsql/15/data | /var/opt/rh/rh-postgresql13/lib/pgsql/data | 用 SHOW data_directory; 确认 |
| 初始化 | postgresql-15-setup initdb | scl enable rh-postgresql13 -- postgresql-setup --initdb | postgresql-setup --initdb --unit postgresql17 |
| 服务名 | postgresql-15 | rh-postgresql13-postgresql | postgresql17 |
| 包管理器 | yum | yum | dnf |
5.4 openEuler 上的两个注意点
- 别混用两套包。 装之前先
rpm -qa | grep -i postgres确认环境干净。发行版包和 PGDG 包混装会导致/usr/bin/psql与/usr/pgsql-x/bin/psql版本打架,psql -V和SHOW server_version;对不上,排查起来非常浪费时间。 - RHEL 8 系(Rocky / Alma)装 PGDG 前要禁用自带模块(openEuler 无 module 机制,跳过即可):
忘了这步的典型表现是解析依赖失败,或装完发现版本不对。sudo dnf -qy module disable postgresql sudo dnf install -y postgresql16-server postgresql16 postgresql16-contrib
六、目录结构、配置文件与 systemd 管理
6.1 关键路径(PGDG 包,CentOS 7)
| 项目 | 路径 |
|---|---|
| 二进制 | /usr/pgsql-15/bin/ |
| 数据目录 | /var/lib/pgsql/15/data/ |
| 主配置文件 | /var/lib/pgsql/15/data/postgresql.conf |
| 访问控制 | /var/lib/pgsql/15/data/pg_hba.conf |
| 日志目录 | /var/lib/pgsql/15/data/log/ |
| 服务单元 | /usr/lib/systemd/system/postgresql-15.service |
| 端口 | 5432 |
数据目录内部(了解即可,别手动改):
/var/lib/pgsql/15/data/
├── PG_VERSION            # 大版本号
├── postgresql.conf       # 主配置
├── pg_hba.conf           # 客户端认证
├── pg_ident.conf         # 操作系统用户映射
├── base/                 # 各数据库的数据文件
├── global/               # 实例级系统表
├── pg_wal/               # WAL 日志(勿手动删)
├── pg_xact/              # 事务提交状态
└── log/                  # 运行日志(logging_collector 开启时)
6.2 postgresql.conf:主配置
三个最常改的参数:
listen_addresses = 'localhost'   # 监听地址,远程访问需改成 '*'
port = 5432
password_encryption = scram-sha-256   # PG 14+ 默认已是 scram-sha-256
改哪个参数需要什么级别的操作,别猜,直接问数据库:
sudo -u postgres psql -h /tmp -c "SELECT name, setting, context FROM pg_settings WHERE name IN ('listen_addresses','shared_buffers','work_mem');"
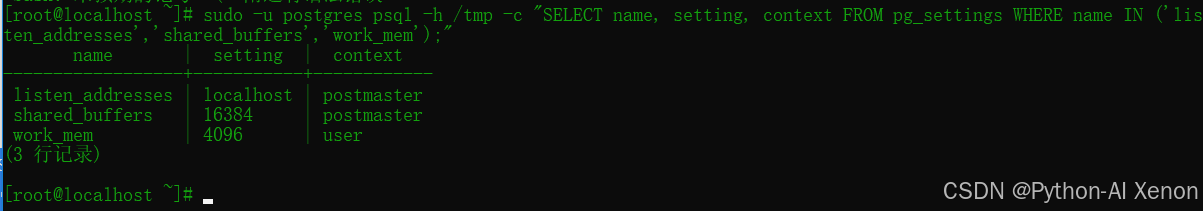
context 的含义:
| context | 含义 | 生效方式 |
|---|---|---|
postmaster | 实例级参数 | 必须 restart |
sighup | 可通过信号重载 | reload 即可 |
user / superuser | 会话级 | SET 立即生效 |
6.3 pg_hba.conf:客户端认证
文件名里的 hba = host based authentication。每行一条规则,格式:
# TYPE   DATABASE   USER   ADDRESS          METHOD
local    all        all                     peer
host     all        all    127.0.0.1/32     scram-sha-256
host     all        all    ::1/128          scram-sha-256
匹配是自上而下的,第一条命中即生效,所以放行的规则要写在拒绝规则之前。常用 METHOD:
| METHOD | 说明 | 适用场景 |
|---|---|---|
peer | 用操作系统用户名做数据库用户名,不校验密码 | 本地 socket,运维操作 |
scram-sha-256 | 密码认证,加密传输凭据 | TCP 连接的默认选择 |
md5 | 旧式密码认证 | 兼容老客户端 |
trust | 不校验,直接放行 | 仅本地临时排错用,绝不上生产 |
reject | 明确拒绝 | 黑名单 |
6.4 systemd 常用操作
sudo systemctl start    postgresql-15
sudo systemctl stop     postgresql-15
sudo systemctl restart  postgresql-15    # 改 listen_addresses / 内存参数后需要
sudo systemctl reload   postgresql-15    # 改 pg_hba.conf / 部分日志参数后即可
sudo systemctl status   postgresql-15
sudo systemctl is-enabled postgresql-15  # 确认开机自启
sudo journalctl -u postgresql-15 -f      # 跟踪服务日志
也可以用 PG 自带的控制命令(不依赖 systemd):
sudo -u postgres /usr/pgsql-15/bin/pg_ctl -D /var/lib/pgsql/15/data status
sudo -u postgres /usr/pgsql-15/bin/pg_ctl -D /var/lib/pgsql/15/data reload
七、开始使用:登录、psql 常用命令
7.1 登录的几种方式
# ① 切到系统 postgres 用户,走 peer 认证(最常见)
sudo -i -u postgres
psql                       # 提示符变为 postgres=#

# ② 不切用户,直接执行一条 SQL
sudo -u postgres psql -c "SELECT version();"

# ③ 用密码走 TCP(需先在 pg_hba.conf 放行)
psql -h 127.0.0.1 -U bloguser -d blogdb

# ④ 连接串写法
psql "postgresql://bloguser:BlogDbPass!@127.0.0.1:5432/blogdb"
为什么必须
sudo -i -u postgres? 不是权限不够,而是local认证默认是peer:PG 用你的操作系统用户名当数据库用户名。以root身份直接psql会报role "root" does not exist,这是设计如此。
7.2 psql 元命令(反斜杠命令)
psql 是 PG 最趁手的工具,这些以 \ 开头的命令不是 SQL,后面不要加分号:
| 命令 | 作用 |
|---|---|
\? | 查看所有元命令帮助 |
\l / \l+ | 列出所有数据库 |
\c dbname | 切换数据库 |
\dt / \dt+ | 列出当前 schema 的表(\dt *.* 看全部) |
\d tablename / \d+ | 查看表结构(含索引、约束、注释) |
\di / \ds / \dv / \df | 索引 / 序列 / 视图 / 函数 |
\du / \du+ | 列出所有角色及其属性 |
\dn | 列出 schema |
\x | 切换竖排显示(宽表救命,再按一次关闭) |
\timing | 开关执行计时 |
\conninfo | 显示当前连接信息 |
\i file.sql | 执行外部 SQL 文件 |
\o file.txt | 把输出写到文件 |
\e | 用编辑器写复杂 SQL |
\q | 退出 |
7.3 常用系统查询
-- 版本信息
SELECT version();
SHOW server_version;

-- 当前数据库 / 用户 / 端口
SELECT current_database(), current_user, inet_server_port();

-- 查看某参数的当前值
SHOW shared_buffers;
SELECT name, setting, unit FROM pg_settings WHERE name = 'work_mem';

-- 数据库大小和表大小
SELECT pg_size_pretty(pg_database_size('blogdb'));
SELECT pg_size_pretty(pg_total_relation_size('posts'));

-- 当前活跃连接
SELECT pid, usename, datname, state, left(query, 50) FROM pg_stat_activity;
八、建库、建用户、授权
8.1 完整流程
-- ① 给超级管理员设密码(默认 postgres 无密码,靠 peer 保护)
ALTER USER postgres WITH PASSWORD '换成强密码';

-- ② 建应用专用账号(不要用 postgres 给应用连)
CREATE USER bloguser WITH PASSWORD 'BlogDbPass!';

-- ③ 建库,直接指定 owner
CREATE DATABASE blogdb OWNER bloguser;

-- ④ 切进库,授予 schema 权限
\c blogdb
GRANT USAGE, CREATE ON SCHEMA public TO bloguser;

-- ⑤ 会话级默认值(可选但推荐)
ALTER ROLE bloguser SET client_encoding TO 'utf8';
ALTER ROLE bloguser SET timezone TO 'Asia/Shanghai';
ALTER ROLE bloguser SET default_transaction_isolation TO 'read committed';

-- ⑥ 库级权限
GRANT ALL PRIVILEGES ON DATABASE blogdb TO bloguser;
第 ④ 步为什么不能省? PostgreSQL 15 收紧了 public schema 的默认权限,不再允许 PUBLIC 角色在其中创建对象。典型症状是:库建好了、用户也授权了,应用建表时却报
permission denied for schema public
如果库是 CREATE DATABASE blogdb OWNER bloguser 建的,owner 天然有权限;如果是用 postgres 建的库、再让应用账号去建表,就必须补上面那句 GRANT。
8.2 权限模型详解
权限是分层授予的,缺任何一层都会失败:
实例级:角色属性(LOGIN / CREATEDB / CREATEROLE / SUPERUSER)
  └─ 库级:CONNECT / TEMPORARY / CREATE
      └─ schema 级:USAGE / CREATE
          └─ 对象级:SELECT / INSERT / UPDATE / DELETE / TRUNCATE / REFERENCES / TRIGGER
-- 只读账号(做报表、只读副本时很有用)
CREATE USER reader WITH PASSWORD 'ReadPass!';
GRANT CONNECT ON DATABASE blogdb TO reader;
GRANT USAGE ON SCHEMA public TO reader;
GRANT SELECT ON ALL TABLES IN SCHEMA public TO reader;
-- 让以后新建的表也自动可读
ALTER DEFAULT PRIVILEGES IN SCHEMA public GRANT SELECT ON TABLES TO reader;

-- 查看权限
\du                                       -- 角色属性
SELECT datname, datacl FROM pg_database WHERE datname = 'blogdb';   -- 库级 ACL
\dp posts                                 -- 表级权限(等价于 \z)

-- 回收权限
REVOKE CREATE ON SCHEMA public FROM PUBLIC;

-- 删除(有依赖时先处理依赖)
DROP DATABASE blogdb;
DROP ROLE bloguser;                       -- 若该角色还拥有对象,需先 DROP OWNED BY
DROP OWNED BY bloguser;
8.3 权限设计建议
- 应用账号只给 CRUD,迁移(DDL)单独用另一个账号。 生产库上跑
migrate时临时提权,跑完降回来。 - 一个应用一个库、一个账号,别多个项目共用一个 role(出问题时无法定位)。
- 不要给应用账号
SUPERUSER。PG 的超级用户能读写任意库、执行任意代码(COPY ... PROGRAM),风险极高。
九、PostgreSQL 能力尝鲜(SQL 小练习)
建一张表,把 MySQL 没有的几种能力都摸一遍:
\c blogdb

CREATE TABLE posts (
    id         bigint GENERATED BY DEFAULT AS IDENTITY PRIMARY KEY,
    title      text NOT NULL,
    body       text,
    tags       text[],                        -- 数组类型
    view_count int DEFAULT 0,
    meta       jsonb DEFAULT '{}'::jsonb,     -- 二进制 JSON,可索引
    published  boolean DEFAULT false,
    created_at timestamptz DEFAULT now()      -- 带时区的时间戳
);

INSERT INTO posts (title, body, tags, meta, published) VALUES
  ('第一篇博客', 'Hello PostgreSQL', ARRAY['pg','blog'], '{"draft": false, "author": "me"}', true),
  ('PostgreSQL 入门', '关于 MVCC',   ARRAY['pg','db'],   '{"draft": true,  "author": "me"}', false),
  ('Linux 小技巧', 'systemd 用法',    ARRAY['linux'],     '{"draft": false, "author": "you"}', true);
JSONB 查询(MySQL 想要同样效果得建生成列 + 索引):
SELECT title, meta->>'author' AS author FROM posts WHERE meta->>'draft' = 'false';
-- 更地道的写法:用 @> 包含操作符,可以走 GIN 索引
SELECT title FROM posts WHERE meta @> '{"draft": false}';

CREATE INDEX idx_posts_meta ON posts USING gin (meta);
数组查询:
SELECT title FROM posts WHERE tags @> ARRAY['pg'];      -- 包含 pg 标签
SELECT title FROM posts WHERE 'linux' = ANY(tags);      -- 等价写法
全文检索(中文建议配合 zhparser / pgroonga 等分词插件):
-- 生成检索向量并用 GIN 索引加速
ALTER TABLE posts ADD COLUMN search_vector tsvector
  GENERATED ALWAYS AS (to_tsvector('english', coalesce(title,'') || ' ' || coalesce(body,''))) STORED;
CREATE INDEX idx_posts_search ON posts USING gin (search_vector);

SELECT title, ts_rank(search_vector, query) AS rank
FROM posts, to_tsquery('english', 'postgresql') query
WHERE search_vector @@ query
ORDER BY rank DESC;

-- 中文无分词插件时,可用 pg_trgm 做模糊匹配兜底
CREATE EXTENSION IF NOT EXISTS pg_trgm;
CREATE INDEX idx_posts_title_trgm ON posts USING gin (title gin_trgm_ops);
SELECT title FROM posts WHERE title LIKE '%数据%';
窗口函数 / CTE(复杂报表利器):
-- 每个作者阅读量排名
SELECT title, meta->>'author' AS author, view_count,
       rank() OVER (PARTITION BY meta->>'author' ORDER BY view_count DESC) AS rk
FROM posts;

-- 递归 CTE:查出 1 到 10
WITH RECURSIVE t(n) AS (
  SELECT 1
  UNION ALL SELECT n + 1 FROM t WHERE n < 10
) SELECT sum(n) FROM t;
UPSERT 与 RETURNING:
INSERT INTO posts (id, title) VALUES (1, '新标题')
ON CONFLICT (id) DO UPDATE SET title = EXCLUDED.title, view_count = posts.view_count + 1
RETURNING id, title, view_count;
十、从 MySQL 过来的对照速查表
10.1 三个心智差异(先接受,再操作)
- 认证机制不同。 PG 本地 socket 默认
peer(拿操作系统用户名当数据库用户名),MySQL 没这概念。 - 用户是全局角色,不是
'user'@'host'。 主机限制统一写在pg_hba.conf。 - 库与 schema 是两层。 MySQL 的 “database” 其实更接近 PG 的 schema;PG 的库之间完全隔离,不能跨库 JOIN。
10.2 命令行对照
| 操作 | MySQL | PostgreSQL |
|---|---|---|
| 进命令行 | mysql -u root -p | sudo -i -u postgres psql |
| 列出数据库 | SHOW DATABASES; | \l |
| 切换数据库 | USE dbname; | \c dbname |
| 列出表 | SHOW TABLES; | \dt |
| 看表结构 | DESC tbl; | \d tbl |
| 列出用户 | SELECT user,host FROM mysql.user; | \du |
| 看活跃连接 | SHOW PROCESSLIST; | SELECT * FROM pg_stat_activity; |
| 看版本 | SELECT VERSION(); | SELECT version(); |
| 看索引 | SHOW INDEX FROM tbl; | \d tbl(底部 Indexes 段) |
| 执行 SQL 文件 | source f.sql; | \i f.sql |
| 竖排显示 | \G | \x |
| 看当前连接 | STATUS; | \conninfo |
| 退出 | exit | \q |
| 备份 | mysqldump -u root -p db > db.sql | pg_dump -Fc -d db -f db.dump |
| 恢复 | mysql -u root -p db < db.sql | pg_restore -d db db.dump |
10.3 DDL 与数据类型对照
| 场景 | MySQL | PostgreSQL |
|---|---|---|
| 自增主键 | INT AUTO_INCREMENT | GENERATED BY DEFAULT AS IDENTITY(推荐)或 bigserial |
| 字符串 | VARCHAR(n) / TEXT | 同样有,PG 的 TEXT 无性能劣势,不必纠结长度 |
| 布尔 | TINYINT(1) | boolean |
| 时间 | DATETIME | timestamp / timestamptz(推荐带时区) |
| 二进制 | BLOB | bytea |
| JSON | JSON | json / jsonb(推荐,可索引) |
| 大整数 | BIGINT | bigint |
| 枚举 | ENUM(...) | 自定义类型或 CHECK 约束 |
| 标识符引号 | 反引号 `col` | 双引号 "col"(字符串才是单引号) |
| 字符串拼接 | CONCAT(a,b) | a || b |
| 分页 | LIMIT 10 OFFSET 20 | 相同 |
| 当前时间 | NOW() | now() |
10.4 四个语法坑
- 双引号不是字符串。
SELECT "name" FROM t在 PG 里是"取名为 name 的列",不是字符串常量。字符串一律单引号。 GROUP BY严格。 SELECT 里出现的非聚合列必须进GROUP BY,MySQL 的宽松模式在这里会直接报错。- 几乎没有隐式类型转换。
WHERE id = '123'可能报类型不匹配;ORM 传参时要留意。 - 标识符默认折叠成小写。
CREATE TABLE BlogPost建出来是blogpost;查询写BlogPost也能命中(同样被折叠),但统一小写命名最省心。 - 中文排序:排序规则由
initdb时的lc_collate决定,事后改不了。需要中文按拼音排序要在建库时指定 collation,否则只能重建库。
十一、远程连接与安全加固
数据库如果在云上,安全是四层叠加的。任意一层没配好会"连不上",任意一层放太开会"被连上":
客户端 → ① 云厂商安全组 → ② 云主机 firewalld → ③ PostgreSQL listen_addresses → ④ pg_hba.conf
11.1 方案 A:SSH 隧道(强烈推荐)
数据库保持只监听 localhost,一个端口都不用对外开。
# 在你自己的电脑上执行
ssh -N -L 55432:127.0.0.1:5432 your_user@你的云主机IP
# 加 -f 可后台运行:ssh -f -N -L 55432:127.0.0.1:5432 your_user@IP
然后像连本地库一样连接:
psql -h 127.0.0.1 -p 55432 -U bloguser -d blogdb
DBeaver / Navicat / pgAdmin 同理:主机 127.0.0.1、端口 55432。
- 优点:全程 SSH 加密,5432 完全不暴露,零防火墙改动。
- 缺点:每次要建隧道,SSH 断开连接就断(可用
autossh保活)。
11.2 方案 B:开放 5432,IP 限制交给安全组
如果倾向于"云主机内部防火墙放通、只在安全组限 IP"(管理成本最低的常见做法),四层这样配:
① PostgreSQL 监听
sudo vi /var/lib/pgsql/15/data/postgresql.conf
listen_addresses = '*'          # 改完必须 restart
② pg_hba.conf(第二道防线)
sudo vi /var/lib/pgsql/15/data/pg_hba.conf
# 只放行自己的公网出口 IP,不要写 0.0.0.0/0
host    all    all    你的公网IP/32    scram-sha-256
改完 sudo systemctl reload postgresql-15。
③ 云主机内部防火墙
# 只放通需要的端口(推荐)
sudo firewall-cmd --permanent --add-port=5432/tcp
sudo firewall-cmd --permanent --add-service=http
sudo firewall-cmd --permanent --add-service=https
sudo firewall-cmd --reload
sudo firewall-cmd --list-all
④ 云厂商安全组(真正的边界)
入方向:TCP 5432,来源填你的公网 IP/32(家宽 IP 会变,可填小网段,或配合跳板机)。
11.3 方案 B 的风险,说清楚
- 安全组是唯一边界。一旦被误删、临时改成
0.0.0.0/0忘记改回,数据库就直接裸奔在公网。 - 同 VPC 内的其它主机可能仍然可达,安全组对内网流量不一定生效。
- 建议做法:安全组限 IP 为主防线,
pg_hba.conf里也写具体 IP 做第二道。两层都写死,成本几乎为零,却能防住"改错一层就裸奔"。无论如何pg_hba.conf至少保留scram-sha-256,绝不要写trust。
11.4 SELinux 的隐藏影响
CentOS 7 上,只要数据目录用默认的 /var/lib/pgsql/15/data,SELinux 一般不会拦。但如果把数据目录挪到自定义路径(如 /data/pg),就会被拦住,表现为启动失败或权限错误。
排查时临时关闭确认:
sudo setenforce 0        # 临时(重启失效)
getenforce
确认是 SELinux 问题后,应写策略放行,而不是长期关闭:
sudo semanage fcontext -a -t postgresql_db_t "/data/pg(/.*)?"
sudo restorecon -Rv /data/pg
11.5 连不上时的三层定位法
# ① 服务有没有在听
sudo ss -lntp | grep 5432                    # 空 → listen_addresses 或服务未起
# ② 服务端放不放行
grep -vE '^\s*#|^\s*$' /var/lib/pgsql/15/data/pg_hba.conf
# ③ 网络通不通(从客户端测)
nc -zv 云主机IP 5432                          # 超时 → 安全组 / firewalld
十二、Django 接入示例
12.1 安装驱动
pip install psycopg2-binary        # 含预编译 so,最省事
# 或 psycopg3(Django 4.2+ 支持,异步更友好)
pip install "psycopg[binary]"
生产环境想自己编译用
pip install psycopg2,需要postgresql15-devel+gcc+python3-devel。个人项目直接psycopg2-binary即可。
12.2 settings.py
import os

DATABASES = {
    'default': {
        'ENGINE': 'django.db.backends.postgresql',
        'NAME': 'blogdb',
        'USER': 'bloguser',
        'PASSWORD': os.environ['DB_PASSWORD'],   # 别硬编码
        'HOST': '127.0.0.1',        # 同机别写 localhost(会走 unix socket,行为不同)
        'PORT': '5432',
        'CONN_MAX_AGE': 60,         # 连接复用,小机器上效果明显
        'OPTIONS': {'connect_timeout': 5},
    }
}
验证全链路:
python manage.py makemigrations
python manage.py migrate
python manage.py dbshell          # 能进 psql 即通
12.3 为什么 PG 与 Django 是加成项
除了全文检索和 JSONB,真正落到 Django 代码里的优势:
| PG 能力 | Django 侧对应 |
|---|---|
tsvector + GIN 索引 | django.contrib.postgres.search(SearchVector、SearchRank),不用引 Elasticsearch |
jsonb + GIN | models.JSONField,.filter(meta__draft=False) 直接查嵌套字段 |
| 数组类型 | ArrayField,标签场景省掉一张关联表 |
| 窗口函数、CTE、物化视图 | ORM 支持度最高的数据库后端 |
| 部分索引、表达式索引 | UniqueConstraint(condition=...)、Index(condition=...) |
| 事务性 DDL | migrate 失败能真正回滚,迁移更安全 |
| 扩展(pg_trgm、pgvector) | 一个 migration 里 CREATE EXTENSION 即可启用 |
timestamptz | USE_TZ=True 行为一致,不踩时区坑 |
一句话:Django 的许多高级功能其实是按 PostgreSQL 的能力设计的(django.contrib.postgres 整个模块就是明证)。同机部署、1~2G 内存的小机器上,PG 与 MySQL 的资源开销没有量级差异,没理由放弃这些能力。
十三、日志与故障排查
13.1 三种日志,别找错地方
# ① 数据库自身日志(PGDG RPM 默认 logging_collector=on)
sudo ls -l /var/lib/pgsql/15/data/log/
sudo tail -f /var/lib/pgsql/15/data/log/postgresql-*.log

# ② systemd 服务日志
sudo journalctl -u postgresql-15 -f
sudo journalctl -u postgresql-15 --since "10 min ago"

# ③ 服务日志为空时的兜底(前台启动,直接看输出)
sudo -u postgres /usr/pgsql-15/bin/pg_ctl -D /var/lib/pgsql/15/data start
路径不确定就问数据库:
sudo -u postgres psql -c "SHOW data_directory;"
sudo -u postgres psql -c "SHOW log_directory;"
13.2 值得打开的日志项
# /var/lib/pgsql/15/data/postgresql.conf(改完 reload)
logging_collector = on
log_directory = 'log'
log_filename = 'postgresql-%Y-%m-%d.log'
log_rotation_age = 1d
log_min_duration_statement = 1000   # 慢查询阈值(ms),0=记录全部,-1=关闭
log_connections = on                # 排查连接问题时开启,平时可关
log_disconnections = on
log_lock_waits = on                 # 锁等待,死锁排查利器
log_temp_files = 0                  # 记录落盘的临时文件(排序内存不够时)
log_checkpoints = on
log_error_verbosity = default       # 排错时可临时设为 verbose
13.3 慢查询统计
CREATE EXTENSION IF NOT EXISTS pg_stat_statements;
SELECT calls,
       round(total_exec_time::numeric, 1) AS total_ms,
       round(mean_exec_time::numeric, 2) AS avg_ms,
       left(query, 80) AS query
FROM pg_stat_statements
ORDER BY total_exec_time DESC
LIMIT 10;
需要在 postgresql.conf 里加 shared_preload_libraries = 'pg_stat_statements'(该参数必须 restart 才生效)。
13.4 一条查询卡住了
SELECT pid, usename, datname, state, wait_event_type, wait_event,
       now() - query_start AS duration, left(query, 60) AS query
FROM pg_stat_activity
WHERE state <> 'idle'
ORDER BY duration DESC;

SELECT pg_cancel_backend(<pid>);      -- 温和:取消当前查询
SELECT pg_terminate_backend(<pid>);   -- 强硬:断开该连接
十四、备份、恢复与定时备份
14.1 三种备份方式
sudo mkdir -p /var/backups/pg

# ① 单库,自定义格式(推荐:可压缩、可选择性恢复、可并行)
sudo -u postgres pg_dump -Fc -d blogdb -f /var/backups/pg/blogdb_$(date +%F).dump

# ② 单库,plain SQL(跨版本迁移、想手改内容时用)
sudo -u postgres pg_dump -d blogdb -f /var/backups/pg/blogdb_$(date +%F).sql

# ③ 角色与全局对象(pg_dump 不包含角色定义!务必单独备份)
sudo -u postgres pg_dumpall --globals-only -f /var/backups/pg/globals_$(date +%F).sql

# 全集群
sudo -u postgres pg_dumpall -f /var/backups/pg/all_$(date +%F).sql
三种方式的取舍:
| 方式 | 优点 | 缺点 | 适用 |
|---|---|---|---|
pg_dump -Fc | 可压缩、可按对象恢复、pg_restore -j 并行 | 不能直接看内容 | 日常备份首选 |
pg_dump plain | 纯文本可读可改、跨版本能力强 | 恢复慢、体积大 | 小库、跨版本迁移 |
| 文件系统 + WAL 归档(PITR) | 可恢复到任意时间点 | 配置复杂 | 生产关键库 |
14.2 恢复
# 自定义格式 → 需先有空库
sudo -u postgres createdb blogdb_restore
sudo -u postgres pg_restore -d blogdb_restore --clean --if-exists /var/backups/pg/blogdb_2026-09-28.dump

# 连建库一起恢复(-C 表示 dump 中带 CREATE DATABASE,因此连到 postgres 库执行)
sudo -u postgres pg_restore -C -d postgres /var/backups/pg/blogdb_2026-09-28.dump

# plain SQL
sudo -u postgres psql -d blogdb_restore -f /var/backups/pg/blogdb_2026-09-28.sql
⚠️ 没演练过的备份等于没备份。 至少做一次:备份 → 恢复到另一个库 → 核对行数 → 删掉。真出事时你不会想现学
pg_restore的参数。
14.3 每日自动备份脚本
sudo mkdir -p /var/backups/pg
sudo tee /usr/local/bin/pg_backup.sh > /dev/null <<'EOF'
#!/usr/bin/env bash
set -euo pipefail

DATE=$(date +%F_%H%M)
DIR=/var/backups/pg
KEEP_DAYS=14

mkdir -p "$DIR"
# 单库(自定义格式)
sudo -u postgres pg_dump -Fc -d blogdb -f "$DIR/blogdb_${DATE}.dump"
# 角色与全局对象(pg_dump 不含,必须单独备份)
sudo -u postgres pg_dumpall --globals-only -f "$DIR/globals_${DATE}.sql"
# 清理过期备份
find "$DIR" -name "*.dump" -mtime +${KEEP_DAYS} -delete
find "$DIR" -name "*.sql"  -mtime +${KEEP_DAYS} -delete
echo "$(date '+%F %T') backup ok: blogdb_${DATE}.dump"
EOF

sudo chmod +x /usr/local/bin/pg_backup.sh
挂到 crontab(每天凌晨 3 点):
sudo crontab -e
0 3 * * * /usr/local/bin/pg_backup.sh >> /var/log/pg_backup.log 2>&1
注意点:
- 脚本里用
sudo -u postgres走 peer 认证,不要把PGPASSWORD明文写进 crontab;确实需要时用~/.pgpass(权限必须600)。 - 备份别和数据目录放同一块盘。云主机建议挂一块便宜的额外盘,或用
rclone/s3cmd同步到对象存储。 - 日常体检:
pg_restore -l xxx.dump只列出内容、不真恢复,用来验证备份文件完好。
十五、小内存云主机调优参考
/var/lib/pgsql/15/data/postgresql.conf,按内存对号入座(改完 restart):
| 参数 | 1 GB 内存 | 2 GB 内存 | 说明 |
|---|---|---|---|
shared_buffers | 128MB | 256MB | 经验值:物理内存的 25% |
effective_cache_size | 512MB | 1GB | 不实际分配内存,是给优化器的"OS 缓存有多少"提示,取 50%~75% |
work_mem | 8MB | 16MB | 每个排序/哈希操作都能用,会乘以并发数,别贪大 |
maintenance_work_mem | 64MB | 128MB | VACUUM / CREATE INDEX 用 |
max_connections | 50 | 100 | 博客根本用不到 100;配了连接池可以更小 |
wal_level | replica | replica | 不做主从就保持默认 |
checkpoint_completion_target | 0.9 | 0.9 | 平滑刷盘,减少 I/O 抖动 |
random_page_cost | 1.1 | 1.1 | SSD 云盘一定要调,默认 4.0 是按机械盘设的 |
配套建议:
- 小机器上最有效的优化往往是减少连接数:Django 设
CONN_MAX_AGE,或前面挂 PgBouncer。PG 每个连接一个进程,100 个连接就是 100 个进程。 autovacuum不要关。博客表小,它几乎不吃资源,关了表会膨胀。- 调完验证:
EXPLAIN (ANALYZE, BUFFERS) SELECT ...看真实执行计划和缓存命中。
十六、常见故障速查表
| 报错 / 现象 | 根因 | 修复 |
|---|---|---|
HTTPS Error 410 - Gone | 该版本的 EL7 仓库已被摘除 | 禁用对应子仓,只保留目标版本(见 4.3) |
Requires: libzstd >= 1.4.0 | CentOS 7 基础源无此包,PG 15 硬依赖 | 通过 EPEL 或手动 rpm 安装(见 4.4),别用 --skip-broken |
No package libzstd available | 未启用 EPEL | yum install -y epel-release 后重试 |
psql: command not found | 客户端不在 PATH | /usr/pgsql-15/bin/psql,或 export PATH=$PATH:/usr/pgsql-15/bin |
could not connect ... Connection refused | 未启动 / 未监听该地址 | systemctl status;查 listen_addresses;ss -lntp | grep 5432 |
no pg_hba.conf entry for host ... | 未放行来源 IP | 在 pg_hba.conf 加规则后 systemctl reload |
password authentication failed for user | 密码错 / 认证方式不匹配 | 确认 scram-sha-256;改过 password_encryption 需重设密码 |
Peer authentication failed for user "xxx" | TCP 走成了 peer,或反之 | 本地 socket → peer;TCP → scram-sha-256;或用 sudo -u postgres psql |
permission denied for schema public | PG 15 收紧 public 权限 | GRANT USAGE, CREATE ON SCHEMA public TO bloguser; |
role "root" does not exist | 以 root 直接 psql | sudo -u postgres psql,或建同名 role |
FATAL: database "blogdb" does not exist | 库名拼错 / 大小写 | \l 核对;未加双引号的标识符都折叠为小写 |
启动报 could not create lock file / 权限错误 | 数据目录属主不对 | chown -R postgres:postgres <datadir>,权限 0700 |
| 日志时间比北京时间差 12/13 小时 | 系统时区不对 | timedatectl set-timezone Asia/Shanghai |
| 改了配置不生效 | restart / reload 混淆 | SELECT name, context FROM pg_settings WHERE name='xxx';(postmaster=需重启,sighup=reload 即可) |
| 忘记 postgres 密码 | — | pg_hba.conf 临时改 trust → reload → ALTER USER → 改回并 reload |
排查口诀:先看 systemctl status,再 ss -lntp,再 pg_hba.conf,最后 tail 日志。九成问题在这四步内现形。
十七、上线收尾 checklist
装完别急着写业务代码,照着过一遍:
- 服务开机自启:
systemctl is-enabled postgresql-15→enabled - 系统时区与数据库时区均为
Asia/Shanghai - 库编码为 UTF8(
\l的 Encoding 列) - 应用有独立账号,没有拿
postgres连库 -
listen_addresses按方案明确设置,不是"默认值就上线" -
pg_hba.conf中没有trust、没有0.0.0.0/0 - 安全组只放行了自己的 IP(方案 B)
-
pg_dump能跑通,且做过一次真实恢复演练 - crontab 每日备份已挂上,日志有输出
-
shared_buffers/random_page_cost已按 SSD 调整 - 清楚数据目录、配置文件、日志目录三个路径
附:一页纸命令卡
# —— 安装(CentOS 7 + PGDG)——
sudo yum install -y https://download.postgresql.org/pub/repos/yum/reporpms/EL-7-x86_64/pgdg-redhat-repo-latest.noarch.rpm
sudo yum-config-manager --disable pgdg12 pgdg13 pgdg16 pgdg17 pgdg18
sudo yum install -y epel-release libzstd
sudo yum install -y postgresql15-server postgresql15 postgresql15-contrib
sudo /usr/pgsql-15/bin/postgresql-15-setup initdb
sudo systemctl enable --now postgresql-15

# —— 日常 ——
sudo -i -u postgres psql                    # 登录
\l  \c db  \dt  \d tbl  \du  \x  \q        # 元命令
sudo systemctl reload postgresql-15         # 改了 pg_hba
sudo tail -f /var/lib/pgsql/15/data/log/*.log

# —— 建库授权 ——
CREATE USER bloguser WITH PASSWORD 'xxx';
CREATE DATABASE blogdb OWNER bloguser;
\c blogdb
GRANT USAGE, CREATE ON SCHEMA public TO bloguser;

# —— 备份 ——
sudo -u postgres pg_dump -Fc -d blogdb -f blogdb_$(date +%F).dump
sudo -u postgres pg_dumpall --globals-only -f globals_$(date +%F).sql

# —— openEuler 24.03 ——
sudo dnf install -y postgresql-17-server postgresql-17 postgresql-17-contrib
sudo /usr/bin/postgresql-setup --initdb --unit postgresql17
sudo systemctl enable --now postgresql17
写在最后
PostgreSQL 的学习曲线比 MySQL 陡一点 —— 三层结构、pg_hba.conf、MVCC 与 VACUUM、角色与权限分层,这些都是要跨过去的门槛。但跨过去之后你会发现:以前需要引 Elasticsearch、MongoDB、Redis 才能做的事,现在一个数据库就够了。
而对于在 CentOS 7 这类 EOL 系统上部署,记住一点:失败往往不是你敲错了命令,而是生态已经往前走了。PGDG 不再为 EL7 出包、libzstd 不在基础源里、旧版本仓库返回 410 —— 这些都是时代留下的痕迹。老机器停在 PG 15 是合理的终点;真想要 PG 17 的原生体验,把系统换成 openEuler 24.03 或 Rocky 9,比在 EOL 系统上打补丁轻松得多。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)