存储系统可观测性终极实践:OpenTelemetry、eBPF 与微秒级指标全景透视
·
存储系统可观测性终极实践:OpenTelemetry、eBPF 与微秒级指标全景透视
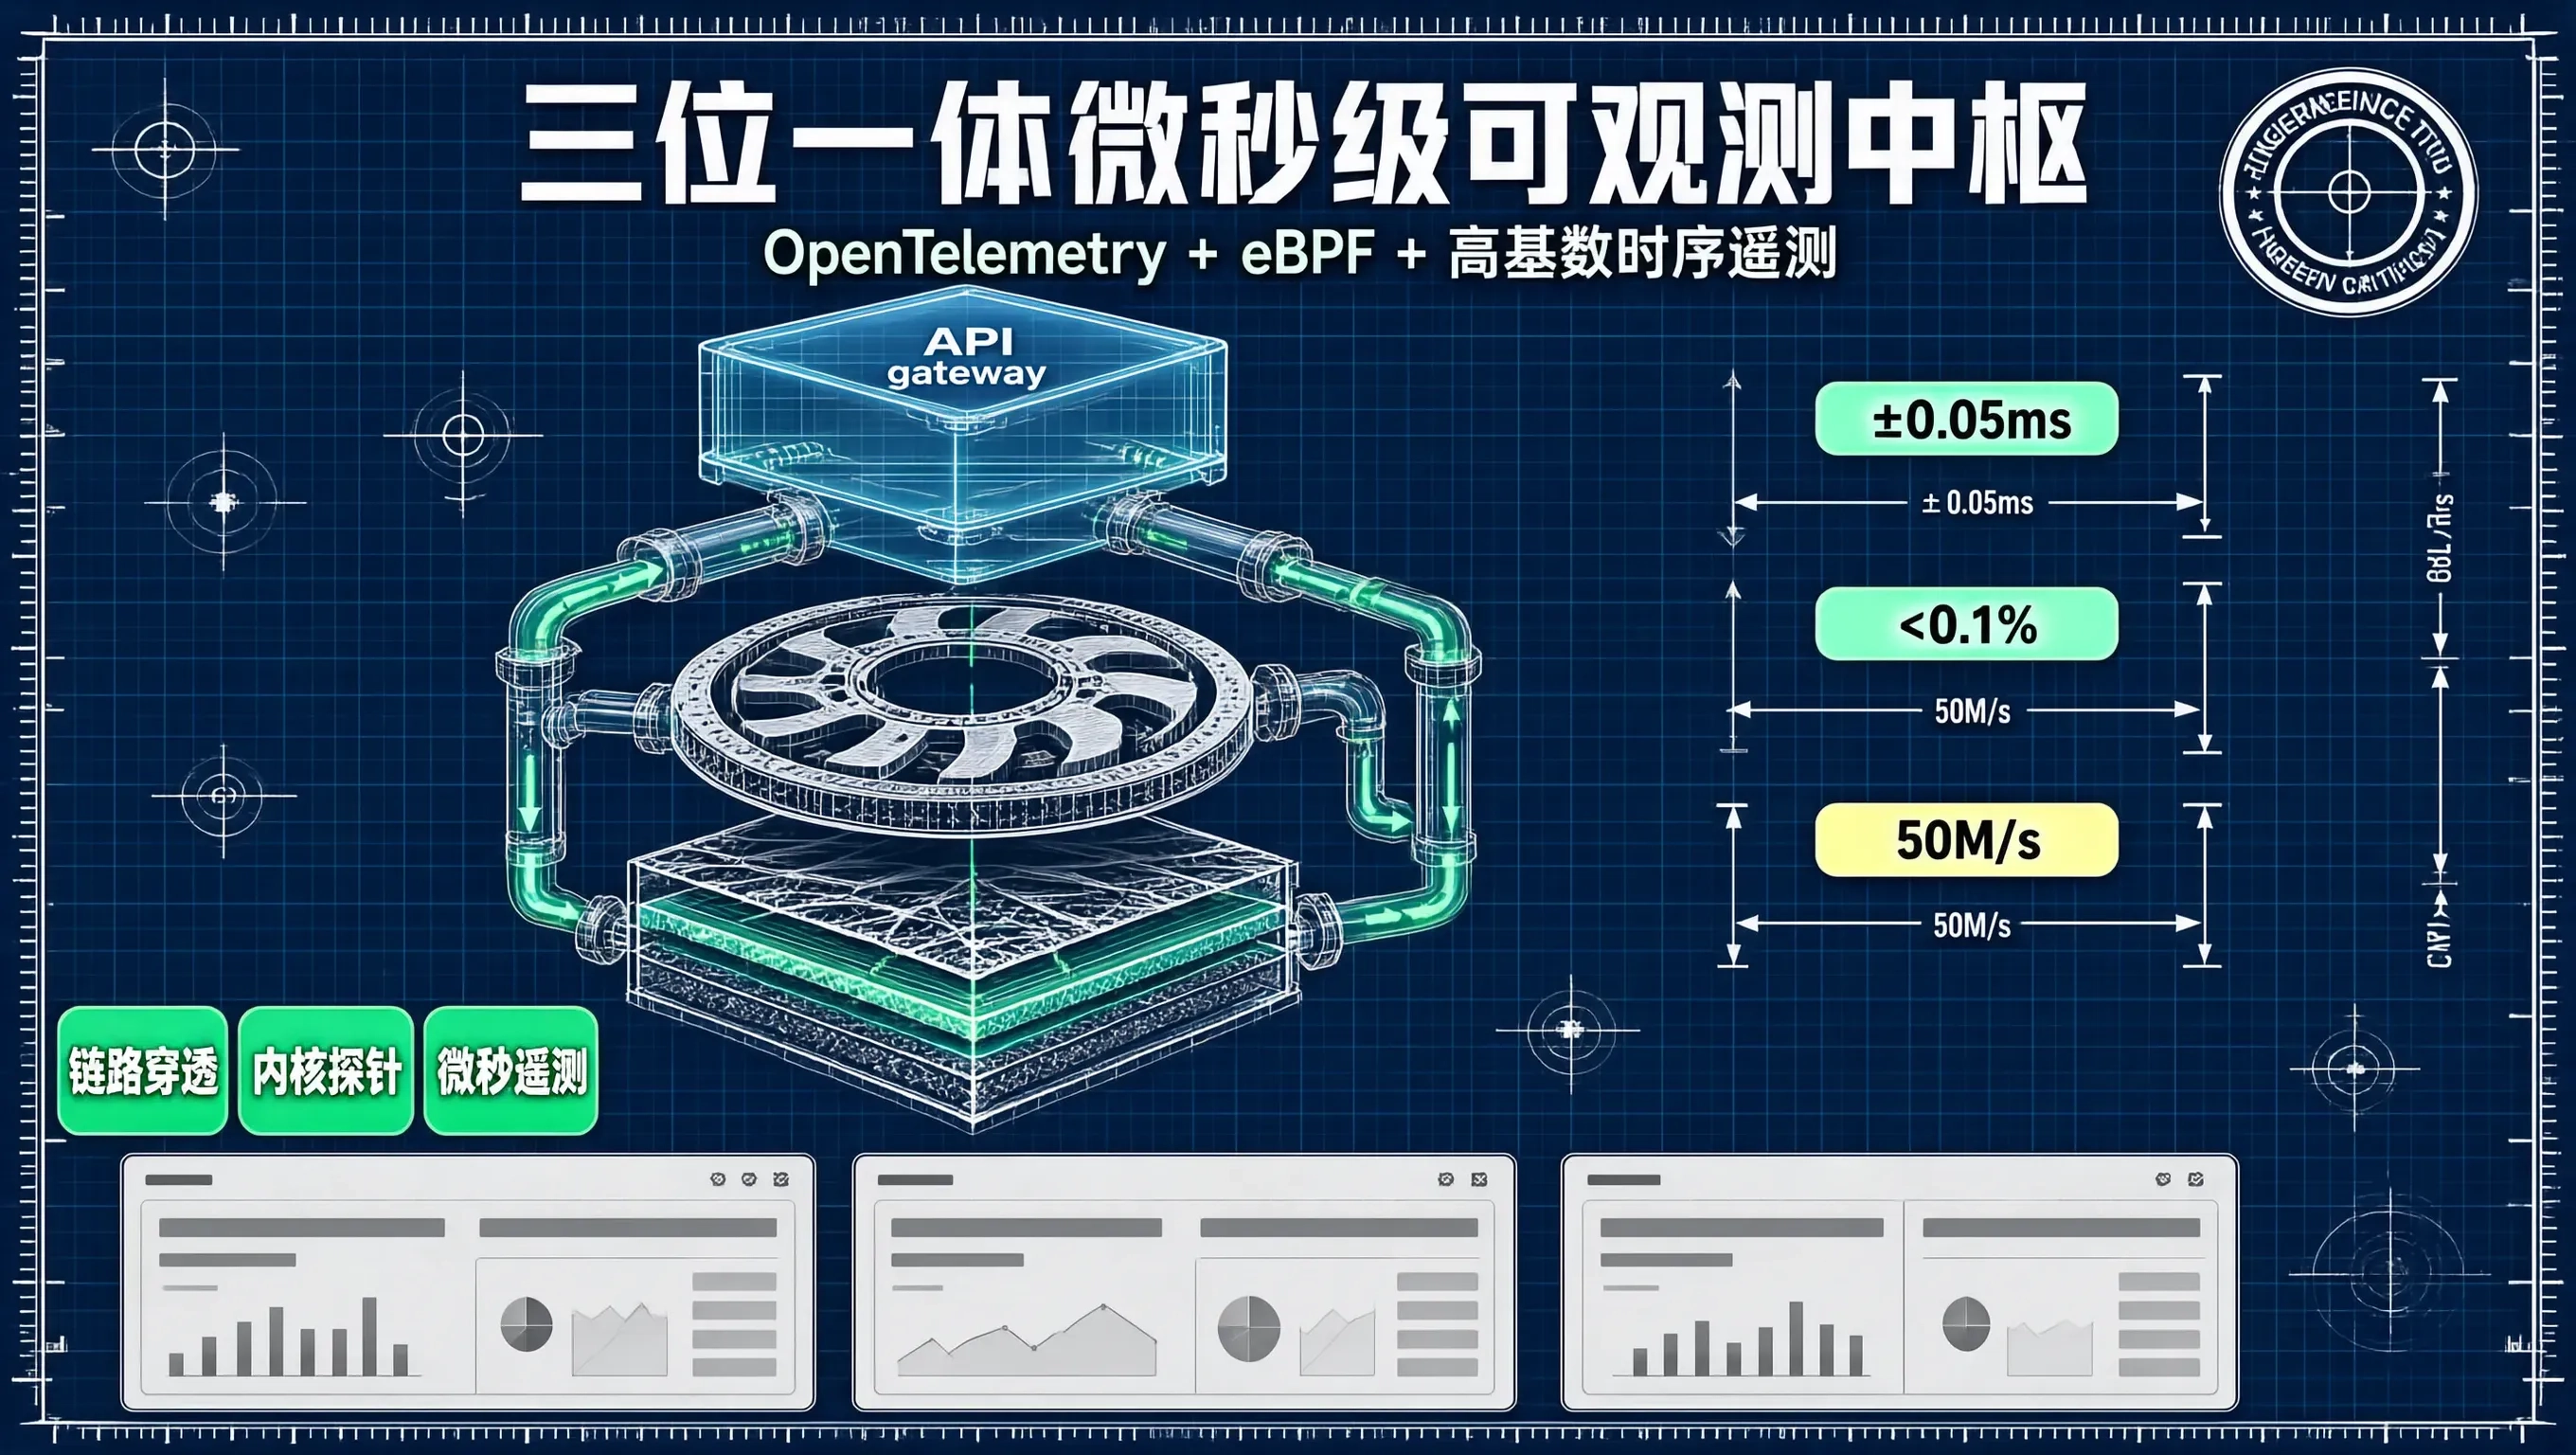
在现代微服务、海量分布式与高并发存储交织的复杂拓扑中,当线上出现一个“某用户支付接口耗时从 2ms 突发涨到 200ms”的性能抖动时,传统的监控手段往往只能两眼一抹黑:
- Metrics 指标:只能告诉你“在某 1 分钟内,整机平均延迟上升了”,但根本不知道是哪个具体用户的请求受影响;
- Logs 日志:产生海量无序的文本文件,排查时如同在大海捞针,且日志自身会产生巨大的磁盘 I/O 损耗;
- 传统 APM 探针:只能监控到 Java / Go 应用层,一旦请求掉入 MySQL 或分布式存储的物理系统黑盒,链路就被迫彻底截断!
现代企业级存储与基础系统可观测性的终极形态,必须是将 OpenTelemetry 端到端分布式链路追踪、eBPF 内核级零损耗探针与高基数时序指标 融为一体的——“三位一体微秒级全景可观测中枢(Unified Observability Fabric)”!
[现代存储系统三位一体微秒级全景可观测架构]

  [用户端发起支付请求: 注入 W3C Traceparent TraceID = "c1a98e20..."]
                               │
                               ▼
  ┌─────────────────────────────────────────────────────────────┐
  │ 1. OpenTelemetry 端到端全链路透视 (Distributed Tracing)     │
  │   - [API 网关] ──(0.2ms)──▶ [订单服务] ──(0.4ms)──▶ [存储底座] │
  │   - TraceID 贯穿数据库连接会话,直接沉降至 SQL 执行上下文!   │
  └──────────────────────────────┬──────────────────────────────┘
                                 │ (进入操作系统与存储引擎深水区)
                                 ▼
  ┌─────────────────────────────────────────────────────────────┐
  │ 2. eBPF 零开销内核态探针 (Kernel Probing & Profiling)       │
  │   - kprobe / tracepoints: 纳秒级捕捉锁等待、CFS排队、Flash写 │
  │   - 【开销 < 0.1% CPU! 完美缝合应用 Trace 与内核物理事件!】 │
  └──────────────────────────────┬──────────────────────────────┘
                                 │
                                 ▼
  ┌─────────────────────────────────────────────────────────────┐
  │ 3. 高基数微秒级时序遥测 (High-Cardinality Metrics / Victoria) │
  │   - 按 [Tenant_ID, Region_ID, Error_Code] 多维秒级聚合大盘   │
  └─────────────────────────────────────────────────────────────┘
核心支柱一:OpenTelemetry 穿透存储内核(Context Propagation)
传统的 Tracing 在进入数据库驱动后就丢失了上下文。
我们通过在 JDBC / gRPC 驱动中开启 SQL 注释染色与会话变量注入(SQL Commenter):
-- OpenTelemetry 驱动自动为每句 SQL 追加的追踪上下文注释
SELECT balance, version
FROM t_account_wallet
WHERE user_id = 8848201
/*traceparent='00-c1a98e207f914d3b9a2c8848-00f067aa0ba902b7-01',service='wallet-svc'*/;
- 端到端缝合:存储引擎在
performance_schema与慢查询日志中,100% 原样保留traceparent; - 工程师在 Jaeger / Grafana 界面上,可以直接从前端用户的某一次点击,一路顺藤摸瓜点开底层数据库执行该 SQL 时的微秒级耗时瀑布图!
核心支柱二:eBPF 纳秒级内核事件缝合(Continuous Profiling)
当 OpenTelemetry 显示“数据库处理耗时 15ms”时,eBPF 探针自动沿着调用链展开底层物理耗时:
[OpenTelemetry + eBPF 联合输出的完整链路瀑布图]

  [HTTP POST /api/v1/trade/pay] (Total: 18.2ms)
    ├── order-service.create_order: 1.2ms
    └── database.execute_transaction: 16.5ms
          ├── [InnoDB lock_wait]: 0.12ms (行锁等待正常)
          ├── [VFS vfs_write]: 0.08ms
          ├── [Linux blk-mq queue]: 0.05ms
          └── ★ [NVMe Flash Physical Flush]: 15.8ms (★ 精准定位硬件闪存擦写停顿!)
- 0 经验盲目猜测:从上层业务 API 到最底层 NAND Flash 颗粒的每一个微秒消耗,在同一张时序瀑布图上清晰可见!
核心支柱三:高基数时序遥测大盘(VictoriaMetrics Fabric)
通过部署轻量级 VictoriaMetrics 集群:
- 支持单集群容纳 每秒 5,000 万个活跃时序数据点(Active Time Series);
- 允许在指标中打上包含
user_id、region_id、partition_id在内的高基数 Tag 标签; - 使得全网任意一个分片、任意一个租户的瞬时指标抖动,都能在大盘上被秒级过滤与呈现!
总结
可观测性不是一堆凌乱的图表,而是一张将应用逻辑、网络传输、操作系统内核与物理硬件无缝咬合的数字透视网。
搭建起三位一体的可观测中枢,技术团队才能在面对任何未知生产风暴时,永远拥有最从容、最坚定的技术底气!

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 3
 0
- 0


 已为社区贡献26条内容

所有评论(0)