GO [ 并发 · 调度器 ]
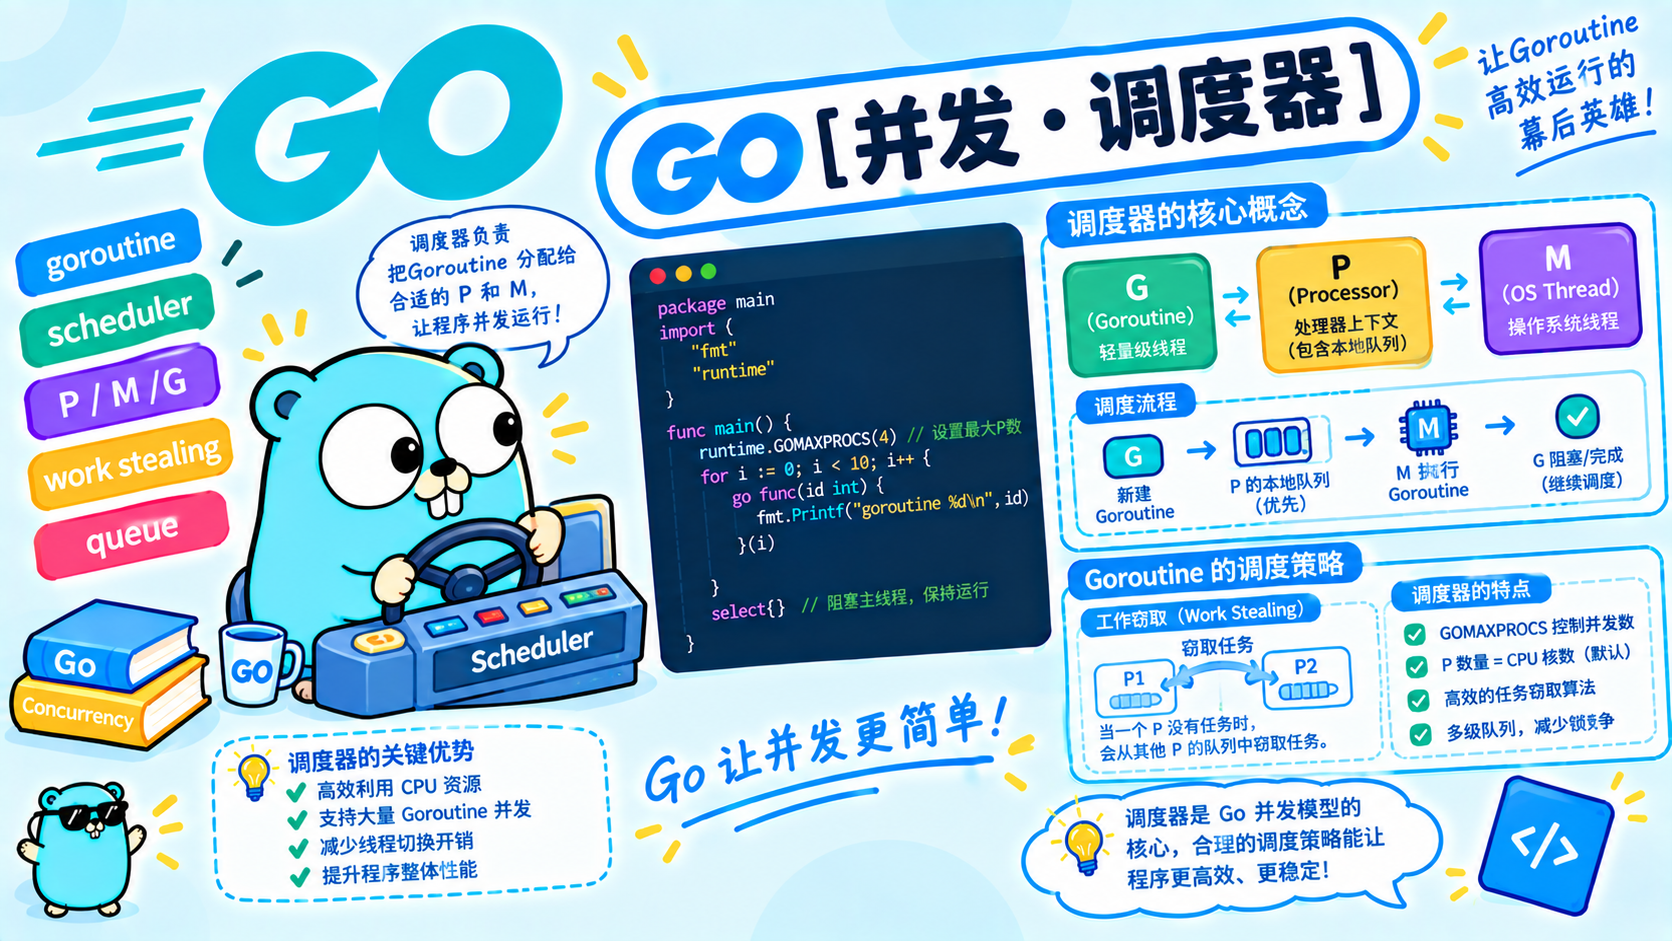
上一篇我们已经学习了 goroutine、channel、select、WaitGroup、Context、Mutex、RWMutex、Cond 和 atomic。现在有一个更底层的问题:
go func() { ... }()
这行代码到底是怎样被执行起来的?一个进程里明明可以有成千上万个 goroutine,操作系统线程却没有那么多,Go 运行时是如何把它们安排到 CPU 上的?当 goroutine 等待 channel、网络 I/O 或锁时,为什么不会把整个程序卡住?
这些问题属于 Go runtime scheduler,也就是 Go 运行时调度器。学习调度器不是为了在业务代码里手动操作它,而是为了知道并发程序的成本来自哪里:goroutine 创建并不等于 CPU 并行,阻塞不一定是坏事,GOMAXPROCS 也不是“启动多少 goroutine”的参数。
按照 Go 官方 runtime 内部文档 HACKING.md 的定义,调度器管理三类核心资源:
- G(Goroutine):要执行的 Go 代码;
- M(Machine):可以执行 Go 代码的操作系统线程;
- P(Processor):执行用户 Go 代码所需要的资源和权限。
调度器的任务可以概括成一句话:把一个可以运行的 G,放到拥有 P 的 M 上执行。
本篇按照“G/M/P → goroutine 创建 → 运行队列 → 工作窃取 → 阻塞与唤醒 → 系统调用和 netpoll → 抢占 → 实际观测”的顺序展开。每一个概念都尽量用可以复制运行的代码验证。
本文代码在 Go 1.27.0 darwin/arm64 环境中实际运行。调度器输出会随 CPU 数量、操作系统和 Go 版本变化,示例日志只展示结构,不应当把具体数字当成固定协议。
G、M、P 分别是什么
G:goroutine 的运行载体
G 就是一个 goroutine。它保存函数入口、栈、程序计数器、状态和调度现场等信息。
启动一个 goroutine 时,Go 编译器会把 go 语句转换成运行时调用。运行时创建或复用一个 G,把它放到可运行队列,然后由调度器在合适的时刻执行。
从业务代码看,G 的生命周期可以简化成:
创建 → 可运行 → 运行中 → 阻塞/等待 → 再次可运行 → 运行结束
G 阻塞时不会占用一个正在执行用户代码的 P。比如下面的 goroutine 在等待 channel:
package main

import (
	"fmt"
	"time"
)

func main() {
	ready := make(chan struct{})

	go func() {
		fmt.Println("worker waits")
		<-ready
		fmt.Println("worker wakes")
	}()

	time.Sleep(20 * time.Millisecond)
	fmt.Println("main sends wake signal")
	close(ready)
	time.Sleep(20 * time.Millisecond)
}
worker 等待期间,调度器可以让其他 goroutine 使用 CPU。这里的“等待”不是忙循环,而是把当前 G 挂起,等 channel 关闭后再标记为可运行。
M:操作系统线程
M 是 operating system thread。它可以执行用户 Go 代码,也可能进入系统调用、执行 runtime 代码,或者处于空闲状态。
M 的数量不一定等于 P 的数量。一个 M 进入阻塞系统调用时,运行时会尽量把它持有的 P 交给其他 M,让其他 G 继续执行;系统调用返回后,原来的 M 可能重新获得 P,也可能因为没有空闲 P 而等待。
可以用下面的程序制造一些系统调用和 Go 代码混合执行的场景:
package main

import (
	"fmt"
	"os"
	"runtime"
	"sync"
	"time"
)

func main() {
	runtime.GOMAXPROCS(2)
	var wg sync.WaitGroup

	wg.Add(2)
	go func() {
		defer wg.Done()
		file, err := os.CreateTemp("", "scheduler-demo-*")
		if err != nil {
			return
		}
		defer os.Remove(file.Name())
		defer file.Close()
		_, _ = file.WriteString("hello")
		fmt.Println("syscall-like file work finished")
	}()

	go func() {
		defer wg.Done()
		for i := 0; i < 3; i++ {
			fmt.Println("go work", i)
			time.Sleep(5 * time.Millisecond)
		}
	}()

	wg.Wait()
}
这里不能从输出顺序反推出具体 M 的调度顺序。runtime 会根据系统调用、P 是否空闲、队列中是否有 G 等条件做动态决策。
P:执行 Go 代码的资源
P 不是 CPU 核心,也不是操作系统线程。它代表执行用户 Go 代码所需要的资源,例如本地可运行队列、内存分配器状态和调度相关状态。
P 的数量等于 GOMAXPROCS。如果 GOMAXPROCS=4,最多同时有 4 个 P 执行用户 Go 代码;每个 P 通常需要绑定一个 M 才能运行。
previous := runtime.GOMAXPROCS(2)
defer runtime.GOMAXPROCS(previous)
不要把 GOMAXPROCS(2) 理解成“程序最多只能启动两个 goroutine”。它只限制同一时刻能够并行执行用户 Go 代码的 P 数量,goroutine 数量可以远大于 2。
官方 runtime 文档对三者关系的描述可以画成下面这样:
          可运行的 G
        ┌─────────────┐
        │ G1 G2 G3 G4 │
        └──────┬──────┘
               │ 调度
      ┌────────▼────────┐
      │       P         │  执行 Go 代码所需的资源
      └────────┬────────┘
               │ 绑定
      ┌────────▼────────┐
      │       M         │  OS thread
      └────────┬────────┘
               │
              CPU
goroutine 创建以后去了哪里
从 go 语句到可运行队列
下面的代码:
go work(10)
在语义上做了三件事:
- 在当前 goroutine 中计算函数值和参数;
- 创建一个新的 goroutine 描述对象 G;
- 把 G 标记为 runnable,放入调度器可以找到的运行队列。
函数参数在调用方求值这一点很重要:
value := expensiveInput()
go work(value)
expensiveInput() 并不会自动在新 goroutine 中执行。只有 work(value) 的函数体属于新 goroutine。
本地队列和全局队列
每一个 P 都有一个本地 runnable queue,用来保存准备在这个 P 上运行的 G。运行时还维护一个全局队列,用于在本地队列之间转移工作。
简化后的结构如下:
P0: [G1 G2 G3]       P1: [G4 G5]
       │                    │
       └───────┬────────────┘
               │ 本地队列不足时寻找工作
        Global run queue: [G6 G7 ...]
当前 P 创建出的新 G,通常会优先放到自己的本地队列。这样做可以减少所有 goroutine 都竞争一个全局锁的成本。
本地队列容量和具体数据结构属于 runtime 实现细节。Go 1.27 的 runtime/proc.go 中可以看到 runqput、runqget、runqgrab 和 runqsteal 等函数。业务代码不应该依赖这些未导出的名字,但理解它们有助于解释为什么调度器能在大量 goroutine 下工作。
runnext:让刚唤醒的工作尽快运行
P 还存在一个 runnext 概念,用于保存一个倾向于快速运行的 G。它可以让通信双方在生产者刚发送数据后,接收者更快得到调度,减少一轮完整队列扫描的延迟。
这不是“严格的优先级队列”。runtime 仍然需要防止某个 goroutine 对长期运行的 goroutine 造成饥饿,并且在 race 模式下会引入调度随机化来暴露依赖固定顺序的测试。
工作窃取:空闲 P 如何找到工作
如果 P0 的本地队列为空,但 P1 还有很多可运行 G,P0 不会一直空转。调度器会尝试从其他 P 的本地队列中窃取一部分工作,这就是 work stealing。
可以把过程简化为:
P0 本地队列为空
       │
       ▼
检查全局队列
       │ 没有足够工作
       ▼
随机选择其他 P
       │
       ▼
窃取对方本地队列的一部分 G
       │
       ▼
放入 P0 本地队列并继续执行
工作窃取的意义是平衡负载,同时尽量保持本地队列的低竞争。窃取不是复制 G,而是把 G 的所有权从一个 runnable queue 转移到另一个 queue。
下面的 CPU 密集型例子可以在 scheduler trace 中看到本地队列和全局队列的变化:
package main

import (
	"runtime"
	"sync"
)

func busy(iterations int) {
	value := 0
	for i := 0; i < iterations; i++ {
		value += i % 7
	}
	if value == -1 {
		panic("unreachable")
	}
}

func main() {
	runtime.GOMAXPROCS(2)
	var wg sync.WaitGroup

	for i := 0; i < 100; i++ {
		wg.Add(1)
		go func() {
			defer wg.Done()
			busy(5_000_000)
		}()
	}

	wg.Wait()
}
不要用 runtime.Gosched() 代替设计良好的同步。Gosched 只是主动让出当前时间片,它不会等待数据、不建立 happens-before,也不会解决数据竞争。
goroutine 阻塞以后发生什么
channel 阻塞
当 goroutine 执行下面的代码,而 channel 当前无法完成接收:
value := <-input
runtime 不会让它继续占用 CPU 反复检查。当前 G 会进入等待状态,调度器把它从 runnable 集合中移除,之后由发送方把它重新变成 runnable。
生产者消费者的最小示例:
package main

import "fmt"

func main() {
	jobs := make(chan int)

	go func() {
		jobs <- 42
	}()

	value := <-jobs
	fmt.Println(value)
}
接收操作和发送操作在 runtime 内部都可能调用 gopark,而匹配成功后通过类似 goready 的路径把等待中的 G 放回 runnable 状态。函数名属于 runtime 内部实现细节,业务代码只需要遵守 channel 的所有权和关闭规则。
锁阻塞
Mutex 竞争时,不能立即获得锁的 goroutine 也会等待,而不是一直占用 CPU 自旋。锁实现会维护等待者,并在解锁时唤醒合适的 goroutine。
var mu sync.Mutex

mu.Lock()
// 临界区
mu.Unlock()
不要在锁的临界区里执行不必要的网络 I/O、磁盘 I/O 或长时间计算。锁持有时间越长,等待队列越长,调度器越难保持吞吐和延迟。
time.Sleep 和定时器
time.Sleep 不会让 M 线程原地忙等。goroutine 会被挂起,计时器到期后再被标记为可运行。
package main

import (
	"fmt"
	"time"
)

func main() {
	started := time.Now()
	time.Sleep(20 * time.Millisecond)
	fmt.Println(time.Since(started) >= 20*time.Millisecond)
}
不过 Sleep 只适合表达“至少等待一段时间”,不适合表达“等另一个任务完成”。后者应该用 channel、WaitGroup 或 Context。
系统调用和 netpoll
系统调用不会简单等于 goroutine 阻塞
网络服务器经常需要同时等待很多连接。如果每个连接都占用一个永久阻塞的操作系统线程,线程数量会迅速膨胀。Go runtime 会把网络 I/O 接入 netpoller:
goroutine 调用网络 API
        │
        ▼
fd 暂时不可读/写
        │
        ▼
G 被挂起,M/P 可以运行其他 G
        │
        ▼
OS 通过 epoll/kqueue/iocp 等机制通知就绪
        │
        ▼
netpoller 把 G 标记为 runnable
具体底层机制由操作系统决定。业务代码不应该直接假设一定使用 epoll 或 kqueue,而应该理解:使用 Go net 包的网络 I/O 时,runtime 会尽量把等待从“占用线程”转化成“等待事件”。
为什么文件 I/O 的行为可能不同
网络 FD 通常可以交给运行时网络轮询器,但普通文件在不同系统上的异步能力和语义不同。文件读写可能通过系统线程池或直接系统调用完成,不能把网络 I/O 的调度行为机械套到所有文件操作上。
如果一个外部库通过 cgo 进入长时间阻塞的 C 调用,runtime 也会把它视为可能阻塞的 M。此时应关注线程数量、P 是否能够继续运行,以及是否应该把阻塞操作放到受控 worker 中。
抢占与长时间运行的 goroutine
早期的 Go 调度更依赖函数调用、channel 操作和显式安全点。如果某个 goroutine 在纯 Go 计算循环中很久不调用可能触发调度的操作,其他 goroutine 可能得不到及时运行。
现代 Go runtime 具备异步抢占能力。调度器和系统监控线程会识别运行时间过长的 G,通过安全的抢占机制让它暂时让出执行权。
下面的循环没有主动调用 Gosched,仍然应该让其他 goroutine 获得机会:
package main

import (
	"fmt"
	"runtime"
	"time"
)

func main() {
	runtime.GOMAXPROCS(1)

	go func() {
		fmt.Println("second goroutine ran")
	}()

	deadline := time.Now().Add(30 * time.Millisecond)
	for time.Now().Before(deadline) {
		// 模拟长时间计算
	}

	fmt.Println("main finished")
}
这不意味着可以放心写无限循环。抢占有延迟,cgo、不可抢占的 runtime 区域和错误的自旋循环仍然可能造成问题。循环本身如果有明确的协作点,可以主动检查 Context 或使用 runtime.Gosched,但不要把它当成锁或通信机制。
用 schedtrace 观察调度器
Go 官方 Diagnostics 文档支持通过 GODEBUG=schedtrace=X 打印调度摘要,X 的单位是毫秒:
GODEBUG=schedtrace=1000 ./scheduler-demo
可能看到类似输出:
SCHED 1004ms: gomaxprocs=4 idleprocs=0 threads=11 spinningthreads=1 idlethreads=4 runqueue=8 [0 1 0 3]
可以这样理解:
| 字段 | 含义 |
|---|---|
gomaxprocs | 当前 P 的数量 |
idleprocs | 没有执行用户 Go 代码的 P 数量 |
threads | runtime 创建过的 M/线程数量统计 |
idlethreads | 当前空闲线程数量 |
runqueue | 全局 runnable queue 长度 |
[0 1 0 3] | 每个 P 的本地 runnable queue 长度 |
数组长度通常与 GOMAXPROCS 对应。trace 只是一个时间点的快照,不能单独证明某个 goroutine 一直被饿死;要研究延迟,还需要执行追踪或 profile。
运行实验
保存上面的 CPU 任务为 scheduler-demo.go,然后执行:
go run scheduler-demo.go
GODEBUG=schedtrace=200 GOMAXPROCS=2 go run scheduler-demo.go
go run 本身也会启动编译相关进程,所以如果想只观察目标程序,可以先构建:
go build -o scheduler-demo scheduler-demo.go
GODEBUG=schedtrace=200 GOMAXPROCS=2 ./scheduler-demo
使用 execution trace
调度摘要适合快速观察,execution trace 适合看完整事件时间线:
package main

import (
	"os"
	"runtime/trace"
	"sync"
)

func busy(iterations int) {
	value := 0
	for i := 0; i < iterations; i++ {
		value += i % 7
	}
	if value == -1 {
		panic("unreachable")
	}
}

func main() {
	file, err := os.Create("trace.out")
	if err != nil {
		panic(err)
	}
	defer file.Close()

	if err := trace.Start(file); err != nil {
		panic(err)
	}
	defer trace.Stop()

	var wg sync.WaitGroup
	for i := 0; i < 4; i++ {
		wg.Add(1)
		go func() {
			defer wg.Done()
			busy(10_000_000)
		}()
	}
	wg.Wait()
}
运行后使用:
go tool trace trace.out
execution trace 可以帮助回答:
- goroutine 是运行、阻塞还是被抢占;
- P 是否长期空闲;
- 网络轮询是否造成延迟;
- GC、系统调用和调度等待各占用多少时间。
官方文档建议把 trace 用于理解延迟和利用率,用 CPU profile、heap profile 等工具分析热点和内存成本。不同诊断工具会互相影响,最好分开采集。
调度器与业务代码的边界
调度器会自动完成很多工作,但业务代码仍然必须做好这些事情:
- 不要依赖 goroutine 的执行顺序;
- 不要用
time.Sleep代替同步; - 通过 channel 或锁建立明确的 happens-before;
- 控制 goroutine 的生命周期,避免无人负责退出;
- CPU 密集型任务设置合理 worker 数量,不要无上限启动 goroutine;
- 网络和 I/O 任务关注超时、取消和结果消费;
- 用 trace、pprof 和 race detector 验证猜测,不要凭日志顺序推断调度器行为。
常见误区
误区一:GOMAXPROCS 就是 goroutine 数量上限
不是。它限制 P 的数量,也就是并行执行用户 Go 代码的上限。goroutine 可以远大于 P,等待 I/O 的 goroutine 也不会持续占用 P。
误区二:goroutine 越多,程序越快
goroutine 创建很轻量,但每个 goroutine 仍然需要栈、调度和通信成本。大量 goroutine 竞争同一个锁、同一个 channel 或下游资源时,吞吐反而可能下降。
误区三:runtime.Gosched 可以解决同步问题
不能。它只让出当前执行机会,不传递数据、不等待条件,也不能修复数据竞争。
误区四:看到线程数多就说明 goroutine 泄漏
M 可能因为系统调用、cgo、网络轮询或 runtime 工作而增加。判断泄漏应该看 goroutine 数量、阻塞栈、生命周期和资源是否持续增长,不能只看线程总数。
误区五:schedtrace 的一次快照就是结论
一次输出只能说明某个时刻队列状态。要分析饥饿、尾延迟和调度等待,需要连续 trace、profile 和可重复压测。
总结
本篇从 runtime 角度理解了 Go 并发:
- G 是 goroutine,保存要执行的代码和调度现场;
- M 是操作系统线程,可以执行 Go 代码、系统调用或 runtime 代码;
- P 是执行用户 Go 代码所需的资源,数量由
GOMAXPROCS决定; - 调度器的核心任务是把 runnable G 匹配到拥有 P 的 M;
- G 通常先进入 P 的本地队列,必要时进入全局队列;
- 空闲 P 可以通过 work stealing 从其他 P 获取 runnable G;
- channel、锁、定时器和网络 I/O 会让 G 阻塞,阻塞的 G 不应持续占用 CPU;
- netpoller 把网络事件转换成 goroutine 的唤醒;
- sysmon 和抢占机制帮助长时间运行的 G 让出执行机会;
schedtrace适合观察队列摘要,execution trace 适合分析事件时间线;- 调度器会尽量提高吞吐,但不会替业务代码决定任务所有权、取消和关闭顺序。
真正理解 G/M/P 之后,可以把 goroutine 看成“可调度的任务”,把 P 看成“执行 Go 代码的资源许可”,把 M 看成“承载执行的线程”。channel 阻塞时,等待的是 G;P 可以转去运行其他 G;网络事件到来时,netpoller 再把等待中的 G 放回调度器。
官方资料

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 1
 0
- 0


 已为社区贡献16条内容

所有评论(0)