【Linux笔记】Linux基础IO
一、理解文件
1.1 狭义理解
文件是存储在磁盘上,磁盘是永久性存储介质,因此文件在磁盘上的存储是永久性。
磁盘是外设(既是输出设备也是输入设备),对磁盘上的文件操作都是对外设的输入和输出进行操作,简称 "IO" 操作。
1.2 文件操作的认知
文件操作本质是:文件内容操作 + 文件属性操作
文件 = 文件属性(元数据)+文件内容
因此,对于内容大小为0KB的文件,其在磁盘上也是占据空间大小的
1.3 系统角度理解
用户对文件的操作本质是进程对文件的操作,操作系统通过对进程的调度,从而实现对磁盘的管理。
用户通过C/C++等高级语言中的库函数操作文件,本质上是库函数封装的系统调用对进程进行操作,进而实现对文件的操作。
二、回顾C语言文件操作
2.1 打开和关闭文件
2.1.1 fopen 函数
1.函数原型: FILE *fopen(const char *filename, const char *mode);

2.参数一 filename: 要打开的文件名(含路径)

  参数二 mode: 打开文件的方式

4.返回值:

- 成功:返回指向 FILE 结构体的指针
- 失败:返回 NULL
mode模式:
| 模式 | 含义 | 文件不存在时 | 文件存在时 |
|---|---|---|---|
"r" (read) | 只读 | 失败,返回 NULL | 从头开始读取 |
"w" (write) | 只写 | 创建新文件 | 清空文件内容 |
"a" (append) | 追加写入 | 创建新文件 | 在文件末尾追加 |
"r+" | 读写 | 失败,返回 NULL | 从头开始读写 |
"w+" | 读写 | 创建新文件 | 清空文件内容 |
"a+" | 读 + 追加写 | 创建新文件 | 在文件末尾追加 |
2.1.2 fclose 函数
1.函数原型 int fclose(FILE *stream);

2.参数一 stream : 目标文件流指针

3.返回值

- 成功关闭: 返回 0
- 发生错误: 返回 EOF(通常定义为 -1)
2.2 写入文件的函数
2.2.1 fputc --写入单个字符
1.函数原型 int fputc(int c, FILE *stream);


2.参数一 c : 要写入的字符,虽然类型是 int,但实际只使用低 8 位(即一个字节)

  参数二 stream : 写入的目标文件流指针


3. 返回值

- 成功:返回写入的字符值(转为 unsigned char 后再转为 int)。
- 失败:返回 EOF(通常为 -1)


备注:EOF为宏定义 #define EOF (-1)

注意: fputc 不会自动加换行符,需手动添加
注意:
fputc的返回值参数类型是 int 而非 char,这是因为需要能区分有效字符值(0~255)和 错误标志 EOF(-1)。如果用 char 接收返回值,在有符号 char 的平台上,0xFF 会被误判为 EOF
代码示例:写入 26 个大写字母
#include <stdio.h>

int main(void)
{
    FILE *fp = fopen("char_output.txt", "w");
    if (!fp)
    {
        perror("fopen");
        return 1;
    }

    // 写入 26 个大写字母
    for (char ch = 'A'; ch <= 'Z'; ch++)
    {
        if (fputc(ch, fp) == EOF)
        {
            perror("fputc failed");
            break;
        }
    }
    fputc('\n', fp);  // fputc 不会自动加换行符,需手动添加

    fclose(fp);
    return 0;
}

// 文件内容: ABCDEFGHIJKLMNOPQRSTUVWXYZ\n
2.2.2 fputs --写入字符串
1.函数原型 int fputs(const char *s, FILE *stream);

2.参数一 s :写入的字符串

  参数二 stream :目标文件流指针

3.返回值:

- 成功:返回一个非负整数(C 标准未规定具体值,不要假设它等于字符串长度)。
- 失败:返回 EOF。

注:fputs 不会自动加换行符,需手动添加
写入已知字符串常量或变量,不需要格式化的纯文本输出。
代码示例:写入字符串
#include <stdio.h>

int main(void)
{
    FILE *fp = fopen("string_output.txt", "w");
    if (!fp)
    {
        perror("fopen");
        return 1;
    }

    fputs("Hello, World!\n", fp);     // 需手动加 \n
    fputs("This is line two.\n", fp);

    //  常见误区:fputs 不会自动追加换行符
    // fputs("no newline", fp);  → 下一行内容会紧接在后面

    fclose(fp);
    return 0;
}

// 文件内容:
// Hello, World!
// This is line two.
2.2.3 fprintf --格式化写入
1.函数原型:int fprintf(FILE *stream, const char *format, ...);

2.参数一 stream : 目标文件流指针

  参数二 format : 格式控制字符串,语法与 printf 完全一致

  参数三  ...   : 可变参数,对应格式符的待写入数据

3.返回值

- 成功:返回实际写入的字符个数。
- 失败:返回负数。
适用场景:将多种类型的数据按指定格式组合写入文本文件,如日志记录、配置文件生成、CSV 导出等。这是日常开发中使用频率最高的写入函数。
代码示例:格式化写入字符串到文件中
#include <stdio.h>

int main(void)
{
    FILE *fp = fopen("formatted_output.txt", "w");
    if (!fp)
    {
        perror("fopen");
        return 1;
    }

    char name[] = "Alice";
    int age = 25;
    double score = 97.5;

    // 格式化写入,语法与 printf 完全一致
    int n = fprintf(fp, "Name: %s\nAge: %d\nScore: %.1f\n", name, age, score);
    printf("本次写入了 %d 个字符\n", n);

    // 实用技巧:用 fprintf 生成 CSV
    FILE *csv = fopen("data.csv", "w");
    if (csv)
    {
        fprintf(csv, "%s,%d,%.1f\n", name, age, score);
        fclose(csv);
    }

    fclose(fp);
    return 0;
}

// formatted_output.txt 内容:
// Name: Alice
// Age: 25
// Score: 97.5
2.2.4 fwrite --二进制块写入
1.函数原型: size_t fwrite(const void *ptr, size_t size, size_t nmemb, FILE *stream);

2.参数一 ptr    :指向待写入数据缓冲区的指针

  参数二 size   :每个元素的字节大小

  参数三 nmemb  :要写入的元素个数

  参数四 stream :目标文件流指针

3.返回值:

- 返回实际成功写入的元素个数(不是字节数!)。
- 若返回值 < nmemb,表示写入不完整(磁盘满、I/O 错误等)。
适用场景:保存结构体、数组、图像/音频原始数据等二进制内容。必须配合
"wb"模式打开文件。
代码示例:
#include <stdio.h>

typedef struct
{
    int id;
    char name[20];
    float score;
} Student;

int main(void)
{
    //  二进制写入必须用 "wb" 模式
    FILE *fp = fopen("students.dat", "wb");
    if (!fp)
    {
        perror("fopen");
        return 1;
    }

    Student students[3] = {
        {1001, "Alice", 95.5f},
        {1002, "Bob",   88.0f},
        {1003, "Carol", 92.3f}
    };

    // 一次性写入 3 个 Student 结构体
    size_t written = fwrite(students, sizeof(Student), 3, fp);

    if (written != 3)
    {
        fprintf(stderr, "写入不完整!期望 3 个,实际 %zu 个\n", written);
    }
    else
    {
        printf("成功写入 %zu 条记录,共 %zu 字节\n",
               written, written * sizeof(Student));
    }

    fclose(fp);
    return 0;
}
注:
size和nmemb不要写反:虽然数学上size * nmemb总字节数相同,但fwrite返回的是"元素个数"。如果写成
fwrite(buf, total_bytes, 1, fp),当写入不完整时返回值只会是0或1,你无法知道到底写了多少字节。始终推荐
fwrite(ptr, sizeof(element), count, fp)的写法。
2.3 读入文件的函数
2.3.1 fgetc --读取单个字符
1.函数原型 int fgetc(FILE *stream);

2.参数 stream : 已打开的文件流指针

3.返回值:

- 读取成功:返回读取到的字符(先转为 unsigned char,再转为 int),范围 0 ~ 255。
- 文件结束或出错:返回 EOF(通常为 -1)。
适用场景:逐字符处理文件内容,例如字符统计、逐字符加密/解密、简单的词法分析等。
代码示例:
#include <stdio.h>

int main()
{
    FILE *fp = fopen("sample.txt", "r");
    if (!fp)
    {
        perror("fopen");
        return 1;
    }

    int c;          // 必须是 int,不能用 char!
    int count = 0;  // 统计字符总数

    while ((c = fgetc(fp)) != EOF)
    {
        putchar(c); // 输出到屏幕
        count++;
    }

    printf("\n--- 共读取 %d 个字符 ---\n", count);

    // 区分是"文件结束"还是"读取错误"
    if (feof(fp))
    {
        printf("正常到达文件末尾。\n");
    }
    if (ferror(fp)) {
        printf("读取过程中发生 I/O 错误!\n");
    }

    fclose(fp);
    return 0;
}
2.3.2 fgets --读取一行字符串 (常用)
1.函数原型 char *fgets(char *s, int size, FILE *stream);

2.参数一 s      : 接收数据的字符数组(缓冲区)

  参数二 size   : 缓冲区大小,fgets 最多读取 size - 1 个字符(留一个位置给 \0)

  参数三 stream : 已打开的文件流指针

3.返回值

- 成功:返回缓冲区的指针 s。
- 文件结束或出错:返回 NULL。

4.注意事项:

- fgets函数 最多读 size - 1 个字符。
- fgets函数 遇到遇到 '\n' 或 EOF 会提前停止,并会保留'\n'到缓冲区s中。
- fgets函数 在读取的字符末尾会自动添加'\0'。
适用场景: 逐行读取文本文件内容,如读取配置文件、日志文件、CSV 文件等。
这是读取文本文件最常用的函数。
代码示例:
#include <stdio.h>
#include <string.h>

int main()
{
    FILE *fp = fopen("config.txt", "r");
    if (!fp)
    {
        perror("fopen");
        return 1;
    }

    char line[256];
    int line_num = 1;

    //  正确用法:用 fgets 返回值做循环条件
    while (fgets(line, sizeof(line), fp) != NULL)
    {
        printf("第 %d 行: %s", line_num, line);
        // 注意:fgets 会保留末尾的换行符 \n,所以这里不需要再加 \n

        // 实用技巧:去掉末尾的换行符
        size_t len = strlen(line);
        if (len > 0 && line[len - 1] == '\n')
        {
            line[len - 1] = '\0';  // 去掉换行符
        }
        line_num++;
    }

    fclose(fp);
    return 0;
}
A. 陷阱 1:换行符的处理
fgets 会将换行符 \n 保留在缓冲区 s 中(如果读到了的话)
// 假设文件内容为 "Hello\n"
char buf[100];
fgets(buf, sizeof(buf), fp);

// buf 的内容是 "Hello\n\0",不是 "Hello\0"
如果你的逻辑不需要换行符,必须手动去除:去除换行符\n
// 方法 1:用 strlen
size_t len = strlen(buf);
if (len > 0 && buf[len - 1] == '\n')
{
    buf[len - 1] = '\0';
}

// 方法 2:用 strchr
char *newline = strchr(buf, '\n');
if (newline) *newline = '\0';
B. 陷阱 2:缓冲区不够大时怎么办
// 假设文件内容为 "This is a very long line that exceeds buffer\n"
char buf[10];

fgets(buf, sizeof(buf), fp);
// buf = "This is a\0"  (9个字符 + \0,没有换行符)
// 文件位置指示器停在 ' ' 处

fgets(buf, sizeof(buf), fp);
// buf = "very long\0"
// 以此类推...
C. 陷阱 3:绝不能用的循环条件
//经典错误:最后一行会被处理两次
while (!feof(fp))
{
    fgets(line, sizeof(line), fp);
    printf("%s", line);
}

//正确写法
while (fgets(line, sizeof(line), fp) != NULL)
{
    printf("%s", line);
}
错误原因分析:
假设文件 test.txt 内容为:
hello world
hello linux
追踪循环的执行过程:
char line[100];
while (!feof(fp))
{
    fgets(line, sizeof(line), fp);
    printf("%s", line);
}
| 轮次 | feof(fp) | fgets 执行 | line 的内容 | printf 输出 |
|---|---|---|---|---|
| 第1轮 | false | 读取成功,读到 "hello world\n" | "hello world\n" | hello world |
| 第2轮 | false | 读取成功,读到 "hello linux\n" | "hello linux\n" | hello linux |
| 第3轮 | false | 读取失败,触发标志位 | "hello linux\n" | hello linux |
| 第4轮 | true | — | — | 退出循环 |
2.3.3 fscanf --格式化读取
1.函数原型 int fscanf(FILE *stream, const char *format, ...);

2.参数一 stream : 已打开的文件流指针

  参数二 format : 格式控制字符串,语法与 scanf 完全一致

  参数三 ...    : 可变参数,用于接收解析结果的变量地址(必须用 &)

3.返回值

- 成功   :返回成功匹配并赋值的项数。
- 匹配失败:返回 0(没有任何项被成功赋值)。
- 文件结束或出错:返回 EOF。
适用场景: 从结构化文本文件中按固定格式提取数据,如读取成绩表、坐标数据、键值对配置等。
代码示例:
#include <stdio.h>

int main()
{
    // 假设 data.txt 内容为:
    // Alice 25 95.5
    // Bob 30 88.0
    // Carol 22 92.3

    FILE *fp = fopen("data.txt", "r");
    if (!fp)
    {
        perror("fopen");
        return 1;
    }

    char name[50];
    int age;
    double score;

    //  正确用法:检查 fscanf 的返回值是否等于期望的项数
    while (fscanf(fp, "%49s %d %lf", name, &age, &score) == 3)
    {
        printf("姓名: %-10s | 年龄: %d | 分数: %.1f\n", name, age, score);
    }

    // 退出循环后,判断原因
    if (feof(fp))
    {
        printf("--- 所有数据读取完毕 ---\n");
    }
    else
    {
        printf("--- 数据格式错误,解析中断!---\n");
    }

    fclose(fp);
    return 0;
}
2.3.4. fread --二进制块读取
1.函数原型 size_t fread(void *ptr, size_t size, size_t nmemb, FILE *stream);

2.参数一 ptr    : 接收数据的缓冲区指针

  参数二 size   : 每个元素的字节大小(通常用 sizeof)

  参数三 nmemb  : 期望读取的元素个数

  参数四 stream : 已打开的文件流指针

3.返回值

- 返回实际成功读取的元素个数(注意:是元素个数,不是字节数)。
- 若返回值 < nmemb,可能是到达文件末尾,也可能是 I/O 错误。用 feof() 和 ferror() 进一步判断。
适用场景:读取结构体数组、图像/音频原始数据、序列化文件等二进制内容。必须配合
"rb"模式打开文件。
代码示例:
#include <stdio.h>

typedef struct
{
    int id;
    char name[20];
    float score;
} Student;

int main(void)
{
    // 假设 students.dat 是由 fwrite 写入的二进制文件
    FILE *fp = fopen("students.dat", "rb");  // 必须用 "rb"
    if (!fp)
    {
    	perror("fopen");
    	return 1;
    }

    Student buf[3];

    // 一次性读取 3 个 Student 结构体
    size_t read_count = fread(buf, sizeof(Student), 3, fp);

    printf("期望读取 3 条,实际读取 %zu 条\n", read_count);

    for (size_t i = 0; i < read_count; i++)
    {
        printf("ID: %d | 姓名: %-10s | 分数: %.1f\n",
        buf[i].id, buf[i].name, buf[i].score);
    }

    // 判断是否完整读取
    if (read_count < 3)
    {
        if (feof(fp))
        {
            printf("文件数据不足,未读满 3 条。\n");
        }
        else if (ferror(fp))
        {
            printf("读取过程中发生 I/O 错误!\n");
        }
    }

    fclose(fp);
    return 0;
}
2.4 判断文件是以何方式结束方式的函数
2.4.1 feof -- 判断文件结束的方式
1.函数原型 int feof(FILE *stream);

2.参数 stream: 已打开的文件流

3.返回值

- 如果文件结束指示符已被设置,返回非零值
- 如果文件结束指示符未被设置,返回 0

4.函数功能

feof 函数是用来检测上一次的读取操作是否因为到达文件末尾而失败,不能用于"判断文件是否已经读取结束"


5.核心原理

- 每个文件流内部都有一个文件结束指示符(EOF indicator),它是一个状态标记。

- 当你对文件流执行一次读取操作(如 fgetc、fgets、fread 等),如果这次操作尝试在文件末尾之后读取,系统才会把这个指示符设置为"已到末尾"。

- feof 只是检查这个指示符的状态,它本身不会主动探测文件是否还有内容。

这意味着:即使文件指针已经指向了最后一个字节之后,只要没有发生一次"越界"的读取操作,feof 仍然返回 0。
2.4.2 feof 使用演示
以读取函数的返回值作为循环条件,用 feof 来区分"到达文件末尾"和"发生读取错误"。
代码示例A: 文本文件逐字符读取
int ch;
while ((ch = fgetc(fp)) != EOF)
{
    putchar(ch);
}
// 循环结束后,用 feof 判断退出原因
if (feof(fp))
{
    printf("已到达文件末尾。\n");
}
else if (ferror(fp))
{
    printf("读取过程中发生错误。\n");
}
代码示例B: 文本文件逐行读取
char buf[1024];
while (fgets(buf, sizeof(buf), fp) != NULL)
{
    printf("%s", buf);
}

if (feof(fp))
{
    printf("文件读取完毕。\n");
}
else
{
    printf("读取过程中发生错误。\n");
}
代码示例C:二进制文件读取
unsigned char buffer[256];
size_t bytes_read;
while ((bytes_read = fread(buffer, 1, sizeof(buffer), fp)) > 0)
{
    // 处理 buffer 中的 bytes_read 个字节
}

if (feof(fp))
{
    printf("文件读取完毕。\n");
}
else
{
    printf("读取过程中发生错误。\n");
}
三、系统文件IO
3.1 open 系统调用
1.头文件包含

#include <sys/types.h>
#include <sys/stat.h>
#include <fcntl.h>

2.函数原型

- int open(const char *pathname, int flags);

- int open(const char *pathname, int flags, mode_t mode);
第一个open函数,用于打开一个已存在的文件,不需要指定权限。
第二个open函数,当 flags 中包含
O_CREAT(创建文件)时,必须用第三个参数mode指定新文件的权限。
3.1.1 参数说明
A. 参数一 pathname
参数说明

pathname(文件路径)

- 相对路径 "./file.txt"   (不以 / 开头)
- 绝对路径 "/usr/bin/file.txt" (必须以 / 开头)
B. 参数二 flag
核心设计思想:用一个整数的不同二进制位,来表示多个独立的布尔状态。
参数flag的标志位
| 标志 | 含义 |
|---|---|
O_CREAT | 文件不存在则创建 |
O_EXCL | 与 O_CREAT 一起使用,若文件已存在则返回错误(确保是新建文件) |
O_TRUNC | 若文件存在且为写模式,则将文件长度截断为 0(清空文件) |
O_APPEND | 追加模式,每次写入都追加到文件末尾 |
O_NONBLOCK | 非阻塞模式打开(常用于管道、设备) |
O_CLOEXEC | 执行 exec 系列函数时自动关闭该文件描述符 |
O_SYNC | 每次写入都同步刷盘 |
参数flag的组合方式
// 只读打开已有文件
O_RDONLY

// 读写打开,不存在则创建
O_RDWR | O_CREAT

// 写入打开,不存在则创建,存在则清空
O_WRONLY | O_CREAT | O_TRUNC

// 写入打开,不存在则创建,存在则报错(原子性创建)
O_WRONLY | O_CREAT | O_EXCL

// 写入打开,追加模式
O_WRONLY | O_APPEND
底层原理:二进制与位运算
在头文件 <fcntl.h> 中,标志通常这样定义:

#define O_RDONLY    0           // O_RDONLY 特殊:值为 0
#define O_WRONLY    (1 << 0)    // O_WRONLY= 1
#define O_RDWR      (1 << 1)    // O_RDWR= 2
#define O_CREAT     (1 << 6)    // O_CREAT= 64
#define O_EXCL      (1 << 7)    // O_EXCL= 128
#define O_TRUNC     (1 << 9)    // O_TRUNC= 512
#define O_APPEND    (1 << 10)   // O_APPEND= 1024
组合标志:按位或(|)
当你写 O_WRONLY | O_CREAT | O_TRUNC 时,CPU 执行的是按位或运算:
O_WRONLY :  0000 0000  0000 0001
O_CREAT  :  0000 0000  0100 0000
O_TRUNC  :  0000 0010  0000 0000
			─────────────────────  按位或 (|)
结果     :   0000 0010  0100 0001
解析标志:按位与(&)
内核收到 flag = 577(二进制 0000 0010 0100 0001)后,如何知道用户是否设置了 O_CREAT、 O_WRONLY 和O_TRUNC呢?
if (flag & O_CREAT)
{
    // 创建文件
}
else if(flag & O_WRONLY)
{
	// 只写文件
}
else if(flag & O_TRUNC)
{
	// 清空文件
}
C. 参数三 mode
指定新建文件的权限位,常用八进制表示,仅在使用 O_CREAT 时需要设置。
常见的权限位值
| 值 | 含义 |
|---|---|
0644 (rw- -w- -w-) | 属主读写,组和其他用户只读(最常用) |
0600 (rw- --- ---) | 仅属主读写 |
0755 ( rwx r-x r-x) | 属主读写执行,组和其他用户读执行 |
0666 ( rw- rw- rw-) | 所有人读写 |
注:最前面的0 表示C语言的八进制数字。
3.1.2 返回值说明
文件描述符 fd
返回值说明

- 返回成功:返回一个非负整数,即文件描述符(0、1、2 通常已被 stdin、stdout、stderr 占用,所以一般从 3 开始)。

- 返回失败:返回 -1,并设置全局变量 errno
3.2 write 系统调用
1.头文件包含:#include <unistd.h>


2.函数原型:ssize_t write(int fd, const void *buf, size_t count);


3.函数功能:将 buf 指向的缓冲区中最多 count 个字节写入到 fd 所标识的文件中。
3.2.1 参数说明
参数说明

1.参数一 fd  :文件描述符,标识要读取的源文件/设备/管道等

2.参数二 buf : 指向 “待写入的字符串”

3.参数三 count : 请求写入的字节数
3.2.2 返回值说明
返回值说明

1. 返回值 >=0 , 实际成功写入的字节数(可能 < count)

2. 返回值 =-1 , 写入出错,设置errno
3.3.3 实战演示
int main()
{
    int fd = open("test_write.txt", O_WRONLY | O_CREAT | O_TRUNC, 0644);
    if (fd < 0) { perror("open"); return 1; }

    const char *msg = "Hello, write syscall!\n";
    ssize_t ret = write(fd, msg, strlen(msg));
    if (ret < 0)
    {
        perror("write fail");
    }
    else
    {
        printf("成功写入 %zd 字节\n", ret);
    }

    close(fd);
    return 0;
}
3.3 read 系统调用
1.头文件包含:  #include <unistd.h>


2.函数原型: ssize_t read(int fd, void *buf, size_t count);


3.函数功能: 从 fd 标识的文件中读取最多 count 个字节到 buf 中。
3.3.1 参数说明
参数说明

1.参数一 fd  :文件描述符,标识要读取的源文件/设备/管道等

2.参数二 buf : 指向接收数据缓冲区的指针

3.参数三 count : 请求写入的字节数
3.3.2 返回值说明
返回值说明

1. 返回值 > 0 : 实际读取到的字节数

2. 返回值 = 0 : 到达文件末尾(EOF)或 对端关闭

3. 返回值 = -1 : 读取出错,设置 errno
3.3.3 实战演示
#include <stdio.h>
#include <unistd.h>
#include <fcntl.h>
#include <errno.h>

#define BUF_SIZE 4096

int main()
{
    int fd = open("test_write.txt", O_RDONLY);
    if (fd < 0)
    {
    	perror("open");
    	return 1;
    }

    char buf[BUF_SIZE];
    ssize_t total = 0;
    ssize_t n;

    // 循环读取直到 EOF 或出错
    while ((n = read(fd, buf, sizeof(buf))) > 0)
    {
        // 这里可以将 buf[0..n-1] 处理/输出
        fwrite(buf, 1, (size_t)n, stdout);
        total += n;
    }

    if (n < 0)
    {
        if (errno == EINTR)
        {
            fprintf(stderr, "读取被信号中断\n");
        }
        else
        {
            perror("read");
        }
    }
    else
    {
        printf("\n--- 共读取 %zd 字节 ---\n", total);
    }

    close(fd);
    return 0;
}
3.4 close 系统调用
1.头文件包含 #include <unistd.h>

2.函数原型 int close(int fd);

3.函数功能:释放文件描述符:使 fd 不再有效,该编号可被后续 open 等复用。
3.4.1 参数说明
参数说明

fd : 要关闭的文件描述符
3.4.2 返回值说明
返回值说明:

1. 返回值 = 0 : 成功关闭

2. 返回值 =-1 : 关闭失败,设置 errno
3.5 文件描述符的本质
在 Linux 系统中,fd(file descriptor,文件描述符)是一个非负整数,用来在进程中标识一个已打开的 I/O 资源。
当进程启动时,进程默认存在 0、1、2 三个
fd,分别对应stdin、stdout、stderr当进程退出时,进程的文件描述符
fd会被系统自动回收。
3.5.1 文件描述符运行的全流程
核心结构体如下所示:
      用户态                       				 内核态
  ─────────────────            ─────────────────────────────────────────────────────

   fd = 4 (整数)                     current ──▶ task_struct
                                                    │
                                                    ▼
                                              files 指针  (struct files_struct *)
                                                    │
                                                    ▼
                                              ┌──────────────────────────┐
                                              │ files_struct             │
                                              │  ├─ count                │◀──── count引用计数
                                              │  ├─ fdtab     ─┐         │◀──── fdtab 指针
                                              │  └─ next_fd    │         │
                                              └────────────────│─────────┘
                                                               │
                                                               ▼
                                              ┌──────────────────────────┐
                                              │ fdtable (struct fdtable) │
                                              │  ├─ max_fds              │
                                              │  ├─ fd[]                 |◀──── 数组下标=fd
                                              │  ├─ open_fds 		 |
                                              │  └─ close_on_exec 	 |
                                              └──────│───────────────────┘
                                                     │ fd[4]
                                                     ▼
                                              ┌──────────────────────────┐
                                              │ struct file              │
                                              │  ├─ f_count   		 │ ◀──── (引用计数)
                                              │  ├─ f_pos     		 │ ◀──── (文件偏移)
                                              │  ├─ f_flags, f_mode      │
                                              │  ├─ f_path   		 │
                                              │  ├─ f_inode 		 │
                                              │  ├─ f_op 		 | ────┐
                                              │  └─ private_data         │     │  (file_operations*)
                                              └──────────────────────────┘     │
                                                                               ▼
                                                                ┌────────────────────────┐
                                                                │ 具体文件系统/设备的      │
                                                                │    回调函数表           │
                                                                │ read/write/ioctl/poll  │
                                                                └────────────────────────┘
结构体调用流程图如下所示:
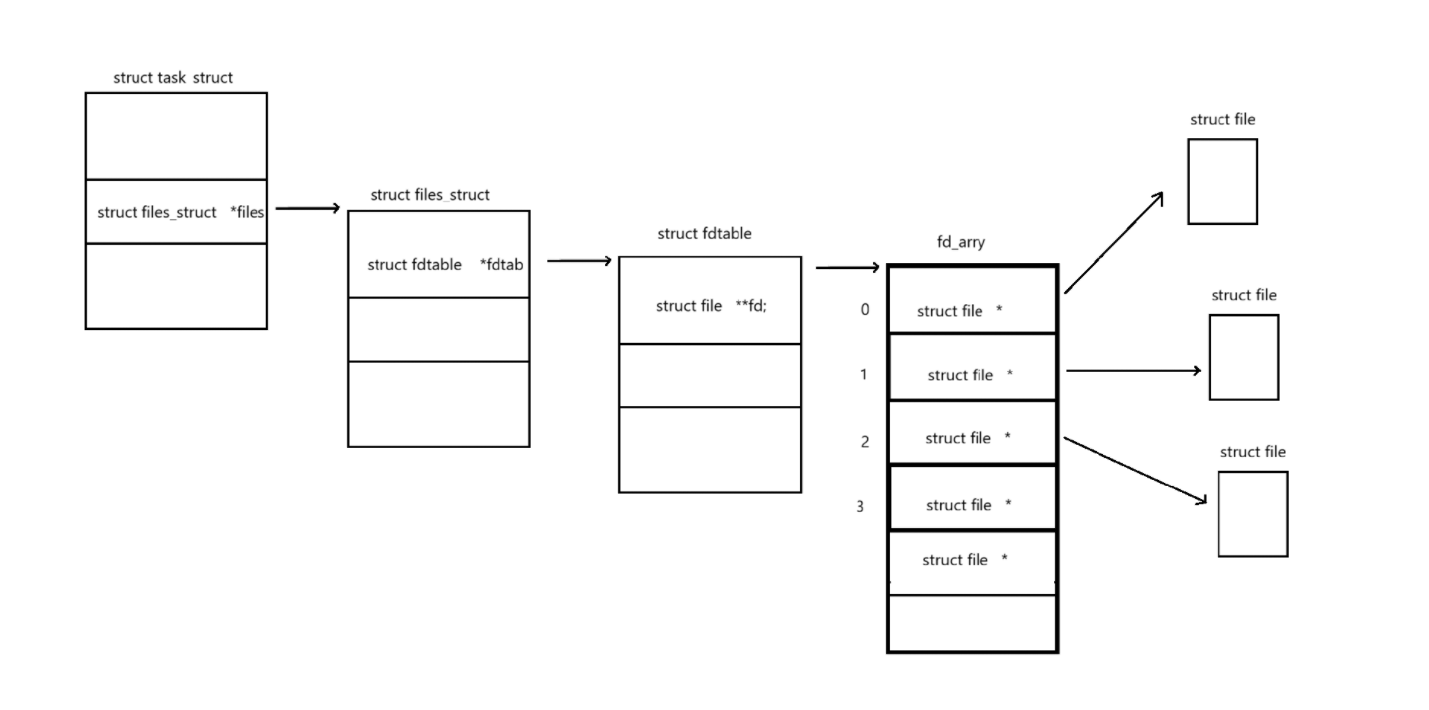
3.5.2 struct task_struct
进程描述符 task_struct , 包含指向文件描述符表的指针 struct files_struct *files
struct task_struct
{
    ...
    struct files_struct   *files;        // ★ 指向文件描述符表结构
    ...
};
3.5.3 struct files_struct
struct files_struct
{
      atomic_t          count;            // ★引用计数 (fork/dup 时共享)
      struct fdtable    *fdtab;           // ★ 指向真正的 fdtable
      struct fdtable    __rcu fd_rcu[NR_FILE_BUFFERS];
      struct fdtable    __percpu *max_fds_t;  // per-cpu 优化

      // 内联位图(减少小规模时的额外分配)
      unsigned long     *close_on_exec;
      unsigned long     *open_fds;

      int               next_fd;          // 下一个可分配的 fd(缓存优化)
      unsigned long     close_on_exec_init[1];
      unsigned long     open_fds_init[1];
      struct file       *fd_array[NR_OPEN_DEFAULT];  // ★ 默认小数组嵌入
};
3.5.4 struct fdtable
struct fdtable
{
    unsigned int    max_fds;            // 当前数组容量
    struct file   **fd;                // ★ 真正的指针数组,fd[i] 就是打开的文件
    unsigned long  *open_fds;           // 位图,哪些 fd 已分配
    unsigned long  *close_on_exec;      // 位图,哪些 fd 在 exec 时关闭
    struct rcu_head rcu;               // 延迟回收
};
3.5.5 struct file
这是Linux内核中真正表示"已打开的文件"的实体。
struct file
{
    union
    {
        struct llist_node   fu_llist;       // 释放链表节点
        struct rcu_head     fu_rcuhead;     // RCU 释放头
    } f_u;
    struct path            f_path;         // 路径(dentry + vfsmount)
    struct inode          *f_inode;        // ★ 指向 inode
    const struct file_operations *f_op;    // ★ 操作函数表 (read/write/ioctl...)
    loff_t                 f_pos;          // ★ 当前文件偏移(lseek 改它)
    unsigned int           f_flags;        // open() 时的标志位 (O_RDONLY 等)
    fmode_t                f_mode;         // FMODE_READ / FMODE_WRITE 等
    const struct cred     *f_cred;         // 凭据
    void                  *private_data;   // 各子系统私有数据
    spinlock_t             f_lock;         // 保护 f_flags / f_pos 等小字段
    atomic_long_t          f_count;        // ★ 引用计数
    struct mutex           f_pos_lock;
    ...
};
3.5.6 struct file_operations
struct file_operations
{
    struct module *owner;
    loff_t   (*llseek)    (struct file *, loff_t, int);
    ssize_t  (*read)      (struct file *, char __user *, size_t, loff_t *);
    ssize_t  (*write)     (struct file *, const char __user *, size_t, loff_t *);
    ...
    long     (*ioctl)     (struct file *, unsigned int, unsigned long);
    int      (*poll)      (struct file *, struct poll_table_struct *);
    int      (*mmap)      (struct file *, struct vm_area_struct *);
    int      (*open)     (struct inode *, struct file *);
    int      (*release)   (struct inode *, struct file *);
    ...
} __rcu;
3.6 重定向操作
3.6.1 本质理解
重定向 = open 打开文件的方式 + dup2系统调用
用 open +dup2 + close 这类系统调用,把某个指定的
fd(通常是 1 或 2)在进程的fd表里的内容改成新的目标。简单来说:重定向操作 等价于 修改进程文件描述符表(
fdtable)中某个fd的指向。
3.6.2 三个标准文件描述符
每个进程默认打开三个文件描述符:
fdtable

  ┌─────────┬──────────────────────────────────┐
  │  fd=0   │  stdin  → /dev/tty (终端键盘)     │
  ├─────────┼──────────────────────────────────┤
  │  fd=1   │  stdout → /dev/tty (终端屏幕)     │
  ├─────────┼──────────────────────────────────┤
  │  fd=2   │  stderr → /dev/tty (终端屏幕)     │
  └─────────┴──────────────────────────────────┘
3.6.3 dup2系统调用
1.函数原型 int dup2(int oldfd, int newfd);

2.参数一 oldfd : 已打开的有效文件描述符

  参数二 newfd : 目标文件描述符

3.返回值

- 返回成功 :  返回 newfd
- 返回失败 :  返回 -1 ,并设置 errno

4.函数功能:强制让 newfd 指向 oldfd 所指向的 struct file。(如果 newfd 已经打开,先关闭它)
3.6.4 文件描述符的分配原则
核心原则:最小可用原则(Lowest Available Number)
当进程请求打开一个新文件或创建一个新的 I/O 通道(如 pipe、socket)时,内核必须返回当前进程文件描述符表(fdtable)中未被使用的最小非负整数。
通俗理解为:内核从 fd = 0 开始向下进行扫描找到第一个“空闲”的槽位,就把它分配出去。(不会跳过前面的空闲槽位去分配后面)
代码示例:打开文件 myfile,查看分配的文件描述符
#include <stdio.h>
#include <sys/types.h>
#include <sys/stat.h>
#include <fcntl.h>
int main()
{
     int fd = open("myfile", O_RDONLY);
     if(fd < 0)
     {
         perror("open");
         return 1;
     }
     printf("fd: %d\n", fd);
     close(fd);
     return 0;
}

输出结果为 fd:3
代码示例:关闭文件描述符0,打开文件 myfile,查看分配的文件描述符
#include <stdio.h>
#include <sys/types.h>
#include <sys/stat.h>
#include <fcntl.h>
int main()
{
     close(0);
     int fd = open("myfile", O_RDONLY);
     if(fd < 0)
     {
         perror("open");
         return 1;
     }
     printf("fd: %d\n", fd);
     close(fd);
     return 0;
}

输出结果为 fd: 0
代码示例:关闭文件描述符1,打开文件 myfile,查看分配的文件描述符
#include <stdio.h>
#include <sys/types.h>
#include <sys/stat.h>
#include <fcntl.h>
int main()
{
     close(1);
     int fd = open("myfile", O_RDONLY);
     if(fd < 0)
     {
         perror("open");
         return 1;
     }
     printf("fd: %d\n", fd);
     close(fd);
     return 0;
}

输出结果为 fd: 1
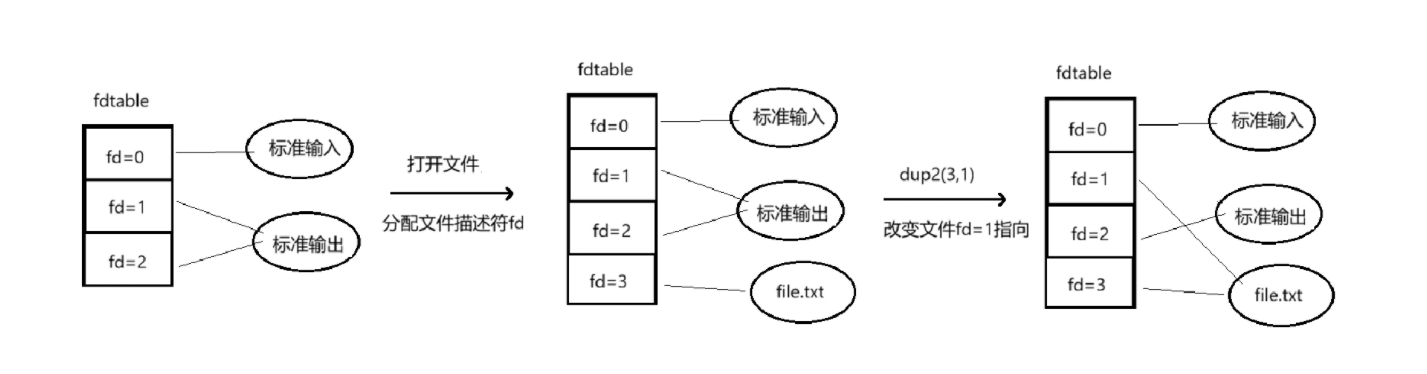
3.6.4 重定向原理
让 fdtable 中 newfd 槽位的指针,指向 oldfd 所指向的同一个 struct file 对象
3.6.5 Shell 重定向的完整实现流程
Shell 重定向的本质:
-
Shell 通过 fork 进程,并通过
open + dup2 + close修改 子进程 的fdtable,让标准输出指向目标文件, -
然后 exec 执行命令,命令完全透明地写入文件而不是终端,而 Shell 自身的
fdtable不受影响。
代码示例:实现终端输入 ls > output.txt 的执行
// 模拟 Shell 执行 "ls > output.txt" 的核心逻辑

void shell_execute_redirect()
{
    pid_t pid = fork();

	// 子进程
    if (pid == 0)
    {
        // 第一步:打开目标文件
        // 假设 fd = 3(最小可用fd)
        int fd = open("output.txt", O_WRONLY | O_CREAT | O_TRUNC, 0644);
        if (fd < 0)
        {
            perror("open");
            exit(1);
        }

        // 第二步:重定向 stdout 到该文件
        dup2(fd, 1);
        // 现在 fd=1 (stdout) 指向 output.txt

        // 第三步:关闭不再需要的原始 fd
        close(fd);   // close(3),释放多余的引用
        // fd=1 仍然指向 output.txt(因为 f_count > 0)

        // 第四步:exec 替换为 ls 程序
        char *args[] = {"ls", NULL};
        execvp("ls", args);

        // exec 成功后,ls 程序继承了修改后的 fdtable
        // ls 调用 printf / write(1, ...) 时,数据写入 output.txt
    }

    if (pid > 0)
    {
        // 父进程
        // 不执行重定向!Shell 自己的 fdtable 不受影响
        wait(NULL);  // 等待子进程结束
    }
}
代码执行流程如下:
==== 阶段1: fork 之前 (Shell 进程) ====

Shell的fdtable   内核 file 对象
  ┌──────┐
  │ fd=0 ├────▶ /dev/tty (键盘)
  ├──────┤
  │ fd=1 ├────▶ /dev/tty (屏幕)
  ├──────┤
  │ fd=2 ├────▶ /dev/tty (屏幕)
  └──────┘


==== 阶段2: fork 之后,子进程继承了父进程的 fdtable,通过引用计数的方式控制文件的释放 ====

 子进程fdtable    内核 file 对象
  ┌──────┐
  │ fd=0 ├────▶ /dev/tty (stdin 键盘)
  ├──────┤
  │ fd=1 ├────▶ /dev/tty (stdout 终端)
  ├──────┤
  │ fd=2 ├────▶ /dev/tty (屏幕)
  └──────┘


==== 阶段3: open("output.txt") → 返回 fd=3 ====

 子进程 fdtable                      内核 file 对象
  ┌──────┐
  │ fd=0 ├─────────────────────────▶/dev/tty (stdin 键盘)
  ├──────┤
  │ fd=1 ├─────────────────────────▶/dev/tty (stdout 终端)
  ├──────┤
  │ fd=2 ├─────────────────────────▶/dev/tty (stderr 终端)
  ├──────┤
  │ fd=3 ├─────────────────────────▶ output.txt
  └──────┘


==== 阶段4: dup2(3, 1) → 让 fd=1 指向 output.txt ====

  子进程 fdtable                     内核 file 对象
  ┌──────┐
  │ fd=0 ├─────────────────────────▶ /dev/tty (stdin 键盘)
  ├──────┤
  │ fd=1 ├────────────────┐
  ├──────┤                │
  │ fd=2 ├────────────────|─────────▶/dev/tty (stderr 终端)
  ├──────┤                |
  │ fd=3 ├────────────────└────────▶  output.txt
  └──────┘


==== 阶段5: close(3) → 关闭多余的 fd ====

  子进程 fdtable                     内核 file 对象
  ┌──────┐
  │ fd=0 ├─────────────────────────▶ /dev/tty  (stdin 键盘)
  ├──────┤
  │ fd=1 ├─────────────────────────▶ output.txt
  ├──────┤
  │ fd=2 ├─────────────────────────▶ /dev/tty  (stderr 终端)
  ├──────┤
  │ fd=3 │  (已关闭)
  └──────┘

  ★ fd=1 仍然指向 output.txt
  ★ 后续 execvp("ls") 后,ls 往 fd=1 写的数据全部进入 output.txt


==== 阶段6: execvp("ls") → ls 继承修改后的 fdtable ====

  ls 进程的 fdtable                  内核 file 对象
  ┌──────┐
  │ fd=0 ├─────────────────────────▶ /dev/tty  (stdin 键盘)
  ├──────┤
  │ fd=1 ├─────────────────────────▶ output.txt
  ├──────┤
  │ fd=2 ├─────────────────────────▶ /dev/tty  (stderr 终端)
  └──────┘

  ls 程序完全不知道重定向的存在
  它调用 write(1, "file1\nfile2\n", ...) 时
  内核 VFS 根据 fdtable 找到 output.txt 的 struct file
  数据写入文件而不是终端
3.6.6 常见的重定向操作
A. 标准输出重定向 >(覆盖写)
操作语义:将标准输出重定向到指定的文件,如果文件已存在则清空原内容。
ls > output.txt
底层原理:
int fd = open("output.txt", O_WRONLY | O_CREAT | O_TRUNC, 0644);
dup2(fd, 1);
close(fd);
B. 标准输出重定向 >>(追加写)
操作语义:将标准输出重定向指定文件,并追加到文件末尾不清空原内容。
echo "new line" >> log.txt
底层原理:
int fd = open("log.txt", O_WRONLY | O_CREAT | O_APPEND, 0644);
dup2(fd, 1);
close(fd);
C. 标准输入重定向 <
操作语义:将文件内容作为命令的标准输入(stdin, fd=0)
cat < input.txt
底层原理:
int fd = open("input.txt", O_RDONLY);
dup2(fd, 0);
close(fd);
D. 标准错误重定向 2>
操作语义:只将标准错误(stderr, fd=2)重定向到文件,标准输出仍然打印在终端。
gcc main.c 2> error.log
底层原理:
int fd = open("error.log", O_WRONLY | O_CREAT | O_TRUNC, 0644);
dup2(fd, 2);
close(fd);
E. 标准错误重定向 2>>
操作语义:将错误信息追加到文件末尾。
gcc main.c 2>> error.log
底层原理:
int fd = open("error.log", O_WRONLY | O_CREAT | O_APPEND, 0644);
dup2(fd, 2);
close(fd);
F. 重定向 stdout 和 stderr 到同一文件
command > output.log 2>&1
深入理解上述指令:
步骤 1: 解析 "> output.log"
  → open("output.log", O_WRONLY|O_CREAT|O_TRUNC)  → 假设返回 fd=3
  → dup2(3, 1)
  → close(3)
  → 此时 fd=1 指向 output.log


步骤 2: 解析 "2>&1"
  → 语义:让 fd=2 指向 fd=1 当前指向的地方
  → dup2(1, 2)   ← 注意:不需要 open,直接 dup2
  → 此时 fd=2 也指向 output.log


结果:fd=1 和 fd=2 都指向 output.log


  fd=1 ─────────┐
                ├──▶ output.log (struct file, f_count=2)
  fd=2 ─────────┘
经典错误:
command 2>&1 > output.log
步骤 1: 解析 "2>&1"
  → dup2(1, 2)
  → 此时 fd=1 还指向终端,所以 fd=2 也指向终端(等于没变)

步骤 2: 解析 "> output.log"
  → open("output.log", ...) → fd=3
  → dup2(3, 1)
  → close(3)
  → 此时 fd=1 指向 output.log,但 fd=2 仍然指向终端

结果:stdout 写入文件,stderr 仍然打印在终端(没有达到合并的目的)

  fd=1 ───────────▶ output.log

  fd=2 ───────────▶ stderr
四、缓冲区
4.1 什么是缓冲区?
缓冲区的本质:是一块内存区域,用于在数据从一个位置传输到另一个位置的过程中,临时存放数据。**
简单理解为:缓冲区是一个数据搬运的中转站,存放在内存区域。
在 I/O 操作中,缓冲区存在于两个层面:

- 用户空间的缓冲区:位于应用程序的进程地址空间中,由 C 标准库(如 glibc)管理。

例如:FILE* 结构体内部就包含了一块用户态缓冲区。


- 内核空间的缓冲区:位于操作系统的内核地址空间中,由操作系统管理。

例如:当数据从磁盘或网络到达时,首先存放在内核缓冲区,再由系统调用(如 read/write)拷贝到用户空间。
实验验证0:关闭标准输出 stdout (文件描述符fd=1) ,预测 printf输出的内容到 log.txt 文件中。
#include <stdio.h>
#include <unistd.h>
#include <sys/types.h>
#include <sys/stat.h>
#include <fcntl.h>

int main()
{
    close(1);
    //关闭文件描述符fd=1,预测fd=1
    int fd = open("log.txt",O_CREAT| O_WRONLY | O_APPEND | O_TRUNC,0666);

    //printf默认输出到fd=1 所指向的文件,即log.txt文件中。
    printf("fd:%d\n",fd);
    printf("hello Linux\n");
    printf("hello Linux\n");
    printf("hello Linux\n");

    return 0;
}


[hamber@VM-0-14-centos lesson18]$ cat log.txt
fd:1
hello Linux
hello Linux
hello Linux
实验验证1:关闭标准输出 stdout (文件描述符fd=1) ,预测 printf输出的内容到 log.txt 文件中,最后执行close(fd)。
#include <stdio.h>
#include <unistd.h>
#include <sys/types.h>
#include <sys/stat.h>
#include <fcntl.h>

int main()
{
    close(1);
    //关闭文件描述符fd=1,预测fd=1
    int fd = open("log.txt",O_CREAT| O_WRONLY | O_APPEND | O_TRUNC,0666);

    //printf默认输出到fd=1 所指向的文件,即log.txt文件中。
    printf("fd:%d\n",fd);
    printf("hello Linux\n");
    printf("hello Linux\n");
    printf("hello Linux\n");

    //关闭文件描述符fd文件指向
	close(fd);
    return 0;
}


//文件并没有写入到log.txt文件中,文件描述符已经关闭,用户缓冲区的内容不能够C库函数通过调用系统调用写入到内核缓冲区中。
[hamber@VM-0-14-centos lesson18]$ cat log.txt
[hamber@VM-0-14-centos lesson18]$
实验验证2:关闭标准输出 stdout (文件描述符fd=1) ,预测 printf输出的内容到 log.txt 文件中,通过系统调用 write 写入一个字符串,最后执行close(fd)。
#include <stdio.h>
#include <unistd.h>
#include <sys/types.h>
#include <sys/stat.h>
#include <fcntl.h>

int main()
{
    close(1);
    //关闭文件描述符fd=1,预测fd=1
    int fd = open("log.txt",O_CREAT| O_WRONLY | O_APPEND | O_TRUNC,0666);

    //printf默认输出到fd=1 所指向的文件,即log.txt文件中。
    printf("fd:%d\n",fd);
    printf("hello Linux\n");
    printf("hello Linux\n");
    printf("hello Linux\n");

    //通过系统调用write写入文件log.txt
    const char * msg="hello world\n";
    write(fd,msg,strlen(msg));

    //关闭文件描述符fd文件指向
	close(fd);
    return 0;
}

//只有write系统调用函数,写入到log.txt
[hamber@VM-0-14-centos lesson18]$ cat log.txt
hello world
总结实验:
①gilbc库函数提供的接口(printf、fputs、fprintf、fwrite等) 不是直接写入内核级的缓冲区,而是写入用户层缓冲区,只有系统调用接口(write 等)直接写入内核级别缓冲区。
②当用户满足刷新条件时,C 库自动调用 write() 系统调用,将数据从用户缓冲区拷贝到内核缓冲区。操作系统再根据策略将内核缓冲区的数据刷入磁盘。
4.2 缓冲区的机制
以 C 语言标准 I/O(fopen、fwrite、fread 等)为例,整个流程如下:
应用程序
   |
   |
   v
[用户空间缓冲区]  <---- C 标准库管理(FILE 结构体内)
   |
   | 当满足刷新条件时,调用 write() 系统调用
   v
[内核空间缓冲区]  <---- 操作系统管理(页缓存/缓冲区缓存)
   |
   | 操作系统决定何时将数据真正写入设备
   v
[磁盘/终端/网络设备]
核心工作流程:
① 写操作(以 fwrite 为例): 应用程序调用 fwrite() 时,数据并不是直接写入磁盘,而是先拷贝到用户空间缓冲区。当缓冲区满足刷新条件时,C 库自动调用 write() 系统调用,将数据从用户缓冲区拷贝到内核缓冲区。操作系统再根据策略将内核缓冲区的数据刷入磁盘。
② 读操作(以 fread 为例): C 库调用 read() 系统调用,一次性从内核缓冲区读取一大块数据到用户空间缓冲区。后续的 fread() 调用直接从用户缓冲区取数据,避免频繁的系统调用。
③ FILE 结构体: 在 Linux 中,FILE 结构体内部封装了文件描述符(fd)、缓冲区指针、缓冲区大小、当前读写位置、缓冲模式等信息。
4.3 FILE结构体 --用户缓冲区存储位置
struct _IO_FILE
{
    int _flags;                  // 文件状态标志(读写模式、错误、EOF 等)

    /* ===== 读缓冲区指针 ===== */
    char* _IO_read_ptr;          // 当前读指针(下一个要读取的位置)
    char* _IO_read_end;          // 读缓冲区的末尾(有效数据的末端)
    char* _IO_read_base;         // 读缓冲区的起始地址

    /* ===== 写缓冲区指针 ===== */
    char* _IO_write_base;        // 写缓冲区的起始地址
    char* _IO_write_ptr;         // 当前写指针(下一个要写入的位置)
    char* _IO_write_end;         // 写缓冲区的末尾(缓冲区的边界)

    /* ===== 缓冲区整体边界 ===== */
    char* _IO_buf_base;          // 整个缓冲区的起始地址
    char* _IO_buf_end;           // 整个缓冲区的结束地址

    /* ===== 文件位置与偏移 ===== */
    __off_t _offset;             // 文件当前的偏移量(类似 lseek 的位置)

    /* ===== 链表与线程安全 ===== */
    struct _IO_FILE* _chain;     // 指向下一个 FILE 结构体(链表,管理所有打开的流)
    _IO_lock_t *_lock;           // 互斥锁,保证多线程下对同一个 FILE 的操作安全

    /* ===== 底层文件描述符 ===== */
    int _fileno;                 // 底层封装的文件描述符 fd(open 系统调用返回的那个整数)

    /* ... 其他字段(如 backup buffer、短缓冲区、vtable 等) ... */
};
4.4 缓冲区的刷新条件
4.4.1 自动刷新缓冲区
A.基于缓冲模式的常规刷新
 缓冲模式               适用对象(默认情况)							触发刷新的条件

 全缓冲     			 普通磁盘文件								    "缓冲区写满"


 行缓冲 				 标准输出 stdout(连接终端时)					 "写入的数据遇到换行符 \n " 或 "缓冲区写满"


 无缓冲 				 标准错误 stderr							  "每次执行写操作时,立即刷新。"
B.特殊场景下的自动刷新
场景	             触发原因          	                           说明

读写切换	    从写操作切换为读操作	              在同一个可读写的流(如"w+"模式)中,执行读操作前,必须先刷出写缓冲区,
										       防止读到旧数据。


关闭文件	    调用 fclose(fp)	               在关闭文件时,内部会强制先执行刷新,再关闭底层文件描述符。


程序正常退出    调用 exit() 或 main函数的return  	C 运行时库会遍历所有打开的 FILE 链表,依次刷新并关闭所有流。
4.4.2 手动刷新缓冲区
完整的数据落地链路:用户缓冲区 --> (fflush) --> 内核缓冲区 --> (fsync)--> 物理磁盘
A.用户空间刷新(C 标准库层面)
函数			      作用范围			  					      说明

fflush(fp)  	  指定的单个输出流				将 fp 对应的用户缓冲区数据立即通过 write() 刷入内核。

fflush(NULL)      所有已打开的输出流				遍历 FILE 链表,刷新所有输出流的用户缓冲区。
B.内核空间刷新(操作系统层面)
  函数				作用								说明

fsync(fd)	强制刷盘(数据 + 元数据)	将内核缓冲区中的文件数据以及文件的元数据(如大小、修改时间)全部强制写入物理磁盘。
4.4.3 重要代码演示
#include <stdio.h>
#include <string.h>
#include <unistd.h>
#include <sys/types.h>
#include <sys/stat.h>
#include <fcntl.h>

int main()
{
    close(1);
    //关闭文件描述符fd=1,预测fd=1
    int fd = open("log.txt",O_CREAT| O_WRONLY | O_APPEND | O_TRUNC,0666);

    printf("fd:%d\n",fd);
    printf("hello Linux1\n");
    printf("hello Linux2\n");
    printf("hello Linux3\n");

    //通过系统调用write写入文件log.txt
    const char * msg="hello world\n";
    write(fd,msg,strlen(msg));

    fork();
    return 0;
}


输出结果如下所示:

[hamber@VM-0-14-centos lesson18]$ cat log.txt
hello world
fd:1
hello Linux1
hello Linux2
hello Linux3
fd:1
hello Linux1
hello Linux2
hello Linux3
解析
log.txt中 输出两次printf对应字符串的原因:
printf在stdout中执行的是行刷新,但是这里进行了重定向,改变了fd=1文件描述符的指向,所以这里不满足行刷新的规则,这里满足的是在程序结束后进行刷新。因为进行了fork函数的调用,创建了子进程,在main函数return后,父进程和子进程均需要进行从用户刷新缓冲区到内核缓冲区,所以输出两次
printf对应字符串到log.txt文件中。write函数是系统调用,不涉及用户缓冲区向内核缓冲区的刷新,所以这里只输出了一次到
log.txt文件中。
4.5 为什么需要缓冲区?
缓冲区存在的本质是:用于缓解速度差异 和 进行效率优化
4.5.1 减少系统调用次数
系统调用(如 read/write)涉及从用户态到内核态的切换,代价较高(上下文切换、参数校验等)。
模式 			行为 				 			系统调用次数

无缓冲 	每次写 1 个字节 				如果写100个字节,需要进行100次 write() -> 100 次上下文切换

有缓冲  	攒够 4096 字节再写  			1 次 write() -> 1 次上下文切换
4.5.2 匹配速度差异
CPU 的处理速度远高于磁盘 I/O 或网络传输速度,缓冲区充当“减速带”。
写操作:CPU 高速将数据写入内存缓冲区,然后由操作系统在后台慢慢刷到磁盘,CPU 不必等待。


读操作:操作系统一次性预读一大块数据到内核缓冲区(预读机制),后续读取直接命中缓存。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 2
 0
- 0


 已为社区贡献3条内容

所有评论(0)