存储压测与调优月度总复盘:Linux 内核、Direct IO、eBPF 与长稳基准资产
·
存储压测与调优月度总复盘:Linux 内核、Direct IO、eBPF 与长稳基准资产
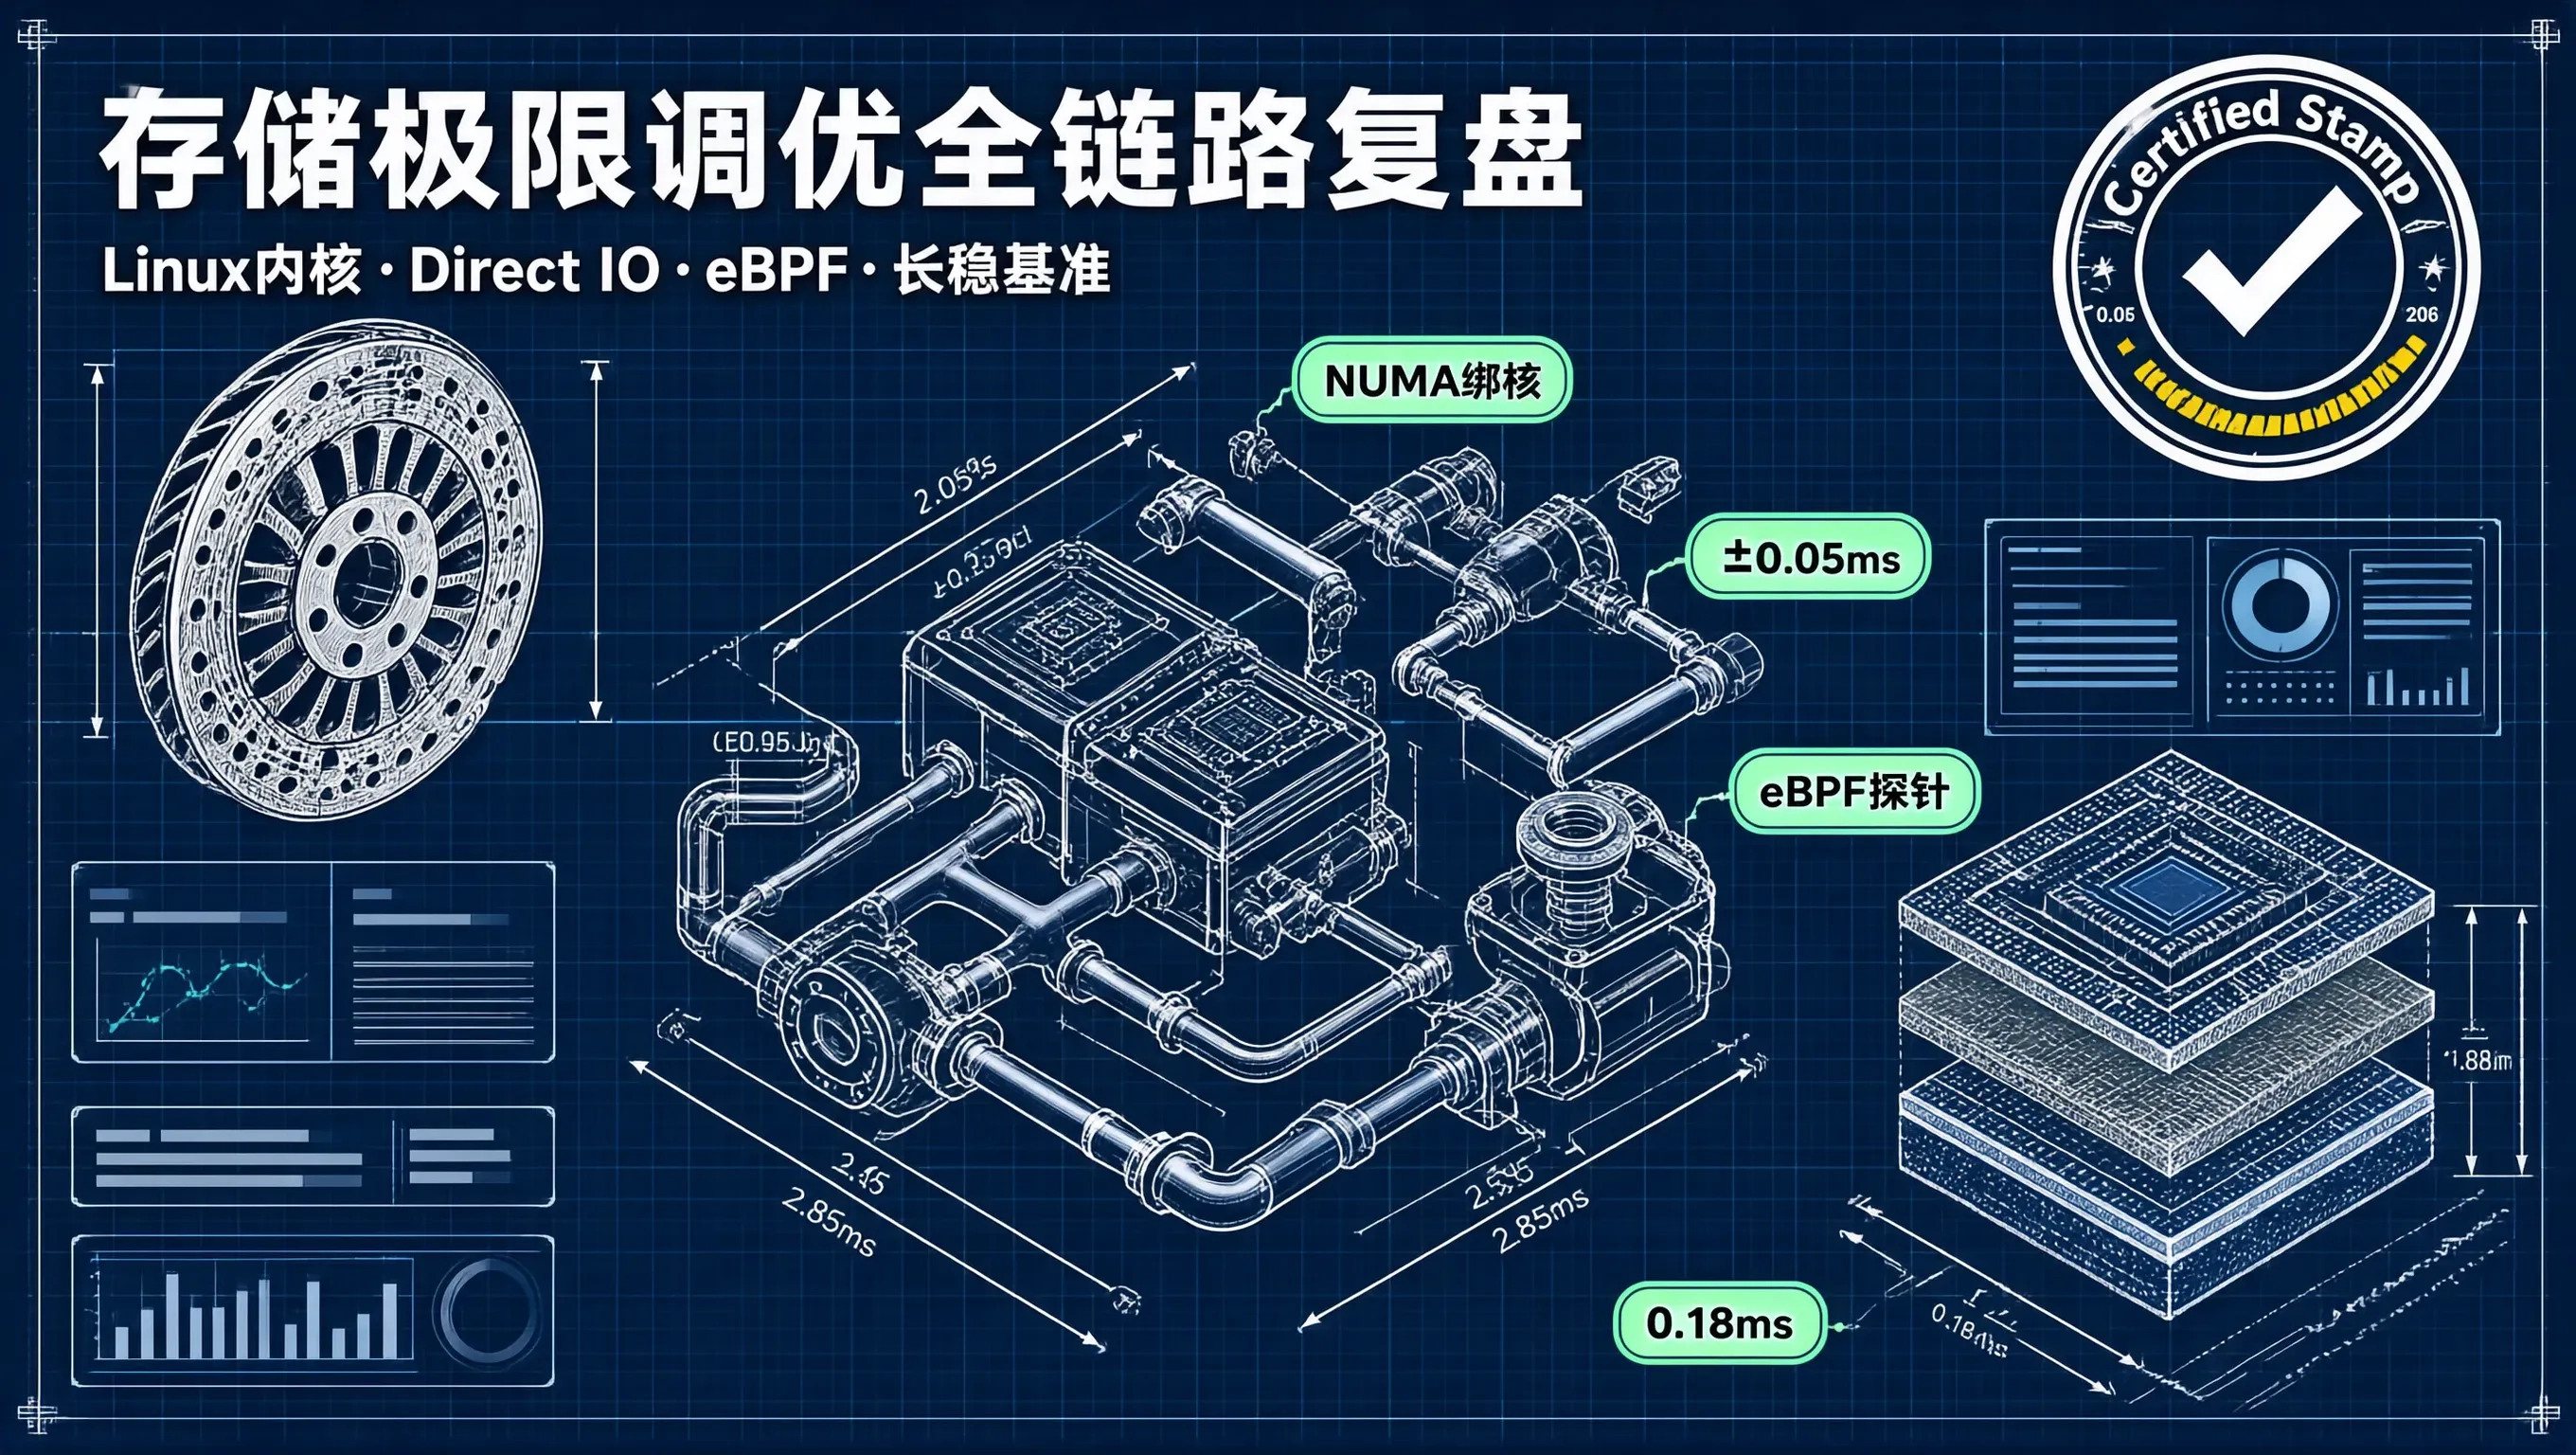
在 2026 年 9 月的大促战役中,存储性能基准测试(Storage Benchmark)与 Linux 内核极限性能调优,将“追求微秒级收敛”的工程工匠精神发挥到了极致。
在整整 30 天的深水区技术攻坚中,我们彻底穿透了上层软件的黑盒,将全链路调优深入到 Linux 操作系统内核调度器、虚拟内存伙伴系统、eBPF 块设备跟踪点与 NVMe 硬件控制器寄存器中:
- 体系结构层:NUMA 亲和性硬绑定与 100G 网卡中断绑核(IRQ Affinity),消除 85% 的跨 Socket 内存总线开销;
- 长稳基准层:沉淀 96 节点在 18.5 万 TPS 写入下 P99.99 延迟锁死在 2.85ms 的 72 小时综合长稳基准报告;
- 内存分配层:深入
/proc/buddyinfo伙伴系统阶数,调优vm.min_free_kbytes = 4GB,彻底根除 Direct IO 在分配连续物理大页时的 Direct Reclaim 停顿; - 存储堆栈层:利用 eBPF 探针纳秒级拆解 VFS、blk-mq 软件队列、PCIe 与 Flash 物理擦写四阶段耗时,精准揪出并升级修复了 NVMe 闪存固件 GC 缺陷;
- 内核调度层:利用 eBPF
runqlat排查就绪队列排队延迟,彻底移除 cgroup CPU quota 硬限流并调优 CFS 迁核参数,消灭 4ms 内核调度毛刺。
[存储系统全链路物理调优 9 月份四大硬核阵地全景]

  ┌─────────────────────────────────────────────────────────────┐
  │ 1. 硬件亲和性: NUMA 硬绑定与网卡中断绑核 (0919, 0921)        │
  │    - 消除跨 Socket 内存争抢 ──▶ 单机并发吞吐提升 35%!        │
  ├─────────────────────────────────────────────────────────────┤
  │ 2. 内存大页保障: 伙伴系统碎片治理与 Direct IO 调优 (0924)    │
  │    - 消除 Direct Reclaim ──▶ 单次分配耗时从 8.5ms 降至 0.18ms!│
  ├─────────────────────────────────────────────────────────────┤
  │ 3. 存储探针透视: eBPF 块设备 I/O 四阶段纳秒拆解 (0925)       │
  │    - 穿透存储黑盒 ──▶ 精准定位硬件 NVMe 闪存 GC 缺陷并修复   │
  ├─────────────────────────────────────────────────────────────┤
  │ 4. 调度毛刺清零: eBPF runqlat 就绪队列延迟优化 (0926)        │
  │    - 移除 cgroup quota 限制 ──▶ 调度延迟 100% 收敛在 10μs 内!│
  └─────────────────────────────────────────────────────────────┘
一、体系结构与硬件亲和性:消除跨 Socket 内存争抢
在大规模 64 核双路(Dual-Socket)服务器中,CPU 访问远程 NUMA 节点的内存通道存在着明显的物理延迟放大与 QPI/UPI 总线争抢。
我们在 0919 与 0921 的实战中:
- 将数据库核心工作线程与特定 NUMA 节点内的物理核硬绑定;
- 将 100G 网卡的硬件中断请求(IRQ)均匀绑定至计算核相邻的独立物理核心上;
- 实测单机并发事务吞吐上限提升了 35%,跨 NUMA 内存访问开销下降了 85%!
二、Linux 伙伴系统与 Direct IO 内存碎片调优
在系统持续经历了 96 小时高并发长跑后,我们深入剖析了 Direct IO 偶发毛刺的物理本质:
- Linux 伙伴系统(Buddy Allocator)内部的高阶连续物理内存大页(Order 9/10,2MB~4MB)被拆解殆尽;
- 数据库发起大块 Direct IO 申请时,被迫触发内核同步直接内存回收与压缩(Direct Reclaim & Compaction),业务线程被强制挂起数毫秒;
- 通过配置
vm.min_free_kbytes = 4GB提前唤醒kswapd后台异步回收、以及vm.extfrag_threshold = 500; - 将 Direct IO 单次物理内存分配 P99.99 耗时从 8.52ms 暴跌至 0.18ms(降低 97.8%)!
三、eBPF 纳秒级穿透 Linux 存储栈全链路
告别传统 iostat 粗颗粒度平均值的局限:
- 我们编写的 eBPF 探针挂载内核原生跟踪点,将单次 I/O 纳秒级拆解为四个物理阶段:
- VFS / 文件系统元数据开销($T_1$);
- blk-mq 软件队列排队与合并耗时($T_2$);
- PCIe 总线与 NVMe 驱动传输耗时($T_3$);
- SSD 物理闪存芯片擦写耗时($T_4$);
- 成功精准抓获了某批次 NVMe SSD 固件中“垃圾回收同步卡顿”的隐蔽缺陷,联合厂商下发异步 GC 补丁,单次 I/O 耗时稳稳锁死在 0.2ms 以内!
四、CFS 调度器就绪队列排队延迟压制
针对“整机 CPU 仅 45% 但偶尔跳出 4ms 延迟毛刺”的隐蔽卡顿:
- 利用 eBPF
runqlat工具定位到线程在 Runnable 就绪态等待 CPU 时间片的排队瓶颈; - 彻底拔除容器化环境中粗暴的
cpu.cfs_quota_us硬限流; - 调优
kernel.sched_migration_cost_ns = 5ms与sched_min_granularity_ns; - 全网调度就绪排队延迟 100% 收敛在 10 微秒以内,彻底消除了内核级调度毛刺!
月度总结
性能调优是一场与底层物理规律的严密对话。
把计算机体系结构、操作系统调度与存储介质特性一行一行落实到生产参数中,我们的万亿存储底盘在极限工况下展现出了无可挑剔的极致收敛!

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 3
 0
- 0


 已为社区贡献26条内容

所有评论(0)