解剖一个“迷你操作系统“——时间片轮转多道程序内核 mykernel 的实验与分析
一、实验环境与准备
实验在实验楼(shiyanlou)提供的 Linux 3.9.4 内核环境中进行,主要工作是:清理旧目录 → 打入 mykernel 补丁 → 生成最小化配置 → 编译 → 启动。
1.1 打入 mykernel 补丁
进入内核源码根目录后,先清理可能残留的旧实验目录,再通过 patch -p1 应用补丁,最后用 make allnoconfig 生成一个"全否"的最小化配置——这一步非常关键,它把内核裁剪到最小规模,使得编译时间从几十分钟缩短到几分钟,同时排除了大量无关子系统对实验的干扰。
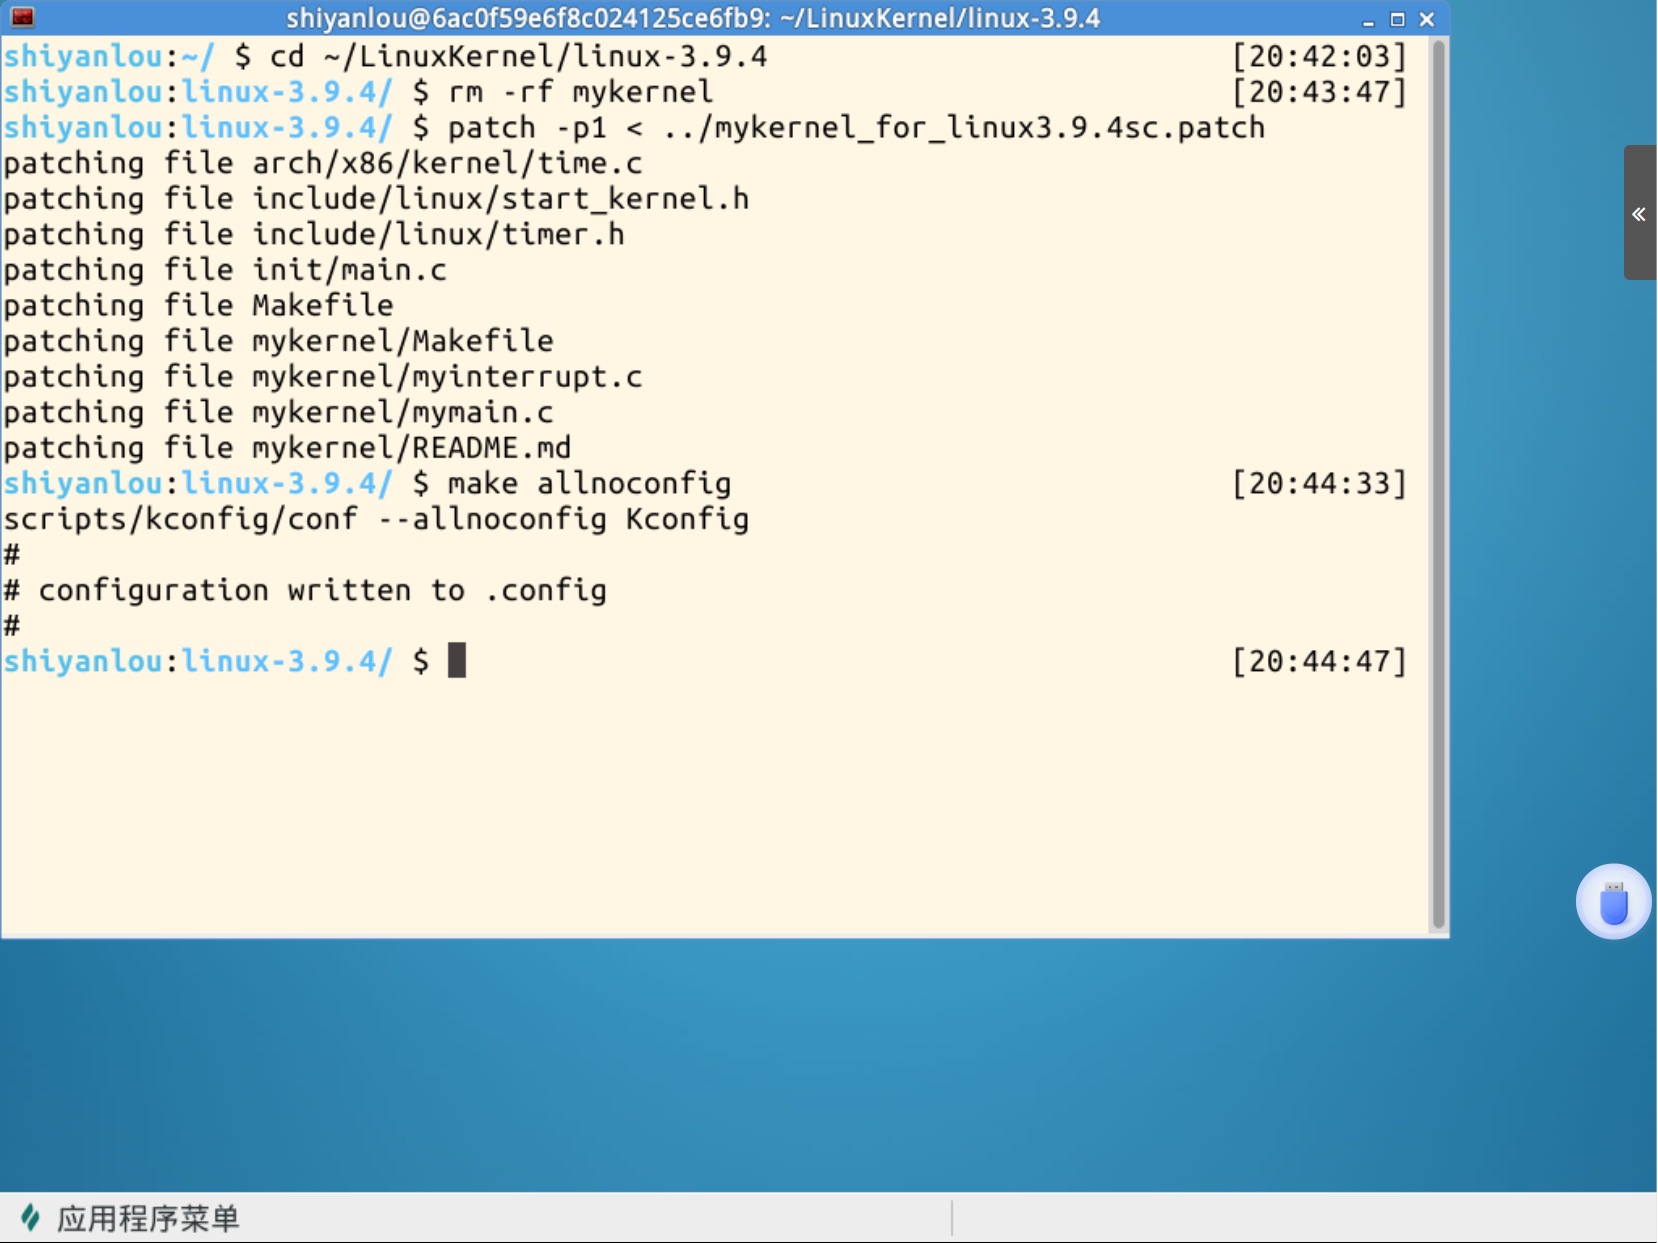
图 1:终端处于 /LinuxKernel/linux-3.9.4 内核根目录,依次完成切换目录、清理旧 mykernel 目录、打入实验补丁、生成最小化内核配置的操作。可以看到补丁成功应用到了内核的多个核心文件,.config 配置文件生成完毕。
从补丁的输出可以看出,mykernel 并不是一个"外挂"模块,而是直接修改了内核自身的四个地方:
| 被修改的文件 | 作用 |
|---|---|
arch/x86/kernel/time.c | 把时钟中断的处理函数替换为 my_timer_handler |
include/linux/stat_kernel.h、include/linux/time.h | 为实验补充声明 |
init/main.c | 把内核启动的入口 start_kernel() 中的进程初始化部分替换为 my_start_kernel() |
mykernel/ 目录 | 新增实验代码本体(mymain.c、myinterrupt.c、mypcb.h、Makefile) |
这正是理解操作系统的第一个关键认识:所谓"内核",本质上就是被放在特定位置、在特定时机被调用的一组函数。 我们替换掉 init/main.c 里的入口,整个系统的"性格"就变了——原本要启动 init 进程、挂载文件系统的 Linux,变成了只有我们自己调度逻辑的迷你内核。
1.2 编译内核
补丁完成后执行编译,最终生成可启动的内核镜像 bzImage,然后用 QEMU 启动验证。
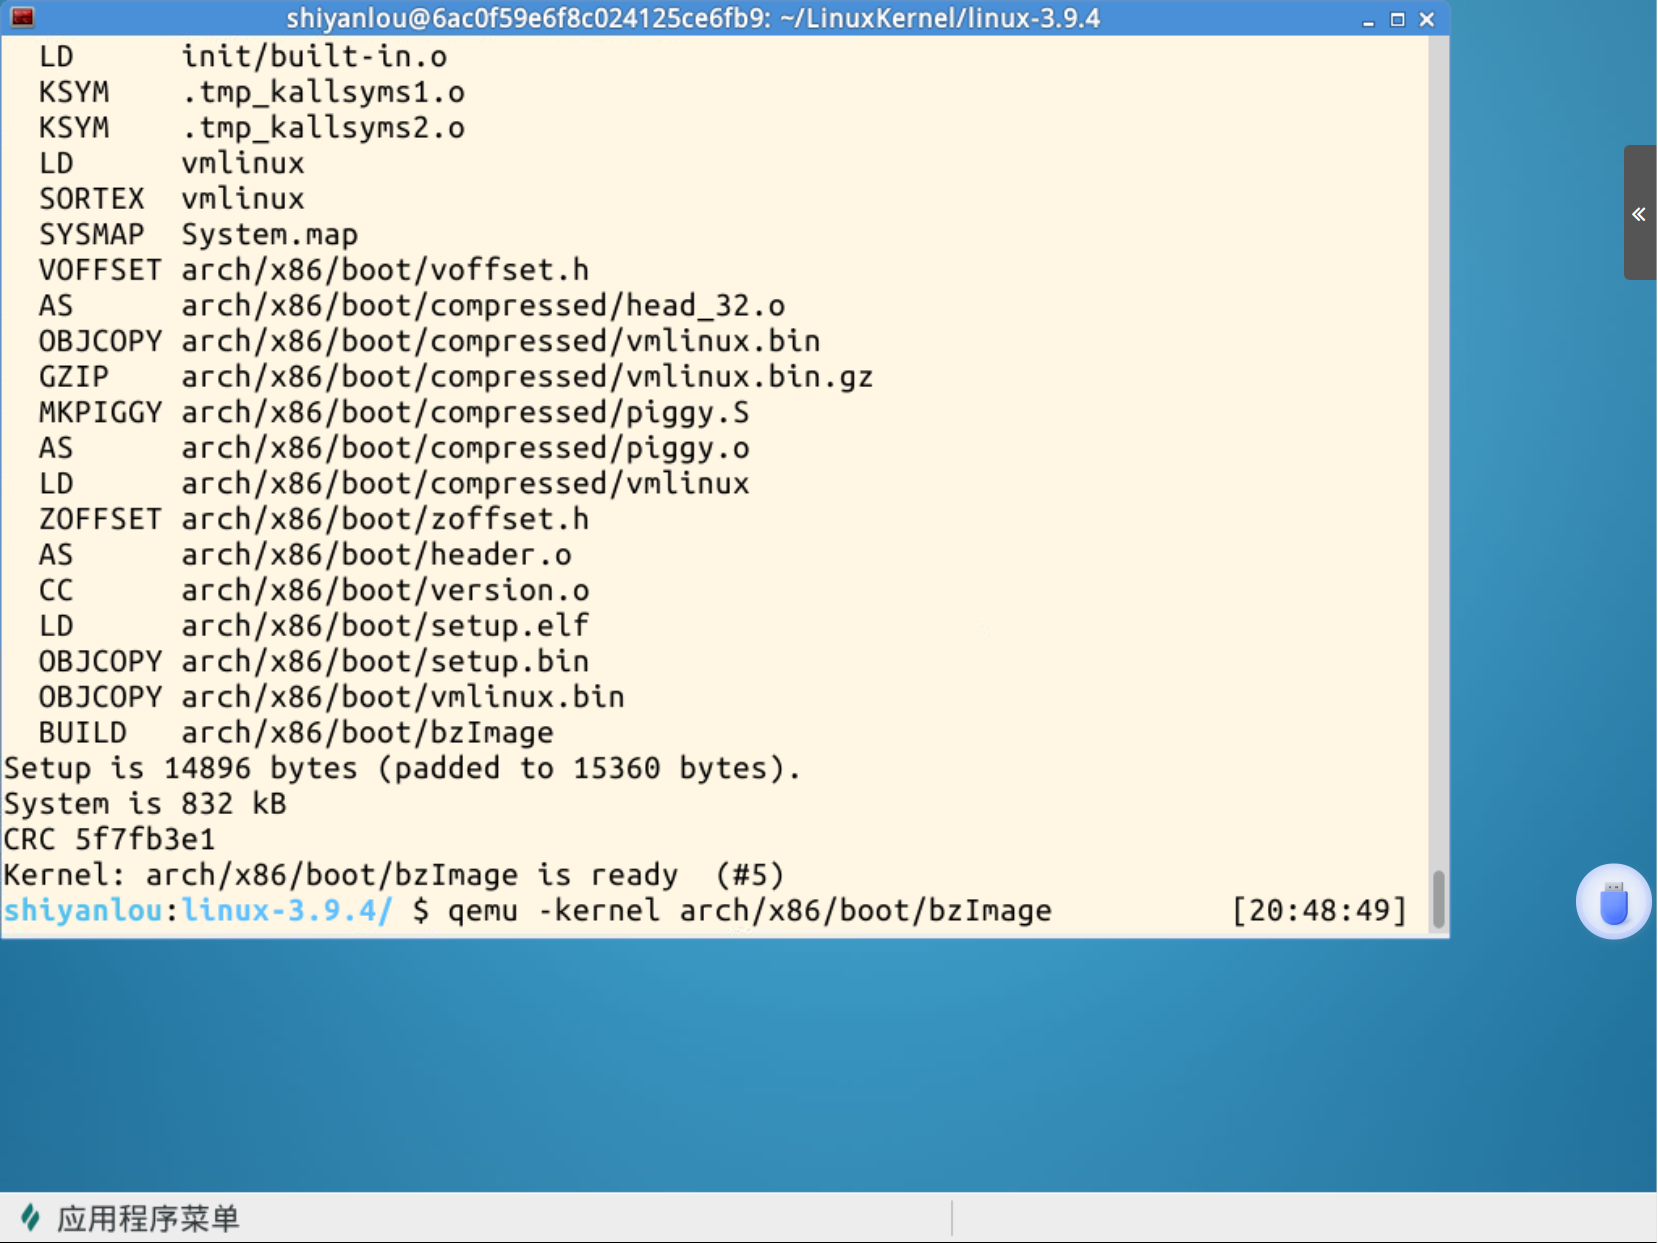
图 2:内核源码全程编译结束,成功生成可启动的 bzImage 内核镜像,终端输入 QEMU 虚拟机启动命令,准备加载运行本次实验的精简内核。
图 15:内核根目录下,代码修改后完成新一轮编译,成功生成 bzImage 内核镜像(版本 #7),镜像大小、CRC 校验值同步更新,说明代码改动已编译进内核文件。
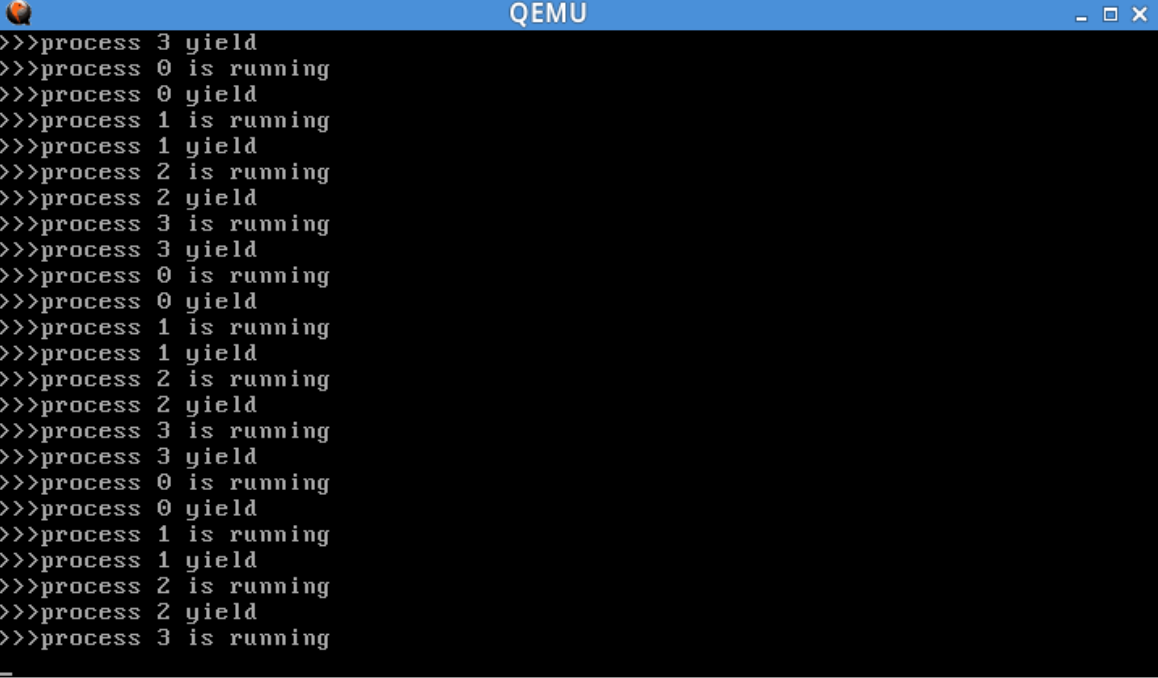
图 16:内核根目录下完成第 9 次编译,bzImage 镜像生成成功,终端输入 QEMU 虚拟机启动命令,准备加载最新编译的内核,验证代码修改后的实际运行效果。
一点体会:实验中反复编译了 9 次。每一次
make都是"改代码 → 编译 → 启动 → 看输出 → 再改"的循环。内核开发没有捷径,能快速验证的改动才是好的改动,这也是精简内核存在的意义。
二、mykernel 的源码结构
2.1 目录与文件构成
内核启动后,进入 mykernel 子目录查看实验源码。
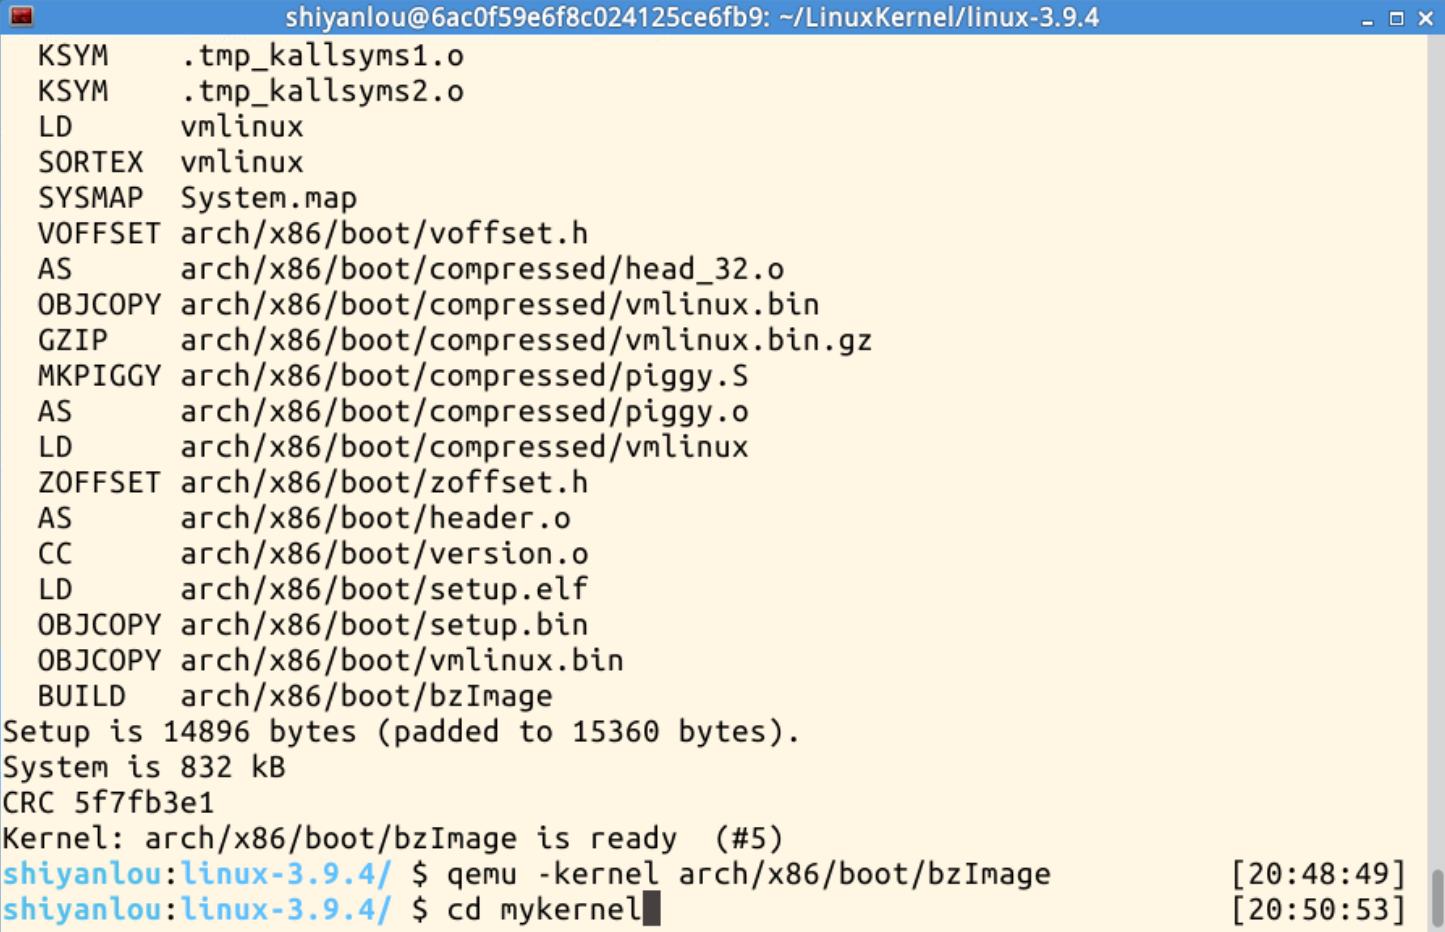
图 3:执行内核启动命令后,终端通过 cd 命令切换到 mykernel 子目录,准备查看和修改实验相关的核心源码。
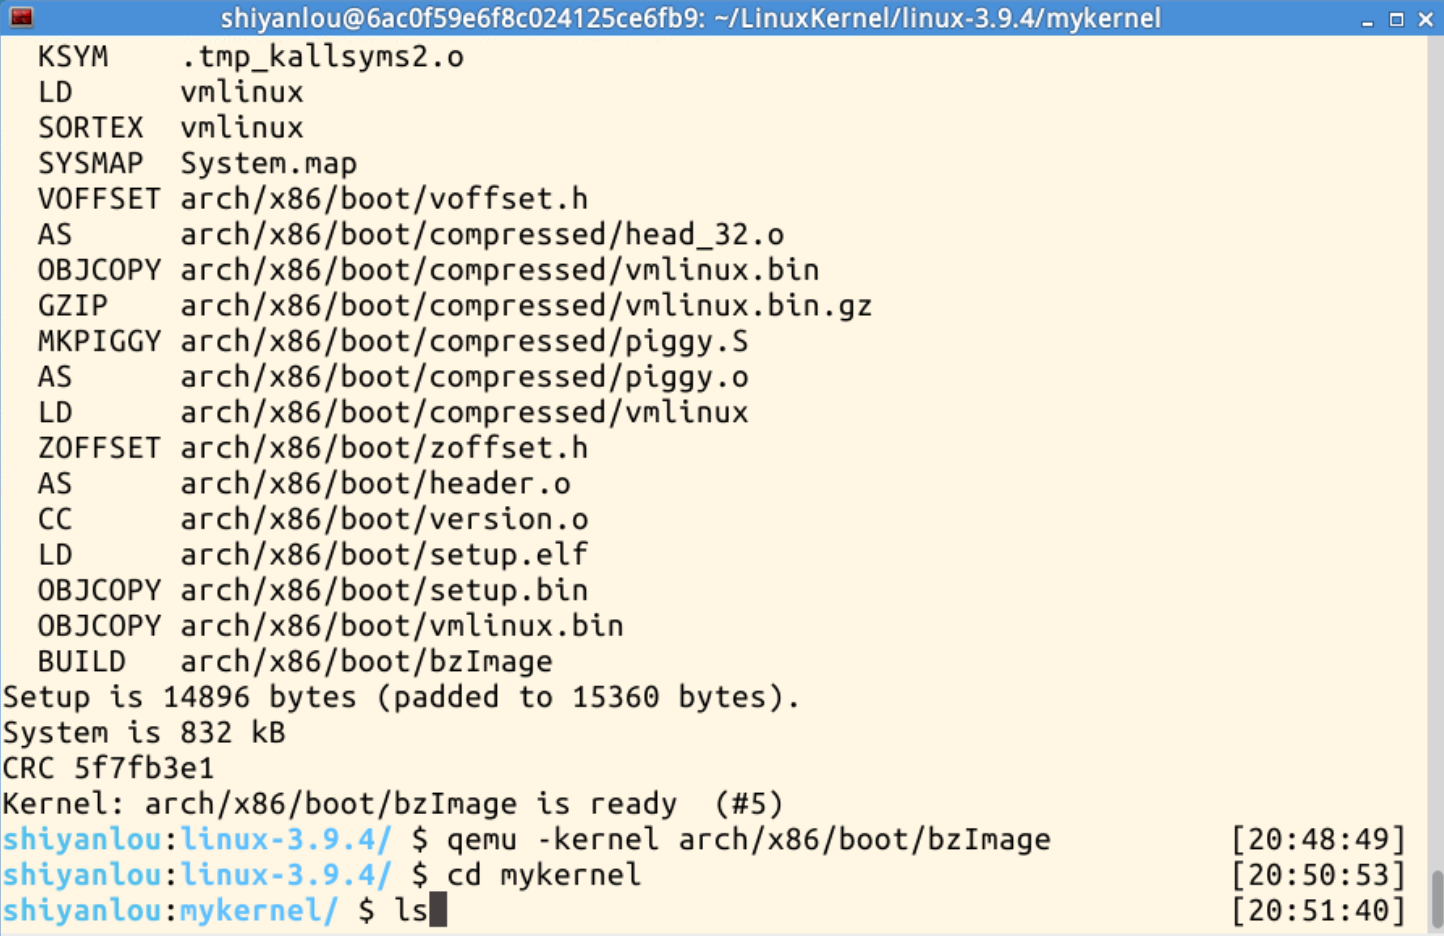
图 4:在 mykernel 目录下执行 ls 命令,列出目录内的源码文件、编译目标文件、Makefile 和说明文档,随后执行 vim 命令,准备编辑 mymain.c 内核入口文件。
整个实验的核心只有三个 C 文件:
mypcb.h—— 进程控制块(PCB)的定义,是进程的"身份证";mymain.c—— 内核启动入口my_start_kernel()和进程体my_process();myinterrupt.c—— 时钟中断处理my_timer_handler()和进程调度my_schedule()。
2.2 原版代码:一个"假"内核
先看补丁自带的原版 mymain.c:
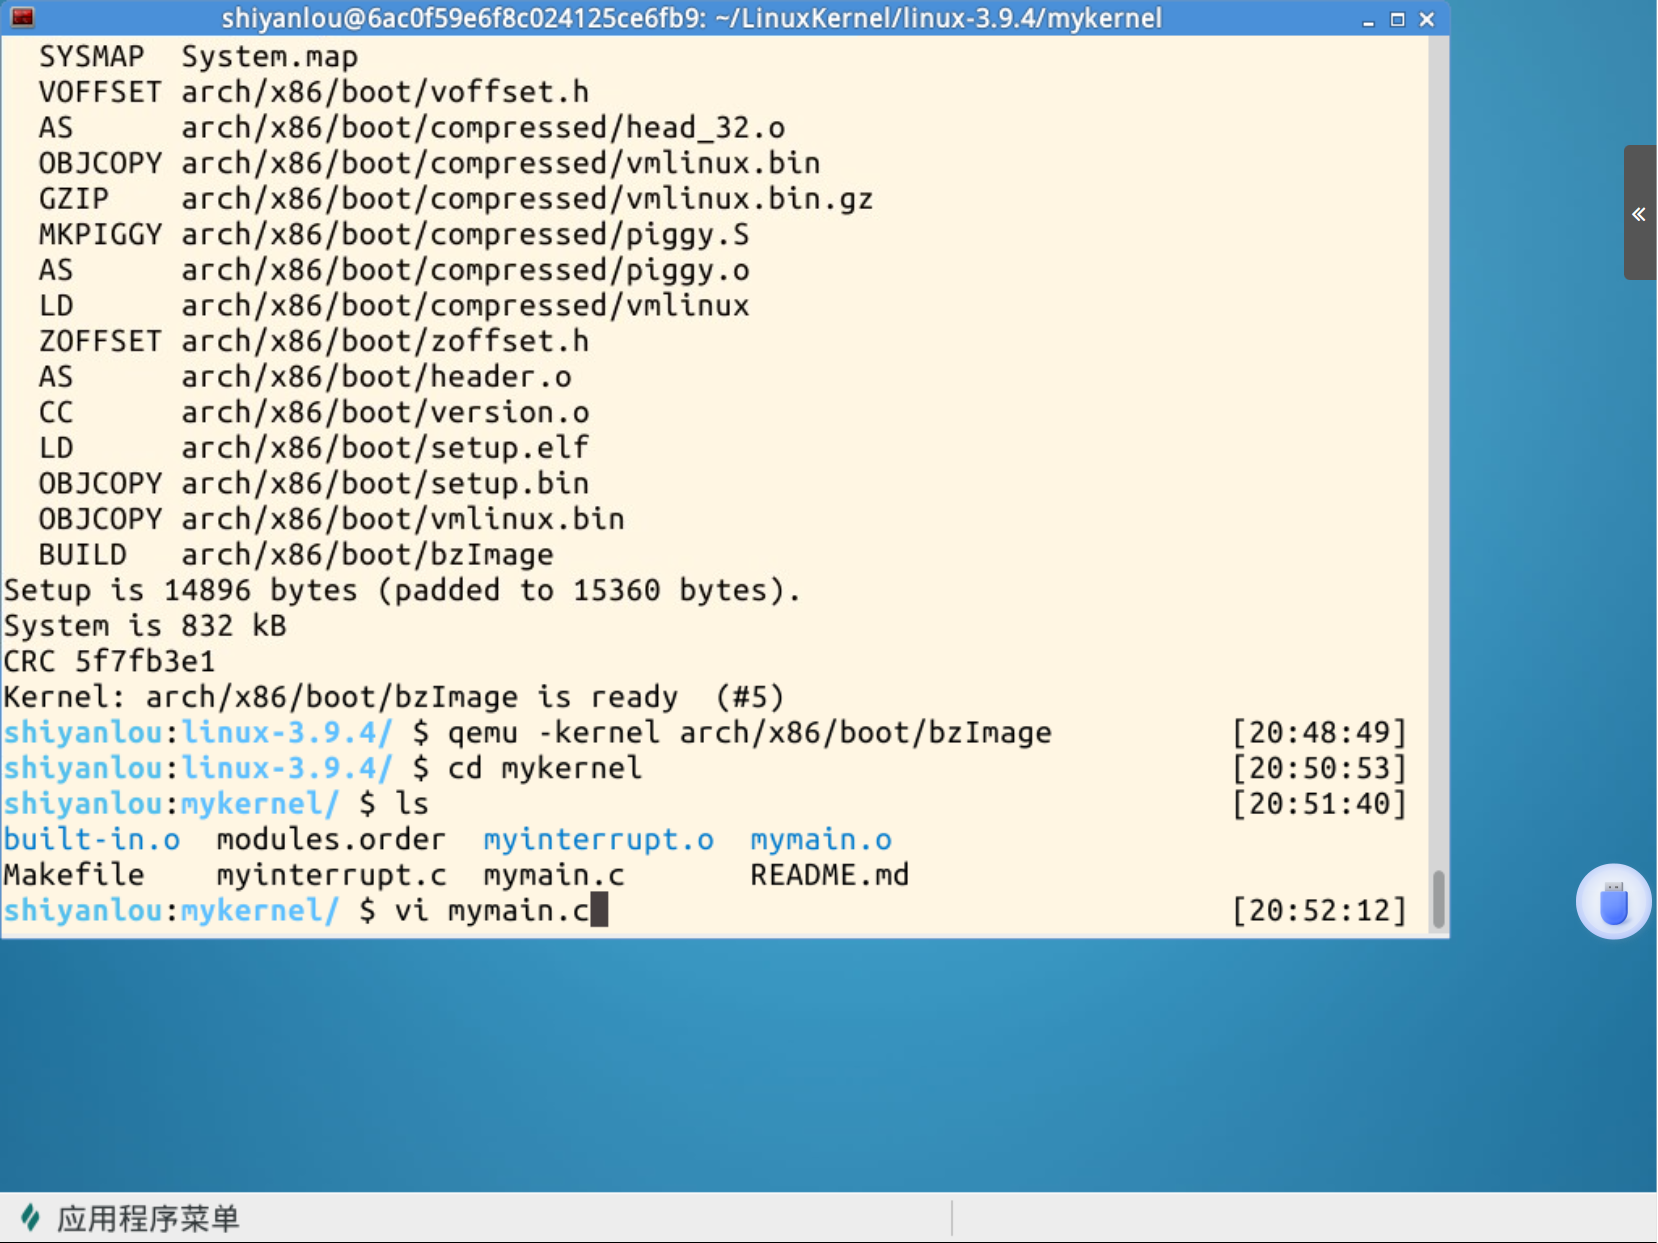
图 5:vim 编辑器打开原版 mymain.c 文件,展示补丁自带的初始内核入口代码:my_start_kernel 函数内仅包含一个死循环,每计数到固定次数打印一行日志,尚未实现多进程与调度逻辑。
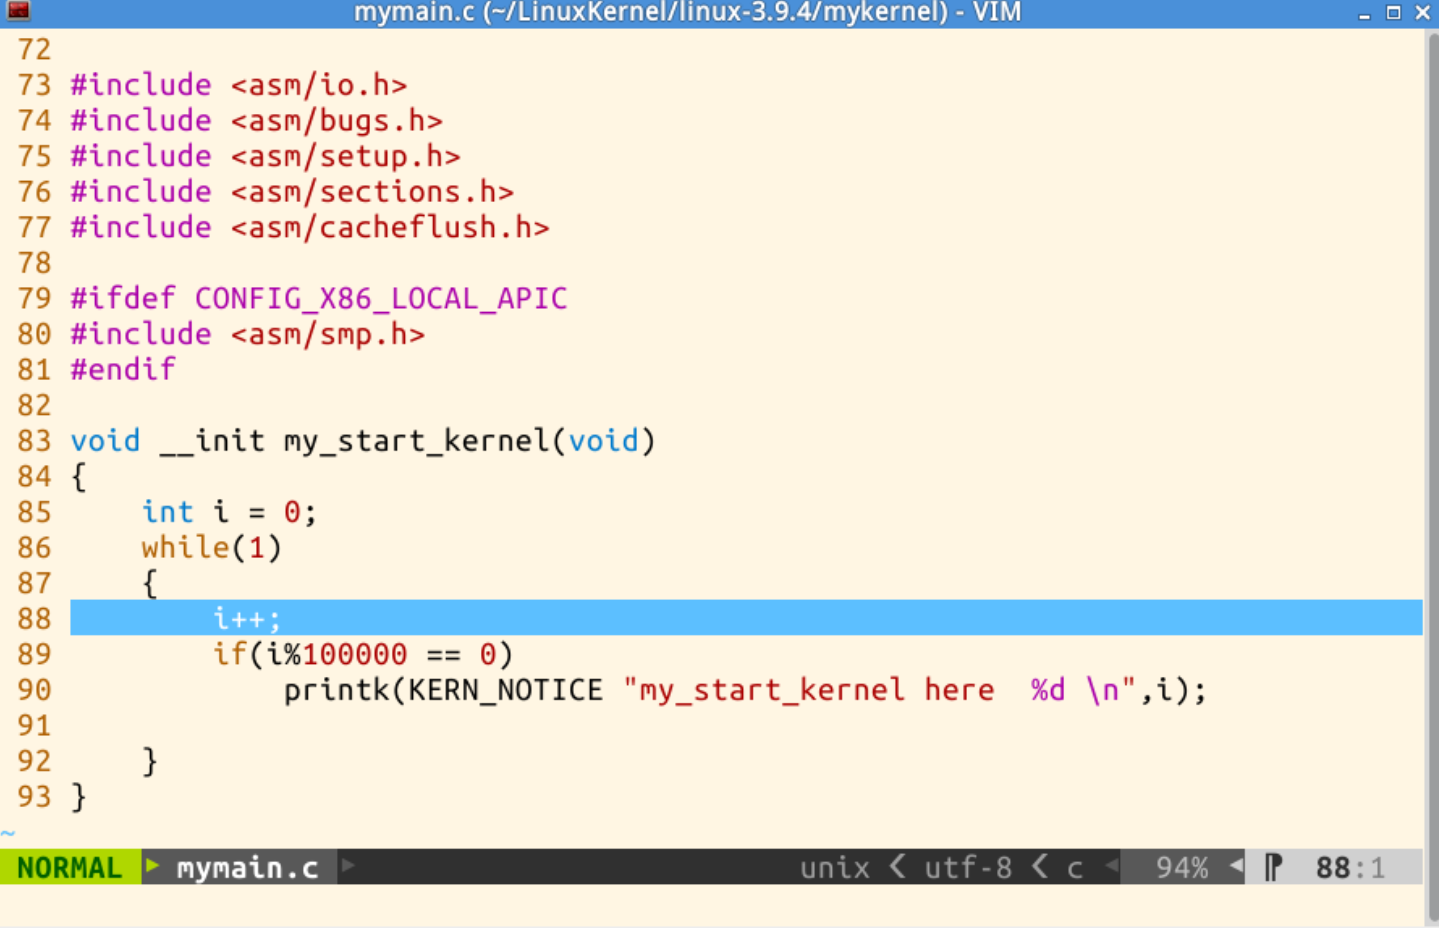
图 6:vim 界面聚焦 mymain.c 的循环计数逻辑,清晰展示原版单进程内核的执行流:程序在死循环内持续计数,满足条件时通过 printk 输出信息,CPU 始终被这一个执行流占用。
此时 my_start_kernel() 的结构大致是这样的:
void __init my_start_kernel(void)
{
    int i = 0;
    while (1) {
        i++;
        if (i % 100000 == 0)
            printk(KERN_NOTICE "my_start_kernel here %d \n", i);
    }
}
再看原版 myinterrupt.c: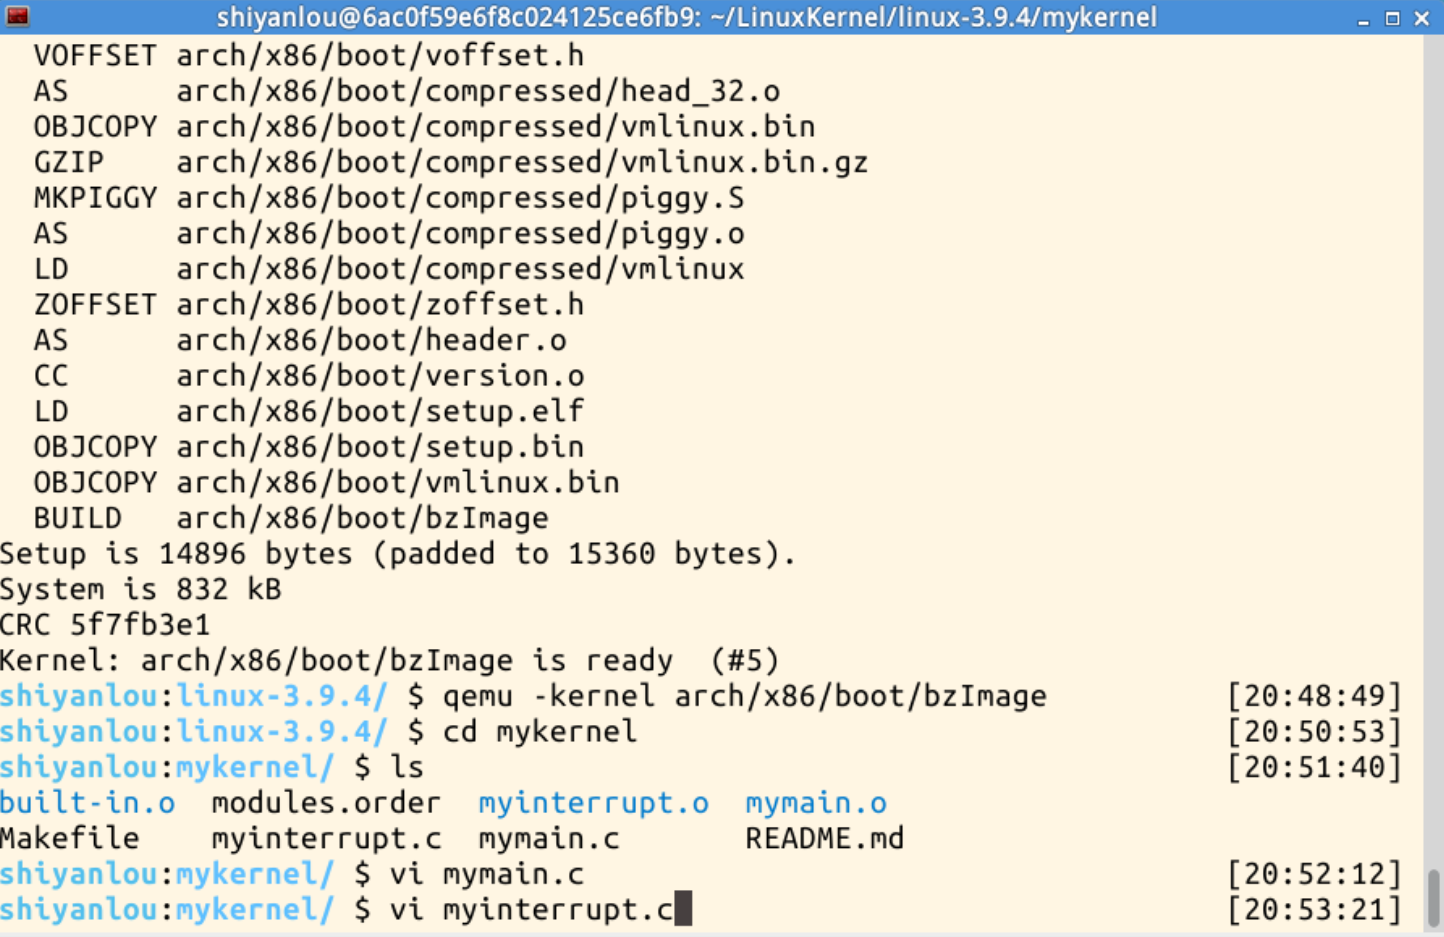
图 7:终端执行 vim 命令,准备打开并编辑时钟中断处理文件 myinterrupt.c,为后续添加调度逻辑做准备。
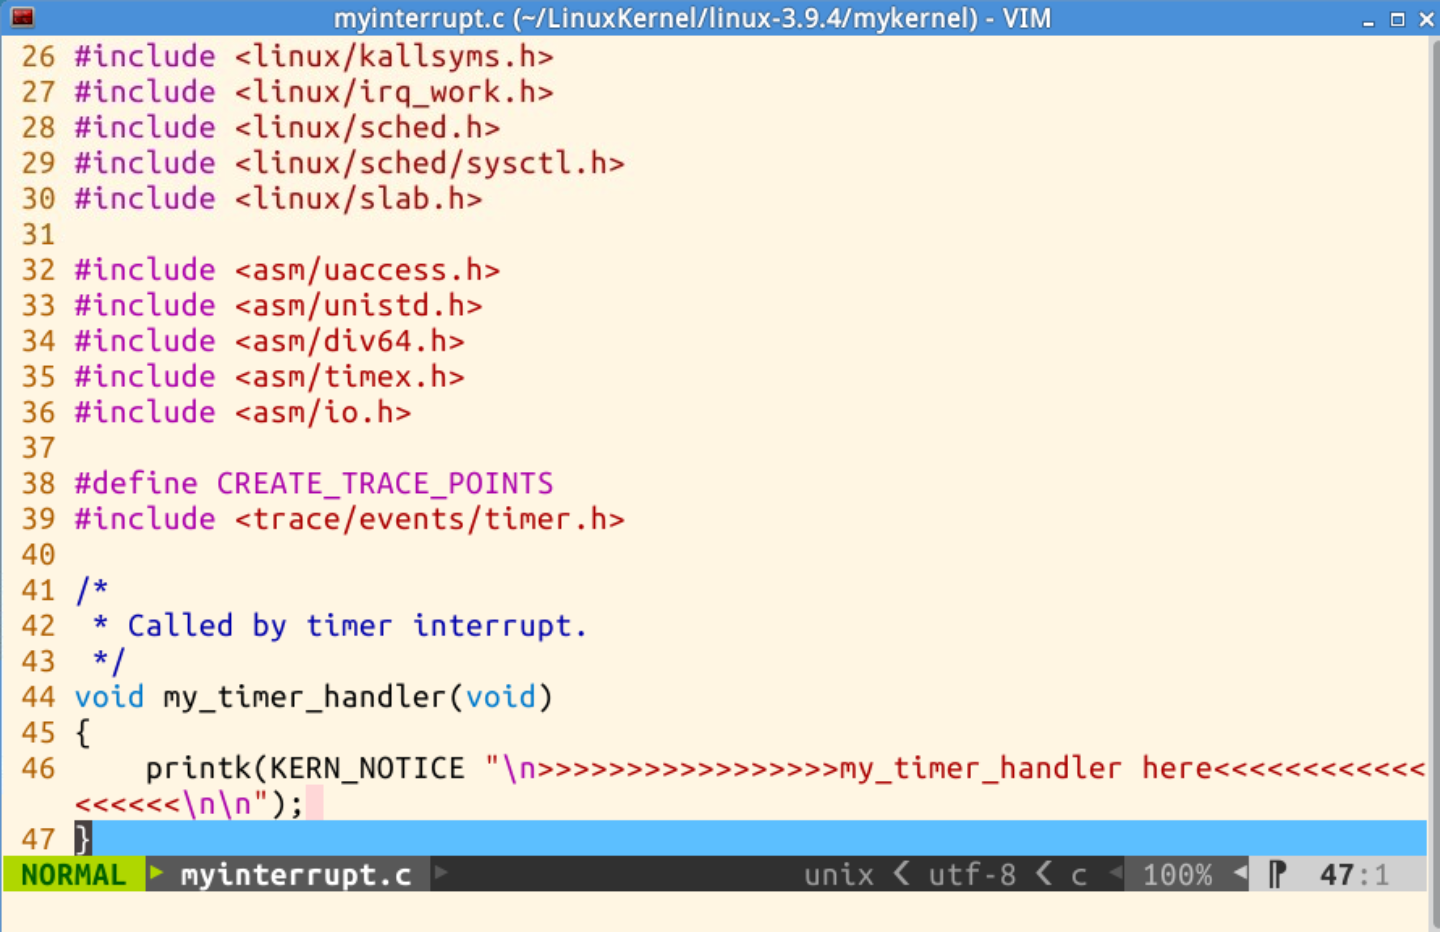
图 8:vim 编辑器打开原版 myinterrupt.c 文件,展示补丁自带的初始中断处理代码:包含大量内核头文件,时钟中断处理函数 my_timer_handler 仅打印中断触发提示,没有进程调度与上下文切换逻辑。
void my_timer_handler(void)
{
    printk(KERN_NOTICE "\n>>>>>>>>>>>>>>>>>my_timer_handler here<<<<<<<<<<<<<<<<<<\n\n");
}
这个"内核"显然不能算操作系统:入口函数进来就是一个死循环,永远不返回;时钟中断只是打印一行字,不做任何有意义的事。它验证了一件事——光有中断和入口,没有"进程"这个抽象,系统就无法同时做两件事。整个实验要做的,就是在这两个函数之间搭起"进程"这座桥。
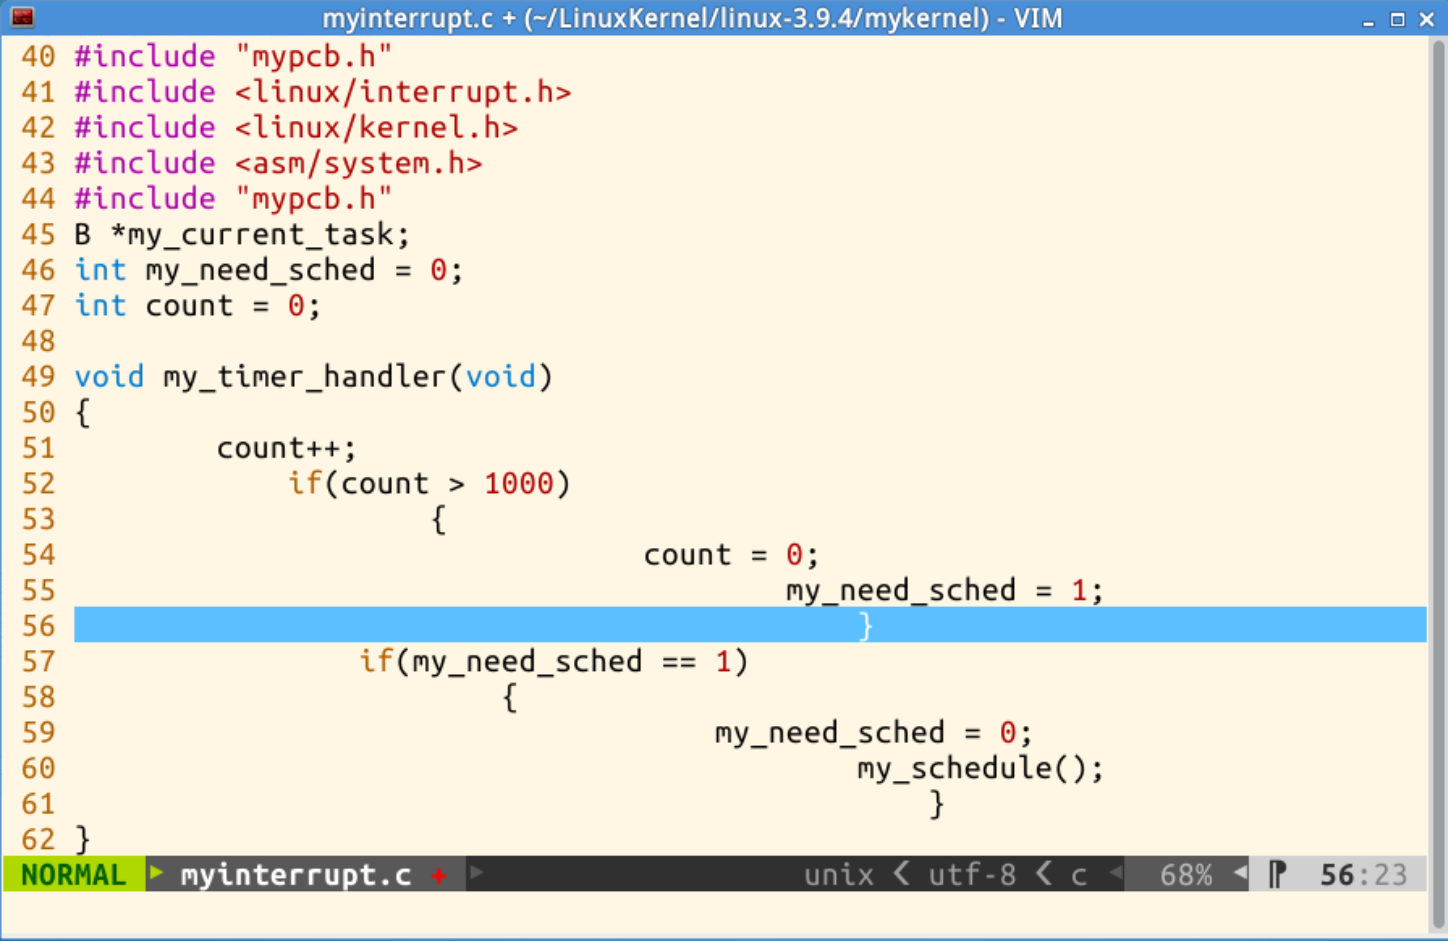
图 13:vim 编辑器打开 mymain.c 文件,显示补丁自带的原始单进程内核入口代码,my_start_kernel 函数内是计数打印的死循环逻辑,底部已输入 :wq 指令,准备保存文件并退出编辑器。
三、进程的描述:进程控制块 PCB
要让"进程"这个概念落地,首先要有一块内存来描述它。在 mykernel 中,这就是 mypcb.h。
图 9:终端先后执行编辑 mymain.c、创建并编辑 mypcb.h 的命令,准备新增进程控制块头文件,以此为基础扩展多进程调度功能。
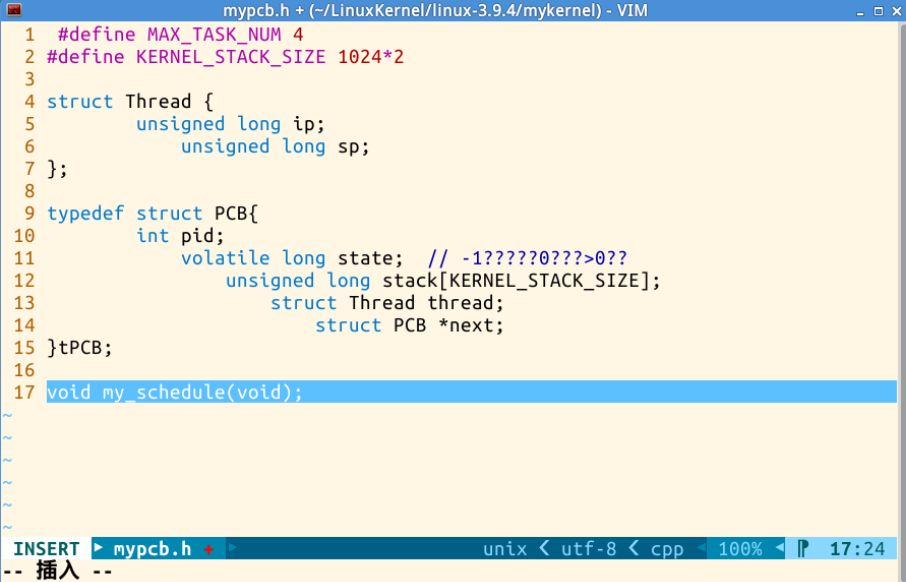
图 10:vim 编辑器打开 mypcb.h 头文件,已完成进程控制块相关定义:包含最大进程数、内核栈大小的宏定义,Thread 上下文结构体,PCB 进程控制块结构体,以及调度函数声明,当前处于编辑插入模式。
补全后的 mypcb.h 如下:
#define MAX_TASK_NUM        4
#define KERNEL_STACK_SIZE   1024*8

/* CPU 现场状态 */
struct Thread {
    unsigned long       ip;   /* 指令指针 */
    unsigned long       sp;   /* 栈指针   */
};

typedef struct PCB {
    int                 pid;                          /* 进程号 */
    volatile long       state;                        /* -1 不可运行, 0 可运行, >0 停止 */
    unsigned long       stack[KERNEL_STACK_SIZE];      /* 进程的内核栈 */
    struct Thread       thread;                        /* 当前 CPU 现场 */
    unsigned long       task_entry;                    /* 进程入口函数 */
    struct PCB          *next;                         /* 指向下一个进程,构成循环链表 */
} tPCB;

void my_schedule(void);
这里有三个设计点值得反复咀嚼:
第一,每个进程拥有独立的内核栈。 stack[KERNEL_STACK_SIZE] 这一行是整个实验的基石。进程切换之所以能"换一个世界继续跑",根本原因就是每个进程的栈是分开的——切换栈,就切换了函数调用现场。这和真实 Linux 中每个进程有独立内核栈(通常 8KB,即双页)的设计思路完全一致。
第二,struct Thread 里只存了 ip 和 sp 两个寄存器。 这看起来简陋得不可思议,但它恰恰揭示了进程切换的最小充分条件:只要保存了"下一条要执行的指令在哪"(ip)和"栈在哪"(sp),这个执行流就可以被暂停和恢复。 其他寄存器(eax、ebx……)会随着栈上的函数调用现场被自然保存和恢复。
第三,next 指针构成单向循环链表。 这为实现"时间片轮转"提供了最朴素的数据结构:调度的动作就是"取下一个"。
四、进程的启动机制:进程 0 是怎么"无中生有"的
这是整个实验中最精妙、也最难理解的部分。
4.1 先创建,再启动
my_start_kernel() 分两步走。第一步是数据结构层面的创建:把 4 个 PCB 串成循环链表。
void __init my_start_kernel(void)
{
    int pid = 0, i;

    /* 初始化 0 号进程 */
    task[pid].pid          = pid;
    task[pid].state        = 0;                                   /* 可运行 */
    task[pid].task_entry   = task[pid].thread.ip = (unsigned long)my_process;
    task[pid].thread.sp    = (unsigned long)&task[pid].stack[KERNEL_STACK_SIZE - 1];
    task[pid].next         = &task[pid];                          /* 自成一环 */

    /* 派生出 1、2、3 号进程 */
    for (i = 1; i < MAX_TASK_NUM; i++) {
        memcpy(&task[i], &task[0], sizeof(tPCB));                 /* 复制 0 号进程的模板 */
        task[i].pid          = i;
        task[i].state        = -1;                                /* 不可运行:还没跑过 */
        task[i].thread.sp    = (unsigned long)&task[i].stack[KERNEL_STACK_SIZE - 1];
        task[i].next         = task[i-1].next;
        task[i-1].next       = &task[i];
    }
    ...
}
注意几个细节:
thread.ip全部指向my_process这个函数入口——四个进程跑的是同一个函数体,区别只在于各自的pid和各自的栈。这就是"多道程序"最纯粹的样子。thread.sp指向各自栈数组的最高地址(栈是从高地址向低地址生长的)。- 1、2、3 号进程的
state = -1,表示"已创建但从未运行"。这个标志位将在调度时被区分对待,是理解进程切换分支的关键。 - 链表的构造顺序是
task[0] → task[1] → task[2] → task[3] → task[0]。
4.2 用 push + ret 伪造一次函数调用
第二步才是真正"让 CPU 跑起来"。my_start_kernel() 结尾是一段内联汇编:
    pid = 0;
    my_current_task = &task[pid];
    asm volatile(
        "movl %1, %%esp\n\t"   /* 1. 把 0 号进程的栈顶地址装入 esp */
        "pushl %1\n\t"         /* 2. 压入 ebp 的初始值 */
        "pushl %0\n\t"         /* 3. 压入 my_process 的入口地址 */
        "ret\n\t"              /* 4. 弹出栈顶到 eip —— 跳进 my_process! */
        "popl %%ebp\n\t"       /* 5. 恢复 ebp */
        :
        : "c" (task[pid].thread.ip), "d" (task[pid].thread.sp)
    );
这段代码的巧妙之处在于:它用一条 ret 指令完成了对 my_process 的跳转,而不是用 call。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 4
 0
- 0


 已为社区贡献1条内容

所有评论(0)