进程的基本概念与操作
目录:
1. 冯诺依曼结构
无论是我们日常使用的笔记本电脑,还是数据中心里轰鸣的服务器,绝大多数现代计算机都遵循着同一个伟大的基础架构——冯·诺依曼体系结构。理解这个结构,是理解计算机底层运行逻辑的基石。
我们将从最基础的硬件架构出发,逐步推导出计算机运行的核心机制,并最终揭示计算机数据流动的本质。
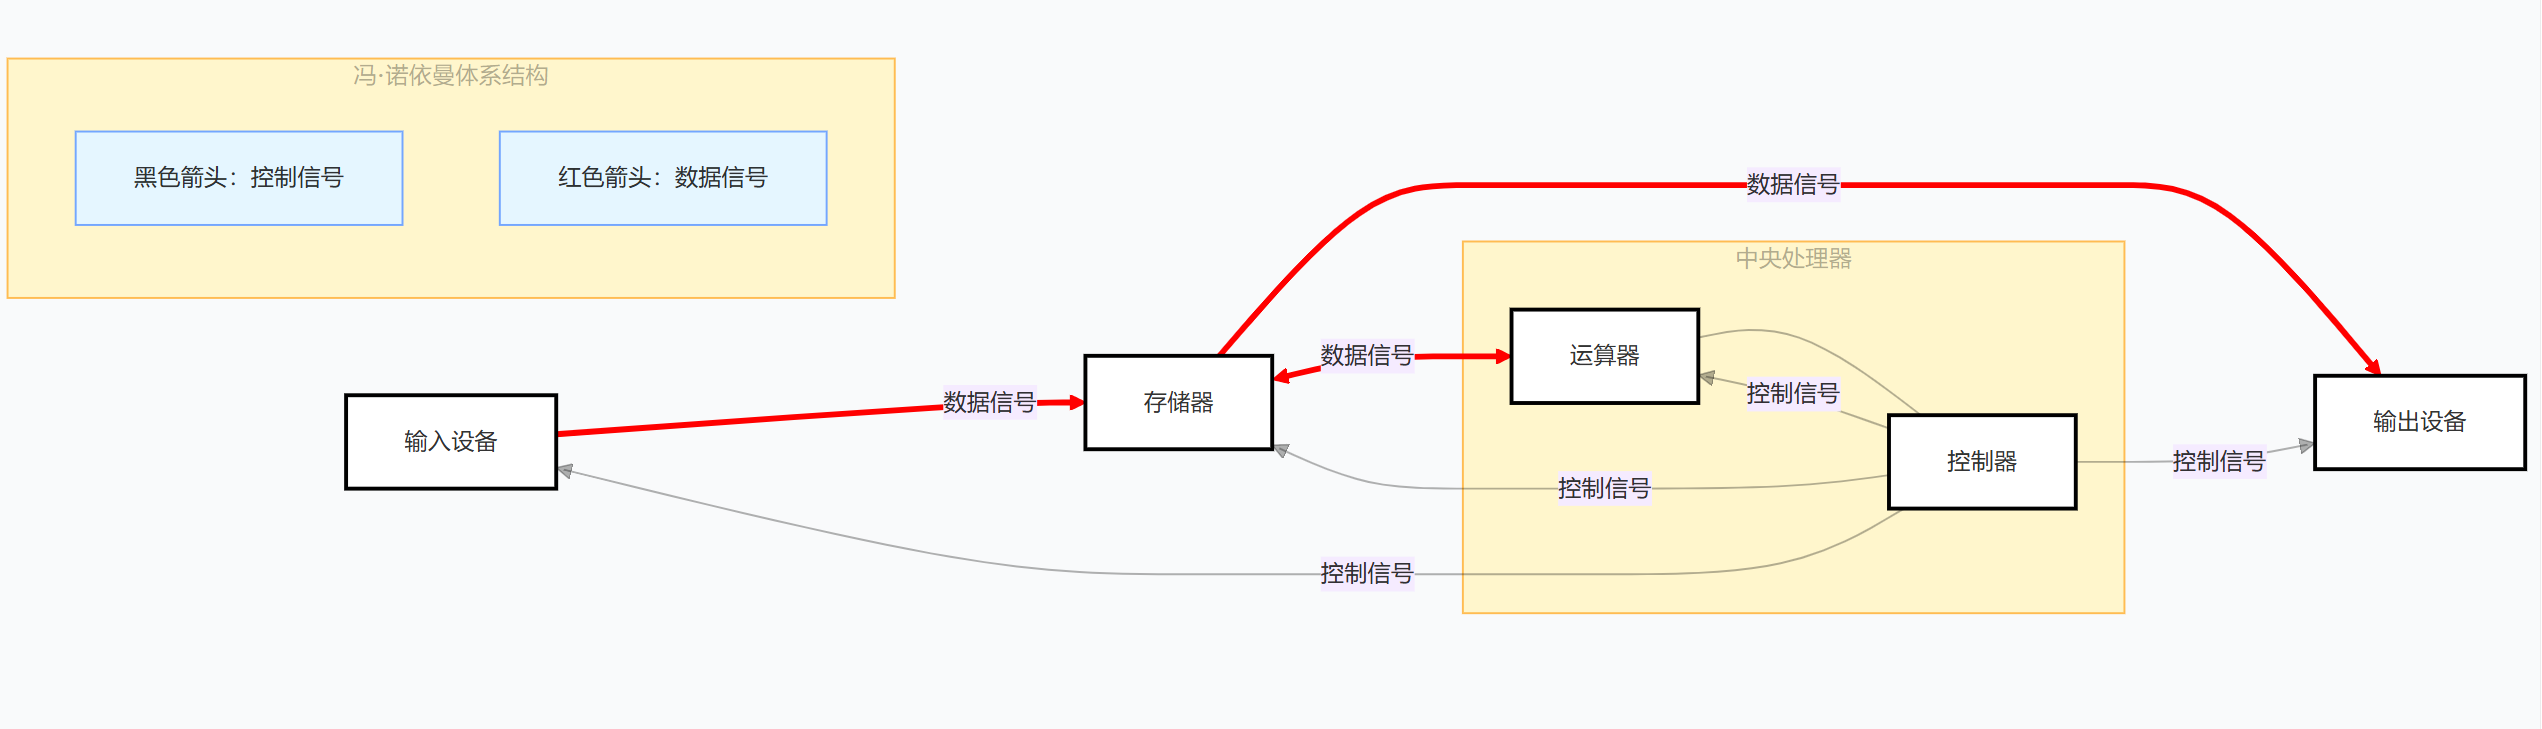
五大核心部件:
-
输入设备:负责接收外部信息,如键盘、鼠标、扫描仪等。
-
输出设备:负责将处理结果呈现给外界,如显示器、打印机等。
-
存储器:负责存放数据和程序。
-
运算器:负责算术运算和逻辑运算。
-
控制器:负责协调和控制各个部件的工作。
-
中央处理器(CPU):由运算器和控制器共同组成,是计算机的运算和控制核心。
1.1 存储器的地位与价值
1.1.1 引入内存的原因
外设(如硬盘、网卡、键盘)的读写速度相比于CPU的运算速度,存在着巨大的鸿沟。如果CPU直接与这些慢速外设交互,其绝大部分时间都将处于等待状态,性能会被严重浪费。
1.1.2 局部性原理与预加载
为了解决速度不匹配的问题,计算机引入了内存。基于局部性原理,数据可以被提前加载到内存中。在大部分情况下,当CPU需要处理数据时,可以直接与速度较快的内存进行交互。这在很大程度上掩盖了外设的慢速,极大地提升了整体效率。
1.1.3 体系结构
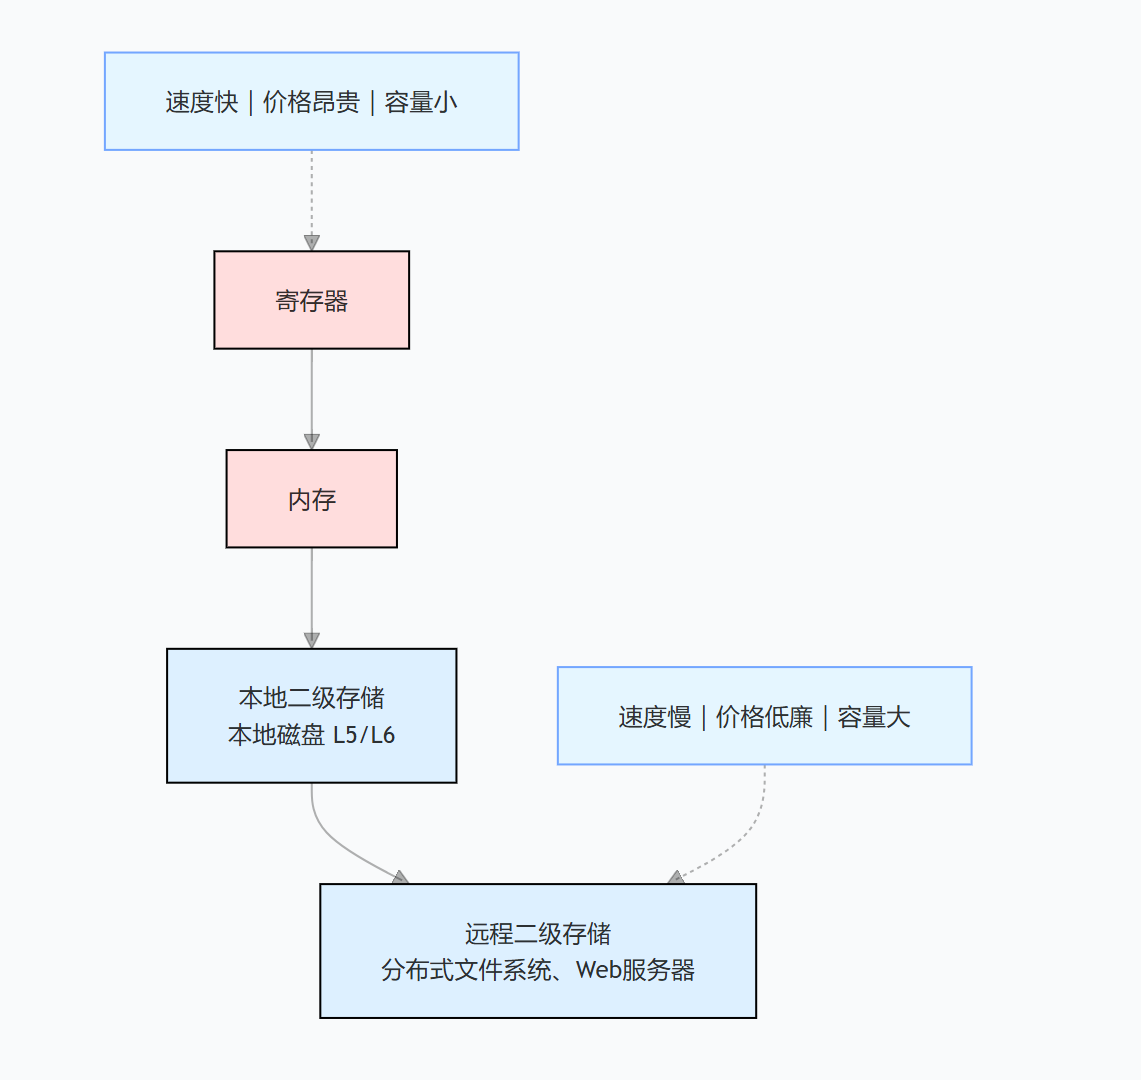
计算机如果全部用最贵最快的寄存器来存所有数据,成本会高到普通人根本买不起;但如果全部用廉价慢速的磁盘,运行速度又会极差。 所以工程师设计了分层存储体系:
- 寄存器:CPU 内部,速度最快、价格最贵、容量最小,存放当前 CPU 正在运算的数据。
- 内存:速度较快,成本中等,存放当前程序运行需要的数据。
- 本地二级存储:就是电脑硬盘,速度慢,价格便宜,容量大,用来持久保存本地文件。
- 远程二级存储:远端服务器,分布式文件系统、网页服务器,容量极大,成本很低,但是要走网络,速度最慢。
分层的好处:
遵循局部性原理:程序在一段时间内,只会频繁访问一小部分数据。 把高频访问的数据放在高速昂贵的上层存储;低频、海量数据放在低速廉价的下层存储。 用较低的整体成本,拿到不错的运行效率,也就是高性价比。
1.2 输入与输出(I/O)
在编写代码时,我们经常接触到 Input 和 Output(例如C语言的 #include <stdio.h>,C++的 #include <iostream>)。这里的输入和输出,是站在内存的角度,或者说站在加载到内存中的程序的角度来定义的。
-
凡是把数据拷贝进内存的,就是输入设备。例如:键盘、鼠标、扫描仪、摄像头、话筒,以及接收网络数据的网卡和读取数据的磁盘。
-
凡是把数据从内存拷贝出去的,就是输出设备。例如:显示器、打印机、播放声音的内置喇叭,以及发送网络数据的网卡和写入数据的磁盘。
在数据层面上,CPU不和外设直接打交道,CPU只和内存交互。 这就是冯·诺依曼体系为计算机提供的性价比优势。
计算机数据流动的过程,本质上就是“拷贝”!
-
文件从硬盘加载到内存,是一次拷贝(Input)。
-
内存将数据传递给CPU寄存器,是一次拷贝。
-
CPU运算完毕将结果写回内存,是一次拷贝。
-
内存将数据刷新到显示器,是一次拷贝(Output)。
计算机的效率问题,本质上由设备的拷贝效率决定。 内存之所以成为核心枢纽,正是因为它是所有数据拷贝的集散地。
2. 操作系统
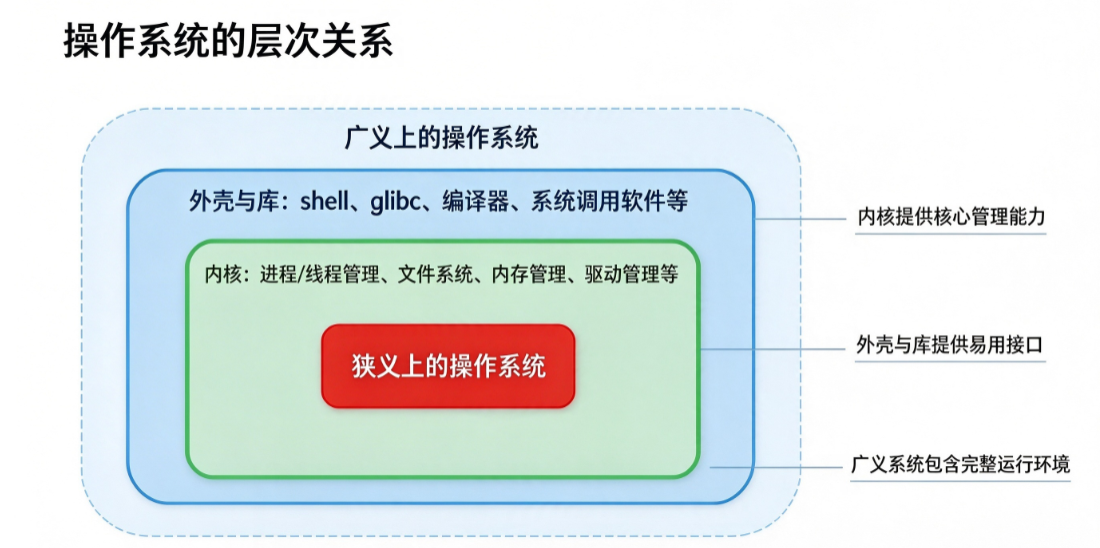
任何计算机系统都包含一个基本的程序集合,称为操作系统。从不同视角来看,操作系统有不同的定义:
-
广义的操作系统:包含了内核、外壳(Shell)、以及预装的系统级软件等。实际上是一个包含了内核、图形界面、基础函数库(如glibc、g++等)和预装软件的庞大集合。这是一个面向普通用户的、开箱即用的整体环境。
-
狭义的操作系统(OS内核):真正被称为“操作系统”的核心,即 Kernel(内核)。
无论何种计算机设备,其内核都必须具备四大核心功能:
-
内存管理
-
文件管理
-
驱动管理
-
进程管理
操作系统本质上是一款软件,是一款进行软硬件资源管理的软件。
2.1 操作系统的管理
操作系统本质是一套承担管理职能的系统软件。我们可以抽象理解管理行为本身:管理包含两大核心活动:决策与执行。
在管理模型中存在两类主体:管理者与被管理者。
- 管理者:负责制定规则、判断情况、下达指令,也就是完成决策。
- 被管理者:接收管理者下发的指令,完成对应的任务,也就是负责执行。
管理者不需要直接接触每一个被管理者个体,依然可以完成有效的管理。实现远程、批量管理的核心途径,是采集、持有被管理者的相关状态数据。
管理者依靠被管理者的状态信息,掌握当前整体情况,以此作为判断依据进行决策。
由此可以提炼结论:管理的本质,是对被管理者相关数据的管理;数据是管理者进行决策的依据与来源。
放到操作系统场景理解: 操作系统作为计算机软硬件资源的管理者,它并不需要直接 “接触” CPU、内存、进程这些硬件 / 程序实体。操作系统会维护大量描述资源状态的数据结构(进程 PCB、内存页表、文件元信息等),依靠这些数据掌握所有资源的状态;基于这些数据做调度、分配、回收等决策,再由硬件与进程完成实际执行。
2.2 权限与安全:系统调用
理解了操作系统是一个庞大的管理者后,我们来看看它是如何为用户提供服务的。我们电脑上的软件分为多个层次:
-
用户层:包括命令行、图形化界面、库函数等。
-
系统软件层:即操作系统的四大管理模块。
-
驱动层:硬件驱动程序。
-
底层硬件:网卡、硬盘、显示器等。
如果我们写C/C++代码,调用的很多函数(如 printf、fopen)实际上都是对系统调用的封装。通常我们不直接接触系统调用,因为操作系统在保护自己。
操作系统引入保护机制的核心原因:操作系统无法信任任意用户态应用程序。应用程序的行为不可预知,若允许应用直接访问硬件、修改系统资源,可能造成系统崩溃、数据损坏或安全破坏。
为实现资源保护与安全访问,CPU 提供了用户态与内核态两种运行级别。普通应用程序运行在用户态,权限受限,不具备直接访问底层硬件的能力。 当应用程序需要执行硬件相关操作,例如读写磁盘、发起网络通信时,必须通过系统调用接口,触发 CPU 从用户态切换至内核态,由操作系统内核代为完成对应的资源访问操作。内核处理完成后,CPU 再切回用户态,将执行结果返回给应用程序。
3. 进程基本概念
关于什么是进程,不同维度有不同的定义:
-
课本概念:程序的一个执行实例,正在执行的程序等。
-
内核观点:担当分配系统资源(CPU时间、内存)的实体。
而在现代操作系统(尤其是Linux)的视角下,有一个极为精准的公式:
进程 = 内核数据结构对象 + 自己的程序代码和数据。
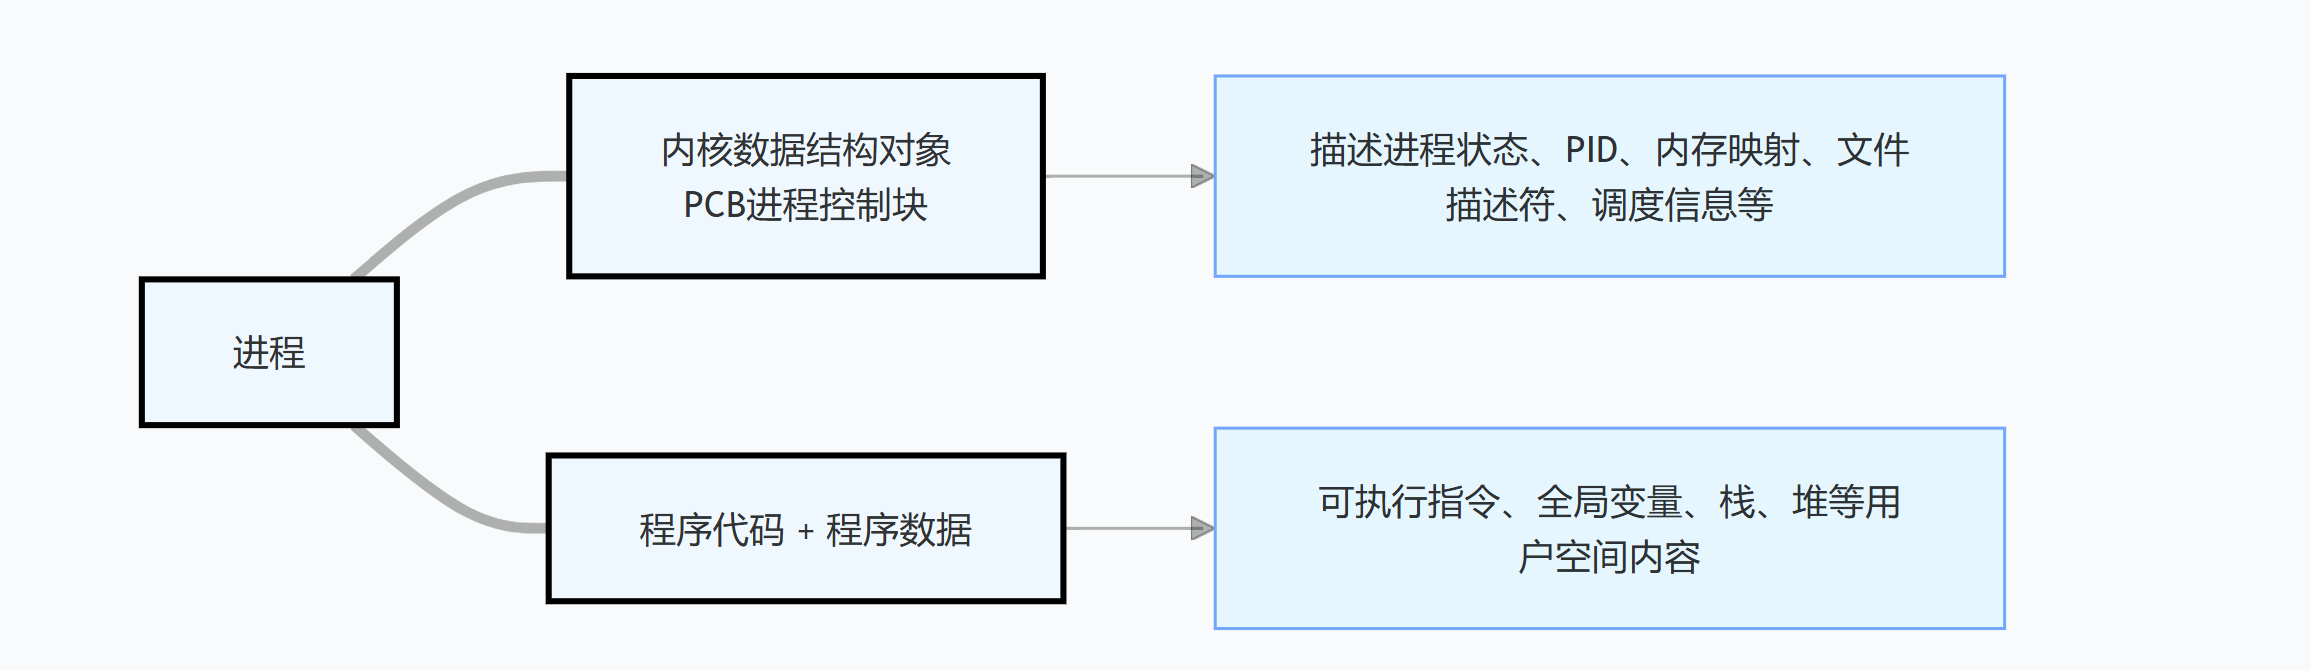
为了理解这个公式,我们需要澄清一个概念:什么不是进程?
写在磁盘上的 code.c 源文件,或者编译生成的 code.exe 可执行文件,它们不是进程。它们本质上是文件,是存放在磁盘上的静态“代码和数据”。
当一个程序需要运行时,操作系统会将其从磁盘Input(加载)到内存中。此时,这个程序才拥有了成为进程的基础。双击图标、执行 ./cmd 命令,本质都是启动进程!
3.1 PCB
操作系统为了管理进程,会把每一个进程的全部属性、状态信息,统一存放在一个专门的数据结构中,这个数据结构称为进程控制块 PCB(Process Control Block)。PCB 可以理解为进程属性信息的集合,是操作系统感知、管理进程的核心载体。 PCB 是通用理论概念,在不同操作系统中有各自具体实现。在 Linux 操作系统中,PCB 对应的实现就是 task_struct 结构体,也就是说 task_struct 属于 PCB 的一种具体实现。
task_struct 是 Linux 内核定义的数据结构类型。每当创建一个新进程,内核就会在内存(RAM)中分配一块空间,实例化一个task_struct对象,这个对象内保存该进程所有管理信息。内核就是依靠内存里大量的task_struct实例,完成对系统内所有进程的管理。
3.2 task_struct
在 Linux 中,task_struct 是内核的一种数据结构类型。它会被装载到 RAM(内存)里,并且包含着进程的所有信息。任何进程的所有属性,都是直接或间接通过这个结构体找到的。
task_struct 的内容极其庞大,主要分类如下:
-
标示符 (Identifiers):描述本进程的唯一标示符(PID),用来区别其他进程。
-
状态 (State):任务状态、退出代码、退出信号等。
-
优先级 (Priority):相对于其他进程的优先级。
-
程序计数器 (Program Counter):程序中即将被执行的下一条指令的地址。
-
内存指针 (Memory Pointers):包括指向程序代码和进程相关数据的指针,还有和其他进程共享的内存块的指针。
-
上下文数据 (Context Data):进程执行时处理器寄存器中的数据。(这是进程切换时“休学与复学”的关键,后续会详细探讨CPU与寄存器的交互)。
-
I/O状态信息 (I/O Status Information):包括显示的I/O请求,分配给进程的I/O设备和被进程使用的文件列表。
-
记账信息 (Accounting Information):可能包括处理器时间总和、使用的时钟数总和、时间限制、记账号等。
-
其他信息。
我们在Linux终端输入的命令,实际上也是在启动进程。
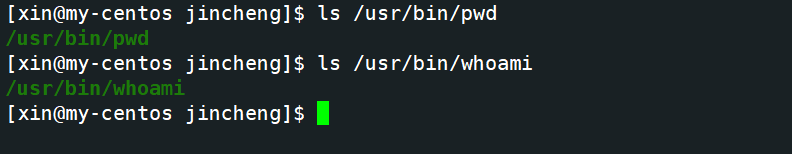
-
ls、pwd、whoami,这些被执行的命令,本质上都是在磁盘特定路径下的文件(程序)。 -
当我们在终端敲下回车时,操作系统将它们加载到内存,并为它们创建对应的
task_struct(PCB),此时它们就变成了进程。 -
命令执行完毕,输出结果(Output),进程结束,操作系统回收其对应的
task_struct和内存空间。
4.查看进程

4.1 PID 与 PPID
在操作系统中,为了区分和管理众多的进程,内核为每个进程分配了一个唯一的身份标识。
-
进程ID (PID):描述本进程的唯一标示符,用来区别其他进程。
-
父进程ID (PPID):每个进程(除了系统初始进程)都是由另一个进程创建的,创建者就是父进程。
获取标识符:系统调用
在 Linux 内核的 task_struct 结构体内部,保存着该进程的 PID 属性。作为一个运行在用户态的普通程序,是无法直接读取内核数据结构的。操作系统为了保证自身安全,必须对外提供专门的接口——系统调用。
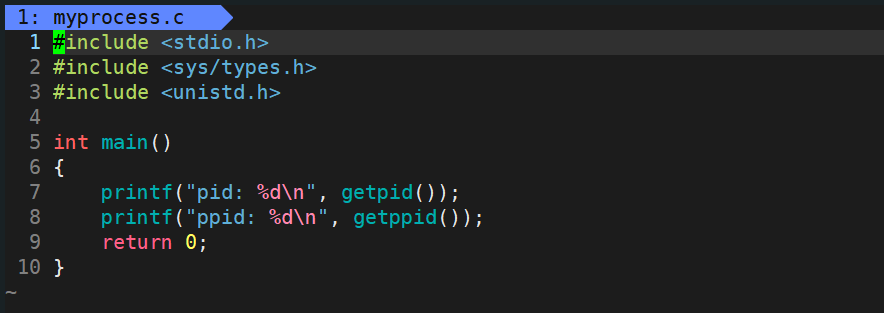
getpid 和 getppid 就是操作系统提供给上层应用获取自身 PID 和 PPID 的系统调用。
#include <sys/types.h>
#include <unistd.h>

pid_t getpid(void);  // 获取当前进程的PID
pid_t getppid(void); // 获取当前进程的父进程PID
在 Linux 终端中,我们可以使用 ps 命令来查看当前系统的进程状态。
-
ps aux:查看系统所有进程的详细信息。 -
ps aux | grep [进程名]:过滤查看特定进程。
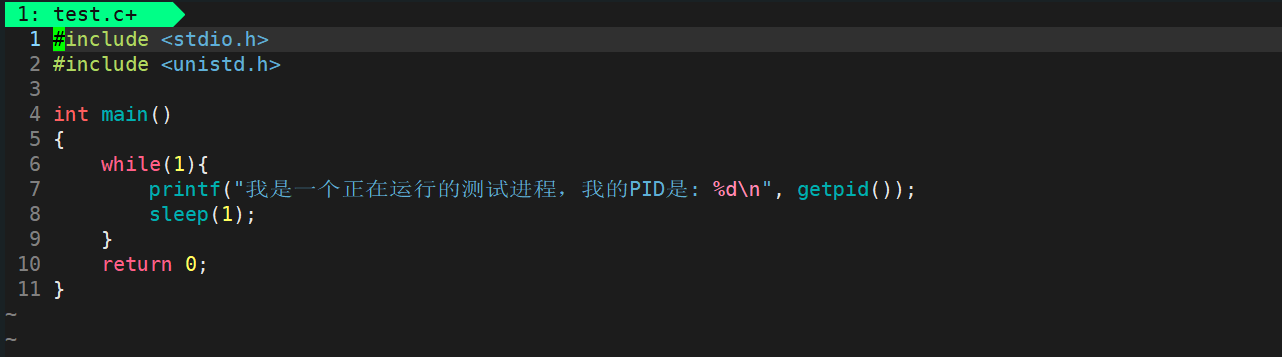
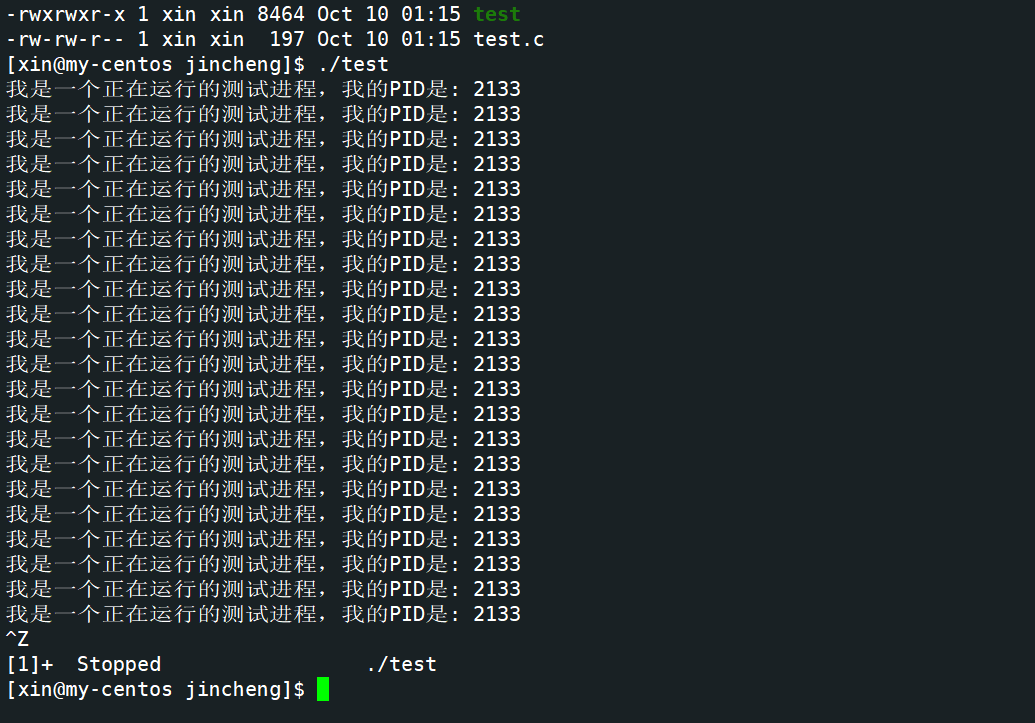
ps aux | grep test | grep -v grep在打开的 vim 编辑器中,按 i 键进入插入模式,复制并粘贴以下代码。这段代码的作用是让程序进入一个死循环,每隔 1 秒休眠一次,这样它就会一直留在系统中,方便我们查看它的进程信息。
查看 test 进程的信息:
ps aux | grep test | grep -v grep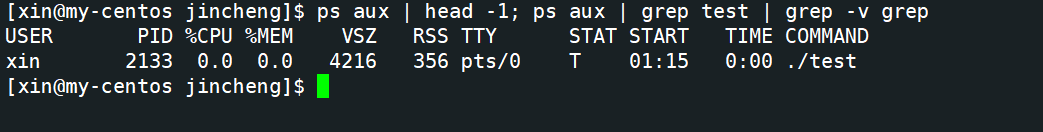
通过 /proc 文件系统查看:
既然我们已经拿到了 PID(假设是 3239),我们可以直接去 /proc 目录下查看它:
ls /proc/2133
你会看到一长串文件和文件夹,这些都是内核暴露出来的该进程的详细信息(如 cwd 是当前工作目录,exe 是指向可执行文件的链接,status 包含进程状态等)。这就是操作系统将内核数据结构 task_struct 映射到用户态文件系统的具象体现。
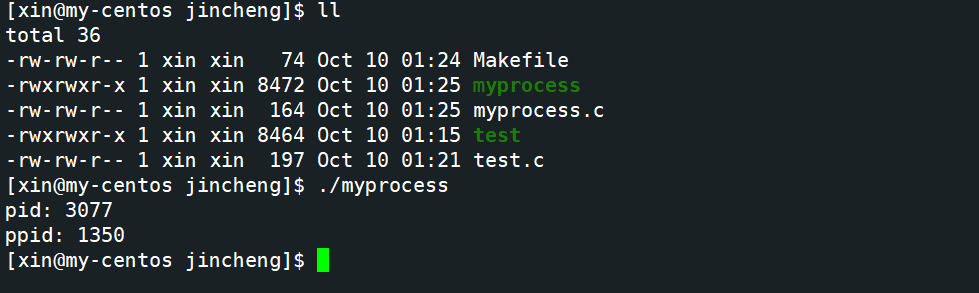
直接在程序中打印出自身的 PID 和 PPID:
5. 进程的创建:fork()
在 Linux 中,创建一个新进程的唯一方法是使用 fork() 系统调用。这是一个极其特殊且强大的函数。
5.1. fork() 的核心特性
-
调用一次,返回两次:
fork()函数会在当前进程(父进程)中创建一个新的进程(子进程)。父进程和子进程都会从fork()函数之后继续执行。 -
返回值区分父子:
-
在父进程中,
fork()返回子进程的 PID。 -
在子进程中,
fork()返回 0。 -
如果出错,返回 -1。
-
-
写时拷贝(Copy-On-Write):父子进程代码共享,数据各自开辟空间,私有一份。为了节省内存,初始时父子进程共享同一块物理内存,只有当其中一方尝试修改数据时,操作系统才会为其复制一份独立的数据空间。
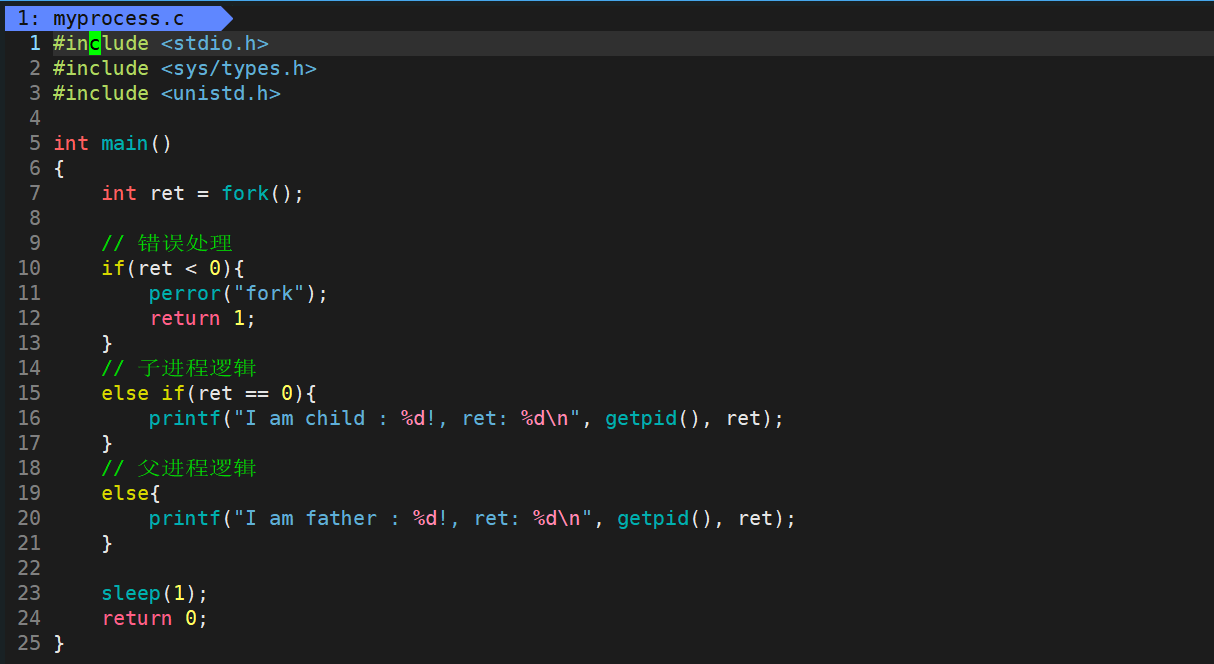
5.2 代码演示
#include <stdio.h>
#include <sys/types.h>
#include <unistd.h>

int main()
{
    int ret = fork();

    // 错误处理
    if(ret < 0){
        perror("fork");
        return 1;
    }
    // 子进程逻辑
    else if(ret == 0){
        printf("I am child : %d!, ret: %d\n", getpid(), ret);
    }
    // 父进程逻辑
    else{
        printf("I am father : %d!, ret: %d\n", getpid(), ret);
    }

    sleep(1);
    return 0;
}
程序运行后,屏幕上会打印两行 hello proc。第一行是父进程打印的(ret 大于0),第二行是子进程打印的(ret 等于0)。因为 fork() 之后代码共享,父子进程都执行了后面的 printf 语句。
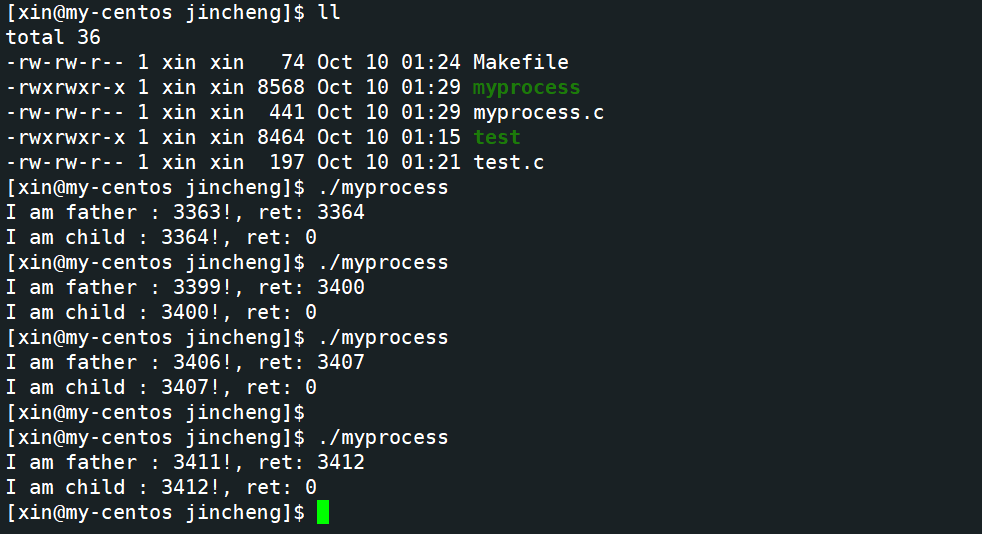
现象:你会发现屏幕上打印了类似以下的两行内容(PID 每次运行不同):
- PID 是临时标识,不是程序自带的固定编号 程序(
myprocess)是磁盘上的可执行文件,文件本身没有 PID。 只有当你./myprocess把程序加载、创建进程之后,Linux 内核才会分配一个 PID 给这个进程。 进程运行结束、退出之后,PID 就归还到内核的 PID 池,可以分给别的新进程。 - 内核分配 PID 的规则 Linux 一般是递增分配:新进程拿到上一个分配 PID+1; 但系统后台一直在不断创建 / 销毁进程(终端、守护进程等),会不断消耗 PID。 等你再次运行
./myprocess,中间已经有别的进程占用过编号,所以拿到的 PID 和上次运行肯定不同。
父进程调用 fork() 得到的返回值 ret 是子进程的 PID 。而子进程内部的 ret 是 0。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)