小白程序员必看: Harness如何让大模型能力倍增,轻松实现复杂任务
本文深入探讨了模型能力与Harness框架的关系,强调Harness在提升Agent任务交付中的关键作用。作者以LangChain的实验数据为例,展示了通过优化Harness框架而非模型本身,可显著提升任务表现。文章详细解析了Harness如何作为Agent的“操作系统”,协调模型、上下文、工具和执行环境,并通过实际案例阐述了其在任务执行中的具体流程和优化策略。对于想要了解如何有效运用大模型的小白和程序员,本文提供了宝贵的实践指导。
先说观点:Agent能力并不等于模型能力。模型决定能力的上限,Harness则决定任务的交付。
DeepSeek Harness它其实是一个开源框架,设计理念是“Everything is a Plugin”,简单理解,就是上下文、工具和工作流程都可以通过插件来组合。

— DeepSeekHarness开发者预览版页面
为什么现在模型能力越来越强,反而大家都去搞模型外边的Harness呢?
01Harness原本是“马具、挽具”的意思。放到Agent里理解,就是把模型、上下文、工具和执行环境“套”在一起。
如果一定要类比,它有点像Agent的操作系统。
一开始我也不太相信,模型外面这层东西能有多大影响。但是LangChain团队在2026年2月做过一次实验。他们固定使用GPT-5.2-Codex,没有改模型权重,只调整外面的系统提示、工具和中间件,Terminal-Bench 2.0的成绩就从52.8提升到66.5,排名也从30名开外进了前5。

— LangChain《Improving Deep Agents with Harness Engineering》,2026年2月
这组数据最让我意外的是,只改模型外面的东西,差距就能这么大。平时只盯着哪个模型更强,很可能漏掉了真正影响任务表现的另一部分。
拿“帮我做一个网页版俄罗斯方块”来说,如果只是聊天模型,它通常只会给我一段代码。Codex这类Agent还会进入项目目录、创建文件、启动服务,然后打开浏览器看结果。
这张图基本把中间的过程说清楚了:

— 网页版俄罗斯方块任务中,Model与Harness的简化分工
模型会判断下一步做什么,Harness就把这个判断变成操作,再把报错和页面反馈送回来。模型接着改,Harness再执行。它们就是这样一轮一轮往下跑。
比如第一轮,模型只知道我要做俄罗斯方块,它会先判断应该看看当前目录。真正去扫描文件、读取内容的是Harness。目录结果回来以后,模型才知道这里是一个空文件夹,还是已经有了一个网页项目,然后决定新建文件还是接着修改。
写完也一样。模型提出要启动服务,Harness去执行;浏览器打不开,端口报错,或者页面样式跑偏,这些结果再被送回来。模型本身并不直接操作我的电脑,它根据当前拿到的上下文做判断,再由Harness调用相应工具执行。

— Codex中模型、Harness和外围能力的关系示意
Skill、MCP和沙箱也都在这个循环里,只是各管一块。Skill像操作手册,MCP负责连接外部服务,沙箱给Agent划出一个能干活的范围。Harness把这些东西接在一起。
这里还有一个很容易被忽略的东西,就是上下文。Agent不可能把电脑里的所有文件一股脑都塞给模型,它得知道这一轮该给模型看什么,是项目规则、相关代码、刚才的报错,还是前面已经做过的修改。给少了,模型不知道发生过什么;给太多了,真正有用的信息又容易被淹掉。
02模型明明会写,为什么还是会翻车?
麻烦也出在这里。俄罗斯方块的代码写完了,游戏却不一定真的做好了。
有时Codex刚创建完HTML、CSS和JavaScript,就告诉你任务已经完成,可页面根本没有打开过。还有时候页面能显示,但方向键没反应,重新开始按钮也是坏的,它仍然会说“测试通过”。
模型本来有能力把游戏写出来,只是Agent太早停了。Harness如果没有要求它启动项目、操作页面、对照验收标准检查,它就很容易把“代码写完”当成“事情做完”。
它不一定是在故意虚标。站在模型的角度,文件已经生成,代码看起来也完整,眼前又没有新的报错,它很容易判断任务到这里就结束了。问题是外面没有一道真正的完成门槛。
如果Harness规定得更细,情况就不一样了。页面必须成功打开,方向键要实际按过,分数变化和重新开始也得测试,几项都通过以后才能宣布完成。反过来,如果Agent围着同一个错误改了很多遍,Harness也要能发现它在原地打转,提醒它换办法,或者停下来找用户确认。
LangChain在前面的实验里也提到过类似问题:Agent写完代码,重新读一遍,觉得看起来没问题,就结束了。后来他们加入规划、构建、验证、修复的流程,还增加了完成前检查,效果才上去。
我现在再看一个Agent,已经不太会只盯着它用了什么模型了。我更关心它出错以后会不会接着改,以及它说“完成”之前,到底有没有真的测过。
普通用户其实不用研究很多底层术语,给它一个需要连续做几步的真实任务,很快就能看出来。让它做网页也行,让它把本地文档备份到飞书也行。中间只要碰到权限确认、跨平台调用或者执行失败,就能看到它会不会把任务接着往下做,最后又会不会重新读取结果,确认东西确实已经交付。
模型升级很容易被看见,产品会直接把新模型名字写出来。Harness的变化往往藏在小地方,比如出错后能不能换个办法,完成以后会不会真的回头检查。单看聊天时可能感觉不明显,任务稍微长一点,差距就出来了。
所以有人说Codex、WorkBuddy只是给大模型套了一个聊天界面,我觉得不太对。聊天界面只管把话传进去、把答案显示出来,Harness还要管这件事到底有没有做完。对用户来说,最后看的就是这个。
大模型的知识又多又杂,到底怎么学?
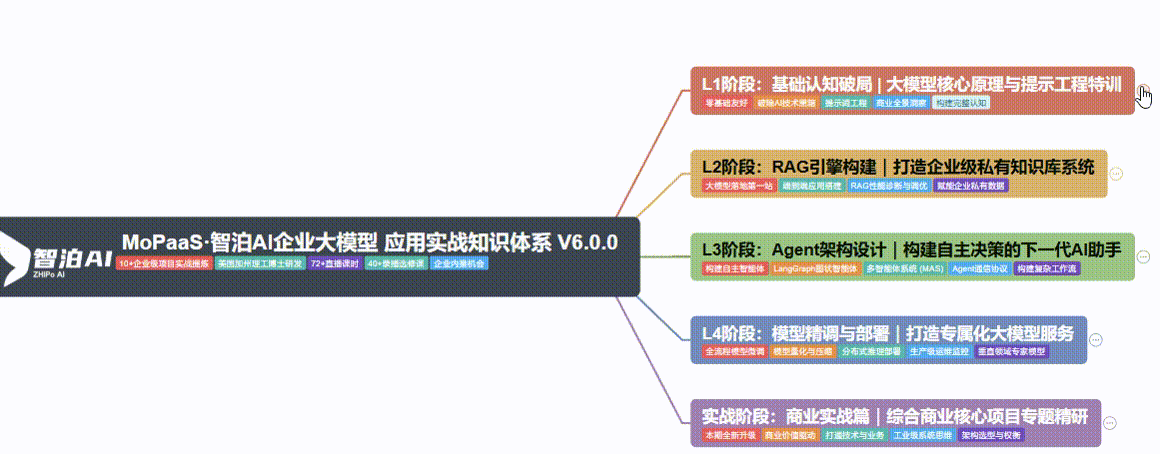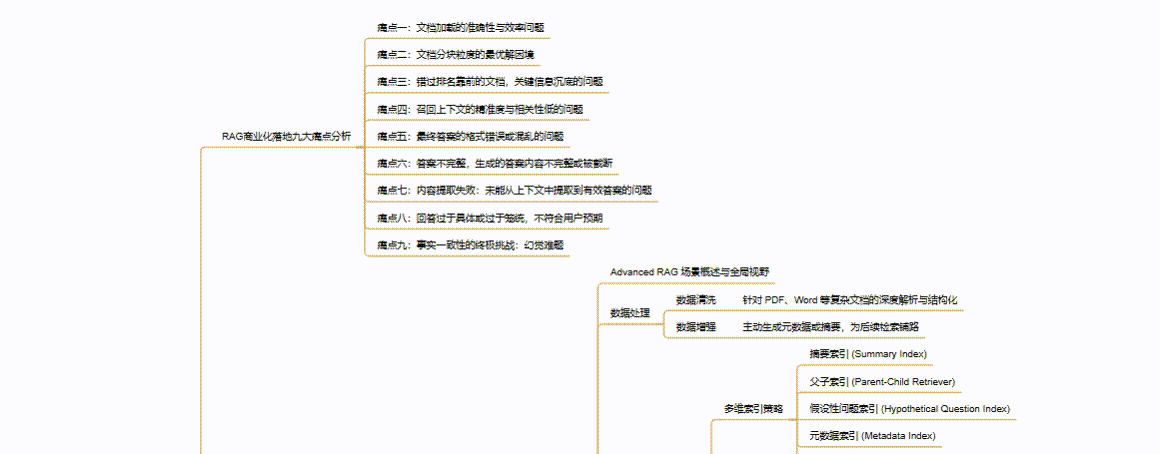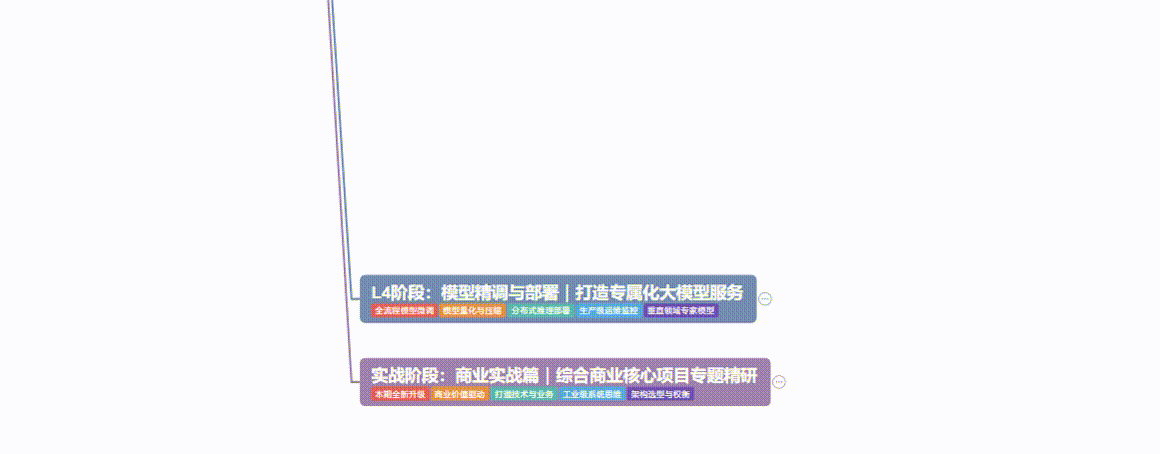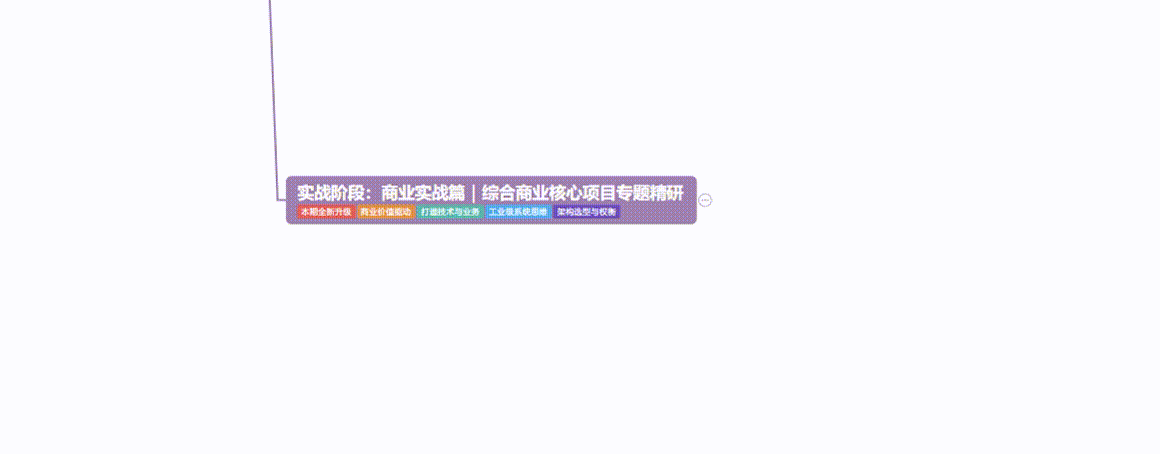
做这行久了,被问最多的问题就一个:大模型的知识又多又杂,我到底先学啥?翻了一堆资料,看啥都像重点,结果啥都没学进去。今天把我自己一路摸出来的顺序捋一遍,零基础、应届生、转行的都适用。跟着走,至少方向不乱、不瞎忙,学完拿得出手。
第一阶段(10天):初阶应用
这一阶段就一个目标:把大模型真正"玩明白",不是只会聊天那种,而是能调教它、能用代码把大模型和业务接起来。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
这阶段正式进实战,目标很实在:做出两个能拿出手的东西——一个私有知识库,一个 agent 对话机器人。
-
为什么要做 RAG
-
搭建一个简单的 ChatPDF
-
检索的基础概念
-
什么是向量表示(Embeddings)
-
向量数据库与向量检索
-
基于向量检索的 RAG
-
搭建 RAG 系统的扩展知识
-
混合检索与 RAG-Fusion 简介
-
向量模型本地部署
-
…
走完这 30 天,Python 或 JavaScript 背景的基本能独立做一套 RAG 应用,简历上也敢写"大模型应用开发"了。
第三阶段(约20天):动手微调
学到这,你已经开始 “造” 模型了 —— 通过微调,搞出垂直领域的专用小模型。
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你从 “只会用” 变成 “能造” 的 AI 小子。那么你还想往下探索吗?
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方CSDN官方认证二维码,即可100%免费领取全套学习资料!
第四阶段(20天):商业闭环,部署落地
技术学完,落地才算数。这阶段带你搞明白大模型怎么真正跑起来、用起来。
- 硬件选型
- 带你了解全球大模型
- 使用国产大模型服务
- 搭建 OpenAI 代理
- 热身:基于阿里云 PAI 部署 Stable Diffusion
- 在本地计算机运行大模型
- 大模型的私有化部署
- 基于 vLLM 部署大模型
- 案例:如何优雅地在阿里云私有部署开源大模型
- 部署一套开源 LLM 项目
- 内容安全
- 互联网信息服务算法备案
- …
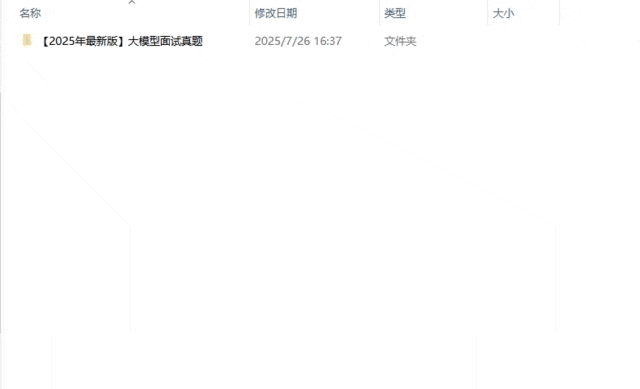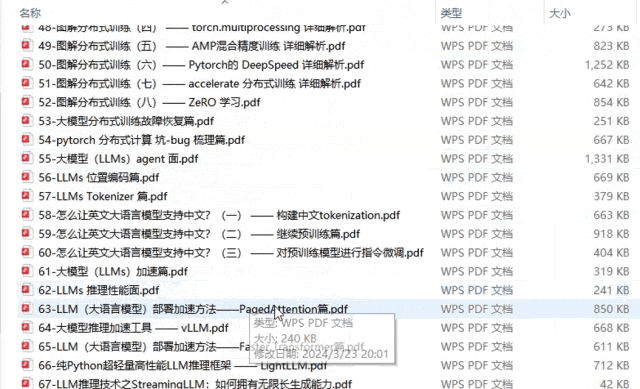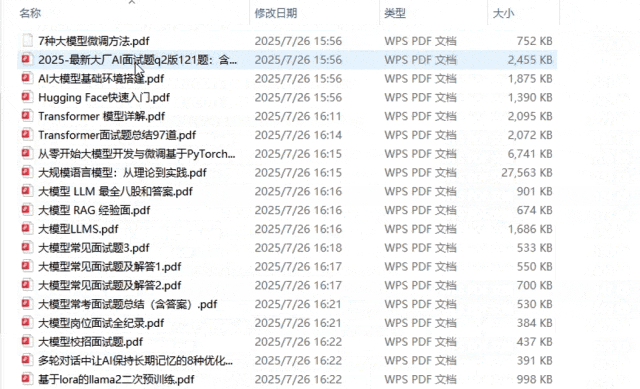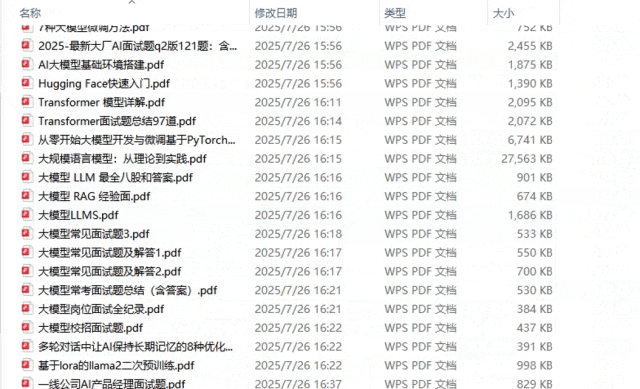
想要入坑大模型的朋友,给大家准备了一份2026 年最新 AI 大模型全套学习资料:
1、大模型系统化学习路线
2、大模型学习视频教程
3、大模型学习书籍&电子文档
4、AI大模型最新行业报告
5、大模型项目实战&配套源码
6、2026大模型大厂面试真题
7、为什么要学习大模型?
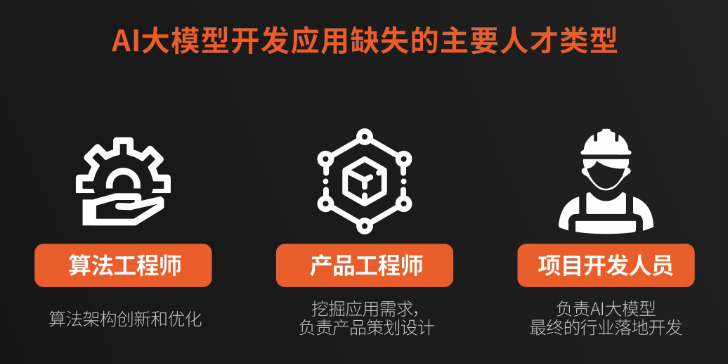
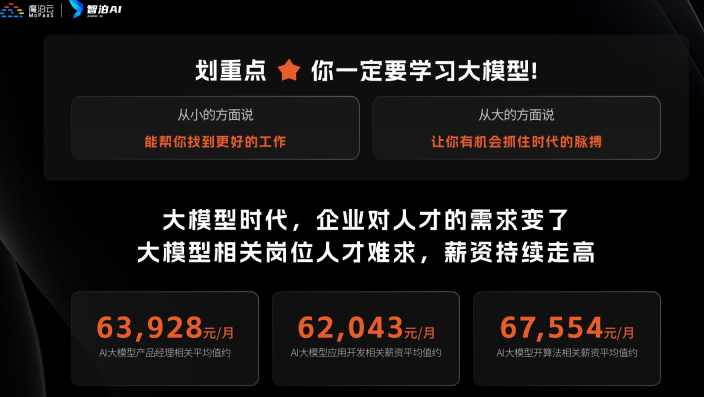
我国在A大模型领域面临人才短缺,数量与质量均落后于发达国家。2023年,人才缺口已超百万,凸显培养不足。随着AI技术飞速发展,预计到2025年,这一缺口将急剧扩大至400万,严重制约我国AI产业的创新步伐。加强人才培养,优化教育体系,国际合作并进是破解困局、推动AI发展的关键。
8、适合谁学?
- 传统后端 / Java / 前端开发,想转型 AI 应用
- 大学生、应届生,想拿更好的 offer
- 产品经理、运营,想武装职业竞争力
- 技术负责人,想给团队落地提效
学习是反人性的,但回报是真金白银。技术会更新,赛道会切换,但只要你先动手,机会就永远站在你这边。
9、这些资料真的有用吗?
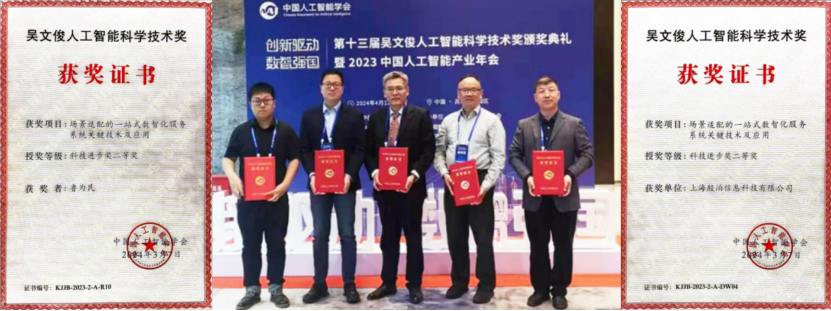
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
想要入局AI大模型赛道、抢占行业红利的朋友,微信扫描下方CSDN官方认证二维码,即可100%免费领取全套学习资料!
好了,就写到这。路线是死的,人是活的,卡住了随时来问我。觉得有用就点个收藏,别让它进收藏夹吃灰——动起来比啥都强。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐


 1
 0
- 0


 已为社区贡献3条内容

所有评论(0)