10.进程间通信(下)【由浅入深-Linux】
文章目录
- 第五章:System V 消息队列
- 1、 宏观框架:基于有型数据块的内核共享队列
- 2、 创建与获取消息队列的内核三大细节辨析
- 补充:共享内存、消息队列、信号量的key都在一个链表里面吗?
- 3、 消息队列接口全家族语法流控与 System V 大一统 Spec 辨析
- 补充:什么是多执行流,多执行流就是进程吗?
- 第六章:System V 信号量
- 1、 核心前置基础:多执行流并发的铁幕与五大解密概念
- 2、 回溯历史:我们在经典场景中遭遇过的并发撕裂
- 3、 信号量的物理本质:面向资源预定的内核计数器
- 4、 信号量底层的核心双重细节:汇编级非原子陷阱与 IPC 认亲机制
- 5、 信号量集总线矩阵与内核控制家族接口语法全解
- 补充:System V 信号量:从进程到 `semval` 的完整源码地图((底层看懂可省略))
- 补充:“建造者模式”
- 补充: System V 信号量完整使用指南:从创建到删除
- 6. System V 信号量的C++面向对象封装
- 补充: PV 操作是 OS 上的概念吗?
- 第七章: 内核是如何组织管理IPC资源的
- 第八章: mmap⽂件映射
第五章:System V 消息队列
在第四章中,我们见证了共享内存以“零拷贝”的物理特性登顶单机本地通信的速度王座,但同时也看清了它由于“裸奔”缺乏同步控制而导致的脏读踩踏惨剧。为了在维持高效本地通信的同时,天然提供明确的消息边界与按类型接收能力,System V 规范推出了另一款极具工程价值的高级组件——消息队列(Message Queue)。
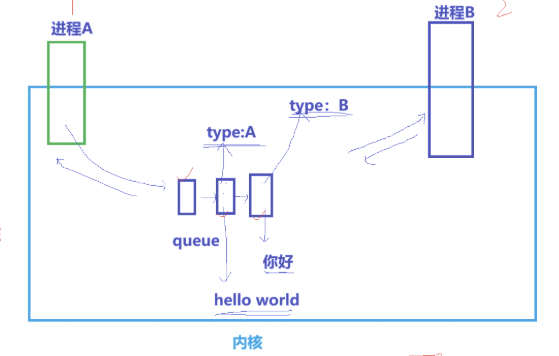
1、 宏观框架:基于有型数据块的内核共享队列
要建立消息队列的整体认知,首先需要明确其核心本质:消息队列,是由操作系统内核维护的一种带有“类型标签”的消息队列;在本文后面参考的 Linux 2.6.x 内核实现中,可以进一步把它理解成由内核结构体和消息链表组织起来的队列。
它与管道那种不保留应用层消息边界的字节流传输模式不同,转而采用一条条独立消息作为基本传输单位;如果应用层使用管道却不自行设计消息边界,就可能遇到通常所说的“粘包/拆包”问题。
1.1 为什么必须引入“有类型数据块”?
在理解消息队列的内核结构时,初学者最容易产生一个疑问:普通的队列结构只需要按照先进先出(FIFO)的规则排队就行了,为什么 Linux 内核的消息队列在存放数据时,非要在每个数据块上强行焊装上一个 “类型(Type)” 标签?
核心底层真相:因为在复杂的单机多进程并发环境中,所有使用同一个消息队列的进程都可能向其中塞入数据,导致来自不同进程、不同用途的消息混在同一个队列中;如果没有额外的分类依据,接收方就很难按业务目的选择消息。
我们可以将这个内核痛点拆解为以下两个工程致命场景:
- 数据的“张冠李戴”踩踏:假设进程 A 想给进程 B 发送一个任务包,进程 C 想给进程 D 发送一个告警包。如果队列里的数据块没有类型标签,它们在内核链表里融为一团。进程 B 顺着队列向前一抓,极有可能误吞了属于进程 D 的告警包,直接引发系统级逻辑错乱。
- 双向实时对话的方向混乱:如果父子进程想要利用同一个队列实现“既能老爹传给儿子,又能儿子传给老爹”的双向实时通信。如果没有类型标识,父进程刚写完一个包放入队列,随后自己调用读取接口时,极有可能会在原地把自己刚刚写进去的包又重新读了出来,导致通信方向和业务协议发生混乱,严重时甚至会形成逻辑上的空转或错误等待。
1.2 内核的解耦防线:给每个数据包贴上“名牌”
为了打破这种“数据混在一起分不清”的尴尬僵局,Linux 内核规定:任何写入消息队列的数据块,在应用层整备时,其结构体的第一个核心字段必须是一个 大于 0 的长整型(long)类型代码。
========================================================================================
                   【 消息队列内部数据块“乱序混杂、精准类型抽离”全景拓扑 】
========================================================================================

  多个无关进程并发写入 -----------------------------------------------------> 消费者定向抽吸
 +-----------------+                                                           |
 | 进程A -> 投递包   | --+                                                       |
 +-----------------+   |                                                       |
                       v 内核链表统一收拢 (乱序混在一起)                            |
 +-----------------+   +----------------------------------------------------+   |
 | 进程C -> 投递包 | ->  |[Type: 1|数据] -> [Type: 2|数据] -> [Type: 1|数据]   |   |
 +-----------------+   +----------------------------------------------------+   |
                                                                                |
                                                                                v
                                                             【 进程B 指定只读取 Type==2 】
                                                              (精准越过1号包,只抽走2号资产)
========================================================================================
这个类型标签,就是刻在每个数据包身上的“名牌(身份证)”。
由于有了类型的加持,当多进程向内核总线灌入数据时,无论队列内部堆积了多么混乱、来自多少个不同进程的“大杂烩”数据块,接收方进程在调用读取接口时,都可以向内核理直气壮地下达定向筛选指令(例如:“我今天只接收 Type == 2 的核心业务包,其余的包别塞给我”)。
内核在底层收到指令后,会开启智能扫描,自动越过前面排队的 1 号、3 号数据块,精准把 2 号数据块解包并抽吸出来递给上层。
总结:
消息队列的优势之一,在于它利用内核统一管理的消息队列实现多进程间的数据交换;同时,通过 “有类型消息” 让接收方能够按类型选择消息。它既保留了队列的排队能力,又赋予了用户态定向分类消费的自由度。具体的内部数据结构属于 Linux 内核实现细节,后文以 Linux 2.6.x 结构为例继续说明。
补充:System V IPC 的生命周期:消息队列创建后属于内核维护的 System V IPC 资源,创建它的进程退出并不会自动把队列删除;通常需要由程序调用
msgctl(msqid, IPC_RMID, ...)、使用ipcrm显式删除,或者在系统重启时被清除。
2、 创建与获取消息队列的内核三大细节辨析
在理清了消息队列基于“有类型数据块”进行跨界物理解耦的宏观框架后,我们必须将视角切入到 Linux 内核的腹地,去深挖消息队列在冷启动创建阶段的三个核心控制细节。这三个细节决定了操作系统如何管理这些并发资产,以及毫无血缘关系的两个独立进程如何在茫茫内存中精准对齐、共用一条通信总线。
2.1 细节一:多队列并存下的“先描述,再组织”总控哲学
在大型工业级 Linux 服务器或高性能网关环境中,系统内部通常会同时运行着成百上千个不同的多进程集群,它们各自都在利用消息队列进行独立的业务协同。这意味着,在内核空间的内存深处,消息队列绝对不可能只有孤零零的一份,而是必然同时存在着多份消息队列。
面对如此海量的动态消息队列资源,操作系统内核(OS)是如何做到高效调度、精确分流而绝不发生符号混淆的呢?这里死死坚守着整个 Linux 内核设计的核心哲学:先描述,再组织!
- 先描述(元数据账本化):内核绝对不认识什么“裸队列”。每当有一个进程调用接口申请开辟一个新的消息队列,操作系统首先会在内核中为它量身定制一个专属的管理结构体(账本)。这个结构体里详细记录了这套队列的所有静态与动态属性(如:现在谁是主人、里面积压了多少个数据包、允许容纳的最大字节数红线是多少)。
- 再组织(统一的数据结构网格):当所有的消息队列都被“账本化”描述之后,操作系统会用一个全局的指针数组(或高效的基数树/红黑树链表),把这些散落在内核腹地里的管理结构体严密地串联起来。
经过这一层抽象,操作系统对全系统消息队列资产的管理,最终被成功退化成了对一条简单链表或数组的增、删、改、查。OS 只需要死死控盘这个中央总账本,就能在一瞬间对全系统的 IPC 资产实施行政级高并发调度。
2.2 细节二:用户接口账本与内核队列本尊——struct msqid_ds / struct msg_queue
在 System V 消息队列的源码实现中,必须严格区分两个层次:用户态接口层与内核态真实对象层。用户态所见的 struct msqid_ds 只是一个“状态账本”与“控制接口”,用于数据交换与属性设置;而内核真正管理、挂载于 IPC 命名空间内部的队列实体,是 struct msg_queue。
用户态接口结构(账本/快照)
struct msqid_ds 是暴露给用户空间的标准结构(定义于 <sys/msg.h>),它记录了队列的各类属性与统计信息:
struct msqid_ds {
    struct ipc_perm msg_perm;     // 权限与密钥(uid/gid/mode/key)
    struct msg    *msg_first;     // (概念上)指向队列首消息
    struct msg    *msg_last;      // (概念上)指向队列尾消息
    __kernel_time_t msg_stime;    // 最后发送时间
    __kernel_time_t msg_rtime;    // 最后接收时间
    __kernel_time_t msg_ctime;    // 最后属性变更时间
    unsigned long   msg_cbytes;   // 当前总字节数
    msgqnum_t       msg_qnum;     // 当前消息条数
    msgqnum_t       msg_qbytes;   // 队列字节数上限(红线)
    __kernel_pid_t  msg_lspid;    // 最后发送者 PID
    __kernel_pid_t  msg_lrpid;    // 最后接收者 PID
};
注:其中的
msg_first/msg_last在早期的概念或某些架构中用于表示消息链表指针,但在 Linux 2.6.x 主流实现中,内核并不以此作为真正的队列组织头,它仅作为兼容层字段出现于用户态账本中,真正内核链表由msg_queue中的专用链表头管理。
内核态真实对象(本尊)
内核中真正的消息队列对象是 struct msg_queue。其核心设计是内嵌了一个通用 IPC 权限控制块 struct kern_ipc_perm q_perm,该内嵌成员承载了队列的 key、id、uid、gid、mode 等所有与权限和全局索引相关的通用信息。
struct msg_queue {
    struct kern_ipc_perm q_perm;   // ⚙️ 核心门禁与索引:包含 key/id/权限位
    // ... 其他内核专用字段(等待队列头、消息链表头、q_qnum、q_qbytes 等)
};
关键桥梁:字段转换与对象查找
这两个结构并非同一对象,它们之间的“桥梁”存在于 msgctl 系统调用中:
-
双向字段转换:当用户调用
msgctl(IPC_STAT)获取状态时,内核会将msg_queue中的真实运行数据“翻译”并填充到用户态的struct msqid_ds账本中。反之,msgctl(IPC_SET)则从用户态账本提取权限等字段回写到内核对象。核心映射关系如下:msq->q_perm↔ds->msg_permmsq->q_qnum↔ds->msg_qnummsq->q_qbytes↔ds->msg_qbytes- (时间戳、PID 等字段亦做对应转换)
-
内核查找机制:当内核根据用户传入的
msqid查找队列时,IPC 底层框架首先通过 ID 定位到通用的struct kern_ipc_perm *指针。由于q_perm被直接内嵌于msg_queue中,内核利用经典的container_of(ipcp, struct msg_queue, q_perm)宏,便能从成员指针反向推导出完整的队列对象首地址。这使得通用 IPC 管理代码无需关心具体队列类型,优雅地实现了多态管理。
内核控制流深层行为解析
- 消息链条的物理组织:虽然用户态账本保留了
msg_first/msg_last以作概念参考,但struct msg_queue内部维护着独立的内核链表头(如q_messages),所有待处理的消息struct msg均通过该链表进行真实的物理链接与管理。 - 容量的动态守卫:
msg_qbytes(对应ds->msg_qbytes)定义了该队列允许占用的最大总字节数。当累积字节触及此红线时:- 阻塞模式下的
msgsnd会令调用进程睡眠,等待接收方取走消息腾出空间; - 非阻塞模式则直接返回
EAGAIN。
该上限可通过具有CAP_SYS_RESOURCE权限的进程调用msgctl(IPC_SET)动态调整,因此切勿将其固化为不可变的硬编码常量(如“16KB”),它实质是一个受系统配置与特权管控的运行时动态阈值。
- 阻塞模式下的
综上,二者核心关系可凝练为:
用户态 msqid_ds(账本)  ←msgctl字段转换↔ 内核态 msg_queue(本尊)
                                              │
                                              └── 内嵌 kern_ipc_perm q_perm
                                                     ↑
                                             container_of 反向推导
2.3 细节三:Key 与 msqid 矩阵——跨进程认亲与精准对齐的终极依据
现在我们必须面对整章最核心的架构思辨问题:既然操作系统内部可以同时存在大量消息队列对象,而进程 A 和进程 B 又是两个完全独立运行、在用户态毫无交集的执行流,它们在冷启动拉起时,究竟怎么保证自己能看到并共用“同一个”消息队列?
这套精准对齐、跨界认亲的底层逻辑,完美复用了我们在共享内存中所学的 Key-ID 双生辩证矩阵。
1. 外部暗号达成共识:Key
两个没有任何生态交集的进程,要想在茫茫内核 IPC 资源中完成对齐,首先需要约定一个双方一致的外部暗号—— key。它用于在同一 IPC 命名空间、同一类 System V IPC 资源中查找对象;它并不保证数学意义上的“全系统绝对唯一”。
- 程序员在编写代码阶段,会让进程 A 和进程 B 约定同一个磁盘路径和项目 ID。
- 两端进程在启动后,各自在独立的控制流中运行完全相同的
ftok算法。 - 经过
ftok计算后,两端在用户态得到相同的key_t数值。在 Linux 常见实现中key_t通常是整数类型,但程序不应把“固定 32 位”当成跨平台硬规则;而且ftok也存在碰撞可能,所以它的作用是双方约定同一个 key,而不是生成密码学意义上的唯一 ID。
2. 内核大闸的排他比对与翻译下发
当接收方进程 A 调用创生接口 msgget(key, IPC_CREAT | IPC_EXCL | 0666) 时,控制流通过系统调用进入内核态:
- 寻址查重:内核拿着这个
key,在“消息队列”这一类 IPC 资源自己的管理集合/索引结构中查找,并与已有对象的通用 IPC 权限信息中的 key 进行比对。具体是数组、树、IDR/XArray 等哪种组织方式,随内核版本变化。 - 创生并登记:如果不存在同 key 的消息队列且参数合法,内核创建对应的内核消息队列对象(在 Linux 2.6.x 中可看到
struct msg_queue),并把 key、权限、队列状态等信息登记进去。 - 分发标识符:随后,内核返回一个非负整数
msqid(消息队列标识符)。它是交给用户态后续操作该队列的 IPC ID,内核可以由它校验并定位对象;不能简单把它等同于“绝对物理数组下标”。
3. 进程 B 的定向锁死闭环
随后,完全不相关的发送方进程 B 被拉起,它拿着手里通过相同算法算出来的 key 去调用获取接口 msgget(key, IPC_CREAT)。
内核再次在消息队列自己的 IPC 管理集合中查找同一个 key,找到进程 A 刚才创建的队列后,会把对应的 msqid 返回给进程 B。只要两边处在同一 IPC 命名空间并找到同一对象,它们后续就能通过这个 ID 操作同一个消息队列。
终极技术结论:
进程 A 和进程 B 在应用层虽然各跑各的,但因为两端拿到了指向同一 System V 消息队列对象的msqid,后续调用msgsnd/msgrcv时传入这个 ID,内核便可以校验并定位到相同的队列对象。ID 的编码、索引结构和查找复杂度属于内核实现细节,不能把它固定理解成“绝对物理座位号 + 永远 O(1)”。
补充:共享内存、消息队列、信号量的key都在一个链表里面吗?
核心结论:不在同一个链表里
共享内存、消息队列、信号量这“三驾马车”,在同一个 IPC 命名空间中按资源类型使用逻辑上彼此分开的管理集合/索引。 它们不会因为 key 数值相同就跨类型发生冲突。
1. 最直观的工程铁证:Key 的复用
在实际项目开发中,你可以拿着完全相同的 key(比如利用同一个磁盘路径和项目 ID,通过 ftok 算出来的 0x66ccff66),在代码里执行以下两个操作:
int shmid = shmget(key, 4096, IPC_CREAT | 0666); // 成功创建共享内存
int msgid = msgget(key, IPC_CREAT | 0666); // 拿着一模一样的 key,同样成功创建消息队列!
在参数、权限以及其他条件都正常的情况下,这两行可以同时成功;共享内存和消息队列不会仅仅因为使用了相同的 key 就互相触发跨类型的 EEXIST。
如果内核把它们放在同一个链表里查重,当第二行 msgget 带着 0x66ccff66 冲进内核时,大闸会瞬间闭合,判定该 Key 已经被共享内存占坑了,从而强行报错弹回。两者的和平共处,铁证如山地证明了内核在寻址查重时,是“分灶吃饭”的。
2. 内核源码解密:ipc_namespace 的独立分账单
在 Linux 内核空间中,为了支持容器化隔离(如 Docker 的 IPC 隔离),设计者抽象出了一个总控结构体叫做 struct ipc_namespace(IPC 命名空间)。
在这个大总管结构体内部,并排陈列着三个互不干扰、完全独立的 struct ipc_ids 资产总账本:
struct ipc_namespace {
    // ...
    struct ipc_ids ids[3];
    // 内核通过标准下标将三者物理割裂:
    // ids[0] -> 专门管理全系统的 消息队列 (IPC_MSG_IDS)
    // ids[1] -> 专门管理全系统的 信号量   (IPC_SEM_IDS)
    // ids[2] -> 专门管理全系统的 共享内存 (IPC_SHM_IDS)
    // ...
};
下标说明:其中
ids[0]/ids[1]/ids[2]的注释不要死记。讨论真实内核时应优先使用IPC_MSG_IDS、IPC_SEM_IDS、IPC_SHM_IDS这些符号常量;在经典 Linux 源码中常见的是IPC_SEM_IDS = 0、IPC_MSG_IDS = 1、IPC_SHM_IDS = 2。核心知识点是“三种 IPC 分开管理”,不是背数字。
系统调用时的内核物理路由
当在用户态调用不同的系统接口时,控制流通过系统调用进入内核态,随后会按 IPC 类型走向各自的管理集合:
- 呼叫
msgget(key, ...)→ \rightarrow → 内核控制流只抱起ids[IPC_MSG_IDS]这张消息队列的专属图纸去执行哈希寻址查重。 - 呼叫
shmget(key, ...)→ \rightarrow → 内核控制流一扭头,带着key冲向了另一个完全隔绝的网格ids[IPC_SHM_IDS](共享内存总账)中去比对。
它们查找的是不同类型的 IPC 资源集合,因此同一个 key 数值可以合法地同时用于消息队列、共享内存和信号量;当然,同一类型内部仍要按 System V 规则处理 key 冲突。
3、 消息队列接口全家族语法流控与 System V 大一统 Spec 辨析
在理解了消息队列的Linux 内核管理机理后,我们正式切入工程落地。要想在代码中安全、有序地拉起一条面向结构化数据块的本地通信总线,我们必须牢牢啃透原生 C 语言接口家族的语法规范与流控特征。
3.1 msgget 系统调用:总线资产的申请与检索
在 Linux 操作系统中,创建新的消息队列或获取已有消息队列标识符的标准 System V 接口是 msgget。
1. 语法接口原型
#include <sys/types.h>
#include <sys/ipc.h>
#include <sys/msg.h>

int msgget(key_t key, int msgflg);
2. 参数物理语义
key:用于标识/查找消息队列的key_t值。它常由ftok根据路径和项目 ID 生成,也可以按 System V 规则使用其他合法 key;不要把“必须由ftok生成、固定 32 位且绝对唯一”当成硬规则。msgflg:位图控制掩码。IPC_CREAT:若内核中当前不存在目标队列,则全新创建;若已存在,则就地直接获取并返回其控制句柄。IPC_CREAT | IPC_EXCL:排他性创生大闸。若目标队列完好存在,系统调用瞬间物理报错返回-1,并将错误码errno焊死设置为EEXIST。- 权限拼接位:低 9 位可以用八进制权限位(如
0666)与创建标志按位或组合。System V IPC 对象的这些权限位不按普通文件创建那样套用进程umask。
3. 返回值规范
- 成功:返回一个非负整数
msqid(消息队列标识符)。它是用户态后续收发与控制消息队列时使用的 IPC ID,而不是可以直接当作“物理数组下标”理解的地址/索引。 - 失败:返回
-1,并自动激活内核全局错误账本errno。
4. 全场景代码落地演练
#include <stdio.h>
#include <stdlib.h>
#include <sys/types.h>
#include <sys/ipc.h>
#include <sys/msg.h>
#include <errno.h>
#include <string.h>

void DemonstrateMsgget(key_t key) {
    // 场景 A:纯粹获取一个已经存在的队列,或者在不存在时创建它
    // 权限赋予 0666(可读可写)
    int msqid_normal = msgget(key, IPC_CREAT | 0666);
    if (msqid_normal < 0) {
        perror("Scenario A: msgget alloc or get failed");
    } else {
        printf("Scenario A: Successfully got/created msqid = %d\n", msqid_normal);
    }

    // 场景 B:排他性创建。必须确保该资源是由当前控制流全新缔造的
    int msqid_exclusive = msgget(key, IPC_CREAT | IPC_EXCL | 0666);
    if (msqid_exclusive < 0) {
        if (errno == EEXIST) {
            // 拦截到良性技术冲突:证明内核中早已积压了同名 Key 的队列
            printf("Scenario B: Exclusive create failed because asset already exists in kernel.\n");
        } else {
            printf("Scenario B: Catastrophic error: %s\n", strerror(errno));
        }
    } else {
        printf("Scenario B: Exclusively created brand new msqid = %d\n", msqid_exclusive);
    }

    // 场景 C:严格只读/检索模式。不带 IPC_CREAT 标志,若资源不存在则死活不创建,直接报错
    int msqid_strict = msgget(key, 0666);
    if (msqid_strict < 0) {
        printf("Scenario C: Strict lookup failed. Target queue does not exist right now.\n");
    } else {
        printf("Scenario C: Strict lookup success. Found existing msqid = %d\n", msqid_strict);
    }
}
3.2 msgsnd 与 msgrcv:结构化消息的发送与定向吸纳
消息队列与管道、共享内存最本质的决裂,在于它在应用层实施交互时,强制约束必须使用结构化数据块。
1. 业务层协议模板:struct msgbuf
标准 C 库和内核并没有在底层帮你写死你的业务报文长什么样。相反,它向程序员下发了一条硬性调用规范:无论你的业务数据有多复杂,你传给内核的数据块结构体,其第一个成员必须是一个大于 0 的长整型(long)变量,用来充当“类型标签(Type)”。
// 工业级标准自定结构化数据包模板
struct my_msgbuf {
    long mtype;        👑 绝对死线:消息类型标签,物理数值必须严格大于 0
    char mtext[1024];  用户级自定义业务资产:可以是任意文本、多维结构体、流媒体字节
};
1.该结构体由用户自己定义好后传给msgsnd,内核只划定了一条底线规范:不管你应用层怎么折腾,你传给我的这块内存,最前端必须是一个表示类型的
long变量;其大小准确以sizeof(long)为准,在 Linux 常见 64 位 LP64 环境中通常为 8 字节。
2.char mtext[1024]大小用户自定义,不一定是1024
2. 发送接口:msgsnd
int msgsnd(int msqid, const void *msgp, size_t msgsz, int msgflg);
-
参数语法规则:
msqid:内核分配的座位号。msgp:指向你整备好的结构体包(如struct my_msgbuf*)的物理指针。msgsz:核心高频地雷点。这里传入的是mtype后面的消息正文长度,不能把头部long算进去(常见写法:sizeof(struct my_msgbuf) - sizeof(long))。 如果错误地把整个结构体大小都传进去,内核会从mtype后继续按更大的msgsz读取,可能越过实际正文缓冲区,带入额外数据甚至造成访问错误;它不是简单的“整体结构体照搬”。msgflg:发送行为控制位。通常默认填0(阻塞发送,若队列满则原地睡眠等空位);若挂载IPC_NOWAIT,则在队列满时瞬间报错返回-1,抛出EAGAIN异常,绝不卡死。
-
返回值:成功返回
0;失败返回-1。
3. 接收接口:msgrcv
ssize_t msgrcv(int msqid, void *msgp, size_t msgsz, long msgtyp, int msgflg);
-
参数语法规则:
-
msqid与msgp:座位号与接收缓冲区指针。 -
msgsz:当前接收缓冲区允许容纳的纯业务资产最大容量(同样不含 long 的大小)。 -
msgtyp:定向抽吸的灵魂调度官(核心控制位)。msgtyp == 0:严格遵循先进先出(FIFO)天规,无脑读取队列里的第一个数据包。msgtyp > 0:精准分类消费。内核直接越过其余排队报文,只把队列里第一个标签类型严格等于msgtyp的数据包剥离抽吸出来。msgtyp < 0:低优先级降维检索。内核会扫描整个队列,找出标签类型小于或等于msgtyp绝对值的所有消息,并把其中类型最小的第一个包读取带走。
-
msgflg:通常填0(阻塞死等包到来)。若挂载IPC_NOWAIT且队列中没有指定类型的包,立刻返回-1抛出ENOMSG错误。
-
-
返回值:成功返回实际读取到的业务资产字节数;失败返回
-1。
4. 全场景代码落地演练
#include <stdio.h>
#include <stdlib.h>
#include <string.h>
#include <sys/types.h>
#include <sys/ipc.h>
#include <sys/msg.h>
#include <errno.h>

struct custom_msg {
    long msg_type;       // 类型
    char payload[256];   // 自定义纯业务容积
};

void DemonstrateDataFlow(int msqid) {
    struct custom_msg pack1 = {1, "Priority_1_Asset_Data"};
    struct custom_msg pack2 = {2, "Priority_2_Asset_Data"};

    // 👑 长度精准计算防线:严禁包含头部 long 的大小
    size_t asset_size = sizeof(struct custom_msg) - sizeof(long);

    // 场景 A:标准阻塞模式发送
    if (msgsnd(msqid, &pack1, asset_size, 0) < 0) {
        perror("Blocking send failed");
    }

    // 场景 B:非阻塞高并发模式发送。若内核队列已满,绝不卡死控制流,瞬间弹回
    if (msgsnd(msqid, &pack2, asset_size, IPC_NOWAIT) < 0) {
        if (errno == EAGAIN) {
            printf("Queue is full right now. Non-blocking send skipped.\n");
        }
    } else {
        printf("Non-blocking send packet 2 success.\n");
    }

    // 场景 C:严格先进先出(Type == 0)接收
    struct custom_msg receive_box;
    ssize_t n1 = msgrcv(msqid, &receive_box, asset_size, 0, 0);
    if (n1 > 0) {
        printf("FIFO Recv Success. Data: %s\n", receive_box.payload);
    }

    // 场景 D:精准分类消费。强制指定只抽取标签类型为 2 的资产包
    // 挂载 IPC_NOWAIT,若此时队列中没有2号包,立刻返回,不产生任何卡顿
    ssize_t n2 = msgrcv(msqid, &receive_box, asset_size, 2, IPC_NOWAIT);
    if (n2 < 0) {
        if (errno == ENOMSG) {
            printf("No type 2 packet available in kernel queue at this moment.\n");
        }
    } else {
        printf("Targeted Recv Success. Type 2 Data: %s\n", receive_box.payload);
    }
}
3.3 ipcs -q 与 ipcrm -q:控制台层面的队列审计与行政火化
ipcs
和ipcrm是 Linux 下管理 System V IPC的命令工具:ipcs用来查看系统中已经创建的 IPC 对象,例如ipcs -m查看共享内存段,ipcs -q查看消息队列,可以看到它们的key、shmid/msqid、属主、权限、大小或消息数量等信息;ipcrm用来删除这些 IPC 对象,例如ipcrm -m shmid删除指定共享内存段,ipcrm -q msqid删除指定消息队列。也就是说,ipcs负责“查看”,ipcrm负责“删除”,主要用于检查和清理程序退出后仍然残留在内核中的 System V 共享内存和消息队列。
当多进程总线在调试期间发生逻辑卡死、导致消息包在后台大量堆积时,运维人员可以通过操作系统提供的控制台行政命令实施强行盘点与清除。
1. 资产盘点总线:ipcs -q
# 直接在 Linux Shell 终端输入
$ ipcs -q


------ Message Queues --------
key        msqid      owner      perms      used-bytes   messages
0x66ccff66 0          root       666        0            0
0x66ccff67 32768      mounanlin  666        2048         2
0x01122334 65536      mounanlin  600        512          1
- 账本输出核心字段解析:
msqid:内核下发给用户侧操控资源的唯一实权锁匙。perms:八进制访问门槛权限位(如666)。used-bytes:当前队列中已经积压、尚未被读进程抽吸抽干的纯业务资产总字节数。messages:当前内核链表里正挂着排队的数据包物理总个数。
2. 行政强行火化:ipcrm -q / -Q
# 黄金规范语法:基于内核座位号 msqid 实施 O(1) 级别的数组直插爆破
$ ipcrm -q 32768

# 旁路备用语法:基于外部 FTok 密钥 key 进行全局哈希逆向寻址擦除
$ ipcrm -Q 0x66ccff66
- 内核行为:
ipcrm -q对消息队列是立即物理销毁(不等引用计数归零),不像共享内存那样只打“待删除”标记;队列中遗留的所有消息会被当场丢弃,同时内核会暴力唤醒所有正阻塞在该队列上的进程(msgsnd/msgrcv等),让它们立刻返回-1并设置错误码为EIDRM,告诉调用者“内核对象已经被删了,别再等了”。
3.4 msgctl 系统调用:多维度的控制总闸
在 C/C++ 代码内部,对消息队列资产实施获取状态、动态改写账本或实施代码级销毁的系统级总指挥官是 msgctl。
1. 语法接口原型
int msgctl(int msqid, int cmd, struct msqid_ds *buf);
2. 参数物理语义
msqid:由msgget返回的消息队列标识符(IPC ID)。cmd:最高核心控制意志。IPC_STAT:输出型控制流。强行把内核深处的总控头账本深拷贝到用户态传入的buf结构体中,用以审计msg_qnum等核心指标。IPC_SET:输入型控制流。由用户在外部整备好新权限或容量上限,强行覆写、倒灌进内核控制块,用以动态修改访问门禁。IPC_RMID:释放大闸。注销并删除消息队列。由于该删除动作不需要与账本属性产生任何数据交互,此时第三个参数buf可直接硬编码填入NULL/nullptr。
3. 返回值规范
- 成功:返回
0。此时若有其他进程正阻塞在msgsnd或msgrcv上,该通道会在内核中发生粉碎性断裂,阻塞调用会瞬间被迫苏醒并直接报错返回-1,抛出EIDRM(标识符已被销毁)硬伤。 - 失败:返回
-1。
4. 全场景代码落地演练
#include <stdio.h>
#include <stdlib.h>
#include <sys/types.h>
#include <sys/ipc.h>
#include <sys/msg.h>
#include <errno.h>

void ControlAndDestroyQueue(int msqid) {
    struct msqid_ds internal_notebook;

    // 场景 A:获取当前内核队列的底账属性数据(IPC_STAT)
    if (msgctl(msqid, IPC_STAT, &internal_notebook) == 0) {
        printf("--- Kernel Information Report ---\n");
        printf("Current Bytes in Queue: %ld\n", internal_notebook.msg_cbytes);
        printf("Current Packets count  : %ld\n", internal_notebook.msg_qnum);
        printf("Max capacity allocation: %ld bytes\n", internal_notebook.msg_qbytes);
    } else {
        perror("Fetch IPC_STAT notebook failed");
    }

    // 场景 B:改写门禁属性。动态上调或收紧权限界限(IPC_SET)
    // 强制修改八进制访问权限门槛为 0600(严格只允许创生所有者单独读写)
    internal_notebook.msg_perm.mode = 0600;
    if (msgctl(msqid, IPC_SET, &internal_notebook) == 0) {
        printf("Scenario B: Successfully changed perm to 0600.\n");
    } else {
        perror("Modify permissions failed");
    }

    // 场景 C:行政强制解体物理火化大闸(IPC_RMID)
    // 无需读写任何属性,第三个参数直接无脑填充为 NULL
    if (msgctl(msqid, IPC_RMID, NULL) == 0) {
        printf("Scenario C: Core Queue dismantled successfully from mainboard.\n");
    } else {
        perror("Dismantle IPC_RMID failed");
    }
}
3.5 用户态 msqid_ds 与内核态 msg_queue:第一成员布局不要混淆
在看清了全套 API 的玩法后,我们再次把视线对准“先描述,再组织”的资产底座。这里需要修正一个容易混淆的点:用户 API 使用 struct msqid_ds + struct ipc_perm 表示可查询/可设置的状态;而 Linux 2.6.x 内核内部使用 struct msg_queue + struct kern_ipc_perm q_perm 管理真实队列对象。 两层结构有关联,但不是同一个结构体。
1. 统一的权属门禁母模:struct ipc_perm
struct ipc_perm {
    __kernel_key_t  key;    // 👑 寻址暗号:由 ftok 熔炼而成的全局唯一 Key 值
    __kernel_uid_t  uid;    // 资产当前所有者的用户 ID (UID)
    __kernel_gid_t  gid;    // 资产当前所有者的组 ID (GID)
    __kernel_uid_t  cuid;   // 创生始作俑者的用户 ID (Creator UID)
    __kernel_gid_t  cgid;   // 创生始作俑者的组 ID (Creator GID)
    __kernel_mode_t mode;   // 💥 物理访问门槛:八进制权限位(如 0666)
    unsigned short  seq;    // 槽位翻转序列号(用于御绝 ABA 身份冒领的版本号)
};
2. 消息队列用户态控制账本示意:struct msqid_ds
struct msqid_ds {
    struct ipc_perm msg_perm;     // 👑 物理铁律:必须、且雷打不动地占据结构体的最前端(第一成员)
    struct msg    *msg_first;     // 指向内核链表第一个有效数据包的物理指针(队列头)
    struct msg    *msg_last;      // 指向内核链表最后一个有效数据包的物理指针(队列尾)
    __kernel_time_t msg_stime;    // 最后一次成功执行发送(msgsnd)的时间戳
    __kernel_time_t msg_rtime;    // 最后一次成功执行接收(msgrcv)的时间戳
    __kernel_time_t msg_ctime;    // 最后一次执行行政属性修改(msgctl)的时间戳
    unsigned long   msg_cbytes;   // 当前队列中已经积压的纯业务资产总字节数
    msgqnum_t       msg_qnum;     // 当前队列中挂着排队的数据包物理总个数
    msgqnum_t       msg_qbytes;   // 该队列物理上被系统允许容纳的最大字节数上限(控制红线)
    __kernel_pid_t  msg_lspid;    // 最后一次引发写动作的进程 PID
    __kernel_pid_t  msg_lrpid;    // 最后一次引发读动作的进程 PID
};
核心物理设计特征:首地址的绝对重合
在标准 C 语言的结构体布局规则中,结构体对象的地址与其第一个成员的地址在数值上相同(适当转换后可以利用这一布局特征)。
观察这个 struct msqid_ds 示例:struct ipc_perm msg_perm 位于 Offset 0,因此在这个局部 C 布局示例中,&my_queue 与 &my_queue.msg_perm 数值相同。
因此,示例中把 struct msqid_ds * 转成 struct ipc_perm * 后访问第一个成员区域是可以理解的;但这只能证明 C 结构体的首成员布局特性,并不能证明 Linux 内核就是把用户态 msqid_ds* 强转成 ipc_perm* 来实现 IPC 多态。内核公共 IPC 代码真正复用的是内部的 struct kern_ipc_perm。
// 内核底层完全合法的物理多态强转
struct msqid_ds my_queue;

// &my_queue 的物理地址与 &my_queue.msg_perm 的物理地址 100% 严丝合缝重合
struct ipc_perm *perm_ptr = (struct ipc_perm *)&my_queue;

// 此时通过 perm_ptr 即可直接越界审查或改写最前端的 key、uid、mode 等通用属性
printf("Direct read Key via pseudo-polymorphism: 0x%x\n", perm_ptr->key);
注意:上面的强转代码只是演示“结构体地址 == 第一成员地址”的 C 语言布局性质。代码注释里的“越界审查”并不准确:
perm_ptr只能按照真实存在的第一成员ipc_perm范围访问;更不能据此推出 Linux 内核把三类 IPC 全装在一个用户态_ds指针数组中。
3.6 终极引出:System V 是一套统一风格的 IPC 接口规范
顺着“第一成员物理首地址绝对重合”的布局线索,结合 System V 极其对称的系统调用函数矩阵,我们终于可以站在整机系统编程的最高处,以降维打击的视角,俯瞰整个 System V 本地高级通信子系统的终极宏观全景。
如果我们把目光同时投向 消息队列(msg)、共享内存(shm)和信号量(sem) 这三驾马车的用户接口结构,以及操作它们的 System V 系统调用,一幅高度对称的接口设计会铺开。
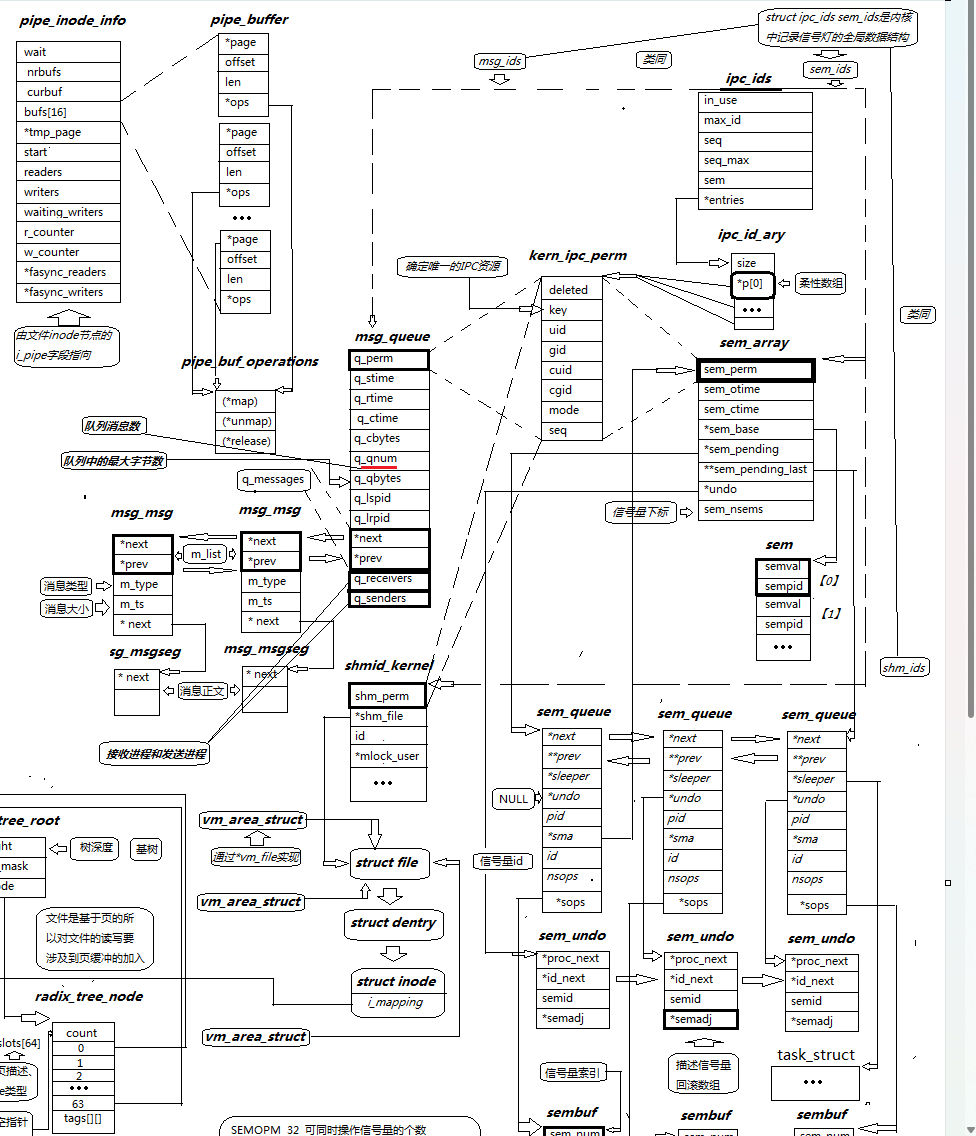
3.6.1 数据账本层面的物理镜像对称
在解读源码前,必须先死死记住一条铁律:用户态看到的是“账本快照”,内核态管理的是“物理本尊”。
- 用户态接口账本:
struct msqid_ds、struct shmid_ds、struct semid_ds仅用于msgctl/shmctl/semctl与用户态交换数据,它们内部包含的是用户态struct ipc_perm,绝不能当成内核真实对象使用。 - 内核态物理本尊:真正被挂载、分配 ID、参与运行时管理的是
struct msg_queue、struct shmid_kernel、struct sem_array。
而源码串联的秘密,就藏在这三个内核结构体的第一个成员里(以 Linux 内核源码为准):
// 1. 消息队列的内核本尊
struct msg_queue {
    struct kern_ipc_perm q_perm;   // 👑 第一成员:内核公共权限头(偏移量=0)
    // ... q_messages, q_qnum, q_qbytes 等专有字段
};

// 2. 共享内存的内核本尊
struct shmid_kernel {
    struct kern_ipc_perm shm_perm; // 👑 第一成员:内核公共权限头
    // ... shm_file, shm_nattch, shm_segsz 等专有字段
};

// 3. 信号量的内核本尊
struct sem_array {
    struct kern_ipc_perm sem_perm; // 👑 第一成员:内核公共权限头
    // ... sem_nsems, sems[] 等专有字段
};
关键内存规律:因为
q_perm是struct msg_queue的第一个成员,所以&msq->q_perm的地址数值和msq自身的指针值完全相等(偏移量为 0)。共享内存和信号量同理。
3.6.2 函数家族与系统调用参数的孪生拓扑
如果说数据结构的内存布局是静态的物理基础,那么 System V 核心函数家族的入参形式与流控逻辑,则是动态层面上严丝合缝的工业镜像。
无论是哪一种通信组件,其核心动作全部被统一收拢进“资源创生(Get)”与“行政控制(Ctl)”两大函数拓扑之中:
1. 资源创生与获取接口的“参数流控对齐”
int msgget(key_t key, int msgflg);              // 消息队列
int shmget(key_t key, size_t size, int shmflg); // 共享内存
int semget(key_t key, int nsems, int semflg);   // 信号量
- 入参形式高度对称:第一个参数都是
key_t(IPC 命名空间内寻址),最后一个参数都是标志位(支持IPC_CREAT/IPC_EXCL)。 - 底层路由一致:它们最终汇入公共的
ipcget(),通过传入不同的ipc_ops操作表区分具体行为。
2. 行政控制与资源销毁接口的“句柄化自洽”
int msgctl(int msqid, int cmd, struct msqid_ds *buf);
int shmctl(int shmid, int cmd, struct shmid_ds *buf);
int semctl(int semid, int semnum, int cmd, ...);
- 操控实权锚定 ID:全凭内核返回的 ID 句柄指定操作对象。
- 命令宏高度一致:均支持
IPC_STAT(查)、IPC_SET(改)、IPC_RMID(删)。
System V 核心函数对照矩阵
| 技术维度 | 消息队列 | 共享内存 | 信号量 |
|---|---|---|---|
| 外部寻址 | key_t | key_t | key_t |
| 创生接口 | msgget(key, flg) | shmget(key, size, flg) | semget(key, nsems, flg) |
| 控制句柄 | msqid | shmid | semid |
| 控制接口 | msgctl(id, cmd, buf) | shmctl(id, cmd, buf) | semctl(id, num, cmd, ...) |
| 核心命令 | IPC_STAT/SET/RMID | IPC_STAT/SET/RMID | IPC_STAT/SET/RMID |
3.6.3 统一的多态总线管理链网与大一统 Spec 结语
Linux 内核 IPC 架构的大底牌:
System V IPC 并非三个独立的子系统拼凑,而是一套共享“公共基类头(kern_ipc_perm)”与“公共行为表(ipc_ops)”的统一框架。其源码串联逻辑可概括为“三板斧”。
第一板斧:顶层容器分三类
struct ipc_namespace {
    struct ipc_ids ids[3];  // 三个独立集合
};

#define IPC_MSG_IDS 1
#define msg_ids(ns) ((ns)->ids[IPC_MSG_IDS])
ipc_namespace 用 ids[3] 数组把消息队列、共享内存、信号量的 ID 空间物理隔离。msg_ids(ns) 取 ids[1],shm_ids(ns) 取 ids[2]。绝不混装。
第二板斧:具体对象内嵌公共头,存入 IDR 只传公共头地址
创建对象时(以消息队列 newque() 为例):
ipc_addid(&msg_ids(ns), &msq->q_perm, ...);
//                       ^^^^^^^^^^^^^
//                       传入的是 kern_ipc_perm *,不是 msg_queue *
ipc_addid() 内部将 new 指针存入 ids->ipcs_idr:
idr_alloc(&ids->ipcs_idr, new, ...);
串联结果:msg_ids(ns).ipcs_idr 数组里存的是 kern_ipc_perm *,但它物理上指向的其实是 msg_queue 对象的开头(因为偏移量为 0)。公共代码完全不知道也不关心你后面跟着的是消息链表还是信号量数组。
第三板斧:取出时 container_of 恢复完整对象
用户通过 ID 查找时:
struct kern_ipc_perm *ipcp = ipc_obtain_object_idr(&msg_ids(ns), id);
struct msg_queue *msq = container_of(ipcp, struct msg_queue, q_perm);
因为 q_perm 偏移量为 0,container_of 底层等价于:
struct msg_queue *msq = (struct msg_queue *)ipcp; // 直接强转!
于是公共指针又被还原成完整的 msg_queue *,从而能访问 q_messages、q_qnum 等专有字段。
行为多态:ipc_ops 函数指针跳转
数据串联解决的是“对象是谁”,行为串联解决的是“创建时干什么”。各子系统各自填表:
// 消息队列
const struct ipc_ops msg_ops = { .getnew = newque };
// 共享内存
const struct ipc_ops shm_ops = { .getnew = newseg };
// 信号量
const struct ipc_ops sem_ops = { .getnew = newary };
公共 ipcget() 内部调用:
ret = ops->getnew(ns, ops, ...); // 根据传入的表跳到对应的 newque/newary/newseg
概念辅助图(公共指针的“零偏移多态切入”视角)
如下概念图展示了“通用权限头指针”如何通过零偏移强转切入三种不同的大结构体。但请务必注意:真实源码中不存在一个跨类型混装的全局
ipc_perm_array数组;三类 IPC 对象的公共指针分别存放在各自ipc_ids集合的 IDR 中。此图仅用于直观理解“一址两用”的物理内存复用关系。
========================================================================================
                  【 System V 内核对象“公共头复用”概念总线 】
========================================================================================

  内核公共管理视角(只认 kern_ipc_perm * 指针地址)
  +-------------------------+-------------------------+-------------------------+
  |[0]: ptr (kern_ipc_perm*)|[1]: ptr (kern_ipc_perm*)|[2]: ptr (kern_ipc_perm*)|
  +------------+------------+------------+------------+------------+------------+
               |                         |                         |
               | (偏移量=0,强转恢复)       | (偏移量=0,强转恢复)      | (偏移量=0,强转恢复)
               v                         v                         v
       [ 共享内存本尊 ]            [ 消息队列本尊 ]            [ 信号量本尊 ]
       (struct shmid_kernel)      (struct msg_queue)        (struct sem_array)
========================================================================================
最终结语:
System V 之所以经典,在于它用“三板斧”在纯 C 环境中实现了类似面向对象的基类复用:
ipc_namespace.ids[3]分类隔离;具体对象内嵌kern_ipc_perm作为公共头,偏移量为 0 实现“一址两用”;存入 IDR 只传公共头地址,取出时container_of(零偏移等价于强转)恢复完整对象;ipc_ops函数指针表实现行为分派。配合用户态高度对称的xxxget/xxxctl接口,构成了 Linux 内核中最优雅的“编译时多态”框架。
补充:什么是多执行流,多执行流就是进程吗?
不完全是。多进程只是“多执行流”的一种形态。 广义上可以把进程、线程、协程以及被信号打断后执行的信号处理路径都看成不同形式的控制流;但它们在调度方式和是否能真正同时并行方面并不完全相同。
在计算机底层,所谓的“执行流(Execution Flow)”,本质上就是 CPU 正在一行行向前执行的汇编指令序列。如果系统内同时存在多个独立、并发运转的指令序列,它们就共同构成了“多执行流”。
1、 多执行流的三大主流物理形态
为了让广大读者理清边界,可以从并发/异步控制流角度粗略分成下面几类;这不是说操作系统内核会把它们都当成完全相同的独立调度实体:
1.1 进程级别(重量级执行流:多进程)
- 物理特征:通常情况下,每个独立进程都有自己独立的虚拟地址空间(
mm_struct)和页表;特殊的clone/vfork等场景另当别论。 - 协同成本:因为各过各的、内存数据完全隔离,它们之间如果想协同,就必须白嫖操作系统内核提供的公共通道(如管道、共享内存、消息队列)。
1.2 线程级别(轻量级执行流:多线程)
- 物理特征:在同一个进程内部,可以同时被拉起多个线程。在 Linux 内核视角中,线程被称为 轻量级进程(LWP, Light Weight Process)。
- 协同成本:它们共同共享同一个进程的虚拟地址空间(共享代码段、数据段、堆区)。这意味着线程之间天生就能直接看到同一进程中的全局数据,因此一旦多个线程无同步地读写共享对象,就很容易产生数据竞争。
1.3 异步信号处理级别(特殊控制流:信号处理函数)
- 物理特征:当你的单进程程序正在高高兴兴地向前执行主控制流时,突然硬件或内核向该进程投递了一个信号(如
SIGINT)。 - 行为异变:当信号被递送到某个线程时,该线程原本的控制流会被暂时打断,转去执行已注册的信号处理函数(Signal Handler),处理结束后再返回原来的执行位置。它与主流程在时序上发生交织,但并不是凭空多出一条同时占用另一个 CPU 的独立线程;因此访问共享状态时要遵守异步信号安全规则。
2、 降维账本对照
为了在写代码时形成绝对确定的防御性思维,我们需要看清不同执行流在内存资产上的分立与重合:
| 执行流类型 | 虚拟地址空间 | 核心调度实体 | 并发踩踏发生场景 | 保护锁依赖度 |
|---|---|---|---|---|
| 多进程 | 虚拟地址空间通常彼此隔离(各有各的 mm_struct) | 内核独立 task_struct | 在访问共享内存、共享文件、内核 IPC 等公共资源时可能发生竞争 | 依赖 System V 信号量 / 进程共享锁等同步机制 |
| 多线程 | 共享同一进程地址空间(共用一个 mm_struct) | 内核轻量 task_struct | 无同步访问全局变量、堆对象等共享数据时容易发生数据竞争 | 依赖 互斥锁(Mutex)/ 条件变量 / 原子操作等 |
| 信号处理流 | 与被中断线程共享地址空间,并在时序上交织 | 由内核信号递送机制触发 | 信号处理函数与正常代码同时涉及同一状态时可能出问题 | 常用 volatile sig_atomic_t、信号屏蔽字以及异步信号安全接口 |
3、 回归 IPC 与信号量现场:为什么我们要抽象出“多执行流”?
这正是我们在第六章引入“多执行流”这一高级词汇的架构心机:
因为第六章要讲解的信号量(Semaphore)和互斥机制,核心目标都是协调多个可能竞争同一资源的控制流。进程和线程都可能成为并发访问者;而信号处理函数属于更特殊的异步场景,并不意味着普通锁/信号量 API 都适合直接在 signal handler 里调用。
因此,“多执行流”在这里主要是一个帮助理解并发访问者的抽象词:凡是可能让访问同一共享状态的控制路径发生交错,就需要考虑同步与原子性。不要把它理解成“所有执行流都由同一种锁一视同仁拦截”。
第六章:System V 信号量
在前五章中,我们从小到大打通了匿名管道、命名管道以及 System V 共享内存与消息队列。我们反复强调,进程间通信的宏观终极目的,是为了让原本具有绝对隔离独立性的多进程,能够看到由操作系统(OS)统一提供的同一份公共资源(无论是虚拟文件、内存块还是内核队列链表)。
然而,资源共享的大门一旦彻底敞开,多执行流在用户态的无序狂飙直接将系统推向了另一个灾难深渊——数据不一致的并发混乱。本章我们将切入本地高级控制流的终极核心,解构守护临界资产安全的内核同步机制之一——信号量(Semaphore)。
匿名管道和命名管道 FIFO 都允许多个进程同时读写,并不是同一时刻只能有一个读者或写者;内核会通过锁、环形缓冲区和等待队列等机制保证管道内部数据结构不会因并发而损坏,并负责管道空时阻塞读者、管道满时阻塞写者及后续唤醒。但这不等于业务数据绝不会发生并发问题:多个读者会竞争消费数据,一份数据通常只会被其中一个读者读走;多个写者并发写入时,单次write()不超过PIPE_BUF时可保证整块写入不被其他写者插入,超过PIPE_BUF则可能发生数据交错,因此复杂场景下仍需要应用层协议或额外同步。
1、 核心前置基础:多执行流并发的铁幕与五大解密概念
要在代码中驯服信号量这尊原生态的并发猛兽,我们绝对不能一上来就死背系统调用接口。我们必须首先下沉到 CPU 的代码执行流视角,彻底砸碎关于“共享资源”与“执行代码”的认知幻觉,严密焊装好以下五大维度的工程红线概念。
1.1 概念一:共享资源(Shared Resource)
- 技术定义:在单机操作系统内,能够被多个完全独立的执行流(如并发的多进程、多线程)同时看到、并尝试交叉访问的公共资源。
- 物理形态:它可以是我们在前文耗费巨资开辟出来的 64KB 共享内存物理页框、消息队列中的内核链表节点,甚至是多进程往屏幕上乱刀狂砍打印日志时所面对的同一个显示器文件。
- 安全硬伤:共享资源是高并发环境下数据发生交叉踩踏的物理现场。如果缺乏行政干预,多执行流同时对这块空间发起写入,会导致业务报文发生粉碎性的错乱。
1.2 概念二:临界资源(Critical Resource)
许多初学者极易把“共享资源”与“临界资源”混为一谈。在现代操作系统中,这两者存在着严格的受保护界限。
临界资源的本质:指那些在物理底层被实施了严格保护、在任意一个确定的时间点内,被强制约束绝对不允许两个或两个以上执行流同时霸占访问的“特殊共享资源”。
共享资源是一个广义的物理资产: 只有被互斥机制大闸全盘武装起来、进入“排队免踩踏”保护状态的共享资源,才有资格蜕变为临界资源。
1.3 概念三:互斥(Mutual Exclusion)
- 技术定义:一种用来强行守护临界资源安全的排他性控制流向策略。
- 核心天规:在任意时刻,全系统内只能有且仅有一个执行流能够进入并访问某块临界资源。
- 物理特征:当进程 A 正在这块内存里做指针对齐覆写时,门禁闭合,进程 B 和进程 C 哪怕速率再高,也必须在门外老老实实排队休眠,直到进程 A 完全退场、释放控制锁。
1.4 概念四:临界区(Critical Section) vs 非临界区
这是整个并发控制理论中最具欺骗性、最需要顿悟的终极技术分水岭:临界资源在内核里是一块冰冷的内存或文件资产,但谁去访问它?是进程!而进程的访问,最终是要靠 CPU 硬件去一行行执行代码来落地的。
由此,我们在应用层的用户态源码,被物理割裂成了两个决裂的阵营:
- 临界区(Critical Section):在你的整篇业务代码中,那几行真正拿着指针、直接去对临界资源实施读、写、冲刷操作的“高危核心代码段”。
- 非临界区(Non-critical Section):你代码中剩下的、纯粹在各自虚拟空间内部进行局部变量计算、耗时文本整备、与临界资源毫无瓜葛的常规代码。
| 区域对比 | 物理控制本质 | 对系统并发安全的影响 | 代码执行特权 |
|---|---|---|---|
| 临界区 | 触碰临界资源的代码段 | 💥 并发踩踏的爆发火山点,必须手工焊装信号量门禁大闸 | 受到严格约束,进来必须上锁,走人必须放行 |
| 非临界区 | 相对于当前讨论的临界资源不执行共享访问的局部逻辑 | 对当前临界资源不会产生竞争,但如果它访问了其他共享资源仍可能需要同步 | 不需要为当前临界资源持有这把锁 |
// 工业级多进程代码区域解耦对照
void ProcessTask(Shm* shared_mem) {
    // 1. 处于绝对安全的【非临界区】
    int local_temp = 100;
    local_temp += 200;

    // ------------------- 💥 跨越安全红线 -------------------
    // 2. 进入高危的【临界区】!
    // 这两行代码直接拿着指针在冲刷公共物理页框,这就是临界区!
    char* shm_ptr = (char*)shared_mem->Addr();
    strcpy(shm_ptr, "Catastrophic Concurrency Data");
    // ------------------------------------------------------

    // 3. 重新退回到【非临界区】
    printf("Local calculation finished.\n");
}
我们要通过信号量去保护临界资源,在代码层面的物理表现,本质上其实就是要在“临界区”的入口和出口处,强行架设两道关卡。不满足门禁条件的,控制流直接卡在临界区这一行门外睡觉,从而用代码的静止换取资源的绝对原子安全。
1.5 概念五:原子性(Atomicity)与 同步
在多执行流乱序抢占 CPU 算力的残酷环境下,为了保证临界区代码执行的结果具备不可动摇的确定性,控制通道必须死死守住两条底层防线:
1. 原子性(Atomicity)
指一个操作从其他并发执行流观察时具有不可分割的效果:要么看到操作前状态,要么看到操作后状态,不会观察到中间的半完成状态。实现原子语义并不等于“CPU/内核绝对不能在中途发生任何抢占”,关键是中间状态不能被其他竞争者破坏或观察。
2. 同步(Synchronization)
在互斥的安全底线上,进一步解决多执行流之间“谁等谁、谁迁就谁”的步调协同问题,使多个执行流按需要的先后关系配合运行。同步不等于必然保证某个固定 FIFO 顺序,也不是专门为了“避免死锁”而存在。
本节因总结:
进程通信打破了隔离性,让多进程看到了 “共享资源” ;为了防止并发污染,我们必须用 “互斥” 手段将其升级为 “临界资源”;而落实到代码层面,我们防御的靶向目标则是那几行直插资产心脏的 “临界区代码”。而支撑这一全套防御动作的内核级终极总调度官,正是我们接下来要粉碎性拆解的 System V 信号量。
补充:System V 信号量的生命周期:信号量集同样属于随内核存在的 System V IPC 资源,创建进程退出后不会自动清除;正常工程里要设计好所有权,并在合适时机通过
semctl(semid, 0, IPC_RMID)或ipcrm -s删除。
2、 回溯历史:我们在经典场景中遭遇过的并发撕裂
在系统学习信号量之前,许多人会觉得“并发问题”是一个极其高大上、离我们非常遥远的行业黑话。然而事实恰恰相反,早在我们第一次编写多进程代码、调用 fork() 分流的那天起,并发踩踏的灾难就已经在我们眼前实打实地爆发过了。
2.1 现象重现:父子进程的终端文字乱象
回忆一下我们在学习进程控制时,写过的那个最基础的经典测试程序:
#include <stdio.h>
#include <sys/types.h> // pid_t 的标准声明头文件(原代码缺少该头文件会导致严格编译环境下 pid_t 未声明)
#include <unistd.h>

int main() {
    pid_t id = fork();
    if (id == 0) {
        // 子进程控制流
        while (1) {
            printf("HelloChildProcess\n");
        }
    } else {
        // 父进程控制流
        while (1) {
            printf("====================\n");
        }
    }
    return 0;
}
当我们在终端拉起这个程序时,父子进程输出的先后顺序通常是不确定的。下面这段“字符级交错”可以作为理解并发输出的示意,但是否真的细到单个字符被拆开,取决于 stdio 缓冲、一次 write 的大小、终端驱动以及调度时机,不能把它当成每次都必然出现的结果:
====================
HelloChildProcess
======HelloChi===ldProcess
HelloChildPro=====cess===
如果一次完整输出被拆成多个底层写操作,或者多个输出操作之间发生调度切换,就可能看到不同进程的内容交错;但一次 printf/write 是否会被拆到字符级交织并没有这里描述得那么绝对。
2.2 底层原理解密:为什么消息会被严重干扰?
要看清这场踩踏乱象的物理本质,我们需要将视线从应用层的 printf 强行下沉到 Linux 内核的文件总线上。之所以会出现数据混杂在一起的情况,背后隐藏着三个纯粹的底层硬件特征:
1. 一切皆文件与显示器的“共享资源”本质
在 Linux “一切皆文件”的接口思想下,终端也通过文件描述符访问。通常 文件描述符 1(标准输出 stdout) 会连接到当前终端/重定向目标,因此父子进程可以把输出写向同一个目标。
进程启动时通常会继承或拥有 0、1、2 三个标准文件描述符(stdin/stdout/stderr),但它们可以被关闭或重定向,并不是“所有进程无条件永远打开”。当父子进程的 stdout 指向同一个终端时,这个输出目标就成为双方共同访问的资源。
2. 文件描述符的物理继承
当父进程调用 fork() 创建子进程时,内核执行了文件描述符表的浅拷贝。父进程的 1 号描述符指向代表显示器的 struct file 实例,经过浅拷贝,子进程的 1 号描述符也严丝合缝地指向了这同一个 struct file。
这一继承机制意味着:父子进程在诞生之初,就同时握住了往同一个显示器文件里喷涌字节流的实权钥匙。
3. 缺乏原子保护的“无约束时间片切片”
Linux 调度父子进程时,在单核上会通过调度与抢占让它们交替获得 CPU;在多核机器上它们还可能真正并行运行。具体时间片和调度粒度由调度器策略决定,不能固定理解成“以微秒为单位轮流切片”。
- 当父进程被唤醒,开始高频调用
write(1, "====...", 20)向显示器文件灌入数据。 - 如果一次高层输出最终被拆成多次底层写入,那么在其中一次写入之后发生调度切换,另一进程就可能先输出自己的内容。
- 内核大闸闭合,操作系统强行中断父进程,触发上下文切换,转头唤醒了在旁边嗷嗷待哺的子进程。
- 子进程根本不感知父进程写到哪里了。它一醒过来,立刻顺着自己的控制流,抓起
HelloChildProcess往同一个显示器缓冲里灌。 - 结果:多个独立输出操作的先后顺序可能互相穿插;至于是否能出现示例那种字符级拼接,要看底层调用和终端实现,不能仅由“时间片耗尽”一条原因推出。
2.3 降维技术结论:这就是最纯粹的并发问题
这正是我们在本章开篇提及的、最地道的并发问题(Concurrency Issue)。
多执行流在运行期间速率和调度顺序不可控,并且它们能够访问同一个输出目标。如果业务要求多段输出在逻辑上保持为一个整体,就需要在对应临界区使用合适的同步机制;问题本质是多个操作之间缺乏协调,而不是“系统调用一定会在写到一半时被动切开”。
显示器被污染了,我们肉眼还能勉强忍受;但如果这块共享资源是我们上一节要用来存放核心业务资产的物理共享内存(shm),这种缺乏保护的乱序狂飙,会在一瞬间将所有结构体包格式化为满盘皆输的二进制垃圾。引入信号量进行物理级闭环守卫,势在必行。
3、 信号量的物理本质:面向资源预定的内核计数器
在理清了并发问题的毁灭性之后,我们正式引入破局的终极总调度官——信号量(Semaphore,在许多老旧规范中也被生动地称为信号灯)。
要彻底剥离空洞的行业黑话,我们首先给出一个适合本章的直观理解:信号量本质上是一个由系统以原子语义维护的资源计数/同步状态。
它不负责传输任何业务资产数据,它的存在,纯粹是为了描述并清点某块临界资源内部所剩余的、可供进程消费的“空位数量”。
3.1 化繁为简:看电影买票的资源预定哲学
为了让广大读者彻底砸碎认知的铁幕,我们引入一个生活中人人皆知的极其经典的工程类比——去电影院看电影。
假设电影院里有一间高规格的放映厅,里面整整齐齐地排列着 100 个座位。
- 放映厅与座位:这间放映厅,就等价于操作系统中的共享资源;而里面的 100 个座位,则代表该资源内部可以被拆分切片、独立消费的排他性子资源槽位。
- 乱序哄抢的灾难:如果电影院不做任何入场限制,任由外面排队的 200 个买票人(并发进程)在开映瞬间同时往放映厅里冲。多条执行流为了抢夺同一个座位必然在临界区发生惨烈的肢体碰撞,导致全盘大乱(数据污染)。
- 技术破局点:买票机制(信号量):为了维持绝对的确定性秩序,电影院在线上线下架设了一套“售票总线系统”。系统内部常驻着一个数字:
int tickets = 100;。这个票数计数器,就是大名鼎鼎的信号量(Semaphore)。
核心流控时序深度思辨:
当一个观众(进程)想要去放映厅消费座位时,他必须严格遵循两步走的控制流:
- 第一步(买票=申请信号量):观众先去售票系统买票。系统一看
tickets > 0,于是利索地执行一次扣减:tickets--,并利索地下发一张电影票给观众。 - 第二步(执行临界区代码):观众拿着这张票,大摇大摆地凭票入场,找到自己的座位坐下看电影。
这里隐藏着一个极其硬核、支撑起高并发安全底线的终极哲学质疑:当你申请座位资源的时候,这个座位究竟在什么时候才真正属于你?是你的身体实打实地坐在放映厅凳子上的那一瞬间,还是你在前台成功买到票的那一瞬间?
- 资源的预定机制:毫无疑问,在你拿到票的那一秒,那个座位在法律和物理层面上就已经被你提前预定(Reservation)了!哪怕你现在还站在放映厅大门外买可乐、根本没有去碰那个座位(还没执行临界区写代码),别人也绝对无法抢走属于你的这根物理电容槽。
- 安全避障闭环:只要票卖光了(计数器
tickets == 0),后续涌入的进程再怎么调用接口,也会被售票系统冷酷地拦截下来。内核大闸闭合,强行剥夺其 CPU 执行权,让其在门外的等待队列里安稳休眠(wait阻塞挂起),从而用空间上的静止,御绝了临界区内部发生任何踩踏冲突的可能性。
未来想进入共享区域/访问临界资源必须先申请信号量,申请信号量本质是对资源的预定
3.2 深度审计细节一:信号量本身作为共享资源的“原子性防线”
顺着买票机制的推导逻辑,细心的读者一定会敏锐地察觉到一个技术悖论:既然系统内成百上千个毫无血缘关系的独立进程,在冲进临界区之前,都必须无条件地先去查看、并尝试修改(sem--)这同一个计数器。那么:
核心细节一:信号量计数器本身,不也沦为了一个暴露在全天下所有人枪口底下的“公共共享资源”了吗?!
如果多个执行流自己拿一个普通共享整数做 sem--,普通“读-改-写”在没有原子/同步保护时就可能发生竞争,例如两个执行流都读到旧值并分别写回,最终产生典型的丢失更新(lost update)。
终极总调度官的救赎:P / V 原子操作
为了堵死这个逻辑死结,System V 信号量由内核提供具有原子语义的操作接口;应用进程不需要、也不应该自己用普通共享整数去模拟内核信号量的 P/V 状态变更。
对 System V 信号量计数值的修改需要通过内核提供的 semop / semctl 等接口完成。内核内部会使用锁、等待队列以及体系结构原子原语等机制保证规定的原子语义,并不等同于“整个 P/V 就是一条硬件 lock 指令”。
1. P 操作(申请资源:Proberen 测试并扣减)
进程在进入临界区前发起 P 操作。对用户可见的语义是:满足条件时扣减与整组 semop 操作以原子方式生效;不满足条件时,根据标志位选择阻塞等待或立即失败。实现过程中内核可以被调度/睡眠,关键是其他进程不会看到一个“只完成一半”的信号量操作结果。
- 成功执行则计数器减一,进程拿到通行证昂首跨入临界区。
- 若计数器已为 0,P 操作会用原子锁将当前进程安全挂起。
2. V 操作(释放资源:Verhogen 增加并放行)
当进程完成资源使用后执行 V 操作,计数器按请求增加,并可能唤醒满足条件的等待进程。具体哪一个等待者先运行并不是 System V 接口保证的严格 FIFO“下一个进程”语义,最终还受到内核实现和调度器影响。
3.3 深度审计细节二:超级 VIP 单人放映厅与二元信号量的互斥闭环
在明确了信号量作为计数器的本质后,我们来看最后一个关于通道类型的精细划分特征:
电影院里有 100 个座位的普通大厅,如果用一个信号量来表示还剩多少个可用座位,这类数值可以大于 1 的信号量通常称为 “计数信号量(Counting Semaphore)”。System V 还进一步把多个信号量组织成一个“信号量集(Semaphore Set)”。
但是,如果我们决定把某一块共享资源作为一个整体进行互斥保护,希望同一时间只允许一个进程进入对应临界区,就可以把信号量初始值设为 1。
========================================================================================
                      【 二元信号量(初值为 1)的严格互斥流控 】
========================================================================================

 初始状态: sem = 1
    |
    v
 进程 A 抢先切入 -> 成功执行 P 操作 (sem = 1 - 1 = 0) -> 独占进入【超级VIP放映厅】
    |
    +---> 此时 进程 B 紧接着冲过来 -> 尝试执行 P 操作 (此时 sem==0 )
    |        |
    |        v [ 内核大闸闭合 ]
    |     进程 B 瞬间被强行剥夺 CPU 执行权,直接在门外扔进等待队列休眠死等!
    |
 进程 A 看完电影退场 -> 成功执行 V 操作 (sem = 0 + 1 = 1)
    |
    v [ 精准唤醒骨牌 ]
 锁匙归还,处于等待队列首位的 进程 B 被瞬间踢醒,接管放映厅主权。
========================================================================================
核心细节二:二元信号量(Binary Semaphore)的值被约束在 0 和 1 两种状态,通常初始化为 1。初值为 1 时,它可以作为一道互斥门禁:P 后变为 0,V 后恢复为 1。
当信号量退化为二进制的 0 与 1 两个状态时,它在行为矩阵上展现出了完美的互斥锁(Mutex)特征。
在任意时刻,只要一个进程成功执行 P 操作将 1 扣减为 0,它就获得了进入受保护临界区的许可;其余执行流需要等待许可恢复。需要注意,System V 信号量本身不像某些 mutex 类型那样强制记录“只有所有者才能解锁”的 ownership 规则,因此协议必须由程序正确配对。
二元信号量用最极简的 0 0 0 与 1 1 1 的数学流控,在本地高级并发的修罗场上,为裸奔的共享内存焊装上了最坚固、最确定的安全防弹装甲。
4、 信号量底层的核心双重细节:汇编级非原子陷阱与 IPC 认亲机制
在理解了信号量作为“资源预定计数器”的宏观哲学后,我们必须把视线拉向微观的硬件物理层。很多初学者在直观上觉得,既然信号量本质上是个整型计数器,那在代码里直接声明一个 int sem = 10;,然后用 sem-- 和 sem++ 来进行资源清点不就行了?
这背后隐藏着两个致命的底层技术黑洞。本节将深度解构为什么普通的自减操作无法单枪匹马守护临界安全,以及信号量为什么必须被归类为进程间通信(IPC)的底层物理由来。
4.1 细节一:sem-- 不是原子性的!深入 CPU 寄存器的三步转换
核心技术结论:在应用层用户态编写的单行 C/C++ 代码
sem--(或++),在 CPU 硬件流控层面绝对不是原子操作!
许多人对原子性的认知存在巨大的逻辑幻觉,误以为在编辑器里写下的一行简短代码,CPU 就会在一瞬间“一口气执行完”。事实上,当编译器将 sem-- 翻译成二进制机器指令时,这一行高级代码会被无情地拆解为多行低级汇编指令。
物理硬件层面的“读、改、写”三步时序流程:
当 CPU 尝试去扣减物理内存中 sem 变量的数值时,它必须经历以下三个离散的硬件步骤:
- 读(Read):CPU 内部的运算器无法直接在内存(RAM)芯片内部执行数学运算。它必须首先发出总线指令,将驻留在物理内存中的
sem变量数值,拷贝读取到 CPU 内部的某个专属寄存器(Register)中(例如:执行mov汇编指令,将数值10读入寄存器)。 - 改(Modify):CPU 内部的运算单元(ALU)发起动作,对该寄存器内部存放的数字执行真正的自减操作(例如:执行
dec或sub指令,让寄存器内部的10蜕变为9)。 - 写(Write):寄存器刷新完毕后,CPU 再次发起总线回写流,将寄存器内部改写后的全新数值
9,跨越数据总线重新写回到物理内存对应的sem变量坑位中。
致命的并发时间片重叠踩踏:
正因为普通的 sem-- 在底层跨越了“三地独立搬运”,它在并发世界里直接就成了漏风的筛子。
假设进程 A 刚刚执行完了第一步(把 10 读进了自己的寄存器),还没来得及自减,它的时间片就突然耗尽了。
操作系统强行接管,保存现场,换进程 B 上线。进程 B 运行速率极快,它一路畅通地把三步全部走完,把内存里的 sem 成功改写成了 9。
当进程 A 再次苏醒、恢复现场时,它根本不知道外界发生了什么。它顺着自己寄存器里残留的 10 继续向下执行第二步、第三步,最终把 9 再次狠狠地拍回了内存。
最终灾难结果:两个进程明明各自执行了一次自减,内存里的计数器居然才仅仅减少了 1!这种由于数据不一致带来的混乱,会瞬间让临界区的排队门禁全盘崩溃。
硬件级防线底线:
判断一个操作是否原子,不能简单套用“单条汇编指令就一定原子、多条就一定不原子”的规则。原子性依赖具体 CPU 指令、内存访问宽度、缓存一致性以及同步原语;System Vsemop则由内核利用适当的锁和原子机制向用户提供规定的原子语义。
4.2 细节二:进程如何看到同一个信号量?信号量划归 IPC 的本质原因
在明确了信号量需要靠内核特权级汇编来守卫后,我们必须攻克另一个对称的工程大疑问:
核心细节二:既然每个进程都运行在自己绝对隔离的虚拟地址空间里,那我们怎么保证全系统内不同的独立进程,在冲进临界区前,看到并扣击的是“同一个”信号量计数器资源呢?
1. 保护共享资源的前提:信号量必须本身先成为“共享资源”
这触及到了本地并发控制的终极技术辩证法:你的根本目标是为了用信号量去保护那块高危的共享内存;但是要想达成这个目标,多进程首先必须跨越铁幕,在内核深处先看到同一份“信号量计数器资源”!
如果进程 A 在自己的空间里自嗨修改 sem_A,进程 B 在自己的空间里修改 sem_B,两边手里拿的完全是不同的钥匙,临界区的门禁大闸将直接沦为摆设。因此,多进程看到同一个信号量,是一道无法逾越的物理前置死线。
2. 解密信号量被无条件划归为进程 IPC 阵营的物理由来
正是基于这一层技术需求,System V IPC 规范把信号量与共享内存、消息队列并列提供,让不同进程能够通过内核中的同一组信号量协调共享资源访问。
很多初学者会产生概念混淆,觉得进程间通信(IPC)的职责是为了给多进程“传输业务数据包”,而信号量一个字节的业务数据都传不了,凭什么也算 IPC?
- 回归 IPC 的宏观定义:我们在第一章就下过最硬核的结论——进程间通信的本质,是由操作系统内核(Kernel)提供一块所有通信进程都能访问到的公共资源。
- 身份的终极自洽:System V 信号量集合由内核维护。多个进程约定相同的
key(常见做法是使用相同参数调用ftok),再通过semget获取同一个semid,就能操作同一组内核信号量;这里的semid是 IPC 标识符,不是物理地址或绝对数组下标。
消息队列和共享内存利用 IPC 机制让多进程看到同一份“数据资产”;信号量则让多个进程看到同一份同步控制状态。它虽然不负责承载业务数据,却属于 System V IPC 家族,用来解决进程间同步与互斥问题。
5、 信号量集总线矩阵与内核控制家族接口语法全解
在掌握了并发控制的微观汇编陷阱后,我们正式切入信号量(Semaphore)的工程落地。System V 规范为了应对复杂的单机多资源并发调度,其底层的接口设计展现出了极高的集约化和抽象度。本节我们将逐一拆解信号量集、创生、操作、控制总闸以及原子操作结构体的独立语法规则与流控特征。
5.1 semget 系统调用:信号量集合的全新创生与物理圈地
在 Linux 内核中,System V 规范不允许你单独创生一个孤立的信号量计数器。所有的信号量在物理底层全部是以 “信号量集”的数组形态存在的。开辟全新集合或获取已有集合座位号的唯一标准接口是 semget。
关于 semget 的大白话补充
这个接口说白了就是“去房管局申请建一栋带有特定座位数量的电影院”。
- 它为什么叫
get而不叫create?
因为它是个双向接口。如果这栋电影院在内核里还没建,它负责全新建造;如果别人已经建好了,你顺着同样的暗号(key),它负责把这栋房子的专属房间号(semid)告诉你。 - 怎么理解
nsems这个参数?
信号量在 Linux 底层是个数组。nsems就是这个数组的长度。- 如果你只想搞一把简简单单的“互斥锁”(一个座位),这个数字就填
1(建一个单人放映厅)。 - 如果你想用一个大总管同时管好 5 个不同的公共资源,这个数字就填
5(一口气建一个拥有 5 个放映厅的影城)。
- 如果你只想搞一把简简单单的“互斥锁”(一个座位),这个数字就填
1. 语法接口原型
#include <sys/types.h>
#include <sys/ipc.h>
#include <sys/sem.h>

int semget(key_t key, int nsems, int semflg);
2. 参数物理语义
key:用于查找/创建信号量集的key_t值,常由ftok生成。不要把它死记成“固定 32 位且绝对唯一”的密钥。nsems:创建新信号量集时表示希望包含的信号量个数;只创建一把简单互斥门禁时常填1。获取已经存在的集合时,System V 允许nsems为 0;如果给出大于现有集合大小的nsems,会失败(如EINVAL),所以它不是任何场景都“严格必须填 1”。semflg:位图控制掩码。IPC_CREAT:若内核中不存在目标集合,则全新创建;若已存在,则就地直接获取并返回控制句柄。IPC_CREAT | IPC_EXCL:排他性创生大闸。若目标集合完好存在,瞬间物理报错返回-1,并将错误码errno焊死设置为EEXIST。- 权限拼接位:低
9
9
9 位必须手动级联组装八进制访问门禁(如
0666),同样完全不受进程umask掩码的裁剪。
3. 返回值规范
- 成功:返回一个非负整数
semid(信号量集标识符),供后续semop/semctl使用;它是 IPC ID,不应直接解释成“绝对物理数组下标”。 - 失败:返回
-1,并自动激活内核全局错误账本errno。
4. 全场景代码落地演练
#include <stdio.h>
#include <stdlib.h>
#include <sys/types.h>
#include <sys/ipc.h>
#include <sys/sem.h>
#include <errno.h>
#include <string.h>

void DemonstrateSemget(key_t key) {
    // 场景 A:创建或获取一个包含单体计数器(如常规二元互斥锁)的普通信号量集
    int semid_normal = semget(key, 1, IPC_CREAT | 0666);
    if (semid_normal < 0) {
        perror("Scenario A: semget alloc failed");
    } else {
        printf("Scenario A: Successfully got/created semid = %d\n", semid_normal);
    }

    // 场景 B:排他性创生。同时开辟一个包含 5 个独立计数器的分布式信号量矩阵
    int semid_exclusive = semget(key, 5, IPC_CREAT | IPC_EXCL | 0666);
    if (semid_exclusive < 0) {
        if (errno == EEXIST) {
            printf("Scenario B: Exclusive create failed. Asset already active in kernel.\n");
        } else {
            printf("Scenario B: Error: %s\n", strerror(errno));
        }
    } else {
        printf("Scenario B: Exclusively created brand new semaphore matrix. semid = %d\n", semid_exclusive);
    }
}
5.2 semop 系统调用与核心操作结构体 struct sembuf
完成冷启动后,多进程要在临界区前后实施 P/V 操作,System V 提供的标准原子操作接口就是 semop(Linux 还提供 semtimedop 等扩展)。
semop
如果把信号量集比作多间放映厅,那么 semop 系统调用其实就是“放映厅门口的自动化刷卡检票机”。
它的标准原型是 semop(semid, sops, nsops),检票机一共需要你递交三样东西:
-
semid(哪家电影院):告诉系统你要进的是哪个信号量集。 -
struct sembuf *sops(你的“原子检票清单”或“批量申购单”):- 核心真相:它是指向一个或一组
struct sembuf结构体的物理指针(或数组首地址)。 - 类比:它就像是一张“批量入场申请单”。因为 System V 支持高端的“原子级批量操作”,允许你一口气把 1 号厅、2 号厅、3 号厅的门全部锁上(如果其中有一个厅满座,整张单子全部作废原地挂起,这就是原子性)。所以你必须把打包好的一张或多张控制卡片,通过
sops这个指针打包递给检票机。
- 核心真相:它是指向一个或一组
-
nsops(清单上写了几条指令):- 告诉检票机你这次递过来的
sops清单里到底包含了几张struct sembuf卡片。常规只操作一个信号量时填1;如果希望把多条操作作为一组原子提交,则填写数组中的实际操作条数。
- 告诉检票机你这次递过来的
顺着 sops 递进检票机后,我们需要死死盯住卡片(struct sembuf)里的这三个格子:
-
sem_num(你要去几号厅):因为之前建的是影城数组,你得在卡片上写清楚,你这次打算去摸集合里第几个下标的计数器(下标从 0 开始)。 -
sem_op(你是买票还是退票):这是动作的灵魂,是一个纯粹的数学正负号:- 填
-1(买票入场 / P操作):当当前值足够扣减时,内核原子地执行减 1;如果值不足,默认会阻塞等待,若设置了IPC_NOWAIT则不会睡眠,而是立即失败并返回EAGAIN。 - 填
+1(退场还票 / V操作):内核原子地增加计数,并可能唤醒因为条件不满足而等待的进程;System V 不承诺严格按照“门口队首下一个”FIFO 顺序交接 CPU。
- 填
-
sem_flgsem_flg = 0;表示默认阻塞模式:如果当前信号量条件不能满足,进程就睡眠等待。sem_flg = IPC_NOWAIT;表示非阻塞模式:如果当前操作不能立即完成,就直接返回失败,不等待。sem_flg = SEM_UNDO(内核级退票保险):表示进程退出时由内核自动撤销本进程对信号量造成的影响,常用于避免进程异常退出后信号量状态永久错误。
SEM_UNDO的核心是内核为每个进程独立维护一个“净变化账本”(semadj),而不是记录每一次semop的操作历史。进程每次操作信号量时,内核不关心它做过什么具体动作,只累加一个“总调整量”(例如 P 操作导致信号量值减 1,就在账本里记下-1;V 操作加 1,就记下+1)。当进程无论正常退出还是异常崩溃时,内核自动把当前信号量的数值反向回退这个净调整量(相当于把账本归零),从而避免信号量被异常退出的进程锁死。但必须清醒:这只是一份“数值退票保险”,不是“业务数据保险”。例如进程拿到了锁但还没写完共享数据就崩溃了,内核虽然帮你把信号量恢复成了“未锁定”状态,但共享内存里那半截损坏的数据内核是不会帮你恢复的。所以SEM_UNDO只能解决资源计数死锁问题,绝不能替代业务层自己的事务回滚协议。
1. 语法接口原型
int semop(int semid, struct sembuf *sops, size_t nsops);
sops:指向一个由用户在外部整备好的原子控制指令结构体数组(struct sembuf)的物理指针。nsops:本次批量提交的控制指令结构体对象的个数(若只对一个计数器做 PV 操作,该数字严格填1)。semop()成功返回0,失败返回-1,并设置errno表示具体错误原因。
2. 参数语法规则:核心结构体 struct sembuf 深度剖析
Linux 内核为了能够用一条指令同时描述复杂的并发组合,将所有的 PV 操作意志全部收拢、封装进了 <sys/sem.h> 内部的一个原生结构体结构中:
struct sembuf {
    unsigned short sem_num;  // 💥 靶向目标:当前要操作的信号量在集合(数组)中的下标(从 0 开始)
    short          sem_op;   // 👑 动作灵魂:决定本次到底是执行 P 操作还是 V 操作的数学符号
    short          sem_flg;  // 控制流保护策略位图
};
3. sem_op 的三重大脑底层路由(决定 PV 命运的数字)
内核在收到 sem_op 内部填充的数字时,会启动严格的数学正负号分流审查:
-
情况一:
sem_op < 0(物理执行 P 操作大闸)- 内核行为:
sem_op < 0表示申请一定数量的资源。内核检查当前值是否足以完成扣减;对于计数信号量,这并不一定意味着“独占”整个资源。 - 流控特征:如果当前值足够,则整组
semop操作按原子语义生效并返回;如果不足,默认阻塞等待。若对应sem_flg设置IPC_NOWAIT,则不阻塞而直接以EAGAIN失败。 - 标准工程规范:执行常规互斥锁时,该位置严格填
-1。
- 内核行为:
-
情况二:
sem_op > 0(物理执行 V 操作放行)- 内核行为:
sem_op > 0表示增加信号量值,通常用于归还资源/释放许可;内核会把这个正整数按原子语义加到相应计数器上。 - 流控特征:增加成功后,某些此前因条件不满足而等待的
semop可能变得可执行,内核会重新检查并唤醒合适的等待者;不应把它固定理解成“严格唤醒队首第一个进程”。 - 标准工程规范:执行常规释放时,该位置严格填
+1。
- 内核行为:
-
情况三:
sem_op == 0(内核级“等零”大闸)sem_op == 0表示“等待该信号量变为 0”。如果当前已经为 0 就立即成功;否则默认阻塞等待,若设置IPC_NOWAIT则直接以EAGAIN失败。
4. sem_flg 的工业级保底王牌:SEM_UNDO
位图标志位可以填 0、IPC_NOWAIT、SEM_UNDO 等组合。SEM_UNDO 是否使用要根据业务语义决定,不建议无条件套用:它会消耗内核 undo 资源,而且有些协议本来就不希望进程退出时自动补偿。
SEM_UNDO的生命线守护机制:
假设进程 A 成功执行了 P 操作(sem_op = -1),冲进了共享内存临界区。突然,进程 A 因为内存越界触发了毁灭性的段错误(SIGSEGV)瞬间粉碎性暴毙,甚至没来得及调用 V 操作去还钥匙。
如果不使用SEM_UNDO,而进程在 P 成功后异常退出且没有任何其他进程负责释放/修复这个资源计数,那么信号量可能长期停在不期望的状态,导致其他进程持续等待。
使用SEM_UNDO后,内核会保存该进程针对相应信号量的调整量,并在进程结束时按 semadj 进行补偿。对于最简单的-1场景,补偿效果常表现为把 1 加回去;对于更复杂的正负操作,不能一律理解成“固定执行一次 V(+1)”。
5. 全场景 P/V 原子控制流落地演练
#include <sys/types.h>
#include <sys/ipc.h>
#include <sys/sem.h>
#include <stdio.h>
#include <stdlib.h>

// 封装高内聚的原子 P 操作(上锁门禁)
void P(int semid, int sem_index) {
    struct sembuf p_cmd;
    p_cmd.sem_num = sem_index;  // 指定对集合中哪一个下标的计数器动刀
    p_cmd.sem_op  = -1;         // 💥 负数代表执行 P 操作,强行申请资源
    p_cmd.sem_flg = SEM_UNDO;   /* 👑 挂载安全保底防线,防止进程暴毙引发全盘死锁 */

    // 跨入内核态,执行原子读、改、写。若不够减,当前控制流将卡死在这一行睡觉
    if (semop(semid, &p_cmd, 1) < 0) {
        perror("Atomic P operation cracked");
        exit(5);
    }
}

// 封装高内聚的原子 V 操作(释放锁)
void V(int semid, int sem_index) {
    struct sembuf v_cmd;
    v_cmd.sem_num = sem_index;  // 数组定位
    v_cmd.sem_op  = 1;          // 💥 正数代表执行 V 操作,物理归还锁匙
    v_cmd.sem_flg = SEM_UNDO;   // 保持状态机对齐

    // 跨入内核态,直接自增,并精准踢醒门外挂起等待的兄弟进程
    if (semop(semid, &v_cmd, 1) < 0) {
        perror("Atomic V operation cracked");
        exit(6);
    }
}
5.3 semctl 系统调用与专属多态联合体 union semun
对信号量集合实施初始值焊装、底账属性读取或强制销毁的系统级总指挥官是 semctl。
semctl
这个接口不负责日常的买票检票,它是“电影院经理的后台管理控制面板”。
- 为什么刚建完信号量不能直接用,非要调用
semctl?
在 Linux 上 ,新创建的 System V 信号量集的值会初始化为 0;但从可移植/System V 编程习惯看,创建者仍应显式使用SETVAL或SETALL完成初始化,并让其他进程在确认初始化完成后再使用,不要依赖隐含初值作为协议。
所以在本文“初值为 1 的互斥门禁”示例中,创建者应调用semctl(..., SETVAL, ...)把目标信号量显式设置为 1(或者设置成你需要的资源计数)。 - 怎么理解
union semun?
它就是经理手里提着的那个“多功能手提箱”。- 如果你想给信号量强行初始化赋值,你就往箱子里的
.val格子塞个数字(比如 1); - 如果你想彻底把这栋电影院连根拔除拆毁,你就给
cmd投递一个IPC_RMID,内核收到指令后,瞬间在物理内存里将整个信号量集合解体火化。
- 如果你想给信号量强行初始化赋值,你就往箱子里的
1. 语法接口原型
int semctl(int semid, int semnum, int cmd, ...);
返回值:成功时,
GETVAL返回信号量值(非负整数),其他命令返回0;失败统一返回-1,并设置errno。
2. 参数物理语义
2.1 semid:信号量集的身份铁牌
由 semget() 成功返回的信号量集标识符(IPC ID)。它是内核 IDR 中查找该信号量集对象的唯一凭证,必须传对,否则直接报 EINVAL。
2.2 semnum:靶向定位的数组下标
信号量集本质是一个信号量计数器数组(由 semget 的 nsems 参数决定长度)。semnum 指定你要精确操作这个数组里的第几个计数器(下标从 0 开始)。
- 生效场景:当
cmd是GETVAL(读单个值)、SETVAL(设置单个值)、GETPID(获取最后操作进程 PID)等针对单个信号量的命令时,semnum必须指向0到nsems-1之间的有效索引。 - 失效场景(填 0 占位):当
cmd是IPC_RMID(删除整个集合)、IPC_STAT(读整个集合属性)或SETALL(设置全部计数器)等作用于整个集合的命令时,semnum失去物理语义,内核直接忽略它。但 C 语法必须传参,按 Linux 源码惯例和 man 手册要求,此时必须硬编码填入0
2.3 cmd:最高核心控制意志(宏命令)
| 命令宏 | 物理行为 | 作用范围 |
|---|---|---|
IPC_RMID | 立即删除整个信号量集。内核释放集合对象,唤醒所有阻塞在该集合上的进程(让他们返回 EIDRM)。无论 semnum 填什么,集合整体消失。 | 整集 |
SETVAL | 焊装初始值的绝对大闸。将 semnum 指定的那一个计数器的值,强制原子性地设置为 ... 可变参数传入的 int val。 | 单个 |
GETVAL | 回读当前指定计数器内部残存的真实数字。返回 semnum 对应的那个信号量的当前计数值。 | 单个 |
IPC_STAT | 将内核中该信号量集的权限、时间戳、当前值等属性,拷贝到用户态传入的 struct semid_ds *buf 中(通过可变参数传递)。 | 整集 |
IPC_SET | 用用户态传入的 struct semid_ds *buf 中的权限(sem_perm.uid/gid/mode)覆盖内核属性。 | 整集 |
GETALL | 将集合中所有信号量的当前值,一次性拷贝到用户态传入的 unsigned short *array 数组中。 | 整集 |
SETALL | 用用户态传入的 unsigned short *array 数组中的值,一次性设置集合中所有信号量的值。 | 整集 |
2.4 ...(可变参数段):命令的“弹药盒”与 union semun 的秘密
semctl 最后一个参数是 ...,意味着它不固定类型,具体传什么完全由 cmd 说了算。这是整个函数最让人头疼的地方。
在 Linux 系统中,标准 C 库(glibc)并不预定义 union semun,需要你自己在代码里手动定义这个联合体。原因很简单:不同类型的 cmd 需要传不同形态的数据(整数值、结构体指针、数组指针),用联合体可以把它们包在一起,让编译器知道内存大小和对齐方式。
你必须在你调用 semctl 的 .c 文件开头,显式定义如下联合体:
union semun {
    int val;                    // 用于 SETVAL:要设置的整数值
    struct semid_ds *buf;       // 用于 IPC_STAT / IPC_SET:属性结构体指针
    unsigned short *array;      // 用于 GETALL / SETALL:数组指针
};
四种典型的传参套路(按 cmd 分类):
cmd 类型 | 可变参数的实际数据类型 | 物理弹药说明 |
|---|---|---|
SETVAL | int val(或直接传 union semun) | 直接把你要焊装的初始值(例如 1)塞进去。常见写法:semctl(semid, semnum, SETVAL, 1); 或者 semctl(semid, semnum, SETVAL, un.val=1); |
GETVAL | 不传任何东西(可省略,或传 0) | 因为返回值直接由函数带出,不需要给内核带东西进去。 |
IPC_STAT / IPC_SET | struct semid_ds *buf(联合体的 .buf 成员) | 必须传一个用户态已分配好的结构体指针,内核会往里面填数据(STAT)或从里面读数据(SET)。 |
GETALL / SETALL | unsigned short *array(联合体的 .array 成员) | 必须传一个长度至少等于集合内信号量个数(nsems)的 unsigned short 数组首地址。*unsigned short array里面的值就是array下标对应信号集下标的信号该设置的值 |
特别注意(最容易翻车的坑):
由于 semctl 是变参函数,编译器不做类型检查。如果你传指针时没传对,内核拿到垃圾地址会直接崩溃(或返回 EFAULT)。因此,最安全的终极写法是:
无论哪种
cmd,统一定义一个union semun变量,只用它的对应成员传参,绝不直接塞裸指针。
- 例如设置单个值:
union semun un; un.val = 10; semctl(semid, 0, SETVAL, un); - 例如读取属性:
union semun un; struct semid_ds ds; un.buf = &ds; semctl(semid, 0, IPC_STAT, un);
这样,编译器至少能帮你检查联合体的大小,减少手工传错类型的概率。
3. 工业级避坑天规: union semun 的肉身定义规范
在 glibc/Linux 常见环境下,<sys/sem.h> 通常不会直接替你定义 union semun(可通过相关宏判断),因此很多示例会在源文件中自行声明如下联合体:
👑 工业级系统编程铁律:必须在自己的代码里肉身手写这个联合体!
union semun {
    int              val;    /* 当 cmd == SETVAL 时,内核只认这个用来初始化的整型值 */
    struct semid_ds *buf;    /* 当 cmd == IPC_STAT 时,用来回读底账的结构体指针 */
    unsigned short  *array;  /* 当需要联合对整条数组一口气初始化时使用的数组指针 */
};
4. 全场景控制大总管控制流落地演练
#include <stdio.h>
#include <stdlib.h>
#include <sys/types.h>
#include <sys/ipc.h>
#include <sys/sem.h>
#include <errno.h>

void ControlSemaphoreSet(int semid) {
    // 场景 A:将信号量集中下标为 0 的那个计数器,初始值强行焊装设置为 1(蜕变为二元锁)
    union semun init_signal;
    init_signal.val = 1;

    if (semctl(semid, 0, SETVAL, init_signal) < 0) {
        perror("Scenario A: SETVAL failed");
        exit(1);
    }
    printf("Scenario A: Successfully initialized semaphore[0] to 1.\n");

    // 场景 B:动态回读该计数器内部残存的真实数字(GETVAL)
    int current_counter = semctl(semid, 0, GETVAL);
    if (current_counter >= 0) {
        printf("Scenario B: Current semaphore[0] counter value = %d\n", current_counter);
    }

    // 场景 C:行政级强制解体销毁整个信号量集合资产(IPC_RMID)
    if (semctl(semid, 0, IPC_RMID, NULL) < 0) {
        perror("Scenario C: Dismantle IPC_RMID failed");
    } else {
        printf("Scenario C: Entire Semaphore Set uninstalled successfully.\n");
    }
}


多个信号量
#include <stdio.h>
#include <stdlib.h>
#include <sys/ipc.h>
#include <sys/sem.h>

union semun {
    int val;
    struct semid_ds *buf;
    unsigned short *array;
};

int main(void)
{
    // 创建一个包含 2 个信号量的集合
    int semid = semget(IPC_PRIVATE, 2, IPC_CREAT | 0666);
    if (semid == -1) {
        perror("semget");
        exit(1);
    }

    union semun arg;

    // sem[0] = 2
    arg.val = 2;
    semctl(semid, 0, SETVAL, arg);

    // sem[1] = 0
    arg.val = 0;
    semctl(semid, 1, SETVAL, arg);

    printf("操作前: sem[0]=%d, sem[1]=%d\n",
           semctl(semid, 0, GETVAL),
           semctl(semid, 1, GETVAL));

    /*
        一次 semop 做两个操作:

        sem[0] -= 1
        sem[1] += 1
    */
    struct sembuf ops[2];

    ops[0].sem_num = 0;
    ops[0].sem_op  = -1;
    ops[0].sem_flg = 0;

    ops[1].sem_num = 1;
    ops[1].sem_op  = +1;
    ops[1].sem_flg = 0;

    // 一次性提交两个操作
    if (semop(semid, ops, 2) == -1) {
        perror("semop");
        exit(1);
    }

    printf("操作后: sem[0]=%d, sem[1]=%d\n",
           semctl(semid, 0, GETVAL),
           semctl(semid, 1, GETVAL));

    // 删除整个信号量集合
    semctl(semid, 0, IPC_RMID);

    return 0;
}
5.4 控制台层面的集合审计与行政火化:ipcs -s 与 ipcrm -s
常驻内核的信号量集合在 Shell 终端中同样拥有专属的行政盘点与爆破总闸。
1. 资产盘点总线:ipcs -s
# 直接在 Linux 终端敲击
$ ipcs -s

------ Semaphore Arrays --------
key        semid      owner      perms      nsems
0x66ccff66 0          root       666        1
0x66ccff68 98304      mounanlin  666        2
- 账本输出核心字段解析:
semid:内核返回给用户态操控该信号量集的 IPC 标识符。perms:八进制门槛访问权限位。nsems:该集合内部当前包含的信号量计数器物理总个数(即数组的物理长度)。
2. 行政强行火化:ipcrm -s / -S
# 黄金标准语法:基于内核索引 semid 实施 O(1) 数组直插爆破
$ ipcrm -s 98304

# 旁路备用语法:基于外部唯一的 Key 进行全局哈希逆向擦除
$ ipcrm -S 0x66ccff68
5.5 用户态 semid_ds 与内核态 sem_array:第一成员布局不要混淆
操作系统为了管理多个信号量集合,同样采用“先描述,再组织”的思路。这里必须区分:用户接口使用 struct semid_ds + struct ipc_perm;而 Linux 2.6.11/2.6.18 内核内部的真实集合对象是 struct sem_array,其公共权限部分是 struct kern_ipc_perm sem_perm。
它们不要被当成 Linux 2.6.x struct sem_array 的原样内核定义。真正的旧版内核结构在后文章节会单独列出。
1. 统一的权属门禁母模:struct ipc_perm
struct ipc_perm {
    __kernel_key_t  key;    // 👑 寻址暗号:由 ftok 熔炼而成的全局唯一 Key 值
    __kernel_uid_t  uid;    // 资产当前所有者的用户 ID (UID)
    __kernel_gid_t  gid;    // 资产当前所有者的组 ID (GID)
    __kernel_uid_t  cuid;   // 创生始作俑者的用户 ID (Creator UID)
    __kernel_gid_t  cgid;   // 创生始作俑者的组 ID (Creator GID)
    __kernel_mode_t mode;   // 💥 物理访问门槛:八进制权限位
    unsigned short  seq;    // 槽位翻转序列号(用于御绝 ABA 身份冒领的版本号)
};
2. 信号量集用户态/概念控制账本示意:struct semid_ds
struct semid_ds {
    struct ipc_perm sem_perm;       // 👑 物理铁律:必须、且雷打不动地占据结构体的最前端(第一成员)
    __kernel_time_t sem_otime;      // 最后一次执行原子操作(semop)的时间戳
    __kernel_time_t sem_ctime;      // 最后一次执行控制大总管(semctl)的时间戳
    struct sem      *sem_base;      // 💥 核心指针:死死指向内核深处存放计数器数组实体的物理内存首地址
    struct sem_queue *sem_pending;  // 挂起在该信号量上的阻塞进程等待队列
    struct sem_undo  *undo;         // 当前信号量绑定的物理动态补偿账本
    unsigned short  sem_nsems;      // 集合内部包含的计数器物理总个数
};
Linux 2.6.11/2.6.18 的内核结构图中,集合级对象是
struct sem_array,其第一成员是struct kern_ipc_perm sem_perm,并包含sem_base、等待操作与 undo 等内部字段;所以上面的semid_ds代码不要当成内核本尊。
核心物理设计特征:首地址的绝对重合
在标准 C 语言的结构体布局规则中,结构体对象的地址与第一个成员的地址在数值上相同。
因此,这段本地示例里可以利用 Offset 0 的布局把对象地址转成第一个成员类型来理解字段复用;但这并不能证明 Linux 内核真实的 sem_array 是通过把用户态 semid_ds* 强转成 ipc_perm* 来工作。内核内部复用的是 kern_ipc_perm。
// 内核底层完全合法的物理多态强转
struct semid_ds my_semset;
struct ipc_perm *perm_ptr = (struct ipc_perm *)&my_semset; // 首地址 100% 重合,转型完美通过
补充章节:拔掉伪装,信号量在内核里也是结构体吗?
在前面的章节中,为了化繁为简,我们用“消息队列组织消息、共享内存映射共享页、信号量维护计数/同步状态”帮助建立直觉。这里继续向下看内核结构,但要记住具体字段属于内核版本实现细节。
此时,深入钻研 C/C++ 底层的读者必然会产生一个灵魂质疑:既然 Linux 操作系统万物皆对象,管理任何资产都死死遵循“先描述,再组织”的铁律,那信号量在内核腹地里,难道真的就只是一个赤裸裸的 int 类型的数字吗?
核心结论:信号量不只是用户想象中的一个裸
int。System V 信号量集在内核中由集合级对象和单个信号量状态共同组织;以 Linux 2.6.x 为例,可以看到struct sem_array、struct sem、等待操作和 undo 等配套结构。
1、 单个计数器的肉身真面目:struct sem
我们在上文先用 struct semid_ds 做过接口层/概念层说明;按 Linux 2.6.x 内核源码,集合级本尊应看 struct sem_array,其中包含指向单体 struct sem 数组的 sem_base:
struct sem *sem_base; // 死死指向内核计数器数组的首地址
这个指针所指向数组里的每个元素代表一个信号量的内核状态。
struct sem {
    int            semval;  // 👑 真正的物理计数器!(也就是“残存票数”)
    int            sempid;  // 最后一次对该特定计数器执行 PV 操作的进程 PID
    struct list_head pending_list; // 💥 核心死线:挂在这“单体计数器”身上的阻塞睡眠等待队列
};
2、 为什么不能只是一个 int?解密结构体内部的精妙设计
看完这些结构后,可以明确:System V 信号量的内核实现不只是一个孤立整数,还要维护集合元数据、每个信号量的值/最近操作进程以及等待中的 semop 等状态。具体这些等待状态挂在哪一级结构上,随内核版本变化。
2.1 谁动了我的奶酪? —— sempid 的历史追溯
如果信号量只是一个孤立的 int sem,当系统在高速并发踩踏中突然发生死锁时,内核大总管根本无法查证这个数字到底是被哪条狼(哪个进程)给扣成
0
0
0 的。
而通过在内部焊装一个 sempid 字段,每次执行 semop 成功引发数字跳变时,内核都会瞬间顺手把当前进程的 PID 强行刻写进 sempid 格子里。这为高性能多进程集群提供了天然的“故障追溯黑匣子”。
2.2 等待队列与挂起操作 —— 具体组织随内核版本变化
① 进程挂起时,内核到底“存”了什么?
当进程 A 因为 semop(1号厅) 票数不够而被拍晕时,内核不是仅仅标记“A在等1号厅”。
内核会创建一个叫 struct sem_queue 的结构体(你可以理解为一张“欠条”),这张欠条上详细记录了:
- 进程 A 是谁(
task_struct); - A 到底要执行怎样的
semop操作(比如“要把 1 号厅减 1”); - A 当前满足条件的“期望值”是什么。
重点来了:这张“欠条”存哪儿? 这就引出了版本差异的核心。
② 在 Linux 2.6.x 里,铁律是:“集合级大通铺”
在 2.6.x 内核源码中,struct sem_array(代表整个影城集合)里维护了两个指针:
sem_pending:指向队列头部;sem_pending_last:指向队列尾部。
这意味着:所有厅(1号、2号…5号)的等待者,不分彼此,全部塞进这同一个“大通铺”链表里。
“不能把每个 struct sem 都固定拥有一条专属 pending_list” 1号厅满座时,A和B的“欠条”挂在影城经理(集合)名下,而不是挂在1号厅的门牌号底下。
③ 既然挂在一起,唤醒时怎么操作?(这才是精髓)
假设此时 2 号厅有人退票,值发生了变化。
内核的唤醒逻辑是:遍历整个“大通铺”链表(从头到尾),把每一张“欠条”拿出来,重新计算一遍。
- 检查 A 的欠条:A 想买 1 号厅。内核看一眼 1 号厅的当前值——还是 0。不满足,把欠条扔回去,A 继续睡。
- 检查 B 的欠条:同理,继续睡。
- 检查 C 的欠条:C 想买 2 号厅。内核看一眼 2 号厅——有票了!满足,把 C 的欠条从链表中摘除,唤醒 C。
关键收益:正是因为这个“大通铺”设计,当任意一个厅变化时,内核能原子地、一次性检查所有跨厅的复杂操作(比如某个进程同时要求“1号厅减1 且 2号厅加1”),避免了并发抢票的数据错乱。
④ “不能当铁律”?(版本变化)
因为内核开发者觉得 2.6.x 的“大通铺”效率太低了——每次任意一个信号量变化,都要遍历整个集合的全部等待者,万一集合里有 10 个信号量,挂了 1000 个进程,唤醒开销极大。
在新的内核版本(如 4.x 之后),数据结构可能被优化为:
- 引入每信号量(Per-semaphore) 的等待队列,让 1 号厅的等待者只挂在 1 号厅下面;
- 或者引入红黑树(rbtree)来加速查找;
- 甚至改变锁的粒度(从集合级大锁拆分为细粒度锁)。
总结
挂起时,内核存的是完整的操作“欠条”(
sem_queue);在 2.6.x 老版本中,所有欠条统一挂在“影城集合”(sem_array)下,不挂单个厅;新版本为了性能可能会改成挂在单个厅下或更复杂结构。因此,“每个信号量自带一条等待队列”不是亘古不变的真理,必须看内核版本源码。
3、 总结:System V 信号量的两层核心解耦账本
我们可以把 System V 信号量的内核资产分成“集合级管理对象 + 单体信号量状态”两层来理解。按Linux 2.6.x,集合级对象应以 struct sem_array 为准,下面原来的 semid_ds 文本拓扑继续保留作为概念示意。
========================================================================================
                     【 System V 信号量双层控制账本级联网络 】
========================================================================================

 【 第一层:行政总控制头 (全局一指控盘) 】
   struct semid_ds (影城大总管)
   +------------------------------------+
   | struct ipc_perm sem_perm; (门禁)   |
   | unsigned short  sem_nsems; (长度)  |
   | struct sem     *sem_base;  --------+-------+ (指针级联)
   +------------------------------------+       |
                                                v
 【 第二层:实体物理计数器数组 (一线肉搏) 】
   struct sem array[] (放映厅阵列)
   +-----------------------------------------------------------------------------------+
   | [Idx 0]: semval(票数) | sempid(最后PID) | struct list_head pending_list(专属排队链) |
   +-----------------------------------------------------------------------------------+
   | [Idx 1]: semval(票数) | sempid(最后PID) | struct list_head pending_list(专属排队链) |
   +-----------------------------------------------------------------------------------+
========================================================================================
补充:System V 信号量:从进程到 semval 的完整源码地图((底层看懂可省略))
当前内核中
IPC_SEM_IDS == 0,即信号量永远挂在ipc_namespace->ids[0]上。
开篇:你要找的那张票(semval),藏在哪条路径上?
任何 semop 操作,最终都要修改某个信号量的 semval。内核找它的路径是 铁打的三级跳:
当前进程 (current)
    → 命名空间 (ipc_namespace)
        → IDR 基数树 (ipc_ids.ipcs_idr)
            → 权限头 (kern_ipc_perm)
                → 信号量集合 (sem_array)  [通过 container_of 反推]
                    → 具体信号量 (struct sem)  [通过 sem_num 索引 sems[]]
                        → 最终目标:semval
第一部分:落脚点 —— 如何找到你的"影城"(sem_array)
1. 进程先找到自己的"世界"(ipc_namespace)
每个进程的 task_struct 里藏着 nsproxy,里面直接指向当前 IPC 命名空间。内核通过 current->nsproxy->ipc_ns 一步拿到。
这个命名空间里有一个 struct ipc_ids ids[3] 数组,分别管理三种 IPC:
ids[0]:信号量(Semaphore)ids[1]:消息队列(Msg Queue)ids[2]:共享内存(Shm)
所以,取信号量 IDR 树的宏 sem_ids(ns) 展开就是 &ns->ids[0]。
2. 全局花名册(ipc_ids)与 IDR 树
ipc_ids 结构里最重要的两个成员:
struct idr ipcs_idr:凭semid快速找到内核对象。struct rhashtable key_ht:凭key快速找到或创建集合。
当你调用 semget 传入 key 时,内核优先查 key_ht;当你拿着 semid 做 semop 时,内核直接进 ipcs_idr 取值。
3. 从 IDR 取出的"万能头"(kern_ipc_perm)
IDR 树里存的是 struct kern_ipc_perm *。这个结构是所有 IPC 对象的公共头,里面记录了 id、key、uid/gid、权限 mode 以及一把自旋锁 lock。
真正的精髓在这里: struct sem_array 结构体的第一个成员就是 struct kern_ipc_perm sem_perm。因此,内核拿到 perm 指针后,直接调用 container_of(perm, struct sem_array, sem_perm),就能算出整个 sem_array 的起始地址。
第二部分:核心阵地 —— sem_array 和它的子信号量(struct sem)
semget(key, nsems, ...) 创建的是一整个数组,而不是单个信号量。
sem_array 的核心布局(去繁就简):
struct sem_array {
    struct kern_ipc_perm sem_perm;   // 公共头
    struct list_head pending_alter;  // 待处理的“修改类”操作队列(集合级)
    struct list_head pending_const;  // 待处理的“阻塞类”操作队列(集合级)
    int sem_nsems;                   // 信号量个数
    struct sem sems[];               // 柔性数组,真正的信号量本体
};
每一个 struct sem 里藏着什么?
struct sem {
    int semval;                      // 就是你要读/改的票数!
    struct pid *sempid;              // 最后操作它的进程 PID
    spinlock_t lock;                 // 每个信号量自己的锁(细粒度优化)
    struct list_head pending_alter;  // ★★★ 重点:每个信号量自己的等待队列!
    struct list_head pending_const;  // ★★★ 重点:每个信号量自己的等待队列!
};
第三部分:重头戏 —— 挂起等待(彻底澄清你的困惑)
上一轮你反复纠结:“等待队列到底是集合级的,还是每个信号量独有的?”
在当前的 master 源码面前,答案非常明确:两者都有,且分工明确!
1. 为什么要有"两套"队列?
- 集合级队列(
sem_array->pending_*):用于跨信号量的复合操作。比如用户一次semop传入了 3 个sembuf,要求同时修改sems[0]和sems[1]。这种操作无法挂在单个信号量下面,只能挂在集合级别统一管理。 - 单信号量级队列(
sem->pending_*):用于只针对单一信号量的简单操作。比如进程 A 只等sems[2]的值变成 1。为了提高唤醒效率,内核直接把 A 挂在sems[2]自己的链表上。
2. 挂起的全过程(sem_queue 登场)
当 do_semtimedop() 发现操作无法立即满足时(比如要减 1 但 semval=0),内核不会丢下进程不管,而是:
- 分配一个
struct sem_queue(你可以理解为一张"欠条")。 - 这张欠条里记录着:阻塞的进程(
sleeper)、要执行的操作数组(sops)、是否带SEM_UNDO。 - 内核根据操作类型,决定把这张欠条挂在集合级的
pending_alter上,还是挂在特定struct sem的pending_alter上。 - 调用
schedule(),进程彻底让出 CPU,进入睡眠。
3. 唤醒的绝妙机制(update_queue())
当任何一个信号量的 semval 发生变化时(比如有人退票),内核会调用 update_queue()。这个函数会同时扫描:
- 该
struct sem自己的pending_alter链表。 - 整个
sem_array的集合级pending_alter链表。
每张"欠条"都会重新调用 perform_atomic_semop() 检查。一旦条件满足,就把 sem_queue 从链表中摘下,唤醒 sleeper 进程,让它继续执行。
结论: 在 master 分支中,“单信号量专属队列"和"集合级大队列"是共存且互补的关系,不存在谁取代谁。这是为了兼顾"单一操作的高效性"和"复合操作的原子性”。
第四部分:SEM_UNDO —— 进程崩溃时的"后悔药"(撤销机制)
如果 sem_flg 带了 SEM_UNDO,内核必须保证:进程无论正常退出还是异常崩溃,它对信号量的修改都会被回滚。
1. 记账本(sem_undo 与 semadj)
进程每次执行带 SEM_UNDO 的 semop 时,内核不会记录"旧值是多少",而是记录**“退出时需要补偿多少”**(即 semadj 数组)。
- 比如你把
semval从 5 减到了 4(减少了 1),内核就在该进程对应的sem_undo->semadj[sem_num]里累加+1。 - 退出时,内核把
semadj里的值加回到semval上。
2. 进程如何找到自己的账本?
task_struct 里有一个 struct sysvsem 结构,其中包含 struct sem_undo_list *undo_list。
这个 undo_list 是一个链表头,挂着该进程所有操作过的信号量集合对应的 sem_undo 节点(每个 semid 对应一个节点)。
当进程调用 exit() 时,内核走 exit_sem() → 遍历 undo_list → 找到每个 sem_array → 加上 semadj 补偿 → 彻底释放账本。
第五部分:三条源码调用链(刻进 DNA 里的查找逻辑)
① 创建(semget)
semget() → ksys_semget() → 从 current->nsproxy->ipc_ns 取 sem_ids → ipcget() → newary() → sem_alloc() 分配 sem_array + sems[] → ipc_addid() 把 perm 塞进 ipcs_idr → 返回 semid。
② 操作(semop / semtimedop)
semop() → do_semtimedop() → 根据 semid 进 ipcs_idr 找 perm → container_of 得 sem_array → 根据 sem_num 取 struct sem → perform_atomic_semop() 尝试修改 → 失败则创建 sem_queue 挂入 pending 链表并睡眠 → 成功则直接修改 semval。
③ 撤销(SEM_UNDO 与进程退出)
semop(SEM_UNDO) → 操作信号量的同时,通过 current->sysvsem.undo_list 查找或创建 sem_undo,更新 semadj[]。进程退出 → exit_sem() → 遍历 undo_list → 根据 semid 找回 sem_array → 将 semadj 累加到 semval 上。
最终,用一张真正的"底层流脉图"收尾
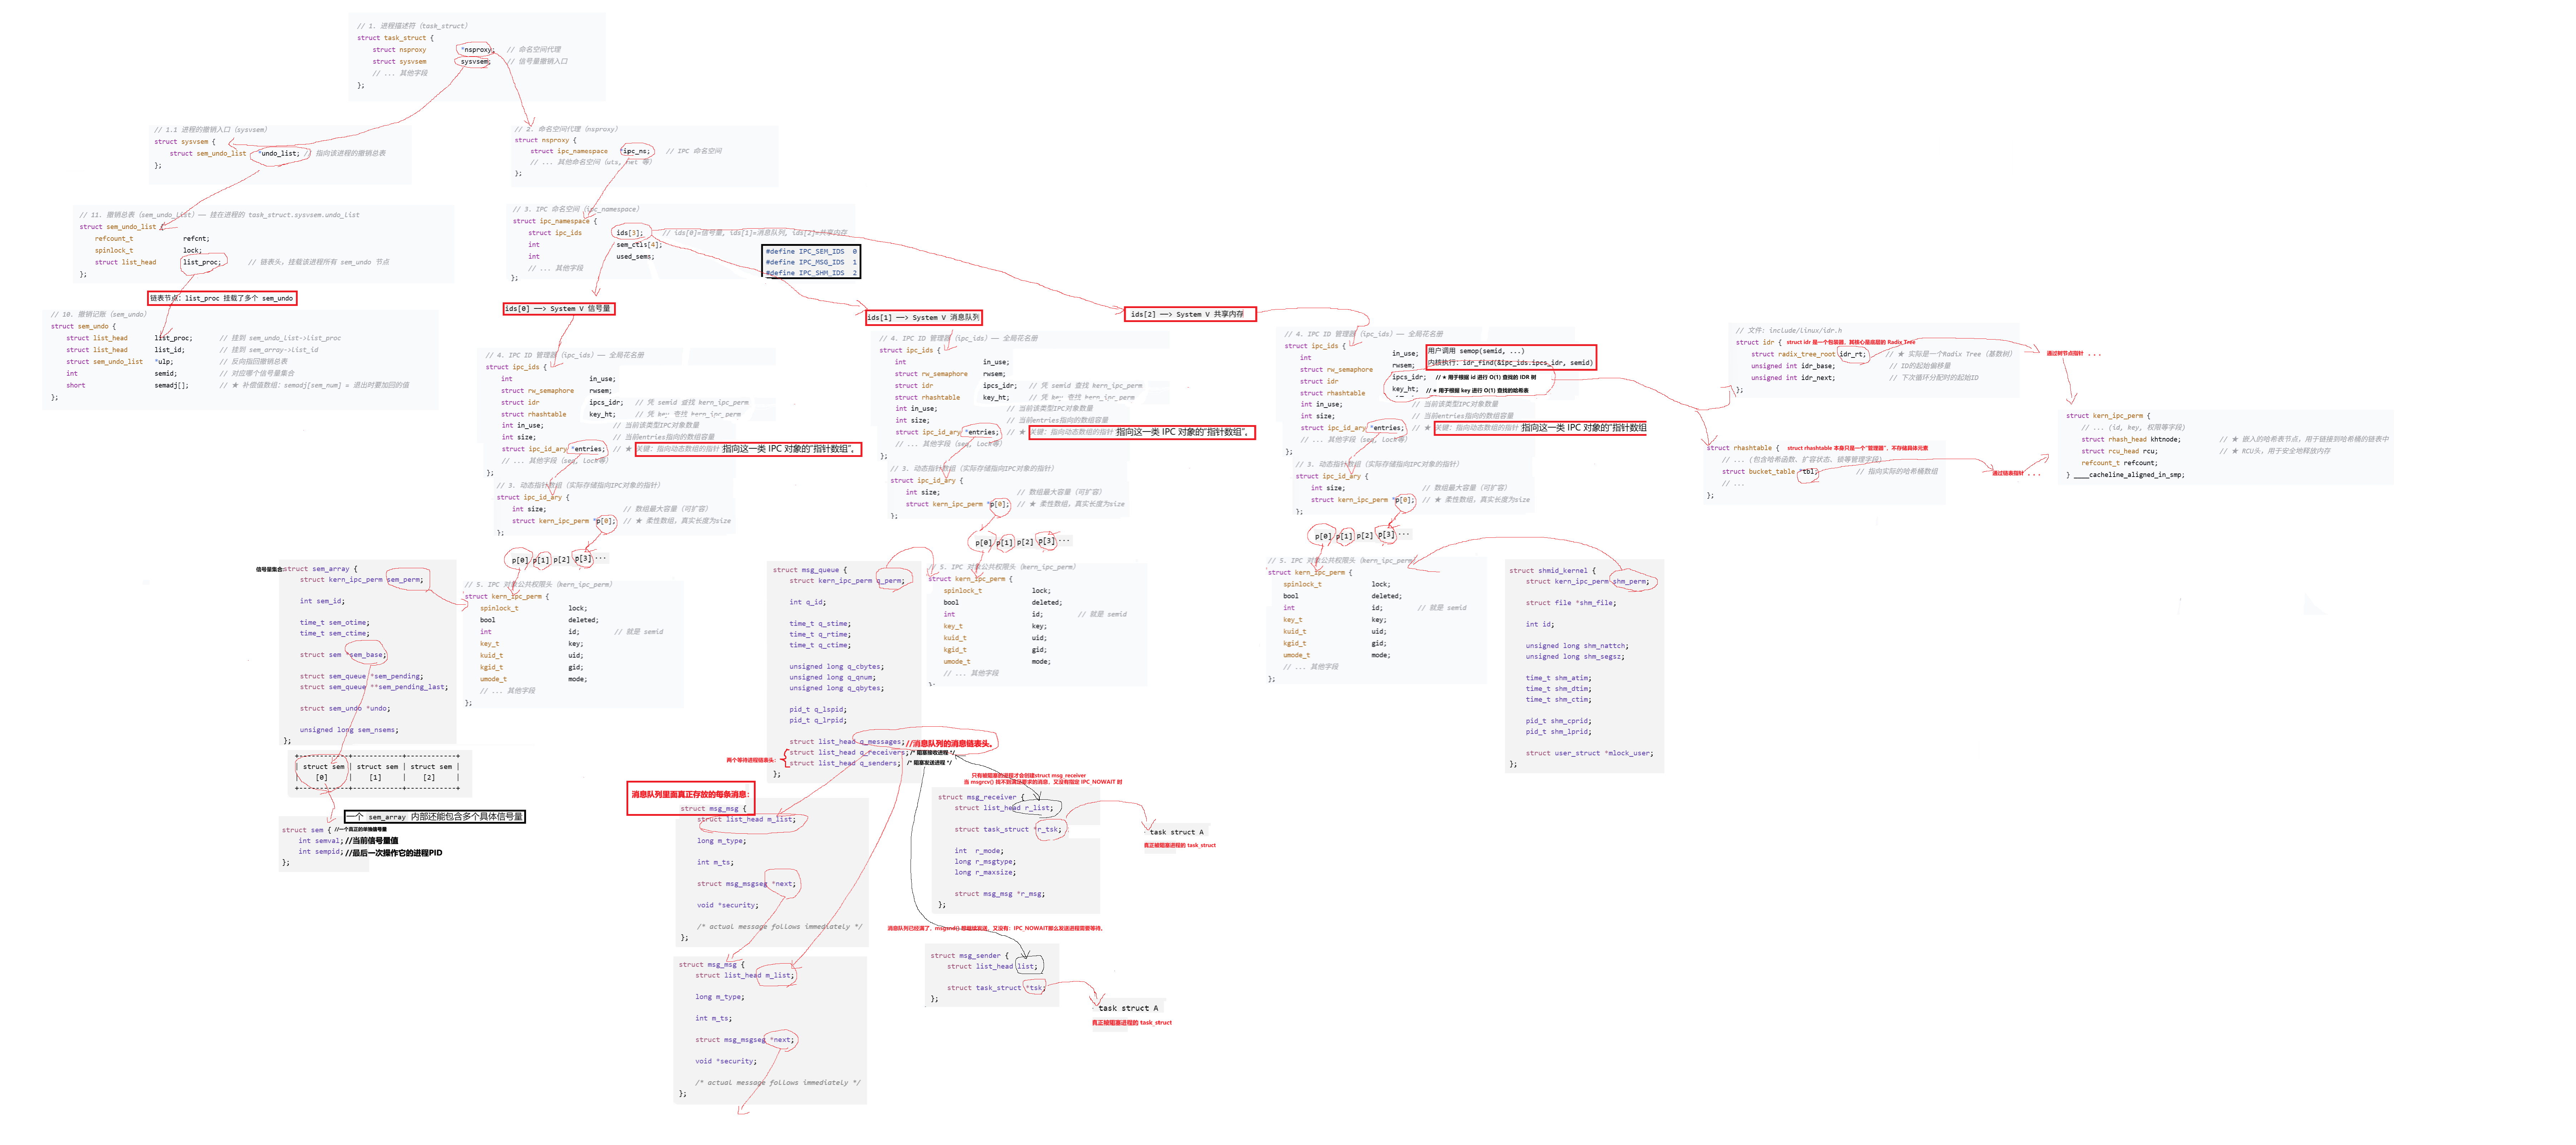
最后一句话总括:
在
master内核中,信号量通过ipc_namespace → ids[0] → ipc_ids → idr被定位为sem_array;semid映射到集合,sem_num映射到struct sem。等待队列采用集合级与单信号量级并存的双轨制,既保证复合操作的原子性,又优化单操作的唤醒性能;SEM_UNDO通过task_struct挂载的sem_undo_list记录semadj差值,实现进程退出时的自动补偿。
补充:“建造者模式”
工厂模式:
把“对象的创建过程”封装起来,使用者只需要告诉工厂自己想要什么对象,而不需要关心这个对象具体怎么new、选择哪个具体类。它主要解决的是创建哪一种对象的问题,例如根据参数创建汽车、卡车或摩托车,让客户端依赖抽象接口而不是具体实现。
建造者模式:
把一个复杂对象的创建过程拆成多个步骤,由建造者按步骤逐步组装,最后得到完整对象。它主要解决的是一个复杂对象怎么一步一步创建的问题,特别适合构造参数很多、组合方式很多的对象,例如创建电脑时分别设置 CPU、内存、硬盘、显卡等,最终再build()出完整电脑。
在后面我们要把 Linux 原生的 C 语言信号量接口改写成 C++ 对象。在这之前,我们必须先补上一条设计模式的干货——建造者模式(Builder Pattern)。
听起来很高大上,但它在生活里天天都在发生。为了好懂,我们直接用“去店里点奶茶”来彻底看清它的到底是个什么底盘逻辑。
1. 为什么需要它?传统方法的“大崩盘”
假设我们要写一个“奶茶”的类。一杯奶茶有很多参数:杯型(大杯/中杯)、甜度(全糖/半糖)、加料(珍珠/椰果)。
如果用传统的做法,把参数全塞进构造函数里,代码长成这样:
// ❌ 传统的糟糕写法
MilkTea my_tea = MilkTea("大杯", "半糖", "珍珠", "少冰", "多奶", "打包");
这会带来两个严重的工程灾难:
- 参数大爆炸:这一长串字符串,谁能记得清哪个位置该填什么?只要不小心把“大杯”和“半糖”的位置写反了,编译器根本不报错,结果做出来一杯奇葩奶茶。
- 不能分步选择:有时候读者点奶茶,想先选个杯型,中间想一想,最后才决定加不加珍珠。传统的构造函数逼着你必须“一句话把所有参数死死写完”,根本没有喘息和分步挑选的自由。
为了解决这个痛点,建造者模式诞生了。它的核心思想很简单:把“配置参数的过程”和“最终做出来的动作”彻底分家!
2. 极简代码实现:帮人点奶茶的服务员
工厂模式:就像是肯德基的点餐台,你丢过去一个“A套餐”的暗号,它直接丢给你一个做好的成品,你不需要参与定制。
建造者模式 :则是一个贴身的服务员,它拿着小本子(建造者),陪着你一步一步地勾选你的个性化配置,最后才把图纸送进厨房。
我们用最纯粹、最简单的 C++ 代码来实现这个点奶茶的过程:
#include <iostream>
#include <string>

// 1. 最终的目标产品:一杯实实在在的奶茶
class MilkTea {
public:
    std::string size;      // 杯型
    std::string sweet;     // 甜度
    std::string topping;   // 加料

    void Show() {
        std::cout << "您的奶茶好了:" << size << " + " << sweet << " + 加" << topping << std::endl;
    }
};

// 2. 建造者:拿着本子记录你需求的服务员
class MilkTeaBuilder {
private:
    MilkTea _tea; // 服务员手里先拿着一杯“空的、待组装”的奶茶对象
public:
    // 关键点:每个配置函数,最后都返回“*this”(也就是返回服务员自己)
    MilkTeaBuilder& SetSize(std::string s) {
        _tea.size = s;    // 记下杯型
        return *this;     // 把自己传回去,这样后面就能接着调用别的函数
    }

    MilkTeaBuilder& SetSweet(std::string s) {
        _tea.sweet = s;   // 记下甜度
        return *this;     // 接着把自己传回去
    }

    MilkTeaBuilder& SetTopping(std::string t) {
        _tea.topping = t; // 记下加料
        return *this;     // 接着把自己传回去
    }

    // 终极总闸:参数全部勾选完毕,厨房正式开工做奶茶!
    MilkTea Build() {
        return _tea;      // 把做好的奶茶交货给顾客
    }
};

int main() {
    // 3. 读者(应用层)开始优雅地下单
    MilkTeaBuilder waiter;

    // 像下楼梯一样,连着写。这就是传说中的“链式调用”
    MilkTea my_tea = waiter.SetSize("大杯")
                           .SetSweet("半糖")
                           .SetTopping("珍珠")
                           .Build(); // 最后一炮,交货!

    my_tea.Show();
    return 0;
}
3. 总结它的核心物理优势
看完上面这段代码,广大读者就能瞬间明白,为什么我们要费尽心机去写这个服务员(Builder)类:
- 自解释的填空题:通过
.SetSize("大杯")这种长相,代码自己就告诉了所有人这一步是在配杯型,彻底消灭了死记硬背参数顺序的痛苦。 - 流程的安全大闸:如果读者在下单时漏掉了核心参数,服务员可以在最后的
.Build()函数里执行拦截检查(防呆设计),参数不齐直接拒绝去内核圈地,保障了底层安全。
在下一节我们要重构系统信号量时,创建和获取它的流程非常割裂(全新创建时需要强行写入初始值,而单纯获取别人建好的锁时,绝对严禁二次写入)。这种复杂的流程判断,如果用传统的构造函数写,代码会瞬间炸裂。只有用建造者模式,把参数暂存起来,最后在 Build 的总闸口里统一做逻辑分流,才是工业界最干净、最稳健的解耦打法。
补充: System V 信号量完整使用指南:从创建到删除
第一阶段:创建或获取 —— semget()
#include <sys/sem.h>

int semget(key_t key, int nsems, int semflg);
行为矩阵(四种典型用法)
| 调用方式 | 不存在时 | 已存在时 |
|---|---|---|
semget(key, nsems, IPC_CREAT | 0666) | ✅ 创建新集合 | ✅ 返回已有集合(忽略 nsems) |
semget(key, nsems, IPC_CREAT | IPC_EXCL | 0666) | ✅ 创建新集合 | ❌ 失败,errno=EEXIST |
semget(key, 0, 0666) | ❌ 失败,errno=ENOENT | ✅ 返回已有集合 |
semget(IPC_PRIVATE, nsems, 0666) | ✅ 每次都创建新集合(key 无意义) | — |
关键注意事项
nsems:集合中信号量的个数。创建时指定,后续不可更改。获取已存在集合时传0即可。- 权限位(
0666):与文件权限相同,受umask影响。 - 返回值:成功返回
semid(非负整数),失败返回-1。
第二阶段:初始化 —— semctl() 的 SETVAL / SETALL
struct sembuf 是系统给你的;union semun 在 Linux 中通常是你自己定义的。
semget 创建出来的信号量初始值是随机的(内核分配时未清零),必须显式初始化。
union semun {
    int              val;    // SETVAL 用
    struct semid_ds *buf;    // IPC_STAT/IPC_SET 用
    unsigned short  *array;  // GETALL/SETALL 用
};
初始化单个信号量
union semun arg;
arg.val = 1;  // 把 sem[0] 设为 1(二值信号量,相当于互斥锁)
semctl(semid, 0, SETVAL, arg);
初始化全部信号量
unsigned short vals[3] = {1, 2, 0};
union semun arg;
arg.array = vals;
semctl(semid, 0, SETALL, arg);
// 结果:sem[0]=1, sem[1]=2, sem[2]=0
⚠️ 常见坑
- 创建后忘记初始化,直接用
semop减操作会导致不可预期的值(可能为负,可能巨大)。 - 多进程场景下,必须确保初始化只执行一次(通常用
IPC_CREAT | IPC_EXCL创建者负责初始化,其他进程只获取)。
第三阶段:核心操作 —— semop()(P/V/等待零)
int semop(int semid, struct sembuf *sops, size_t nsops);

struct sembuf {
    unsigned short sem_num;  // 集合中的索引
    short          sem_op;   // 操作值
    short          sem_flg;  // 0 / IPC_NOWAIT / SEM_UNDO
};
1. sem_op > 0 —— 释放资源(V 操作)
struct sembuf op = {0, +1, 0};
semop(semid, &op, 1);
// 等价于:sem[0] += 1
- 从不阻塞。
- 通常用于释放锁或增加可用资源数量。
2. sem_op < 0 —— 申请资源(P 操作)
struct sembuf op = {0, -1, 0};
semop(semid, &op, 1);
// 等价于:sem[0] -= 1,但前提是 sem[0] >= 1
| 条件 | 行为 |
|---|---|
semval >= abs(sem_op) | 立即执行:semval += sem_op(即减去 abs) |
semval < abs(sem_op) | 默认阻塞等待,直到资源足够 |
阻塞时加 IPC_NOWAIT | 立即返回 -1,errno = EAGAIN |
3. sem_op == 0 —— 等待零
struct sembuf op = {0, 0, 0};
semop(semid, &op, 1);
| 条件 | 行为 |
|---|---|
semval == 0 | 立即返回 |
semval != 0 | 阻塞,直到信号量值被其他进程减为 0 |
阻塞时加 IPC_NOWAIT | 立即返回 -1,errno = EAGAIN |
- 不改变
semval,只做条件等待。
第四阶段:原子复合操作 —— 一次 semop 多个 sembuf
struct sembuf ops[3] = {
    {0, -1, 0},   // sem[0] -= 1
    {1, +1, 0},   // sem[1] += 1
    {2,  0, 0}    // 等待 sem[2] == 0
};
semop(semid, ops, 3);
核心特性:全有或全无(原子性)
- 内核会一次性检查所有操作是否都能满足。
- 如果能全部满足 → 全部执行(值同时更新)。
- 如果任一条不满足 → 一条都不执行,整个进程阻塞(或
EAGAIN)。
典型场景:银行转账
从账户 A 扣 100(sem[0]-=100)
往账户 B 加 100(sem[1]+=100)
原子性保证不会出现"A 扣了但 B 没加上"的半成品状态。
第五阶段:SEM_UNDO —— 进程崩溃自动回滚
struct sembuf op = {0, -1, SEM_UNDO};
semop(semid, &op, 1);
行为
- 执行
sem[0] -= 1的同时,内核在进程的sem_undo中记录:“这个进程退出时需要给 sem[0] +1”。 - 进程无论是正常
exit()还是被kill -9强杀,内核都会在exit_sem()中自动执行补偿。
为什么需要它?
进程拿了锁 → 崩溃了
semval 没释放 → 永远为 0 → 其他进程全部饿死
SEM_UNDO 解决了这个问题,是 System V 信号量区别于 POSIX 无名信号量的重要特性。
flag 组合
IPC_NOWAIT | SEM_UNDO // 非阻塞 + 自动回滚
第六阶段:查询与修改 —— semctl() 的 GET/STAT/SET
查询当前值
int val = semctl(semid, 0, GETVAL);        // 查询 sem[0]
unsigned short vals[3];
union semun arg;
arg.array = vals;
semctl(semid, 0, GETALL, arg);             // 查询全部
查询元数据(权限、时间、数量等)
struct semid_ds ds;
union semun arg;
arg.buf = &ds;
semctl(semid, 0, IPC_STAT, arg);
修改权限
// 先读出来,改 mode,再写回去
semctl(semid, 0, IPC_STAT, arg);
ds.sem_perm.mode = 0644;
arg.buf = &ds;
semctl(semid, 0, IPC_SET, arg);
第七阶段:删除 —— IPC_RMID
semctl(semid, 0, IPC_RMID);
关键行为
- 删除的是整个集合,不是单个信号量。
- 如果有进程正在阻塞在该集合的
semop上:- 它们会被唤醒。
semop返回-1,errno = EIDRM(对象已被删除)。
- 已存在的
semid立即失效,后续任何操作都会返回-1(EINVAL)。
删除时机
- 一般是在所有进程都不再需要该信号量时,由最后一个进程调用删除。
- 如果不主动删除,信号量集合会一直存在于内核中(直到系统重启或
ipcrm手动清理)。
第八阶段:阻塞时的异常唤醒
进程在 semop 中阻塞时,可能被以下情况提前唤醒并返回错误:
| 场景 | 返回值 | errno | 说明 |
|---|---|---|---|
收到信号(如 SIGINT) | -1 | EINTR | 被信号中断,需要用户决定是否重试 |
| 信号量集合被其他进程删除 | -1 | EIDRM | 对象已消失,无法继续等待 |
超时(semtimedop 变体) | -1 | EAGAIN | 等待超时仍未满足 |
// 典型重试循环
while (semop(semid, &op, 1) == -1) {
    if (errno == EINTR) continue;  // 信号中断,重试
    if (errno == EIDRM) break;     // 集合被删,退出
    perror("semop failed");
    exit(1);
}
6. System V 信号量的C++面向对象封装
在原生的 Linux 系统编程里,System V 版本的信号量接口用起来比较繁琐。为了建一个信号量,得自己准备 key、调用 semget 创建/获取,必要时再用 semctl 初始化,最后通过 semop 做 P/V 操作。如果忘记在合适的生命周期结束时执行 IPC_RMID,还可能留下常驻内核的 System V IPC 资源。
为了让代码好写又好管,我们用 C++ 的面向对象思路把这些底层操作包起来。核心就是两点:自动释放资源(RAII) 和 分步构建(建造者模式)。
6.1 整体设计思路
在重构开始前,我们必须先在宏观上理清架构的分工。如果把所有创建逻辑、参数检查以及日常的加锁解锁全部塞进一个类里,代码会乱成一团。因此,我们将功能拆给两个类,各司其职,让逻辑更清爽:
-
Semaphore(信号量操作类):- 宏观设计思路:它的核心职责是“只管用和删”。示例利用析构函数在“创建者对象”退出时调用
IPC_RMID。这适合演示 RAII 思想,但真实多进程工程必须先设计好共享 IPC 的所有权与生命周期,不能仅凭某个局部 C++ 对象析构就无条件删除仍被其他进程使用的信号量集。
- 宏观设计思路:它的核心职责是“只管用和删”。示例利用析构函数在“创建者对象”退出时调用
-
SemaphoreBuilder(信号量构建类):- 宏观设计思路:它的核心职责是——“只管建”。因为创建信号量需要经历“ ftok 算暗号
→
\rightarrow
→ semget 圈地
→
\rightarrow
→ semctl 焊装初始值”等多步级联,参数极其臃肿。我们采用建造者模式,把它做成一个贴身的服务员。上层业务像流水线一样在它这里配置参数(比如
.SetVal(1)),配齐之后,它在最终的总闸口里完成安全的内核交互,吐出一个能直接使用的Semaphore对象。
- 宏观设计思路:它的核心职责是——“只管建”。因为创建信号量需要经历“ ftok 算暗号
→
\rightarrow
→ semget 圈地
→
\rightarrow
→ semctl 焊装初始值”等多步级联,参数极其臃肿。我们采用建造者模式,把它做成一个贴身的服务员。上层业务像流水线一样在它这里配置参数(比如
当我们把信号量的初始值设为 1 时,它可以在多个进程之间充当一把二元互斥门禁,保证同一时间只有一个成功 P 的执行流进入对应临界区;它在行为上类似互斥锁,但 System V 信号量与 pthread_mutex 的所有权、健壮性等语义并不完全相同。
6.2 概念演练:建造者模式的基础代码实现
为了让广大读者不被后文复杂的内核接口干扰,我们首先在用户态实现一个最纯粹、最极简的建造者模式。这个设计的基础逻辑是:利用一个中间构建类,把参数暂存起来,通过返回自身引用(return *this;)实现链式调用,最后调用 Build 函数统一开工交货。
6.3 原生源代码封装(Sem.hpp)
1. 宏观设计思路
了解了建造者的打法后,我们正式将其对接进 Linux System V 信号量接口。在 Sem.hpp 中,P/V 操作的原子语义来自 semop 本身;SEM_UNDO 的作用是记录退出补偿,而不是让 P/V “变得原子”。析构函数再通过 _flag 判断当前对象是否按示例约定负责执行 IPC_RMID。
而 SemaphoreBuilder 类则接管了所有的内核级初始化泥潭,在 .Build() 函数内部,根据传入的是 BUILD_SEM(全新创建)还是 GET_SEM(单纯获取),动态决定要不要在底层塞入 union semun 联合体去强行初始化计数器,完美解决了流程割裂的问题。
2. 全注释组件源码
#pragma once // 确保整个头文件在编译期间只被包含一次的内核指令

#include <iostream> // 引入标准输入输出流以支持错误打印
#include <string> // 引入标准字符串类以支持路径整备
#include <memory> // 引入智能指针头文件以实现对象自动化管理
#include <sys/types.h> // 引入系统原生标准类型账本定义
#include <sys/ipc.h> // 引入System V IPC通用权限母模头文件
#include <sys/sem.h> // 引入系统信号量专属底层操作接口
#include <unistd.h> // 引入标准内核系统调用闸门接口

const std::string pathname = "/tmp"; // 全系统无关进程达成共识的唯一路径寻址暗号
int proj_id = 0x77; // 用来给 ftok 算法熔炼密钥的项目副标识 ID

#define GET_SEM IPC_CREAT // 宏定义:单纯检索或获取现有信号量通道的位图掩码
#define BUILD_SEM (IPC_CREAT | IPC_EXCL | 0666) // 宏定义:排他性全新创生的位图控制大闸,附带0666开放权限

class Semaphore // 声明信号量操作类(只管 P/V 和自动销毁)
{ // 类作用域左大括号
public: // 开放外部控制流接口
    Semaphore(int semid, int flag) : _semid(semid), _flag(flag) // 构造函数:初始化绑定内核ID与创建者身份
    { // 构造函数作用域左大括号
    } // 构造函数作用域右大括号

    void P() // 声明原子 P 操作(申请资源,相当于加锁门禁)
    { // 函数作用域左大括号
        struct sembuf sb; // 在栈上开辟原生原子操作结构体
        sb.sem_num = 0; // 靶向定位:操作当前信号量集合中的第 0 个计数器
        sb.sem_op = -1; // 动作灵魂:-1 代表原子扣减,向内核发起资源预定申请
        sb.sem_flg = SEM_UNDO; // 终极保险:挂载自动释放撤销宏,防止进程暴毙引发全盘死锁

        int n = ::semop(_semid, &sb, 1); // 跨入内核态执行原子自减,若票数不够则控制流原地睡眠挂起
        (void)n; // 强转 void,物理级压制 Release 模式下变量未引用的编译器警告
    } // P操作结束

    void V() // 声明原子 V 操作(释放资源,相当于开门放行)
    { // 函数作用域左大括号
        struct sembuf sb; // 在栈上开辟原生原子操作结构体
        sb.sem_num = 0; // 靶向定位:操作当前信号量集合中的第 0 个计数器
        sb.sem_op = 1; // 动作灵魂:1 代表原子自增,物理归还控制锁匙
        sb.sem_flg = SEM_UNDO; // 保持控制状态机对称,同样挂载自动注销撤销宏

        int n = ::semop(_semid, &sb, 1); // 跨入内核态直接自增,并顺手一脚精准踢醒在门口挂起睡觉的兄弟进程
        (void)n; // 强转 void,物理级压制编译器警告
    } // V操作结束

    ~Semaphore() // 声明析构函数(人走茶凉,自动化垃圾资源清理的终极底牌)
    { // 析构函数左大括号
        if(_flag == GET_SEM) return; // 防御性退场:如果你只是二线使用者,根本没资格删,直接安全退出

        int n = ::semctl(_semid, 0, IPC_RMID); // 铁证如山:只有创生始作俑者,才有资格在退场时向内核下达 IPC_RMID 彻底解体资源的行政令
        (void)n; // 强转压制警告
        std::cout << "sem set destroy!" << std::endl; // 向控制台打印资源火化注销成功的调试日志
    } // 析构函数右大括号

private: // 锁定类内部私有资产
    int _semid; // 存储操作系统内核分发下来的绝对物理索引座位号
    int _flag; // 存储当前进程的身份控制标签(决定析构时到底是放行还是火化)
}; // 信号量操作类定义结束

using sem_sptr = std::shared_ptr<Semaphore>; // 利用别名机制,将操作类包装成高阶的智能指针包装盒

class SemaphoreBuilder // 声明建造者类(专门搞定冷启动初始化泥潭的服务员)
{ // 类作用域左大括号
public: // 开放装配车间接口
    SemaphoreBuilder() : _val(-1) // 构造函数:默认给初始值注入一个非法的负数作为防呆基准
    { // 构造函数左大括号
    } // 构造函数右大括号

    SemaphoreBuilder &SetVal(int val) // 声明定制初始值的函数,核心:返回当前建造者类自身的引用
    { // 函数作用域左大括号
        _val = val; // 将外部定制的资源总票数,暂存进建造者自己的临时账本中
        return *this; // 将升级了参数的自己原封不动传回去,开启链式调用
    } // 设置函数结束

    sem_sptr Build(int flag) // 声明最终点火交货的总闸函数,正式去内核圈地映射
    { // 函数作用域左大括号
        if (_val < 0) // 防呆安全检查:如果在创生前夜发现连最基本的初始票数都没给
        { // 条件触发左大括号
            std::cerr << "you must init first!" << std::endl; // 拒绝下线,向屏幕喷射警告日志
            return nullptr; // 拦截终止,返回空指针
        } // 检查块结束

        key_t k = ::ftok(pathname.c_str(), proj_id); // 第一步内核流控:运行 ftok 位移算法,熔炼出 32 位全局唯一 Key 暗号
        if (k < 0) exit(1); // 路径解析破裂则直接强行崩溃退出

        int semid = ::semget(k, 1, flag); // 第二步内核流控:拿着 Key 叩击内核大闸,圈定一个物理长度严格等于 1 的信号量集数组
        if (semid < 0) exit(2); // 创生撞坑或权限严重不足则崩溃止损

        if (BUILD_SEM == flag) // 第三步内核流控:只有当身份卡确认为全新的排他创生者时,才开启初始值焊装大闸
        { // 判定成立左大括号
            union semun // 工业级天规:由于内核高冷不提供现成的,必须在代码内部肉身手工手写这个多态联合体
            { // 联合体作用域左大括号
                int val; // 当执行 SETVAL 命令时,内核只认这个格子里的整型数字
                struct semid_ds *buf; // 备用回读底账结构体指针
                unsigned short *array; // 备用批量数组指针
                struct seminfo *__buf; // 备用内部缓存指针
            } un; // 联合体实例化声明结束

            un.val = _val; // 把我们在第一步暂存在本子上的那个初始数字(如1)狠狠地塞进联合体盒子里

            int n = ::semctl(semid, 0, SETVAL, un); // 跨入内核特权层,下达最高行政令 SETVAL,强行将第 0 个计数器的初始票数焊死改写
            if (n < 0) exit(3); // 焊装失败则崩溃
        } // 初始值灌入结束

        return std::make_shared<Semaphore>(semid, flag); // 终极完美闭环:将圈定好的座位号与身份信息打包,塞进智能指针,交货给上层业务
    } // Build函数结束

    ~SemaphoreBuilder() // 声明建造者析构函数
    { // 析构函数左大括号
    } // 析构函数右大括号

private: // 锁定内部资产
    int _val; // 用来暂存用户配置的初始资源数临时账本变量
}; // 建造者类定义结束
代码保持说明:上面的
Sem.hpp按你的要求没有改动其实现和注释。需要记住:semid实际是 System V IPC 标识符,不是“绝对物理索引”;另外SEM_UNDO提供的是退出补偿,semop本身才提供 P/V 的原子语义。该封装可以正常用于本文演示,但生产环境还应检查semop/semctl返回值并明确跨进程资源所有权。
6.4 验证多进程互斥(Writer.cc)
1. 宏观设计思路
打通了底层高内聚的对象大闸后,我们在上层驱动一个极具对抗性的多进程并发打印矩阵。
因为父子进程的 stdout 通常指向同一个终端,双方的输出顺序会受调度影响。这个示例故意把一次逻辑输出拆成两次 printf + fflush,并在中间 usleep,因此如果不加锁,两半输出非常容易被另一进程插入;这里比“单次 printf 必然被拆成字符”更适合作为互斥演示。
在这段测试驱动流中,父进程作为“创生者”拉起计数器并强行将其赋值焊装为 1(退化为二元互斥锁)。
随后,父子进程同时循环。在临界区前调用 .P(),初始值为 1 时只有一个进程能成功进入;另一个会在条件不满足时阻塞。持有许可的一方执行完两次输出后调用 .V() 归还许可,等待者随后有机会被唤醒并继续运行;System V 不保证严格按固定 FIFO 顺序把某个“下一个进程”精准交接出去。
2. 全注释验证源码
#include "Sem.hpp" // 引入我们刚才整备好的面向对象封装总线头文件
#include <cstdio> // 引入标准 C 标准输入输出库以支持原生的 printf 打印
#include <time.h> // 引入时间戳头文件以提供随机数种子
#include <unistd.h> // 引入 unistd 头文件以驱动 fork 派生子进程

int main() // 主控制流控制发起点
{ // main左大括号
    SemaphoreBuilder sb; // 在父进程上下文里率先实例化一个冷启动参数建造者对象

    auto fsem = sb.SetVal(1).Build(BUILD_SEM); // 黄金链式调用:定制初始值为 1,以排他创建者(BUILD_SEM)的至高特权在内核里砸出这把锁

    if (fork() == 0) // 调用系统的 fork() 强行克隆并割裂出一条平行的子进程控制流分支
    { // 子进程分支作用域左大括号
        auto csem = sb.Build(GET_SEM); // 二线子进程上线:直接通过建造者去内核检索获取(GET_SEM)刚才老爹建好的那把锁,绝不重复初始化
        int cnt = 10; // 设定子进程一线的密集肉搏大轮询次数为 10 次

        while (cnt--) // 跨入并发冲突死循环
        { // 循环左大括号
            csem->P(); // 💥 【临界区前夜上锁】:子进程尝试买票执行 P 操作。若老爹此时占着房,子进程当场卡在这一行蒙头睡觉

            printf("C"); // 💥 【踏入临界区】:开始对公共屏幕文件疯狂砍下第一刀,打印车头字符 'C'
            fflush(stdout); // 逼着标准输出流立刻冲刷(Flush),不准在用户态缓冲区有任何停留,马上显示在屏幕上
            usleep(rand() % 95270); // 故意人为制造冲突:在临界区内部睡眠微秒,故意给老爹的时间片留下横插一脚的踩踏后门
            printf("C "); // 继续对屏幕砍下第二刀,打印车尾字符 'C' 并留下空格
            fflush(stdout); // 强行冲刷屏幕

            csem->V(); // 👑 【撤离临界区解锁】:干完所有的活,安全无声调用 V 操作,把锁匙还回为 1,并精准踢醒门外死等的父进程
            usleep(rand() % 43990); // 在非临界区安稳过自己的日子,给对方充分的抢占机会
        } // 循环右大括号
        exit(0); // 子进程完成全部肉搏使命,在这一行优雅卸载死绝,绝对不让它返回跑外层主流
    } // 子进程作用域结束

    int cnt = 50; // 父进程作为主力控制流,在应用层高频发起 50 次攻击大轮询
    while (cnt--) // 跨入父进程并发大死循环
    { // 循环左大括号
        fsem->P(); // 💥 【临界区前夜上锁】:父进程强行在自己的控制流里砸下 P 操作。若儿子正在里面冲刷,老爹也得在门外老实蹲着

        printf("F"); // 💥 【踏入临界区】:老爹直插屏幕心脏,高声打印车头字符 'F'
        fflush(stdout); // 强行逼迫屏幕物理显示
        usleep(rand() % 95270); // 故意在临界区肚子里睡眠,将高并发条件下的时序对抗拉到最满
        printf("F "); // 打印车尾字符 'F' 并留出隔离空格
        fflush(stdout); // 强行冲刷屏幕

        fsem->V(); // 👑 【撤离临界区解锁】:完美的完成一次原子原子重合写,开门归还锁匙,下一道特赦令触发唤醒大闸
        usleep(rand() % 43990); // 退回非临界区超频飙车,互不干扰
    } // 循环右大括号

    return 0; // 主程序宣告完美阖幕
    // 💥 终极技术闭环:当控制流冲过上一行 return 0 的瞬间,父进程上下文被全面物理销毁。
    // 在销毁的前夜,父进程栈板上的 fsem 智能指针对象会自动触发析构函数!
    // 因为它的体内深刻流淌着 BUILD_SEM(创建者)的基因,析构函数会在倒下的最后一毫秒,自动代劳向内核发射 semctl(IPC_RMID)!
    // 整座积压在内核腹地中的信号量大阵被连根拔除、彻底火化,全盘实现了完美的、无需人工 rm 的高阶自治闭环!
} // main右大括号
共享资源不会发生父子进程同时进入临界区的根本原因,是信号量初值为 1,并且 semop() 对信号量的检查与修改是原子的。当一个进程执行 P 操作成功后,信号量由 1 原子减为 0;另一个进程再执行 P 操作时,由于当前条件无法满足,在没有设置 IPC_NOWAIT 的情况下会阻塞睡眠在 semop() 内部,P() 不会返回,因此 P 操作后面的临界区代码无法继续执行。直到持锁进程执行 V 操作释放资源后,等待进程才有机会被唤醒并完成自己的 P 操作。
补充: PV 操作是 OS 上的概念吗?
P/V 是经典的信号量同步理论概念,由 Dijkstra 提出,并不是“只有某一个操作系统才有资格拥有”的概念。 在 System V 信号量中,P/V 语义由内核系统调用实现;在其他环境中,也可以由线程库、运行时以及硬件原子操作配合实现。
P/V 之所以经常和操作系统联系在一起,是因为“原子修改共享状态 + 条件不满足时阻塞等待 + 条件满足时唤醒”通常需要底层同步原语和调度支持。对于本章的 System V 信号量,这些职责确实由 Linux 内核完成。
- 原子性并非只能靠 OS 才能做到:用户态也可以借助 CPU 原子指令和 C/C++ 原子类型实现某些无锁原子操作;不过 System V
semop的多进程共享状态、阻塞/唤醒和整组操作原子性由内核统一保证。 - System V 的阻塞/唤醒由内核调度:当
semop条件不满足且没有IPC_NOWAIT时,内核可以让调用进程进入睡眠等待;条件变化后再唤醒并重新检查。这是 System V 信号量区别于一个普通用户态整数的重要能力。
第七章: 内核是如何组织管理IPC资源的
在前面几章中,我们已经把 System V 共享内存、消息队列以及信号量这“三驾马车”的表面 API 和应用层封装梳理过了。现在进一步下沉内核时,需要把“用户态 _ds 控制结构”和“内核内部对象”严格区分,同时注意内部实现会随 Linux 版本变化。
本章我们将彻底撕开用户态的所有伪装,直插 Linux 内核最隐秘的腹地,看清这些 IPC 资源在黑盒内部究竟是以怎样复杂、多维的数据结构活着的。
源码版本说明:本章后面的内核结构主要按 Linux 2.6.11 / 2.6.18 来理解。“其他源码实现可能有差别”。因此,后面凡是
ipc_ids、ipc_id_ary、msg_queue、sem_array、shmid_kernel、VMA 链表/红黑树等字段,都要带着版本意识看:核心思想可以保留,但不能把旧版字段当成现代 Linux 永远不变的固定结构。
1. 用户级的“投影”与内核级的“本尊”:shmid_ds 与 shmid_kernel
在编写共享内存的资产审计代码时,我们只要写下 shmctl(shmid, IPC_STAT, &ds);,就能从一个名叫 struct shmid_ds 的结构体里读出当前通道的权限、大小和挂接人数。这就给很多初学者带来了一个极其致命的技术错觉,误以为内核在物理内存里也就是用这个结构体来记录一切的。
今天我们就打破这个幻觉,给出底层的第一个核心结论:应用层看到的 struct shmid_ds 是 System V 提供给用户态的共享内存状态/控制结构,可用于 IPC_STAT 获取状态,也可在权限允许时配合 IPC_SET 设置部分属性;它不是内核内部完整的共享内存对象。
1.1 为什么必须要搞两套完全不同的结构体?
操作系统之所以玩这一手“买家秀与卖家秀”的割裂设计,背后承载着严格的进程隔离安全性与职责分离哲学。
在应用层,你的进程只需要知道一些最基础的宏观数字:这块共享内存多大面积(shm_segsz)、当前有几个人手里拉着挂接线(shm_nattch)。这些冰冷的控制数字,放在 struct shmid_ds 里展现给你看,完全是安全的。
但对于内核本尊来说,要管好这块资产,它必须直接和生猛的裸硬件打交道。它在幕后必须记录:
- 底层虚拟内存/页管理:共享内存最终要由 Linux 的 shmem/虚拟内存子系统管理实际页、换入换出、页表映射等状态;
- 底层 shmem 文件对象:Linux 的 System V 共享内存会复用 shmem/tmpfs 与虚拟内存基础设施,内核对象会关联相应的
struct file等内部结构,从而把共享内存页接入统一 VM 管理。
这些内核指针和管理状态只存在于内核地址空间,用户态通过系统调用只能获取内核选择暴露的属性。这样既维持了稳定的用户 ABI,也避免用户进程直接拿到可任意改写的内核指针
1.2 大白话类比:手机银行 App 余额 vs 银行中央金库
为了帮广大读者彻底砸碎认知的铁幕,我们可以把这两者的关系做个极其朴素的生活类比:
struct shmid_ds(用户级截图):就像是你在手机银行 App 上查到的那个“账户余额数字”。它只是一串安全、合法的展示文本。你可以在手机上读取它,但你绝对没办法顺着手机屏幕去修改银行后台的转账代码。struct shmid_kernel(内核级本尊):则是银行总部大楼地底下的“钢筋混凝土物理金库、武装防弹运钞车以及监控调度网格”。这才是资产在物理世界里活着的真实庞大躯壳。
1.3 跨空间投递:属性从本尊到投影的拷贝机制
既然本尊深藏在 Ring 0 特权层的深宫之中,那我们在应用层调用 IPC_STAT 时,拿到的 shmid_ds 属性到底是怎么来的?
这在底层遵循“从内核内部对象整理出用户可见状态,再安全复制到用户缓冲区”的路线。
// 内核态底层的真实控制本尊
struct shmid_kernel {
    struct shmid_ds     shm_ds;      // 👑 嵌套在最前端的、专门准备抄给用户的“小账本”
    struct file         *shm_file;   // 💥 隐藏的内核匿名文件指针(绝对禁止用户窥探)
    struct page         **shm_pages; // 💥 挂接的物理内存页框指针数组(最高硬件机密)
    // ... 其余内核级自旋锁与生存期元数据 ...
};
当你在应用层写下这一行代码:
shmctl(shmid, IPC_STAT, &user_ds); // 传入用户态的缓冲区地址
控制流通过系统调用进入内核态,操作系统在幕后大致完成以下步骤:
- 定位并校验对象:内核根据
shmid这个 IPC 标识符,在共享内存对应的 IPC 管理集合中解码/查找对象,并校验序列号、权限和对象状态。具体索引公式与数据结构随内核版本变化。 - 整理用户可见属性:看到
IPC_STAT后,内核从内部共享内存对象中提取大小、挂接数、权限、时间戳等允许暴露的属性,组织成用户 ABI 所要求的struct shmid_ds形式。 - 安全复制到用户空间:内核通过安全的用户空间复制机制,把这些属性写入用户传入的
user_ds缓冲区;用户态不能因此直接访问shm_file等内核私有指针。
系统调用返回后,用户程序拿到的是 shmid_ds 这份用户可见状态;内核内部的 shm_file、权限对象以及 VM 管理状态仍然由内核自己持有。
整个IPC命名空间只有一个struct ipc_namespace,和一个他的成员struct ipc_ids ids[3](os一般就是一个struct ipc_namespace)所有进程所产生3类systemVIPC分类,同一类IPC全部依靠自己的成员struct kern_ipc_perm 挂靠在这个数组对应的一个元素struct ipc_ids的struct ipc_id_ary *entries成员指向的struct ipc_id_ary的成员struct kern_ipc_perm *p[]柔性数组里面
2. 纵向套娃与柔性数组链条:系统调用返回值是如何精准直插内核的?
在理清用户态“投影”与内核态“本尊”的关系后,还要回答两个问题:三类 IPC 为什么不会彼此混淆?内核返回的 shmid / msqid / semid 又是怎样帮助内核定位并校验具体对象的?
2.1 源码级拓扑大总揽:内核结构体物理连接图
为了看清这套架构,可以参考Linux 2.6.11/2.6.18 的 struct ipc_ids、struct ipc_id_ary、kern_ipc_perm 等结构。它们属于旧内核版本实现,后续内核的数据结构已经演进,因此下面“柔性数组/取模”的细节只应按对应版本理解,不能当成所有现代 Linux 的固定实现。
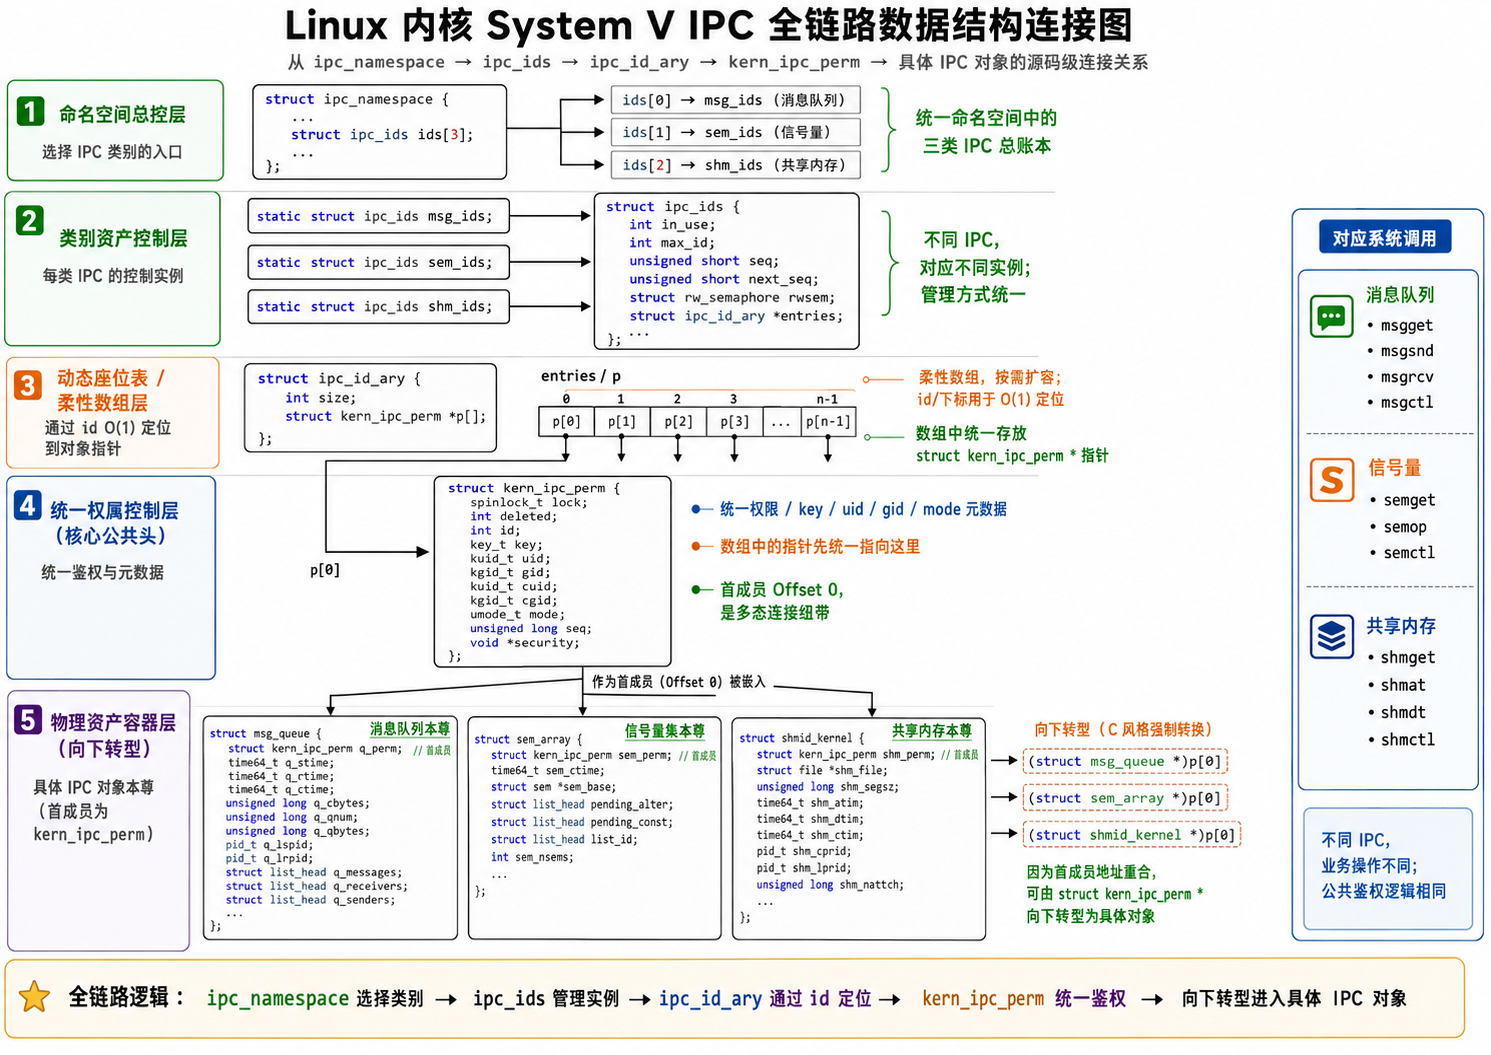
2.2 深度解密一:你怎么知道其中一个具体是什么 IPC?
观察上面的全景连接图,三个门类的 IPC 资产在底层都变成了 struct kern_ipc_perm * 指针,且都排在各自的柔性数组里。这时候必然会产生疑问:内核把它们扯成一样长,自己难道不会搞混吗?
真相:内核根本不需要在结构体里贴标签,因为 “系统调用的路由入口(Syscall Routing)”早在用户态就已经完成物理分流了!
1. 独立的三套办公室(ids[3])
正如全景图所示,内核大总管 struct ipc_namespace 内部并排定义了三个独立的 struct ipc_ids 对象:
ids[IPC_MSG_IDS]:管理消息队列。ids[IPC_SEM_IDS]:管理信号量集。ids[IPC_SHM_IDS]:管理共享内存。
2. 进错大门概不接待
你在上层写代码时,绝对写不出一个叫 ipc_attach() 的通用函数,你必须调用 shmat()(共享内存挂接)或者 msgrcv()(消息队列接收)。
- 当你调用
shmat()时,系统调用进入共享内存子系统,内核只会在共享内存对应的ids[IPC_SHM_IDS]管理集合中查找shmid,不会跑去消息队列集合里找。 - 即使消息队列
ids[IPC_MSG_IDS]中存在数值上类似的 ID/key,也属于另一类 IPC 管理空间,不会被shmat()当成共享内存对象。
这就好比去医院看病,你挂了“眼科”的号(调用了 shmat),医生带你进的必然是眼科大楼(ids[2])。这时候医生从第 1 号诊室里拉出来一个病人,即使这个病人用单子盖着头(伪多态指针),医生也百分之百确定:这货绝对是个眼科病人(shmid_kernel),直接闭眼进行向下转型,绝不可能把他错认成胃病患者。
2.3 深度解密二:IPC ID 怎样编码/定位旧版 ipc_ids 中的对象?
我们在应用层调用 shmget 或 msgget 成功后,会拿到一个叫 shmid 或 msqid 的整型返回值。在后续的代码里,我们拿着这个返回值去调 PV 操作或映射共享区。
底层理解:
shmid/msqid/semid是 IPC 标识符。以 经典 Linux 2.6.x 实现为例,ID 会把“槽位索引”和“序列号”组合起来,从而既能定位对象,又能降低旧 ID 在槽位复用后误命中的风险;现代内核实现细节可能不同。
1. 内核创生时的“复合编码”
在经典旧实现里,可以把创建过程理解为:内核先为对象分配一个内部槽位/索引,再把索引与序列号组合成最终 IPC ID。它不会简单把裸索引原样当作对外 ID 返回。
返回值 ID = Index + ( Seq × IPCMNI ) \text{返回值 ID} = \text{Index} + (\text{Seq} \times \text{IPCMNI}) 返回值 ID=Index+(Seq×IPCMNI)
Index:当前的柔性数组实际下标(当前是0)。Seq:这个座位被翻转复用的版本号(假设当前是1)。IPCMNI:经典旧实现中用于 IPC ID 编码/索引范围的常量;很多旧资料会看到32768这个值。它不是应该跨所有内核版本死记的固定“硬件容量”。- 最终熔炼结果:内核算出一把复合钥匙 ID = 0 + 1 × 32768 = 32768 \text{ID} = 0 + 1 \times 32768 = 32768 ID=0+1×32768=32768,发给上层应用。
版本限定:上面的
ID = Index + Seq × IPCMNI可用来理解经典旧内核的 ID 编码思路;实际 Linux 版本中的 ID 管理方式、最大数量以及内部容器会演进,所以不要把32768和“取模直插”当成现代 Linux 永远固定的 ABI。
2. 办事回传时的“光速取模解包”
当用户把 shmid 回传给内核时,旧版实现可以通过 ID 解码得到索引部分并校验序列号;现代内核则以对应版本的 ID 管理结构完成同样的“定位 + 防旧 ID 误用”目标。
柔性数组下标 Index = shmid ( m o d 32768 ) \text{柔性数组下标 Index} = \text{shmid} \pmod{32768} 柔性数组下标 Index=shmid(mod32768)
内核一算: 32768 ( m o d 32768 ) = 0 32768 \pmod{32768} = 0 32768(mod32768)=0。
终极闭环结论:
对经典旧版实现来说,IPC ID 中确实包含/映射到内部索引信息,因此内核能够由 ID 找回对应槽位;但还必须结合序列号/对象状态进行校验,不能把 ID 直接当裸数组下标使用。
这也是为什么xxget返回的是一个“标识符”而不是用户态指针:用户只保存 ID,具体怎样从 ID 定位到ipc_ids内对象完全由内核版本实现负责。
3. 终极下沉:三大 IPC 容器源码拆解与物理空间的降维合流
在看清了全链路的级联拓扑后,我们要把放大镜对准 Linux 内核的源码腹地,看清每一个结构体格子里到底装了什么核心资产。
3.1 消息队列内核本尊:struct msg_queue 链表总线控制枢纽
在Linux 2.6.x 内核中,消息队列的内核对象可以看到 struct msg_queue。它维护队列权限/状态、消息链表以及收发等待相关结构。
1. 完整内核源码结构体解剖
struct msg_queue {
    struct kern_ipc_perm q_perm;          // 👑 伪多态纽带:必须严格占领结构体最前端(Offset 0)
    time_t               q_stime;         // 最后一次发送消息(msgsnd)的时间戳
    time_t               q_rtime;         // 最后一次接收消息(msgrcv)的时间戳
    time_t               q_ctime;         // 最后一次改写本控制块属性(msgctl)的时间戳
    unsigned long        q_cbytes;        // 当前队列中已经积压的纯业务资产总字节数
    msgqnum_t            q_qnum;          // 当前队列中挂着排队的数据包(消息实体)总个数
    msgqnum_t            q_qbytes;        // 该队列被系统允许容纳的最大容量大闸(控制红线)
    pid_t                q_lspid;         // 最后一次引发写入(msgsnd)的执行流 PID
    pid_t                q_lrpid;         // 最后一次引发读取(msgrcv)的执行流 PID
    struct list_head     q_messages;      // 💥 数据传送带:串联所有真实消息数据块的双向链表头
    struct list_head     q_receivers;     // 💥 消费者挂起铁链:等待读取的阻塞进程队列
    struct list_head     q_senders;       // 💥 生产者挂起铁链:等待写入的阻塞进程队列
};
2. 核心源码字段大白话解密
- 终极控制总线(三大排队铁链):在这个仓库的最底部,并排躺着三个系统级专属的双向链表头。
q_messages用来挂载真实的数据块;q_receivers则是消费者的睡眠基地——当队列空了,一线的接收进程(如msgrcv)会全部安全地扣在q_receivers铁链上睡觉;一旦队列满了,写进程则被操作系统统一扣留、塞进q_senders铁链里挂起等空位。
3.2 信号量集内核本尊:struct sem_array 排他性控制矩阵
信号量集合在内核里由集合级对象统领,并关联多个单体信号量状态。它不负责传输业务数据,主要用于表达资源计数、互斥/同步条件以及等待中的原子操作。
1. 完整内核源码结构体解剖
struct sem_array {
    struct kern_ipc_perm sem_perm;        // 👑 伪多态纽带:必须严格占领结构体最前端(Offset 0)
    time_t               sem_otime;       // 最后一次执行原子 P/V 操作(semop)的时间戳
    time_t               sem_ctime;       // 最后一次改写本控制块属性(semctl)的时间戳
    struct sem           *sem_base;       // 💥 数组指针:死死指向单体原子计数器数组实体的物理内存首地址
    struct list_head     sem_pending;     // 💥 阻塞等待队列:挂起在当前信号量集上的进程链表
    struct list_head     **sem_pending_last; // 指向等待队列尾部的二级指针,用以实现快速追加
    struct sem_undo      *undo;           // 当前信号量集合死死绑定的物理动态补偿账本
    unsigned short       sem_nsems;       // 变长数组边界:当前集合内部包含的计数器物理总个数
};
2. 核心源码字段大白话解密
- 单体信号量(
sem_base/sem_nsems):按 2.6.x 结构,sem_nsems记录集合中的信号量个数,sem_base指向struct sem数组;单体sem保存semval、sempid等状态。等待中的操作在 旧版结构里主要由集合级sem_pending/sem_queue等结构组织,不应固定说成每个struct sem都有自己的排队链表。 SEM_UNDO补偿状态:内核维护与进程/信号量相关的 undo 调整记录,使进程退出时可以按 semadj 做补偿。它能处理一部分异常退出造成的计数不平衡,但不是“所有死锁都能完美根除”的万能机制。
3.3 共享内存内核本尊:struct shmid_kernel 物理资产控盘总账
在 所示 Linux 2.6.x 中,共享内存内核对象可以看到 struct shmid_kernel。它通过 shm_file 等字段接入 Linux 的 shmem/虚拟内存基础设施,最终把同一组共享页映射进不同进程;它并不是“彻底绕开 VFS/文件与 VM 层,直接裸物理页框对接进程”这么简单。
1. 完整内核源码结构体解剖
struct shmid_kernel {
    struct kern_ipc_perm shm_perm;        // 👑 伪多态纽带:必须严格占领结构体最前端(Offset 0)
    struct file          *shm_file;       // 核心桥梁:指向内核在伪文件系统中为其开辟的匿名文件指针
    int                  id;              // 该共享内存在全局表里的唯一物理座位号
    unsigned long        shm_nattch;      // 👑 物理生命线:当前正连线挂接该物理页框的进程总个数
    unsigned long        shm_segsz;       // 用户申请的真实业务字节大小
    time_t               shm_atim;        // 最后一次关联挂接(shmat)的时间戳
    time_t               shm_dtim;        // 最后一次去关联卸载(shmdt)的时间戳
    time_t               shm_ctim;        // 最后一次修改控制块属性(shmctl)的时间戳
    pid_t                shm_cpid;        // 始作俑者:创生该共享内存的进程 PID
    pid_t                shm_lpid;        // 最后一次执行挂接或卸载操作的进程 PID
    struct user_struct   *mlock_user;     // 锁定内存特权:记录当前锁定该物理页、不准其落盘的权属用户
};
2. 核心源码字段大白话解密
- 引用计数生命线(
shm_nattch):它记录当前挂接数量,是共享内存延迟删除判断中的重要条件。典型 System V 语义是:IPC_RMID先把段标记为删除,当最后一个挂接者脱离后实际资源才能最终回收;所以需要同时看“已标记删除 + 挂接数归零”等状态,而不是只看一个数字。 - 共享页的连接桥梁(
shm_file):它让共享内存对象接入 Linux 的 shmem/VM 管理;“零拷贝”的核心效果是多个进程最终映射到同一组物理页,而不是每次传数据都在内核/用户缓冲区之间复制。
补充:C语言如何硬核实现“面向对象与多态”?
前言:进程间通信里的“灵魂拷问”
在分析 Linux 内核 System V IPC(消息队列、信号量、共享内存)时,我们会发现一个奇特的现象:
内核使用同一个函数(如 ipc_obtain_object)和同一个指针类型(struct kern_ipc_perm *)去操作三种完全不同的物理资源。
这不禁让人产生一个疑问:C语言不是面向过程的吗?它凭什么能用一套代码逻辑,分别驱动三种不同的数据结构?
答案就藏在 C 语言最底层的“内存布局”暴力破解法里。
第一部分:思想破冰——面向对象在 C 语言里的“降维打击”
1.1 面向对象到底在“封装”什么?
在 C++/Java 中,类(Class)的本质是:
属性(数据) + 方法(操作数据的函数)
C 语言的结构体(struct)只能存数据,存不了函数。为了在 C 里造出“类”的效果,Linux 内核用了两招“土办法”:
| 面向对象特性 | C 语言的物理实现手段 | 大白话解释 |
|---|---|---|
| 继承(属性复用) | 结构体嵌套(且必须是第一个成员) | 把父类结构体变量,死死焊在子类结构体的最开头(Offset 0)。 |
| 多态(动态调用) | 函数指针(Function Pointer) | 结构体里不写函数体,只存一个函数入口地址(指针)。不同的对象塞进不同的函数地址,调用时就会执行不同的代码。 |
第二部分:技术落地——Offset 0 的“绝对物理特权”
2.1 什么是“首地址绝对重合”?
在 C 语言的内存模型中,如果一个结构体 B 将结构体 A 作为自己的第一个成员变量,那么:
- 变量
b的起始内存地址 和b.a的起始内存地址,在数值上是 100% 相等的(偏移量为 0)。
这就是整个多态机制的物理基石。
2.2 内核中的“父类”与“子类”
- 父类(公共头):
struct kern_ipc_perm,包含权限、ID、Key 等通用元数据。 - 子类(具体资产):
struct msg_queue(消息队列)、struct shmid_kernel(共享内存)。
物理强制规定:所有子类结构体的花括号第一个字段,必须是 struct kern_ipc_perm。
// 子类定义(截取核心部分)
struct msg_queue {
    struct kern_ipc_perm q_perm;   // 必须是第一个!!!
    unsigned long q_cbytes;        // 自己特有的属性
    // ...
};
2.3 多态的操作逻辑
- 存的时候:无论你是什么具体类型,内核一律把你的首地址(即公共头的地址)强转为
struct kern_ipc_perm *,存入数组。 - 取的时候:内核从数组取出这个公共头指针。
- 用的时候:因为公共头地址 = 对象本身地址,内核直接把这个指针强转回具体类型(如
struct msg_queue *),完美还原完整对象。
第三部分:代码见真章——手撕 C 语言多态现场
(注:以下代码修正了原文的大小写编译错误,并简化了注释逻辑)
#include <stdio.h>

// ==========================================
// 1. 定义“父类”:通用权限控制块
// ==========================================
struct BasePermission {
    int id;
    void (*do_work)(void*);  // 函数指针:模拟 C++ 虚函数表入口
};

// ==========================================
// 2. 定义“子类 A”:消息队列
// ==========================================
struct MsgQueue {
    struct BasePermission b_perm; // ⚠️ 物理死线:必须首成员!
    int msg_qnum;
};

void read_msg(void* obj) {
    struct MsgQueue* mq = (struct MsgQueue*)obj; // 直接强转还原
    printf("操作消息队列,积压数量:%d\n", mq->msg_qnum);
}

// ==========================================
// 3. 定义“子类 B”:共享内存
// ==========================================
struct ShmKernel {
    struct BasePermission b_perm; // ⚠️ 物理死线:必须首成员!
    size_t shm_segsz;
};

void write_shm(void* obj) {
    struct ShmKernel* shm = (struct ShmKernel*)obj;
    printf("操作共享内存,开辟大小:%lu 字节\n", shm->shm_segsz);
}

// ==========================================
// 4. 多态核心总线测试
// ==========================================
int main() {
    // 实例化并填充数据
    struct MsgQueue mq = { .b_perm.id = 1, .b_perm.do_work = read_msg, .msg_qnum = 88 };
    struct ShmKernel shm = { .b_perm.id = 2, .b_perm.do_work = write_shm, .shm_segsz = 4096 };

    // 核心多态指针:只看父类模样
    struct BasePermission* bus = NULL;

    // 指向消息队列时,执行读操作
    bus = (struct BasePermission*)&mq;
    bus->do_work(bus);  // 输出:操作消息队列...

    // 指向共享内存时,执行写操作(同一行代码,不同效果)
    bus = (struct BasePermission*)&shm;
    bus->do_work(bus);  // 输出:操作共享内存...

    return 0;
}
第四部分:升华与总结——为什么要这么“折腾”?
通过上面的代码,您可以清晰地看到:
- 统一管理:内核的
ipc_id_ary柔性数组里,只需要存储统一的struct kern_ipc_perm *类型指针,无需为每一种 IPC 单独维护一个数组。 - 零额外开销:这种多态完全由编译器在编译期计算偏移量完成,不需要像 C++ 那样维护复杂的虚函数表(vtable)和 RTTI(运行时类型识别),执行效率极高。
- 代码复用:权限校验(如
ipcperms函数)只认kern_ipc_perm,一套代码通杀所有 IPC 类型。
只需要记住这一句话:
C 语言实现多态,靠的是结构体首成员地址重合(Offset 0)实现属性继承,靠函数指针实现方法动态绑定。
ipc_id_ary正是利用这一特性,用统一的指针数组管理了千差万别的 IPC 资源。
第八章: mmap⽂件映射
1. mmap 的基本概念与作用
在传统的 Linux 文件读写中,我们通常会使用 read 和 write。以普通文件为例,文件页通常由内核 Page Cache 管理,read 还需要把数据从内核缓存复制到用户缓冲区,write 则需要把用户数据复制进内核缓存。因此和内存映射相比,传统接口的数据路径里通常多了一次用户态/内核态之间的显式拷贝。
而 mmap(Memory Map,内存映射)走了一条完全不同的捷径。它的基本作用是:把一个文件直接映射到进程的虚拟内存空间中。
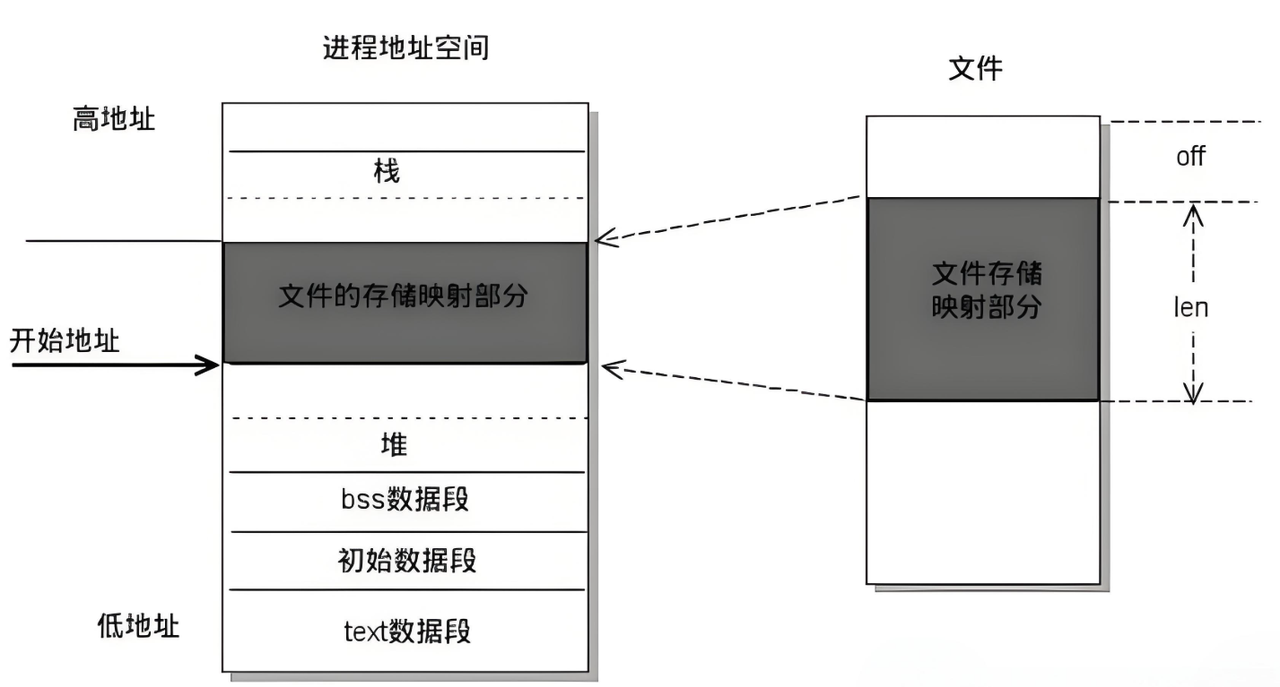
简单来说,操作系统在进程虚拟地址空间中建立一段与文件页关联的映射。之后程序通过普通内存读写访问这些页;对于 MAP_SHARED 可写映射,修改会形成脏页并由内核按写回策略同步到文件。这不等于“你写一个字节,磁盘介质立刻同步多一个字节”,真正的持久化时机还涉及 Page Cache、写回以及 msync/fsync 等同步语义。
2. 通过 mmap 实现进程间共享内存
既然 mmap 可以把文件映射到内存里,那它又是怎么和“进程间通信(IPC)”扯上关系的呢?
秘密就在于多进程映射同一个文件。
假设现在有进程 A 和进程 B 两个完全独立的进程,它们原本是无法直接看到对方的数据的。但是,如果进程 A 和进程 B 都调用了 mmap,并且映射了同一个硬盘上的文件,神仙操作就发生了:
对于同一文件、同一区域的 MAP_SHARED 映射,多个进程通常会通过 Page Cache 映射到同一组底层文件页,因此不需要为每个进程各复制一份文件内容。
这时候,进程 A 修改共享映射后,进程 B 映射同一页时可以看到这些修改;但如果双方并发读写同一数据结构,仍然需要信号量、进程共享 mutex、原子协议等同步手段来规定写入完成时机和数据一致性,不能把“共享同一页”理解成自动解决并发。
这种文件-backed MAP_SHARED 映射可以作为进程间共享内存的一种方式。映射建立后,双方访问的是同一组共享页,因此避免了每次通过 read/write 传输数据时的额外用户/内核缓冲区拷贝。
3. mmap 系统调用语法详解
3.1 先建立一个核心认知:mmap 到底在干什么?
你可以把 mmap 理解为:
在当前进程的虚拟地址空间里,“画”出一块地皮。这块地皮可以连着一份磁盘文件(像租了一块有产权的土地),也可以是纯粹的空地(匿名内存)。
关键点:
mmap执行完,只是 “画了地皮、办了地契(VMA)”,土地上并没有马上盖好房子(物理内存)。- 真正“盖房子”(分配物理内存)的时机,是 你第一次踩上这块地(读写地址) 时,由内核自动触发“缺页中断”来完成。
记住这个比喻,下面所有参数就好理解了。
3.2 六个参数逐个拆解(用地皮比喻)
函数原型长这样:
void *mmap(void *addr, size_t length, int prot, int flags, int fd, off_t offset);
我们把它翻译成大白话:
“内核啊,帮我在进程的地址空间里,从
addr位置开始,圈一块length大的地皮。这块地皮的权限是prot,映射方式是flags。如果关联文件,就用fd和offset指定从文件的哪里开始。”
① addr:你想让地皮从哪开始?
void *addr
- 填
NULL:相当于说“内核你随便挑个合适位置”。99% 的场景都这么写,让内核自动分配。 - 填具体地址:相当于“我就要这块地”。除非你是写操作系统或嵌入式裸机,否则千万别乱填,容易冲突导致
mmap失败。
✅ 记住:普通人永远填
NULL。
② length:地皮要多大?
size_t length
单位是字节。比如 length = 4096,就是要 4KB 的地皮。
注意两点:
- 虽然你填的是字节数,但内核管理地皮的最小单位是 “页(Page)”,通常是 4KB。所以你申请 5000 字节,内核实际会按多个页来管理。
mmap成功不代表这 5000 字节的物理内存都给你备好了,只是虚拟地址上给你画好了线。实际物理内存等你踩上去(读写)时才分配。
✅ 记住:
length是你想要的虚拟地址范围大小,不是马上占用的物理内存大小。
③ prot:这块地能干什么?(权限)
int prot
就是设置这块地的使用权限,常见组合:
| 取值 | 含义 |
|---|---|
PROT_READ | 可读(能看) |
PROT_WRITE | 可写(能改) |
PROT_READ | PROT_WRITE | 可读可写 |
PROT_EXEC | 可执行(能运行代码,比如映射动态库) |
PROT_NONE | 啥都不能干(占位用) |
✅ 记住:你想怎么用这块地,就设什么权限。最常见的是
PROT_READ | PROT_WRITE。
④ flags:这块地是“私有的”还是“共享的”?(最关键的参数)
int flags
这是 mmap 最灵魂的参数,决定了这块地皮的性质。两种最主要模式:
模式一:MAP_SHARED(共享地皮)
MAP_SHARED
- 如果关联了文件:多个进程映射同一个文件时,大家看到的是同一块物理地皮。A 进程在地上写个字,B 进程马上能看到。而且修改最终会写回磁盘文件。
- 如果匿名映射(无文件):可以用于进程间通信(共享内存)。
形象比喻:
你和邻居共享同一个院子,你在院子里种棵树,邻居立刻能看到。而且这棵树最后会留在原地(写回文件)。
模式二:MAP_PRIVATE(私有地皮,写时复制)
MAP_PRIVATE
- 如果关联了文件:刚开始大家共享同一块地皮的内容(比如读同一份文件),但一旦某个进程要修改,内核会悄悄给他复制一份独立的副本,让他改自己的,不影响别人。修改不会写回文件。
- 如果匿名映射:就是普通私有内存,类似
malloc。
形象比喻:
你和邻居共用一本杂志(文件)。你突然想在上面涂鸦,内核会立刻给你买一本一模一样的新杂志让你随便画,邻居手里的原版不受影响。你画的不会还回去。
⑤ fd:地皮连着哪个文件?
int fd
如果是文件映射,这里填 open() 返回的文件描述符。
如果是匿名映射(不关联文件),这里填 -1。
✅ 记住:有文件就填
fd,没文件就填-1。
⑥ offset:从文件的哪个位置开始切地皮?
off_t offset
只在文件映射时有意义。表示从文件的第几个字节开始映射。
offset = 0:从文件开头开始。offset = 4096:从文件第 4096 字节处开始。
注意:offset 必须是页大小(4KB)的整数倍。
✅ 记住:绝大多数场景填
0,从文件头开始。
3.3 两种完整流程示意
场景一:文件映射(MAP_SHARED)
int fd = open("test.dat", O_RDWR);
void *p = mmap(NULL, 4096, PROT_READ | PROT_WRITE, MAP_SHARED, fd, 0);
完整流程:
磁盘上的 test.dat
       ↓
   open() 得到 fd
       ↓
   mmap() 建立映射
       ↓
进程虚拟地址空间多了一块 VMA(地契)
       ↓
程序第一次访问 p[0](踩上这块地)
       ↓
触发缺页中断,内核把文件数据读到物理内存
       ↓
建立页表,p 就可以正常读写了
场景二:匿名映射(不关联文件,类似 malloc)
void *p = mmap(NULL, 4096, PROT_READ | PROT_WRITE, MAP_PRIVATE | MAP_ANONYMOUS, -1, 0);
完整流程:
进程调用 mmap
       ↓
内核在虚拟地址空间画一块空地(匿名 VMA)
       ↓
程序第一次写 p[0] = 10
       ↓
触发缺页中断,内核分配一块物理页(全填 0)
       ↓
建立页表,p 就可以正常使用了
3.4 返回值与错误处理
- 成功:返回映射区域的虚拟起始地址(就是那块地皮的入口),你可以当普通指针用。
- 失败:返回
MAP_FAILED(即(void*)-1),并设置errno。
void *p = mmap(...);
if (p == MAP_FAILED) {
    perror("mmap 失败");
    exit(1);
}
4. munmap 函数全方位解析
通过 mmap 建立的映射在不再需要时通常应使用 munmap 解除;对于长生命周期进程,如果不断建立映射却不解除,会持续占用虚拟地址空间及相关内核资源。进程退出时内核会自动撤销其所有映射,所以它与永久性“文件没 free 就永远泄漏”并不是完全相同的生命周期。
包含的头文件
使用 munmap 只需要引入操纵系统内存映射的核心头文件即可:
#include <sys/mman.h>
函数原型
int munmap(void *addr, size_t length);
参数详解
-
addr(映射区起始地址):
这是你要销毁的虚拟内存映射区的开头。- 硬核规则:传给
munmap的addr必须按系统页大小对齐。它可以是原映射的起始地址,也可以是映射内部某个页对齐的位置,从而解除整段或部分映射;并不是法律上只能传mmap最初返回的那一个地址。
- 硬核规则:传给
-
length(映射区大小):
你需要释放的内存区域的字节数(Byte)。- 底层对齐机制:和
mmap一样,操作系统在底层管理内存依然是以“页(4KB)”为最小单位。所以,传入的length在底层也会被向上取整到 4KB 的整数倍进行释放。 - 工程最佳实践:如果你的目标就是完整撤销整段映射,最简单稳妥的做法仍然是保存
mmap返回地址和原始映射长度,并把它们传给munmap。Linux 会按页处理范围;munmap也支持解除映射的一部分。
- 底层对齐机制:和
返回值说明
- 成功:返回
0。 - 失败:返回
-1并设置errno。典型EINVAL情况包括地址未按页对齐、length == 0或地址范围计算溢出等;Linux 对“范围中部分页本来就没有映射”的处理并不等价于这里原文所说的“一定因为不属于合法映射而报错”。
底层核心逻辑与防坑指南
- 它解绑的是“桥梁”,而不是“河”:
调用munmap只是把进程虚拟地址空间与物理文件之间的“映射关系”给切断了,并且释放掉了这块虚拟内存。它绝对不会把硬盘上的物理文件给删掉,文件依然完好损地躺在磁盘里。 - 与 MAP_SHARED 的脏页同步(重要):
如果MAP_SHARED映射被修改,相应文件页会变成脏页并由内核按写回策略最终写回文件。munmap的主要语义是解除映射,它不等价于“强制同步落盘”接口;如果程序需要在某个时间点明确等待脏页同步完成,应使用msync(..., MS_SYNC)(必要时再结合fsync等持久化手段)。 - 映射区生命周期与 fd 无关:
我们建立映射后立刻就调用close(fd)。这里必须明确:关闭文件描述符fd并不会自动销毁映射区,也不会引发munmap失败。映射区一旦建立,它就独立存在于进程的虚拟内存中了,直到进程退出或者显式调用munmap,它才会被真正销毁。
持久化补充:进程间“看到修改”和“修改已经持久化到磁盘”是两件事。共享页可先在 Page Cache 中彼此可见;如果业务要求某个时间点数据已经同步到文件/存储介质,应显式使用
msync/fsync等适当接口,而不能只依赖munmap。
5. ftruncate 函数全方位解析
在 Linux 的 mmap 编程中,ftruncate 的核心使命是强制改变文件的大小。它是连接“空文件”与“内存映射”之间不可或缺的桥梁。
包含的头文件
要使用 ftruncate,必须在代码开头引入以下两个头文件:
#include <unistd.h>
#include <sys/types.h>
函数原型
int ftruncate(int fd, off_t length);
参数详解
-
fd(文件描述符):
这是你要操作的目标文件的“身份证号”。它必须是一个已经成功打开的文件描述符。 -
硬核死律:该文件描述符对应的打开模式,必须具备写入权限(如
O_WRONLY或O_RDWR)。如果你用只读模式(O_RDONLY)打开了一个文件,接着对它调用ftruncate,操作系统会无情拒绝并直接报错。 -
length(目标长度):
你希望将文件调整到的目标大小,单位是字节(Byte)。它的类型是off_t;在很多 64 位 Linux ABI 中它是 64 位有符号整数类型,但不要把它跨平台死记成一定就是 C/C++ 的long。- 如果文件原本的大小小于
length,文件将被扩展到指定大小。 - 如果文件原本的大小大于
length,文件将被截断,超出部分的数据直接被丢弃。
- 如果文件原本的大小小于
返回值说明
- 成功:返回
0。 - 失败:返回
-1,并且系统会自动设置全局错误码errno。常见的失败原因包括:EBADF(文件描述符无效或没有写权限)、EINVAL(传入的长度不合法)等。
底层核心逻辑:为什么“0就是 \0”?
当 ftruncate 强行把一个 0 字节的空文件拉大到 4096 字节时,新诞生出来的这 4096 个字节的空间里,操作系统会默认全部填充二进制的零(即 0x00)。
在这里讨论的是字节值:新扩展区域读出来是值为 0 的字节,即 0x00;当把这样的字节作为 char 使用时,它就是 C 字符串里的空字符 。不能笼统把“任意上下文里的整数 0、0x00、字符对象”都说成完全同一种类型,只是它们在这个单字节值上等价。
6. fstat 函数全方位解析
fstat 的核心使命是获取已打开文件的元数据。在读取端进程中,它可以拿到文件当前的逻辑字节长度,从而指导 mmap 使用合适的映射长度。
包含的头文件
#include <sys/types.h>
#include <sys/stat.h>
#include <unistd.h>
函数原型
int fstat(int fd, struct stat *statbuf);
参数详解
fd(文件描述符):
已经打开的目标文件的文件描述符。与ftruncate不同,fstat只是读取文件的属性,因此文件是以只读(O_RDONLY)还是读写(O_RDWR)模式打开的,完全不影响它的执行。statbuf(状态缓冲区指针):
这是一个输出型参数。你需要在外部显式声明一个系统内置的结构体变量struct stat st;,然后把它的地址&st传进来。函数一旦执行成功,内核就会把这个文件的所有属性塞进这个结构体里。
struct stat 结构体核心成员(struct stat 是系统头文件中已经定义好的结构体,你包含对应头文件后就可以直接使用。)
这个结构体非常庞大,装满了文件的各种隐私,但在 mmap 通信场景下,我们通常只需要盯死它的一个核心成员:
struct stat {
    dev_t     st_dev;     /* 文件的设备ID */
    ino_t     st_ino;     /* 文件的 inode 节点号 */
    mode_t    st_mode;    /* 文件的类型和访问权限 */
    nlink_t   st_nlink;   /* 硬链接数 */
    uid_t     st_uid;     /* 所有者的用户ID */
    gid_t     st_gid;     /* 所有者的组ID */

    off_t     st_size;    /* 【核心成员】文件的总字节数(大小) */

    blksize_t st_blksize; /* 操作系统文件系统传输的块大小 */
    blkcnt_t  st_blocks;  /* 分配给该文件的 512B 块的数量 */
    /* ... 还有各种时间戳成员 */
};
我们通过 st.st_size 就可以直接拿到文件当前最精确的字节数。
返回值说明
- 成功:返回
0,此时statbuf指向的结构体已经被填满了有效数据。 - 失败:返回
-1,并设置errno错误码(例如EBADF表示传入的文件描述符非法)。
读写闭环的底层意义
通过 fstat 拿到 st.st_size 之后,读取端调用 mmap 时,第二个参数直接填入 st.st_size。
这在本例中的意义是动态自适应文件长度:读取端根据 st_size 映射当前文件范围。映射得太短会读不到后面的内容;映射超过文件 EOF 的页面并不是“只是浪费虚拟内存”这么简单,访问越过文件有效范围还可能触发 SIGBUS。
7. mmap 写入映射代码实现
mmap 只是把“文件的某一段”映射到内存地址,并不代表文件真的已经有那么大。 比如文件现在是 0 字节,你却 mmap(..., 4096, ...) 映射了 4096 字节,看起来好像得到了 4096 字节内存,但文件实际并没有这 4096 字节;这时你往映射区里写数据,访问到文件 EOF 之后的页面,可能直接触发 SIGBUS。所以正确做法通常是先 ftruncate(fd, 4096),先把文件真实大小扩展到 4096 字节,再 mmap 这 4096 字节进行读写。
原文件:0 字节

ftruncate(fd, 4096)
        ↓
文件真实大小变成 4096 字节
        ↓
mmap(..., 4096, ...)
        ↓
现在才能安全地通过映射区写这 4096 字节
一句话记忆:
先
ftruncate把文件“撑大”,再mmap映射并写入;mmap本身不会自动把文件变大。
同时,为了保证读取端能够把写入的数据当作字符串正常打印出来,我们在写入时,故意把 4096 字节的最后一个字节留作 \0(利用了 ftruncate 默认补 0 的特性)。
#include <iostream>
#include <string>
#include <unistd.h>
#include <sys/types.h>
#include <sys/stat.h>
#include <fcntl.h>
#include <sys/mman.h>
#include <cstring>

// 定义映射区的大小,通常设置为系统内存页大小的整数倍(4KB)
#define SIZE 4096

int main(int argc, char *argv[])
{
    // 1. 检查命令行参数,确保用户传了目标文件名
    if (argc != 2)
    {
        std::cerr << "Usage: " << argv[0] << " filename" << std::endl;
        return 1;
    }
    std::string filename = argv[1];

    // 2. 打开目标文件
    // 注意:若想成功进行可读可写的内存映射,文件打开模式必须是 O_RDWR(读写模式)
    // O_CREAT 表示文件不存在则创建,0666 是创建文件时的默认权限
    int fd = ::open(filename.c_str(), O_CREAT | O_RDWR, 0666);
    if (fd < 0)
    {
        std::cerr << "open error" << std::endl;
        return 2;
    }

    // 3. 调整文件大小
    // 新创建的文件或默认文件大小通常是 0,无法直接与 mmap 进行映射。
    // 这里使用 ftruncate 函数强行将文件大小截断并扩展到 SIZE(4096字节),系统会自动用 0 值填充
    ::ftruncate(fd, SIZE);

    // 4. 发起 mmap 内存映射
    // nullptr: 让操作系统自动选择映射区的虚拟起始地址
    // SIZE: 映射区的大小
    // PROT_READ | PROT_WRITE: 映射区权限,可读可写
    // MAP_SHARED: 共享映射,对这块内存的修改会同步到文件和其它进程中
    // fd/0: 映射该文件从开头(偏移量为0)开始的内容
    char *mmap_addr = (char*)::mmap(nullptr, SIZE, PROT_READ | PROT_WRITE, MAP_SHARED, fd, 0);

    // 检查映射是否成功
    if (mmap_addr == MAP_FAILED)
    {
        perror("mmap");
        ::close(fd); // 映射失败也要记得关闭文件描述符
        return 3;
    }

    // 5. 核心操作:直接像操作内存数组一样修改文件内容
    // 特别注意:这里循环到 SIZE - 1,故意留下最后一个字节不修改(保持 ftruncate 填充的 '\0')
    // 这样读取端直接用 std::cout 打印时,才不会发生越界乱码或崩溃
    for (int i = 0; i < SIZE - 1; i++)
    {
        mmap_addr[i] = 'a' + i % 26; // 循环写入 a~z 的字母
    }

    // 也可以直接使用传统的内存拷贝函数来写入数据:
    // memcpy(mmap_addr, "hello", 5);

    // 6. 善后工作
    // 取消内存映射,解除虚拟地址与文件的绑定关系
    ::munmap(mmap_addr, SIZE);

    // 关闭文件描述符(mmap映射成功后,关闭fd不会影响已经建立好的映射区)
    ::close(fd);

    return 0;
}
8. mmap 读取映射代码实现
读取端的操作相对简单,我们不需要(也不应该随意)改变文件大小。读取端先通过 fstat 拿到文件当前的逻辑字节长度,然后根据这个长度建立只读映射。
#include <iostream>
#include <string>
#include <unistd.h>
#include <sys/types.h>
#include <sys/stat.h>
#include <fcntl.h>
#include <sys/mman.h>
#include <cstring>

int main(int argc, char *argv[])
{
    // 1. 检查命令行参数,确保传入了要读取的文件名
    if (argc != 2)
    {
        std::cerr << "Usage: " << argv[0] << " filename" << std::endl;
        return 1;
    }
    std::string filename = argv[1];

    // 2. 以只读模式(O_RDONLY)打开目标文件
    int fd = ::open(filename.c_str(), O_RDONLY); // 标准只读打开宏为 O_RDONLY
    if (fd < 0)
    {
        std::cerr << "open error" << std::endl;
        return 2;
    }

    // 3. 动态获取文件的真实大小
    // 声明一个 stat 结构体,用来接收文件的属性信息
    struct stat st;
    // fstat 可以根据文件描述符获取文件状态,其中 st.st_size 就是文件的字节大小
    if (::fstat(fd, &st) < 0)
    {
        std::cerr << "fstat error" << std::endl;
        ::close(fd);
        return 3;
    }

    // 4. 发起 mmap 只读映射
    // 映射的大小直接使用前面获取到的文件真实大小 st.st_size
    // 权限设置为 PROT_READ(只读),标志位依然是 MAP_SHARED(共享)
    char *mmap_addr = (char*)::mmap(nullptr, st.st_size, PROT_READ, MAP_SHARED, fd, 0);

    // 检查映射是否成功
    if (mmap_addr == MAP_FAILED)
    {
        perror("mmap");
        ::close(fd);
        return 4;
    }

    // 5. 核心操作:直接读取共享内存中的数据
    // 由于写入端在末尾留了 '\0',这里可以直接将指针当作普通字符串输出
    std::cout << mmap_addr << std::endl;

    // 6. 善后工作
    // 取消映射,传入的长度必须与映射时的长度(st.st_size)严格一致
    ::munmap(mmap_addr, st.st_size);

    // 关闭文件描述符
    ::close(fd);

    return 0;
}
读写配合的核心细节剖析
看了上面这两段代码,细心的读者一定会发现一些极其精妙的配合和底层约束,这里我们直接挑明:
- 文件权限与映射权限的死律:
- 文件权限与映射权限的规则:在本例的
MAP_SHARED + PROT_WRITE写入端中,文件描述符需要以可写方式打开(这里用O_RDWR)。需要注意,mmap的保护权限与open模式之间的约束还和MAP_SHARED/MAP_PRIVATE有关,不能概括成“任何情况下 mmap 权限都绝不能大于 open 权限”。 - 文件大小与“空洞文件”:
新文件的大小是 0。如果我们不调用ftruncate强行改变文件大小,mmap虽然可能不会报错,但当你试图去用指针写内存时,操作系统会因为“无法将数据同步到不存在的物理文件区域”而向进程发送SIGBUS(总线错误)信号,直接把你的进程干掉。 - 文件描述符的“卸磨杀驴”:
在代码里,我们建立映射之后就立刻可以去操作指针了。实际上,一旦mmap映射成功,这个文件描述符fd的使命就已经完成了。即使你紧接着调用close(fd)关闭了文件,也完全不会影响你继续通过指针读写这块共享内存。只有当你显式调用munmap时,这段内存映射才会真正彻底销毁。
9. malloc/new/free 与动态库的底层大揭秘
9.1 我们天天用的内存调用,底层真的都是 mmap 吗?
写 C++ 时,malloc、new、free 几乎天天见。程序运行时,还要加载一堆 .so 动态库。你有没有好奇过,这些上层 API 在 Linux 内核里到底是怎么“要内存”的?
核心结论:
mmap是重要的底层机制,但不是唯一。- 具体怎么分配,取决于 C/C++ 运行库(如 glibc)和内存分配器的实现策略。
Linux 为了平衡性能和系统调用开销,把虚拟内存分配玩成了 “批发”和“零售” 两种模式。
9.1.1 malloc / new 的“双重人格”
在 C++ 中,new 表达式会先调用 operator new 获取原始内存,再构造对象。标准没有规定 operator new 必须用 malloc,但 glibc 的实现中,malloc 是主力。
glibc 的 malloc 会根据申请大小,走不同路线:
| 申请大小 | 底层行为 |
|---|---|
| 较小 / 常规分配 | 优先从已有的内存池(arena / heap)中切一块给你,若池子不够大,则通过 brk 或 sbrk 扩展堆区。 |
| 较大分配 | 可能直接调用 mmap 创建一块独立的匿名内存映射,返回给你。 |
⚠️ 阈值不是固定的 128KB:
这个阈值(mmap_threshold)是动态可调的,默认值可能随版本和系统变化,128KB 只是常见的默认示例,不能当作铁律。
无论哪种方式,物理页都是按需分配的(即写时分配),mmap 或 brk 只是先拿到虚拟地址范围。
9.1.2 free 的幕后动作
free 的行为和申请时对应:
- 如果内存来自 堆/arena,
free通常把块归还给分配器缓存,不一定会立刻还给内核(方便后续复用)。 - 如果内存来自 独立的
mmap,free很可能调用munmap立即归还给操作系统。
但具体阈值和策略,取决于 malloc 的实现,不是语言标准规定的。
9.1.3 动态链接库(.so)—— mmap 的“绝对主场”
加载 .so 文件时,动态链接器(ld.so)会直接调用 mmap,把磁盘上的 .so 文件的代码段(.text)和数据段(.data)映射到进程的虚拟地址空间。
这里的妙处是:
- 如果多个进程使用同一个
.so,只读/可执行的文件页通常通过 Page Cache 在物理内存中共享(MAP_PRIVATE映射,只要没发生写时复制,就共享同一份物理页)。
所以,动态库加载是 mmap 最典型的应用场景。
9.2 模拟实现自己的 malloc 与 free
既然 mmap 可以创建匿名映射(不关联文件),我们就可以用它来模拟一套极简的内存分配器,亲身体验底层原理。
9.2.1 核心设计痛点:free(ptr) 只传指针,怎么知道要释放多大?
free(ptr) 只有一个指针参数,没有长度信息。为什么标准库能做到?
因为分配器自己悄悄记住了每块内存的大小!
工业界经典做法:在返回给用户的内存块前面,加一个“头部(Header)”,专门存储元数据(如块大小)。
内存布局如下:
[ Header (存有 total_size) ] [ 真正交给用户的可用数据区 ]
^                            ^
mmap 返回的真实起始地址      返回给用户的指针 (user_ptr)
- 申请时:实际
mmap的大小 = 用户需求大小 +sizeof(Header)。 - 返回时:把 Header 填好,然后返回
(char*)raw_ptr + sizeof(Header)。 - 释放时:把
user_ptr往前挪一个 Header 大小,读出总大小,然后munmap整个块。
9.2.2 完整模拟实现代码
注意:这只是教学演示,不等同于 glibc 的高性能实现(真实实现还要考虑对齐、分桶、并发、碎片、复用等)。
#include <iostream>
#include <sys/mman.h>
#include <unistd.h>

// 内存块头部
struct MemoryHeader {
    size_t size;  // 总大小(含 Header + 用户数据)
};

// 自定义 malloc
void* my_malloc(size_t size) {
    if (size == 0) return nullptr;

    size_t total_size = size + sizeof(MemoryHeader);

    // 匿名映射,可读可写
    void* raw_ptr = ::mmap(nullptr, total_size,
                           PROT_READ | PROT_WRITE,
                           MAP_PRIVATE | MAP_ANONYMOUS,
                           -1, 0);
    if (raw_ptr == MAP_FAILED) {
        perror("my_malloc mmap failed");
        return nullptr;
    }

    // 写入头部
    MemoryHeader* header = static_cast<MemoryHeader*>(raw_ptr);
    header->size = total_size;

    // 返回用户区域指针
    void* user_ptr = static_cast<char*>(raw_ptr) + sizeof(MemoryHeader);
    return user_ptr;
}

// 自定义 free
void my_free(void* ptr) {
    if (ptr == nullptr) return;

    // 找回真正的起始地址
    void* raw_ptr = static_cast<char*>(ptr) - sizeof(MemoryHeader);
    MemoryHeader* header = static_cast<MemoryHeader*>(raw_ptr);
    size_t total_size = header->size;

    // 解除映射
    if (::munmap(raw_ptr, total_size) < 0) {
        perror("my_free munmap failed");
    }
}

// 测试
int main() {
    std::cout << "--- 测试 my_malloc ---" << std::endl;
    int* arr = static_cast<int*>(my_malloc(10 * sizeof(int)));
    if (!arr) return 1;

    for (int i = 0; i < 10; ++i) arr[i] = i * 10;

    std::cout << "数据: ";
    for (int i = 0; i < 10; ++i) std::cout << arr[i] << " ";
    std::cout << std::endl;

    std::cout << "--- 测试 my_free ---" << std::endl;
    my_free(arr);
    std::cout << "释放成功!" << std::endl;

    return 0;
}
关键点重申:
mmap返回的是虚拟地址,物理页在首次访问时才会真正分配(按需调页)。- 代码中把
mmap说成“申请物理内存”是通俗说法,实际是建立虚拟映射。munmap会立刻解除映射,虚拟地址范围失效。
9.3 总结对比表
| 操作 | 底层机制 | 是否一定用 mmap |
|---|---|---|
malloc 小内存 | 优先从堆(brk)分配 | ❌ 不一定 |
malloc 大内存 | 可能用 mmap 匿名映射 | ✅ 可能 |
free 小内存 | 归还给分配器缓存,不一定 munmap | ❌ |
free 大内存 | 可能 munmap | ✅ 可能 |
加载 .so 动态库 | 几乎总是 mmap 文件映射 | ✅ 是 |
通过这个模拟,你应该能直观理解:
- 分配器如何通过“头部”记住元数据。
mmap既能用于分配匿名内存,也能用于映射文件(如.so)。- 真实分配器远比这复杂,但底层核心思想相通。
10. 洞察内存映射:从 GDB 指令到内核源码的全链路解密
10.1 第一层:用户态视角(GDB 里能看到什么?)
当我们在 GDB 中运行程序并停住时,输入 info proc mappings,会看到进程的“虚拟地址地图”。这张地图告诉我们在逻辑上拥有哪些内存区域。
Start Addr      End Addr        Size     Offset   objfile
0x555555554000  0x555555555000  0x1000   0x0      /home/project/mmap_write  (1. 程序本身)
0x555555755000  0x555555776000  0x21000  0x0      [heap]                    (2. 堆)
0x7ffff7fc2000  0x7ffff7fc3000  0x1000   0x0      /home/project/test.dat    (3. 文件映射)
0x7ffff7fc3000  0x7ffff7fc6000  0x3000   0x0      (空白)                    (4. 匿名映射)
0x7ffff7fc6000  0x7ffff7fca000  0x4000   0x0      /usr/lib/libc.so          (5. 动态库)
0x7ffffffde000  0x7ffffffff000  0x21000  0x0      [stack]                   (6. 栈)
这一层我们只看懂三件事即可:
- 地址范围(Start -> End):这只是进程眼中的“虚拟地址”范围,不代表真的占用了同等大小的物理内存条空间。
- Size(大小):全是
0x1000(4KB)的整数倍。这不是巧合,因为 Linux 管理内存的最小单位是“页(Page)”,虚拟地址映射的最小粒度就是 4KB。 - objfile(来源):
- 有文件路径的(如 1、3、5):说明这块虚拟地址背后有磁盘文件支撑。
- 显示
[heap]或[stack]的:特殊用途区域。 - 空白(如 4):这就是我们上一章用
mmap申请的匿名内存,或者某些特殊的内部映射,它没有普通磁盘文件。
结论:
info proc mappings只是给我们看了一张“虚拟地址的目录表”,记录了“从哪个地址开始,到哪个地址结束,这块区域是干什么用的”。
10.2 第二层:内核的数据结构(Linux 是怎么记住这张表的?)
用户进程的地图,内核必须用数据结构记录下来。Linux 内核为每个进程维护了一套“房产证”,记录着每一块虚拟地址区域的归属。
这套“房产证”主要由三个核心结构体层层嵌套组成:
-
task_struct(进程的身份证)
每个进程在内核中都有一个task_struct,里面包含了一个指针mm,指向该进程的整个内存描述符。 -
mm_struct(进程的地图册)
这个结构体就是整张虚拟地址空间的总览。它里面包含了一串链表或树(用于快速查找),链接着下面要讲的无数个vm_area_struct。 -
vm_area_struct(地图册上的每一页房产证,简称 VMA)
每一块连续的内存映射区域,就对应一个vm_area_struct。- 它记录了这块区域的起始地址(
vm_start)和结束地址(vm_end)。 - 它记录了这个区域的权限(读、写、执行)。
- 它还有一个极其关键的指针:
vm_file。
- 它记录了这块区域的起始地址(
关键区别:
- 如果这块内存是映射的磁盘文件(如图 10.1 中的第 3 行),那么
vm_file就指向代表该文件的内核对象。 - 如果这块内存是匿名映射(如图 10.1 中的第 4 行),那么
vm_file就等于NULL(空)。
结论:
info proc mappings显示的每一行,在内核源码里就是一个vm_area_struct(VMA)结构体实例。我们看到的“空白 objfile”,在源码里就是vm_file == NULL。
10.3 第三层:文件映射是怎么“绑定”上磁盘的?(VMA 到磁盘的桥梁)
如果 vm_file 不是空的,那么就进入了文件映射的链路。很多初学者误以为 vm_file 直接指向磁盘上的文件,其实中间还隔着一层专门管理缓存的结构。
这条链条是这样的(请盯紧箭头):
VMA (vm_file) -> struct file (f_mapping) -> struct address_space (host) -> struct inode -> 磁盘数据
逐个拆解:
struct file:这是内核中打开的文件对象。它不关心文件具体在磁盘哪里,它只负责维护当前读写的状态(比如文件指针位置)。struct address_space:这是物理内存页缓存(Page Cache)的“管家”。它里面有一棵大树(i_pages),挂着这个文件已经加载到物理内存中的那些数据页。struct inode:这是文件的**“身份证”**(索引节点)。它记录了文件的大小、权限,以及最重要的——文件数据具体在磁盘的哪个扇区。
你看,这条链路的逻辑是:
程序访问某个虚拟地址 -> 找到 VMA -> 通过 VMA 找到打开的文件对象 -> 通过文件对象找到页缓存管家 -> 通过管家去找文件身份证 -> 最后才去磁盘读数据。
10.4 第四层:缺页中断——什么时候才真正用物理内存?
好,地图有了,绑定关系也有了,但物理内存还没分配呢!这就引出了最后一个关键机制:缺页中断(Page Fault)。
当我们用 mmap 映射完一块区域,或者用 malloc 要了一块内存后,此时物理内存里根本没有对应的数据,只是虚拟地址空间里画了个大饼。
- 第一次访问:当 CPU 执行到
arr[0] = 10;时,CPU 的 MMU(内存管理单元)去查页表,发现没有对应的物理地址,于是触发 缺页中断。 - 内核处理:CPU 暂停当前指令,跳进内核态。内核会根据出错的虚拟地址找到对应的 VMA。
- 如果是文件映射:内核调用 VMA 中的
fault函数,通过上面第 3 步的链路,把磁盘上的数据读进物理内存的一个页框,然后在页表里填上这个物理地址。 - 如果是匿名映射:内核直接在物理内存中找一个空闲的页框,全填充为 0,然后填进页表。
- 如果是文件映射:内核调用 VMA 中的
- 恢复执行:内核处理完毕,CPU 回到刚才的指令重新执行,这时因为页表已经填好了,就能正常读写了。
总结一下全链路(一句话概括)
info proc mappings展示的是进程的虚拟地址区域(VMA 列表)。- 内核源码中,每个区域由
vm_area_struct描述。 vm_area_struct中的vm_file决定了它是匿名内存还是文件内存。- 如果是文件内存,通过
vm_file -> f_mapping -> inode的路径,最终关联到磁盘上的物理数据。 - 但这一切只是“映射关系”,真正的物理内存,是在你首次读写触发“缺页中断”时,才由内核按需分配的。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 9
 0
- 0


 已为社区贡献5条内容

所有评论(0)