Linux中基础IO和文件认识
文件
1:文件在磁盘里
2:磁盘是永久性存储的介质,因此文件在磁盘上存储是永久性的
3:磁盘是一个外设(即是输出设备也是输⼊设备)
4:磁盘上的⽂件本质是对⽂件的所有操作,都是对外设的输⼊和输出简称IO0
文件的认识
1:对于0KB的文件来说也是占用一定的磁盘空间
2:文件=文件属性+文件内容的集合
3:所有的⽂件操作本质是⽂件内容操作和⽂件属性操作
系统角度认识
1:对文件的操作本质是进程对文件的操作
2:磁盘的管理者是操作系统
3:⽂件的读写本质不是通过C语⾔/C++的库函数来操作的(这些库函数只是为⽤⼾提供⽅便),⽽ 是通过⽂件相关的系统调⽤接⼝来实现的
fopen和open
带f开头:C 标准库(stdio.h)的文件流函数,高层 IO
不带f:操作系统系统调用(POSIX,如 Linux),底层文件描述符 IO
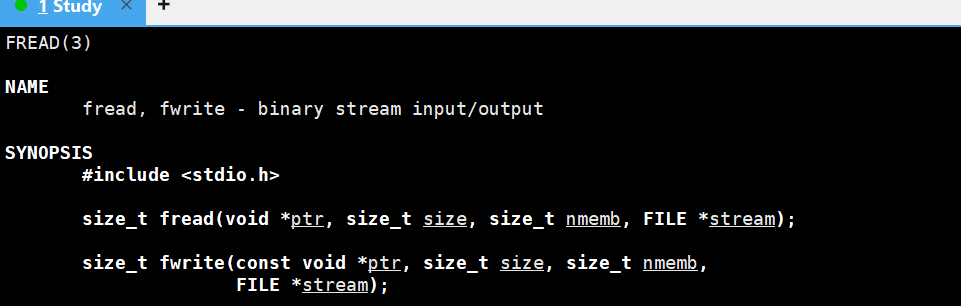
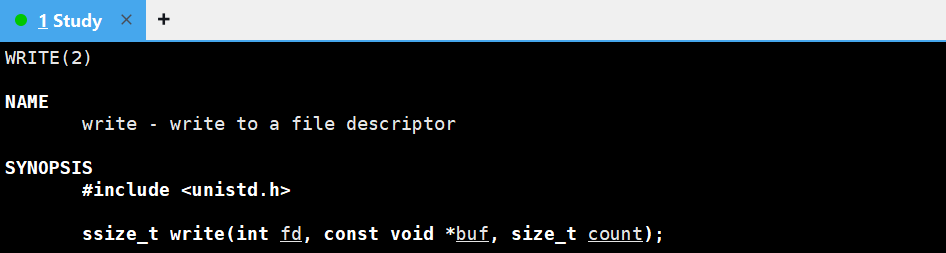
| 特征 | 带 f:fopen,fread,fwrite,fclose,fseek | 不带 f:open,read,write,close,lseek | |||||||
| 接口来源 | C 标准库函数,跨平台 | OS 系统调用,POSIX 标准,Linux/Unix,Windows 也有 API 但接口不一样,不跨平台 | |||||||
| 操作对象 | FILE* 文件指针(流) | int 文件描述符 fd(小整数) | |||||||
| 缓冲区 | ✅自带用户态缓冲(库缓冲) | ❌无库层缓冲,直接调用内核;只有内核缓冲 | |||||||
| 文本 / 二进制 | 区分文本模式"r"和二进制"rb" | 没有文本模式,全部原始二进制字节 | |||||||
| 换行处理 | Windows 下自动\n <-> \r\n转换 | 原样读写字节,不做换行转换 | |||||||
| 错误获取 | ferror()、feof() | errno全局变量 | |||||||
| 可移植性 | 所有 C 编译器都能用(Windows/Linux/macOS) | Unix 系;Windows 不支持这套,要用 Win32API | |||||||
| 典型函数 | fopen,fclose,fread,fwrite,fgets,fputs,fprintf,fscanf,fseek,ftell,rewind | open,close,read,write,lseek | |||||||
核心概念
1、FILE* 流(高层)
fopen返回FILE *fp,这个结构体里面封装了文件描述符 fd,再加一块内存缓冲区。 当你调用fread/fwrite,数据先读写到库的内存缓冲区,不是立刻落到磁盘。
- 刷新缓冲区:
fflush(fp)强制把缓冲区数据交给操作系统。
好处:减少系统调用次数,读写小数据性能更高。
2、文件描述符 fd(底层系统调用)
open()返回 int 整数 fd,直接跟操作系统内核打交道,没有 C 库的缓冲。 调用read/write就直接发起系统调用,每一次都进入内核。
频繁小 read/write 性能差,因为系统调用有开销。
3、二者可以互相转换
fileno(FILE* fp):从FILE*拿到底层 fdfdopen(int fd, const char *mode):用已有的 fd 包装成 FILE * 流
文本模式 vs 二进制模式
FILE *fp = fopen("a.txt", "r");   // 文本模式
FILE *fp = fopen("a.txt", "rb");  // 二进制模式
Linux 下文本 / 二进制模式没有区别,不会转换换行。
open/read 这套底层接口永远等价二进制模式,没有文本模式。
使用场景
- 普通 C 程序,追求可移植、简单文件读写 → 用
fopen/fread/fwrite(带 f),自带缓冲,简单。 - Linux 系统编程:管道、socket、设备文件、高级标志(非阻塞 O_NONBLOCK,锁等) → 用
open/read/write系统调用。fopen无法直接设置非阻塞这类内核属性。
一句话总结
带 f 是 C 标准库封装,有缓冲、区分文本二进制、跨平台,操作 FILE*;不带 f 是操作系统原生系统调用,操作文件描述符 fd,无库缓冲,Unix/Linux 专用。
fprintf / snprintf
它们都属于 stdio.h 标准库函数(带 f 家族),本质是格式化输出函数,核心能力:把数字、变量按格式转成字符串。
fprintf
int fprintf(FILE *stream, const char *format, ...);
- 输出目标:
FILE*文件流(可以是文件、stdout、stderr) - 作用:格式化,直接写入文件流缓冲区。
重点:
fprintf是基于FILE*流,走 C 库缓冲区,不是直接写磁盘。数据先到用户缓冲区,fflush/fclose 才真正交给内核。printf等价于fprintf(stdout, ...),stdout 就是默认的屏幕 FILE * 流。
snprintf
int snprintf(char *buf, size_t size, const char *format, ...);
- 输出目标:内存缓冲区(char 数组,内存字符串),不碰文件!
- 作用:格式化,把结果写到内存字符数组里。不会直接写入文件。
char buf[64];
int a = 200;
snprintf(buf, sizeof(buf), "num=%d", a);
//此时buf里面存放 "num=200" 字符串
和 fopen /open/read/write 的关系
关系图
- fprintf:格式化 → 写到
FILE*流 → C 库缓冲区 →(fflush)交给内核 write 系统调用。
变量 → fprintf → FILE*缓冲区 → fflush → write()系统调用 → 内核
- snprintf:格式化 → 写到内存 char []。之后你可以选择:
- 用
fputs/fwrite把 buf 写到 FILE * 文件; - 或者拿到 fd,调用系统调用
write(fd, buf, strlen(buf))写入文件。
- 用
变量 → snprintf → 内存buf
          ↓
    方案1:fputs(buf, fp)  //走FILE*库缓冲
    方案2:write(fd, buf, strlen(buf)) //直接底层系统调用
| 函数 | 输出目的地 | 是否操作文件 | 底层依赖 | |
| printf | stdout(屏幕 FILE*) | 是 | FILE * 流 | |
| fprintf | 任意 FILE*(文件 /stdout/stderr) | 是 | FILE * 流、库缓冲 | |
| sprintf/snprintf | 内存 char [] 数组 | ❌不碰文件内存操作 | 纯内存,无 IO | |
FILE *fp = fopen("test.txt","w");
int val = 666;
fprintf(fp, "value:%d\n", val);
fclose(fp);


FILE *fp = fopen("test.txt","w");
int val = 666;
char buf[32];
snprintf(buf,sizeof(buf),"value:%d\n",val);
fputs(buf, fp);
fclose(fp);


int fd = open("test.txt", O_WRONLY|O_CREAT, 0644);
int val = 666;
char buf[32];
snprintf(buf,sizeof(buf),"value:%d\n",val);
write(fd, buf, strlen(buf)); //直接系统调用write
close(fd);
总结:
- fprintf:格式化后直接输出到 FILE * 文件流;做格式化 + IO
- snprintf:格式化输出到内存字符串,只做字符串拼装,完全不做 IO;可以搭配 fwrite/fputs,也可以搭配底层 write 系统调用。内核没有格式化能力,格式化逻辑全部在 C 标准库。
格式化输出:
简单说:把程序里面各种类型的数据(整数、小数、字符),转换成人类看得懂的字符串,按你指定的样子拼接好,再输出出去,就叫格式化输出。
printf("xxx %d", a)格式化后输出到屏幕 (stdout 流)fprintf(fp, "xxx %d", a)格式化后输出到FILE* 文件流(文件)snprintf(buf, size, "xxx %d", a)格式化后输出到内存字符数组 buf,不输出到屏幕、不写文件。只是在内存拼好字符串,后面你想写到哪里再自己写。dprintf(fd, "xxx %d", a)(Linux POSIX 扩展) 格式化后直接输出到底层文件描述符 fd。等价于先用 snprintf 拼字符串,再调用 write。
再回到你前面的 fopen /open
- 带 f 的库函数(fprintf):自带格式化 + FILE 流缓冲 IO
- open/read/write 系统调用:只有原始字节 IO,没有格式化。想要输出数字,必须先用 snprintf 做格式化把数字变成字符串,再 write。
一句话总结
格式化输出 = 根据模板,把内存里的数字、小数等各种变量,转换成可读的字符串,拼接成一整段文本。 格式化是 C 库做的工作,操作系统内核完全不懂
%d。
OPEN的使用
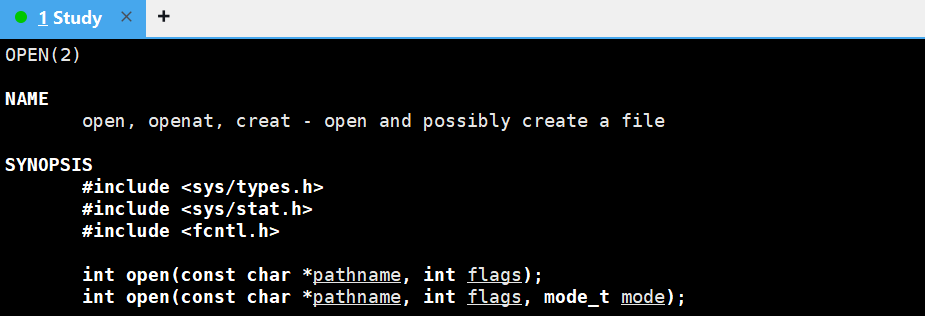
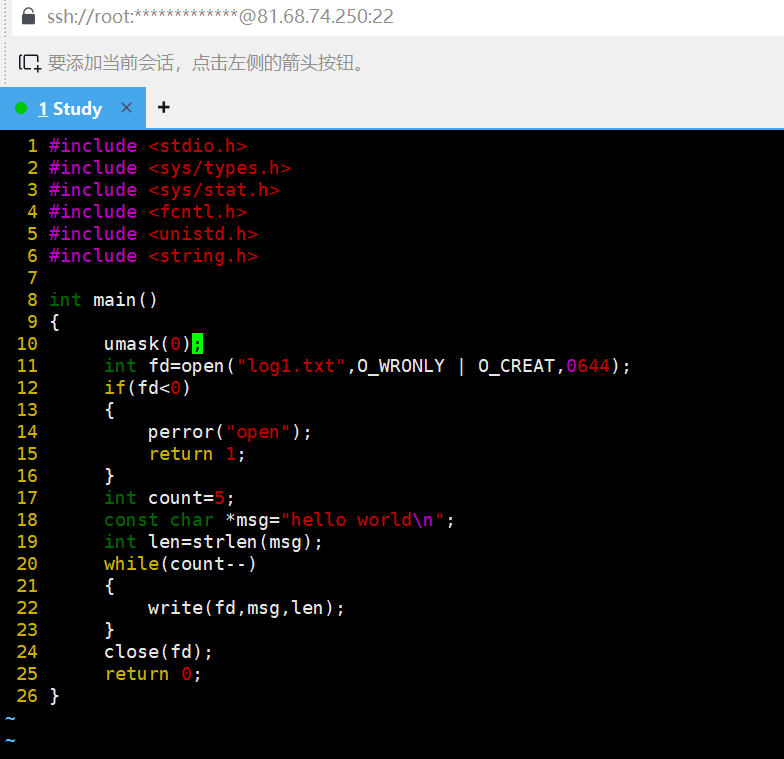
三个参数:
第一个:创建文件的文件名
第二个:创建文件的属性
第三个:文件的权限设置
第二个属性:
基础必选(只能选一个)
| flags | 含义 | ||
| O_RDONLY | 只读打开,只能读,不能写 | ||
| O_WRONLY | 只写打开,只能写,不能读 | ||
| O_RDWR | 读写打开,可读可写 | ||
常用附加标志(用 | 和上面组合)
| 标志 | 作用 | |||||
| O_CREAT | 文件不存在就创建,用这个标志时 open 必须传第三个参数 mode | |||||
| O_EXCL | 和O_CREAT一起:文件已存在则 open 报错,保证新建文件 | |||||
| O_TRUNC | 如果文件存在,打开时直接清空文件内容(截断为 0 字节) | |||||
| O_APPEND | 追加写,每次 write 都写到文件末尾,不会覆盖原有内容 | |||||
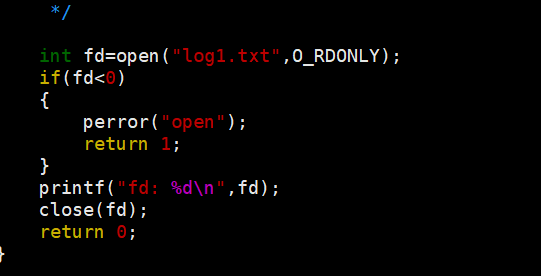
打印fd: 3
| 动作 | 流向 | 作用 | |
| 读文件 (read/fgets) | 磁盘 ➜ 程序内存 | 获取文件内容,不显示 | |
| 写 stdout (printf/fputs/write (1,..)) | 程序内存 ➜ 屏幕 | 把内存内容打印出来 | |
读文件:把磁盘上文件里的数据,读取到程序内存(变量 / 数组)里面。 👉读文件不等于直接打印到屏幕 (stdout)。
- 读:磁盘 → 程序内存(读到数组、buf 缓冲区)
- 输出到屏幕:内存 → stdout(
printf/fputs做这件事)
流程:读文件把内容拿到内存,你自己再写代码把内存里的内容打印到屏幕,才会看到输出。使用read/fputs/printf等
一句话总结
O_RDONLY:open 的参数,控制打开之后这个文件描述符能不能写,只做权限设置,不读取数据。read():系统调用,真正从磁盘读字节到内存,read 必须依靠 open 返回的 fd。
O_RDONLY 是开门权限;read 是伸手拿东西。开门≠拿东西。
配套记忆
- open:开门,获取文件描述符,设置权限 (O_RDONLY/O_WRONLY/O_RDWR)
- read:拿数据进来(磁盘→内存)
- write:把数据送出去(内存→磁盘)
- close:关门
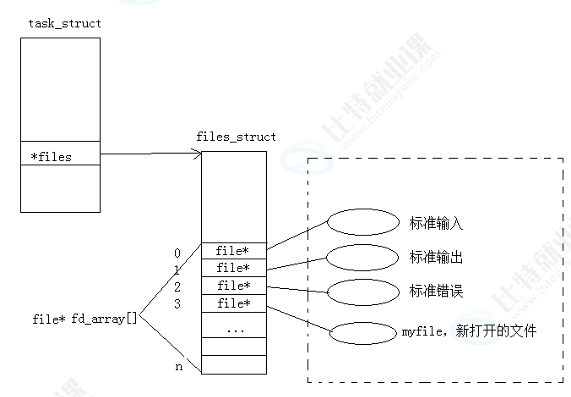
为什么打印3
因为系统自动打开了
stdin 标准输入 键盘 fd: 0
stdout 标准输出 显示器 fd: 1
stderr 标准错误 显示器 fd: 2
| fd | 名字 | 含义 | 默认目标 |
| 0 | stdin | 标准输入 | 键盘 |
| 1 | stdout | 标准输出 | 屏幕 |
| 2 | stderr | 标准错误输出 | 屏幕 |
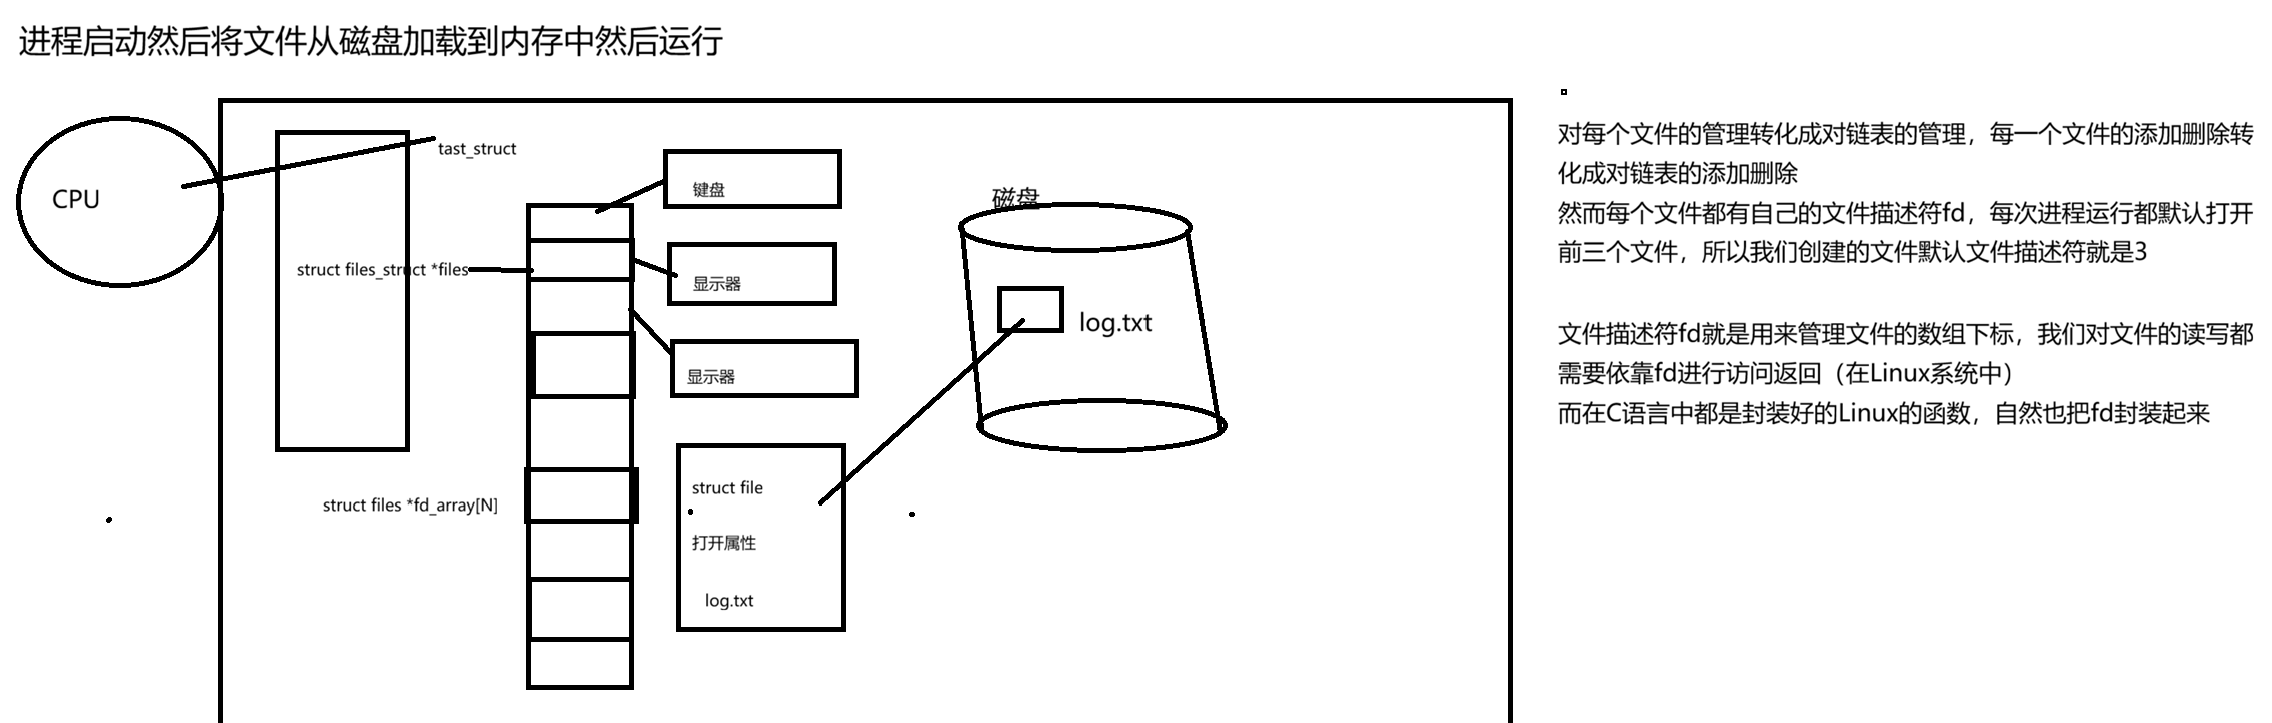
对Linux一切接文件
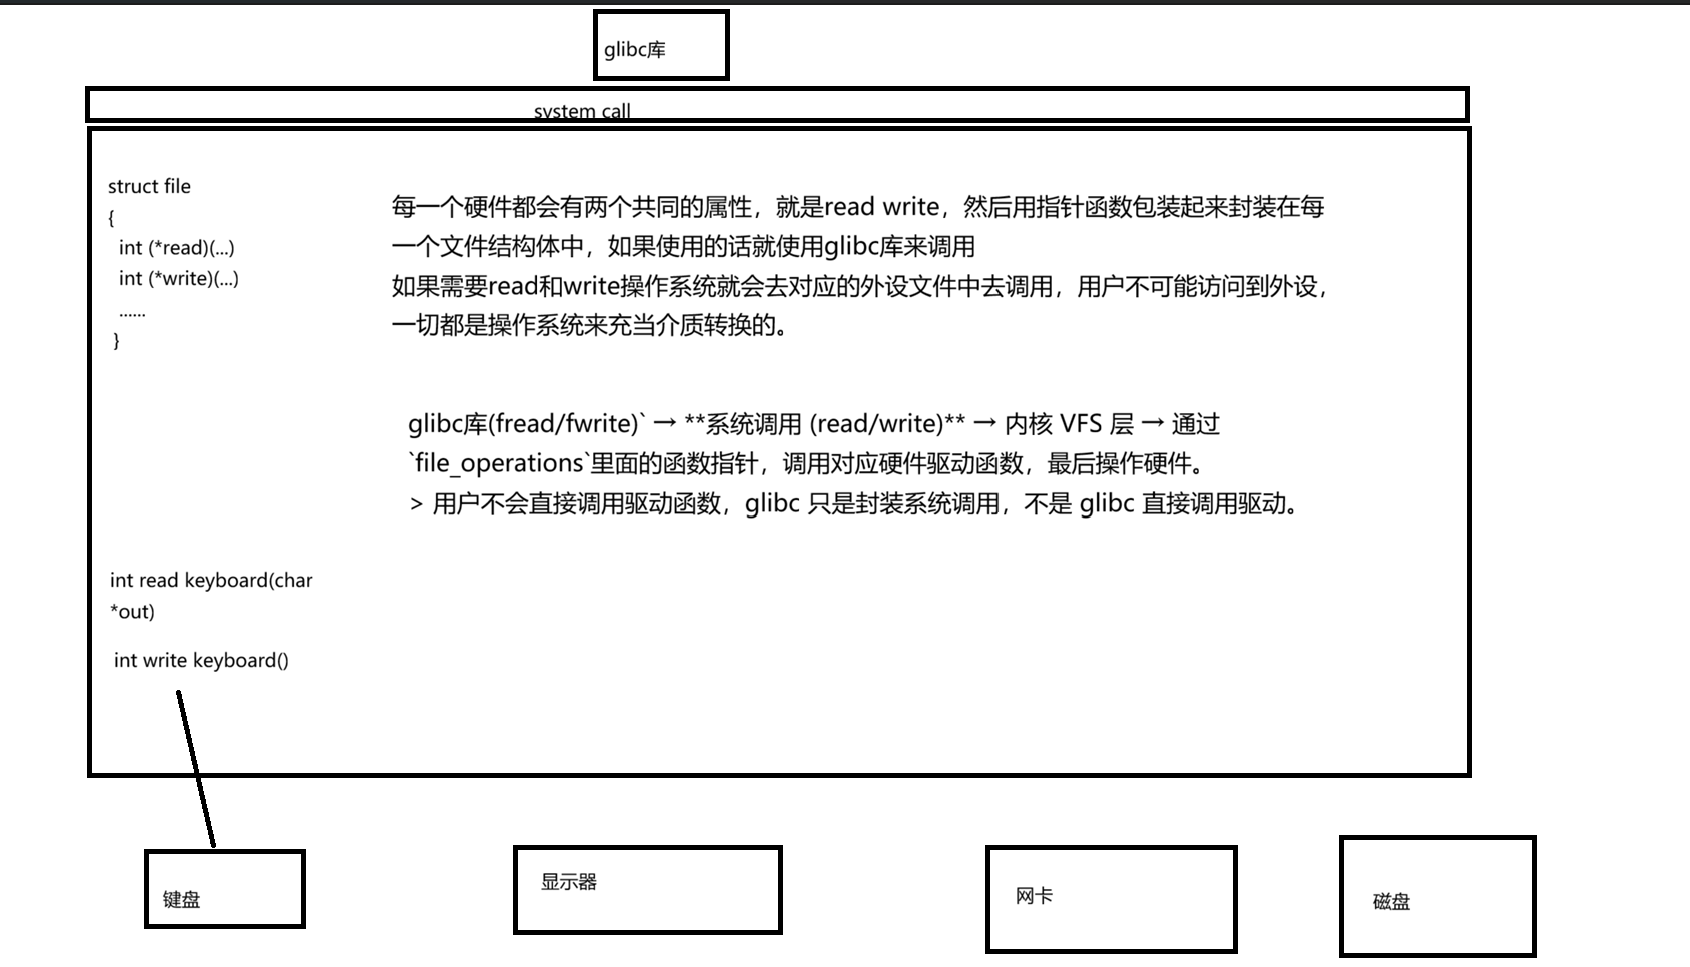
重定向
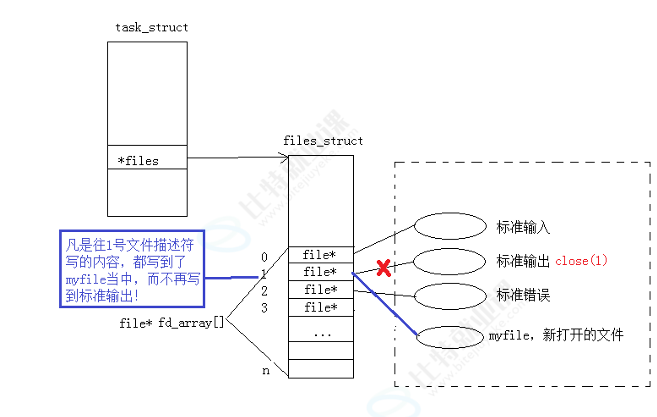
重定向本质:
改变文件描述符指向,把本来输出到 A 的内容,改输出到文件 / 别的地方。
输出重定向 > 、>>
> 覆盖重定向(等价O_WRONLY | O_CREAT | O_TRUNC)
ls > out.txt
# ls本来打印到屏幕(fd1),现在写到 out.txt,文件原有内容全部清空
>> 追加重定向(等价O_WRONLY | O_CREAT | O_APPEND)
echo "hello" >> log.txt
# 写到文件末尾,不删除旧内容
2代表 stderr(错误信息)
#错误信息写入err.txt,正常输出依旧屏幕
cat nofile.txt 2> err.txt
dup和dup2函数
头文件:#include <unistd.h>
int dup(int oldfd);
int dup2(int oldfd, int newfd);
1️⃣ dup(int oldfd)
函数行为 传入一个已经打开的文件描述符oldfd,内核会找当前进程里最小的、没有被占用的文件描述符编号,让这个新 fd 和oldfd指向同一个struct file,返回这个新的文件描述符。
示例: 进程默认 fd:0 (标准输入)、1 (标准输出)、2 (标准错误),都被占用。
int fd = open("a.txt", O_WRONLY|O_CREAT,0666); // fd=3
int new_fd = dup(fd);
- 现在最小空闲 fd 是 4,
dup(3)返回4。 - fd=3 和 fd=4,两个编号,指向同一个打开的文件对象。
⚠️注意:文件引用计数 + 1;关闭其中一个 fd,另一个还可以继续读写文件,只有全部 close,内核才真正释放文件对象。
dup 特点
- 只能由内核帮你选新的 fd 编号,你不能指定新 fd 的值。
- 返回值:成功返回新 fd;失败返回
‑1。
2️⃣ dup2(int oldfd, int newfd) (重定向最常用)
dup2(oldfd, newfd):把 oldfd 复制到 newfd,你自己指定 newfd 是几号。
执行逻辑分两步:
- 如果
newfd原本是一个已经打开的有效文件描述符,dup2会自动先 close (newfd),把它关掉。 - 然后让
newfd这个编号,和oldfd指向同一个struct file。 - 返回值:成功返回
newfd;失败返回‑1。
int fd = open("log1.txt", O_WRONLY|O_CREAT|O_TRUNC,0666);
dup2(fd, 1);  // oldfd=fd(3), newfd=1
- fd=1 原本指向显示器(stdout),dup2 自动 close (1),关闭显示器连接。
- 让 fd=1 现在指向 log1.txt 的文件对象。
printf一直往 fd=1 写,输出就写入文件,不再打印屏幕。
dup2 重点细节
- 如果
oldfd == newfd,不会做任何操作,直接返回 newfd,不会 close。 newfd可以是任意数字,比如dup2(fd,1)、dup2(fd,2)重定向 stderr。
| 函数 | 参数 | 新 fd 编号谁决定 | |
| dup(oldfd) | 只传旧 fd | 内核自动选最小空闲 fd | |
| dup2(oldfd, newfd) | 旧 fd + 指定新 fd 编号 | 程序员手动指定 newfd | |
小坑
- dup、dup2 只是复制描述符,不复制缓冲区,共用同一个文件偏移量。一个 fd 写文件移动偏移,另一个 fd 读写也会看到偏移变化。
- 出错记得判断返回值;open 失败得到
‑1,再传给 dup2 会直接出错。 - 头文件必须
<unistd.h>,否则编译警告。
shell 重定向 ./a.out > log.txt
shell 底层就是 fork 子进程,在子进程内部调用dup2()把 fd=1 指向文件,然后 exec 执行程序,程序 printf 就输出到文件。和你代码写dup2(fd,1)做的是一模一样。
缓冲区
概念
缓冲区是内存空间的⼀部分。也就是说,在内存空间中预留了⼀定的存储空间,这些存储空间⽤来缓 冲输⼊或输出的数据,这部分预留的空间就叫做缓冲区。缓冲区根据其对应的是输⼊设备还是输出设 备,分为输⼊缓冲区和输出缓冲区。
缓冲类型
• 全缓冲区:
这种缓冲⽅式要求填满整个缓冲区后才进⾏I/O系统调⽤操作。对于磁盘⽂件的操作通 常使⽤全缓冲的⽅式访问。
• ⾏缓冲区:
在⾏缓冲情况下,当在输⼊和输出中遇到换⾏符时,标准I/O库函数将会执⾏系统调⽤ 操作。当所操作的流涉及⼀个终端时(例如标准输⼊和标准输出),使⽤⾏缓冲⽅式。因为标准 I/O库每⾏的缓冲区⻓度是固定的,所以只要填满了缓冲区,即使还没有遇到换⾏符,也会执⾏ I/O系统调⽤操作,默认⾏缓冲区的⼤⼩为1024。
• ⽆缓冲区:
⽆缓冲区是指标准I/O库不对字符进⾏缓存,直接调⽤系统调⽤。标准出错流stderr通 常是不带缓冲区的,这使得出错信息能够尽快地显⽰出来
特殊刷新:
1. 缓冲区满时; 2. 执⾏flush语句; 3. 进程结束
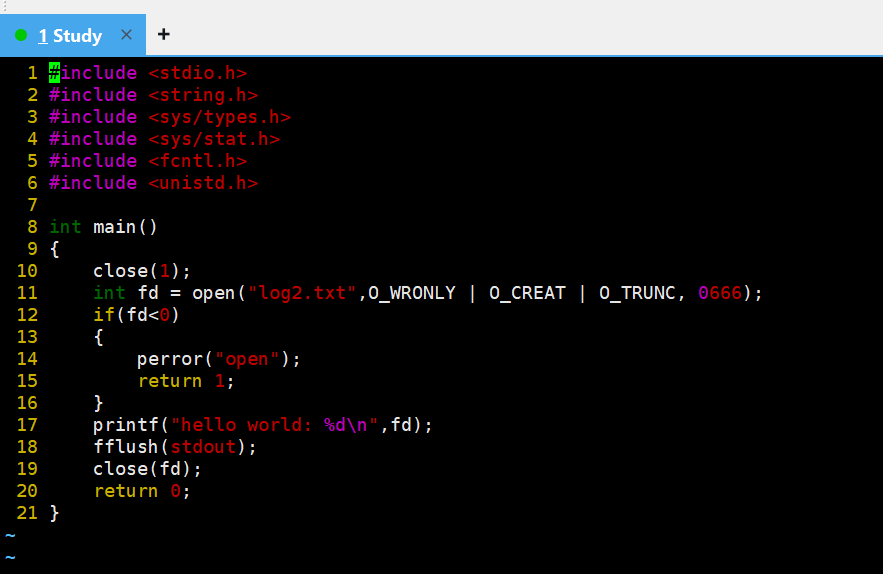
printf属于标准 I/O 库,带用户态行缓冲。
- stdout 本来是终端设备,默认是行缓冲模式:遇到
\n才会把缓冲区数据调用 write 系统调用。 - 但是!当底层 fd 指向普通文件之后,stdout 会自动切换成全缓冲模式!
如果没有 fflush (stdout): printf 的字符串还留在 C 库用户缓冲区,没有执行 write 系统调用;直接 close (fd) 关闭文件,缓冲区的数据丢失,log2.txt 看不到内容。
fflush(stdout):强制把 stdout 用户缓冲区里残留的数据,调用 write 系统调用,写入到文件(fd=1 指向 log2.txt),数据进入内核 Page Cache。
注意:fflush 只刷用户态缓冲区,不刷磁盘;只是把数据交给内核。
printf封装的就是 stdout 流,stdout 内部封装文件描述符 fd=1。当我们 close (1),open 拿到 fd=1,这就完成重定向。- 流 (stdout) 和底层 fd 是两层:
- stdout:C 库 FILE*,带用户缓冲区。
- fd:内核文件描述符。
close (fd) 只会关闭内核层面文件,不会自动刷新 C 库 FILE 缓冲区。缓冲区数据还在进程内存,不手动 fflush,程序退出前丢失。
程序 return 0 正常退出的时候,进程会销毁,库会自动 fflush 所有打开的流;但是这里我们手动提前 close (fd),在 return 之前就关闭底层文件,所以库自动刷新还没来得及执行,文件已经关闭。
printf → stdout【用户缓冲区】(全缓冲)
        ↓没有fflush,不会触发write
close(fd=1) →内核关闭文件
进程后续才会自动fflush,但文件已经关闭 →数据丢失!

printf → stdout缓冲区
fflush(stdout) →调用write(fd=1)数据交给内核
close(fd=1) →文件关闭,数据成功保存
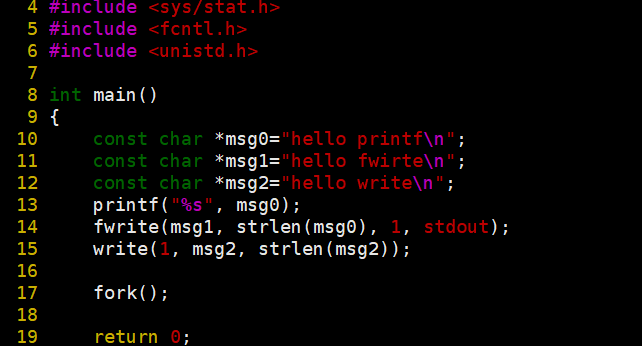
对其进行重定向./test > log3.txt
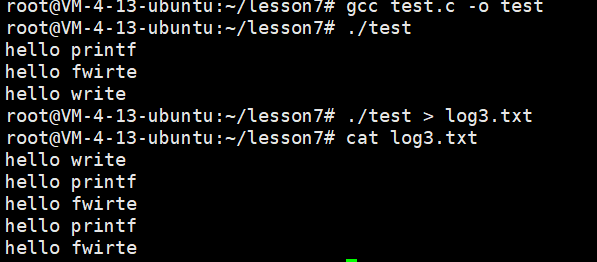
• ⼀般C库函数写⼊⽂件时是全缓冲的,⽽写⼊显⽰器是⾏缓冲。
• printf fwrite 库函数+会⾃带缓冲区(进度条例⼦就可以说明),当发⽣重定向到普通⽂ 件时,数据的缓冲⽅式由⾏缓冲变成了全缓冲。
• ⽽我们放在缓冲区中的数据,就不会被⽴即刷新,甚⾄fork之后
• 但是进程退出之后,会统⼀刷新,写⼊⽂件当中。
• 但是fork的时候,⽗⼦数据会发⽣写时拷⻉,所以当你⽗进程准备刷新的时候,⼦进程也就有了 同样的⼀份数据,随即产⽣两份数据。
• write 没有变化,说明没有所谓的缓冲。
综上: printf fwrite 库函数会⾃带缓冲区,⽽ write 系统调⽤没有带缓冲区。另外,我们这 ⾥所说的缓冲区,都是⽤⼾级缓冲区。其实为了提升整机性能,OS也会提供相关内核级缓冲区,不过 不再我们讨论范围之内。
Buffer(块缓冲区)
面向块设备(磁盘),操作磁盘块。
- 写:程序写数据先写到 buffer,攒一批再刷入磁盘,减少磁盘 IO 次数。
- 读:从磁盘读到 buffer,供程序读取。
作用:合并小块 IO,减少磁盘操作,提升 IO 性能。 现在内核中 buffer 大多被 page cache 接管,buffer 更多用于直接块设备读写。
Cache(Page Cache 页缓存)⭐最重要
Linux 最核心的文件缓存,以内存页(4KB)为单位。
- 读文件:磁盘数据读到 page cache;后续读直接读内存,不用访问磁盘。
- 写文件:数据先写入 page cache(脏页),内核后台线程 (
pdflush/kswapd) 定期把脏页刷回磁盘。
脏页 (dirty page):cache 里已经修改,但还没同步到磁盘的数据。
用户态缓冲区 vs 内核缓冲区
- 内核缓冲区(Page Cache / Buffer):操作系统内核维护,所有进程共享。
write/read系统调用交互。 - 用户态缓冲区(C stdio 库):C 库 (fopen/fread/fwrite) 自己在应用内存开辟缓冲区。
fwrite()→ 用户缓冲区满 → 调用 write 系统调用进入内核 cache。fflush():清空用户缓冲区,调用 write 交给内核;不刷磁盘。
三种写模式(用户态写文件和缓冲区关系)
- 标准写(默认):write () 写入 Page Cache,返回成功≠数据落盘!数据还在内存缓存,断电丢失。
fsync(fd):强制把该文件 cache 脏页刷到磁盘,阻塞等待磁盘完成。O_DIRECT:绕过 page cache,直接读写磁盘,无操作系统缓存,应用自己管理缓冲区。适合数据库。
⚠️
fflush()是 C 库用户态缓冲区刷新,和 Linux 内核 page cache 不是一回事! fflush 只把 C 库缓冲区数据交给系统调用 write,不会刷磁盘,想要落盘需要再调用 fsync。
Linux IO 数据流简图(文本版)
普通 C 库写文件流程:fwrite()
【应用程序内存】
       ↓
fwrite() →【C stdio 用户态缓冲区】(用户空间,C库维护)
       ↓ fflush() /缓冲区满 /fclose()
write()系统调用 →【内核 Page Cache 页缓存】(内核空间,脏页)
       ↓ 内核后台线程kswapd/flusher定时刷盘 / fsync()强制刷盘
【磁盘】
重点区分:
fflush():只把数据从用户缓冲区推到 Page Cache,不落到磁盘。fsync(fd):把 Page Cache 里该文件脏页真正刷入磁盘硬件,返回才代表持久化完成。
直接系统调用 write ()(无用户态缓冲区)
【应用内存】
      ↓
write()系统调用 →【内核 Page Cache】(标记为脏页)
      ↓ fsync() /内核定时回写
【磁盘】
write 返回成功,数据只在内存 Page Cache,断电丢失。
O_DIRECT 模式(绕过 Page Cache)
【应用内存】
      ↓
write(O_DIRECT) → 绕过Page Cache
      ↓ 直接块IO
【磁盘】
读文件流程(Page Cache 命中 / 未命中)
read()系统调用
       ↓
检查 Page Cache
├─命中:直接拷贝数据到用户内存,不访问磁盘 ✅
└─未命中:内核发起磁盘读 → 数据载入Page Cache → 拷贝到用户内存
| 层级 | 位置 | 谁管理 | 关键函数 | ||
| 用户态缓冲区 | 用户空间 | C stdio 库 | fwrite、fflush、fclose | ||
| Page Cache(内核缓冲区) | 内核空间 | Linux 内核 | write/read系统调用、fsync | ||
| 磁盘硬件 | 硬件 | 磁盘控制器 | 物理持久化存储 | ||
面试题
fflush ≠ fsync:fflush 清用户缓冲区;fsync 刷内核缓存到磁盘,二者缺一不可才能持久化。write()返回成功≠落盘,只是拷贝到内核内存。- buff/cache 高不用担心内存,需要内存时内核自动回收。
- O_DIRECT 绕过 Page Cache,但会丧失内核缓存加速,要自己做缓存,有对齐限制。
close 文件描述符,会不会刷新 stdio 库缓冲区? 不会! close 只是内核系统调用,完全不知道 C 库缓冲区存在。FILE * 缓冲区属于用户空间,必须 fflush。
什么时候 stdout 是行缓冲,什么时候全缓冲? stdout 指向终端:行缓冲;stdout 指向普通磁盘文件:自动切换成全缓冲。本案例中 open 之后,stdout 底层 fd 指向普通文件,切换成全缓冲,就算 printf 带
\n换行符,也不会自动刷缓冲区!这是坑。
Q:free 命令里 buff/cache 占用很高,是不是内存不够?
不是。 Linux 设计哲学:空闲内存就是浪费。把空闲内存拿来做缓存,加速读写。当应用需要内存时,内核会自动回收 buff/cache 给程序使用,看available才是真实可用内存。
Q:write 返回成功,断电数据丢失为什么?
write 只是把数据拷贝到内核 page cache,没写入磁盘。断电内存数据丢失。需要fsync()保证持久化。
Q:O_DIRECT 优缺点
绕过 page cache,减少一份内存拷贝;但是需要应用自己做缓存,IO 对齐限制,性能不一定更高。数据库常用。
Q:sync 命令做什么
把内核中所有脏页缓冲区强制提交到磁盘,阻塞完成返回。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 6
 0
- 0


 已为社区贡献4条内容

所有评论(0)