文件(这里带大家从原理上了解文件,库函数接口不多讲)
1、一个文件读请求,怎么从代码跑到磁盘硬件的
这里我先简单讲讲原理,方便读者阅读后边的内容。
首先用户调用 C /C++库函数(fopen/fread),但是并没有权限直接去访问操作系统、硬件驱动、硬件。C/C++ 库只是做参数封装、维护用户缓冲区。当需要真正 IO 时发起系统调用(open/read),CPU 切换到内核态,内核通过文件描述符 fd 查找内核 fd_array 与 struct file 对象,调用文件系统与驱动访问硬件,完成后将结果返回用户空间。(大白话就是用户只用库函数无法访问到硬件,只能通过库函数然后发起系统调用,再访问硬件)(而文件其实是在磁盘上的,磁盘是外设,访问外设就要访问硬件,所以我们上边才想法设法的想要访问硬件)
用户—>库函数—>系统调用—>内核—>硬件驱动—>硬件(大概为了方便可以这样理解)
这里会有语言缓冲区和系统缓冲区的知识,下文我讲了缓冲区然后再带大家理解一下这里的内容。
2、文件接口简单样例
下面给出 fopen 的简单接口样例,演示如何打开文件、写入内容并关闭文件。
#include <stdio.h>

int main()
{
    // 以写方式打开文件,若不存在则创建
    FILE *fp = fopen("test.txt", "w");
    if (fp == NULL)
    {
        perror("fopen");
        return 1;
    }

    // 向文件写入内容
    fprintf(fp, "hello fopen\n");

    // 关闭文件
    fclose(fp);

    return 0;
}
fopen 返回的是 FILE* 指针,它封装了文件流的相关信息(如缓冲区、文件描述符等)(这个是C语言层面封装的FILE)。
fopen是c语言层面的库函数,然后它底层封装的是open这个函数,他是系统调用的函数,这里就体现第一个话题讲的那个顺序了。
open他的返回值是fd,也就是文件描述符,具体这个作用是啥,等我下边讲了访问文件的本质就明白fd有啥用了,这里只是简单带大家见见世面(如何使用fopen)。
3、了解进程到文件的整个过程(这里重点了解文件描述符fd)
这一部分就是从细节上了解是怎么从代码跑到硬件磁盘的,然后讲讲每一部分下边存放的内容是啥?
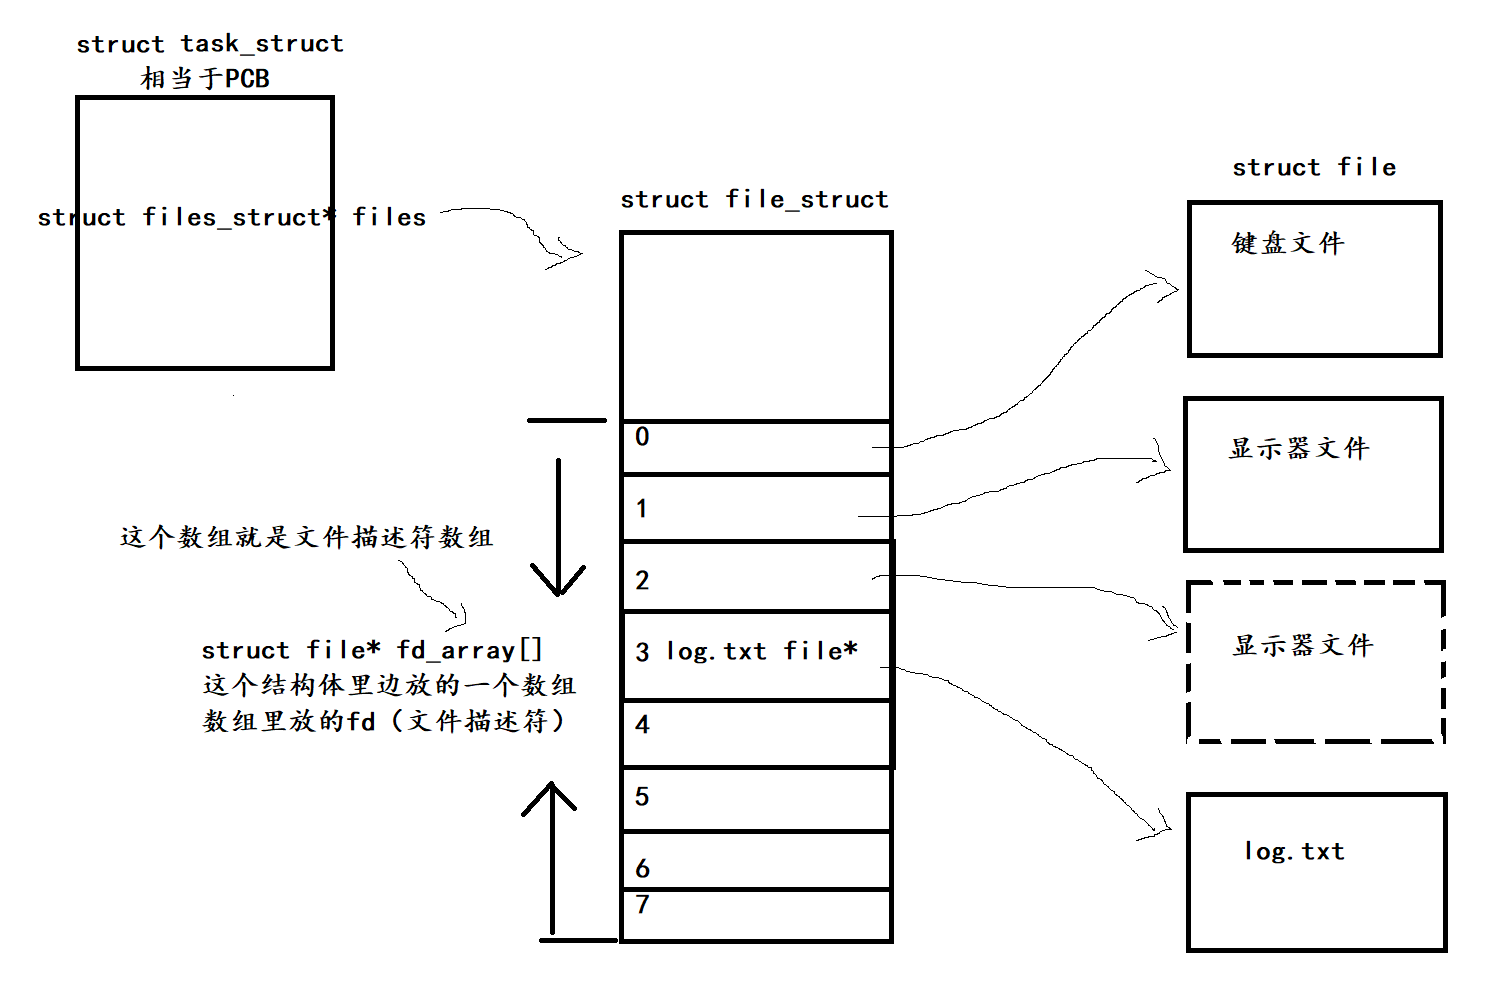
首先一个进程有一个进程总控制块 struct task_struct,它里面有一个 files 指针,指向 struct files_struct 结构体;这个结构体内部包含文件描述符数组 fd_array[],数组的下标就是我们说的文件描述符 fd,数组里存的是指向 struct file 的指针。
数组的前三项 0、1、2 分别对应标准输入stdin、标准输出stdout、标准错误stderr(但是这里需要注意的是我这里的2指向的是和1是同一个struct file, 我这里画俩个是方便理解),默认都指向终端设备。新打开的文件会从 3 号开始分配文件描述符。
fd 由操作系统按最小可用原则分配:有空闲的小编号时,优先分配小编号。
4、从文件层面学习重定向
重定向本质就是修改fd指向的struct file,函数里重定向用的是dup2(oldfd,newfd)。
首先来讲讲这里的dup2这个函数,整体理解就是删除newfd的指向,保留oldfd的指向。
举个例子就瞬间明白。
#include <stdio.h>
#include <unistd.h>
#include <fcntl.h>

int main() {
    // 1. 打开目标文件,得到文件描述符 fd(系统默认分配 3)
    int fd = open("log.txt", O_WRONLY | O_CREAT | O_TRUNC, 0644);
    if (fd == -1) {
        perror("open");
        return 1;
    }

    // 2. 核心重定向:让 1号(标准输出)指向 fd 对应的文件
    // 原本 fd=1 指向终端屏幕,现在改成指向 log.txt
    dup2(fd, 1);

    // 3. printf 底层是 write(1, ...),现在会写入 log.txt,不会出现在终端
    printf("这句话会写到log.txt里,不会打印在屏幕上\n");
    printf("标准输出已经被重定向到文件了\n");

    // 关闭原始fd,不影响1号的使用(struct file引用计数-1,不为0就还在)
    close(fd);

    return 0;
}
这段代码是实现输出重定向,本来正常时输出到fd=1(也就是显示器)上,因为dup2改变1指向的是open打开的这个log.txt的这个struct file这一部分,所以输出到这个文件里边。
画图理解就如下:
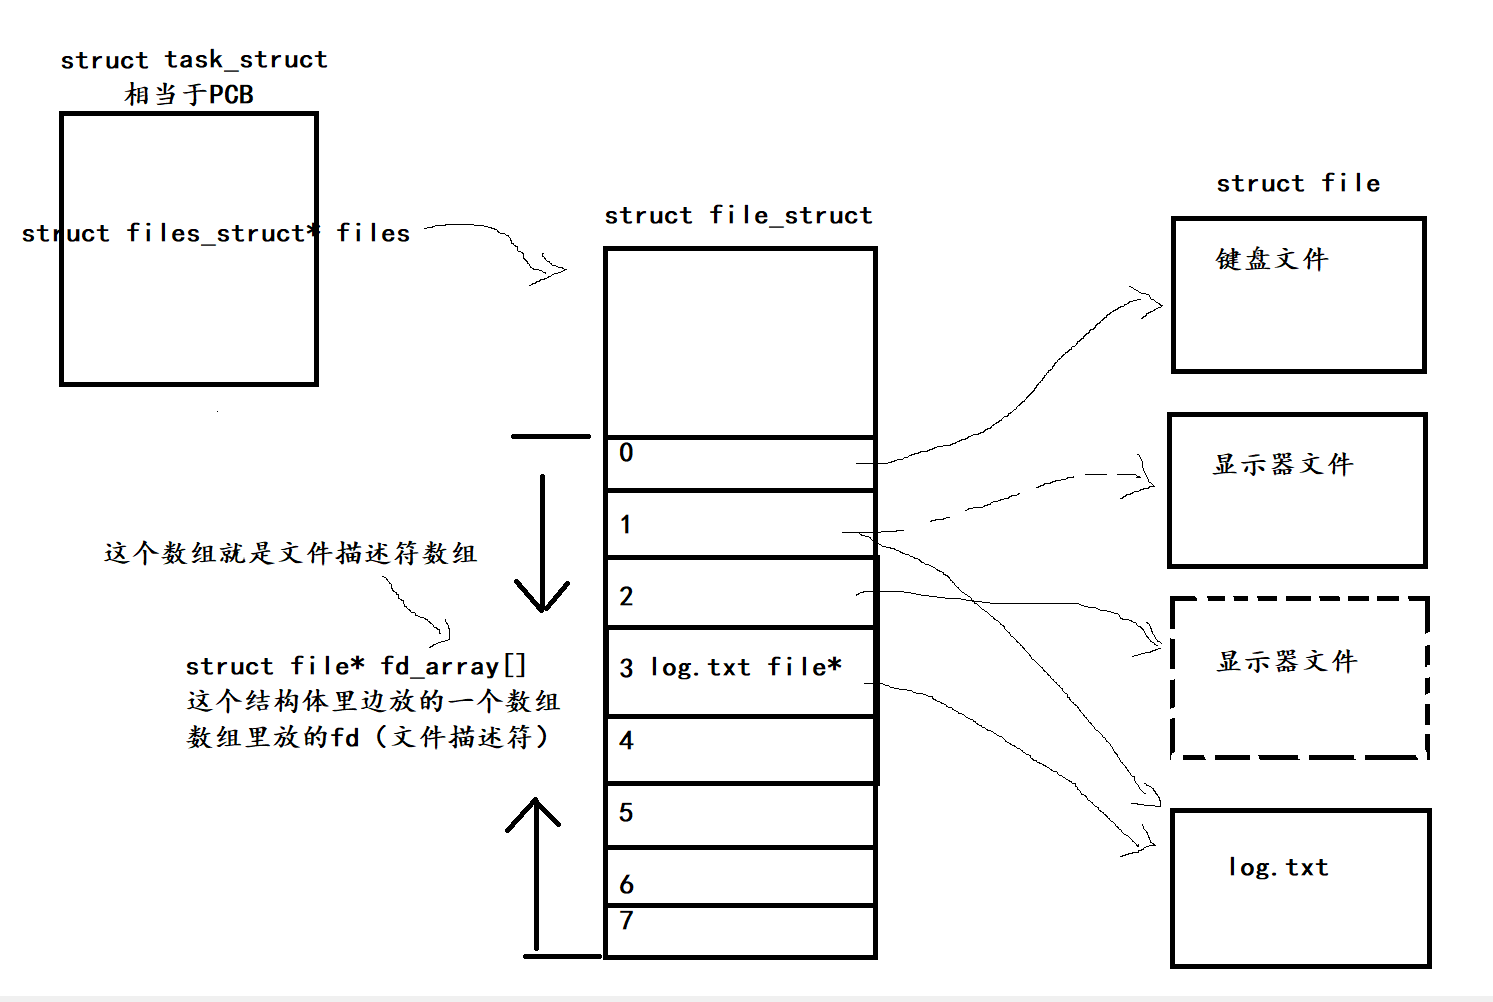
此时1指向的就是log.txt,所以往1里边写内容(write(1,内容,内容的字节大小),此时写入的就是log.txt文件)
注意:这里的dup2分清楚第一个参数和第二个参数对应的意思,然后dup2完成的就是对于不同下标的fd里边存放指针内容的拷贝。
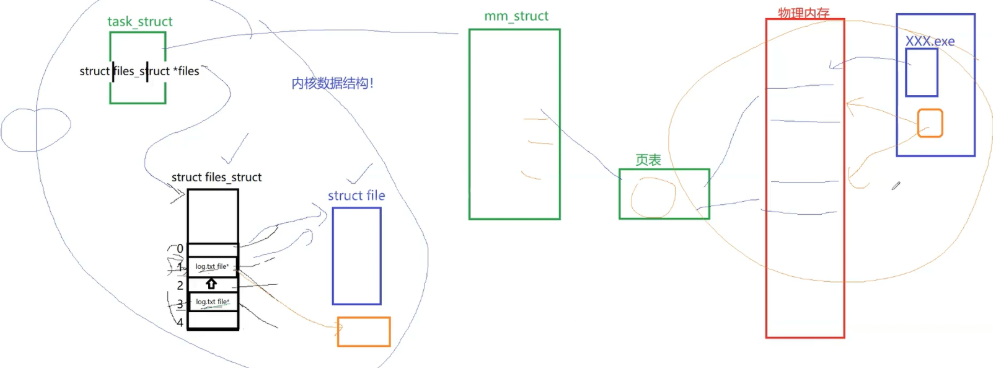
拓展思考:如果进程替换,会不会影响到这里的文件描述符?(大概的原理如下图所示,大家可以按照图自己拓展的了解一下进程替换)
5、文件描述符数组012 中1和2有啥区别呢?
上边的画原理图里边我讲到fd的1和2应该指向的是同一个struct file,画俩个是方便理解,这里我单独讲讲俩个的区别。
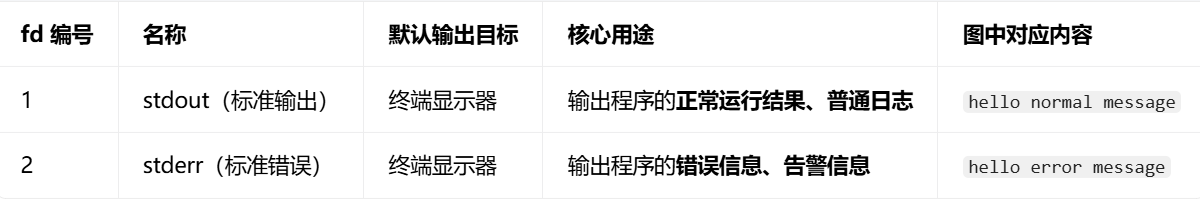
这里还有个核心的区别就是缓冲区刷新的区别(可以先跳到7了解了缓冲区再来看这个区别)
对于标准输出(fd=1)来说,是行刷新和全刷新
对于标准错误 (fd=2)来说,是无刷新,只要调用输出函数,内容立刻写入目标设备。
举个例子说明二者是完全独立的文件描述符。
1. 分开重定向(各自输出到不同文件)
./mytest 1>normal.log 2>err.log
- 1 号标准输出重定向到
normal.log,只存正常日志; - 2 号标准错误重定向到
err.log,只存错误日志; - 二者完全分离,互不干扰,适合生产环境日志分类。
2. 合并重定向(都输出到同一个文件)
# 两种写法完全等价,> 默认就是 1>
./mytest 1>all.log 2>&1
./mytest >all.log 2>&1
- 第一步:把 1 号的指向改成
all.log文件; - 第二步:
2>&1表示「把 2 号重定向到 1 号当前指向的位置」,也就是同样指向all.log; - 最终效果:正常输出和错误输出都写入同一个文件。
6、理解Linux中一切皆文件
这里我放一个图,其实就完全可以理解了
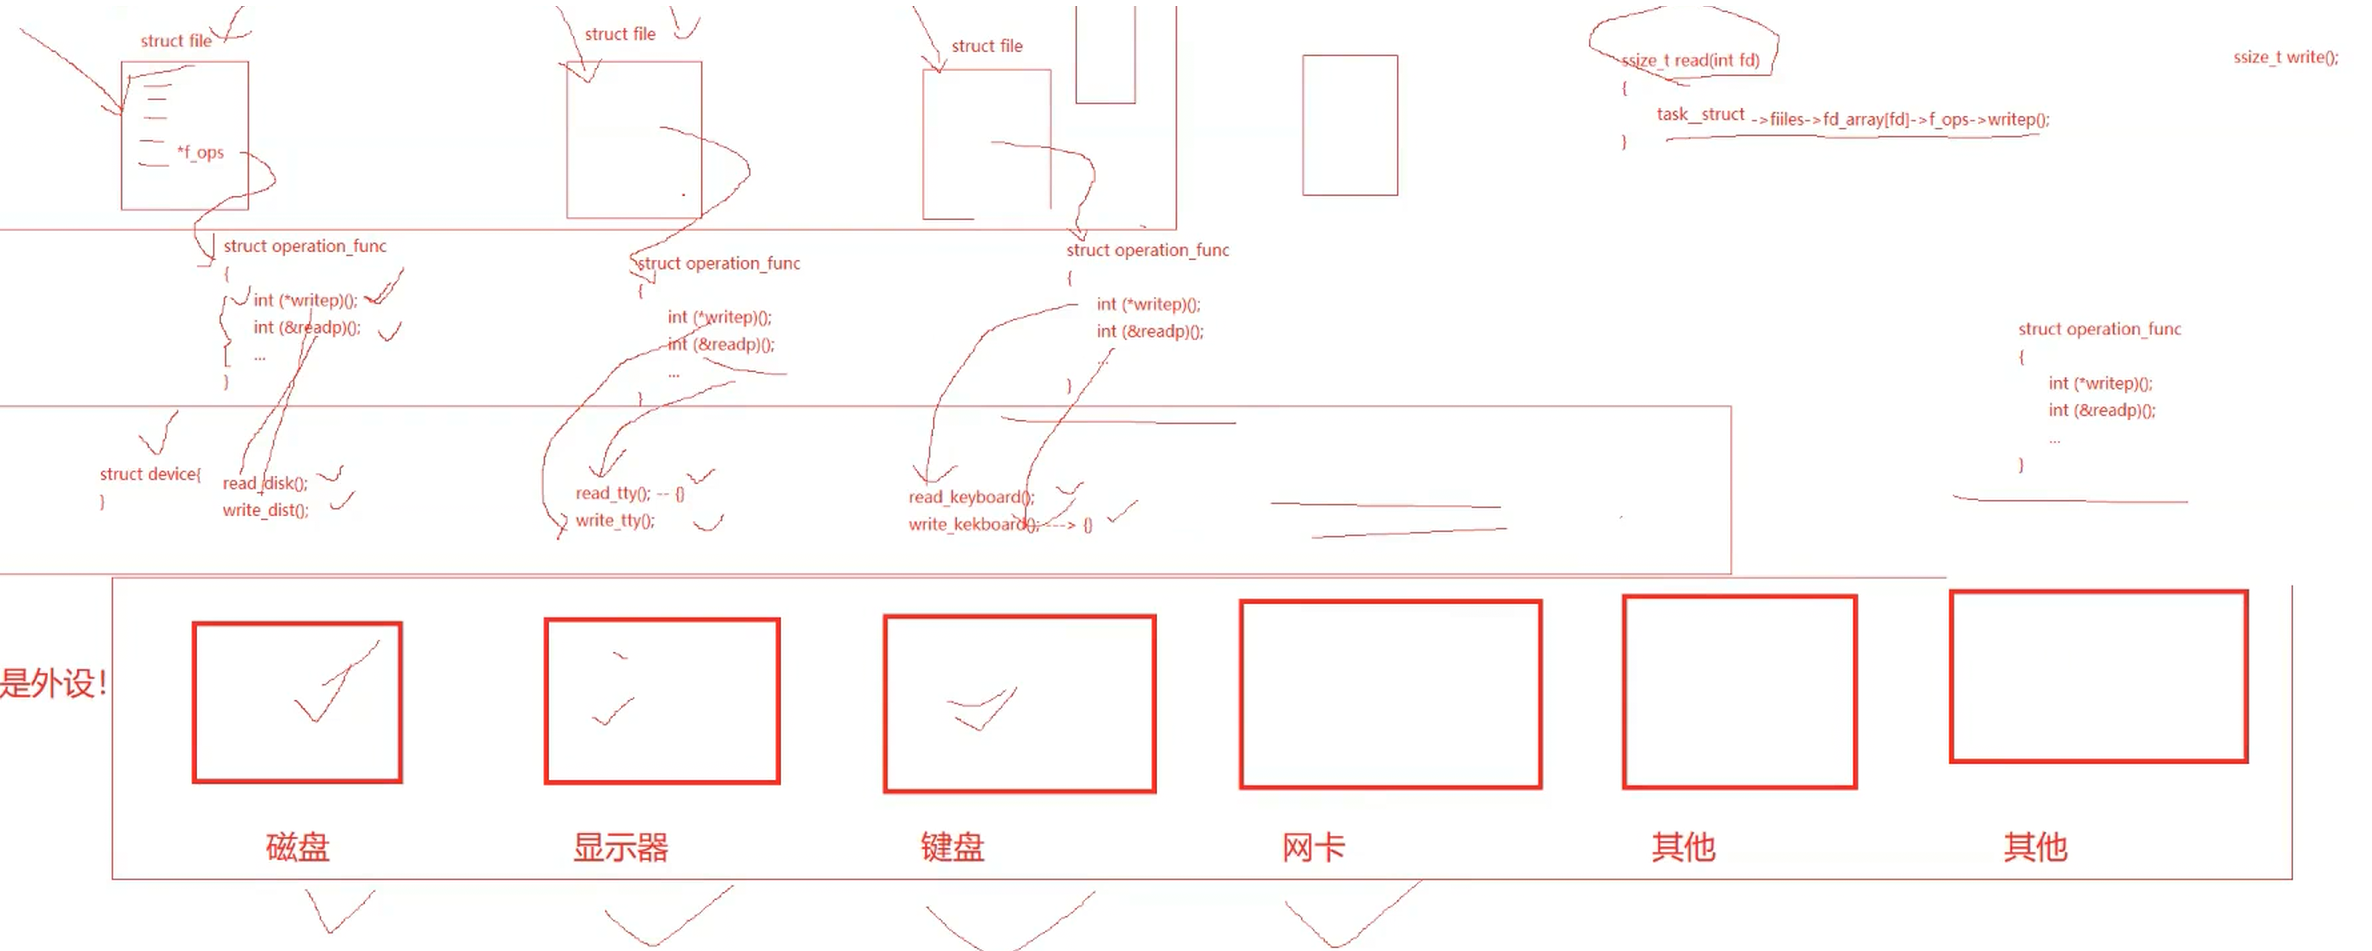
所有外设都被抽象成文件,都可以用统一的文件接口来操作。每个打开的文件对应一个 struct file 结构体,结构体里有一个操函数表指针,指向 struct file_operations 结构体。
不同的外设驱动,会提供各自的 file_operations 实例,里面封装了对应外设的 read、write 等所有文件操作的具体实现。上层调用读写时,内核会通过这个函数指针表,自动跳转到对应外设的驱动函数,完成实际的硬件操作。
其实整体的思路和多态差不多。
上层是统一的 VFS 虚拟文件系统接口,底层靠 file_operations 函数指针表实现多态;应用层只用一套 read/write 就能操作磁盘、键盘、网卡、管道等所有东西,不用关心底层硬件差异。
7、了解系统缓冲区和用户态缓冲区
缓冲区的原理
文件缓冲区和c语言提供的缓冲区不同
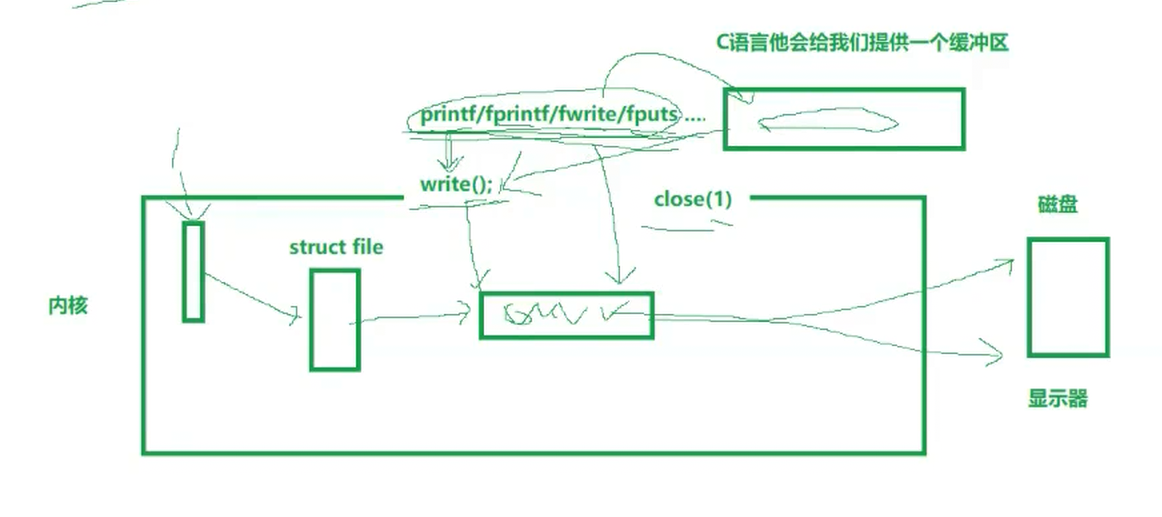
这里的printf这些会将输入的内容先放到c提供的缓冲区里边
然后遇到\n 或者close或者别的导致刷新才会调用系统接口write()将内容写到系统缓冲区(也就是内核里边的)这时候就不受close(1)的限制了,可以在显示器上输出,
但是如果在没有刷新之前就close(1),就相当于把struct file关闭了,那么后续如何刷新,都写不进去系统缓冲区里边,最后就输出不出来。
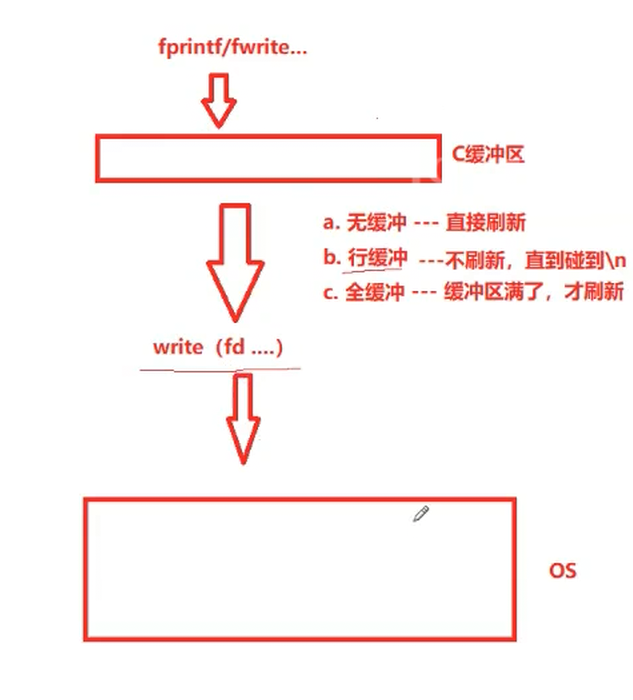
上边这个图就是大概的缓冲区相关的思路。
注意:目前我们认为,只要系统调用write()调用成功,然后写入内核中的系统缓冲区里,就可以将数据到硬件了,目前我们主要了解的是上层的原理。
刷新的分类
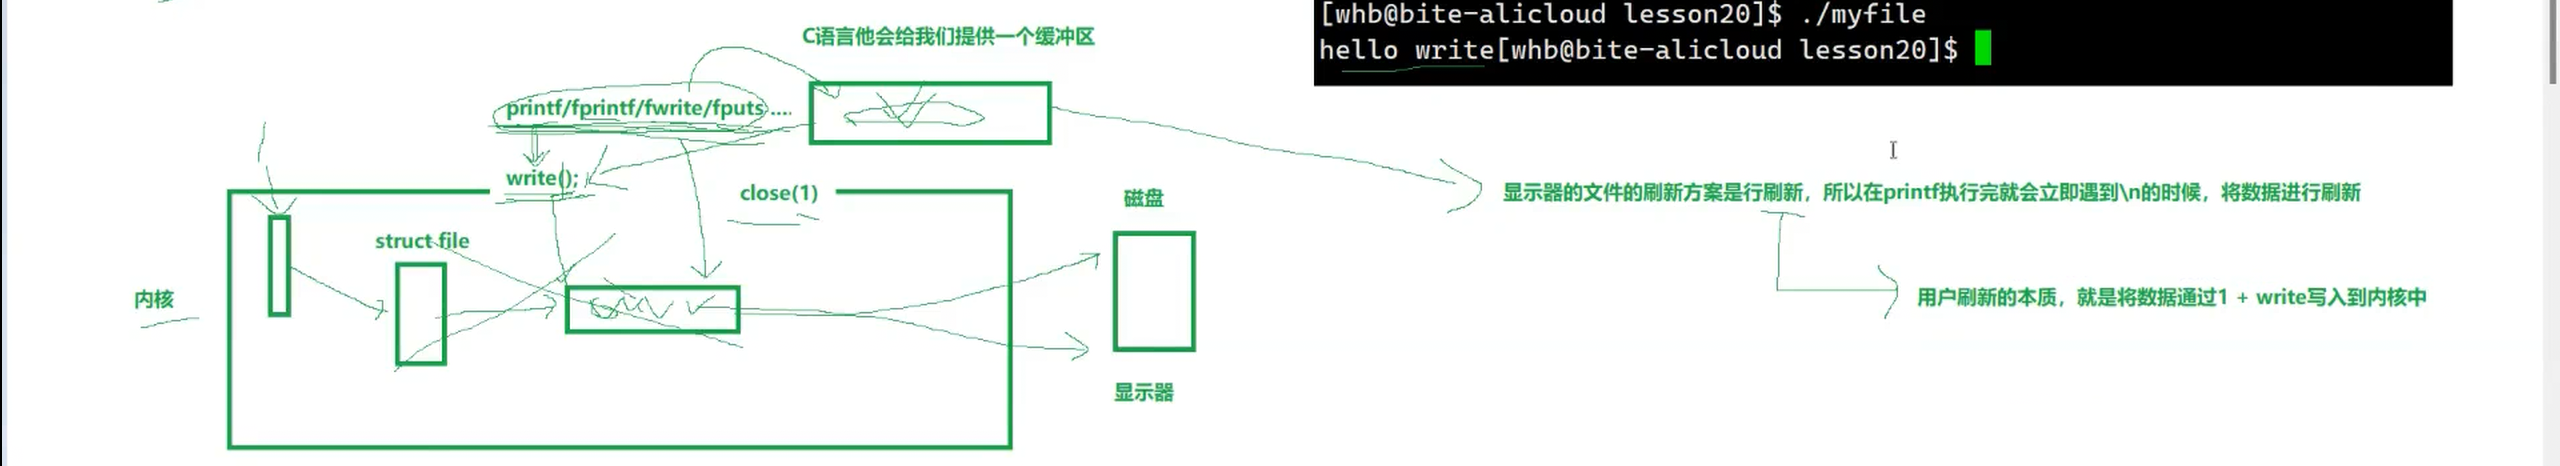
这里解释刷新的意义,然后刷新分的是三种,
1.一般行刷新就是在显示器打印的时候
2.文件的时候是全刷新
3.一般进程退出return 不管是哪种刷新都是会刷新的。
问题:这里根据刷新方式判断下边这段代码会输出什么内容?
#include <stdio.h>
#include <string.h>
#include <unistd.h>
int main(void)
{
const char *fstr = "hello fwrite\n";
const char *str = "hello write\n";
// ========== C 标准库 IO:自带用户态缓冲区 ==========
printf("hello printf\n"); // stdout -> fd=1
sleep(2);
fprintf(stdout, "hello fprintf\n"); // stdout -> fd=1
sleep(2);
fwrite(fstr, strlen(fstr), 1, stdout);
sleep(2);
// ========== 系统调用:直接进入内核,无用户态缓冲区 ==========
write(1, str, strlen(str)); // 直接操作 fd=1
sleep(5);
// close(1); // 打开此行可测试:提前关闭标准输出,缓冲区内容会丢失
fork();
return 0;
}
运行结果:这段代码在终端(显示器)上运行时,输出结果如下:
hello printf
hello fprintf
hello fwrite
hello write
hello printf
hello fprintf
hello fwrite
一共 7 条输出。
前 4 条是父进程在 fork() 之前打印的:其中 printf、fprintf、fwrite 属于 C 标准库函数,数据先进入用户态缓冲区,遇到 \n 触发行刷新后写入内核;write 是系统调用,直接写入内核,所以也立即输出。
fork() 之后,子进程通过写时拷贝复制了父进程的地址空间,此时父进程缓冲区中仍残留着尚未刷新的 3 条数据(hello printf、hello fprintf、hello fwrite),子进程退出时也会刷新自己拷贝的那份缓冲区,于是这 3 条又被打印了一遍,最终得到 7 条输出。
为什么要有缓冲区?
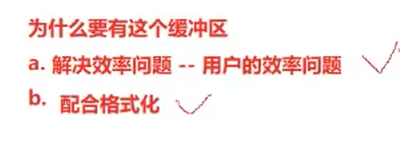
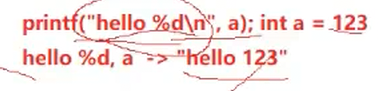
比如输入的是数字123 但是系统内部其实是要把123分别转换为字符的1 2 3然后放到字符串里边 最后才输出 那么这一步的操作就是格式化也就是在缓冲区这一时期完成的
那么用户态缓冲区在哪呢?
在 FILE 这个结构体当中,他里边还有fd
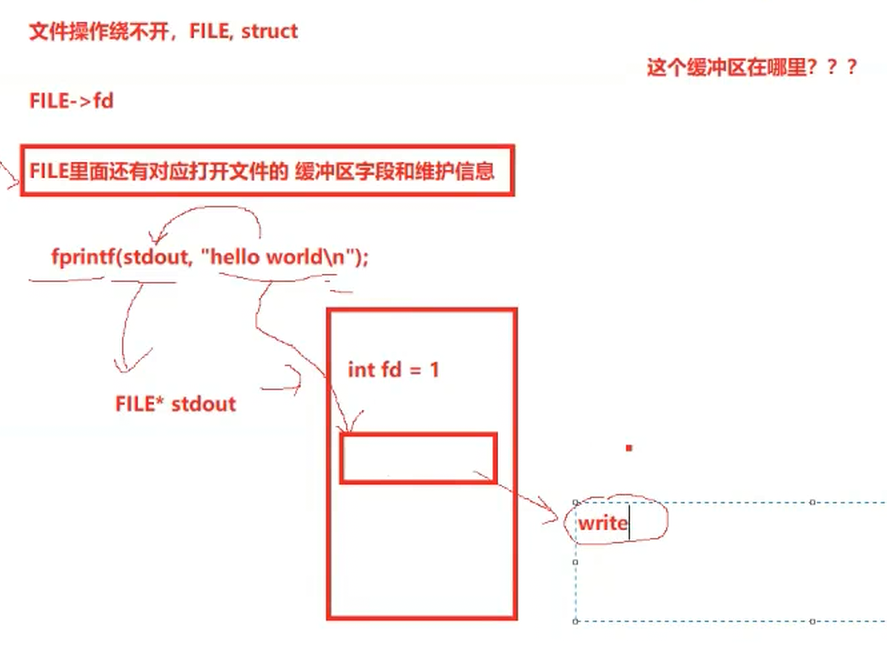
讲讲这里的FILE是如何找到struct file的?
FILE 内部保存着 _fileno(即 fd 编号,比如 stdout 对应的就是 1)。
当需要真正写入内核时,C 库会拿着这个 fd 编号,调用 write 系统调用,陷入内核。
内核收到 fd 编号后,去当前进程的 files_struct → fd_array[fd] 里,找到对应的 struct file * 指针。
后续所有真正的文件操作,都通过这个内核里的 struct file 来完成。
那么系统缓冲区在哪?
通俗的理解为在struct file里边的一个指针,然后这个指针指向外部的 address_space,这个结构体内部有个papa_tree这里边。(这里简单知道大体在哪后续文章里讲)
8.了解文件是有内容+属性的方式存储的(也是讲磁盘里的内容)
8.1先看现象
磁盘里边存放的文件的内容和属性是分开的 然后inode table里边村放的是文件的属性,但是没有文件名字, 只有文件编号。
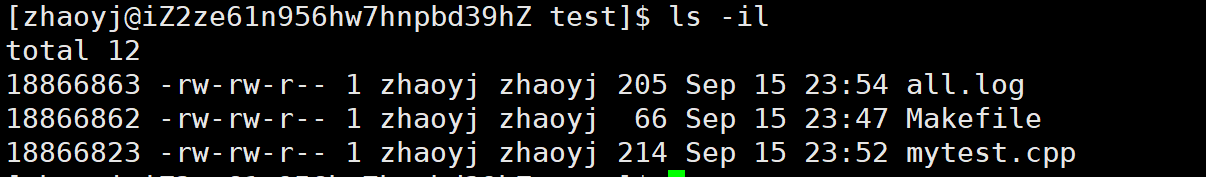
注意这里就是查看文件编号的方式,其中18866823就是当前mytest.cpp的文件编号也就是inode
8.2再讲原理
从磁盘到文件(软件)的内存分配
首先是分区 然后分组 然后一个组里边放着相同结构的东西
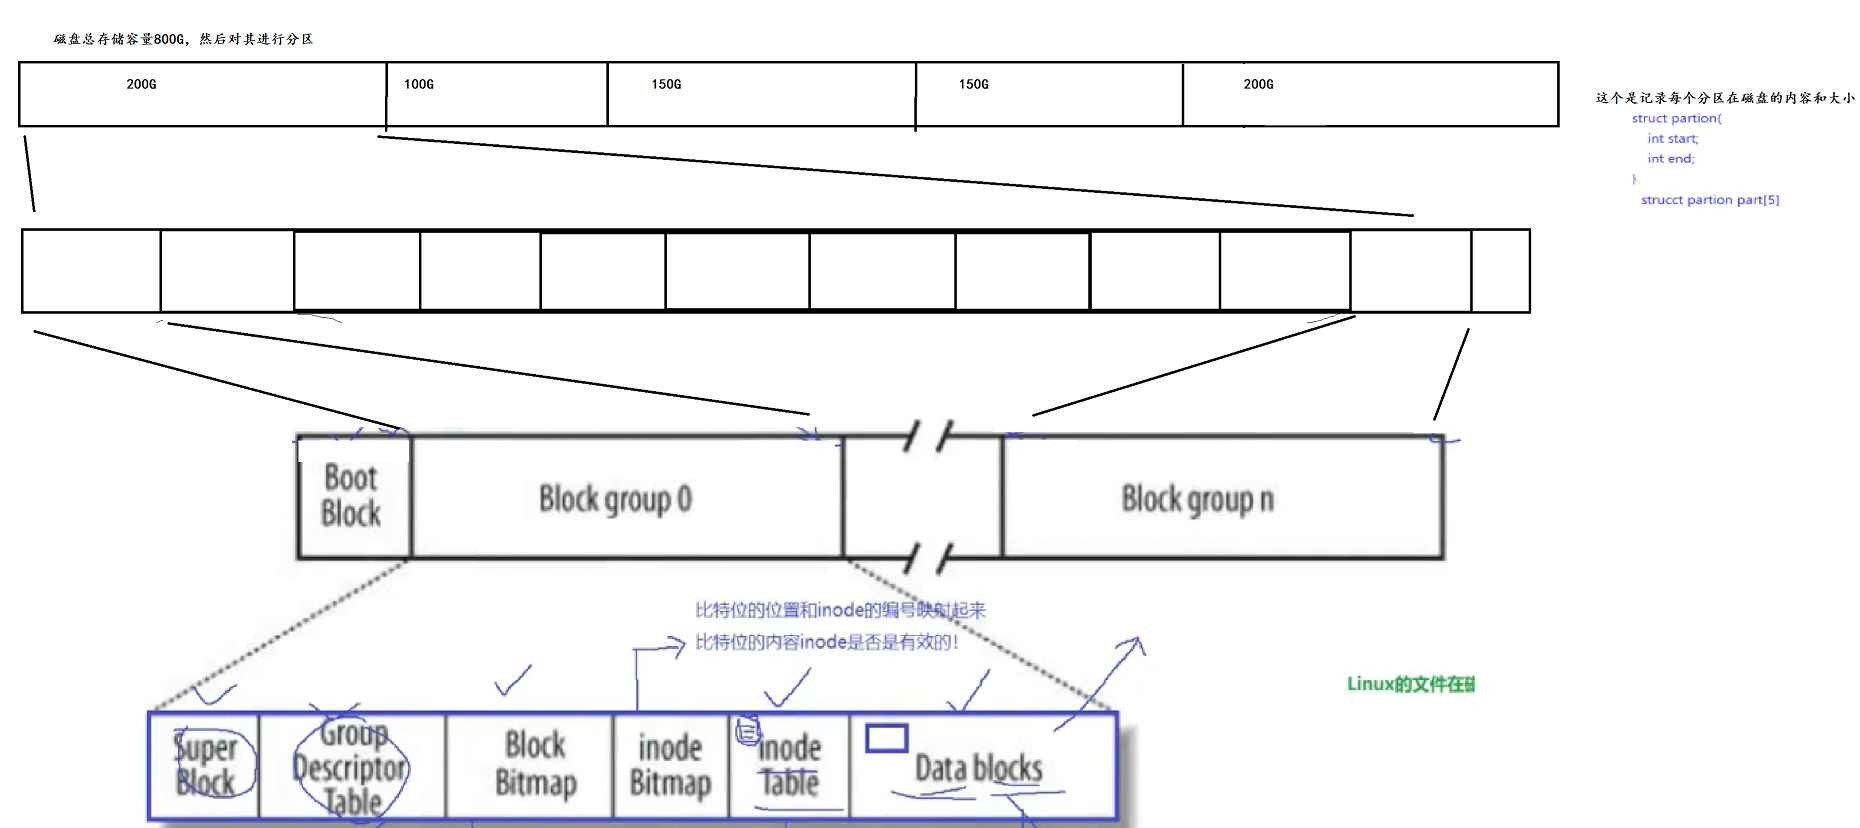
首先对应的是一个磁盘的存储内存大小是800G,然后对其进行分区,struct partition part[5]就是对这几个分区的管理,每个分区结构体里记录 start(起始扇区)和 end(结束扇区),用来定义每个分区在磁盘上的位置和大小。
然后就是对一个区进行分组,组的大小是相同的,除了最后一个因为不一定刚好可以分。
其中第一个组是Block group0,然后一个组里的结构如上图所示,
下面把 Block group 里各个部分分别放的是什么内容,以及它们之间的关联梳理一下:
- Super Block(超级块):存放整个文件系统的全局信息,比如总块数、总 inode 数、块大小、每个组有多少块等。它是整个文件系统的"总目录",其他组的管理都依赖它。(并不是每个组都有这一个超级快)。
- Group Descriptor Table(组描述符表):记录每个 Block group 的元信息,比如该组的 block bitmap、inode bitmap、inode table 分别在哪,以及组内空闲块和空闲 inode 的数量。它相当于每个组的"索引卡"。
- Block Bitmap(块位图):用一位(bit)对应组内的一个数据块,1 表示该块已被占用,0 表示空闲。分配数据块时,系统就是通过查这张位图找到空闲块的。
- Inode Bitmap(inode 位图):用一位对应组内的一个 inode,1 表示该 inode 已被使用,0 表示空闲。创建文件时,系统从这里找一个空闲 inode 来存放新文件的属性。
- Inode Table(inode 表):连续存放多个 inode 结构体,每个 inode 里保存一个文件的属性(大小、权限、时间戳、数据块指针等)和文件编号。注意:inode 里不存文件名,文件名是放在目录项里的。
- Data Blocks(数据块):真正存放文件内容的地方,一个文件的内容会被拆成若干个数据块存放,具体哪些块属于哪个文件,由对应 inode 里的数据块指针来索引。
它们之间的关联可以这样理解:
- 要创建一个文件,系统先查 inode bitmap 找一个空闲 inode(值为0的),再查 block bitmap 找空闲数据块,然后把文件属性写进 inode、内容写进数据块,最后更新两张位图标记为已占用。
- 要读取一个文件,系统先通过目录项找到文件的 inode 编号,去 inode table 里取出该 inode,再根据 inode 里的数据块指针,到 data blocks 里把内容读出来。
- block bitmap 和 inode bitmap 是"记账本",inode table 是"档案室",data blocks 是"仓库",super block 和 group descriptor 则是"总管理员"和"分管理员",它们配合起来才能完成文件的创建、读写和删除。
注意:上边讲到每一个文件的inode都是存放在对应的目录里边的,那么目录也是文件,目录的inode存放到哪里呢?
答案就是存放在上一个目录里边,然后整体都是从根目录开始一一访问的,

但是如果每一次都到根去找,效率太低了,所以创建了一个叫dentry的缓存,里边存放的就是全局里边常用到的inode,这样可以提高一定的效率。
软链接和硬链接
这里可以看博客的别的文章
软链接和硬链接到底有啥作用和区别_软连接和硬链接的区别-CSDN博客
硬链接和软链接的本质区别,就在于它们和 inode 的绑定方式完全不同
1,软链接可以理解成创建一个快捷方式。它和windows下的快捷方式的作用是一样的。
2,硬链接等于cp -p 加 同步更新。

openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)