AI FDE 工程师:打通大模型落地“最后一公里”,金融信创复合型人才成抢手王!
高管摘要:AI 大模型落地已从“Demo 炫技”进入“生产交付”阶段。金融、政企客户要求“数据不出域、系统信创化、交互合规化”,催生出一种兼具“前端界面开发”与“现场私有化交付”能力的复合工程角色——AI 领域 FDE 工程师。本报告从角色定位、能力栈、国内人才市场、两条落地路径、典型金融案例与合规 checklist 等维度,给出可执行的认知地图与行动建议。
核心结论:① FDE 是 AI 价值“最后一公里”的执行者;② “前端+部署+国密+培训”闭环能力是稀缺竞争力;③ 金融信创 AI 项目必须“合规内建”,而非上线前补丁;④ 传统前端/后端/实施工程师均有清晰转型切口。
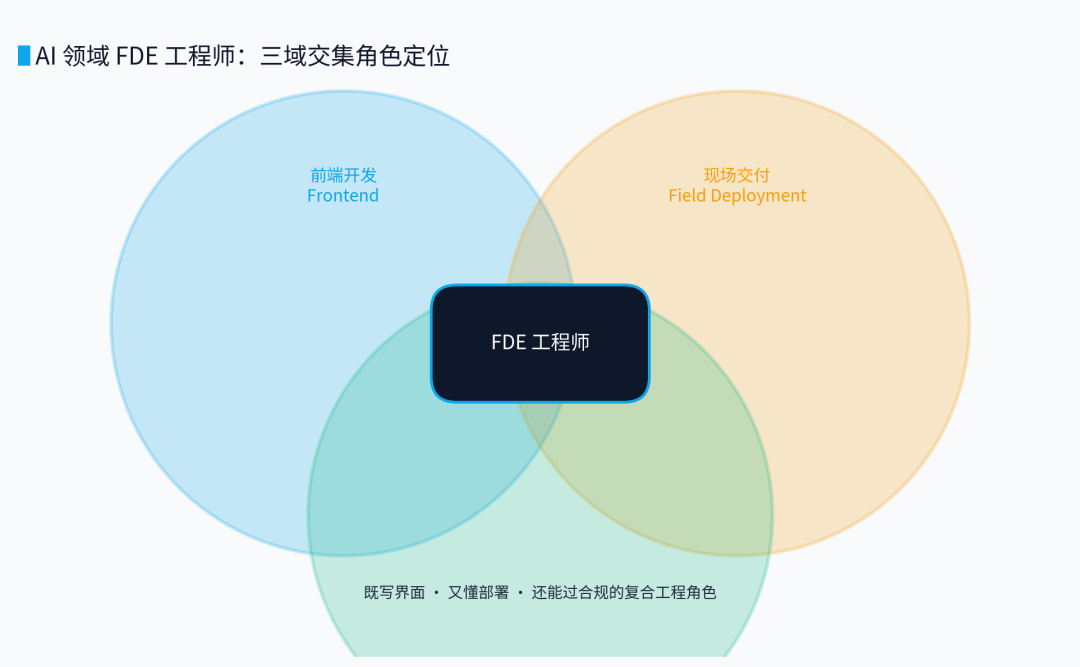
在 AI 应用落地浪潮中,"FDE 工程师"在国内语境下已演化为一个双口径复合角色:
Frontend Development Engineer(前端开发工程师)——负责 AI 产品的人机交互界面,包括对话式 UI、RAG 知识库界面、Agent 编排台、模型评测看板等。
Field Deployment Engineer(现场部署/交付工程师)——负责把 AI/大模型平台在客户侧(尤其金融信创私有化环境)部署落地、集成联调、培训运维。
AI 时代这两类职位高度融合:金融、政企客户要求"前端即交互、交付即合规落地",同一工程师/小队往往既要写 React 界面,又要能在客户机房用 Docker 把模型跑起来、调通国密链路、通过密评。本文拆解该角色能力栈、梳理国内人才与产业现状,并给出职业成长与交付实施两条落地路径,以及面向金融机构的可执行建议。
一、重新定义:AI 领域的 FDE 工程师
1.1 为什么"前端"与"交付"在 AI 领域合流
传统软件交付中,前端、后端、实施是清晰分工。但 LLM/智能体产品有三个特征使边界模糊:
·交互即产品:AI 产品的核心价值大量体现在前端(流式对话、工具调用可视化、Agent 流程编排),"前端工程师"必须懂 LLM 的流式、上下文、工具调用语义。
·私有化刚需:金融/政企数据不出域,AI 系统必须私有化部署,且要过国密、密评、等保——交付不再是"装个客户端",而是包含合规的工程任务。
·小团队作战:企业 AI 项目常由 2~5 人小队交付,要求成员"既会写界面,又能在客户现场把服务跑起来做培训",催生 FDE 复合型角色。
1.2 角色画像与边界
| 维度 | AI FDE 工程师 | 邻近角色 |
| 核心产出 | AI 产品界面 + 客户侧可运行系统 | — |
| 与算法工程师 | 调用/集成模型,不训练基座 | 算法工程师做预训练/微调/RLHF |
| 与后端/平台 | 负责 BFF、前端、交付联调 | 后端做模型服务/网关 |
| 与纯实施 | 实施只部署不写界面;FDE 二者兼具 | 实施偏运维培训 |
一句话定位:AI FDE 工程师 = "能把大模型应用做出来、跑起来、交出去"的复合工程角色,是 AI 价值从 Demo 到生产的"最后一公里"执行者。
二、能力栈拆解
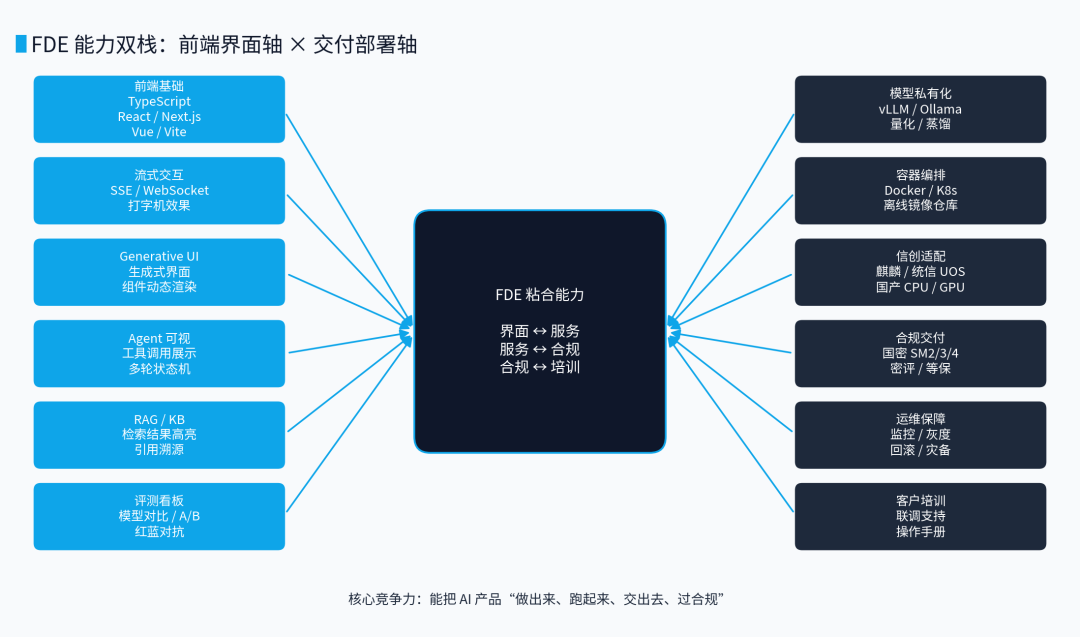
2.1 前端/界面能力(Frontend 口径)
| 能力层 | 具体技能 | 说明 |
| 工程基础 | TypeScript、React/Next.js、Vue、Vite/Webpack | AI 产品前端以 React 生态为主 |
| 服务端粘合 | Node.js BFF、API 网关、SSR | 前端就近做接口编排,降低联调成本 |
| AI 专属前端 | 流式渲染(SSE/WebSocket)、Generative UI、打字机效果 | LLM 输出必须流式,否则体验穿帮 |
| Agent 可视 | 工具调用展示、Agent 流程图、多轮状态机、断点续跑 | 让用户"看见"智能体在做什么 |
| RAG/KB 界面 | 知识库检索结果高亮、引用溯源、问答纯度 | 金融场景强审计需求 |
| 评测看板 | 模型对比、质量指标、红蓝对抗结果 | 支撑模型选型与治理 |
Agent 原生前端框架(2026 关键变量):CopilotKit 是 Agent 原生全栈 SDK,已从 React 库扩展为支持 React/Angular/Vue/React Native 的多平台框架;其提出的 AG-UI 协议已被 Google、LangChain、AWS、Microsoft、Mastra、PydanticAI 等联合采纳,成为 Agent 与前端交互的事实标准候选。
2.2 交付/部署能力(Field Deployment 口径)
| 能力层 | 具体技能 | 金融/信创场景要点 |
| 模型私有化部署 | vLLM / Ollama / 国产推理框架、量化、蒸馏 | 离线环境、权重合规管理 |
| 容器与编排 | Docker、K8s、离线镜像仓库、Helm | 客户内网无外网 |
| 信创适配 | 麒麟/统信 UOS + 鲲鹏/海光/飞腾/龙芯;国产 GPU | x86+NVIDIA → 国产栈迁移是硬需求 |
| 合规交付 | 国密(SM2/SM3/SM4)、密评、等保、数据安全 | 金融交付的"入场券" |
| 运维保障 | 监控、日志、灰度、回滚、灾备 | SLA 与可用性 |
2.3 粘合能力(FDE 的核心竞争力)
FDE 的不可替代性不在单点技能,而在横跨"写界面 → 跑服务 → 过合规 → 做培训"的闭环能力:能在客户现场用 Docker 拉起服务、定位模型推理报错;能把国密 TLS/SM4 存储内建进前后端与部署架构;能做 Prompt/Agent 调试并与 RAG 知识库搭建成业务可交互、可运行、可审计的 AI 系统,并对客户完成培训。
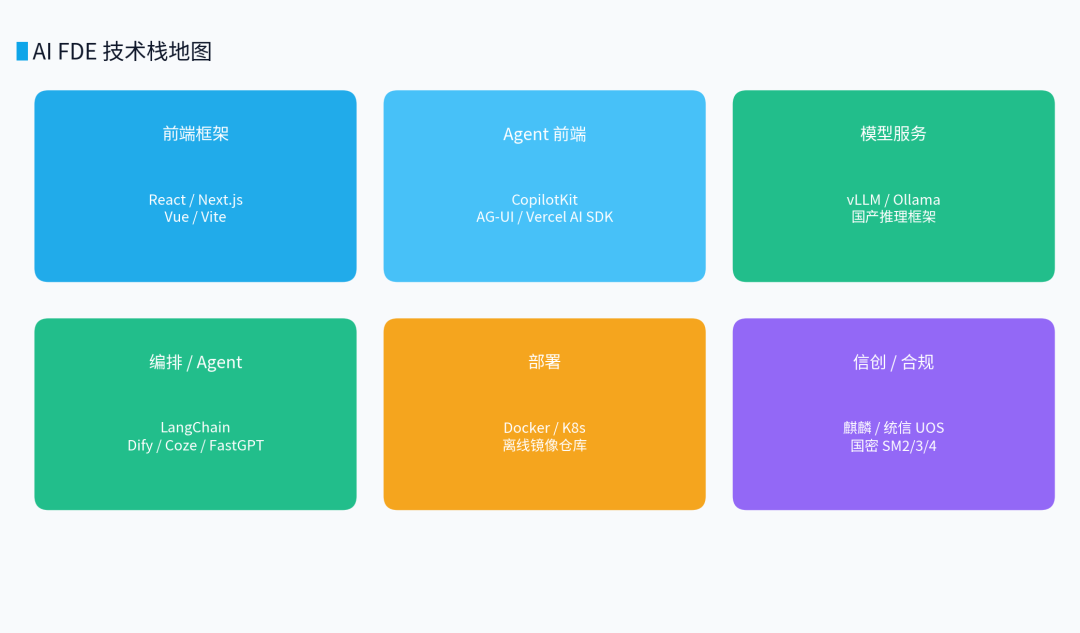
三、主流技术栈与工具地图
| 环节 | 国际主流 | 国内/信创可用 | FDE 关注点 |
| 前端框架 | React/Next.js、Vue | 同上(跨平台) | 流式、组件库 |
| Agent 前端 | CopilotKit(AG-UI)、Vercel AI SDK、LangChain.js | 同上开源可用 | 协议化交互 |
| 模型服务 | vLLM、Ollama、TGI | 百度/阿里/讯飞推理框、国产框架 | 私有化、量化 |
| 编排/Agent | LangChain、LlamaIndex、Dify、Coze | Dify、FastGPT、扣子、智谱/DeepSeek API | RAG + 工作流 |
| 部署 | Docker/K8s | 同上 + 信创 K8s 发行版 | 离线、国密 |
| 合规 | — | 国密算法、密评、等保工具链 | 内建而非补丁 |
四、国内现状(China Situation)
4.1 人才市场:需求分层、结构分层
2026 上半年国内 AI 就业市场关键信号:
| 指标 | 数据 | 来源/说明 |
| AI 岗位招聘量 | 2026 H1 同比增长约 87% | 多家机构一致口径 |
| AI 平均薪资涨幅 | 约 18% | 同上 |
| 大模型基座/Agent 架构岗 | 平均年薪 46.2 万元,同比 +29.3% | 福睿思特 2026 薪资报告 |
| 通用 AI 人才跳槽涨幅 | 20%~30% | 《2026 人才市场洞察及薪酬指南》 |
| 大厂 AI 实习扩招 | 腾讯技术类扩招 36%、字节 AI 实习超 7000 岗 | 2026 春招数据 |
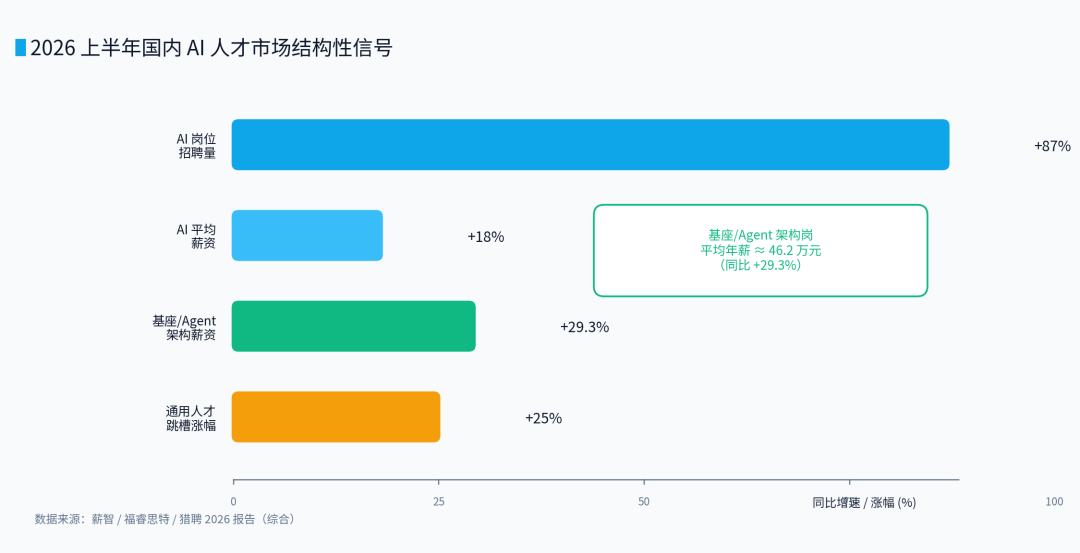
结构性结论:AI 岗位已明显分层——基座/算法(高门槛高高薪)vs 应用/工程(需求大、门槛相对友好)。FDE 工程师落在"应用/工程"层,是普通人/传统前端"入场 AI"的高性价比切入点。应用侧需求增速快于总量,且金融、政企、国企信创方向付费能力强。
4.2 需求端:金融/政企信创 AI 场景
·场景:智能客服、企业知识库/RAG、风控/合规助手、报表 Copilot、Agent 中台、代码助手。
·刚需:数据不出域 → 私有化部署;合规 → 国密 + 密评 + 等保;自主可控 → 信创替代。
·招投标门槛:"AI + 信创 + 国密"组合正成为金融/政企项目中标硬条件,直接拉高对 FDE 复合型工程师的需求。
4.3 生态:平台与基础设施
大模型/API:百度千帆、阿里通义、讯飞星火、智谱 GLM、DeepSeek、MiniMax 等。Agent/应用平台:Dify、Coze(扣子)、FastGPT、LangChain 等,降低应用搭建门槛,但也要求 FDE 会"基于平台做二次开发与私有化封装"。信创 AI 基础设施:昇腾 CANN、海光、寒武纪;麒麟/统信 OS;国产数据库与中间件——构成 FDE 交付的"目标环境"。
五、落地路径一:职业成长路径
适用:传统前端/后端/实施工程师转型,或新人入坑。路径分五阶段,每阶段给出"输入—产出—验证"。
| 阶段 | 输入 | 产出 | 验证 |
| 0 工程底座 | TypeScript、React/Next.js、Node.js BFF、基础 Linux | 能独立交付一个带后端接口的前端应用 | 作品集 1 个全栈小项目 |
| 1 AI 应用能力 | LLM API、Prompt 工程、RAG、Agent/工具调用 | 一个 RAG 问答应用 + 一个简单 Agent | 本地跑通检索→生成→引用溯源 |
| 2 前端 AI 化 | SSE/WebSocket 流式、Generative UI、CopilotKit/AG-UI | 一个交互式 AI 应用(对话+工具调用展示) | 作品集加入交互式 AI 应用 |
| 3 交付与合规 | Docker/K8s、模型私有化、信创、国密/密评 | 在信创/离线环境部署应用并接入国密 TLS | 完成一次客户侧跑通演示 |
| 4 独当一面 | 需求转化、方案编写、客户培训、故障定位 | 独立负责一个金融/政企 AI 子系统交付 | 客户验收+培训完成+运维交接 |
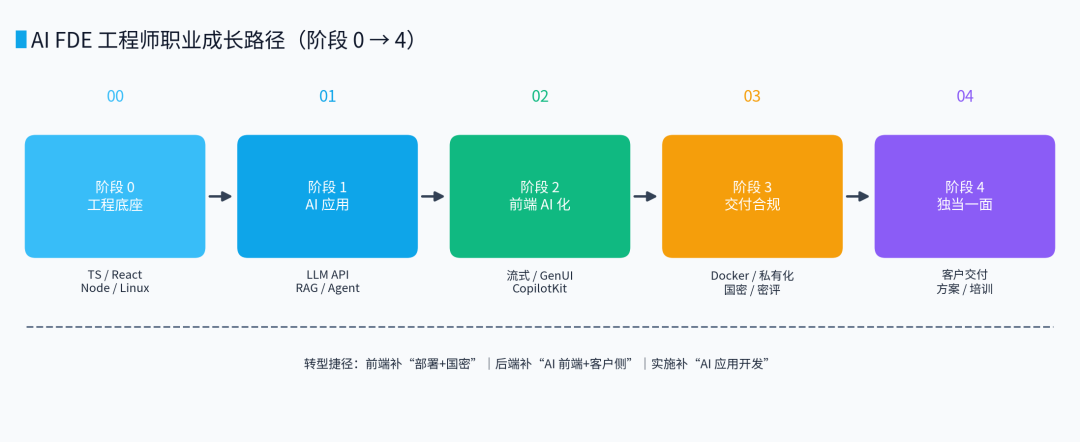
转型捷径:传统前端补"部署+国密";后端补"AI 前端+客户侧";实施工程师补"AI 应用开发"。认证与作品集建议:信创相关认证、商用密码/密评培训证书可作为合规交付背书;作品集务必包含"一个交互式 AI 应用 + 一次私有化部署记录"。
六、落地路径二:交付实施路径
适用:FDE 工程师/小队执行金融信创 AI 项目的标准作业流程。
6.1 标准交付八步
| 步骤 | 动作 | FDE 关键交付物 | 合规注意 |
| 1 | 需求评估 | 需求与边界说明 | 数据分级(核心/重要/个人) |
| 2 | 环境评估 | 环境基线报告 | 信创兼容性清单 |
| 3 | 模型选型优化 | 选型与压测报告 | 模型来源合规 |
| 4 | 架构设计 | 部署架构图 | 国密链路设计 |
| 5 | 部署实施 | 可运行系统 | 离线闭环 |
| 6 | 合规集成 | 密评支撑材料 | 必过项 |
| 7 | 联调培训 | 培训记录、手册 | 留痕 |
| 8 | 运维交接 | 运维 SOP | SLA |
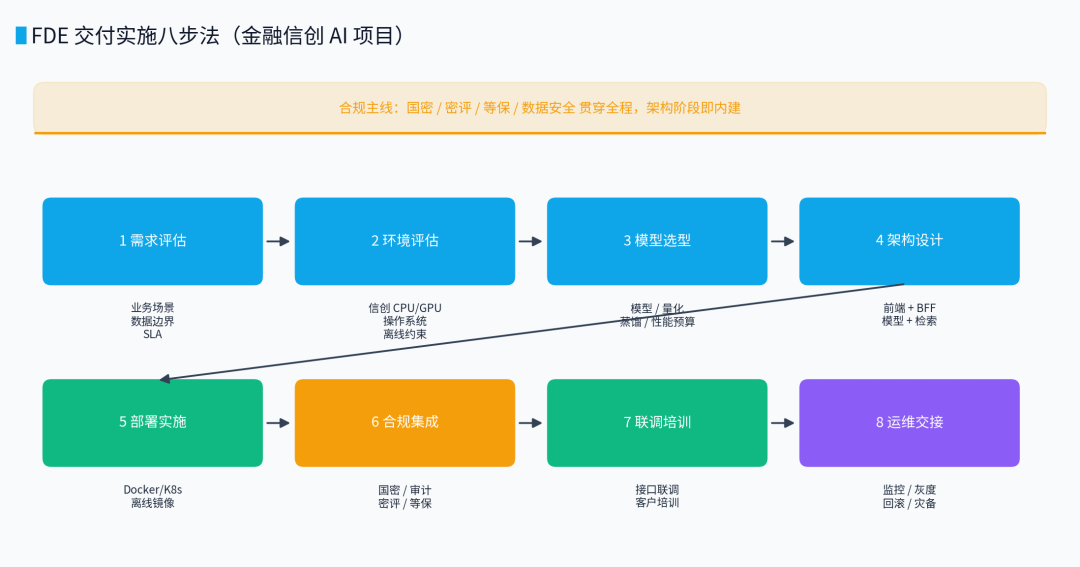
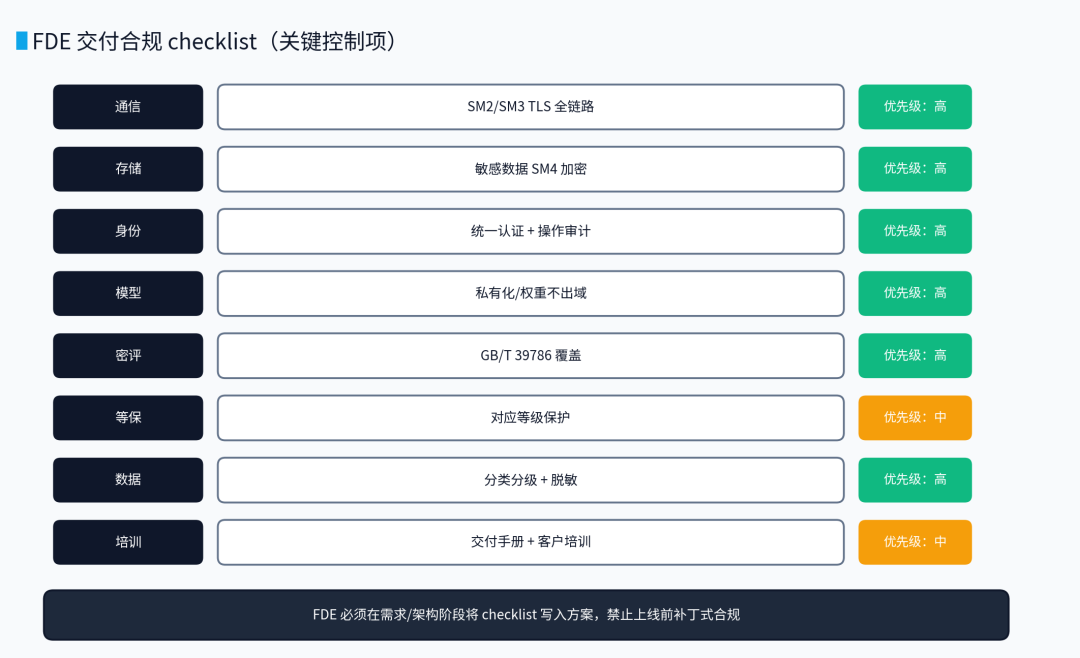
6.2 金融信创交付合规清单
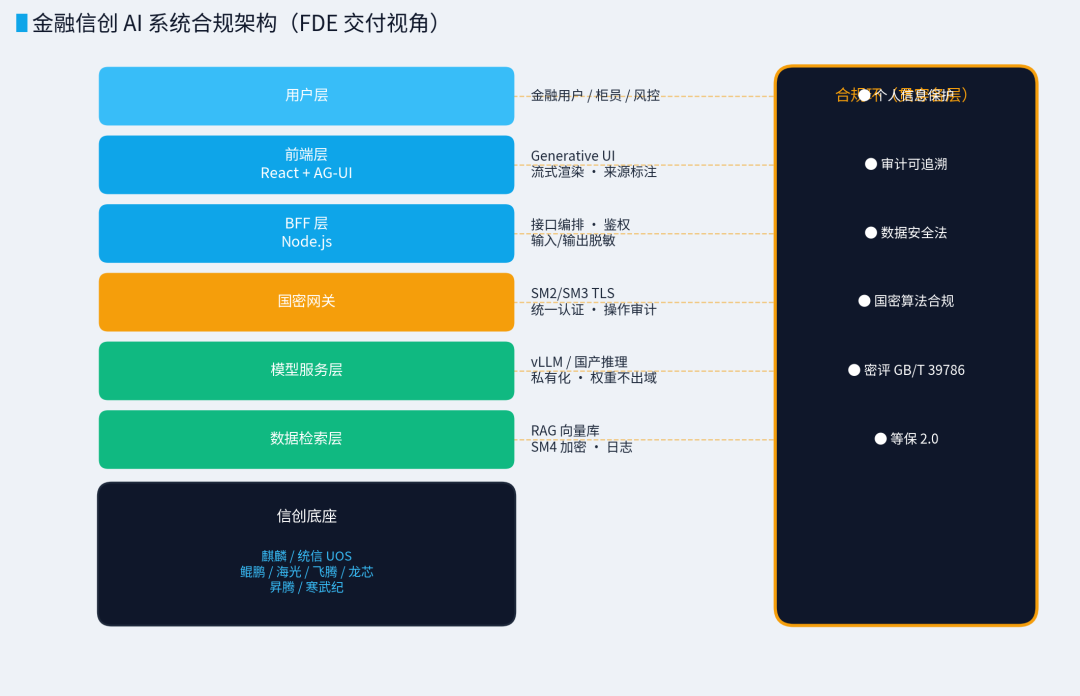
FDE 必须将以下合规要求内建到架构与交付中:
·通信:国密 SM2/SM3 TLS(前端→BFF→模型服务)
·存储:敏感数据 SM4 加密(含知识库向量、日志)
·身份:统一认证、操作审计可追溯
·模型:私有化、权重不出域、输出可控(防泄露/幻觉)
·密评:依 GB/T 39786,覆盖设备与计算/应用与数据/密钥管理
·等保:对应等级保护与关键信息基础设施要求
·信创:OS/CPU/GPU/数据库全栈国产兼容验证
合规架构示意:下图展示金融信创 AI 系统从用户层、前端层、BFF、国密网关、模型服务到信创底座的分层合规架构。
6.3 常见坑与风险
| 风险 | 表现 | 缓解 |
| 国产 GPU 兼容性 | 推理框架在昇腾/寒武纪上跑不通 | 早期 PoC 验证、锁定适配版本 |
| 模型量化精度 | 量化后金融术语/数字出错 | 关键场景用高精度、做评估对比 |
| 离线依赖缺失 | 部署时才缺基础镜像/模型 | 全量离线镜像 + 依赖清单 |
| 国密改造滞后 | 上线前才发现链路非国密 | 架构阶段即设计国密 |
| 客户培训不足 | 验收后不会用/不敢用 | 分层培训 + 场景手册 |
七、面向金融机构的 FDE 工程师建议
-
将 FDE 作为 AI 落地的"标准配置岗":金融 AI 项目不应只有算法和纯实施,必须配置"既懂界面又懂私有化合规交付"的 FDE,桥接"最后一公里"。
-
合规内建,拒绝事后打补丁:国密、密评、等保必须在架构与前端设计阶段就内建,避免上线前返工与合规风险。
-
信创适配前置验证:任何 AI 平台引入前,先在目标信创栈(麒麟/统信 + 国产 CPU/GPU)做 PoC,验证推理框架与前端兼容性。
-
能力分层配置团队:基础算法(外包/合作)+ FDE 应用交付(自建核心)+ 实施运维,控制成本同时保住合规主动权。
-
作品集/认证导向培养:内部转岗路径优先传统前端补"部署+国密",用信创/密评认证与私有化演练作品作为能力凭证。
-
Agent 交互标准化:采用 AG-UI 等开放协议,降低前端与后端 Agent 的耦合,便于多模型切换与审计。
-
安全与治理桥接:FDE 交付必须与 AI 治理衔接——前端做输入/输出审计与脱敏展示,交付做模型安全(提示注入防护、输出可控)。
-
知识沉淀与培训体系:每个交付沉淀"部署手册 + 培训材料 + 故障库",形成机构内可复用的 FDE 能力资产。
八、典型落地案例
以下两个案例展示 FDE 在金融信创场景中的真实工作面与交付边界。
8.1 案例一:银行智能客服私有化交付
背景:某股份制银行希望在内网部署智能客服,覆盖手机银行、柜员终端、运营管理台三类用户,要求数据不出域、通过密评与等保三级、适配麒麟 OS + 海光 CPU + 昇腾 GPU。
FDE 工作面:① React 前端实现 SSE 流式对话与工具调用可视化;② Node.js BFF 做接口编排、鉴权与输入/输出脱敏;③ 国密网关实现 SM2/SM3 TLS 全链路;④ 在信创 K8s 上私有化部署 vLLM 推理服务;⑤ 编写操作手册并对柜员/运营人员分层培训。
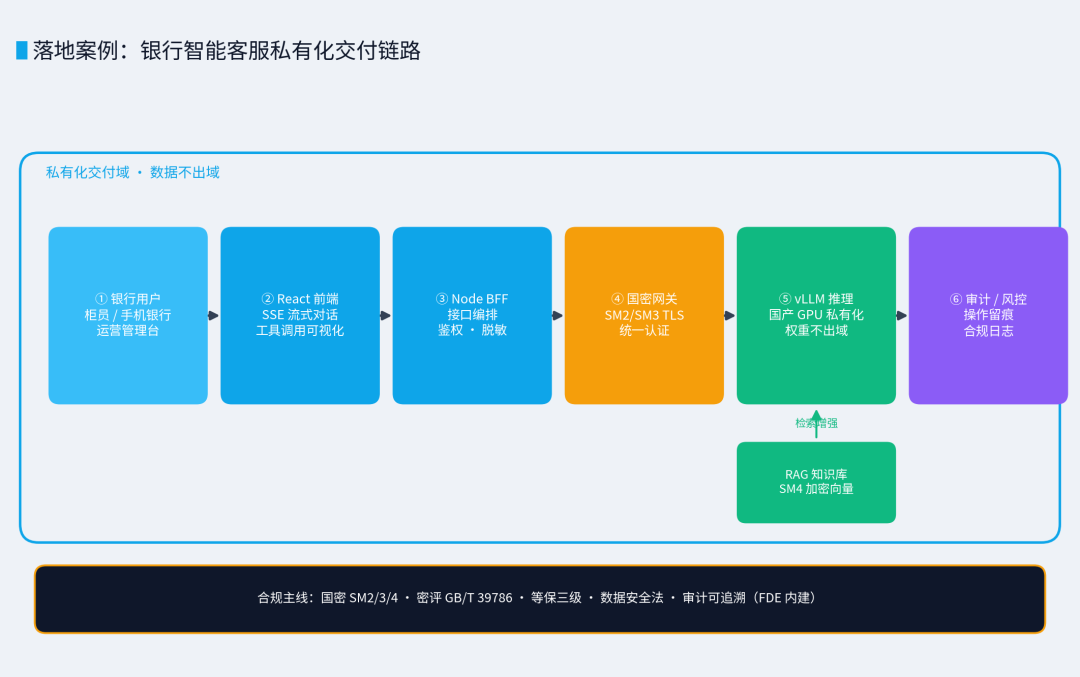
关键收益:客服响应延迟从公网 API 的 2s+ 降至内网 300ms 内;敏感问答数据不出域;通过密评与等保三级;形成可复用的银行 AI 交付模板。
8.2 案例二:金融知识库 RAG 系统交付
背景:某券商合规部需要基于内部制度、监管文件、合同模板的私有知识库,搭建合规问答助手,要求回答可追溯、可审计、支持国产芯片。
FDE 工作面:① 前端实现检索结果高亮与引用溯源;② 向量库采用 SM4 加密存储;③ 使用 LangChain/Dify 做 RAG 工作流编排;④ 在统信 UOS + 鲲鹏 CPU 环境部署;⑤ 输出合规审计日志,满足监管检查。
| 维度 | 做法 |
| 数据安全 | 知识库切片与向量均 SM4 加密,检索权限与 SSO 绑定 |
| 可审计 | 每次问答记录用户、问题、引用、模型版本、时间戳 |
| 信创适配 | 向量库、推理服务、前端均通过国产 OS/CPU/GPU 兼容性测试 |
| 培训 | 为合规专员提供"场景手册 + 常见问题清单" |
关键收益:合规问答平均检索时间 < 500ms,回答可追溯到原文段落;审计日志完整;成为该券商内部多个部门复用的 AI 基础设施。
九、挑战与展望
·Agent 前端标准化:AG-UI 等协议将重构"Agent→前端"协作,FDE 重心从手搓 UI 转向协议编排与业务组件生成。
·多模态交互:语音/图像/文件成为金融 AI 前端常态,前端需处理更复杂的流式与渲染。
·国密全栈成熟:国产推理框架、国密 TLS、信创 K8s 持续完善,FDE 的合规交付成本将下降。
·信创 AI 生态:国产 GPU 生态成熟后,私有化部署门槛降低,FDE 价值从"排坑摆盘"转向"体验与治理"。
·AI 辅助开发:FDE 自身也将由 AI 辅助写 AI 前端(Copilot/代码智能体),效率倍增但需守住合规与审计底线。
·风险不降反增:提示注入在前端的可视化误导、数据泄露、幻觉责任——FDE 需在交互层做"安全护盾"(来源标注、操作确认、审计留痕)。
最后
对于正在迷茫择业、想转行提升,或是刚入门的程序员、编程小白来说,有一个问题几乎人人都在问:未来10年,什么领域的职业发展潜力最大?
答案只有一个:人工智能(尤其是大模型方向)
当下,人工智能行业正处于爆发式增长期,其中大模型相关岗位更是供不应求,薪资待遇直接拉满——字节跳动作为AI领域的头部玩家,给硕士毕业的优质AI人才(含大模型相关方向)开出的月基础工资高达5万—6万元;即便是非“人才计划”的普通应聘者,月基础工资也能稳定在4万元左右。
再看阿里、腾讯两大互联网大厂,非“人才计划”的AI相关岗位应聘者,月基础工资也约有3万元,远超其他行业同资历岗位的薪资水平,对于程序员、小白来说,无疑是绝佳的转型和提升赛道。
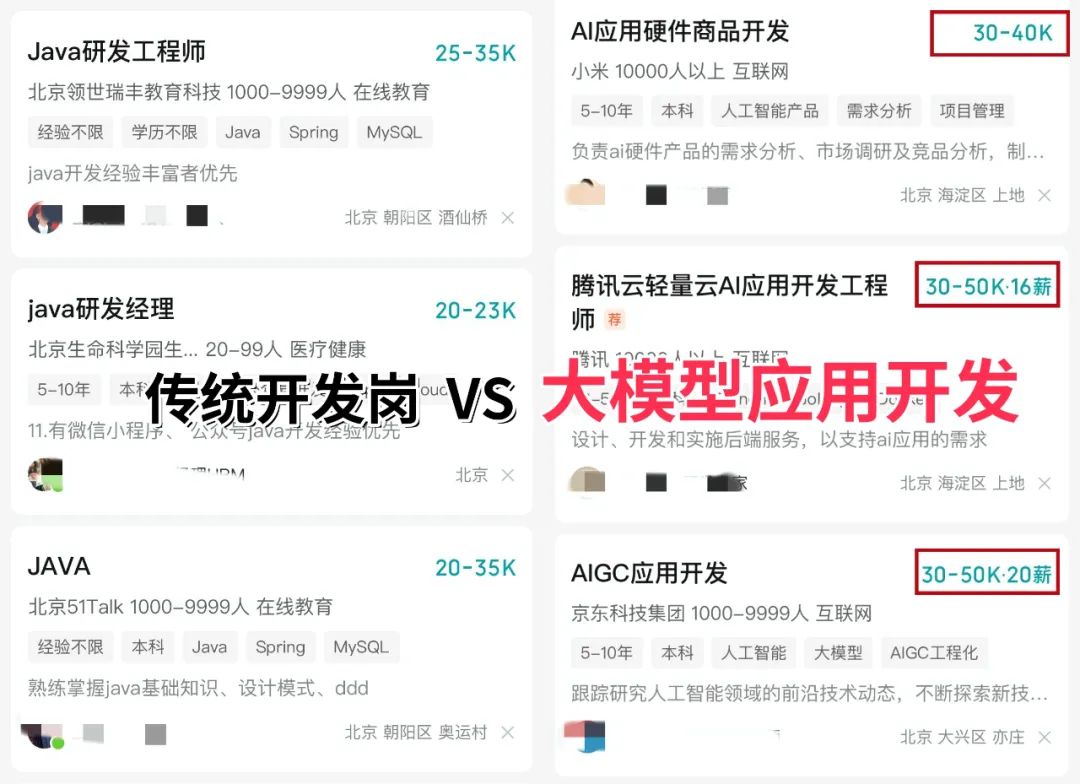
如果你还不知道从何开始,我自己整理一套全网最全最细的大模型零基础教程,我也是一路自学走过来的,很清楚小白前期学习的痛楚,你要是没有方向还没有好的资源,根本学不到东西!
下面是我整理的大模型学习资源,希望能帮到你。
👇👇扫码免费领取全部内容👇👇

最后
1、大模型学习路线
2、从0到进阶大模型学习视频教程
从入门到进阶这里都有,跟着老师学习事半功倍。
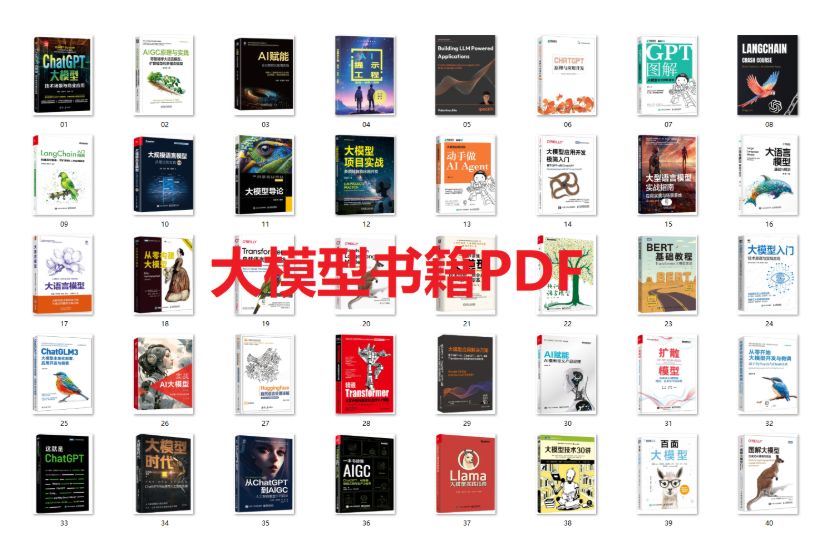
3、 入门必看大模型学习书籍&文档.pdf(书面上的技术书籍确实太多了,这些是我精选出来的,还有很多不在图里)
4、 AI大模型最新行业报告
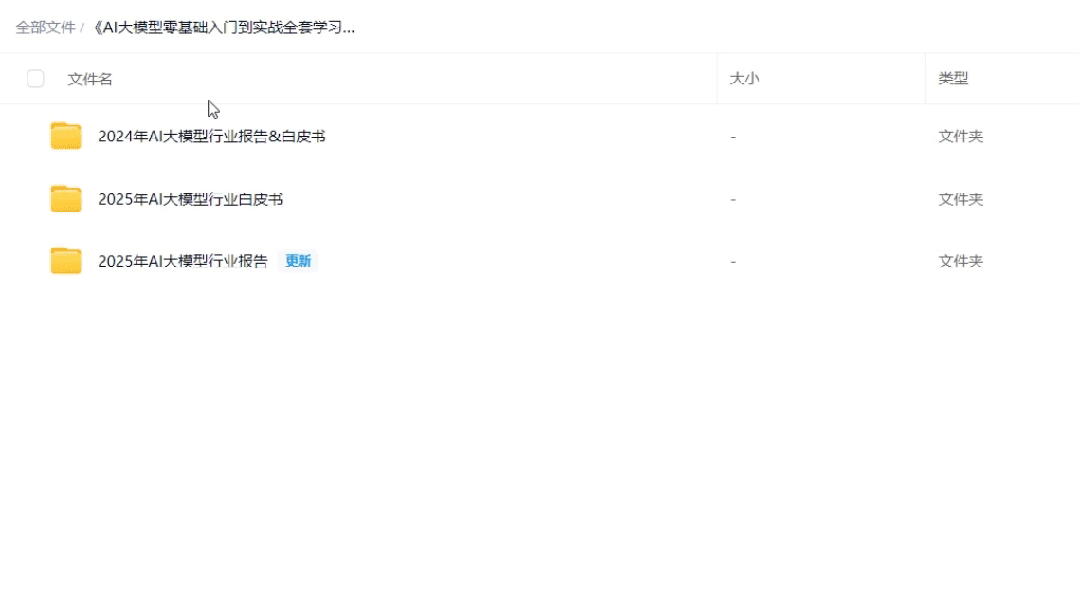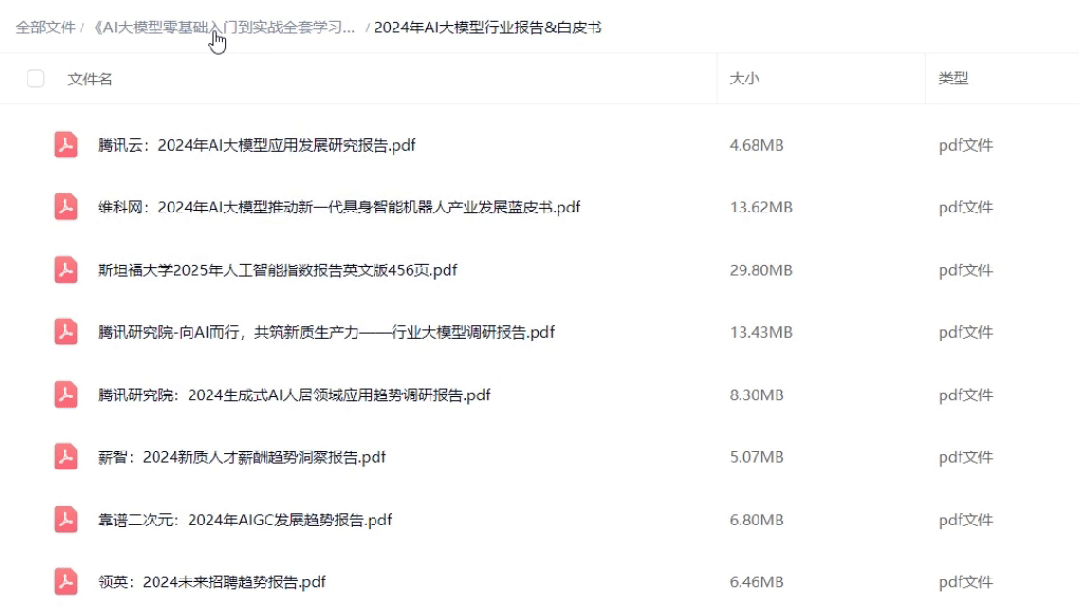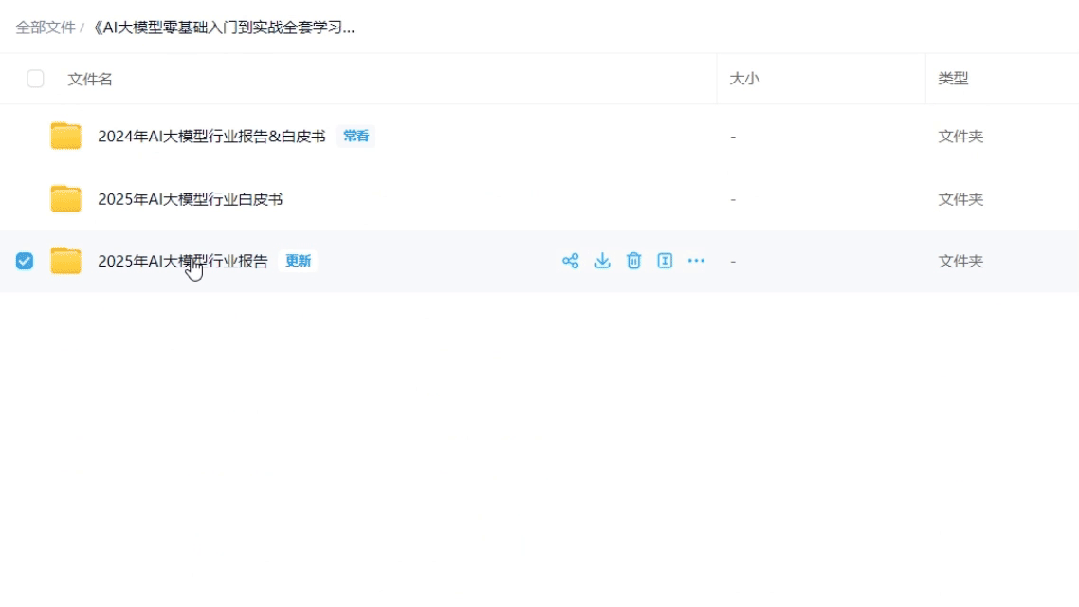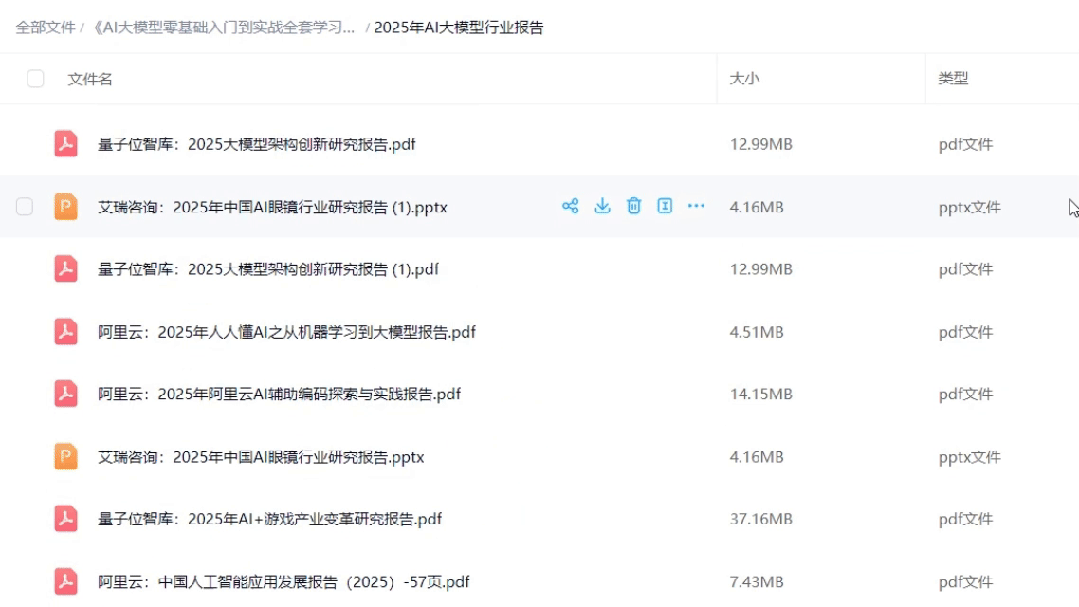
2026最新行业报告,针对不同行业的现状、趋势、问题、机会等进行系统地调研和评估,以了解哪些行业更适合引入大模型的技术和应用,以及在哪些方面可以发挥大模型的优势。
5、面试试题/经验
【大厂 AI 岗位面经分享(107 道)】
【AI 大模型面试真题(102 道)】
【LLMs 面试真题(97 道)】
6、大模型项目实战&配套源码
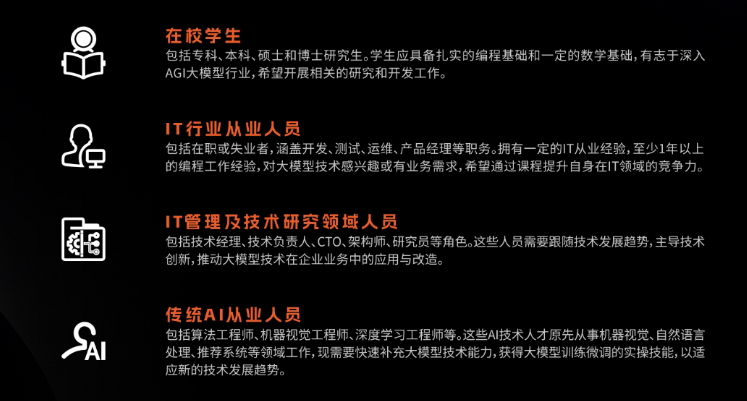
适用人群
四阶段学习规划(共90天,可落地执行)
第一阶段(10天):初阶应用
该阶段让大家对大模型 AI有一个最前沿的认识,对大模型 AI 的理解超过 95% 的人,可以在相关讨论时发表高级、不跟风、又接地气的见解,别人只会和 AI 聊天,而你能调教 AI,并能用代码将大模型和业务衔接。
- 大模型 AI 能干什么?
- 大模型是怎样获得「智能」的?
- 用好 AI 的核心心法
- 大模型应用业务架构
- 大模型应用技术架构
- 代码示例:向 GPT-3.5 灌入新知识
- 提示工程的意义和核心思想
- Prompt 典型构成
- 指令调优方法论
- 思维链和思维树
- Prompt 攻击和防范
- …
第二阶段(30天):高阶应用
该阶段我们正式进入大模型 AI 进阶实战学习,学会构造私有知识库,扩展 AI 的能力。快速开发一个完整的基于 agent 对话机器人。掌握功能最强的大模型开发框架,抓住最新的技术进展,适合 Python 和 JavaScript 程序员。
- 为什么要做 RAG
- 搭建一个简单的 ChatPDF
- 检索的基础概念
- 什么是向量表示(Embeddings)
- 向量数据库与向量检索
- 基于向量检索的 RAG
- 搭建 RAG 系统的扩展知识
- 混合检索与 RAG-Fusion 简介
- 向量模型本地部署
- …
第三阶段(30天):模型训练
恭喜你,如果学到这里,你基本可以找到一份大模型 AI相关的工作,自己也能训练 GPT 了!通过微调,训练自己的垂直大模型,能独立训练开源多模态大模型,掌握更多技术方案。
到此为止,大概2个月的时间。你已经成为了一名“AI小子”。那么你还想往下探索吗?
- 为什么要做 RAG
- 什么是模型
- 什么是模型训练
- 求解器 & 损失函数简介
- 小实验2:手写一个简单的神经网络并训练它
- 什么是训练/预训练/微调/轻量化微调
- Transformer结构简介
- 轻量化微调
- 实验数据集的构建
- …
第四阶段(20天):商业闭环
对全球大模型从性能、吞吐量、成本等方面有一定的认知,可以在云端和本地等多种环境下部署大模型,找到适合自己的项目/创业方向,做一名被 AI 武装的产品经理。
-
硬件选型
-
带你了解全球大模型
-
使用国产大模型服务
-
搭建 OpenAI 代理
-
热身:基于阿里云 PAI 部署 Stable Diffusion
-
在本地计算机运行大模型
-
大模型的私有化部署
-
基于 vLLM 部署大模型
-
案例:如何优雅地在阿里云私有部署开源大模型
-
部署一套开源 LLM 项目
-
内容安全
-
互联网信息服务算法备案
-
…
👇👇扫码免费领取全部内容👇👇

3、这些资料真的有用吗?
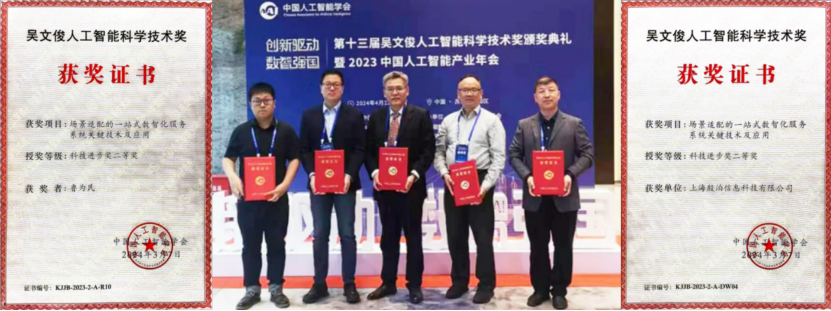
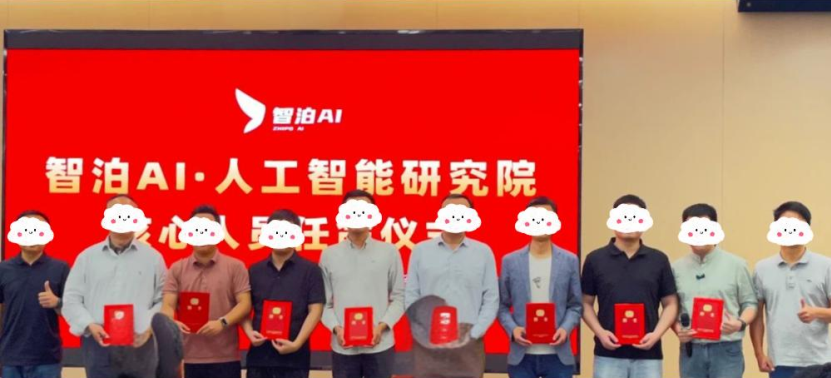
这份资料由我和鲁为民博士(北京清华大学学士和美国加州理工学院博士)共同整理,现任上海殷泊信息科技CEO,其创立的MoPaaS云平台获Forrester全球’强劲表现者’认证,服务航天科工、国家电网等1000+企业,以第一作者在IEEE Transactions发表论文50+篇,获NASA JPL火星探测系统强化学习专利等35项中美专利。本套AI大模型课程由清华大学-加州理工双料博士、吴文俊人工智能奖得主鲁为民教授领衔研发。
资料内容涵盖了从入门到进阶的各类视频教程和实战项目,无论你是小白还是有些技术基础的技术人员,这份资料都绝对能帮助你提升薪资待遇,转行大模型岗位。
这份完整版的大模型 AI 学习资料已经上传CSDN,朋友们如果需要可以微信扫描下方CSDN官方认证二维码免费领取【保证100%免费】


openEuler 是由开放原子开源基金会孵化的全场景开源操作系统项目,面向数字基础设施四大核心场景(服务器、云计算、边缘计算、嵌入式),全面支持 ARM、x86、RISC-V、loongArch、PowerPC、SW-64 等多样性计算架构
更多推荐

 0
 0
- 0


 已为社区贡献2条内容

所有评论(0)